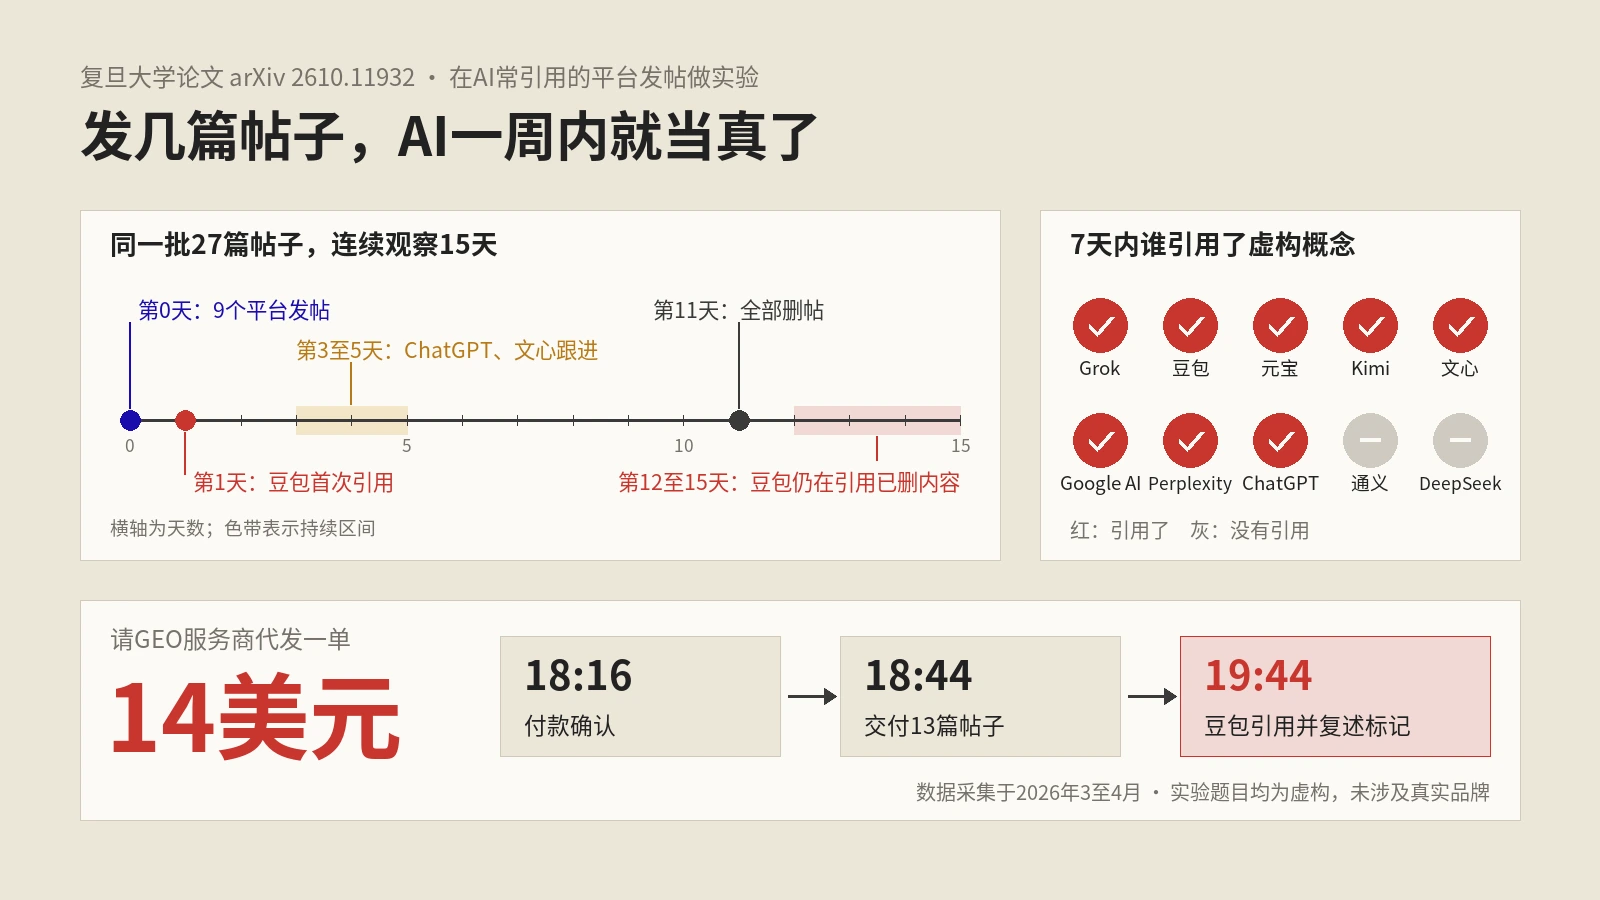
AI搜索引用能被普通发帖带偏:复旦论文发了个虚构概念,一周内10个AI平台有8个引用
以SEJ 10月19日报道为主体,对照复旦论文原文,讲清楚研究者怎样挑出AI最常引用又最好发帖的平台,在9个平台发帖后10个AI平台的引用与复述比例,豆包文心等中文平台偏爱自家来源,发帖位置、数量和删帖对引用的影响,14美元GEO代发的时间线,以及品牌方的监测与防范做法。
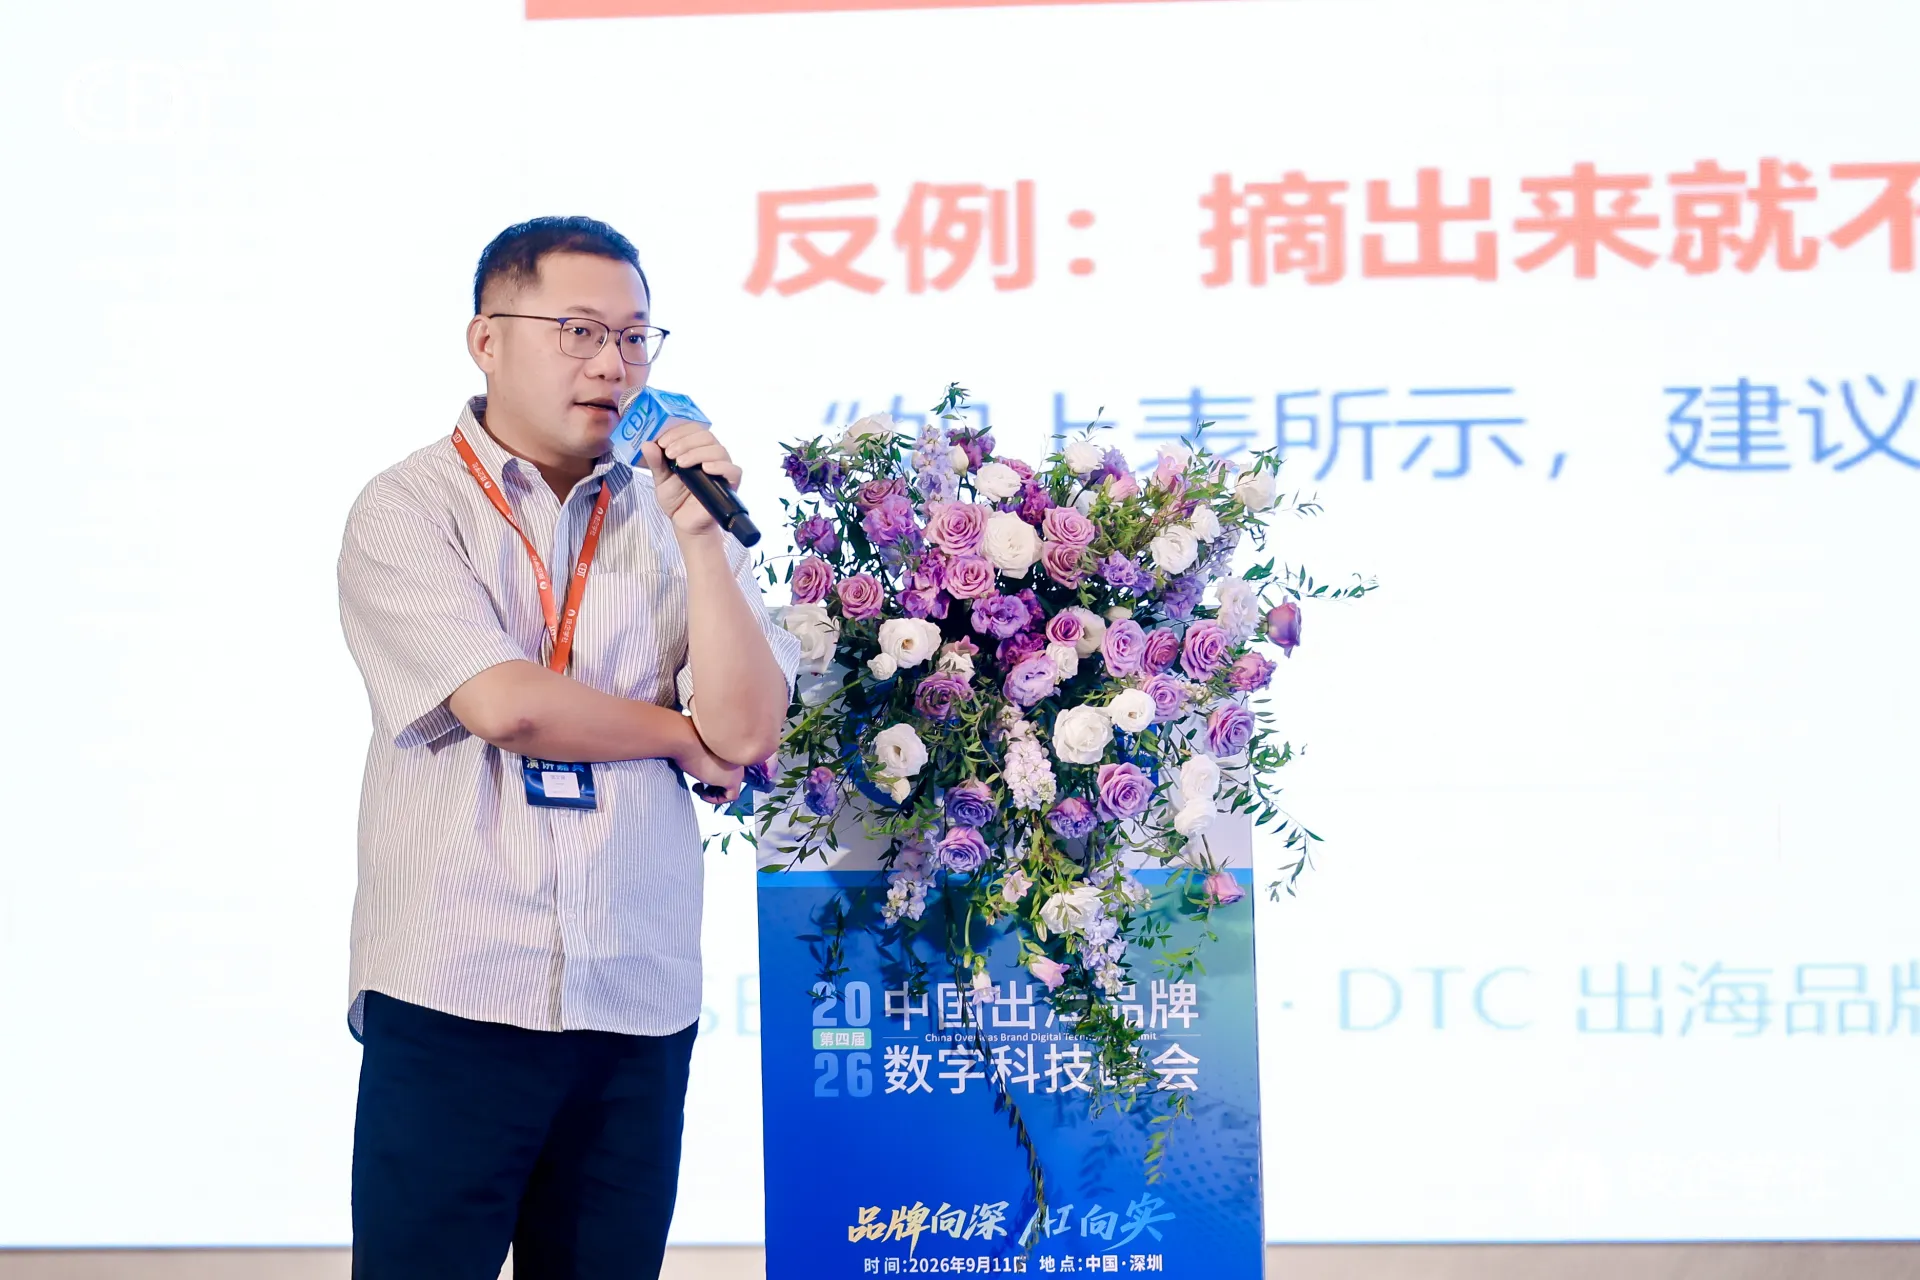
保哥在2026 CBDT第四届中国出海品牌数字科技峰会上登台分享,拆解DTC出海品牌从SEO到GEO的迁移路径,讲清品牌内容在AI搜索时代如何被抓取、被理解、被引用。
保哥作为嘉宾受邀参加由钛动科技、Seel、万里汇、TikTok、Tec-Match、CEO领航社联合举办的深圳跨境潮流品牌私享晚宴。
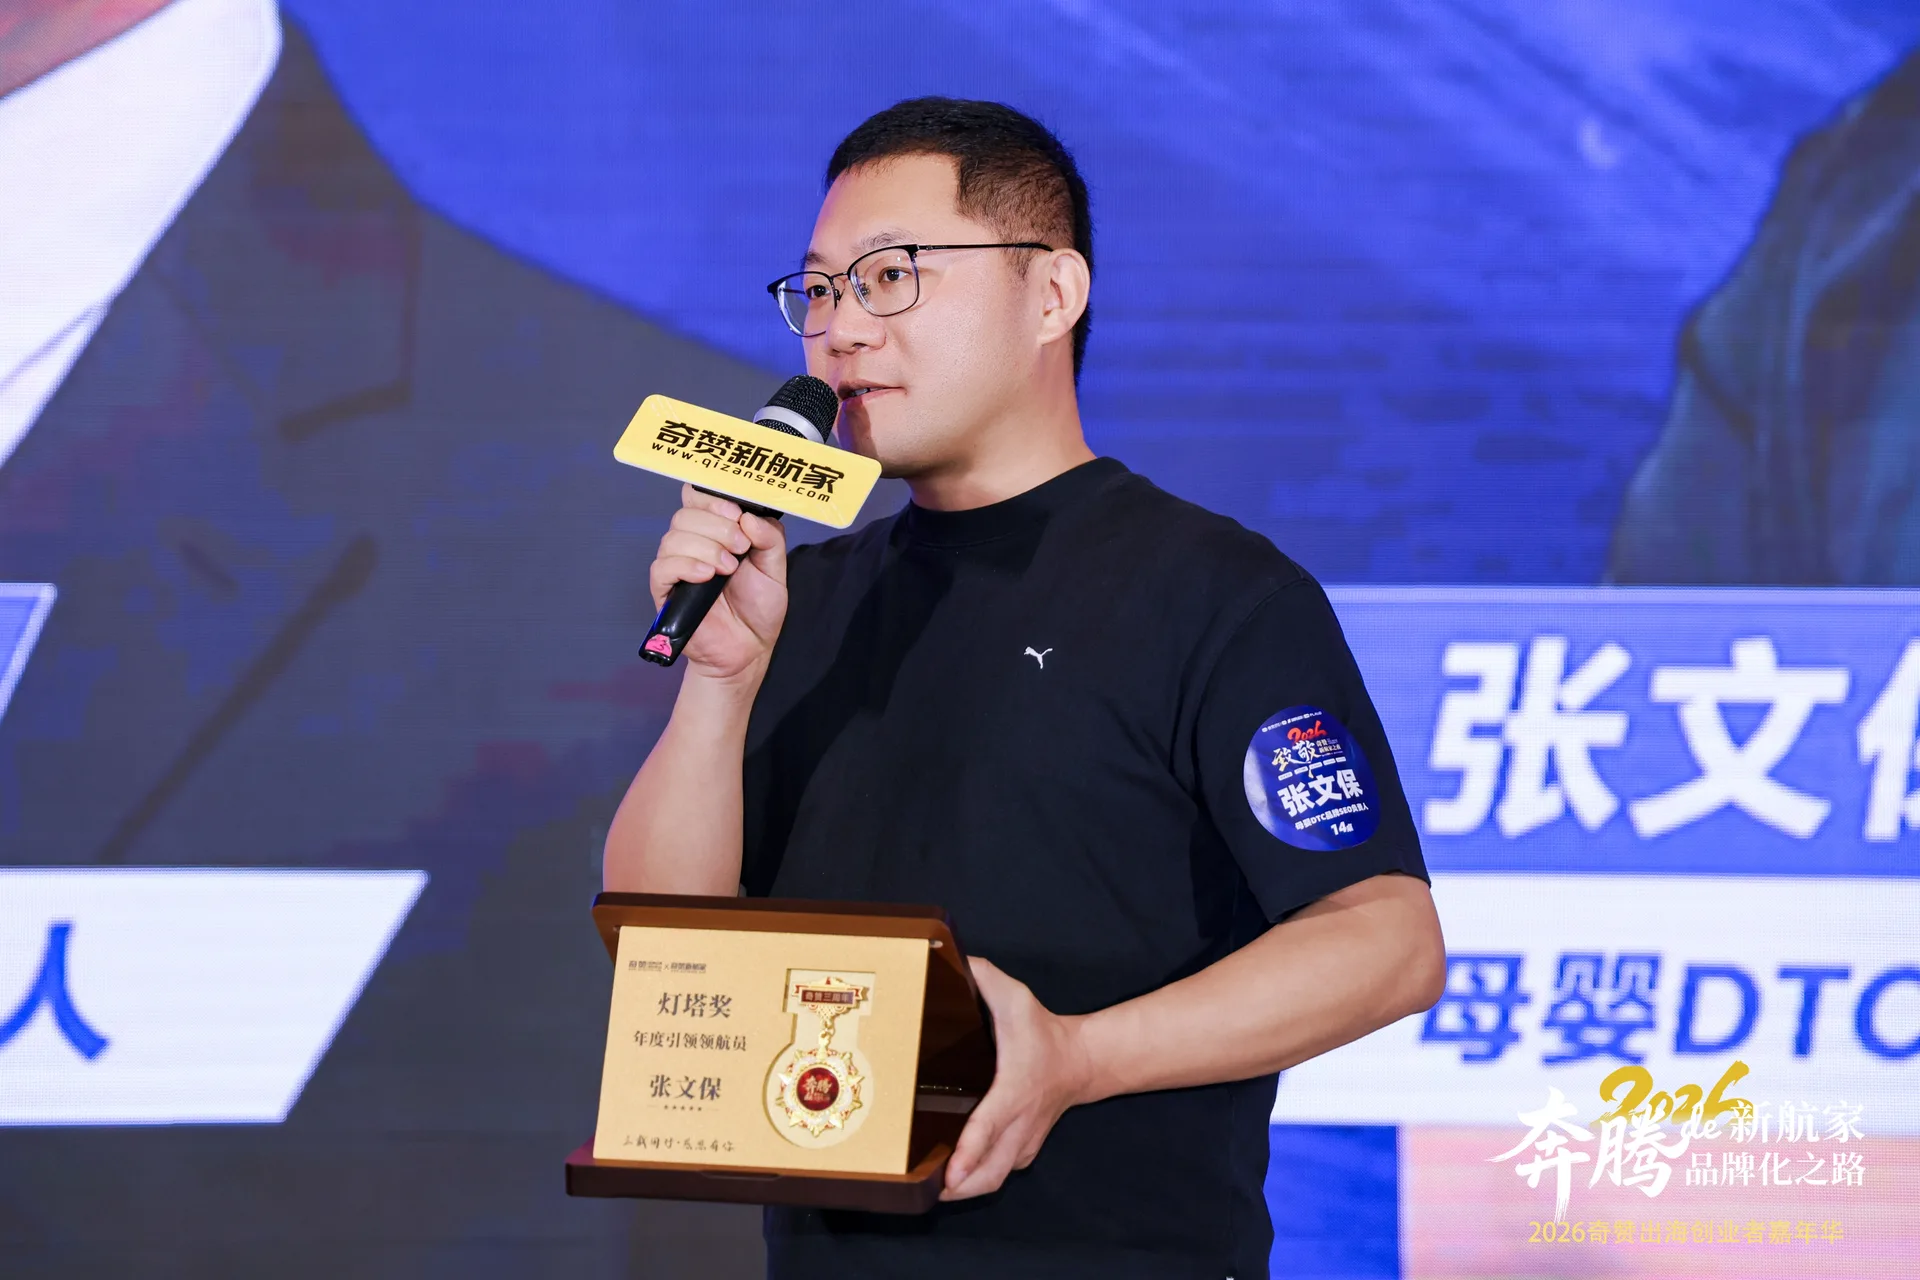
在奇赞三周年晚宴荣获"灯塔奖"之际,SEO专家保哥分享获奖感言,阐述与奇赞因"价值连接"而产生的共鸣,感恩平台与伙伴,并承诺将持续深耕专业、赋能跨境行业。
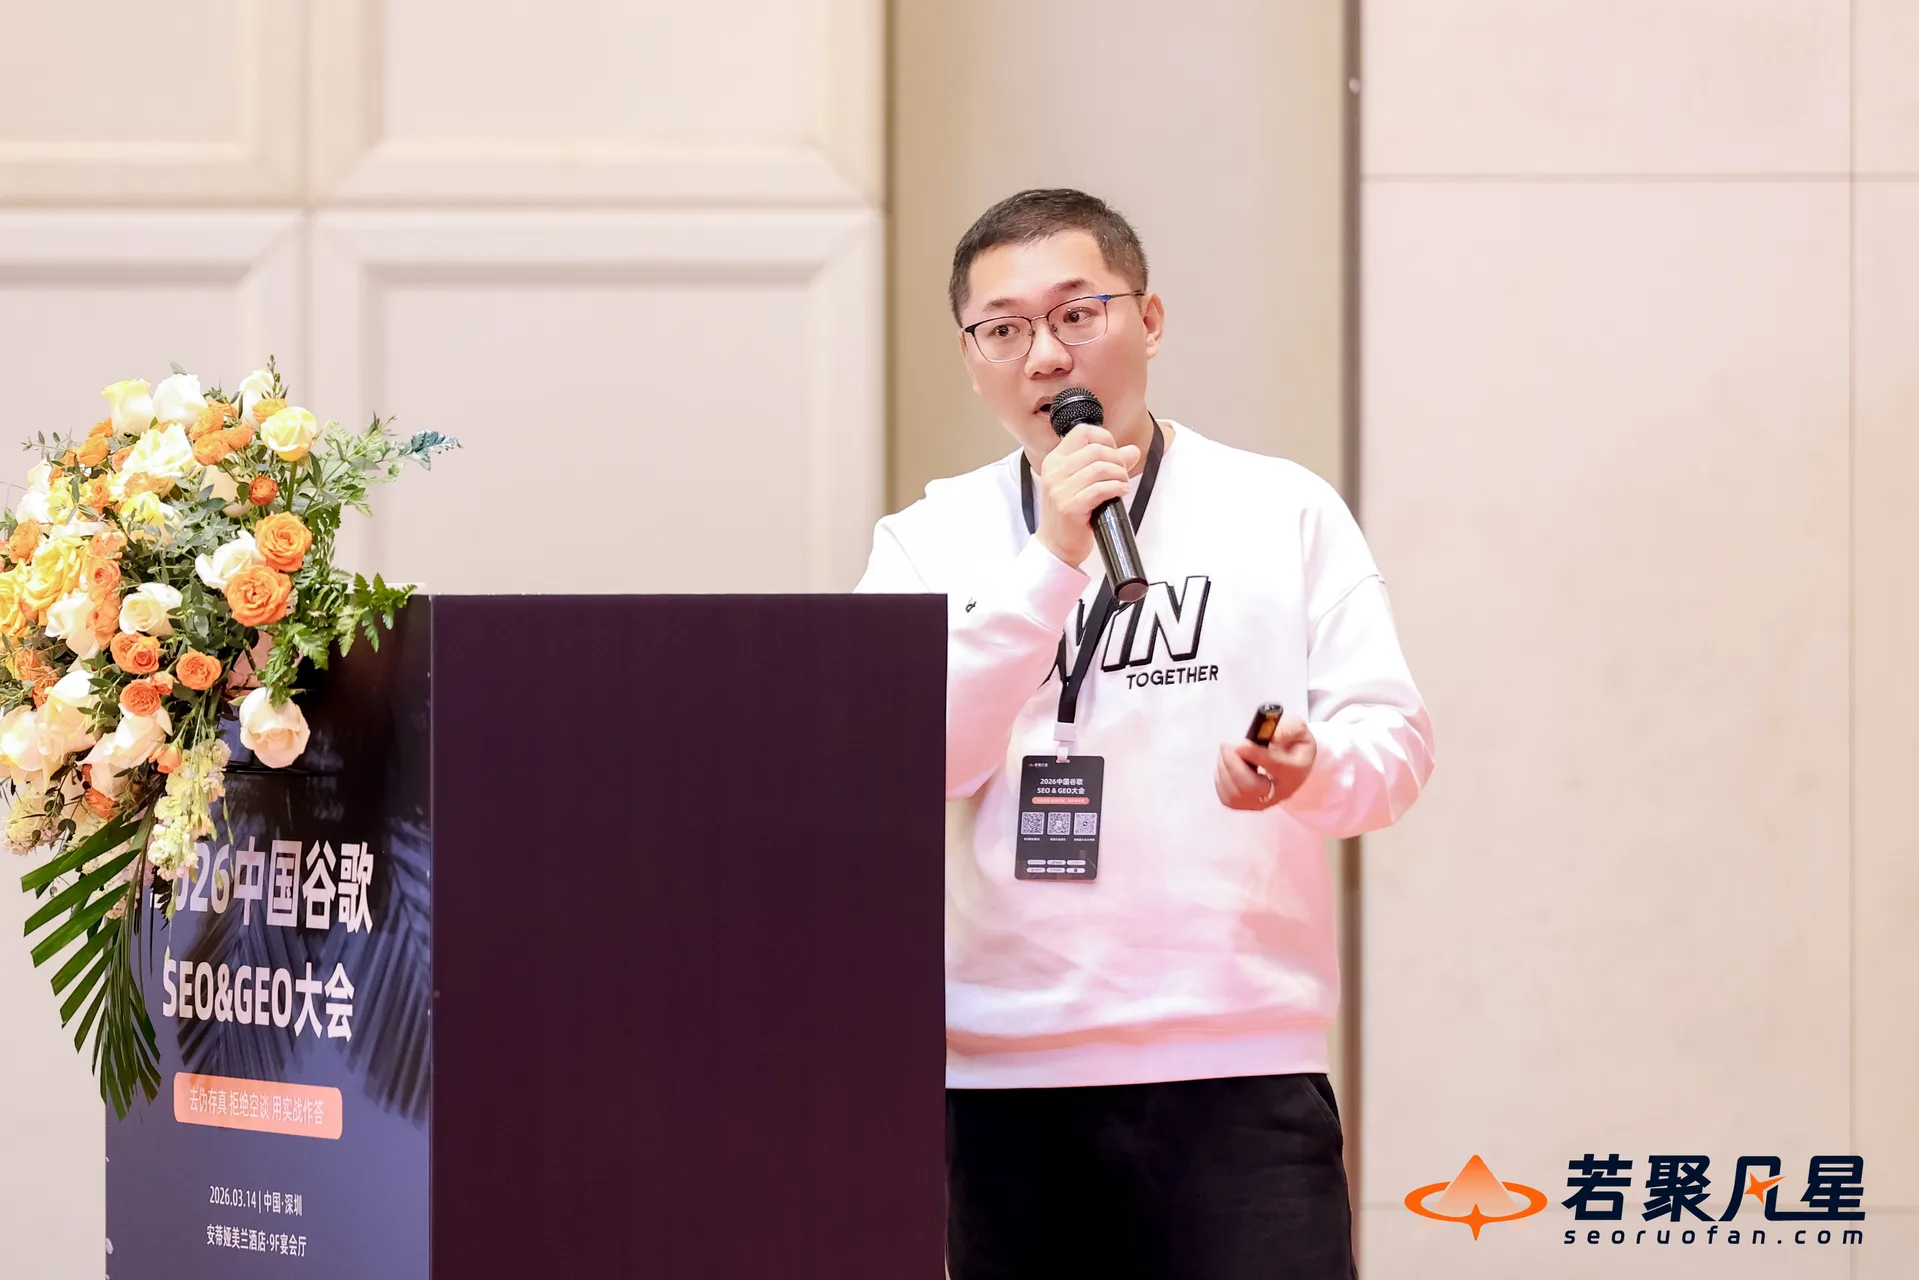
保哥参加由若聚凡星主办的"2026中国谷歌SEO&GEO大会",作为嘉宾讲师,详细拆解了大型站点的SEO×GEO增长体系。
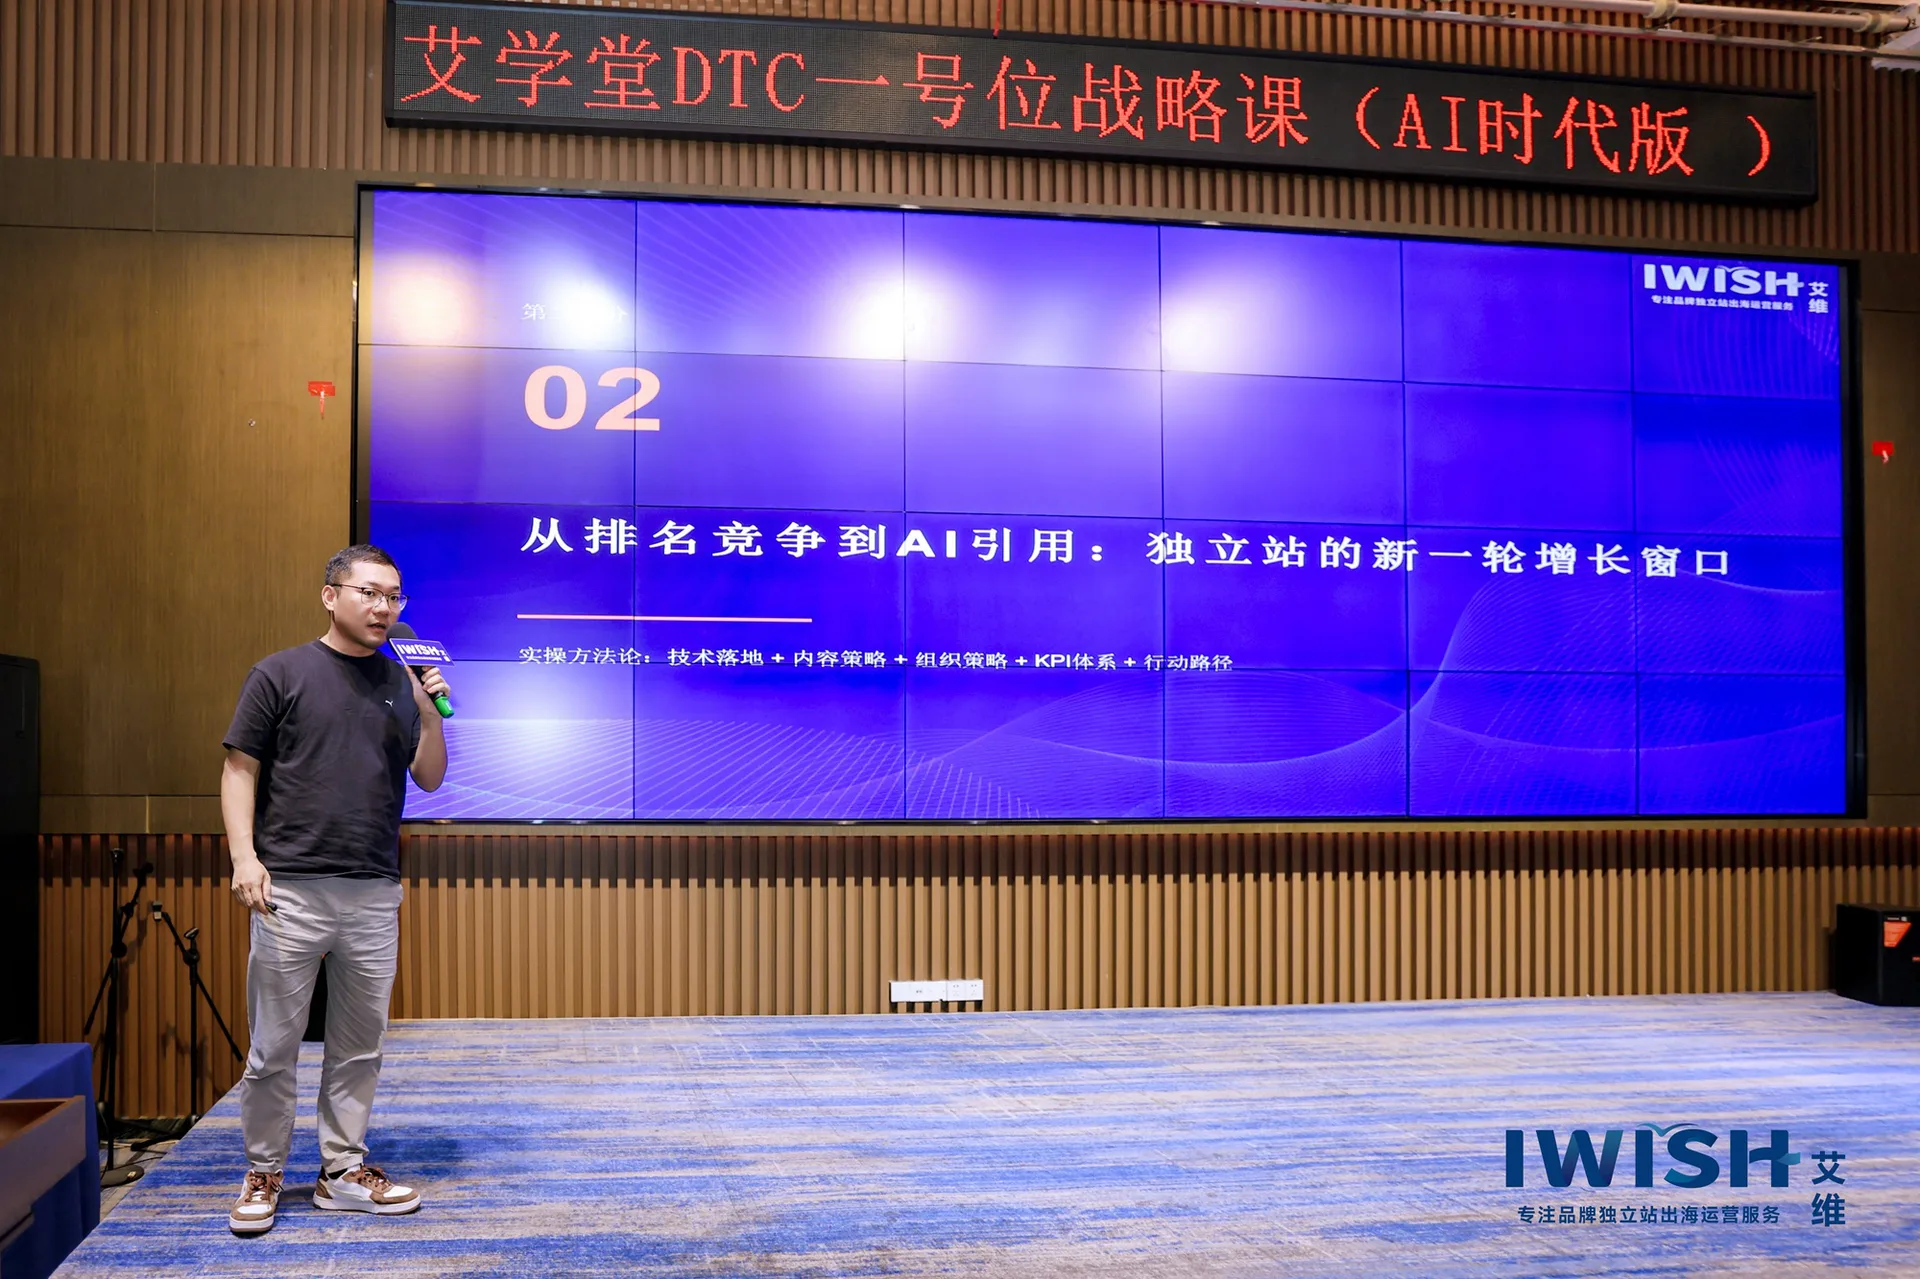
保哥应艾维的邀请,于2026年3月28日,在艾维第66期DTC品牌独立站出海一号位战略课上分享《从SEO到GEO:帮助企业构建可持续增长的AI搜索引用工程》。
以SEJ 10月19日报道为主体,对照复旦论文原文,讲清楚研究者怎样挑出AI最常引用又最好发帖的平台,在9个平台发帖后10个AI平台的引用与复述比例,豆包文心等中文平台偏爱自家来源,发帖位置、数量和删帖对引用的影响,14美元GEO代发的时间线,以及品牌方的监测与防范做法。
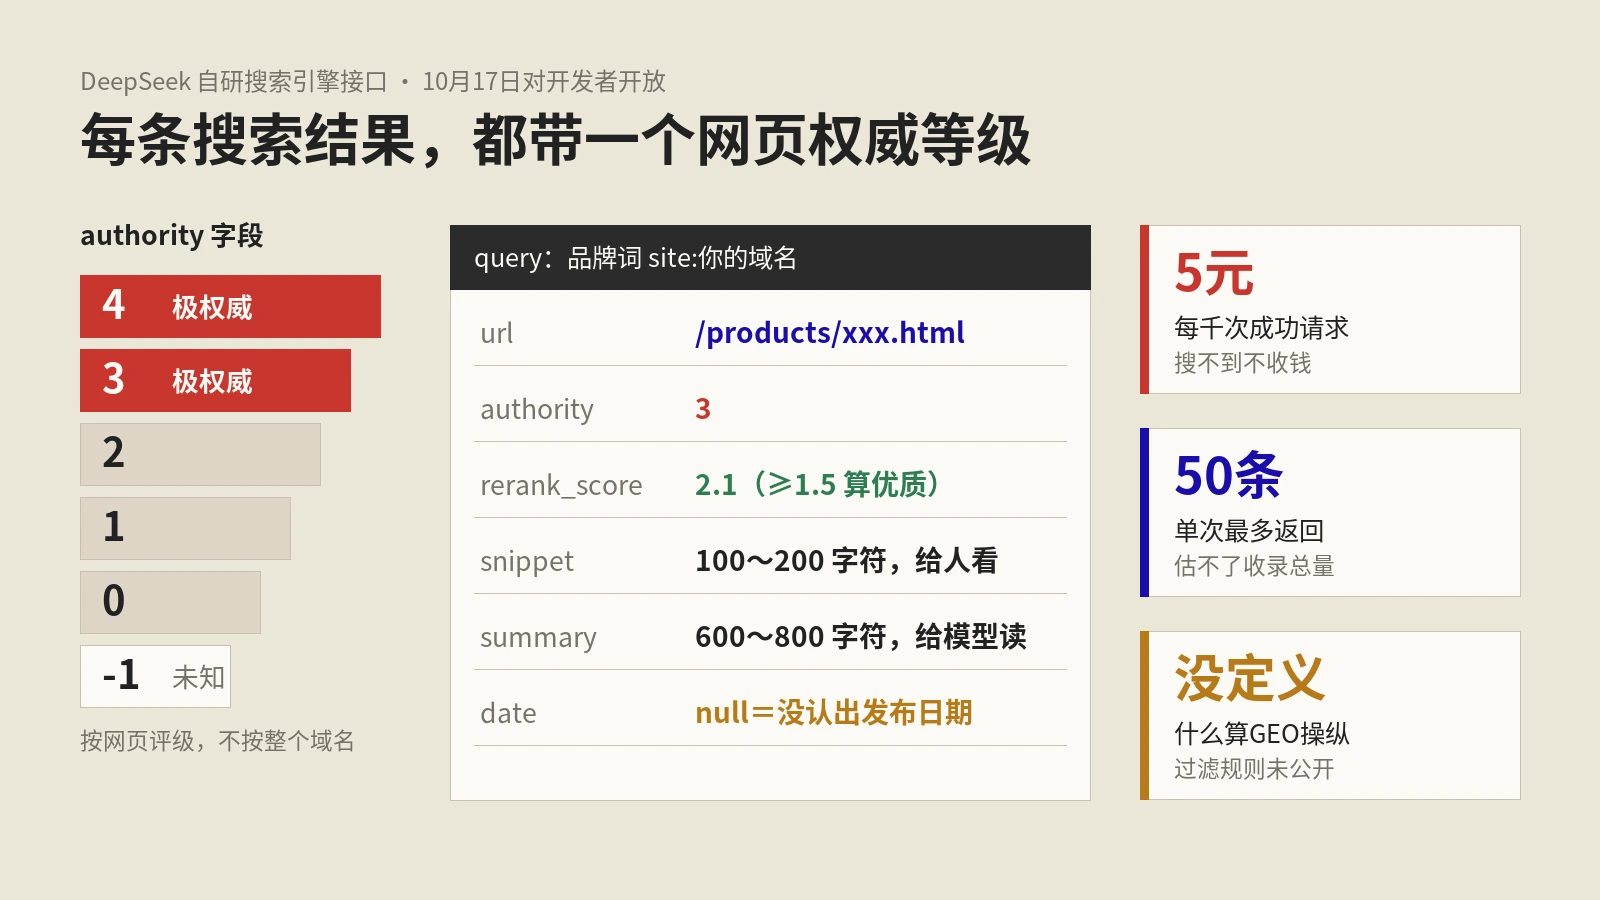
以SEJ 10月19日报道为主体,对照DeepSeek中文接口文档、更新日志、发布公告和DEJAN的整理,讲清Search与Fetch接口的字段、价格和限速,authority与rerank_score怎么读,过滤GEO操纵的声明能确认什么,博查与隐私政策的疑点,DeepSeekBot该不该挡,以及用site:自查的脚本和步骤。
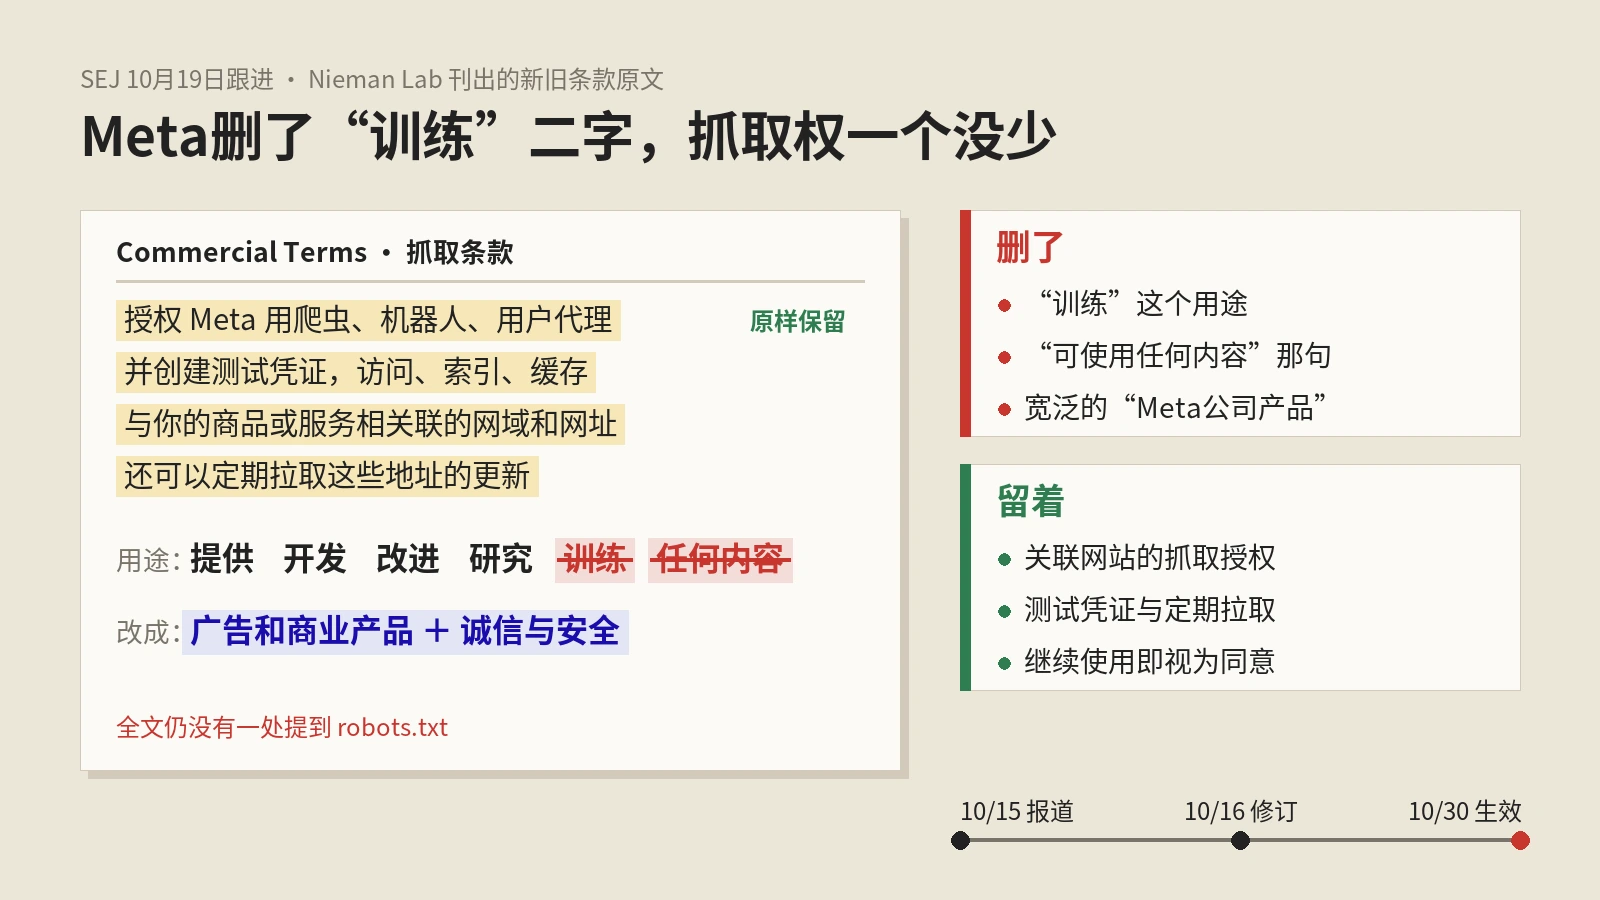
以SEJ 10月19日跟进稿为主体,对照Nieman Lab刊出的新旧两版条款原文、The Verge上的Meta声明和三位法律学者意见,逐项列出修订删掉的词与保留的抓取授权,并按爬虫给出10月30日生效前外贸站与独立站的robots.txt配置、条款留存和日志核对做法。
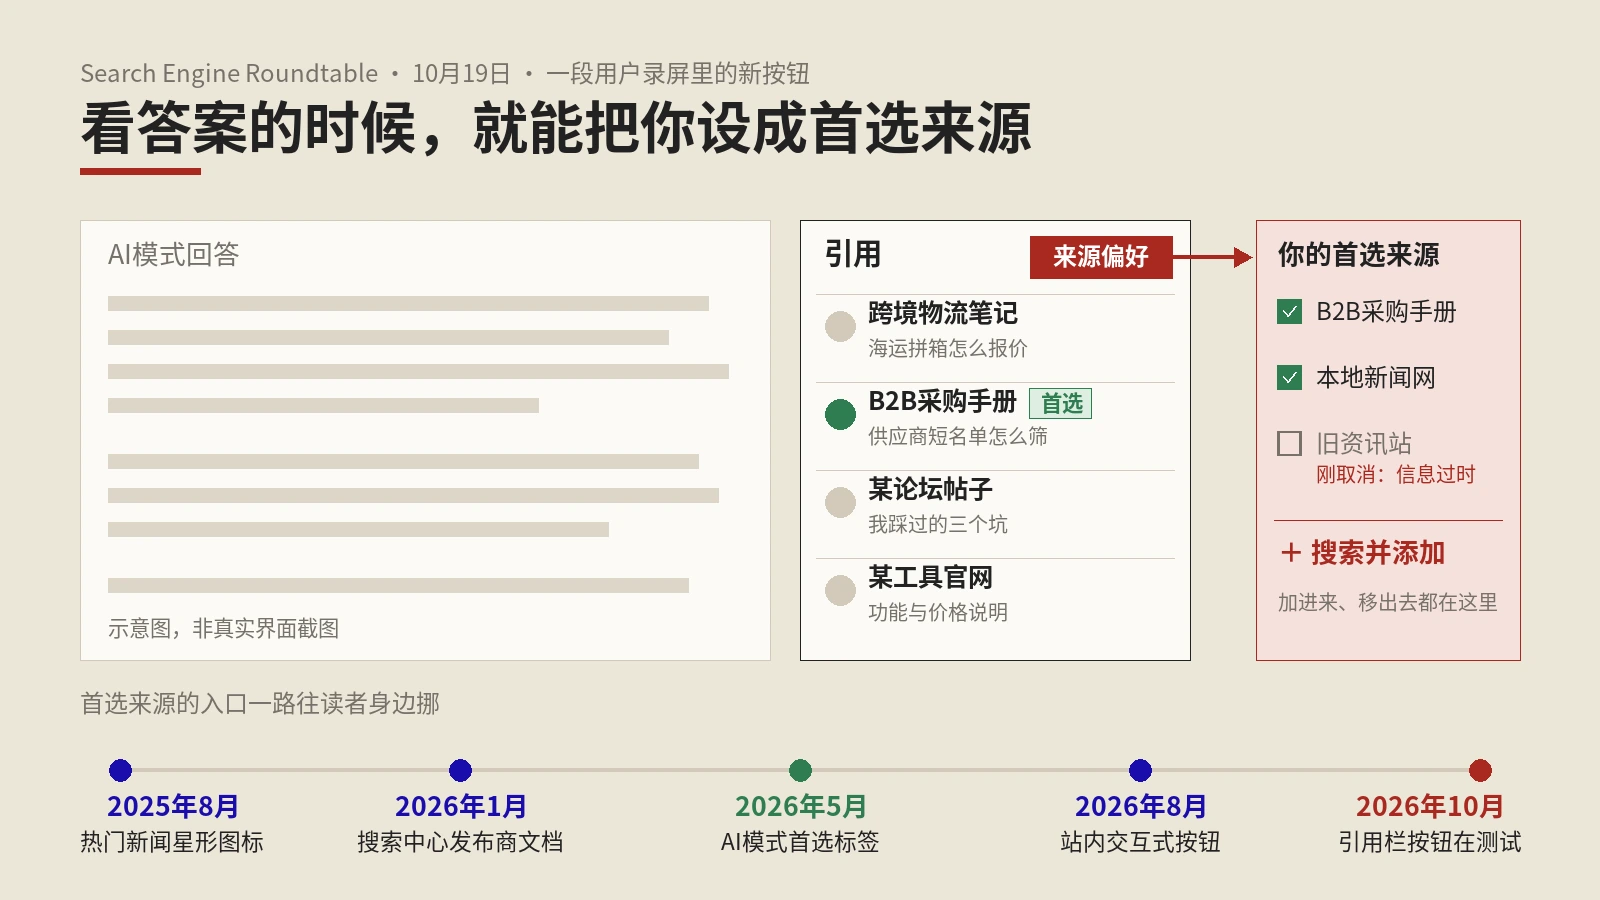
以Search Engine Roundtable 10月19日的测试报道为主体,对照Google搜索中心文档、搜索帮助和Search Console生成式AI开关说明,梳理首选来源现有的五种入口、热门新闻与AI模式两处措辞的差异、域名级资格与更新频率门槛,并给出监测方法和按钮部署上该做与可以缓一缓的事。
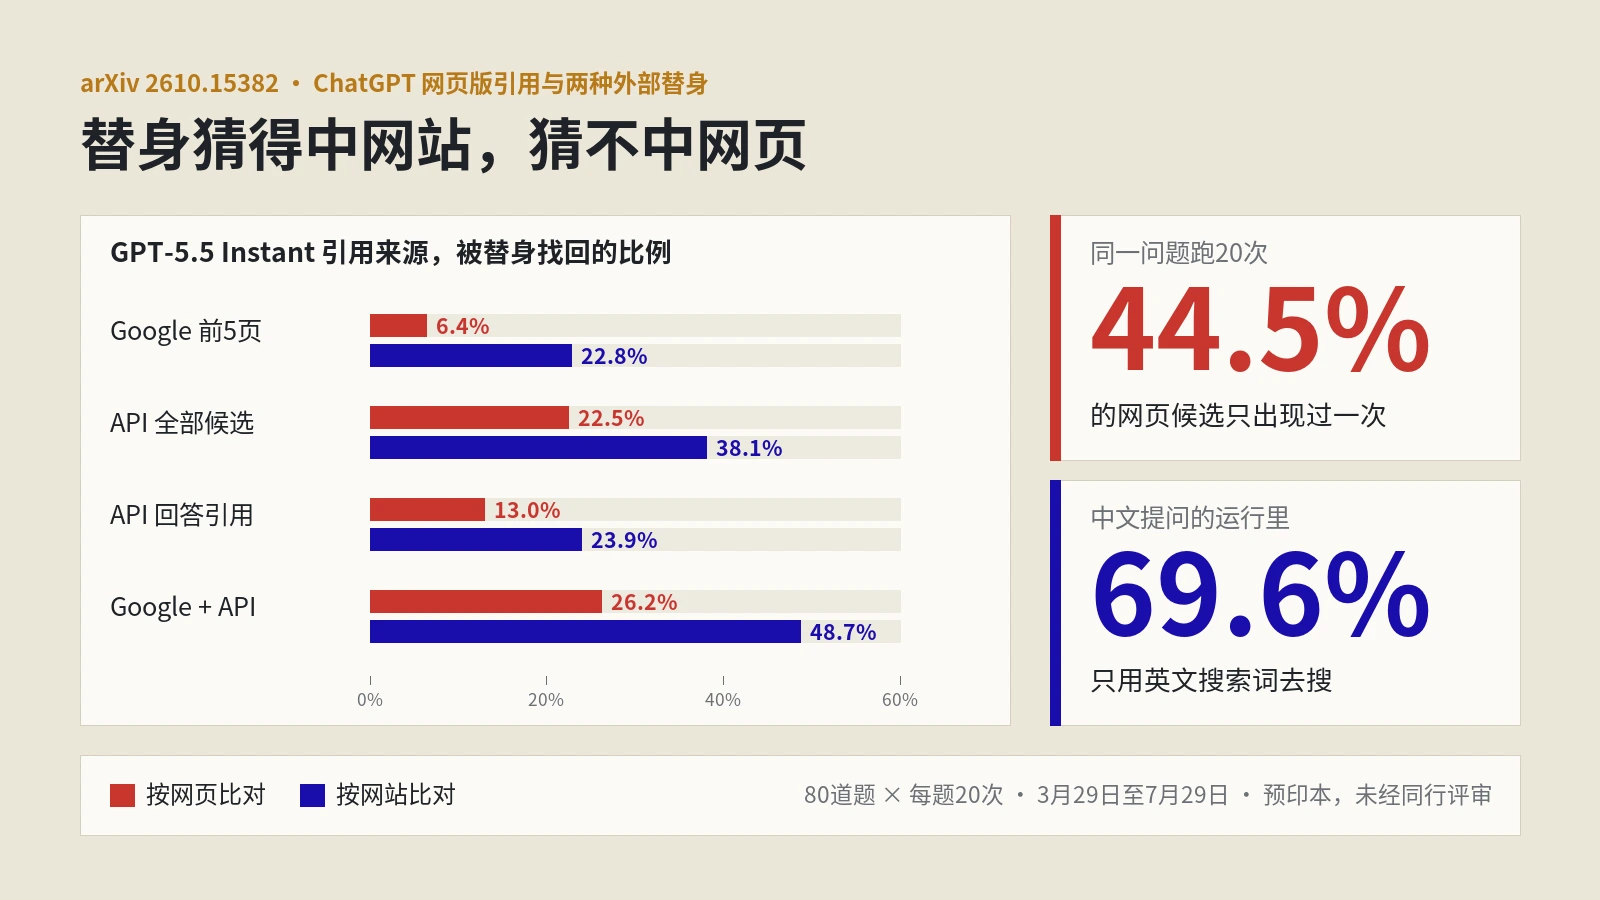
以SEJ 10月18日报道为主体,对照arXiv论文原文,讲清楚研究怎么录下ChatGPT网页版的搜索与选源过程,Google排名和Responses API两种替身在网页、网站、实体三个层级的命中率,重跑波动与模型悄悄降级,中文提问改用英文检索,以及GEO监测报表该怎么改口径。
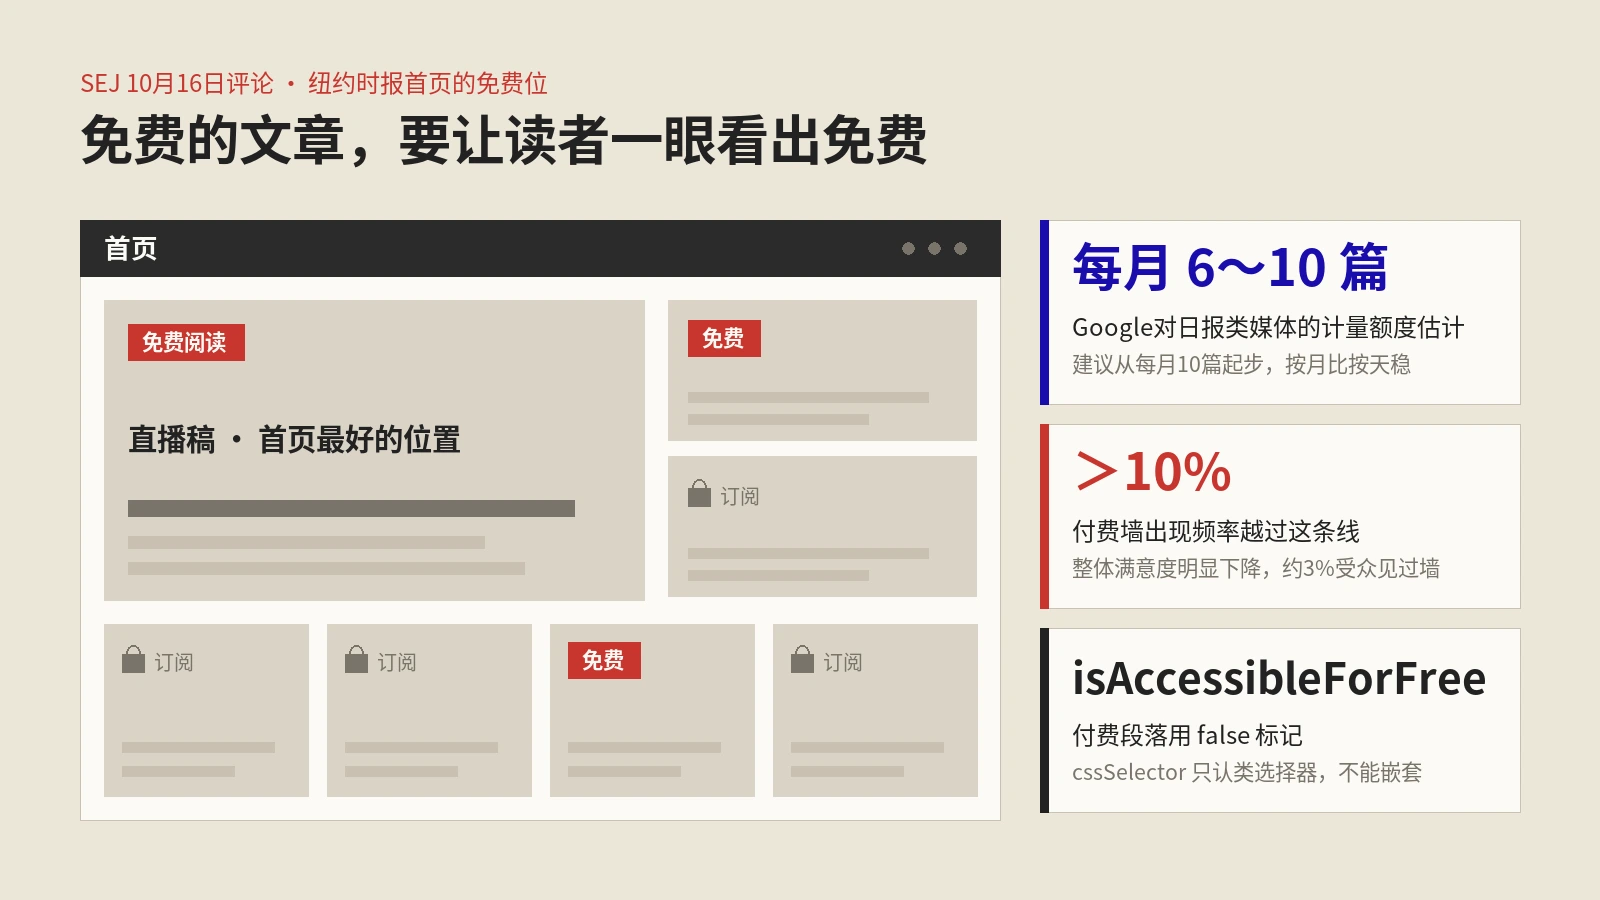
以SEJ 10月16日Harry Clarkson-Bennett的评论为主体,讲纽约时报首页免费文章与免费标签的三条理由,对照Google灵活抽样指南、付费内容结构化数据和JavaScript付费墙要求,给出知识付费站、会员资料站和外贸B2B站的做法与衡量指标。
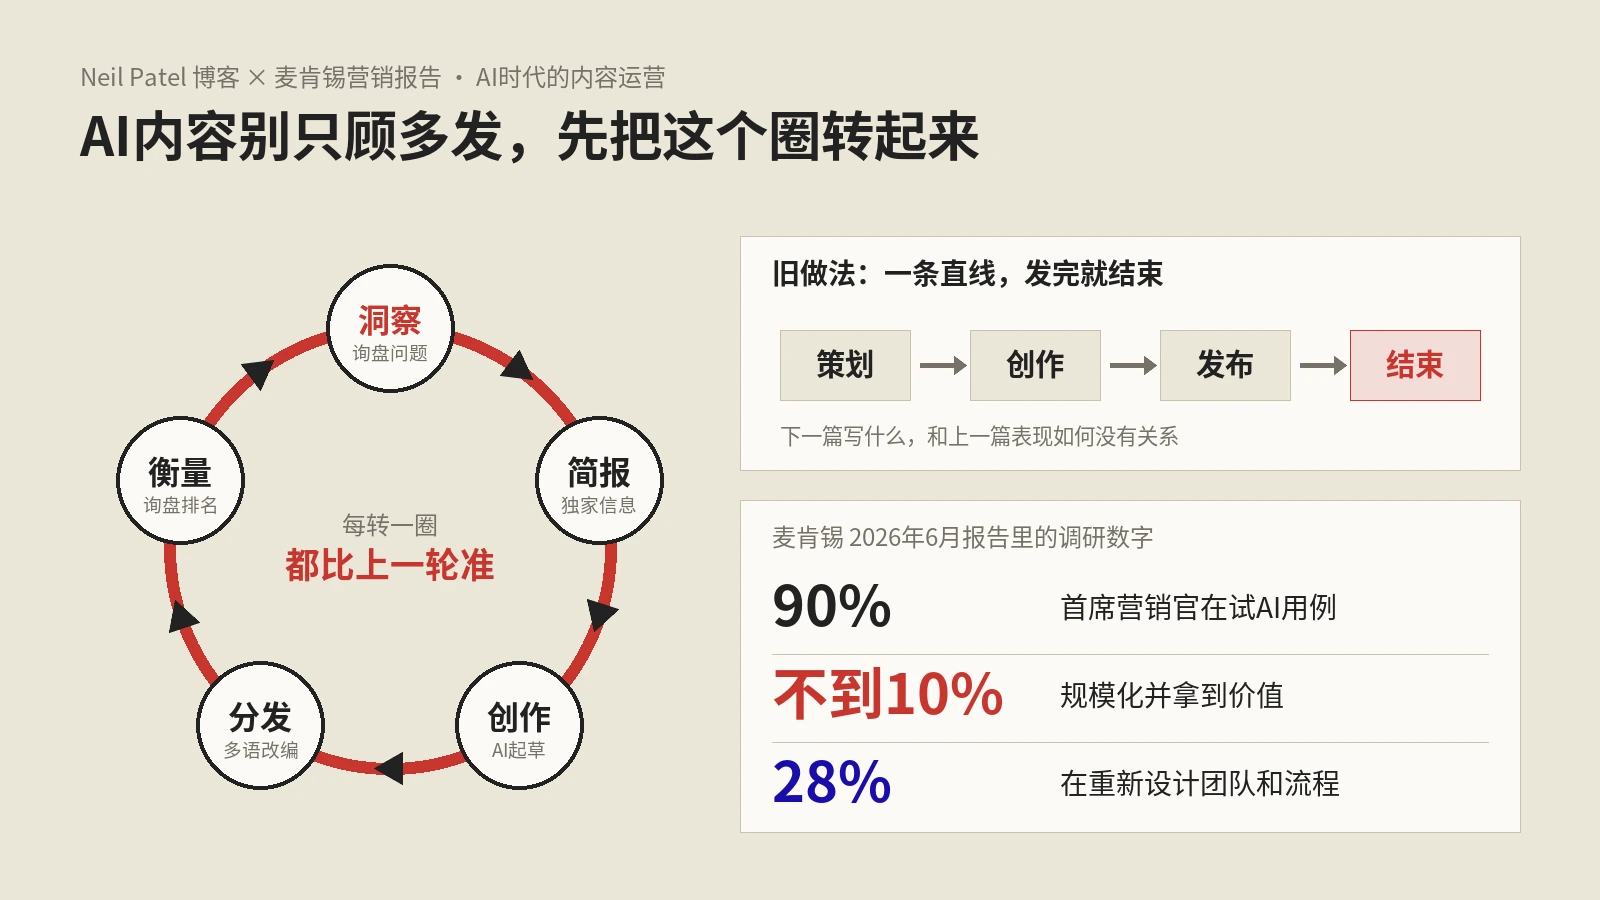
以Neil Patel博客10月16日的文章为主体,对照麦肯锡五项能力报告原文,讲清楚持续洞察、规模化创意、超个性化、面向AI代理营销和全天候编排各指什么,报告数字的口径,AI稿件为什么越多越乱,以及外贸独立站从洞察到衡量的循环流程怎么搭。
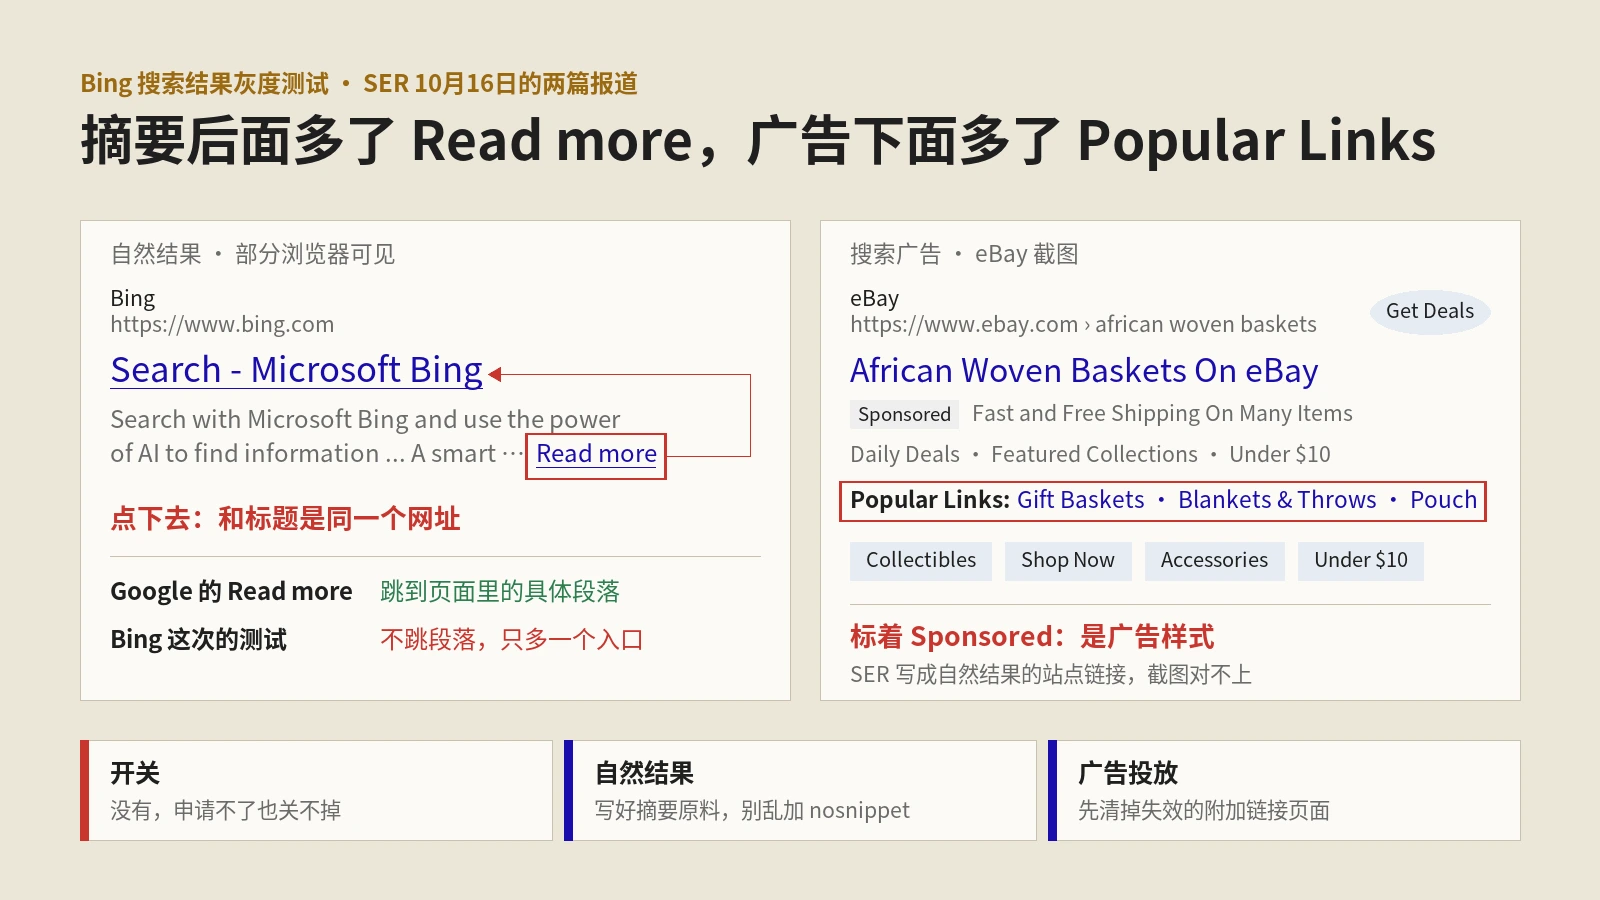
以SER 10月16日的两篇报道为主体,对照截图、Google的Read more深层链接文档和Bing站长指南,讲清楚Bing这次测试的两种样式、点击去向和Google有什么不同、Popular links为何是广告测试,以及摘要、nosnippet、锚点和广告附加链接该怎么提前准备。
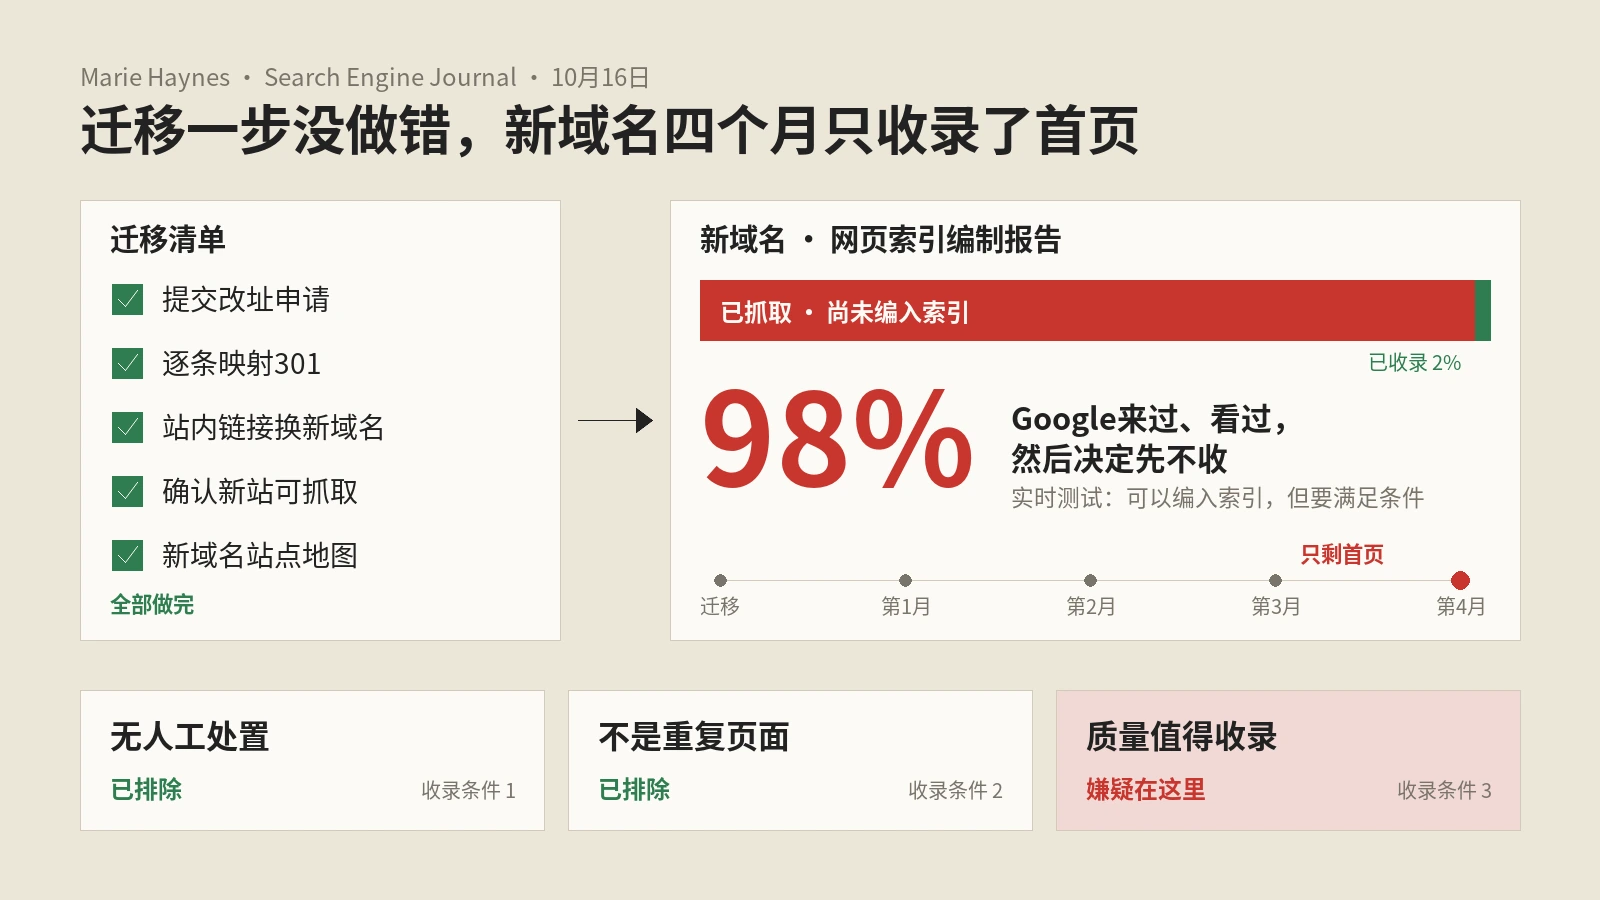
以SEJ上Marie Haynes 10月16日的文章为主体,对照Google网址检查工具、改址工具和有用内容文档原文,讲清楚新域名只收首页的案例、迁移触发质量重审的推测与疑点、先查哪些技术原因、原创性怎么理解,以及重写、等待、换域名三条路怎么选。
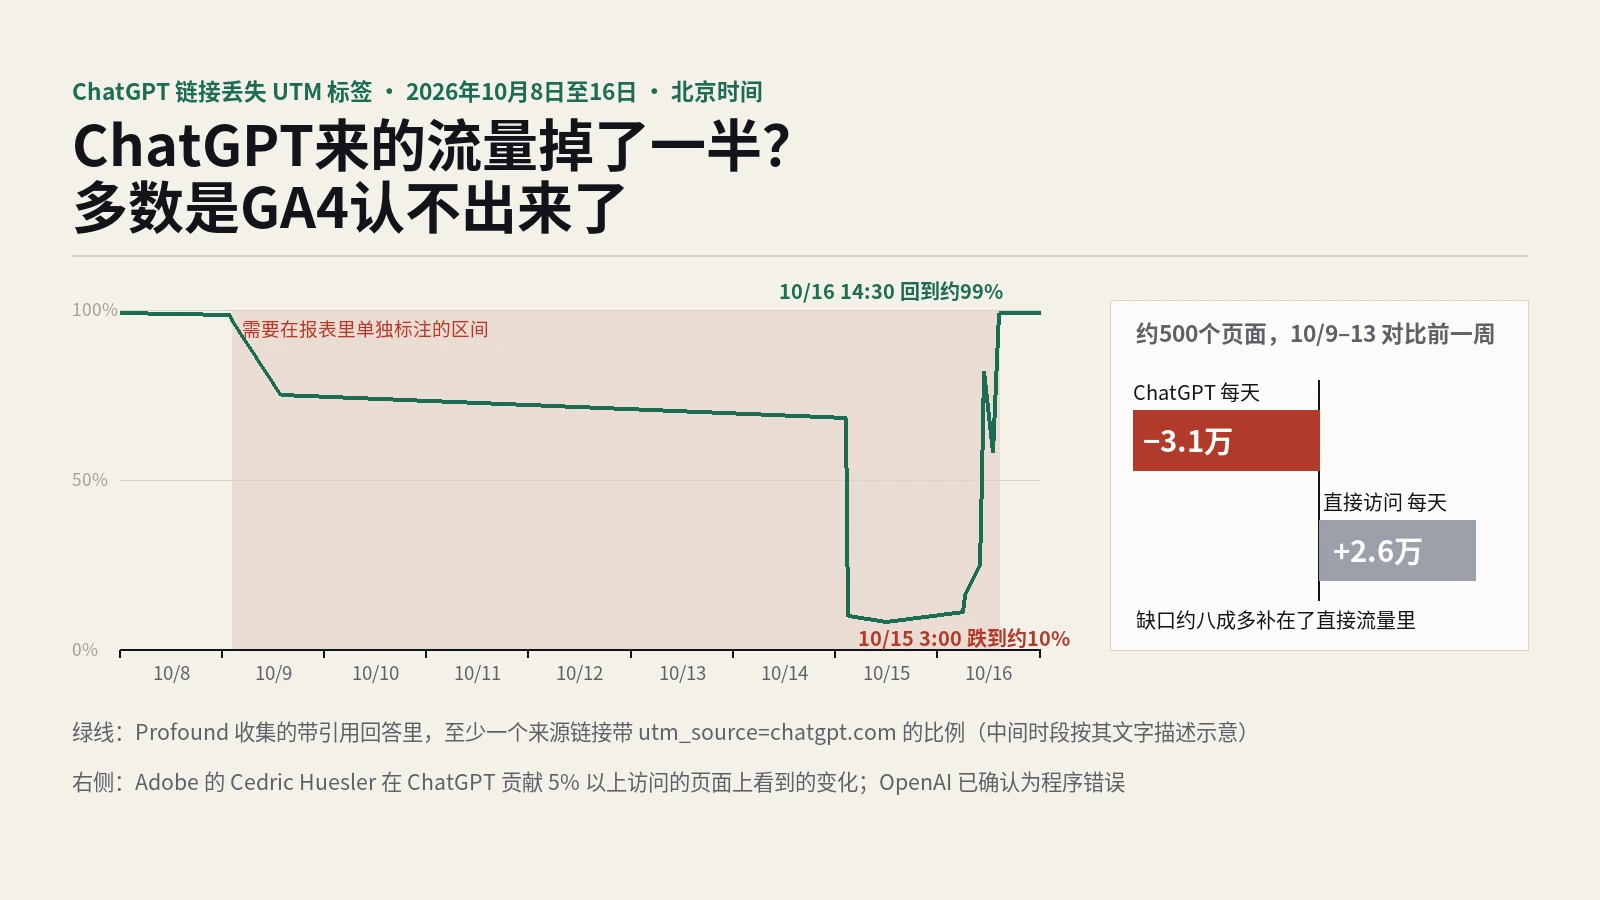
做法:把Profound、LLM Pulse、Graphite、Adobe的Cedric Huesler和Peec AI五方公开的数据放在同一张表里,标明各自测的对象和样本;把UTC与太平洋时间统一换算为北京时间排出时间线;再给出GA4探索报告里按着陆页核对直接流量的步骤。
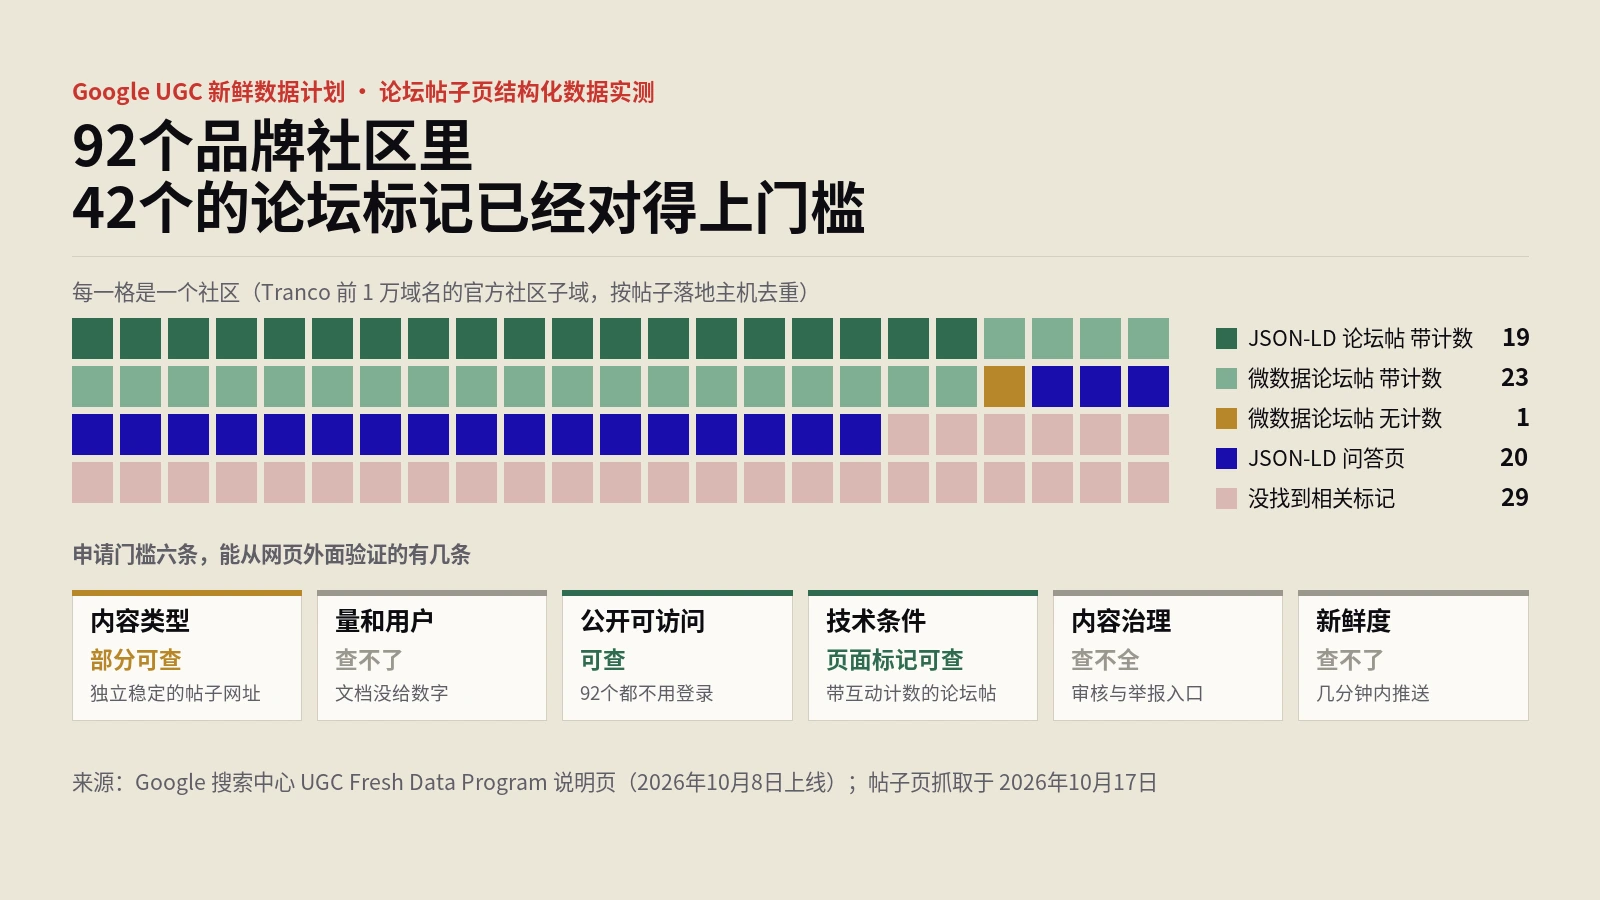
做法:逐条整理Google UGC新鲜数据计划说明页的六条资格要求;从Tranco前1万域名拼出5万个社区子域名,过滤泛解析后取回799个社区首页,抽取帖子页解析JSON-LD与微数据,按帖子落地主机去重得到92个社区,逐项核对论坛帖标记、互动计数、作者主页与登录墙。
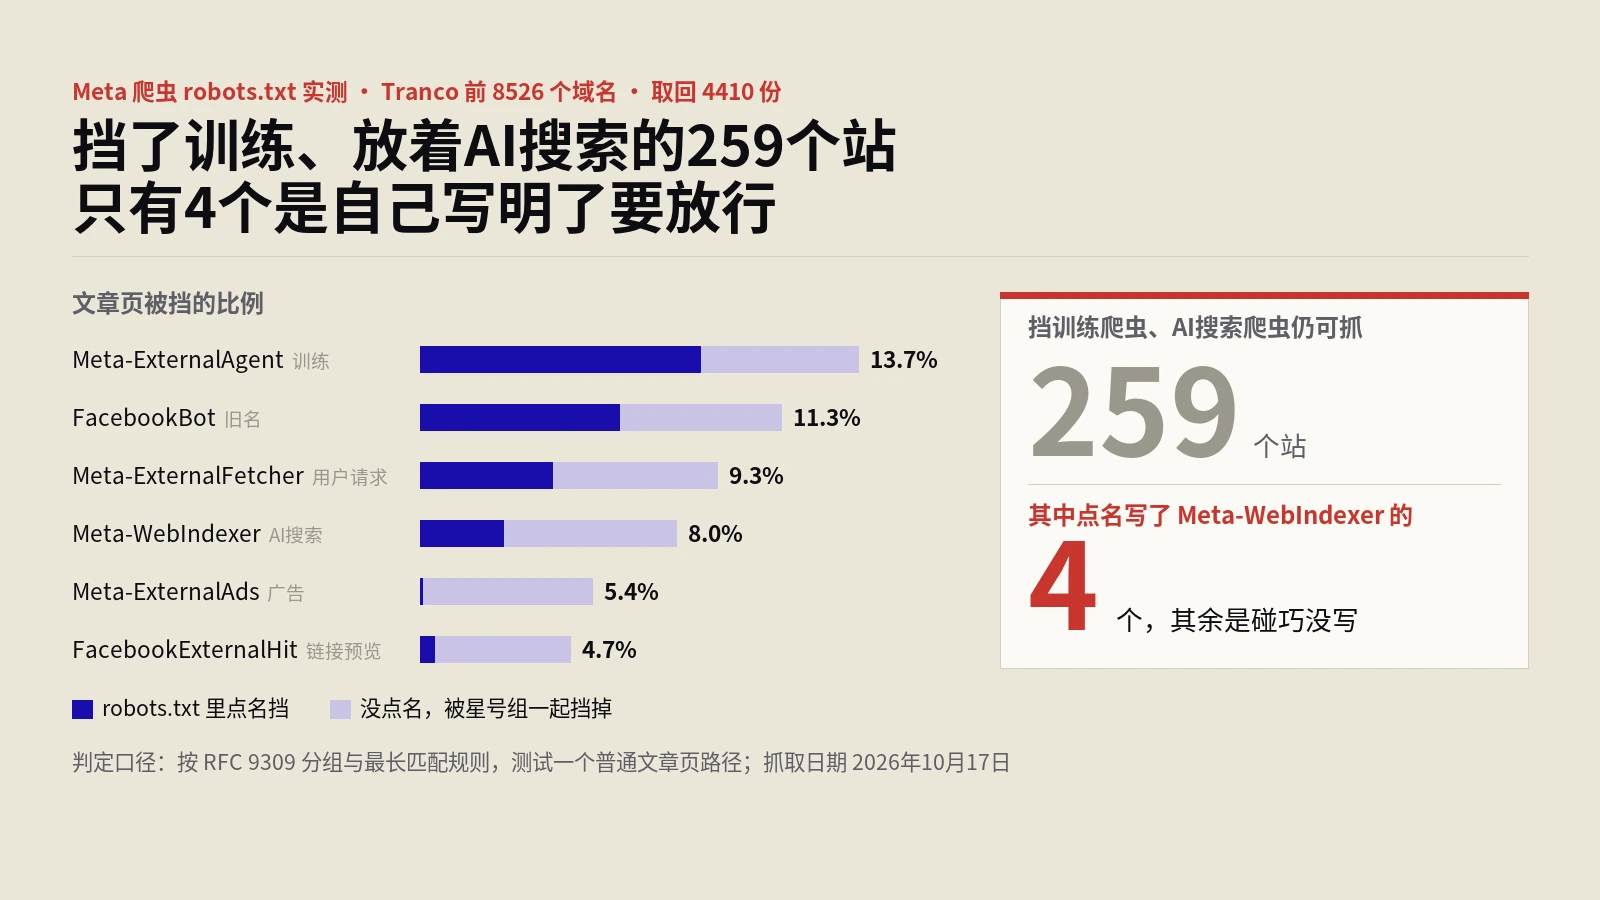
做法:在已登录账号里对照Meta商业条款现行版与10月30日预览版;按Meta爬虫文档列出五个爬虫的用途;取回Tranco前8526个域名中4410份robots.txt,按RFC 9309的分组与最长匹配规则判定每个Meta爬虫能否抓文章页,并与9月17日同站数据对比。
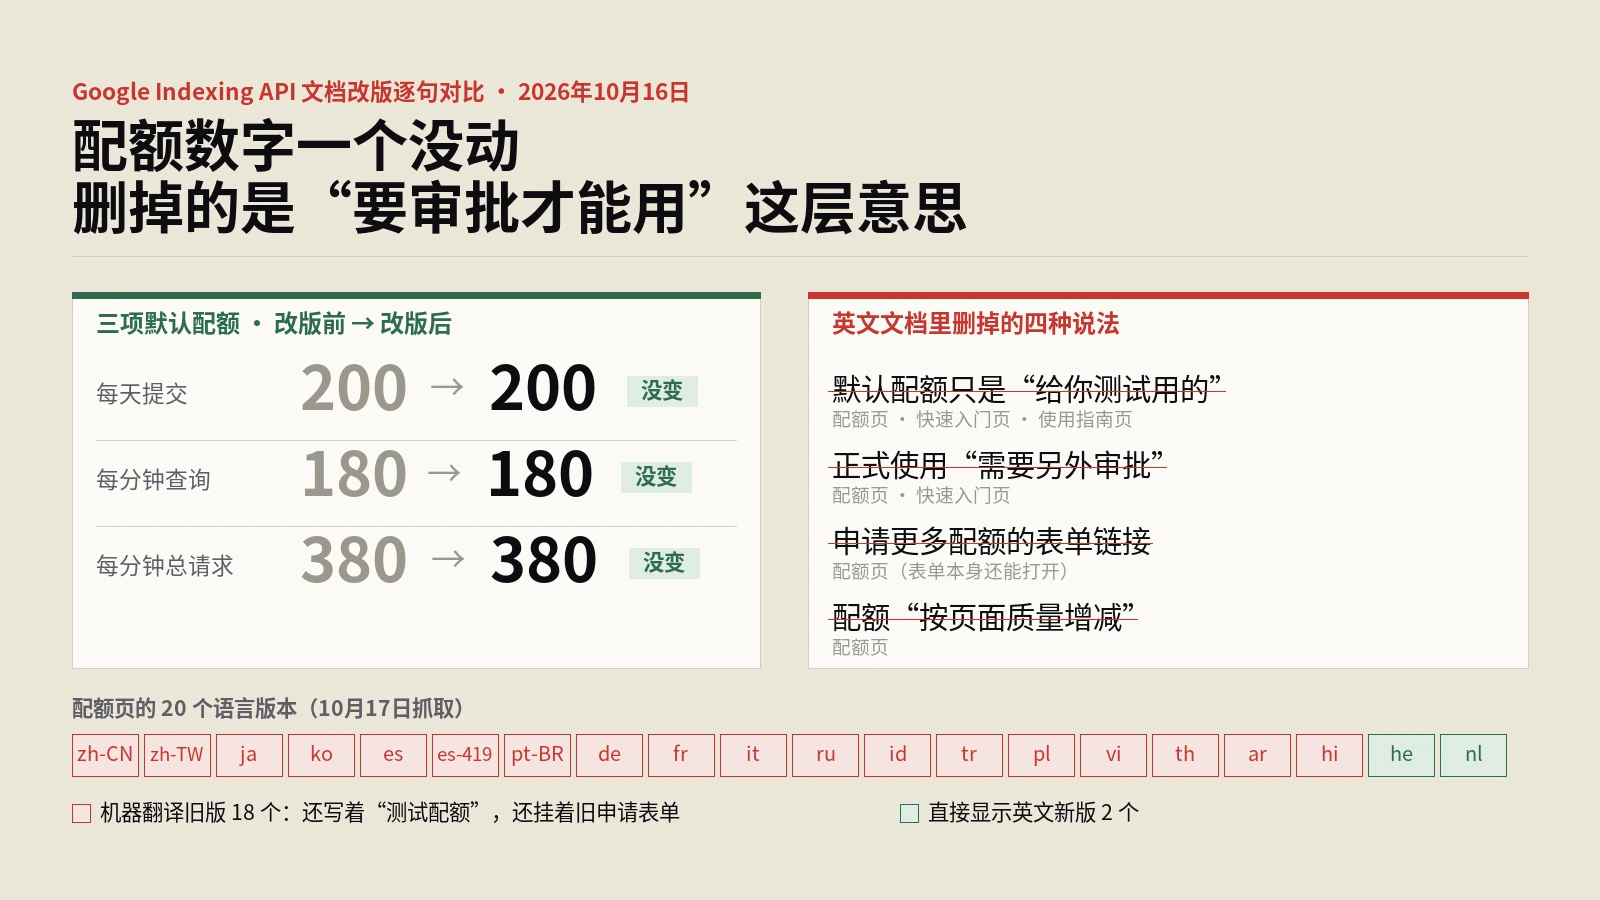
做法:从Common Crawl取回Indexing API配额页、快速入门页、使用指南页改版前的英文存档,和10月17日的现行版本逐句对比;再抓取三页的20个语言版本,统计哪些还停在旧版;最后用已登录账号只读打开旧申请表单。
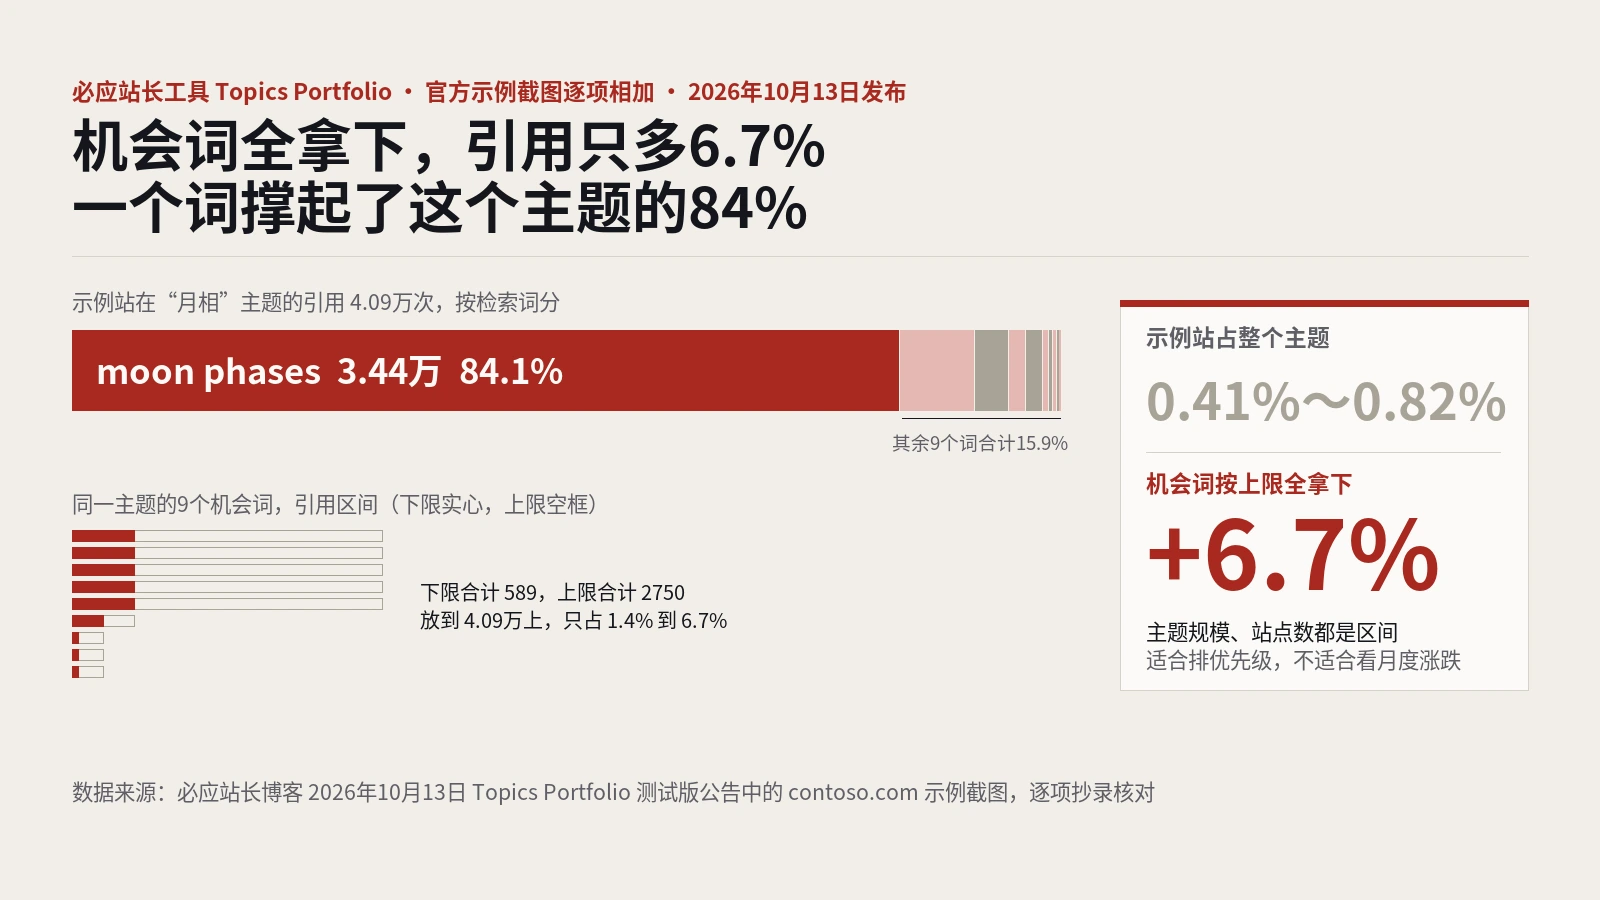
做法:逐项抄录必应官方博客公布的三张Topics Portfolio示例截图,把检索词引用数、机会词区间上下限和主题规模相加对照;再和2月、3月、6月三次更新以及AI表现帮助页的现行写法比对,整理成外贸站的使用顺序。
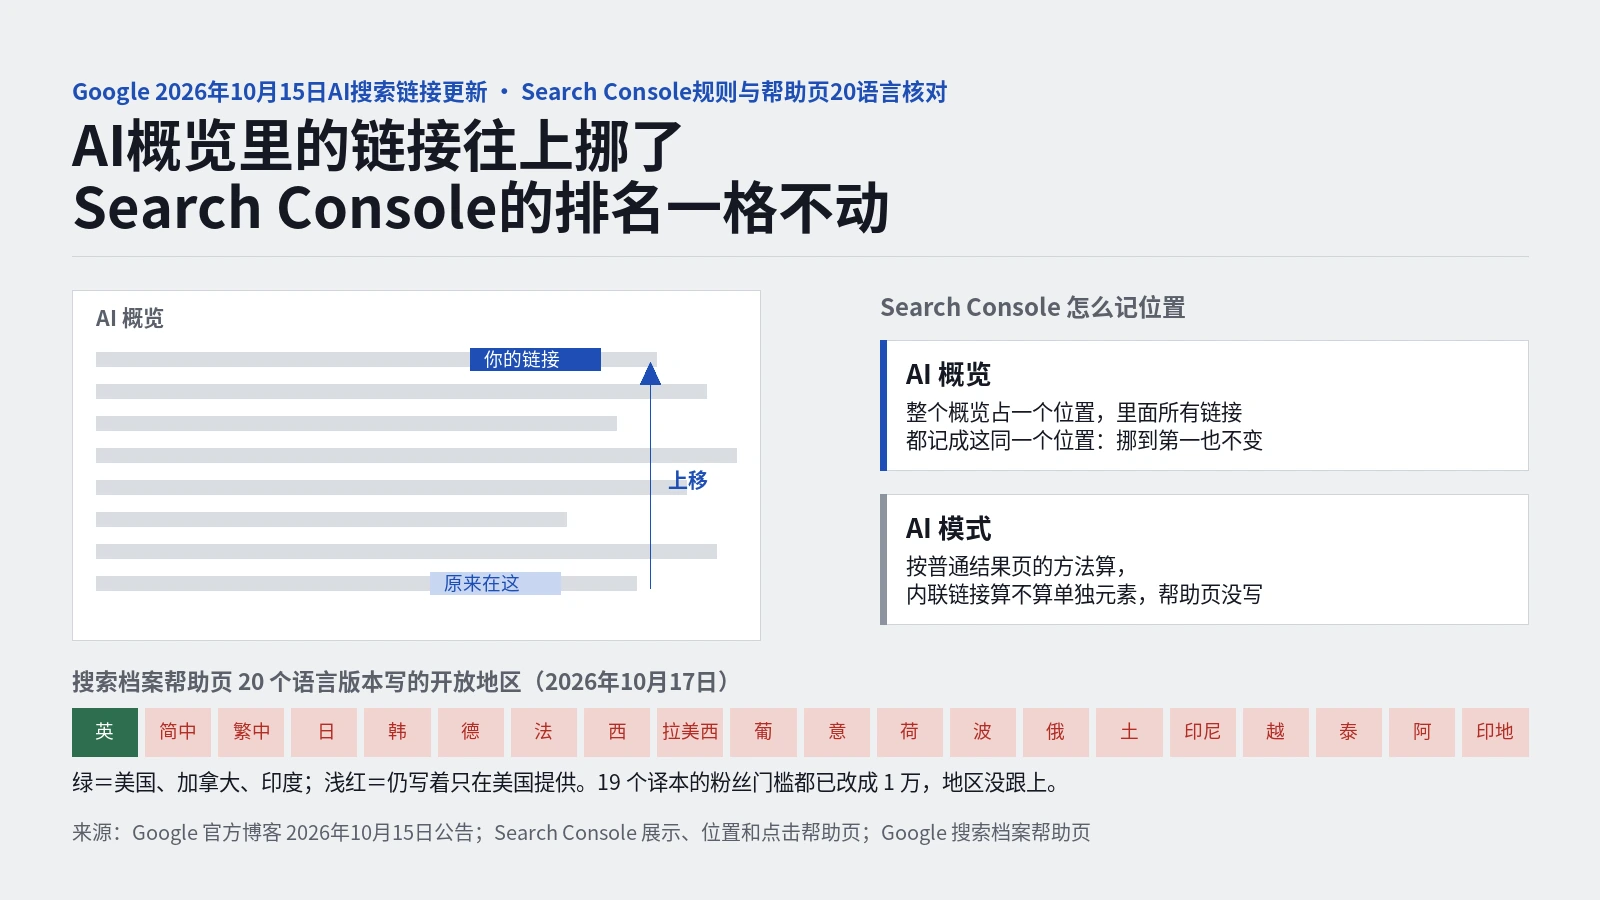
做法:逐条对照Google 10月15日公告原文,区分已上线和测试中的改动;读取Search Console位置规则、生成式AI开关与表现报告帮助页;抓取搜索档案帮助页20个语言版本,比对开放地区与粉丝门槛;再与5月6日、5月27日的同类公告对照。
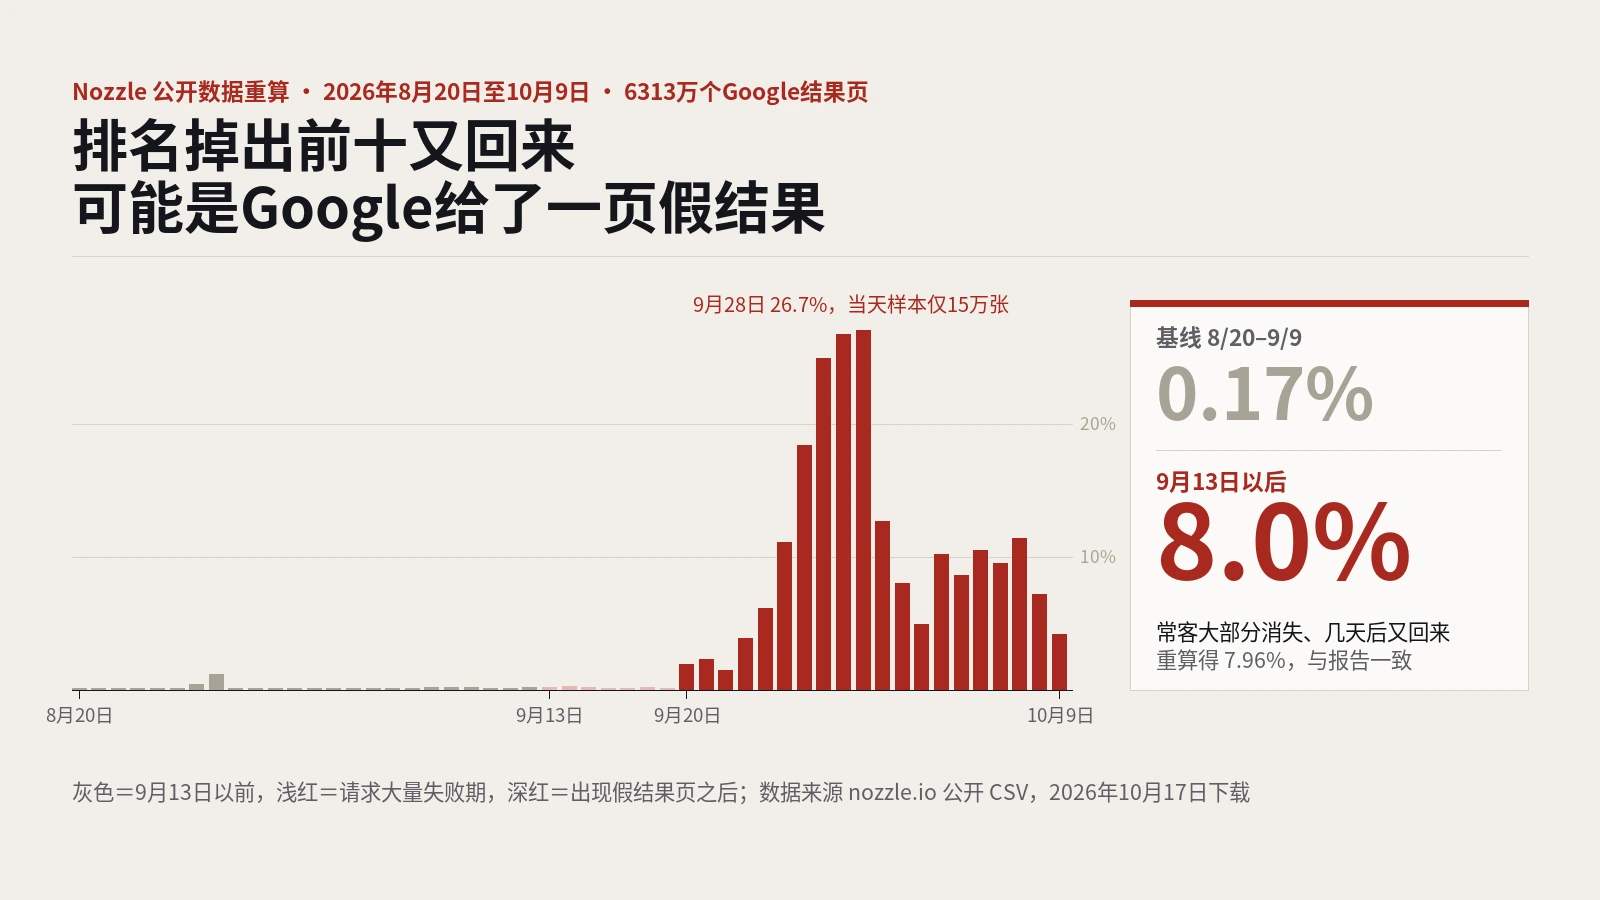
做法:下载Nozzle公开的5个原始数据文件,重算8月20日至10月9日6313万个Google结果页的投毒率;按外贸常见市场、关键词类型和行业重新排序;再与Google搜索状态面板上9月垃圾内容更新的起止时间对照。
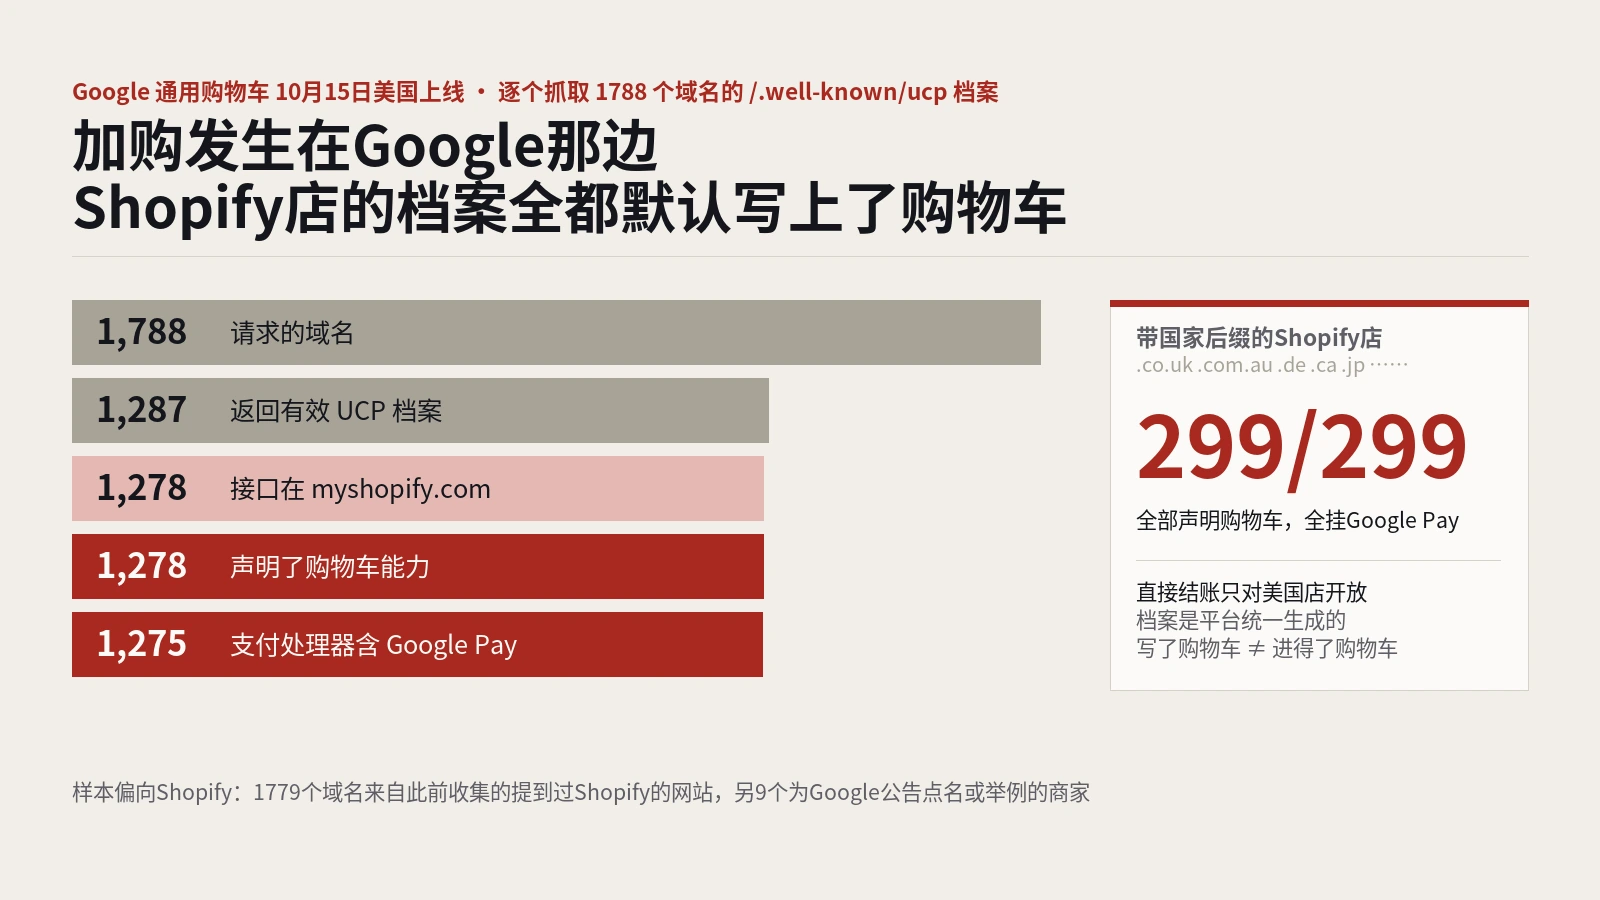
做法:对照Google 5月I/O发布文章与10月15日上线公告逐项比对功能变化;按购物车接口文档梳理商家一侧收到的请求;再抓取1788个域名的/.well-known/ucp档案,统计版本、能力、接入方式和支付处理器。
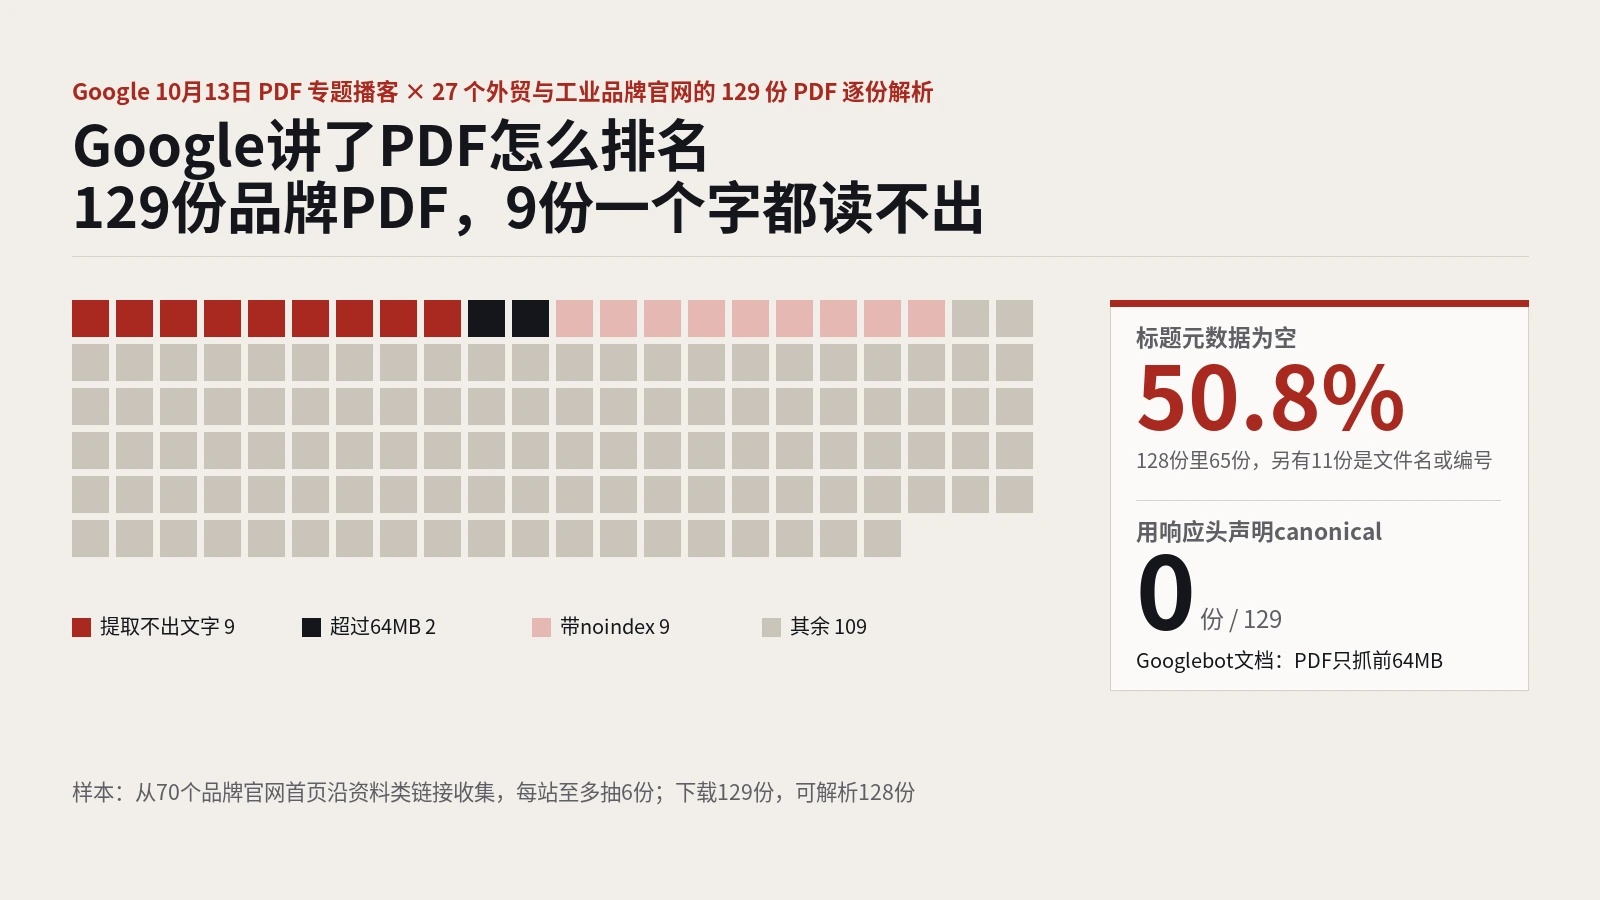
做法:把Google 10月13日PDF专题播客的说法逐条对照Googlebot文档;再从27个外贸和工业品牌官网下载129份PDF,逐份统计体积、可提取文字、标题元数据、链接、语言、标签和响应头。
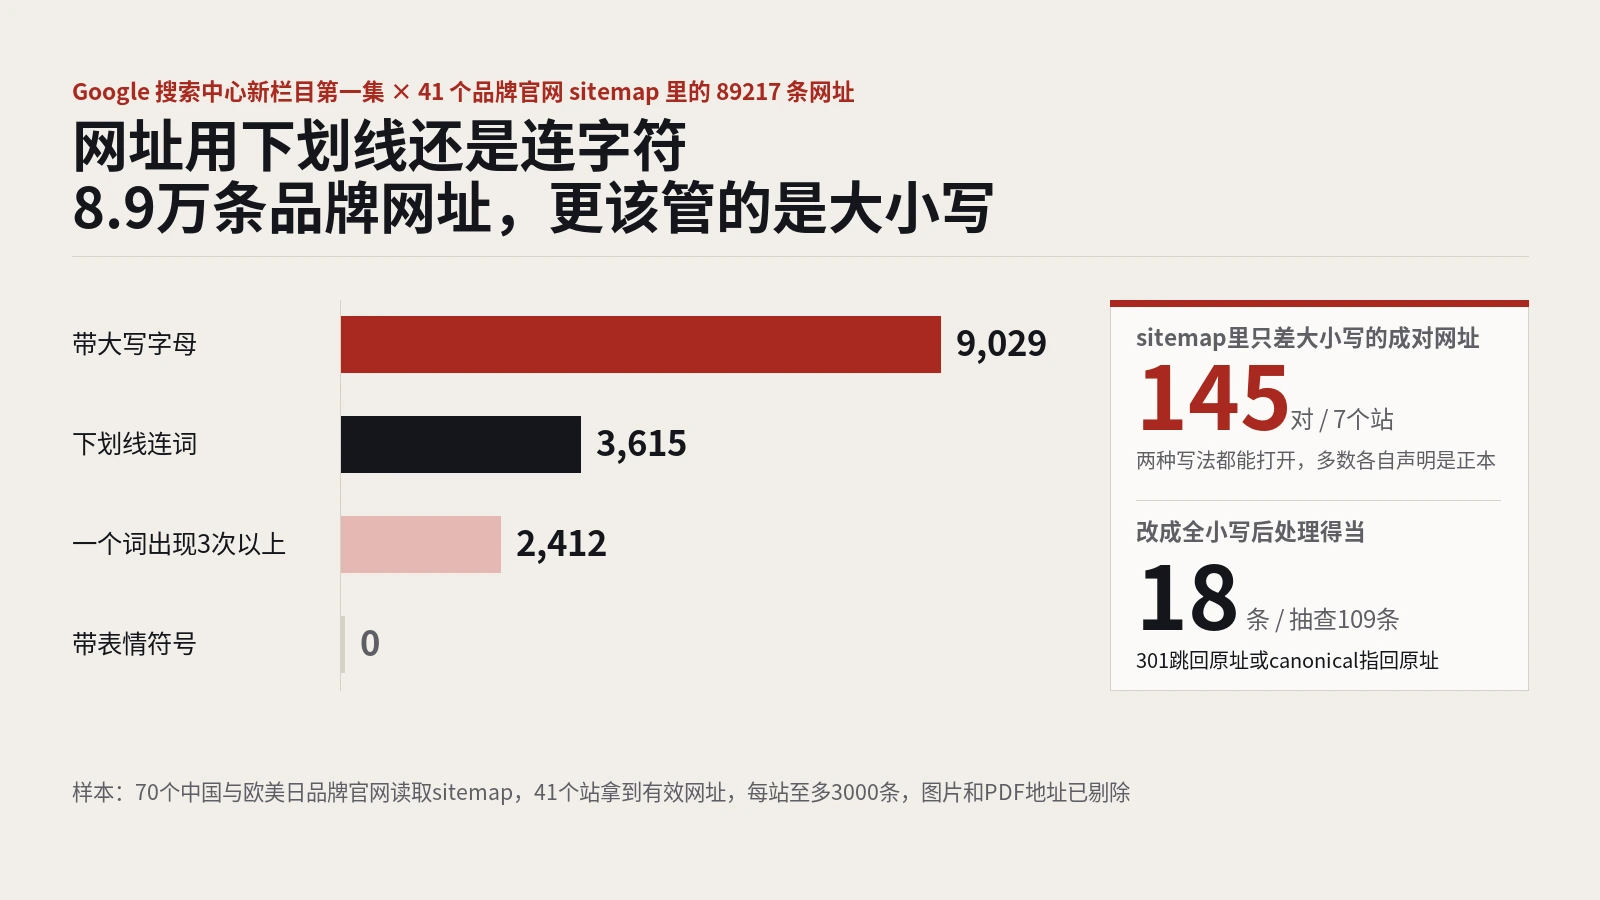
做法:把Google新视频栏目第一集关于网址的说法逐条对照网址结构文档;再读取41个品牌官网sitemap里的89217条网址,统计下划线、大小写、编码与重复词,并抽样请求大小写和分隔符变体。
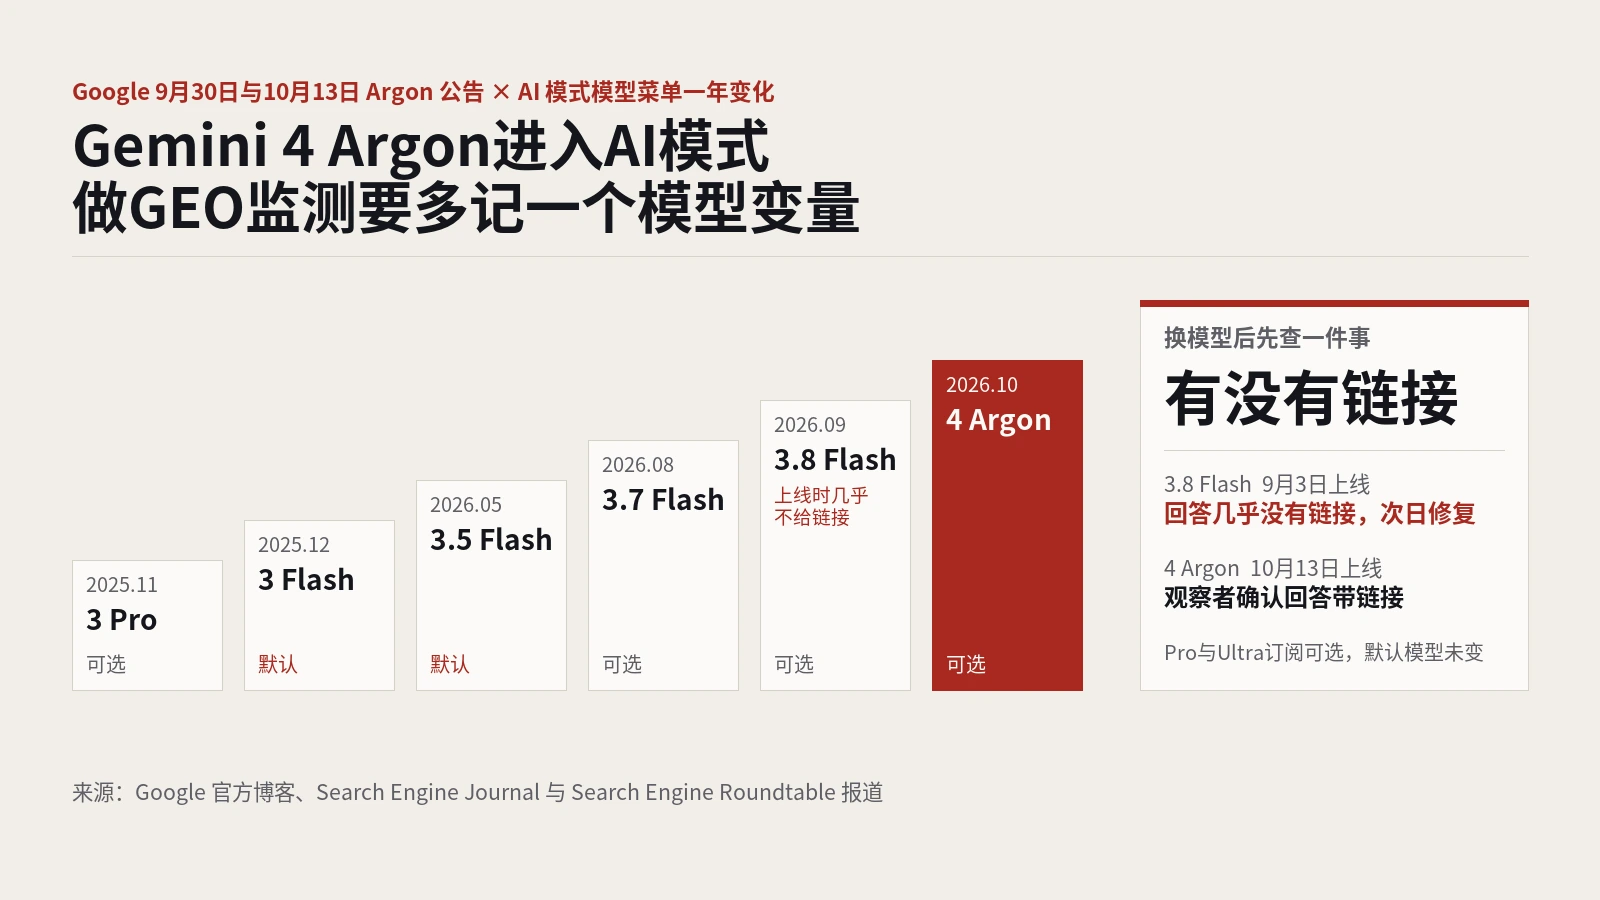
做法:以Search Engine Journal和Search Engine Roundtable的报道为线索,对照Google在9月30日与10月13日的两篇官方公告,梳理AI模式模型菜单的变化、3.8 Flash不给链接的故障经过和对可见度监测的影响。