让大模型记住品牌没那么简单:背得出原文,换个问法就答不上来
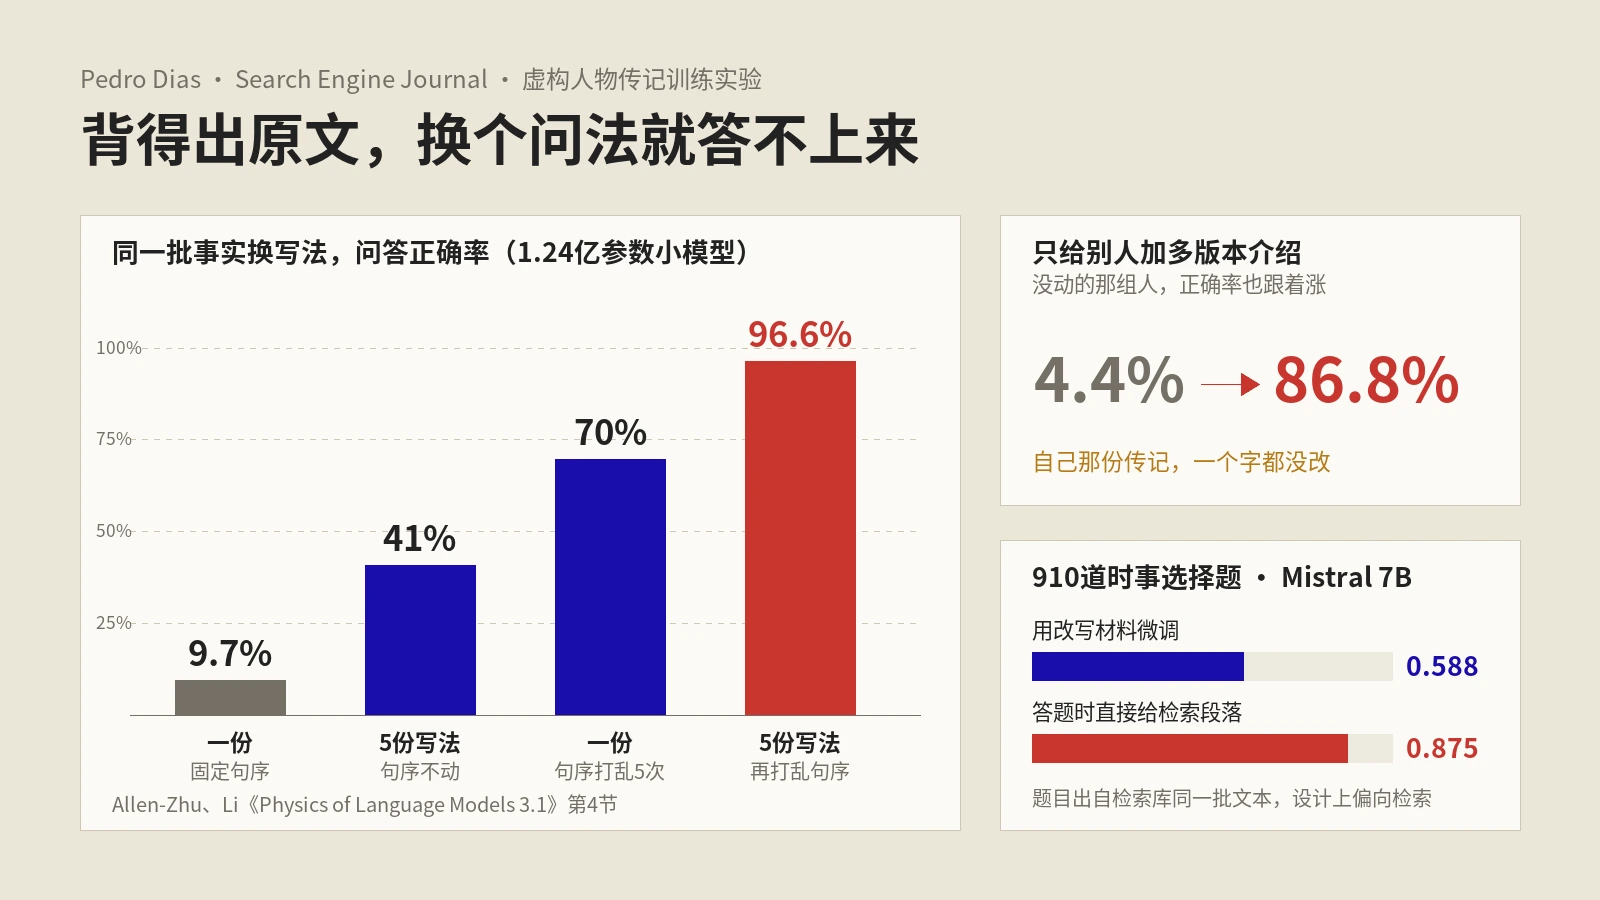
以Pedro Dias在SEJ的文章为主体,逐篇核对他引用的传记训练实验、重复与逐字记忆、微调对比检索、来源偏好四组论文,讲清楚背诵和问答的差别、改写与重复各自管什么、模型换代为何会让品牌召回无故变好,以及外贸站怎样分开测认出、答对、推荐三个指标。
标签
保哥笔记 GEO 标签下共 50 篇文章合集,含《Google与Bing GEO最新动态:5要点解读与》《AI只引用内容不推荐品牌的5大GEO破解法》《多语言AI可见性怎么做?翻译内容为什么在AI检索里吃》等,与 AI搜索、AI搜索优化、GEO优化 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
以Pedro Dias在SEJ的文章为主体,逐篇核对他引用的传记训练实验、重复与逐字记忆、微调对比检索、来源偏好四组论文,讲清楚背诵和问答的差别、改写与重复各自管什么、模型换代为何会让品牌召回无故变好,以及外贸站怎样分开测认出、答对、推荐三个指标。
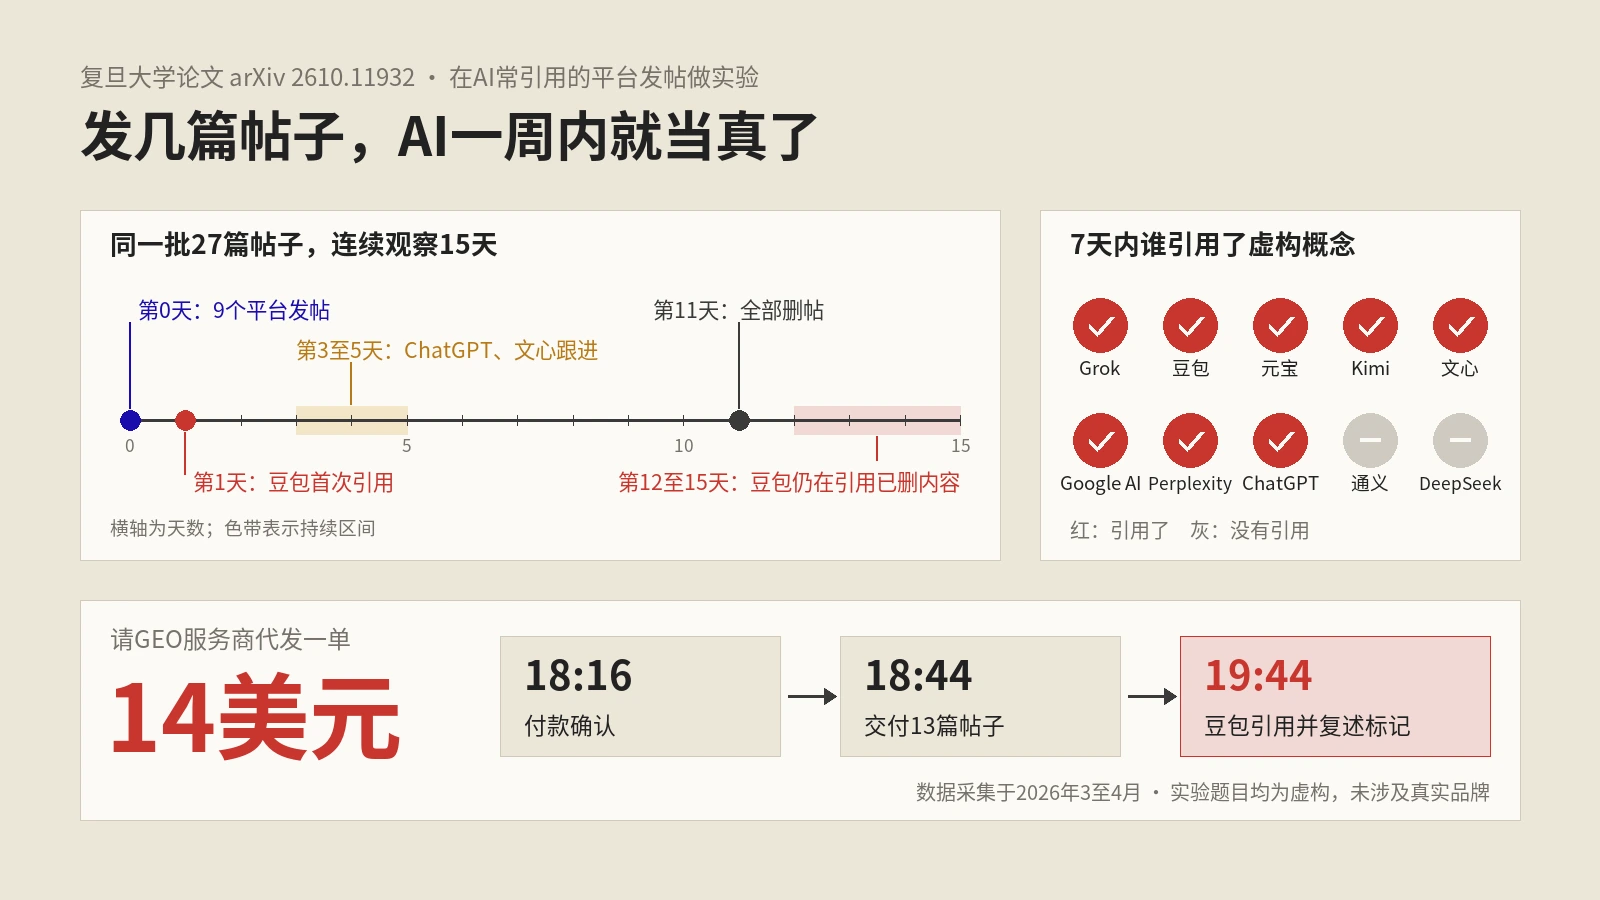
以SEJ 10月19日报道为主体,对照复旦论文原文,讲清楚研究者怎样挑出AI最常引用又最好发帖的平台,在9个平台发帖后10个AI平台的引用与复述比例,豆包文心等中文平台偏爱自家来源,发帖位置、数量和删帖对引用的影响,14美元GEO代发的时间线,以及品牌方的监测与防范做法。
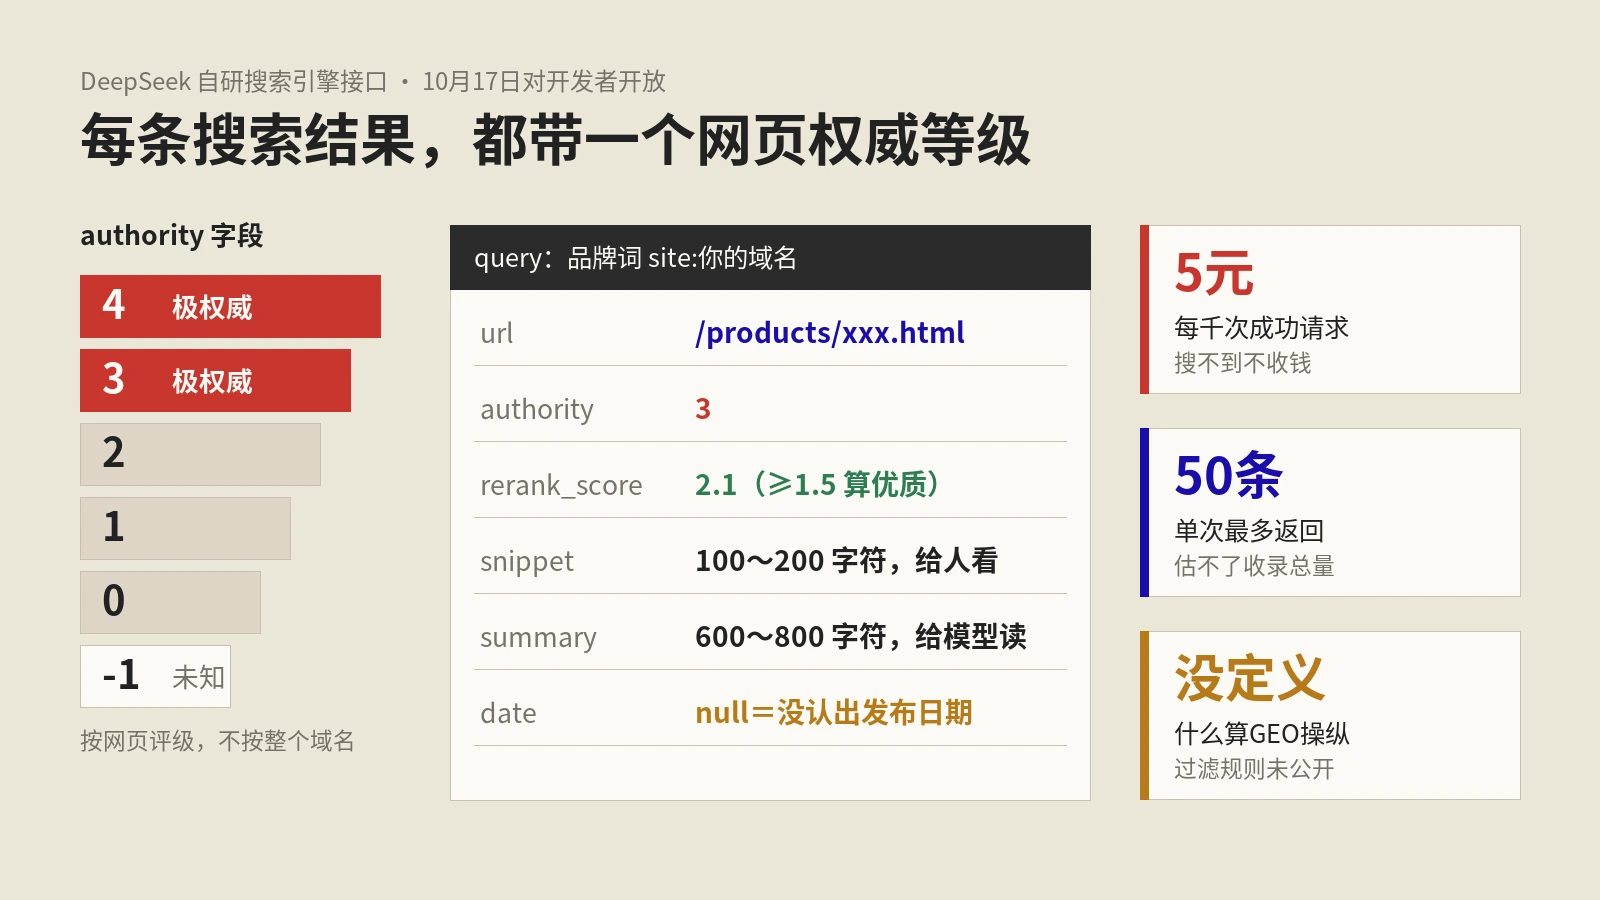
以SEJ 10月19日报道为主体,对照DeepSeek中文接口文档、更新日志、发布公告和DEJAN的整理,讲清Search与Fetch接口的字段、价格和限速,authority与rerank_score怎么读,过滤GEO操纵的声明能确认什么,博查与隐私政策的疑点,DeepSeekBot该不该挡,以及用site:自查的脚本和步骤。
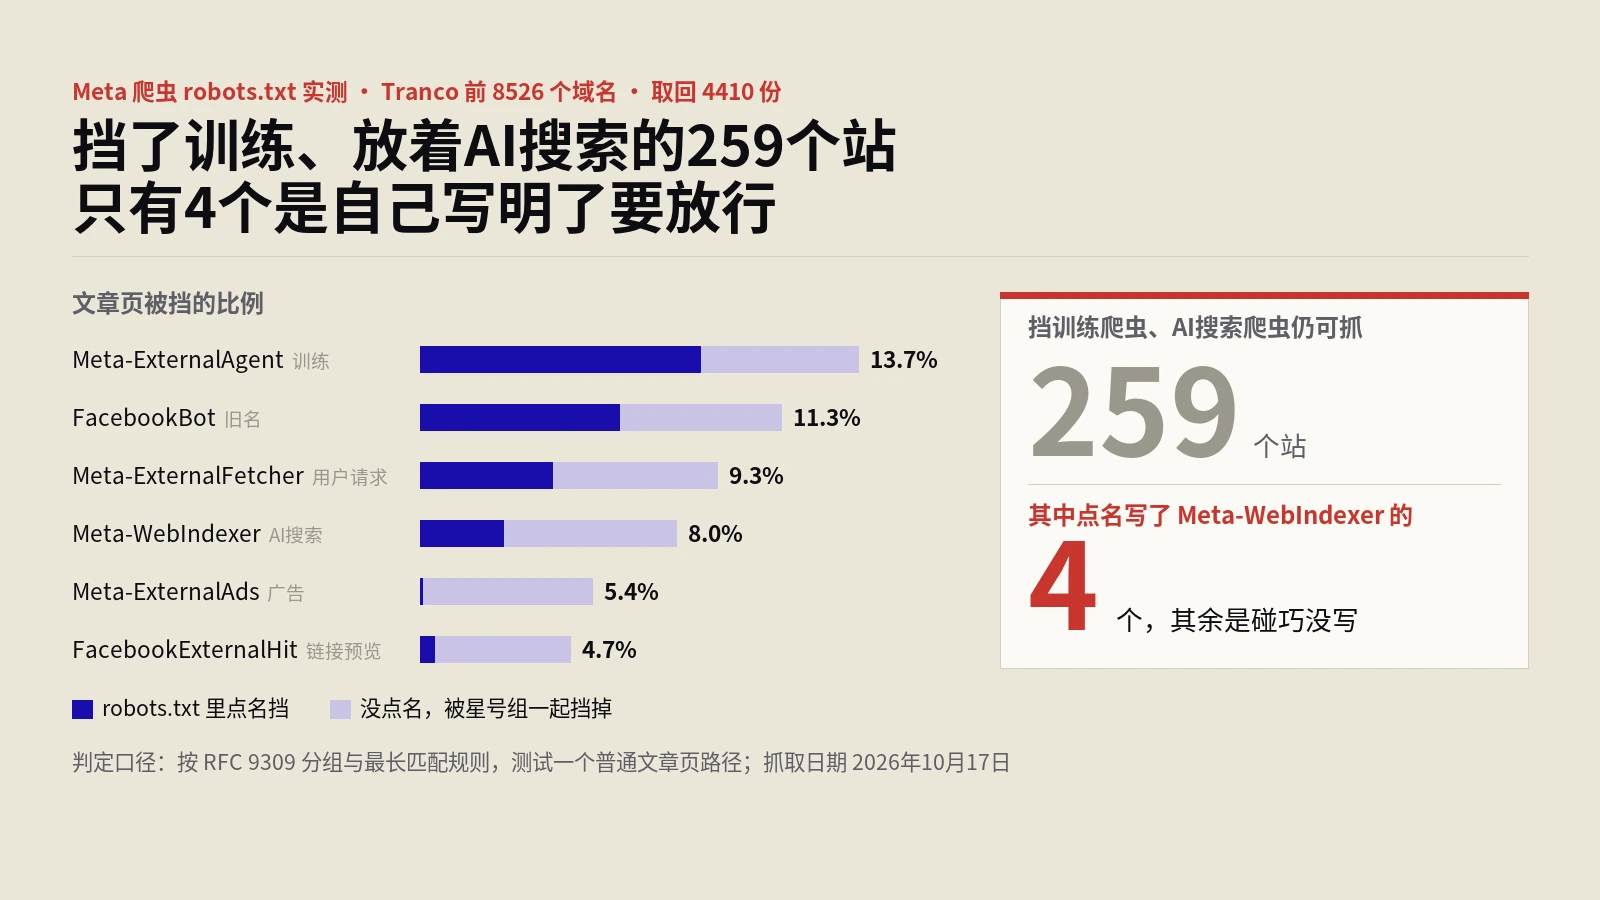
做法:在已登录账号里对照Meta商业条款现行版与10月30日预览版;按Meta爬虫文档列出五个爬虫的用途;取回Tranco前8526个域名中4410份robots.txt,按RFC 9309的分组与最长匹配规则判定每个Meta爬虫能否抓文章页,并与9月17日同站数据对比。
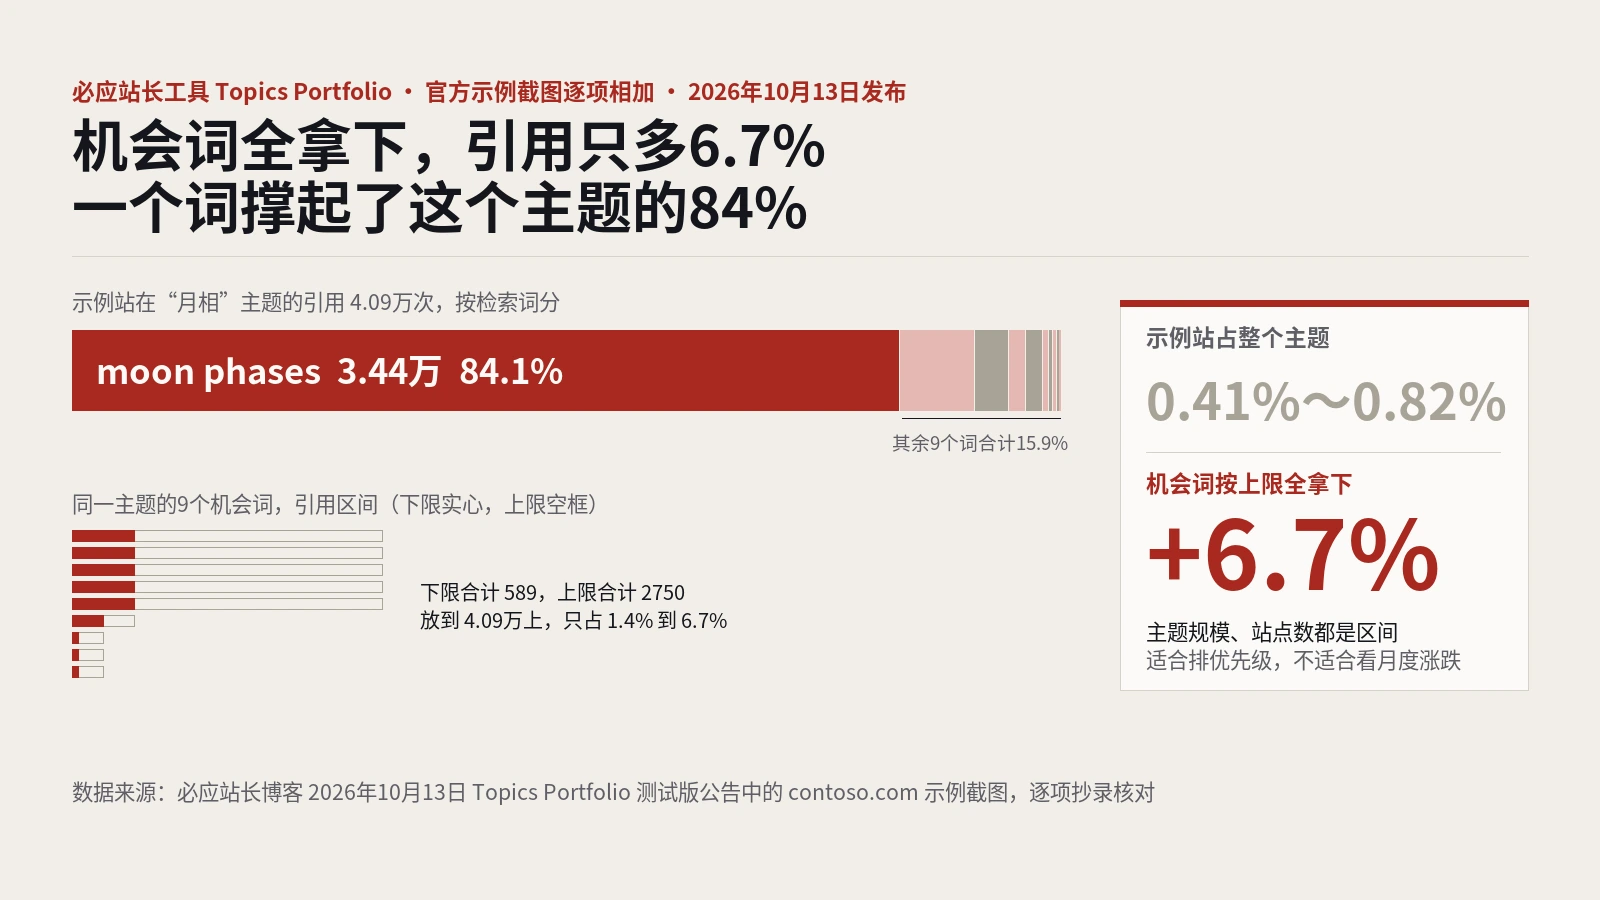
做法:逐项抄录必应官方博客公布的三张Topics Portfolio示例截图,把检索词引用数、机会词区间上下限和主题规模相加对照;再和2月、3月、6月三次更新以及AI表现帮助页的现行写法比对,整理成外贸站的使用顺序。
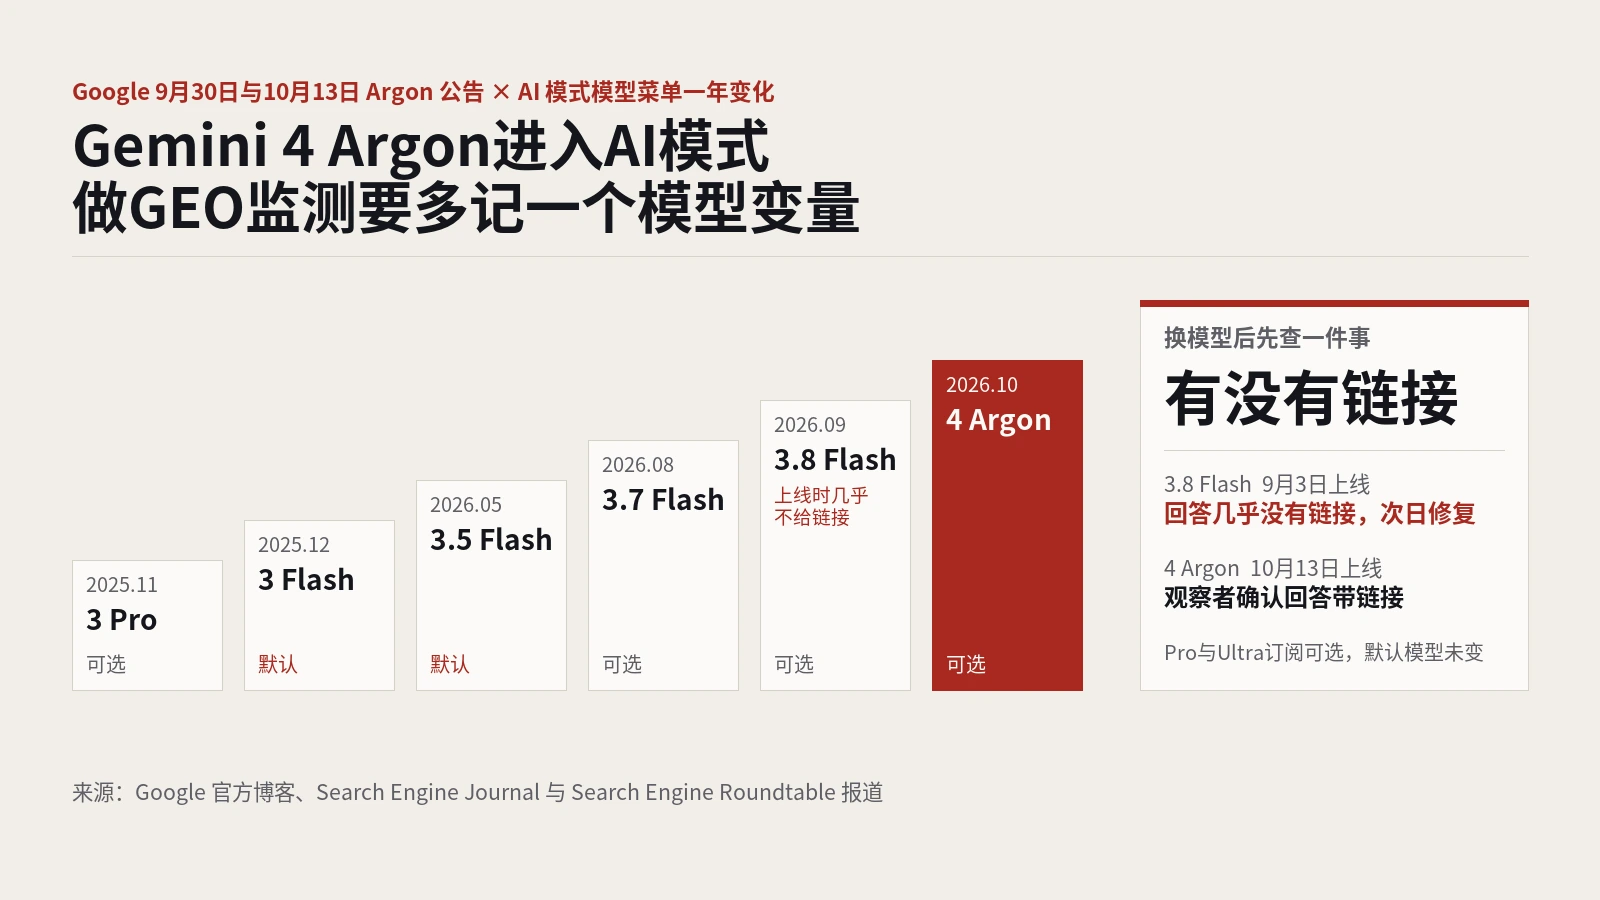
做法:以Search Engine Journal和Search Engine Roundtable的报道为线索,对照Google在9月30日与10月13日的两篇官方公告,梳理AI模式模型菜单的变化、3.8 Flash不给链接的故障经过和对可见度监测的影响。
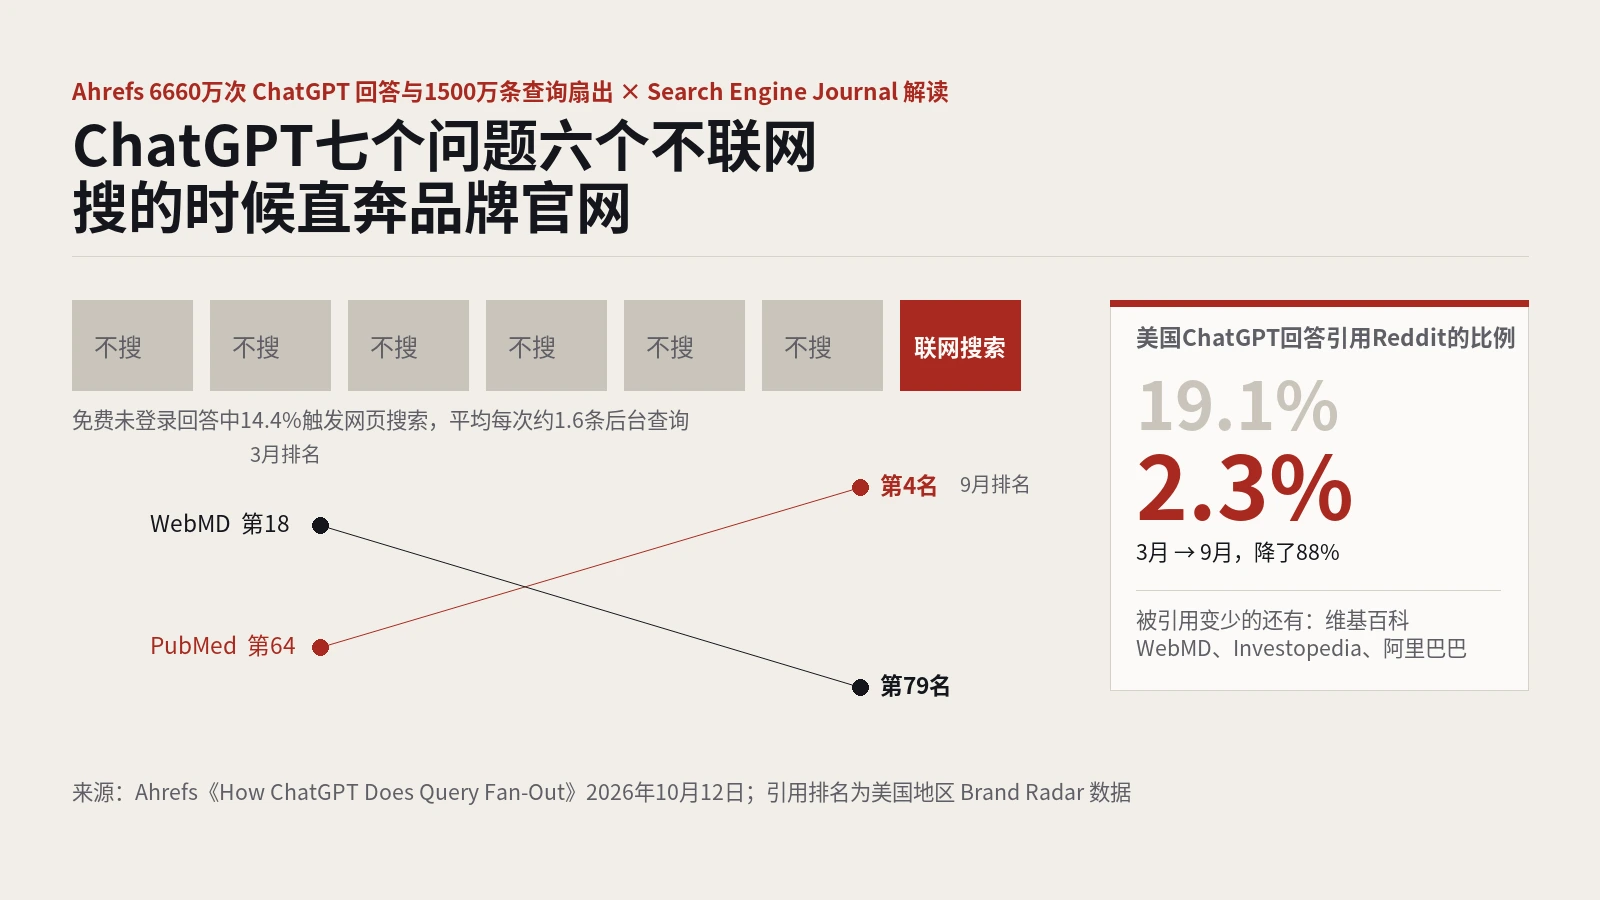
做法:以Ahrefs在10月12日发布的查询扇出研究为主体,结合Search Engine Journal的解读、Nectiv的同类研究和OpenAI帮助页,梳理搜索比例、site:搜索去向、扇出用词变化和引用排名的涨跌。
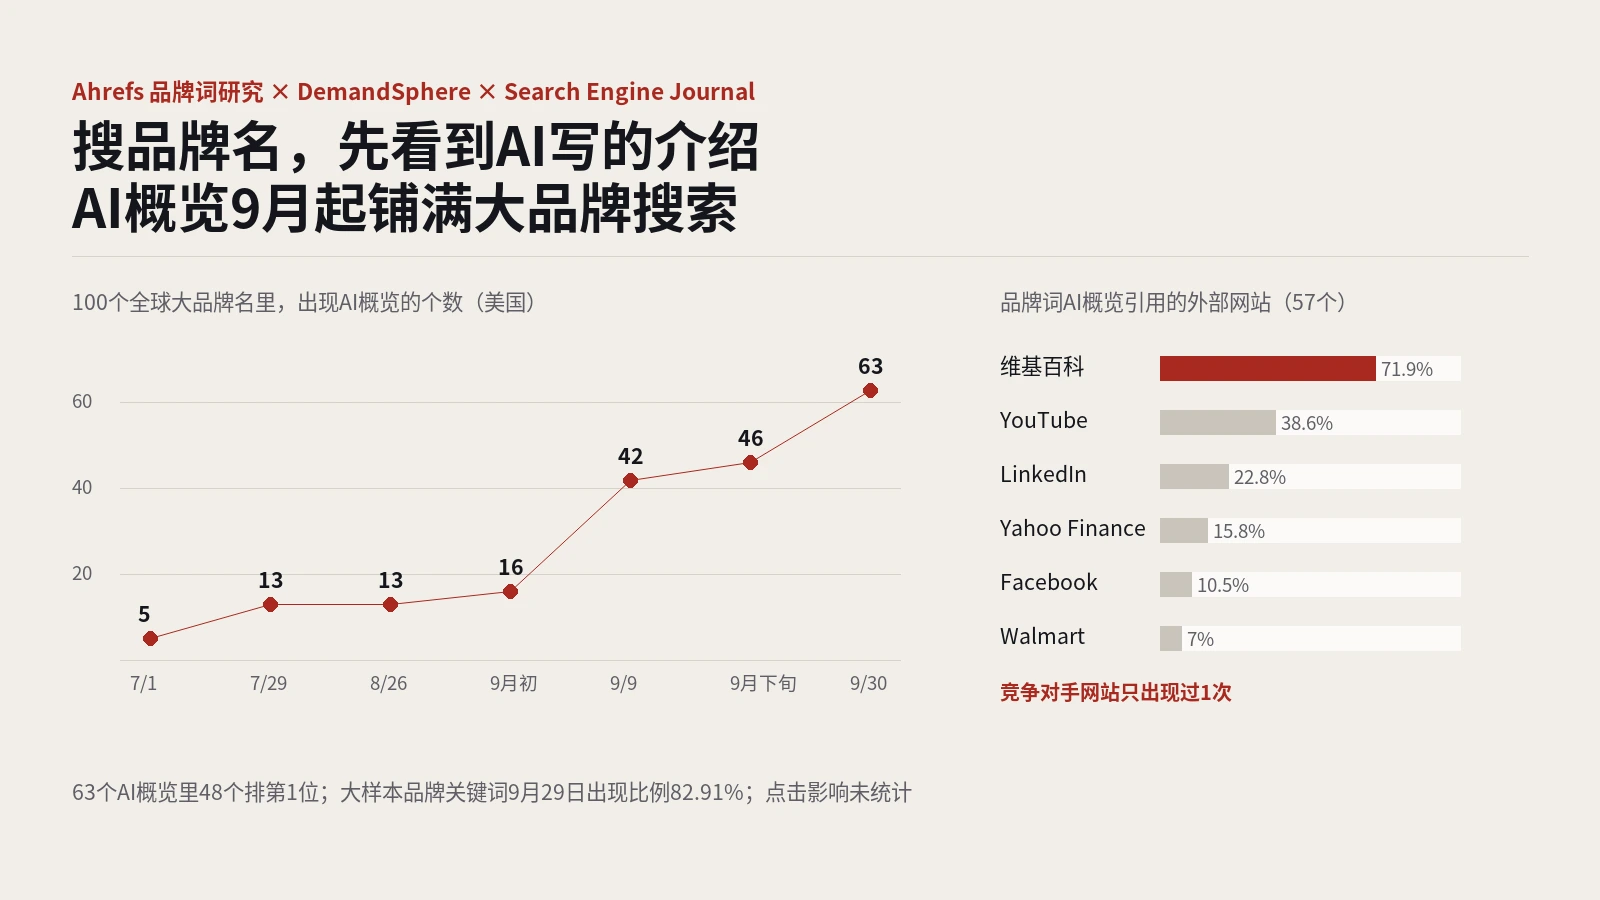
做法:以Ahrefs 10月2日的品牌词AI概览研究为主体,对照Search Engine Journal对Ahrefs、DemandSphere与Chris Long三方数据的样本核对,整理出现比例、每周变化、位置分布、引用来源和数据空白。
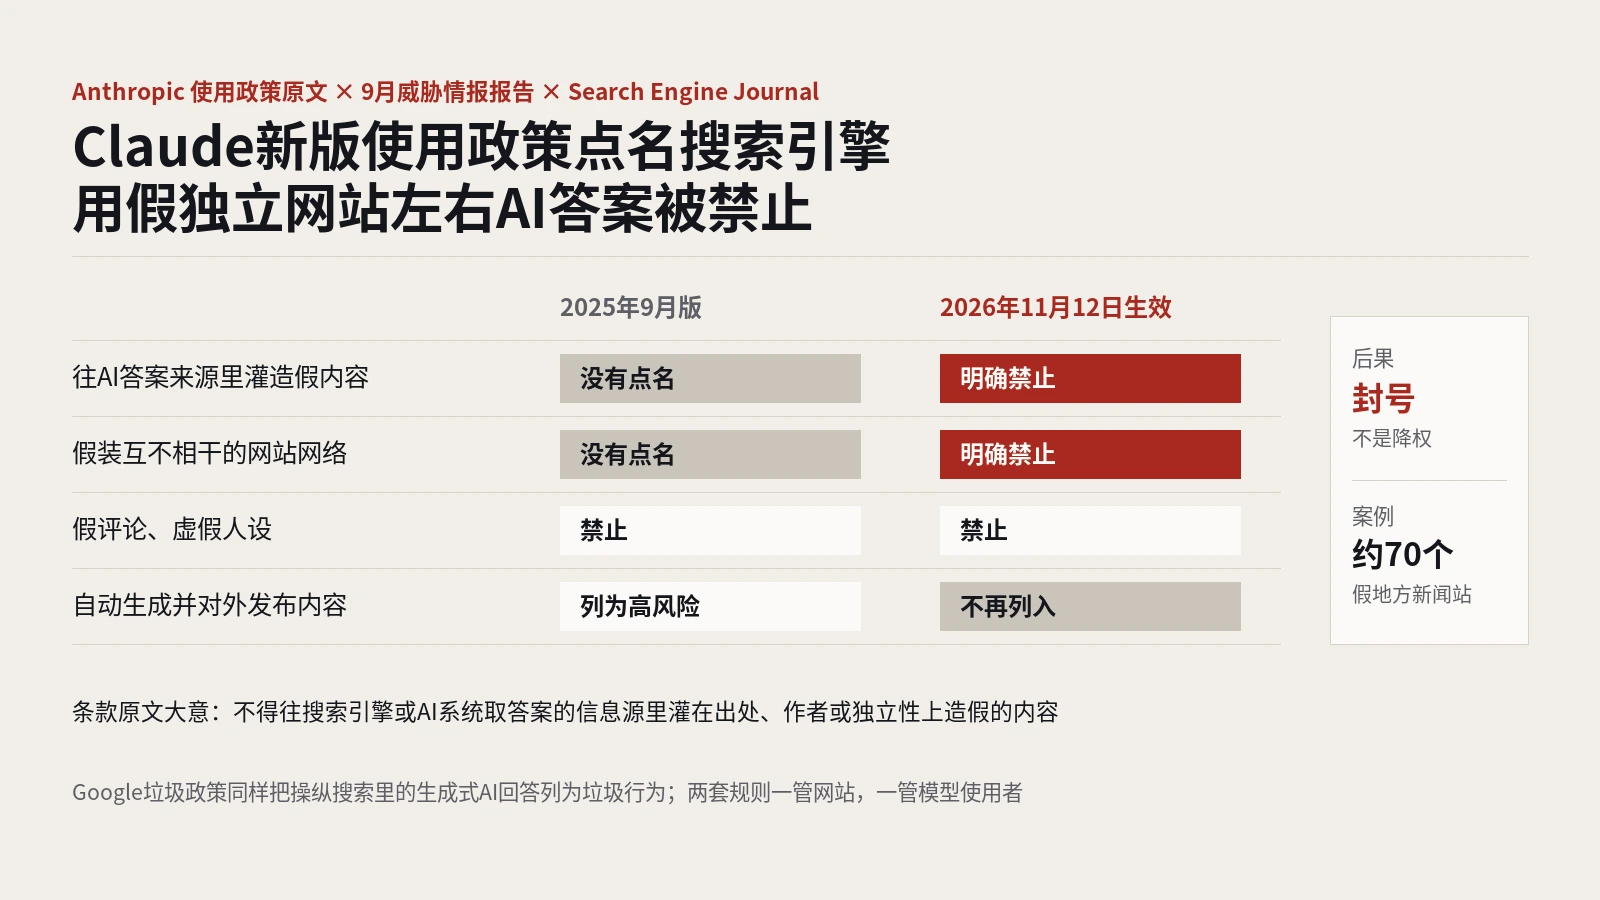
做法:以Anthropic新版使用政策原文和官方更新说明为主体,对照Search Engine Journal的新旧版本比较与Anthropic 9月威胁情报报告中的LKM Company案例,并和Google垃圾政策里关于生成式AI回答的规定并排对照。
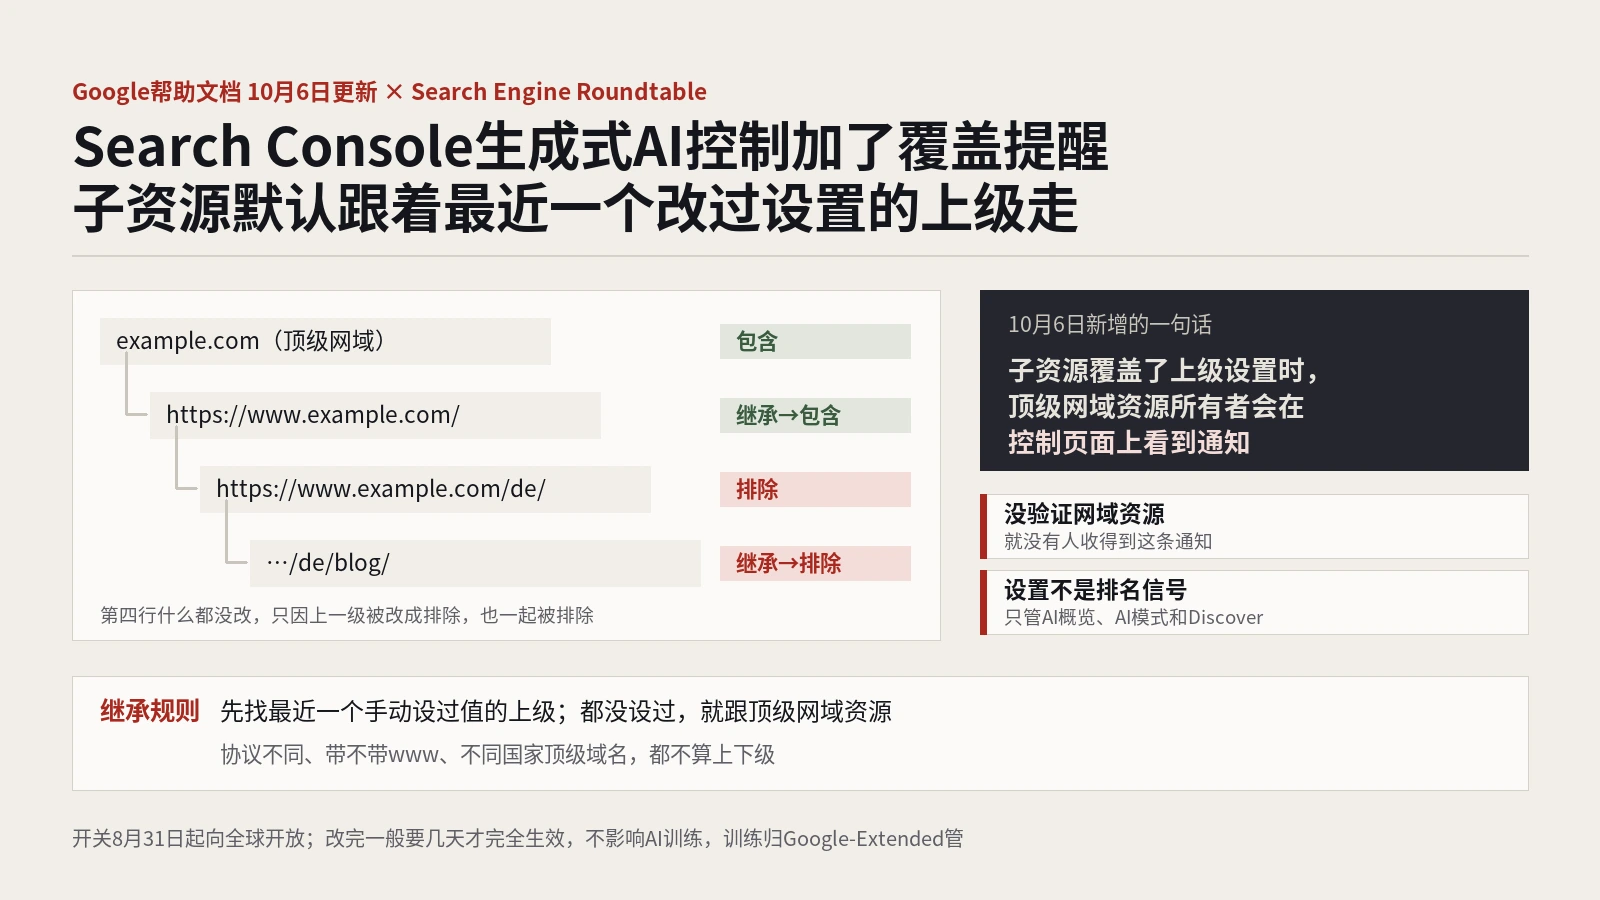
做法:以Search Engine Roundtable对10月6日帮助文档更新的报道为主体,对照Google的生成式AI控制帮助文档、权限说明和官方博客,整理开关上线时间线、三个选项的效果、父子资源继承规则与例子、新通知照顾不到的情况,以及企业管理开关的记录表和自查顺序。
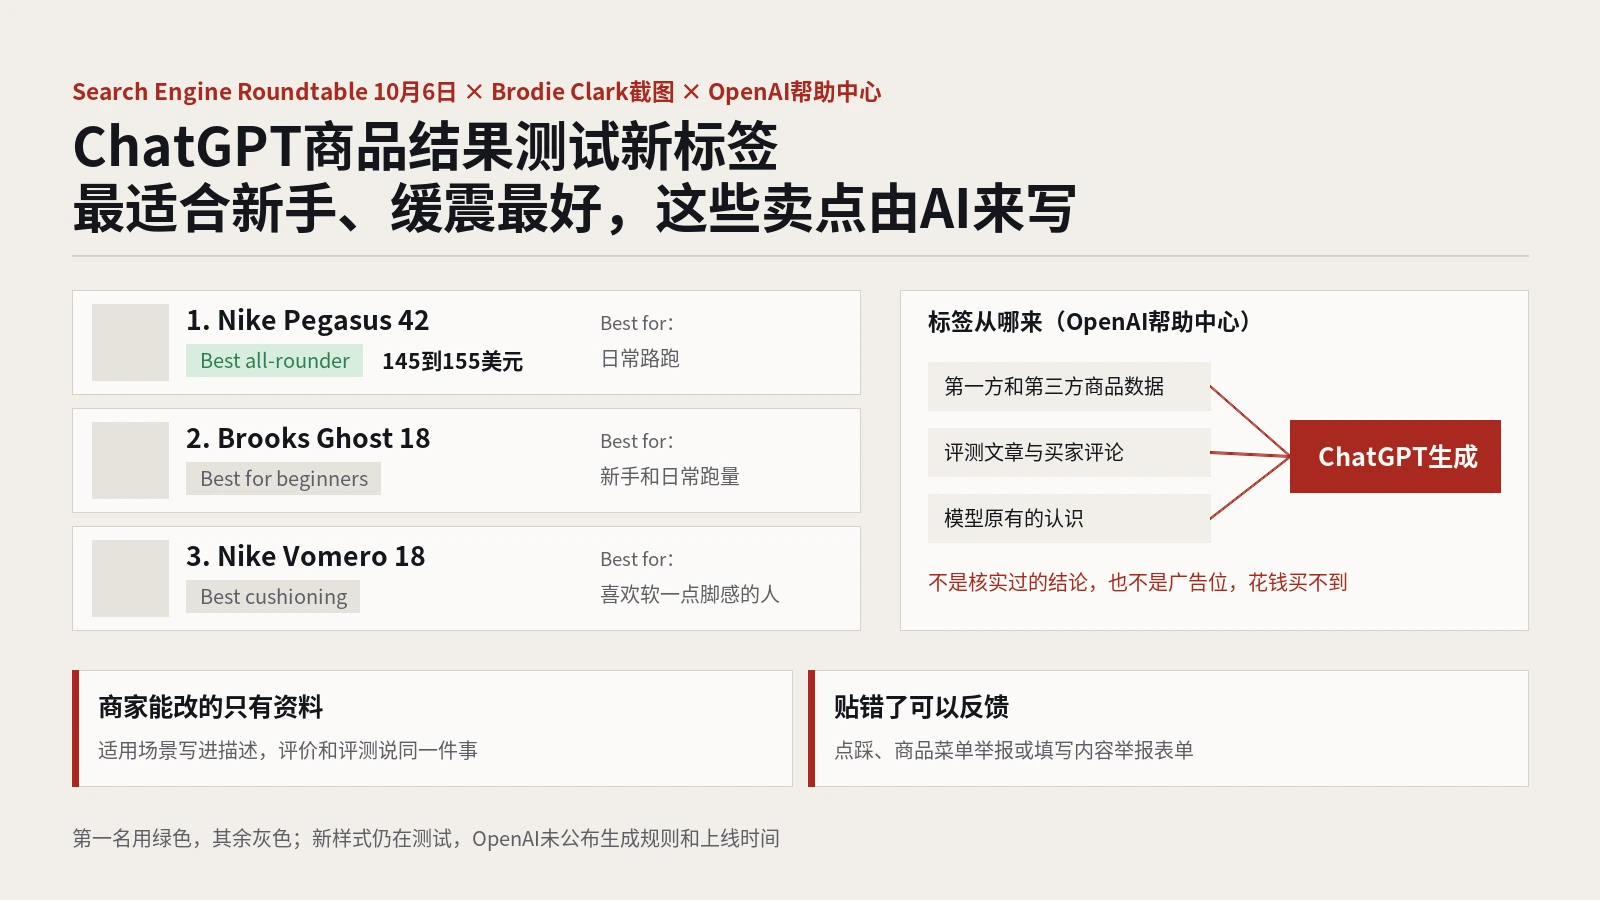
做法:以Search Engine Roundtable的报道和Brodie Clark的截图为主体,对照OpenAI帮助中心的购物说明和商品数据源规范,整理新旧标签的差别、标签生成和Best price规则、ChatGPT选品与商家排序依据,以及外贸独立站可以马上自查的六件事。
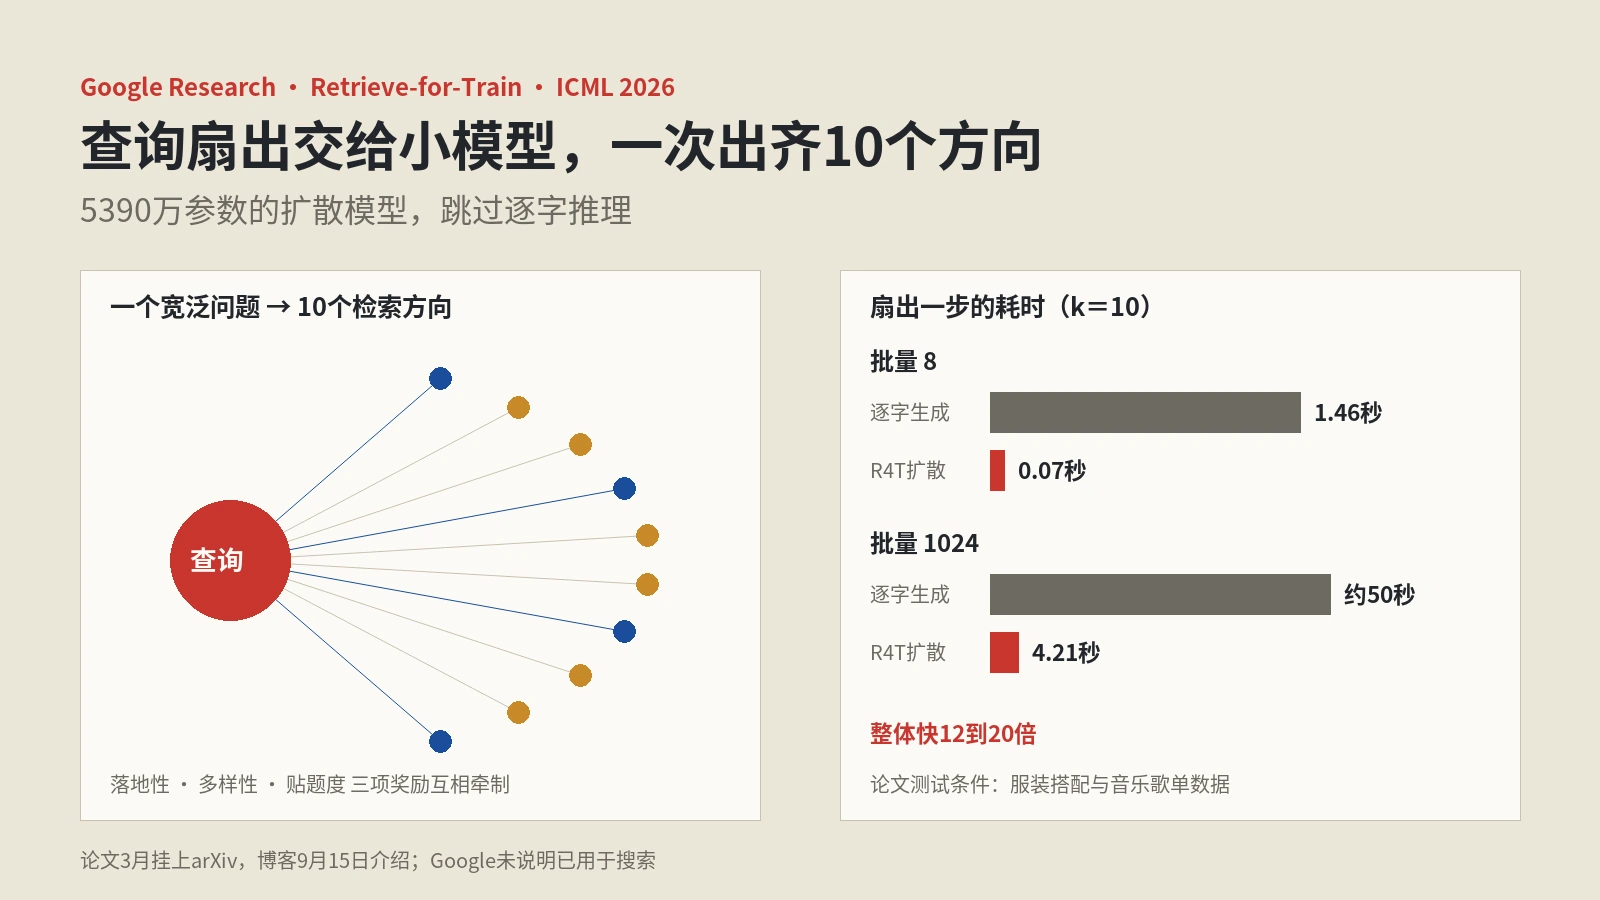
以SEJ 9月24日报道为主体,对照Google Research博客和ICML 2026论文原文,讲清楚R4T查询扇出框架的三步训练流程、三项奖励如何防止模型钻空子、12到20倍提速的测试口径、实验数据集与局限,以及它是否已用于Google搜索和对内容规划的启示。
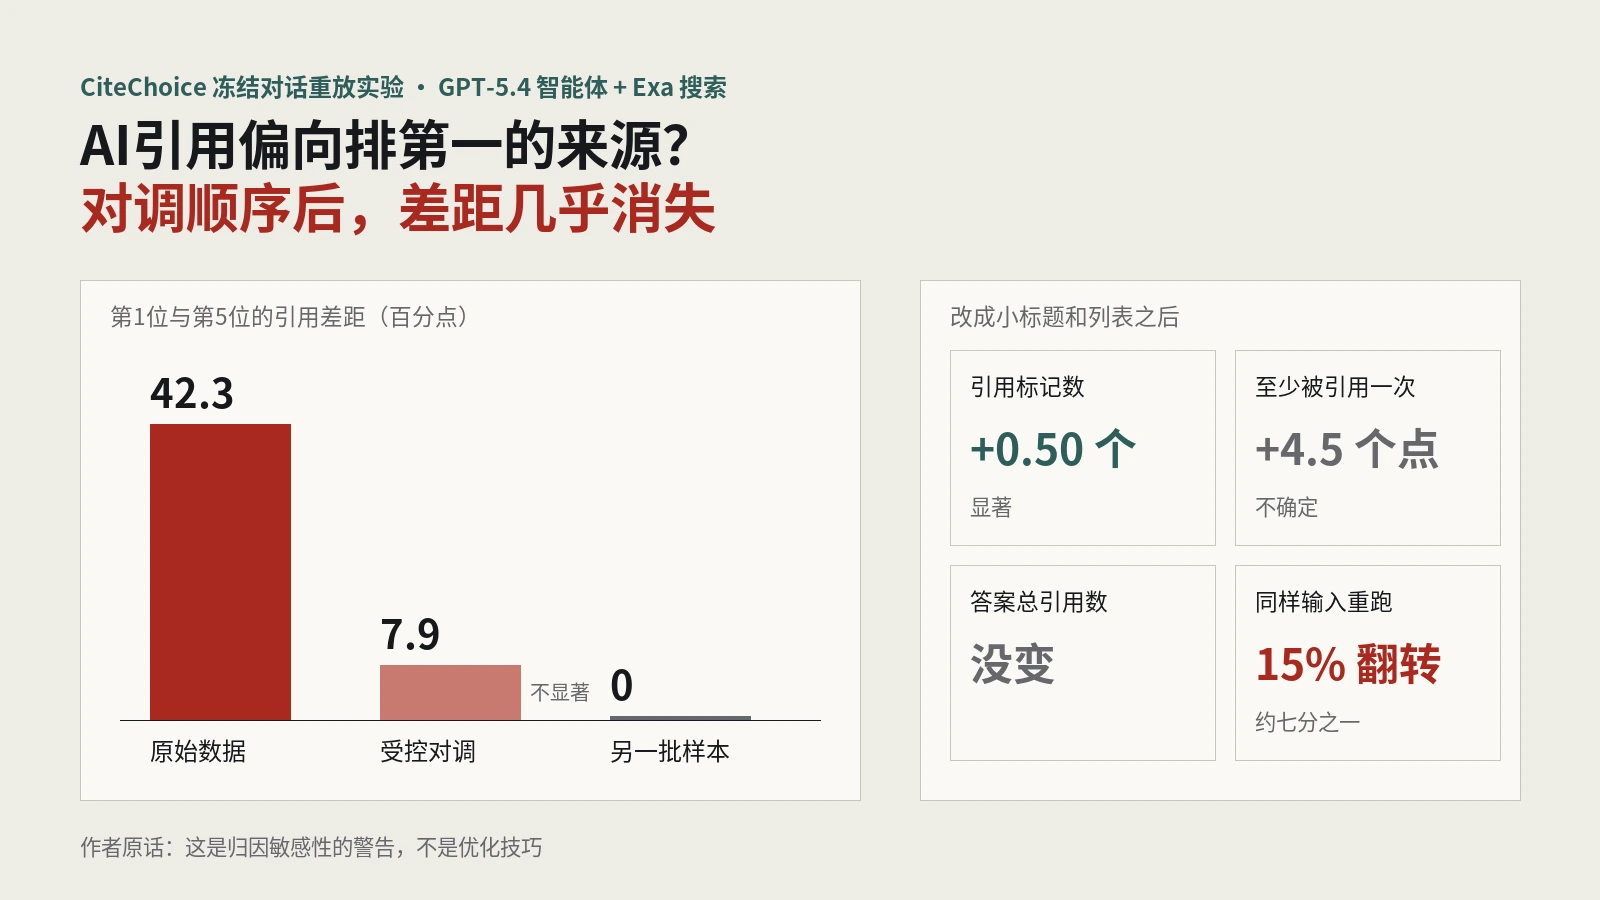
以SEJ 9月17日报道和arXiv预印本CiteChoice为主体,讲清楚这项受控重放实验怎么设计、搜索结果排序和小标题列表格式对AI引用的真实影响有多大、重跑为何约七分之一引用决定翻转,以及做GEO和AI可见度监测时哪些结论能用、哪些不能用。
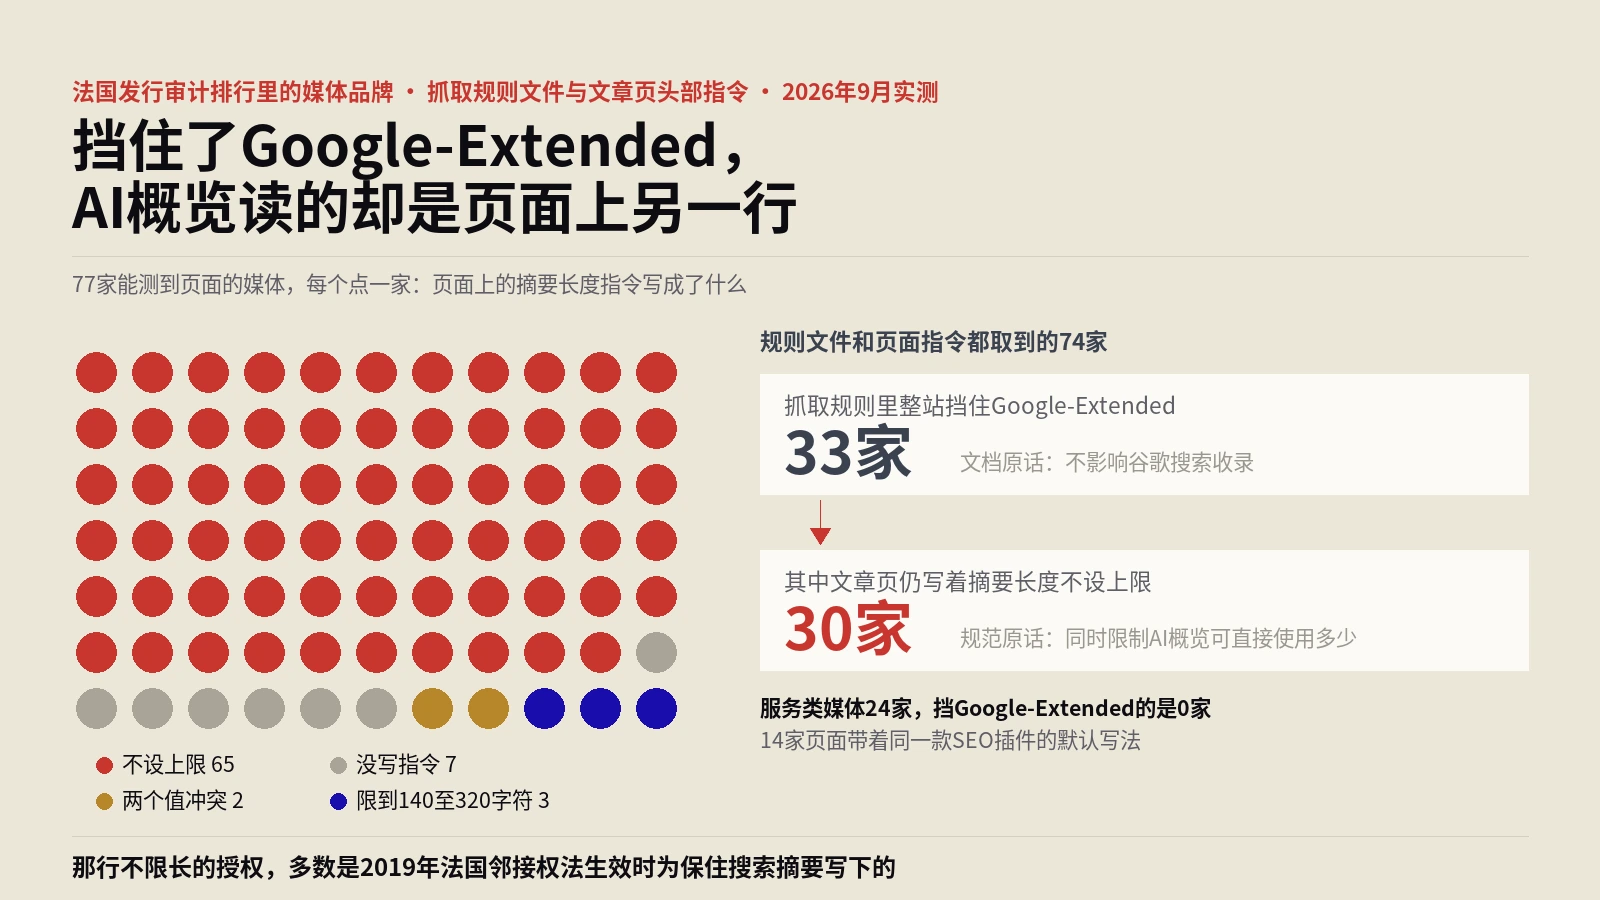
核对办法:从法国发行审计机构八月数字品牌排行里挑出98个媒体品牌,逐家取回抓取规则文件与文章页头部的摘要指令,被防护挡住的用真浏览器补抓;再对照谷歌指令规范、爬虫文档、新闻授权计划说明与2019年法国预览政策,判断每条设置实际管到哪里。
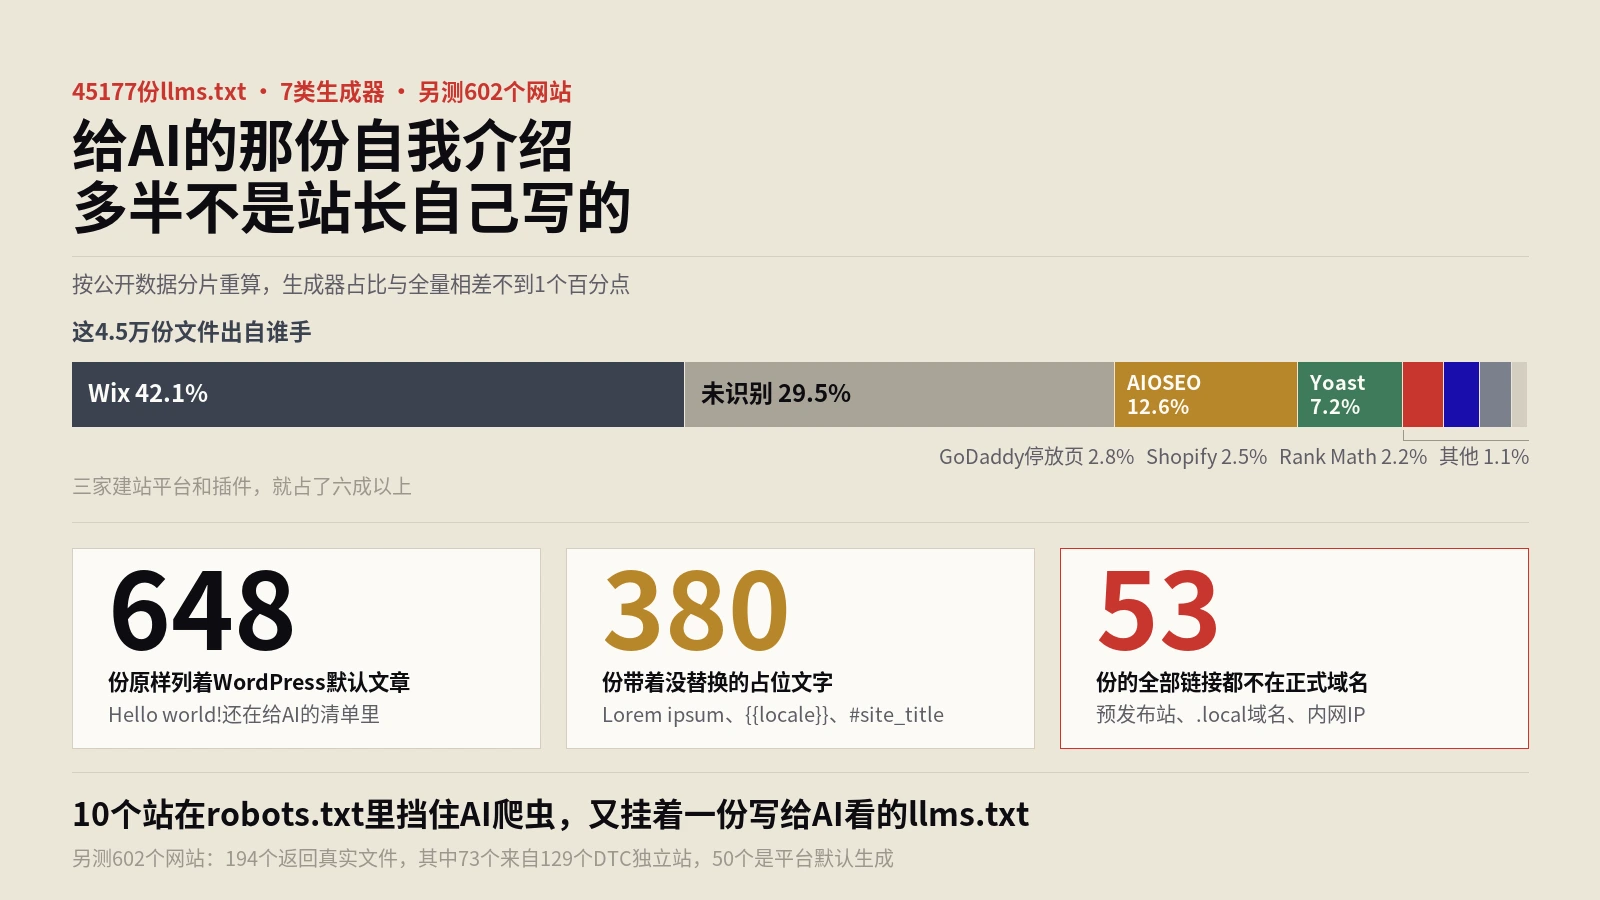
做法:下载Common Crawl公开的llms.txt数据分片,按署名与结构骨架识别生成器,逐份检查默认示例文章、未替换占位符、链接主机是否为预发布或本地地址、政策性语句;另抓602个网站的llms.txt与robots.txt逐条对照,并对抽样链接做两轮存活复测。
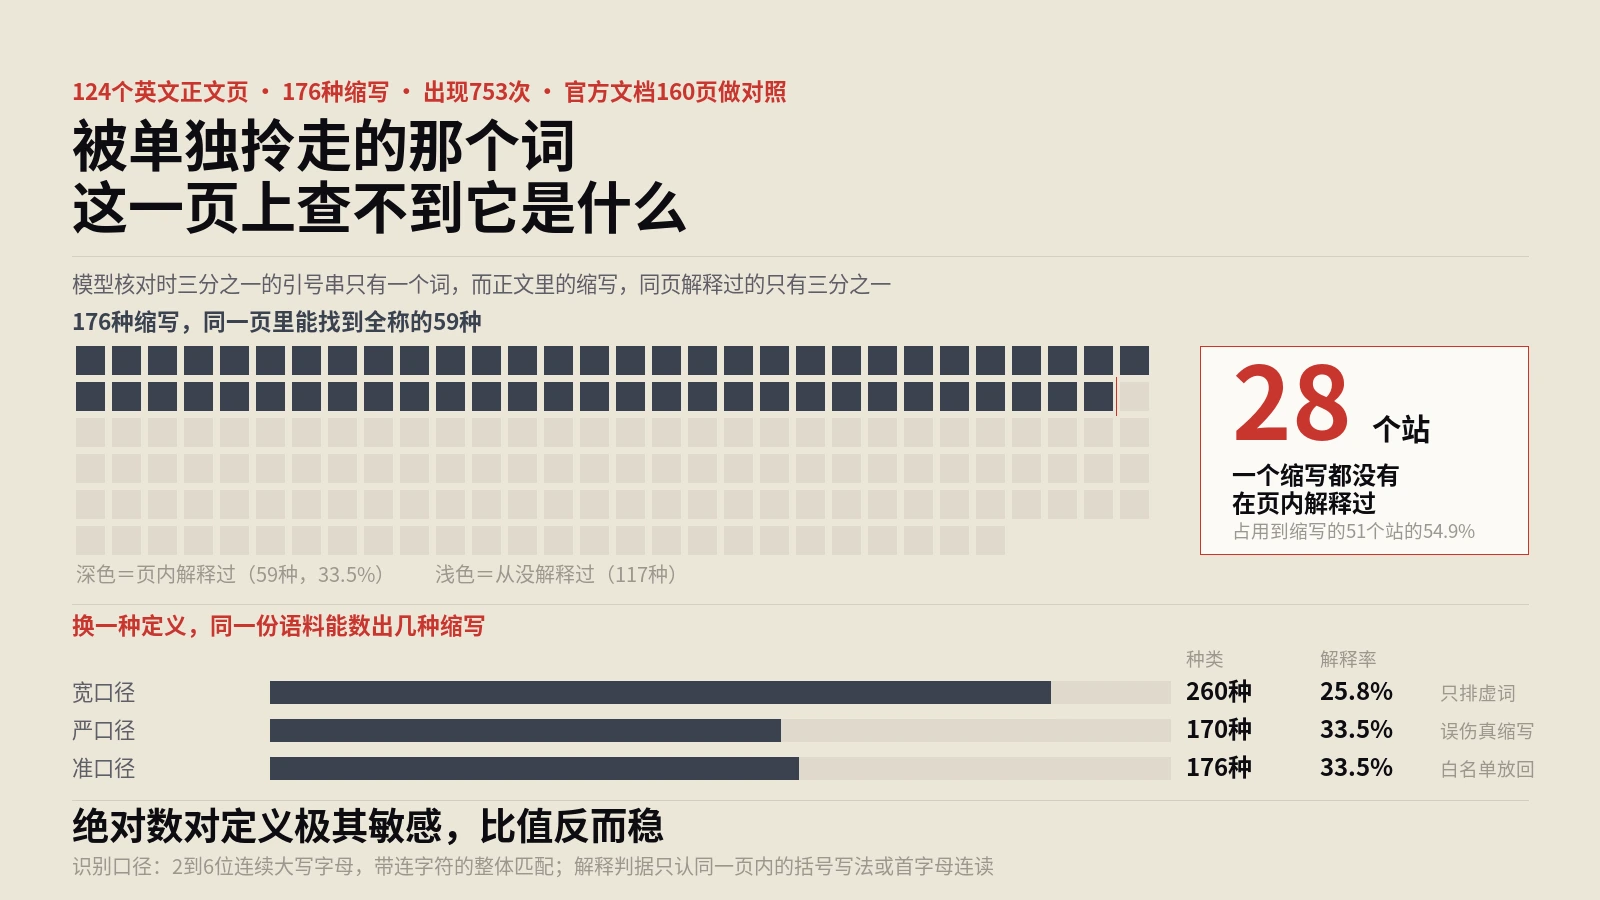
三档口径并列跑,把定义的敏感度一起量出来:先抓2到6位连续大写串并整体识别带连字符的缩写,再分别用宽、严、准三套排除规则统计种类与次数,解释判据只认同一页内的括号写法或首字母连读,最后和谷歌官方文档的160个页面做同尺对照。
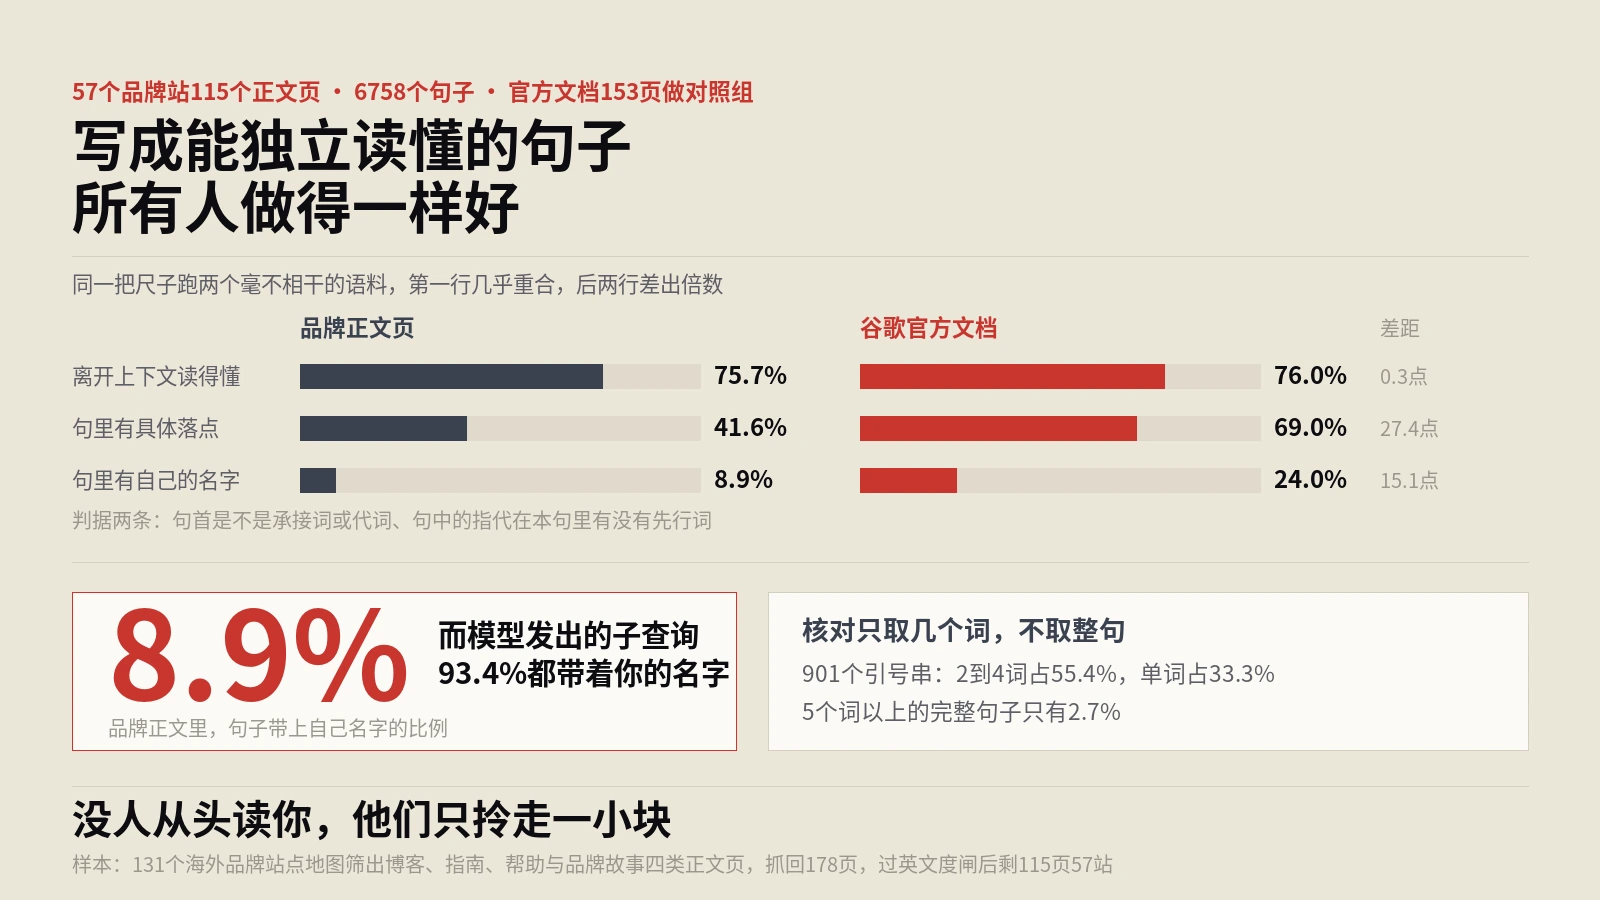
测法写清楚了好复现:从131个站的站点地图筛出博客、指南、帮助与品牌故事四类正文页,低并发抓回178页,先过一道英文度闸剔掉非英文页,再剔掉跨页样板句,最后按句首承接、悬空指代、具名落点、品牌落款四条规则逐句判定,并用谷歌官方文档的153个页面跑同一把尺子做对照。
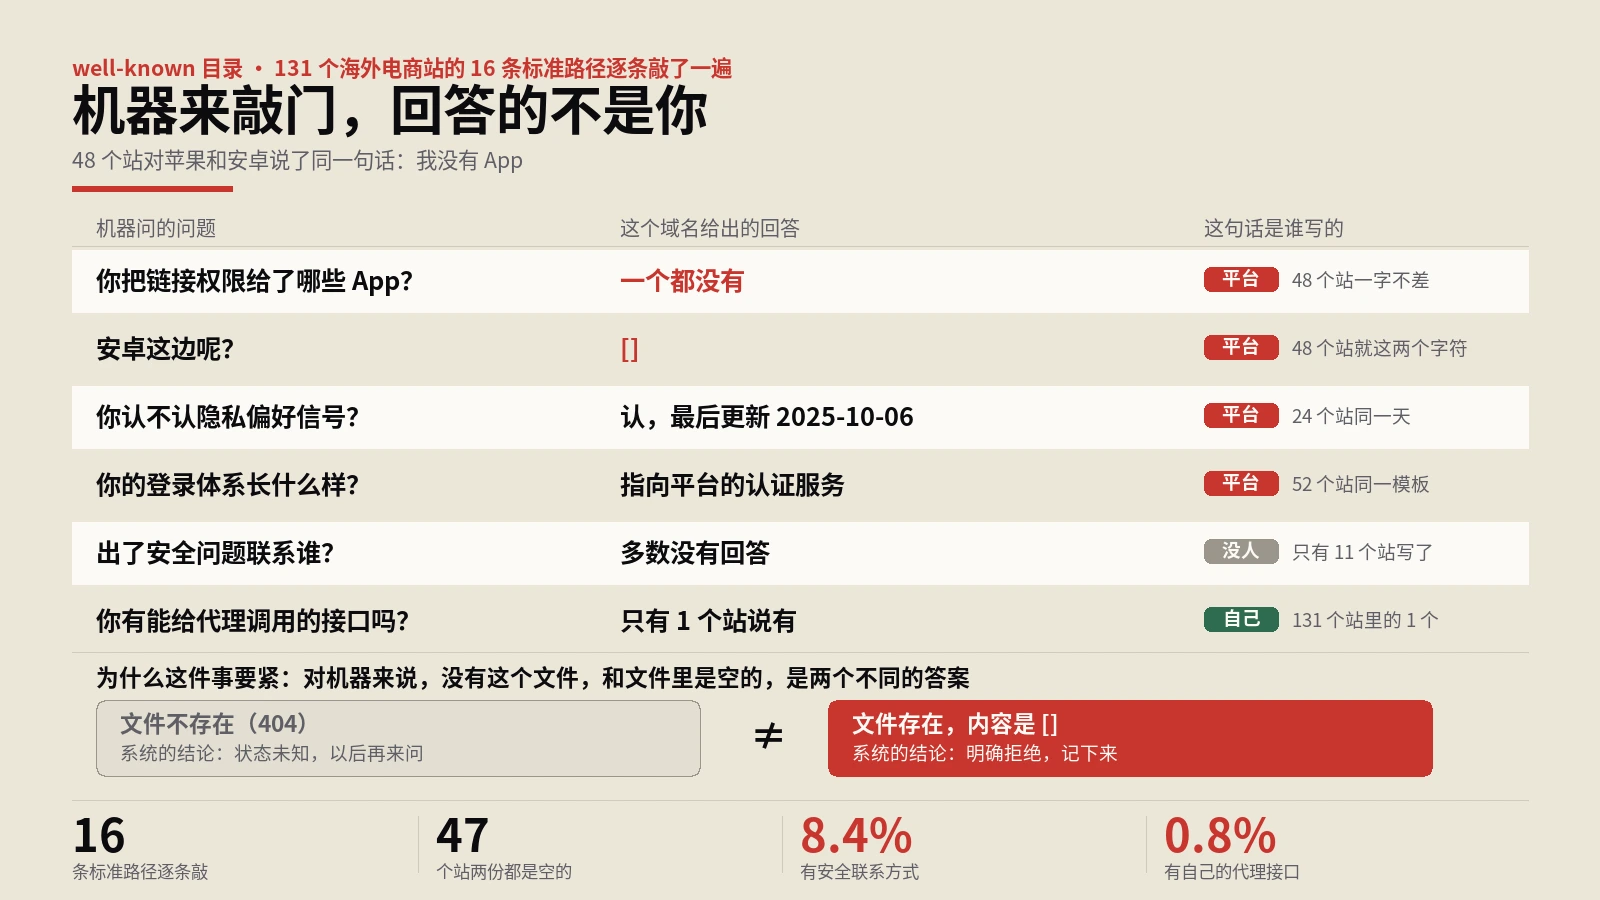
把131个海外电商站的16条well-known路径挨个请求,跟随重定向后按三层判据剔掉假200:状态码、内容类型、正文里有没有自称404或拒绝访问的结构;再抹掉域名与店铺标识做内容聚类,区分哪些是平台批量铺的、哪些是品牌自己写的。判据前后改了6处,方向全部是让数字变小。
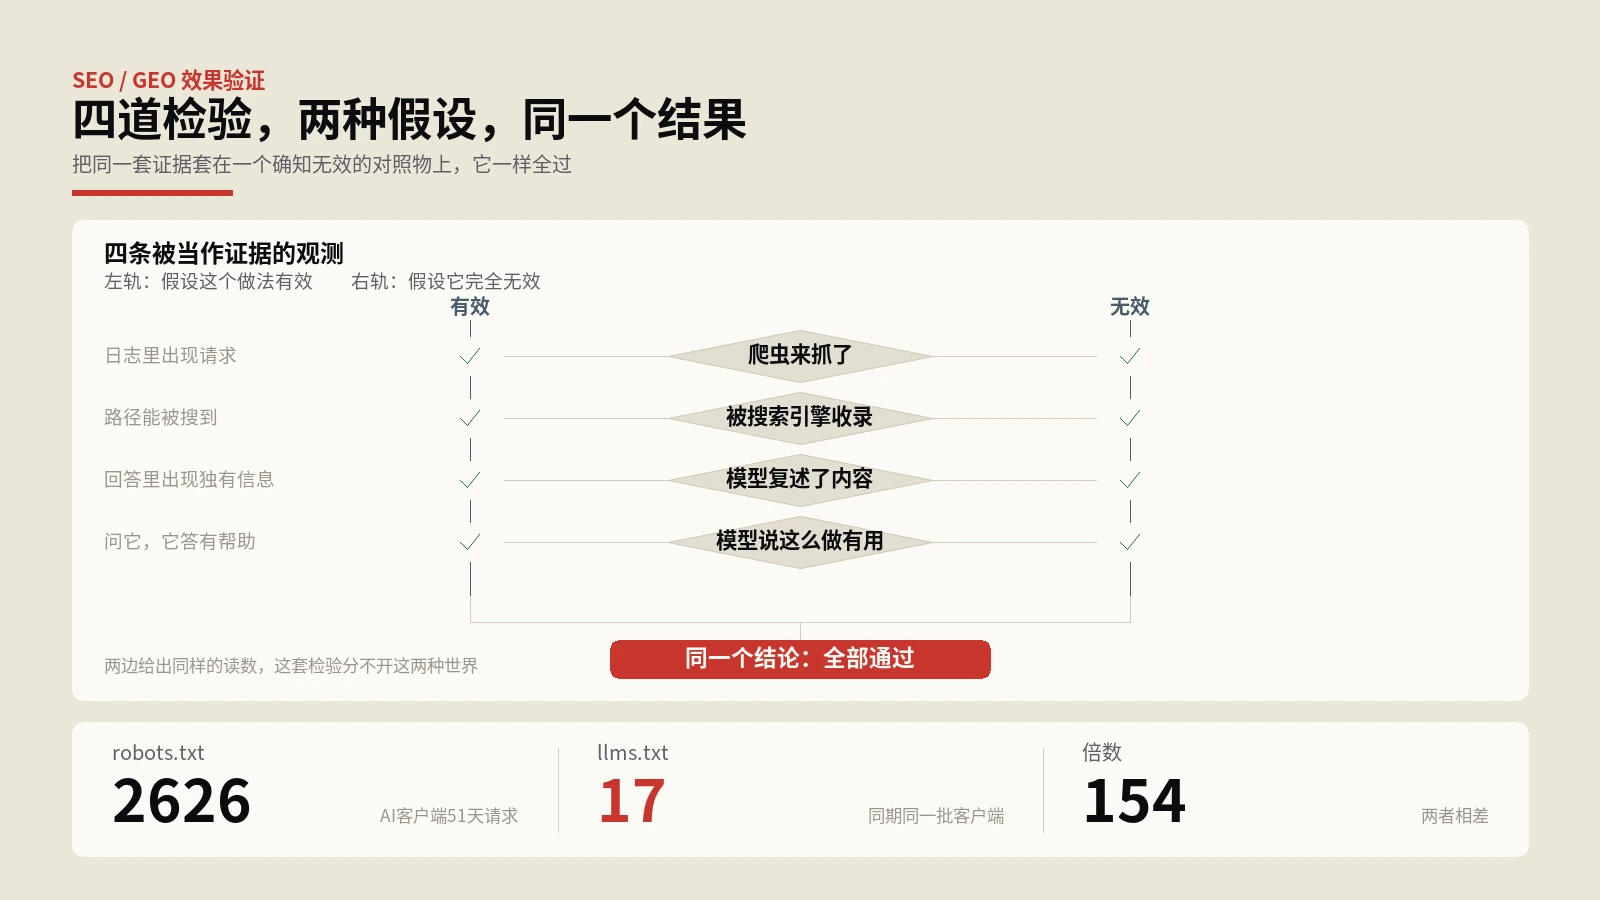
四条被反复引用的效果证据,在做法完全无效的时候也照样成立。本文用51天、230万条访问日志做了一次对照实验,把robots.txt当作已知被使用的参照,量出AI客户端对llms.txt的真实请求只有17次,并给出对照组的七步流程与一条能长期挂在站上的地板线。
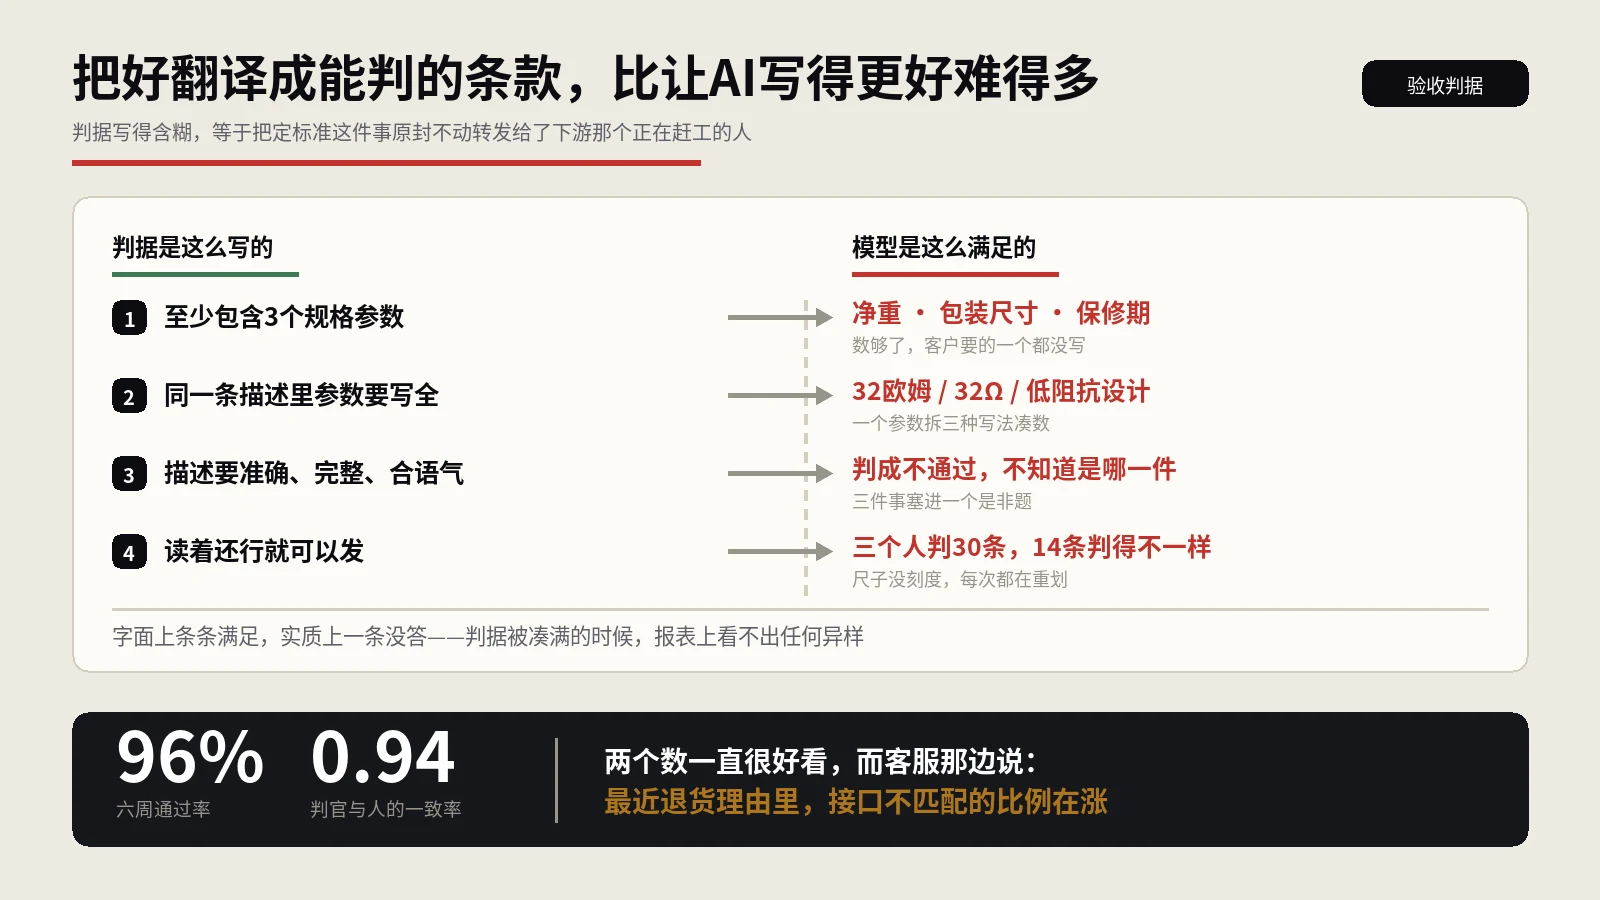
AI批量产出的验收难在没有尺子。这篇把好翻译成可判定条款:判据卡片六个字段、能用规则判的别请模型、模型判官的三种偏差与校准方法、判据的版本管理,附一次判据被凑满的失手复盘。