
让大模型记住品牌没那么简单:背得出原文,换个问法就答不上来
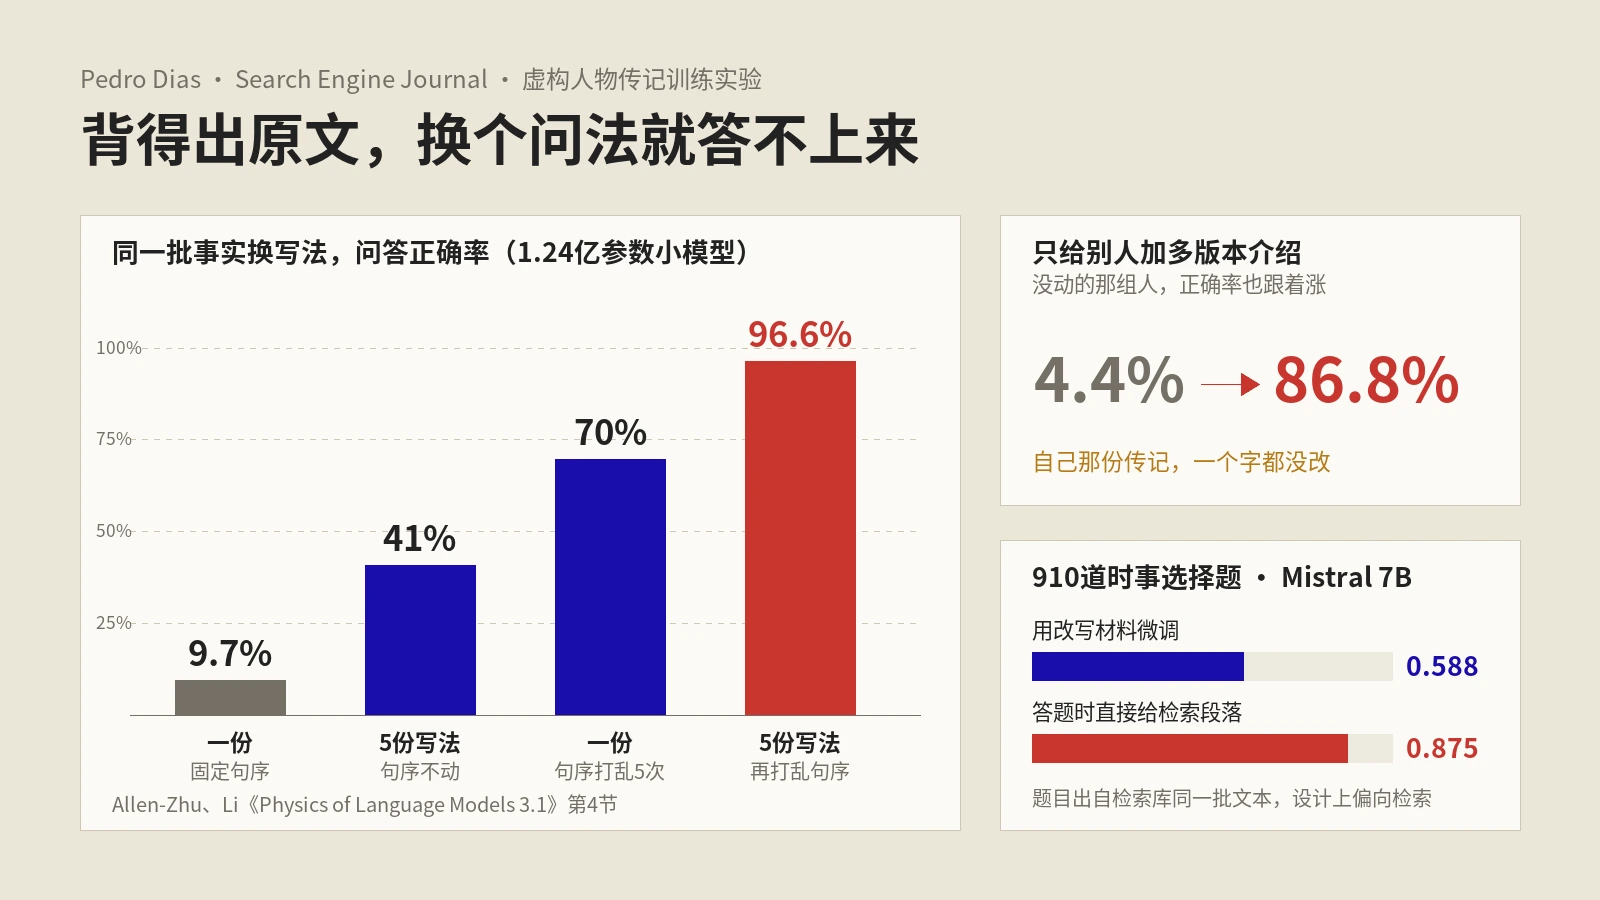
以Pedro Dias在SEJ的文章为主体,逐篇核对他引用的传记训练实验、重复与逐字记忆、微调对比检索、来源偏好四组论文,讲清楚背诵和问答的差别、改写与重复各自管什么、模型换代为何会让品牌召回无故变好,以及外贸站怎样分开测认出、答对、推荐三个指标。
AI到底凭什么推荐某个品牌、引用某篇内容?这里拆解AI引用机制与可见度,从信源选择、训练数据共现、引用滞后到提及与引用差距和E-E-A-T信号演化,帮你看懂AI时代被看见的底层规则。
以Pedro Dias在SEJ的文章为主体,逐篇核对他引用的传记训练实验、重复与逐字记忆、微调对比检索、来源偏好四组论文,讲清楚背诵和问答的差别、改写与重复各自管什么、模型换代为何会让品牌召回无故变好,以及外贸站怎样分开测认出、答对、推荐三个指标。
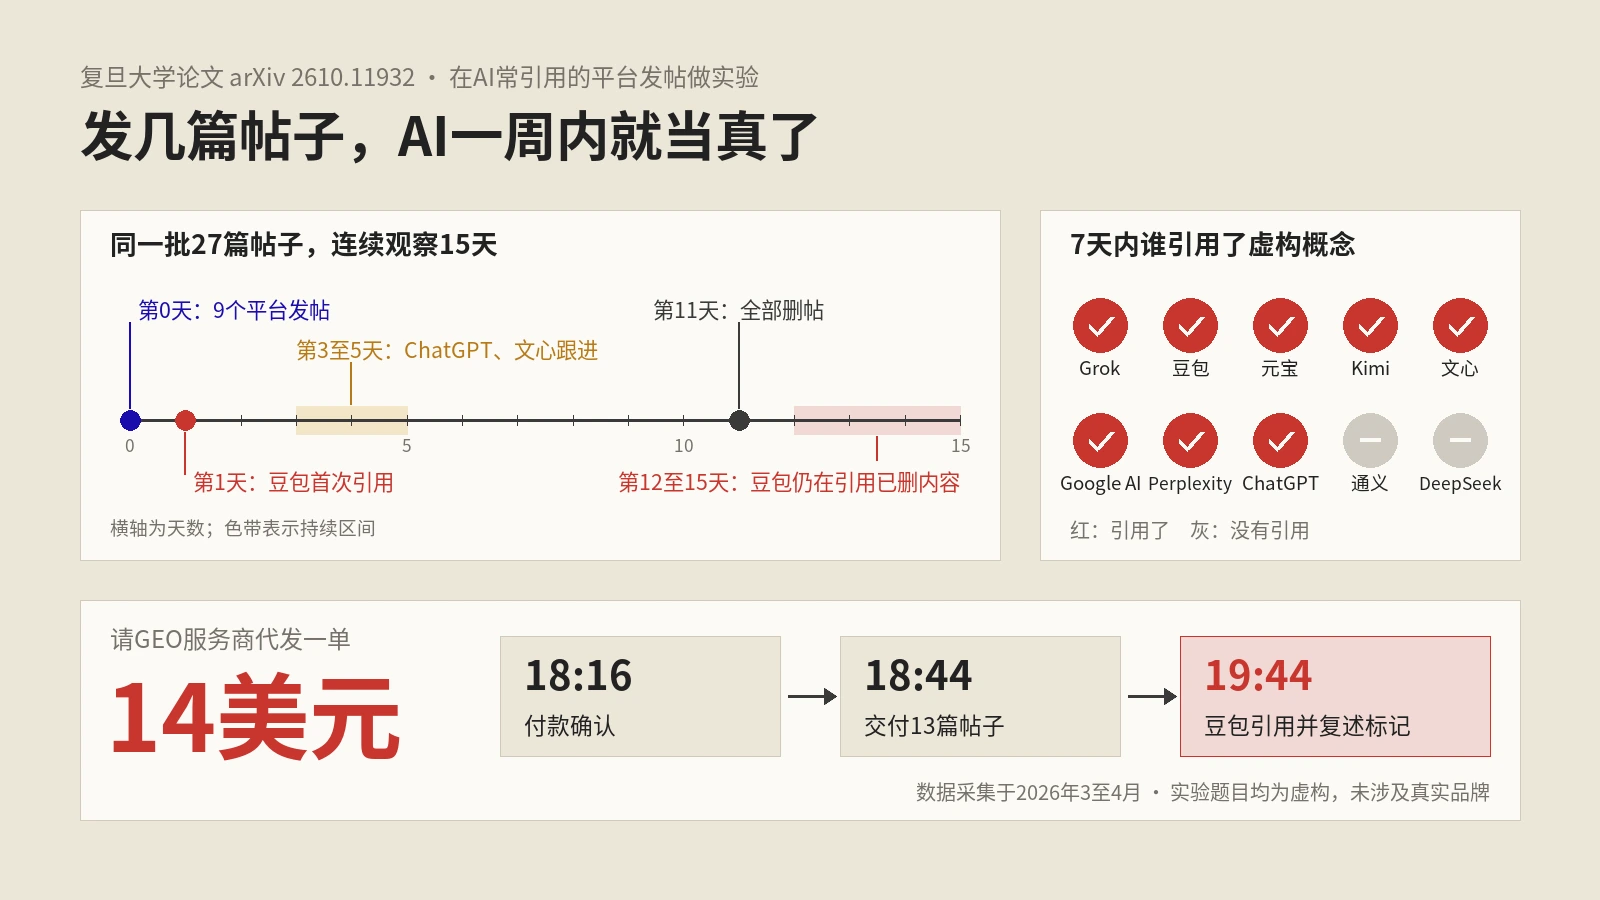
以SEJ 10月19日报道为主体,对照复旦论文原文,讲清楚研究者怎样挑出AI最常引用又最好发帖的平台,在9个平台发帖后10个AI平台的引用与复述比例,豆包文心等中文平台偏爱自家来源,发帖位置、数量和删帖对引用的影响,14美元GEO代发的时间线,以及品牌方的监测与防范做法。
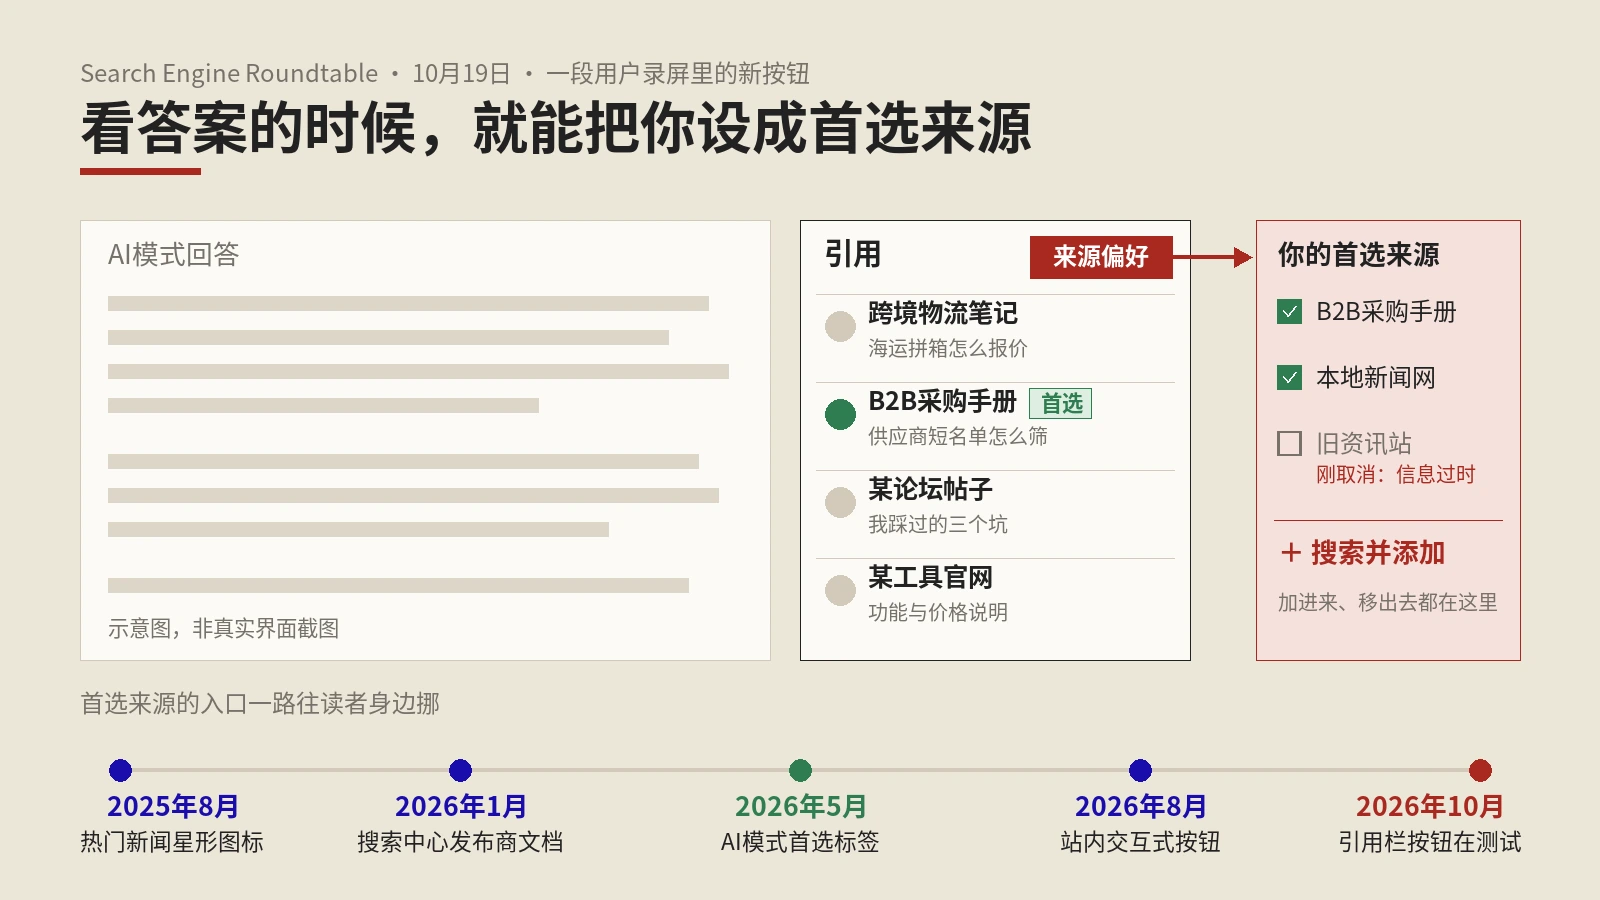
以Search Engine Roundtable 10月19日的测试报道为主体,对照Google搜索中心文档、搜索帮助和Search Console生成式AI开关说明,梳理首选来源现有的五种入口、热门新闻与AI模式两处措辞的差异、域名级资格与更新频率门槛,并给出监测方法和按钮部署上该做与可以缓一缓的事。
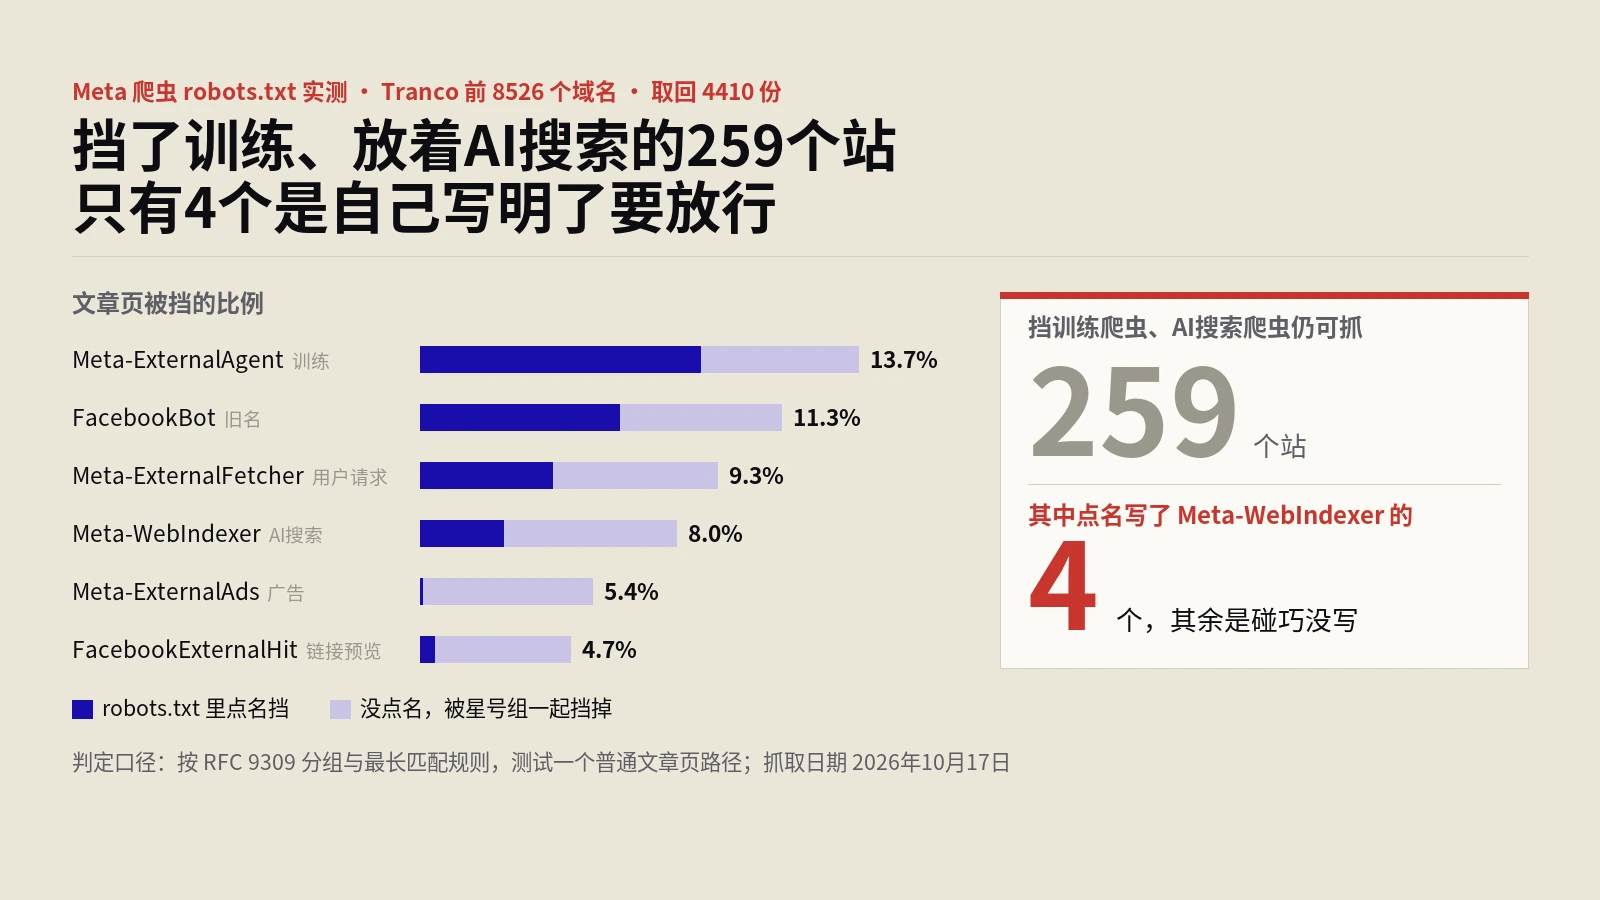
做法:在已登录账号里对照Meta商业条款现行版与10月30日预览版;按Meta爬虫文档列出五个爬虫的用途;取回Tranco前8526个域名中4410份robots.txt,按RFC 9309的分组与最长匹配规则判定每个Meta爬虫能否抓文章页,并与9月17日同站数据对比。
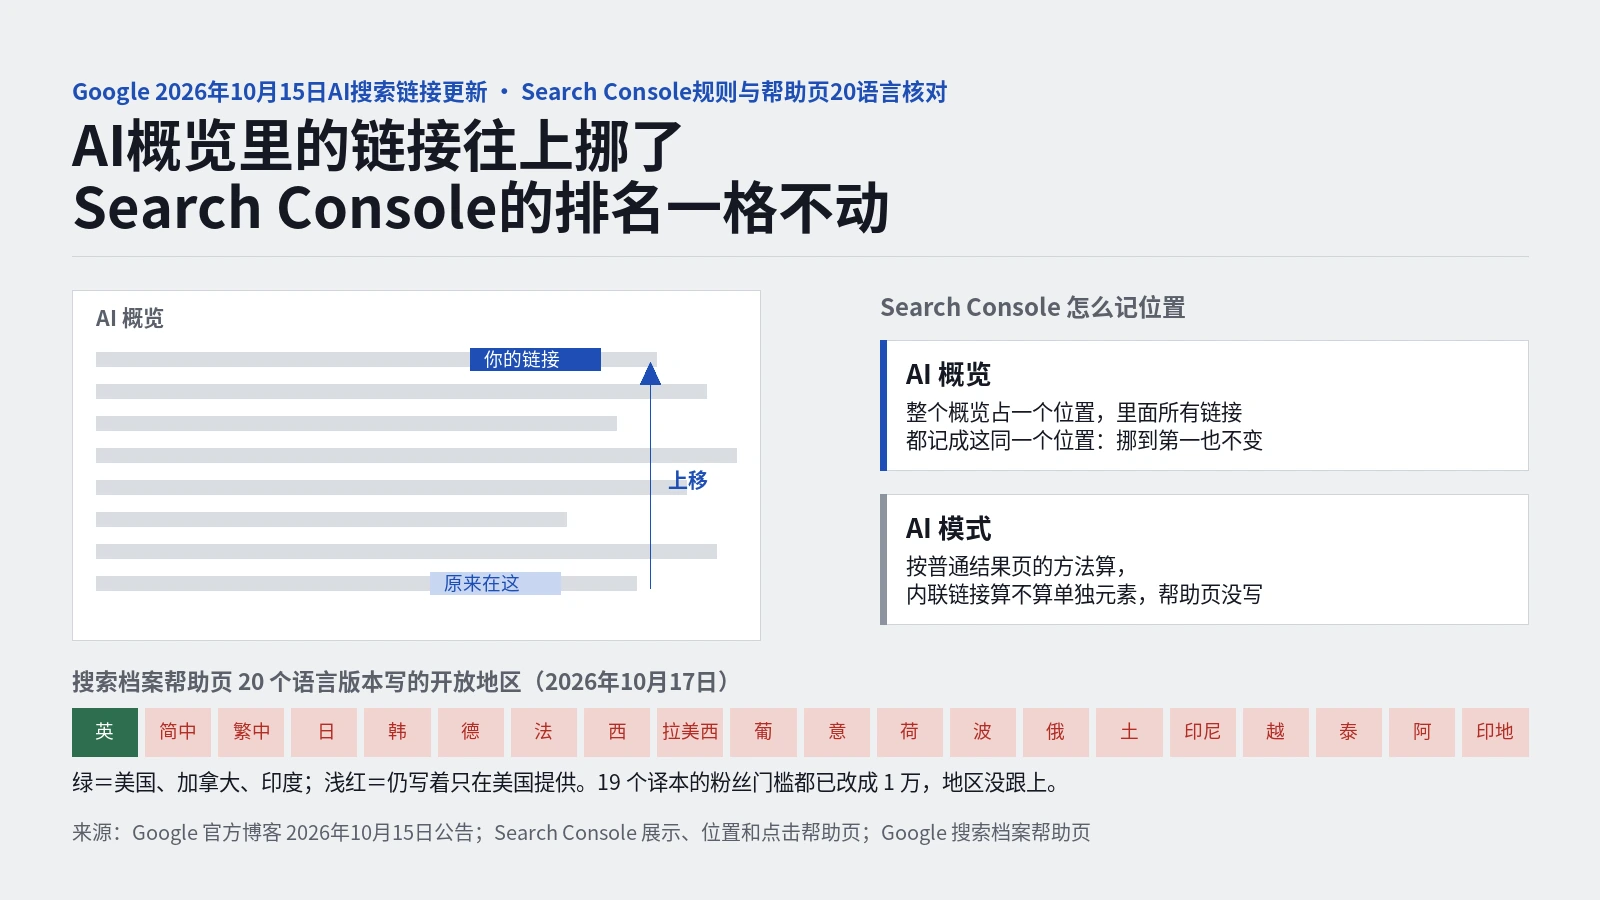
做法:逐条对照Google 10月15日公告原文,区分已上线和测试中的改动;读取Search Console位置规则、生成式AI开关与表现报告帮助页;抓取搜索档案帮助页20个语言版本,比对开放地区与粉丝门槛;再与5月6日、5月27日的同类公告对照。
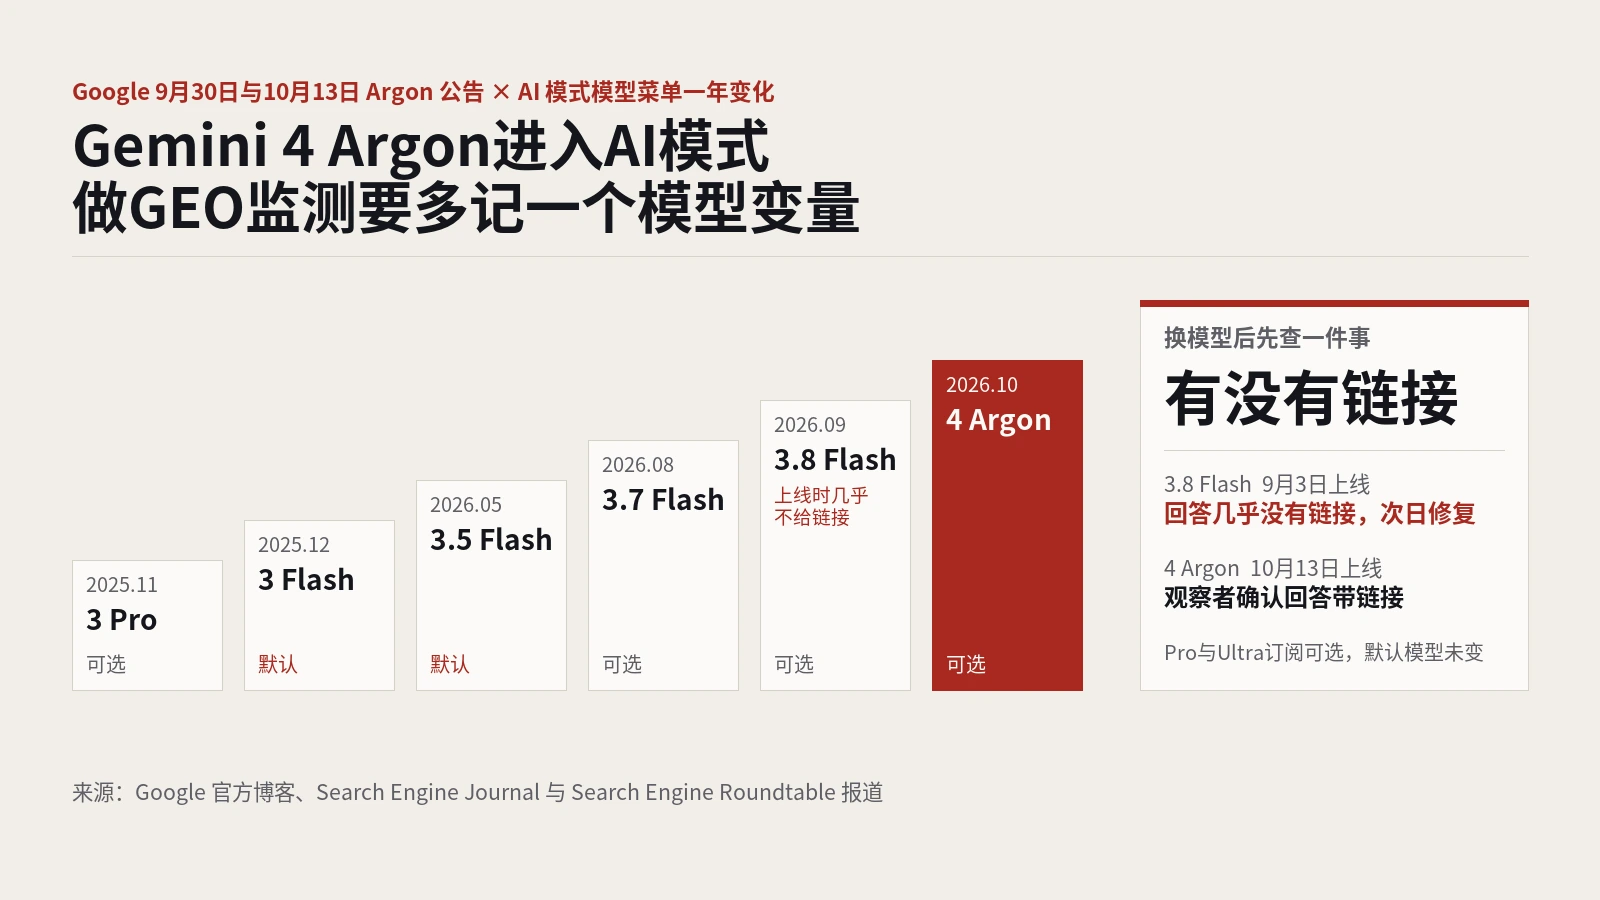
做法:以Search Engine Journal和Search Engine Roundtable的报道为线索,对照Google在9月30日与10月13日的两篇官方公告,梳理AI模式模型菜单的变化、3.8 Flash不给链接的故障经过和对可见度监测的影响。
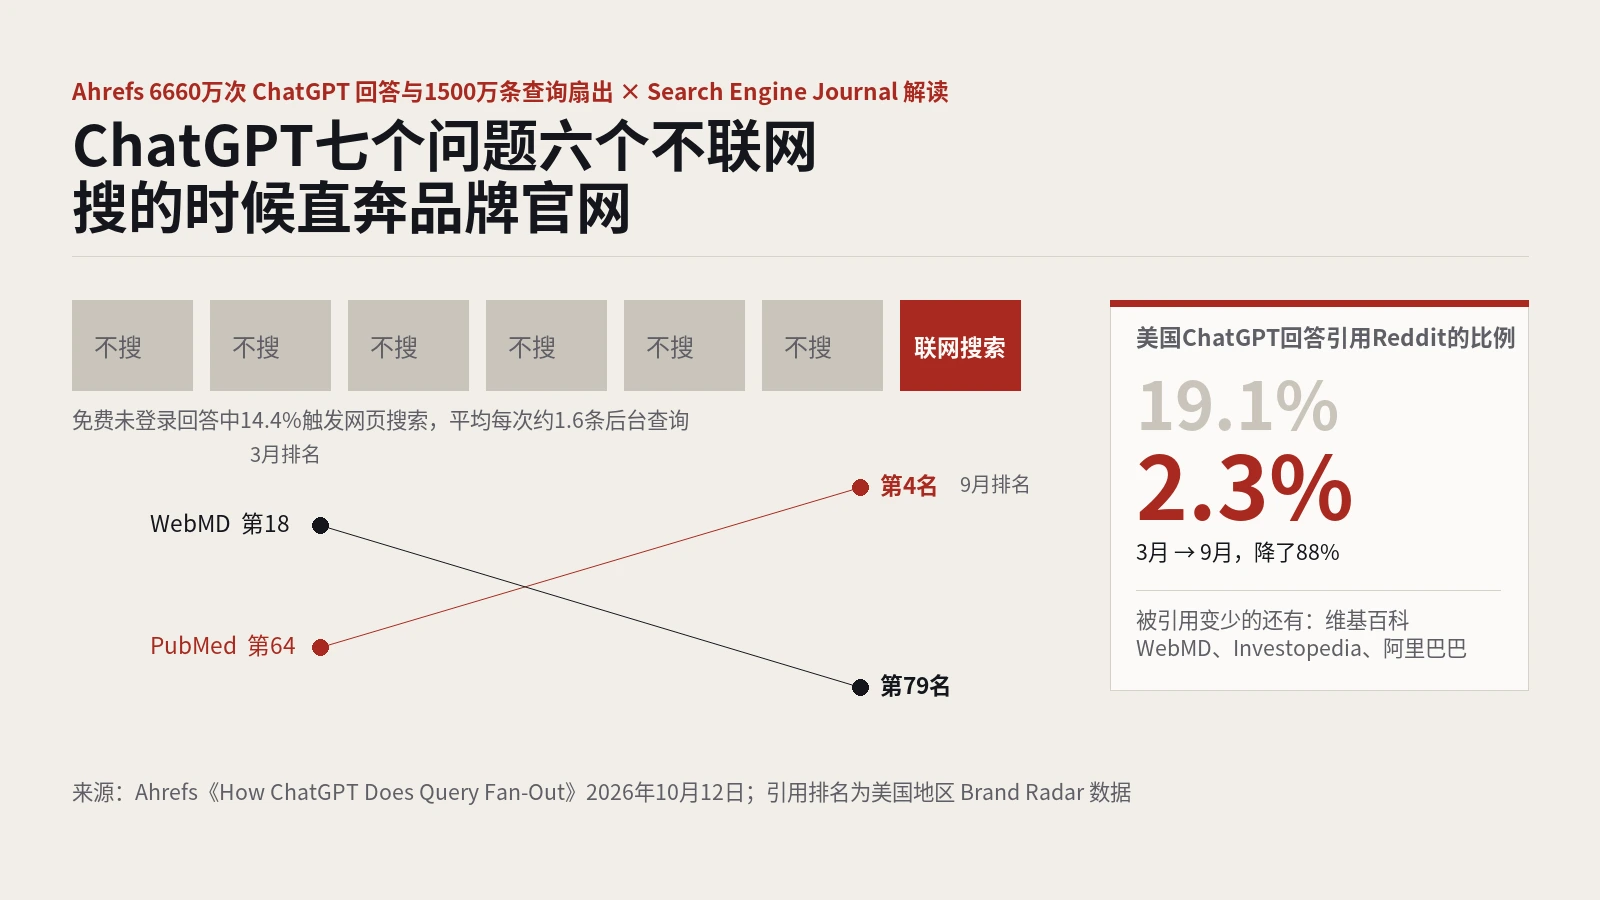
做法:以Ahrefs在10月12日发布的查询扇出研究为主体,结合Search Engine Journal的解读、Nectiv的同类研究和OpenAI帮助页,梳理搜索比例、site:搜索去向、扇出用词变化和引用排名的涨跌。
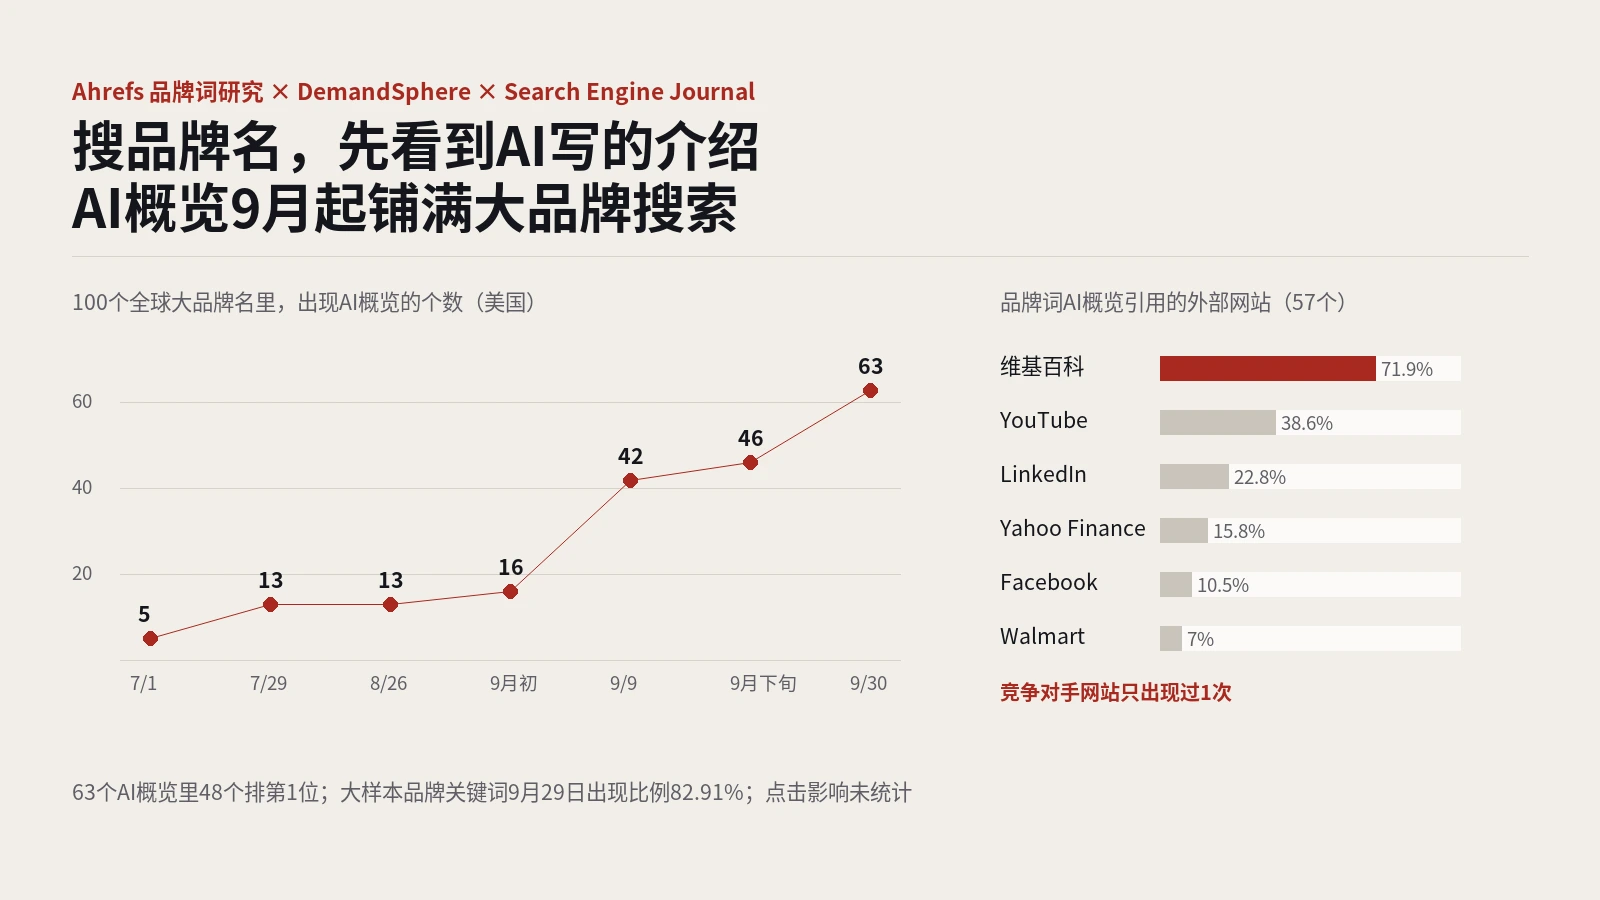
做法:以Ahrefs 10月2日的品牌词AI概览研究为主体,对照Search Engine Journal对Ahrefs、DemandSphere与Chris Long三方数据的样本核对,整理出现比例、每周变化、位置分布、引用来源和数据空白。
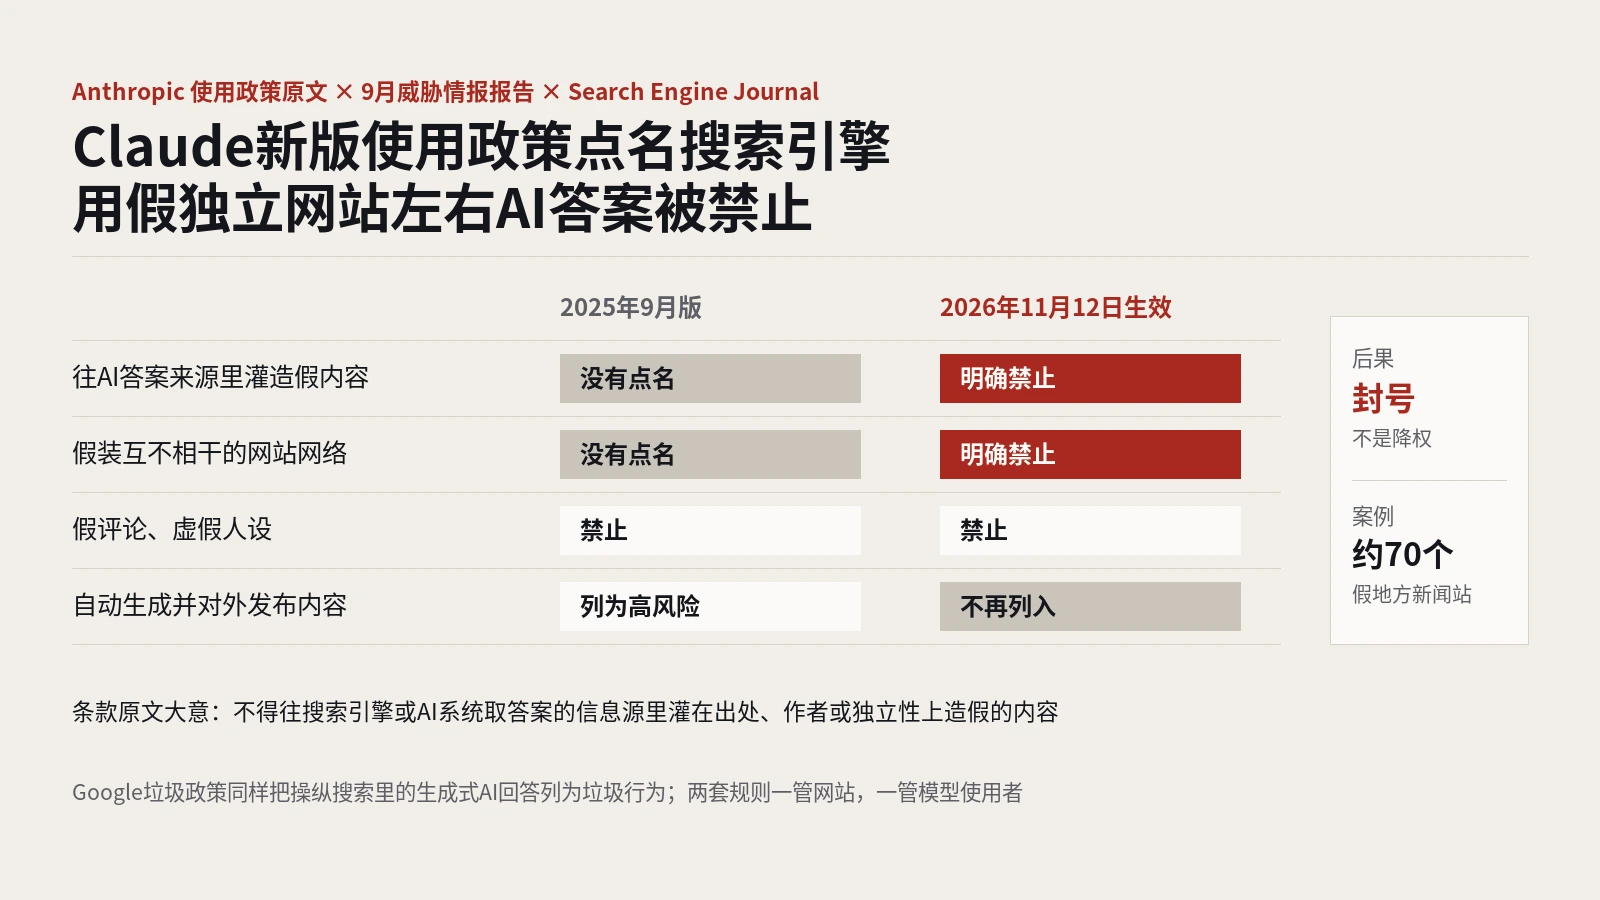
做法:以Anthropic新版使用政策原文和官方更新说明为主体,对照Search Engine Journal的新旧版本比较与Anthropic 9月威胁情报报告中的LKM Company案例,并和Google垃圾政策里关于生成式AI回答的规定并排对照。
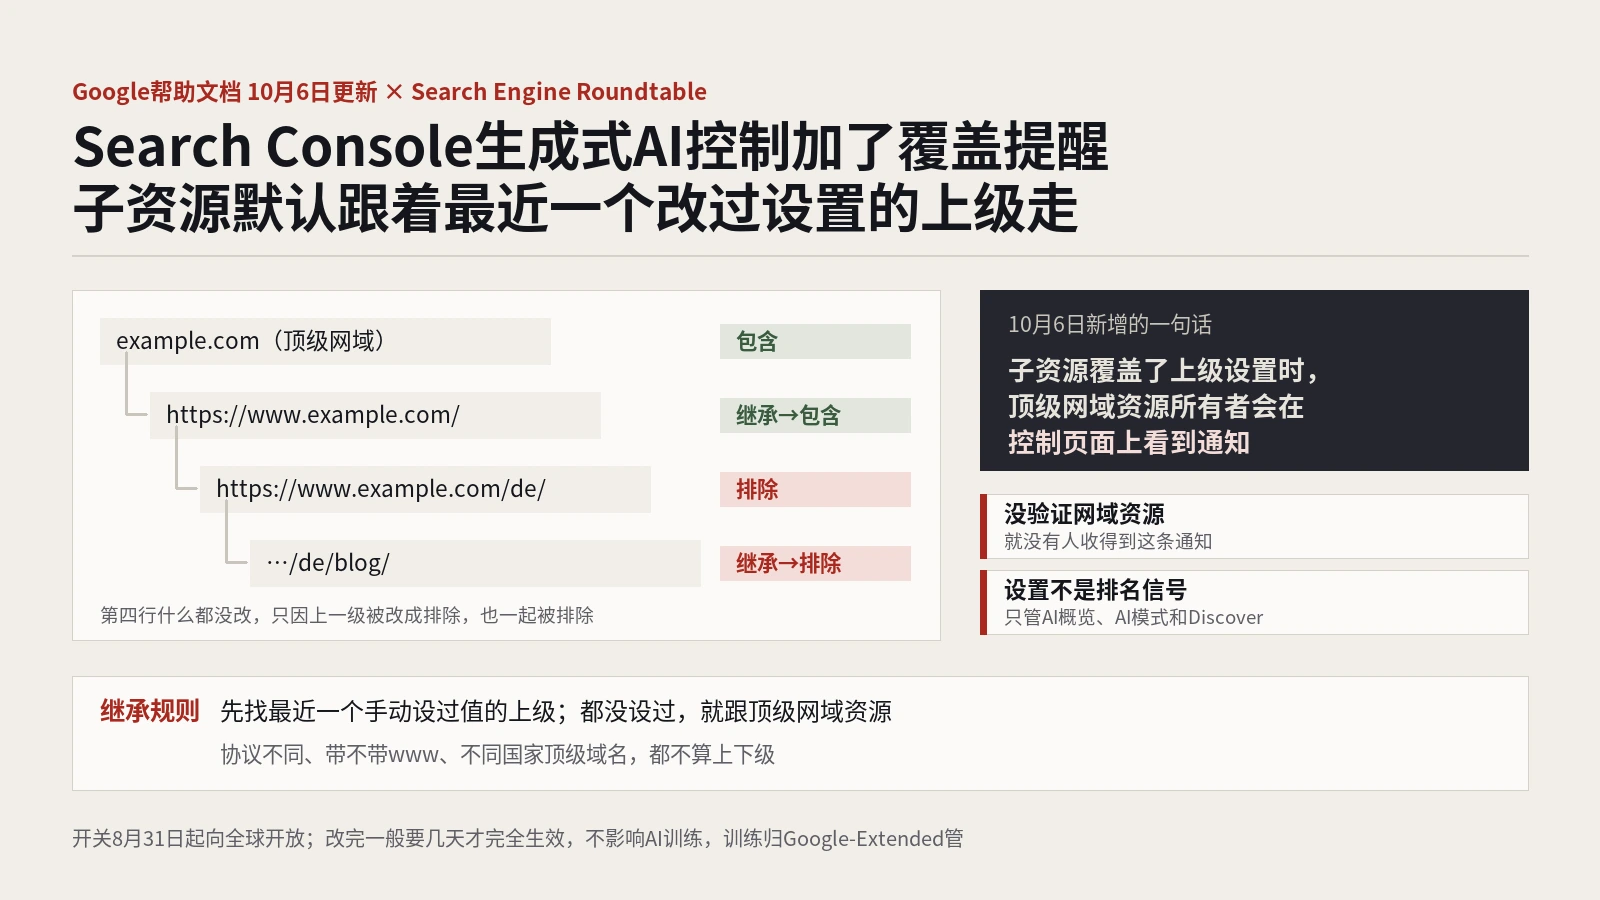
做法:以Search Engine Roundtable对10月6日帮助文档更新的报道为主体,对照Google的生成式AI控制帮助文档、权限说明和官方博客,整理开关上线时间线、三个选项的效果、父子资源继承规则与例子、新通知照顾不到的情况,以及企业管理开关的记录表和自查顺序。
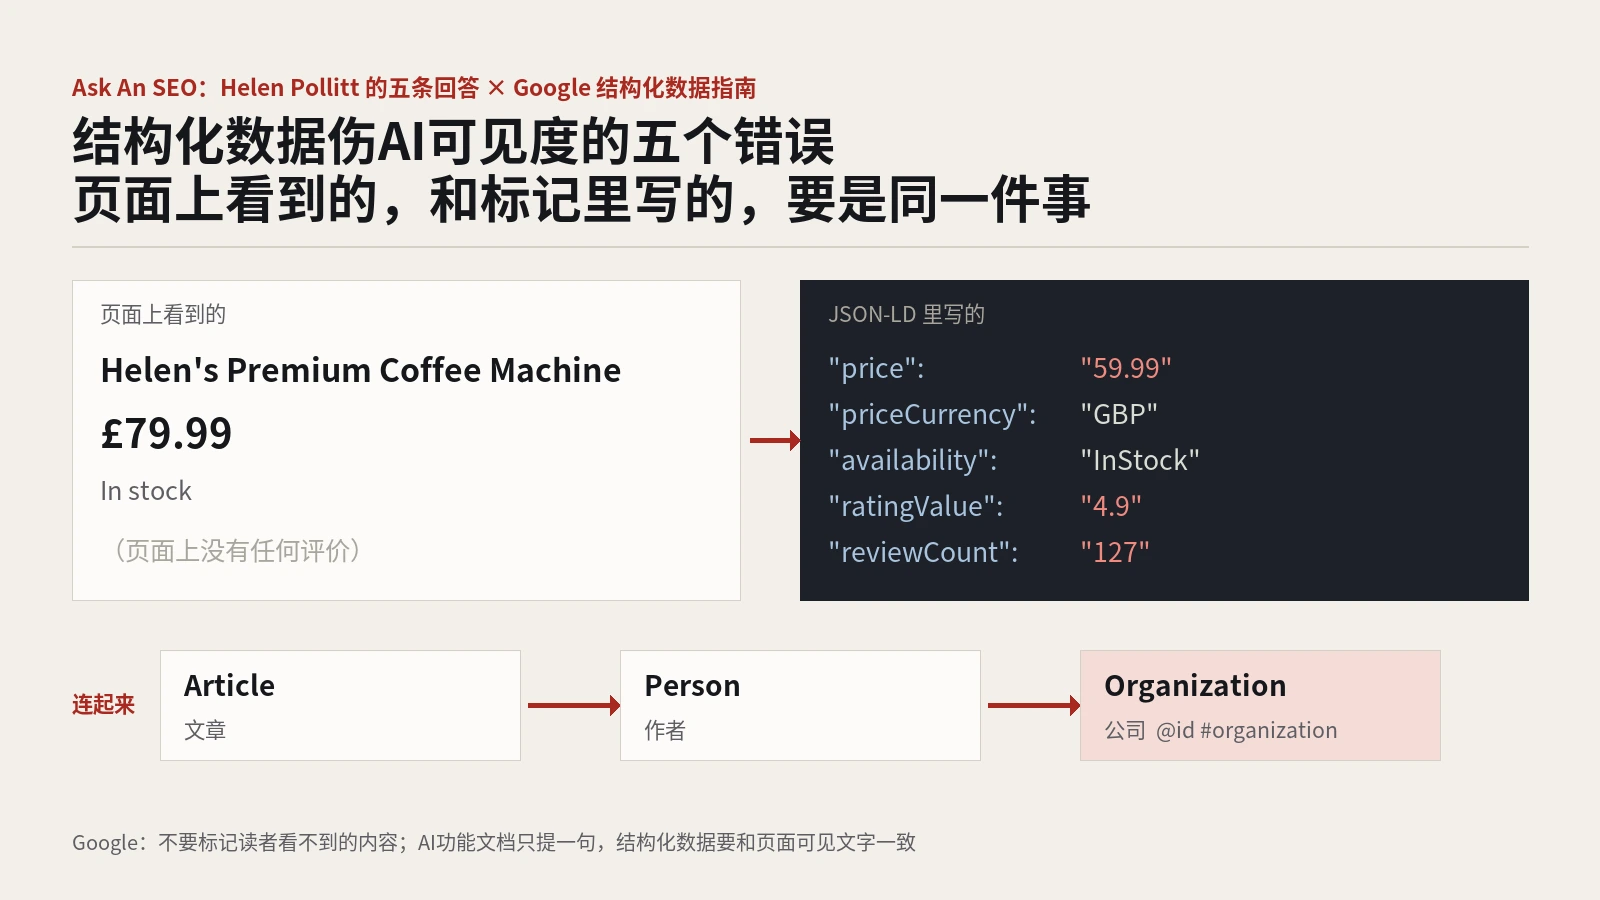
做法:以Search Engine Journal Ask An SEO专栏里Helen Pollitt的五条回答和示例代码为主体,对照Google通用结构化数据指南与AI功能文档,整理实体连接、站外口径、@id一致性、可见性与价格时效五类错误的成因、检查方法和修法,并补充@id跨页引用的工程做法。
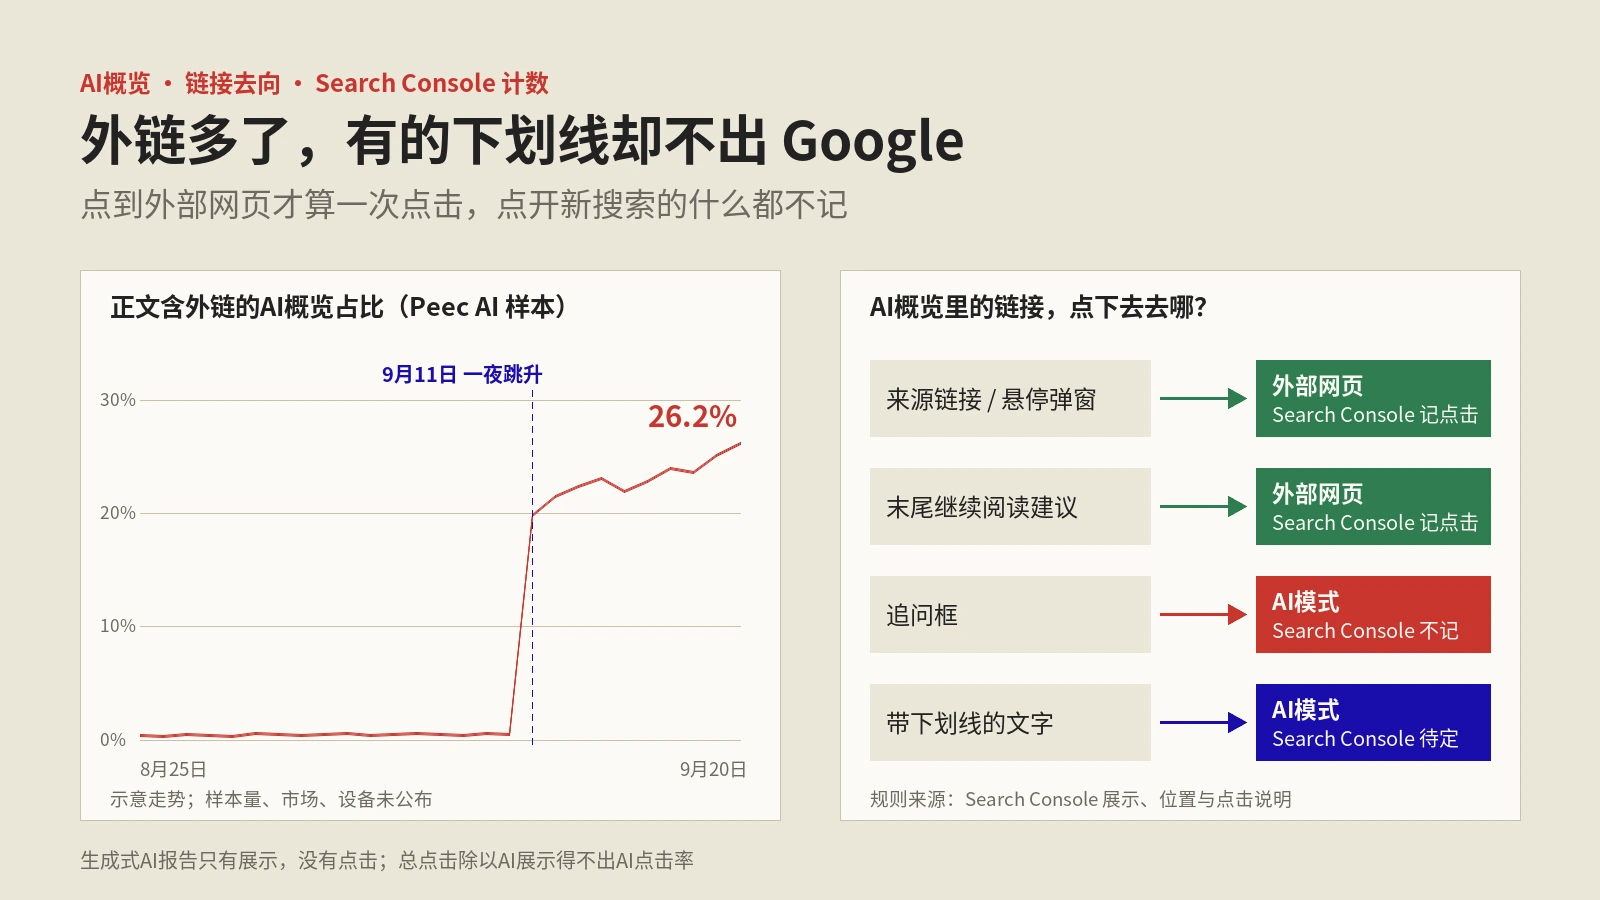
以SEJ 9月25日分析为主体,对照Google一年来五次AI回答链接改版、Search Console展示与点击规则和生成式AI报告帮助页,讲清Peec AI那张26.2%外链图该怎么读、打开AI模式的下划线链接为何可能不计数,以及站长能自己做的抽查办法。
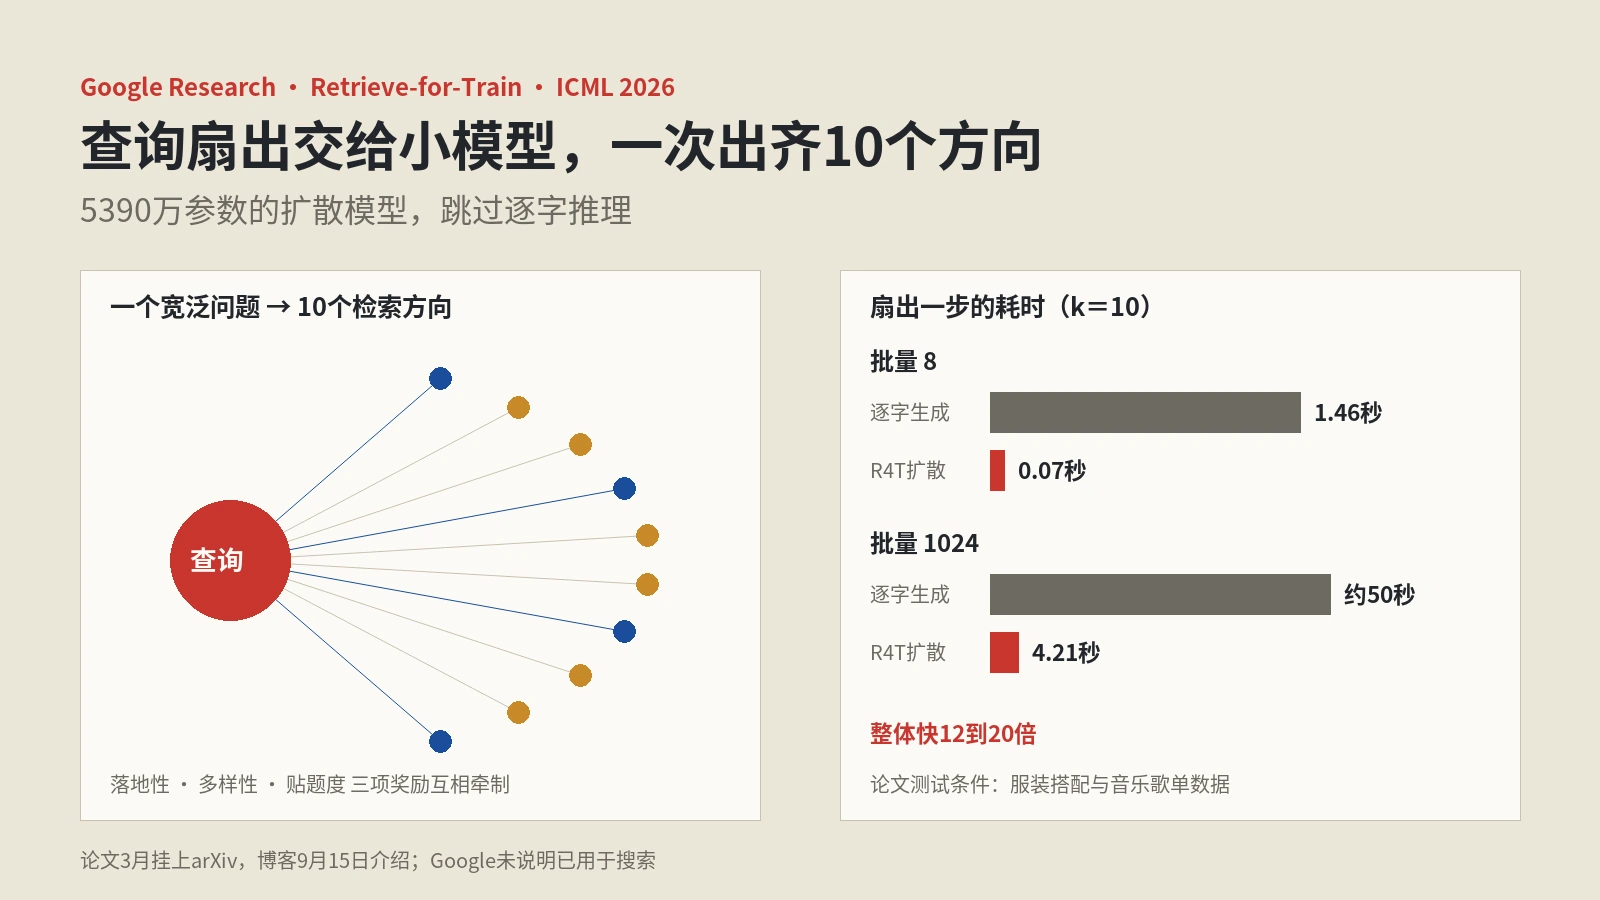
以SEJ 9月24日报道为主体,对照Google Research博客和ICML 2026论文原文,讲清楚R4T查询扇出框架的三步训练流程、三项奖励如何防止模型钻空子、12到20倍提速的测试口径、实验数据集与局限,以及它是否已用于Google搜索和对内容规划的启示。
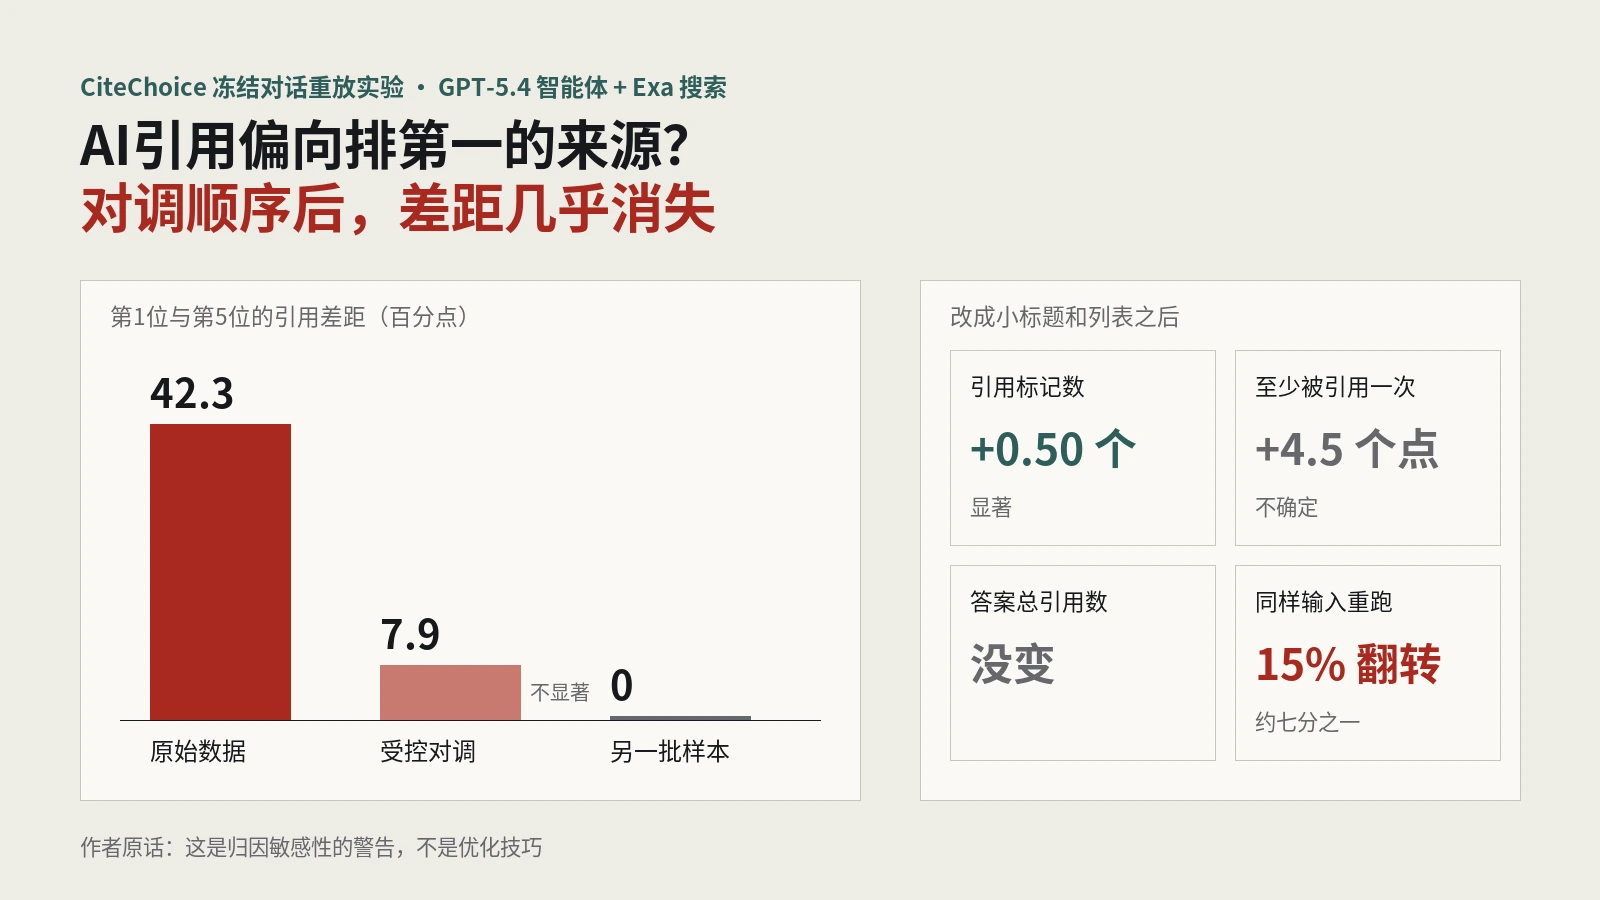
以SEJ 9月17日报道和arXiv预印本CiteChoice为主体,讲清楚这项受控重放实验怎么设计、搜索结果排序和小标题列表格式对AI引用的真实影响有多大、重跑为何约七分之一引用决定翻转,以及做GEO和AI可见度监测时哪些结论能用、哪些不能用。
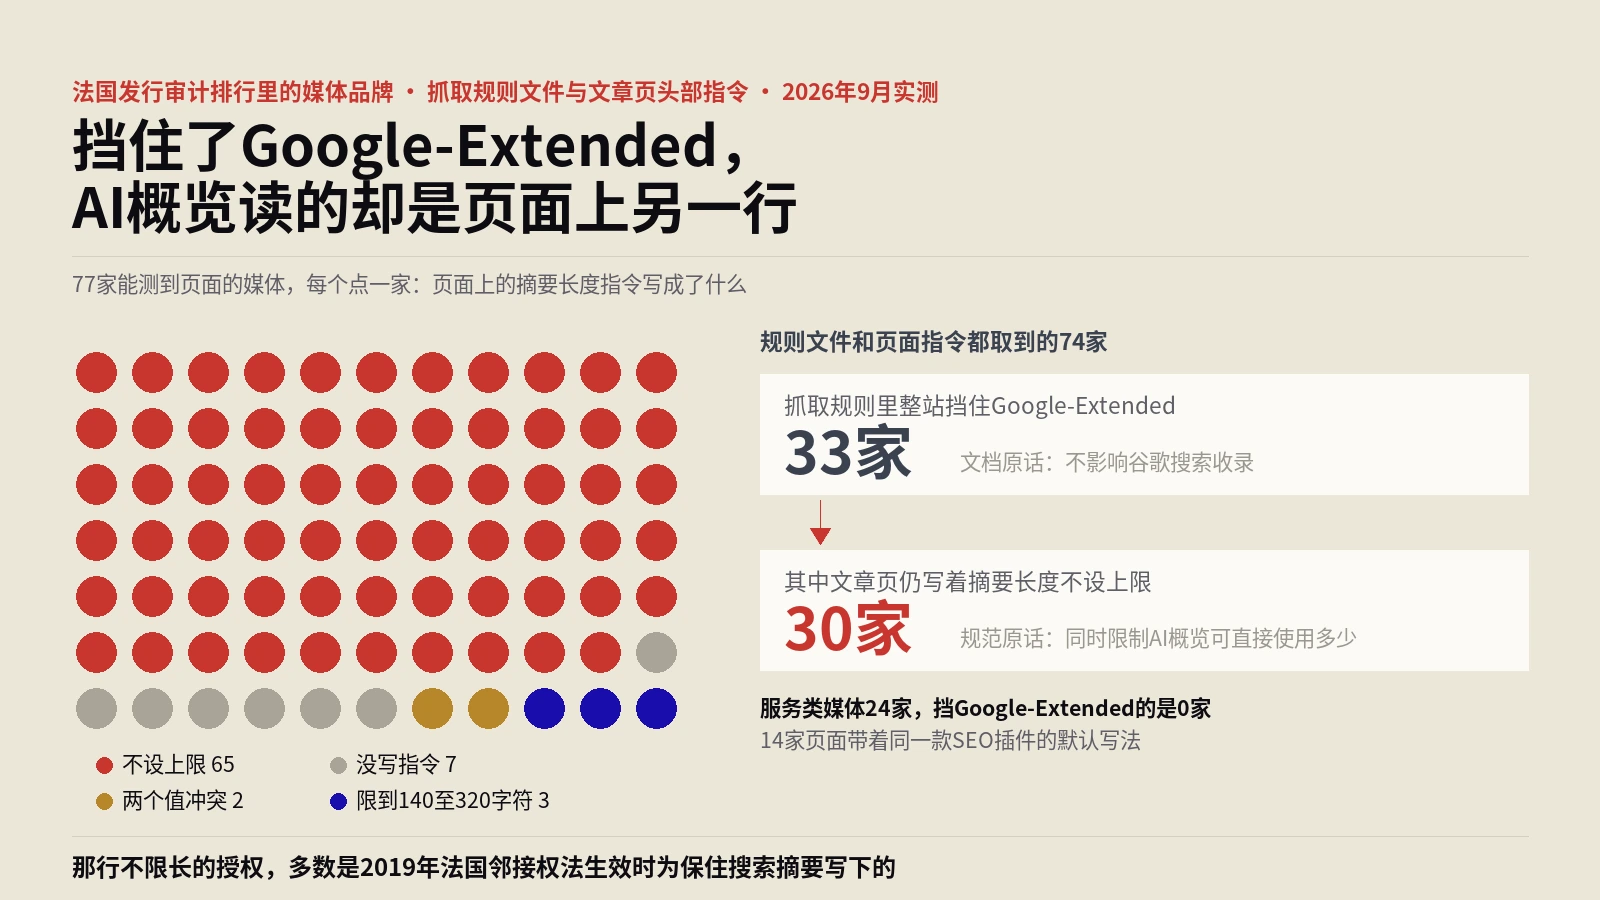
核对办法:从法国发行审计机构八月数字品牌排行里挑出98个媒体品牌,逐家取回抓取规则文件与文章页头部的摘要指令,被防护挡住的用真浏览器补抓;再对照谷歌指令规范、爬虫文档、新闻授权计划说明与2019年法国预览政策,判断每条设置实际管到哪里。
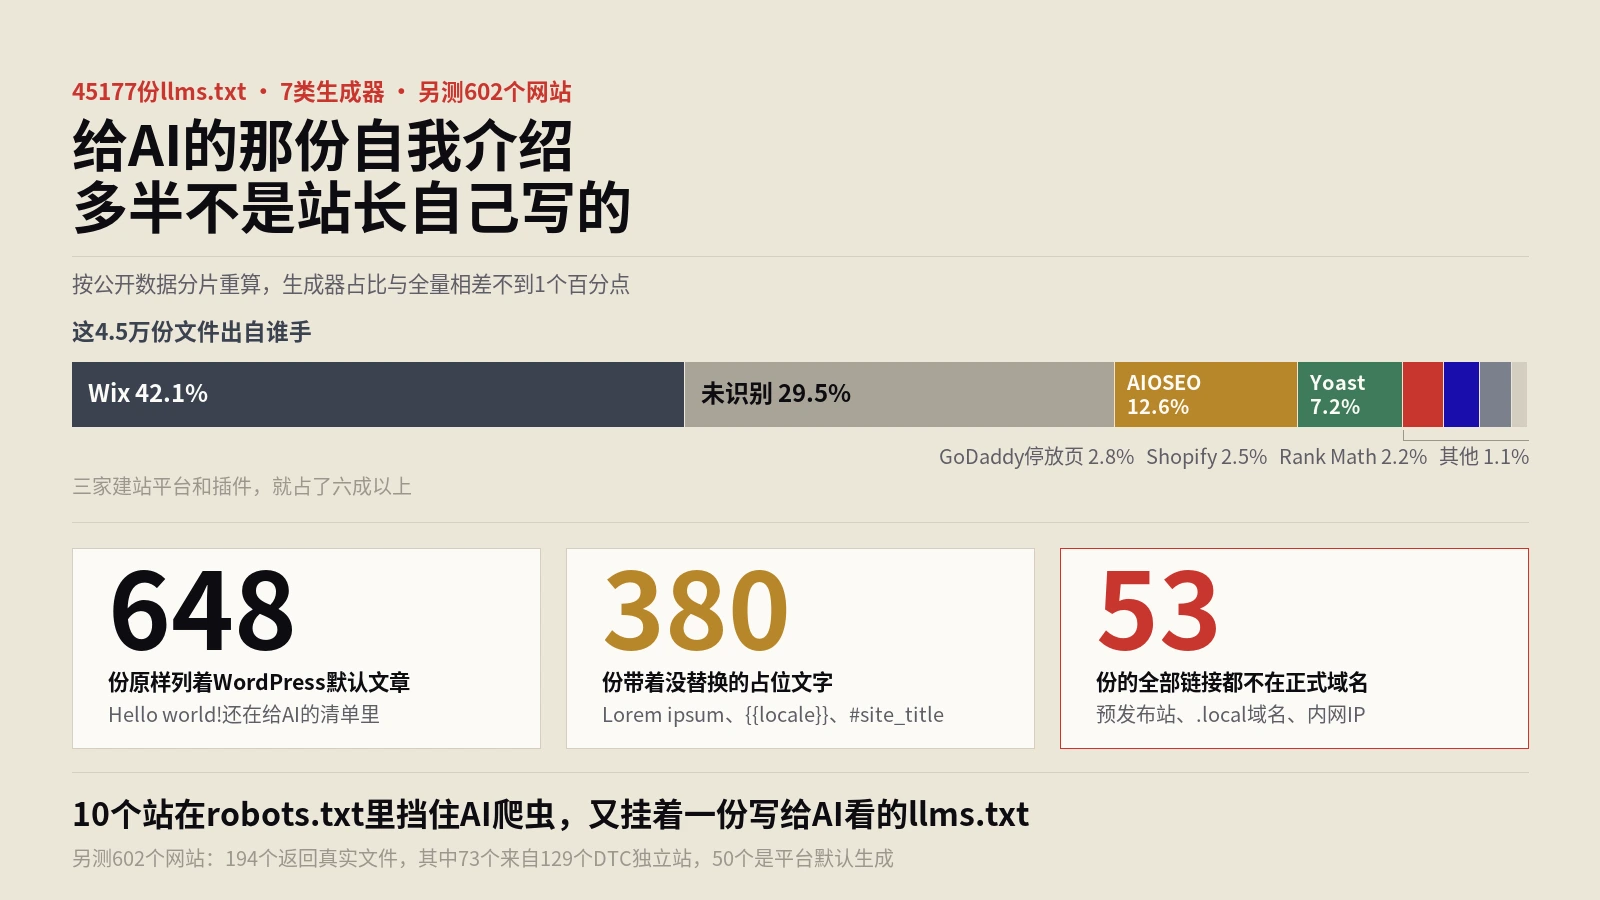
做法:下载Common Crawl公开的llms.txt数据分片,按署名与结构骨架识别生成器,逐份检查默认示例文章、未替换占位符、链接主机是否为预发布或本地地址、政策性语句;另抓602个网站的llms.txt与robots.txt逐条对照,并对抽样链接做两轮存活复测。
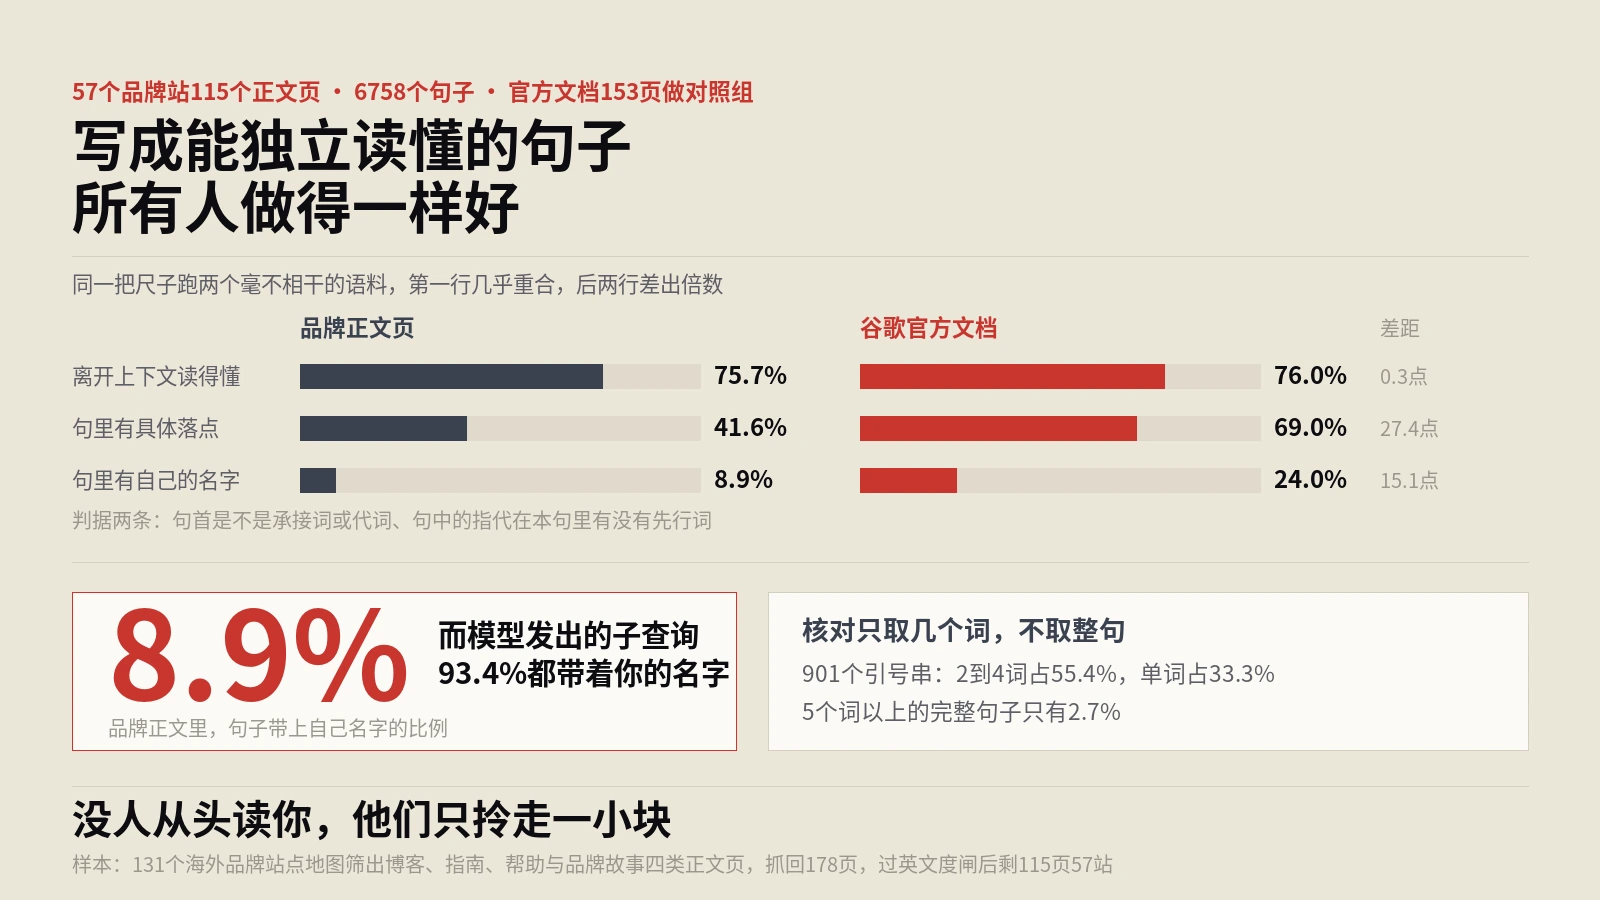
测法写清楚了好复现:从131个站的站点地图筛出博客、指南、帮助与品牌故事四类正文页,低并发抓回178页,先过一道英文度闸剔掉非英文页,再剔掉跨页样板句,最后按句首承接、悬空指代、具名落点、品牌落款四条规则逐句判定,并用谷歌官方文档的153个页面跑同一把尺子做对照。
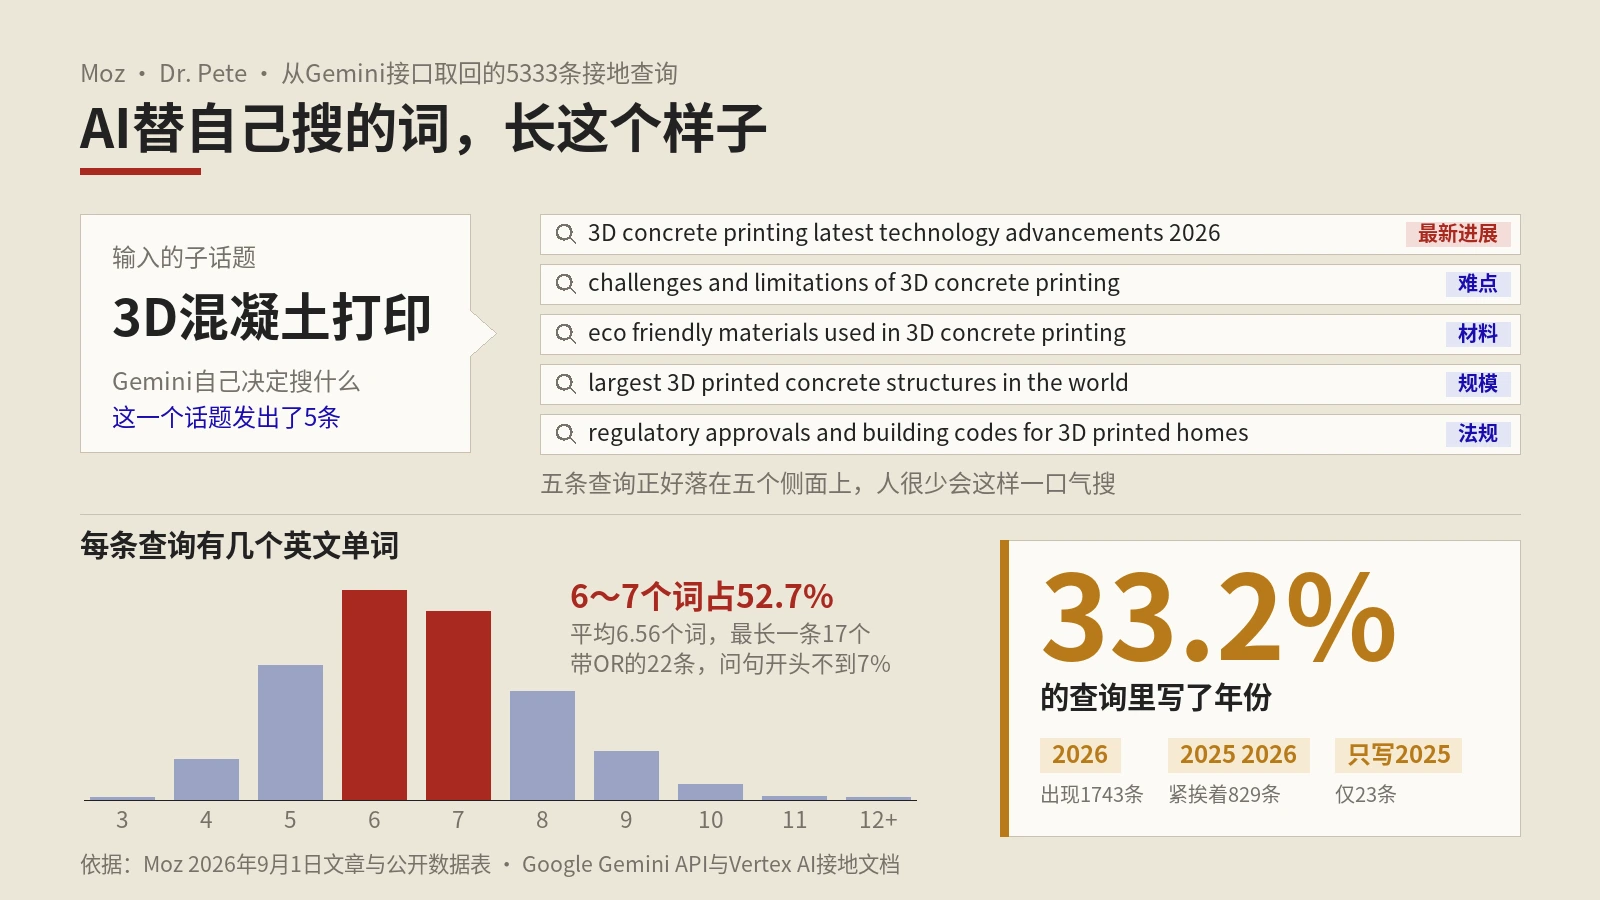
以Moz的Dr. Pete文章和他公开的数据表为主体,重算查询长度分布、年份写法和高频侧面词,对照Vertex AI文档里groundingMetadata的四个字段与搜索建议展示规定,比较Gemini 3按查询和Gemini 2.5按提示两种计费,并给出外贸站按侧面补内容的五步用法。
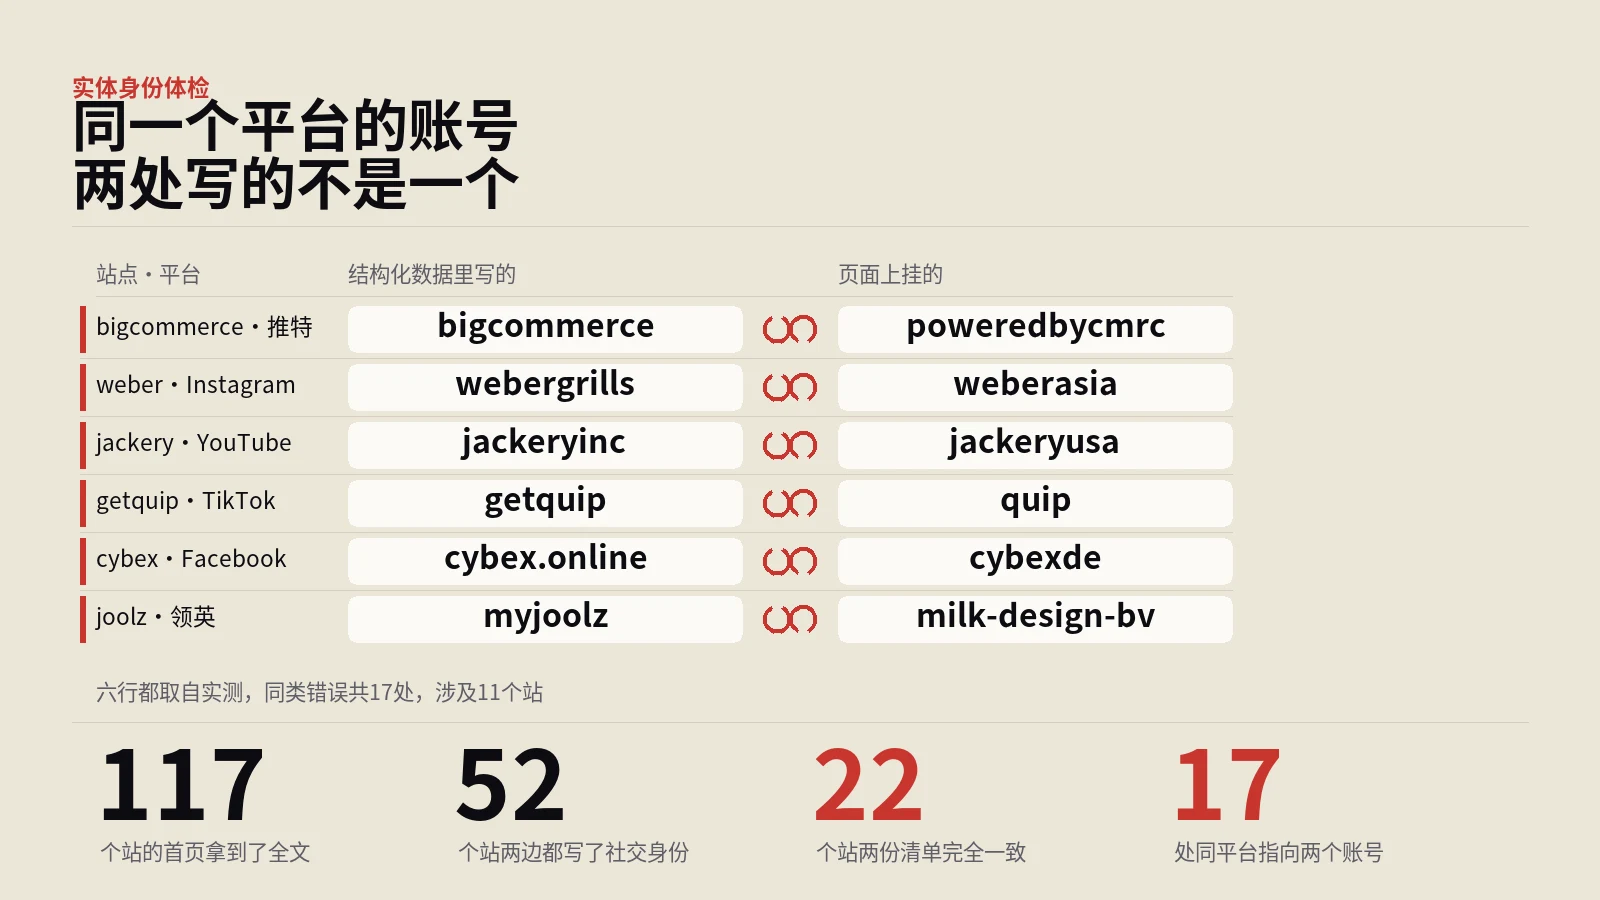
做法是只抓首页一次,把结构化数据里的sameAs、页面上的社交链接和twitter:site三份一起取出来就地比对,先归一到平台粒度再逐个对账号,全程不去社交平台验活。平台判定表里一条写法把整个google.com都吞了进去,凭空造出八个站的Google+残留,修完只剩一个。
要判断一段内容的来源能不能被核实,有一套可以照着跑的量法。先把目标站的首页抓下来存成文件,从中取出机器可读的结构化数据块,把代表组织的那个实体找出来;然后逐字段清点有无,把字段按外人能不能独立查证排成一列——名称和描述属于纯自述,网址和标志一点就知道,关联主页要去对面看,法定名称和税号能在登记处查;最后画出填写率随可核验度变化的那条线,看它在哪一档出现断崖。整套逻辑不到两百行,唯一要留神的是结构化数据的嵌套解析,只在顶层找会漏掉一大半样…
