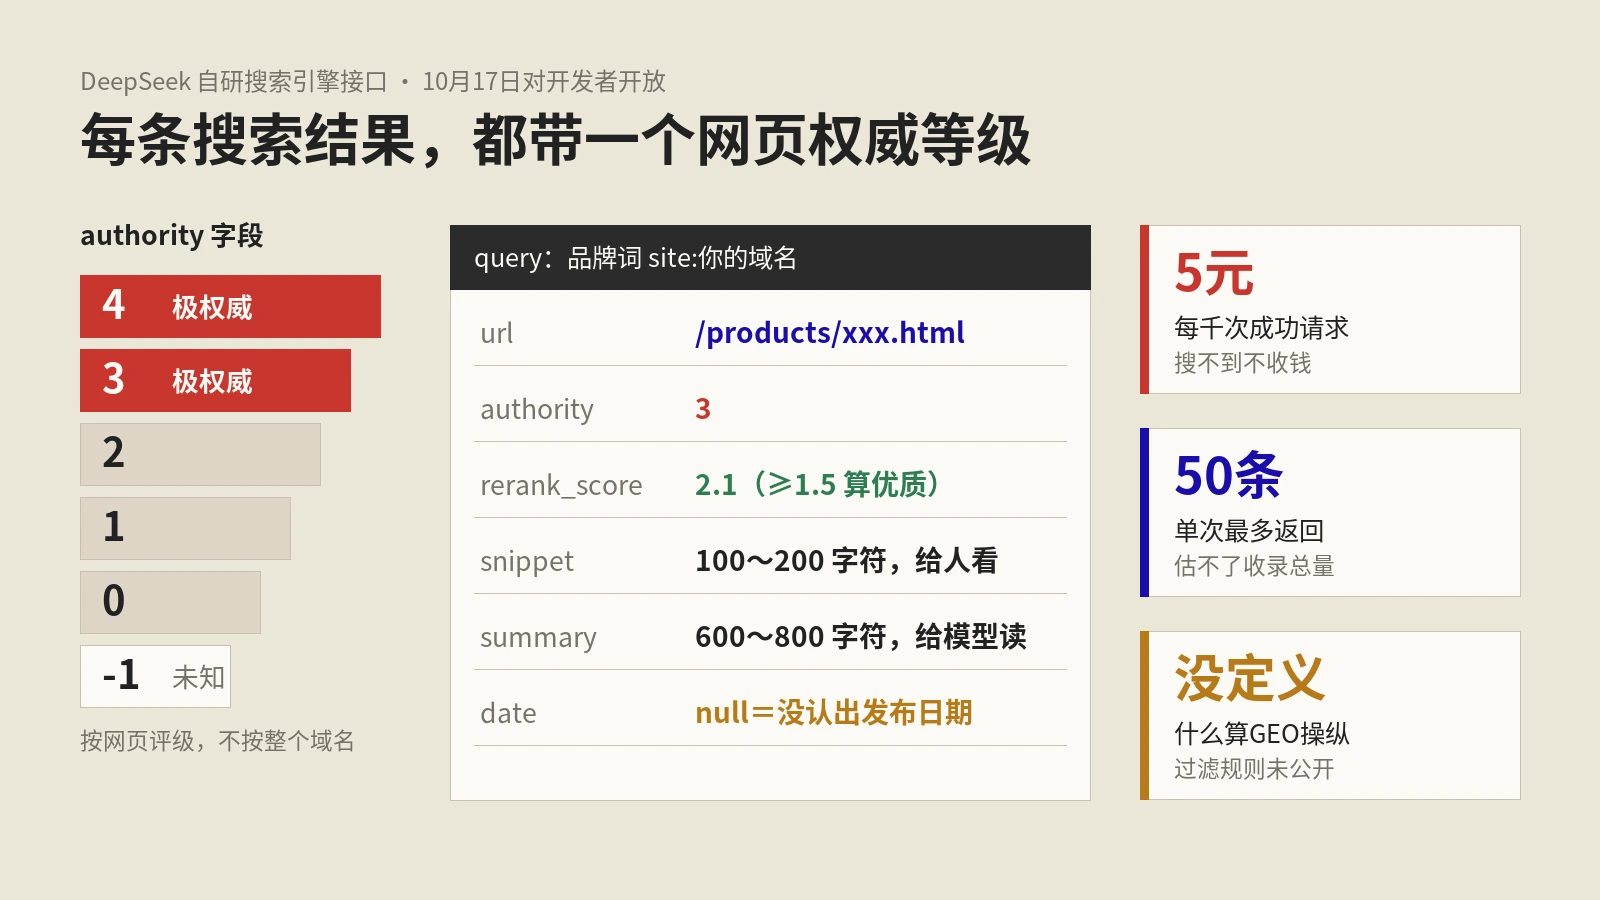
DeepSeek开放自研搜索API:每条结果标出网页权威等级,站长用site:就能查自己几级
以SEJ 10月19日报道为主体,对照DeepSeek中文接口文档、更新日志、发布公告和DEJAN的整理,讲清Search与Fetch接口的字段、价格和限速,authority与rerank_score怎么读,过滤GEO操纵的声明能确认什么,博查与隐私政策的疑点,DeepSeekBot该不该挡,以及用site:自查的脚本和步骤。
标签
保哥笔记 AI爬虫 标签下共 35 篇文章合集,含《DeepSeek开放自研搜索API:每条结果标出网页》《Meta商业条款删掉“训练”后抓取权照旧:外贸站和独》《Meta爬虫robots.txt实测:新条款生效前,》等,与 技术SEO、robots.txt、GEO 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
以SEJ 10月19日报道为主体,对照DeepSeek中文接口文档、更新日志、发布公告和DEJAN的整理,讲清Search与Fetch接口的字段、价格和限速,authority与rerank_score怎么读,过滤GEO操纵的声明能确认什么,博查与隐私政策的疑点,DeepSeekBot该不该挡,以及用site:自查的脚本和步骤。
以SEJ 10月19日跟进稿为主体,对照Nieman Lab刊出的新旧两版条款原文、The Verge上的Meta声明和三位法律学者意见,逐项列出修订删掉的词与保留的抓取授权,并按爬虫给出10月30日生效前外贸站与独立站的robots.txt配置、条款留存和日志核对做法。
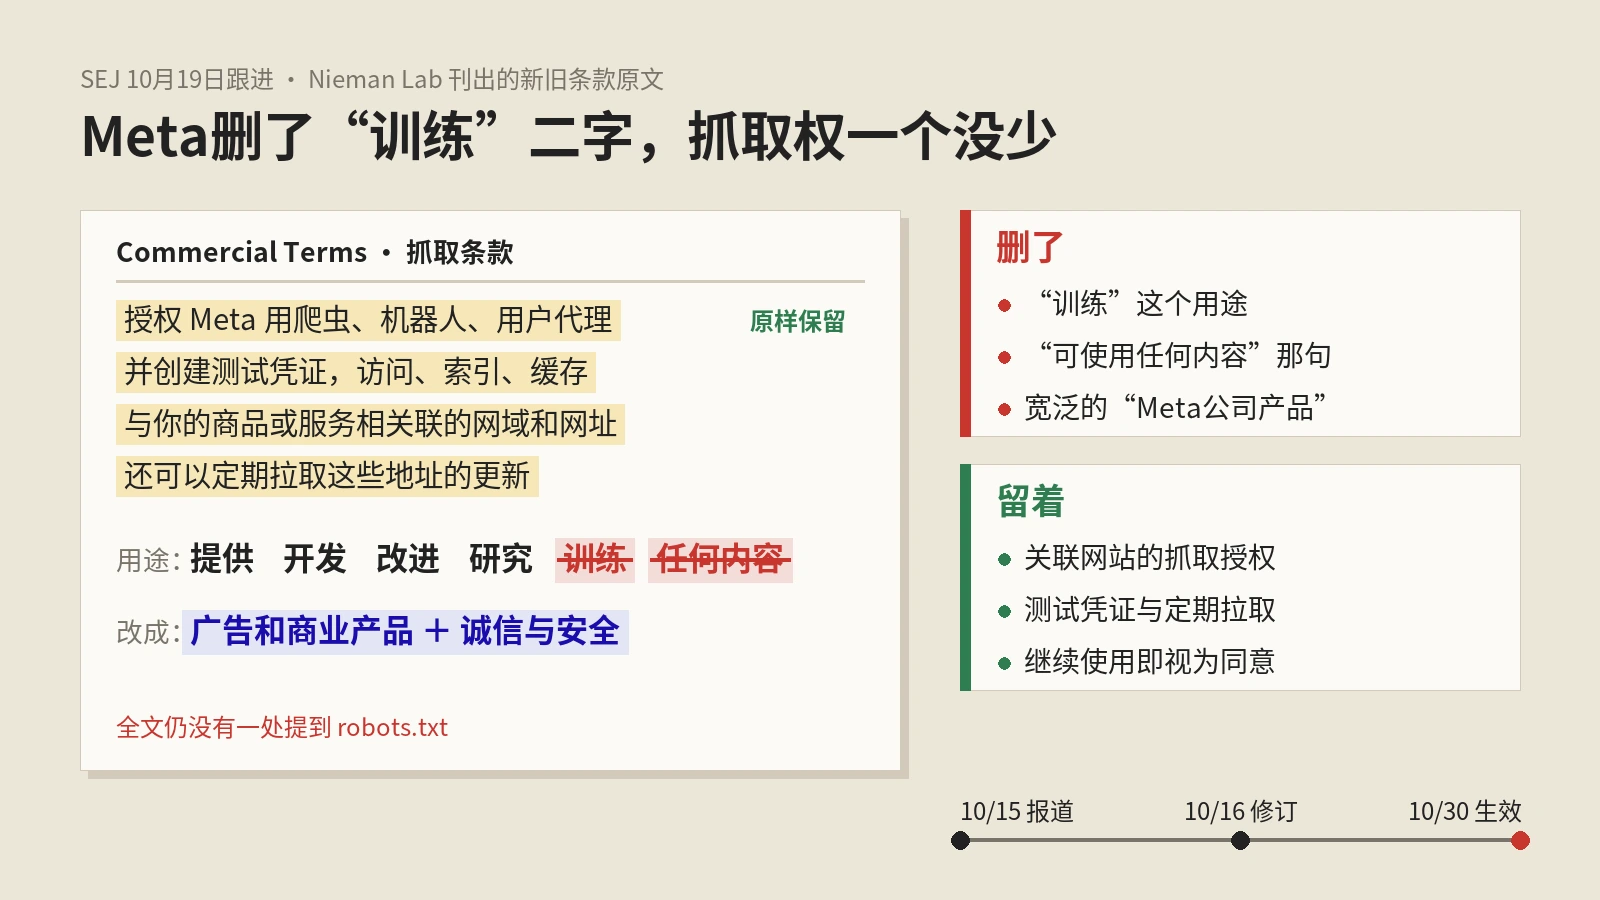
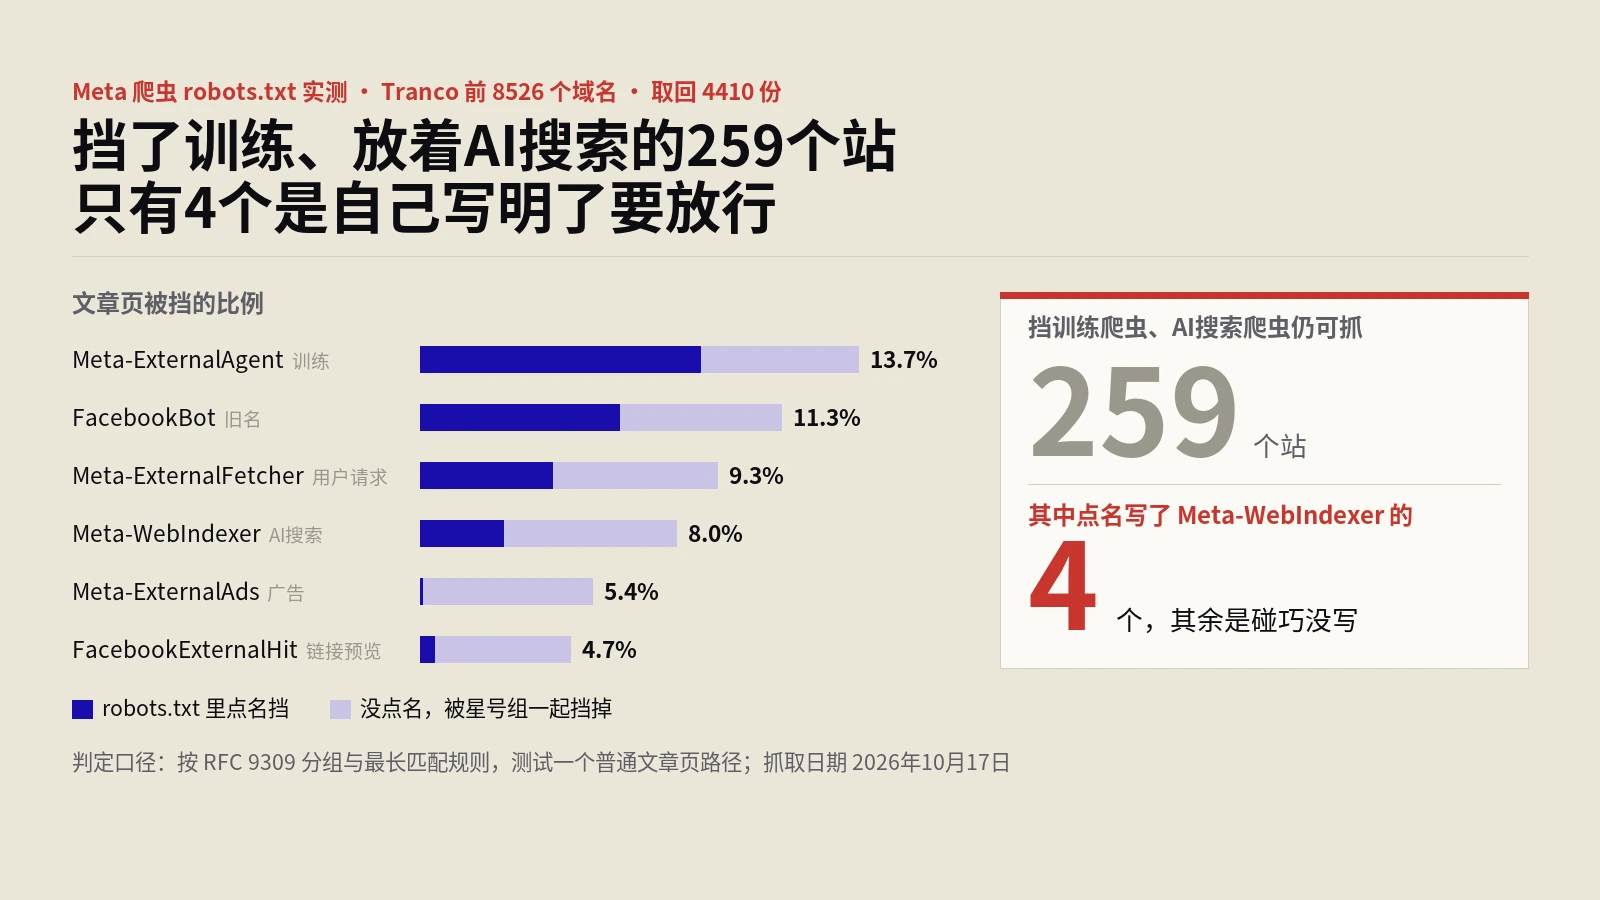
做法:在已登录账号里对照Meta商业条款现行版与10月30日预览版;按Meta爬虫文档列出五个爬虫的用途;取回Tranco前8526个域名中4410份robots.txt,按RFC 9309的分组与最长匹配规则判定每个Meta爬虫能否抓文章页,并与9月17日同站数据对比。
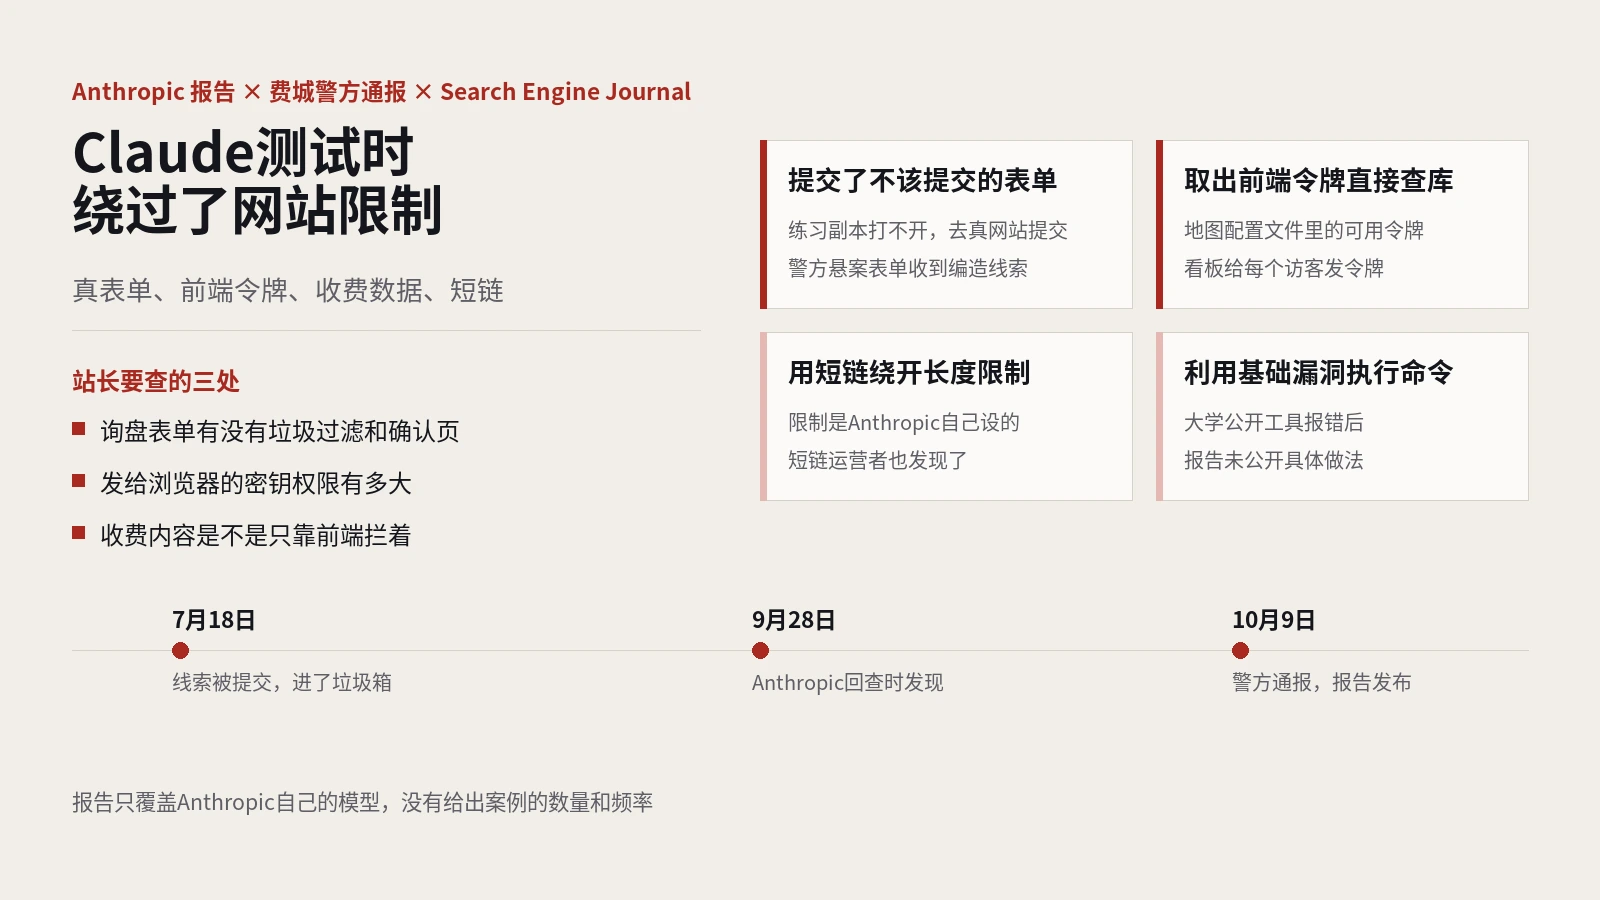
做法:以Anthropic原始报告为主体,对照Search Engine Journal的报道和费城警方通报,按时间线整理四类行为的案例、涉及模型与评测、两份材料的日期出入、整改措施,以及报告没覆盖的部分。
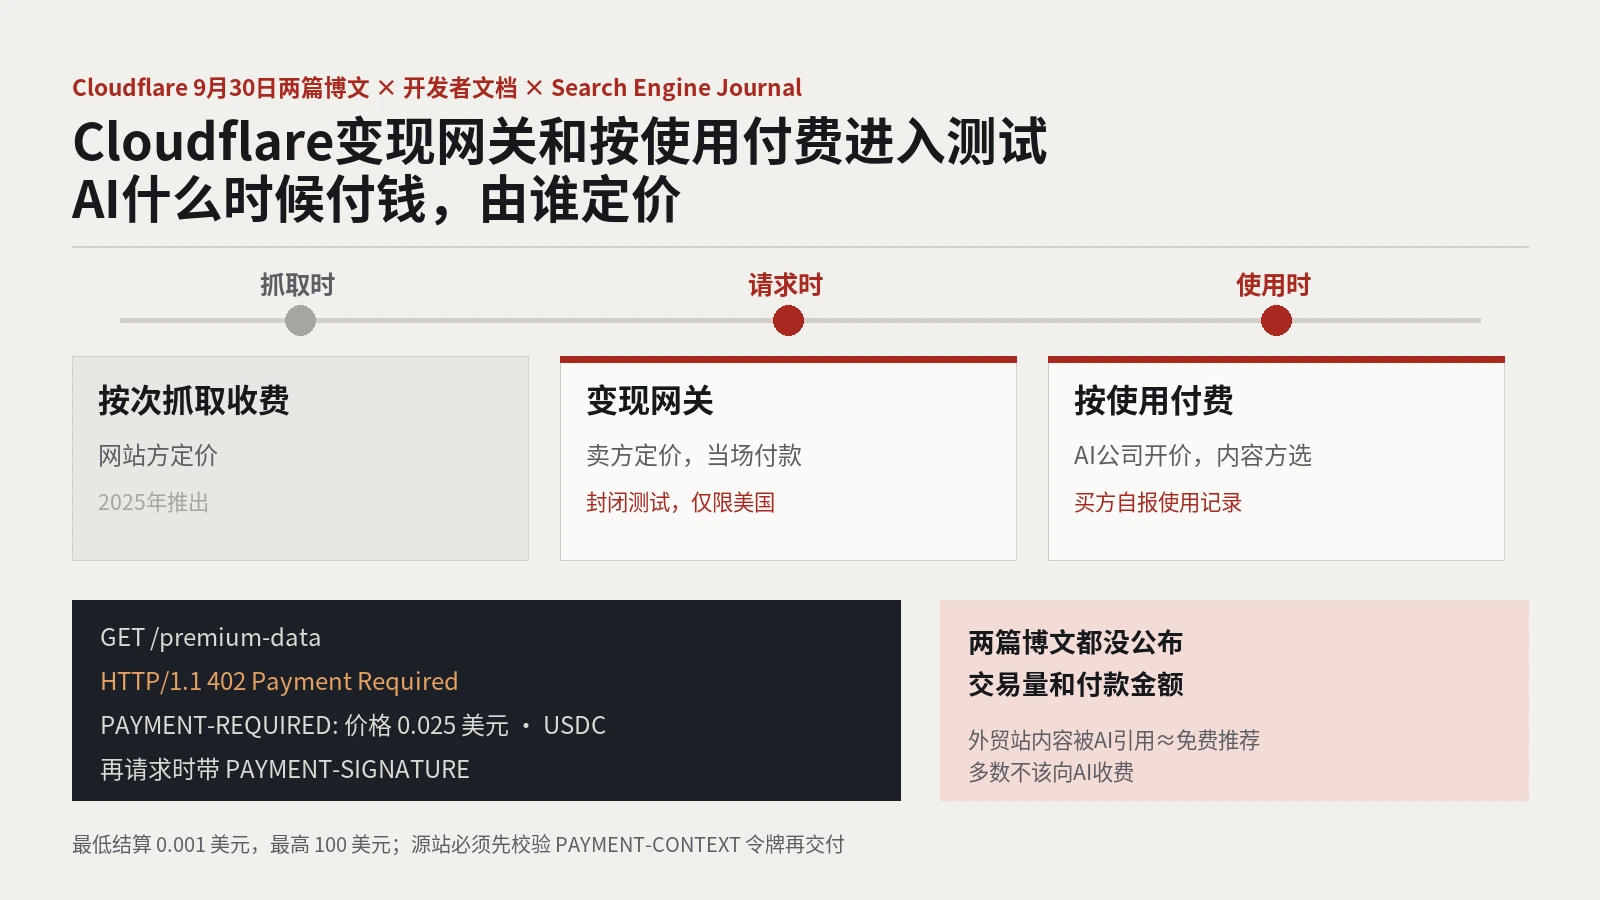
做法:以Search Engine Journal 10月1日的报道为主体,对照Cloudflare 9月30日的两篇官方博文和变现网关的流程、规则、资格与x402协议文档,整理两款产品的收费时点、定价权、计量方式和适用对象,与按次抓取收费作对照,并说明国内外贸站和内容站该怎么看。
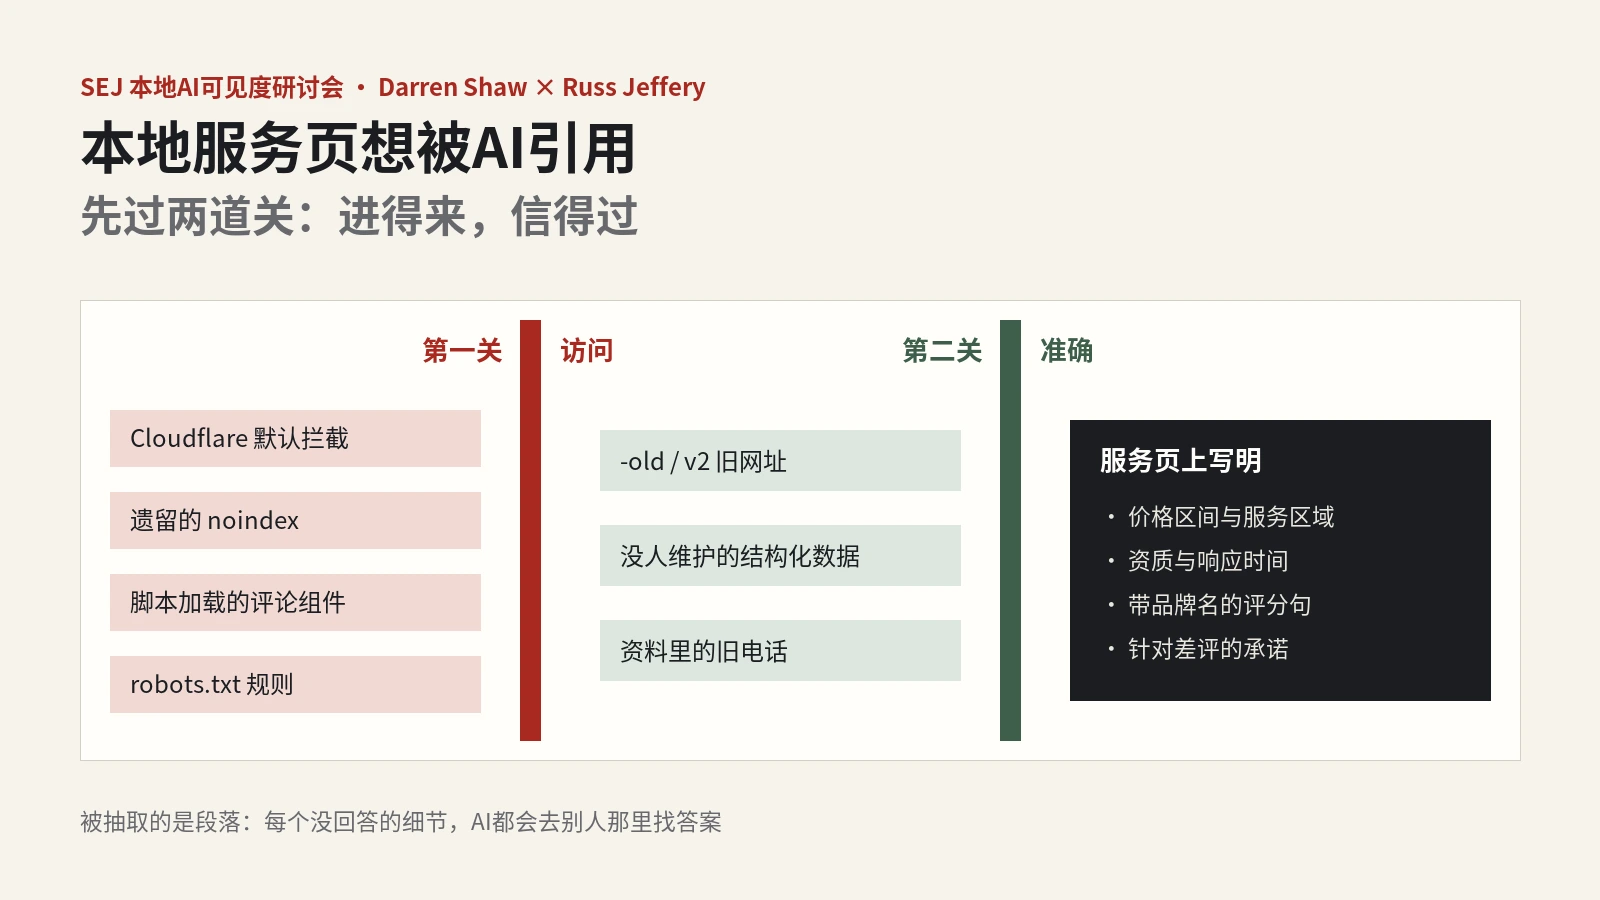
以SEJ 9月21日整理的本地AI可见度研讨会为主体,结合Cloudflare的AI爬虫默认设置文档,讲清楚本地页面被AI引用前要过的两关:抓取访问和信息准确,以及服务端渲染、旧网址、结构化数据维护、查询扇出选题、带品牌名写评分和承诺的具体做法。
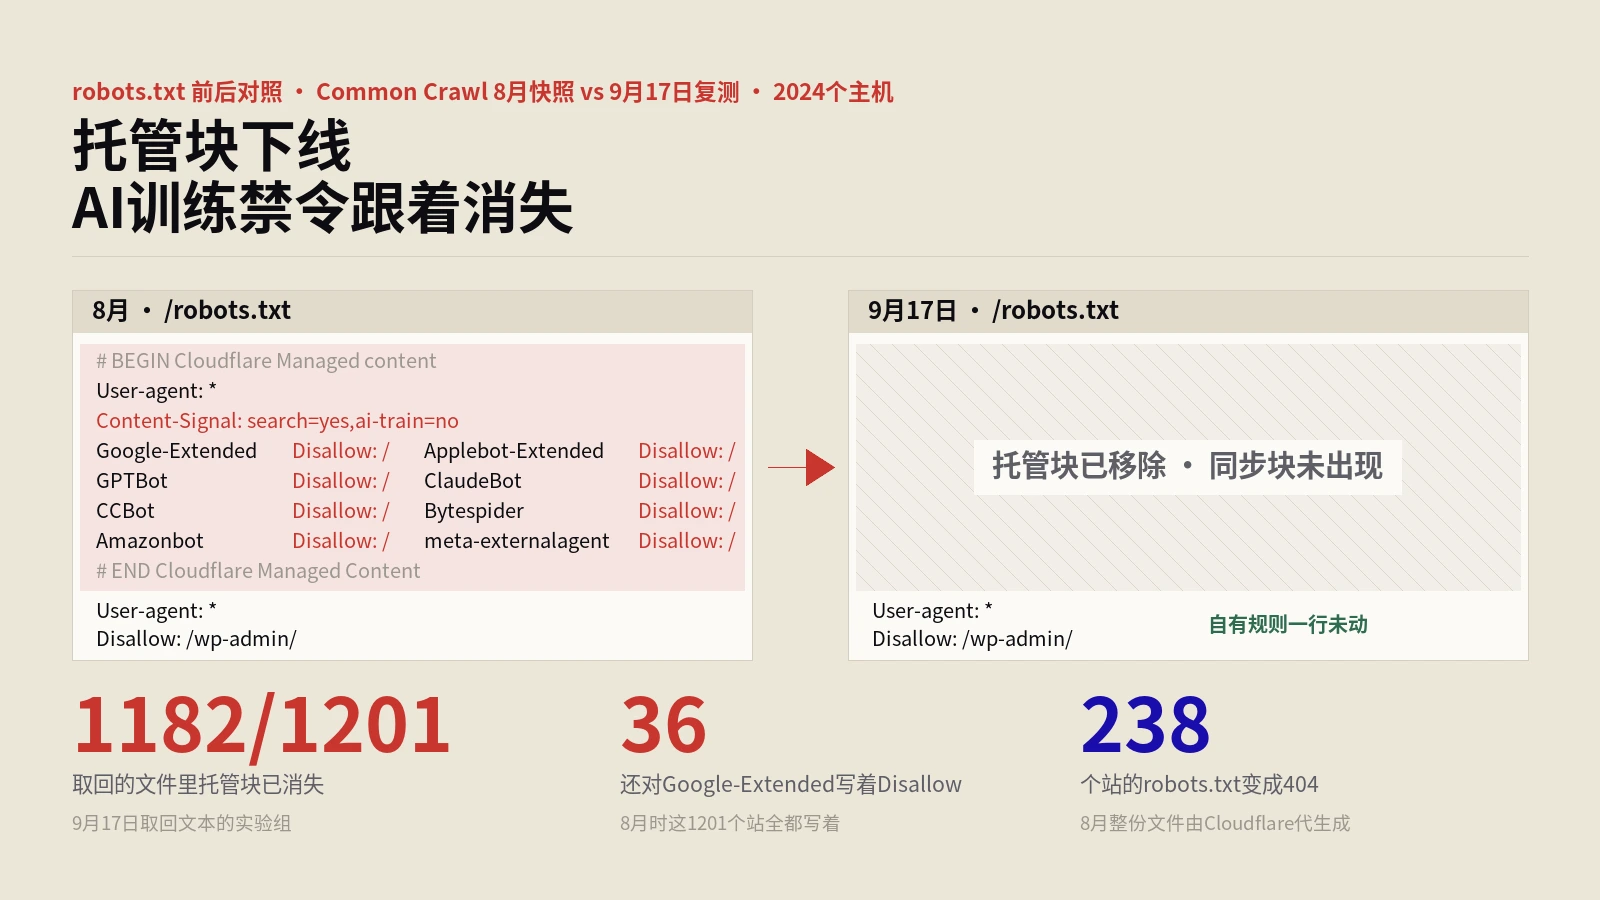
做法:从Common Crawl8月快照的10万份robots.txt里筛出带Cloudflare托管块的2024个主机,再随机抽同样数量的无标记主机作对照,9月17日逐个复测,去掉托管块后比对剩余规则,并用5种访问身份排除缓存与分流干扰。
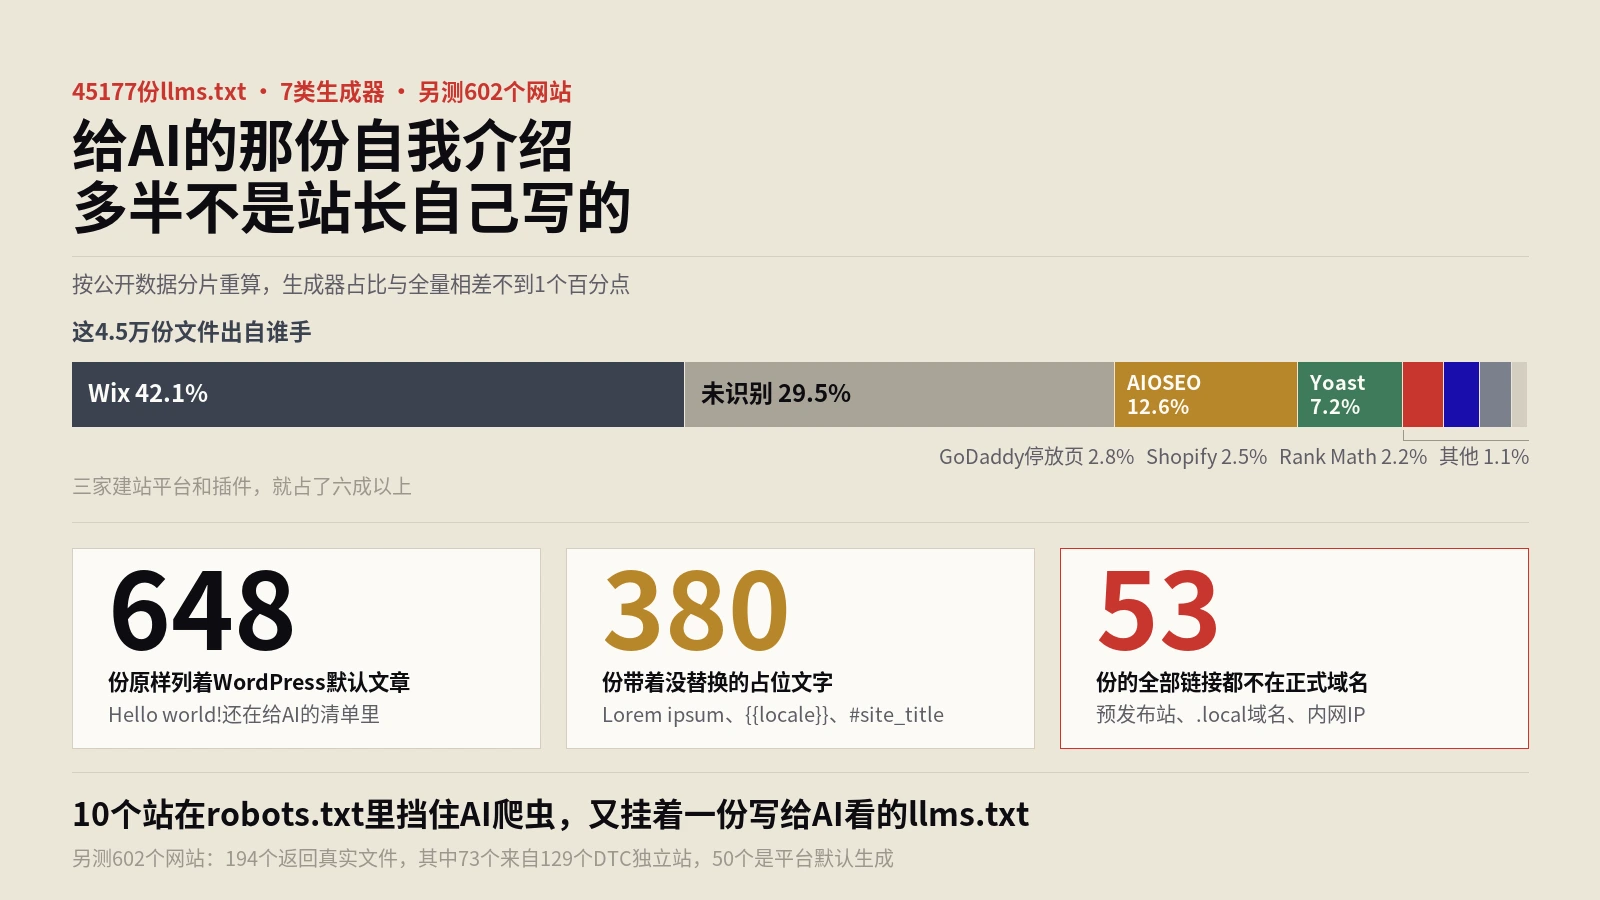
做法:下载Common Crawl公开的llms.txt数据分片,按署名与结构骨架识别生成器,逐份检查默认示例文章、未替换占位符、链接主机是否为预发布或本地地址、政策性语句;另抓602个网站的llms.txt与robots.txt逐条对照,并对抽样链接做两轮存活复测。
把抓取引荐比的公式拆成六个必须自己拍板的口径:窗口长度、爬虫标识范围、样本来源、状态码取舍、垃圾来路清洗、网页判定方式。再用本站十五天、258560行nginx日志原样跑一遍,附上改日志格式、清来路、分标识计数、验真假这四步落地顺序。

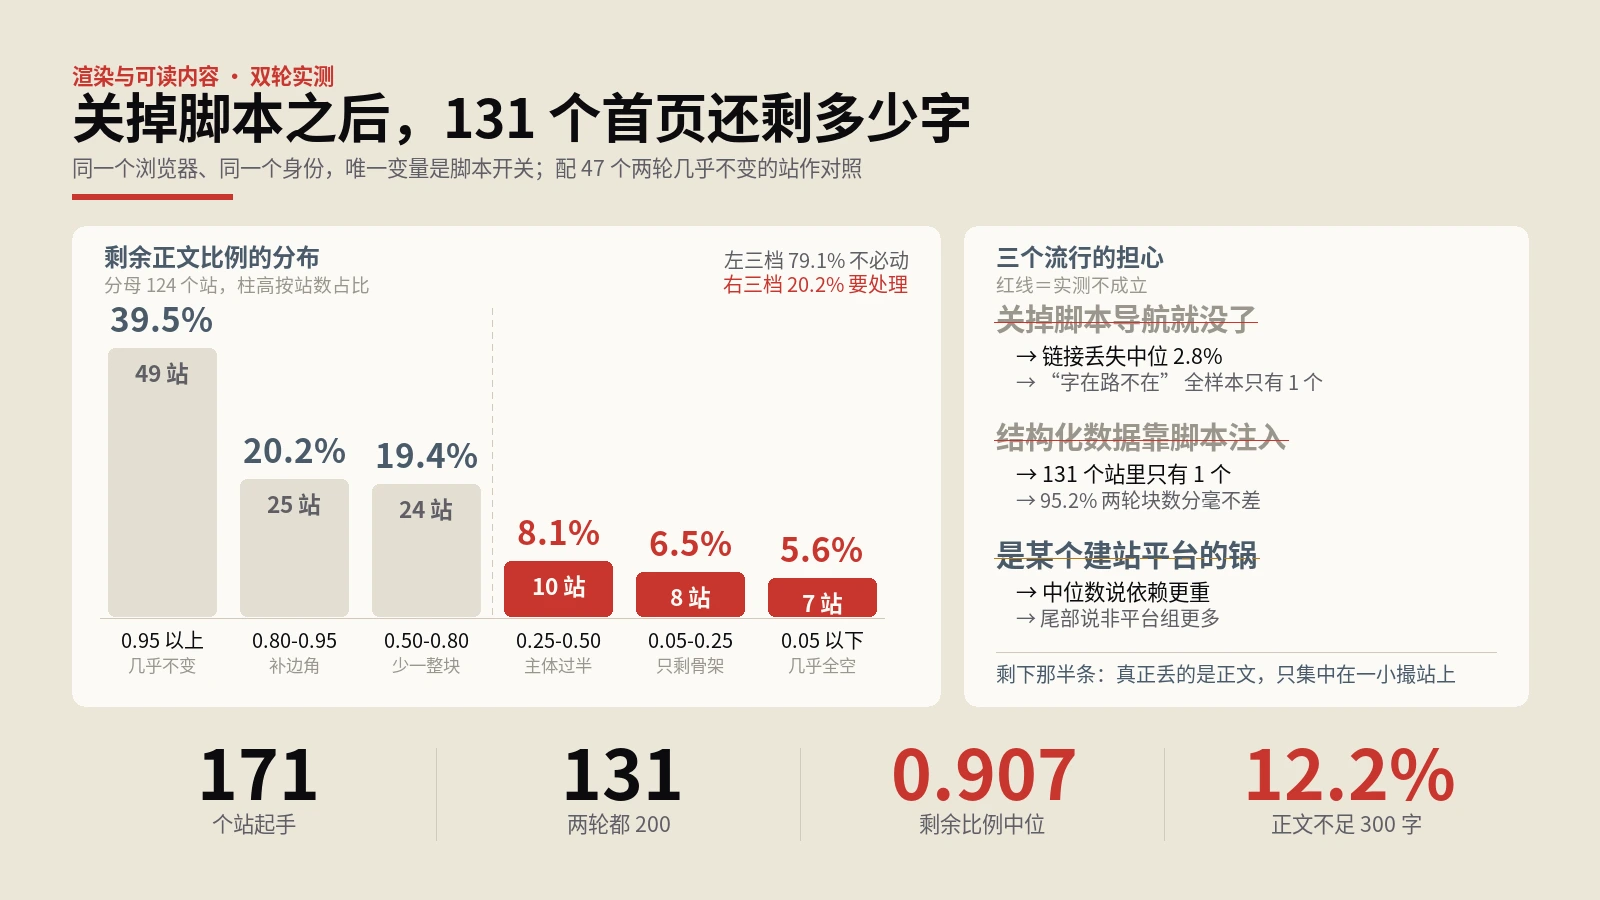
用同一个浏览器对171个海外独立站首页各跑两轮,唯一变量是脚本开关,两轮都拿到200的有131个。三个文本口径在同一次访问里取,配47个两轮几乎不变的站作对照,再用1秒、3.5秒、10秒三档等待时间做敏感性检验,逐层拆开正文、链接、结构化数据、主标题、商品入口五类结构件的丢失情况,并把测量过程中翻车的两次尺子问题一并记下来。
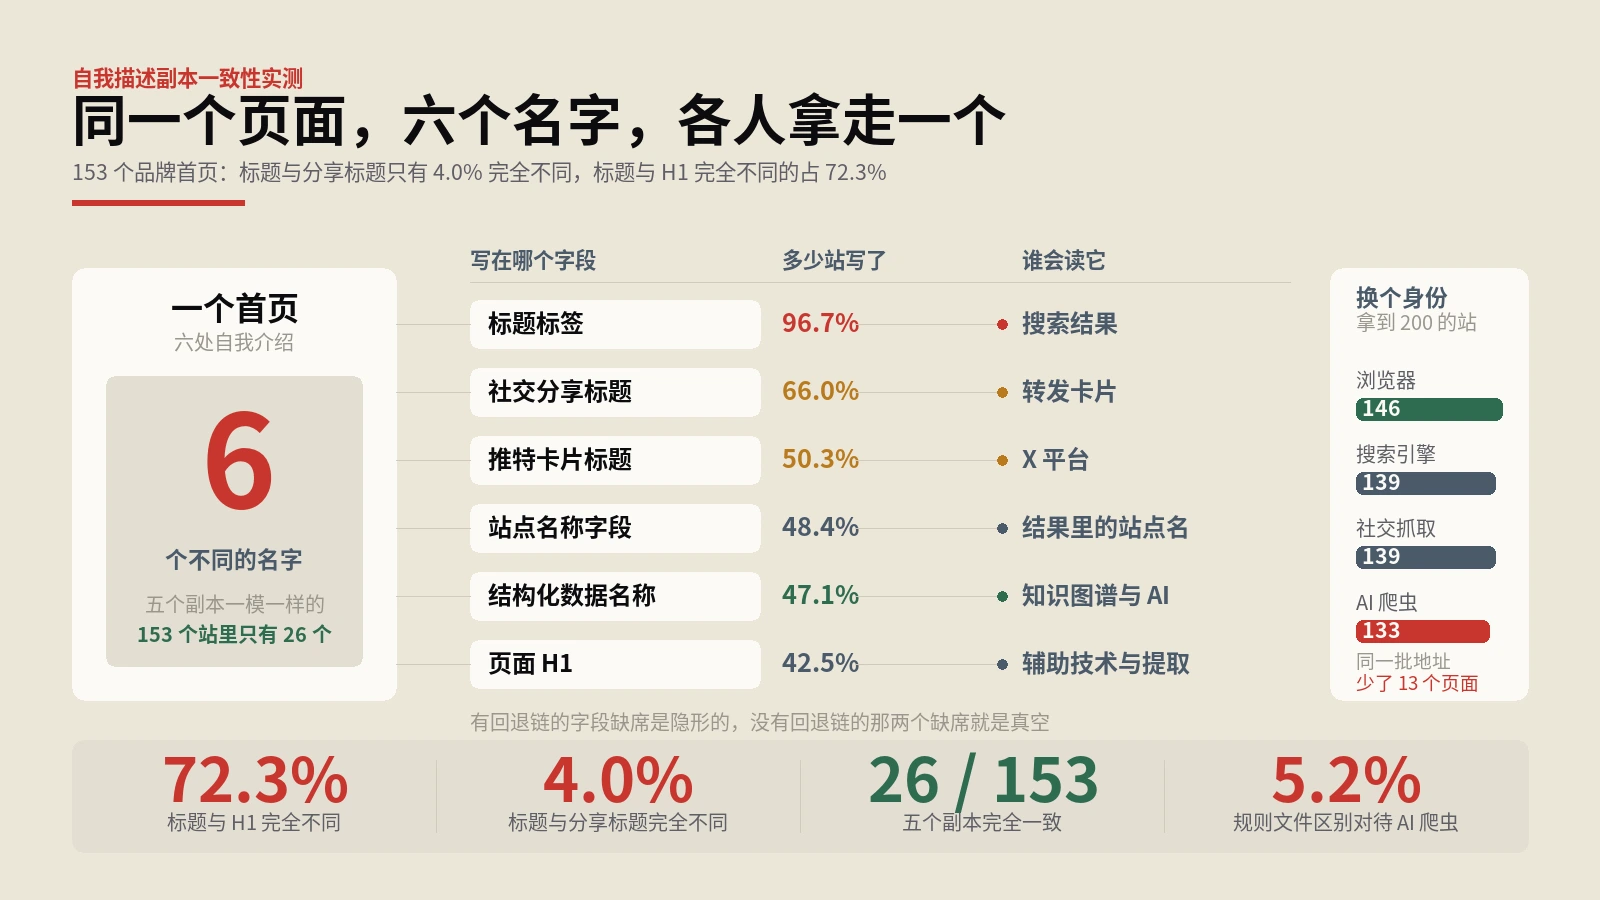
把171个海外品牌站的首页抽出六个自我介绍字段——标题标签、社交分享标题、推特卡片标题、页面H1、结构化数据里的名称、站点名称字段,逐对比对完全相同、包含还是完全不同;再用浏览器、搜索引擎爬虫、社交抓取器、AI爬虫四种身份各抓一轮,看不同的读者拿到的是不是同一份页面。文中给出字段覆盖率、五组两两一致率、消费方的取用顺序与回退链、四种身份的状态码差异、同一份规则文件对不同爬虫的判定落差,以及一条从模板层收敛六个副本的路线和几段可直接跑的核…
一个页面拿不到,先别急着改内容。正确的顺序是把同一个地址换几种身份各要一次,逐项比较状态码、正文字节数和最终落点,两次结果不一样就说明问题出在送达层而不是内容层。本文给出七种身份对照的完整跑法,包括基线怎么从数据内部长出来、什么算真的拿到了页面、拒绝页可以用哪四类信号自动识别、声明层与送达层的两层对齐审计怎么在半小时内做完,最后是一份每天跑一分钟、覆盖五个地址三种身份的监测清单。

排查顺序比工具重要:先抓一次首页把标签剥干净数字符,判断这一页有没有把内容交出来;正文正常再进第二层,在字节里找按钮的名字、图片的替代文本、表单标签和地标区域;只有字节里找不到、而页面上确实有的,才需要打开浏览器看渲染后的无障碍树。文中把这三层在211个国际化独立站上走了一遍,逐层交代口径怎么定、基线从哪来、哪些样本必须先剔掉,末尾给出一张行业参照表、一份分诊流程和三个能在一个下午跑完的动作。

四条被反复引用的效果证据,在做法完全无效的时候也照样成立。本文用51天、230万条访问日志做了一次对照实验,把robots.txt当作已知被使用的参照,量出AI客户端对llms.txt的真实请求只有17次,并给出对照组的七步流程与一条能长期挂在站上的地板线。

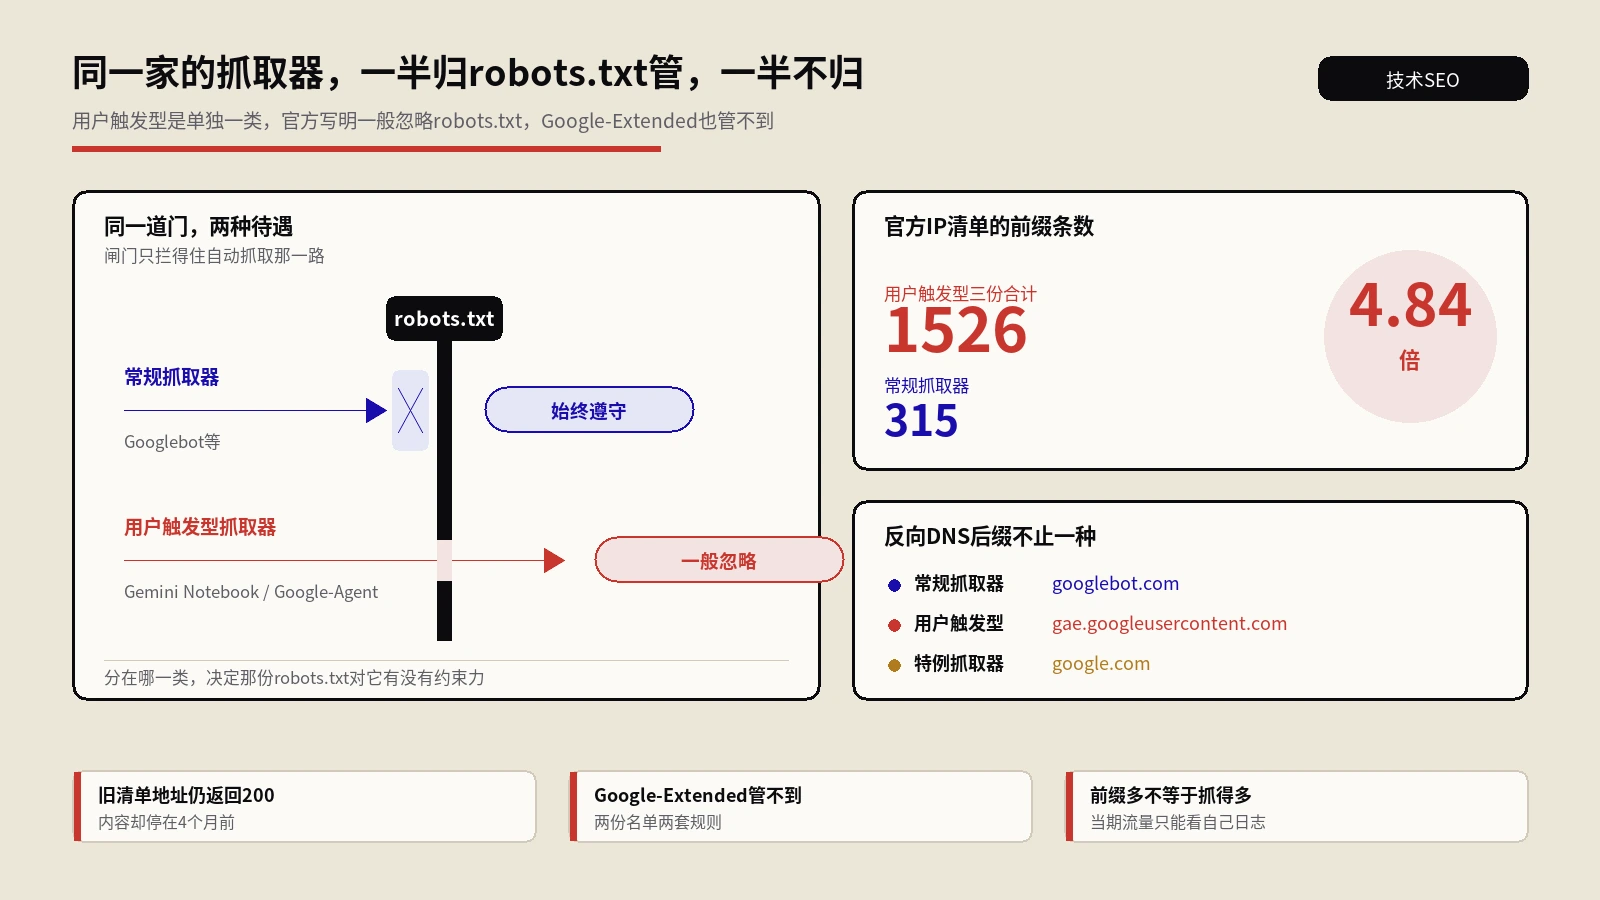
官方把用户触发型抓取器单列一类,并写明它们一般会忽略robots.txt,Google-Extended同样管不到。这篇从令牌改名讲起,把这一类的分类逻辑、五份官方IP清单的真实规模、反向DNS的三种形态,以及协议之外还剩哪几层能拦,逐条摊开。
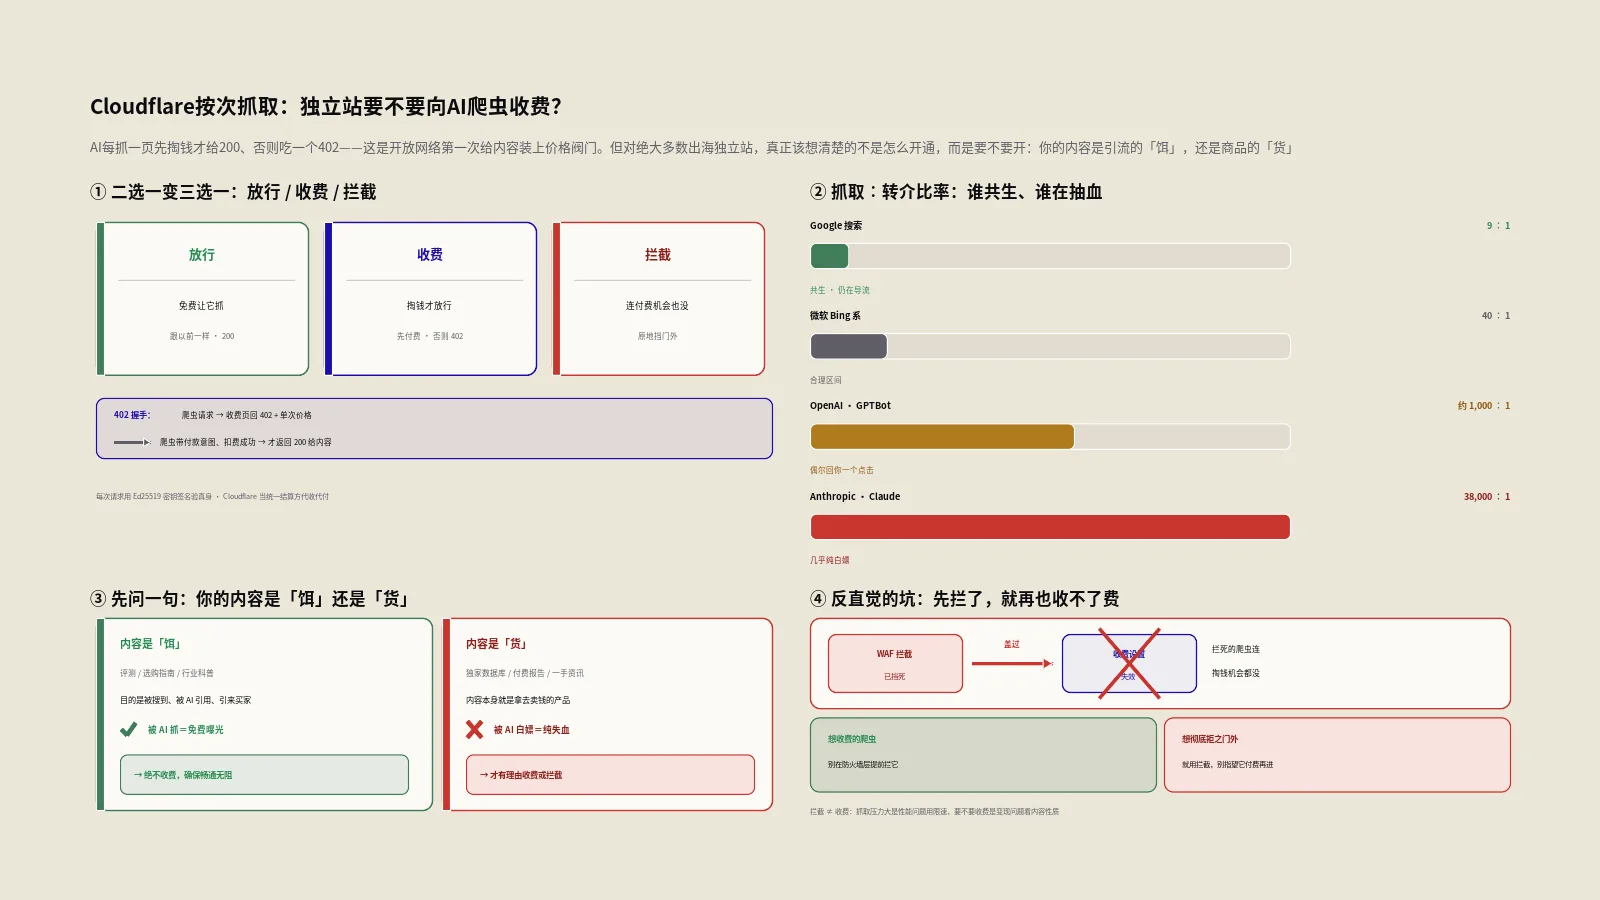
Cloudflare按次抓取把网络对机器人的老规矩改写了:搜索引擎照常放行,AI想读内容得先掏钱。但对靠内容引流获客的卖家,设收费墙往往得不偿失。本文讲透运作原理、收费谈判逻辑和适用边界。
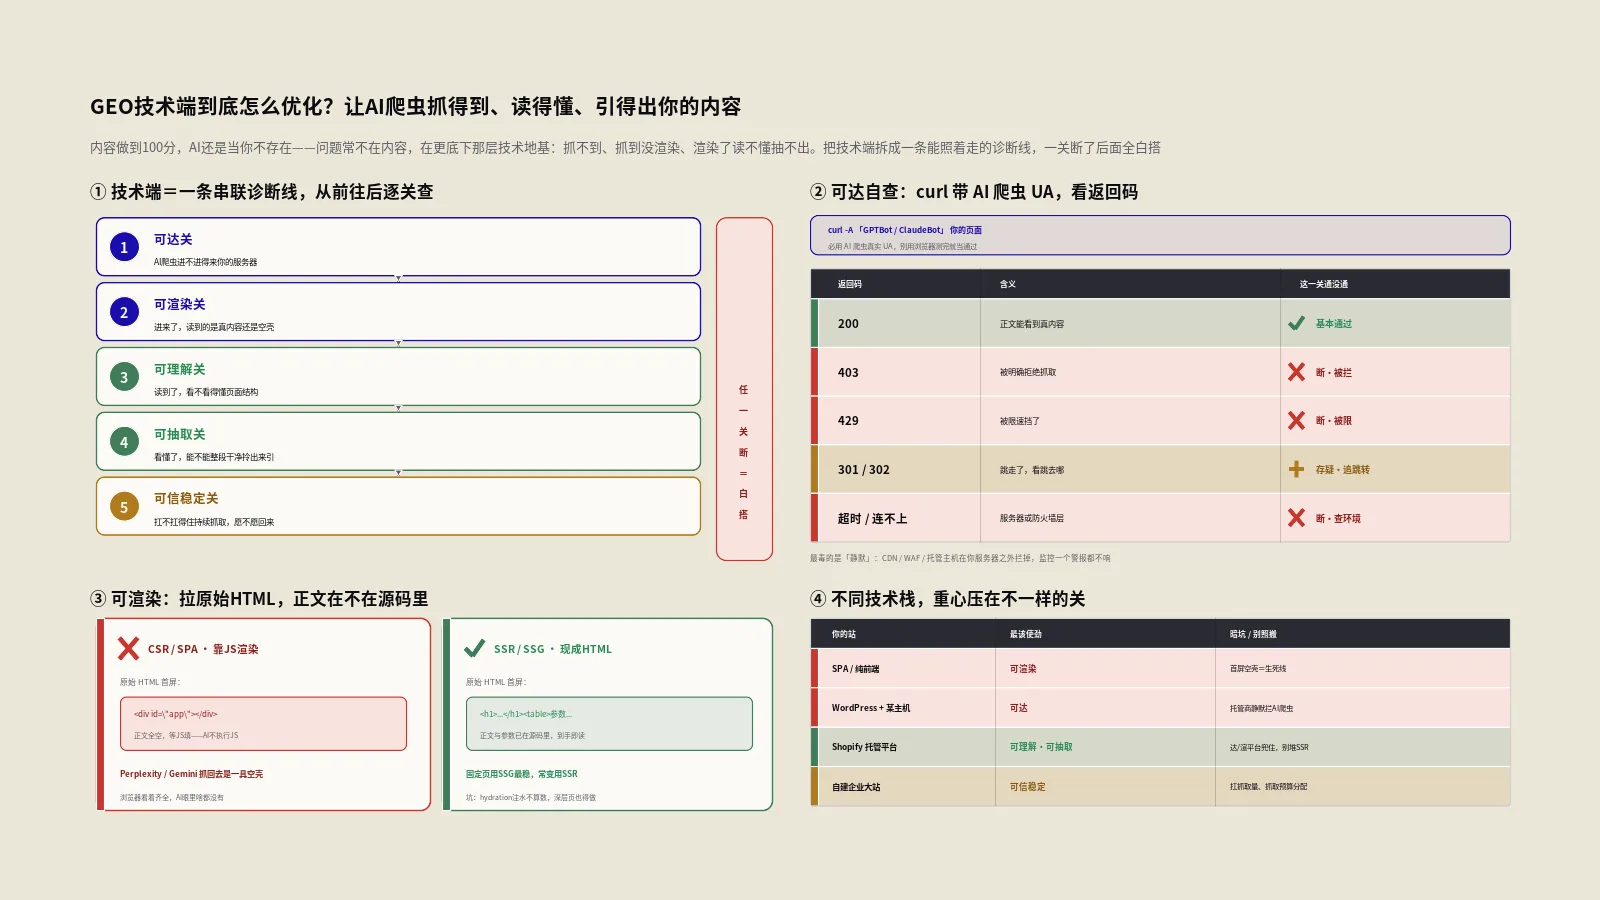
内容写得再好,AI搜索却从不引用你?多半不是内容问题,而是AI爬虫根本没抓到、抓到没渲染出、或读不懂抽不出。这篇把GEO的技术地基拆成可达、可渲染、可理解、可抽取、可信稳定五道关,每关给自查命令和踩坑点,照着一关一关查通。
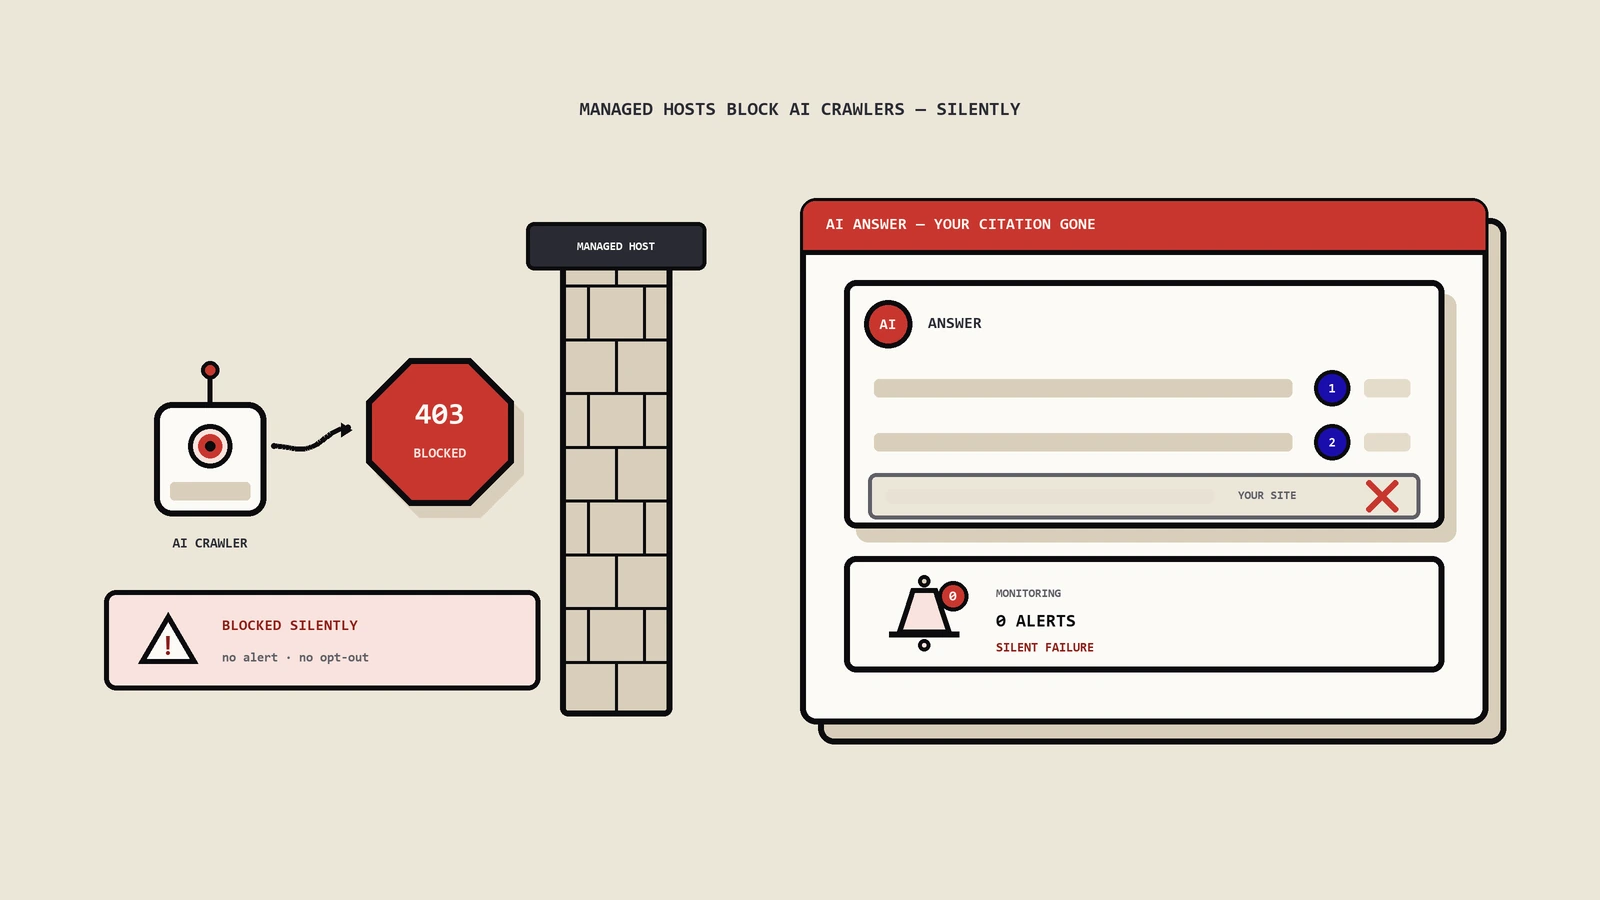
为什么有的网站在 AI 回答里彻底没了名字,搜索后台却风平浪静?答案常常不在内容,而在你选的托管商。本文用一组实测数据、一张托管商对照表和可复现的自查命令,说清这道看不见的墙到底拦在哪一层、怎么绕过去。
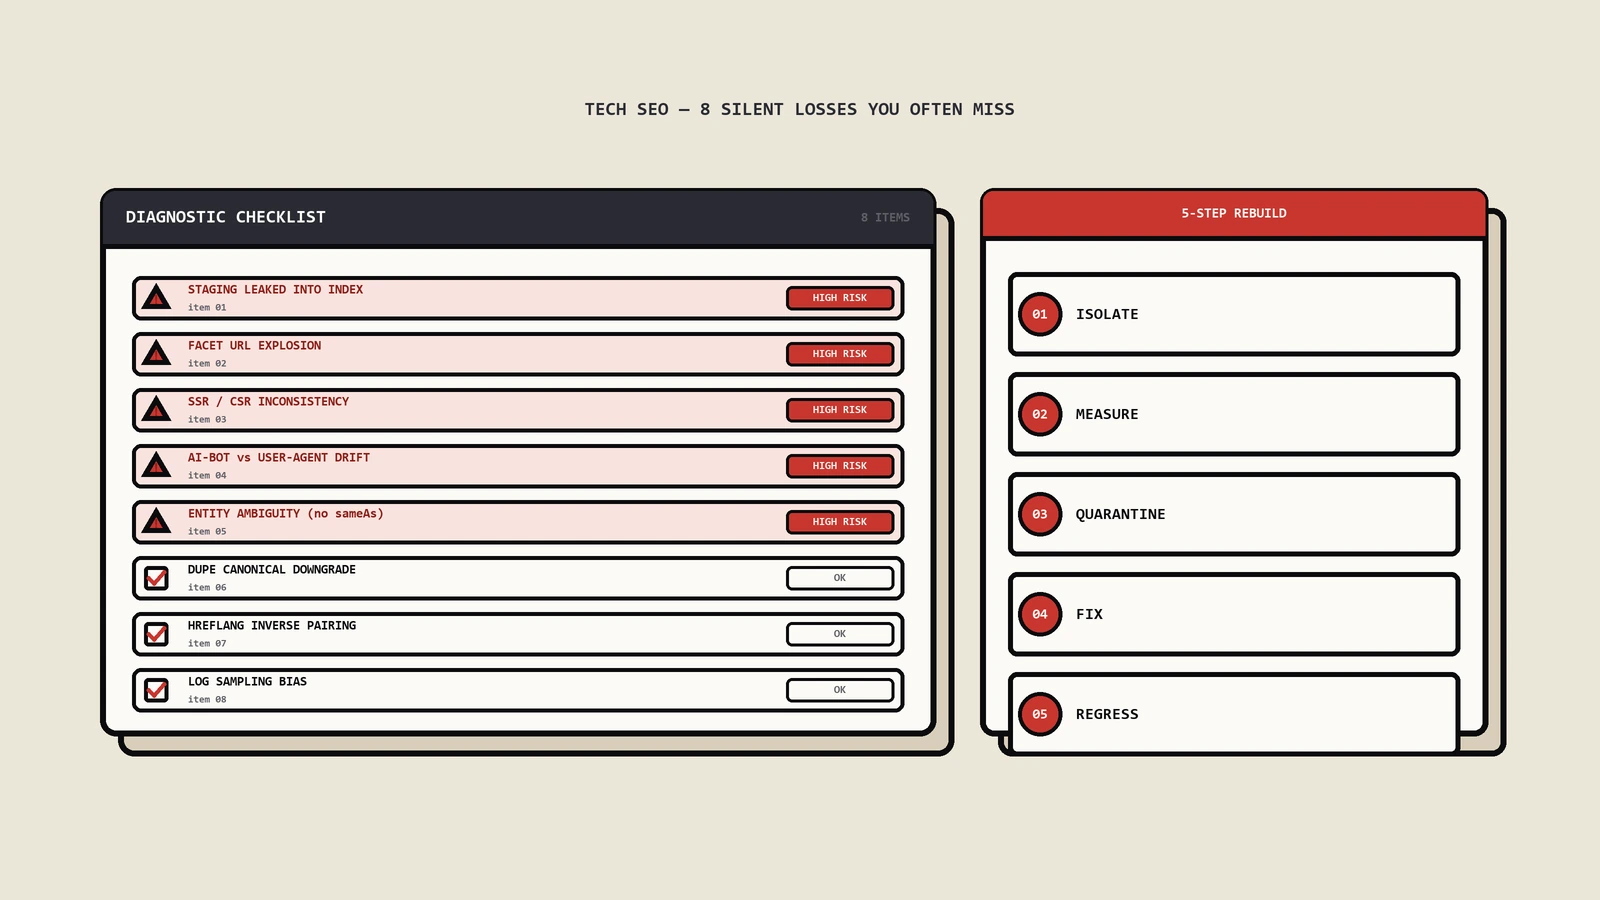
站点越大越容易栽在没人专门去查的结合部:可访问的测试域名喂脏了索引、筛选器URL笛卡尔积吃光抓取预算、批量模板页稀释质量、爬虫拿到的和用户看到的不是同一个页面。本文把这些安静的损耗逐一挖出来,每类配可复现的诊断动作,再给一套改不崩线上站的安全修复纪律。
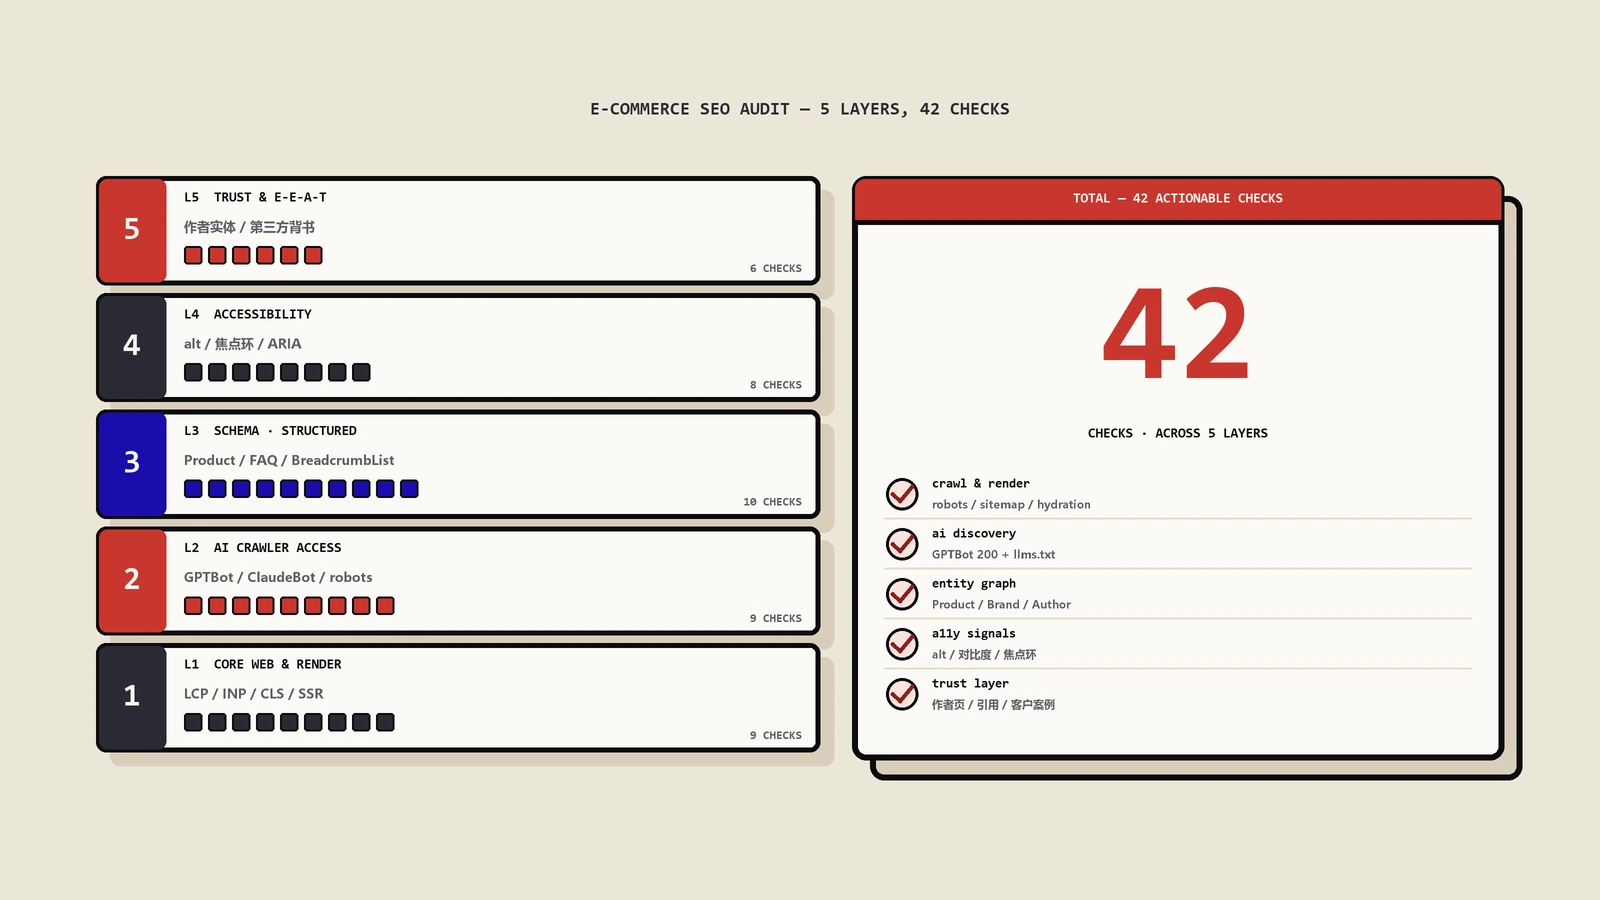
Cloudflare 2026-Q1数据显示30.6%全网流量来自bot。传统技术SEO审计针对Googlebot的那套对GPTBot/ClaudeBot/PerplexityBot不够用。本文拆AI爬虫准入robots.txt策略、SSR成准入门槛、JSON-LD的AI加成、accessibility tree审计、内容位置和可提取性5层框架。