Cloudflare托管robots.txt下线实测:1201个站的AI训练禁令同时消失
本文目录
- Cloudflare在2026年9月15日对AI爬虫设置做了哪些调整?
- 旧版托管robots.txt写了哪些AI训练禁令?
- 怎么判断托管块是在9月15日前后消失的?
- 8月带托管块的站点,9月17日的robots.txt变成了什么样?
- 自有规则保持不变、只少了托管块的站点占多少?
- 没有自有robots.txt的站点,托管功能下线后返回什么?
- Google-Extended和Applebot-Extended为什么只能写在robots.txt里?
- Bot Preference Sync的同步块在样本里出现了吗?
- 仍然保留旧托管块的站点是什么情况?
- 使用Cloudflare的站点现在应该核对什么?
- 常见问题解答
- Cloudflare托管robots.txt被弃用后,我的AI训练设置还有效吗?
- Disallow AI Training和Block有什么区别?
- 给Google-Extended写Disallow会影响谷歌搜索排名吗?
- robots.txt返回404会有什么影响?
- 怎么知道Bot Preference Sync有没有在我的站上生效?
- 必应现在怎么退出AI训练?
- 权威参考资料
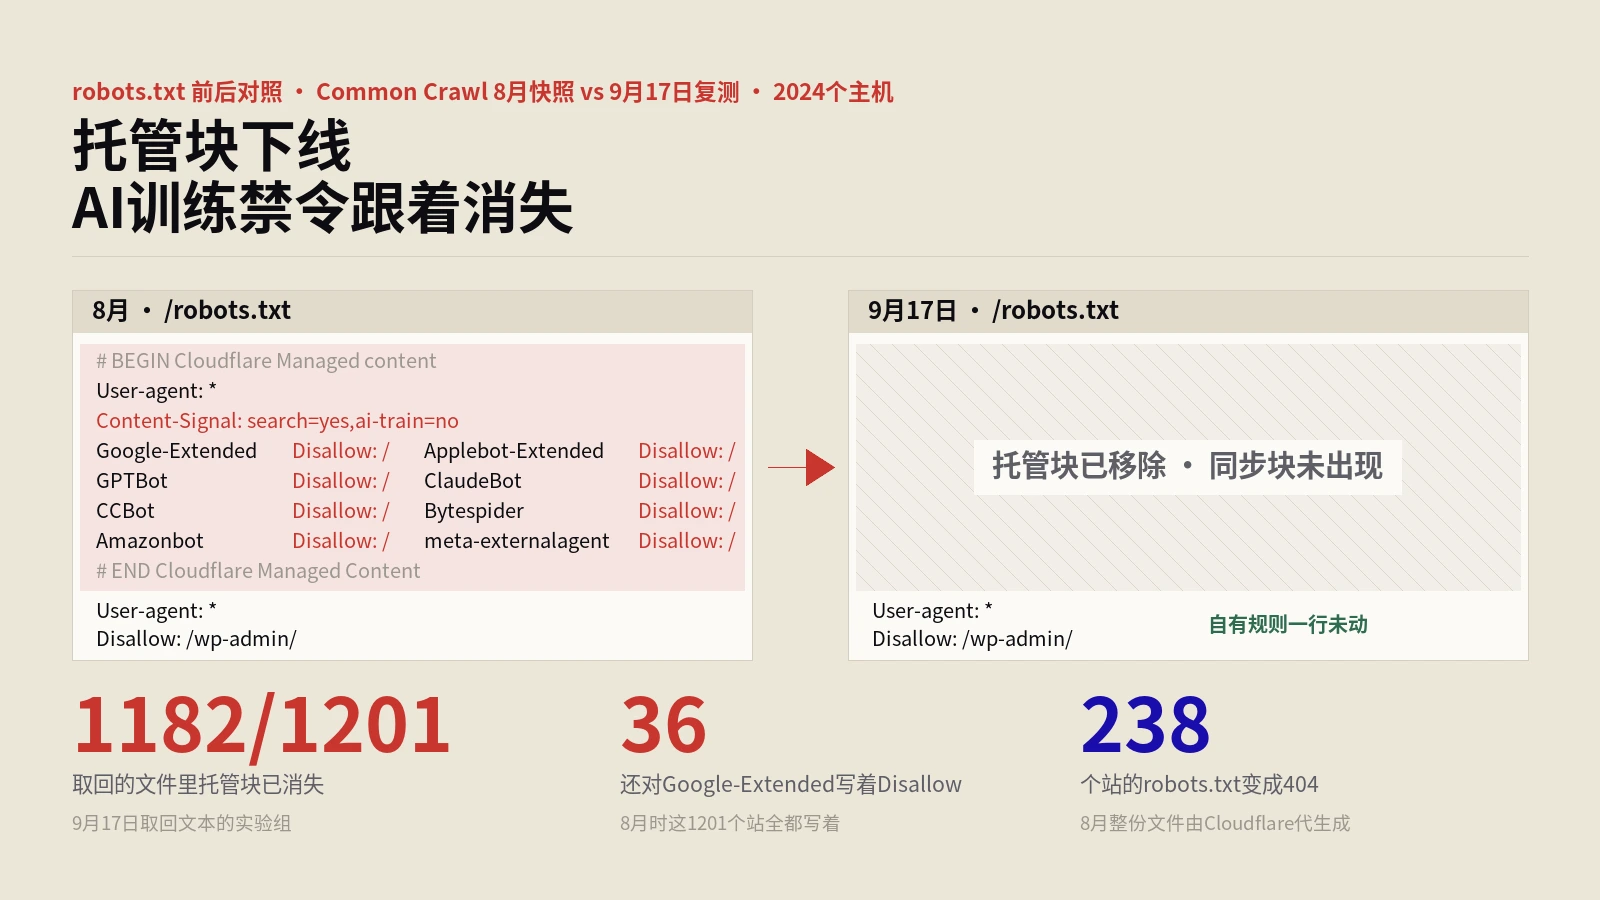
摘要:从Common Crawl 2026年8月抓取的103682份robots.txt里,筛出2518份带有Cloudflare托管内容块的文件,去重后是2024个主机;9月17日逐个复测,能取回robots.txt的1201个站里,1182个的托管块已经消失,出现新版Bot Preference Sync同步块的是0个。这1201个站在8月都对Google-Extended写了
Disallow: /,今天仍保留这条规则的只有36个。8月自带规则的站点,90.8%除了少掉托管块之外一字未改;8月完全依赖Cloudflare代生成文件的站点,有238个的robots.txt现在直接返回404。
2026年9月15日,Cloudflare调整了AI爬虫相关的安全设置:新增“Disallow AI Training”选项,把Apple、Google、Microsoft的混合用途爬虫标为“Accountable”,同时宣布旧的“Block AI Bots”开关和托管robots.txt(Managed robots.txt)功能将被弃用,由Bot Preference Sync接替。按Cloudflare的说法,绝大多数客户“什么都不用做”,旧设置会自动迁移。
迁移在后台完成,站长看到的是控制台里的新选项;爬虫看到的是robots.txt。这两者在迁移之后是否仍然一致,Cloudflare的公告没有给出数据。本文用一组前后对照的实测回答这个问题:9月15日之前带着托管块的站点,现在对外发布的robots.txt里还剩什么。
站内此前做过两次相关实测:robots.txt里有多少行是平台替站长写的,以及robots.txt声明允许、边缘防护却拦下GPTBot的错配。前者统计的是声明的来源,后者比较的是声明层与送达层。本文关注的是第三个问题:平台改版时,声明层本身被改动了多少。
Cloudflare在2026年9月15日对AI爬虫设置做了哪些调整?
Cloudflare的调整分两篇博文发布。8月21日的Bot Preference Sync公告提出:由平台根据控制台里的搜索、训练、代理三类策略,自动生成并更新robots.txt,让“对外声明的偏好”和“边缘执行的规则”保持同步;旧版托管robots.txt的用户会被提示确认偏好后迁移。9月15日的Accountable混合用途爬虫公告给出了具体规则:
- 训练控制新增“Disallow AI Training”:通过Bot Preference Sync在robots.txt里发布不许训练的偏好,被标为Accountable的混合用途爬虫(Applebot、Bingbot、Googlebot)仍可为搜索抓取,其余训练爬虫在边缘被拦截。
- “Block”和“Block on pages with ads”从此也作用于混合用途爬虫。选择Block,意味着Googlebot、Bingbot、Applebot连搜索抓取都会被挡住。
- “Block AI Bots”开关与托管robots.txt功能进入弃用流程。
- 旧设置自动迁移:训练项原先选Block或Block on pages with ads的,迁移为Disallow AI Training。
“Disallow AI Training”要靠robots.txt生效。对谷歌,它靠的是给Google-Extended写Disallow;对苹果,靠的是给Applebot-Extended写Disallow;对必应,Cloudflare明确说明robots.txt层面的不许训练偏好要到2027年初才会被支持,目前必应认的是页面上的NOARCHIVE标记。
这套控制与Cloudflare去年推出的按次抓取收费是同一条产品线:先让站长能分辨、能拦截,再谈授权与收费。本次调整把“能不能分辨混合用途爬虫”这一环补上了,代价是把一部分控制重新交回给robots.txt。
旧版托管robots.txt写了哪些AI训练禁令?
根据Cloudflare托管robots.txt文档,开启这个功能后,平台会检查源站是否有robots.txt:有,就把托管内容插在源站文件前面,合并成一个响应;没有,就直接生成一份只包含托管内容的文件。在8月的Common Crawl快照里,一个标准的托管块长这样:
| 组成部分 | 内容 | 作用 |
|---|---|---|
| 内容信号政策注释 | 约22行注释,解释search、ai-input、ai-train、use四个信号的含义,并援引欧盟DSM指令第4条 | 声明性文字,爬虫不解析 |
| 起止标记 | # BEGIN Cloudflare Managed content与# END Cloudflare Managed Content | 标出平台管理的范围 |
| 通配分组 | User-agent: *、Content-Signal: search=yes,ai-train=no,use=reference、Allow: / | 允许抓取,声明不许用于训练 |
| 点名禁止 | Amazonbot、Applebot-Extended、Bytespider、CCBot、ClaudeBot、CloudflareBrowserRenderingCrawler、Google-Extended、GPTBot、meta-externalagent,各自Disallow: / | 对9个AI相关令牌全站禁止 |
这9个令牌里,Google-Extended和Applebot-Extended的性质与其他7个不同。它们不是真实存在的爬虫,不会发出请求,只是谷歌和苹果在robots.txt里读取的“用途开关”。谷歌常用抓取工具文档的说明是:Google-Extended用于控制内容是否用于Gemini模型训练,不影响网站在谷歌搜索中的收录,也不是排名信号。
怎么判断托管块是在9月15日前后消失的?
实测分三步,全部数据在2026年9月17日前采集完毕:
- 建立迁移前基线。从Common Crawl 2026年8月抓取批次(CC-MAIN-2026-34,抓取时间8月7日至20日)的10万个robots.txt归档文件中,均匀抽取200个,解析出163859条响应,其中状态码200的robots.txt共103682份。带有
# BEGIN Cloudflare Managed content标记的有2518份,占2.4%,去重后对应2024个主机;带有新版# BEGIN Cloudflare Bot Preference Sync标记的为0份。 - 设置对照组。从同一批快照里随机抽取2024个没有托管标记的主机,其中一半取自当时经Cloudflare响应的主机,使两组的平台构成接近。对照组用来回答一个基础问题:robots.txt在一个月里本来就会变多少。
- 9月17日复测。用
curl_cffi模拟Chrome请求两组主机的robots.txt,保存原文,与8月快照逐份比对。比对时先去掉托管块和内容信号政策注释,再比较剩余的有效规则行。
时间窗口还有一组更细的旁证。本站在9月13日为另一次实测保存过495份robots.txt,其中14个站带着托管块;9月17日能取回的12个站,托管块全部消失。结合Cloudflare公告的日期,托管块的移除发生在9月13日到17日之间,与9月15日的改版吻合。
为排除缓存或按访客身份返回不同内容的可能,对其中14个站分别用Chrome、Googlebot、GPTBot、CCBot和curl五种身份请求,每种身份再加一次带随机参数的请求绕过缓存。能正常返回的站点,各身份拿到的内容完全一致,托管块同样不存在。
8月带托管块的站点,9月17日的robots.txt变成了什么样?
| 9月17日复测结果 | 实验组(8月带托管块) | 对照组(8月无标记) |
|---|---|---|
| 主机数 | 2024 | 2024 |
| 取回robots.txt文本 | 1201 | 1844 |
| 其中托管块已消失 | 1182(98.4%) | 不适用 |
| 其中仍带旧托管块 | 19(1.6%) | 0 |
| 其中出现Bot Preference Sync同步块 | 0 | 0 |
| robots.txt返回404 | 247 | 14 |
| 返回403 | 303 | 79 |
| 状态码200但内容是HTML页面 | 172 | 8 |
| 其他状态码或无法连接 | 101 | 79 |
两组最明显的差异在“取回率”和“404”。对照组有91.1%的主机能取回文本,实验组只有59.3%;实验组有247个主机的robots.txt返回404,是对照组的17倍多。403在两组都有,主要是边缘防护对自动化请求的拦截,这部分无法判断文件内容,不计入后续比较。
取回的1201份文本里,没有一份出现新的同步块。按Cloudflare的设计,Disallow AI Training应当“在robots.txt里发布不许训练的偏好”,但在这批站点上,这份偏好在9月17日还没有出现在对外文件里。
自有规则保持不变、只少了托管块的站点占多少?
把实验组按8月文件的构成拆开:去掉托管块和政策注释之后,还有自有规则的算“源站有文件”,什么都不剩的算“源站无文件”,即当时整份robots.txt都是Cloudflare生成的。
| 8月文件构成 | 主机数 | 9月17日取回文本 | 自有规则完全不变 | 自有规则有改动 | 仍带旧托管块 | 返回404 |
|---|---|---|---|---|---|---|
| 源站有文件 | 1006 | 859 | 780(90.8%) | 68(7.9%) | 11(1.3%) | 9 |
| 源站无文件 | 1018 | 342 | 38 | 296 | 8 | 238 |
对源站有文件的859个站来说,90.8%的变化仅仅是托管块被拿掉了,站长自己写的规则一行没动。有改动的占7.9%,对照组同期的改动比例是6.0%(1844个里111个),两者接近,说明这部分属于正常的日常维护,与迁移无关。
这780个站并没有人为调整AI策略,但它们对外声明的内容已经从“对9个AI令牌全站禁止、声明不许训练”变成了只剩站长原有的那几条规则。对照组里8月对Google-Extended写了Disallow的站只有10个,9月17日仍保留的有9个;实验组这1201个站8月全部写着这条规则,9月17日仍保留的是36个,占3.0%。
| AI令牌 | 8月实验组全站禁止 | 9月17日实验组全站禁止 |
|---|---|---|
| Google-Extended | 1201 | 36 |
| Applebot-Extended | 1201 | 34 |
| GPTBot | 1201 | 49 |
| Bytespider | 1201 | 48 |
| CCBot | 1201 | 46 |
| ClaudeBot | 1201 | 42 |
| Amazonbot | 1201 | 40 |
| meta-externalagent | 1201 | 35 |
剩下的几十条,一部分来自仍保留旧托管块的19个站,其余是站长在自有规则里本来就写过的禁止项。内容信号方面,1201份文本里仍声明ai-train=no的只剩22份。
没有自有robots.txt的站点,托管功能下线后返回什么?
源站无文件的1018个主机,8月时对外的robots.txt完全由Cloudflare生成。托管功能下线后,请求会回落到源站,结果取决于源站怎么处理/robots.txt这个路径:
- 238个返回404。对搜索引擎而言,robots.txt返回404等同于“没有任何限制”,所有爬虫都可以抓取全站。
- 296个返回了一份与8月不同的文本,通常是建站程序或主机商的默认文件,例如只有
User-agent: *和空的Disallow:两行。 - 38个只剩注释,没有任何有效规则,其中一半以上是Cloudflare默认展示的内容信号政策说明。
- 其余主机返回403、HTML页面或无法连接。
谷歌对robots.txt状态码的处理规则是:4xx视为文件不存在,允许抓取;5xx会在一段时间内被当作全站禁止。本次样本里返回5xx的只有几十个,没有集中出现的迹象。对这238个站来说,托管功能下线的实际效果是:一个月前还在对AI令牌说“不”,现在对所有爬虫都没有任何声明。
这类站点的风险在于没有兜底文件。平台停止代写之后,对外声明直接归零,而控制台里的设置看起来一切正常。robots.txt的规则怎么匹配、没写的分组会不会继承通配规则,可以参考站内robots.txt分组不继承的实测,补文件之前先把这些默认行为弄清楚。
Google-Extended和Applebot-Extended为什么只能写在robots.txt里?
因为它们不是爬虫,没有请求可拦。Cloudflare能在边缘拦截的,是真实发出请求、带着可识别身份的爬虫,比如GPTBot、ClaudeBot、CCBot。谷歌的训练数据来自Googlebot抓取的内容,是否用于Gemini训练,由Googlebot读取robots.txt里Google-Extended分组的规则决定。苹果在Siri接入Gemini之后,训练授权同样是站长关心的问题。苹果的Applebot说明页也写明,Applebot-Extended本身不抓取页面,只在robots.txt里表达是否允许数据用于训练苹果的基础模型。
因此,三类AI训练控制在不同的位置执行:
| 训练控制对象 | 执行位置 | 托管块消失后的状态 |
|---|---|---|
| GPTBot、ClaudeBot、CCBot、Bytespider等独立训练爬虫 | Cloudflare边缘拦截(若设置迁移为Disallow AI Training) | 边缘仍可拦截,但robots.txt不再声明 |
| Google-Extended、Applebot-Extended | 只能是robots.txt | 声明消失,训练退出不再生效 |
| Bingbot的训练用途 | 页面上的NOARCHIVE标记,robots.txt支持预计2027年初上线 | 不受本次变化影响,但也从未由托管块覆盖 |
对于同时在意搜索可见度和训练授权的站点,这是本次迁移中影响最大的一项:边缘拦截可以不依赖robots.txt,谷歌和苹果的训练退出却必须依赖它。站内robots.txt挡不住AI训练的四条路径讨论过robots.txt在训练授权上的局限;这里的情况更基础:连这条有限的声明也暂时不在文件里了。
边缘这一侧的实际状态无法从外部完整验证。伪造Googlebot身份的请求会被Cloudflare的已验证爬虫机制识别,拿到的结果不代表真实Googlebot的待遇。本文的结论只针对对外发布的robots.txt。
Bot Preference Sync的同步块在样本里出现了吗?
没有。在以下三组样本里,# BEGIN Cloudflare Bot Preference Sync标记的出现次数都是0:
- 9月17日复测取回的实验组1201份、对照组1844份robots.txt。
- 同日抓取的Tranco前一万个域名,取回5469份robots.txt,其中经Cloudflare响应的2184份。
- 9月13日保存的495份robots.txt。
Cloudflare 8月的公告写的是同步功能“在未来一周内”对所有套餐开放,并会提示旧用户确认偏好。Cloudflare社区论坛在9月15日之后出现了几条相关反馈:有站长把搜索、训练、代理三项都设为允许,robots.txt里却仍然出现ai-train=no和对AI爬虫的禁止;有站长关闭同步开关后,开关又自动恢复为开启。说明同步功能在推出初期的行为并不稳定,而且两个方向的不一致都有人遇到。
结合本次实测,比较稳妥的判断是:旧托管块已经大面积移除,新同步块在大多数站点上尚未生效。这段时间里,控制台显示的偏好与对外发布的robots.txt可能不一致,需要站长自己核对。
仍然保留旧托管块的站点是什么情况?
实验组里有19个站在9月17日仍带着# BEGIN Cloudflare Managed content标记。这些托管块在文件中的位置大多在中后部(19个里有18个的起始位置在全文的47%之后),而Cloudflare插入的托管内容原本位于文件开头,只在政策注释之后。它们更像是站长当初把Cloudflare生成的文本复制进了源站文件,成为静态内容,因此不受平台移除的影响。
Tranco前一万里也有5个站保留着这段文本:Groupon、Snopes、TV Tropes、VSCO和ProCyclingStats。其中Snopes和TV Tropes的禁止名单只有7个令牌,缺少Google-Extended和CloudflareBrowserRenderingCrawler,与8月快照里的9令牌版本不同,看起来是更早时期的托管内容被原样保存了下来;VSCO的名单里多了TikTokSpider和PetalBot,ProCyclingStats则扩展到了40多个令牌,都是人工编辑过的名单。
复制下来的静态副本不会随平台更新,这一点有利有弊:训练禁令得以保留,但名单停留在复制那一天,新出现的AI令牌不会被补上。站内爬虫黑名单与真实访问的对照实测也说明,照抄来的名单与真实来访的爬虫常常对不上。
使用Cloudflare的站点现在应该核对什么?
按影响从大到小,建议按下面的顺序检查:
- 直接请求自己的robots.txt,看看是否还有
Google-Extended和Applebot-Extended的禁止规则、是否有Content-Signal行。命令行可以用curl -s https://你的域名/robots.txt,带一个随机参数绕过缓存再请求一次。 - 核对控制台的训练设置。如果训练项显示为Disallow AI Training,而robots.txt里没有对应规则,说明同步尚未生效;在同步生效之前,谷歌和苹果的训练退出需要自己写进源站文件。
- 确认没有误选Block。9月15日之后,搜索或训练项选择Block会连同Googlebot、Bingbot、Applebot一起拦截,影响的是搜索收录本身。自建服务器做拦截时同样要防误伤,Nginx拦AI爬虫时怎么避开Googlebot有反向解析验证的做法。
- 检查robots.txt是否返回404。如果源站原本没有这个文件,现在应当补一份,至少明确站点地图位置和需要屏蔽的路径。
- 决定是否把规则写进源站。希望训练禁令不受平台改版影响的站点,可以在源站文件里自行维护Google-Extended、Applebot-Extended等规则,并在Bot Preference Sync上线后检查两者合并后的结果是否冲突。
- 必应单独处理。在必应支持robots.txt的训练偏好之前,需要训练退出的页面应添加
NOARCHIVE标记。
规则写好之后,还需要确认爬虫真的读到了。站内robots.txt指令有没有人读的实测列出了用日志核对规则是否被执行的方法;如果站点同时开启了边缘拦截,robots、UA识别与WAF三层的选型框架可以帮助理清各层分工。
常见问题解答
Cloudflare托管robots.txt被弃用后,我的AI训练设置还有效吗?
边缘拦截部分通常仍然有效,旧设置会迁移为Disallow AI Training或Block。但robots.txt里的声明可能已经消失。本次实测中,8月带托管块的站点在9月17日有98.4%已不再包含托管内容,也没有出现新的同步内容。谷歌和苹果的训练退出只认robots.txt,需要单独核对。
Disallow AI Training和Block有什么区别?
Disallow AI Training在robots.txt里发布不许训练的偏好,并在边缘拦截独立的训练爬虫,同时允许Googlebot、Bingbot、Applebot继续为搜索抓取。Block会拦截所有相关爬虫,从2026年9月15日起包括这三个混合用途爬虫,会直接影响搜索收录。
给Google-Extended写Disallow会影响谷歌搜索排名吗?
谷歌的官方文档说明,Google-Extended不影响网站在谷歌搜索中的收录,也不作为排名信号。它控制的是内容是否用于Gemini模型训练。是否出现在AI概览和AI模式里,由Search Console里的另一项设置控制,详见GSC生成式AI报告与屏蔽开关。
robots.txt返回404会有什么影响?
谷歌把4xx状态码视为robots.txt不存在,爬虫可以抓取全站,不会因此导致收录问题。但所有原本写在文件里的限制都不再生效,包括AI训练退出。本次实验组有238个站点属于这种情况,它们在8月时完全依赖Cloudflare生成robots.txt。
怎么知道Bot Preference Sync有没有在我的站上生效?
请求robots.txt,查找# BEGIN Cloudflare Bot Preference Sync标记。出现这个标记,说明同步内容已经插入;没有出现,说明对外文件里没有平台生成的AI偏好声明。9月17日的样本里,这个标记在所有抓取的文件中都没有出现。
必应现在怎么退出AI训练?
必应目前通过页面上的NOARCHIVE标记识别训练退出,带有该标记的内容不会用于训练微软的生成式模型,也不会在Copilot回答中被链接。Cloudflare表示,微软对robots.txt训练偏好的支持计划在2027年初推出。
权威参考资料
本文标题:《Cloudflare托管robots.txt下线实测:1201个站的AI训练禁令同时消失》
本文链接:https://zhangwenbao.com/cloudflare-managed-robots-txt-removal-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0
← 上一篇
商品评分四个数对不上,AI拿走的是商家自己填的那一个下一篇 →
没有了