
商品页的结构化数据里,一半找不到哪个节点是这一页
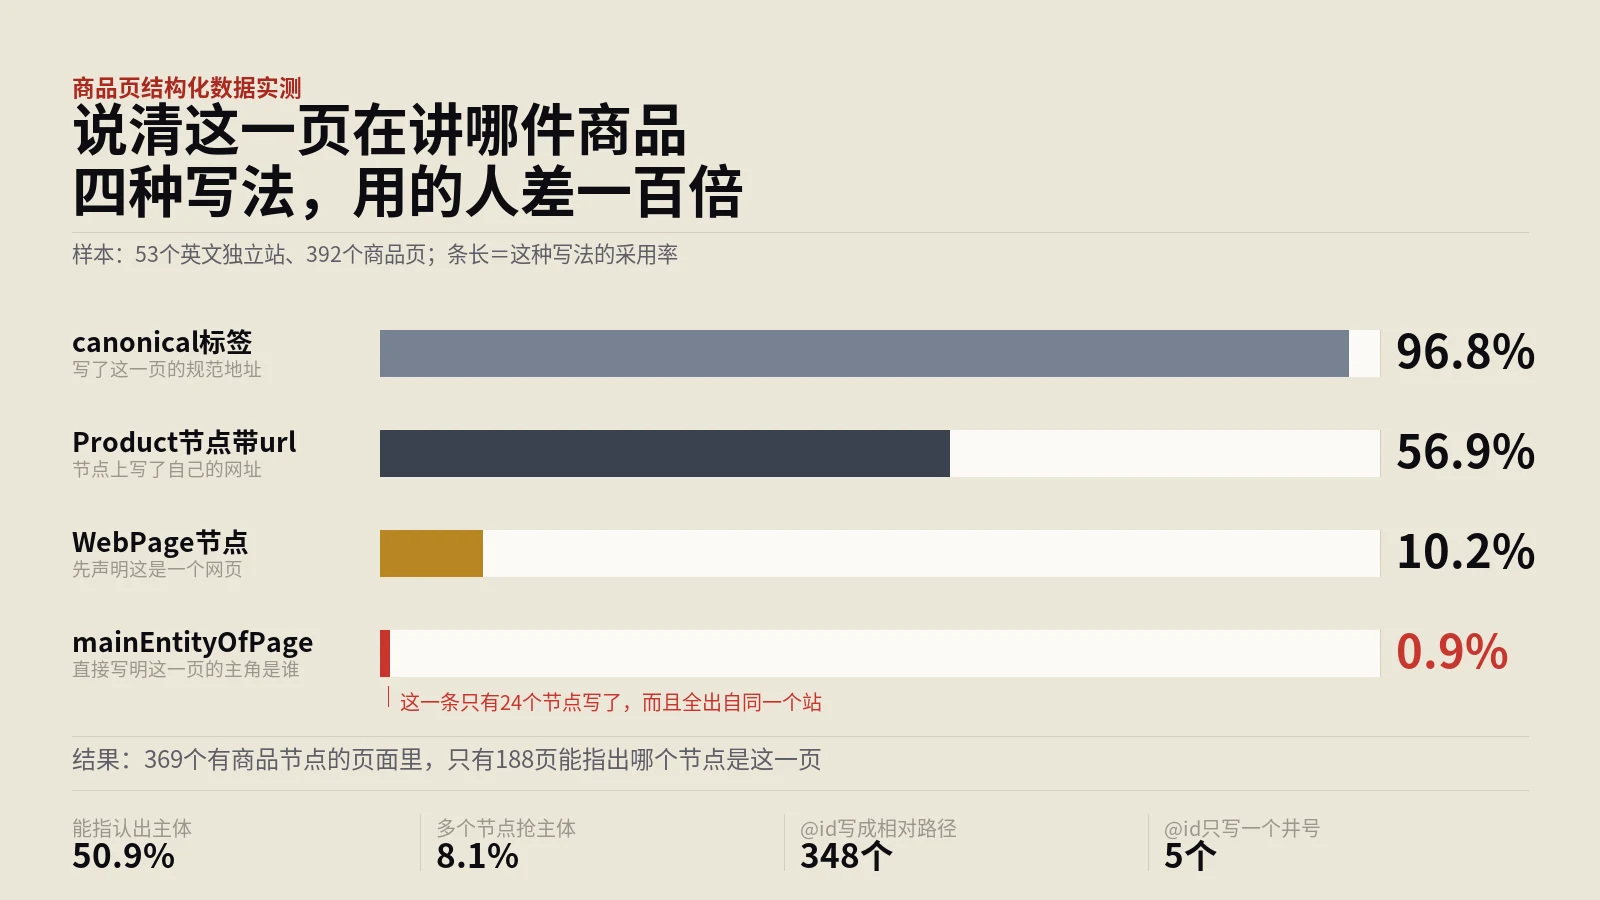
实验台把53个英文独立站392个商品页的JSON-LD节点全部取下,对每一个Product节点上的url与@id补全成绝对地址,再与页面自身地址逐字比对,据此判断这一页能不能指出它的主体。第一版比对忽略了查询参数,得到的通过率虚高三十多个百分点,翻查具体案例后改成完整地址严格比对。随后逐项统计@id、url、mainEntityOfPage的写入率与取值形态,把WebPage节点、结构化数据里的商品名与页面h1、以及同一页内的h1数量一…
标签
保哥笔记 结构化数据 标签下共 50 篇文章合集,含《Rank Math怎么设置对SEO最好?一个出海独立》《Headless CMS上线SEO集体失分?site》《技术SEO一堆问题先修哪个?500站实测排出来的优先》等,与 Schema、技术SEO、GEO 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
实验台把53个英文独立站392个商品页的JSON-LD节点全部取下,对每一个Product节点上的url与@id补全成绝对地址,再与页面自身地址逐字比对,据此判断这一页能不能指出它的主体。第一版比对忽略了查询参数,得到的通过率虚高三十多个百分点,翻查具体案例后改成完整地址严格比对。随后逐项统计@id、url、mainEntityOfPage的写入率与取值形态,把WebPage节点、结构化数据里的商品名与页面h1、以及同一页内的h1数量一…
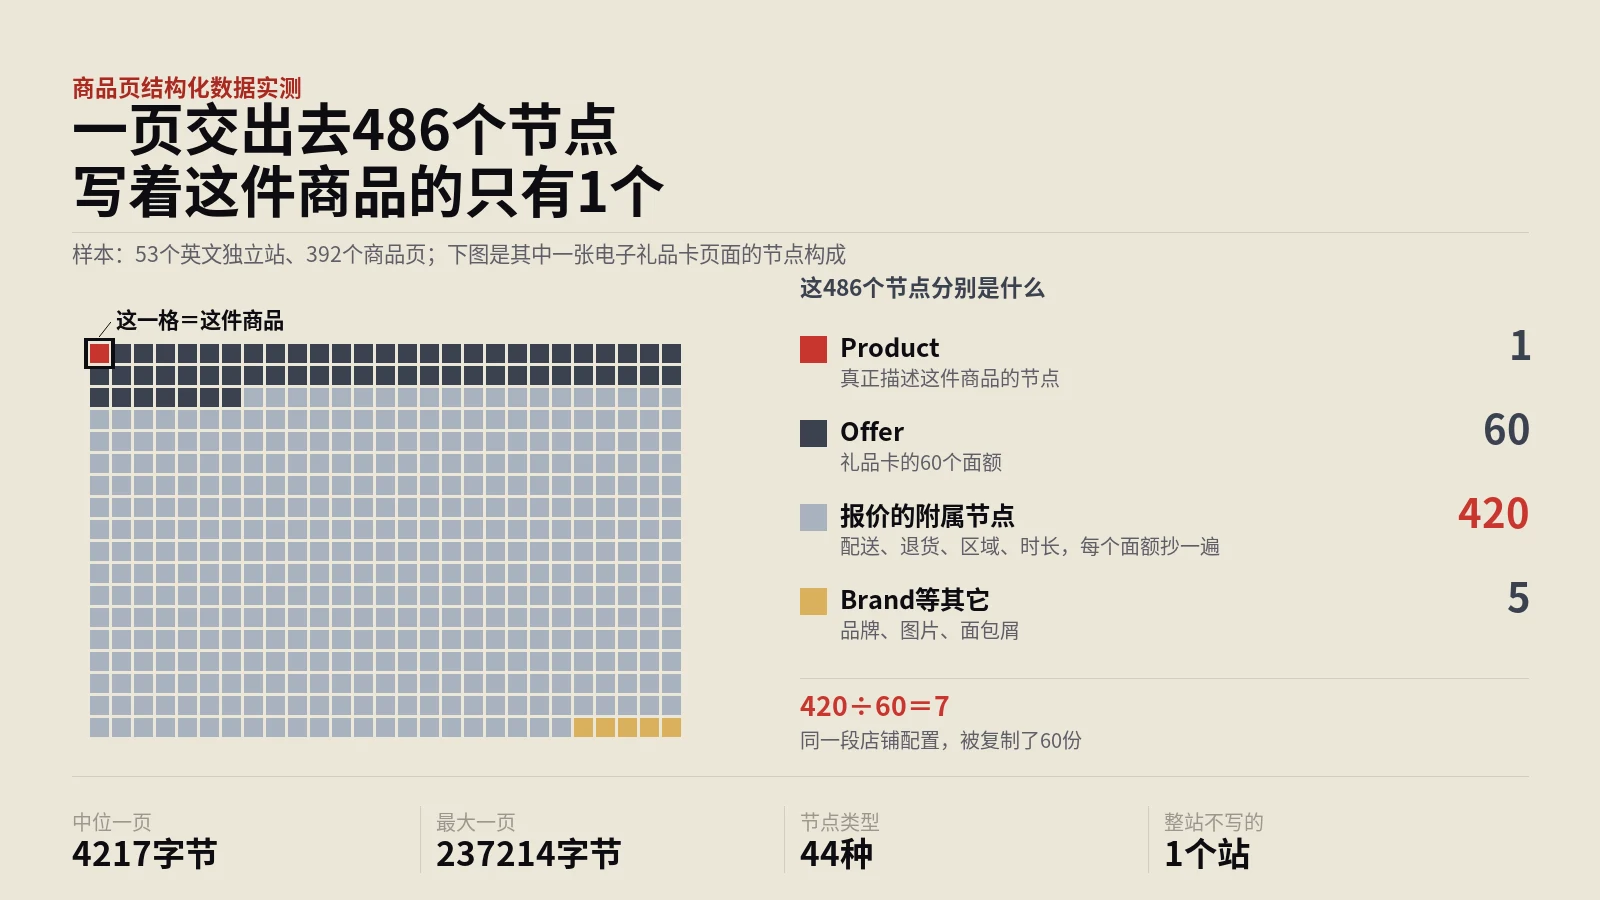
实验台用真实浏览器逐页打开53个英文独立站的392个商品页,等页面渲染完成后取出全部application/ld+json脚本,递归遍历每一个带@type的对象,按类型和它在JSON结构里的位置分别计数,同时记录字节量与脚本标签数。为了把模板复制与变体展开这两种不同的膨胀来源分开,每个站另外抽取了主推款与长尾款做同站对照;三个拿不到真实商品页的站——反爬拦截、跳转首页、地址全部失效——从统计中整体剔除。最后用加长等待时间的第二轮采集做自…
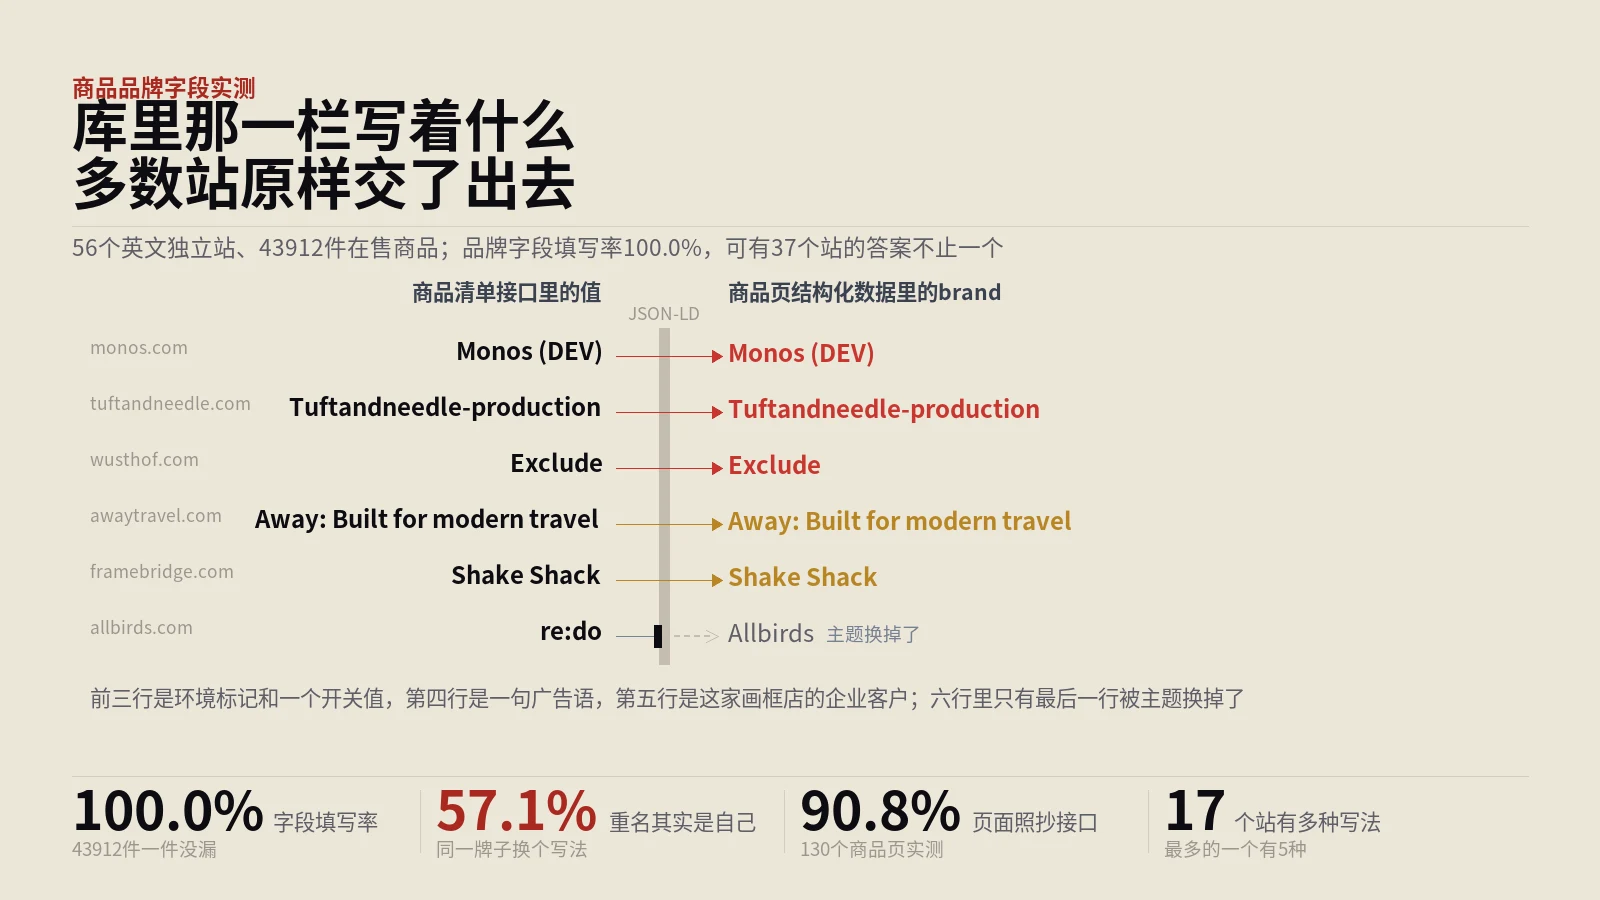
实验台从60个英文独立站的公开商品清单接口取回43912件在售商品的品牌字段,先按站算出主品牌,再把每一个非主品牌的取值做三级归一化——去掉重音符号、把与号换成and、砍掉地区码与公司后缀,据此把它们分成同一品牌的别写、字面空值、真正的另一个牌子三类,并逐条做字符级差异归因。随后用真实浏览器逐站打开商品页,等页面渲染完成后取出JSON-LD里Product节点的brand属性,与接口值一件件对照,判断这些取值有多少原样进入了搜索引擎读取…
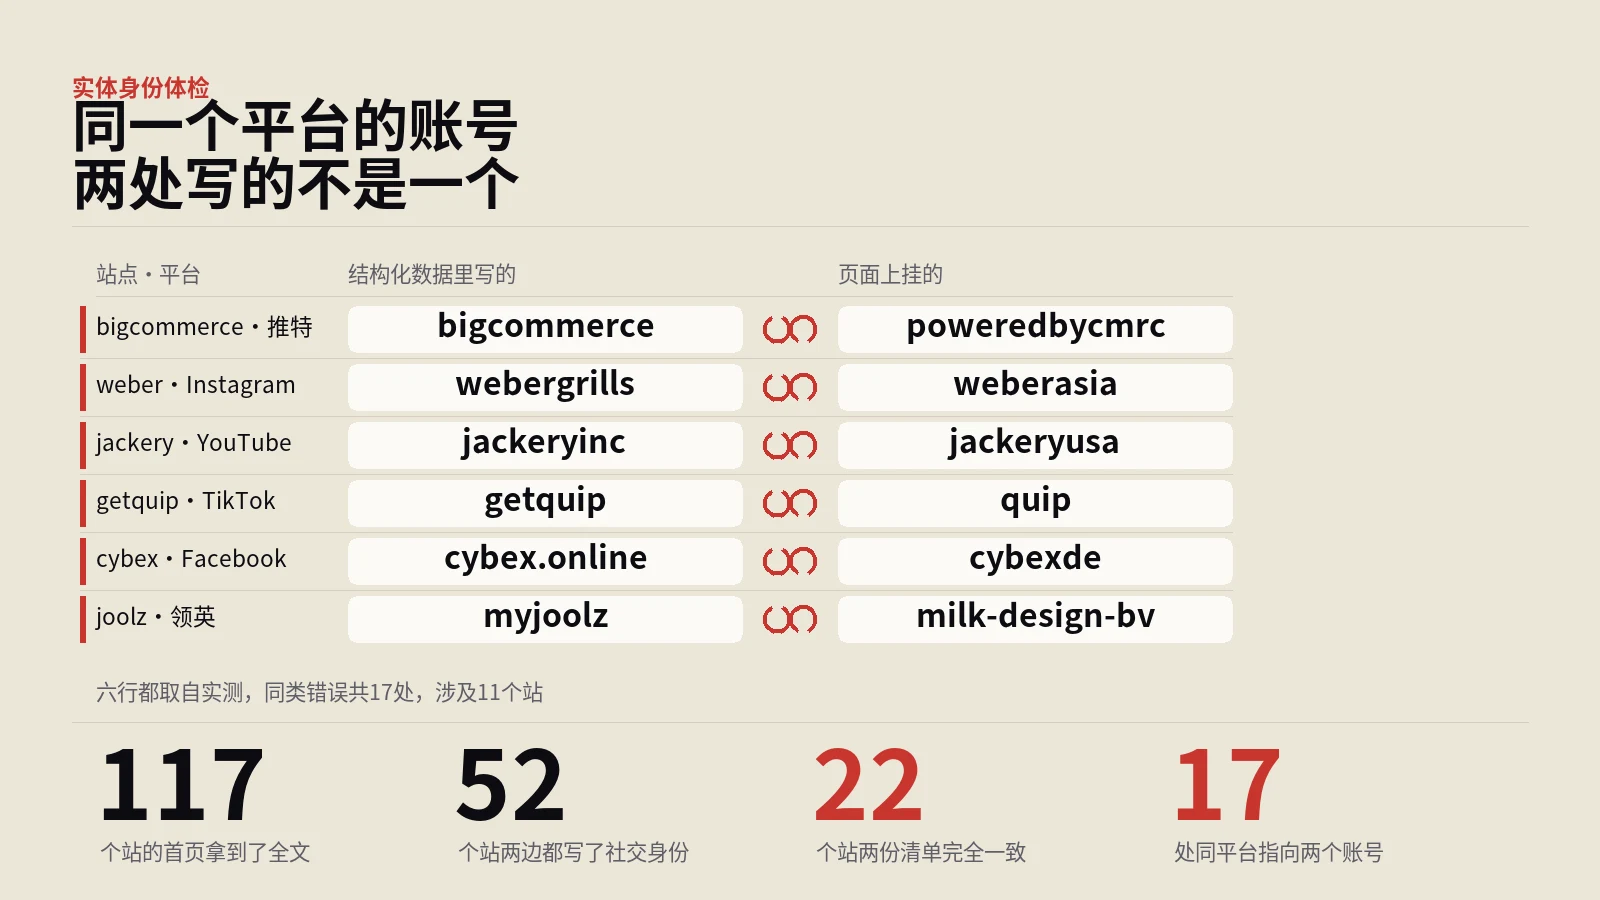
做法是只抓首页一次,把结构化数据里的sameAs、页面上的社交链接和twitter:site三份一起取出来就地比对,先归一到平台粒度再逐个对账号,全程不去社交平台验活。平台判定表里一条写法把整个google.com都吞了进去,凭空造出八个站的Google+残留,修完只剩一个。
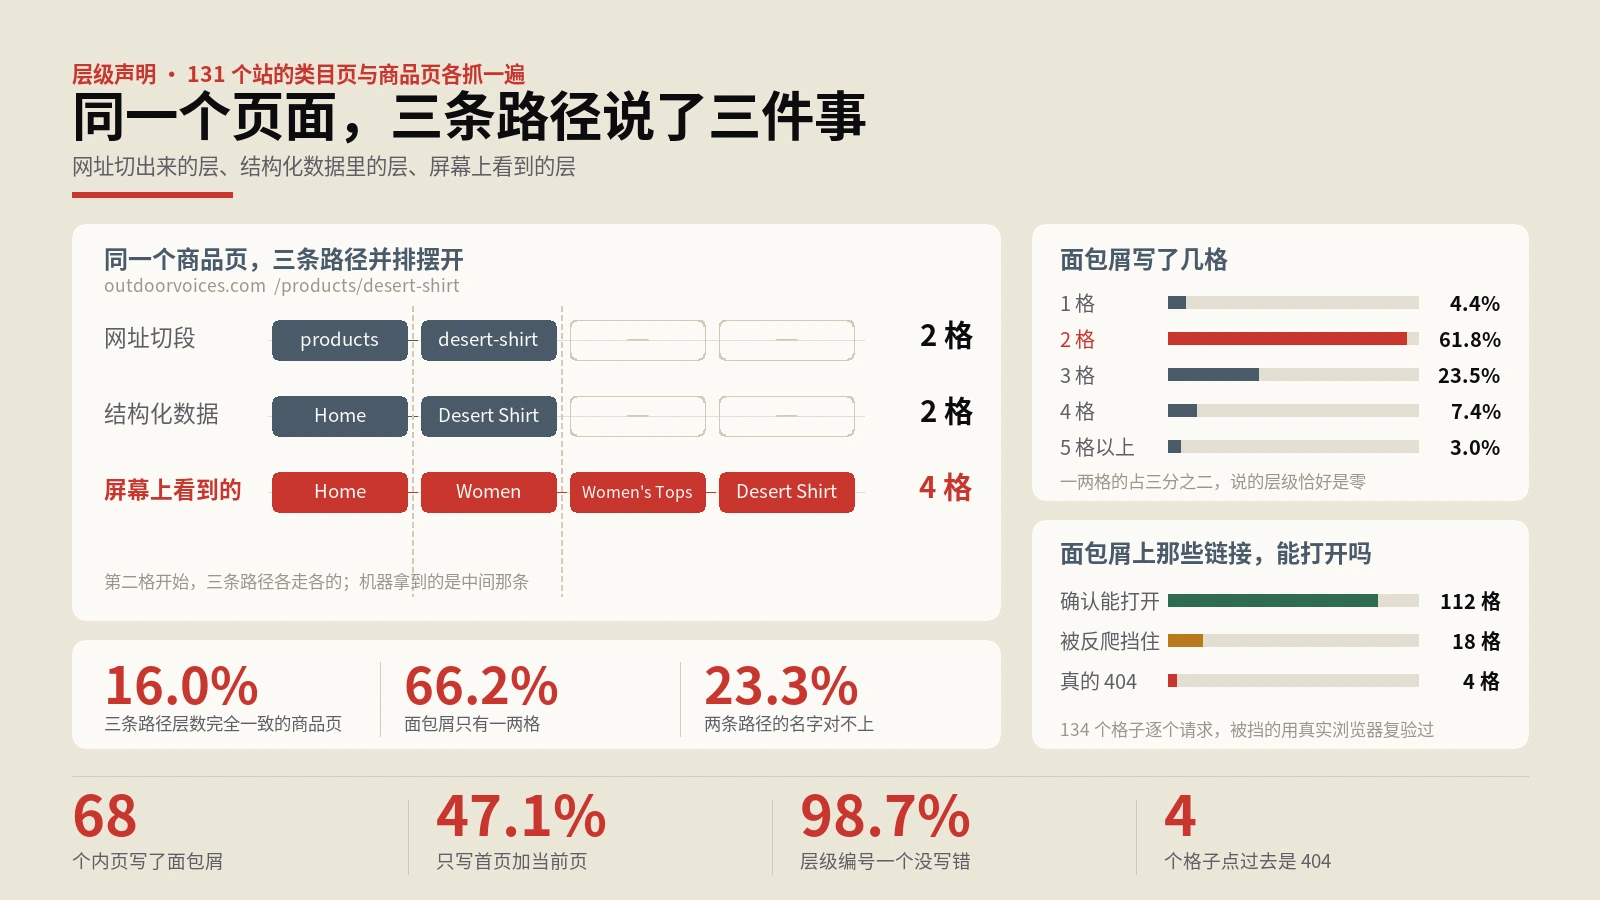
131个海外品牌站抓了类目页与商品页,把三样东西并排对齐——网址切出来的目录段、结构化数据里的BreadcrumbList、渲染后页面上那排可点的面包屑,逐页比对层数、名称与链接可达性;网址段数扣除语言与地区前缀,DOM选择器误判的样本人工剔除。
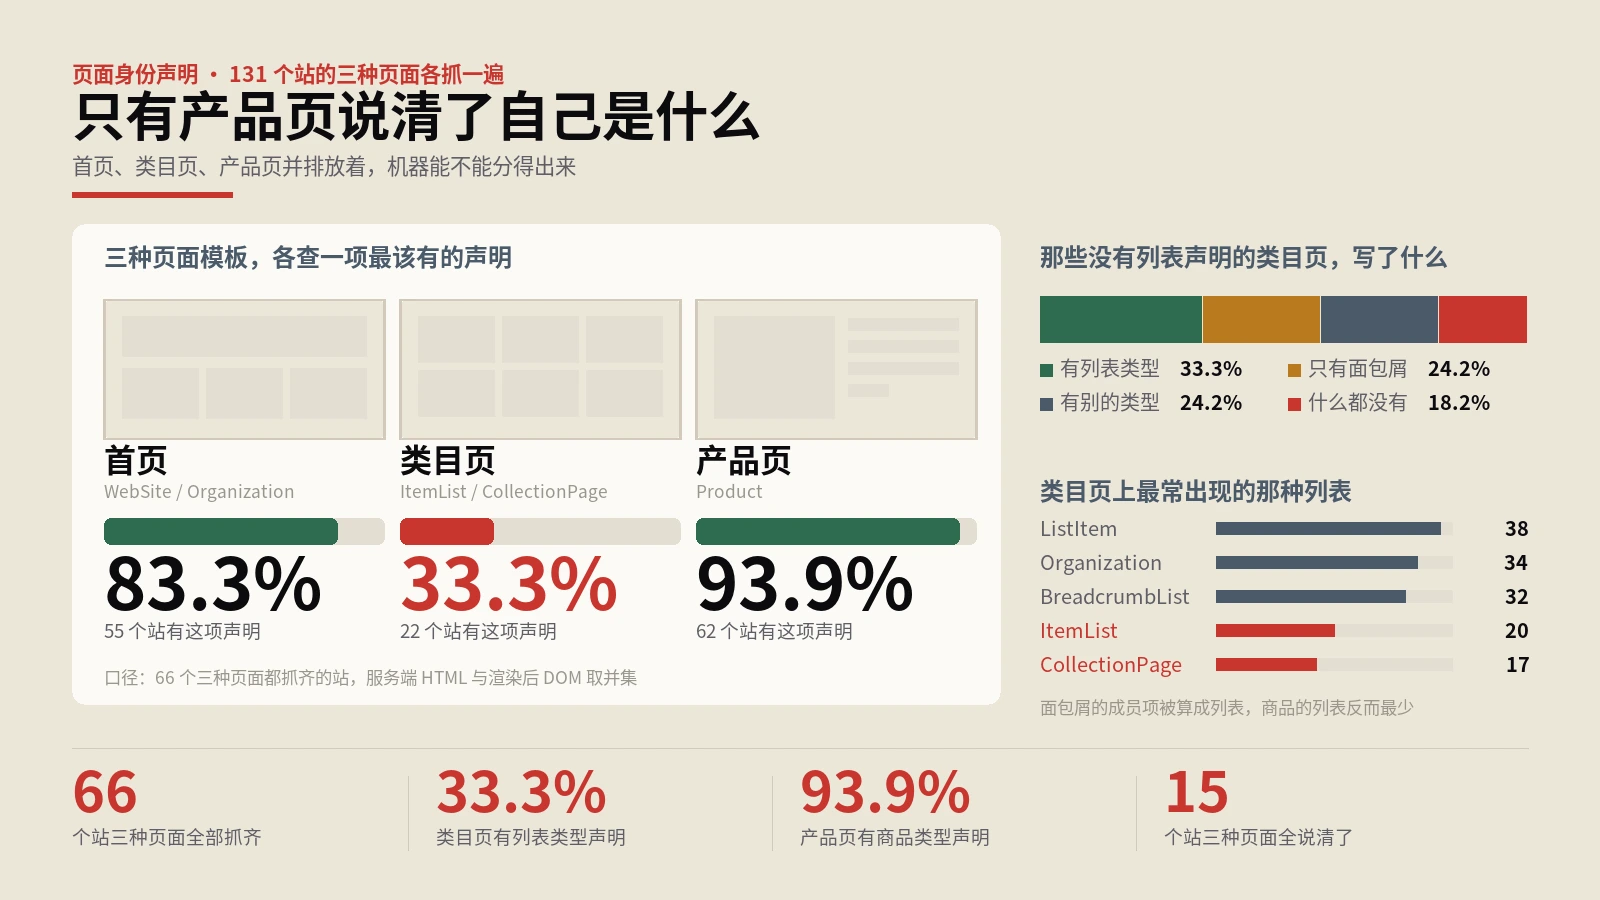
用真实浏览器把131个海外品牌站的首页、类目页、产品页各抓一遍,服务端HTML与渲染后DOM两份都解析后取并集,再人工逐条核对网址挑得对不对,最后落在66个站的可比样本上,逐项量三种页面各自的身份声明覆盖率。
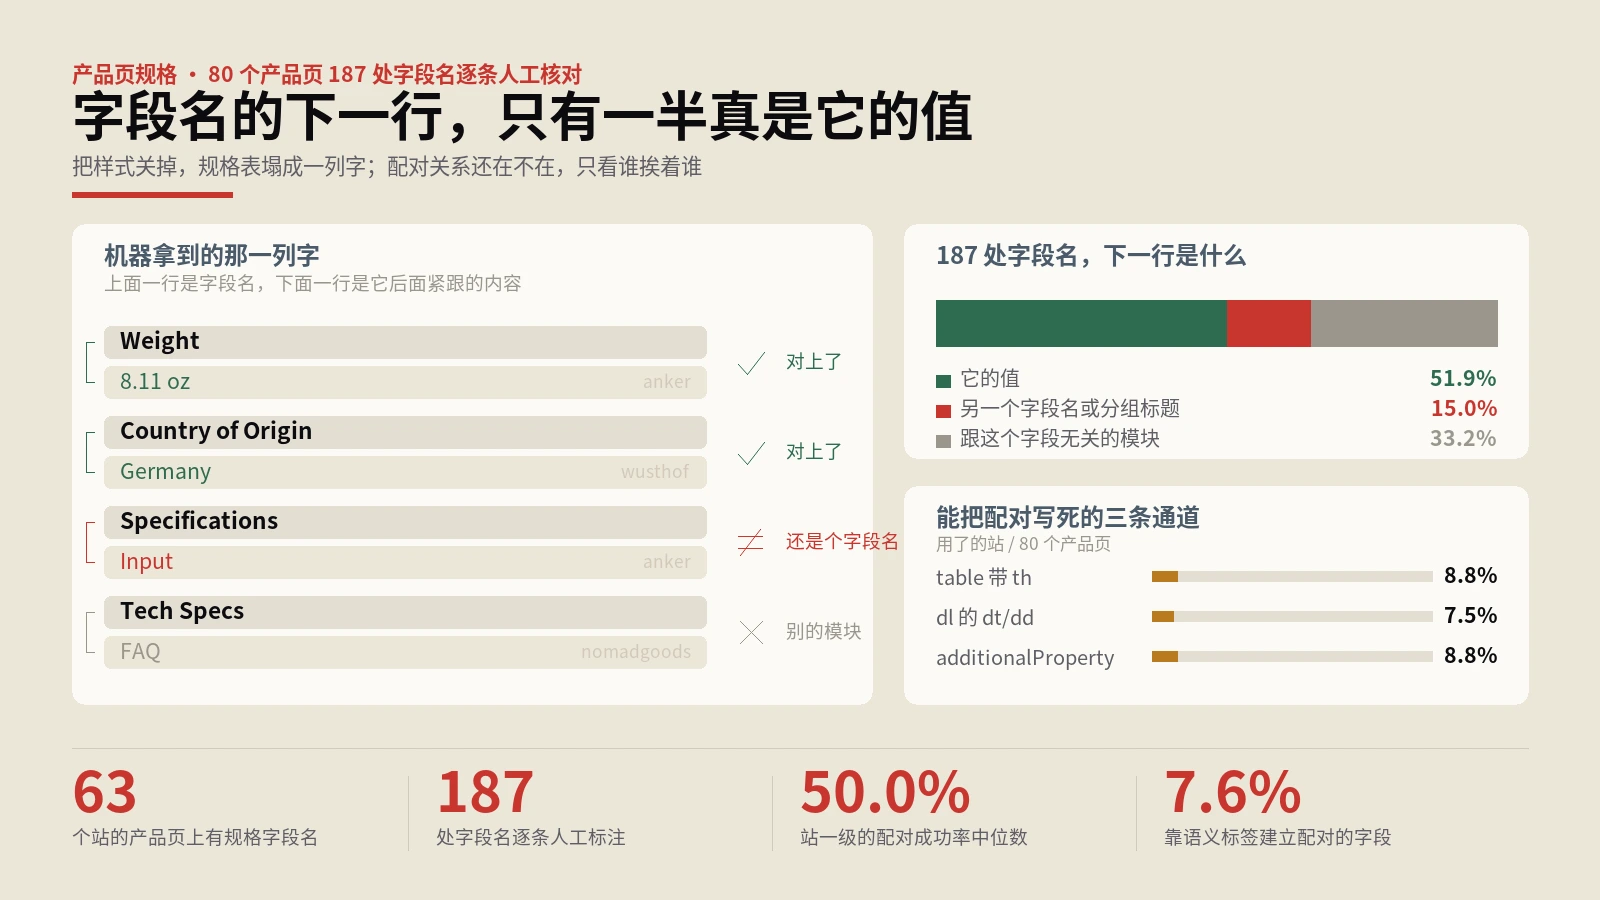
做法是用真实浏览器打开131个英文电商品牌站,从首页两跳之内进到产品页,取渲染之后的document.body.innerText当作机器实际拿到的那条文本流,用一份六十多个词的英文规格字段词表定位字段名所在的行,再逐条看它下一行是什么;同时在DOM那一侧记录字段名用的标签、有没有落在table与dl里、JSON-LD有没有写offers和additionalProperty。关键的一步是尺子自检:脚本自动判据给出的93.6%被187条…
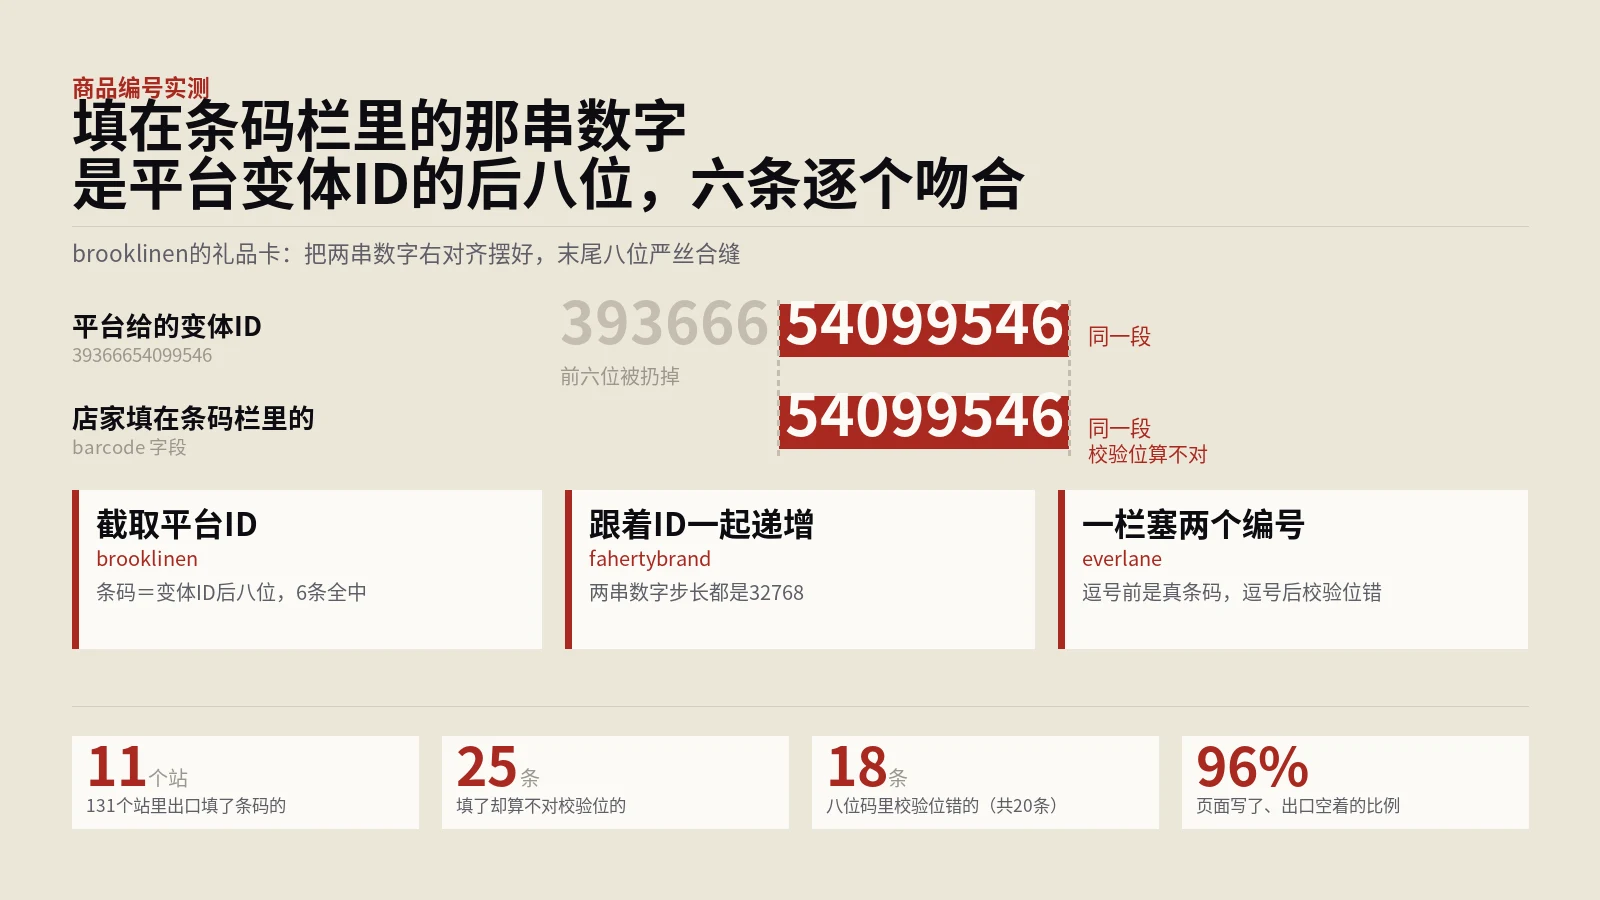
量法是把校验位这把离线尺子架到全站字段上:GTIN不论8位12位13位14位,末位都由前面各位推算,不联网也能判真伪。131个站单线程采集、间隔2秒,把页面结构化数据的每个节点和两个数据出口的每条变体记录都摘出编号,逐条算校验位,再按SKU把两侧配对,看同一件商品的条码是不是同一个。算不对的那些回原始记录里挖,看它原本是什么。
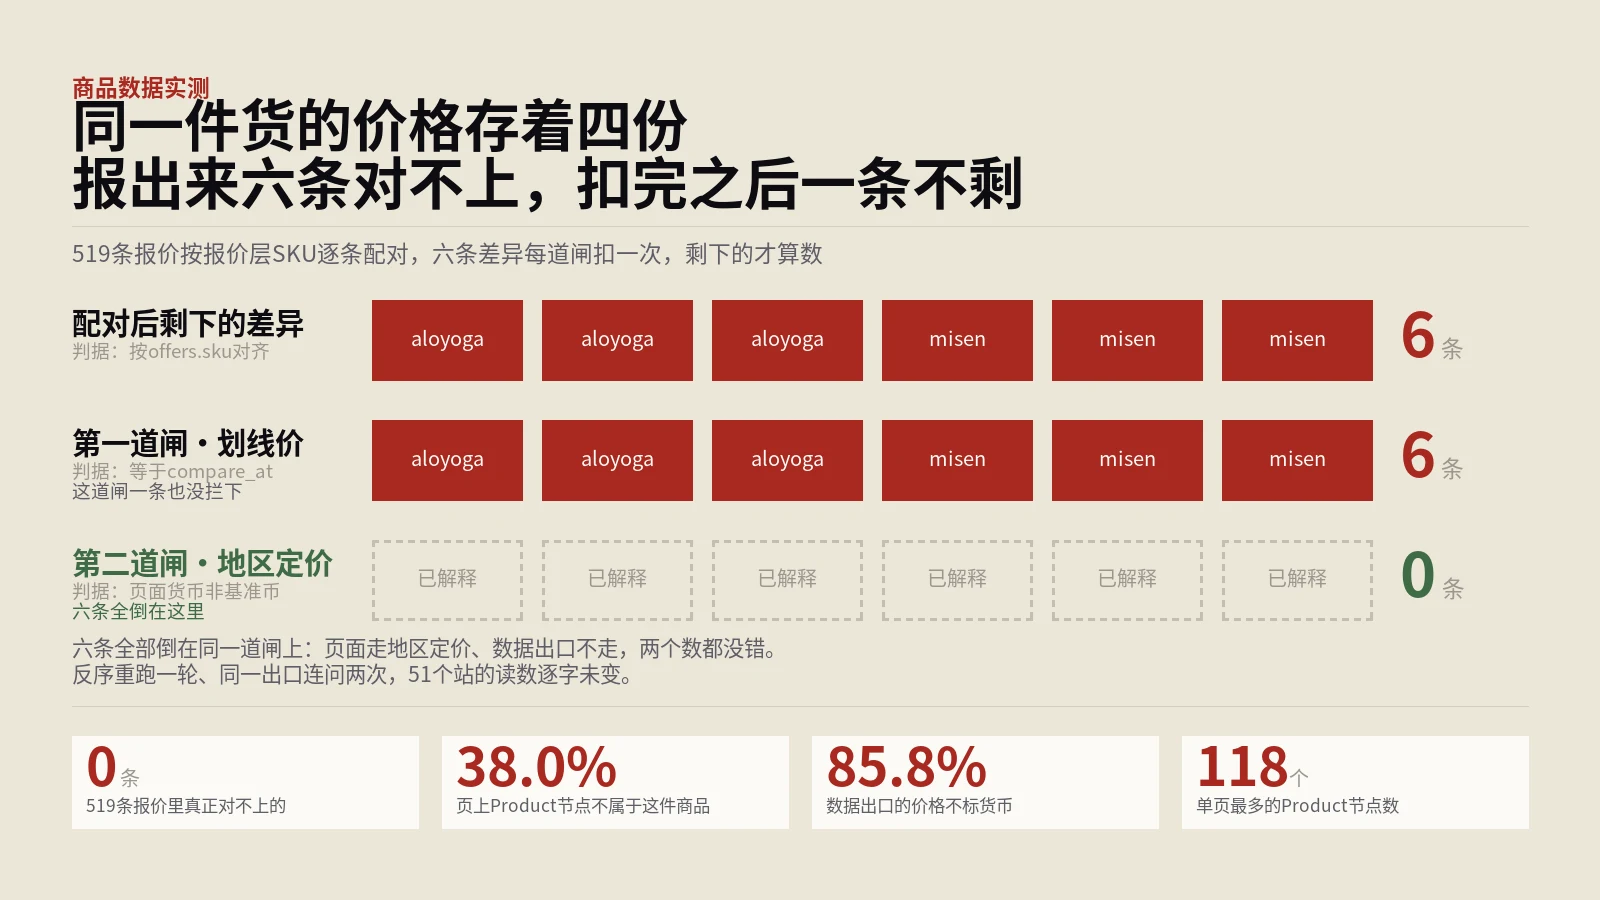
量法是把同一件商品的价格从四条独立路径各取一份:页面渲染、og标签、页面里的结构化数据、以及平台自带的两个数据出口。131个站单线程采集、间隔2秒,第二轮把请求顺序整个反过来重跑,并让同一个出口连问两次做自基线。配对不按节点出现的顺序,按报价层的SKU逐条对齐,再依次扣除划线价、地区定价、商品层与报价层编号错位这三类假阳性,剩下的才算数。
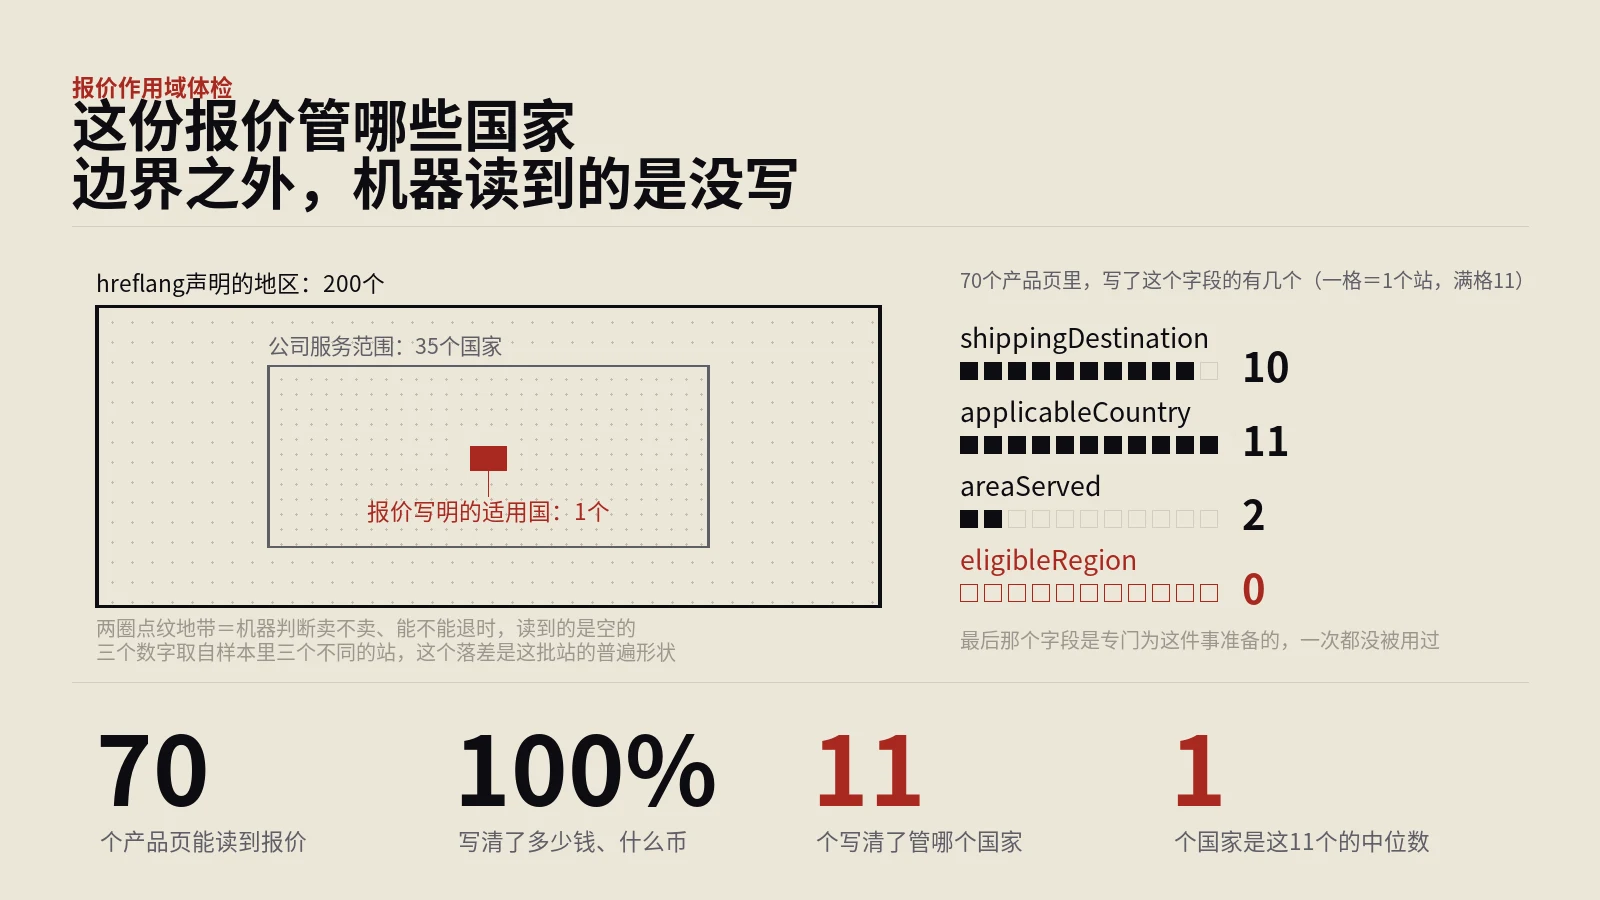
做法是从每个站的robots.txt找到sitemap入口,挑出商品那一份取一条网址抓回来,把结构化数据整段拍平后逐字段核地域信息,再拿hreflang里的多条地区网址交叉验证。尺子在这里坏过一次:第一版把欧元区多国共用一种货币的样本判成了地址不生效,9个站的结论修完只剩3个,而错的那一版恰好指向更有故事的那一边。
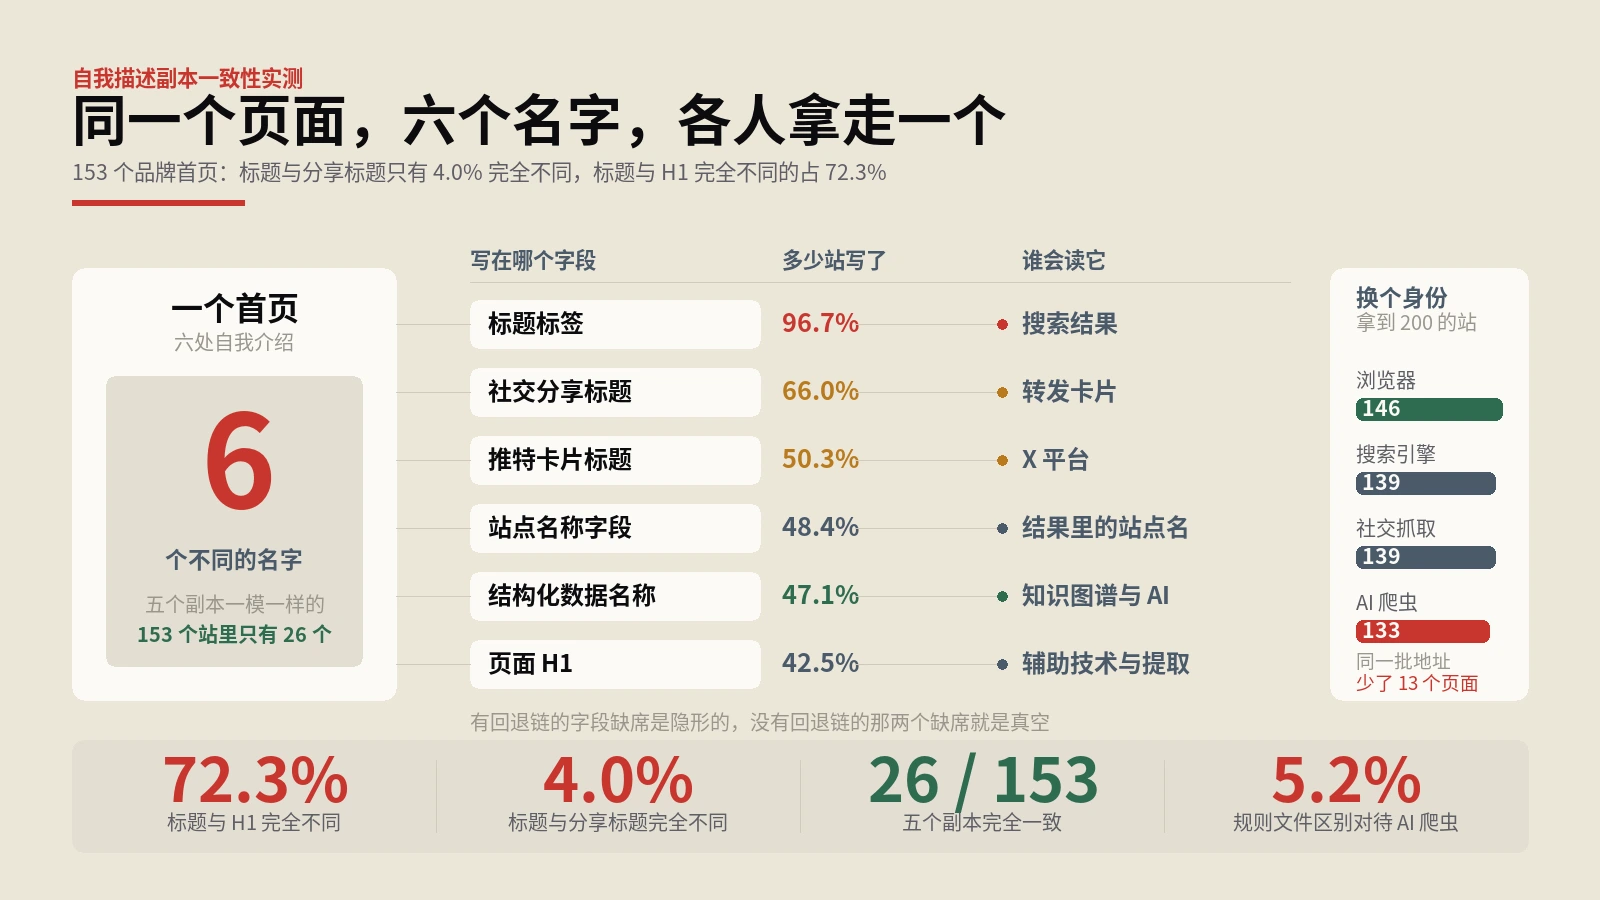
把171个海外品牌站的首页抽出六个自我介绍字段——标题标签、社交分享标题、推特卡片标题、页面H1、结构化数据里的名称、站点名称字段,逐对比对完全相同、包含还是完全不同;再用浏览器、搜索引擎爬虫、社交抓取器、AI爬虫四种身份各抓一轮,看不同的读者拿到的是不是同一份页面。文中给出字段覆盖率、五组两两一致率、消费方的取用顺序与回退链、四种身份的状态码差异、同一份规则文件对不同爬虫的判定落差,以及一条从模板层收敛六个副本的路线和几段可直接跑的核…
要判断一个站的承诺有多少是说给机器听的,有一套可以照着跑的量法。第一步把页面上人能读到的文字提出来,去掉脚本和样式只留正文,用一组模式匹配承诺类表述:免运费、免退货、多少天退货、多少天试用、多少天送达、多少年质保、终身质保、满意保证,各语言的常见说法都要覆盖。第二步在同一个页面的机器可读部分里找对应字段:配送详情、退货政策、退货天数、免运费门槛、处理时长、运输时长。两步结果交叉,就能算出只对人说、两边都说、只对机器说和两边都没说各有多少…

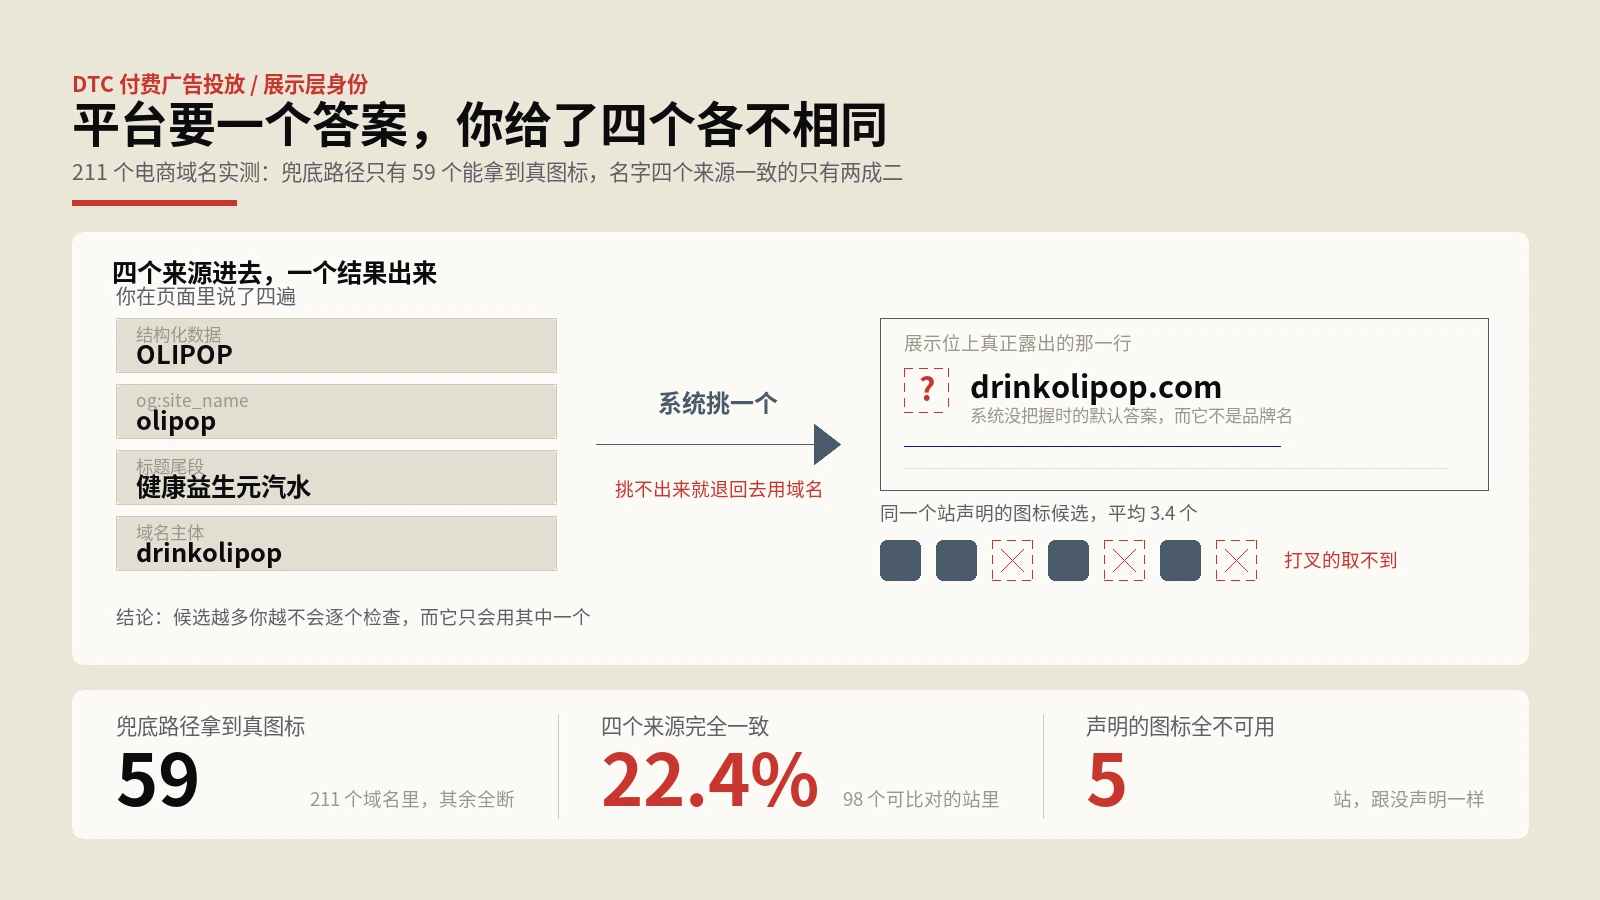
排查展示层身份要按顺序来:先数首页声明了几个图标,再逐个请求确认返回的是能读出宽高的图片,然后核对形状与尺寸,最后修兜底路径;名字那一半则是先补WebSite结构化数据,再把og:site_name和标题尾段调成同一个词。文中把这套顺序在211个国际化电商域名上走了一遍,逐步给出每一步该看什么、判据定在哪、什么情况可以放过,末尾附一张九项核对表和一份发布流程挂钩清单。
盘点品牌名要按顺序来:先把站上所有会说出名字的位置列全,再定一个顾客口头在用的基线名,最后逐个语言版本做减法。多出来的词按去处分流,国家地区直接删掉,法律后缀移进legalName,另一种文字移进alternateName,母公司名交给关系属性。文中把这套顺序在112个域名上走了一遍,逐步说明每一步该看哪个字段、判据定在哪、什么情况该弃权,末尾附一张六列盘点表、一张别名分流表和一份三分钟自检。

Googlebot对单个网址只取前2097152个字节,超出的部分不会报错,只是不存在。本文逐字节量了46个真实电商与建站平台的页面:未压缩HTML中位数972274字节、均值1131569字节,4个页面已越过上限,7个用掉八成以上预算,其中lovevery一个组合装页离上限只剩23个字节。更值得看的是受伤程度完全不按超标幅度排:anker两个页面超标最多却一个链接都没丢,allbirds男款分类页只超27.49%,288个链接被切掉9…

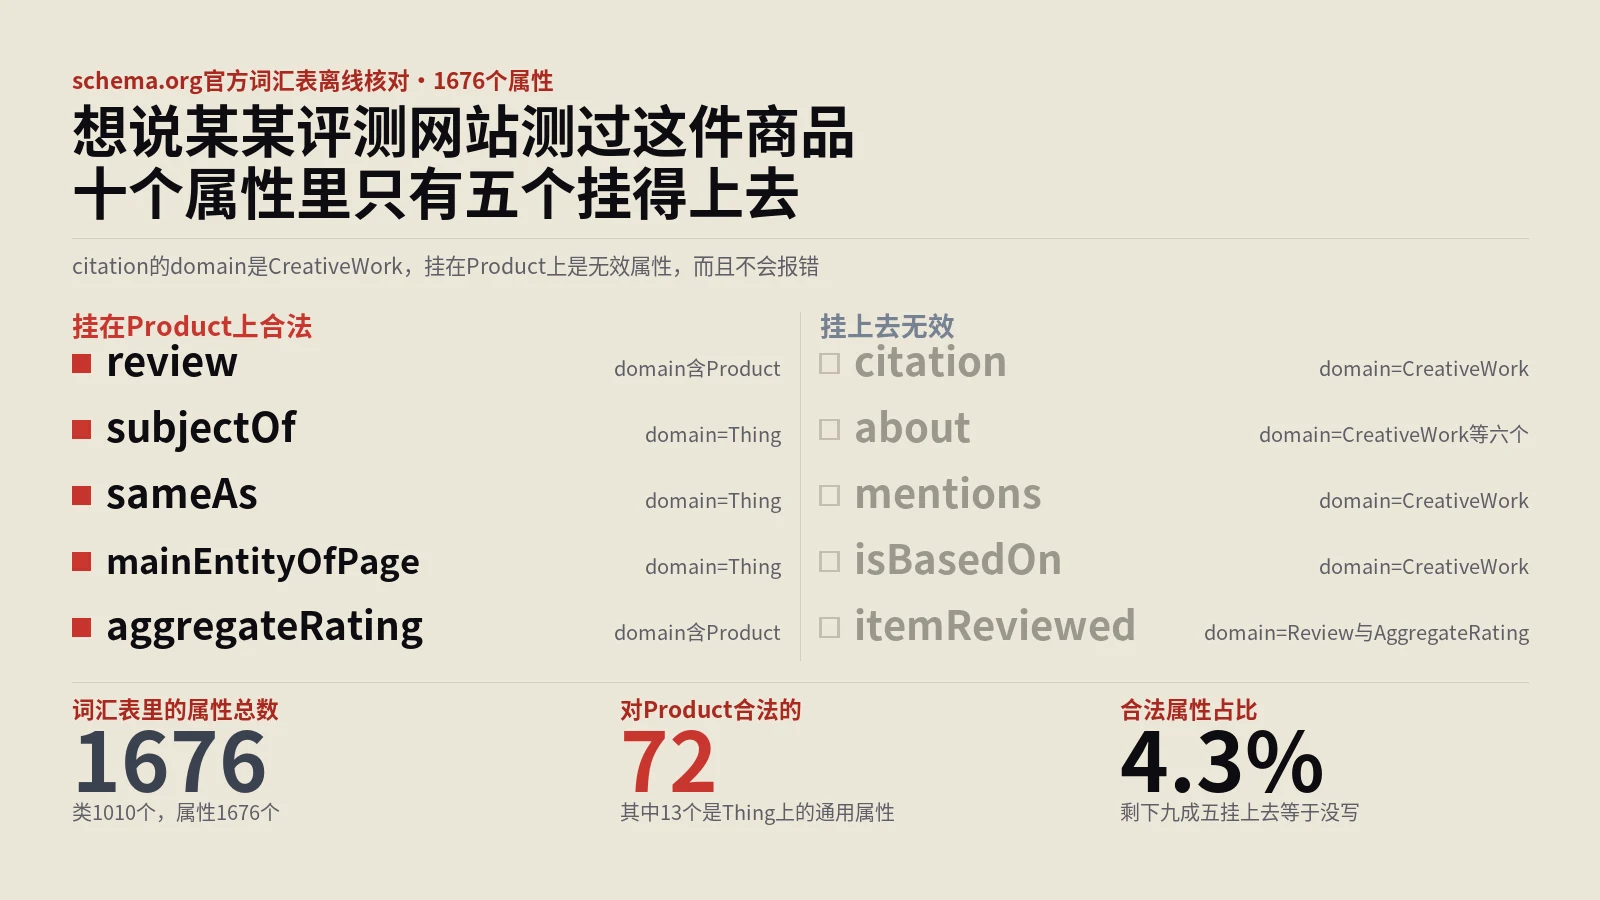
把评测网站的背书写成机器读得懂的关系,正确分工是Product节点上挂subjectOf、WebPage节点上挂citation,Review里再用itemReviewed反指回来把这条边闭合。这篇给出可以直接改的JSON-LD骨架,说明author为什么必须写成Organization、评分为什么绝对不能并进aggregateRating、验证该用schema.org官方验证器而不是富媒体结果测试,最后附一段查属性合法性的代码,自己就…
他买的是那一瓶,装进袋子的是哪一瓶,取决于两小时后货架上还剩什么。整条链路五只手,用户只在第一只手里出现过,而他说的那句话在第二只手里就被压成了一个布尔值。

结账页送达日期怎么写才不用用户自己算?从时长到哪天到,中间那一步加法一直由买家在脑子里完成。文中拆开需要现场心算的六类半成品数值,讲清替用户算完要哪些参数、哪些改动不增加承诺可以立刻做。

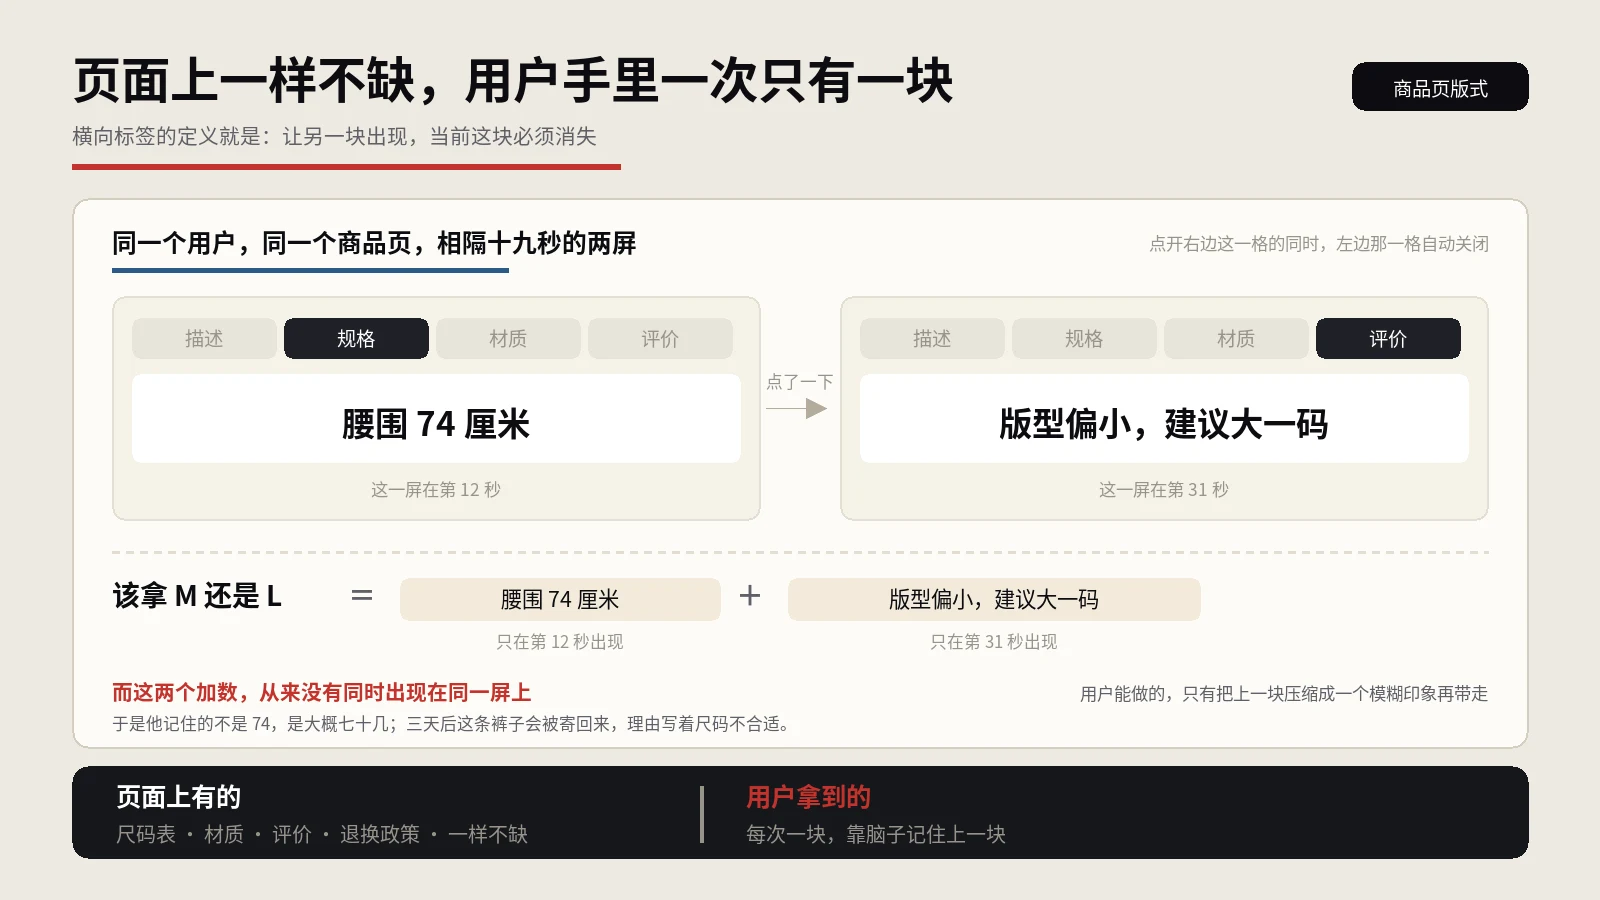
商品页横向标签页为什么该换成展开区块?这类容器一次只显示一块,用户没法把尺码和评价、参数和配件清单放进同一屏。文中给出并置需求清单的跑法、四个不用新埋点的指标,以及移动端横滑标签栏踩到的那条无障碍红线。
折扣的说服力全长在页面上,可这次降价成不成立,一个像素都不在页面上。这篇把参照价这件事拆开:美国那份1967年的老指南列了三个可比对象,做直连消费者品牌的人亲手砍掉了其中两个,只剩自己的价格历史可用,而那张表在多数站上根本不存在。
