NLWeb是什么?微软开源的网站对话接口,读的是你已经写好的Schema和RSS
本文目录
- NLWeb到底是什么,谁在做?
- 它算不算一个协议
- 一次提问在NLWeb里是怎么走完的?
- 接口参数
- 三种回答模式
- 一个请求长什么样
- 视频里说的结构化数据,包括哪些东西?
- 官方实现实际读的是什么
- NLWeb和llms.txt、Schema、MCP的区别
- 一个普通网站要怎么接入?
- 自己部署的大致步骤
- 成本主要花在哪
- 现在值不值得做,做SEO的人该怎么看?
- 哪些网站更值得试
- 先把能复用的东西做好
- 常见问题解答
- NLWeb是什么的缩写?
- NLWeb是谁开发的?
- NLWeb是什么时候发布的?
- NLWeb和MCP是什么关系?
- 视频里说的ASK协议是什么?
- NLWeb能读哪些数据?
- 装了NLWeb对Google排名有帮助吗?
- NLWeb的三种回答模式有什么区别?
- Wix的NLWeb集成有什么要求?
- NLWeb会不会让AI直接拿走网站内容?
- NLWeb和llms.txt有什么不同?
- NLWeb支持哪些大模型?
- 小型外贸网站需要部署NLWeb吗?
- 权威参考资料
摘要:NLWeb是微软2025年5月开源的项目,全称Natural Language Web,由RSS和Schema.org的创造者R.V. Guha主导。它让网站可以直接用自然语言回答人和AI代理的提问,答案用Schema.org格式的JSON返回,每个NLWeb实例同时也是一个MCP服务器。Moz在9月25日重发的白板星期五里,Wix的Crystal Carter把它介绍为让网站准备好迎接代理网络的工具,核心卖点是复用你已经做好的结构化数据。对照微软的GitHub文档,官方实现的数据入口是Schema.org、RSS、JSONL和CSV这类结构化列表,提问走ask和mcp两个接口,支持列表、摘要、生成三种模式。它目前和Google排名没有直接关系,最适合商品、菜谱、活动这类条目多、结构清楚的网站。
站内搜索框,可能是一个网站里最被忽视的功能。用户打一句长一点的话进去,比如我每周打两次网球,主要在红土场,脚偏宽,想找双不容易崴脚的鞋,大多数站内搜索要么什么都搜不到,要么给你一堆不相干的结果。
NLWeb想解决的就是这件事,而且不只给人用,也给AI代理用。Moz在9月25日的白板星期五里请了Wix的AI搜索与SEO传播负责人Crystal Carter,专门讲NLWeb是什么。页面上标注这期最早发布于2026年6月,这次是重发。
这篇以那期视频的内容为主体,对照微软的官方公告和GitHub文档,把NLWeb是什么、怎么运作、怎么上手、值不值得现在做讲清楚。
NLWeb到底是什么,谁在做?
NLWeb是微软的开源项目。微软2025年5月19日的发布公告说,它的目标是让网站用自己选择的模型和自己的数据,简单地做出一个自然语言界面,用户可以像问AI助手一样直接问网站里的内容。
项目由R.V. Guha构思和开发,他当时刚加入微软,任企业副总裁和技术院士。Guha是RSS、RDF和Schema.org这几个网络标准的创造者,Crystal Carter在视频里也特意提了这一点。做SEO的人每天在写的Schema标记,最早就出自他手。
公告里列出的首批合作方包括Chicago Public Media、Common Sense Media、DDM(旗下有Allrecipes和Serious Eats)、Eventbrite、Hearst(Delish)、O'Reilly Media、Shopify、Tripadvisor,以及Milvus、Qdrant、Snowflake这几家向量数据库和数据平台。媒体、菜谱、活动票务、旅游点评、电商,都是条目多、结构清楚的网站。
它算不算一个协议
这一点视频和官方文档的说法不太一样,值得对一下。
Crystal Carter说NLWeb不完全是一个协议,它用到了协议,用的是一个叫ASK的协议。微软GitHub仓库的说明则写得更具体:NLWeb是一组开放协议和配套的开源工具,有两个主要组成部分。
- 一个简单的协议,让人用自然语言和网站交互,返回Schema.org格式的JSON。
- 一个直接可用的实现,利用网站上已有的结构化列表标记,比如商品、菜谱、景点、评价,再配上界面组件,就能加上对话界面。
仓库里说的ask,是每个NLWeb实例都支持的核心方法,用来向网站提一个自然语言问题。视频里的ASK协议,指的就是这个方法和它对应的接口。
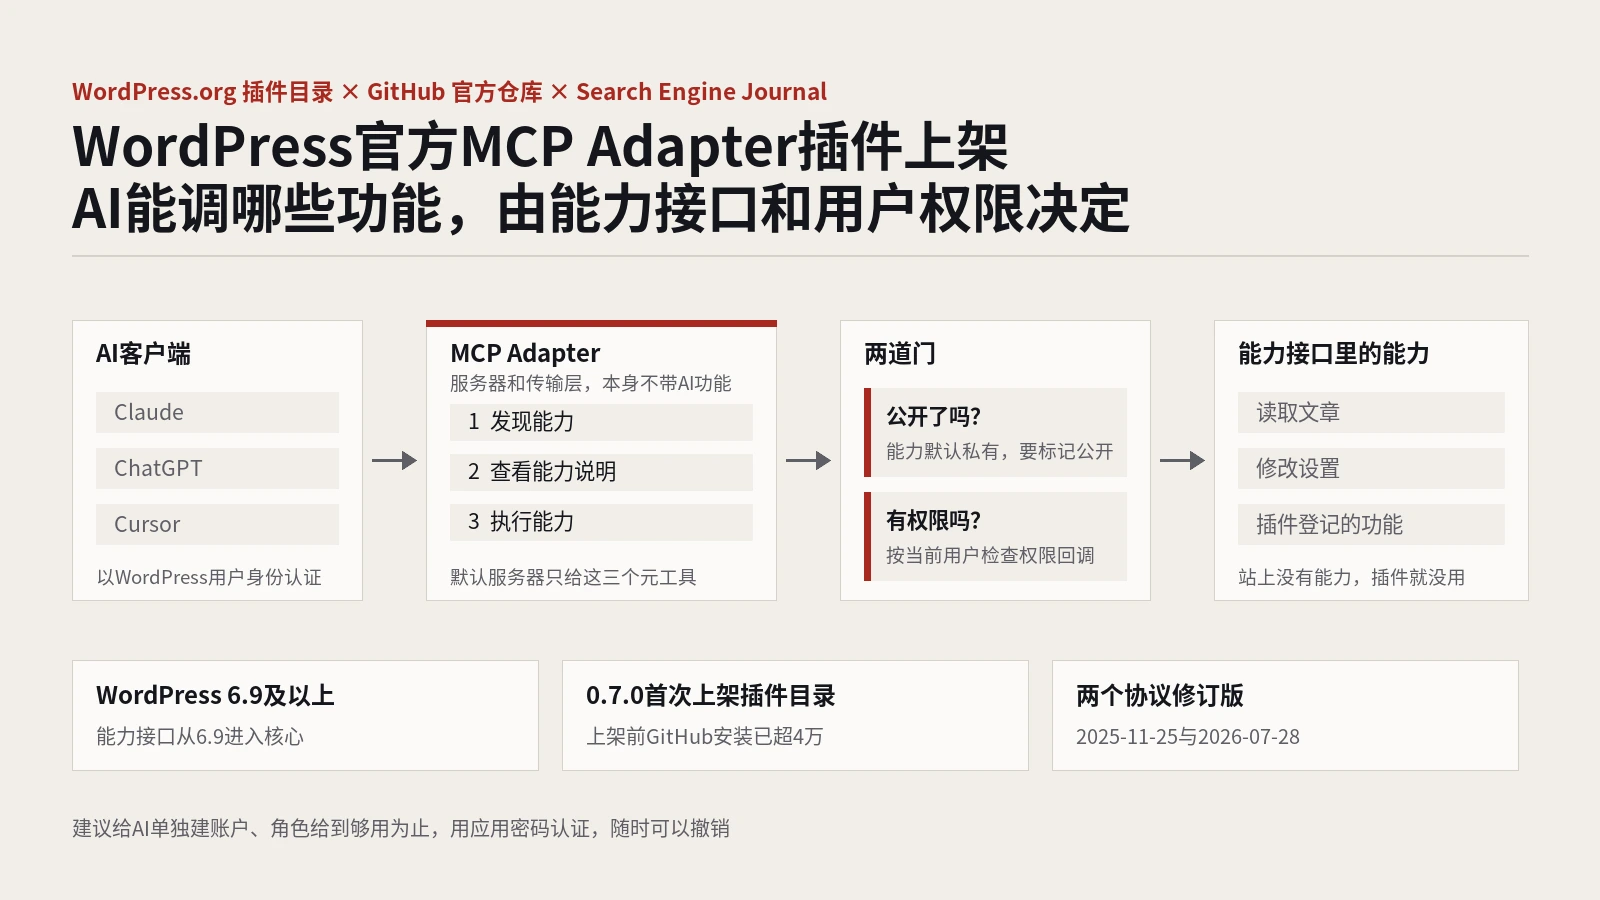
仓库说明里还有一句很有代表性的话:NLWeb之于MCP和A2A,就像HTML之于HTTP。MCP是模型上下文协议,A2A是代理之间通信的协议,都是让AI助手调用工具、互相协作的标准。每个NLWeb实例同时就是一个MCP服务器,说明里还写着A2A支持即将加入。
一次提问在NLWeb里是怎么走完的?
视频里用一个机器人代表AI代理,讲了一个完整的过程:人或者代理问了一个很长的问题,网站上装了NLWeb,就调用ask,去网站的结构化数据里找相关内容,用大模型理解问题、整理答案,需要的话还会调用网站的MCP工具,最后生成一个对提问者有意义的回答。
Crystal Carter强调的一个好处是,答案以网站自己的数据为依据,能减少大模型编造内容。
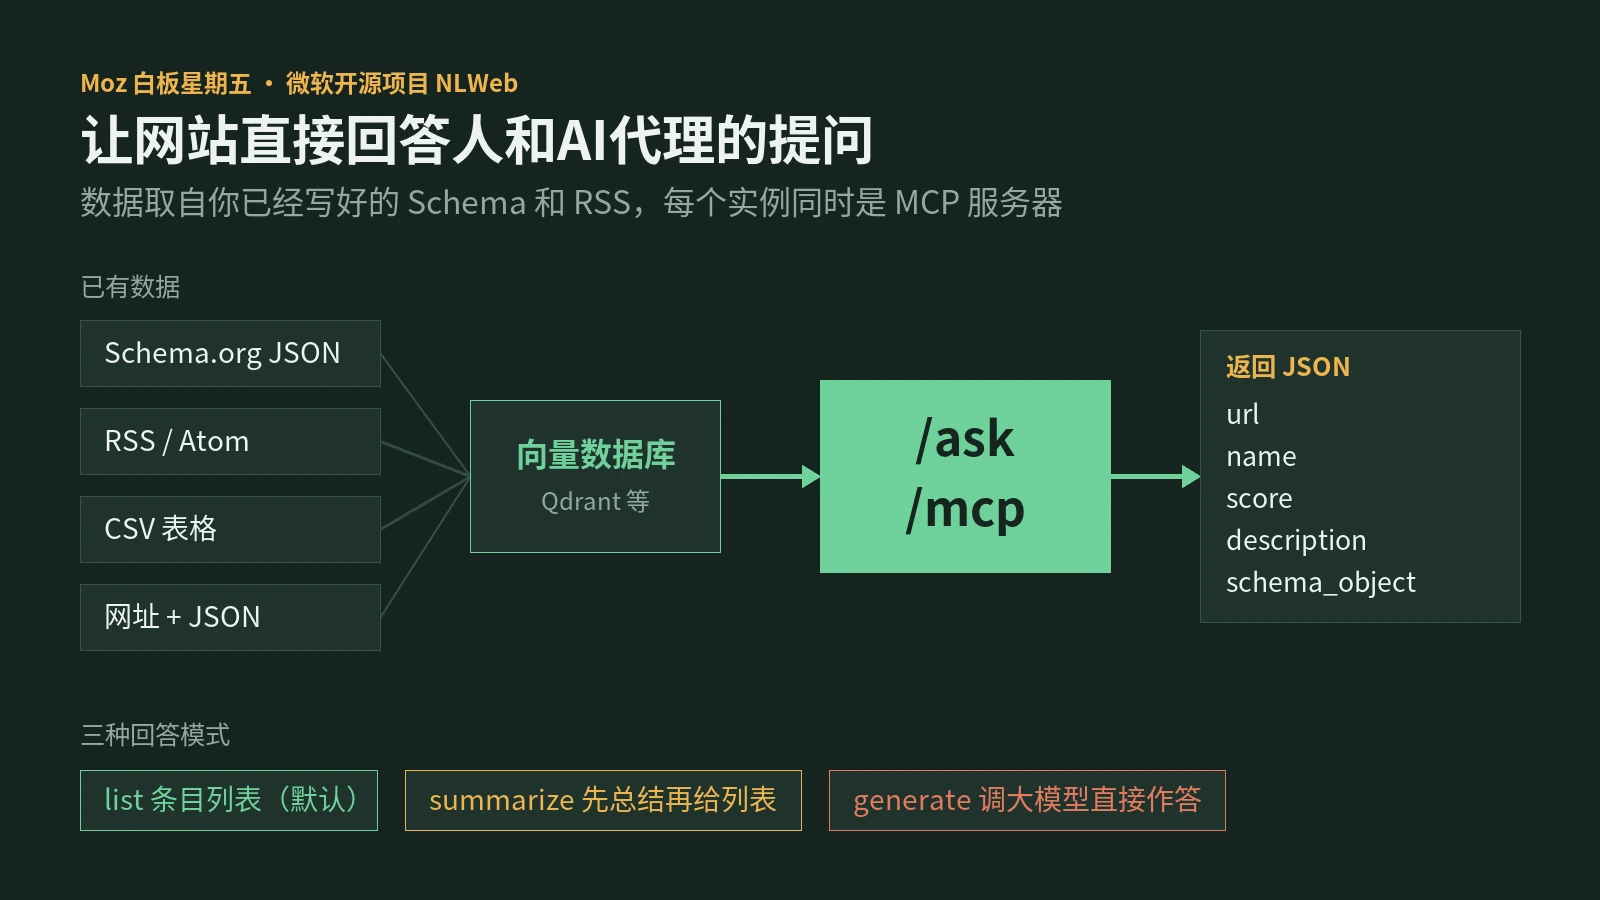
落到技术上,官方的REST接口文档写得很清楚。NLWeb目前提供两个接口:/ask和/mcp。两者参数相同,功能大部分一样,/mcp返回MCP客户端能用的格式,还支持MCP的核心方法,比如列出工具、调用工具。
接口参数
| 参数 | 是否必填 | 作用 |
|---|---|---|
| query | 必填 | 当前这一轮的自然语言问题 |
| site | 可选 | 一个后端可以承载多个站点,用它限定只查某个站的数据 |
| prev | 可选 | 之前问过的问题,逗号分隔,用来还原上下文 |
| decontextualized_query | 可选 | 已经补全上下文的完整问题,提供了服务端就不再处理 |
| streaming | 可选 | 默认流式返回,设为0或false关闭 |
| query_id | 可选 | 不填会自动生成 |
| mode | 可选 | list、summarize、generate三选一,默认list |
参考实现在服务端不保存对话状态,所以多轮对话的上下文要靠调用方自己传回去,这就是prev和decontextualized_query两个参数的用处。
三种回答模式
| 模式 | 返回什么 | 适合的场景 |
|---|---|---|
| list(默认) | 后端里和问题最相关的条目列表 | 找商品、找菜谱、找活动,用户自己挑 |
| summarize | 先对列表做个总结,同时返回列表 | 结果较多,需要先给个概览 |
| generate | 更接近传统的检索增强生成,调用一次或多次大模型来回答问题 | 用户想要一个直接的答案,不想看一串链接 |
返回结果是一个JSON对象,每条结果包含url、name、site、score、description和schema_object。description是大模型生成的,schema_object是从数据库里取出的这条内容的原始JSON。文档还说,结果数组之后会改成更丰富的结构,从Schema.org的ItemList开始。
一个请求长什么样
按文档里的参数,一次最简单的列表查询大致是下面这样。网址、问题和返回值都是演示用的,字段名以官方文档为准:
GET https://example.com/ask?query=适合宽脚的红土场网球鞋&mode=list&streaming=false

{
  "query_id": "q_8f2a",
  "results": [
    {
      "url": "https://example.com/products/clay-court-shoe-wide",
      "name": "Clay Court Pro Wide",
      "site": "example",
      "score": 0.87,
      "description": "宽楦设计,鞋底花纹针对红土场",
      "schema_object": { "@type": "Product", "name": "Clay Court Pro Wide", "offers": { "@type": "Offer", "price": "89.00", "priceCurrency": "USD" } }
    }
  ]
}
如果是代理通过MCP来调用,请求发往/mcp,参数相同,返回的格式换成MCP客户端能识别的样子。
这个设计对网站方有个实际意义:代理拿到的每条结果,都带着你自己写的结构化数据原文。你的Schema写得准不准、全不全,直接决定代理看到的是什么。
视频里说的结构化数据,包括哪些东西?
这一段是视频里讲得最有意思的部分。Crystal Carter说,很多人一听结构化数据,想到的就是Schema标记和JSON-LD。可在数据科学里,凡是给数据打了标签、做了组织,就是结构化。按这个理解,网站上的结构化数据包括:
- Schema标记。
- 标题标签、各级小标题,HTML列表和表格,这些SEO做了很多年的基本功。
- 商品数据源、博客或播客的RSS订阅源。
- XML站点地图。
- 自定义数据库,比如Wix里的CMS动态页面和数据集。
她的结论是,你这些年在Schema、小标题、HTML列表上下的功夫,现在都能派上用场,让网站为代理网络做好准备。她还引用了一个梗:那么多努力,换来了什么?换来了接入NLWeb的资格。
官方实现实际读的是什么
这个说法方向是对的,但和官方参考实现的数据入口对照一下,会更清楚哪些东西是直接用得上的。
按GitHub上的入门文档和数据加载工具说明,NLWeb的做法是先把数据计算成向量,存进向量数据库,查询时从库里检索。数据加载工具支持的格式是这五种:
- 每行两列,用制表符分隔,一列网址,一列JSON。
- 每行一列JSON,网址从JSON里取。
- 带表头的CSV文件。
- RSS或Atom订阅源。
- 指向上面任意一种格式的网址。
可以看出,官方实现直接吃进去的,是Schema.org格式的JSON、RSS和表格数据这类条目化的东西。网页上的小标题、列表、表格,要先被抽取、整理成这几种格式,才能进库。视频里把小标题也算作结构化数据,说的是更宽的理念;要在官方实现里用起来,还得多一步处理。
仓库说明里还有一条生产建议:大多数正式部署会直接连接实时数据库,避免复制内容带来的数据过时问题。对价格和库存经常变的电商站,这一点很关键,向量库里存一份旧价格,代理拿去回答用户,比回答不出来更麻烦。
NLWeb和llms.txt、Schema、MCP的区别
最近一两年冒出来的面向AI的网站标准不少,容易混在一起。放在一张表里看:
| 名称 | 是什么 | AI怎么用它 |
|---|---|---|
| Schema标记 | 写在网页里的结构化元数据 | 抓取网页时顺带读取,理解页面讲的是什么 |
| llms.txt | 放在网站根目录的Markdown文件,列出重要页面 | 读一份静态清单,知道网站有哪些内容 |
| MCP | 让AI助手调用外部工具的通用协议 | 通过协议调用工具、拿数据、执行操作 |
| NLWeb | 网站自己提供的自然语言问答接口,同时也是MCP服务器 | 直接向网站提问,拿回Schema.org格式的结果 |
前两个是被动的,等AI来读;后两个是主动的,AI可以向网站发请求。NLWeb把Schema这类被动数据,变成了可以被提问的接口。站内写过llms.txt的字段和部署方法,可以对照看两者的定位差别。
一个普通网站要怎么接入?
视频里提到了两条路,加上官方文档,大致有三种接入方式:
| 方式 | 要做什么 | 适合谁 |
|---|---|---|
| 自己部署开源代码 | 从GitHub拉代码,配置大模型、向量模型和向量数据库,导入数据,起服务 | 有开发资源、数据量大、要深度定制的团队 |
| 建站平台的一键集成 | Wix提供NLWeb集成,勾选即可,要求是付费套餐并绑定自定义域名 | 用Wix建站、没有开发资源的小商家 |
| 借助合作方的产品 | 视频说还有其他NLWeb合作方在推,官方文档列出了Cloudflare AutoRAG等后端支持 | 已经在用这些平台的网站 |
自己部署的大致步骤
官方的入门教程是在本机跑起来,用的是本地向量库和几个播客RSS做示例数据,要求Python 3.10以上。步骤压缩一下是这样:
- 克隆仓库,建一个Python虚拟环境。
- 进入AskAgent/python目录,安装依赖,会顺带装好本地向量库要用的包。
- 复制环境变量模板,填上你用的大模型接口密钥。
- 改config目录下的三个配置文件:大模型提供方、向量模型提供方、检索后端。教程里检索后端用本地的qdrant_local。
- 运行连通性检查脚本,确认密钥和配置都对。
- 用数据加载工具把RSS导进向量库,命令格式是
python -m data_loading.db_load 数据地址 站点名。 - 启动服务,打开自带的网页界面提问测试。
教程里默认的OpenAI模型是gpt-4.1和gpt-4.1-mini,向量模型默认是text-embedding-3-small。仓库说明列出的大模型支持包括OpenAI、DeepSeek、Gemini、Anthropic等,向量库支持Qdrant、Snowflake、Milvus、Azure AI Search、Elasticsearch、Postgres和Cloudflare AutoRAG。项目用MIT许可证。
对国内团队来说,模型可以选DeepSeek,这降低了一点门槛。不过外贸站的服务器和用户多在海外,部署位置、接口延迟、数据合规要一起考虑,别只看模型便宜。
成本主要花在哪
开源代码不要钱,跑起来要钱的地方有三处:导入数据时计算向量的费用、每次提问调用大模型的费用、向量数据库的托管费用。条目越多、提问越多,费用越高。generate模式要调用一次或多次大模型,比list模式贵得多。上线前最好先估一下每月的提问量。
现在值不值得做,做SEO的人该怎么看?
先说清楚几件NLWeb目前做不到的事。
它和Google排名没有直接关系。没有任何公开信息表明Google、必应或者ChatGPT的搜索会去调用网站的NLWeb接口来生成答案。装了NLWeb,你的网站多了一个能被代理调用的接口,可代理怎么知道这个接口存在,是另一个问题。仓库里有一个叫AgentFinder的模块,定位是在网络上发现和路由到NLWeb代理的服务;行业里也有别的发现规范在推,比如站内讲过的ARD代理资源发现和Lighthouse的新审计,目前都还在早期。
Crystal Carter在视频里也说,代理网络现在还很偏大企业,提到的是万事达、Stripe、沃尔玛这些公司。她认为NLWeb的价值在于让任何网站都能用一次配置接上代理。这个判断有道理,但也要注意她的身份:她在Wix工作,Wix正好提供了NLWeb的一键集成。视频本身没有给出任何采用率或效果数据。
还有一点容易被忽略。仓库说明里写得很直白:NLWeb提供的实现代码只是概念验证,展示一种可能的做法,不是最终方案,项目希望社区做出超越这些示例的各种实现。仓库现在也不只一个问答服务,还拆出了几个模块:AskAgent是核心的问答代理,AgentFinder负责发现代理,DataFinder把自然语言翻译成SQL去查HubSpot、Dynamics 365、Jira这类企业数据,ModelRouter按质量门槛挑性价比合适的模型,NLWebScorer是给检索结果打分的模型。仓库说明还提到,持续集成和自动部署流程目前没有包含在内。
这说明NLWeb的定位更像一套参考设计和工具箱,要拿去跑正式业务,团队得有能力自己补测试、监控和运维。
哪些网站更值得试
- 条目多、结构清楚的网站:商品目录、菜谱、活动、房源、课程。官方实现本来就是围绕结构化列表设计的,首批合作方也集中在这几类。
- 站内搜索体验差、用户问题又比较复杂的网站。NLWeb本身就是一个更好的站内问答,对人也有用,不必等代理普及。站内测过的电商站内搜索查无结果的页面,问题很普遍。
- 已经在用Wix付费版的小商家,接入成本几乎为零,可以先开着看看。
对内容量不大的外贸B2B企业站,几十个产品页、十几篇博客,单独部署一套NLWeb的投入产出比不高。更实在的做法,是先把视频里说的那些基本功做好,这些投入不管NLWeb以后发展得怎样,都不会浪费。
先把能复用的东西做好
不管最后是NLWeb、MCP,还是别的什么代理接口胜出,它们读网站时都更依赖条目化、字段清楚的数据,少靠模型从一大段文字里猜。可以先做这几件事:
- 商品页的Product标记把价格、库存、型号、品牌、规格写全,和页面显示的一致。按全网采用度排优先级的方法,可以参考Schema使用统计数据的解读。
- 博客和资讯保留一个可用的RSS订阅源,很多建站系统默认就有,别为了省事关掉。RSS是NLWeb官方实现直接支持的数据入口。
- 商品数据源保持更新,它既是Merchant Center的入口,也可以作为NLWeb的数据来源。
- 网页上的操作对代理友好,表单、按钮、筛选能被机器识别。站内做过AI代理能不能在网站上完成操作的检查,四个常见动作,能全部顺利完成的站很少。
串起来说,NLWeb目前更像一个方向明确、工具已经能用的早期项目。它最大的意义,是证明了Schema和RSS这些老标准在代理时代还有新用途。值不值得现在部署,看你的网站有没有大量结构化条目,以及站内搜索是不是真的拖了后腿。
常见问题解答
NLWeb是什么的缩写?
NLWeb是Natural Language Web的缩写,意思是自然语言网络。它是微软开源的项目,让网站可以用自然语言回答人和AI代理的提问。
NLWeb是谁开发的?
由R.V. Guha构思和开发,他是RSS、RDF和Schema.org的创造者,2025年加入微软任企业副总裁和技术院士。项目由微软和开源社区共同维护。
NLWeb是什么时候发布的?
微软在2025年5月19日正式发布NLWeb。GitHub仓库创建于2025年4月底,使用MIT许可证。
NLWeb和MCP是什么关系?
每个NLWeb实例同时是一个MCP服务器,提供/mcp接口,支持列出工具、调用工具等MCP核心方法。官方的说法是,NLWeb之于MCP和A2A,就像HTML之于HTTP。
视频里说的ASK协议是什么?
指NLWeb的核心方法ask和对应的/ask接口,用来向网站提一个自然语言问题。官方文档里它和/mcp接口参数相同,返回Schema.org格式的JSON。
NLWeb能读哪些数据?
官方数据加载工具支持网址加JSON的制表符分隔文件、纯JSON、带表头的CSV、RSS或Atom订阅源,以及指向这些格式的网址。数据会先计算成向量存进向量数据库。
装了NLWeb对Google排名有帮助吗?
没有证据表明有直接帮助。目前没有公开信息显示Google或其他AI搜索会调用网站的NLWeb接口。它更直接的价值是改善站内问答和对代理的可调用性。
NLWeb的三种回答模式有什么区别?
list返回最相关的条目列表,summarize先总结再给列表,generate调用大模型直接回答问题,更接近传统的检索增强生成,费用也更高。
Wix的NLWeb集成有什么要求?
按视频里的说法,需要Wix付费套餐并绑定自定义域名,满足条件后勾选启用即可。
NLWeb会不会让AI直接拿走网站内容?
NLWeb是网站方自己部署的接口,返回哪些数据、对谁开放,由网站方决定。微软公告的说法是,让网站在自己愿意的前提下,参与代理网络。
NLWeb和llms.txt有什么不同?
llms.txt是一份静态的页面清单,AI只能读;NLWeb是可以提问的接口,AI发一个自然语言问题,网站返回匹配的条目或答案。
NLWeb支持哪些大模型?
仓库说明列出的有OpenAI、DeepSeek、Gemini、Anthropic、Inception和HuggingFace上的模型,可以在配置文件里切换。
小型外贸网站需要部署NLWeb吗?
条目少的网站单独部署投入产出比不高。先把Product标记、RSS订阅源、商品数据源这些基础做好,以后接任何代理接口都用得上。
权威参考资料
本文标题:《NLWeb是什么?微软开源的网站对话接口,读的是你已经写好的Schema和RSS》
本文链接:https://zhangwenbao.com/nlweb-natural-language-web-ask-schema-mcp-guide.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0