Google UGC新鲜数据计划门槛实测:92个品牌社区,42个结构化数据已达标
本文目录
- UGC新鲜数据计划要什么样的平台?
- 它和Indexing API、普通抓取有什么不同?
- Google和论坛、社交平台打交道的这些年
- 大公司的官方社区,结构化数据做到了哪一步?
- 样本是怎么来的
- 查出来的结果
- 同样用Discourse,为什么标法不一样?
- eBay的社区为什么一边有一边没有
- 做外贸和独立站的,这件事和你有多大关系?
- 真想申请,另外几条门槛怎么自查
- 还有哪些事Google没说
- 常见问题解答
- UGC新鲜数据计划是什么时候推出的?
- 普通独立站能申请UGC新鲜数据计划吗?
- 入选了就能更快出现在Google搜索里吗?
- 论坛用问答标记还是论坛帖标记?
- 用Discourse搭的论坛,默认就有论坛帖标记吗?
- interactionStatistic支持哪些互动类型?
- 申请表里的10个示例网址怎么选?
- UGC新鲜数据计划和Indexing API是一回事吗?
- 权威参考资料
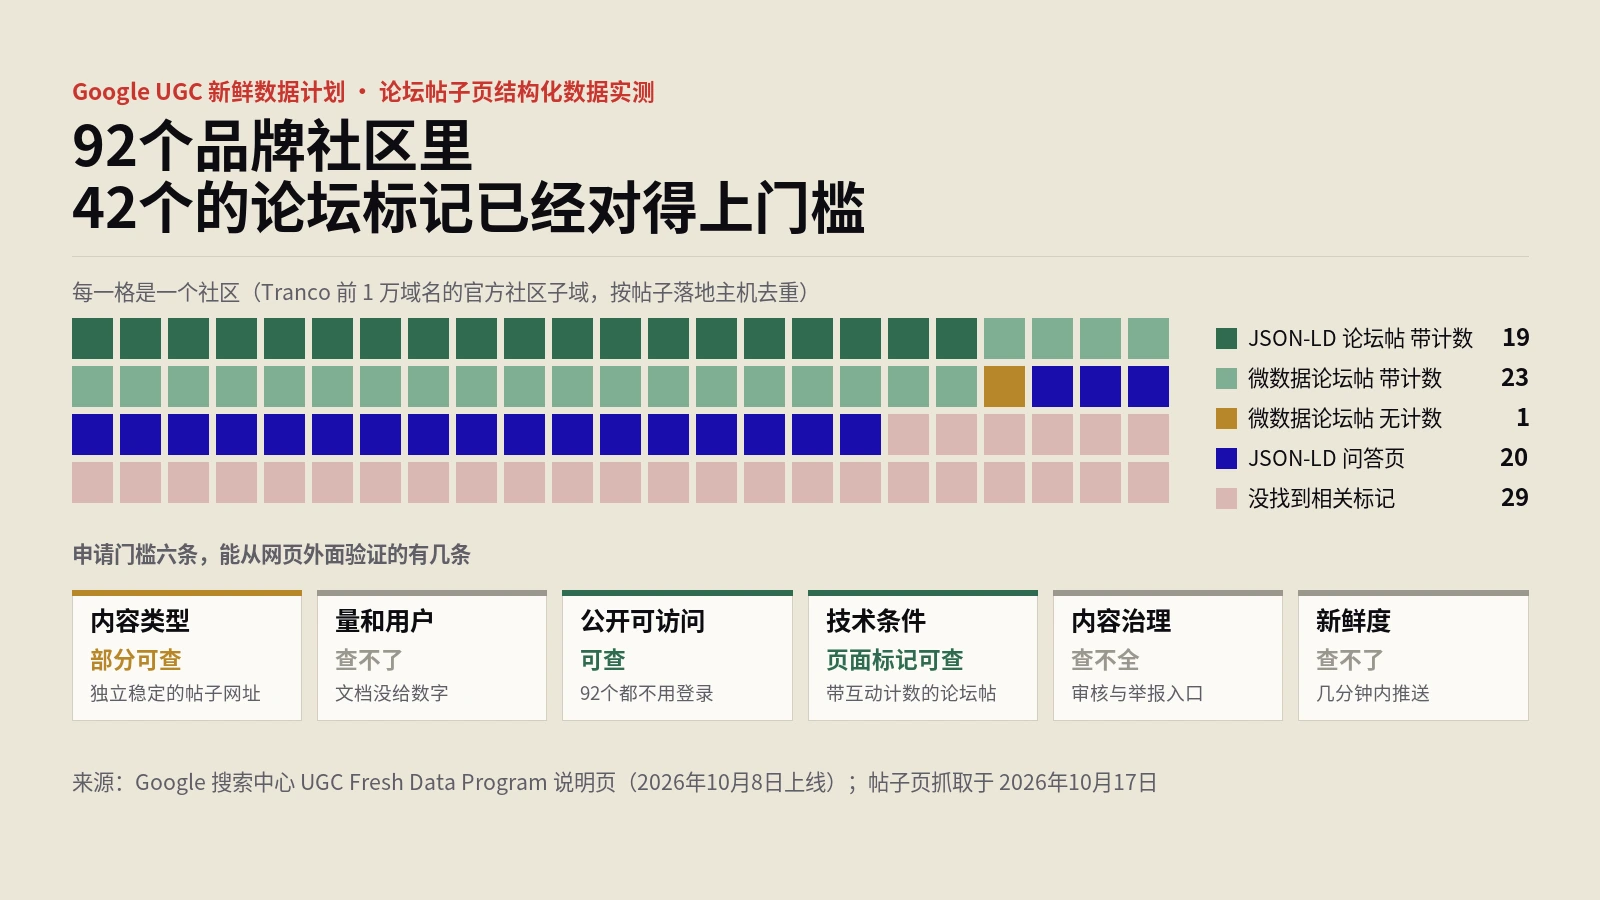
摘要:Google在10月8日开放了UGC新鲜数据计划的申请,论坛和社交平台获批后,可以绕开抓取,直接把帖子和点赞、浏览、回复这些互动数据推给Google。六条申请门槛里,能从网页外面验证的只有结构化数据这一条。我们从Tranco前1万个域名里找出92个能打开帖子页的官方社区:42个已经用论坛帖标记,并带上了互动计数;20个标成了问答页;29个在抽到的帖子页里找不到相关标记,eBay美国、英国、加拿大的社区都在里面。
Google这次给论坛开了一条“快速通道”。
10月8日,Google搜索中心的文档更新日志里多了一条:新增了一页,介绍一个叫UGC Fresh Data Program的计划,直译过来是“用户生成内容新鲜数据计划”。获批的论坛和社交平台,可以通过一条专门的数据接收通道,把帖子内容和互动信号直接发给Google。文档说,这条通道独立于Indexing API,也独立于普通的网页抓取。
Search Engine Journal在10月16日的报道把这件事和Google过去的合作做了对比:2009年接入Twitter做实时搜索,2024年拿到Reddit的数据接口。那几次都是点名合作,这次第一次公开了申请条件和申请表。
门槛写在明处,就可以去量一量。我们挑了申请条件里唯一能从网页外面检查的一条,看看大公司的官方社区现在离它有多远。
UGC新鲜数据计划要什么样的平台?
Google在文档里列了六条资格要求,原文的意思整理如下:
| 要求 | 文档原文的意思 | 从网页外面能不能验证 |
|---|---|---|
| 内容类型 | 平台主要承载用户内容、社交帖子或论坛讨论;每条内容要有独立、稳定的网址,不能只存在于个人主页或信息流里 | 部分能,看有没有独立帖子页 |
| 量和用户 | 用户内容量大,用户基数可观 | 不能,文档没给具体数字 |
| 公开可访问 | 内容在Googlebot和用户都能打开的公开页面上,需要登录或付费才能看的不算;每条内容要能对应到一个有公开主页的作者 | 能 |
| 技术条件 | 能做OAuth 2.0接口认证,能生成严格校验的JSON-LD数据;页面上已经有或准备加有效的schema.org标记,比如带interactionStatistic的SocialMediaPosting或DiscussionForumPosting | 页面标记这部分能 |
| 内容治理 | 不发违法内容,有持续的内容审核,用户能举报 | 不能完整验证 |
| 新鲜度 | 内容越新越好,理想情况是几分钟内发送;互动计数要能在发帖后72小时内持续更新 | 不能 |
申请表有七个必填项:公司名、服务域名、10个用户内容示例网址、月活跃用户数、上线日期、Search Console所有者邮箱、联系邮箱。Google说会在6到8周内答复,获批后再给技术接入文档。
有三件事文档写得很明白,别想多了:
- 入选不保证内容出现在搜索结果里,排名照样由算法决定。
- “几分钟内发送”说的是平台发过去的速度,没承诺Google几分钟内就收录。
- 它不取代公开网址。要求里写着内容必须在Googlebot能打开的公开页面上,所以抓取那一套照样要做好。
它和Indexing API、普通抓取有什么不同?
三条路都是让Google更快知道你的内容,交出去的东西不一样。
| 方式 | 谁能用 | 交给Google的是什么 | 需要审批吗 |
|---|---|---|---|
| 站点地图、Search Console请求编入索引 | 所有网站 | 网址,Google再自己来抓 | 不需要 |
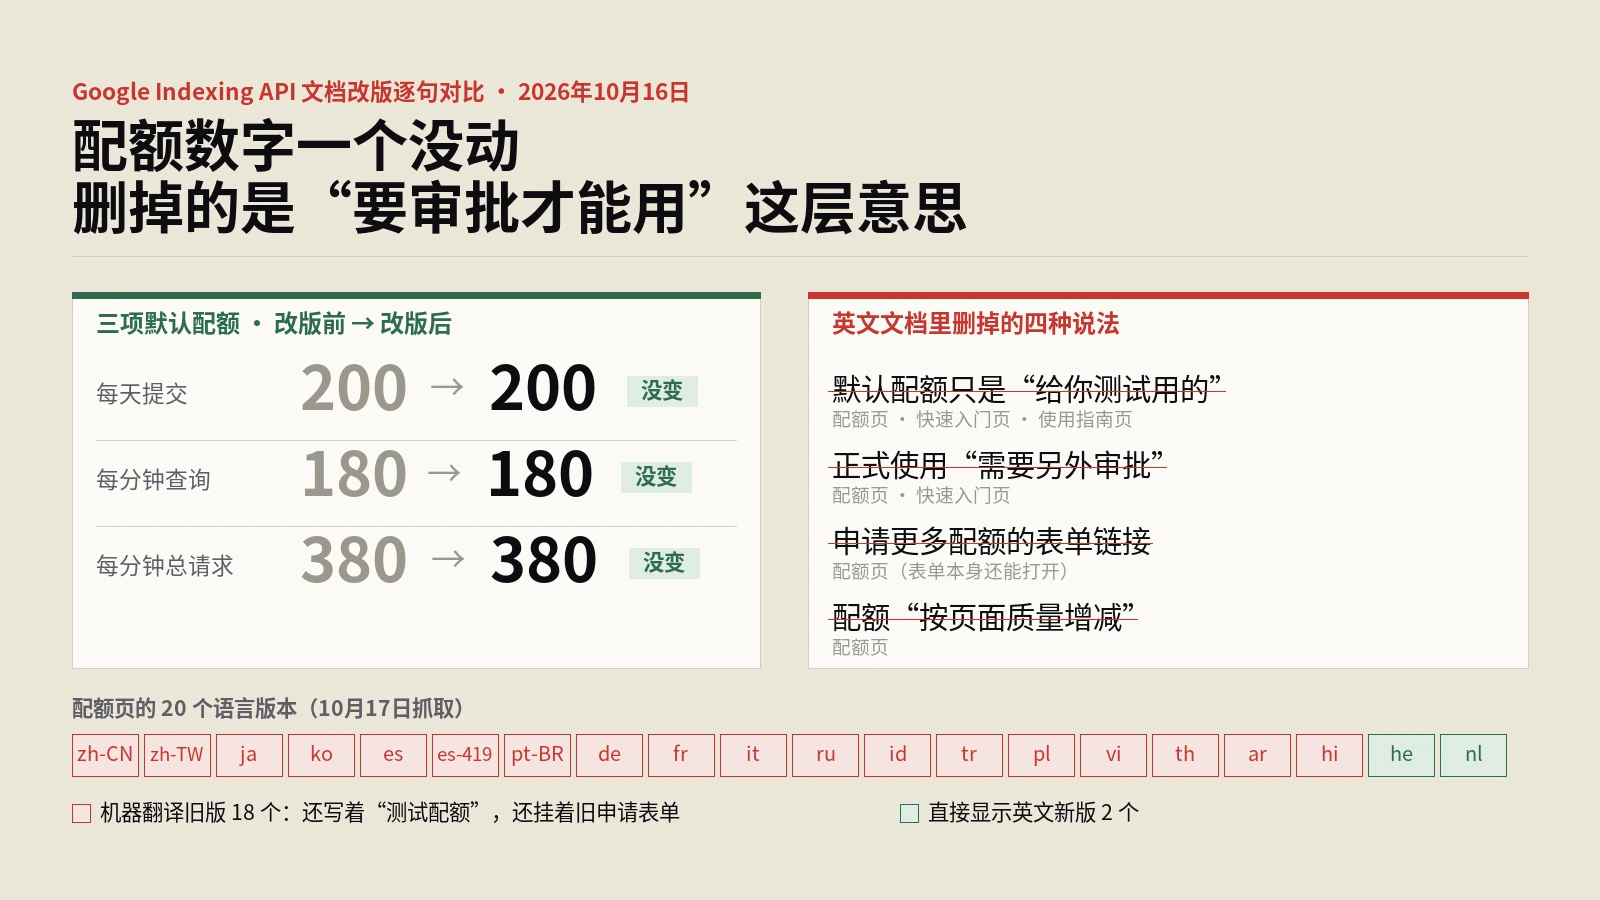
| Indexing API | 职位页和直播视频页 | 网址加一个“已更新”或“已删除”的通知,Google据此安排重新抓取 | 文档10月16日起不再写审批流程,默认每天200次 |
| UGC新鲜数据计划 | 获批的论坛和社交平台 | 帖子内容本身,加上互动数据 | 需要,申请后6到8周答复 |
前两种交的都是网址,第三种交的是内容和互动数字。Google要的东西变了,说明它在意的已经不只是“这个页面存在”,还包括“这条帖子现在有多少人在看、在回”。
Indexing API那一行的变化,就发生在同一周。10月16日Google改了它的文档,删掉了“默认配额只供测试、正式使用要审批”的说法,站内Indexing API文档改版对比一文逐句对过。
Google和论坛、社交平台打交道的这些年
这次不是Google第一次直接拿社交平台的数据。把时间线排一下,能看出它一直在两条线上走:一条是和大平台点名合作,一条是用结构化数据让所有论坛自己“报数”。
| 时间 | 发生了什么 |
|---|---|
| 2009年12月 | Google推出实时搜索结果,展示Twitter、FriendFeed等网站的实时动态 |
| 2011年7月 | Google和Twitter的协议在7月2日到期 |
| 2015年 | 推文重新进入Google搜索,5月先上移动端,8月上桌面端 |
| 2023年11月 | Google推出论坛和个人资料页结构化数据,并在Search Console里加了对应报告 |
| 2024年2月 | Google宣布接入Reddit的数据接口,说这些数据可以用于展示、训练等用途 |
| 2024年6月 | 论坛标记文档确认也支持SocialMediaPosting |
| 2026年3月 | 论坛和问答标记新增描述回复结构的属性,以及标注AI生成内容、机器人内容的字段 |
| 2026年10月8日 | UGC新鲜数据计划说明页上线,公开申请条件和申请表 |
前几次合作都只点了名,没公开技术细节。这次条件和申请表都摆了出来,计划页面也把论坛结构化数据写进了申请门槛。两条线算是接上了:页面上的标记做得好,才有资格走那条直通车。
大公司的官方社区,结构化数据做到了哪一步?
六条门槛里,“页面上有带互动计数的论坛帖标记”这一条,谁都能从外面查。我们就查它。
样本是怎么来的
样本来自Tranco网站排名前1万个域名。我们给每个域名拼上community、forum、forums、discuss、discussions五种子域名,一共5万个候选,先过滤掉“随便什么子域名都能解析”的泛解析域名,再请求首页。
能正常打开首页的有799个。再从首页的HTML里找帖子链接,每个社区取最多两个帖子页来解析。最后能拿到帖子页的有111个,按帖子最终落在哪个主机去重,并剔除成人站点之后,剩下92个社区。
这个样本有个明显的短板。很多社区首页靠JavaScript加载帖子列表,HTML里没有链接,就被漏掉了,所以799个里只有113个找到了帖子链接。用Khoros、Salesforce这类商业社区系统的大品牌,在样本里偏少。下面的比例只代表“首页能直接看到帖子链接的那一类社区”。
查出来的结果
| 帖子页上的标记情况 | 社区数 | 例子 |
|---|---|---|
| JSON-LD论坛帖或社交帖,带互动计数 | 19 | MacRumors论坛、FreeBSD论坛、Proxmox论坛、Vercel社区、Square社区、eBay澳大利亚社区 |
| 微数据论坛帖,带互动计数 | 23 | Unreal Engine论坛、Tailscale论坛、n8n社区、Wolfram社区、Make社区 |
| 微数据论坛帖,未见互动计数 | 1 | Netgate论坛 |
| JSON-LD问答页 | 20 | Hugging Face论坛、Let's Encrypt社区、Fedora讨论区、Obsidian论坛、Perplexity社区 |
| 没找到相关标记 | 29 | eBay美国、英国、加拿大社区,Ubiquiti社区,Databricks社区,Xfinity论坛,CSDN论坛 |
算下来,92个里有42个已经做到了“论坛帖标记加互动计数”,接近一半。这42个在页面标记这一条上,基本可以直接对上Google的例子。
JSON-LD那19个里,17个把文档推荐的五项都填了:作者名、作者主页链接、发布时间、正文、互动计数。剩下两个各缺一项,一个没写正文,一个没写作者主页链接。
互动计数里,19个全都有评论数。其中有浏览数的14个,有点赞数的11个。FollowAction(关注数)出现了3次,但它不在Google论坛标记文档列出的五种互动类型里,算不算数要看Google那边怎么处理。
没有一个社区要求登录才能看帖。这一条在样本里全部过关。
作者主页链接的情况也不错。JSON-LD论坛帖的19个里18个写了作者主页,微数据论坛帖的24个全都写了,问答页的20个里有18个写了。大多数社区软件默认就会输出作者链接,这一项基本不用操心。
有人会问:标记都齐了,是不是就能入选?没那么简单。标记只是六条里最容易做到的一条,用户量、内容量、审核能力、实时推送能力,每一条都比加几行代码难。反过来说,连标记都没有的社区,在技术条件这一项上已经先输了,而这是成本最低、最快能补上的一项。
同样用Discourse,为什么标法不一样?
92个社区里,41个在网页代码里写明了自己用的是Discourse,这是开源社区软件里用得最多的一种。
这41个的标记分成了三种:20个用微数据标论坛帖,17个用JSON-LD标问答页,4个在抽到的帖子页里没找到相关标记。同一套软件出三种结果,和各站的配置、插件、帖子类型有关,具体是哪个开关造成的,这次没有逐一核实。
自己用Discourse的话,查起来很简单:打开一个帖子页,查看网页源代码,搜“DiscussionForumPosting”和“QAPage”这两个词,看出现的是哪一个,再搜“interactionStatistic”看互动计数在不在。
问答页和论坛帖在Google那边是两类东西。Google的论坛结构化数据文档开头就说,如果你的论坛是一问一答的形式,应该用问答标记。所以标成问答页本身不算错。
麻烦在于,UGC新鲜数据计划举的例子是SocialMediaPosting和DiscussionForumPosting,要求带interactionStatistic。我们查到的20个问答页,只有5个的页面里出现了interactionStatistic这个字段。如果Google审核时卡得严,这些社区可能要补互动计数,或者另外准备论坛帖格式的数据。文档没说问答标记算不算,这一点只能等它把技术文档发给入选者之后才知道。
eBay的社区为什么一边有一边没有
eBay的例子挺有意思。eBay澳大利亚社区的帖子页,用JSON-LD标了论坛帖,五项齐全。eBay美国、英国、加拿大社区的帖子页,我们没找到任何相关标记。
两边为什么差这么多,这次没有去核实它们背后是不是同一套社区系统。能确定的是:同一个品牌,换一个国家站,结构化数据可能就从齐全变成空白。品牌方要查,得每个站点各抽几个帖子页看,只查总站不够。
做外贸和独立站的,这件事和你有多大关系?
直接关系不大。这个计划要的是“用户内容量大、用户基数可观”的平台,普通独立站的评论区、问答区,量远远不够。
间接影响可不小。
Google搜索里早就有“讨论和论坛”板块,Reddit在搜索结果里的存在感也有目共睹,站内Reddit霸榜谷歌前三的数据那篇记录过。现在大平台可以直接把新帖推给Google,热门讨论进搜索的速度只会更快。你的产品在论坛里被讨论,正面的、负面的,都会更快被搜到。
有几件事可以现在就做。
如果你的品牌有自己的社区或用户论坛,先查帖子页有没有论坛帖标记。用Google的富媒体搜索结果测试工具贴一个帖子网址,看能不能识别出DiscussionForumPosting。具体字段怎么写,站内Google论坛和问答结构化数据那篇有完整示例。
查一查互动计数有没有标。很多社区只标了作者和时间,没有interactionStatistic。按Google文档,支持的互动类型有五种:点赞、点踩、浏览、评论(或回复)、转发。挑你页面上真实显示的数字去标,页面上没显示的别硬加。
一个帖子页的最简写法大概是这样,字段名照抄,内容换成你页面上真实显示的:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "DiscussionForumPosting",
  "headline": "帖子标题",
  "text": "楼主发帖的正文",
  "url": "https://example.com/t/12345",
  "datePublished": "2026-10-16T09:30:00+08:00",
  "author": {
    "@type": "Person",
    "name": "发帖人昵称",
    "url": "https://example.com/u/nickname"
  },
  "interactionStatistic": [
    {"@type": "InteractionCounter", "interactionType": "https://schema.org/LikeAction", "userInteractionCount": 27},
    {"@type": "InteractionCounter", "interactionType": "https://schema.org/ViewAction", "userInteractionCount": 1532},
    {"@type": "InteractionCounter", "interactionType": "https://schema.org/CommentAction", "userInteractionCount": 9}
  ]
}
</script>
回复可以放进comment字段,按页面上的顺序排;回复太多没全显示的,用commentCount写总数。多页的长帖,后面几页的url都写第一页的地址。这几条都是Google论坛标记文档里的原话,不是我们自己定的规矩。
看看作者名有没有链到公开主页。计划要求每条内容都能对应到一个有公开主页的作者,论坛标记文档也把author.url列为推荐项。作者主页如果要登录才能看,这一条就过不了。
帖子页里有AI生成的回复或机器人自动回复的,可以用digitalSourceType字段注明。Google的论坛标记文档写着,不注明就默认是人写的。
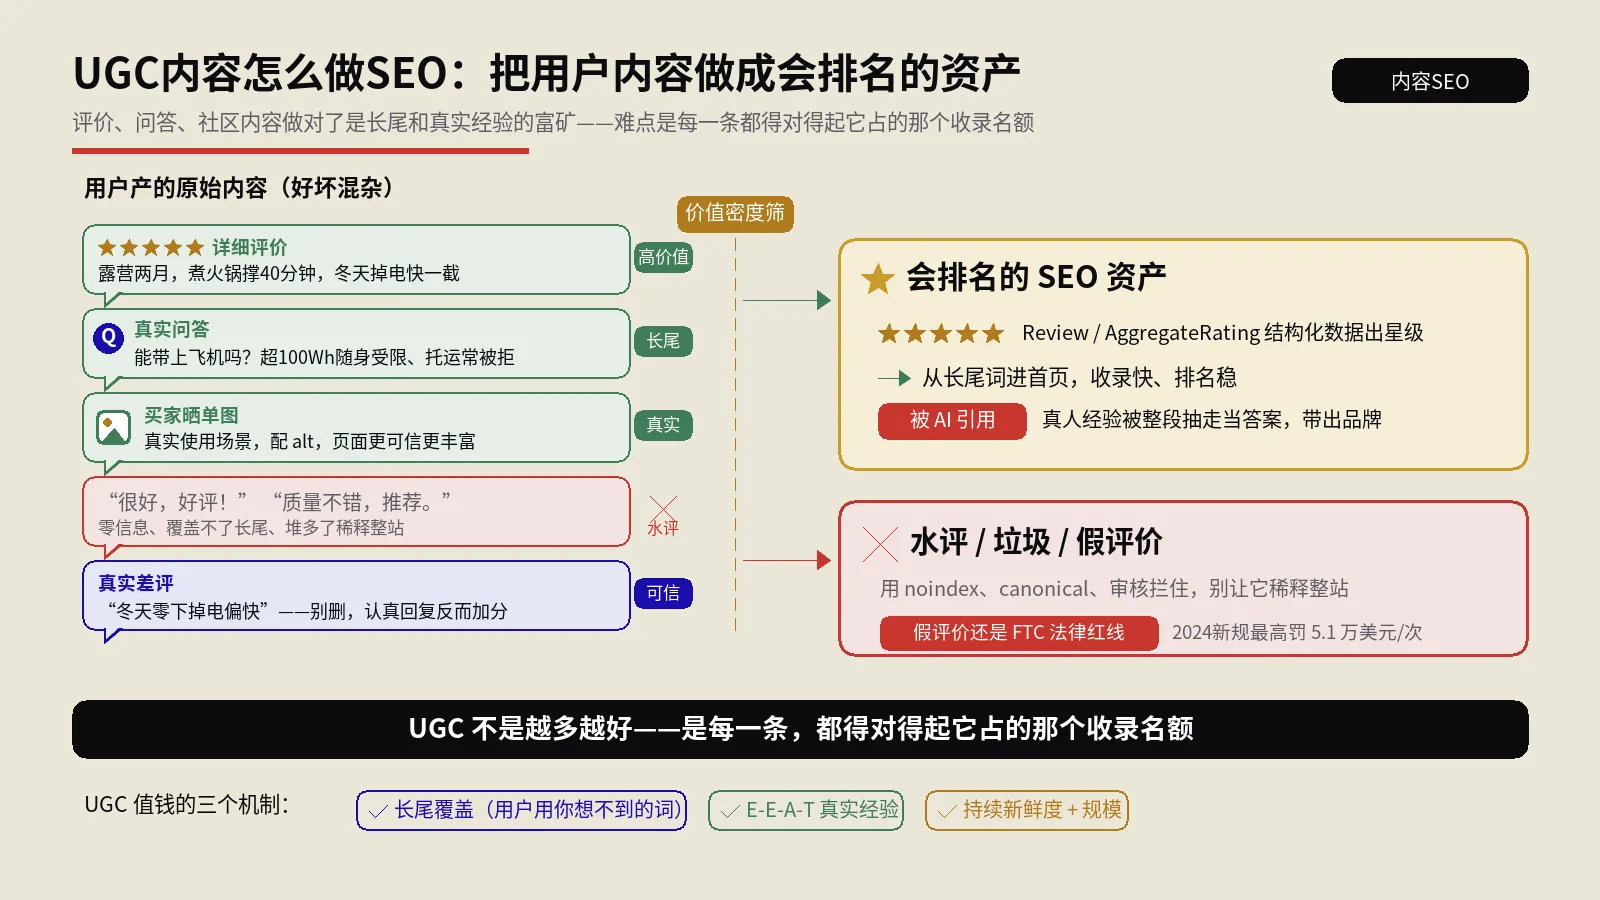
如果你没有自己的社区,那就关注别人社区里关于你的讨论。用户内容怎么为自己所用,站内UGC内容SEO那篇讲过评价、问答、社区内容各自的做法。
真想申请,另外几条门槛怎么自查
结构化数据只是六条里的一条。如果你负责的社区量确实够大,想试一试,其余几条可以按下面的顺序过一遍。
先看帖子有没有自己的网址。每条帖子要有独立、稳定的地址,不能只在信息流或个人主页里滚动出现。有些社区的帖子网址带会话参数,或者改个标题网址就变,这种要先改掉。
再看作者主页能不能公开访问。退出登录,随手点开几个发帖人的头像,能看到主页就过关;跳到登录页的,这一条直接不合格。
举报入口和审核记录要准备好。文档要求“有持续的内容审核,用户能举报”,申请表里没让你交材料,不过帖子页上至少得能看到一个举报按钮,审核的人一眼就能确认。
最费工夫的是新鲜度。文档希望新帖几分钟内就推送过去,发帖后72小时内还要持续更新点赞、回复这些计数。所以发帖、回帖、点赞都要触发一次推送,后台得有一套消息队列,不能靠每天跑一次的定时任务。技术细节要等入选后Google给文档,但队列可以先搭起来。
最后是申请表里那10个示例网址。Search Engine Journal的报道提醒过,这10个网址应该代表你打算推给Google的内容格式。挑的时候选有回复、有点赞、作者主页公开、结构化数据完整的帖子,别挑置顶公告和活动页。
还有哪些事Google没说
到10月17日为止,计划页面、申请表和更新日志都没提到下面这些:
- 已经有哪些平台入选。
- “用户基数可观”具体是多少,申请表只要你填月活跃用户数。
- 推送来的内容会出现在搜索的哪个功能里。页面说“搜索的各种功能”,申请表说“Google搜索和其他平台”。
- 互动数据怎么用于排名,入选者能不能看到报表。
- 为什么互动计数要更新到发帖后72小时。
- 入选之后多久能拿到技术接入文档,什么时候能开始推送。
还有一点要留意。2024年Google宣布接入Reddit数据接口时,公告里写了这些数据可以用于展示、训练等用途。这次的计划页面和申请表都没有出现“训练”这个词。没写不代表不会用,但目前的公开文件里确实没有。
常见问题解答
UGC新鲜数据计划是什么时候推出的?
Google搜索中心在2026年10月8日新增了这个计划的说明页面,更新日志里有记录。页面和日志都没说这条数据通道是从哪天开始运行的。
普通独立站能申请UGC新鲜数据计划吗?
基本不行。计划要求平台主要承载用户内容,用户内容量大、用户基数可观,还要能做OAuth 2.0接口认证和严格校验的JSON-LD数据推送。普通独立站的评论区和问答区达不到这个量级。
入选了就能更快出现在Google搜索里吗?
文档明确说不保证。入选只是多了一条把内容发给Google的通道,能不能出现、排在哪里,仍由排名算法决定。文档里的“几分钟内”说的是平台发送的速度,不是收录速度。
论坛用问答标记还是论坛帖标记?
按Google论坛标记文档,一问一答形式的论坛用问答标记,普通讨论用DiscussionForumPosting。UGC新鲜数据计划举的例子是SocialMediaPosting和DiscussionForumPosting,并要求带互动计数,问答标记算不算,文档没说。
用Discourse搭的论坛,默认就有论坛帖标记吗?
不一定。本次样本里41个Discourse社区,20个用微数据标了论坛帖,17个用JSON-LD标成问答页,4个在抽到的帖子页里没找到相关标记。最稳妥的办法是打开自己的帖子页源代码,搜一下DiscussionForumPosting和interactionStatistic这两个词。
interactionStatistic支持哪些互动类型?
Google论坛标记文档列了五种:LikeAction表示点赞,DislikeAction表示点踩,ViewAction表示浏览,CommentAction或ReplyAction表示评论,ShareAction表示转发。只标页面上真实显示的数字。
申请表里的10个示例网址怎么选?
选能代表你打算推送给Google的内容格式的帖子。最好是有回复、有点赞、作者主页公开、结构化数据完整的普通讨论帖,不要选置顶公告、活动页或需要登录才能看的内容。
UGC新鲜数据计划和Indexing API是一回事吗?
不是一回事。计划页面写明这条通道独立于Indexing API和普通抓取。Indexing API交的是网址和更新通知,只适用于职位页和直播视频页;UGC计划交的是帖子内容和互动数据,只对获批平台开放。
权威参考资料
本文标题:《Google UGC新鲜数据计划门槛实测:92个品牌社区,42个结构化数据已达标》
本文链接:https://zhangwenbao.com/google-ugc-fresh-data-program-forum-markup-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0