Google谈HTML站点地图:替代不了XML站点地图,电商站列分类就够,llms.txt也不算站点地图
本文目录
- HTML站点地图是怎么来的
- Mueller怎么说HTML站点地图
- 名字一样,东西不一样
- 爬虫会抓它,但不会把它当站点地图处理
- 不需要把什么都列进去
- 同一期播客里,几种“地图”放在一起看
- XML站点地图这些年变了什么
- 哪些网站最需要XML站点地图
- 大小限制和命名
- llms.txt替代不了站点地图
- 同一期还解释了“无法获取”报错
- 外贸站和独立站要不要做HTML站点地图
- 做的时候注意这几点
- 一个B2B外贸站的结构示例
- XML站点地图照样要有
- 别把HTML站点地图当成内链架构的替代品
- 常见问题解答
- HTML站点地图和XML站点地图有什么区别?
- HTML站点地图对SEO还有用吗?
- 电商网站的HTML站点地图要列出所有商品吗?
- llms.txt能代替站点地图吗?
- XML站点地图里的priority和changefreq还有用吗?
- 小网站需要XML站点地图吗?
- XML站点地图的大小上限是多少?
- Search Console显示站点地图“无法获取”是什么原因?
- HTML站点地图页面要不要设noindex?
- RSS能当站点地图用吗?
- 权威参考资料
摘要:Google的John Mueller在10月1日的Search Off the Record播客里说,HTML站点地图更像是给用户看的网站地图,替代不了XML站点地图,也不能当站点地图文件提交给Search Console,因为它没有XML那种严格结构,只是一堆链接。爬虫碰到它,会像跟进普通链接一样抓里面的链接,所以对抓取有帮助。电商站不必把所有商品列进去,列出分类让人找到方向就行。他还说llms.txt和HTML站点地图很像,目前Google的系统并不把它当站点地图处理。
HTML站点地图这个东西,很多做了十几年网站的人都有印象:页脚一个“网站地图”链接,点进去是一整页密密麻麻的链接。后来XML站点地图成了标准,这个页面就慢慢没人提了,不少建站模板干脆不带。
它现在还有没有用?Google的John Mueller和Martin Splitt在10月1日那期Search Off the Record播客《Do sitemaps still matter?》里聊到了这个问题,Search Engine Journal专门写了一篇。这篇按播客文字稿把Mueller的原话整理出来,顺带把同一期里讲到的XML站点地图、RSS和llms.txt放在一起比一比,再说外贸站和独立站该怎么做。
HTML站点地图是怎么来的
在XML站点地图出现之前,想让搜索引擎发现新页面,基本靠链接:从已经被收录的页面链过去,或者在首页甚至每一页的页脚放一个链接,指向一个HTML站点地图页面。这个页面上列着站内大量内页的链接,爬虫进来一次就能顺着发现一大片。当时的做法通常是把所有想参与排名的页面都列进去,关于我们这类页面反而不放。
SEJ的文章还提到一个旁证:2004年有一篇大学研究论文记录过,网络爬虫可以利用RSS订阅源来识别新增和最近修改的网页,最多能减少40%的抓取带宽。但RSS当时并不普及,拿来做抓取发现不太现实。后来Google、雅虎和微软联合推出了统一的XML站点地图标准,一直用到今天。
Mueller在这期播客开头也讲了这段历史。他说站点地图的想法提出后,被分享给了当时的微软和雅虎,三家公司都认可,成了一个“半标准”。那时他自己写了一个Windows上的站点地图生成器,会像爬虫一样把网站爬一遍、把网址整理进站点地图,后来因为这个和SEO圈、和Google有了交集,算是他进Google的缘起。按他的说法,站点地图大概已经有20年左右的历史了。
Mueller怎么说HTML站点地图
Martin Splitt问:一定要用XML格式吗?他记得以前还有HTML站点地图。Mueller的回答可以概括成三点。
名字一样,东西不一样
他说这个名字对普通人很容易造成混淆。很多人打开一个XML文件,看到满屏尖括号,会以为这是HTML,或者差不多的东西。两者都叫站点地图,但HTML站点地图基本上就是一张给用户看的网站地图,不能替代XML站点地图文件。
爬虫会抓它,但不会把它当站点地图处理
他的原话是:当然,如果有人在抓取你的网站时发现了HTML站点地图,他们可以像抓网站上其他链接一样抓里面的链接,所以这是有帮助的。但HTML站点地图不能作为站点地图文件提交,也没法像XML站点地图那样被一对一地处理,因为它没有那种严格的结构,基本上就是一堆链接。
Martin追问:那它还是对抓取有帮助吧,从这个页面能找到所有链接,只是没有XML站点地图那么结构化、那么清楚。Mueller回答:对,绝对是。
不需要把什么都列进去
接着他说,很多HTML站点地图并不会包含所有内容。如果你是电商网站,你不会把所有商品都列在HTML站点地图里,可能只列分类,让人能去到正确的地方,再自己挑具体的商品。所以它和XML站点地图相似,但不完全一样。
这句话把HTML站点地图的定位说清楚了:它是导航的一部分,帮人在大分类之间找方向;XML站点地图才是那份力求完整的网址清单。SEJ据此认为,如果要做HTML站点地图,就按对用户有用的方式去做,访客更容易找到更多页面,Google也可能从中受益。
同一期播客里,几种“地图”放在一起看
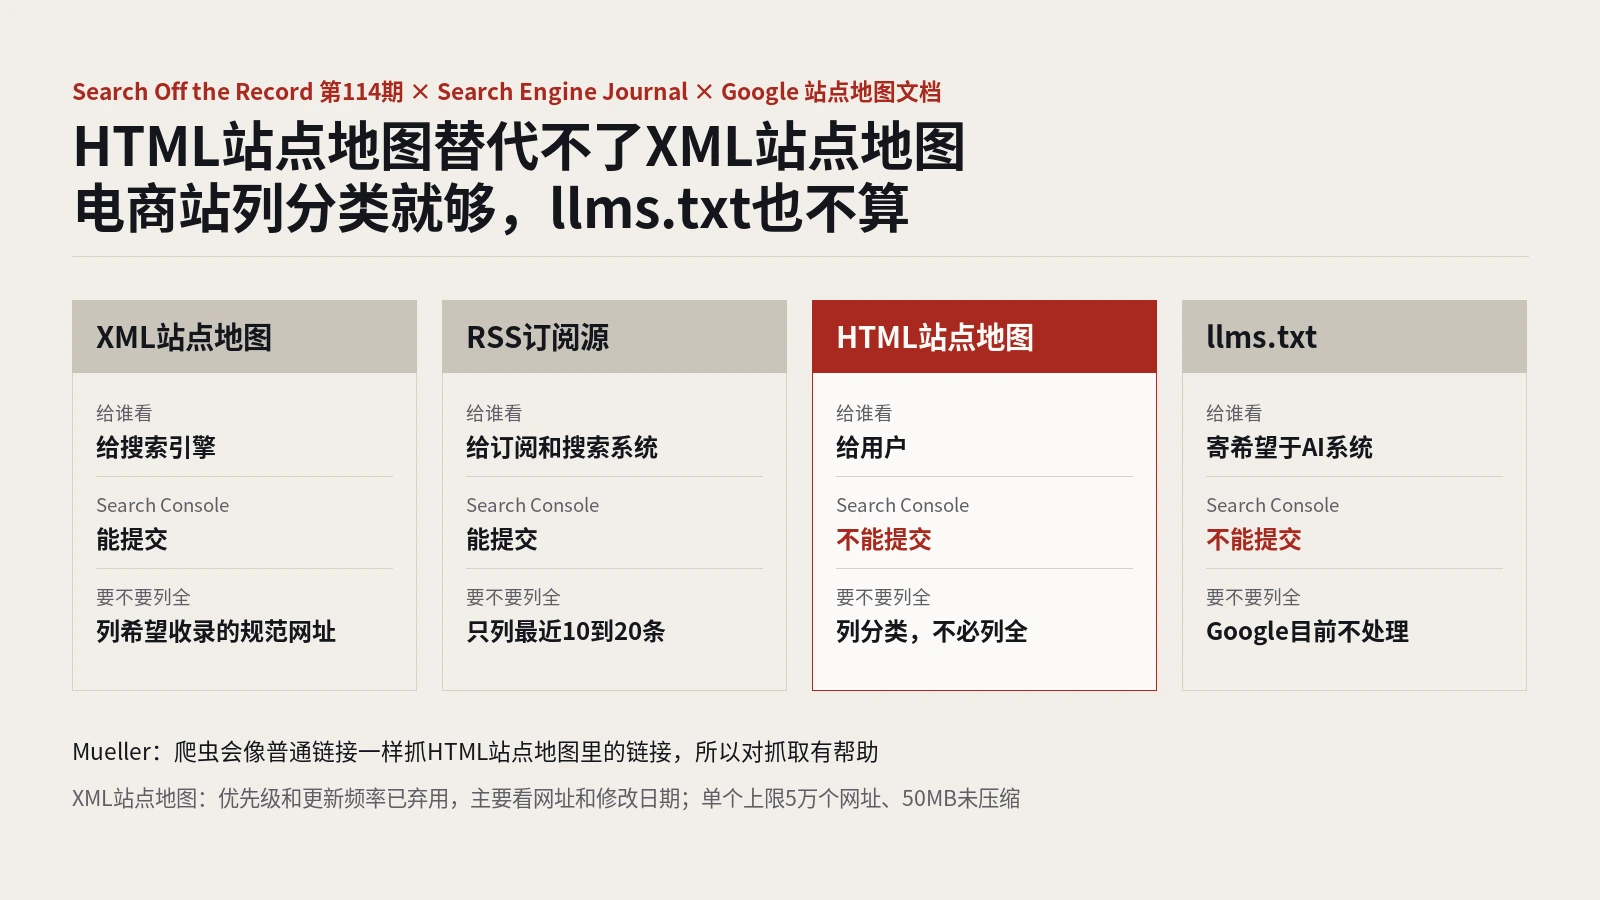
这期节目从XML站点地图一路聊到RSS和llms.txt,把Mueller的说法汇总成一张表,几种东西的分工一眼就能看明白:
| 类型 | 给谁看 | 能不能在Search Console当站点地图提交 | 要不要列全 | Mueller的说法 |
|---|---|---|---|---|
| XML站点地图 | 搜索引擎 | 能 | 列你希望被收录的规范网址 | 主要看网址和修改日期,优先级和更新频率两个字段已经不用了 |
| RSS订阅源 | 订阅工具和搜索引擎 | 能 | 通常只列最近更新的10到20条 | 在只看网址和日期这一点上和站点地图很像,适合让系统快速发现最近的变化 |
| HTML站点地图 | 用户 | 不能 | 不用,电商站列分类即可 | 爬虫会像普通链接一样抓里面的链接,对抓取有帮助 |
| llms.txt | 寄希望于AI系统 | 不能 | 通常只列主要板块 | 很像HTML站点地图;目前Google的系统不会处理它,希望大过现实 |
XML站点地图这些年变了什么
Mueller说,站点地图里原来有一个优先级字段,可你问SEO自己的页面优先级是多少,每个都是最高优先级,结果这个字段没什么用。更新频率字段也一样,SEO都填“总在更新”,有时也不是故意误导,服务端动态生成的页面确实每次都是新的。这两个字段Google都不再用了,现在主要关注网址和修改日期。
修改日期应该填页面最后一次重大修改的时间。他说Google希望用这个日期,但很多网站填错了,所以对它是又爱又恨:如果能判断一个站点地图里的日期比较合理,就会参考;如果所有网址都填今天,Google会意识到这样没意义,转而看单个网址,比如发现新网址就去处理。他特别说明,这不会被反垃圾系统当成坏网站。
站点地图里应该放你希望成为规范网址的版本,带内部跟踪参数或时间戳的网址不要放。他还说,Google在挑选规范网址时也会参考站点地图:好几个相似网址里,被列进站点地图的那个更可能被选中。
哪些网站最需要XML站点地图
Mueller点了两类。一类是新闻站,Google还有专门的新闻站点地图,他印象里只该列最近更新的1000个页面,方便系统跟上新闻站的更新节奏。另一类是内容多、改动频繁的网站,他特别举了电商站的例子:商品价格变了,靠常规抓取,等Google顺着分类一路爬到这个商品页时可能已经晚了;站点地图直接告诉Google“这个商品页改了”,系统就能直接过去。
这一点对外贸独立站很实际。改价、补货、上新这些变化,配合准确的修改日期,比等爬虫自己发现快得多。前提是修改日期只在页面真的有重大变化时才更新,不要每天全站刷新一遍。
大小限制和命名
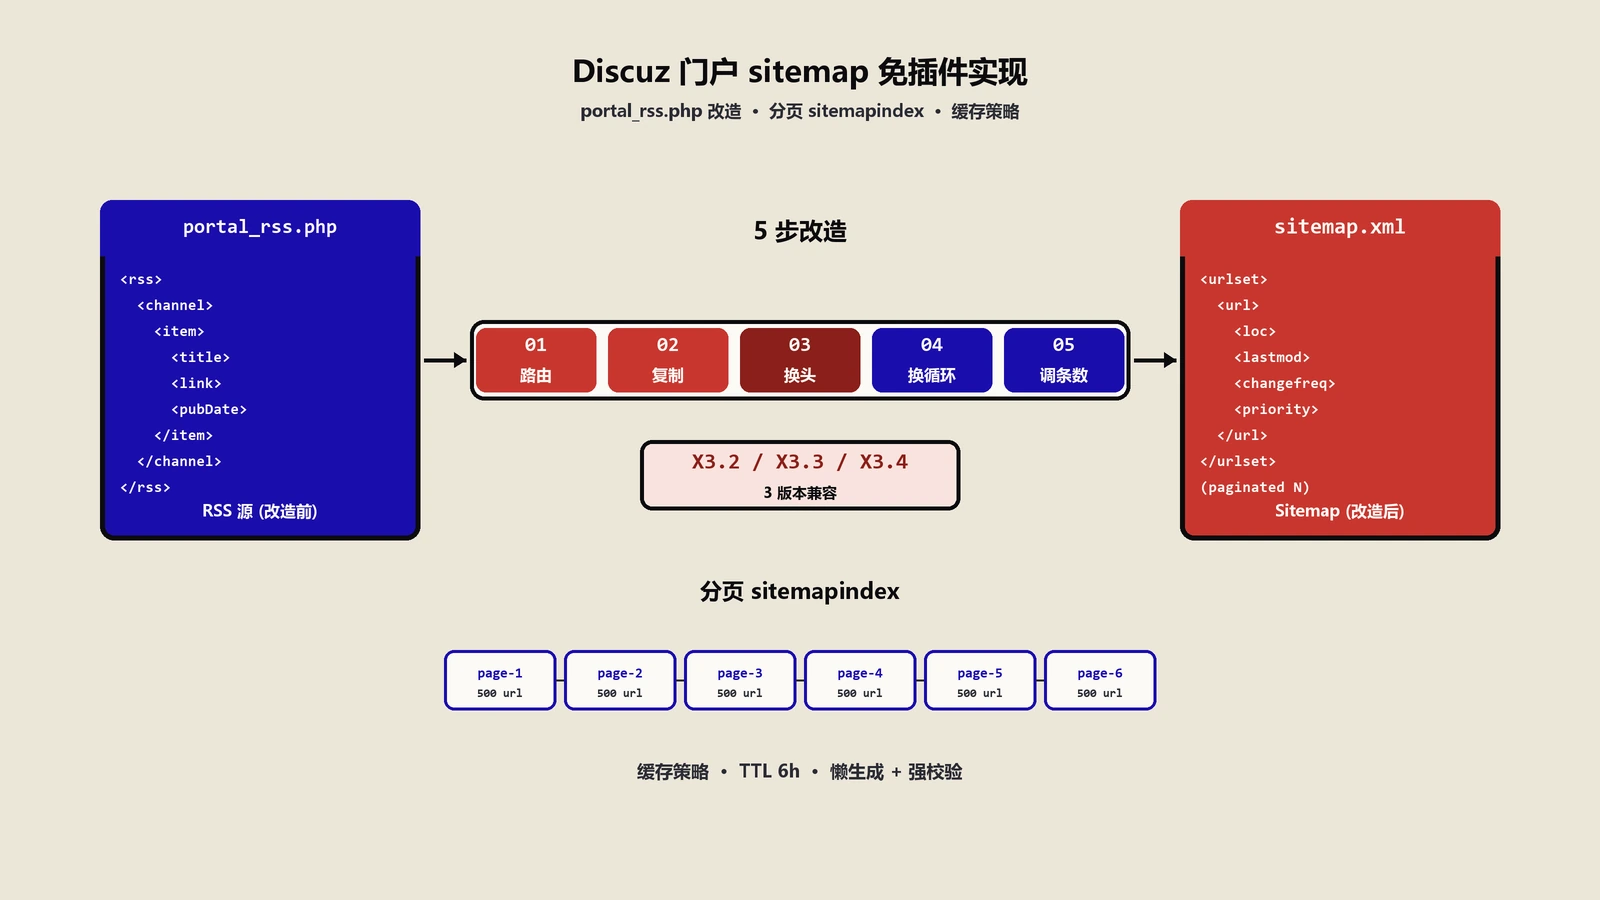
Mueller凭记忆说,单个站点地图上限是5万个网址、50MB,50MB指的是未压缩的大小,压缩后的体积不能拿来凑这个数。站点地图文件可以在Search Console里提交任意多个,也可以写进robots.txt;还可以用站点地图索引文件把多个站点地图串起来,索引只能嵌套一层。文件名可以随便起,但如果起了个特别的名字又不写进robots.txt,就得主动在Search Console提交。
这里有一个和AI相关的提醒:AI训练爬虫通常没有像Search Console这样的后台可以提交站点地图。想让这些爬虫找到你的内容,要么用通用的sitemap.xml文件名,要么靠RSS。他说自己在服务器日志里见过AI爬虫读取站点地图和RSS文件,这些爬虫会拿去做什么,各家一般没有文档说明。AI爬虫在你站上实际抓了哪些文件,可以对照站内AI爬虫抓取偏好那篇查日志。
llms.txt替代不了站点地图
Martin问,有了llms.txt,XML站点地图是不是就不需要了。Mueller直接说不是。他的描述是:llms.txt是一个Markdown文件,有时会包含指向不同内容的链接,很像HTML站点地图,大家希望AI系统用它更好地理解网站,但“希望大过现实”。功能上,Google的系统没法把它当站点地图用,因为它没有严格的格式。将来搜索系统也许会处理Markdown文件,顺着里面的链接去抓,但目前这些都没有发生。
他给建站的人的建议很务实:别把精力放在“将来可能会变”的期待上,要关注现在确实管用、有文档写明的做法。想玩可以玩,内容管理系统自动生成llms.txt也没问题,但别依赖它。llms.txt实际被用成什么样,站内llms.txt内容实测和llms.txt到底有没有用都写过。
同一期还解释了“无法获取”报错
这期节目的末尾,Martin提了一个听众常问的问题:站点地图格式有效、公开可访问、也写进了robots.txt,Search Console为什么有时还显示“无法获取”?SEJ也单独写了一篇。Mueller说论坛里这类问题很多,主要有两个原因:
| 原因 | Mueller的解释 | 能做什么 |
|---|---|---|
| 主机负载 | Google系统能从一个网站抓多少是有限的,可能忙着抓别的,没时间抓这个站点地图,也会显示成“无法获取” | 查服务器日志和抓取统计报告,看有没有大量5xx错误、响应变慢 |
| 抓取需求 | 系统判断没必要从这个网站多抓,已经抓够了,就跳过站点地图;抓取需求很多时候取决于对网站质量的判断 | 提升内容质量,减少低价值页面;质量明显改善后,Google会重新使用站点地图 |
第二个原因值得多想一下。Mueller的原话是,这不纯粹是技术问题,有时候是系统认为这个网站整体质量不怎么样,所以不打算花很多时间抓取和收录内容,也就暂时懒得理站点地图。从Google的角度看,问题还包括“我们到底需不需要、想不想要这个站点地图”。
SEJ的评论也说中了站长最头疼的地方:“无法获取”这个提示和真实原因对不上,站长看到后只会去查文件格式和访问权限,查半天发现都没问题。下次碰到这个提示,文件确认能正常打开之后,就该把注意力转到服务器负载和网站内容质量上。Search Console的抓取统计报告和其他报表怎么配合着看,可以参考站内GSC数据解读与诊断指南。
节目里还提了一句,站点地图也可以用来声明多语言版本,以及图片和视频。Mueller说现在Google识别页面上的图片和视频容易多了,这两种扩展还支持,只是不知道如今有多重要。
外贸站和独立站要不要做HTML站点地图
从Mueller的话推下来,答案取决于它能不能帮用户找东西。几种常见情况:
| 网站情况 | 建议 |
|---|---|
| 几十页的企业展示站,导航已经能到达所有页面 | 可以不做,做了也没坏处 |
| 产品线多、分类层级深的B2B外贸站 | 值得做,按产品大类和子类列出来,帮采购商快速定位 |
| 几千上万个商品的独立站 | 只列分类和重要的专题页,不要列全部商品 |
| 多语言站 | 每个语言版本各做一份,链接指向同语言的页面 |
| 内容站、博客 | 按栏目和主题列出,比按时间罗列文章更有用 |
做的时候注意这几点
- 链接要是爬虫能抓的普通链接。Google的链接最佳实践文档写明,Google通常只能抓取带href属性的a元素,靠脚本点击事件跳转的链接没法可靠地提取。用前端框架渲染的站点地图页,要确认输出的是标准链接。
- 按用户的找法组织,按大类、子类、专题分组,别按网址字母顺序堆一整页。
- 从页脚链过去,让用户和爬虫都能找到它。页脚放什么合适,站内独立站页脚设计讲过。
- 保持更新。分类改了名、下了架,HTML站点地图要跟着改,否则就成了一页死链。
- 别指望它救孤岛页面。完全没有内链指向的页面,应该在正文和导航里补链接,做法见孤岛页面的定位与修复。
一个B2B外贸站的结构示例
按Mueller说的“列分类,让人去到正确的地方”,一个做工业配件的外贸站,HTML站点地图大概可以这样组织(只是示意,分类按自己的业务来):
<h1>Sitemap</h1>
<section>
<h2>Products</h2>
<ul>
<li><a href="/products/valves/">Valves</a>
<ul>
<li><a href="/products/valves/ball-valves/">Ball Valves</a></li>
<li><a href="/products/valves/gate-valves/">Gate Valves</a></li>
</ul>
</li>
<li><a href="/products/fittings/">Pipe Fittings</a></li>
</ul>
</section>
<section>
<h2>Industries</h2>
<ul>
<li><a href="/industries/oil-gas/">Oil & Gas</a></li>
<li><a href="/industries/water-treatment/">Water Treatment</a></li>
</ul>
</section>
<section>
<h2>Company</h2>
<ul>
<li><a href="/about/">About Us</a></li>
<li><a href="/certifications/">Certifications</a></li>
<li><a href="/contact/">Contact</a></li>
</ul>
</section>这个结构里,每个链接都用标准的a标签和href;按产品、行业、公司这类采购商熟悉的维度分组;具体型号留给分类页去展示。采购商常问的认证、工厂介绍这类页面,可以单独列一组,方便他们核实供应商资质。多语言站的每个语言版本各放一份,分组标题和链接文字都用当地语言,链接只指向同语言的页面,不要在英文版站点地图里混进德语或西语的网址。
XML站点地图照样要有
HTML站点地图做得再好,也替代不了XML站点地图。Google的站点地图文档说,如果网站页面之间链接得当,Google通常能发现网站的大部分内容;大约500页以内、内链完整、没有太多视频图片或新闻页的小站,可能不需要站点地图。Mueller在播客里的建议更干脆:站小的时候站长很难判断自己算大还是算小,现在几乎所有内容管理系统都默认生成站点地图,开着就行,小站有站点地图也没有坏处。
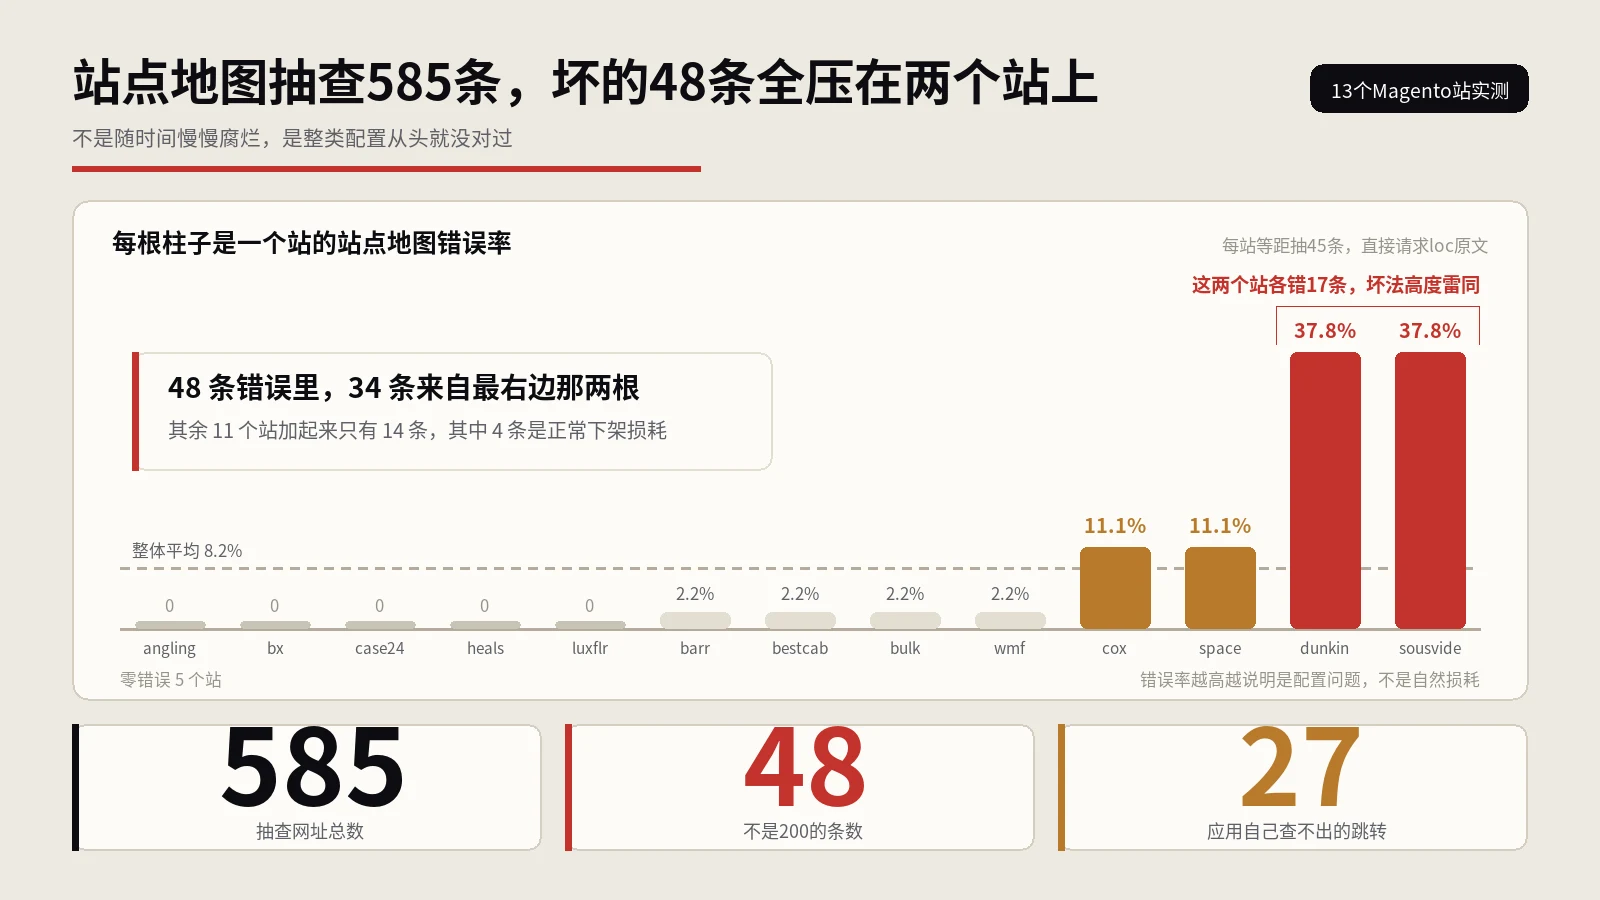
XML站点地图对排名有没有直接作用,站内提交网站地图能提升排名吗讨论过;站点地图里混进坏网址的情况也比想象中常见,可以参考站点地图坏网址抽查那篇自查。
别把HTML站点地图当成内链架构的替代品
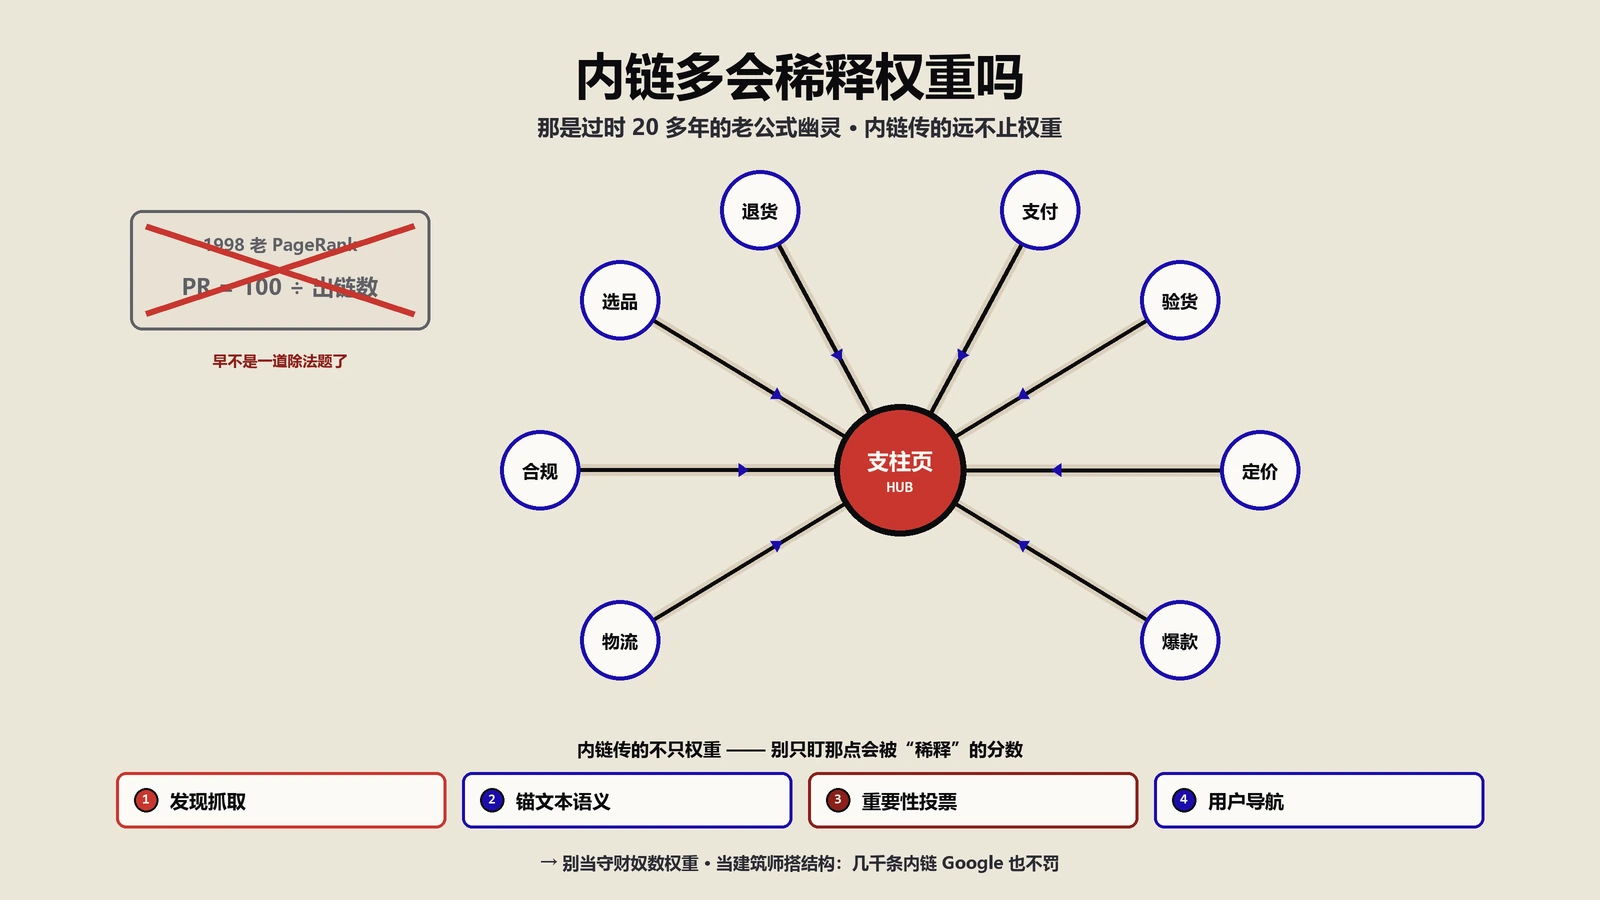
还有一个历史包袱要卸掉。老一代SEO里,HTML站点地图还有一个用途:把首页的链接权重分散到大量内页。SEJ在总结里也提到了这段历史。现在再这么用意义不大,一页上挤几千个链接,每个链接分到的东西很少,用户也不会去看。一个页面上的链接太多,页面本身也会变重,对抓取和加载都没好处。真想让重要页面多得到一些内链支持,更有效的办法是在相关的正文、分类页和专题页里自然地链过去,一页站点地图替代不了这些。
Mueller把电商站的HTML站点地图描述成“列分类,让人去到正确的地方”,这和好的内链架构是一个思路:首页到分类,分类到子类,子类到商品,每一层都能顺着走下去。内链怎么搭,站内内链架构搭建方法写得比较全;面包屑也是同一套思路的一部分,见面包屑导航SEO。商品筛选产生的大量网址,更不该出现在HTML站点地图里,分面导航怎么管见分面导航的SEO治理。
常见问题解答
HTML站点地图和XML站点地图有什么区别?
HTML站点地图是给用户看的网页,列出网站主要板块的链接;XML站点地图是给搜索引擎的文件,按严格格式列出希望被收录的网址和修改日期。Google的John Mueller说,HTML站点地图不能替代XML站点地图,也不能作为站点地图文件提交给Search Console。
HTML站点地图对SEO还有用吗?
有一定作用。Mueller说爬虫发现HTML站点地图后,会像抓普通链接一样抓里面的链接,所以对抓取有帮助。它的主要价值是改善用户导航,让访客更容易找到需要的页面。
电商网站的HTML站点地图要列出所有商品吗?
不需要。Mueller举的例子是,电商站一般不会把所有商品列进HTML站点地图,可能只列分类,让用户先去到对的分类,再自己挑商品。完整的商品网址清单交给XML站点地图。
llms.txt能代替站点地图吗?
不能。Mueller说llms.txt是一个Markdown文件,很像HTML站点地图,但没有严格格式,目前Google的系统不会把它当站点地图处理。他建议把精力放在现在有效、有文档的做法上,可以自动生成llms.txt,但别依赖它。
XML站点地图里的priority和changefreq还有用吗?
没用了。Mueller说这两个字段因为几乎所有网站都填最高优先级、总在更新,已经被Google弃用,现在主要看网址和修改日期。修改日期要填页面最后一次重大修改的时间,全部填今天会让Google忽略这个日期。
小网站需要XML站点地图吗?
Google文档说,约500页以内、内链完整的小站可能不需要。Mueller在播客里的建议是开着就行,因为现在几乎所有内容管理系统默认生成站点地图,小站有站点地图也没有坏处,网站以后变大也用得上。
XML站点地图的大小上限是多少?
单个站点地图最多5万个网址、50MB,50MB按未压缩大小计算。超过可以分成多个文件,用站点地图索引文件串起来,索引只能嵌套一层,并且可以在Search Console提交或在robots.txt里声明。
Search Console显示站点地图“无法获取”是什么原因?
Mueller说主要有两个原因。主机负载方面,Google可能没时间抓取这个文件;抓取需求方面,系统根据对网站质量的判断,认为没必要多抓,就跳过了站点地图。文件格式和访问都正常时,应该检查服务器负载和网站内容质量。
HTML站点地图页面要不要设noindex?
一般不需要。它本身是普通的导航页,被收录也没有坏处。如果不想让它出现在搜索结果里,可以加noindex,但要注意Google方面说过,长期noindex的页面,Google最终可能也不再跟进上面的链接,这样它帮助抓取的作用就打了水漂。
RSS能当站点地图用吗?
可以。Mueller说RSS在只看网址和日期这一点上和站点地图很像,也能在Search Console里当站点地图提交。它通常只列最近更新的10到20条,适合让搜索系统快速发现新内容,大站最好和完整的XML站点地图一起用。
权威参考资料
本文标题:《Google谈HTML站点地图:替代不了XML站点地图,电商站列分类就够,llms.txt也不算站点地图》
本文链接:https://zhangwenbao.com/html-sitemap-vs-xml-sitemap-google-mueller.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0