微软Decision-1进必应和Copilot测试:一个只做判断题的小模型,对SEO意味着什么
本文目录
- Decision-1是什么样的模型
- 三种题型怎么问
- 微软给出的成绩,要看清是谁测的
- 微软内部拿它做了什么
- 决策模型已经是一个品类了
- 必应和Copilot到底在试什么
- 可能用在哪些环节
- 智能体在网页上的每一步,也可能是它来选
- 对做SEO的人有什么影响
- 判断越来越便宜,分类会越来越细
- Copilot的回答会被另一个模型打分
- 必应在AI生态里的位置还在变重
- SEO从业者自己能拿它做什么
- 大批量关键词意图分类
- 内容质检和评论归类
- 小团队上手可以按这个顺序来
- 用之前要注意的几件事
- 常见问题解答
- Microsoft-Decision-1是什么?
- 必应搜索已经在用Decision-1了吗?
- Decision-1怎么收费?
- Decision-1比大模型快多少?
- Decision-1会影响我的网站排名吗?
- SEO工作里能用Decision-1做什么?
- Decision-1能处理中文关键词吗?
- 决策模型和普通大语言模型有什么区别?
- 除了微软,还有谁在做决策模型?
- 在Foundry部署Decision-1要选哪种部署类型?
- Decision-1的打分结果能直接当评级用吗?
- 权威参考资料
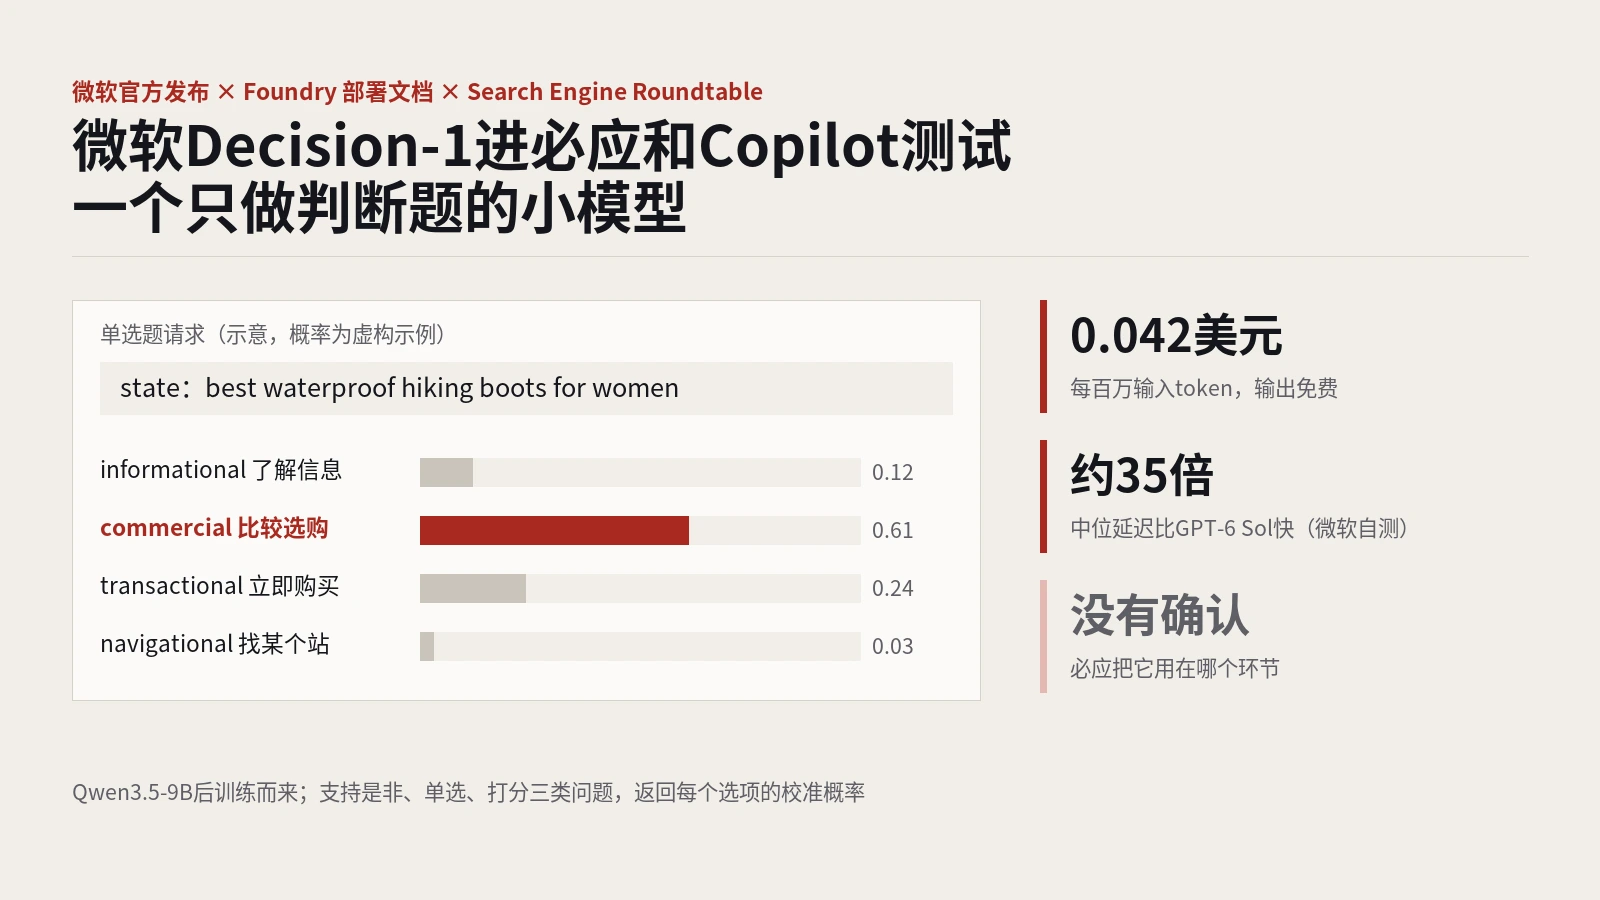
摘要:微软10月9日发布Microsoft-Decision-1,一个不写文章、只做判断的决策模型:给它一段文本和几个固定选项,它返回每个选项的概率。模型由Qwen3.5-9B后训练而来,输入每百万token收费0.042美元,输出免费。微软自测的中位延迟比GPT-6 Sol快约35倍。Copilot团队已经在试用,必应团队对是否在搜索里试验的回应是“我们一直在做实验”。微软列出的用途里有搜索相关性打分、意图识别和内容过滤,但没有说必应拿它做什么。
大模型新闻看多了,很容易默认AI就是“会写会聊”。微软这次发的东西反过来:它故意不让模型写字,只让它在给定的几个答案里挑一个,并且告诉你有多大把握。
这类模型做的是搜索系统里最常见、最不显眼的那部分活:判断这个查询是什么意图、这条结果和查询相关不相关、这段内容该不该过滤。所以当Search Engine Roundtable报道必应和Copilot在试验它时,做SEO的人值得多看两眼。这篇以微软的官方发布文章为主体,把模型是什么、数据怎么来的、必应到底承认了什么,以及SEO从业者自己能怎么用,一一说清楚。
Decision-1是什么样的模型
发布文章署名是微软首席技术官办公室的软件工程副总裁Achint Srivastava。微软给它的定位是“决策打分模型”,专门用来做路由、分类、排优先级、核验和流程控制,可以接进现有的应用、智能体和工作流。
和常见的大语言模型比,它的不同点很集中:
| 对比项 | 常见大语言模型 | Decision-1 |
|---|---|---|
| 输出 | 自由生成文字,可以写理由 | 不生成文字和理由,只返回结构化的判断结果 |
| 判断方式 | 让模型用文字回答“选A”,再由程序解析 | 给定固定选项,一次计算出每个选项的校准概率 |
| 题型 | 不限 | 是非题、单选题、打分题,以及按评分标准给AI回答或智能体动作打分 |
| 底座 | 各家自研 | 在Qwen3.5-9B上做的后训练,微软说之后会换到自家MAI模型和OpenAI的模型上 |
| 价格 | 输入输出都收费 | 输入每百万token 0.042美元,输出免费 |
有个细节国内读者可能会注意到:底座Qwen是阿里巴巴通义千问系列的开源模型,微软拿它做后训练,再挂上自己的品牌发布。这在开源模型圈很常见,也说明底座的选择主要看任务适配和成本。
这里的“校准”是个关键词。微软的要求是:模型说90%把握的判断,在有代表性的样本上应该大约10次对9次。应用程序可以拿这个概率决定是直接执行、先放一放,还是转给人复核。
三种题型怎么问
微软在Foundry平台的部署文档里给了具体的调用格式。请求由两部分组成:一个state,可以是文本或JSON;一组带类型的问题。题型有三种:
- 是非题(文档里的类型名写作noul),返回0到1之间的概率,适合做闸门和过滤,比如“这条客服回复有没有承诺退款”。
- 单选题(choice),从固定标签里选一个,并给出每个标签的概率,适合分类和路由,比如工单该分给账务、技术还是客服。
- 打分题(score),把对象放到一个有序等级上,比如事故严重程度分“外观、轻微、严重、致命”四级。返回值是按概率加权的等级序号平均值,所以可能落在两级之间。
文档有两条提醒很实用:单选题里最高概率偏低时,应该把这个判断升级给人或别的模型;打分题更适合用来排序和设阈值,别把分数当成绝对、精确的评级。不管哪种题型,都要先拿自己标注好的样本验证阈值,再上自动化。
微软给出的成绩,要看清是谁测的
发布文章里的数字都来自微软自己的测试,有几项挺亮眼:
| 维度 | 微软的说法 |
|---|---|
| 准确率 | 在36个基准测试、近15万道训练时没见过的题目上准确率最高 |
| 速度 | 实测最快,比第二名H2O-Lightning-4B v1.1快2.5倍,中位延迟比GPT-6 Sol快约35倍 |
| 稳定性 | 同一请求做8种改写扰动,平均只有1.3%的情况判断会翻转;改写选项描述、颠倒或打乱选项顺序时零翻转 |
| 安全 | 在11个基准、5250条请求上测试有害内容、越狱和提示词注入,能拒绝有害行为,同时保持较高可用性 |
速度为什么重要,微软自己算了一笔很直观的数:如果一个流程有20个前后依赖的判断,每个多花100毫秒,整个流程就多出2秒。搜索结果页要在几百毫秒内出来,每一步判断都得快。
不过这些成绩有两点要留心。对比的大部分是微软挑的模型和基准,发布文章后来还补充过一次JevBench的准确率和校准数据,第三方的独立复测目前还没看到。另外它的底座只有90亿参数,在微软设计的“固定选项判断”这类任务上快而准,不代表它能替代大模型做开放式推理。
微软内部拿它做了什么
发布文章列了几个内部测试场景,数字也是微软自己报的:
- Xbox研究团队用它把1万多条来自问卷、Steam和X的开放式反馈,归到研究人员事先定好的主题里。质量和GPT-6 Sol相当,速度快14倍以上,成本低200倍。
- Copilot团队用它评估聊天和智能体回答的质量,结果和GPT5.6 Luna相当,速度快100倍。
- 值班工程师处理线上事故时,用它从日志、工单、通话和消息里检索相关知识,比大语言模型效果更好也更快。
- Microsoft Discovery的自适应重新规划功能里,智能体按评分标准评估上一次实验再调整方案。用Decision-1打分,一致性是大模型打分的46倍,速度快3倍,整个重新规划过程快了将近4倍。
这几个场景有个共同点:选项都是事先定好的,要么是一份主题清单,要么是一套评分标准,模型只负责往里归。
第二条和搜索关系最近:Copilot团队拿它来评估回答质量。微软已经把它当成“给AI回答打分的裁判”在用了。
决策模型已经是一个品类了
微软在文章开头说,决策模型正在快速成为AI里一个重要的新品类。从它附录列出的对比对象也能看出来,这条赛道上已经有不少选手:
| 对比模型 | 来源 |
|---|---|
| GPT-6 Luna Decisions | OpenAI开发者文档里有专门的Decisions指南 |
| H2O-Lightning-4B | H2O.ai,发布在Hugging Face,测速时排第二 |
| Quyet-1.0-Large | 发布在Hugging Face |
| Surogate Rune 26B-A4B | Surogate,发布在Hugging Face |
| deck-31B | 代码在GitHub |
| Strands-Decider 2B | Strands Labs,代码在GitHub |
连OpenAI都单独做了决策接口,说明“让大模型写一段话再从里面抠答案”这种老办法,在需要大量、快速判断的场景里已经不够用了。搜索引擎就是这种场景的典型:每天处理海量查询,每次都要做好多个判断。
这个品类对SEO的意义在于,搜索系统里的“小判断”会越来越多地交给这类专门模型。它们不负责写回答,却决定了回答要不要出、引用谁、过滤掉谁。
必应和Copilot到底在试什么
这部分信息很少,得一句一句看。
Search Engine Roundtable的Barry Schwartz引用了微软Rangan Majumder在X上的帖子,大意是:我们在Copilot里试验它,效果相当好,他们改进它的速度也让人印象深刻。Barry随后去问必应团队,Krishna Madhavan的回复只有一句:“我们一直在做实验!”
Barry的判断是,必应不一定对所有查询、所有用户都用它,但应该确实在试验。能确认的就这么多:
- Copilot在试验Decision-1,这是微软员工公开说的。
- 必应没有否认,也没有说具体用在哪个环节。
- 没有任何信息显示它已经参与必应的网页排序。
可能用在哪些环节
微软在发布文章里列了一长串建议用途,其中好几项和搜索直接相关:
| 微软列出的用途 | 原文描述 | 放到搜索里大概对应什么 |
|---|---|---|
| 搜索相关性 | 评估一条搜索结果和查询的匹配程度,给出相关性标签或优先级 | 结果打分、标注数据生产 |
| 意图识别 | 识别用户想完成什么,把请求匹配到支持的意图上 | 查询分类,决定出不出AI回答、购物模块等 |
| 模型路由 | 评估请求,按质量、成本和延迟要求选最合适的模型 | 简单问题交给小模型,复杂问题交给大模型 |
| 内容分类和过滤 | 按主题或政策给内容分类,决定展示、过滤还是送审 | 安全过滤、违规内容识别 |
| AI评判 | 按质量标准评估AI生成的回答,决定接受、修改还是拒绝 | Copilot回答质检 |
| 推荐 | 从一组候选里选出最相关的条目、优惠或下一步动作 | 相关推荐、后续问题建议 |
第三列是按常见搜索系统结构做的推测,微软没有说必应用在其中任何一项。写在这里,是让你知道这类模型擅长干什么活;必应有没有这么干,目前没有答案。
智能体在网页上的每一步,也可能是它来选
微软的用途清单里还有三项和智能体直接相关:智能体管控,评估智能体提议的下一步,决定继续、停止、重试,还是交给别的模型、工具或人;电脑和界面操作,根据当前屏幕和任务,从一组候选动作里选下一个界面操作;数据核验,检查输入是否满足要求,决定接受、拒绝还是标记复核。
发布文章里有个演示,拿Decision-1和GPT-6 Sol比谁更快完成“买一个双肩包”的电脑操作任务。微软在结尾也说,智能体开始在真实世界里采取行动,决策模型有潜力帮人引导和管控这些智能体。
对独立站来说,以后替用户来逛店、下单的智能体,每一步点哪里,可能是一个毫秒级的小模型在几个按钮之间挑。按钮文字含糊、关键信息藏在图片里、同一页上有好几个长得差不多的入口,都会增加它选错的概率。网站怎么对智能体友好,站内网站的智能体适配有具体清单。
对做SEO的人有什么影响
短期内,你的网站不会因为Decision-1上线而排名大变,没有任何证据支持这一点,也不需要为它改什么。值得想的是更长一点的趋势。
判断越来越便宜,分类会越来越细
以前搜索引擎给查询分意图、给结果打相关性标签,要么靠规则,要么靠大模型,后者贵而慢,只能用在一部分请求上。决策模型把单次判断的成本和延迟压低之后,更多查询、更多结果都可以过一遍细致的判断。
落到页面上,意思是页面要让机器一眼看出“它在回答哪类问题”。技术指标都达标却迟迟不涨的页面,很多就卡在这一步,站内技术SEO满分却不涨的原因举过例子。一个页面同时想接住信息类和交易类两种意图,在更细的分类面前更容易两头不靠。这不是新道理,搜索意图怎么分、页面形态怎么对应,站内搜索意图的5种类型和用搜索结果页反推落地页形态都讲过,只是这条要求以后会被执行得更彻底。
Copilot的回答会被另一个模型打分
Copilot团队用它评估回答质量,意味着回答生成之后、展示之前,可能还有一道“裁判”。被引用的内容如果经不起核对,回答本身就可能被判为质量不够。这和做GEO时强调的事实可核查、出处清楚是一个方向。必应这边AI回答的引用情况,可以用站长工具里的AI效果报告来看。
必应在AI生态里的位置还在变重
ChatGPT等产品的联网检索和必应关系密切,站内必应排名与ChatGPT品牌推荐做过对照;微软今年还推出了给AI智能体用的必应接地接口,站内微软Web IQ解读写过。必应侧哪怕只是一个分类环节换了模型,影响面也可能比它自己的搜索份额大。外贸站如果还没认真做过必应,必应SEO完整指南可以作为起点。
SEO从业者自己能拿它做什么
比起猜必应怎么用,更实在的是自己用。微软列的“数据标注”“意图识别”“内容分类”,本来就是SEO日常要干的体力活。
大批量关键词意图分类
按文档里单选题的格式,一个关键词意图分类请求大致长这样:
{
  "state": "best waterproof hiking boots for women",
  "questions": {
    "intent": {
      "type": "choice",
      "instructions": "What is the main search intent of this keyword?",
      "criteria": {
        "informational": "Wants to learn or understand something",
        "commercial": "Comparing products or brands before buying",
        "transactional": "Ready to buy or take an action now",
        "navigational": "Looking for a specific site or brand"
      }
    }
  }
}
返回的是选中的标签和四个标签各自的概率。最高概率偏低的词,比如两个意图都在四成上下,正好单独拎出来人工看,这类词往往就是搜索结果页里混着两种页面类型的词。
成本粗略估一下:假设每个请求连同指令和选项描述在300个输入token左右,1万个关键词就是300万token,按每百万0.042美元计算约0.13美元,输出不收费。输出免费也好理解,它只返回标签和概率,本来就没多少输出。实际token数取决于你的指令写多长,用前先拿几十个词试一下。分完意图之后,再按搜索结果重合度做聚类,可以参考站内关键词聚类的方法。
内容质检和评论归类
打分题适合按一套固定标准给大批页面打分,比如“是否回答了标题里的问题”分四级,先筛出最差的一批人工复查。是非题适合做闸门,比如检查产品描述里有没有出现不该有的承诺。Xbox团队归类1万多条玩家反馈的做法,换成独立站就是归类买家评论和售后邮件。
小团队上手可以按这个顺序来
- 先挑一个具体任务,比如“把询盘邮件分成报价、样品、投诉、无效四类”,选项写成一句话的描述,别只写一个词。
- 人工标注100到200条真实样本,当作答案。
- 把这批样本跑一遍,对比模型的选择和人工答案,看准确率,也看错在哪几类上。
- 按最高概率分档统计准确率,比如0.8以上、0.5到0.8、0.5以下各对了多少,据此定一个自动处理的阈值。
- 阈值以上的自动处理,阈值以下的转人工或交给大模型复核,上线后每隔一段时间抽查一批。
第4步就是“校准概率”派上用场的地方。微软说它的概率是校准过的,可这是在它的测试集上,换到你的数据和你的中文选项描述上,要自己再验一遍。稳定性那项测试也有参考价值:选项顺序打乱不会改变判断,批量处理时就不用担心选项排列方式带来偏差。
用之前要注意的几件事
- 它不写理由。你只能拿到选项和概率,想知道“为什么这么判”得换大模型。
- 它只能在你给的选项里挑。真实情况不属于任何一个选项时,它照样会挑一个,所以分类题最好加一个“都不是”或“无法判断”的选项。
- 中文效果要自己测。微软说评测覆盖了多语言任务,但没有单独给中文数据,处理中文关键词前先用标注好的样本跑一遍。
- 选项描述决定结果。文档反复强调要把每个选项写清楚,模糊的标签会得到模糊的概率。
- 调用渠道有两个:Azure上的Microsoft Foundry,或者OpenRouter。走Foundry需要Azure订阅和付费方式,部署类型的选择会影响延迟。
常见问题解答
Microsoft-Decision-1是什么?
微软10月9日发布的决策打分模型。它不生成文字,只在给定的固定选项里做判断并返回每个选项的校准概率,支持是非、单选和打分三类问题,用于路由、分类、排优先级、核验和流程控制。模型在Qwen3.5-9B基础上后训练而来。
必应搜索已经在用Decision-1了吗?
没有确认。微软的Rangan Majumder说Copilot在试验它;必应团队的Krishna Madhavan回应“我们一直在做实验”。Search Engine Roundtable认为必应可能在试验,但不一定用于所有查询和用户。没有信息显示它参与了必应网页排序。
Decision-1怎么收费?
按微软发布文章,输入每百万token 0.042美元,输出免费。可以通过Azure上的Microsoft Foundry或OpenRouter调用,走Foundry需要Azure订阅。
Decision-1比大模型快多少?
按微软自己的测试,中位延迟比GPT-6 Sol快约35倍,比第二快的H2O-Lightning-4B v1.1快2.5倍;Copilot团队的质量评估测试中,和GPT5.6 Luna效果相当、快100倍。这些都是微软自测数据,目前还没有第三方独立复测。
Decision-1会影响我的网站排名吗?
目前没有证据。必应没有说明它用在哪个环节。长期看,判断成本降低后搜索引擎可以对更多查询和结果做细致的意图分类和相关性判断,页面意图清楚、内容经得起核对会更重要,这和现在的SEO要求方向一致。
SEO工作里能用Decision-1做什么?
适合大批量、选项固定的判断:关键词意图分类、页面按统一标准打分质检、买家评论和售后邮件归类、检查文案里有没有违规承诺等。它不给理由,中文效果需要先用标注样本验证,选项描述要写清楚。
Decision-1能处理中文关键词吗?
微软说评测覆盖了多语言和分布外任务,但没有单独公布中文数据。它的底座Qwen3.5-9B来自阿里巴巴的通义千问系列。处理中文关键词或中文评论前,建议先用一两百条人工标注的样本测一遍准确率,再决定是否批量使用。
决策模型和普通大语言模型有什么区别?
大语言模型生成文字,判断结果要从文字里解析;决策模型不生成文字,直接针对固定选项返回结构化结果和每个选项的概率。前者适合开放式问题和需要解释的场景,后者适合大量、快速、选项固定的判断,比如分类、路由和过滤。
除了微软,还有谁在做决策模型?
微软发布文章附录列出的对比对象包括OpenAI的GPT-6 Luna Decisions,以及H2O-Lightning-4B、Quyet-1.0-Large、Surogate Rune 26B-A4B、deck-31B、Strands-Decider 2B等,多数发布在Hugging Face或GitHub上。
在Foundry部署Decision-1要选哪种部署类型?
文档列了两种:DataZoneStandard把推理处理限制在选定的数据区内,适合对数据位置有要求、想减少远距离路由的场景;GlobalStandard可以用全球容量,但推理可能在任何支持的区域处理,延迟可能更高、波动更大。文档建议把资源建在靠近应用和用户的区域,并用自己的负载实测延迟。
Decision-1的打分结果能直接当评级用吗?
微软文档建议不要。打分题返回的是按概率加权的等级序号平均值,可能落在两级之间,更适合用来排序和设阈值。上线自动化前,应该先用自己标注好的样本验证阈值。
权威参考资料
本文标题:《微软Decision-1进必应和Copilot测试:一个只做判断题的小模型,对SEO意味着什么》
本文链接:https://zhangwenbao.com/microsoft-decision-1-bing-copilot-decision-model.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0