Claude Code做SEO能接哪些活?Ahrefs收集的一线用法,按你手里的数据分五类讲清楚
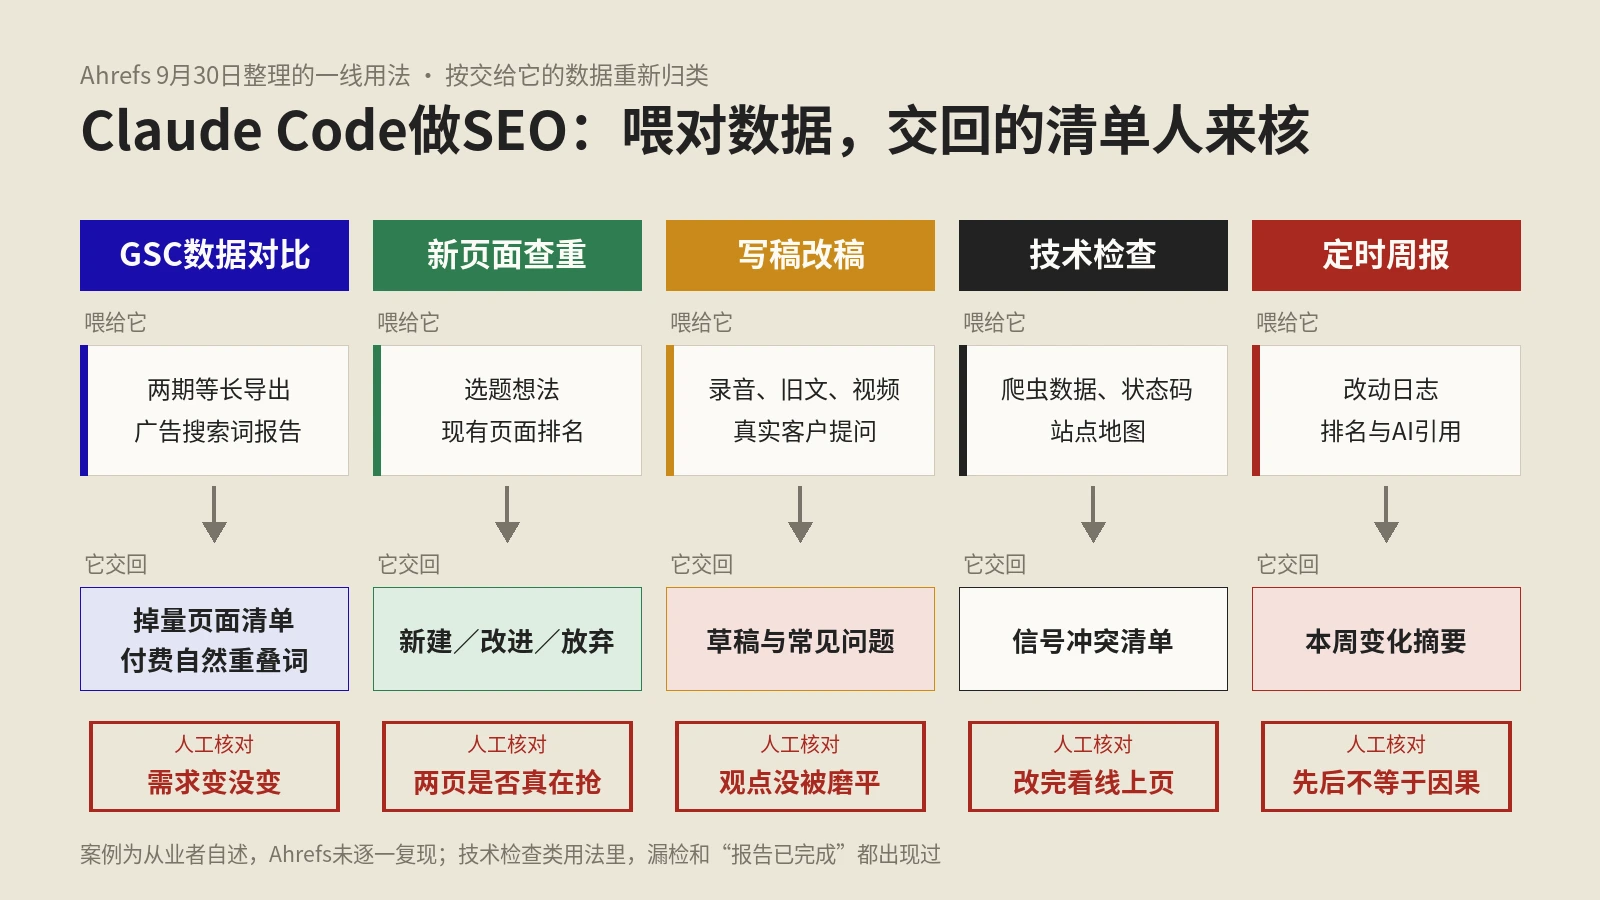
以Ahrefs 9月30日的Claude Code用法合集为主体,按Search Console数据对比、新建页面前的查重与缺口、写稿改稿、技术检查、定时周报五类重新归纳,讲清每类该喂什么数据、产出什么清单、哪一步必须人工核对,并补上官方文档里的使用方式、技能文件、定时任务与权限设置。
AI写稿人人都会,真正拉开差距的是判断和流程。这里讲AI内容生产工作流,从改写工具评测、Prompt工程、客户知识库到品牌口吻固化和人工质检节点,帮你把AI内容做出原创度和品牌感。
以Ahrefs 9月30日的Claude Code用法合集为主体,按Search Console数据对比、新建页面前的查重与缺口、写稿改稿、技术检查、定时周报五类重新归纳,讲清每类该喂什么数据、产出什么清单、哪一步必须人工核对,并补上官方文档里的使用方式、技能文件、定时任务与权限设置。
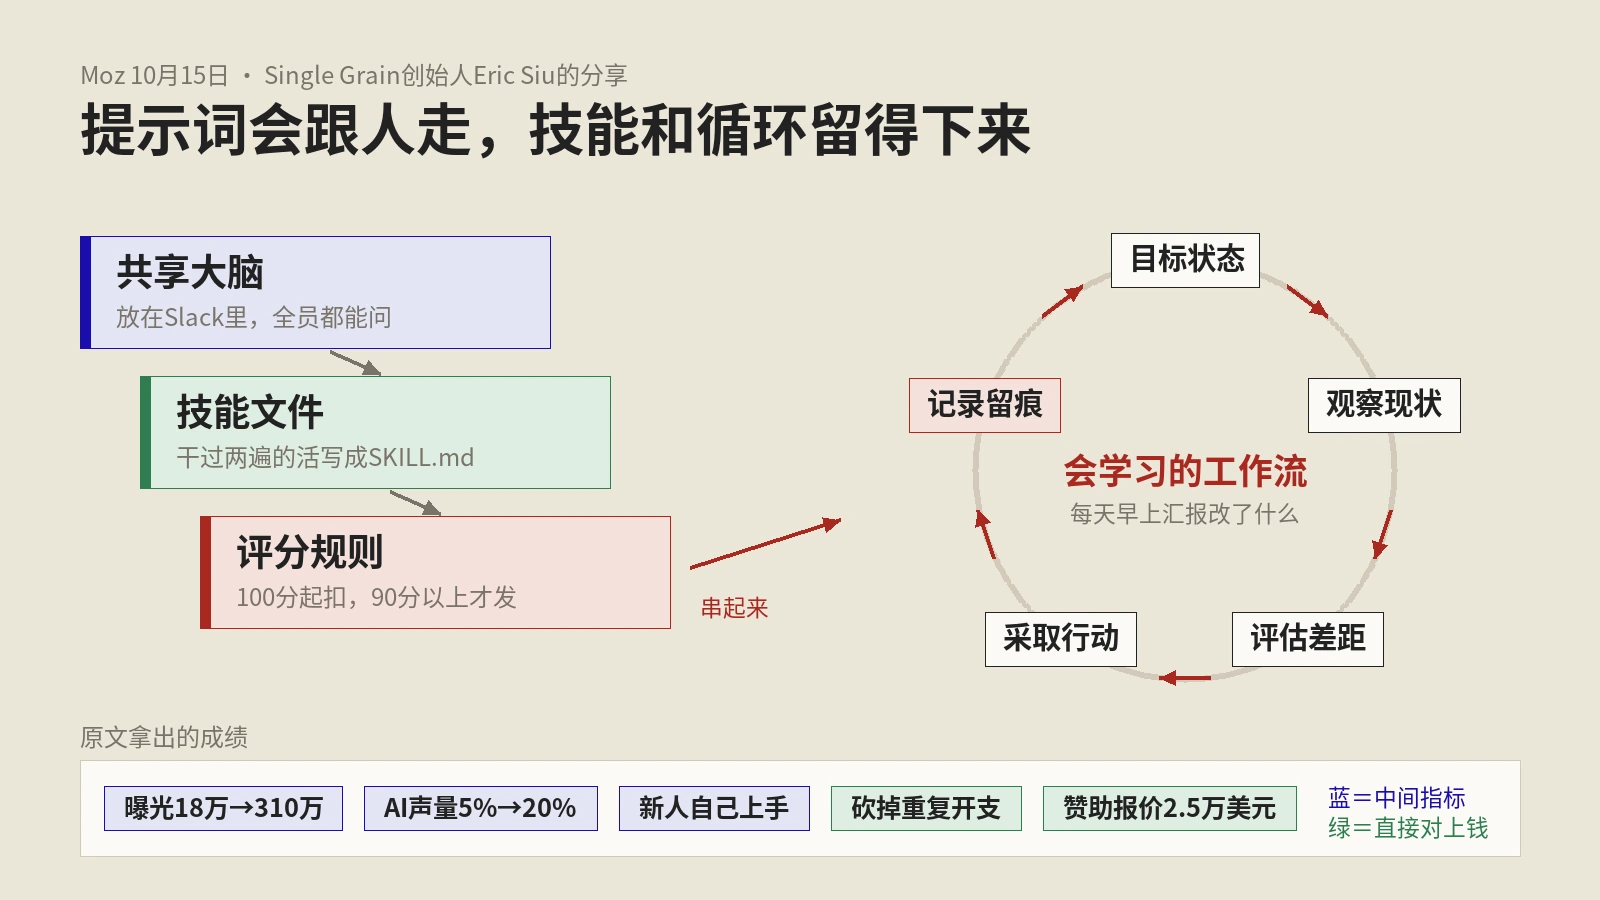
以Moz 10月15日Eric Siu的长文为主体,讲他怎样在Slack里搭共享AI大脑,把重复活写成SKILL.md技能,用100分扣分制的评分规则把关,再把技能串成带目标状态和行动记录的循环,并核对Panopto、BCG、Pew三项研究的样本口径,给出每个循环挂收入指标和留对照组的做法。
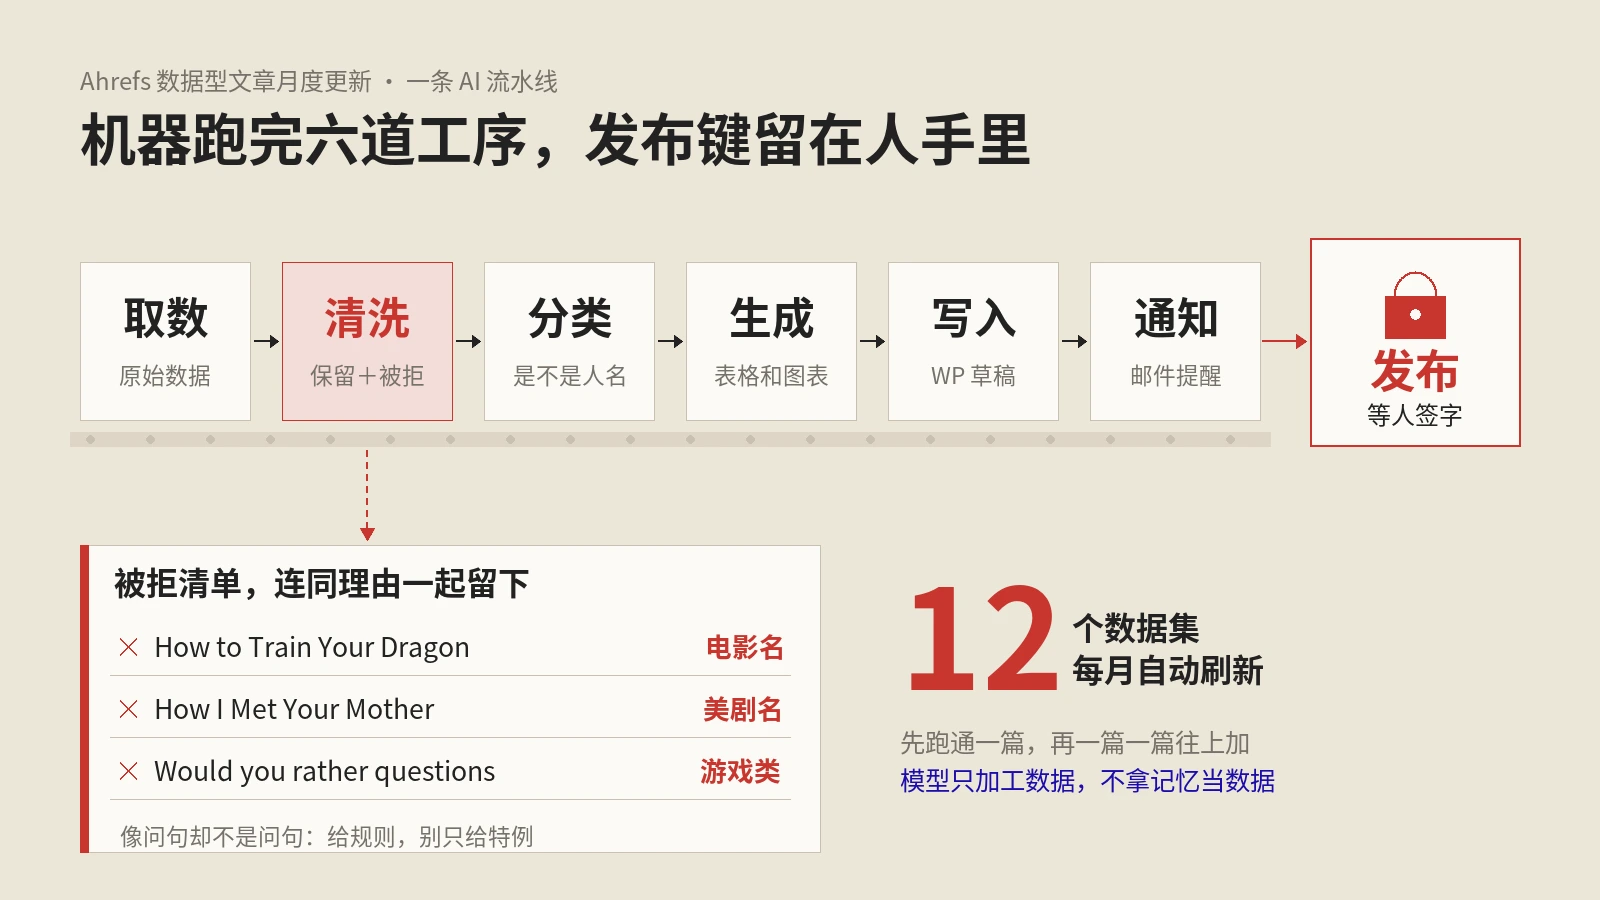
以Ahrefs 10月16日的跟做指南为主体,讲清Si Quan Ong怎样按五条标准挑出数据型文章的月度更新,用采访提示词把操作习惯写成技能文件,指定数据来源,用正反样例和被拒清单训练判断,分六个环节留存中间结果,先单篇后扩展,以及模型升级、共用工作区等会让流程失效的地方。
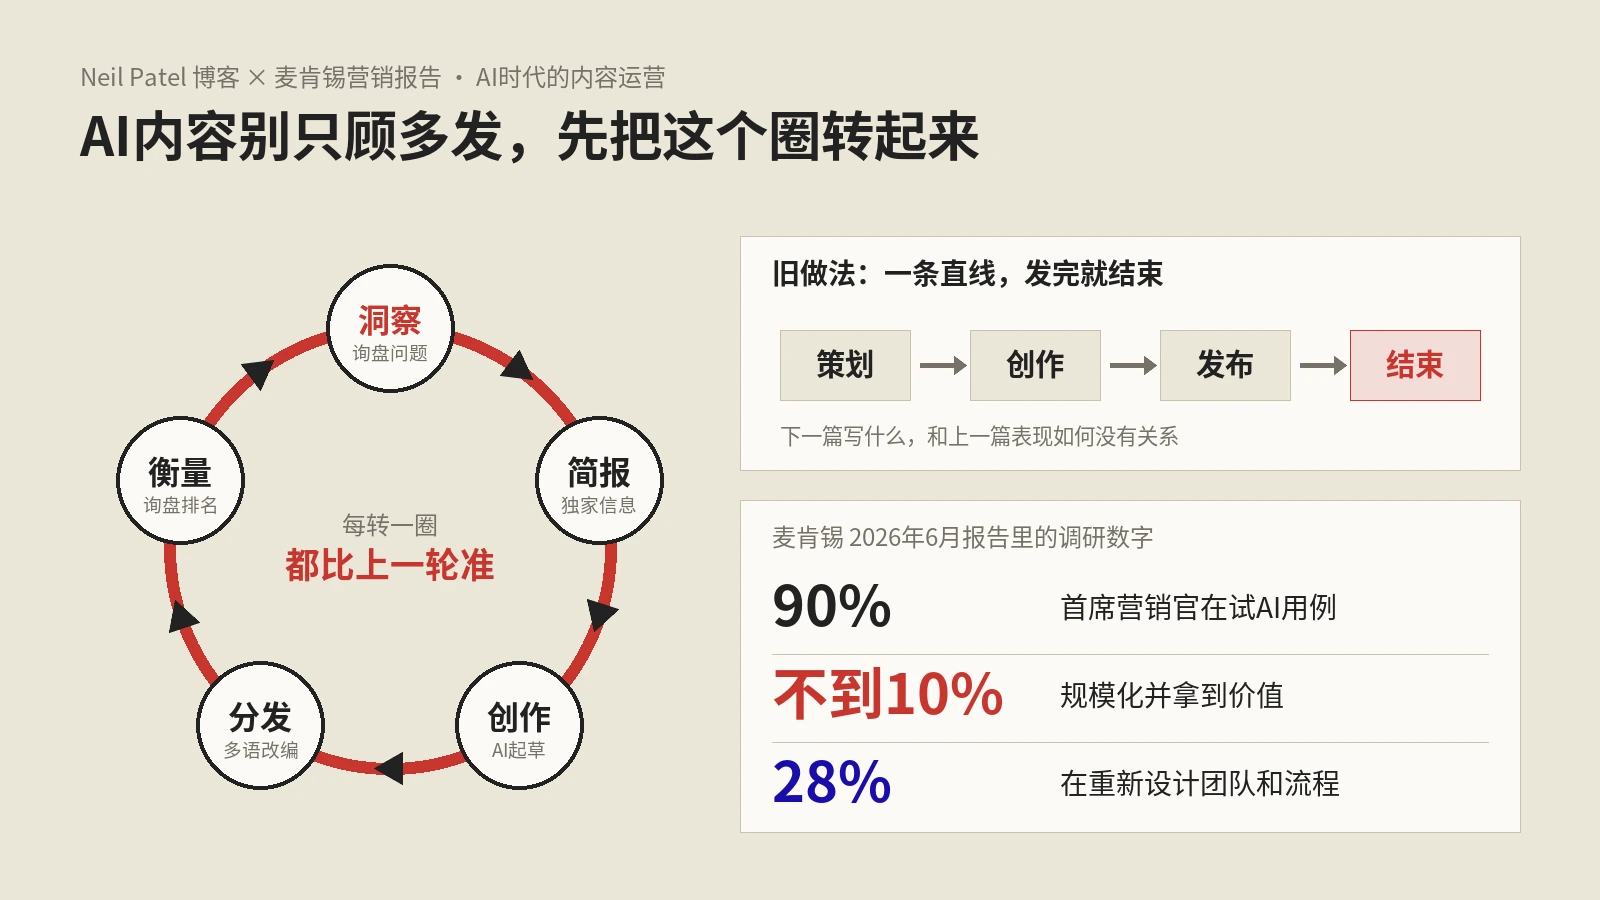
以Neil Patel博客10月16日的文章为主体,对照麦肯锡五项能力报告原文,讲清楚持续洞察、规模化创意、超个性化、面向AI代理营销和全天候编排各指什么,报告数字的口径,AI稿件为什么越多越乱,以及外贸独立站从洞察到衡量的循环流程怎么搭。
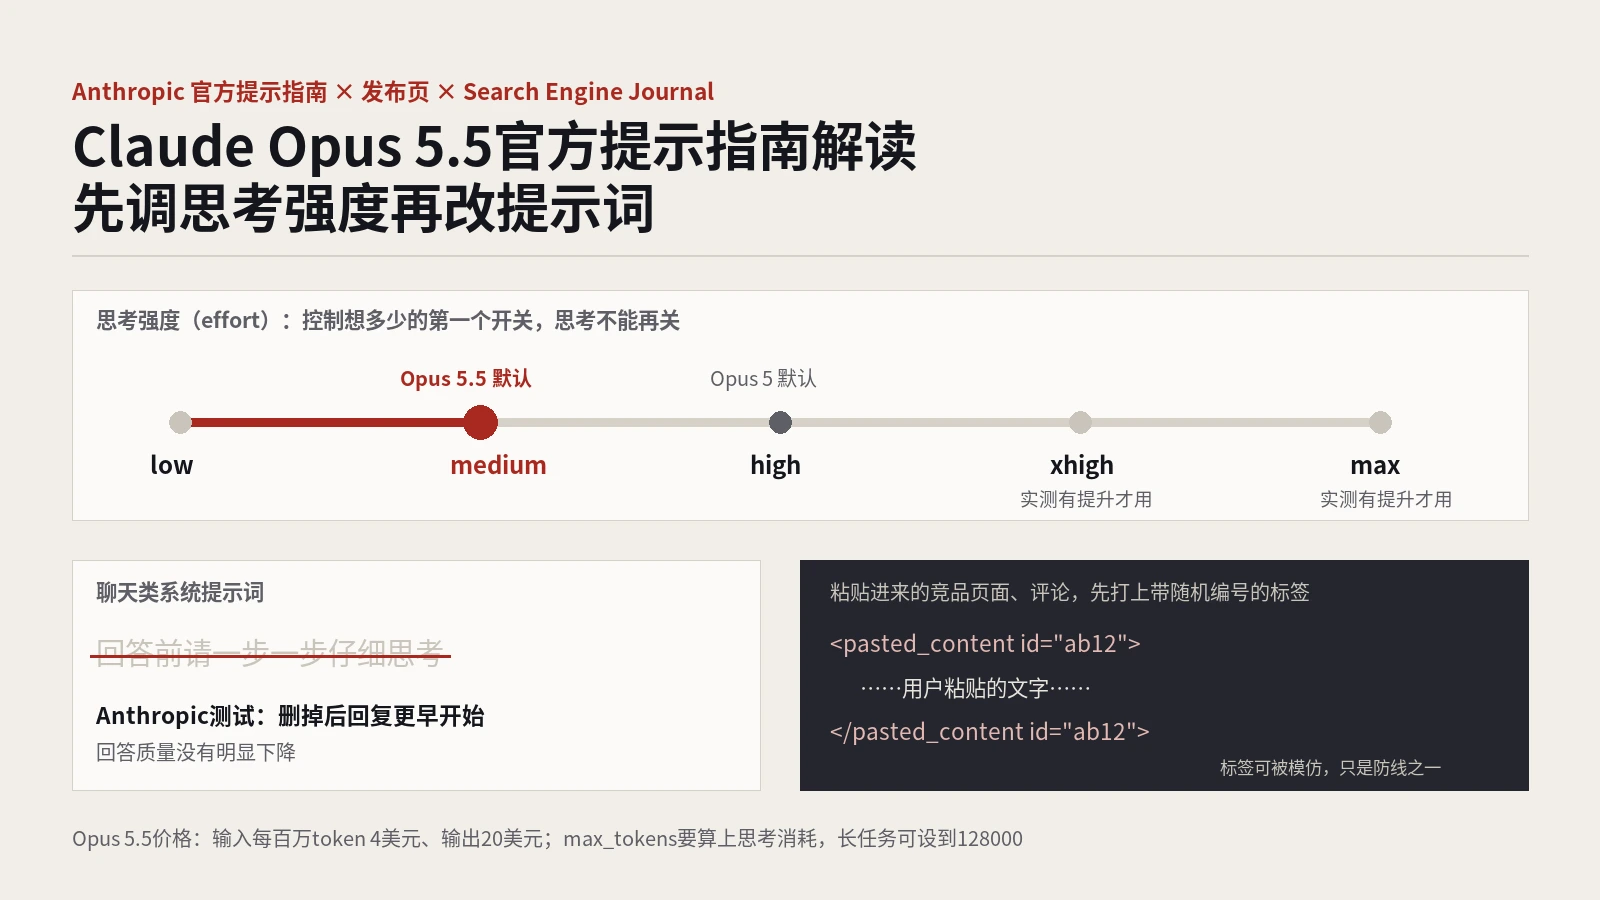
做法:以Anthropic的Claude Opus 5.5提示指南原文为主体,对照Search Engine Journal挑出的五条重点和Anthropic发布页,整理思考强度、思考指令、粘贴内容标签、智能体任务与读图能力的变化,并给出SEO任务的改造清单。
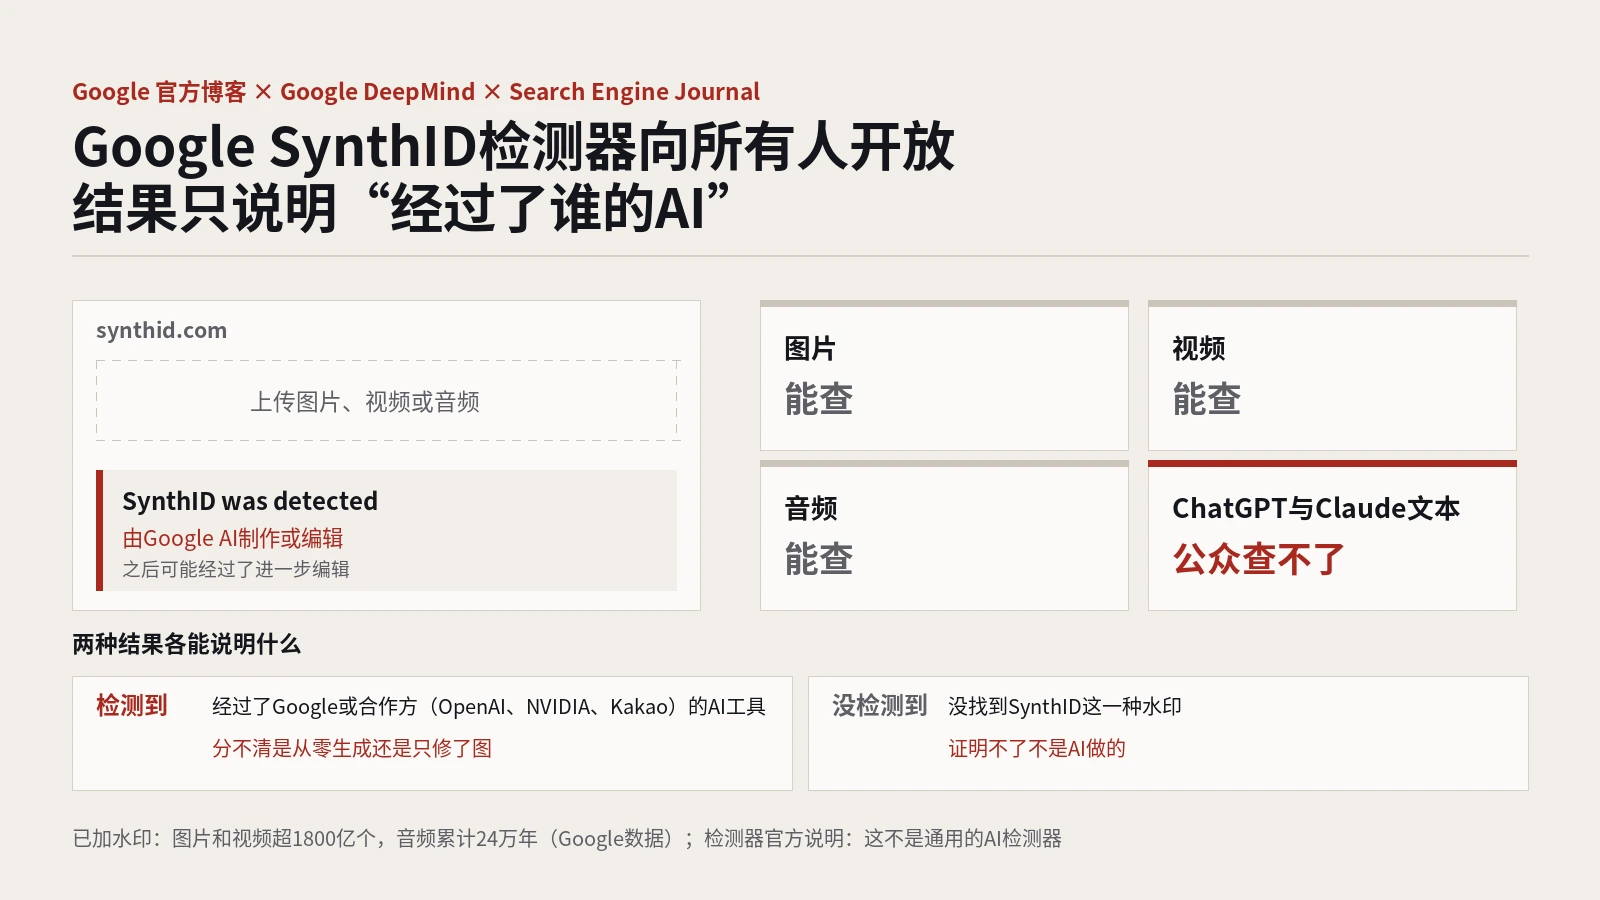
做法:以Google官方博客和Search Engine Journal的两篇报道为主体,对照Google DeepMind的SynthID介绍,整理检测器的开放范围、水印原理、检测结果的含义与局限,以及OpenAI欧盟文本水印的测试数据和检测门槛。
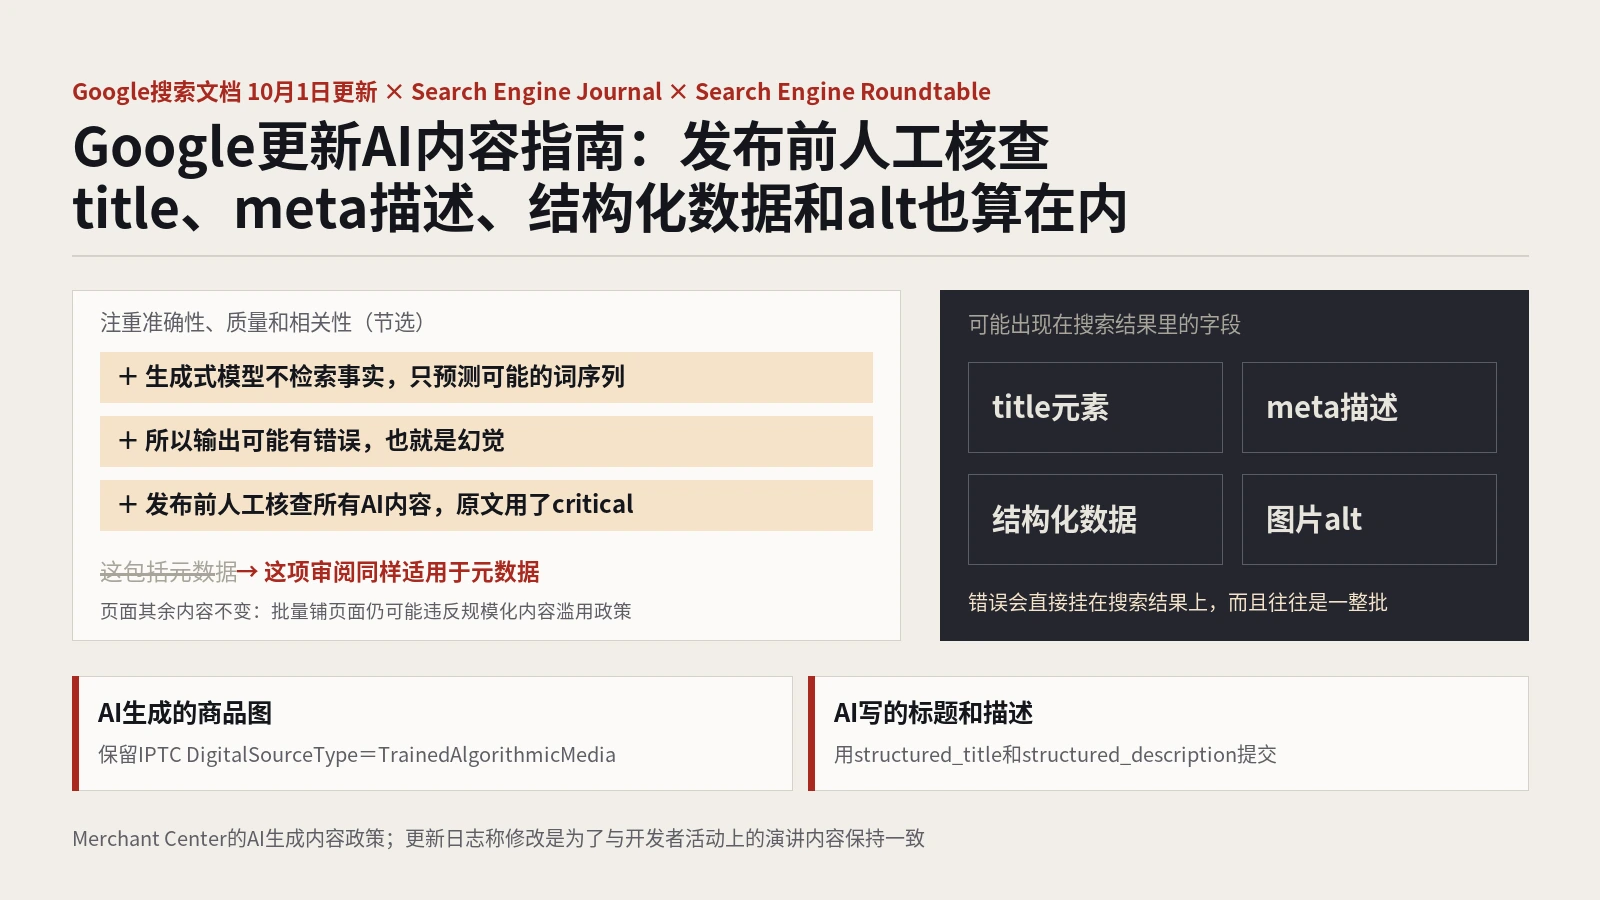
做法:以Search Engine Journal和Search Engine Roundtable对10月1日文档改动的逐句对比为主体,对照Google生成式AI内容指南原文、更新日志和Merchant Center的AI生成内容政策,整理新增三句话、未变的规模化内容警告、元数据为何被点名、AI商品图与商品数据的标注写法,以及审稿分工和核查清单。
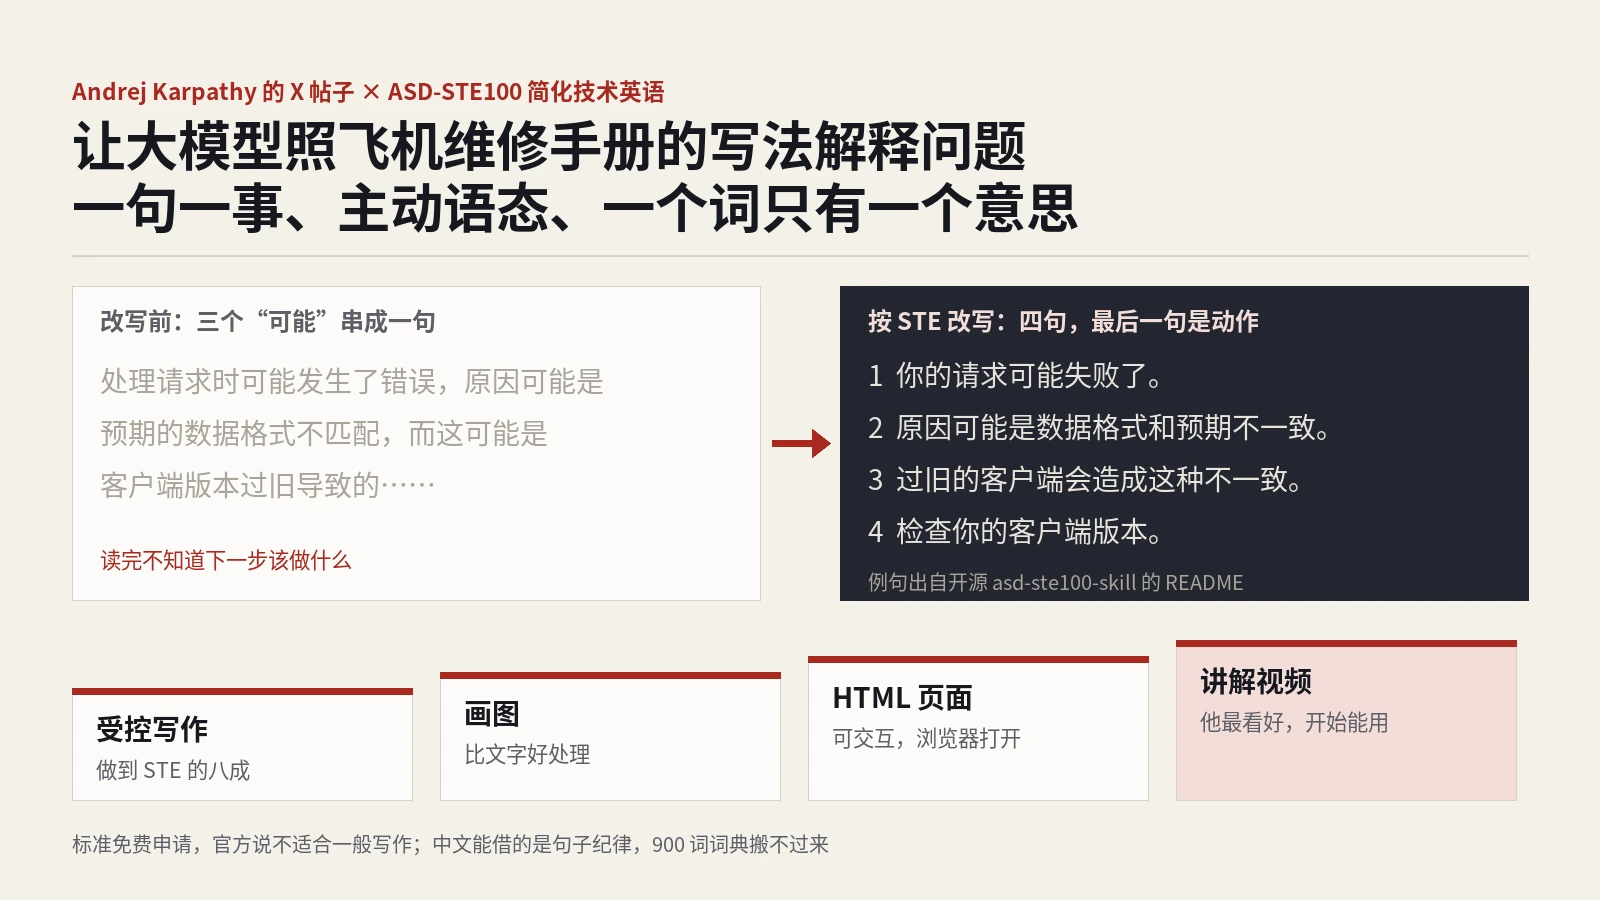
做法:以Search Engine Journal 10月2日对Karpathy帖子的整理为主体,对照ASD-STE100官网FAQ、开源STE技能的规则摘要和Claude博客的HTML文章,讲清标准的来历与核心规则、为什么能让AI输出更好读,以及中文团队可借用的写法、提示词和不适用的场景。
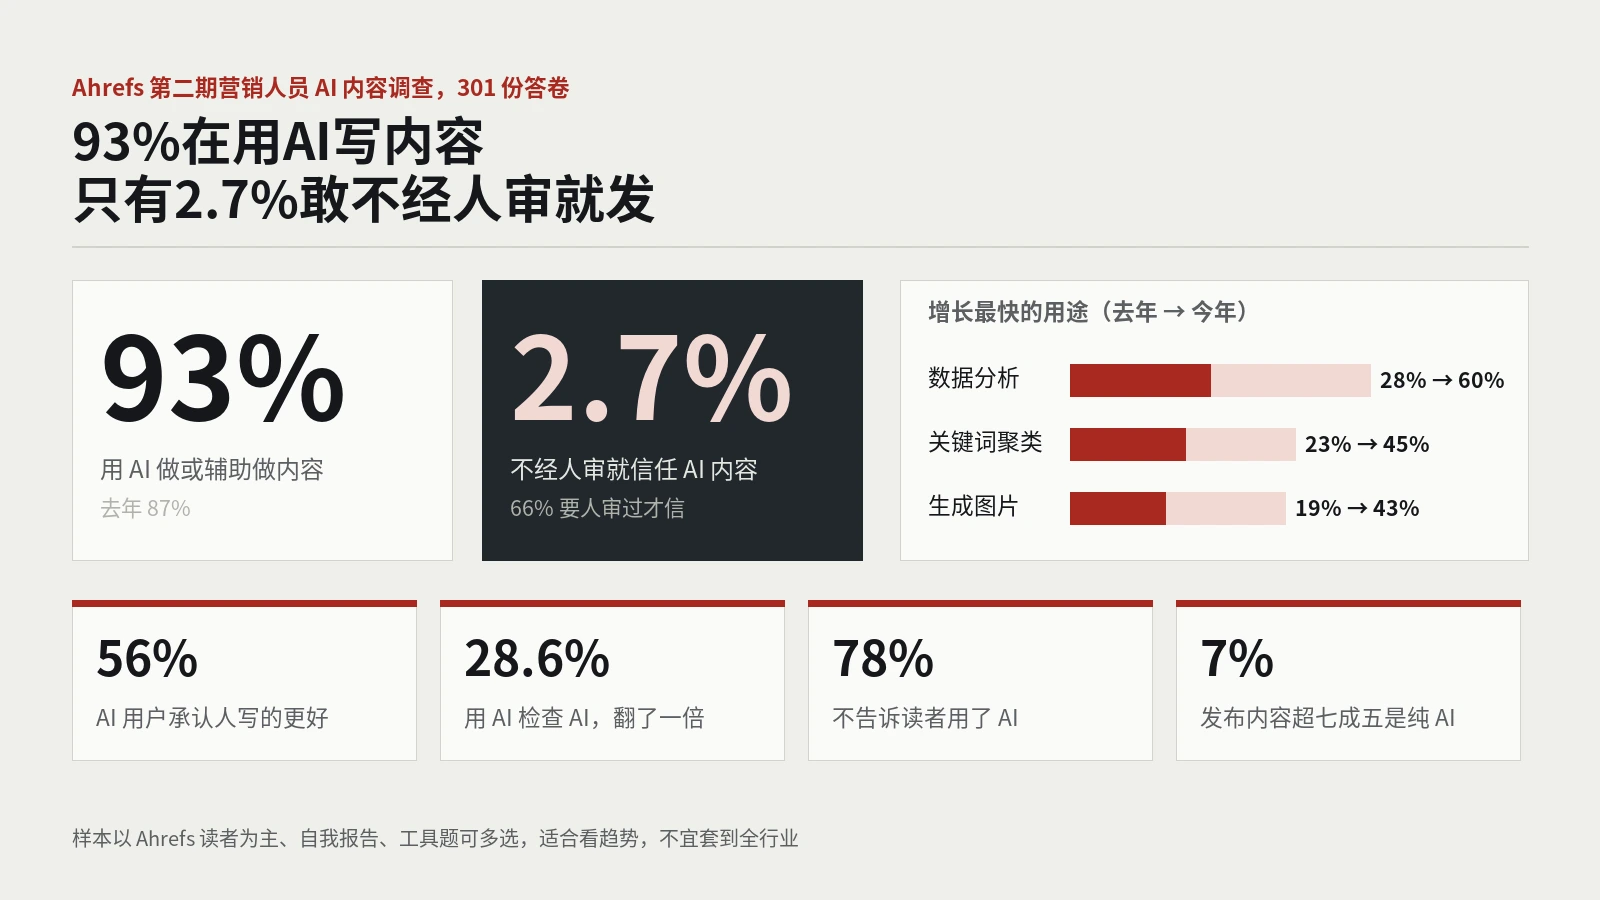
做法:以Ahrefs 9月30日发布的第二期营销人员AI内容调查为主体,对照2025年第一期报告和Google垃圾内容政策,整理AI普及率、增长最快的用途、工具与技能文件、信任与审核、质量评价、成本和披露数据,逐项说明样本局限,并给出外贸内容团队的分工建议和技能文件示例。
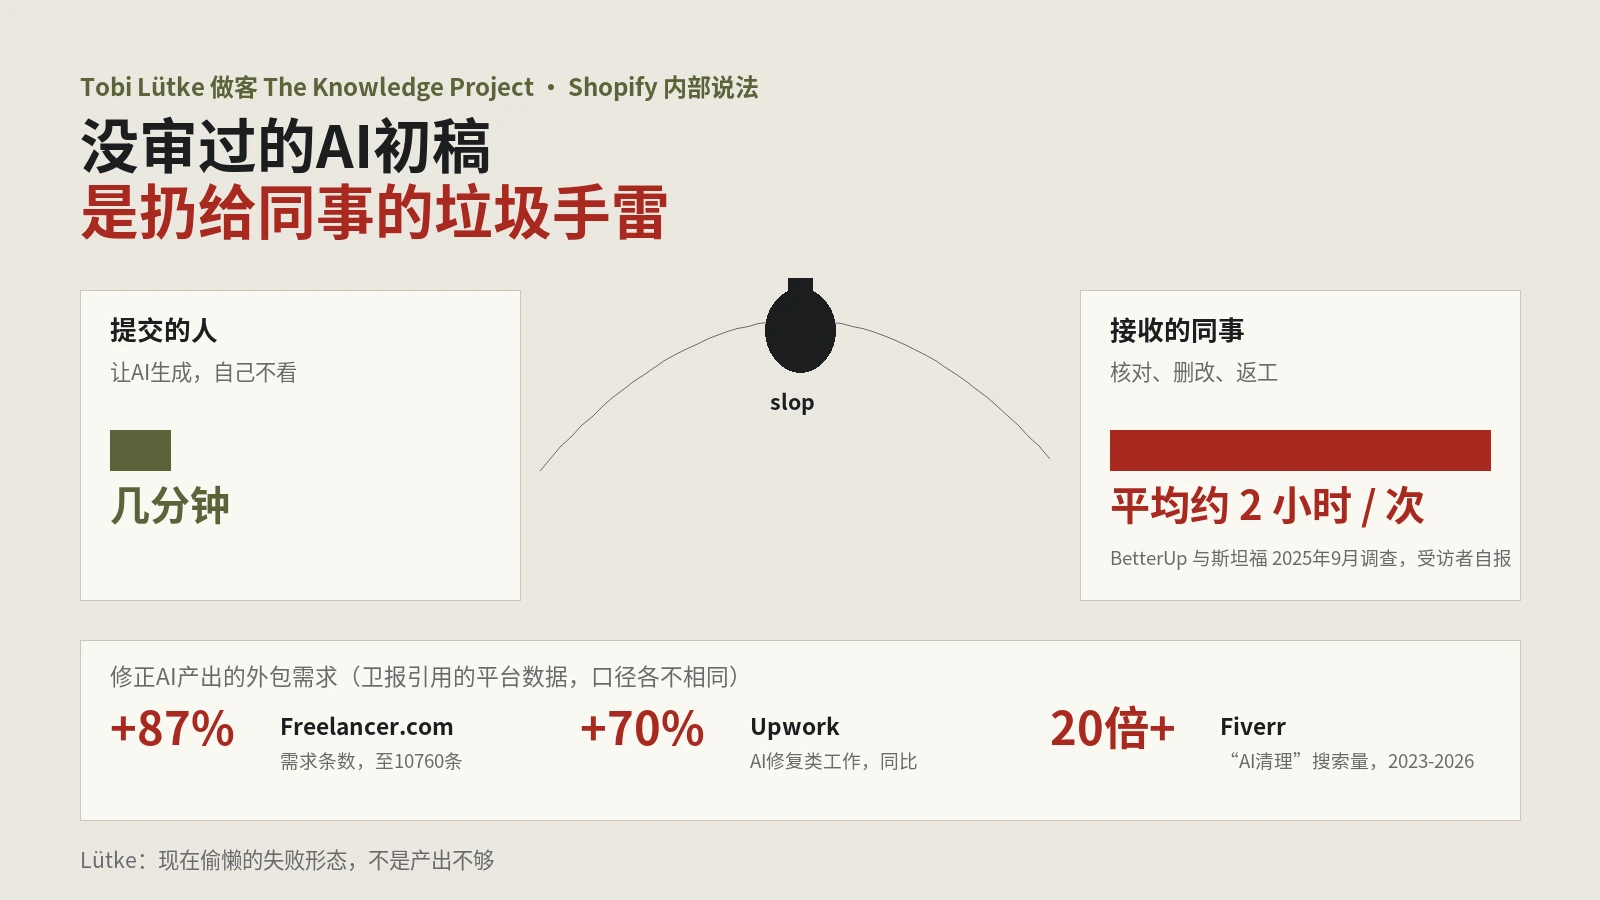
以SEJ 9月21日报道为主体,整理Shopify首席执行官Tobi Lütke在播客里关于slop grenade的原话、Shopify从2025年AI备忘录到全员使用的过程,以及卫报引用的修正AI外包数据和BetterUp的workslop调查,讲内容与外贸团队怎么把审稿时间算进AI成本、立哪些规矩。
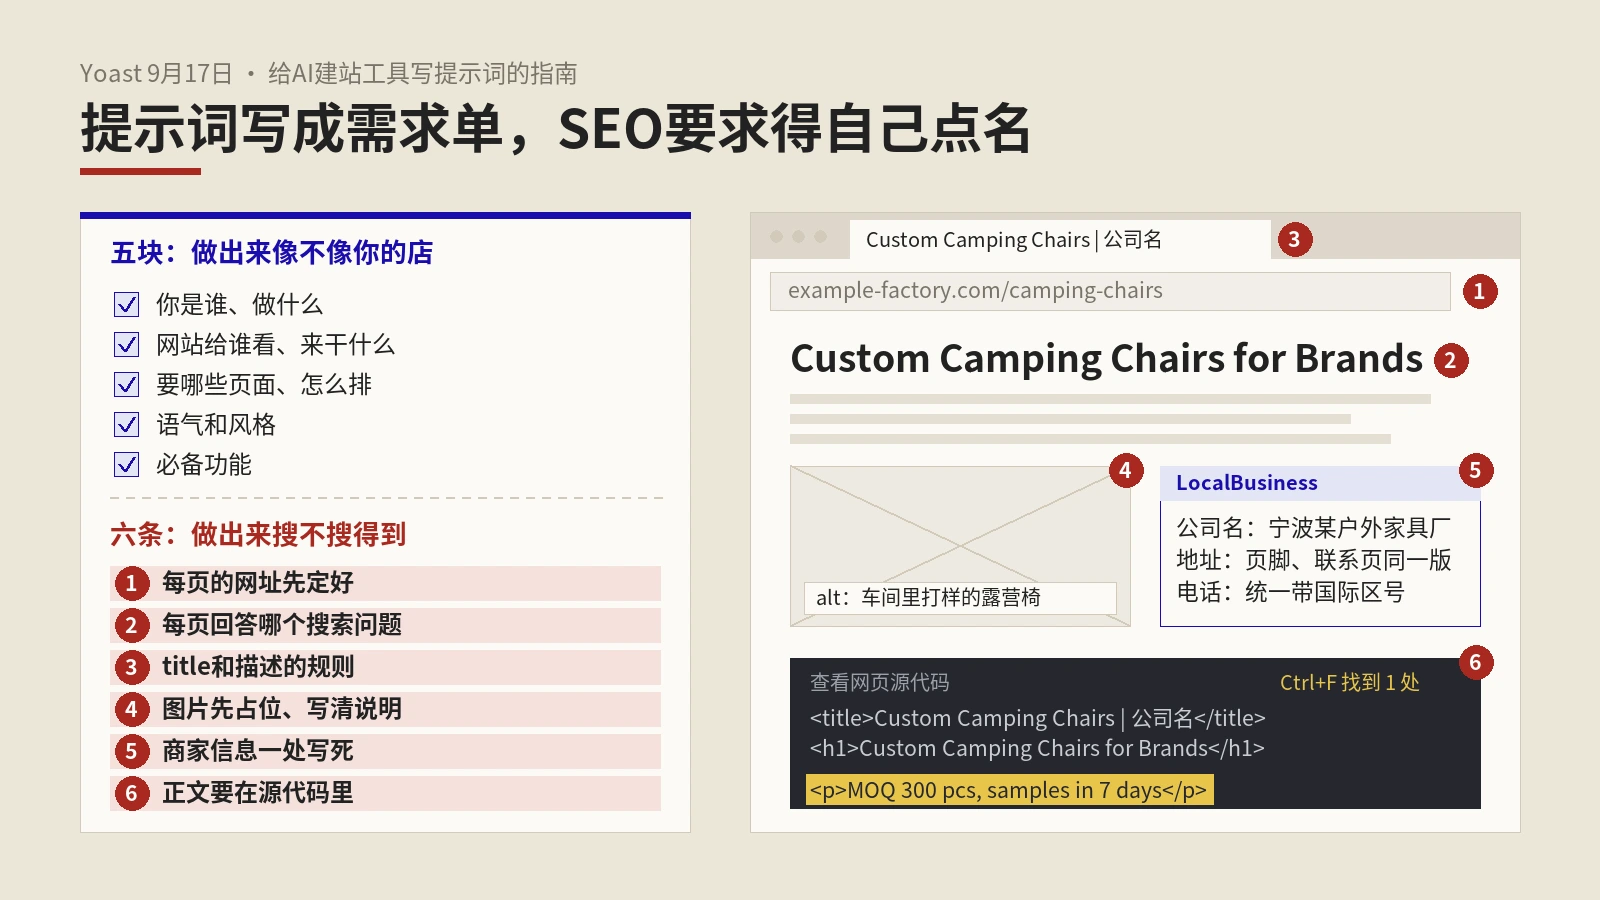
以Yoast 9月17日的AI建站提示词指南为主体,整理业务、访客、页面结构、语气、功能五块写法和五组强弱提示词对比,补上网址、每页搜索问题、标题描述规则、图片说明、商家信息结构化数据、可抓取性六条SEO要求,附两份外贸站提示词和上线前核对表。
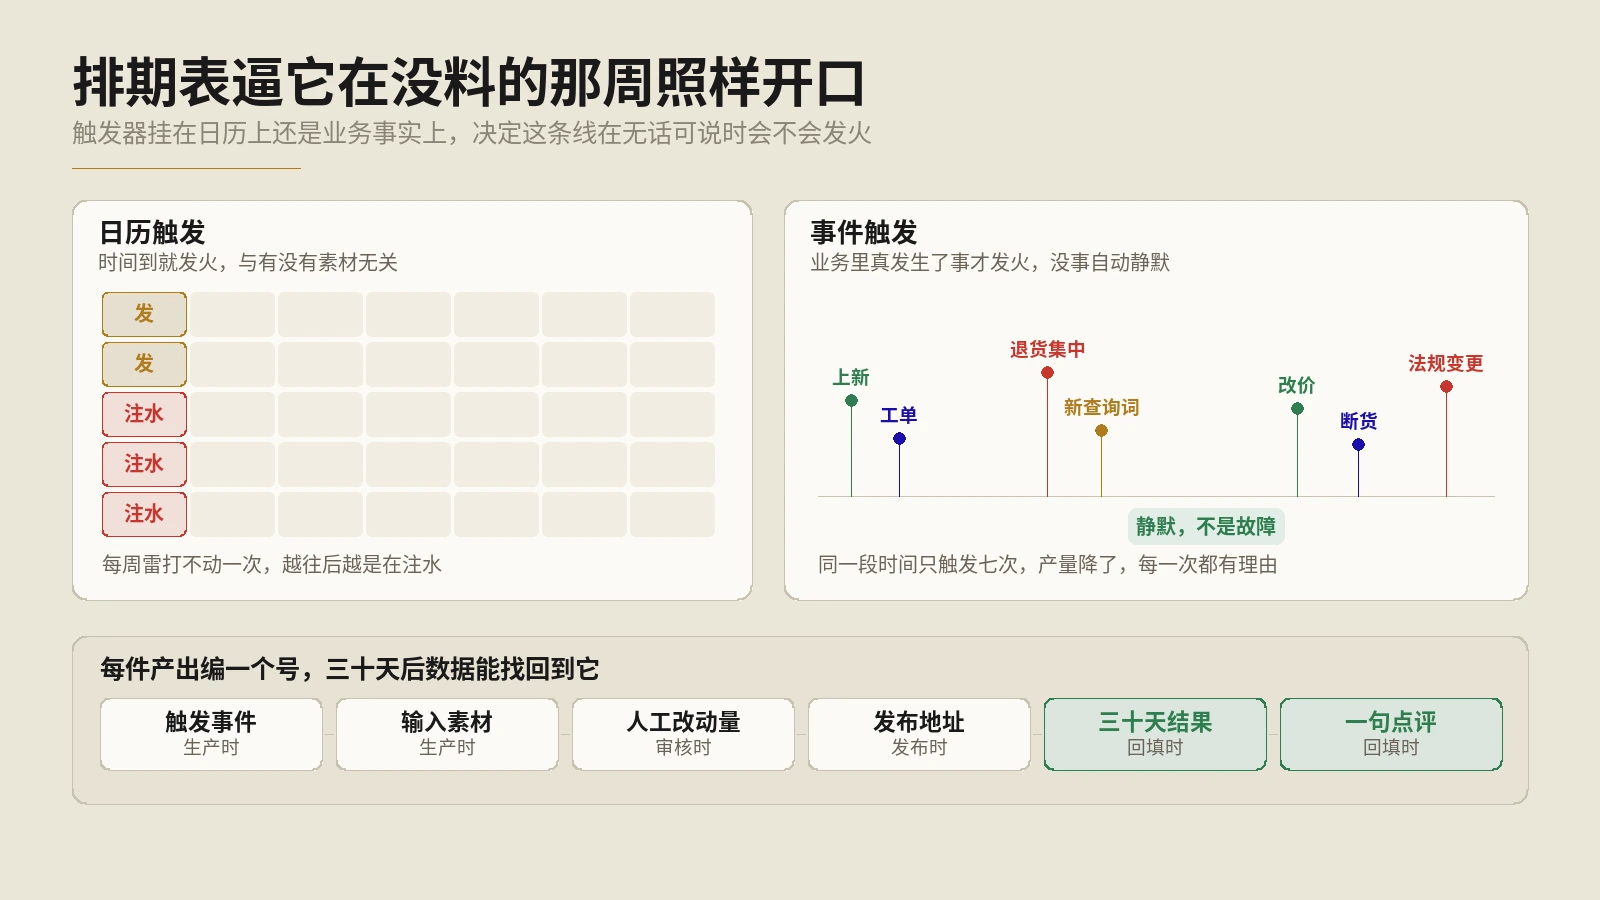
内容自动化的三段结构、六类可用事件源与阈值防抖去重键三参数、产出回执六字段清单、四周落地次序,附独立站页面类型的AI风险对照表与AGPL自部署提醒。
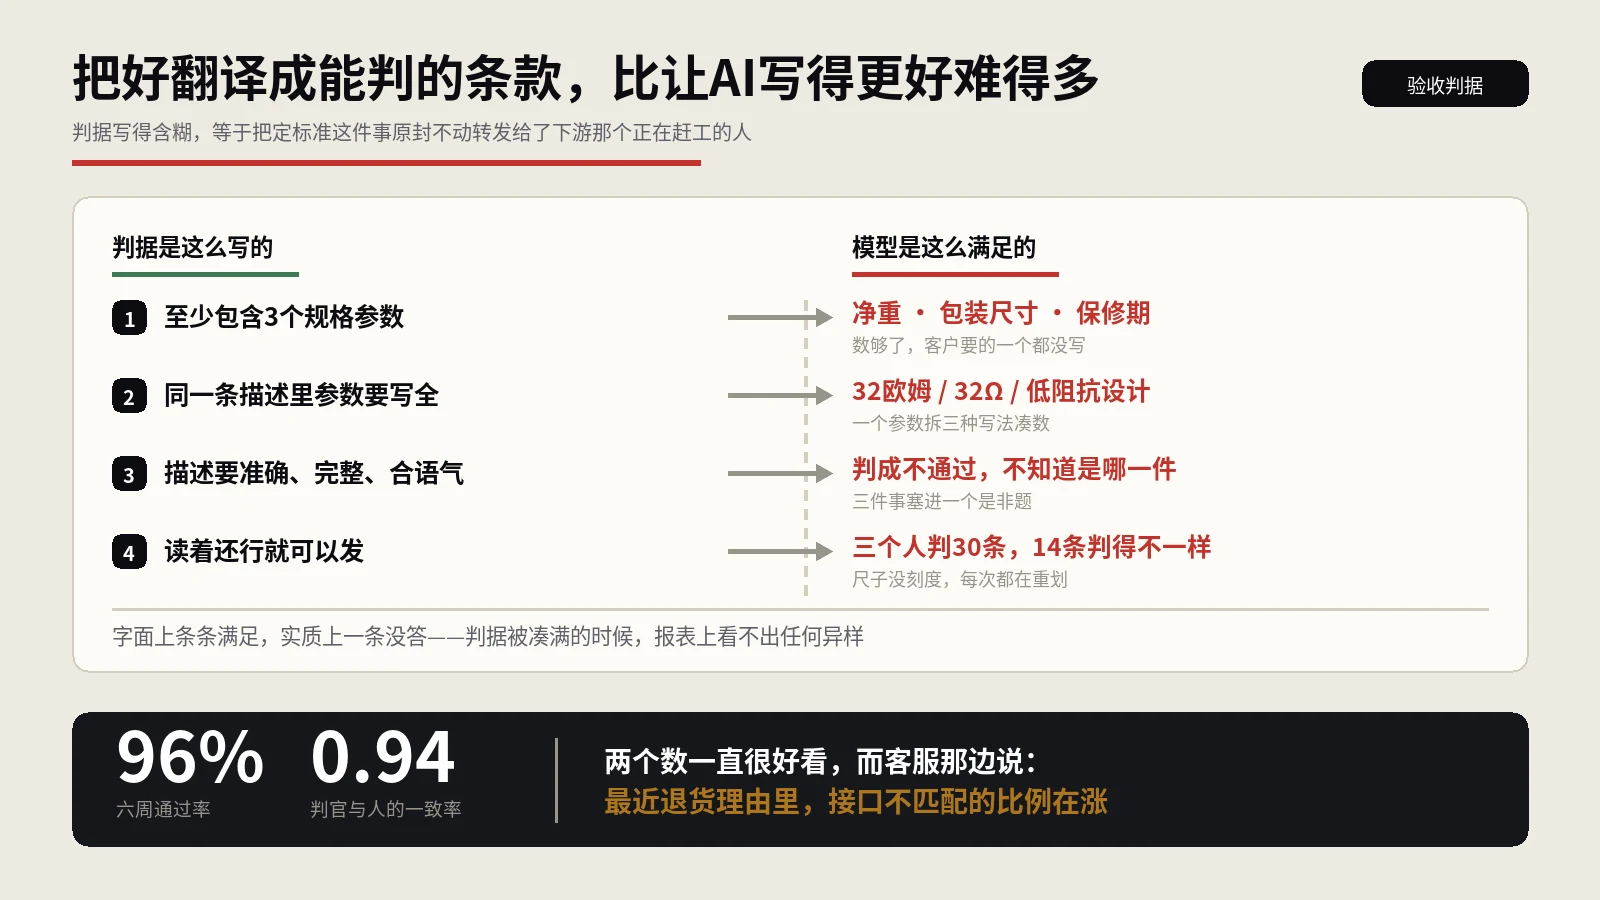
AI批量产出的验收难在没有尺子。这篇把好翻译成可判定条款:判据卡片六个字段、能用规则判的别请模型、模型判官的三种偏差与校准方法、判据的版本管理,附一次判据被凑满的失手复盘。
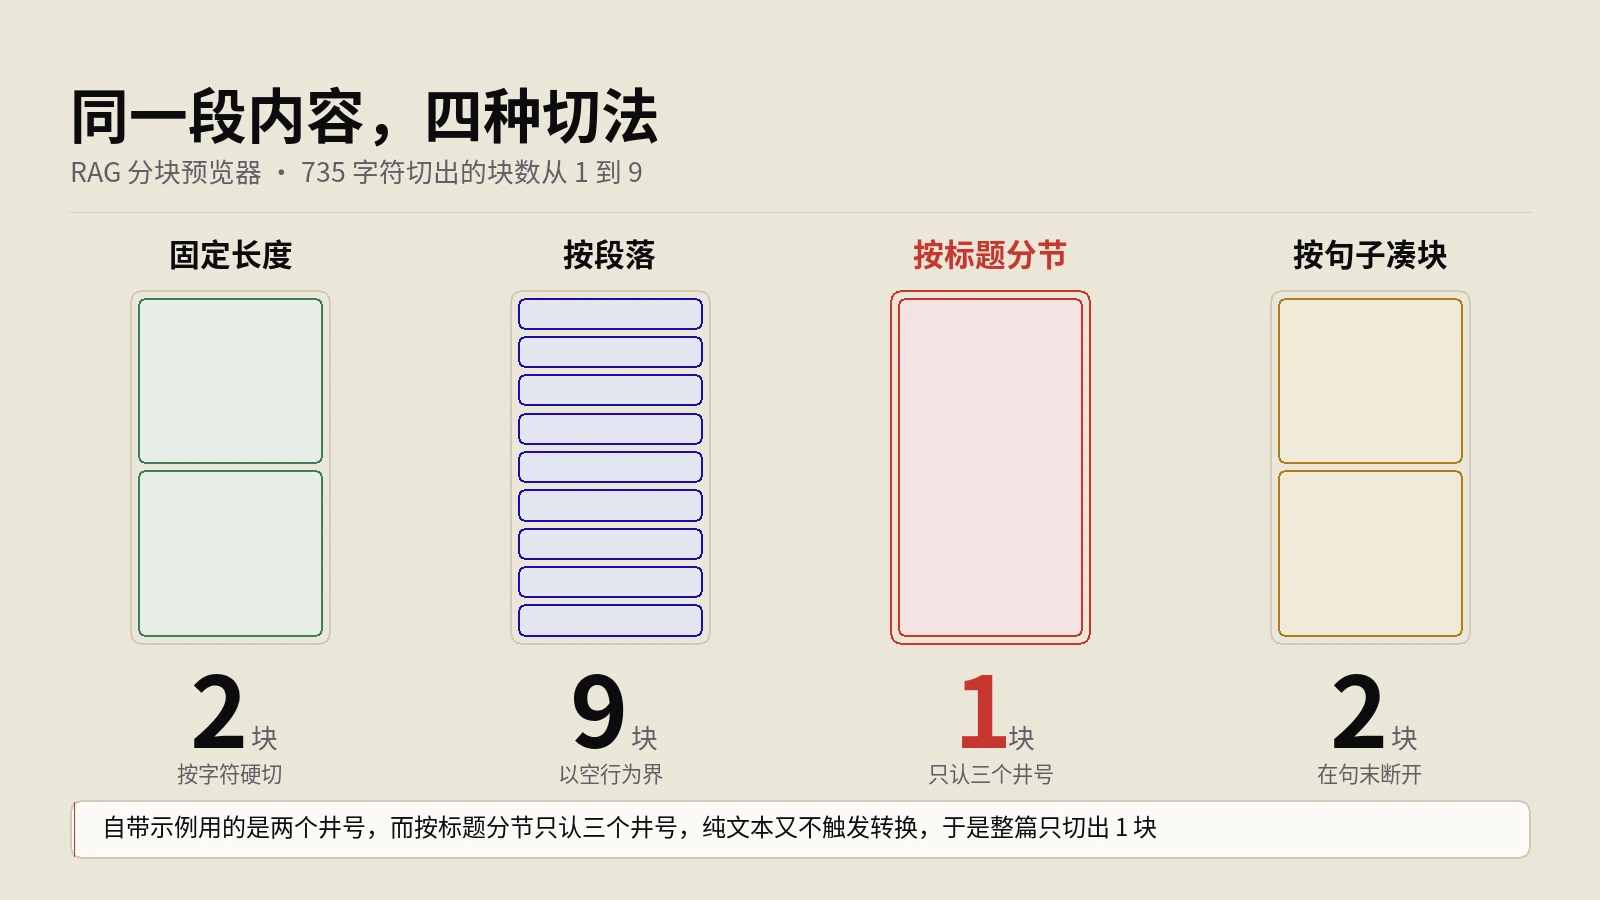
四种切分策略、重叠参数和自包含评分该怎么读?实测自带示例配按标题分节整篇只出1块,重叠只对固定长度生效,概览的平均块长开重叠后偏小八成,英文内容会全线误判。
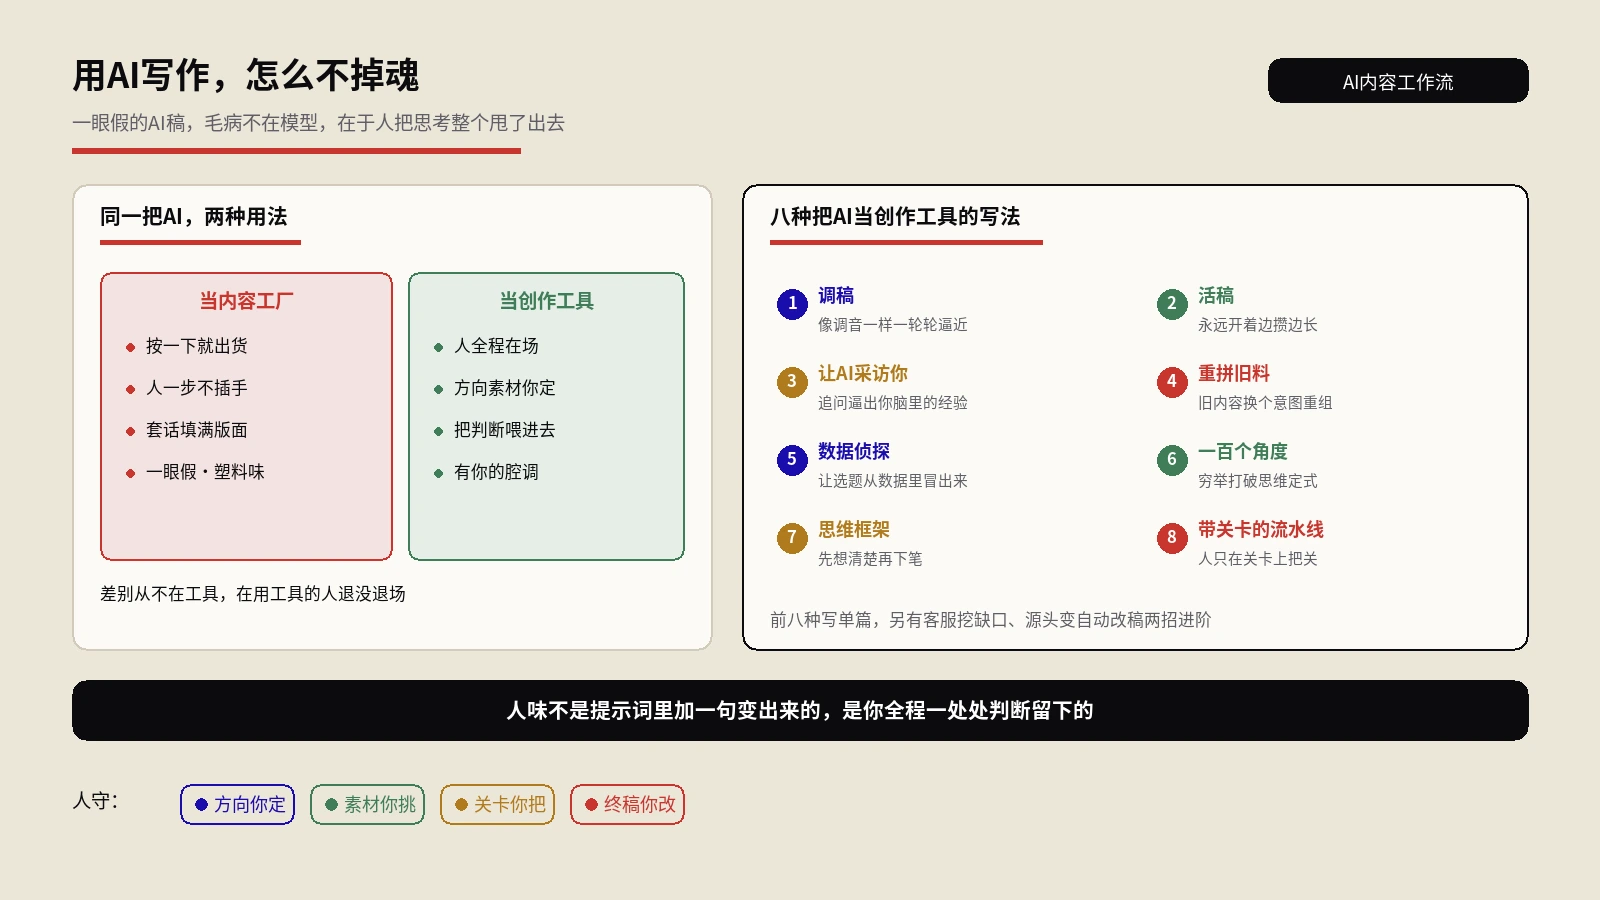
一眼假的AI稿,毛病往往不在模型,在于人把思考整个甩了出去。想让成稿还带着你的腔调,关键是全程别退场。本文拆开调稿、活稿、让AI采访你、重拼旧料、数据侦探、一百个角度、思维框架、带关卡的流水线八种写法,配一张什么内容用哪种的决策表,讲清人味从哪保住。
拆解Seedream 5.0 Pro的两套报价单:档位模式与像素模式的差别、236万像素这条计费线怎么卡、参考图为什么只有Pro收费、交互编辑的标记要自己画,以及图层能力在官方文档里的真实状态。

同一个模型出片差得像两个产品,差别几乎全在提示词的体裁。这篇拆开五段结构与词数预算、十二个参考位各管什么、画面内文字的三种技法、时间轴写法、六种废片成因与跨模型迁移地图,并把网上流传的那个成本数字按官方口径算回来。

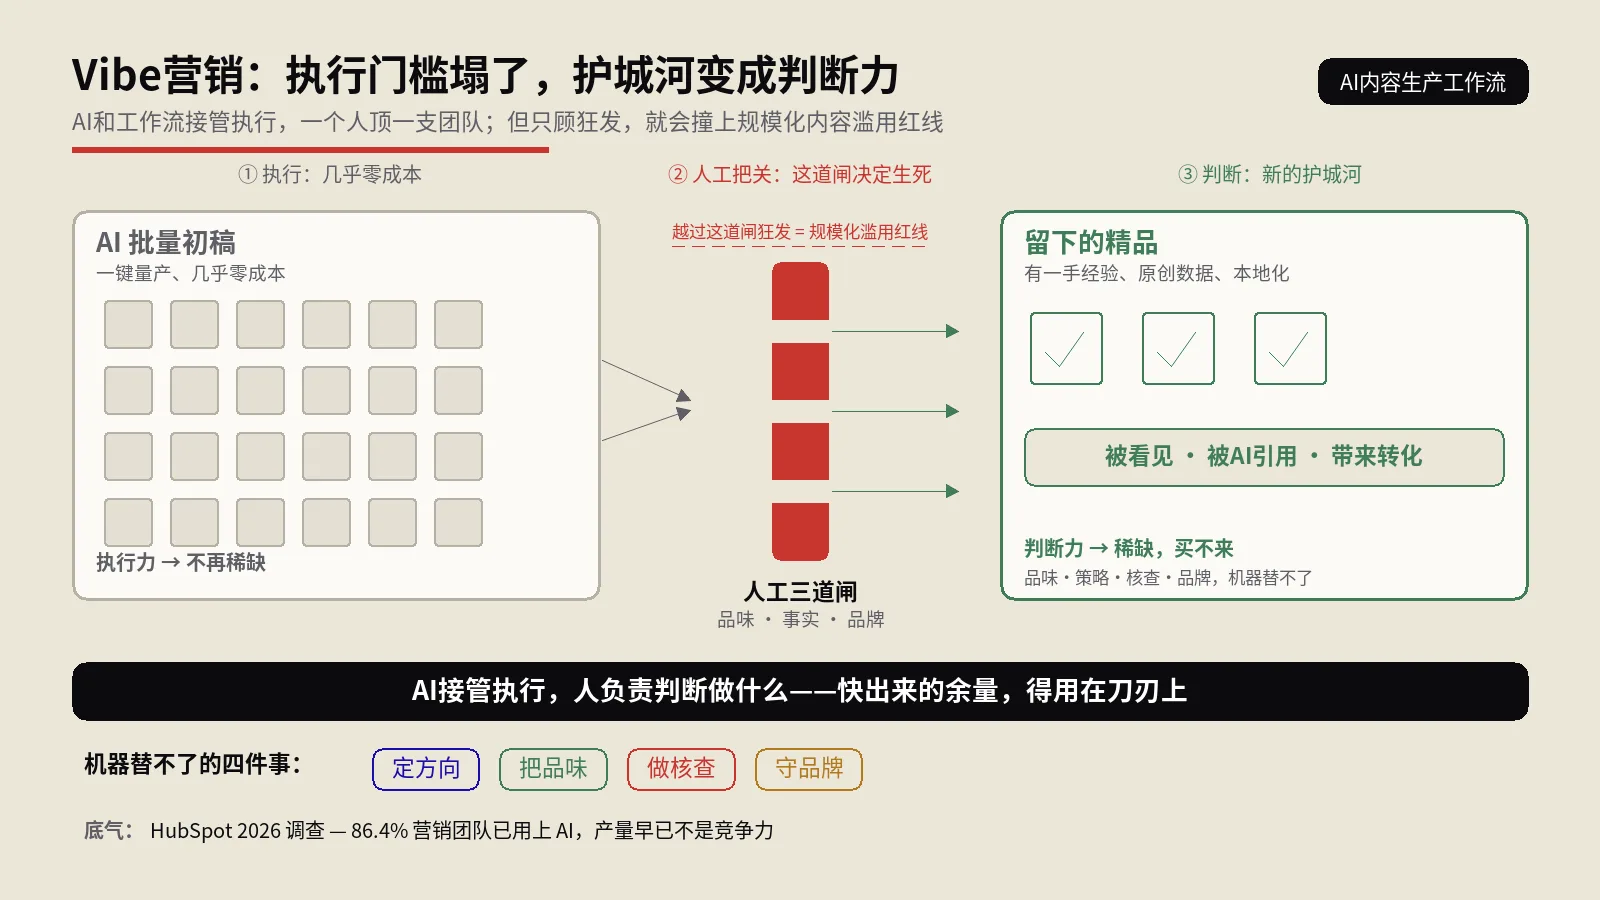
Vibe营销借用Vibe Coding的思路,你描述意图、AI智能体和工作流负责执行,一个人就能跑通过去一支团队的营销活。但执行门槛塌了,产量放大反而容易撞上规模化内容滥用红线,真正的护城河变成判断力和品味。
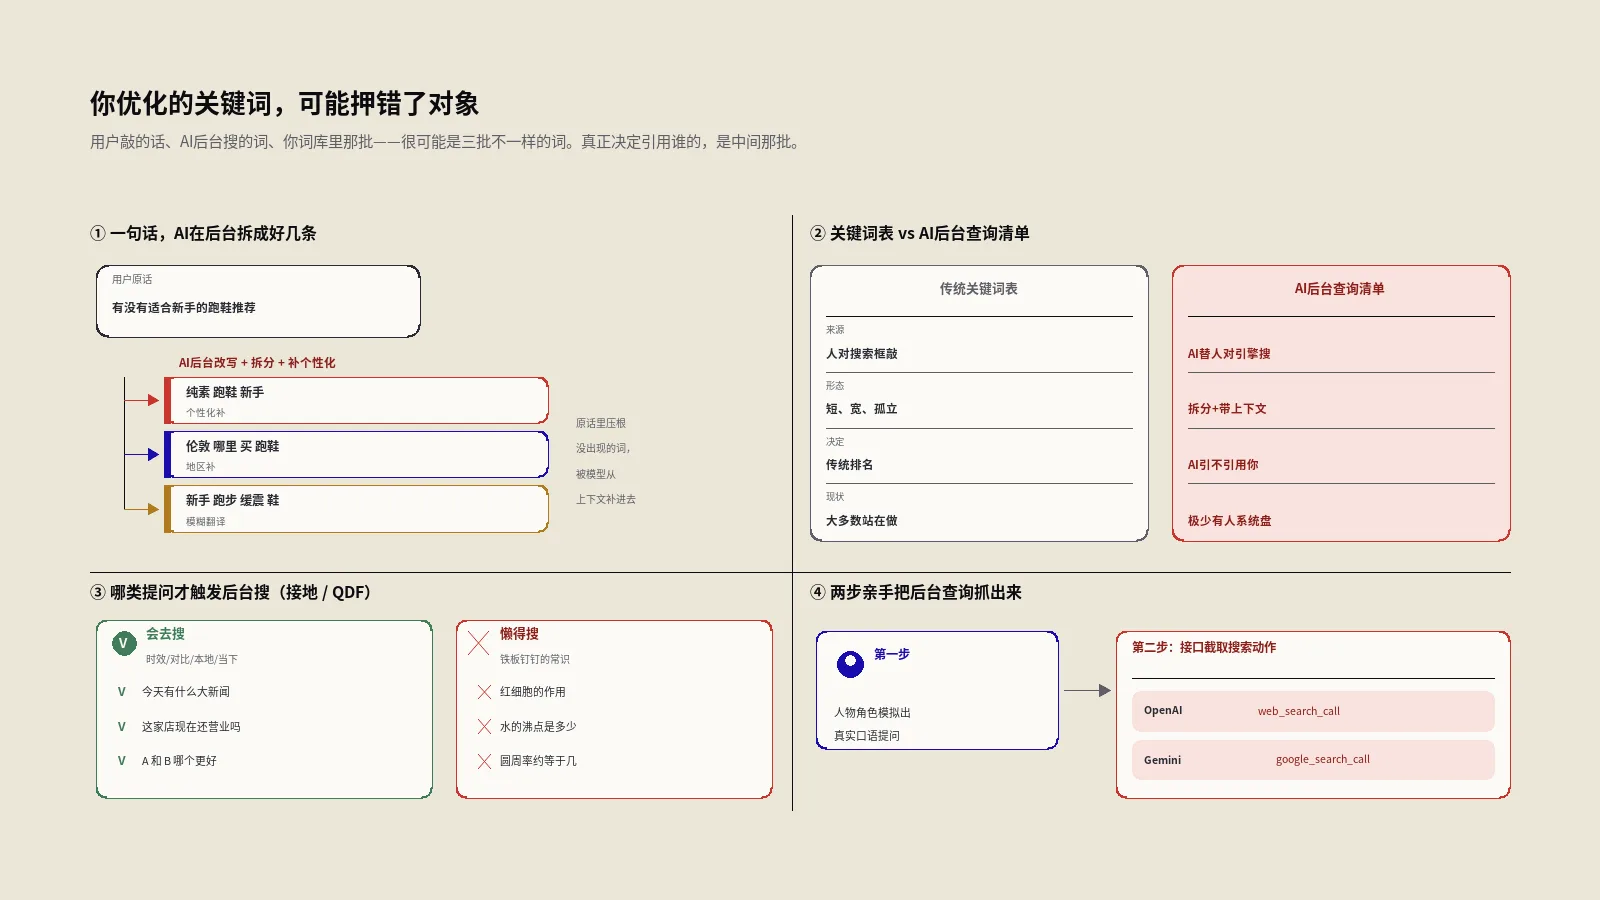
用户问AI一句话,模型会在后台拆成好几条传统搜索去检索,决定引用谁的正是这批看不见的中间查询。这篇讲怎么用人物角色模拟加接口截取,把AI后台真实搜的词抓出来,做差距分析,既补自有内容也去别人站上赚版位。
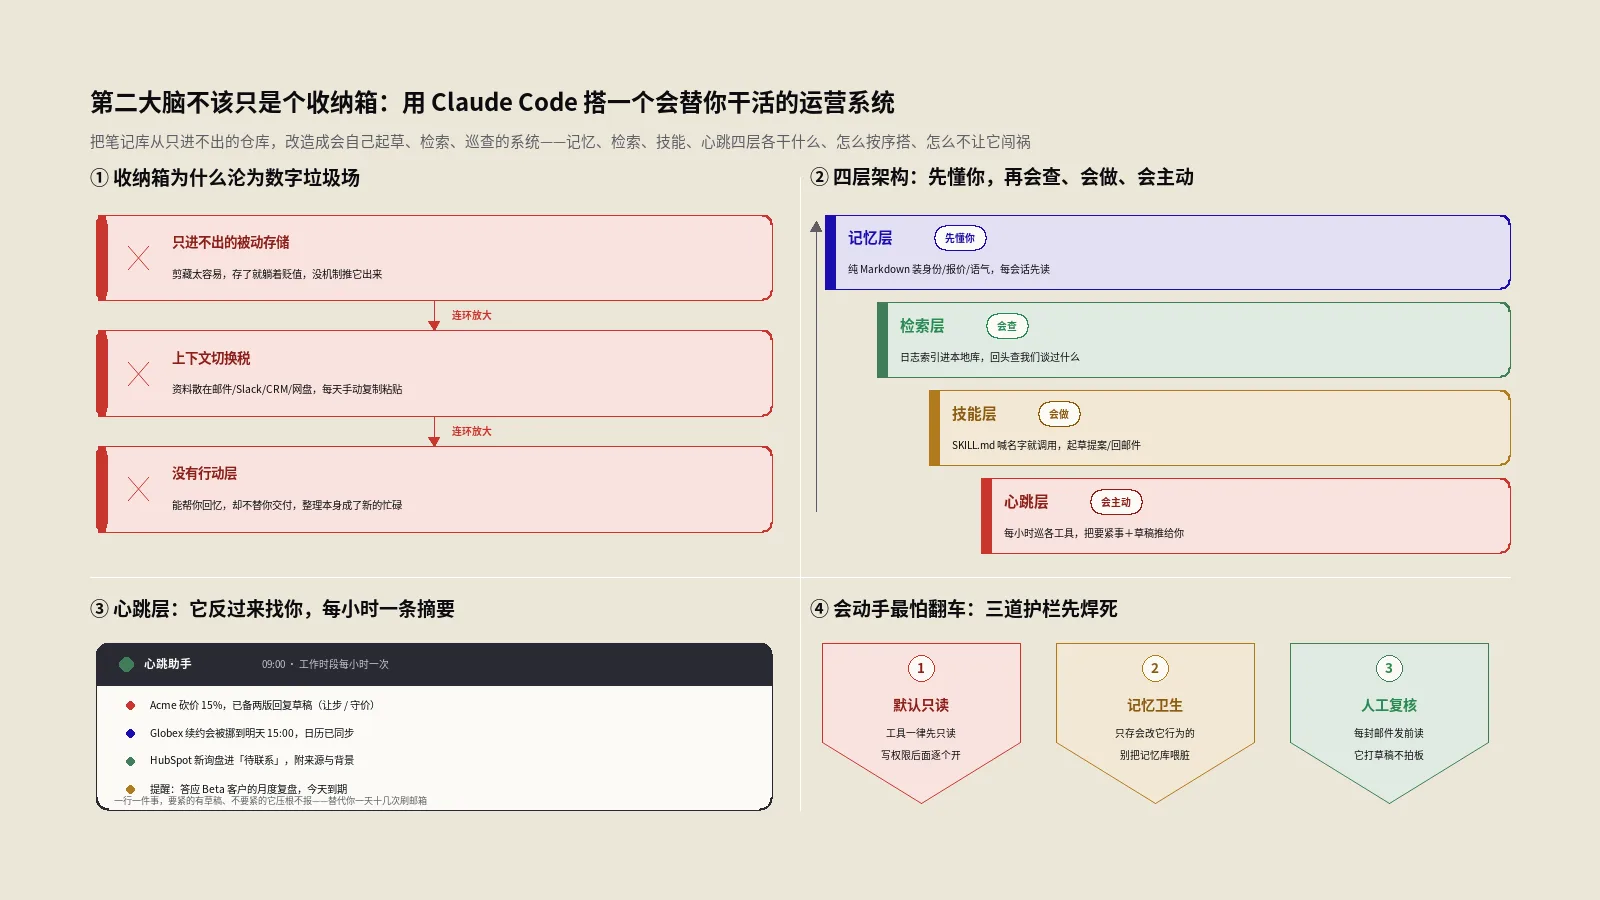
把笔记软件当第二大脑,最后大多堆成没人看的数字垃圾场。这篇讲怎么用Claude Code搭一个会动手的第二大脑:记忆、检索、技能、心跳四层,直连邮箱和CRM,把收集客户背景、写提案、回邮件这些重复活自动化,并给出从零落地的次序和三道防翻车护栏。