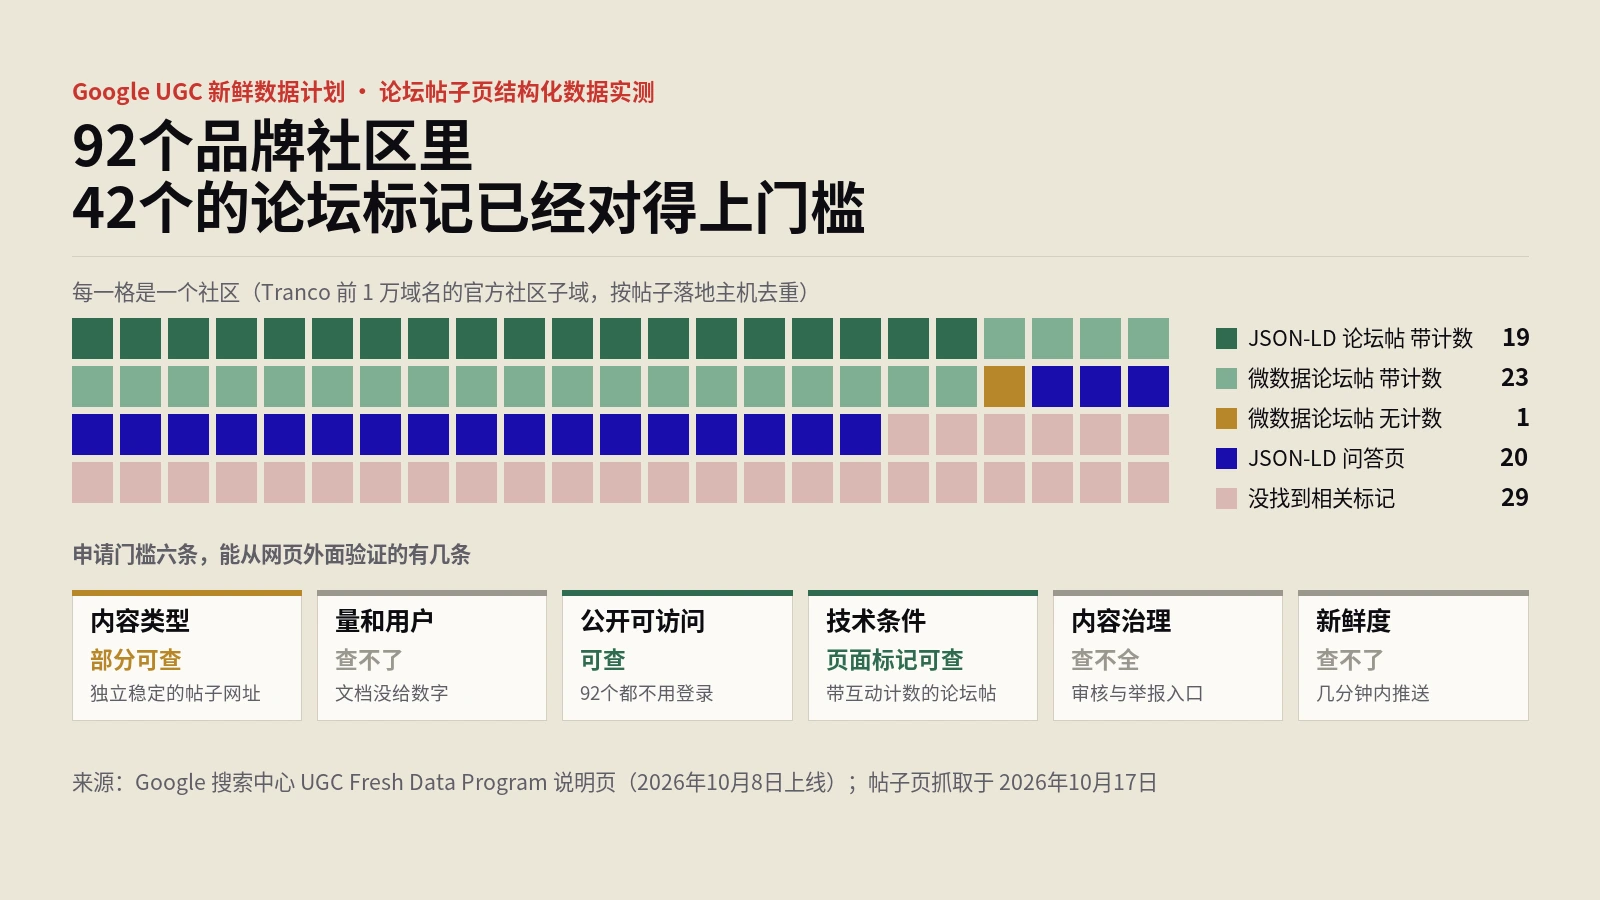
Google UGC新鲜数据计划门槛实测:92个品牌社区,42个结构化数据已达标
做法:逐条整理Google UGC新鲜数据计划说明页的六条资格要求;从Tranco前1万域名拼出5万个社区子域名,过滤泛解析后取回799个社区首页,抽取帖子页解析JSON-LD与微数据,按帖子落地主机去重得到92个社区,逐项核对论坛帖标记、互动计数、作者主页与登录墙。
标签
保哥笔记 技术SEO 标签下共 50 篇文章合集,含《技术SEO一堆问题先修哪个?500站实测排出来的优先》《Core Web Vitals在AI搜索时代还值不值》《电商SEO最重要的5点:从AI爬虫到accessib》等,与 Core Web Vitals、AI爬虫、结构化数据 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
做法:逐条整理Google UGC新鲜数据计划说明页的六条资格要求;从Tranco前1万域名拼出5万个社区子域名,过滤泛解析后取回799个社区首页,抽取帖子页解析JSON-LD与微数据,按帖子落地主机去重得到92个社区,逐项核对论坛帖标记、互动计数、作者主页与登录墙。
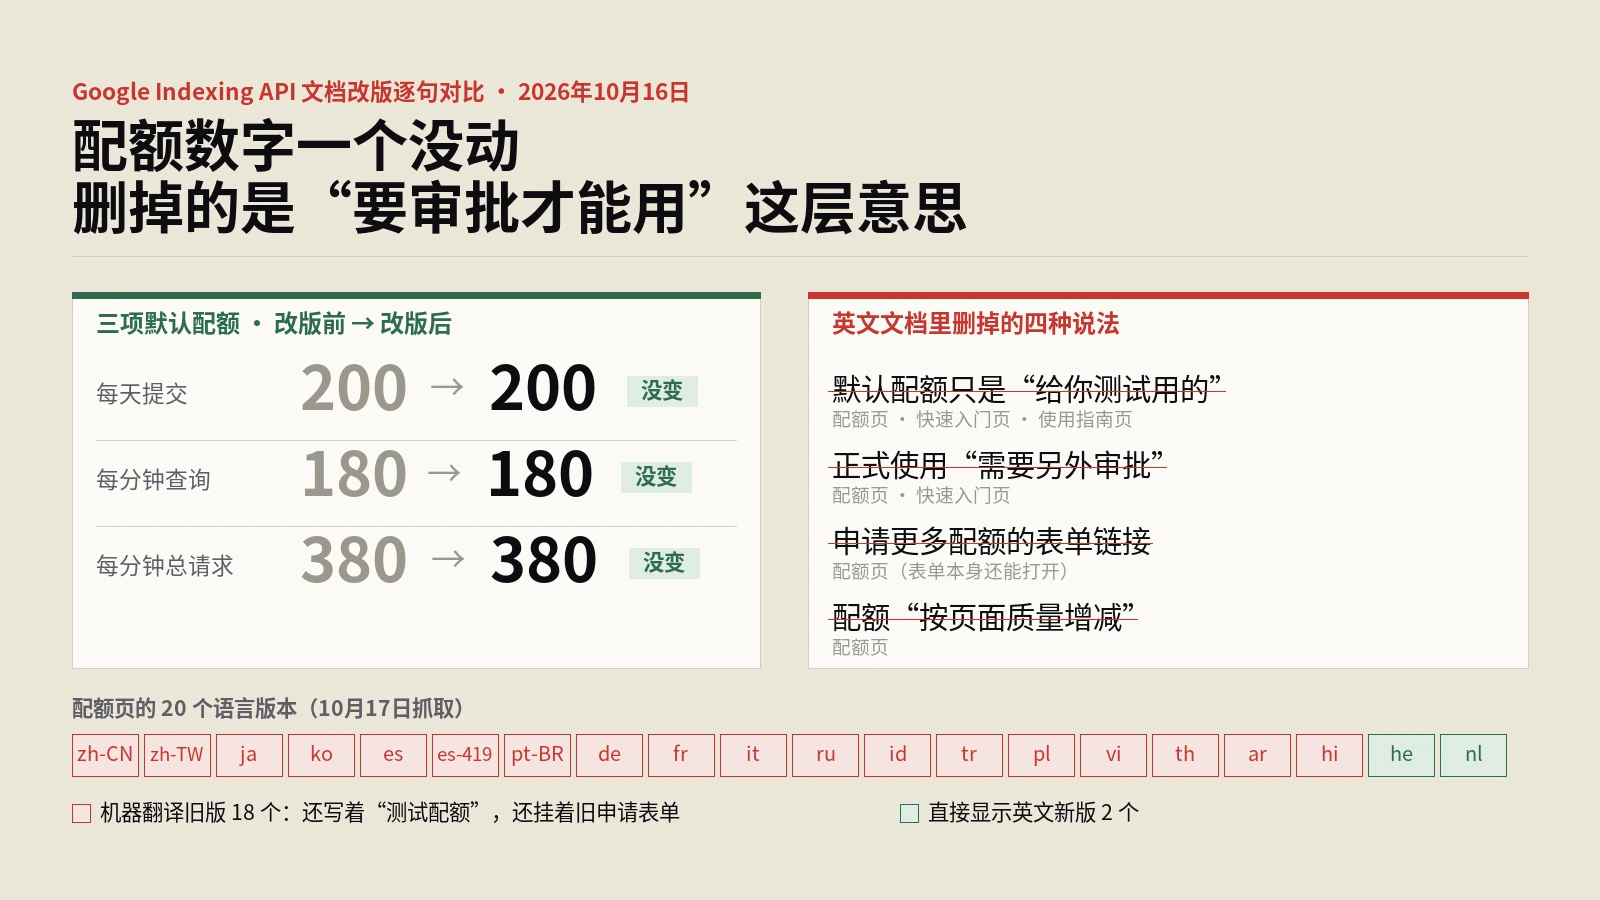
做法:从Common Crawl取回Indexing API配额页、快速入门页、使用指南页改版前的英文存档,和10月17日的现行版本逐句对比;再抓取三页的20个语言版本,统计哪些还停在旧版;最后用已登录账号只读打开旧申请表单。
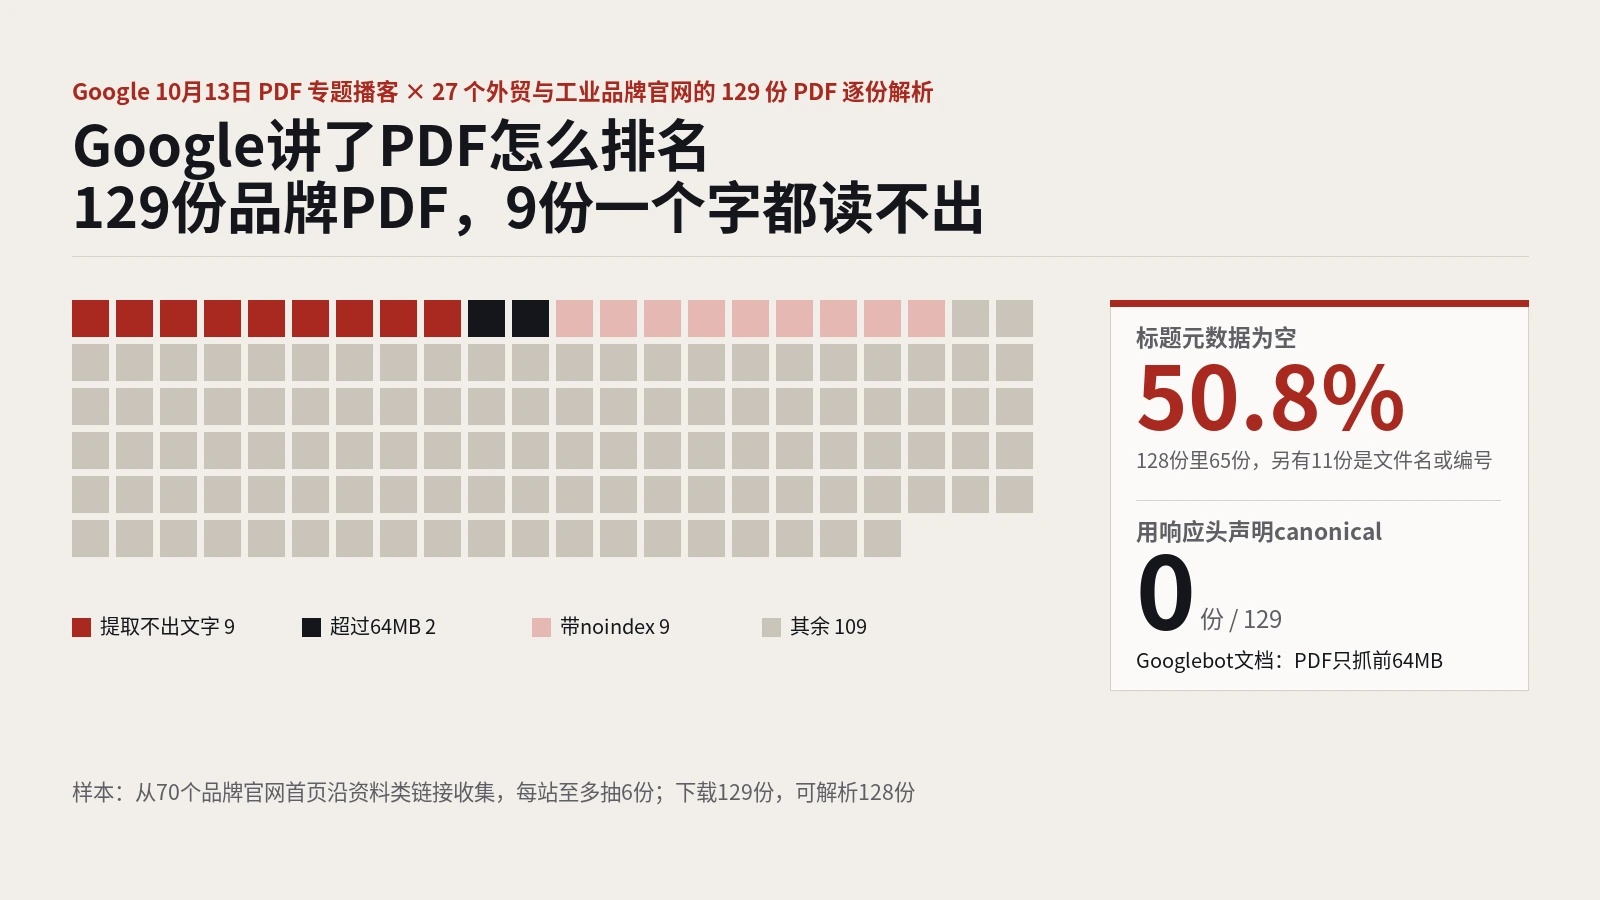
做法:把Google 10月13日PDF专题播客的说法逐条对照Googlebot文档;再从27个外贸和工业品牌官网下载129份PDF,逐份统计体积、可提取文字、标题元数据、链接、语言、标签和响应头。
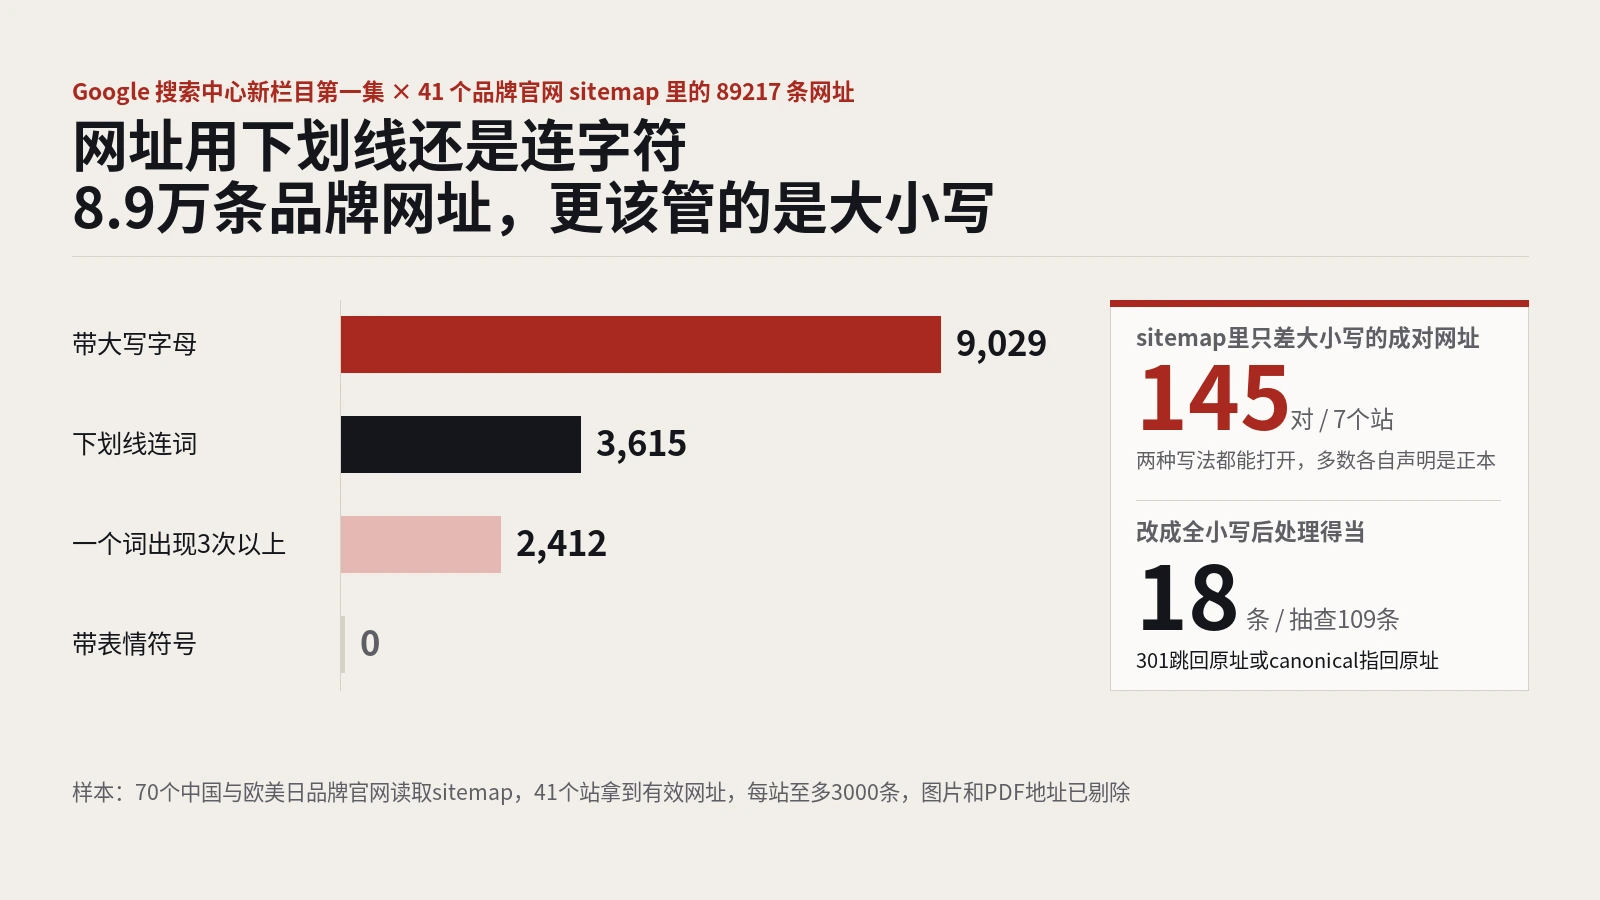
做法:把Google新视频栏目第一集关于网址的说法逐条对照网址结构文档;再读取41个品牌官网sitemap里的89217条网址,统计下划线、大小写、编码与重复词,并抽样请求大小写和分隔符变体。
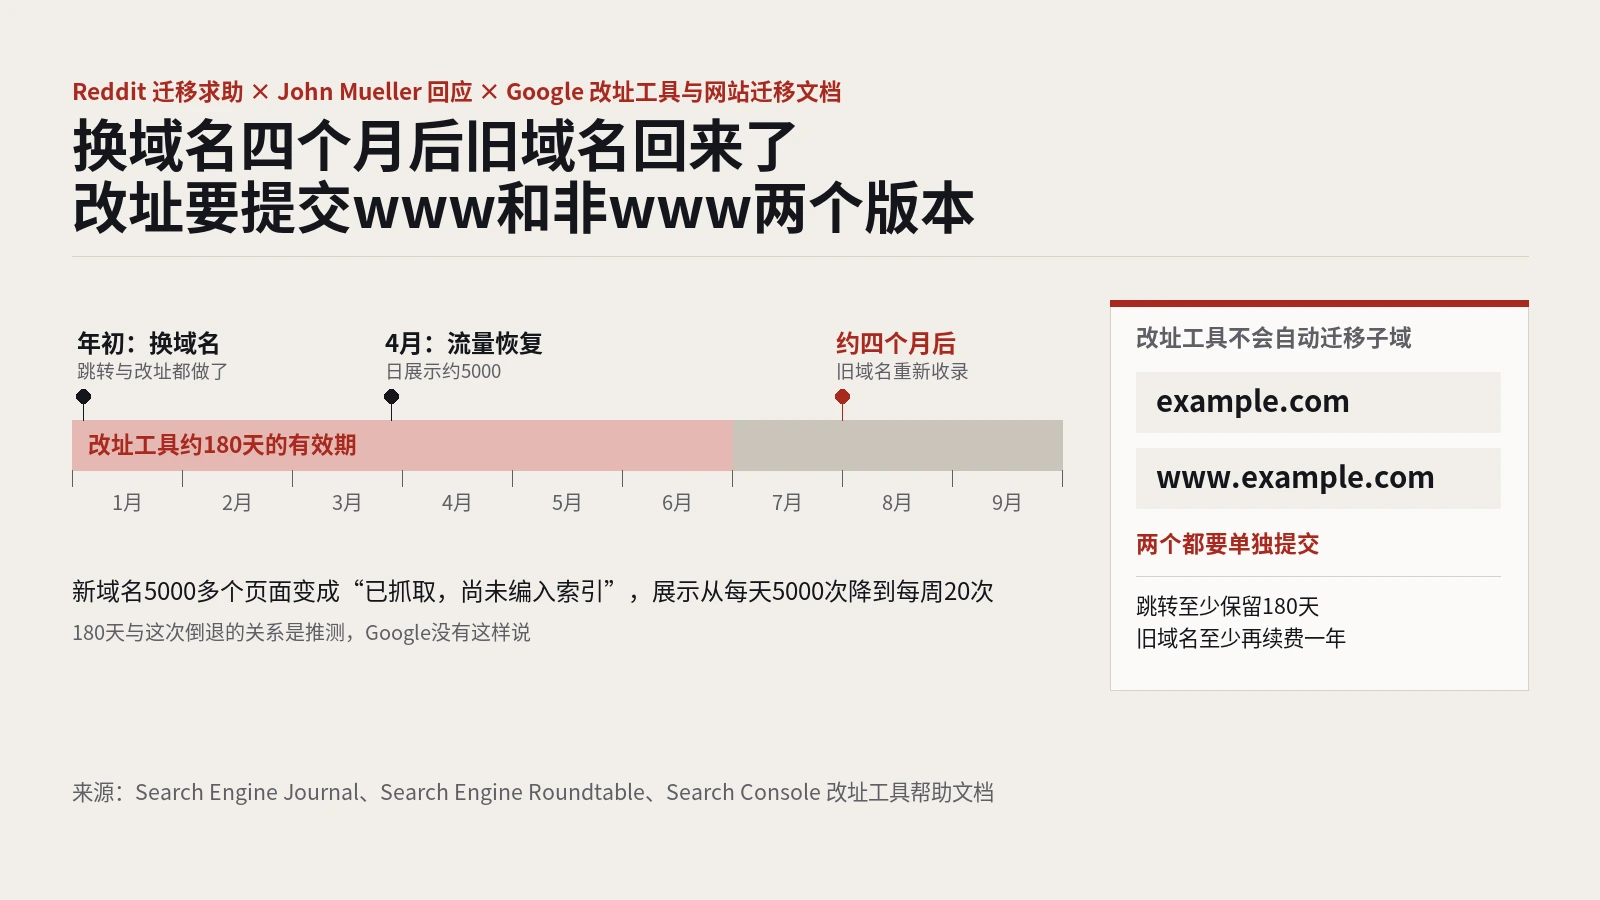
做法:以Search Engine Journal和Search Engine Roundtable报道的Reddit迁移案例为主体,对照Google改址工具帮助文档与网站迁移文档,整理Mueller的回应、子域变体与180天有效期等规定,以及几种可能原因的排查顺序。
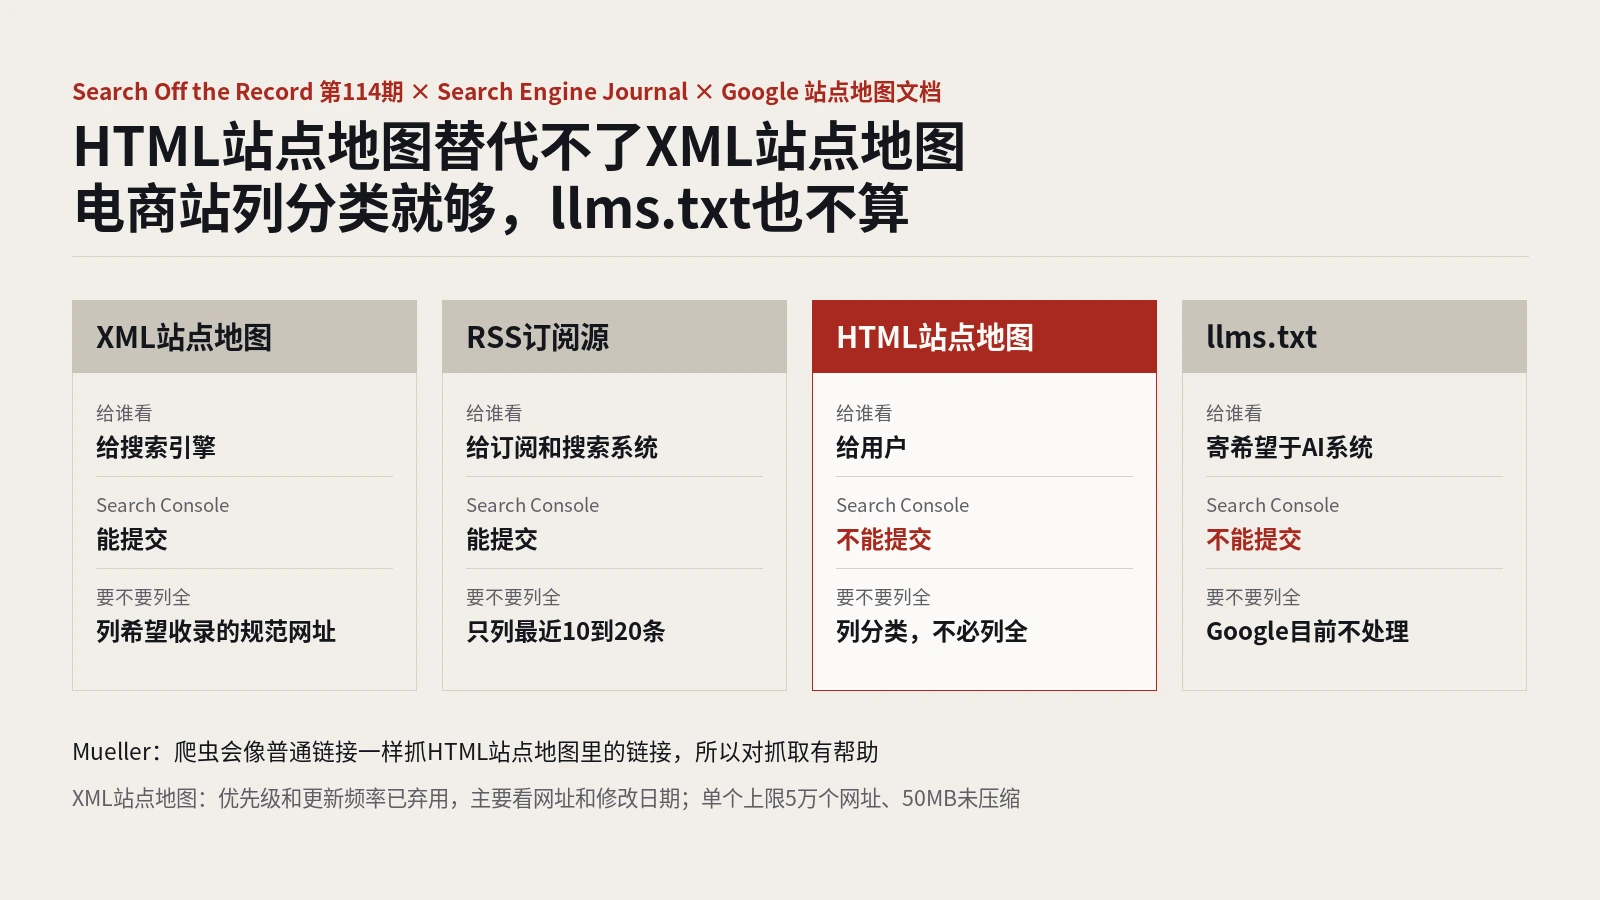
做法:以Search Off the Record第114期播客文字稿为主体,对照Search Engine Journal的两篇解读和Google站点地图、链接最佳实践文档,整理Mueller对HTML站点地图、XML字段、RSS、llms.txt与无法获取报错的说法。
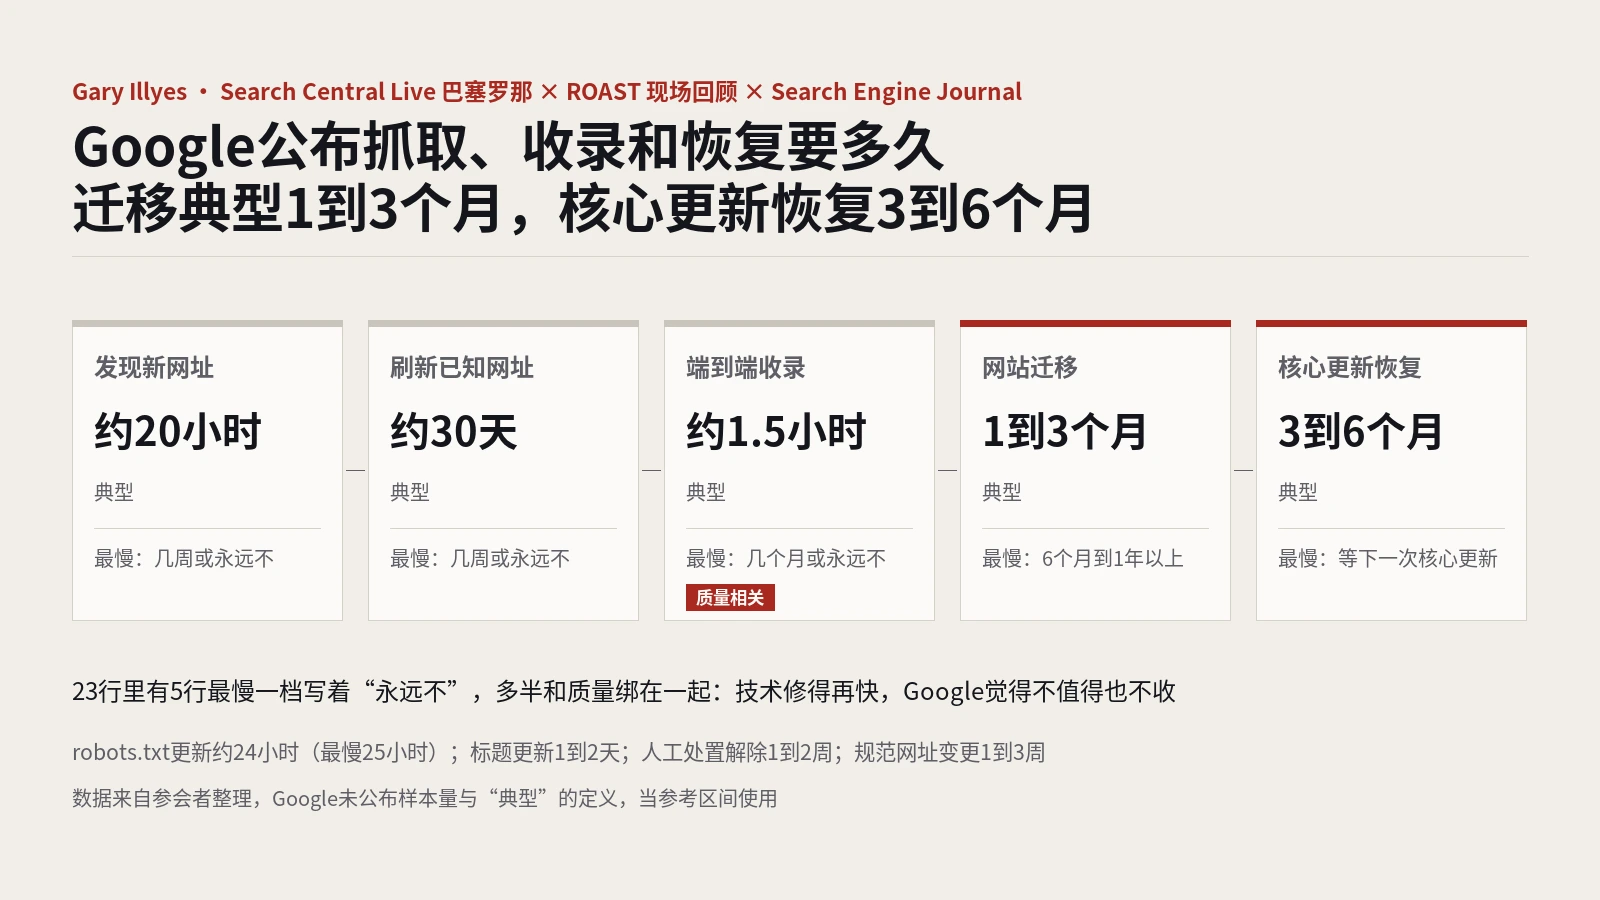
做法:以ROAST对Search Central Live巴塞罗那站的现场回顾为主体,整理Gary Illyes展示的抓取、收录、搜索结果三张耗时表,对照Search Engine Journal的核对与Google迁移、规范化、核心更新文档,并补充同场演讲要点。
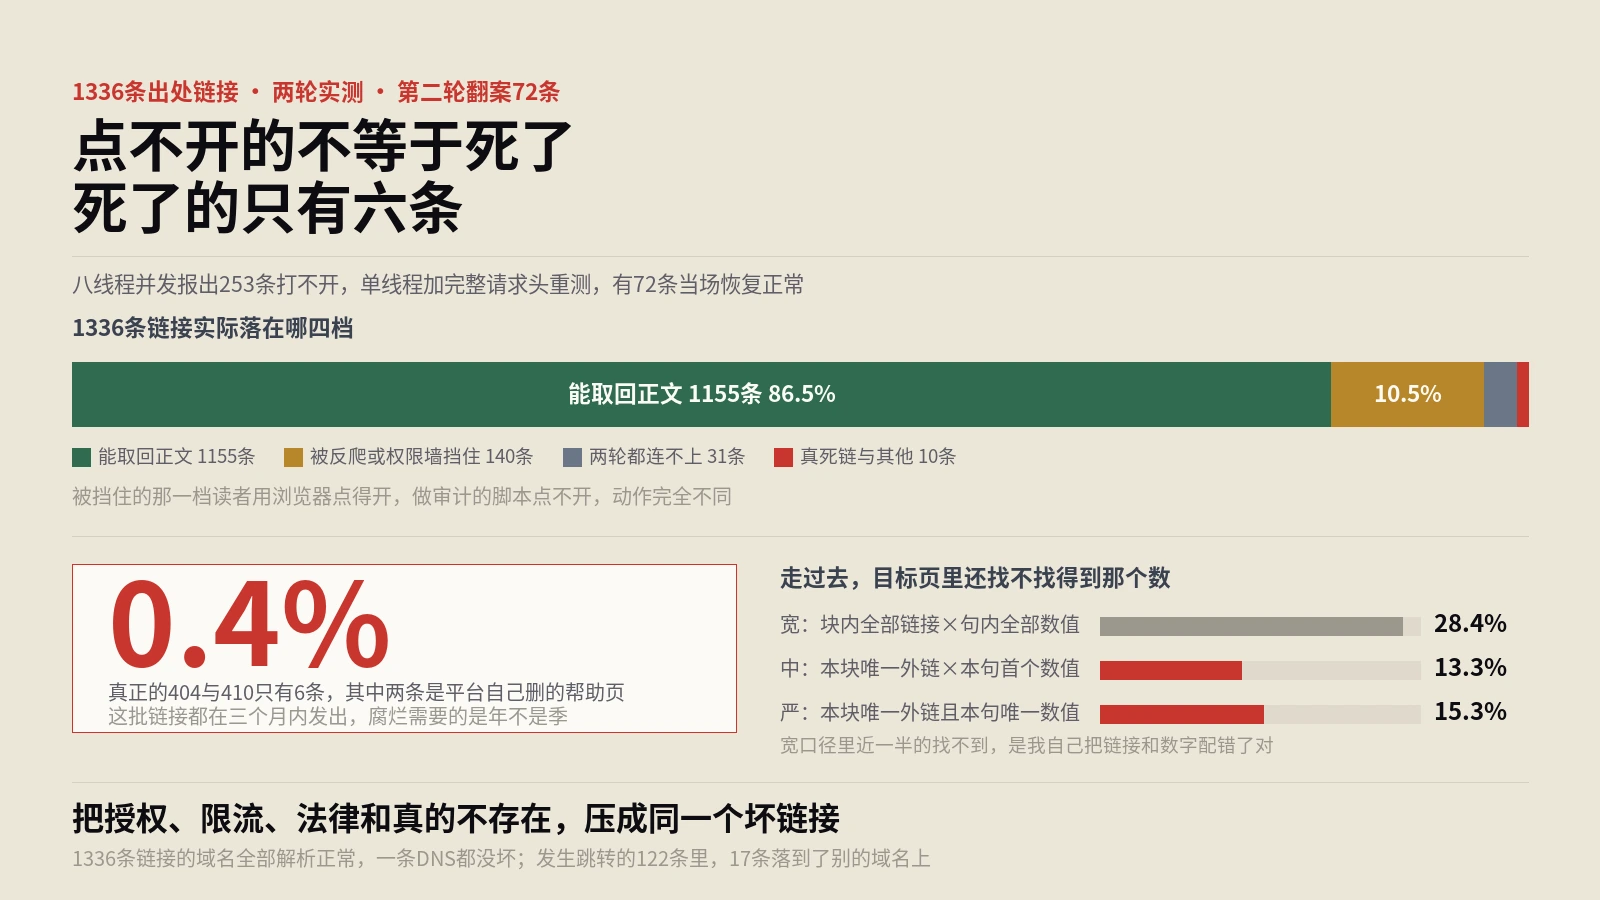
跑法分两轮:先用8线程并发把1336条去重出处链接过一遍,再对所有非200的目标换成单线程、完整浏览器请求头、45秒超时并重试一次,同时单独做一次域名解析,把真死链、被反爬拦住、本地连不上三种情况拆开;最后打开能取回的目标页,用原样、归一化、只比数字串三层匹配找一遍被引的那个数值。
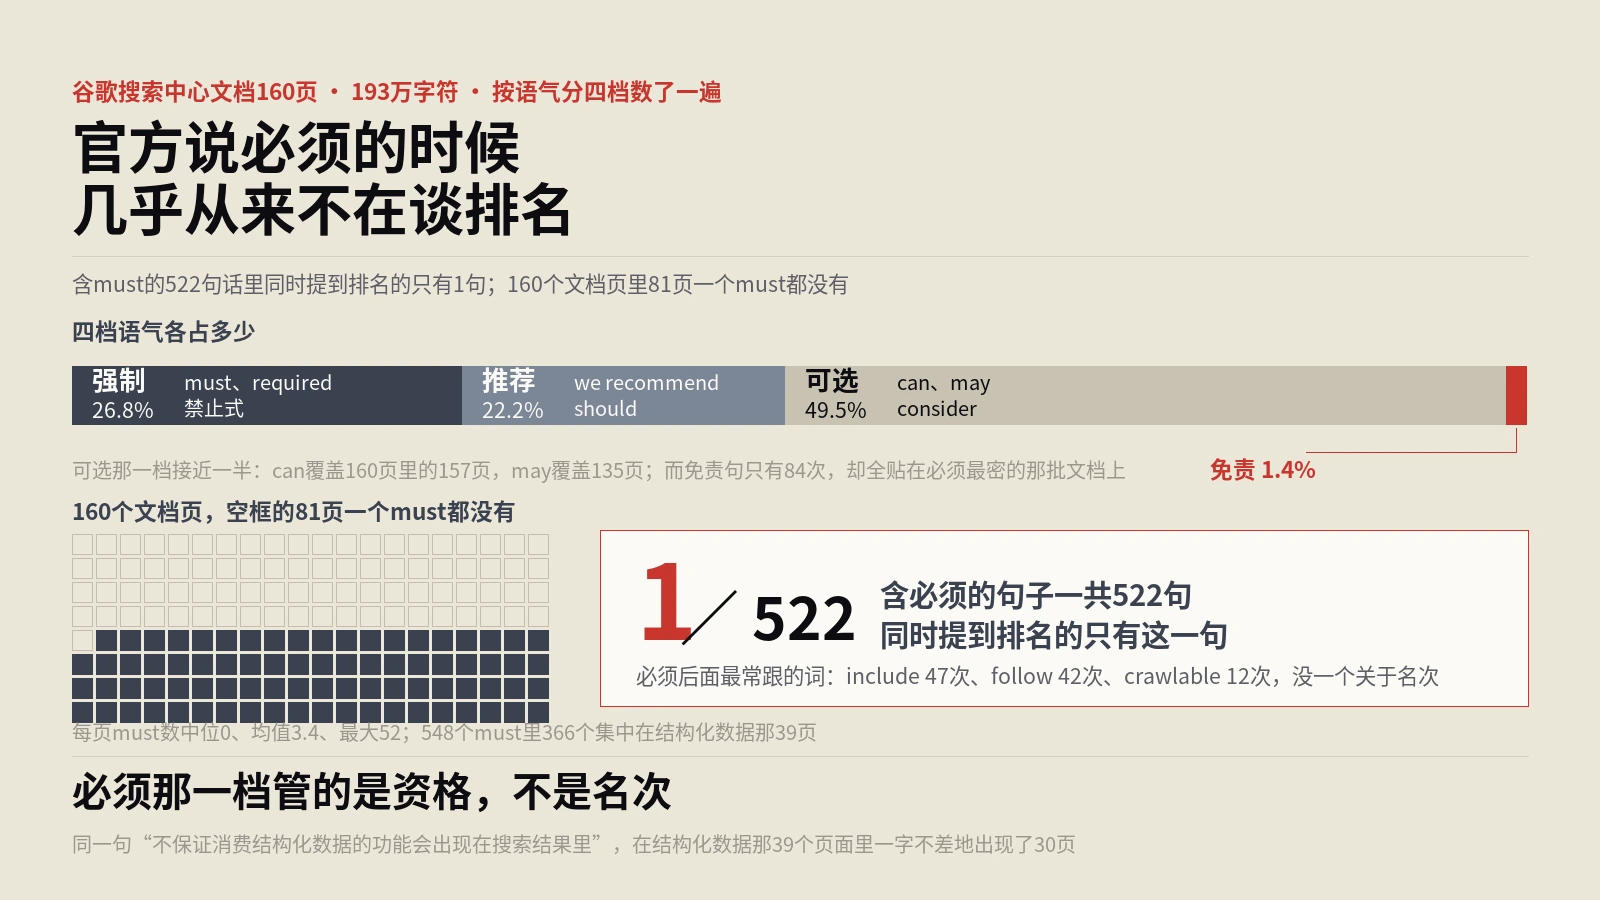
测法很笨但能复现:把文档站160个页面全量抓到本地剥成纯文本,给强制、推荐、可选、免责四档各写一组句式正则,统计次数与覆盖页数,再按页算must分布、把含must的整句切出来交叉检索排名词根。文末给了一套把问题清单标语气码的四步操作。
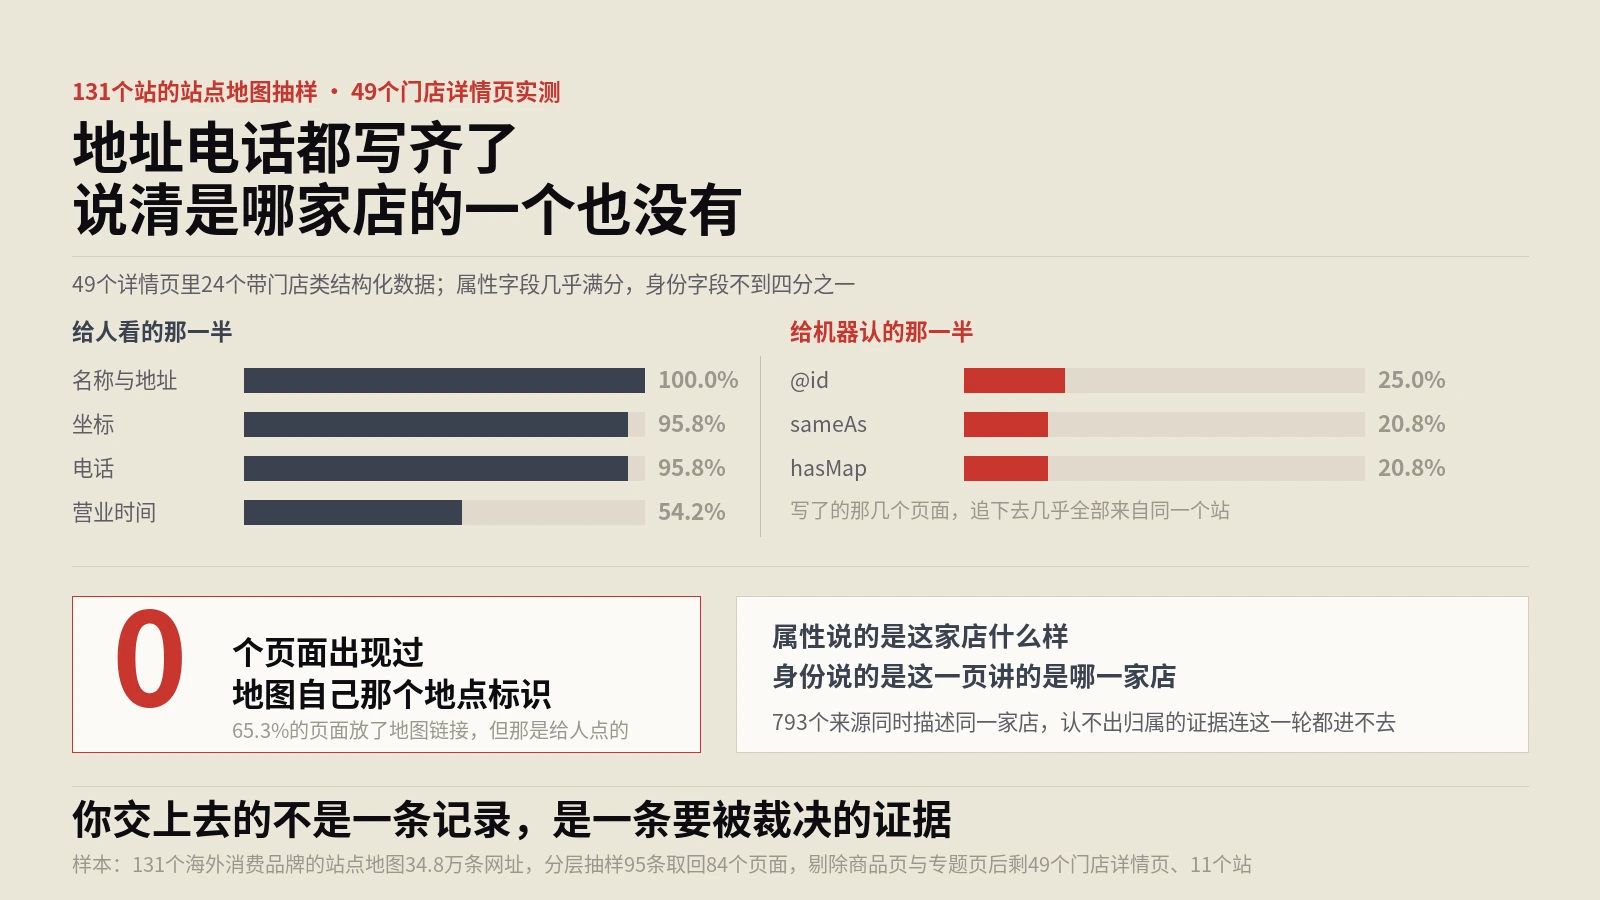
测法写清楚了好复现:从131个站的站点地图里筛门店类网址,分层抽样95条取回84个页面,人工剔掉商品页和专题页,再按门店详情与查找入口分档,最后逐页量结构化数据的属性字段与身份字段。顺带记了一次探测节奏把结论带偏15个百分点的过程。
把抓取引荐比的公式拆成六个必须自己拍板的口径:窗口长度、爬虫标识范围、样本来源、状态码取舍、垃圾来路清洗、网页判定方式。再用本站十五天、258560行nginx日志原样跑一遍,附上改日志格式、清来路、分标识计数、验真假这四步落地顺序。

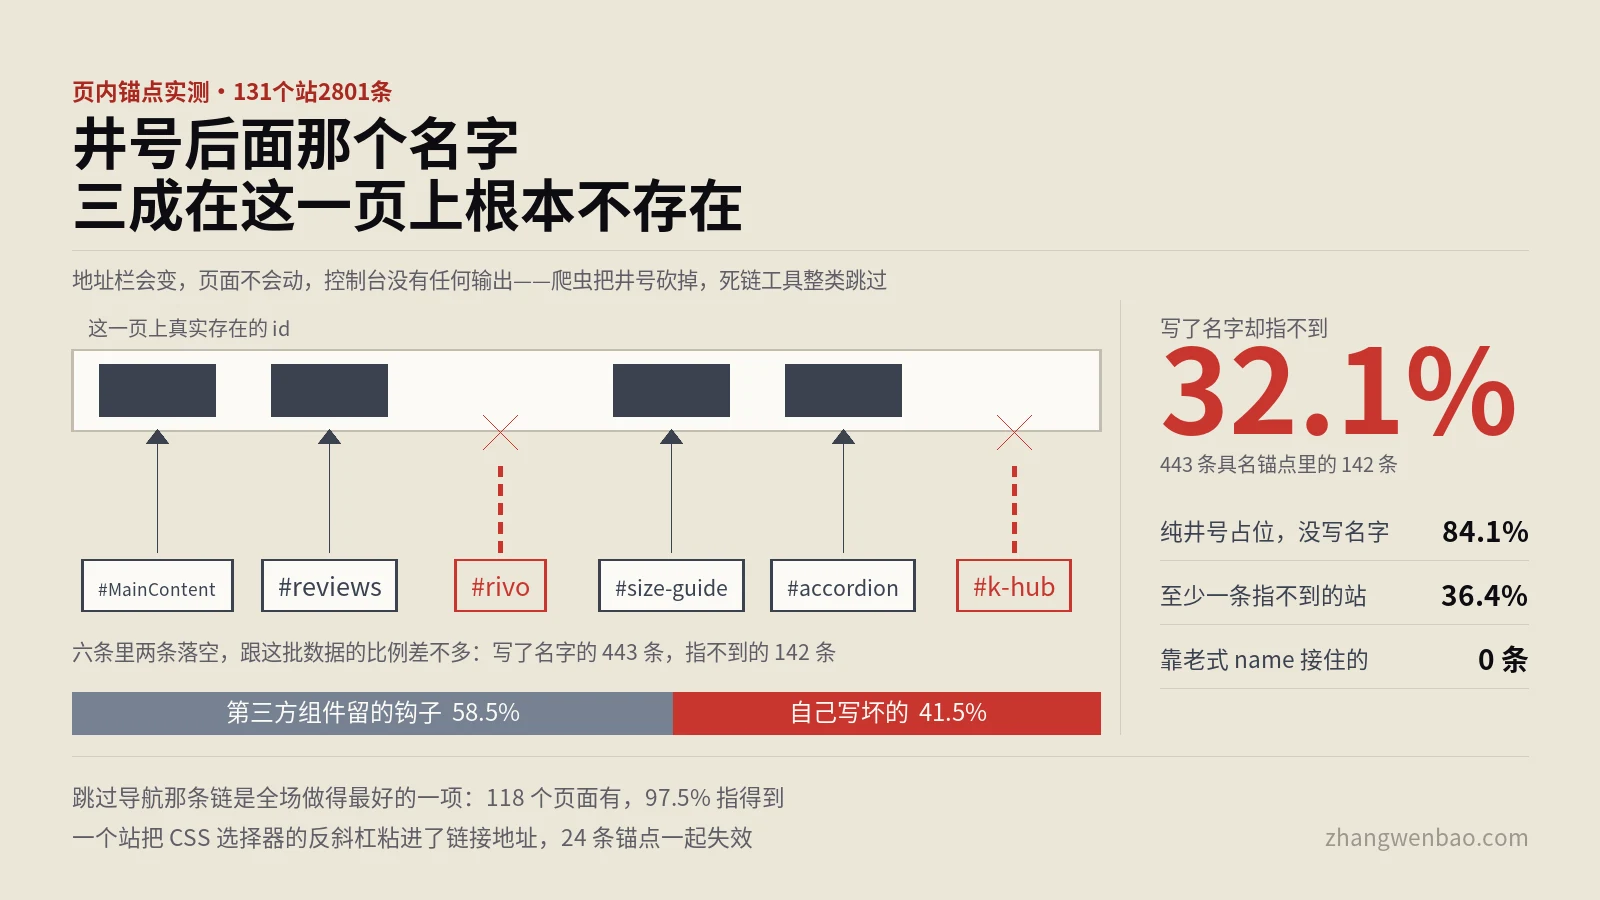
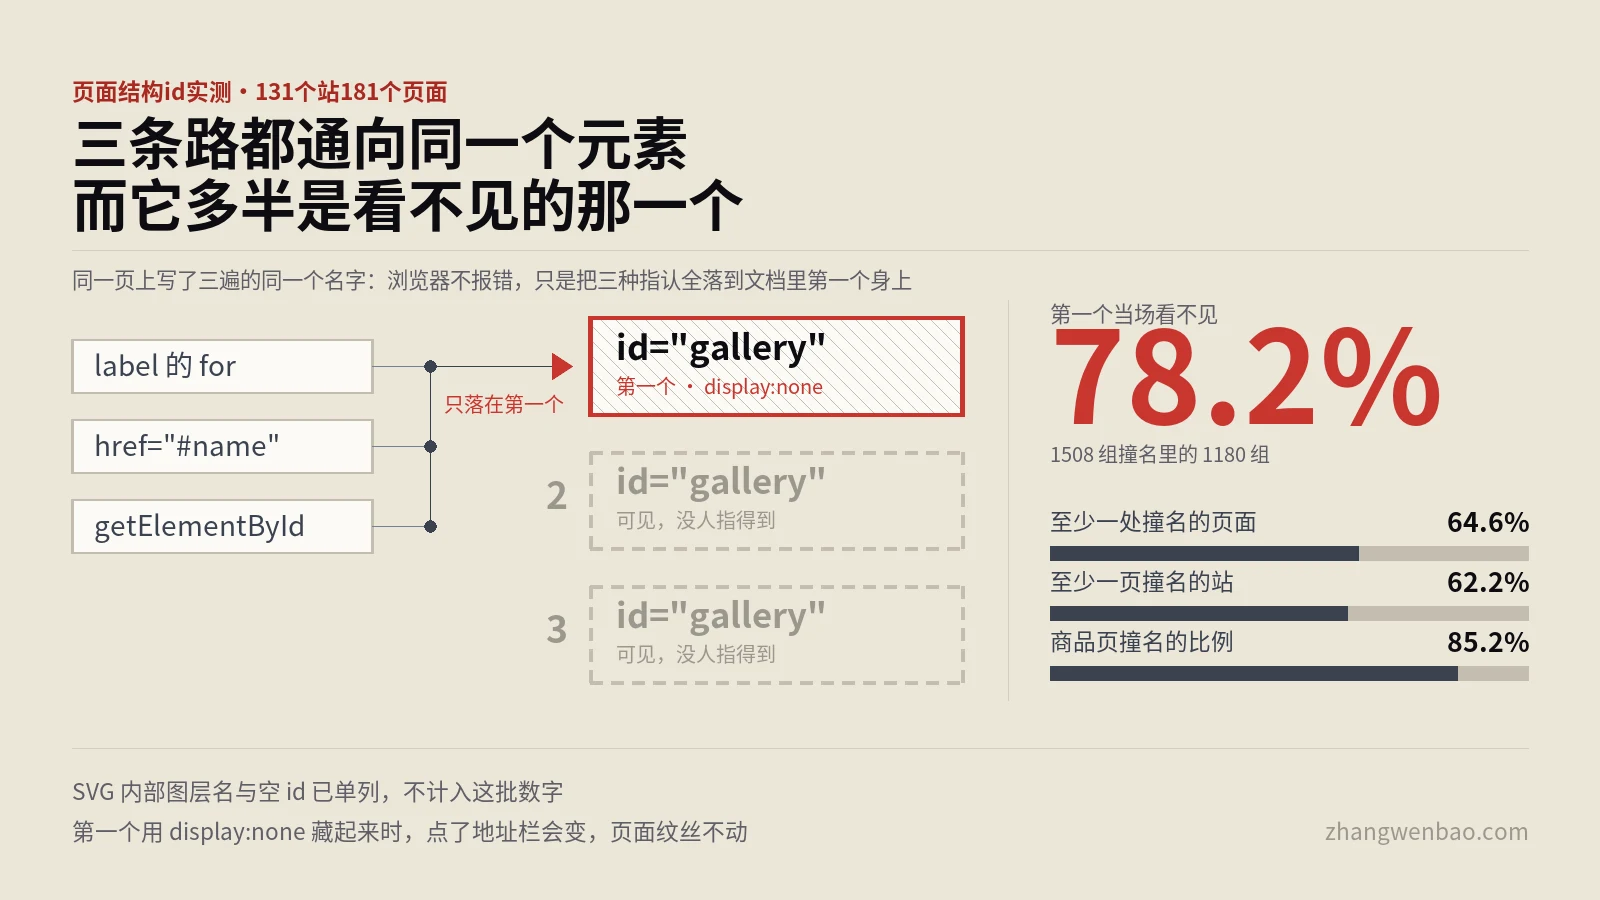
做法是把131个英文独立站首页与商品页上所有以井号开头的链接取下来,连同解析成绝对地址后只多一个井号的那一类,按HTML规范里滚动到片段的四步逐条判定目标在不在。同时把页面上所有按名字指认别人的属性一起量了一遍——label的for、输入框的form、以及aria那一族。这里踩过一个坑:第一遍把单值属性也按空格拆成了多个名字,算出label有一半指不到,改对分类之后真实数字是另一个量级,两个口径都写在文里。死锚点最后按第三方组件的钩子与…
做法是用真实浏览器逐页打开131个英文独立站的首页与商品页,把每个页面上所有带id的元素连同标签名、当场可不可见、往上四层的祖先链一并取下来,按名字分组找出撞名的那些。统计前先把内联SVG导出时自动生成的图层名和写成空字符串的id剔到另外两栏,否则排行榜会被Figma的默认图层名占满。再拿服务端吐出的原始HTML与渲染完的DOM逐页对照,判断这些撞名是模板带来的还是脚本后加的;另挑30个站的首页做两组对照,桌面视口连读三遍再换手机视口读…
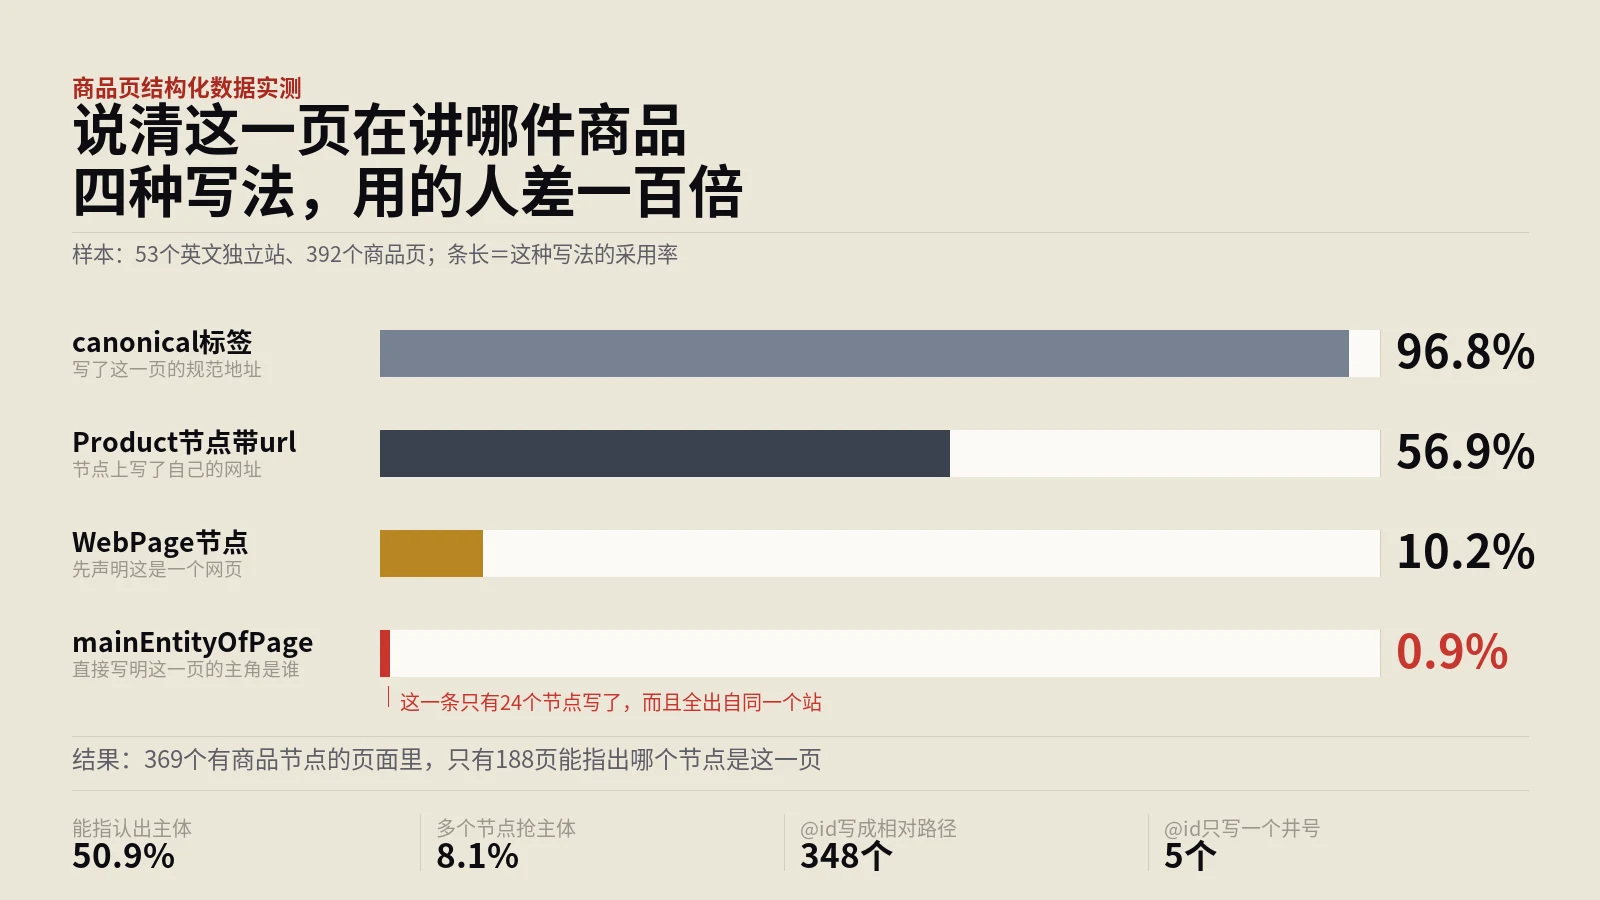
实验台把53个英文独立站392个商品页的JSON-LD节点全部取下,对每一个Product节点上的url与@id补全成绝对地址,再与页面自身地址逐字比对,据此判断这一页能不能指出它的主体。第一版比对忽略了查询参数,得到的通过率虚高三十多个百分点,翻查具体案例后改成完整地址严格比对。随后逐项统计@id、url、mainEntityOfPage的写入率与取值形态,把WebPage节点、结构化数据里的商品名与页面h1、以及同一页内的h1数量一…
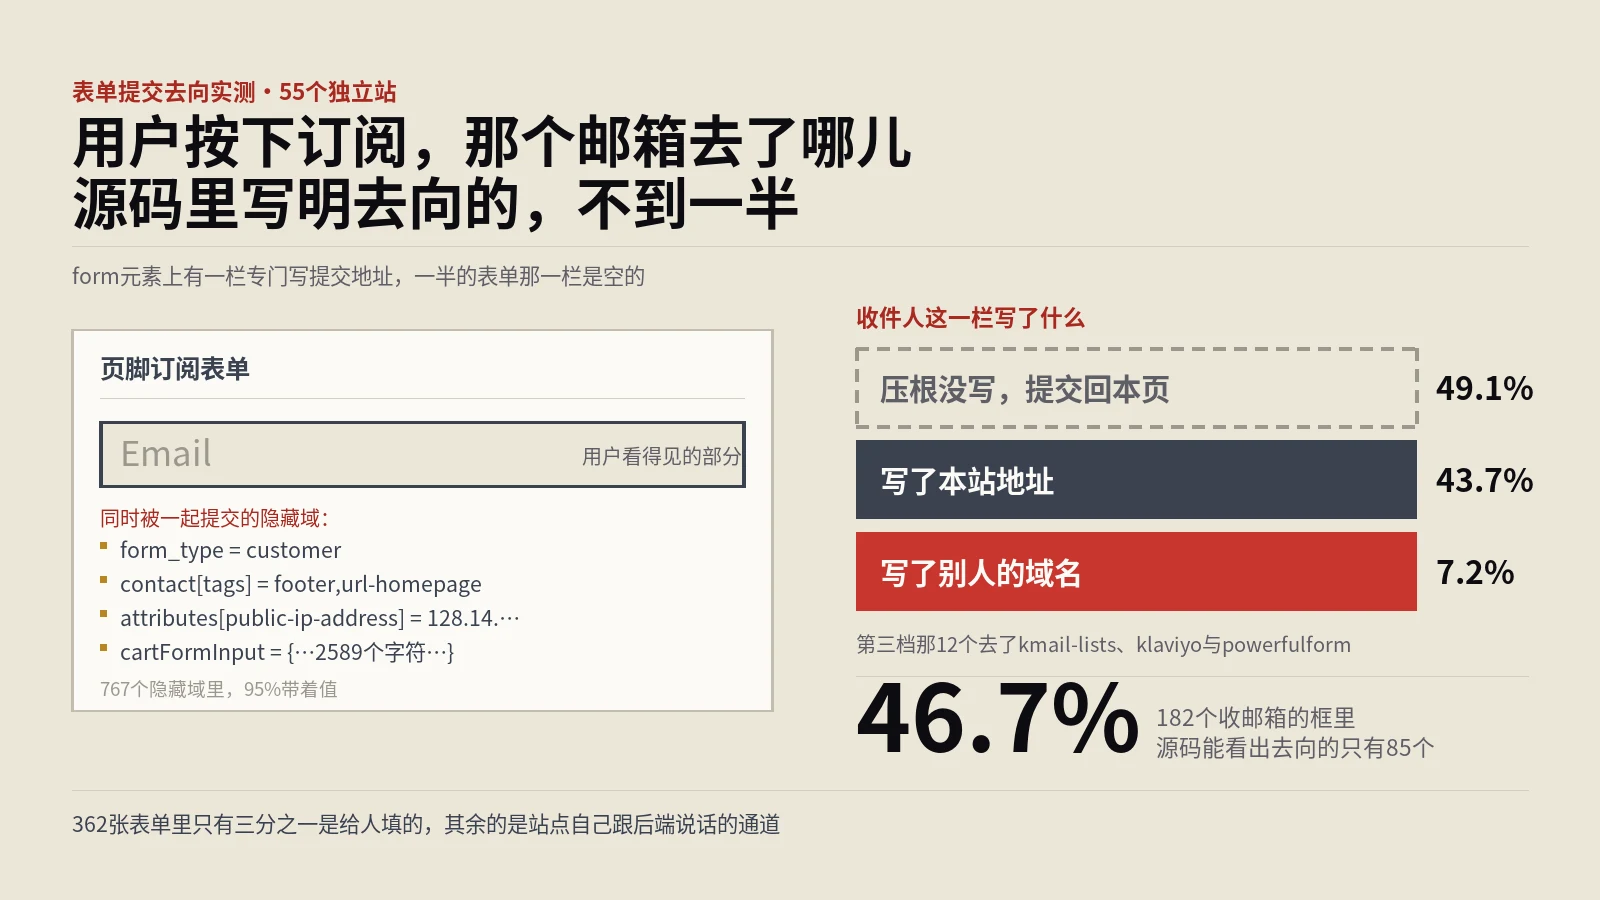
做法是把同一批页面上的form元素连同它的action、method、enctype、novalidate、提交按钮与全部隐藏域一并取下来,按站内签名合并重复渲染的表单,再把每个收邮箱的输入框与它所在的那张表逐一对上,看去向写在哪儿。跨域判据取注册域比较,不看子域;隐藏域按名字归成八类用途,并记下取值长度。另外对每个页面再取一次原始HTML,与渲染后的DOM逐页对照,用来区分“页面本来就这么写”和“脚本后来插进去的”。
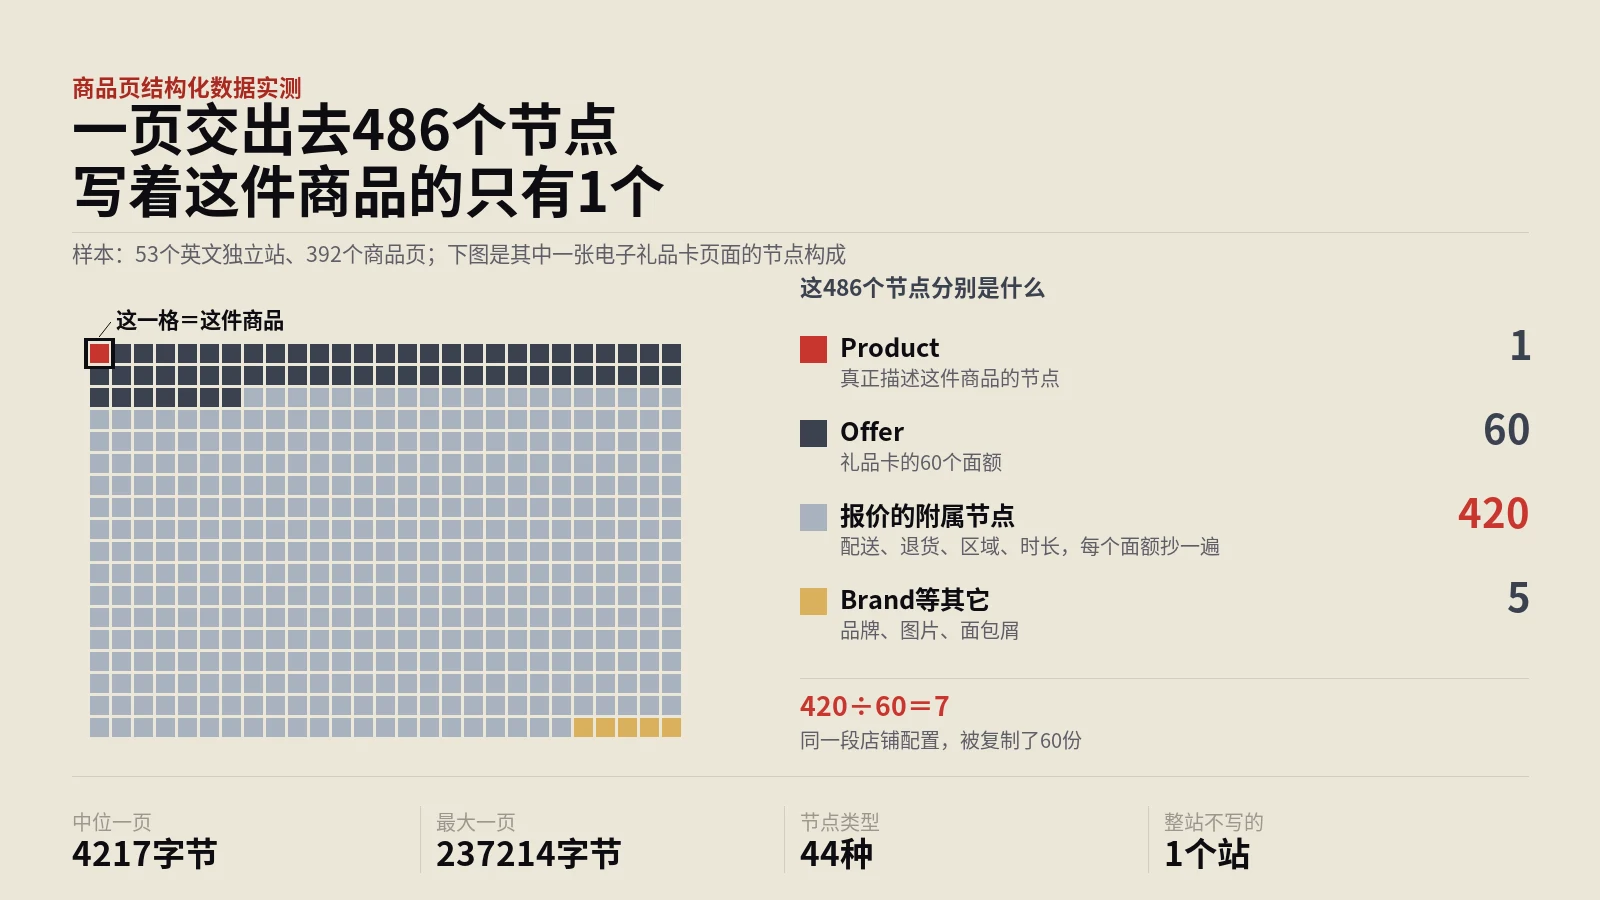
实验台用真实浏览器逐页打开53个英文独立站的392个商品页,等页面渲染完成后取出全部application/ld+json脚本,递归遍历每一个带@type的对象,按类型和它在JSON结构里的位置分别计数,同时记录字节量与脚本标签数。为了把模板复制与变体展开这两种不同的膨胀来源分开,每个站另外抽取了主推款与长尾款做同站对照;三个拿不到真实商品页的站——反爬拦截、跳转首页、地址全部失效——从统计中整体剔除。最后用加长等待时间的第二轮采集做自…
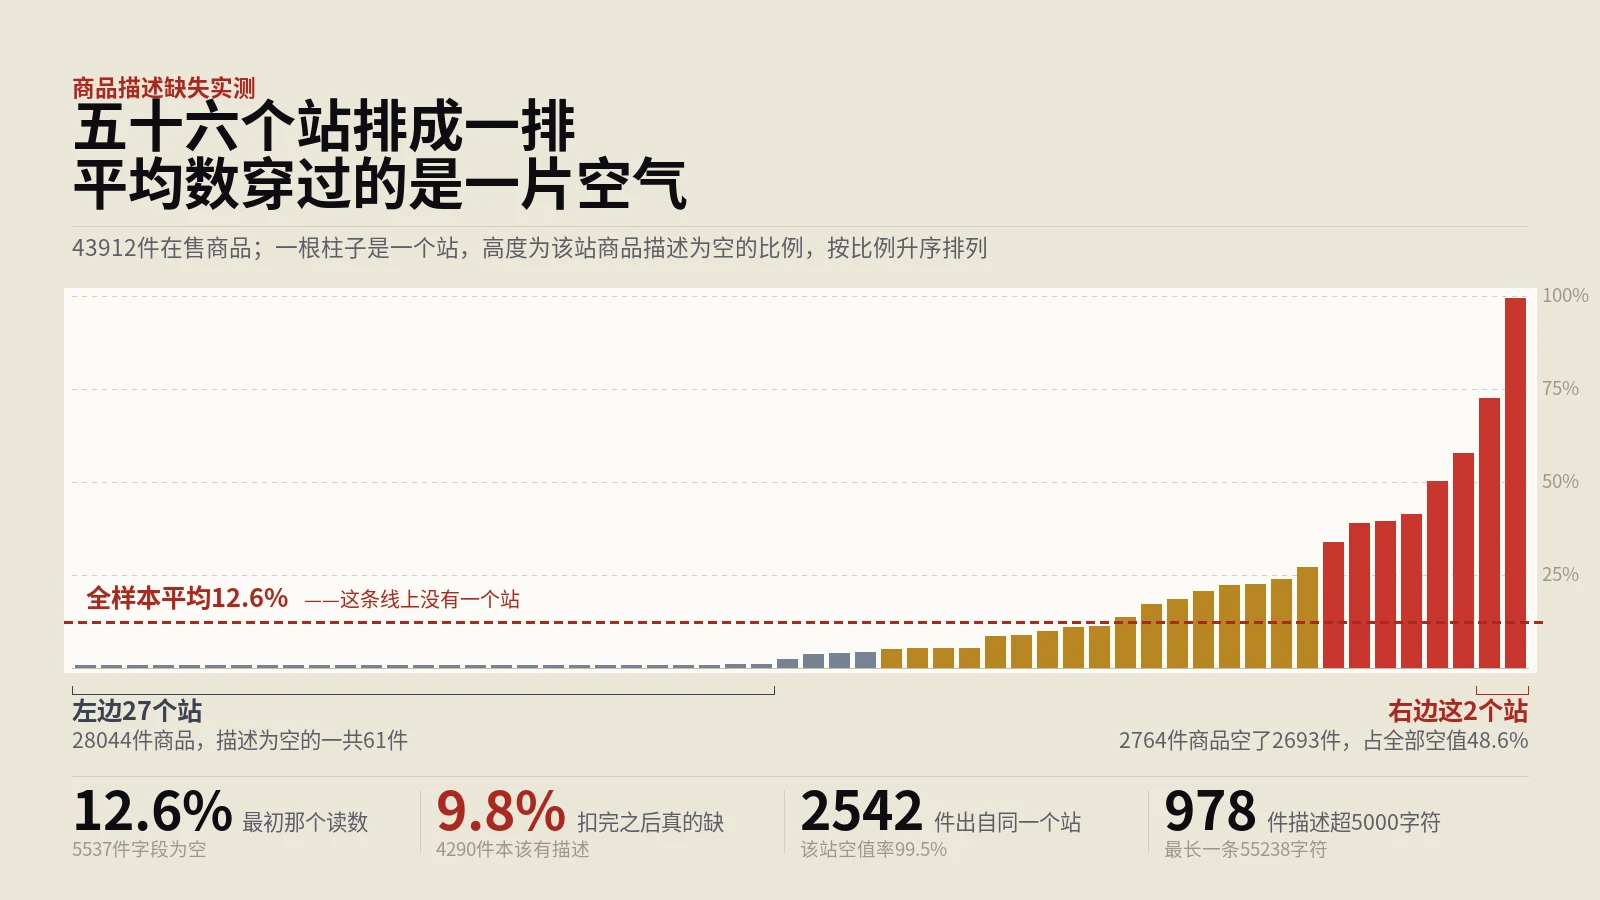
实验台从60个英文独立站的公开商品清单接口取回43912件在售商品的描述字段,先按站算空值率并观察整体分布形态,再用逐站剔除法看单个站对行业指标的影响幅度。随后给每一件空值商品跑一遍归因,按站级用法、非商品条目、占位测试、整条半成品四档依次往下扣。最后用真实浏览器打开商品页,把JSON-LD里的description与页面meta描述取出来跟接口值三方对照——正是这一步推翻了第一档的扣减依据,把2542件从待定改判回真缺,缺口最终从最初…
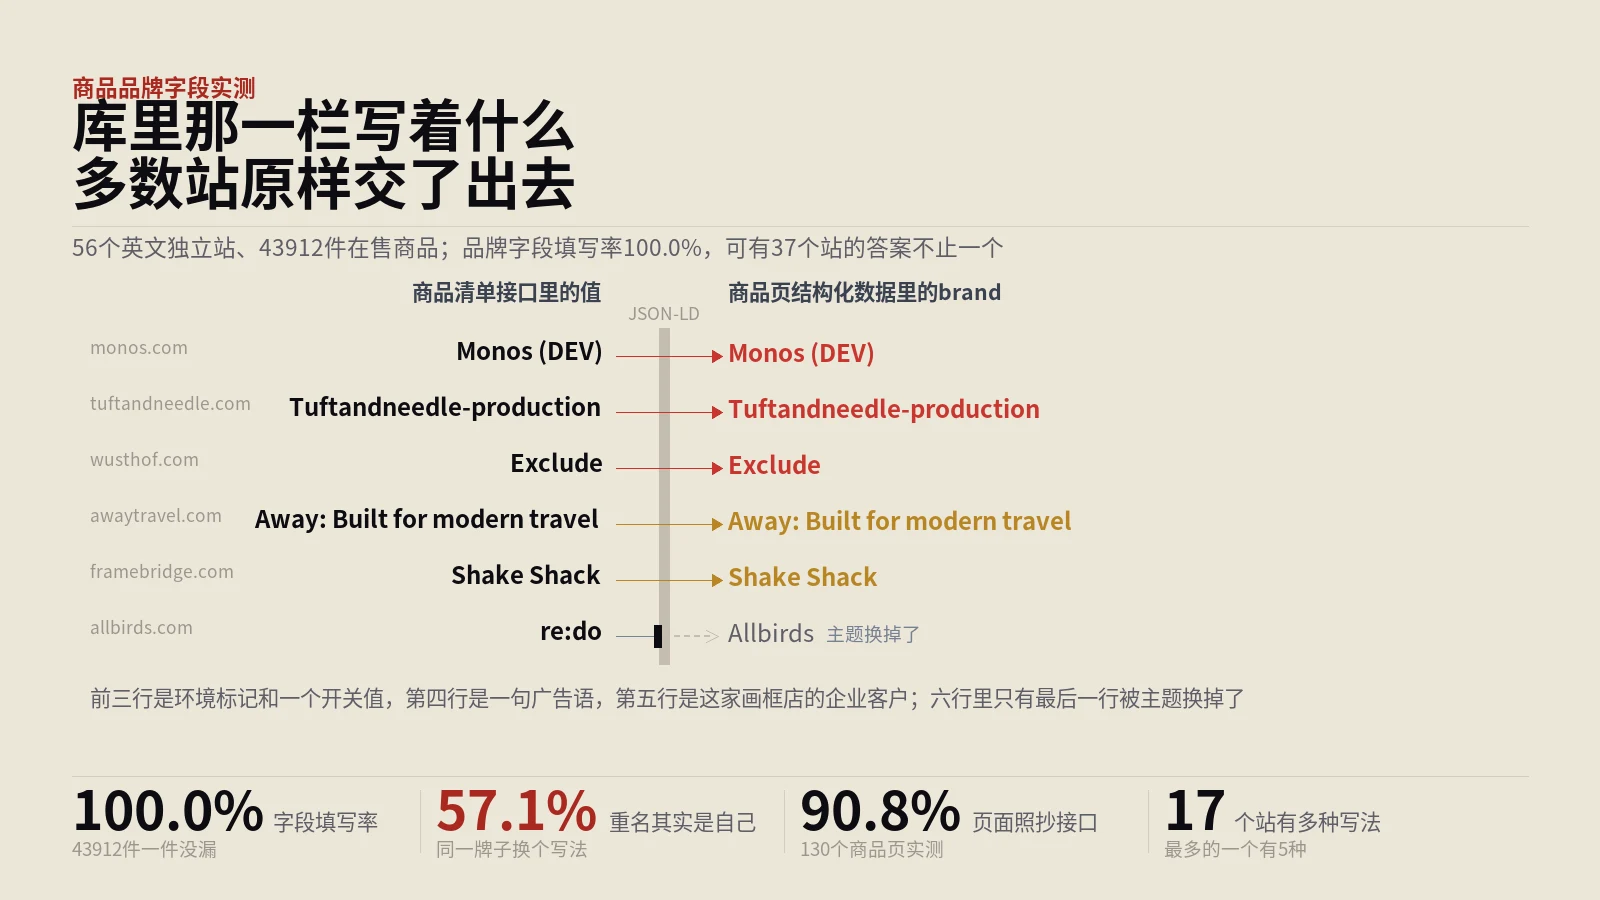
实验台从60个英文独立站的公开商品清单接口取回43912件在售商品的品牌字段,先按站算出主品牌,再把每一个非主品牌的取值做三级归一化——去掉重音符号、把与号换成and、砍掉地区码与公司后缀,据此把它们分成同一品牌的别写、字面空值、真正的另一个牌子三类,并逐条做字符级差异归因。随后用真实浏览器逐站打开商品页,等页面渲染完成后取出JSON-LD里Product节点的brand属性,与接口值一件件对照,判断这些取值有多少原样进入了搜索引擎读取…
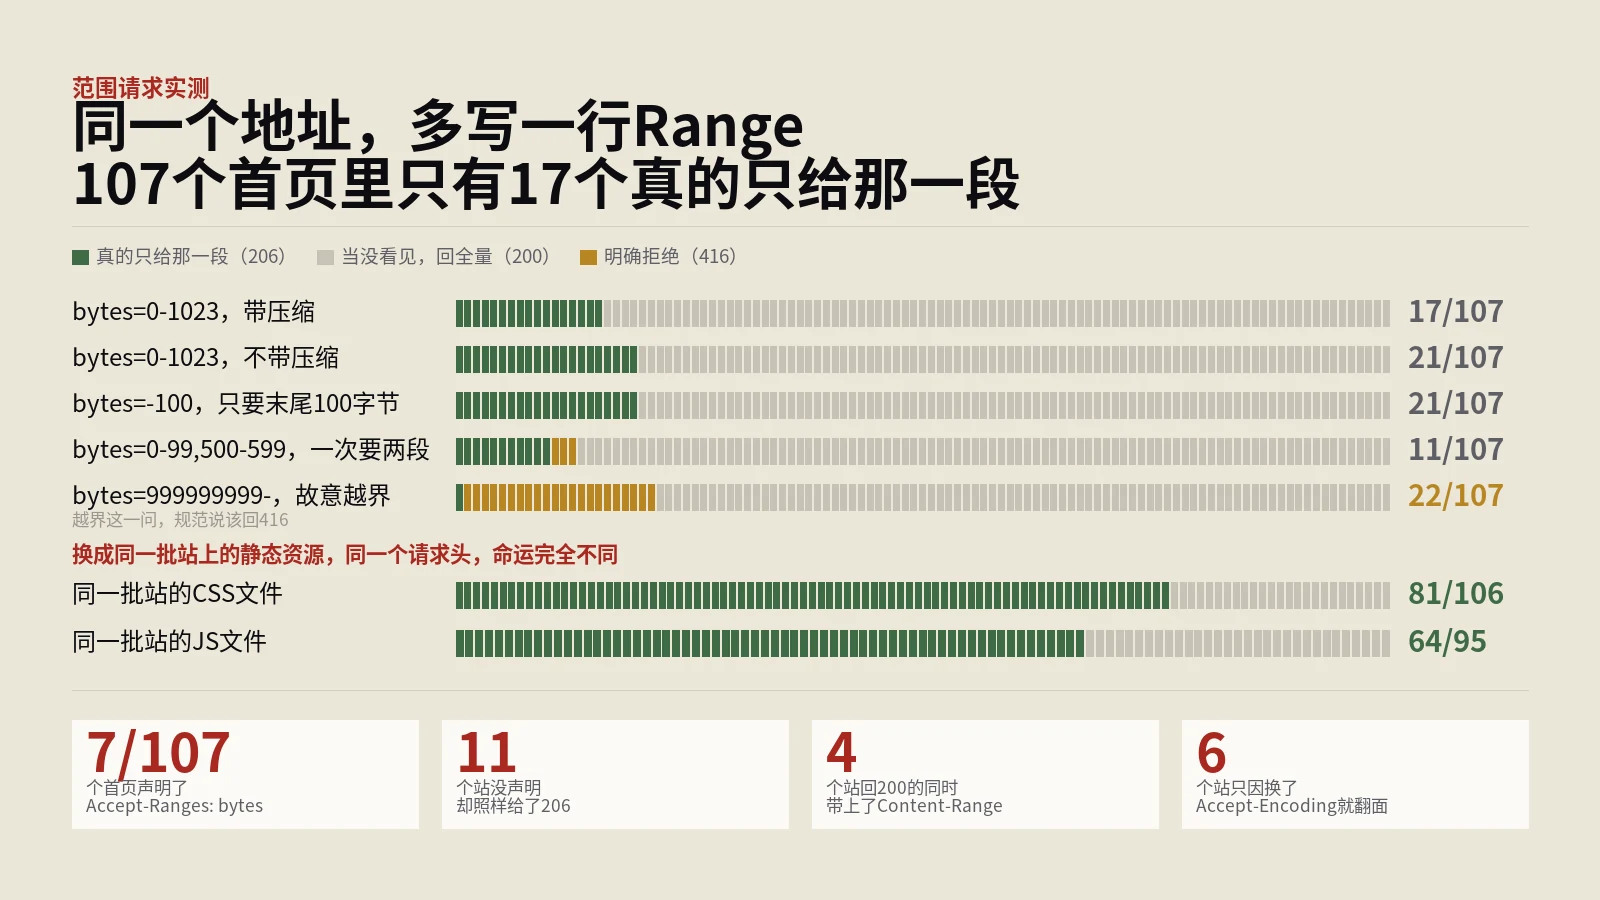
量法是同一个地址问五遍:普通GET、带压缩的Range、不带压缩的Range、只要末尾一百字节、一次要两段、以及一个不可能满足的越界范围,每一遍都记原始字节数而不只是状态码;再对同一批站的CSS与JS各问一遍做对照;最后在自己的nginx上把动态压缩、预压缩、不压缩三档摆开,逐个开关复现。
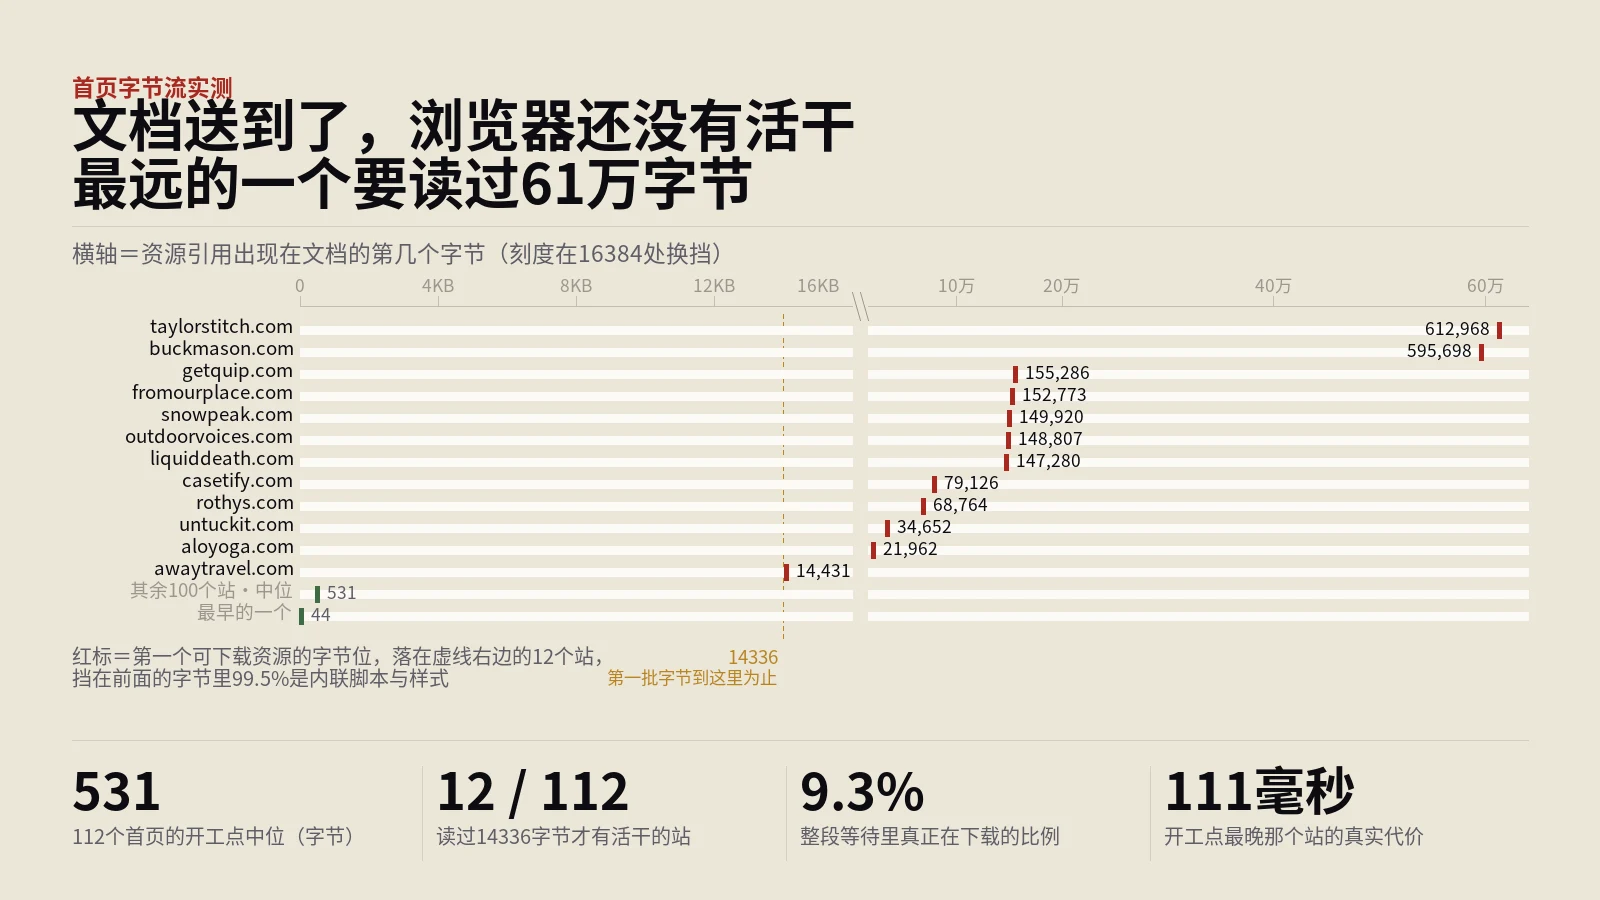
量法分两层:131个站的首页各抓两轮,流式记下首字节与末字节的时刻;再把112份文档按字节位置摊开,找第一个能被预扫描发现的资源引用落在第几位。两层各自成立,但坐标系不同,一层是压缩后的字节,一层是解压后的字符,中间不能互相换算。