谷歌SEO官方文档实测160页:522句必须里,只有1句提到排名
本文目录
- 官方文档的语气分几档,各占多少?
- 四档里面,每个句式各出现多少次
- 一半的文档页一个必须都没有,这正常吗?
- must最多的那几页长什么样
- 548个必须里,三分之二在同一类文档里,为什么?
- 522句必须里只有1句提到排名,这说明什么?
- 把三种写法并排看一遍
- 那句不保证会出现,为什么在30页里一字不差地重复?
- 官方唯一给了分档的地方,管的是什么?
- 为什么可以这一档反而最多?
- 官方为什么几乎不用should,而改说我们建议?
- 把语气压平会让工作变形成什么样?
- 两万三千条问题,最后只有四百条设了截止日期
- 把这套做法拆成能照着跑的四步
- 官方真正的高频词不是排名,是资格
- 这套测量最容易被误用的两个地方
- 读官方文档该怎么读,才不至于把建议读成命令?
- 常见问题解答
- 数句式这种办法,会不会把语气测错?
- 为什么must集中在结构化数据文档里?
- 官方说了必须,又说不保证,到底信哪句?
- 抓取工具报的错误和警告,能不能直接当待办?
- 那些在官方文档里找不到原句的做法,是不是就别做了?
- 这套语气分档能不能用在别的平台文档上?
- 权威参考资料
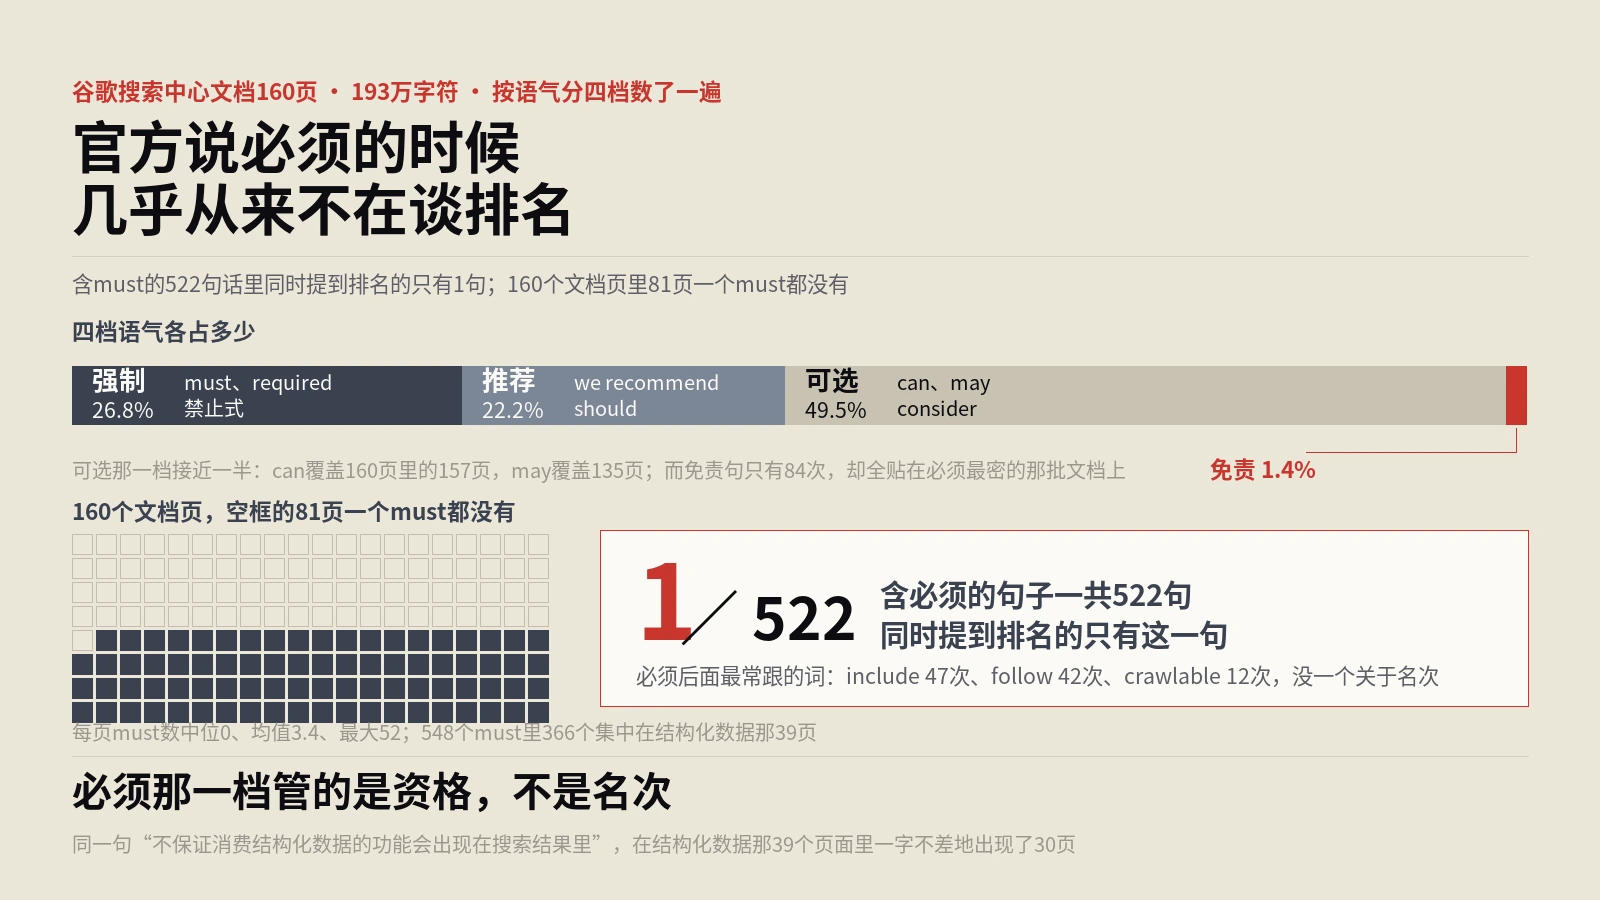
摘要:把谷歌搜索中心的160个文档页全量抓下来,193万字符纯文本,按语气分四档数了一遍:强制类句式1595次占26.8%,推荐类1323次占22.2%,可选类2948次占49.5%,免责类84次占1.4%。一半的文档页(81个,占50.6%)一个must都没有,每页must数的中位数是0。548个must里366个集中在结构化数据那39页,占66.6%,而那类文档只占页数的24.4%。最扎的一个数:含must的522句话里,同时提到排名的只有1句。
有人在社交平台上问谷歌的工程师:一篇老文该扩写以吃下那个子意图,还是单开一篇再互链?回答是这样一句——有时候根本没有绝对正确的答案,但你可以选一个,然后把它做成正确的那个。
这句话在圈子里已经被念了很多年,同类的还有“没有完美的SEO”“没有排名的完美公式”。听多了会当成客套。这次我想把它当成一个可以检验的断言:如果官方自己认为大量问题没有唯一解,那官方文档的语气应该看得出来。于是我去数了一遍。
官方文档的语气分几档,各占多少?
做法先摆出来。谷歌搜索中心文档站的160个页面全量抓到本地,剥掉脚本、样式和导航之后留下193万字符的纯文本。然后按语气把句式分成四档,每档给一组正则,统计出现次数和覆盖页数。
| 档位 | 代表句式 | 出现次数 | 占四档合计 | 出现过的页数 |
|---|---|---|---|---|
| 强制 | must、required、don't、never、avoid | 1595 | 26.8% | 141 |
| 推荐 | we recommend、should、best practice、make sure | 1323 | 22.2% | 137 |
| 可选 | can、may、consider、optional | 2948 | 49.5% | 159 |
| 免责 | 不保证、不是排名因素、看情况 | 84 | 1.4% | 61 |
先说这个测量的边界,免得数字被用过头。我数的是句式,不是语义:一个must也可能出现在“你的服务器必须返回200”这种纯技术约束里,一个can也可能实际上是强烈建议。所以这四个比例是语气的粗略分布,不是义务强度的精确刻度。但比例之间的落差足够大,粗一点也能看出方向。
方向很清楚:可选那一档接近一半。can这个词覆盖了159个页面里的157个,几乎无页不在;may覆盖135页。也就是说你读官方文档的时候,绝大多数时候在读“你可以这样”,而不是“你必须这样”。
四档里面,每个句式各出现多少次
汇总数字容易掩盖细节,所以把明细也摆出来,每一行都能单独复核。
| 档位 | 句式 | 次数 | 覆盖页数 | 覆盖率 |
|---|---|---|---|---|
| 强制 | must | 548 | 79 | 49.4% |
| 强制 | required/requirement | 421 | 81 | 50.6% |
| 强制 | don't/do not/never | 490 | 112 | 70.0% |
| 强制 | avoid | 130 | 51 | 31.9% |
| 推荐 | we recommend/recommended | 540 | 96 | 60.0% |
| 推荐 | make sure/ensure | 476 | 122 | 76.2% |
| 推荐 | best practice | 210 | 64 | 40.0% |
| 推荐 | should | 97 | 51 | 31.9% |
| 可选 | can | 1859 | 157 | 98.1% |
| 可选 | may | 745 | 135 | 84.4% |
| 可选 | if you want/you might | 160 | 81 | 50.6% |
| 可选 | consider | 154 | 75 | 46.9% |
| 可选 | optional | 30 | 14 | 8.8% |
| 免责 | 不保证 | 61 | 51 | 31.9% |
| 免责 | 看情况/因情况而异 | 22 | 12 | 7.5% |
强制档里最高的不是must,是否定式的don't和do not,覆盖了112个页面,占70.0%。这个分布也说得通:禁止比要求更容易说准,因为不做什么的后果是确定的,做什么的收益不是。avoid这类软性劝阻只有130次,说明官方在这一侧也偏向把话说硬。
一半的文档页一个必须都没有,这正常吗?
我单独把must拎出来按页统计,结果比总量更说明问题。
160页里,81页一个must都没有,占50.6%。每页must数的中位数是0,均值3.4,最大的一页有52个。中位数和均值差这么远,说明must高度集中在少数页面里,不是均匀散布在文档各处。
换个说法:你随手打开一页官方文档,一半的概率里面没有任何一句“必须”。而行业里流通的清单几乎每一行都是必须。这个反差不是谁在说谎,是中间有一道压平的工序。
must最多的那几页长什么样
| 页面 | must数 | 它在讲什么 |
|---|---|---|
| 图书结构化数据 | 52 | 字段格式、标识符规范、参与条件 |
| 恶意软件与安全问题 | 38 | 被黑之后必须做的清理步骤 |
| 招聘信息结构化数据 | 27 | 必填字段与内容政策 |
| 商品信息结构化数据 | 27 | 必填字段与价格规范 |
| 配送政策结构化数据 | 23 | 字段取值约束 |
| 视频站点地图 | 21 | 标签格式与取值范围 |
看出规律了:排在最前面的几乎全是结构化数据类的文档,以及被黑之后的应急处理。这两类有个共同点——它们讲的都是格式和资格,不是效果。格式对不上,功能就出不来,这种因果关系是确定的,所以官方敢用must。
548个必须里,三分之二在同一类文档里,为什么?
把数字算细一点:全站548个must,其中366个出自结构化数据那39个页面,占66.6%。而这39页只占160页的24.4%。
三分之一的页数扛了三分之二的“必须”。这不是巧合,它反映了官方文档的一个内在结构:官方只在能给出确定判据的地方用确定的语气。字段该填什么类型、日期该用什么格式、图片该多大,这些有唯一答案,写死没有风险。至于内容该写多深、链接该怎么建、站点该怎么组织,官方给的全是可选和推荐。
顺着这条线看must后面最常接的词,画面会更具体:include出现47次、follow 42次、have 37次、use 15次、meet 12次、crawlable 12次。全是“包含某字段”“遵循某规范”“满足某条件”,没有一个是关于名次的动词。
522句必须里只有1句提到排名,这说明什么?
这是本篇最想留给读者的一个数。
我把含must的句子整句切出来,一共522句。再检索这些句子里有没有同时出现rank这个词根,结果是1句,占0.2%。
也就是说,官方说“必须”的时候,几乎从来不在谈排名。它谈的是能不能拿到某个展示位、能不能被正确抓取、被黑之后该做什么。排名那一侧,官方的语气始终停在推荐和可选。
这个发现能解释很多长期争论。站内那一串关于“某样东西是不是排名因素”的文章——元描述那一项、AMP那一项、提交站点地图能不能提升排名——争的其实都不是事实,是语气。官方从没在这些事上用过强制语气,是传播链条把它们升级成了必须。
把三种写法并排看一遍
| 同一件事 | 官方文档的原始语气 | 抓取工具报表里的级别 | 团队待办里的写法 |
|---|---|---|---|
| 一页多个H1 | 全文没有“只能一个”这种说法,H1只在讲标题链接时被当例子提过一次 | 中高优先级警告 | 必须改成单H1 |
| 元描述缺失 | 可选,影响的是摘要不是排名 | 警告,按数量计 | 必须全站补齐 |
| 图片缺替代文本 | 推荐,讲可访问性与图片搜索 | 错误或警告 | 必须清零 |
| 结构化数据必填字段缺失 | 强制,缺了功能出不来 | 错误 | 必须修 |
前三行是语气被升级,只有第四行三列一致。多个H1到底合不合规那篇把第一行拆得很细,本篇给的是它的一般化:清单和报表这两种形式,天然不携带语气。它们只有“有问题”和“没问题”两个值,读者拿到的时候,那句原文里的“可以”已经掉了。
那句不保证会出现,为什么在30页里一字不差地重复?
免责那一档总共只有84次,占1.4%,看着很少。但它的分布很有意思。
“不保证”这类说法命中46个页面。其中有一句是逐字重复的模板句:谷歌不保证消费结构化数据的功能会出现在搜索结果里。这句话在结构化数据那39个页面里出现了30页,一字不差。
把它和上一节的数字放在一起,就出现了一个很漂亮的对称:must最密的那批文档,也是那句“不保证”贴得最勤的那批文档。官方在同一页上同时说了两件事——你必须这么填,以及填了也不保证有效果。
这两句话一点都不矛盾,它们管的是两个不同的环节。必须那部分管资格:格式不对,你连候选都进不了。不保证那部分管结果:进了候选,展不展示是它的事。文章类结构化数据文档里这两句就挨着放,结构化数据的通用政策页另有一句更直白的:结构化数据本身不影响页面的排名方式。
站内富结果被砍掉之后那类标记还该不该写和改成被AI引用的写法两篇正好是这个结构的现实版:资格那一半你做完了,展示那一半平台随时可以收回。理解了这两个环节的分工,那次变动就不算意外。
官方唯一给了分档的地方,管的是什么?
整个文档站里,唯一明确标出优先级的地方是结构化数据的字段表:必填和推荐两档。我数了一遍,那39页里必填标记82次,推荐标记96次。
注意这个比例——推荐项比必填项还多。也就是说哪怕在官方唯一给了分档的地方,超过一半的条目仍然是“建议填”。商品信息那一页是这里面最典型的,必填10处、推荐11处。
而这份分档管的是展示位资格,不是排名权重。站内词汇表方第一次公开全网使用数据那篇讲哪些类型值得优先做,商品标记新增分类属性那次变动讲字段层面的具体取值,两篇配着这里的必填推荐两档看,能少走不少弯路。
顺手提一句实测口径的限制:我数的是文档里出现的标记词,一个页面可能反复出现同一个字段的标记,所以82和96应该理解为标记的密度,不是去重后的字段数。
为什么可以这一档反而最多?
可选那一档2948次,占49.5%,几乎是强制加推荐的总和。这个结构值得单独想想。
一方面是技术文档的通例:讲清楚“你可以做什么”比规定“你必须做什么”更有用,尤其当读者的站千差万别的时候。入门指南那一页里这种语气最密集,因为它面对的读者背景最杂。
另一方面,这也是一种责任的安放。用了可以,决定权就在你;用了必须,官方要为后果负责。站内AI写的内容会不会被惩罚这个说法和官方AI搜索指南到底叫停了哪几个动作两篇都撞到过同一件事:官方原话的语气比转述过来的版本软得多,而每一次升级都发生在传播环节。
我还检索了“看情况”这一类措辞,命中12个页面22次。官方自己也在用这种语气,跟外面那种斩钉截铁的清单风格正好是两个极端。
官方为什么几乎不用should,而改说我们建议?
上一张表里有一行很容易被跳过:should只出现97次,覆盖51个页面,31.9%。
英文技术文档里should是最常用的建议词,规范类文件甚至给它定了正式含义。谷歌这160页几乎没怎么用它,取而代之的是we recommend,540次,覆盖96个页面。
这个替换不是文风偏好,它改变了句子的责任归属。should把义务放在读者身上,读起来像“你应该”;we recommend把立场放在说话人身上,读起来像“我们推荐,你自己定”。同一件事,前一种写法读者不做就是失职,后一种写法读者不做只是没采纳建议。
还有一个词组值得注意:make sure和ensure加起来476次,覆盖122个页面,76.2%,覆盖率比must高得多。这个词组的语气很滑——它字面上是命令式的“确保”,实际管的多半是可选动作,比如确保链接可抓取、确保移动端能看到同样的内容。翻译成中文的时候它最容易被升级成必须,因为中文里“确保”天然带强制色彩。
这一层观察对做中文SEO内容的人特别有用。你转述官方文档的时候,选哪个中文词等于替官方重新定了一次语气。建议、推荐、应该、必须、务必,这五个词在中文里的强度差得很远,而英文原文可能只是一个we recommend。
把语气压平会让工作变形成什么样?
这一节说后果,因为前面全是数字,落不到手上就没用。
语气被压平之后,最直接的变形是问题数变成了工作量的度量。工具报出一万个问题,读起来像一万件事要做,可那一万条里有九千条原文语气是可以。站内一堆技术SEO问题先修哪个那篇是按业务影响排的,按站点类型给高回报修复排序那篇是按站型排的,两篇的共同前提正是这里:问题数本身不是优先级。
第二种变形是排期被没有截止日期的事情占满。强制项有天然的截止日期:功能出不来,那就是今天的事。推荐和可选项没有,于是它们靠声音大小争资源,而清单让所有条目的声音一样大。
第三种变形更隐蔽:因为清单不带语气,所以它也不带作废标记。站内被淡化的十个老信号里哪些真死哪些只是误读那篇逐项分过类,而十条最佳实践清单逐条点回出处那次核对发现的更根本——清单这种形式本身就在做承诺,读的人会自动补上它没说的前提。语气就是被补掉的那个前提之一。
两万三千条问题,最后只有四百条设了截止日期
说个具体的。去年帮一家B2B工业配件的出海站做技术清理,抓取工具给出来的问题有两万三千条。当时没按数量排,而是先给每一类问题标一个字母:强制、推荐、可选。标法很简单,去官方文档里找原句,看那句用的是哪一档语气,找不到原句的单独归一类。
标完的结果是强制类只有四百多条,绝大部分是结构化数据的必填字段和几个抓取阻塞。这四百多条两周做完了,剩下的按季度慢慢推。那一轮之后,团队里“这个到底要不要做”的争论基本消失了——不是因为有了答案,是因为大家终于在同一套语气上说话。
把这套做法拆成能照着跑的四步
上面那一轮的做法可以拆成四步,任何一份抓取报告都能照着跑。
- 第一步,按问题类型去重。两万三千条问题去重之后通常只剩几十到一百来个类型,剩下的都是同类型的重复计数。这一步最省力,也最能改变人对工作量的判断。
- 第二步,每个类型去官方文档找原句。找的时候只认文档站里的句子,帮助中心和博客另算一档,社交平台上的表态再降一档。找不到原句的单独归一类,标成经验类。
- 第三步,按原句的动词标档。出现must、required、否定式禁止的标强制;出现we recommend、best practice的标推荐;出现can、may、consider的标可选。只给强制类设截止日期,推荐类进季度计划,可选类进观察队列。
- 第四步,把这张对照表存下来当团队共识。下次工具再报同一类问题,不用重新吵一遍,查表就行。这张表还能当新人培训材料,比讲一百句原则有用。
第二步是唯一费时间的,一个类型平均三五分钟。一百个类型大概两个人天,换来的是把待办从两万三千条压到四百条。抓取工具的全站审计怎么跑那篇讲的是怎么把问题采全,本篇这一节讲的是采全之后怎么不被它压垮。
官方真正的高频词不是排名,是资格
再补一组对照,能把前面所有数字串起来。我检索了几个关键词在这160页里的密度:
| 词 | 次数 | 覆盖页数 | 它在讲哪件事 |
|---|---|---|---|
| structured data | 1449 | 77 | 怎么标记 |
| crawl | 839 | 102 | 能不能被抓到 |
| index | 838 | 114 | 能不能进索引 |
| rich result | 439 | 59 | 能拿到什么展示位 |
| eligible/eligibility | 268 | 68 | 够不够资格 |
| ranking | 151 | 34 | 排第几 |
资格这个词根出现268次、覆盖68个页面,是排名那个词的1.8倍;抓取和索引各八百多次。官方文档的重心不在名次上,它在讲一整条流水线的入场条件:能不能被抓到、能不能进索引、够不够资格拿某个展示位。
把这个重心和语气分布叠在一起,官方文档的性质就清楚了——它是一份资格说明书,不是一份排名攻略。你在里面找排名的答案,当然只会找到推荐和可选。站内页面类型声明的实测和结构化数据的语法校验两篇都属于资格那一侧,做完当天能验,这正是强制类工作的特征。
这套测量最容易被误用的两个地方
先说第一个。四档比例是按句式次数算的,不是按条目算的。同一条要求在一页里被反复叮嘱三遍,就会被记成三次。所以次数反映的是官方在某件事上说了多少话,不能直接读成有多少条要求。真正需要按条目算的时候,得回到具体页面手工点。
第二个更要紧:这160页是搜索中心文档站的范围,不含帮助中心、不含官方博客、不含社交平台上的表态。而行业里流通的很多说法恰恰出自后三类。所以某一条在本篇里零命中或者语气很软,完全可能在帮助中心那边有更硬的说法。本篇的结论只覆盖文档站这一个来源,别当成官方口径的全貌。
这两条限制加起来还有一层提醒:不同来源的证据等级本来就不一样。文档站的句子最稳定,帮助中心次之,博客和社交平台上的回答最容易过时。给待办找原句的时候,把出处一起记下来,比只记一个结论管用得多。
读官方文档该怎么读,才不至于把建议读成命令?
我的读法就三步,很笨,但有效。
第一步,看动词。这句话用的是must、required,还是we recommend、can、may。这一步决定了这条东西能不能给自己设一个截止日期。
第二步,看它管的是资格还是效果。管资格的句子后面通常紧跟一句“不保证会出现”,那句话反而是好消息——它说明前面那个必须是真的必须,只不过它换来的是入场券不是名次。
第三步,找不到原句就停下来。行业里流传的很多条目在官方文档里根本没有对应说法,这不代表它无效,但代表它的证据等级是经验而不是文档。搜索基础要求那一页是唯一一处真正接近“不做就不行”的文档,值得整页读完,它的篇幅短得出人意料。
最后回到开头那句话。既然官方自己承认很多问题没有绝对正确的答案,那么读文档的目的就不是找到正确答案,是搞清楚哪些事有唯一答案、哪些事得你自己选一个然后把它做对。那组概念到底是不是排名因素和网页体积越大排名越差这个说法两篇都是这么处理的:先把有定论的部分钉死,剩下的说明白是判断不是事实。
常见问题解答
数句式这种办法,会不会把语气测错?
会有误差,本篇的口径也写明了。一个must可能出现在纯技术约束里,一个can也可能实际上是强烈建议。所以这四个比例应该读成语气的粗略分布,不是义务强度的精确刻度。之所以还值得看,是因为落差足够大:可选档占49.5%、强制档26.8%,而且一半的页面一个must都没有,粗略的测量也推不翻这个方向。
为什么must集中在结构化数据文档里?
因为那类文档讲的是格式和资格,因果关系确定:字段不对,功能就出不来。548个must里366个在结构化数据那39页,占66.6%,而这类文档只占页数的24.4%。反过来说,内容该写多深、链接该怎么建这些没有唯一答案的事,官方用的全是推荐和可选。
官方说了必须,又说不保证,到底信哪句?
两句都信,它们管的是两个环节。必须管资格,格式不对连候选都进不了;不保证管结果,进了候选展不展示是平台的事。那句一字不差的模板句在结构化数据的39页里出现了30页,就贴在必填字段表旁边。理解了这个分工,功能被下线的时候就不会觉得被骗了。
抓取工具报的错误和警告,能不能直接当待办?
不能直接当,但可以当线索。工具只有有问题和没问题两个值,原文那句“可以”在报表里会消失。可行的做法是给每一类问题回官方文档找原句,按语气标一档,只给强制类设截止日期。这一步做完之后,问题总数通常会缩掉一个数量级。
那些在官方文档里找不到原句的做法,是不是就别做了?
不是。行业经验先于文档存在是很正常的事,很多有效做法官方从来没写过。要做的只是把它和有出处的那批分开记录,因为验证方式不一样:有出处的可以当天验收,靠经验的只能靠长期观察和多站对照。混在一张表里会让整张表的可信度被拉平。
这套语气分档能不能用在别的平台文档上?
能,而且做法完全一样:全量抓文档、剥标签、按句式分档、按页统计。值得留意的是不同平台的语气基线差别很大,广告类和商家类的文档通常强制句式更密,因为那边涉及合规。所以跨平台比较之前要先各自算出基线,别拿一个平台的比例去套另一个。
权威参考资料
本文标题:《谷歌SEO官方文档实测160页:522句必须里,只有1句提到排名》
本文链接:https://zhangwenbao.com/google-docs-modal-verb-tone-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0