程序化SEO的账不算在那一页头上,算在整个站头上
本文目录
- 失去信心这个说法,能不能当比喻听?
- 那为什么有的站做组合页做得好好的?
- 131个站里,一个模板下面平均挂着多少页?
- 为什么单页体检工具查不出这个问题?
- 同一个模板生出来的三个兄弟页,到底有多像?
- 独有内容只有200个字符的页面,做上千个是什么概念?
- 那些共有率低的站,是不是就一定好?
- 有没有办法直接认出笛卡尔积式的铺量?
- 那是不是模板页就不能做了?
- 规模化内容滥用这条政策,是什么时候写进去的?
- 铺量在抓取这一侧要付什么代价?
- 怎么在自己站上把这件事量一遍?
- 第一步:把网址收齐并抽象成模板
- 第二步:按模板排序,先看最大的三个
- 第三步:每个模板抽三页,算共有率
- 第四步:把结论落成三选一的处置
- 已经被判了,多久能缓过来?
- 为什么恢复比被判慢那么多?
- 该先删还是先补?
- 删的时候要不要留重定向?
- 这件事和AI批量生产是什么关系?
- 常见问题解答
- 我的商品页模板下有三千个网址,是不是就算规模化滥用了?
- 共有率多少算高?有没有一条明确的线?
- 那些完全相同的文本块里,导航和页脚要不要剔除?
- 我把薄页全部加上noindex,问题是不是就解决了?
- 组合式铺量和正经的长尾覆盖,界线到底在哪?
- 我用工具生成内容,是不是一定会被判?
- 如果我的站被判了,最快的止损动作是什么?
- 权威参考资料
摘要:谷歌的John Mueller在9月上旬又谈了一次程序化SEO,其中一句值得抄下来:我们的系统可能已经对你的站能给用户提供好价值这件事失去了信心,依据是那些老页面。注意主语和宾语——失去信心的对象是站,依据是一批页面,而不是某一页写得好不好。我抓了131个跨境独立站的站点地图做了一轮实测:一个模板下的网址数中位是97条,最大的那个模板平均吃掉全站一半网址;随机取同模板的三个兄弟页做对比,文本块完全相同的比例中位是65%,每页真正独有的文字中位只有2180个字符。
9月上旬,有人拿一个站去问谷歌搜索关系团队的John Mueller:站是按域名、技术、属性这几个维度穷举组合生成的,为什么表现不好。
Mueller的回答不长,但层次很清楚。他先说这类做法常常会做出一个要么是垃圾、要么接近垃圾、要么就是低质量的站;再说这种站容易得到一堆有那么点价值、但整体图景并不令人兴奋的页面,继续用生成数据往上堆并不会让它对用户更有用;然后是那句最要紧的:我们的系统可能已经基于那些老页面,对你的站能为用户提供好价值这件事失去了信心。最后他说,解决这件事往往需要时间和相当大的投入去证明价值。
本站写过程序化SEO从模板化转向语义化的做法,也写过程序化SEO怎么做不被算法当薄页,那两篇讲的都是怎么做。这一篇不讲怎么做,只讲一件事:这套东西被判定的时候,判的单位到底是什么。
失去信心这个说法,能不能当比喻听?
不能。因为把它落到官方政策文本上,会发现措辞是一致的。
谷歌搜索的垃圾内容政策里有一条叫规模化内容滥用,原文的判据是:为了操纵搜索排名而不是帮助用户,生成了大量页面。它还补了一句边界,说这种做法典型的形态是制造大量原创性不足、对用户没什么价值的内容,无论它是怎么被创造出来的。
把这句话拆开看,三个词决定了判定的粒度:大量、页面、主要目的。没有一个词落在单个页面的质量上。它数的是一批,看的是这批东西为什么存在。
同一份政策里紧挨着的门户页滥用条款更直白,它给的例子包括:为多个地区或城市定制、最后把用户漏斗到同一个页面上去的那些页;以及创建实质上高度相似、更像搜索结果而不是清晰可浏览层级的页面。这两条描述的正是大多数程序化SEO工程的产出形态。
那为什么有的站做组合页做得好好的?
因为政策判的是主要目的和实际价值,不是判手法。同样是按城市生成上千页,一家本地服务商在每一页里放的是当地真实的服务网点、价格区间、工时和案例,另一家只是把城市名替换进同一段话。前者是把已有的差异化信息按结构铺开,后者是把没有的信息用模板假装成有。官方那份关于以人为先内容的指南里有一条自查问题问得非常直接:你是不是在用大规模自动化去生产很多主题的内容。
131个站里,一个模板下面平均挂着多少页?
光讨论定义没意思,我把这件事量了一遍。
方法是这样:拿131个跨境独立站做样本,抓robots.txt找到站点地图入口,顺着索引往下取子地图,把能读到的网址全部收集起来,合计32万多条。然后把每条网址的路径做抽象——保留第一段作为版块名,其余每一段替换成通配符,纯数字段单独标记——这样得到的就是这个站实际使用的网址模板。
85个站的网址量够做统计。结果如下。
| 统计项 | 中位数 |
|---|---|
| 每个站收集到的网址数 | 648条 |
| 每个站用到的网址模板数 | 9个 |
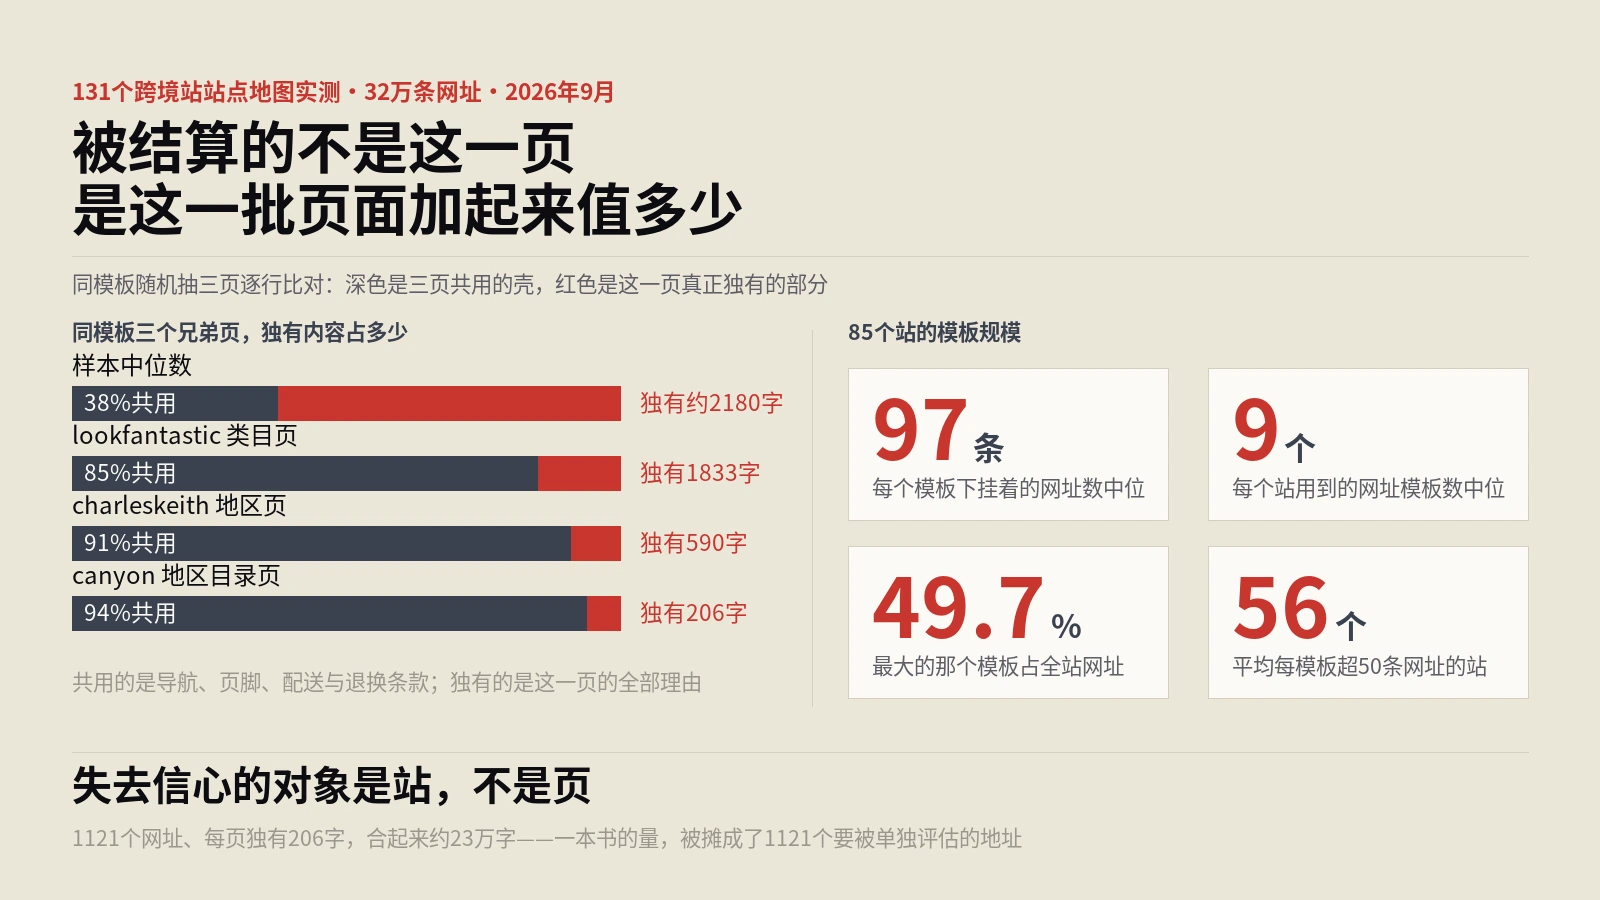
| 每个模板下挂着的网址数 | 97条 |
| 最大的那个模板占全站网址的比例 | 49.7% |
再看分布的另一头:85个站里有56个,平均每个模板下挂着50条以上的网址。这不是什么灰帽玩法,这就是电商站的常态——一个商品详情页模板生出几千个网址,一个博客文章模板生出几百个,一个集合页模板生出几十个。
极端的例子更能说明问题。ikea.com的样本里4567条网址全部落在同一个模板下,一个模板包办了100%。vuoriclothing的商品模板占了全站84%,chubbiesshorts占57%,ruggable占48%。
换句话说,今天几乎所有稍具规模的站,本质上都是程序化生成的。区别不在用不用模板,在模板往里填的东西是不是真的不一样。
为什么单页体检工具查不出这个问题?
因为它们的输入就是一个网址。给一个组合页做体检,标题有、描述有、H标签层级对、图片有alt、加载也快,各项都能拿高分。这些工具没有任何一项指标是问这一页和它的一千个兄弟有什么不同。
能看出问题的只有两种视角:一种是把同模板的多页放在一起比,另一种是把整站的页面构成摊开看。前者要抓页面,后者只要一份站点地图。两种都不在常规体检清单里,所以这类问题往往是在流量掉了半年之后,才有人第一次去数自己站上到底有多少页。
同一个模板生出来的三个兄弟页,到底有多像?
这才是关键那一问。模板本身不是罪名,填进去的东西有多少是自己的才是。
做法很土但很直接:在每个站最大的那个模板下随机抽3条网址,全部抓回来,把可见文本切成行,每行至少12个字符才算一块,然后看三页之间完全相同的文本块占各自的比例。相同的那部分就是壳,剩下的才是这一页自己的东西。
65个站符合抽样条件,46个站三条全部抓成功。结果摆在这儿。
| 指标 | 中位数 | 它的意思 |
|---|---|---|
| 三页完全相同的文本块占比 | 65.3% | 三分之二的段落是逐字一样的 |
| 三页完全相同的字符占比 | 37.6% | 按字数算,约四成是共用的壳 |
| 每页真正独有的字符数 | 2180 | 去掉壳之后剩下的全部内容 |
| 字符共有率超过90%的站 | 46个里有2个 | 三页几乎是同一页 |
先说中位数这一档。三分之二的段落逐字相同,听起来吓人,其实正常——导航、页脚、尺码说明、配送政策、退换条款本来就该一样。按字符算共有四成、独有2180字符,这个比例对一个商品详情页来说是站得住的。
真正值得停下来看的是尾巴那一端。
独有内容只有200个字符的页面,做上千个是什么概念?
样本里最极端的两个站是这样的:
| 站点与模板 | 该模板下的网址数 | 字符共有率 | 每页独有字符 |
|---|---|---|---|
| canyon.com的某个地区目录模板 | 1121 | 94% | 206 |
| charleskeith.com的地区页模板 | 1447 | 91% | 590 |
| warbyparker.com的眼镜分类模板 | 515 | 90% | 289 |
| lookfantastic.com的类目模板 | 2556 | 85% | 1833 |
把第一行换算一下:1121个网址,每页自己的文字只有206个字符,整个模板下所有页面加起来的独有内容大约23万字符。一本中等篇幅的书的量,被摊成了1121个独立网址,每一个都要被抓取、被评估、被存进索引。
这就是Mueller说的那句有那么点价值、但整体图景并不令人兴奋的具体样子。单看任何一页,它都不是垃圾:有标题、有商品、有价格、能用。问题不在这一页有多差,在于这一批页面加起来,并没有比其中一页多给出多少东西。
本站以前拆过薄内容不是字数少这件事,当时的判据还落在单页上;这次的实测把判据挪到了批次上,两者是同一个问题的两个尺度。类似的尺度差也出现在可替代内容那篇里:可替代性从来不是跟自己比,是跟同题材已经存在的东西比。
那些共有率低的站,是不是就一定好?
不一定,这里有个反向的坑。共有率低可能意味着每页内容扎实,也可能意味着这个模板下的页面本来就不是一类东西,被我的抽象规则错误地归成了一组。样本里有几个站的最大模板其实是博客文章目录,文章之间当然不像,但那不代表这个站的商品页没问题。
所以这个数字只能当筛子用,不能当判决书。它的正确用法是:先按模板排序,找出网址数最多、共有率最高的那两三个模板,然后人工打开几页看看,判断那批页面到底值不值得存在。
有没有办法直接认出笛卡尔积式的铺量?
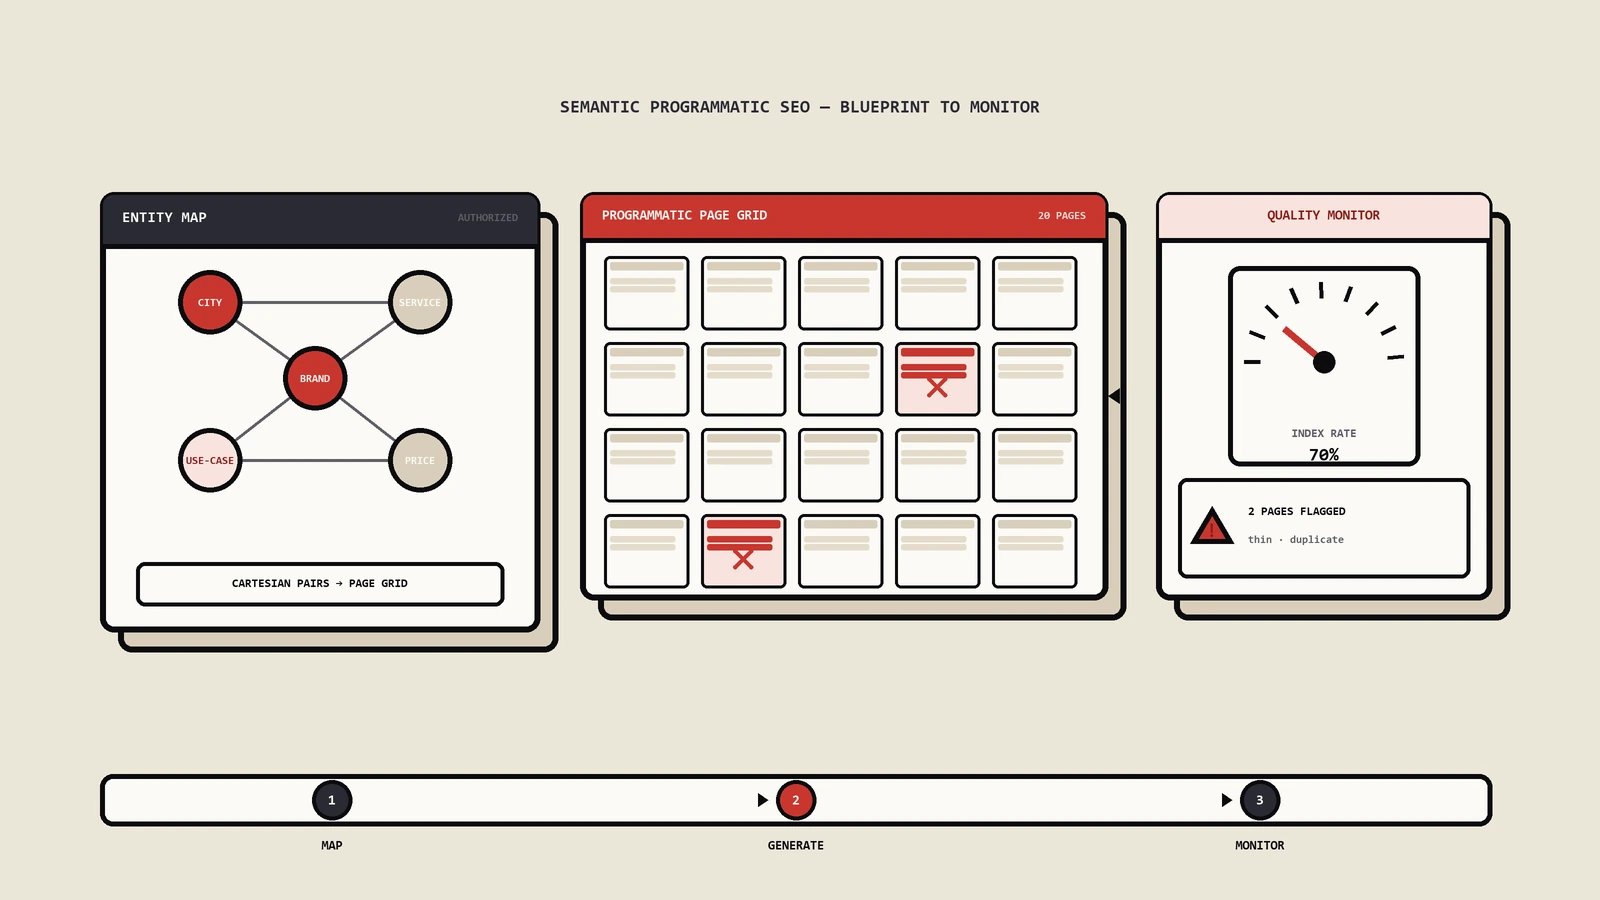
有,而且只需要网址,不需要抓页面。做法是:挑出那些带两个以上变量位的模板,把每个变量位实际出现过的取值各自去重,算出这几个集合的乘积,再看实际存在的网址数占这个乘积的比例。这个比例我叫它填充率,越接近1,说明这个模板下的网址越像是把几份清单穷举组合出来的。
样本里有57个站存在这样的多变量模板。按填充率排下来,10个站在0.9以上,18个站在0.5以上,中位数是0.33。填充率高不等于有问题——一家在十个国家卖三类产品的店,自然会有接近满格的组合。但它是一个很便宜的线索:填充率接近1、同时共有率也高的那些模板,基本就是Mueller说的那种穷举出来的东西。
这个方法的好处是能在抓页面之前先排掉大部分,成本几乎为零。缺点是它对三段以上的深层路径不太准,变量位一多,乘积被高估,填充率会虚低。
那是不是模板页就不能做了?
当然不是。上面的数据已经说明,不用模板的站基本不存在。真正要分清的是三种不同的东西。
| 形态 | 判据 | 典型场景 |
|---|---|---|
| 模板化渲染 | 每页背后有真实且不同的数据 | 商品详情页、门店页、职位页 |
| 组合式铺量 | 把两三个维度的清单做笛卡尔积,内容靠拼 | 城市加服务、品牌加型号、技术加属性 |
| 规模化内容滥用 | 大量页面,主要目的是拿排名 | 自动摘要、同义词改写、跨站拼接 |
第一种是必需品。第三种是政策明文禁止的。麻烦的全在第二种——它在技术上和第一种没区别,在动机上又常常离第三种很近。Mueller问的那个站属于典型的第二种:域名、技术、属性三个清单穷举所有组合。
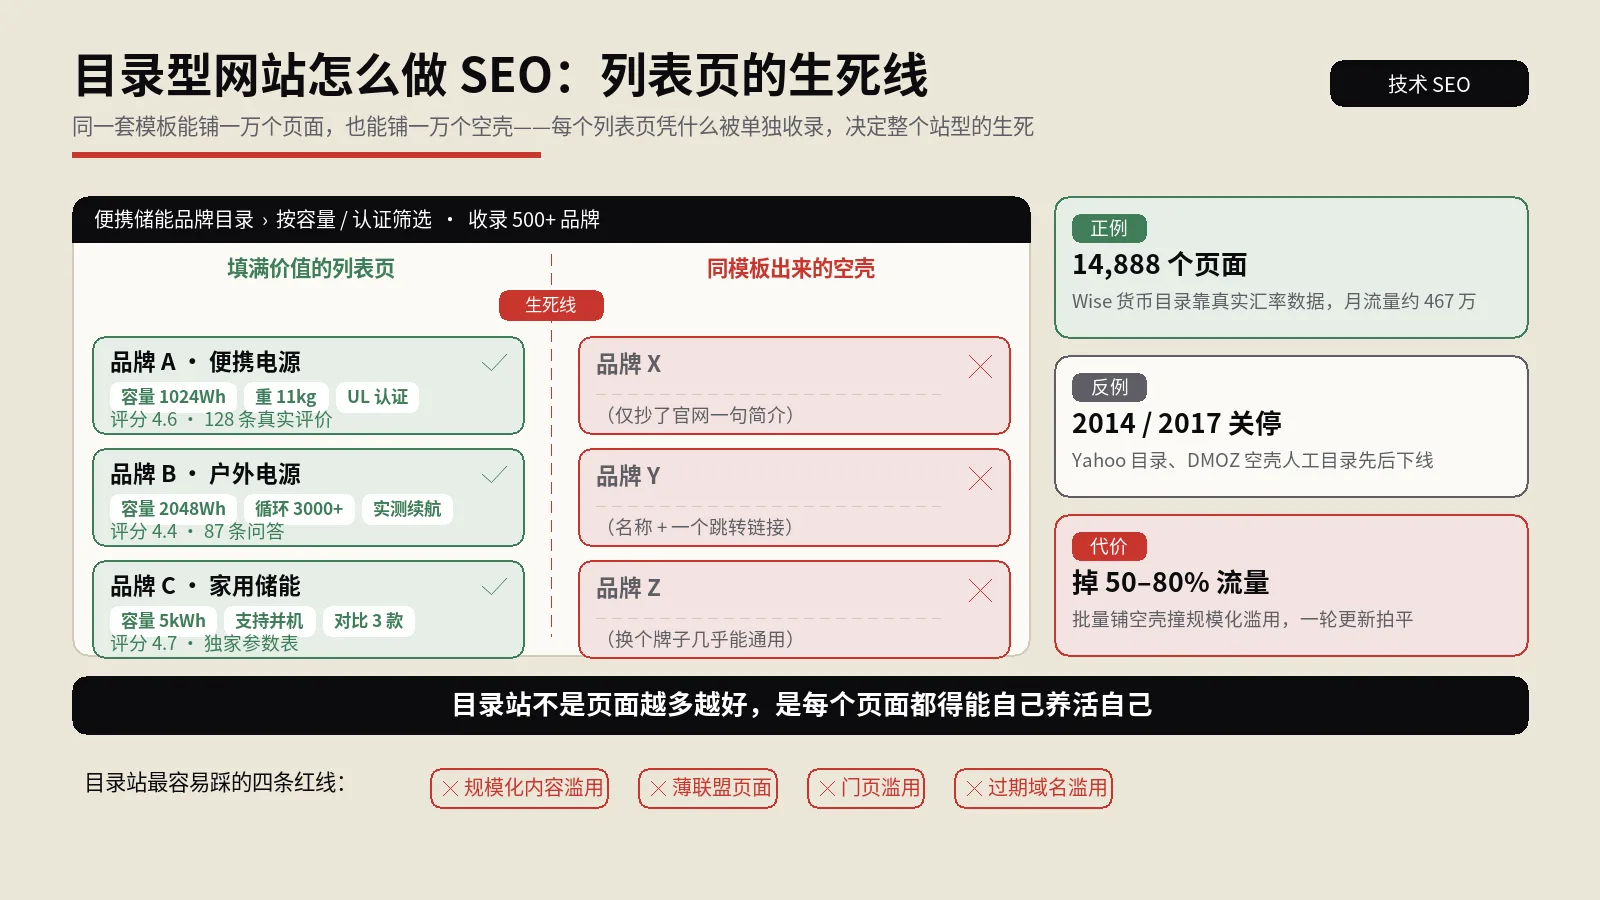
有几类站型天生就站在第二格边上。目录站、双边市场、招聘站的主体都是海量列表页,本站分别拆过目录型网站的列表页凭什么被单独收录和职位页又薄又短命怎么还能被收录,这两类站的解法不是少做页面,而是让每一条列表本身携带别处拿不到的信息。
判断自己在哪一格,有一个不用等谷歌判决的自查:把模板里的变量抽掉,剩下的那段话如果单独发出去还成立,说明变量没承担信息量,那批页面就是在铺量。反过来,如果抽掉变量之后整段话读不通了,说明每一页确实各有各的内容。
规模化内容滥用这条政策,是什么时候写进去的?
值得回头看一眼它的来历,因为措辞的变化本身就说明了判定单位的迁移。
这一条是2024年3月那次政策更新正式加进垃圾内容政策的。在那之前,官方的类似表述叫自动生成内容,重点落在生成这个动作上;改版之后名字里的关键词换成了规模化,重点落到了量上。
同一次更新还把过期域名滥用和站点信誉滥用一起写了进去,这三条有一个共同点:它们判的都不是某一页的写法,而是一批页面、一个域名、一段历史。从那次之后,谷歌公开讨论内容质量时的口径就基本固定在这个粒度上了,Mueller这次说的失去信心,用的正是同一套语言。
本站梳理过从熊猫算法到AI模式这十四年的内容质量演进,这条线其实很清楚:早期算法按页打分,中期开始按站打分,现在连恢复周期也是按站算的。
铺量在抓取这一侧要付什么代价?
除了质量判定,还有一笔更直接的账。
官方那份大型站点的抓取预算文档说得很明白:大量低价值网址会影响一个站被抓取和收录的效率,因为抓取资源被浪费在这些地址上,真正重要的页面反而可能被推迟发现。文档里点名的低价值形态包括分面导航、会话标识、站内搜索结果页、以及大量的软404。
看一眼我这次收集到的规模就知道这不是危言耸听。样本里网址量最大的那个站,光是从站点地图里能读到的就有7万多条;排在前列的几个站也都在1万到4万之间。这些数字还只是声明出来的部分,带参数的筛选组合根本不进站点地图。
铺量在这里是双重扣分:低价值页面一边稀释整体图景,一边挤占本来该给重要页面的抓取份额。从服务器日志读抓取预算浪费那篇里给过一个诊断顺序,先看抓取分布再看收录比例,基本能把浪费在哪儿指出来。
怎么在自己站上把这件事量一遍?
整套流程不到一小时,不需要买工具,也不需要后台权限——全部输入只有一份公开的站点地图和几个网页。顺带一提,这套办法拿去看竞争对手同样好用,而且比任何第三方估算工具都准,因为数的是对方自己声明出来的东西。
第一步:把网址收齐并抽象成模板
从robots.txt里找到站点地图入口,顺着索引把子地图全部取下来。要注意索引文件里的条目本身也是地图而不是页面,得递归一层。取完之后把每条网址的路径按斜杠切段,第一段保留原样,其余每段替换成通配符,纯数字段单独标记,拼回去就是模板。站点地图提取的几种格式与坑那篇里有各种非标准写法的处理办法。
第二步:按模板排序,先看最大的三个
统计每个模板下的网址数,降序排。头三个模板通常吃掉全站七八成网址,它们的质量基本就等于这个站在搜索眼里的质量。按页面模板抽样做电商审计那篇讲的就是这个思路,逐条网址查要跑上百天,按模板抽样半天就能出结论。
第三步:每个模板抽三页,算共有率
随机取3条,抓下来把可见文本切成行,统计三份之间完全相同的行占各自的比例。用不用脚本都行,实在不想写代码,把三页的正文粘进文档做对比也能看出个大概。判读的档位可以参考上面那张表:字符共有率长期在85%以上的模板需要重新评估,超过90%的基本可以判定是在铺量。
第四步:把结论落成三选一的处置
对每一个有问题的模板,只有三条路:补内容让每页真正不同、合并成更少但更厚的页、或者从索引里拿掉。第三条最容易被忽略,但往往是最划算的。接口与数据文件这类没有head标签的地址怎么声明不收录那篇里的手段同样适用于批量页面。
已经被判了,多久能缓过来?
Mueller给的说法是需要时间和相当大的投入,并且建议参照别人处理垃圾内容问题和核心更新恢复的经验来估周期。这句话里两个信息量都不小:一是他没有给月份数,二是他把这件事和核心更新恢复归成了同一类难度。
为什么恢复比被判慢那么多?
因为判定的依据是一批页面的整体图景,而整体图景是被历史累积出来的。删掉一千个薄页,索引那边需要重新抓完这一千个地址才知道它们没了;补厚一千个页面,需要重新评估这一千个页面的价值。收录到起量的真实时间线那篇给过一个参考区间,批量改动的生效周期通常以月计,而不是以周计。
该先删还是先补?
看那批页面背后有没有真东西。有真数据只是没写出来,优先补;本来就没有对应的实体,删得越快越好。判断方法很朴素:随便挑十页,问自己能不能为每一页写出三句别的页写不出来的话。写得出来就补,写不出来就删。
| 这批页面的情况 | 处置 | 大致代价 |
|---|---|---|
| 背后有真实实体,只是内容没写 | 补厚,按搜索量排序分批做 | 最贵,但收益也在这边 |
| 实体存在但极度长尾,单独成页没意义 | 合并成更少的聚合页 | 中等,重定向要做干净 |
| 只是清单穷举出来的组合,没有实体 | 下线,返回410或301 | 最便宜,见效也最快 |
| 有实体但内容来自抓取或改写 | 先下线,再考虑要不要重做 | 拖着不处理的代价最高 |
这张表里最容易被做错的是第二行。合并本身不难,难的是合并之后旧地址的处理:几百上千条重定向如果指向同一个聚合页,很容易被当成软404,那就等于白做。
删的时候要不要留重定向?
有替代目标就301过去,没有就直接返回410。批量页面最怕的是删成一堆软404,既占抓取又不给信号。改完之后一定要复核线上状态码,本站测过站点地图里抽了585条网址有48条是坏的,而生成它的程序一次都没报错。
这件事和AI批量生产是什么关系?
直接相关,而且政策文本已经写进去了。规模化内容滥用那一条的第一个例子就是:使用生成式AI工具或者类似工具生成大量页面而不为用户增加价值。
但要注意它后面那句无论它是怎么被创造出来的。这条政策从来没有禁止用工具,它禁止的是产出没有增量而数量巨大这件事本身。手工写一千篇没有信息增量的稿子,和用工具生成一千篇,在这条政策下是同一件事。
现实里的麻烦在于,工具把生产成本压到接近零之后,第二种形态的页面变得极其容易做出来。本站拆过AI批量内容撞上质量墙那件事,也复盘过六个站四个降权的AI内容流水线,两次的结论是同一个:流水线本身不是问题,问题是流水线上没有一个环节负责判断这一页值不值得存在。
还有一种更隐蔽的形态是地区版本。同一份内容按语言和国家复制几十份,字符层面看起来各不相同,信息层面是同一份。这件事在一个模板生成十种语言那篇里量过,而它现在又多了一层麻烦——结果页本身已经开始按辖区分叉,同一批地区页在不同法域下的处境也不再一样。
说到底,Mueller那句话值得反复读的地方在于主语:失去信心的对象是站,不是页。你上线一批新页面,被结算的是整个域名的信用;你清理一批老页面,恢复的也是整个域名的信用。重复内容有没有惩罚那篇里讲过,谷歌确实没有一个叫重复内容惩罚的东西;但没有惩罚不等于没有代价,代价就写在这句失去信心里。
常见问题解答
我的商品页模板下有三千个网址,是不是就算规模化滥用了?
数量本身不构成判据。政策里的判据是大量页面加上主要目的是操纵排名。三千个商品页背后如果有三千件真实在售的商品,各有各的图、价格、规格、库存,那它是电商站的正常形态。真正要自查的是那些没有实体对应的页面:按属性组合出来的筛选结果页、按城市复制出来的服务页、按关键词拼出来的问答页。
共有率多少算高?有没有一条明确的线?
官方没有给过任何数字,上面那些档位是我自己在46个站的样本上算出来的经验值,只能当参考。按字符算的共有率中位是37.6%,超过85%的模板值得重新评估,超过90%基本可以判定在铺量。更稳妥的用法是纵向比:把自己站内各个模板放在一起排序,最高的那两个先查。
那些完全相同的文本块里,导航和页脚要不要剔除?
做粗筛的时候不用,因为你要看的是相对排序,导航页脚对所有模板的影响是一样的。要出对外结论的时候得剔除,否则一个导航很重的站会被系统性地高估。剔除的办法是先把三页的共有块提取出来,再与站内任意两个不同模板的页面求交集,交集部分基本就是全站公共壳。
我把薄页全部加上noindex,问题是不是就解决了?
能解决一部分,但不是全部。noindex之后这些页面不再进索引,整体图景那一侧的压力会降下来。不过它们仍然会被抓取一段时间,仍然占着内部链接的权重传递。更彻底的做法是同时处理三件事:从索引里拿掉、从站点地图里删掉、把站内指向它们的链接也清理掉。
组合式铺量和正经的长尾覆盖,界线到底在哪?
在于那个组合是不是真的有人搜、而且你是不是真有东西可说。有搜索需求但你没内容,做出来的是空壳;有内容但没人搜,做出来的是自娱自乐;两样都有才叫长尾覆盖。起草之前先把这两件事验一遍,比事后补救便宜得多。
我用工具生成内容,是不是一定会被判?
不是。政策原文特意写了无论它是怎么被创造出来的,意思是判产出不判手法。用工具生成一篇有真实数据、有独到判断、读完不用再去别处搜的内容,它和人写的在政策上没有区别。反过来,手工写出来的注水稿一样算数。
如果我的站被判了,最快的止损动作是什么?
先停止新增。很多人发现表现下滑的第一反应是再发一批内容把量补回来,这个动作会让整体图景继续恶化。正确的顺序是先冻结产出,再按模板盘点存量,再决定补、并、删,最后才考虑恢复更新节奏。
权威参考资料
本文标题:《程序化SEO的账不算在那一页头上,算在整个站头上》
本文链接:https://zhangwenbao.com/programmatic-seo-sitewide-trust-scaled-pages.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0