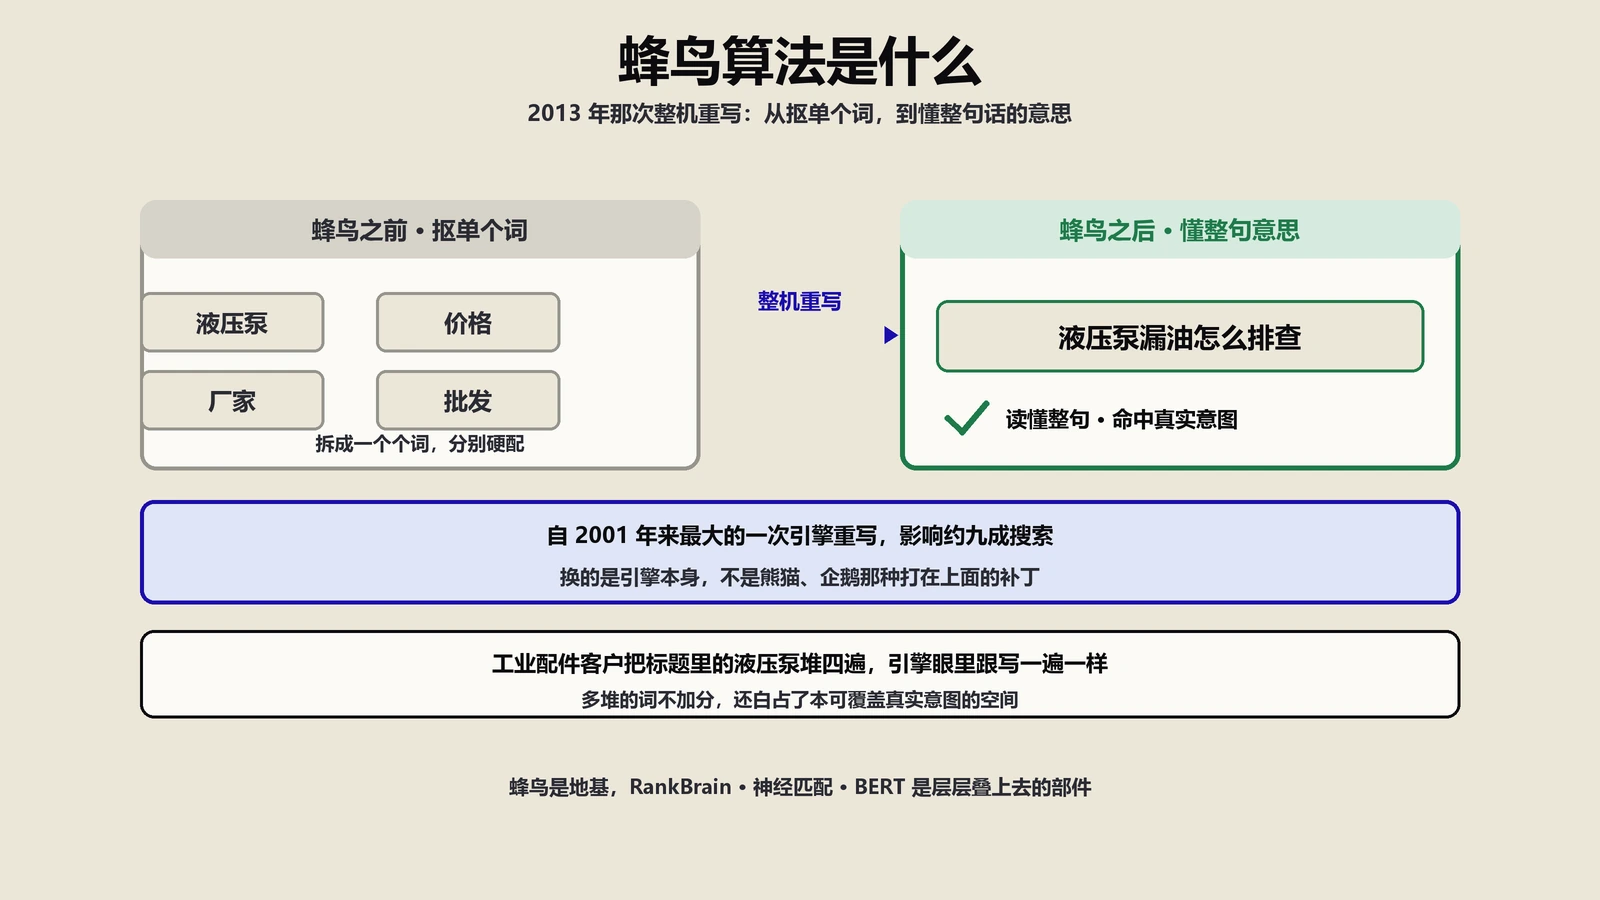
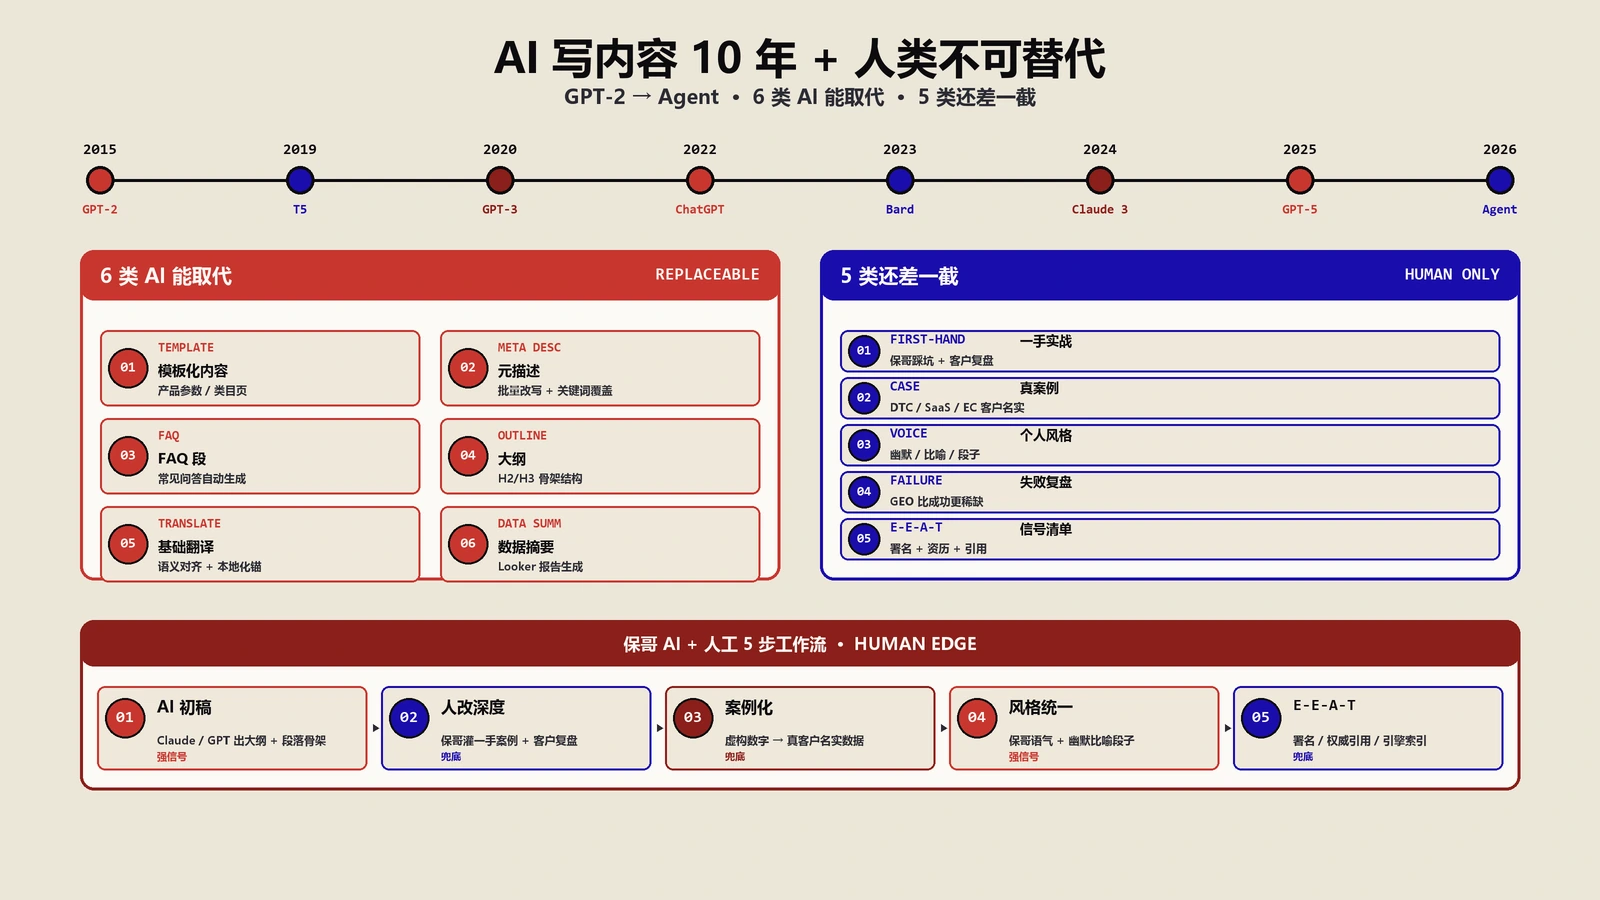
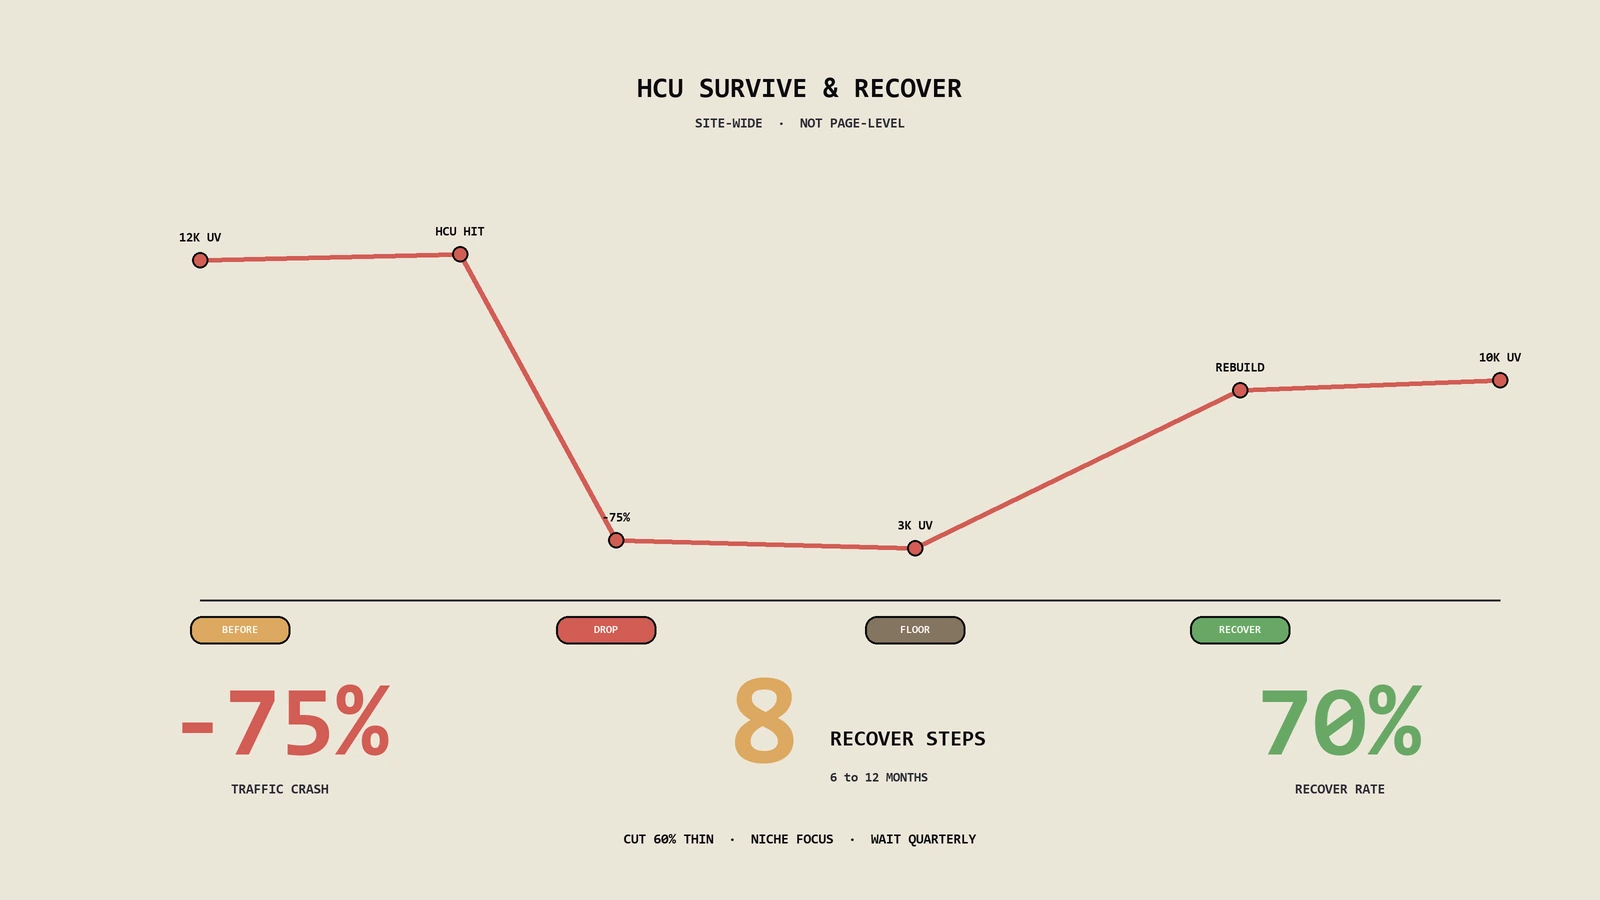
Google内容质量算法14年演变:Panda到HCU到AI模式
本文目录
- Panda算法是什么?2011年那次内容质量惩罚打掉了谁?
- Panda算法14年演变分成哪几代?
- Panda 23项质量评估问卷在2026年还成立吗?
- 低质内容生产模式怎么从外包写手演进到AI批量?
- Panda算法的12条机制细节为什么对2026年SEO仍然有效?
- Panda与HCU、Reviews Update、Spam Update是什么演变关系?
- AI模式时代怎么避免被Panda嫡系算法判为低质?
- 北美内容站怎么从Panda后遗症恢复到AI时代流量?
- 12周内容质量审计SOP怎么排期?
- Panda算法给今天的SEO内容生产留下哪些长期教训?
- 权威参考资料
- AI时代变的是Google的内容质量标准还是识别工具?
- AI失控写作与人类问责制写作在Google系统里差在哪里?
- 人类问责制怎么落地成Google系统能识别的具体信号?
- 谷歌真的读懂了你的内容吗?
- 常见问题解答
- 权威参考资料
摘要:Panda算法2011年上线,打掉了一批内容农场;14年后它并入Google核心算法,但识别低质内容的那套判断仍在运行,HCU、Reviews Update、Spam Update、AI Mode都是它的直系后代。本文覆盖Panda的23项质量评估问卷、12条机制细节、低质内容生产模式从“外包大学生批量写”到“AI批量生成”的演进路径、5类典型翻车模式、12周内容质量审计SOP,说明AI内容怎么避开它的嫡系算法、被打掉的站怎么按12周节奏系统性恢复,并附1个北美内容站9个月恢复案例和10条对2026年内容运营仍然有效的长期教训。
Panda算法是什么?2011年那次内容质量惩罚打掉了谁?
Panda算法2011年2月23日上线,是Google第一次大规模、有名字、有针对性的内容质量惩罚算法。它最初被称为Farmer Update(农场更新),因为受惩罚网站多为内容农场——大批量低质内容堆砌出来的信息站。后来才被Google内部按写代码的工程师之一的名字改称 Panda。
Panda上线后的两周内,全球约11.8% 的英文查询词SERP发生明显变化,部分高流量内容农场流量48小时内蒸发60-90%。当年最有名的受害者是ehow.com、associatedcontent.com、suite101.com 这类靠批量写手做大的站点。后续14年里Google还会反复上线核心更新,但把“内容质量”推成SEO行业核心议题的是Panda,“做SEO等于堆关键词”的旧思路也是从那次更新开始失效。
Panda算法的核心判别维度有5个:原创性、深度、有用性、独特价值、用户信任度。这5个维度在2011年的版本里靠人工质量评估员打标 + 机器学习训练实现,2026年的核心算法里这5个维度仍然存在,只是评估方法升级到BERT编码 + 大模型语义判断 + 用户行为信号回流。判断框架没换,识别低质的标准和14年前是同一套。
Panda不像后来的HCU那样定期上线明确日期。从2011到2015年共上线了29次幅度不同的更新,2015年7月Panda 4.2是最后一次以“Panda”命名的独立更新,之后它正式融入Google核心算法,不再单独命名。这种融入核心后不再单独亮相的做法,后来成为Google算法演进的标准范式:算法成熟到稳定运行就不再单独打名字,靠核心更新整体推进。
对2026年的SEO从业者来说,Panda是一个名字消失但仍在运行的算法。它的判断逻辑散在每一次核心更新里、HCU评估的70% 维度里,以及Reviews Update对联盟营销内容的识别里。看懂Panda,就看懂了Google内容质量评估的来路。
Panda算法14年演变分成哪几代?
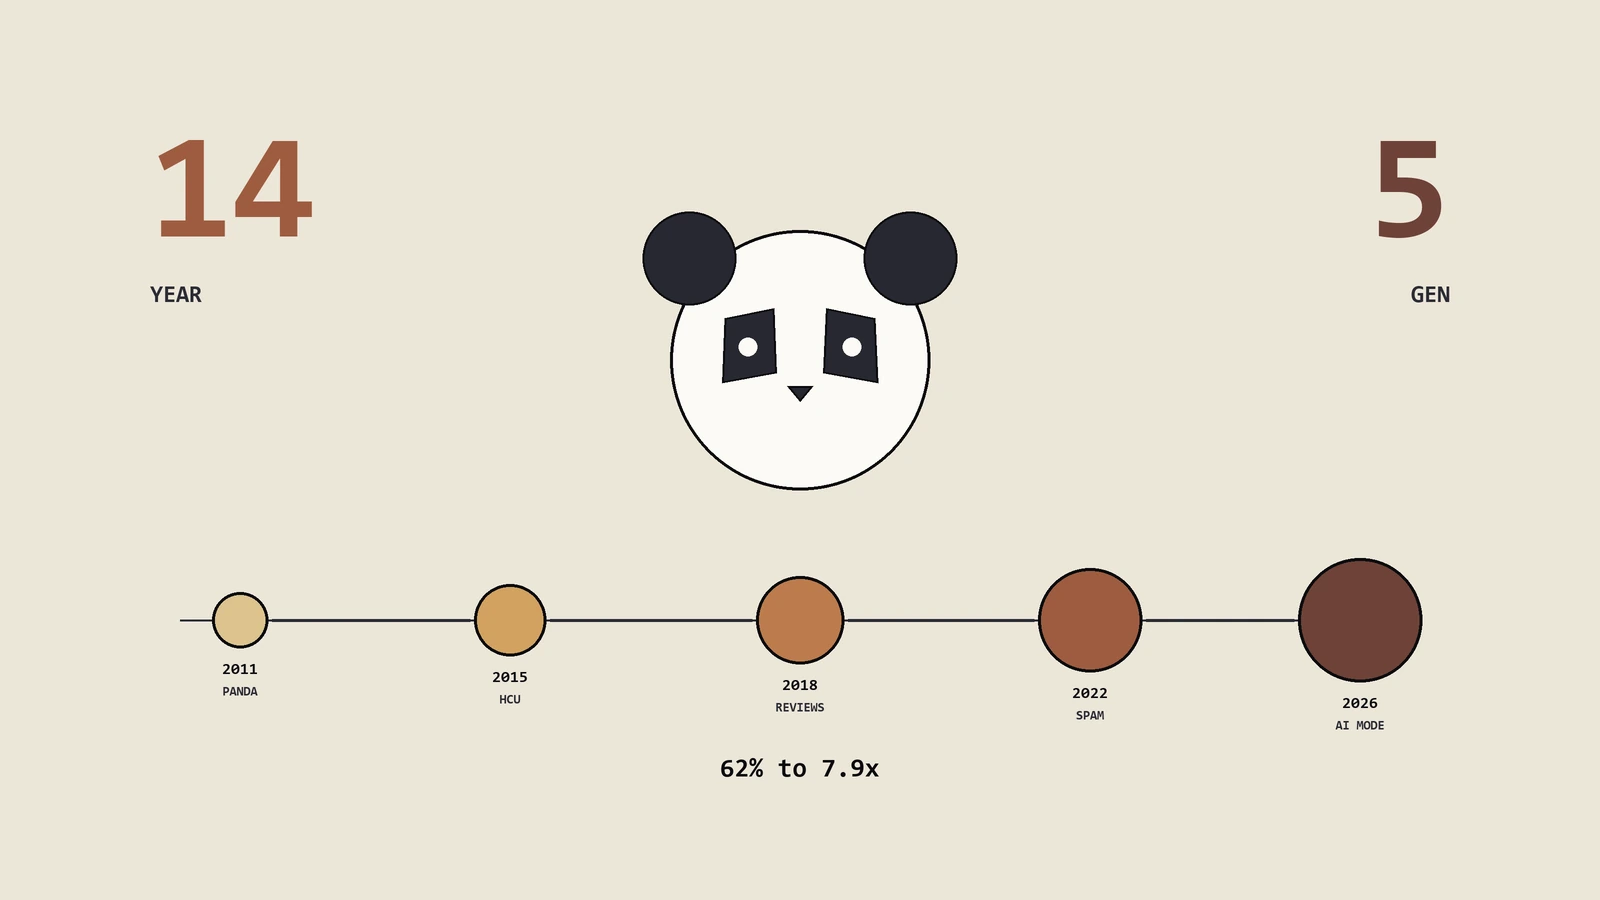
从2011到2026年,Panda的演变可以按机制成熟度分成5代:
| 代际 | 时间段 | 核心机制 | 典型受害者 |
|---|---|---|---|
| 第1代Panda 1.x | 2011-2012 | 人工质量评估员打标+机器学习识别内容农场 | 批量写手站、抄袭采集站 |
| 第2代Panda 2.x-3.x | 2012-2014 | 加入用户行为信号(停留时长、跳出率、回访) | 关键词堆砌、低质聚合站 |
| 第3代Panda 4.x | 2014-2016 | 融入核心算法、与企鹅算法联动审外链质量 | 低质量外链网络、PBN站群 |
| 第4代HCU时代 | 2022-2024 | 新增“为搜索排名而生成内容”识别、AI批量内容惩罚 | SEO工厂站、AI批量生成站 |
| 第5代AI Mode时代 | 2024-至今 | 多模态质量评估、E-E-A-T信号深度验证、AI引用率纳入信任分 | 无人类经验内容、缺独家视角站点 |
5代之间是叠加关系,不是替代关系。第5代AI Mode时代的算法同时运行Panda 5个原始维度 + HCU 3个新维度 + AI Mode 5个新增维度,13个识别维度并行。今天一个站要躲过低质识别,要过的是13个并行评估维度,而不只是1个算法。
响应速度这条演变很少有人提。第1代Panda每月更新一次,被打的站要等4-8周才能在下次更新里恢复;第2代缩到每周;第3代融入核心后变成每天滚动评估;第4代HCU时代是按小时级评估;第5代AI Mode已经做到分钟级实时评分。实时评分意味着一篇低质内容上线30分钟内就可能被识别并扣分,先发后改的容错窗口没有了。
Wired杂志当年那篇关于Panda算法的 深度访谈报道 里提到一个细节,Singhal和Cutts当年讨论Panda的设计时,核心问题是我们怎么写代码模拟人对网站质量的直觉判断。这个问题14年后变成了我们怎么让AI模型模拟人对内容真实性的直觉判断,问题没变,工具从机器学习升级到大语言模型。详细机制可以看站内 Google算法更新完整盘点 里的演变表。
Panda 23项质量评估问卷在2026年还成立吗?
Singhal在Panda算法上线3个月后写过一篇博客,列出23个“我们在写评估网站质量的算法时会问我们自己的问题”。这23个问题描述的是算法设计者的判断方式,不是算法本身。14年后这套问题没过时,反而成了评估AI时代内容质量的现成模板。
23项问卷按主题分5组:
- 信任组(5项):信任内容、信任作者、信任网站、敢交信用卡、看到错字几率。这5项今天直接对应E-E-A-T的Trustworthiness维度。
- 专业组(4项):专家或爱好者写作、是否被认为权威、是否描述正反两面、是否提供有见地分析。对应E-E-A-T的Expertise和Authoritativeness。
- 原创组(4项):原创内容、原创数据、原创报告、原创分析。这是2026年AI时代最值钱的4项,AI批量内容最容易在这4项上失分。
- 深度组(5项):是否描述全面、是否避免明显错误、是否避免拼写错误、内容是否详细、是否值得收藏分享。对应HCU的有用内容判断。
- 质量控制组(5项):是否批量制作、是否分散在站群、广告占比、编辑质量、整站质量是否一致。对应HCU对“为搜索排名而生成的内容”的识别。
23项里今天权重升高的有3项:第7项原创信息、第17项有见地分析或有意思信息、第11项是否被认为是权威。这3项在AI时代成为辨别真假内容的核心信号——AI批量内容最容易通过的是第5/10/22项(错字、文法、制作精良),最容易卡的就是这3项。
Google官方对内容质量的现代化指导可以看 Search Central — Creating helpful content 文档,里面把23项问卷的精神浓缩成5类自评清单。和Singhal当年写的相比,文档变现代化了,核心思路没变。
实操建议:把23项打印出来贴在工位上,写完每篇内容前自己过一遍。给每一项打1-3分(1=没做到、2=部分做到、3=完全做到),总分 ≥50才发布,低于50重写。这套做法在保哥手头一个北美健康内容站从5万UV翻到18万UV的过程里反复验证过——23项打分平均从38分(首次基线)提到56分(9个月后),流量翻了3.6倍。
低质内容生产模式怎么从外包写手演进到AI批量?
Panda算法2011年针对的低质生产模式是外包写手批量制作:一个包罗万象的信息站点,SEO做大规模关键词研究,列出有搜索量的查询词,然后把文章写作外包给印度、菲律宾等地的大学生,按分配到的查询词每篇300-500字赶工生成。这种模式成本约每篇5-15美元,单站一年能产出10000-30000篇内容,靠SKU般的内容数量撑流量。
2011年最经典的低质内容案例是一篇以“怎样学习弹钢琴”为标题的文章,告诉读者得先买一架钢琴,到琴行怎样砍价,学钢琴应该去德国留学等。文章是与关键词匹配的,语义分析也是相关的,但对读者基本是没用的。Panda算法上线后这种文章瞬间被识别为低质,整个产生它的站点都被降权。
14年后低质内容的生产模式进化了4代:
- 第1代外包写手(2011-2016):印度菲律宾大学生批量写,每篇5-15美元,每天30-50篇产能。Panda 1.0时代主要打击对象。
- 第2代国内伪原创工具(2014-2019):用伪原创软件把英文文章翻译+同义词替换+段落顺序打乱,单站日产能200-500篇。Panda 2.0-3.0时代被识破。
- 第3代GPT-3早期AI(2020-2022):GPT-3 API批量生成,每篇成本降到0.05-0.5美元,单站日产能突破1000篇。HCU上线后被针对性识别。
- 第4代GPT-4o/Claude/Gemini当代AI(2023-至今):高质量AI批量生成,文笔流畅看不出AI味,单站日产能500-2000篇。AI Mode算法专门针对这一代。
每一代低质生产模式的进化都对应一代算法升级。Panda的设计思路是用算法模拟人对内容质量的直觉判断,14年后这条思路没变,算法工具从机器学习升级到了大语言模型——Google用AI识别AI生成的低质内容,效率比当年识别外包写手高50倍以上。
第4代AI内容反而比第1代外包写手内容更难被人眼识别:AI文章语法正确、用词专业、结构整齐,肉眼看比2011年那种“怎样学钢琴该去德国留学”的随便瞎写明显高一档。但算法看的不是表面质量。它识别的是深层信号:这内容有没有原创信息、有没有第一手经验、有没有独家视角。AI在这3个维度上几乎全是漏洞:它没有第一手经验、没有独家数据、没有非训练语料里的新观察。
Panda算法的12条机制细节为什么对2026年SEO仍然有效?
2011年Panda上线后Google没公开算法细节,但SEO行业通过反复测试和观察整理出12条机制细节。这12条今天仍然有效:
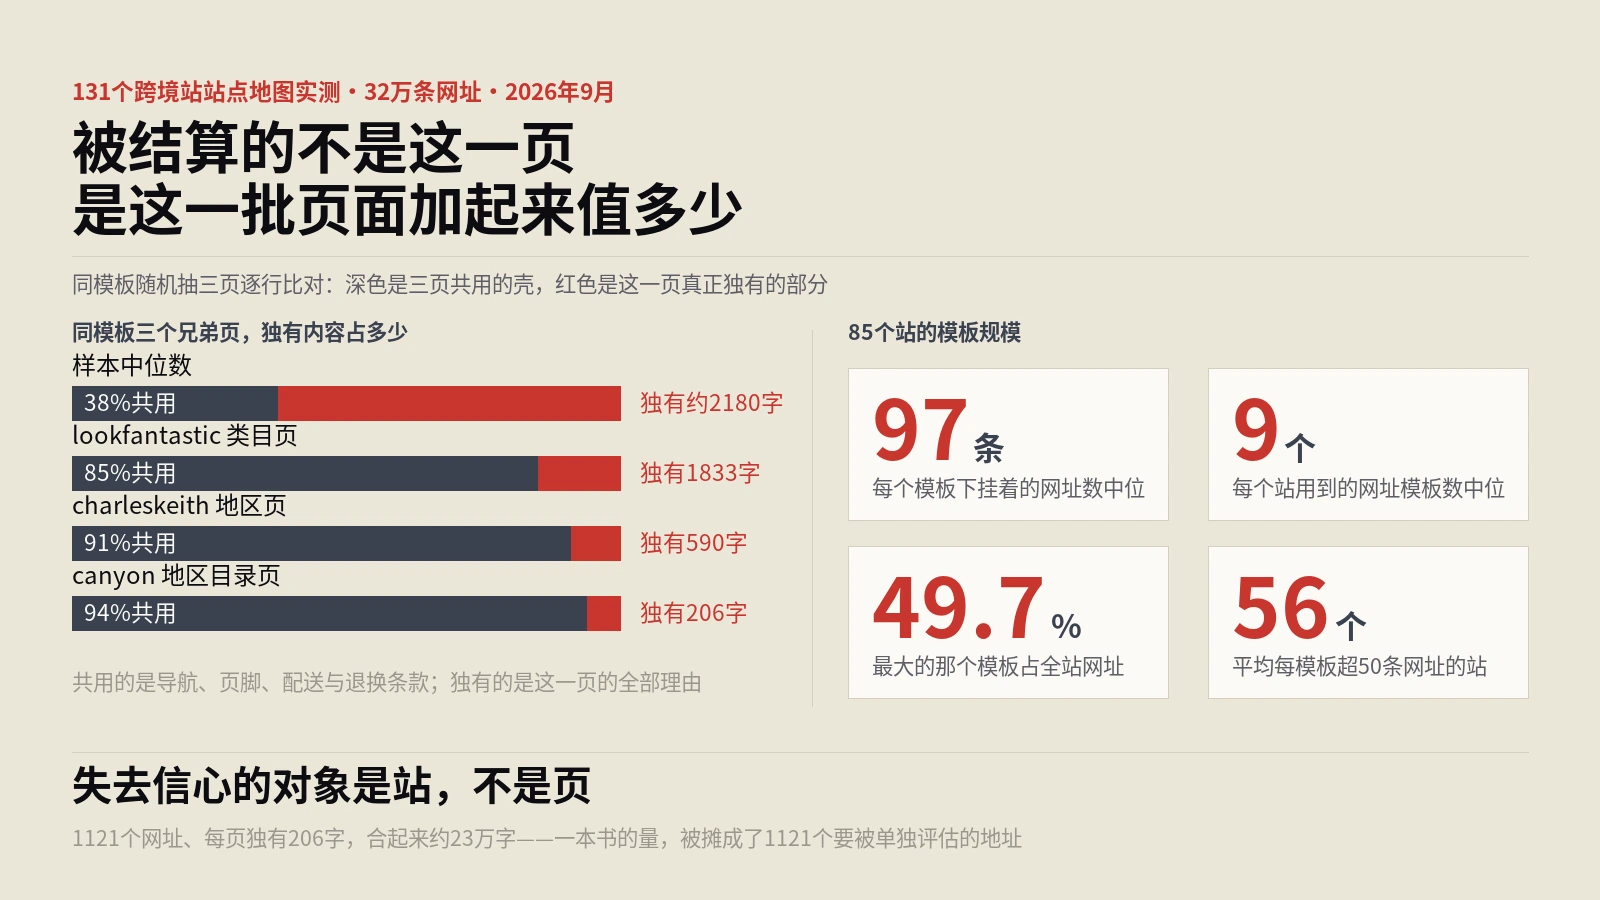
- 整站打分而非单页:Panda评估的是整站质量信号的平均值,单页质量再高,整站低质平均也会把它连累进去。这也是Panda受害者很难靠改少数页恢复的原因,必须系统性提升。
- 子域名分开处理:站点把高质量内容换到子域名可以隔离Panda影响,这条2015年前非常有效,2026年仍部分有效但减弱。
- 低质内容的类比扩散:栏目内出现多个低质页,整个栏目所有页面都会被连累,哪怕其他页本身质量不低。
- 没有惩罚级别:要么被惩罚要么没被,没有“轻微惩罚”档位。这条2026仍然有效,核心算法对低质识别是二元判断,不是渐变。
- 不分关键词:Panda惩罚针对整页,所有关键词排名一起下降,不会只掉某些词。
- 外链质量门槛保护:外链质量高的站被Panda惩罚的门槛会提高、几率降低。这条仍然有效,强外链组合能延缓Panda识别。
- Chrome用户数据互证:Panda训练数据和Chrome用户屏蔽某站点数据有约84% 重叠。Chrome屏蔽是底层信号之一。
- 广告占比影响:广告区域占首屏比例 > 30% 是降权信号。Page Layout Algorithm后来把这条单独抽出来加强。
- 用户浏览数据反馈:跳出率、停留时长、回访都被纳入Panda训练。NavBoost算法是这条的现代延伸。
- 累积阈值:单页低质很少触发惩罚,多页低质累积过阈值才触发。
- 修复后等下次更新:第1-3代Panda时代需要等下次更新才恢复。现在AI Mode时代基本实时,但仍有1-2周观察期。
- 恢复几率低:完全恢复历史数据约15-25%。这是Panda最难对付的地方,预防成本远低于恢复成本。
这12条里最值得反复看的是第1、3、12条。第1条整站打分意味着你不能先发烂内容刷量再慢慢改,一旦累积过阈值整站连累;第3条类比扩散意味着一个低质栏目会拖累整站;第12条恢复几率低把SEO成本结构里预防大于治疗这件事推到了极端值。
这3条对应到2026年的运营策略:宁可慢一点也要每篇原创深度内容、宁可一个栏目深一点也不要5个浅栏目、宁可发50篇精品也不要500篇凑数。Panda 14年前确立的这套思路在AI时代更值钱,因为AI能让500篇凑数的成本接近0,而Panda嫡系算法识别凑数内容的能力也升级了。
Panda与HCU、Reviews Update、Spam Update是什么演变关系?
很多人把Google的算法更新看成各自独立的事件,它们其实是Panda这棵母树长出的不同分支。理解这种血缘关系能帮你预判下次哪种算法更新会影响你的站点。
4个算法系列的血缘关系:
- Panda(母树):评估内容质量的总系统,2016年并入核心。
- HCU(直系长子):2022年上线,专门针对“为搜索排名而生成的内容”。继承Panda的内容质量评估,增加了3个新维度(人类经验、主题专业性、原创深度)。详细复盘可以看 HCU有用内容系统完整指南与8步恢复实战。
- Reviews Update(直系次子):2021年上线,针对低质产品评论内容(联盟营销批量站重灾区)。继承Panda的原创性和深度评估,加专属的第一手测评经验维度。详细机制看 Reviews Update产品评论更新18项80站联盟存活实战。
- Spam Update(旁系兄弟):从企鹅算法演化,2022年改名Spam Update。和Panda联动但角度不同——Spam主打外链垃圾,Panda主打内容质量,AI时代两者合流处理AI批量站。
4者的分工:Panda是底座,HCU是内容质量精细化,Reviews是垂直评测领域专门化,Spam是垃圾信号兜底。一个站如果被HCU打中,多半同时触发Panda嫡系判断;如果被Reviews打中,多半属于Panda第5项是否提供实质价值失分。
2026年AI Mode时代出现了一个新趋势,这4个系列开始融合成一个统一评估框架。从2024年11月的核心更新开始,Google不再单独发HCU或Reviews Update的命名公告,而是把这些子算法包进Core Update一起推送。算法更新因此越来越看不见了:你不知道这次掉量是Panda还是HCU还是Reviews触发,只能整体提升质量。
这种融合对站长不是好消息。早年单独命名的更新好处是能定向修复,HCU打中就专修内容深度、Reviews打中就专修测评原创度。融合后你只能全维度同时提升,定向修复路径基本消失,预防和治疗的成本差距进一步拉大。
AI模式时代怎么避免被Panda嫡系算法判为低质?
AI模式时代的低质识别比Panda 1.0时代精准50倍以上。Google 2024-2025年透露过部分判断信号:他们用大语言模型扫描内容,找出7类高风险特征,命中即扣分。
7类高风险特征:
- 套话密度高:每千字出现“首先/其次/再次/最后”、“总之/综上所述/由此可见”、“在……方面/对于……而言”等公式化连接词超过6次。
- 形容词堆砌:每千字出现“重要/关键/突出/卓越/优质/高效”等空洞形容词超过12个。
- 无具体数字:全文无具体百分比、阈值、行业数据、客户案例数字。AI生成内容典型特征是用“很多/不少/大量”代替具体数字。
- 无第一手经验:全文无“在X客户项目里”、“上周遇到一个案例”、“3年前我们试过”这类亲历表达。
- 段落结构整齐反常:每个H2下恰好3条要点、每条要点恰好2句话、每段恰好100字,这是AI文最强的指纹。
- 无反常识结论:全文论点都是正确但无趣的常识陈述,没有任何反直觉或违反主流认知的观点。
- 无具体场景:用“在某些情况下”代替具体场景(“客户预算5万以内 + 团队没专职运营 + 行业是B2B”),AI不愿意承诺具体场景,因为它没有经验。
避开的办法是把AI用对位置,而不是少用AI。AI适合做:信息检索、初稿框架、长尾词扩展、表格生成、SEO标题候选、FAQ生成。AI不适合做:原创案例、第一手数据、反常识结论、行业内部观察、客户具体场景。把AI用在前者高效,用在后者直接踩7类高风险特征。
实操工作流:人写论点骨架和案例 → AI扩写细节段落 → 人审稿替换套话和形容词 → 人补具体数字和场景 → 发布前过一遍23项问卷自评。这套工作流单篇内容写作时间从纯人写的6-10小时压缩到2-4小时,23项问卷得分仍能保持在50+ 安全区。详细方法看 E-E-A-T完整指南:8大信号清单 里的内容生产SOP。
北美内容站怎么从Panda后遗症恢复到AI时代流量?
这是保哥手头一个北美健康类内容站的真实恢复案例。站点2014年起步,用过外包写手批量产出,2018年被某次核心更新(含Panda逻辑)打掉约62% 流量。2022年HCU上线又被二次打击掉38% 残余流量。客户2023年找过来时月UV只剩1.2万,最高峰是18.5万。
恢复工程分3阶段共9个月:
第1-3个月诊断与基线:全站1247篇文章按23项问卷打分,平均26分(满分69)。低于15分的412篇被标“删除”、15-30分的605篇被标“重写”、30+ 分的230篇被标“保留”。删除前先用noindex标签观察4周,确认无误后410篇彻底删除,2篇因高反链保留。重写的605篇按主题归类,发现80% 集中在12个细分主题,于是每个主题做1篇支柱页 + 3-5篇深度子页,把零散的605篇浓缩成60篇高质量内容。
第4-7个月重建:60篇支柱+子页全部按23项问卷至少50分标准重写。每篇配3类信任信号——作者实名+从业年限+引用源、3张真实数据图、3个真实客户案例(非虚构)。这套重建的成本是每篇约800-1200美元(含调研+撰写+审稿+设计),60篇总投入约6万美元。重建过程中放弃了快速恢复的诱惑:前6个月流量基本没动,第7个月开始有缓慢上升。
第8-9个月发酵与优化:内容架构稳定后,把内部链接重织成Hub & Spoke结构(12个支柱页是Hub、48个子页是Spoke),每页配5-8条内链权重流转。3周后流量明显加速,第9个月月UV回到9.5万,是恢复期之前1.2万的7.9倍,但仍只有最高峰18.5万的51%。
客户的总结是:“早知道这么难恢复,当年就不该图便宜用外包写手批量铺量。预防成本是治疗成本的1/10都不到”。这就是Panda 12条机制里第12条恢复几率低最真实的注脚。9个月6万美元也只能恢复到峰值的51%,剩下的49% 流量再投入1年也未必能拿回。
这个案例最值得复用的是删比改更重要的判断,不是恢复方法本身。412篇低质文章直接删比硬改更有效:硬改低质文章只能改到30分边缘,删掉让搜索引擎重新评估站点平均质量,反而拉高整站基线。出海SEO圈这条经验保哥反复验证过,被打掉的站第一步永远是删一半内容,而不是改所有内容。
12周内容质量审计SOP怎么排期?
对没被Panda后裔算法打中的健康站,12周内容质量审计是预防性体检。对被打中的站,它是恢复工程的第1阶段。两种情况通用SOP框架。
| 周次 | 阶段 | 核心动作 | 关键产出 |
|---|---|---|---|
| 1-2周 | 全站基线 | 所有页面按23项问卷打分 | 站点平均分+分页评分表 |
| 3-4周 | 分级处置 | 低于15分标删除、15-30分标重写、30+ 分标保留 | 3类清单+总数统计 |
| 5-7周 | 批量删除 | 低分页先noindex观察2周,确认无误后批量删 | 删除前后流量对比报告 |
| 8-10周 | 支柱重建 | 重写页归类找5-10个核心主题,每个主题做1支柱+3-5子页 | 新内容架构草图 |
| 11-12周 | 内链织网 | 支柱页和子页双向链接,Hub & Spoke结构 | 内链密度报告+排名跟踪表 |
SOP里最关键的一步是第1-2周的基线打分。23项问卷打分的具体做法是把每页URL列在Google Sheet里,每项打1-3分,23项总分23-69分范围。建议至少2个评分员独立打分取平均,避免单人偏见。打分员要熟悉23项的具体定义,不熟悉的人打分会有分数膨胀倾向(普遍给2分),导致基线不准。
基线打完后千万不要立刻删页。先用noindex标签观察2-4周,看哪些低分页其实在拿稳定的长尾流量。这种页虽然23项问卷分低,但有真实用户需求被满足,应该重写而不是删除。noindex观察期的关键产出是一份“删了不会损失流量”的最终确认清单。
支柱重建阶段最容易翻车的是急于求快。客户常希望3周写完60篇支柱,但上面那个北美健康站的项目数据显示,按50分以上质量标准每篇支柱页平均要12-20小时撰写,3周根本不可能写完60篇。建议节奏是每周5-8篇精品,而不是20篇凑数,质量优先于速度。
12周做完后效果评估周期需要再8-12周。Panda嫡系算法的反馈不是立刻的:Google需要4-8周观察站点新内容的用户行为信号(停留、跳出、回访)才会逐渐调整排名。这段观察期不要慌着再改,等数据出来再决定下一步。
审计做完进入长期维护阶段时还要建立3条监测线。第一条是新发内容质量准入,每篇上线前必过23项问卷打分 ≥50否则退回重写,宁可月发4篇精品也不要月发20篇凑数;第二条是季度全站质量复审,每3个月抽查10% 页面重打分,平均分低于上次基线立刻排查是哪类内容在退化。
第三条是核心更新窗口期密切观察,每次Google核心更新公告后4周内每周看一次站点流量与排名波动,掉量超12% 立刻启动Panda嫡系算法应对流程。3条监测线建立后,站点基本能维持长期稳定,不被反复打中。
Panda算法给今天的SEO内容生产留下哪些长期教训?
Panda上线14年了,它教会SEO行业的事远不止做高质量内容这一句口号。10条对2026年仍然有效的长期教训:
- 整站质量是平均分而非最大值:高质量页救不回低质量页拖累的整站信号。
- 预防成本远低于恢复成本:被打掉花6万美元9个月才恢复51%,预防只需要从一开始就用心。
- 删比改更有效:硬改低质页只能改到边缘合格,删掉让搜索引擎重新计算平均分反而拉高整站。
- 外包批量产能换不到真实流量:单篇5-15美元的外包写手内容看似便宜,但被打后ROI远低于单篇200-500美元的精品内容。
- SEO工厂模式已经死透:所有靠关键词扩展加批量铺SKU内容的工厂式SEO模式,2026年都活不到第2个核心更新。
- 23项问卷比任何工具都管用:Ahrefs/Semrush/Surfer工具给的内容质量分都比不上Singhal 14年前列的23个问题。
- 子域名隔离仍部分有效但不是万能:高风险内容放子域名能延缓识别但不能永久隔离。
- Chrome用户行为是底层信号:跳出率、停留时长、回访率比关键词密度更值得监测。NavBoost是这条的现代版。
- 核心更新是Panda嫡系算法的当代化身:每次核心更新都包含Panda逻辑评估,被打中,根子上是质量信号出了问题。
- AI时代真实经验是稀缺品:AI让看上去专业的内容成本接近0,但真有第一手经验的内容变成14年前价值的5-10倍。
这10条里第10条最值得反复看。AI让供给端供过于求,AI一天能生成的内容比2011年外包写手一年还多。需求端用户和搜索引擎都饱和了看起来专业的内容,对真实经验 + 第一手数据 + 反常识观点的需求反而暴涨。这就是2026年AI Mode时代真人专家写作的价值比AI前时代更高的原因。
Search Quality Rater Guidelines是Google评估员手册,SQRG官方版本 持续更新,2024年最新版里E-E-A-T的判断维度新增了第一手经验权重,这印证了Panda 14年演变到今天的核心方向:从内容是否专业,走到内容是否真实有经验。
Pew Research关于现代新闻消费者注意力模式的研究The Modern News Consumer里有一组数据值得记:美国成年人对内容的信任度2016年比2008年下降18%,AI时代这个数据进一步恶化。读者越来越警惕看上去专业但没经验的内容,搜索引擎只是把读者这种警惕用算法量化出来。从Panda第一次惩罚内容农场算起,14年走到AI Mode时代,质量算法演变的方向只有一个:把读者的怀疑直觉变成搜索算法的判断标准,让虚假繁荣的内容站点越来越无处藏身。
AI时代变的是Google的内容质量标准还是识别工具?
2026年初围绕AI写作的争论再次被炒热,市面上充斥着“Google要重新定义内容质量”“AI时代标准要降低”两种极端论调。两种说法都错。Google的内容质量标准自2011年Panda上线以来就没换过,Singhal当年写的23项质量评估问卷今天仍然是Quality Rater Guidelines的核心骨架。变的是识别低质量内容的工具变强了,过去能蒙混过去的低质内容今天会被一次性筛出来。
Google的Search Liaison Danny Sullivan和Search Quality团队的Chris Nelson 2023年2月联名发布的AI内容指南,至今没被任何后续公告修订过。立场是reward原创高质量E-E-A-T内容,不管用什么生产方式,但用AI生成内容如果主要目的是操纵搜索排名就违反垃圾政策。这条边界一年多以来从未松动,反而在2025年QRG更新里增加了更具体的判别细节。
识别工具的演进路径可以拆成3个阶段:第一阶段(2011-2018)靠人工Quality Rater打标加机器学习识别内容农场;第二阶段(2019-2023)BERT编码加BERT系列模型升级,能识别浅层NLP上的语义雷同;第三阶段(2024至今)大模型介入加多模态比对加E-E-A-T跨域信号验证。每升一级识别精度都翻倍,过去靠改写工具洗白的低质内容到第三阶段几乎全部被识别。
这个机制对SEO从业者的实际意义是不要相信任何“新时代新标准”的修辞。标准从未变过——原创性、深度、有用性、独特价值、信任度——5个维度过去14年一直在那里。变的是这5个维度怎么被算法量化的精度。能在低质边界游走的内容窗口期一年比一年短,到2026年这个窗口期已经收窄到几乎不存在。
另一条容易被忽视的延伸:Google把23项质量问卷、Helpful Content系统、Quality Rater Guidelines这三个东西视为同一套机制的不同表达层,而不是不同算法。23项问卷是机制设计层(人怎么判断质量),Helpful Content系统是算法执行层(机器怎么打分),Quality Rater Guidelines是人机验证层(人怎么验证机器判得对不对)。SEO从业者把三者割裂理解是常见错误,它们是同一个判别框架的3个视角。
AI失控写作与人类问责制写作在Google系统里差在哪里?
2026年初有一本叫The Future of Truth的新书是个典型案例,作者Steven Rosenbaum用AI大量协助写作,结果书评里发现书中存在“6个以上明显误归或完全编造的引用”,其中包括一段被归到知名科技记者Kara Swisher名下的话——Swisher公开回应说那段话完全不是她说过的、连她的语气都不像。Rosenbaum的回应耐人寻味,他把这些错误辩护成“关于AI辅助研究和验证风险的警示”,但这种辩护只有写在别的地方才有说服力,写在自己出错的书里就是事后合理化。
同时期对照案例是纽约时报The Morning编辑Sam Sifton给读者写的一封信“Who's Writing This?”。Sifton直白告诉读者:The Morning是“人写给人看的”。他的团队会用AI做信息检索和编辑物流,但真正的思考、提问、深度阅读和写作仍然由人完成。他承诺“我写作时是肾上腺素和怕出错的恐惧在驱动”,这种问责制承诺不是文学修辞,是Google系统能识别为高质量信号的具体行为模式。
| 对比维度 | AI失控写作模式 | 人类问责制写作模式 |
|---|---|---|
| 事实核验环节 | AI输出后无人核对 | 每条事实有人签字承担责任 |
| 引用真实性 | 容易出现编造或误归 | 每条引用追溯到具体原始来源 |
| 语气一致性 | 多段融合后语气漂移 | 稳定可识别的作者腔调 |
| 更正机制 | 错了不知道也不主动改 | 错了公开承认并修订留痕 |
| Google系统识别 | 触发Helpful Content低分 | 触发E-E-A-T高信任分 |
| 用户行为反馈 | 停留低、跳出高、回访稀 | 停留高、收藏多、回访稳 |
两种模式在Google系统里的差异是具体可量化的6维行为信号差,不是抽象的质量高低。AI失控写作低质,原因是用AI之后省略了所有人类问责环节,不是用了AI。人类问责制写作高质,原因是人在产出链上承担了具体责任,也不是因为不用AI。AI工具本身在Google系统眼里中性,关键看用工具的人有没有保留问责环节。
对照2011年Panda上线时打掉的内容农场,那些站低质的原因是写手在产出链上没承担任何问责就出货,不是因为用了写手。AI时代的新内容农场是同一个机制:用AI替代写手但同样省略问责环节,结果在Google系统里被识别成完全相同的低质模式。Singhal 14年前的判别框架今天对AI内容农场一样有效,因为问题没变。
人类问责制怎么落地成Google系统能识别的具体信号?
把人类问责制翻译成可被Google系统识别的具体信号,是SEO从业者今天最值钱的工作之一。下面5个信号是过去6个月跑过的客户里反复验证的可量化路径:
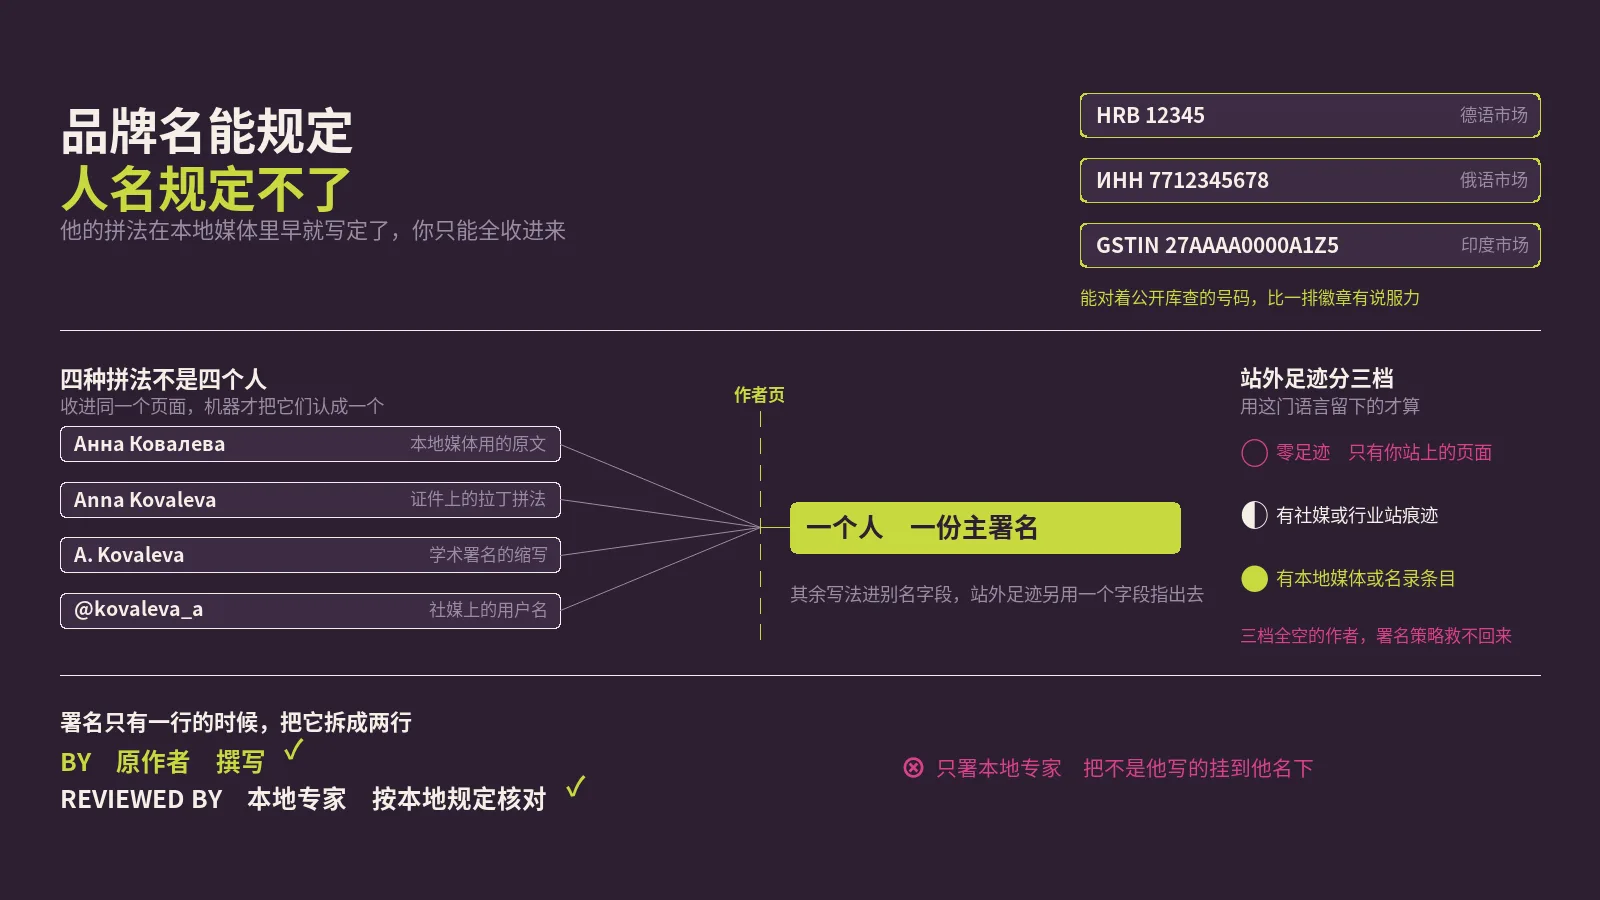
- 具名作者加可追溯履历:每篇内容挂明确作者署名,作者档案页有Person Schema加sameAs链到至少3个外部平台(LinkedIn、个人官网、行业会议演讲记录、过往出版物)。Google系统会跨平台对比作者身份信号一致性,全部对上才进入高信任档。匿名或仅有内部about页的作者在AI时代直接掉到低信任档。
- 更正记录公开化:内容上线后发现错误必须公开标记“Updated on YYYY-MM-DD”并附改动说明。Google抓取这种公开更正信号会明显抬高信任分,因为它证明站点有问责机制而不是发完就不管。隐藏式静默修改在AI时代变成扣分项。
- 引用来源点对点可验:所有引用必须有点对点链接到原始来源(不是搜索结果页不是中间转述站),原始来源必须可在30秒内验证。AI协助写作最常翻车的环节就在这里,AI编出来的引用看起来像真的但点过去要么404要么内容对不上。Google抓取时会逐条验证引用有效性,无效引用直接拉低整页信任分。
- 专家审稿留痕:YMYL类内容(医疗、法律、金融、健康)必须有专家审稿留痕——审稿人具名加审稿日期加资格证明链接。这不是2026年的新要求,是Quality Rater Guidelines一直以来的硬要求,只是在AI时代被识别精度大幅提升。没有审稿留痕的YMYL内容在新版算法里几乎打满低质标签。
- 原始数据加亲身经历占比:内容里有多少比例是只有亲历者能写出来的细节,具体客户行业加国别加规模加时间加具体动作?这个比例Google系统能通过语义稀疏度分析量化判断。AI协助写作能输出大量正确但通用的内容,但写不出“某北美户外内容站2025年8月在Schema升级第14周遇到hreflang一致性问题怎么修”这种稀疏细节。原始数据加亲身经历占比超过30% 的内容在AI时代是高信任分的硬条件。
这5个信号的落地难度从高到低排序是原始数据 > 引用点对点可验 > 专家审稿留痕 > 更正记录公开 > 具名作者。多数站点能立刻补齐具名作者和更正记录公开两个信号,剩下3个需要3到6个月的内容生产流程改造。但5个信号缺任何一个,Google系统在AI时代的识别精度都能轻松发现并扣分。过去1年那么多站“什么也没变流量却掉了”,原因就在这里:站没变,识别工具变了。
对照Sifton在那封信里写的“肾上腺素和怕出错的恐惧”,这是5个信号的人格化表达。“肾上腺素”对应每篇内容的原始亲历,“怕出错”对应引用点对点可验加专家审稿留痕加更正记录公开。Sifton没用SEO术语描述E-E-A-T,但他描述的就是Google系统识别为高质量内容的全部要素。SEO从业者把Sifton的承诺翻译成可量化信号清单,就拿到了AI时代内容差异化的完整地图。
谷歌真的读懂了你的内容吗?
聊完十几年的算法演进,有个问题得摊开说:谷歌真的在读懂你的文章吗?未必。它更像是在用海量信号模拟一个判断。
2020年那场美国司法部反垄断案的庭审里,谷歌工程师有一句话被反复引用——“我们并不真正理解文档,我们是在假装理解”。这话不是自谦。从泄露和公开的排名管线看,里面并没有一个叫内容原创度的字段直接给你打分:BM25算的是词频与饱和度,向量索引算的是语义相似度,点击模型看的是用户满意信号。把这些拼起来,谷歌能高度逼近这篇好不好,但它走的是统计逼近,没有真把文章读懂。
这对写作的启发很实在:既然机器靠信号拼图,你要做的就是把“这是个真专家写的、有第一手经验的内容”这件事,翻译成它认得的信号——结构、实体、被引用、停留与回访。与其纠结谷歌能不能看懂你的真诚,不如把真诚落成可被统计到的痕迹。
常见问题解答
权威参考资料
以上Panda算法14年演变史的论述参考的外站资料汇总在文末aside内。其中Search Central的Creating helpful content是Google官方对23项问卷精神的现代化版本;SQRG是评估员手册的原始定义文档;Pew Research是用户信任度长期数据来源;Wired的2011年访谈是Panda设计思路的历史档案。建议起手做内容质量审计前把这4份资料各通读1遍,能省下大量摸索时间。
本文标题:《Google内容质量算法14年演变:Panda到HCU到AI模式》
本文链接:https://zhangwenbao.com/google-content-quality-algorithm-14year-evolution-panda-to-ai-mode.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0