Google核心更新预测96.8%可信吗?熊猫式质量更新来之前,外贸站该先查什么
本文目录
- 96.8%这个数是谁算的,算的又是什么?
- 他预测的“更新”包括没人确认的波动
- 90天的概率比30天还低,这在数学上说不通
- 模型没有公开,没法复现
- 拿Google状态面板的记录对一对
- 两个核心更新之间隔多久
- 不加任何模型,随便挑一段时间会撞上几次更新
- 感恩节前收工、12月很少有核心更新,这两条记录不支持
- 熊猫算法当年到底在打什么?
- 为什么大家会把熊猫读成字数门槛?
- Google这个月改的两份文档,和熊猫的问题清单像在哪?
- AI内容指南加了一句“必须人工核查”
- 有用内容指南新增了主要内容的定义和四个评估属性
- Gary Illyes在巴塞罗那的那句话
- 真来了,是打整个网站还是只打单页?
- 外贸站和独立站这几周该做什么?
- 先清点批量生成的页面
- 查一遍作者页
- 把元数据也纳入人工审核
- 先把对比基线存好
- 跟老板怎么说
- 这份预测最后能信几成?
- 常见问题解答
- Google官方说过近期会有熊猫式更新吗?
- 熊猫算法现在还单独存在吗?
- 页面字数少会被熊猫式更新惩罚吗?
- 用AI写内容会不会在下次更新里被打?
- 核心更新期间排名下跌,应该马上改页面吗?
- 网站只有少量AI生成页面,会拖累全站吗?
- 权威参考资料
摘要:把Google搜索状态面板2023年以来的公开记录摊开看。随便挑一个90天,里面有至少一次官方确认更新的概率是90.4%,和这份预测给出的90天90.9%几乎一样。更有信息量的是另一组数字:核心更新间隔拖过147天的情况以前出现过4次,其中3次在之后30天内就来了新的核心更新。样本只有4个,能说明的是“该来了”,说明不了会不会是一次熊猫式的质量清算。
这几天不少SEO负责人的工作群里都转着同一张截图:96.8%,一个月内Google会有一次熊猫式更新。老板看完只问一句:我们会不会被打?
截图出自Search Engine Journal 10月15日刊出的专栏《96.8% Chance Of A Panda-Style Update Within A Month According To Prediction Model Signals》,作者Dan Taylor是英国代理商10 Spurs的创新与咨询负责人。文章讲了三件事:熊猫算法当年被误读成字数标准,他自建的预测模型给出的概率,以及Google最近几次文档改动指向哪里。下面按他的思路走一遍,每个能核的数字都拿Google的原始记录对了一下,对不上的地方直接写出来,最后落到外贸站和独立站这几周该做什么。
96.8%这个数是谁算的,算的又是什么?
先说清楚来历:这是Dan Taylor个人搭的模型,Google没有发布过任何更新预告。Google的核心更新一向是上线当天才在状态面板和社交账号上说一声,事前从不打招呼。
按他文中的描述,模型吃两类信号:
- 宏观的时间规律,比如距上次更新过了多少天、季节因素、历年更新的间隔。
- 眼前的微观波动,比如排名数据里的统计异常,以及X、Reddit和行业网站上关于更新的讨论热度。
这些信号喂进一个梯度提升决策树模型,用25年的Google更新历史去训练,输出未来几天出现更新的校准概率。结论是:从10月13日算起,30天内出现更新的概率96.8%,90天内90.9%。
这里有三处要先说清,不然这个数很容易被读歪。
他预测的“更新”包括没人确认的波动
文中原话是模型输出的概率针对“未经确认的波动或官方推送”。这样一来,排名工具上某天曲线一抖、论坛里一堆人喊掉量,按这个口径就可能算一次命中。可标题写的是“熊猫式更新”,正文里又写成“一次Google更新”,三个说法指的范围差得很远。读者看到96.8%,脑子里想的是一次大规模质量清算,模型算的却可能只是“未来一个月排名会动”。说实话,排名一个月不动才是新闻。
90天的概率比30天还低,这在数学上说不通
“30天内发生”是“90天内发生”的子集,前者的概率不可能高于后者。96.8%和90.9%并排写,要么两个数用的不是同一个口径,要么其中一个标注有误。文中给90.9%加了个括号写着置信度,也没解释置信度和概率是什么关系。小标题里还有一个“10月下旬到11月中旬约90%到96%”的区间,三组数放在一起,读者没法知道哪个才是模型真正的输出。
模型没有公开,没法复现
训练数据怎么标注、未确认的波动怎么定义、回测成绩如何,文中都没给。没有回测,就没法知道这个模型过去喊“96%”的时候有几次真的来了。这一点不怪作者,专栏文章本来也不是论文,只是转发截图的人要心里有数:这是一个从业者的个人判断,包了一层模型的外衣。
另外,Dan Taylor今年3月在SEJ写过一篇《Are We Due Another Florida-Style Update?》,讨论会不会再来一次佛罗里达式的大洗牌。编辑按语说那篇写在3月24日那次更新之前几天。对一下状态面板,3月24日开始的是3月垃圾更新,3月核心更新是27日开始的。那之后核心更新来了,可也没出现佛罗里达那样一夜重排的场面。
拿Google状态面板的记录对一对
好在Google自己留着一份公开记录。Google搜索状态面板的排名历史页列出了每一次官方确认的排名更新、开始日期和持续时长。下面这张表只摘核心更新。
| 年份 | 核心更新开始日期 | 当年次数 |
|---|---|---|
| 2022 | 5月25日、9月12日 | 2 |
| 2023 | 3月15日、8月22日、10月5日、11月2日 | 4 |
| 2024 | 3月5日、8月15日、11月11日、12月12日 | 4 |
| 2025 | 3月13日、6月30日、12月11日 | 3 |
| 2026(截至10月20日) | 3月27日、5月21日 | 2 |
Dan Taylor说Google一年通常做三到四次核心更新,2023到2025年确实是4、4、3次,这句没毛病。2022年只有两次,说明“三到四次”是近几年的习惯,Google没承诺过频率。
他说5月以后再没有过广泛核心更新,8月和9月是针对性的垃圾更新,这也对得上。2026年状态面板上还有一次6月24日开始的6月垃圾更新,他没提,不影响结论。
两个核心更新之间隔多久
把相邻两次核心更新的开始日期相减,2022年以来一共14个间隔:短的28天(2023年10月到11月),长的184天(2022年9月到2023年3月)。到SEJ这篇发出的10月15日,距5月21日已经147天;到本文发布这天是155天。
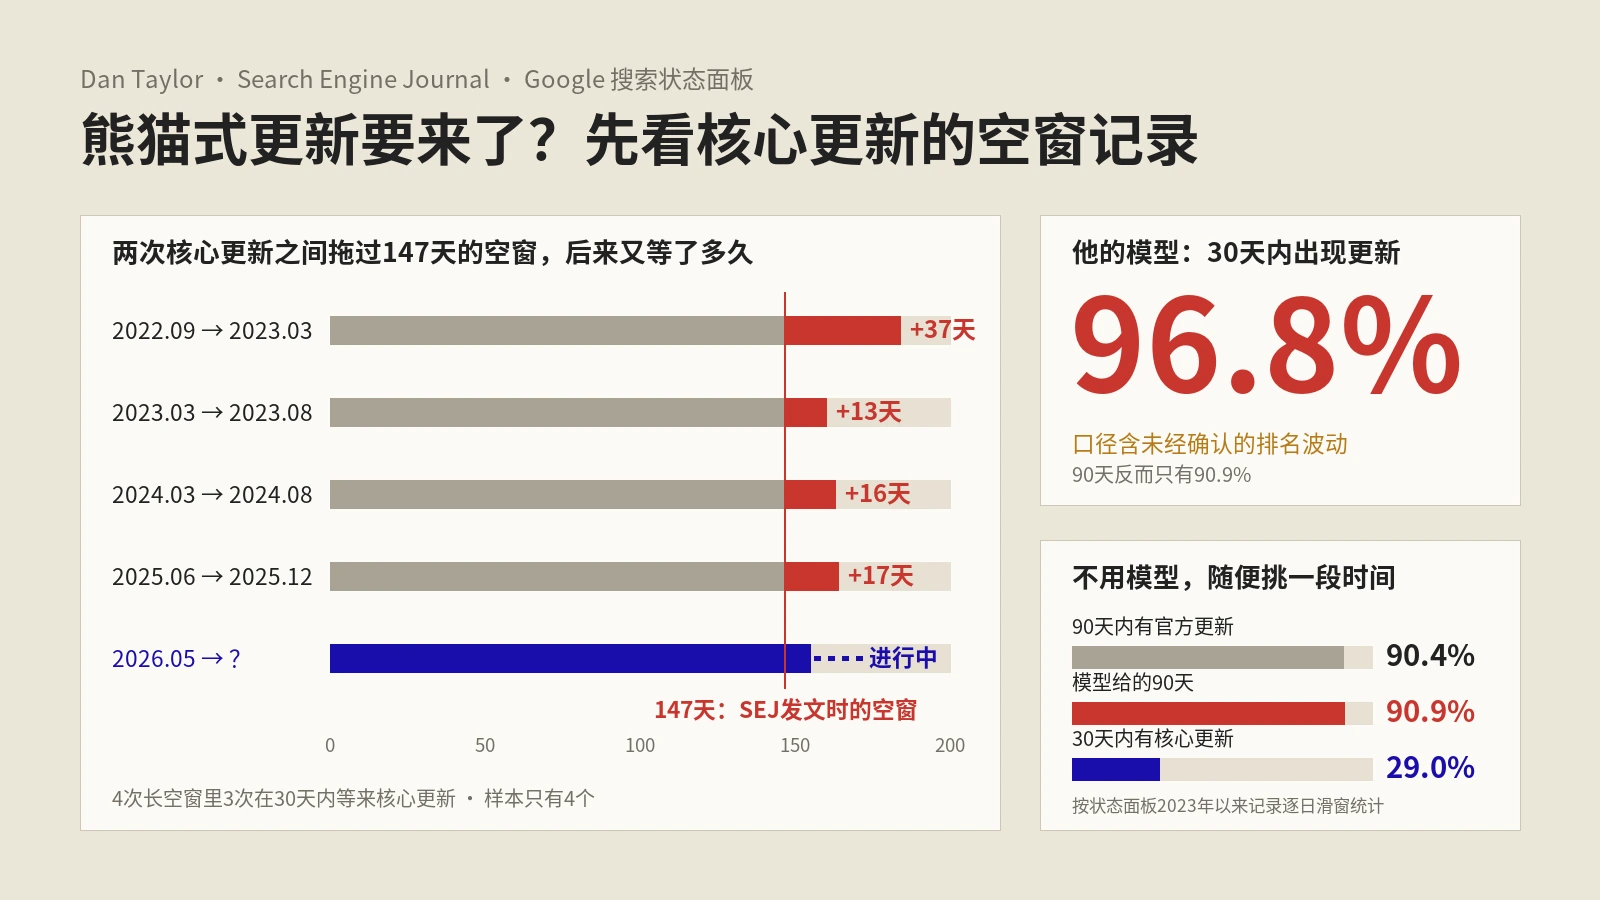
147天不算破纪录。历史上超过147天的间隔有4个:184天、160天、163天、164天。换个问法更有意思:每次间隔拖到147天之后,下一次核心更新又等了多久?
| 那次空窗 | 总间隔 | 过了147天后还等了几天 |
|---|---|---|
| 2022年9月12日到2023年3月15日 | 184天 | 37天 |
| 2023年3月15日到8月22日 | 160天 | 13天 |
| 2024年3月5日到8月15日 | 163天 | 16天 |
| 2025年6月30日到12月11日 | 164天 | 17天 |
4次里有3次在30天内等来了核心更新。这是支持Dan Taylor判断的证据,只是样本只有4个,拿它算概率太勉强,当成“按以往节奏该来了”的旁证比较合适。
不加任何模型,随便挑一段时间会撞上几次更新
再看基础概率。用状态面板上2023年1月以来的全部官方确认更新(核心、垃圾、有用内容、评论、Discover等都算),按天滑动一个窗口去数:
| 窗口里至少出现一次 | 30天窗口 | 90天窗口 |
|---|---|---|
| 核心更新 | 29.0% | 74.3% |
| 任何官方确认的排名更新 | 46.7% | 90.4% |
90天窗口里撞上一次官方更新的概率本来就是90.4%,模型给的90.9%和它几乎重合,90天这个预测加不加模型,结果都差不多。明显高出基础概率的是30天的96.8%,可它偏偏把未确认的波动也算了进去,这两个数没法放在同一个口径下比。
再把每年10月13日往后的90天拎出来看:2022年有10月19日的垃圾更新和12月的两次更新;2023年有11月2日的核心更新和11月8日的评论更新;2024年有11月11日、12月12日两次核心更新和12月19日的垃圾更新;2025年只有12月11日的核心更新。四年里每年这段时间都有官方更新,30天内来核心更新的是2023和2024两年。
感恩节前收工、12月很少有核心更新,这两条记录不支持
Dan Taylor把10月下旬到11月中旬叫作“黄金窗口”,理由是9月垃圾更新推完之后,Google有三到四周的时间推一次核心更新,并在感恩节和黑色星期五之前完成。12月他只给了约15%,说那时候一般只有轻量的链接或垃圾更新,因为节日购物季前有代码冻结。
这几条和面板记录都有出入。
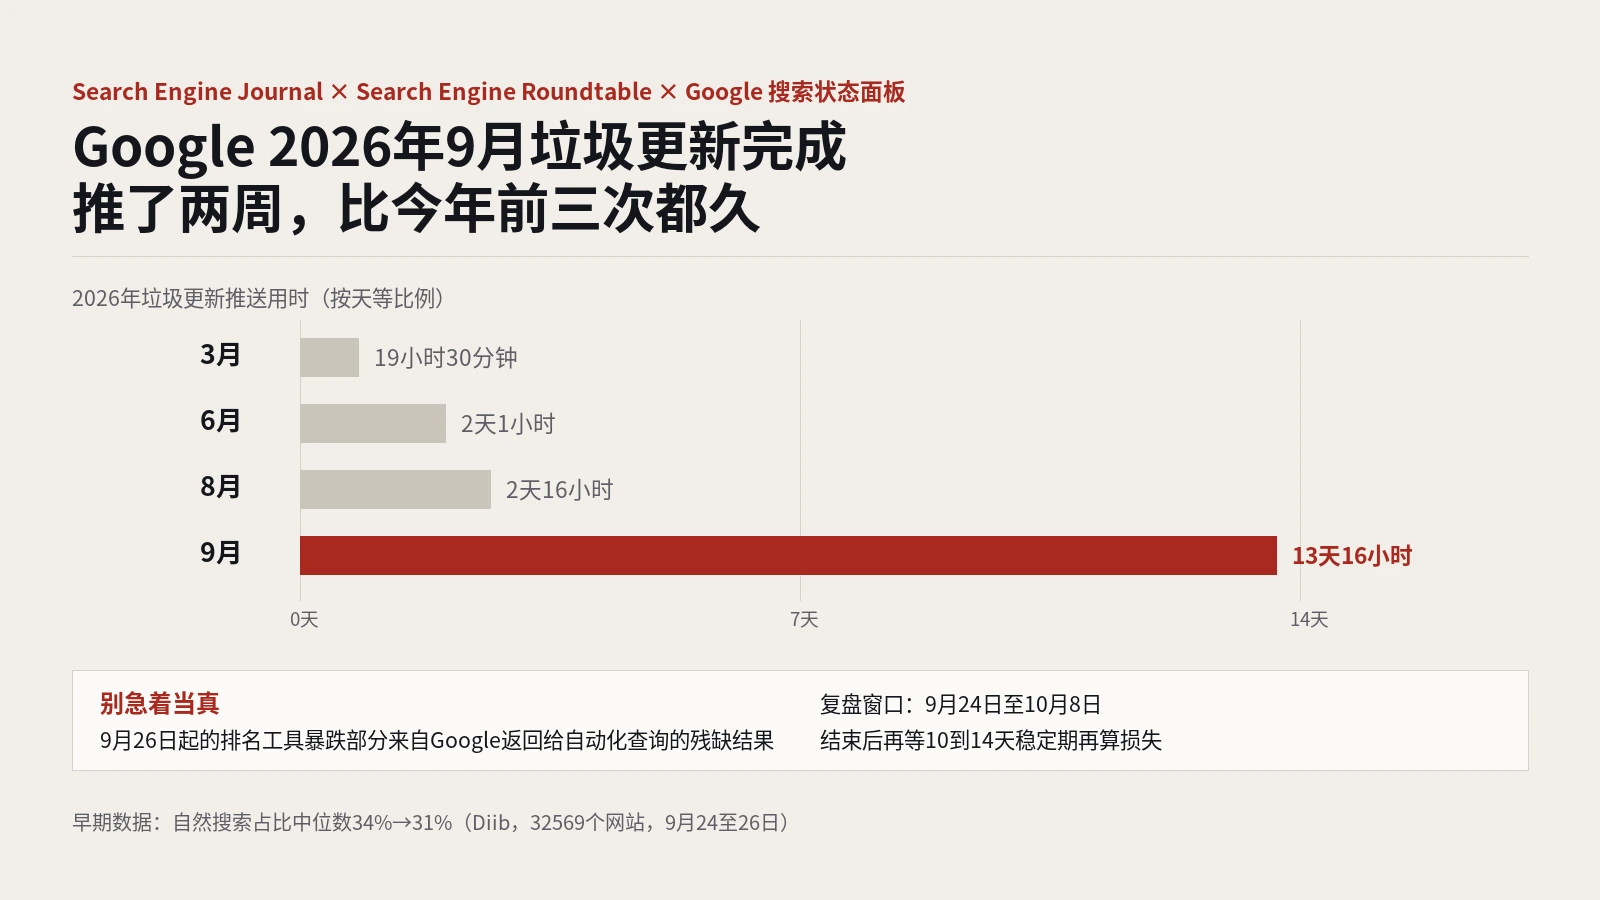
9月垃圾更新在他发文前已经推完了。状态面板记录它从9月24日开始,持续13天16小时,10月8日完成。文中还写着“等它推完”,估计稿子写在更早的时候。
感恩节前完成也不是Google遵守的规矩。2023年11月核心更新从11月2日推到28日,感恩节是23日;2024年11月核心更新从11月11日推到12月5日,感恩节是28日。两次都是跨着感恩节和黑五推的。
12月很少有核心更新这条,最近两年正好相反:2024年12月12日、2025年12月11日都开始了核心更新。“节日代码冻结”是行业里流传多年的说法,Google从来没有官方确认过这样一条规则。
所以对外贸和独立站卖家,旺季前后都要做好排名动的准备。别把希望押在“Google会体谅商家旺季”上,它推更新的时间表里没这一项。
熊猫算法当年到底在打什么?
预测的部分说完,回到标题里那只熊猫。这部分是Dan Taylor文章里最有价值的地方。
2011年2月24日,Google院士Amit Singhal和首席工程师Matt Cutts在官方博客发了一篇《Finding more high-quality sites in search》,宣布一次“明显影响11.8%查询”的排名改动,目标是降低低价值、抄袭别人内容、或者就是没什么用的网站的排名,同时让有原创内容和研究、深度报道、深入分析的网站排得更好。这次改动先只在美国上线。
这篇博客里有个细节常被忽略。Google那时刚推出一个Chrome扩展,让用户屏蔽不想看到的网站。Google说新算法没用这份屏蔽数据,但事后对比发现,被屏蔽最多的几十个域名里,有84%也被这次改动识别出来了。用户的嫌弃和算法的判断大体一致,这是Google当时给出的佐证。
一周后,两人在TED大会期间接受《连线》杂志采访,讲了这次更新是怎么做出来的。Google把一批网页发给外部测试员,问的是这类问题:你愿意在这个网站上填信用卡吗?你愿意让孩子吃这个网站上推荐的药吗?这个网站算权威吗?如果放在杂志上发表行不行?广告是不是太多了?然后用这些人工判断去训练分类器。名字来自参与研发的一位姓Panda的工程师,内部就叫它大熊猫。
到了2011年5月,Google站长博客又发了一篇《More guidance on building high-quality sites》,列了二十多个自我评估问题。Google现在的排名系统指南里还留着一条记录:熊猫系统2011年公布,后来不断演变,2015年并入了核心排名系统。所以严格说,今天不存在单独的熊猫更新,Dan Taylor说的“熊猫式”指的是那一类按网站整体质量下判断的做法。
站内以前写过熊猫算法当年怎么打内容农场,也梳理过从熊猫到有用内容系统再到AI模式这十几年的质量算法演变,想看全貌的可以翻那两篇,这里只说和这次预测有关的部分。
为什么大家会把熊猫读成字数门槛?
Dan Taylor的解释很到位:大家看到的是结果,没看到原因。
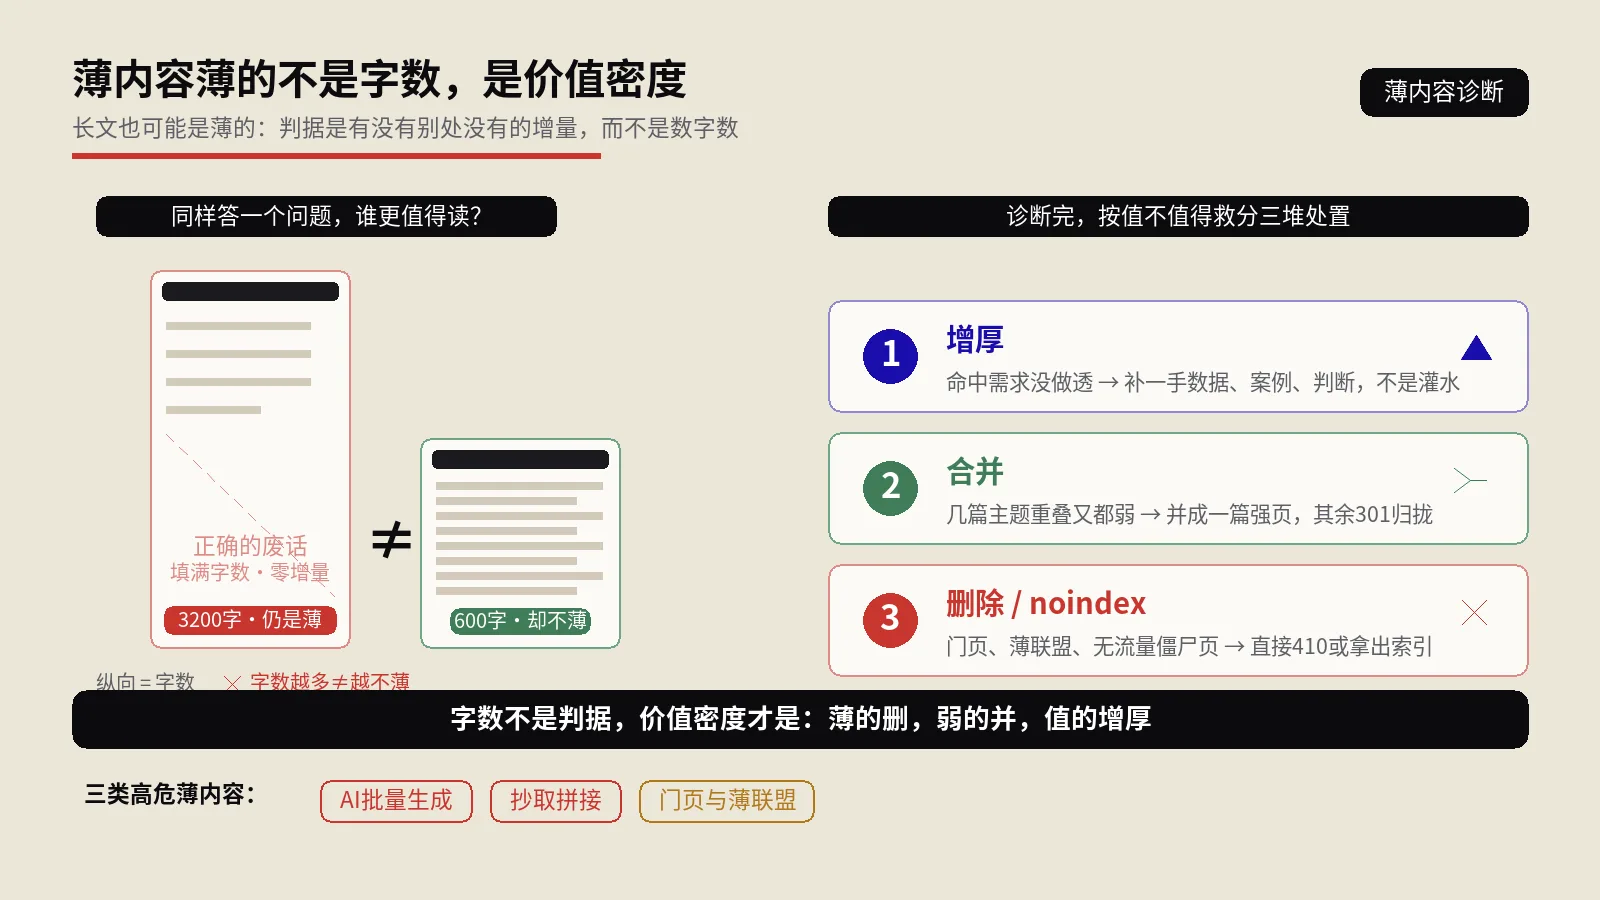
当年掉量的内容农场和单薄的联盟站,页面普遍很短。从业者顺着症状往回推,就把篇幅当成了病根。500字先是被当成下限,后来成了目标,最后干脆成了质量的代名词。一篇150字就把一个具体问题答清楚的页面被当成有毛病,一篇把同一个观点车轱辘话说了2000字的页面反而被当成修好了。
他的原话是,篇幅看得见,可熊猫并不给篇幅打分。熊猫判断的是一个网站在评估员眼里像不像值得依赖的东西,还是更像一堆冲着排名堆出来的库存。长页面可能不及格,短页面也可能及格。
这里要替Google的原始文档补一句公道话。2011年那份问题清单里确实有一条和长短有关:文章是不是简短、空洞,或者缺少有用的具体内容。注意这句话是三个词并列的,“短”后面紧跟着“空洞”和“缺具体内容”。被指认的是没有干货,短只是常见的伴随症状。整份清单里没有一个字数、没有一个链接比例,也没有任何“质量模板”,这一点Dan Taylor说得没错。
这个误读到今天还在流行。很多外包写手的报价单仍然按字数算,很多内容团队的考核仍然是“每篇不少于3000字”。字数到底算不算排名因素,站内有一篇专门讲内容长度和排名的关系,Google的人多次公开说过字数不是排名因素,把一个话题讲透需要多长就写多长。
Google这个月改的两份文档,和熊猫的问题清单像在哪?
Dan Taylor认为时间点值得留意:Google刚在10月初改了两份和内容质量直接相关的文档,口径收紧之后往往跟着一次算法动作。这个推断没法证实,但改了什么是可以核对的。
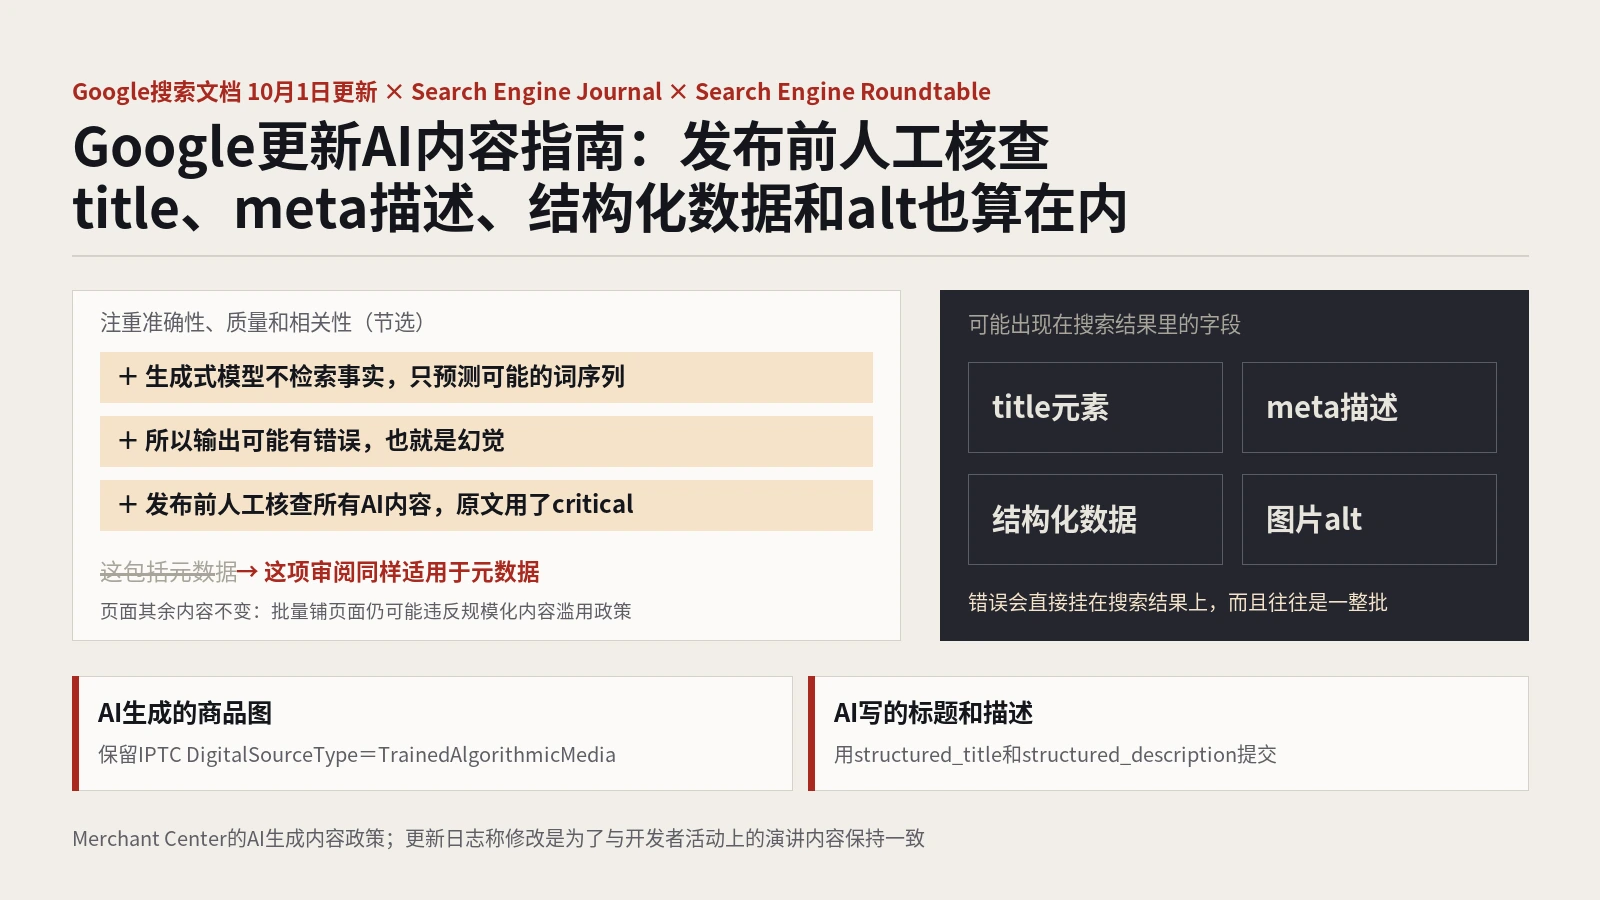
AI内容指南加了一句“必须人工核查”
Google的生成式AI内容指南在10月1日更新,新增了三句话,大意是:生成式模型不检索事实,只是根据训练数据预测最可能出现的词序列,所以输出可能有错误,也就是幻觉;发布前一定要人工核查所有AI生成内容的准确性和可信度。后面那句关于元数据的话也从“这包括元数据”改成了“这项审核同样适用于元数据”,点名的是title、meta描述、结构化数据和图片alt文本。具体改动站内在Google更新AI内容指南那篇里逐句对照过。
有用内容指南新增了主要内容的定义和四个评估属性
Google的《创建有用、可靠、以用户为本的内容》现在多了一节“主要内容”,定义为网页上直接帮助页面实现其目的的任何部分,包括正文和媒体、计算器这类互动功能、直接回应页面主题的用户评论、藏在标签页里的规格参数,以及标题和小标题。
紧接着列出评估员被训练去看的四个属性:投入、原创性、才能或技能、准确性。投入这一条写得最具体:从信息源自动生成页面,或者用生成式AI在没有人工把关的情况下产出大量文字,属于几乎没有投入;注明来源、给别人署名,替代不了原创的投入。
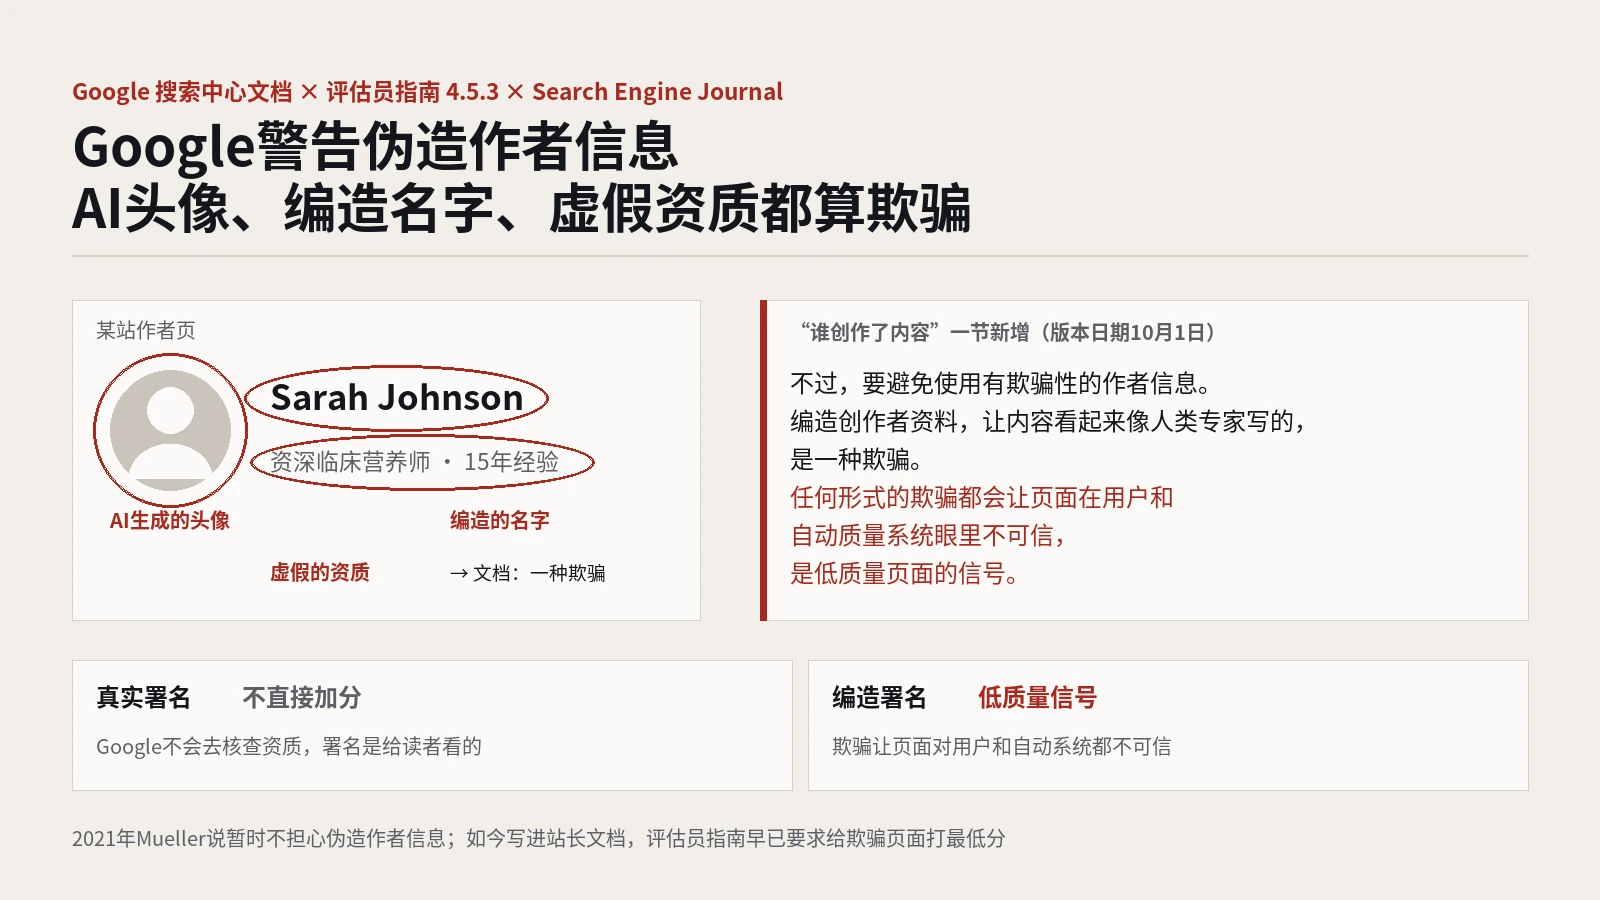
同一页还在“谁创作了内容”一节加了一段,明确说用AI生成的头像、编造的名字或虚假资质伪造作者资料,让内容显得像人类专家写的,属于欺骗,会让页面在用户和自动化质量系统眼里都不可信,是低质量页面的信号。站内在Google警告伪造作者信息那篇讲过来龙去脉。
把2011年和2026年的说法摆在一起,像的地方一眼就能看出来:
| 2011年熊猫问题清单 | 2026年10月的文档措辞 |
|---|---|
| 内容是不是冲着猜什么能排上去写出来的 | 没有人工把关地用AI大批量产出文字,属于几乎没有投入 |
| 文章有没有原创信息、报道、研究或分析 | 原创性:提供别的网站上还没有的信息或视角 |
| 文章有没有拼写、风格或事实错误 | 准确性;AI内容发布前必须人工核查,元数据也一样 |
| 这些内容是不是由很多作者批量产出,或分散在一大堆网站上 | 伪造作者资料属于欺骗,是低质量信号 |
| 你会信任这个网站给出的健康建议吗 | 可能严重影响人们生活或健康的话题,必须高度准确并符合专家共识 |
有一点要讲清楚。这两份文档都写明,质量评估员的打分不直接影响排名,他们的作用是帮Google检验排名系统改得对不对。文档改动说明Google在评估时看什么,并不等于哪个算法哪天上线。Dan Taylor把文档更新当成更新临近的信号,是一种合理猜测,只是没有直接证据。
Gary Illyes在巴塞罗那的那句话
Dan Taylor还引了Google的Gary Illyes在搜索中心线下活动上的表态:规模化内容正在变成比链接垃圾更大的问题。他写的是“本周在巴塞罗那”,按Roast整理的巴塞罗那第三天纪要,这份纪要10月2日就发出来了,比他的文章早了将近两周,“本周”的说法对不上。
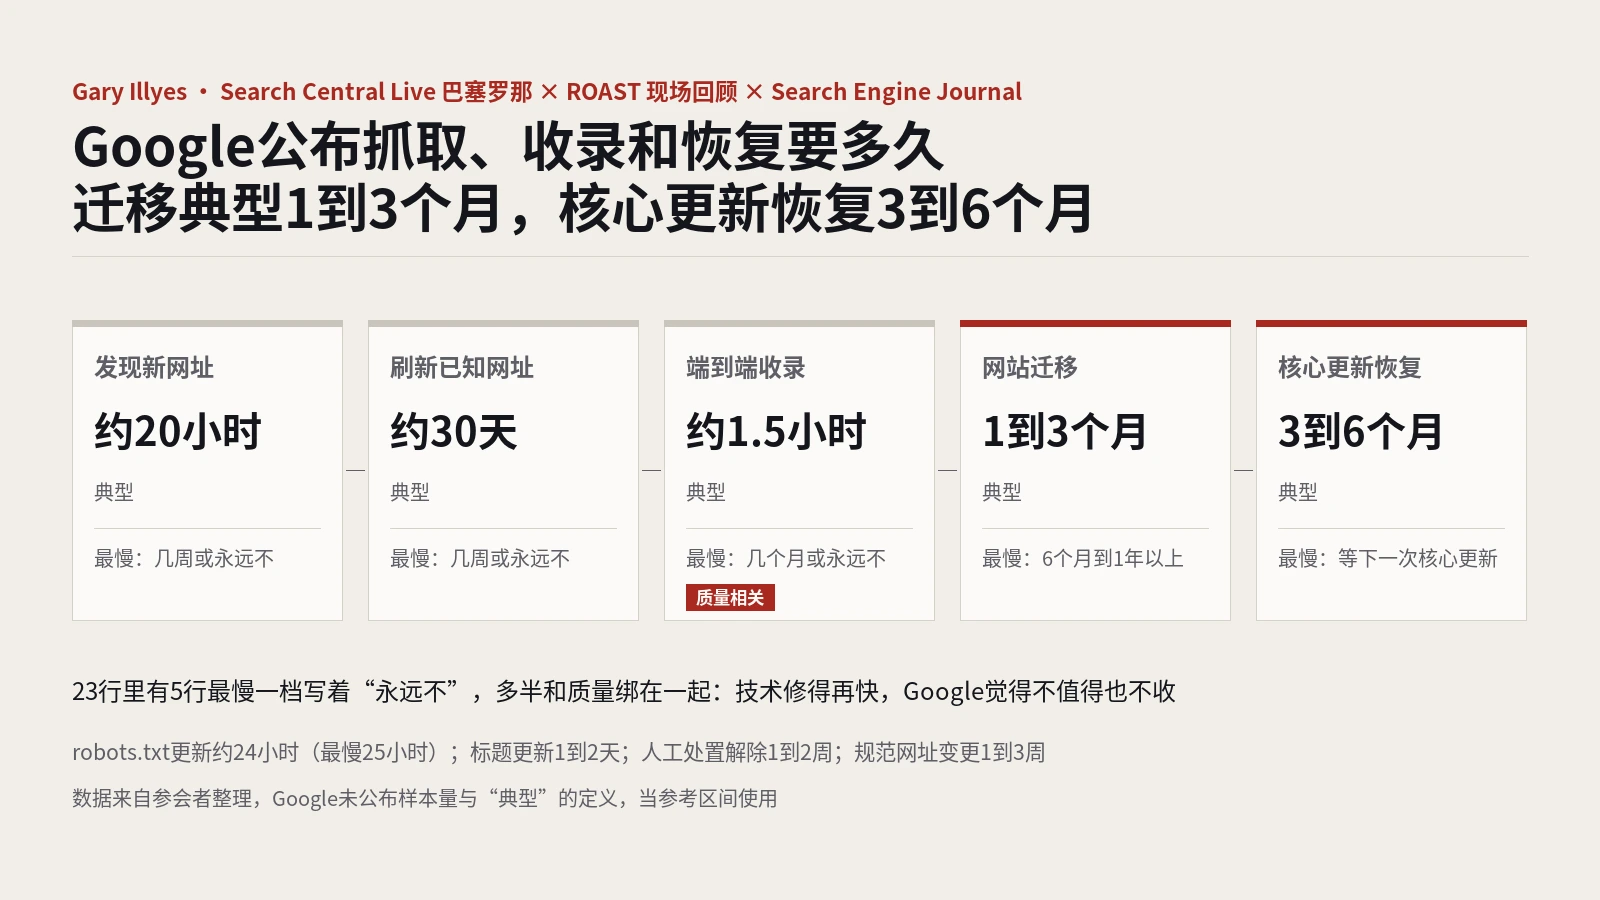
同一份纪要里还有两个值得记的数:Google每天过滤掉400亿个垃圾网页;从核心更新里恢复,通常要3到6个月。Gary在活动收尾时给的建议也很直接:AI该用就用,但要负责任地用,别往已经泛滥的AI垃圾里再添一把。站内在Google公布抓取、收录和恢复时长那篇整理过这些时间区间。
真来了,是打整个网站还是只打单页?
Dan Taylor的结论是,一次更凶的熊猫会像2011年那样做网站级的分类,伤害落在整个站上,不只落在那几张薄页面上。
这句话和Google最近的公开表态有点出入。同一份巴塞罗那纪要里记着Gary的另一句话:核心更新不以网站为对象,评估的是页面层面的内容,所以同一个站有的页面涨、有的页面跌。
两边的说法能对上。Google排名系统指南写的是:排名系统按页面工作,用多种信号判断单个页面怎么排;网站级的信号和分类器也在用,会影响对页面的理解;一个站有些好的网站级信号,不代表它所有内容都排得好,反过来也一样。
放到实际情况里,大概是这样:
- 一个站上大部分页面是批量生成、没人审过的,网站级信号会被拉低,原本写得不错的页面也可能跟着受牵连。2011年内容农场整站掉量就是这种情况。
- 一个站整体靠谱,只有一小块栏目是批量页,更可能看到的是那一块下滑,其他页面不太受影响。
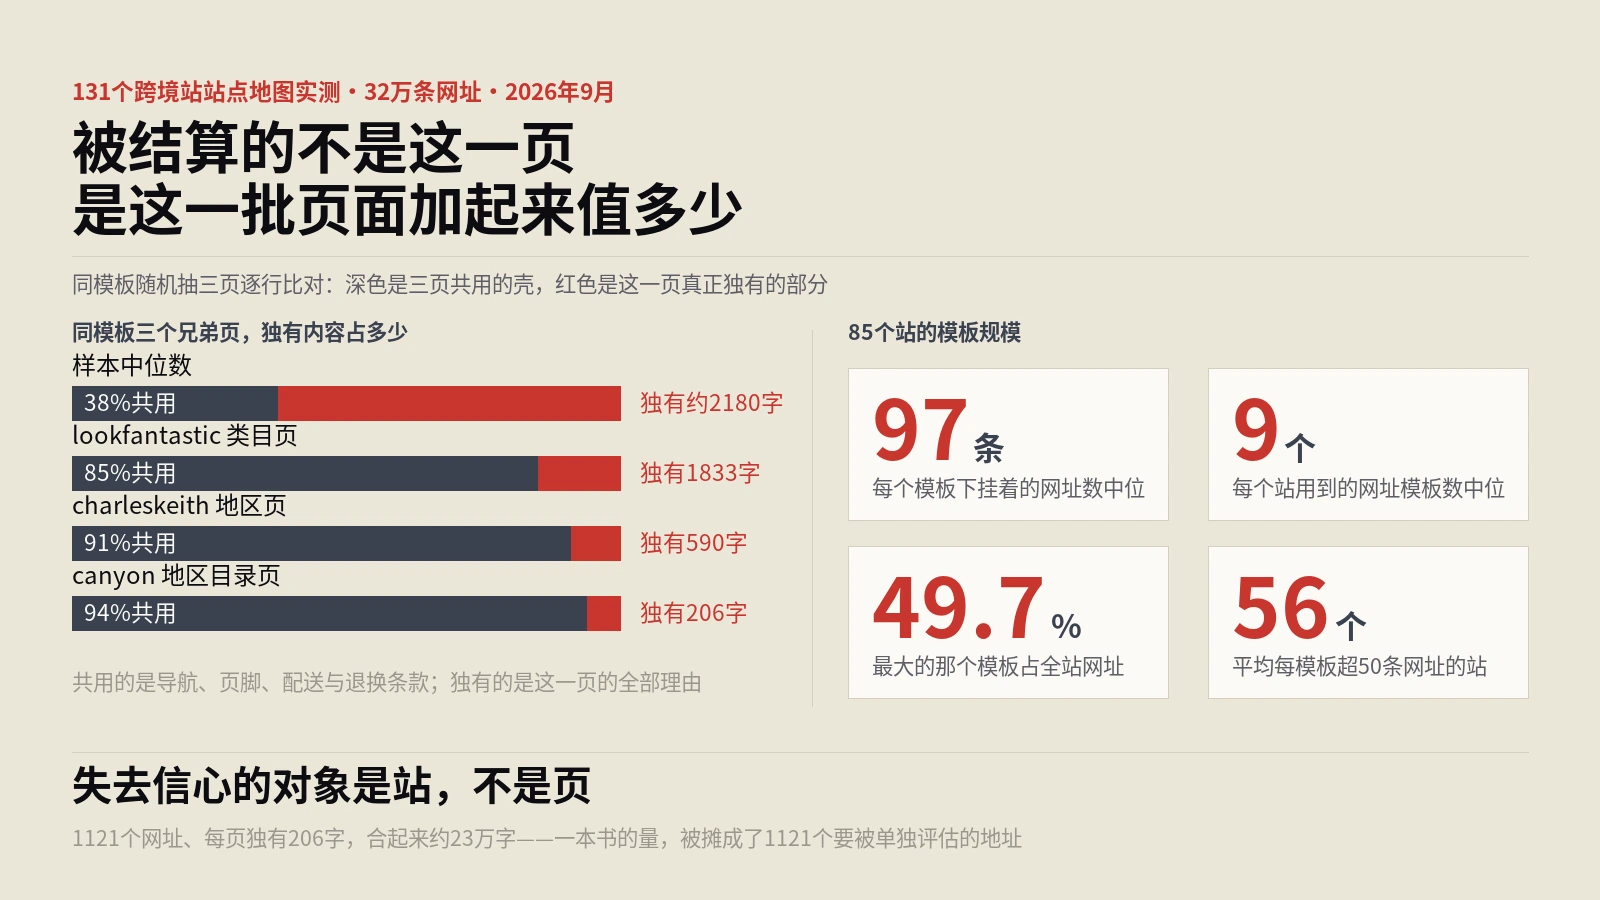
所以要担心的,是批量页在全站页面里的占比。只有零星几篇AI稿,没什么好慌的。今年8月垃圾更新之后,有从业者观察到全自动发布、从一开始就没有人工痕迹的站掉得最狠,SEJ当时整理过这些说法,不过都是小样本的个人观察。站内在薄内容诊断与修复清单里写过怎么按栏目估这个占比。
外贸站和独立站这几周该做什么?
不管96.8%准不准,下面这几件事在任何一次核心更新前做都不吃亏。没更新,网站也会变好;真来了,至少不会被打个措手不及。
先清点批量生成的页面
把这一两年用AI或模板批量做出来的页面列一张表:城市落地页、产品对比页、术语解释页、FAQ聚合页最常见。每类抽几页,按Google那四个属性问自己:有没有人花了真功夫,有没有别家没有的信息,写的人懂不懂行,内容对不对。答不上来的那一类,要么补进真实的规格参数、报价区间、售后条款、实拍图,要么合并,要么加noindex。
别一口气删掉几千页。大规模删页本身会带来抓取和内链的连锁变动,更新期间叠在一起,事后很难分清是哪件事造成的。最近人工处置多起来,规模化内容和单薄内容就是最常见的两类,有这类问题的站更该先处理。
查一遍作者页
很多外贸站的博客署名是“Admin”或者一个编出来的英文名,配一张图库头像,简介写着“十年行业专家”。按Google现在的写法,用AI头像、编名字、编资质让读者以为是专家写的,就是欺骗。真有工程师、采购经理参与写作,就写真名和真实职务;没有,就老老实实署公司名,别硬造一个人。
把元数据也纳入人工审核
很多团队的审稿流程只看正文,title和meta描述是插件或脚本自动填的,图片alt是AI批量生成的。新版指南把这些都点名了。最省事的做法是在发布清单里加一项:AI生成的title、描述、alt和结构化数据,至少抽查一遍事实,尤其是价格、认证、参数这类数字。
先把对比基线存好
现在就从Search Console导出最近8到12周按页面和查询的数据存档。真有核心更新上线,用更新前几周和更新完成一周以后的数据比,别在推送中途看两三天的曲线就动手改页面。Google的核心更新文档也是这么建议的。排名正常抖动和真实下跌怎么分,可以参考这篇分诊方法。
跟老板怎么说
Dan Taylor建议现在就跟决策层打招呼。说法可以更稳妥一点:核心更新已经五个月没来了,按过去几年的节奏,年底前来一次的可能很大;Google最近改的文档都在强调投入、原创、技能和准确,批量页多的站风险更高;我们已经做了哪些检查,基线数据存在哪里,真有波动按什么节奏复盘。
别把“96.8%”写进汇报。这个数是一个人的模型算的,口径还包括未确认的波动,到时候来的只是一次普通核心更新甚至什么都没来,解释起来会很被动。说“很可能会来,我们准备好了”就够了。
这份预测最后能信几成?
回头看,Dan Taylor这篇文章里有两样东西可以分开对待。
关于时间,他的判断和公开记录大体一致:核心更新间隔已经拉得很长,过去几次长空窗之后多数在一个月内等来了更新,年底前来一次的可能确实高。可96.8%这个精度没有根据,90天的数字又和基础概率几乎重合,感恩节前完成、12月少有核心更新这两条也和最近两年的记录对不上。
关于内容,他对熊猫的解读、对字数迷信的批评,以及把这次文档改动和2011年问题清单放在一起看的角度,都很有用,和Google的原始文档也对得上。就算这个月什么都没发生,这些也该做。
算法更新从来都是“迟早的事”,没人能精确到哪一天,Google自己也不会提前说。能确定的只有自己网站上那些批量页、假作者和没人看过的元数据,这几样今天就能动手改。
常见问题解答
Google官方说过近期会有熊猫式更新吗?
没有。96.8%来自SEJ专栏作者Dan Taylor自建的预测模型,Google从不提前预告核心更新。截至10月20日,Google搜索状态面板上最近一次排名更新是9月24日开始、10月8日完成的9月垃圾更新,最近一次核心更新是5月21日开始的那次。
熊猫算法现在还单独存在吗?
不单独存在了。Google的排名系统指南写明,熊猫系统2011年公布,2015年并入核心排名系统。现在说的熊猫式更新,指的是按网站整体内容质量做判断的那类做法,Google不会再以熊猫的名义发布更新。
页面字数少会被熊猫式更新惩罚吗?
字数本身不是评判依据。2011年Google的问题清单问的是文章是不是简短、空洞或缺少有用的具体内容,重点在没有干货。一个150字就答清楚具体问题的页面可以是好页面,一篇灌水到3000字的页面也可能被判为低质量。
用AI写内容会不会在下次更新里被打?
Google没有禁止用AI写内容,它反对的是不加人工把关地批量产出。新版指南要求AI生成内容在发布前人工核查准确性,title、meta描述、结构化数据和图片alt也包括在内。有人审、有原创信息、有真实作者的AI辅助内容,和批量自动发布的内容是两种情况。
核心更新期间排名下跌,应该马上改页面吗?
不建议。核心更新通常推两周左右,期间排名会来回波动。Google的建议是等推送完成后至少一周,再拿更新前几周的数据做对比。按巴塞罗那活动上Google给出的说法,从核心更新中恢复通常要3到6个月,中途频繁改动只会让原因更难分清。
网站只有少量AI生成页面,会拖累全站吗?
Google说排名系统主要按页面工作,同时也用网站级的信号和分类器。零星几篇问题页面一般影响有限;批量生成的页面占全站比例越高,越可能拉低网站级信号,连带影响原本不错的页面。所以先算清楚批量页的占比,再决定改、合并还是noindex。
权威参考资料
本文标题:《Google核心更新预测96.8%可信吗?熊猫式质量更新来之前,外贸站该先查什么》
本文链接:https://zhangwenbao.com/google-panda-style-update-prediction-core-update-timing.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0