内容自动化从哪一步做起?Ahrefs把12份数据榜单的月更交给AI,发布键留在人手里
本文目录
摘要:Ahrefs的Si Quan Ong把12份数据型文章的月度更新做成了一条自动流水线,取数、剔除、分类、做表、写进WordPress草稿、发邮件提醒都交给机器,唯独发布要他本人点头。他给的七步做法里,最有用的是三样东西:先把自己干活的每个小动作写成清单,让模型只加工指定来源的数据,再让系统把被它剔掉的条目连同理由一起留下来。这套办法适合有固定节奏、规则稳定的重复活,拿来一键批量生成文章就用错了地方。
内容团队里总有几件活,没人愿意干,又不能不干。更新老文章里的数据就是其中一件:一篇还好,十几篇榜单类文章每个月都要重新取数、重新做表、重新改日期,干到第三个月,人就开始找理由往后拖。
Ahrefs在10月16日发了一篇跟做指南How to Automate Content Creation: A Follow-Along Guide,作者Si Quan Ong是Ahrefs的SEO与营销讲师,Ryan Law审稿。他讲的内容自动化,跟很多人想的那种“输入关键词、点一下、一天出五百篇”完全不沾边。他拿自己手上最烦的一件事开刀,把数据型文章的月度更新交给AI流水线,然后把搭这条流水线的步骤写了出来。
下面以这篇为主体,把七个步骤和他踩过的坑讲清楚,补上Ahrefs自己的新鲜度研究和Google规模化内容政策的原文,再说说国内做独立站和外贸内容的团队能照着搭哪一段。先交代一句:文中推荐的Letaido是Ahrefs自家的AI营销平台,读到工具推荐那部分心里有个数就行,方法本身换成Claude Code、Codex或者n8n一样能用。
Ahrefs的数据刷新中枢每个月替人干了什么?
Si Quan这些年做了一批数据驱动的文章,比如Top Google Searches(Google搜索量最高的词)和Top Google Questions(搜得最多的问题)。这类文章数字越新越有用,每次更新后搜索流量也往往最好。问题是篇数一直在涨,每月全部更新一遍变得吃不消,团队只好退一步改成按季度更新,明知月更对读者更好。
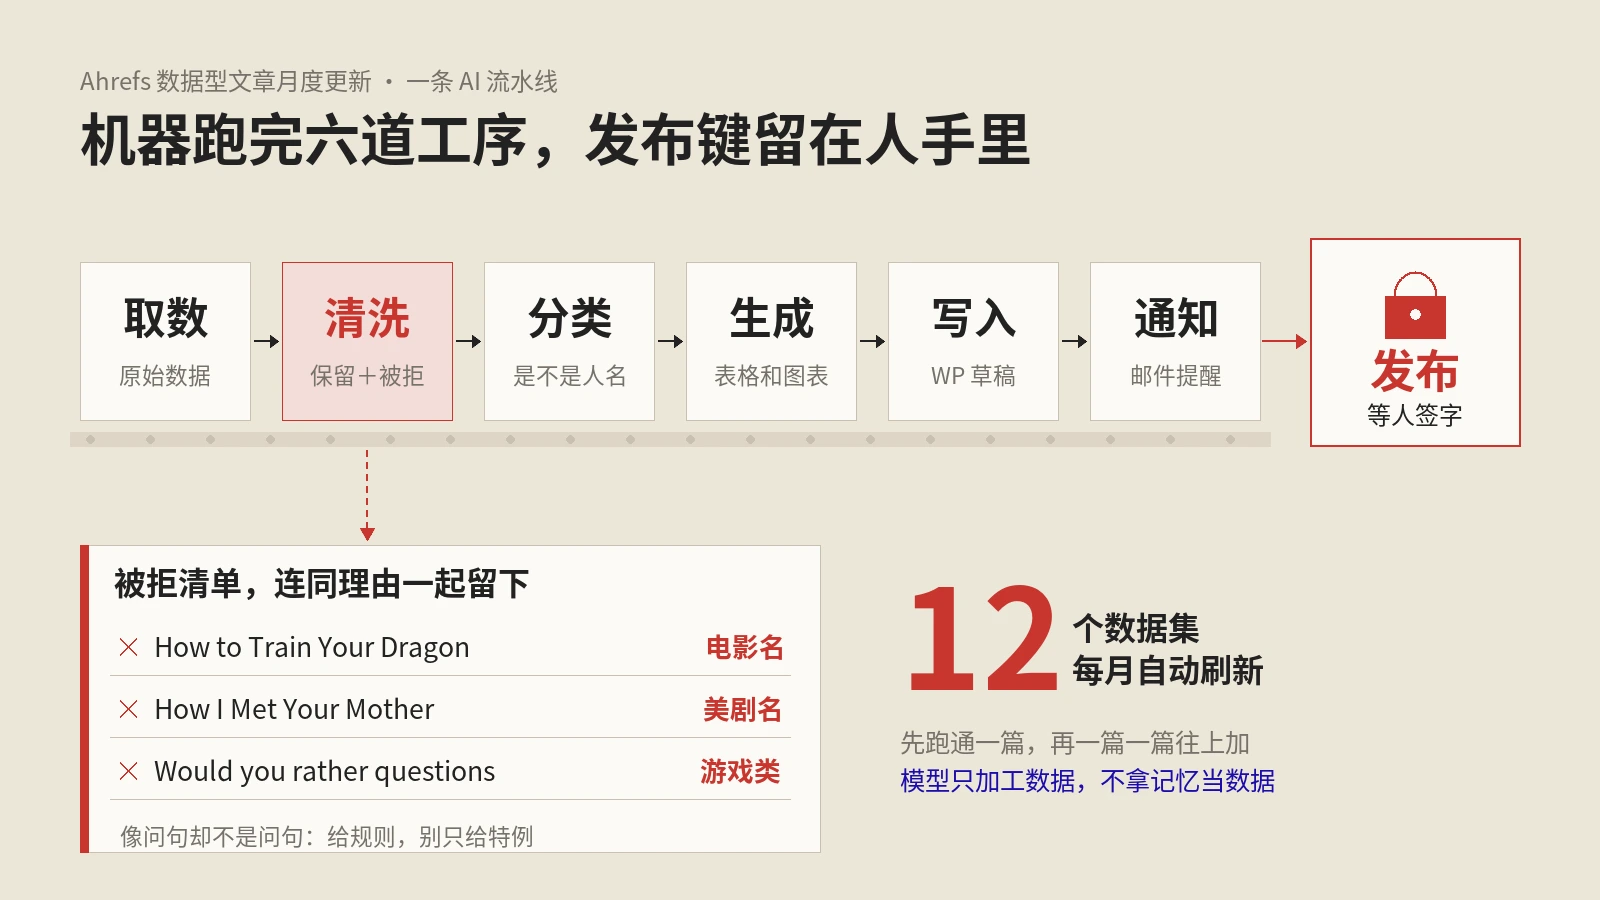
他后来搭了一个叫Data Refresh Hub的东西,每月自动跑一遍:
- 给12个数据集拉取新数据;
- 剔除成人类等不合适的结果,并检查每条是否符合文章主题,比如“搜得最多的问题”里只能留问句;
- 重建相关的表格和图表;
- 把改动写进WordPress草稿;
- 跑完发邮件通知他;
- 等他审完再发布,审之前什么都不上线。
为什么一家工具公司愿意在“更新老文章”上花这么大力气?原文给的理由是新鲜度。Google的QDF机制(Query Deserves Freshness,判断某个查询需要新信息)会给近期更新过的页面加分,站内那篇内容新鲜度与QDF机制讲过它的来龙去脉。AI助手这边也有类似倾向,Ahrefs在一项分析1700万条引用的研究里算过:ChatGPT、Perplexity、Copilot和Gemini引用的网址平均发布了1064天,自然搜索结果里的网址平均1432天,前者新了25.7%。
这个数字看的时候要留意口径。它比的是平均发布时长,按“最后更新时间”算,差距缩小到13.1%(909天对1047天)。而且Google的AI概览是个例外,引用的内容平均比自然结果还老16天。所以这项研究能说明AI助手整体偏新,推不出“改个日期就能多被引用”。能起作用的是内容里的数字确实换成了新的,日期只是跟着变。
先挑哪件活交给机器?
原文第一步就劝住了一个常见冲动:别从“我们能拿AI做点什么”开始想。这个问题太开放,可能性无穷多,人对着它一般不会想得更远,只会头疼,然后回去接着干原来的活。
更好的起点是你现在最烦的那件事。实在想不出来,就把每周、每月、每季度固定要干的活,以及每出一篇内容都要走一遍的活列出来,再按下面五条筛:
| 筛选条件 | 原文的意思 | 外贸站和独立站能对上的活 |
|---|---|---|
| 重复 | 每天、每周或每月都要做 | 每月更新海运价格走势、汇率换算表 |
| 耗时 | 每次花的时间都比预想的长 | 多语种商品页的规格表同步 |
| 规则相对稳定 | 换个行业流程也差不多,比如关键词研究 | 按固定口径整理Search Console月度报表 |
| 做对了有价值 | 跟业务挂得上钩 | 带来询盘的行业数据页、年度榜单页 |
| 经常被拖延或草草了事 | 因为费时,大家都往后推 | 老博客里失效的外链和过期的政策条款 |
五条里最容易被忽略的是“规则相对稳定”。一件活如果每次都要现场拍脑袋,机器接手后只会更乱。数据刷新这件事刚好五条全中:每月一次,步骤繁琐,规则基本不变,做好了有流量,又总被拖。
把自己的做法一条条写下来,连小动作也别漏
原文有句话很实在:没人讲得清楚的流程,AI代理也没法稳定地自动化。大部分重复活我们都是凭肌肉记忆干的,肌肉记忆最不擅长解释自己。要写的是你真实的做法,连抄近路的地方也算进去,不是那份好几年没人打开的操作手册。
Si Quan把更新Top Google Searches的过程写下来,大致是这样:
- 在Keywords Explorer里做一次空搜索,国家选美国;
- 下载前200个关键词的CSV;
- 打开表格人工过一遍,删掉不合适的词,比如成人类查询;
- 拿排名靠前的结果跟上月对比,看有没有明显异常;
- 所有数字向上取整到最近的一万;
- 把数据贴进托管表格的TablePress插件;
- 检查有没有贴错;
- 去内部工具拉全球搜索量最高的词,再走一遍上面的流程;
- 判断变化大不大,要不要重写导语和小标题;
- 确认文中图片都是最新的;
- 改“最后更新”日期。
像“向上取整到一万”“和上个月对比”这种小决定,平时顺手就做了,让你凭空回忆,十有八九想不起来。他的建议是让AI代理反过来采访你,提示词大意如下,中文团队可以直接拿去用:
我想把某项工作自动化。请就我现在怎么做这件事采访我,一次只问一个问题。只要我的回答含糊,或者说了“通常”“看情况”“我就是知道”,就追问下去。最后把完整流程写成一份逐步清单,我提到的每条规则和例外都要写进去。
清单写好后别躺在文档里,把它做成技能文件,也就是代理每次干这件活都会读的一套固定指令,写一次就不用反复解释。Claude的技能文件怎么写,站内Claude Code Skill编写指南有字段和作用域的细节;想把品牌口吻也固化进去,可以看用Claude技能固化品牌口吻那篇。
模型只管加工数据,数据得从你指定的地方来
这一步原文的态度很明确:工作流里要紧的信息,别指望大模型的记忆,也别指望泛泛的网页搜索。模型会编数字,网页搜索抓到什么算什么,可能是五年前的盘点文,也可能是别人的AI垃圾内容。
正确做法是告诉模型该用哪些来源,再通过MCP、API或上传文件把这些来源接进去。原文列的可用来源包括自家产品产生的一手数据、你常用工具的接口、产品文档和帮助中心、客户访谈、公司认可的研究、自己的博客和视频、搜索数据和编辑规范。他那12个数据集的来源是这样分的:
| 数据集 | 来源 |
|---|---|
| 搜索最多的词、搜索最多的问题、趋势话题、最贵的关键词 | Keywords Explorer |
| 被引用最多的域名 | Brand Radar |
| 搜索最多的人物 | Keywords Explorer加上模型识别 |
| 两篇文章里的全球榜单 | Ahrefs内部数据库 |
原文在这里顺手推了自家的Ahrefs MCP服务器:由Ahrefs托管,不用安装,接上账户后Claude、ChatGPT、Copilot这类工具能在对话里直接查Keywords Explorer和Site Explorer的实时数据。广告归广告,思路是通用的,你常用的数据工具如果提供MCP或API,就优先走这条路,让模型每次读的都是当天的原始数据,别让它去网上找二手转述。
他总结的经验就一句:模型的活是处理数据,它本身不能当数据。国内团队照搬时,来源换成自己手里的就行,比如Search Console的接口、店铺后台导出的订单和退货数据、ERP里的价格表。发布端也一样,原文特意提到要能直接写进WordPress,否则机器干了九成,最后一成还得人每月复制粘贴表格,自动化就白做了。WordPress这边现在有官方的MCP适配插件,能开放哪些站点功能由权限说了算,见站内WordPress官方MCP Adapter插件的解读。
给它看好样子和坏样子,再让它留下被剔掉的那份清单
指令有用,例子更有用。只要工作流里有需要判断的地方,就给系统准备几类样例:你会收的、你会拒的、每个决定的理由,以及拿不准、该交给人的情况。
原文的例子很好懂。“搜得最多的问题”这份榜单只收问句,最简单的规则是“以who、what、where、when、why、how开头的都留下”。可很多查询以疑问词开头,却根本不是问题:How to Train Your Dragon是电影《驯龙高手》,How I Met Your Mother是美剧《老爸老妈的浪漫史》,would you rather questions是一类问答游戏。模型看到开头是how、后面又像句人话,就可能放行。
关键在理由怎么写。只说“拒掉驯龙高手”,模型学到的是一个特例;写成“电影、剧集、书名、歌名一律拒掉,哪怕看起来像问句”,它学到的是一条规则,连原文没提过的How to Lose a Guy in 10 Days(电影《十日拍拖手册》)也能自己拦下。
“搜得最多的人物”更难,因为Ahrefs没有现成的人物名单,只能让模型从已有数据里认出哪些词指的是人。Jordan是篮球运动员、国家还是球鞋?Taylor Swift tickets该不该算进Taylor Swift?他最后定下只算纯人名搜索。Ahrefs的Brand Radar里有实体筛选,能把苹果公司和水果苹果分开,原文借这个例子推荐了一下。
这一步里最该抄的是最后一条:让系统把被拒的条目连同拒绝理由一起保存下来,别只给你看最后的结果。Si Quan贴的截图里,系统已经误拒了几条货真价实的问句,他反倒觉得这说明流程在起作用,因为他一眼就看到了,回头改规则就行。只看最终结果的话,丢了什么永远不会知道。
先跑通一篇,每一步都留下产出
准备了这么多,人很容易想一口气把12个数据集全接上。原文的建议是先拿一篇试,他自己就是先把Top Google Searches跑到满意,才去碰别的。理由很实际:一份产出里找错容易,12份同时错,你都不知道从哪查起。
从一篇起步,还方便一点点放权。他一开始只允许系统改表格,别的都不许动,怕一让它“优化文章”就塞进一堆破折号和AI腔。观察了两三个月满意了,才放开更大的改动:现在导语第一句会跟着榜单第一名自动变,配图也随表格更新自动生成。
他还建议每个大环节都输出一份中间结果:
| 环节 | 做什么 | 留下什么 |
|---|---|---|
| 取数 | 从各个来源拉原始数据 | 原始数据文件 |
| 清洗 | 剔除不相关的结果 | 保留清单加被拒清单 |
| 分类 | 给剩下的条目分类打标,比如判断是不是人名 | 分类后的清单 |
| 生成 | 做新的表格和图表 | 表格和图表 |
| 写入 | 把改动写进WordPress草稿 | 草稿 |
| 通知 | 告诉他跑完了 | 邮件 |
这样出了错不用从头重跑,逐个看产出,找到哪一环开始不对,修好从那一环接着跑。他的系统还把每月改过的数据都存了下来,时间一长就攒成了一份历史数据,以后能画搜索趋势的走势图,这种内容别人做不出来,因为别人没有这份数据。
拿外贸站常见的“海运价格月报”页套一下这张表:取数环节从运价指数官网或货代给的报价表拉当月数据,清洗环节剔除报价单里明显填错的航线,分类环节按航线和箱型归组,生成环节出对比表和走势图,写入环节把表格更新进CMS草稿,通知环节给运营发一封带变化摘要的邮件。六个环节各留一份文件,月底哪条航线的数字看着不对,翻清洗环节的被拒清单和取数环节的原始文件,几分钟就能定位是来源错了还是规则错了。
最后是他给自己定的一条死规矩:永远不让AI自动发布。他打了个比方,大餐厅的主厨不会亲手做每一道菜,可每道菜端出厨房都挂着他的名字,所以出菜前他都要过目。自动化就是你的厨房,你就是那个主厨。
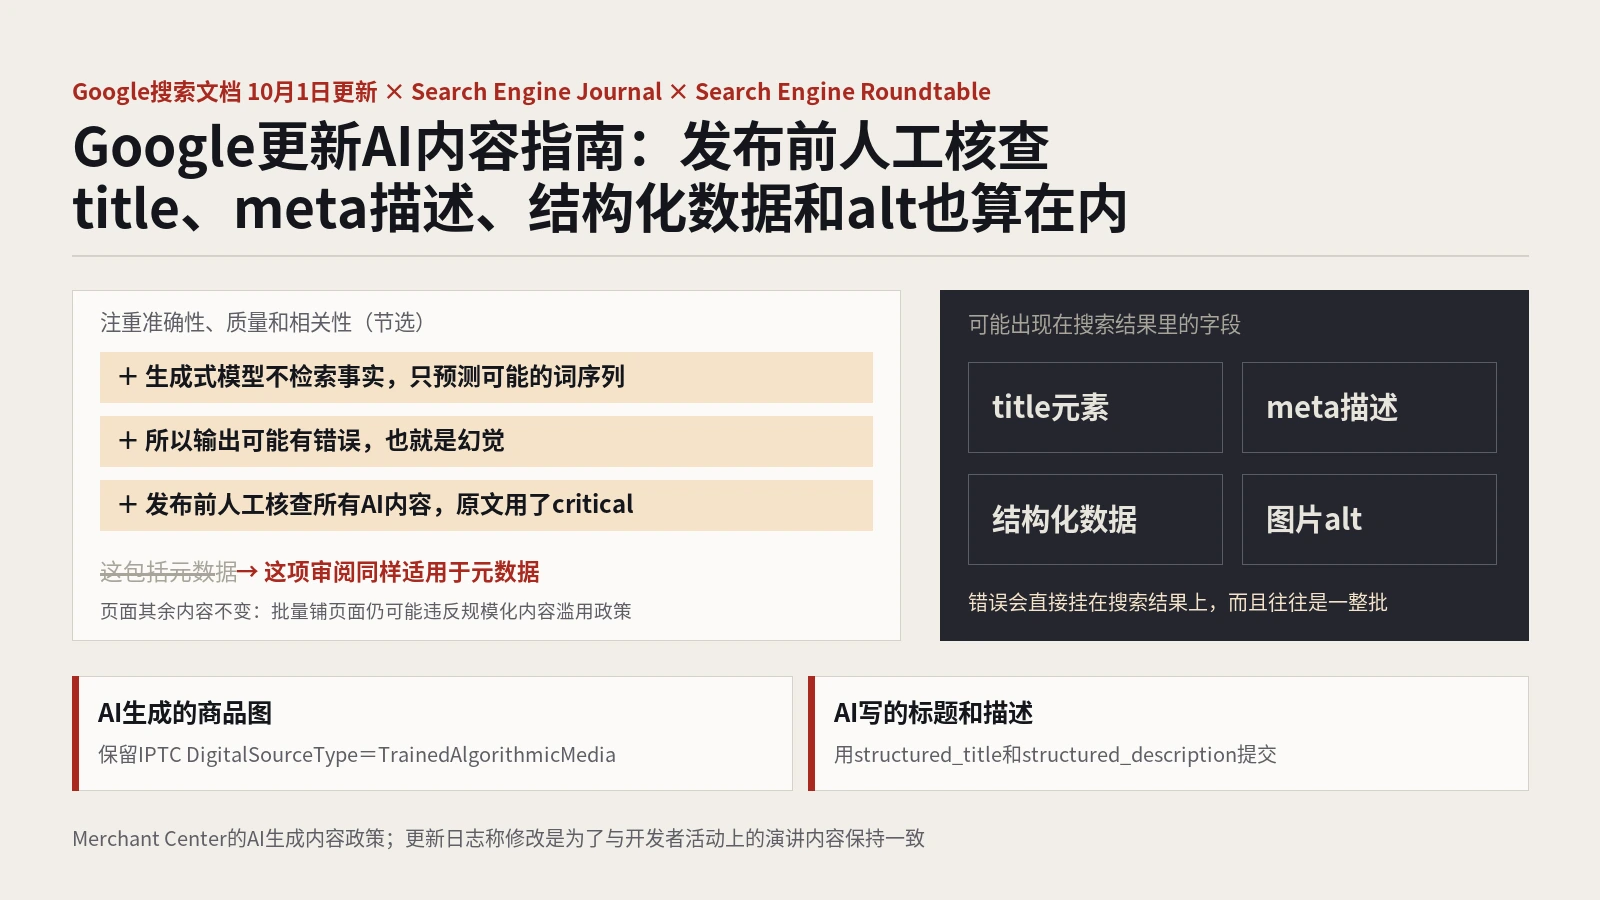
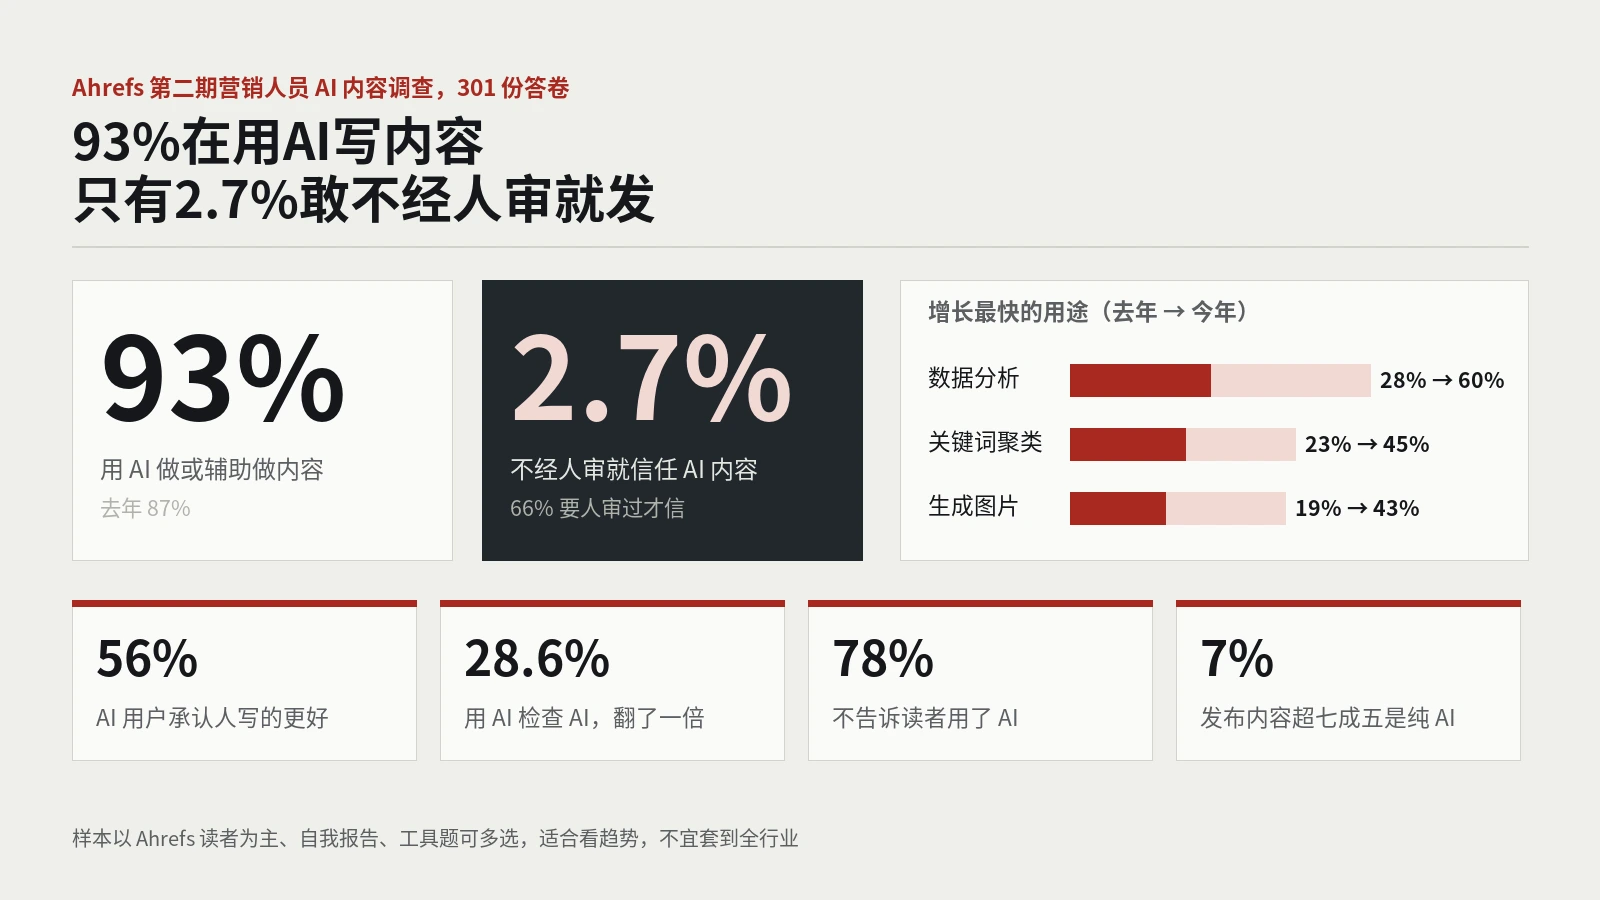
这条规矩跟Google的口径也对得上。Google最近更新的AI内容指南要求发布前人工核查,标题、meta描述、结构化数据和图片alt都算在内,见站内Google更新AI内容指南的解读。Ahrefs自己做的营销人员调查里,只有2.7%的人敢不经人审就发AI内容,细节在Ahrefs 2026年营销人员AI内容调查。
上线、排期,再一篇篇推开
单篇测试通过后,按它将来自己跑的样子,从头到尾真跑一遍,然后把机器做的版本和人做的版本摆在一起比。原文列了五个检查点:
- 数字:抽几个回到来源核对,看对不对;
- 被拒清单:扫一遍,看有没有好东西被误删;
- 格式:跟文章其余部分、跟你家的版式是否一致;
- 改写过的文字:动过导语或小标题的话,读起来还像不像你写的;
- 链接、日期这些小地方:错了读者一眼就能看出来。
判断标准就一个问题:这要是我自己做的,我会发吗?
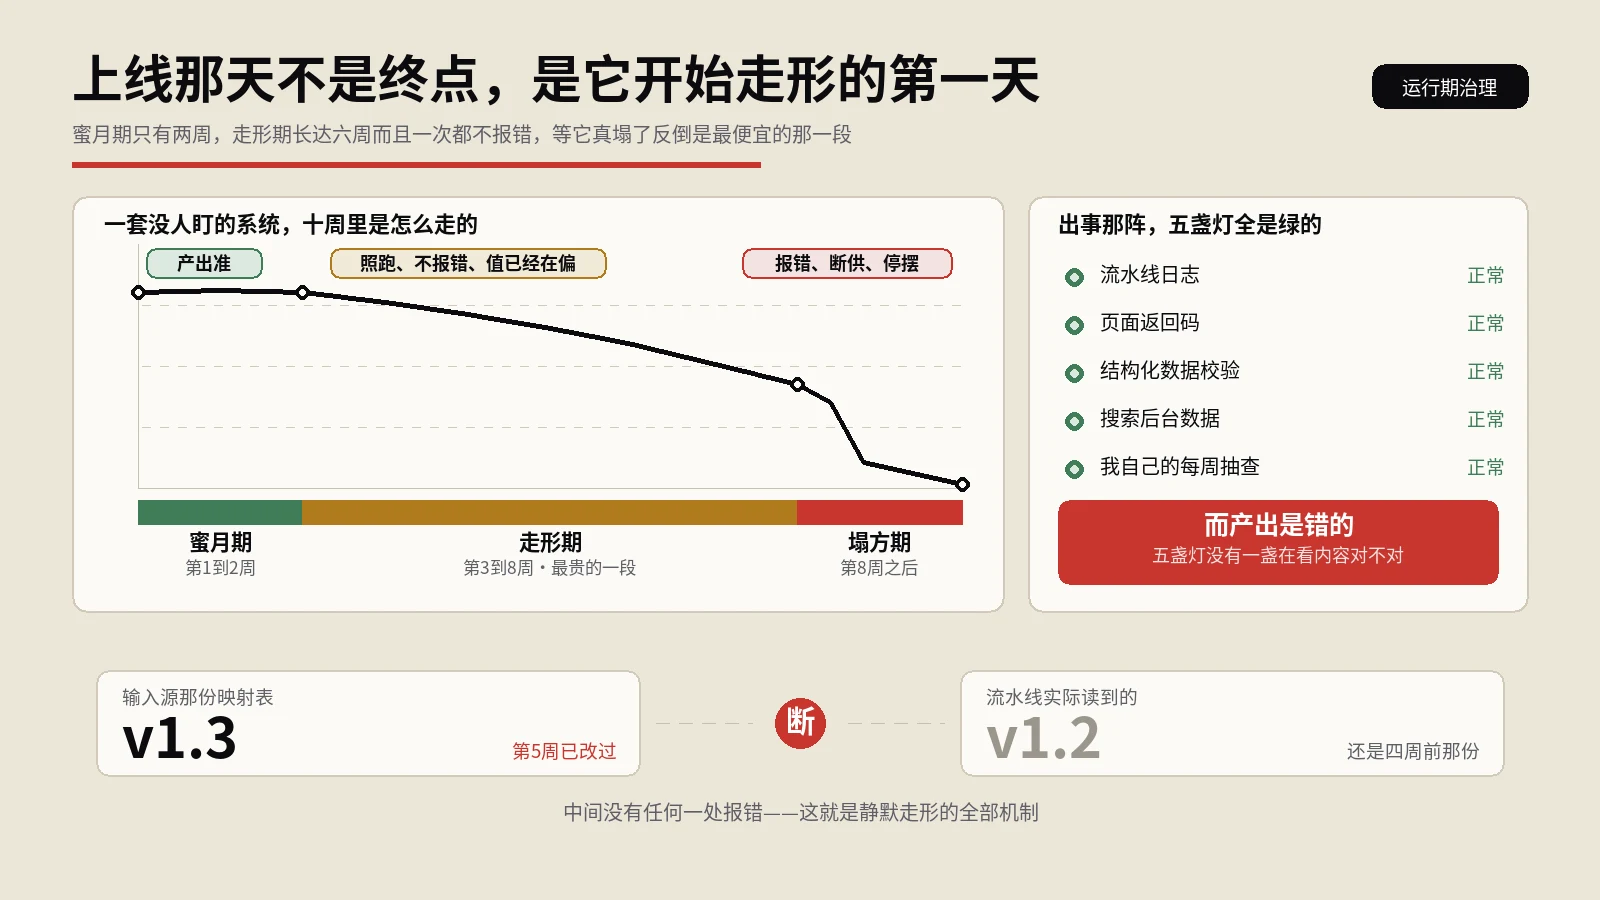
都过关了再排定时任务,比如每月一次。排期有两个细节。时间要排在数据源更新之后,不然你会得到一份排版漂亮的上月数据。另外要设失败提醒,让它出错时也通知你,别只在跑完时报喜。最糟的失败是悄无声息的那种,任务压根没跑,三个月都没人发现。站内内容自动化触发器与回执设计专门讲过怎么给每次运行留回执,可以配着看。
扩展的时候也是一篇一篇来。每篇文章都有自己的怪脾气,“搜得最多的人物”和“最贵的关键词”需要的规则完全不同,不过流水线的大部分已经搭好,每多接一篇就更省事。他把做法分享给同事后,Louise Linehan也用同一套方法去更新她那篇增长最快的SaaS公司榜单。原文对此有段话说得挺透:全公司发通知让大家多用AI,换来的往往只是焦虑和一堆开着的ChatGPT标签页;有人先做出一个能用的东西给同事看,同事说“我那摊活也能这么弄吗”,AI才算在团队里用开了。
搭好以后还会在哪些地方坏掉?
原文这里自嘲了一句:搭完了是不是就能去巴厘岛喝鸡尾酒,让AI替你上班了?很遗憾,他上次确认的时候,人还在伦敦。
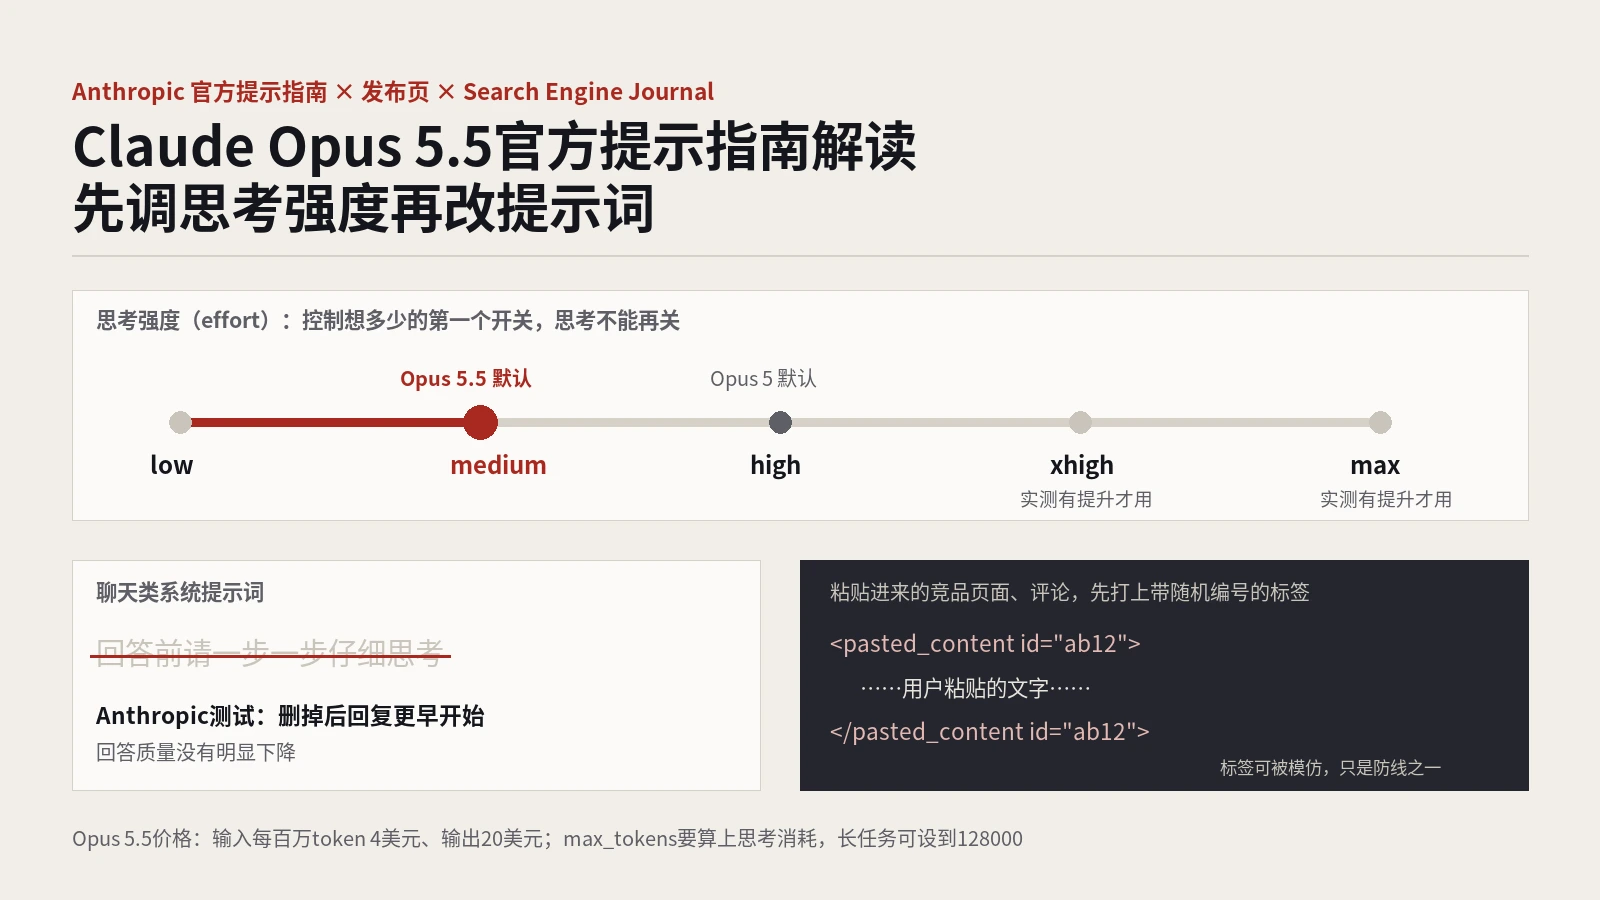
他举了两个真实的例子。一个是Anthropic发布Opus 5时,一个很流行的插件Compound Engineering被弄坏了,Kieran Klaassen在X上发帖说过这件事;维护得这么勤的插件都能一夜之间坏掉,自己手搓的自动化更别说。另一个是他自己的:他的自动化跟内容团队共用一个工作区,Ryan为自己的工作流加了一个新的密钥和连接桥,不知情地把他的流程搞坏了。
他列的易坏点,加上国内团队的对应情况,大致如下:
| 容易坏的地方 | 原文的说法 | 国内团队该盯什么 |
|---|---|---|
| 模型更新 | 新版本可能对同一套指令理解不同,上月好用的规则突然被忽略,或者被执行得过于死板 | 换模型或模型升级后先拿一篇回归测试,再放开全量 |
| 来源变化 | 接口改了,数据格式变了,导出文件多了一列 | 平台后台改版、导出字段改名,取数环节要校验列名 |
| 怪数据 | 一条新闻能让某个词一夜冲上榜首 | 给环比涨幅设阈值,超过就标出来等人看 |
| 规则过时 | 出了一部片名像问句的新电影,旧规则没覆盖 | 被拒清单和保留清单定期抽查,新情况补进技能文件 |
| 格式损坏 | CMS升级、换主题或多了新区块类型,表格立刻像1998年做的 | 主题和插件更新后检查表格页的显示 |
共用工作区那个坑,国内团队尤其要记一笔。几个人共用一个n8n实例或者同一套API密钥,有人改了凭据或连接配置,别人的流程就可能悄悄失效。各自的流程用各自的凭据,改公共配置前在群里说一声,比事后排查省事得多。自动化随着时间慢慢走形的情况,站内AI自动化从第二周就开始走形那篇有更细的守护办法。
这套做法在哪些情况下不适用?
先说Ahrefs的特殊条件。它手里有自家的关键词库和品牌引用数据,Top Google Searches那一页写的是从287亿个关键词的数据库里取数。数据是别人拿不到的,自动刷新出来的东西才有独特价值。一个小站如果只是让AI每月去网上搜一圈、重新整理别人的榜单,刷出来的东西跟一手数据没法比,还可能撞上Google的规模化内容滥用政策。
这条政策的原文值得看一眼。Google在搜索垃圾政策里写的是:规模化内容滥用,指生成大量页面的主要目的是操纵搜索排名、对用户没帮助,不论内容是怎么做出来的;所举的例子里就有用生成式AI工具生成大量对用户没有价值的页面,以及抓取信息流、搜索结果再经同义替换、翻译等自动处理批量出页面。Si Quan的做法不怕这条政策,是因为每个页面本来就有人做、有人看,自动化只是把重复劳动拿走了,页面数量一页没加。AI内容和这条政策的关系,站内AI生成内容会被Google惩罚吗讲得更全。
再说Ahrefs自己的另一条路。Ryan Law在4月发过How I Do Content Engineering with Claude Code,用Claude Code串起23个自定义技能文件,6到12分钟出一篇可发布的草稿,写到那时用这套流程发了15篇左右、更新了30来篇。他说这套流程能把博客撑到几万篇,但他不会这么做,因为对Ahrefs和读者都没好处。两篇放在一起看,Ahrefs的取舍一目了然:自动化用来干最公式化的那部分活,产量不是目标。
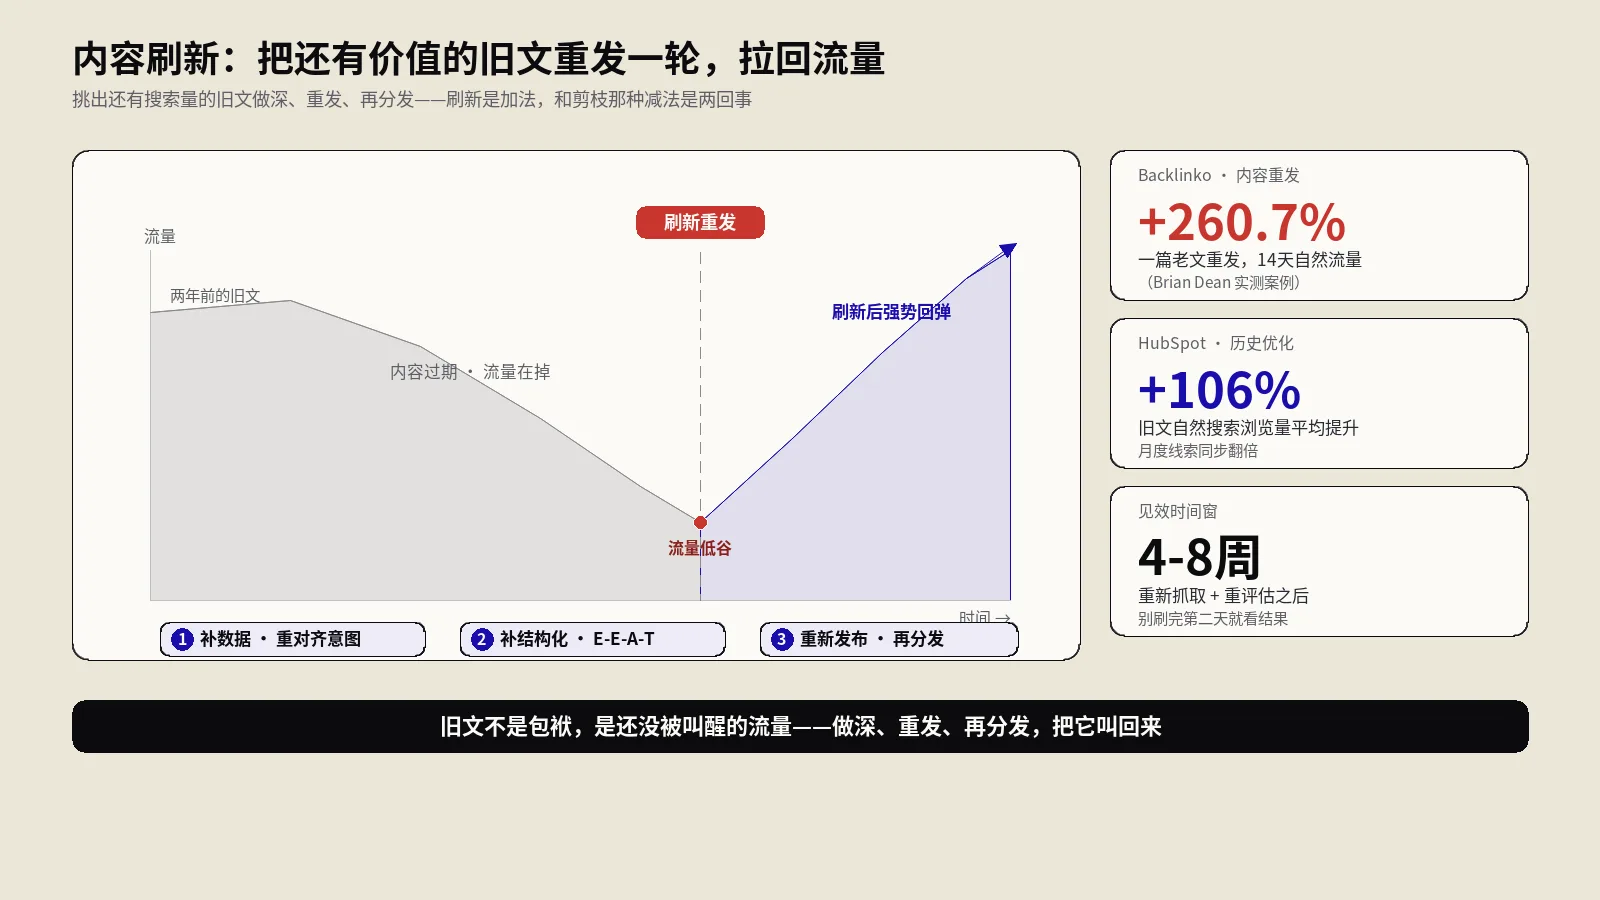
还有一类是规则不稳定的活。品牌立场文章、需要采访的深度稿、每次角度都不同的专题,靠一份清单是写不出来的,硬套流水线只会产出一批长得差不多的稿子。保哥的看法是,一件活能不能交给机器,先看你能不能把它写成一份别人照着做也不会走样的清单;写不出来,就说明它还得人来干。想先给全站的老文章排个刷新优先级,可以从内容刷新怎么做才能把流量拉回来那套流程起步,再挑其中最机械的一段交给机器。
原文结尾的问题可以原样借来问自己:做有用的内容时,是哪些环节拦着我们没法做更多?把这些无聊的环节交给AI,人把时间留给想法、观点、经验和品味,这些模型装不出来。
常见问题解答
内容自动化是不是就是用AI批量写文章?
原文的定义是用软件或AI完成一串可重复的内容生产任务。Ahrefs这个案例自动化的是数据型文章的月度更新,取数、清洗、做表、写草稿交给机器,选题、判断和发布仍由人负责,文章数量没有增加。
第一件交给AI的活该怎么选?
从最烦的重复活里挑,按五条筛:经常要做、每次耗时、规则相对稳定、做好了有业务价值、总被拖延。五条大都符合的活最适合先试,比如每月更新数据表、整理固定口径的报表。
为什么要保存被AI剔除的条目?
被拒清单是最早的报警器。本该保留的问句或有用的数据被误删时,看一眼被拒清单就能发现,然后改规则;只看最终结果,丢了什么根本无从知道。
自动更新的文章可以不经人审直接发布吗?
不建议。原文作者给自己定的规矩是永远不让AI自动发布,Google的AI内容指南也要求发布前人工核查标题、描述、结构化数据和图片alt。发出去的东西挂着你的名字,出错要你负责。
没有Letaido,用别的工具能搭吗?
能。原文明确说Claude Code、Codex等代理都可以,只是要自己接MCP、WordPress和数据库。Letaido是Ahrefs自家产品,原文推荐它带有自家立场,方法本身不依赖某个工具。
自动化跑稳以后还需要维护吗?
需要。模型升级、数据接口改版、突发新闻造成的异常数据、新出现的例外情况、CMS或主题更新,都可能让流程悄悄出错。要设失败提醒,并定期抽查保留清单和被拒清单。
权威参考资料
本文标题:《内容自动化从哪一步做起?Ahrefs把12份数据榜单的月更交给AI,发布键留在人手里》
本文链接:https://zhangwenbao.com/ahrefs-content-automation-data-refresh-workflow.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0