Claude Code Skill编写指南:frontmatter字段、四级作用域与避坑要点
本文目录
- Skill的定位是什么,与斜杠命令的差别在哪?
- 一个最小可用的SKILL.md需要哪些内容?
- name必填动名词、description限20字,这两条还成立吗?
- frontmatter的进阶字段各自控制什么?
- 命令名由什么决定,自定义命令是否已并入Skills?
- Skill的四级作用域如何决定可用范围?
- 怎样用附属文件让SKILL.md既精简又够用?
- 动态上下文注入与context:fork怎么用?
- 可复用的Skill设计原则有哪几条?
- 写Skill最容易踩的坑有哪些?
- 常见问题解答
- Skill的name字段必须是动名词形式吗?
- description是不是越短越好,最好20字以内?
- 自定义命令和Skill是两个不同的东西吗?
- 怎么让一个内容很多的Skill不浪费token?
- context: fork的作用是什么?
- 什么样的任务才值得做成Skill?
- 权威参考资料
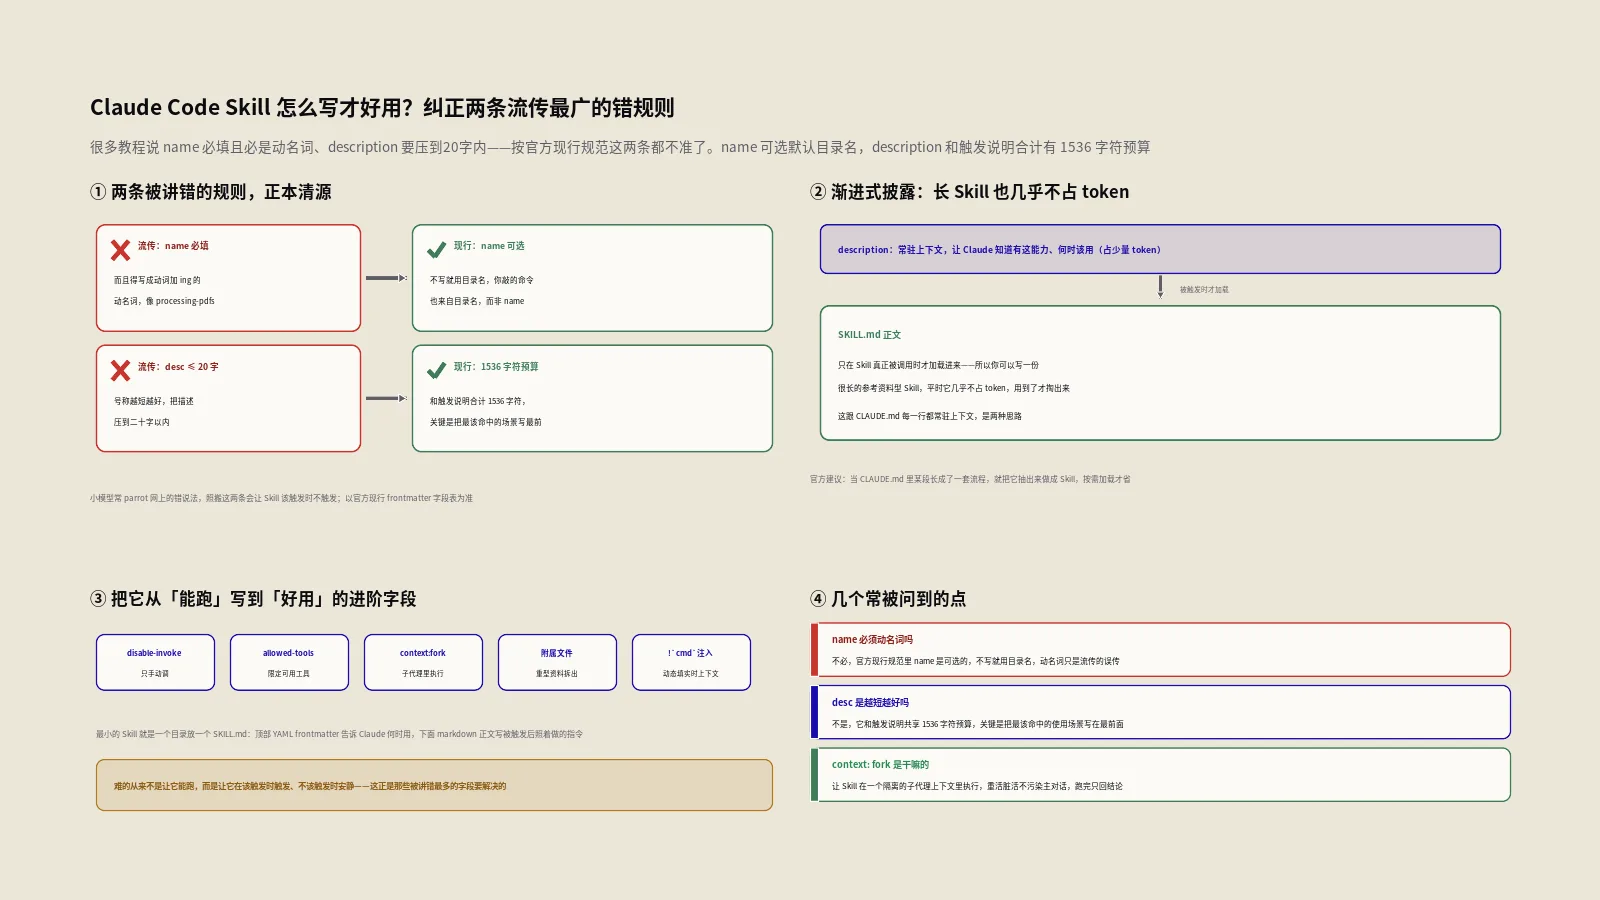
摘要:不少Skill教程把两条规则讲成定论:name字段必填、还得写成动词加ing的动名词形式,description要压到20字以内。按官方现行规范,这两条都不成立。name是可选字段,不写就用目录名,你敲的命令也来自目录名而非name;description不该越短越好,它和触发说明合起来有1536字符的预算,要诀是把最该命中的使用场景写在最前面。决定一个Skill好不好用的也不止这两个字段,disable-model-invocation、allowed-tools、context:fork、附属文件、动态上下文注入这一整套机制,才是把Skill从能跑写到好用的关键。本文按官方现行规范梳理frontmatter字段、四级作用域、渐进式披露和子代理执行,给出一套经得起用的Skill设计模式。
Skill的定位是什么,与斜杠命令的差别在哪?
Skill是把一套专业知识、工作流程或最佳实践打包成的“能力单元”:你写一个SKILL.md文件,Claude Code就把这项能力收进工具箱。它和手动敲斜杠命令的差别在触发方式上——斜杠命令要你主动点名,Skill则由Claude根据对话上下文自动判断什么时候该用,你在做什么,它就在相关的时候被调起来,不必每次点名。
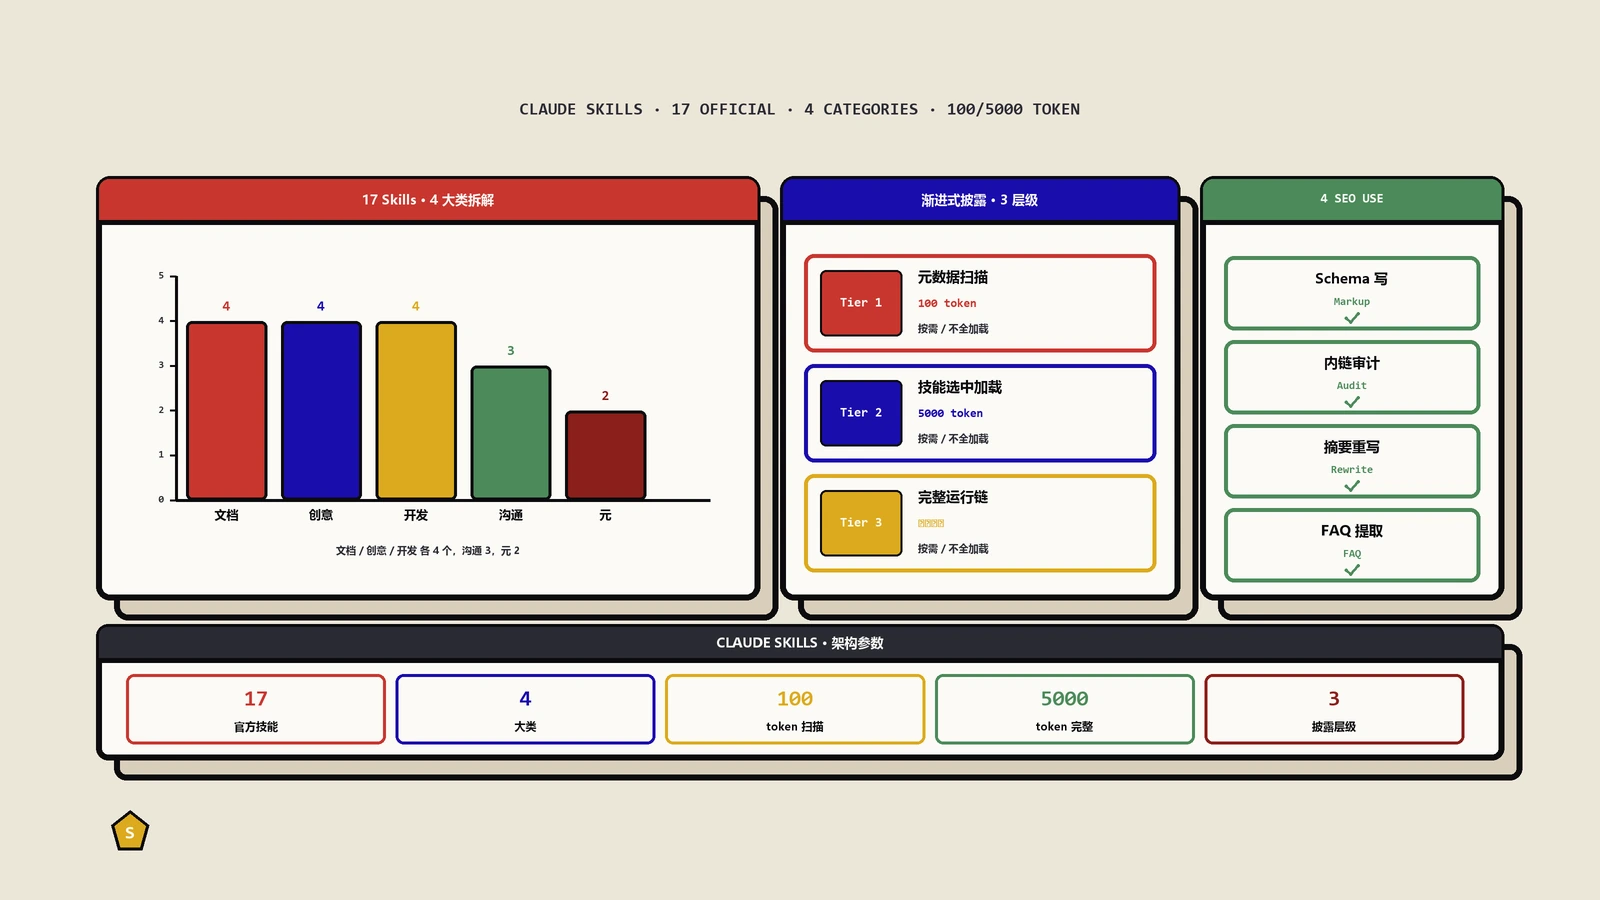
自动触发之下是一套省token的机制,官方叫渐进式披露。Claude Code官方的Skills文档把规则写得很明确:一个Skill的description会常驻在上下文里,好让Claude知道有这么个能力、什么时候该用,但它的正文只有在真正被调用时才加载进来。所以你可以写一份很长的参考资料型Skill,平时它几乎不占token,用到时才被读进上下文。
这跟CLAUDE.md把每一行都常驻上下文是两种思路。官方也据此建议:CLAUDE.md里某段一旦长成一套流程,就该抽出来做成Skill。两者怎么分工,保哥在CLAUDE.md和README该写什么那篇里写过,这里不重复,记住一句就够:Skill是按需加载的能力,这是它一切设计的出发点。
按需加载这条决定了Skill的写法:description要让Claude准确判断何时触发,正文要在被加载时直奔主题、不啰嗦,重型参考资料要拆到附属文件里,不能一股脑塞进来。后面讲的字段和模式,都围绕同一个目标——让这项能力在对的时机、用最省的代价被准确调起来。
一个最小可用的SKILL.md需要哪些内容?
一个Skill就是一个目录,里面放一个SKILL.md当入口。这个文件分两部分:顶上用---夹起来的YAML frontmatter,告诉Claude什么时候用这个Skill;下面是markdown正文,写Claude被触发后该照着做的指令。最小配置只要一段描述加几句指令就能跑起来:
---
description: 总结未提交的改动并标出风险点。当用户问改了什么、想要提交信息、或要审查diff时使用。
---

## 当前改动

!`git diff HEAD`

## 指令

把上面的改动用两三句话总结,再列出你注意到的风险,
比如缺少错误处理、写死的值、需要更新的测试。若diff为空,就说没有未提交的改动。
把它存成~/.claude/skills/summarize-changes/SKILL.md,重启Claude Code,你问“我改了什么”,它就会自动触发;也可以直接敲/summarize-changes手动调。里头那行!`git diff HEAD`要单独看:Claude Code会在把Skill内容送进去之前先把这条命令跑掉,用真实的diff结果替换掉它,后面专门讲这个机制。让一个Skill跑起来就这点东西,难的是让它在该触发时触发、不该触发时安静,这要回到那些被讲错最多的字段上。
name必填动名词、description限20字,这两条还成立吗?
这两条是流传最广的规则,也是错得最彻底的。不少教程写得斩钉截铁:name字段必填,而且得写成动词加ing的动名词形式,像processing-pdfs;description要言简意赅,最好20字以内。按官方现行规范,这两条都不成立。
先说name。官方的frontmatter参考里,name是可选字段,不是必填;不写它,就默认用Skill所在的目录名。更关键的一点是,触发Skill的那个命令名来自目录名,而不是frontmatter里的name,name只是显示在Skill列表里的一个标签。所以纠结name用不用动名词、要不要动词开头意义不大,决定命令叫什么的是你给目录起的名字。把目录命名得清晰、贴合功能,比抠name字段的词性有用得多。
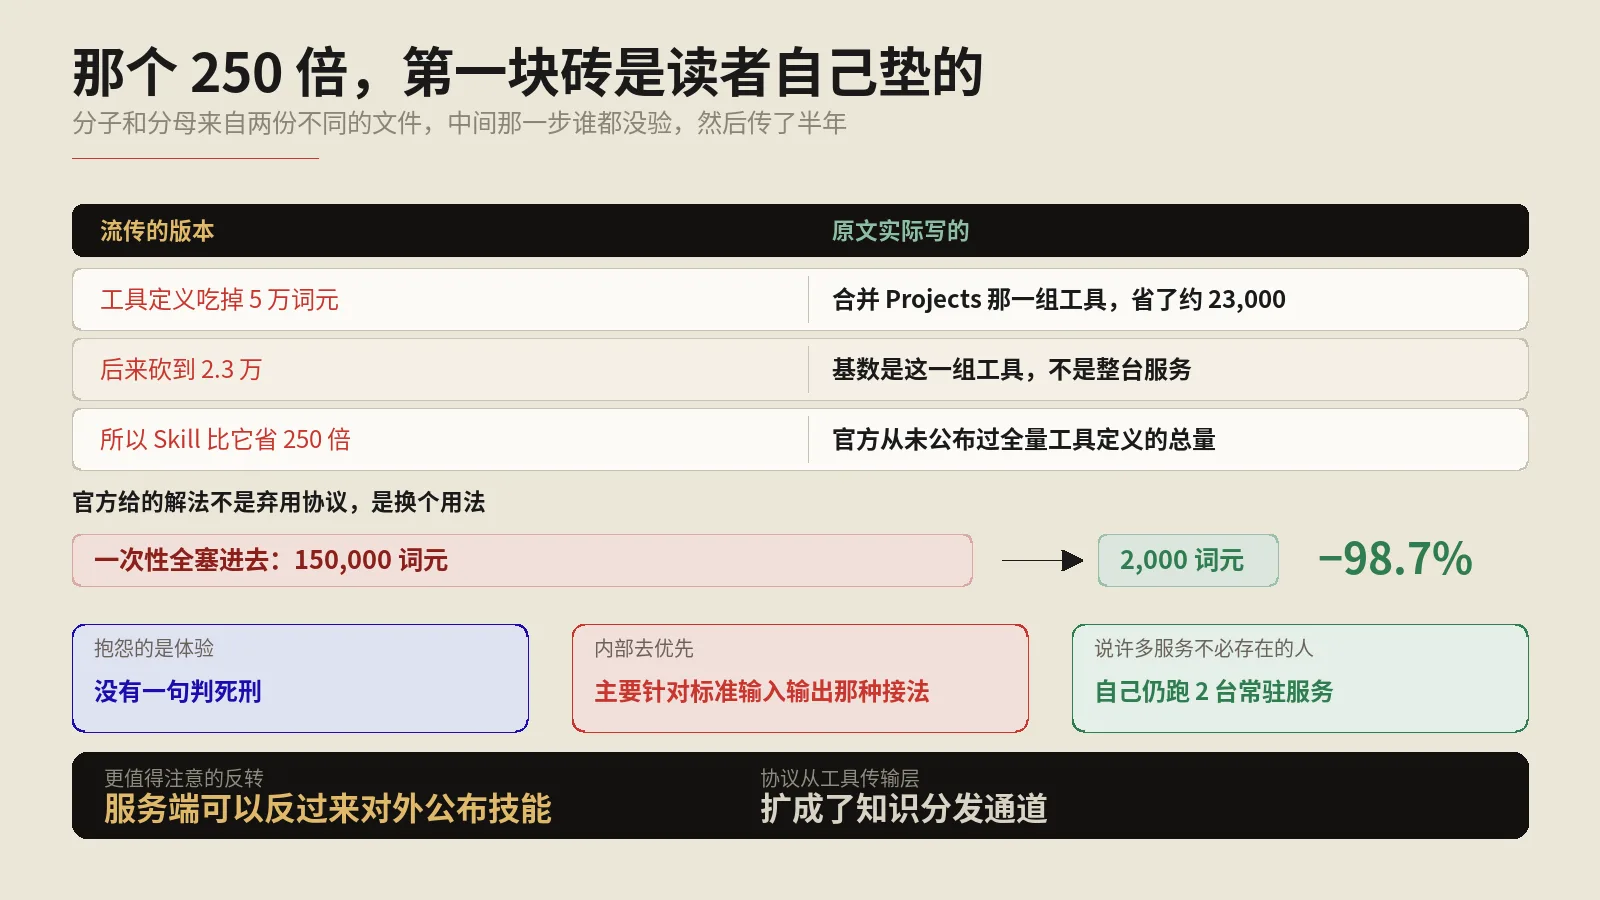
再说description。它不该被无脑压短。description是Claude判断何时该用这个Skill的唯一依据,写得太短,反而把能帮助命中的关键词砍掉了。官方的规则是:description和可选的when_to_use合起来,在Skill列表里被截断的上限是1536字符,这是个相当宽裕的预算,远不是20字以内。
要诀在于把最该命中的使用场景写在最前面,因为列表空间紧张时是从尾部开始截断。一句话:description要写得具体、带上用户会自然说出口的关键词、把核心用例顶到最前,而不是一味求短。这一条写好了,Skill触发的准头能上一个台阶;写砸了,它要么该出手时哑火,要么动不动乱触发。
frontmatter的进阶字段各自控制什么?
只用name和description,Skill的能力还剩一半没动。官方frontmatter里还有一长串字段,每个对应一种具体的控制需求,先看最常用的几个:
| 字段 | 作用 |
|---|---|
description | Claude判断何时触发的依据,写具体、关键词靠前(最该写好的一个) |
when_to_use | 补充触发场景和示例请求,接在description后面一起算进1536字符预算 |
disable-model-invocation | 设为true则只有你能手动调、Claude不会自动触发,给有副作用的操作用 |
user-invocable | 设为false则只有Claude能调、不在斜杠菜单露面,给纯背景知识用 |
allowed-tools | Skill激活时这些工具免确认直接用,比如放行特定git命令 |
context | 设为fork则在隔离的子代理上下文里跑这个Skill |
agent | 配合context:fork,指定用哪种子代理来执行 |
argument-hint | 自动补全时提示该传什么参数 |
其中两个字段最值得先配好。一个是disable-model-invocation: true:凡是带副作用、你想自己攥住触发时机的操作,比如部署、提交、给客户发消息,都该加上它,免得Claude自行判断后就把部署跑了。另一个是user-invocable: false,方向相反:某些纯背景知识型的Skill,比如“某个老系统是怎么运作的”,对人来说/某某并不是一个有意义的动作,但Claude在相关时该知道,这类就藏起来只让Claude用。
两个字段配合起来,你能精确控制每个Skill属于哪一类:只归你调用的命令、只由Claude自动调起的背景能力,或者两者都行。这种控制精度,正是Skill比一根光秃秃的斜杠命令强的地方。
表里没展开的还有几个字段,让控制粒度更细。model能指定这个Skill激活时用哪个模型,比如一个简单的格式化Skill就走便宜的小模型,不必动用最贵的那档,省钱;effort则单独调这个Skill的思考力度。paths用glob模式限定Skill只在你处理匹配的文件时才自动加载,比如一个只管前端规范的Skill,设上paths: "src/web/**",你改后端时它就不会被拉进来,触发更精准。
shell能指定动态注入命令用bash还是PowerShell,Windows用户会用到。这些字段平时未必都用得上,但遇到“想让某个Skill只在特定情况下、用特定代价生效”的需求时,知道它们存在,你就知道该去拧哪个旋钮,不用硬在description里绕。
命令名由什么决定,自定义命令是否已并入Skills?
命令名这件事还牵出另一个大变化,顺着name一起说清。放在~/.claude/skills/或.claude/skills/下的Skill,命令名来自目录名:.claude/skills/deploy-staging/SKILL.md对应的命令就是/deploy-staging。这个规则简单可靠,记住目录名即命令名基本不会错。
那以前在.claude/commands/下写的自定义命令呢?官方已经把自定义命令并入了Skills:一个.claude/commands/deploy.md和一个.claude/skills/deploy/SKILL.md都会生成/deploy命令,行为一致。你原来.claude/commands/里的文件照样能用,不用迁移;Skill则多出三样能力:可以带附属文件、能用frontmatter控制由谁触发、能让Claude在相关时自动加载。新写的优先用Skill的目录形式,能力更全。不少老教程没跟上这条变化,仍把自定义命令和Skill当成两个东西讲,实际上它们早就合流了。
Skill的四级作用域如何决定可用范围?
常见说法只提到个人级和项目级两种,官方现在是四级作用域,放在哪一级决定了谁能用、能用在哪:
| 层级 | 路径 | 作用范围 |
|---|---|---|
| 企业级 | 由托管设置部署 | 组织内所有用户 |
| 个人级 | ~/.claude/skills/ | 你的所有项目 |
| 项目级 | .claude/skills/ | 仅当前项目,可提交共享 |
| 插件级 | 插件目录下的skills/ | 启用该插件处 |
分层逻辑跟CLAUDE.md那套作用域一脉相承:你个人不管在哪个项目都想要的Skill,放个人级;只跟某个项目相关、又想让队友也能用的,放项目级并提交进仓库;要打包分发给一群人的,做成插件。同名时企业级压个人级、个人级压项目级,插件级则用插件名:Skill名的命名空间,不会跟其他层冲突。
一个实用习惯是:先在个人级把一个Skill调顺手,确认好用了,再决定要不要下沉到项目级共享给团队,别一上来就往项目仓库里塞半成品Skill,污染队友的环境。
怎样用附属文件让SKILL.md既精简又够用?
Skill被调用后,它的正文会作为一条消息进入对话,并在整个会话里一直留着,所以正文的每一行都会被反复计入token,写臃肿就是持续消耗预算,还会稀释注意力。但一项能力又常常需要配上大段的参考资料。两头兼顾的办法是附属文件。
一个Skill目录里,SKILL.md是必需的入口,旁边还可以放别的文件:详细的API参考、示例集、能执行的脚本。SKILL.md只保留精炼的概览和导航,重料拆到单独文件里,用到了Claude才去读。官方建议SKILL.md正文控制在500行以内,超了就该往附属文件搬。目录大致长这样:
my-skill/
├── SKILL.md        必需,概览与导航
├── reference.md    详细参考,用到才加载
├── examples.md     示例集,用到才加载
└── scripts/
    └── helper.py   脚本,被执行而非读进上下文
关键动作是在SKILL.md里用一句话点明每个附属文件装了什么、什么时候该看,比如“完整API细节见reference.md”。Claude据此判断,需要时才按图索骥去加载,平时这些重料一个token都不占。把常驻的导航和按需的细节分开,就是渐进式披露的落地写法,也是Skill不发胖的关键一招。再配上正文只说做什么、不解释为什么,Skill就能同时做到轻和够用。
脚本类附属文件还有一个额外好处:它由Claude执行,不读进上下文,所以可以塞进任意复杂的逻辑(生成可视化、跑校验、批处理),脚本干重活,Claude只管编排。
动态上下文注入与context:fork怎么用?
再往上一层,是让Skill接入实时数据,甚至开出独立的工作空间。两个官方机制要单独讲。
第一个是动态上下文注入,就是开头见过的!`命令`语法。Skill正文被送给Claude之前,这些命令先被跑掉,输出替换掉占位符。于是Claude拿到的是已经填好的真实diff内容,而不是一句“去看看diff”。给Skill喂实时数据很顺手,比如总结PR时先把!`gh pr diff`的结果注进来。两点要记牢:这是预处理,Claude不执行命令,只看到最终填好的结果;!要出现在行首或紧跟空白才生效。
第二个分量更重:用context: fork让Skill在一个隔离的子代理里跑。加上这个字段,Skill的正文就变成驱动一个子代理的任务提示,子代理不带你当前的对话历史,自己开一片干净的上下文去干活,干完把结果汇报回来。配合agent字段还能指定用哪种子代理,比如用只读、专为代码探索优化的Explore代理去跑一个研究型Skill:
---
name: deep-research
description: 彻底研究某个主题。当需要在代码库里深入排查、跨多文件梳理时使用。
context: fork
agent: Explore
---

彻底研究 $ARGUMENTS:
1. 用Glob和Grep找到相关文件
2. 读懂并分析代码
3. 给出带具体文件引用的结论
这段里还出现了$ARGUMENTS,它是参数占位符:你敲/deep-research支付回调逻辑,这串就被替换进去。需要按位置取参时还能用$0、$1这种简写。
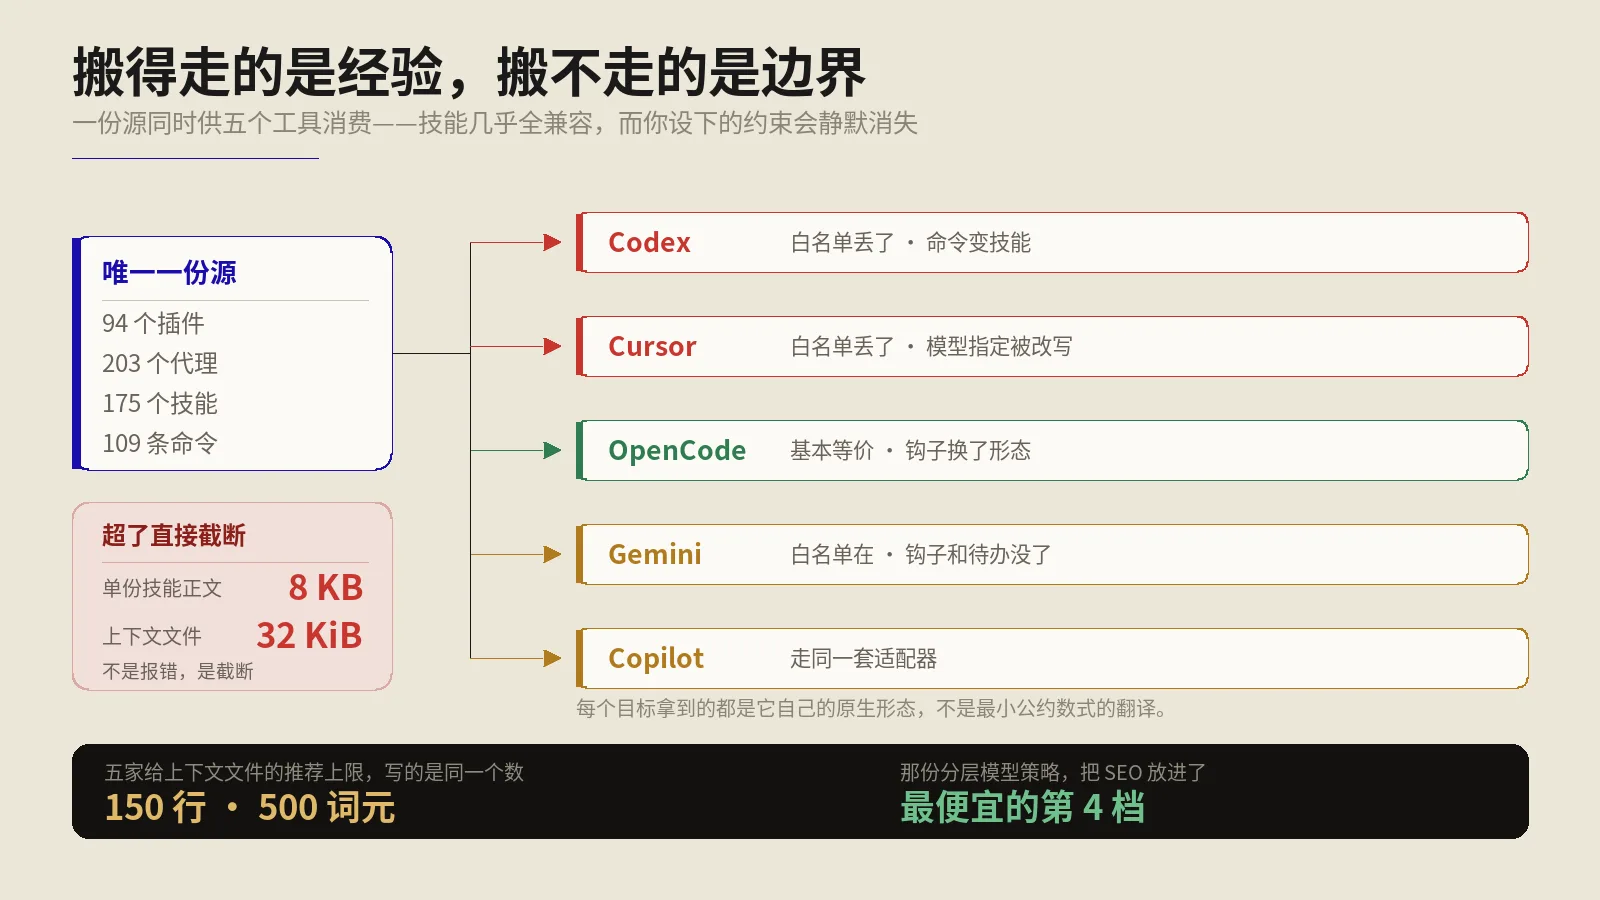
context: fork的价值是把重型、发散的任务隔离出去跑,不污染你主对话的上下文。它跟MCP、子代理是配套使用的一套机制,保哥在三大扩展机制怎么选里讲过三者各管一段,搭起来用威力才出得来。Agent Skills开放标准本身也是跨工具通用的,Claude Code在它基础上加了触发控制、子代理执行这些扩展,所以你学到的这套设计模式,迁移性也不差。
可复用的Skill设计原则有哪几条?
把前面的字段和机制收拢成四条能直接照着用的设计原则,省得你下次写Skill还得从头琢磨。第一条,description优先:它是触发的命门,永远先把它写具体、把核心用例顶到最前,宁可在它身上多花10分钟,也别让一个好Skill因为描述模糊而总不触发。第二条,正文越精炼越好:只写“做什么”的指令,不写“为什么”的解释,重料一律拆去附属文件,把SKILL.md当导航,不当仓库。
第三条,按副作用决定触发权:纯查询、纯生成的安全操作放手让Claude自动触发,带部署、提交、对外发送这类副作用的,一律加disable-model-invocation攥在自己手里。第四条,按作用域分层:个人习惯放个人级,团队约定放项目级提交共享,这套分层思路和CLAUDE.md的四级作用域是一以贯之的。
用一个真实场景把这套原则走一遍。保哥带的一个做宠物用品独立站的团队,每周要给十几个核心竞品做一轮上新与改价巡检,过去靠人工一个个翻、整理成表,慢且容易漏。后来把它做成了一个Skill:description写得很具体——“巡检竞品上新和价格变动并汇总成表,当用户要做竞品周报、对比竞品价格时使用”,关键词全带上,触发准确也不误伤;正文只留5步精炼指令,详细的竞品清单和字段口径拆进了同目录的reference.md,平时不占token。
这活要跑一堆抓取,属于重型发散任务,就给它加了context:fork扔到子代理里跑,不污染主对话的上下文;它又只查不改、没有副作用,于是放开让Claude在相关时自动触发。配置完成后,运营同事说一句“出本周竞品周报”,成品表就自己生成好了。零散的字段落到一个真实需求上,立刻拼成了一个顺手的工具,设计模式的意义也在这里:不用背字段,而是知道在什么场景该拧哪个旋钮。
写Skill最容易踩的坑有哪些?
下面是高频翻车点,照着自查能少走很多弯路。
第一坑,目录结构写错,Skill直接失效。SKILL.md必须放在一个目录里,比如.claude/skills/my-skill/SKILL.md,不能图省事写成.claude/skills/my-skill.md;文件名也得是大写的SKILL.md,大小写敏感。这个错最隐蔽,因为它不报错,只是单纯不触发,对着一个“怎么调都没反应”的Skill查半天,根子常在路径上。
第二坑,触发不准。该触发时哑火,多半是description没写好,没带上用户会自然说出口的关键词,Claude匹配不上;回去把description写具体、把核心用例顶到最前。反过来,乱触发、该安静时插嘴,是description写得太泛,把它收窄,或者干脆加disable-model-invocation: true改成只手动调。
第三坑,正文写太长。正文常驻上下文、每行都在烧token,长流程和大参考资料该拆去附属文件,SKILL.md只留精炼指令。最后一坑是过度工程化:并非每件小事都值得做成Skill,一句话能交代清楚的事硬包成Skill,纯属给自己添维护负担。判断标准很简单,你是不是反复在把同一套指令、清单或多步流程贴进对话?是,才值得固化成Skill;偶尔用一次的,随手说就好。这几坑避开,写出来的Skill就既好触发、又好维护。
常见问题解答
Skill的name字段必须是动名词形式吗?
不必,name也不是必填字段。按官方现行规范,name可选,不写就默认用Skill所在的目录名;触发Skill的命令名同样来自目录名,而不是frontmatter里的name。所以动词加ing这类词性讲究意义不大,把目录名起得清晰、贴合功能才更实在。那条动名词规则属于过时说法。
description是不是越短越好,最好20字以内?
恰恰相反。description是Claude判断何时触发的唯一依据,压得太短会把能帮助命中的关键词砍掉。官方规则是description和when_to_use合起来上限1536字符,预算相当宽裕。要诀在于写具体、带上用户会自然说出口的关键词、把最该命中的使用场景顶到最前面,因为空间紧张时是从尾部截断。
自定义命令和Skill是两个不同的东西吗?
已经合流了。官方把自定义命令并入了Skills,一个.claude/commands/deploy.md和一个.claude/skills/deploy/SKILL.md都会生成/deploy命令、行为一致。原来commands目录里的文件照样能用,不必迁移;Skill则多了附属文件、触发控制、自动加载这几项能力。新写的优先用Skill的目录形式。不少老教程还把两者当两回事讲,实际上早就是一套了。
怎么让一个内容很多的Skill不浪费token?
用附属文件做渐进式披露。SKILL.md只保留精炼的概览和导航,把详细API参考、示例集、脚本拆到同目录的单独文件里,并在SKILL.md里点明每个文件装了什么、何时该看,Claude用到才加载,平时不占token。官方建议SKILL.md正文控制在500行内。正文本身也只说做什么、不解释为什么,因为它被调用后会一直常驻上下文。
context: fork的作用是什么?
它让Skill在一个隔离的子代理上下文里跑:Skill正文变成驱动子代理的任务提示,子代理不带你的对话历史,自己开一片干净上下文去执行,干完汇报结果。配合agent字段还能指定用哪种子代理,比如用只读的Explore代理跑研究型任务。价值在于把重型、发散的任务隔离出去,不污染你主对话的上下文,适合研究、批量分析这类活。
什么样的任务才值得做成Skill?
判断标准是看你是不是反复在把同一套指令、清单或多步流程贴进对话。是,就值得固化成Skill,省得每次重打;偶尔用一次、一句话能交代清的事,随手说就好,硬包成Skill反而添维护负担。另一个信号来自CLAUDE.md:里面某段一旦从一条事实长成一套流程,就该抽出来做成Skill,让它按需加载而不是常驻。
本文标题:《Claude Code Skill编写指南:frontmatter字段、四级作用域与避坑要点》
本文链接:https://zhangwenbao.com/claude-code-skill-patterns.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0