商品评分四个数对不上,AI拿走的是商家自己填的那一个
本文目录
- AI说这家店评价不好的时候,它看的是哪个数字?
- 这次是怎么量的?
- 第一套:品牌自己商品页上写给机器读的分
- 第二套和第三套:第三方平台上的显示分,和同一批评价的算术平均
- 第四套:页面上带出来的那几条评价
- 品牌自己写给机器读的那个分,长什么样?
- 用两条评价报出一个满分
- 宿主类型基本都对,个别写错了地方
- 同一批品牌,在第三方那里是几分?
- 两个分并排放,差多少?
- 同一批评价,换个算法能差出3分吗?
- 把那7条中性评价加回去,小店的分立刻对上了
- 评价多的那些,差在时间这一头
- 页面上带出来的那20条评价,是最新的吗?
- 不跑JavaScript读到的分,和页面上显示的分一样吗?
- 反方向也会发生:渲染之后,原来有的分没了
- 谷歌那边的规矩,和ChatGPT那边是两套吗?
- 做独立站的,现在该动哪几处?
- 先确认机器读到的是哪一个数
- 条数太少就别写这个分
- 别把别家的分搬进自己的结构化数据
- 第三方平台上的分,要看最近这一段
- 把口径写进你自己的报表
- 顺手检查那张feed
- 这次测量有哪些地方靠不住?
- 常见问题解答
- 商品页上写aggregateRating会被谷歌判违规吗?
- 只有几条评价,该不该写平均分?
- Trustpilot上的分怎么和页面上的星级分布对不上?
- ChatGPT的商品feed里必须填评分吗?
- AI会不会自己去第三方平台核实评分?
- 权威参考资料
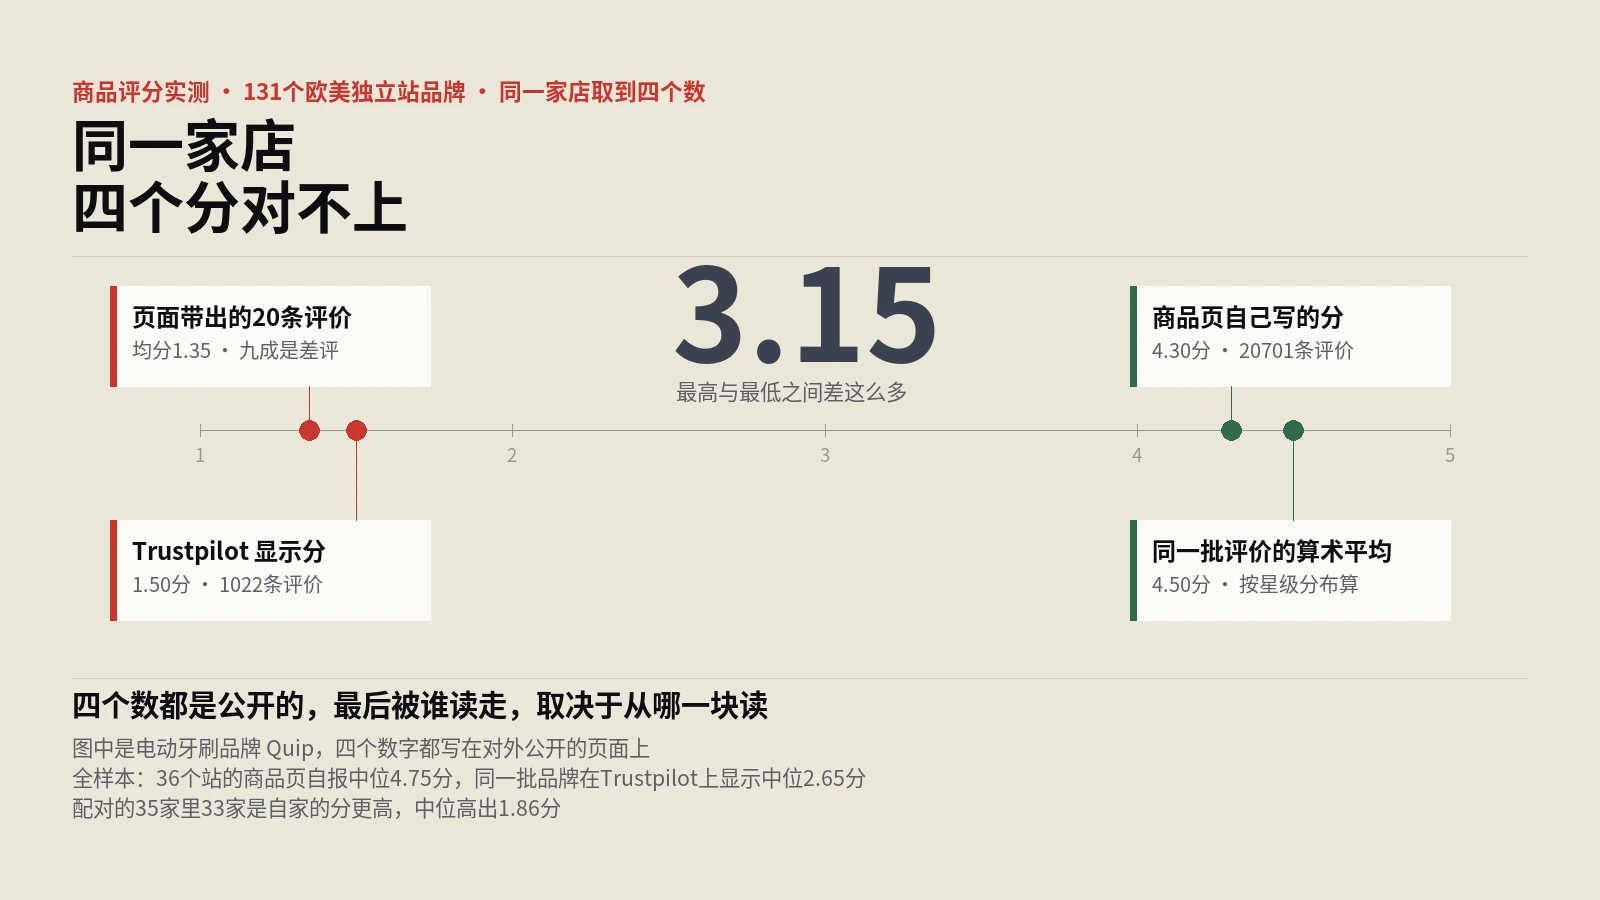
摘要:131个欧美独立站品牌,同一家店至少有四个评分对不上。商品页原始HTML里写给抓取器读的那个,36个站的中位数是4.75分,写着满分的7家里有6家评价不超过6条;同一批品牌在Trustpilot上显示的中位数是2.65分,两边能配对的35家里33家是自家的分高,中位高出1.86分。把Trustpilot的星级分布按算术平均重算,126家里18家和显示分差1分以上,Notino一家差3.46分。把平台公布的7条中性先验加回去,两条评价的BabyBjörn算出3.83,页面上写的正是3.8。而ChatGPT的商品数据规范里,评分是商家自己填的一个字段,帮助页写明它不由OpenAI核实。
Exploding Topics在7月做过一次2338人的美国消费者调查,Semrush在9月初把结果发了出来。里面有个数字值得做电商的人看两眼:74.15%的受访者说,如果AI聊天机器人告诉他们某个产品的评价好坏参半或者偏负面,他们购买的意愿会下降;只统计正在用AI的人,这个比例是85.31%。反过来的数字是57.5%,这些人真的因为聊天机器人说的话放弃过一次购买。
调查的口径要留神,样本是自主报名的在线调查,不同问题的分母还不一样。但方向上的事情不难判断:越来越多的人在下单之前会问一句机器,而机器的回答里一定会带上评价和评分。
那就有了一个能查的问题。机器嘴里那个分,到底是谁给的。
这篇不讨论怎么攒评价,站内的电商产品评论的采集与结构化写过流程;也不讨论刷单和假评论的经济账,刷一条假评论挣多少钱那篇把分母都拆过了。这次只做一件事:把同一家店在不同地方显示的评分,一个一个抓回来放在一张表里,看它们对不对得上。
AI说这家店评价不好的时候,它看的是哪个数字?
先看规范怎么写的,这比猜要快。
OpenAI在开发者站上公开了一份商品数据规范,商家可以把自己的商品目录交给ChatGPT。规范里跟评价有关的字段只有两个:review_count是商品评价条数,star_rating是0到5分的平均分,保留两位小数,文档给的示例值是4.50。两个字段都是可选的,规范只要求它们描述同一批评价,不要在变体之间重复累加。
字段说明里没有任何一句写着这个分要从哪里来,也没有写谁来核对。它就是商家自己填进去的一个数。另有一组store_review_count和store_star_rating,用来描述店铺整体的评分,属于需要额外开通的字段,同样是自填。
OpenAI的帮助页写得更直白。那一页解释ChatGPT怎么挑商品,说模型会考虑价格、评价、易用性等因素,商品数据来自第一方和第三方提供商;讲到评价和评分那一段,最后一句是评价和评分不由OpenAI核实。
Shopify的店铺不用做任何事,商品数据已经通过Shopify Catalog进去了。这条路径上有多少商品在流动,站内量过一次,ChatGPT购物推荐里有65%来自商品feed。
所以链条是清楚的:商家填一个分,平台不核实,模型拿它跟别的信号一起排出推荐,用户听到的是一句“这家的评价不太好”或者“这款口碑很好”。商品在AI购物里靠什么被选中,站内从集合页这一侧也拆过。
那就值得问问,商家自己填的那个分,和别人给这家店打的分,差多少。
这次是怎么量的?
样本是一份固定的品牌清单:131个欧美独立站品牌,覆盖服饰、家居、户外、个护、小家电几个大类,这份名单在站内做过好几轮实测,这次继续用它,方便和以前的结论对上。
要取的数字有四套,取法各不相同。
第一套:品牌自己商品页上写给机器读的分
从每个品牌的商品站点地图里取商品页,每站最多两条,用普通的浏览器UA去请求,拿到什么就是什么,不跑JavaScript。然后从原始HTML里找aggregateRating,JSON-LD和微数据两种写法都收,只保留5分制的(bestRating不是5的丢掉,有些站用的是10分制或者100分制)。这一步模拟的就是一个不渲染页面的抓取器看到的东西。
第二套和第三套:第三方平台上的显示分,和同一批评价的算术平均
Trustpilot的品牌页用带浏览器的方式抓,从页面自带的数据里取三样东西:平台显示的TrustScore、各星级各有多少条评价、页面结构化数据里带出来的那几条评价。星级分布能算出一个算术平均分,它和显示的TrustScore不是一回事,下面会看到这两个数差多少。
第四套:页面上带出来的那几条评价
Trustpilot的品牌页在结构化数据里会带出一批Review节点,每条有日期和星级,中位数是20条。它们的均分是第四个数。
另外做了两组对照。一组是同一天把Trustpilot的页面再抓一遍,看显示分、评价数、星级分布这三样会不会变,这是自基线,用来确认后面看到的差异不是抓取本身抖出来的。另一组是挑一批商品页用真浏览器渲染一遍,对比不跑JavaScript时读到的评分和跑完之后读到的评分。
品牌自己写给机器读的那个分,长什么样?
先说能不能读到。131个品牌里,有83个站的商品页能正常取回HTML;这83个站的原始HTML里,写了5分制aggregateRating的只有36个,43%。
剩下那57%不是都没有评价。页面里到处是评价组件的痕迹:这83个站里,56个站的商品页上能看到Yotpo,39个有Okendo,15个有Bazaarvoice,11个有Junip,Judge.me和TurnTo各5个,不少站同时装了两三家。组件装了,星星在页面上转着,结构化数据那一份却没有跟着写进原始HTML。评价组件怎么把数据接进结构化数据,站内以Ryviu为例写过一份完整配置。这件事下一节会用浏览器再验一遍。
再看写了的那36个站,分数长这样:中位4.75,最低3.00,最高5.00,4.5分以上的26家占72%,低于4分的只有2家。
| 分档 | 站数 | 说明 |
|---|---|---|
| 4.9及以上 | 13 | 其中7家写着满分5.00 |
| 4.5到4.89 | 13 | |
| 4.0到4.49 | 8 | |
| 低于4.0 | 2 | 最低3.00分,评价条数2 |
这个分布不奇怪。商品页上的评分来自这家店自己收集的评价,收集渠道通常是下单后的邮件邀请,愿意回来打分的本来就偏满意的那一批,再加上大部分评价组件默认只展示已审核通过的。结果就是所有人的分都挤在4.5到5.0之间。一个班全考95分以上,这个分数就不再告诉你谁学得好。把评价做成能被搜索和AI用上的资产,站内的UGC资产化那一套讲过怎么排。
用两条评价报出一个满分
更值得看的是分数背后的条数。这36家的reviewCount中位数是140条,但有10家不到10条:Taylor Stitch的商品页写着5.00分,条数是1;Jackery、Outdoor Voices、LookFantastic也写着5.00分,条数都是2;Reebok写着4.40分,条数是7。写着满分的一共7家,其中6家的评价不超过6条。
结构化数据的规范没有禁止这种写法,谷歌的文档也只是建议评分最好伴随评论正文和作者名。问题在于,这个数字流进feed、流进AI的回答之后,1条评价的4.9分和6700条评价的4.9分,在一句“评分很高”里是分不出来的。条数字段虽然也在feed里,但它是不是会被用来加权,规范没有写。
宿主类型基本都对,个别写错了地方
这36家把aggregateRating挂在哪个类型底下:挂Product的20家,挂ProductGroup的13家,还有1家用了SoftwareApplication,1家直接挂了个没有类型的对象,1家把AggregateRating单独放在顶层。
那家用SoftwareApplication的是瑜伽服品牌Alo Yoga,商品页上写着4.90分、6700条评价,宿主类型却是软件应用。它大概率是从App的评分模板里抄过来的,这种错配站内拆过一次,第三方评测背书写进结构化数据时属性挂不上去那篇讲的是同一类问题。
同一批品牌,在第三方那里是几分?
131个品牌里,128个在Trustpilot上能抓回资料页,其中126个已经有评分。这126家的TrustScore中位数是2.65分,2分以下的40家,3分以下的69家,4分以上的32家,4.5分以上的只有10家。评价条数中位995条,不足50条的17家,超过一万条的21家。已认领资料页的94家。
这个分布本身就够刺眼。如果只看这一个来源,欧美独立站有一多半属于差评占多数的商家。但先别急着下结论,这份名单上的品牌都是有一定规模的,Trustpilot上愿意主动去写评价的人本来就偏向两头,而且下面会看到,这个显示分和评价本身的分布经常对不上。
两个分并排放,差多少?
把站内自报分和Trustpilot显示分能配上对的,一共35家。
站内的分减去第三方的分,中位数是+1.86,平均+1.66。35家里33家是自家的分更高,只有2家更低。差1分以上的22家,差2分以上的17家,差3分以上的6家。
| 品牌 | 商品页自报 | 自报的评价条数 | Trustpilot显示分 | Trustpilot评价条数 |
|---|---|---|---|---|
| Alo Yoga | 4.90 | 6700 | 1.4 | 1379 |
| Béis | 4.90 | 5181 | 1.6 | 263 |
| UNTUCKit | 4.80 | 1368 | 1.6 | 163 |
| Reebok | 4.40 | 7 | 1.4 | 1788 |
| Oclean | 5.00 | 588 | 2.0 | 171 |
| Quip | 4.30 | 20701 | 1.5 | 1022 |
| Rothy's | 4.70 | 824 | 2.0 | 197 |
| Away | 4.47 | 43 | 4.7 | 2681 |
两个分都没算错,它们量的本来就不是同一件事。商品页上的分问的是“买了这件商品的人满不满意”,而且只问了那些被邀请回来打分的人;Trustpilot上的分问的是“和这家店打过交道的人怎么说”,退货、客服、发货延迟、订阅扣款,全算在里面,写评价的人也多半是自己找上门的。这一层的承诺有没有同时写给机器看,站内量过63个站的配送与退货承诺。
可这两个数字在机器眼里长得一模一样:一个0到5之间的小数,配一个条数。没有哪个字段旁边标着一句这个分是问谁得来的、问的是哪一段经历。
同一批评价,换个算法能差出3分吗?
Trustpilot的页面上除了那个大字号的分,还给了各星级各有多少条评价。把这份分布按最普通的算术平均算一遍,再和平台显示的分并排放:126家里,两个数差半分以上的有40家,差1分以上的18家,差2分以上的6家。
| 品牌 | 平台显示分 | 星级分布的算术平均 | 差值 | 评价条数 |
|---|---|---|---|---|
| Notino | 1.1 | 4.56 | +3.46 | 1133 |
| Quip | 1.5 | 4.50 | +3.00 | 1022 |
| About You | 1.3 | 3.47 | +2.17 | 390 |
| Arc'teryx | 2.4 | 4.52 | +2.12 | 14410 |
| Casper | 2.3 | 4.33 | +2.03 | 6093 |
| Framebridge | 4.0 | 2.41 | −1.59 | 96 |
Notino那一行值得多看一眼:1133条评价里5星占82%、1星只占7%,怎么算都是一家口碑不错的店,平台给出的分是1.1。Arc'teryx有14410条评价,算术平均4.52,显示2.4。
这不是谁算错了。Trustpilot在帮助页里把口径写得很清楚:TrustScore不是简单平均,计算时考虑三件事。一是时间,越新的评价权重越高;二是频率,评价来得越规律分数越稳;三是每家店的计算里都会先掺进7条中性的3.5星评价,评价多了以后这7条的影响会被稀释。另外写明了不区分评价来源,邀请来的、自然来的、已验证的,权重一样;同一个顾客多次评价,只算最近那一条。
把那7条中性评价加回去,小店的分立刻对上了
这条口径可以直接验算。取评价不足50条的17家,先算它们星级分布的算术平均,再按公式把7条3.5星掺进去,看结果离显示分有多远。
| 品牌 | 评价条数 | 算术平均 | 掺进7条3.5星之后 | 平台显示分 |
|---|---|---|---|---|
| BabyBjörn | 2 | 5.00 | 3.83 | 3.8 |
| Liquid Death | 9 | 1.00 | 2.09 | 2.1 |
| Olipop | 6 | 2.50 | 3.04 | 3.7 |
| Snow Peak | 5 | 2.40 | 3.04 | 3.2 |
| Marine Layer | 22 | 2.32 | 2.60 | 2.6 |
BabyBjörn只有2条评价,两条都是5星,算术平均满分,掺完先验之后是3.83,页面上写的是3.8。Liquid Death那9条全是1星,算完2.09,页面上写的是2.1。整组17家的偏差中位数,从掺先验前的−0.19收敛到了+0.05。
也有对不上的。Olipop那6条评价算完是3.04,页面上写的是3.7,还差着0.66。公式只公开了三个因素,时间权重具体怎么衰减没有写出来,所以这一步只能说明先验确实在起作用,不能说把分数完全还原了。
评价条数少的时候,页面上那个分有一大半是这7条虚拟评价投出来的。两条真实评价的店和两千条评价的店,分数摆在一起长得一模一样,都是一个带星星的数字。
评价多的那些,差在时间这一头
先验解释不了Notino和Quip这种。它们评价上千条,7条中性评价早就被稀释没了,差出来的3分只能来自时间权重:老评价好、新评价差,分数就会被压到跟历史分布完全对不上的位置。
Quip正好是个能对照的例子。它的星级分布里5星占76%、1星占7%,算术平均4.50;而页面结构化数据里带出来的那20条评价,日期从2025年7月排到2026年9月,均分1.35,其中18条是1到2星。同一家店,历史上的评价和最近的评价是两回事,平台的分跟着最近那一头走,星级分布那张图还留着历史的样子。
这两个数字都写在同一个页面上,谁拿走哪一个,取决于抓的是哪一块。
页面上带出来的那20条评价,是最新的吗?
第四个数来自Trustpilot页面结构化数据里的Review节点,126家都有,条数中位20条。它们看上去像是“最新评价”,实际情况要复杂一点。
99家的最新一条落在2026年9月之后,确实是新鲜的;但有5家的最新一条还停在2026年之前,最旧的一家停在2022年3月。跨度也不一致,中位是从2026年6月底到9月中旬,也有站是横跨好几年的几条凑在一起。
再看这批评价的分数偏向。这批评价的均分比全量算术平均低的有85家,高的35家,差值中位−0.25;这几条里1到2星的占比中位数是70%,而全量分布里1星的占比中位数只有36.8%。
页面上顺手能被机器读走的那二十来条评价,比这家店的整体评价明显更负面。一个只读这一块的抓取器,会得到一个比平台显示分还低的印象。
不跑JavaScript读到的分,和页面上显示的分一样吗?
上一节有个没解释的现象:83个站里只有36个把评分写进了原始HTML,剩下的装了评价组件却读不到分。挑26个商品页用真浏览器跑了一遍,等页面加载完、往下滚一段,再读同一份DOM。
先看原始HTML里没有评分的那16个页面。渲染完之后,有3个站的结构化数据出现了:Anker一款充电器是4.87分、223条评价,Brooklinen是4.5分、7158条,Cluse是4.52分、26161条。评分一直都在,只是要等脚本跑完才写进页面。
另有2个站渲染完也没有结构化数据,但页面元素上写着分数。Casper的商品页有一个可访问性标签,内容是这款商品4.5分、共4423条评价;Decathlon的标签写着这款商品评分4.75分。人能看见,读屏软件能读到,JSON-LD里没有。
剩下11个页面渲染完确实没有评分,多半是真没有评价,或者评价挂在另一个页面上。
反方向也会发生:渲染之后,原来有的分没了
再看原始HTML里本来就有评分的那10个页面。5个渲染前后完全一致,3个变了:Boll & Branch从4.9474分、19条变成4.9444分、18条,一条评价在两次读取之间被撤了下来;Avocado Green Mattress的条数从149变成150;Faherty的分从4.8变成4.84,条数没动,两个数字来自同一批评价的不同取整。
剩下2个更有意思:Brompton原始HTML里写着4.7分、93条,Dreametech写着3.0分、2条,渲染完之后,这两个页面的结构化数据里都找不到评分了。脚本在运行过程中把整段JSON-LD换掉了,换上去的那一份不带评分。
把三件事并排:同一个商品页,一个不跑脚本的抓取器读到一个数,一个跑完脚本的抓取器读到另一个数(或者读不到),一个人用眼睛看到第三个数。谁都没撒谎,只是各自停在了不同的时刻。
判断自己的站属于哪一种,不需要工具。用curl取一遍商品页,在结果里搜aggregateRating,搜得到就是写进原始HTML的;再在浏览器里打开同一页看看星星在不在。两个答案不一样,说明喂给不渲染的抓取器的那一份是空的。站内讲过同一个地址对不同身份的抓取器给出不同内容,这里是同一个身份在不同时刻拿到不同内容,同一类问题的另一面。
谷歌那边的规矩,和ChatGPT那边是两套吗?
同样是把评分喂给机器,谷歌那边的门槛要高得多,而且写了很多年。
先看结构化数据这一层。谷歌评价摘要的文档里有一组硬性要求:评分必须直接来自用户;不要把别的网站上的评价或评分聚合到自己的标记里;页面上必须能让用户看到这条评价或这个平均分,标记的内容要和页面上呈现的一致;虚假的或者没有明确披露的有偿评价不能写进标记。
还有一条专门针对商家给自己打分:如果被评价的这个主体控制着关于它自己的评价,那么它用LocalBusiness或者其他Organization类型做出来的页面,没有资格拿到星标。文档举的例子就是把关于自己的评价放在自己网站上,无论是直接写进结构化数据,还是通过嵌入的第三方组件。商品页面上的Product评分不在这条禁令里,商家收自家商品的评价一直是允许的,但它同样受前面那几条约束。
再看商品评分这一层。要让评分出现在谷歌购物结果里,只有两条路:自己在Merchant Center里提交产品评价数据源,那是一份包含评价原文、作者、时间的XML;或者接一家谷歌认可的第三方评价聚合器,由它把评价同步过去。认可名单是公开的,Bazaarvoice、Feefo、Judge.me、Junip、eKomi、Emplifi、Feedaty、Kudobuzz等都在上面,各家还有自己的门槛,比如Judge.me要求店铺至少收集到50条评价才能开通谷歌的同步。
两边一对照,差别就出来了。
| 这一层 | 谷歌 | ChatGPT的商品数据 |
|---|---|---|
| 评分怎么进去 | 提交含原文的评价数据源,或走认可的聚合器名单 | feed里填一个star_rating字段 |
| 要不要交评价原文 | 要,评价内容与作者、日期一起提交 | 不要,只要平均分和条数 |
| 商家给自己打分 | 商家层面的自评拿不到星标,商品评分另有一套要求 | 规范没有区分 |
| 能不能把别家的评分搬过来 | 明确禁止聚合其他网站的评价 | 规范没有提 |
| 谁来核实 | 有资格要求与人工政策审核 | 帮助页写明评价与评分不由OpenAI核实 |
这不是说哪一边做得对。谷歌那套规矩是这些年被各种星标滥用一条条逼出来的,代价是流程重;OpenAI现在要的是快速把商品目录接进来,字段能省则省。但对一个正在用AI选商品的消费者来说,这个差别很实在:他在谷歌搜索结果里看到的那颗星,背后至少有一份提交过的评价原文;在聊天框里听到的那句“评分4.8”,背后可能只是商家在feed里填的一个数。
顺带说一句,很多人担心的其实是另一件事:AI会不会去读第三方平台上的评价。这件事站内单独量过,谷歌和Yelp的商家资料页不让AI抓评论,所以真正能被读到的那一部分,比大家以为的少。
做独立站的,现在该动哪几处?
先确认机器读到的是哪一个数
取一遍自己的商品页原始HTML,搜aggregateRating。读不到就说明评分只在渲染之后才存在,接feed的时候这个数得自己填,页面这条路指望不上。读得到的话,把里面的分和条数抄下来,和你商品后台里的数字、和feed里的star_rating三个对一遍,看是不是同一批评价算出来的。
条数太少就别写这个分
1条评价的5.00分和800条评价的4.7分,在页面上长得一样,在feed里也长得一样。谷歌的文档建议评分最好伴随评论正文和作者名,理由正是让人看到分数背后的依据。自己定一个门槛,比如少于20条就不输出aggregateRating,只展示评价列表,比挂一个漂亮但空心的数字安全。评价怎么审、怎么才出星标,WooCommerce那篇按后台流程走过一遍。
别把别家的分搬进自己的结构化数据
谷歌明确禁止聚合其他网站的评价或评分。把Trustpilot的分抄进自己的Product标记,或者把商家层面的评分挂在Organization上,都在这条线外面。商家自己控制的关于自己的评价,用LocalBusiness或其他Organization类型的页面,本来就拿不到星标。
第三方平台上的分,要看最近这一段
既然TrustScore是按时间加权的,那么盯着总分没有用,要盯最近几个月新增评价的分布。历史评价再好看也拦不住分数往下掉,这次那几家评价上千条、显示分却比算术平均低2到3分的,只能从这里解释。反过来,评价少的时候分数被那7条中性评价拉着走,也不必为一两分的波动紧张。
把口径写进你自己的报表
不同来源的分不是同一个问题的答案,放在一张表里对比之前,先注明每个数是问谁得来的、算的是哪一段时间、分母是多少。满意度调查那个92%只覆盖了7.4%的买家讲的是同一件事:数没错,错在没写清楚它覆盖了谁。
顺手检查那张feed
如果已经在给ChatGPT或者其他渠道供feed,review_count和star_rating这两个字段要么都填、要么都不填,规范要求它们描述同一批评价,也要求变体行之间不要重复累加。同一张feed里还有一堆容易填错的标识字段,比如GTIN和UPC那一栏。谁在维护这张feed是另一个常年扯皮的问题,站内那篇产品feed到底该谁管可以一起看。
这次测量有哪些地方靠不住?
先说重复测的结果,这决定了上面那些差值能不能当真。
Trustpilot的24个品牌页同一天抓了两遍:显示分一致的23家,唯一变化的一家是Ruggable,从2.4变成2.3,同时它的评价数从809涨到810。平台的帮助页写着,评价不足一万条的商家每收到一条新评价就立刻重算,这一条正好撞上。评价数完全没变的13家,另外11家两次之间新增了评价,中位增加10条,最多的一家增加了73条。
商品页抓了两轮,两轮都成功的133个页面里,132个的判定完全一致,只有Boll & Branch那一页从4.9474分、19条变成4.9444分、18条。所以“站内分比第三方高1.86分”这个差距,不是抓取抖出来的。
接下来是几条硬伤。
每个品牌最多只取了2个商品页,站内分只能代表这两页,代表不了全站;商品页是从站点地图里按顺序取的,不是热销款,有的站取到的是礼品卡或者配件。品牌自己的评分体系抽样到的商品不同,分数也会不同。
第三方这一侧只量了Trustpilot一家。欧洲市场还有Trusted Shops,美国有Google客户评价、BBB,很多品牌在这些平台上的分和Trustpilot完全不是一回事,只是这些平台不像Trustpilot这样把星级分布和评价节点公开写在页面上,抓不到就没法算。用一家平台的分去代表“第三方口碑”,本身就是个偏窄的口径。
Trustpilot页面结构化数据里的Review节点,本文一律按“页面带出来的那几条”来称呼,没有当成最新评价。前面看到有5家的最新一条停在2026年之前,Notino那一组甚至是2018到2025年的老评价,它们的均分反而比全量还高。这一块的排序规则平台没有公开。
最后一条最要紧:本文没有直接去问ChatGPT任何一个购物问题,然后核对它给出的评分来自哪里。模型答案随机性大,同一个问题问两次就不一样,那种测法本身需要另一套设计。这次能确认的只有规范和文档写了什么:feed里的评分是商家自填的字段,帮助页写明评分不由OpenAI核实。从“字段是自填的”到“AI说出来的那个分就是商家填的那个”,中间还隔着一步,这一步本文没有量。
常见问题解答
商品页上写aggregateRating会被谷歌判违规吗?
商品自己的评分不违规,商家收集自家商品的评价一直是允许的。受限制的是商家层面的自评:如果被评价的主体控制着关于自己的评价,用LocalBusiness或其他Organization类型的页面拿不到星标。另外三条通用要求要守住:评分直接来自用户、页面上能看到对应内容、不要把别的网站的评价聚合进来。
只有几条评价,该不该写平均分?
技术上可以写,实际意义不大。本次36个写了评分的站里有10家的评价不到10条,其中4家用1到2条评价写出了5.00分。分数会进feed、进AI的回答,而条数这个字段会不会被用于加权,规范没有写。稳妥的做法是给自己定个门槛,条数不够就只展示评价内容,不输出平均分。
Trustpilot上的分怎么和页面上的星级分布对不上?
因为TrustScore不是算术平均。平台公布的口径是三件事:新评价权重更高、评价来得规律分数更稳、每家店先掺进7条中性的3.5星评价。评价少的时候分数被那7条拉向中间,评价多而近期变差的时候分数会被时间权重压低。本次126家里,显示分和算术平均差1分以上的有18家。
ChatGPT的商品feed里必须填评分吗?
review_count和star_rating都是可选字段,不填就是没有提供。规范要求两个字段描述同一批评价、变体行之间不要重复累加、没有评价时不要填分数。另有一组店铺层面的评分字段,需要单独开通。
AI会不会自己去第三方平台核实评分?
OpenAI的帮助页写着,评价摘要由模型根据公开网站上的评价生成,评价和评分不由OpenAI核实。同时不少评价平台在robots里限制了AI抓取器,谷歌和Yelp的商家资料页就不让AI读评论。所以不能假设机器手里一定有第三方那一份数据。
权威参考资料
本文标题:《商品评分四个数对不上,AI拿走的是商家自己填的那一个》
本文链接:https://zhangwenbao.com/ai-shopper-review-source-rating-gap-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0