站内搜索页搜不到也返回200,两道锁锁的是同一扇门
本文目录
- 站内搜索页这一类,是怎么被量出来的?
- 为什么45个探到的样本,最后只留了35个?
- 搜到东西的那一页,对机器说了什么?
- 搜不到东西,页面为什么还说自己是200?
- 有结果和没结果,站点区分过吗?
- 那14个把乱码原样写进标题的站,是怎么回事?
- robots.txt和noindex这两道锁,为什么锁的是同一扇门?
- 规范网址是唯一在认真干活的那一层吗?
- 代理时代要来了,这一类页面为什么突然重要了?
- 这一类页面到底该怎么配?
- 先把两道锁拆开,只留一道
- 让空结果页说实话
- 把搜索词从标题里拿掉,或者收窄
- 规范网址想清楚再指
- 顺手补一句身份声明
- 先查一遍自己站
- 这套查法还能用在哪儿?
- 常见问题解答
- 站内搜索页到底该不该让搜索引擎抓
- 空结果页返回404,会不会伤用户体验
- 规范网址指向不带词的搜索页,算不算错
- 为什么要写SearchResultsPage,它又没有富媒体展示
- 标题里带搜索词,会被当成关键词堆砌吗
- 我的搜索框是JS渲染的,会影响SEO吗
- 这轮为什么只有35个站的数据
- 权威参考资料
摘要:131个海外品牌站里,35个站的站内搜索结果页被完整探到。搜一个不存在的词,35个站全部返回200,没有一个返回404;页面上白纸黑字写着0 results found的18个站,状态码也是200。有结果页和空结果页的noindex处理34个站完全一致——也就是说,没有一个站区分过“搜到了”和“搜不到”。robots.txt和页面noindex这两道锁,同时用上的19个站其实是同一扇门锁了两遍,真正配对的只有2个。schema.org有个类型叫SearchResultsPage,用它的站是0个。
8月27日OpenAI给ChatGPT的桌面浏览器加了WebMCP支持。Search Engine Journal的报道里的说法是,网页可以把自己能干的事情结构化地暴露出来,让模型直接调用,而不是靠猜页面上哪个按钮能点。
这件事听起来很新,但它想解决的问题很老。
网站上最老的那个“动作”是什么?是搜索。从1990年代末开始,几乎每个站的右上角都挂着一个放大镜。用户敲一个词,站点吐回一页结果。这个动作比购物车早,比登录早,比现在这些花哨的交互都早。
问题是:这个跑了快三十年的动作,它产出的那一页,对机器说过自己是什么吗?
保哥这一轮就是去问这个问题的。答案挺干脆——没说过。
站内搜索页这一类,是怎么被量出来的?
样本还是这一系列在跑的131个海外品牌与电商独立站。每个站的流程是四步:
- 打开首页,从DOM里找搜索框,记下表单的提交地址和输入框的字段名;
- 用一个大概率有结果的词(shirt)拼出搜索地址,抓一遍;
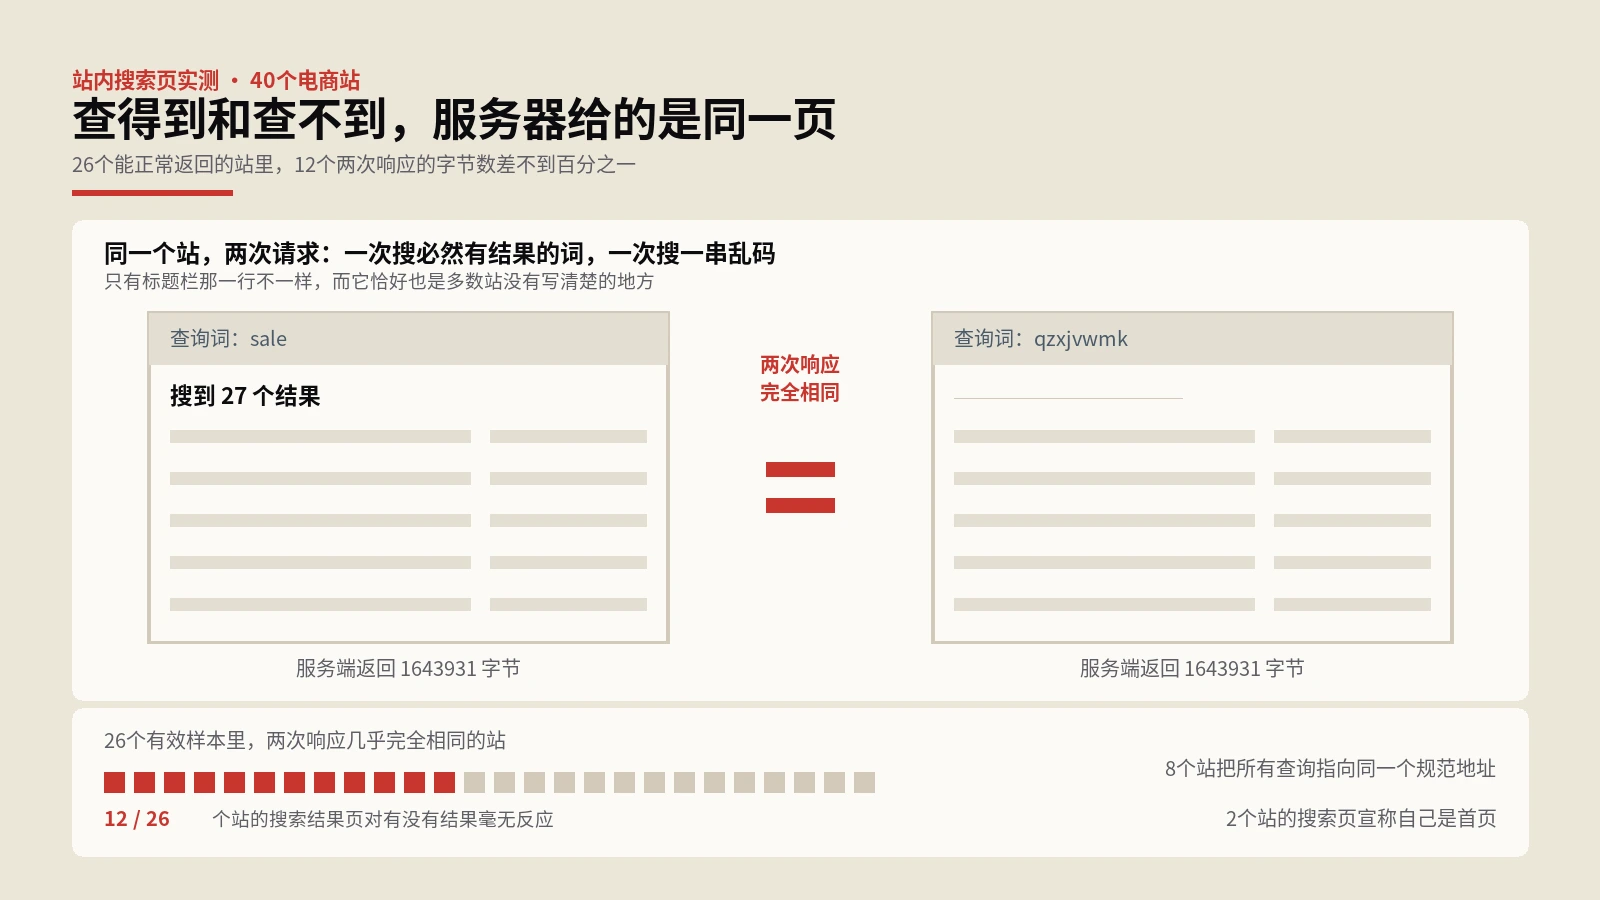
- 用一串一定没结果的乱码(qzxkvw7391)拼出另一个地址,再抓一遍;
- 顺手把根目录的robots.txt也拉下来。
两页都记录状态码、响应头里的X-Robots-Tag、页面里的meta robots、规范网址、标题、JSON-LD类型,以及渲染完之后页面上还剩多少商品卡片、有没有出现“没找到”这类文案。
131个站里,能在首页HTML里找到搜索入口的只有48个。这个数字本身值得停一下:三分之二的站,搜索框是JavaScript渲染出来的组件,对不执行脚本的抓取方来说,那个放大镜压根不存在。这跟JS渲染那一轮量到的损失面是一致的:丢的往往不是正文,是入口。搜索框是独立站最被低估的高转化入口,可它在机器眼里的能见度,和它在用户眼里的完全是两回事。
为什么45个探到的样本,最后只留了35个?
这一步是这轮最该讲的一步。
脚本探到45个站有结果页返回。可逐条人工核对地址和标题的时候,发现其中10个根本没到搜索结果页:
- article.com、burrow.com、italic.com、peakdesign.com、philips.com、shein.com、traeger.com——这7个站的表单提交地址是空的或者指向
#,参数被原封不动挂到了首页上,抓回来的是一份首页; - brompton.com的参数在跳转中被整个丢掉;
- everlane.com返回的是反爬挑战页,warbyparker.com直接403。
剔掉这10个,严口径样本是35个站。所有百分比都按这个分母算。这一步是这一系列反复吃过亏之后的规矩:新造的判据跑完先人工过一遍,别信脚本第一遍给的分母。
这8个被剔的站(7个参数落在首页,1个参数在跳转里丢了)顺手给了一条额外的发现:给首页挂一个它完全不认识的参数,8个站全部返回200和一份完整页面。example.com/?q=shirt、example.com/?searchTerm=shirt、example.com/?header-search=shirt——参数随便编,页面照发。唯一在拦这件事的是规范网址:这8个站的canonical全都指向不带参数的首页。这一层要是也没写,一个首页就能被参数繁殖出无数份。
搜到东西的那一页,对机器说了什么?
35个站,有结果的搜索页:
| 声明 | 站数 | 占比 |
|---|---|---|
| 状态码200 | 35 | 100.0% |
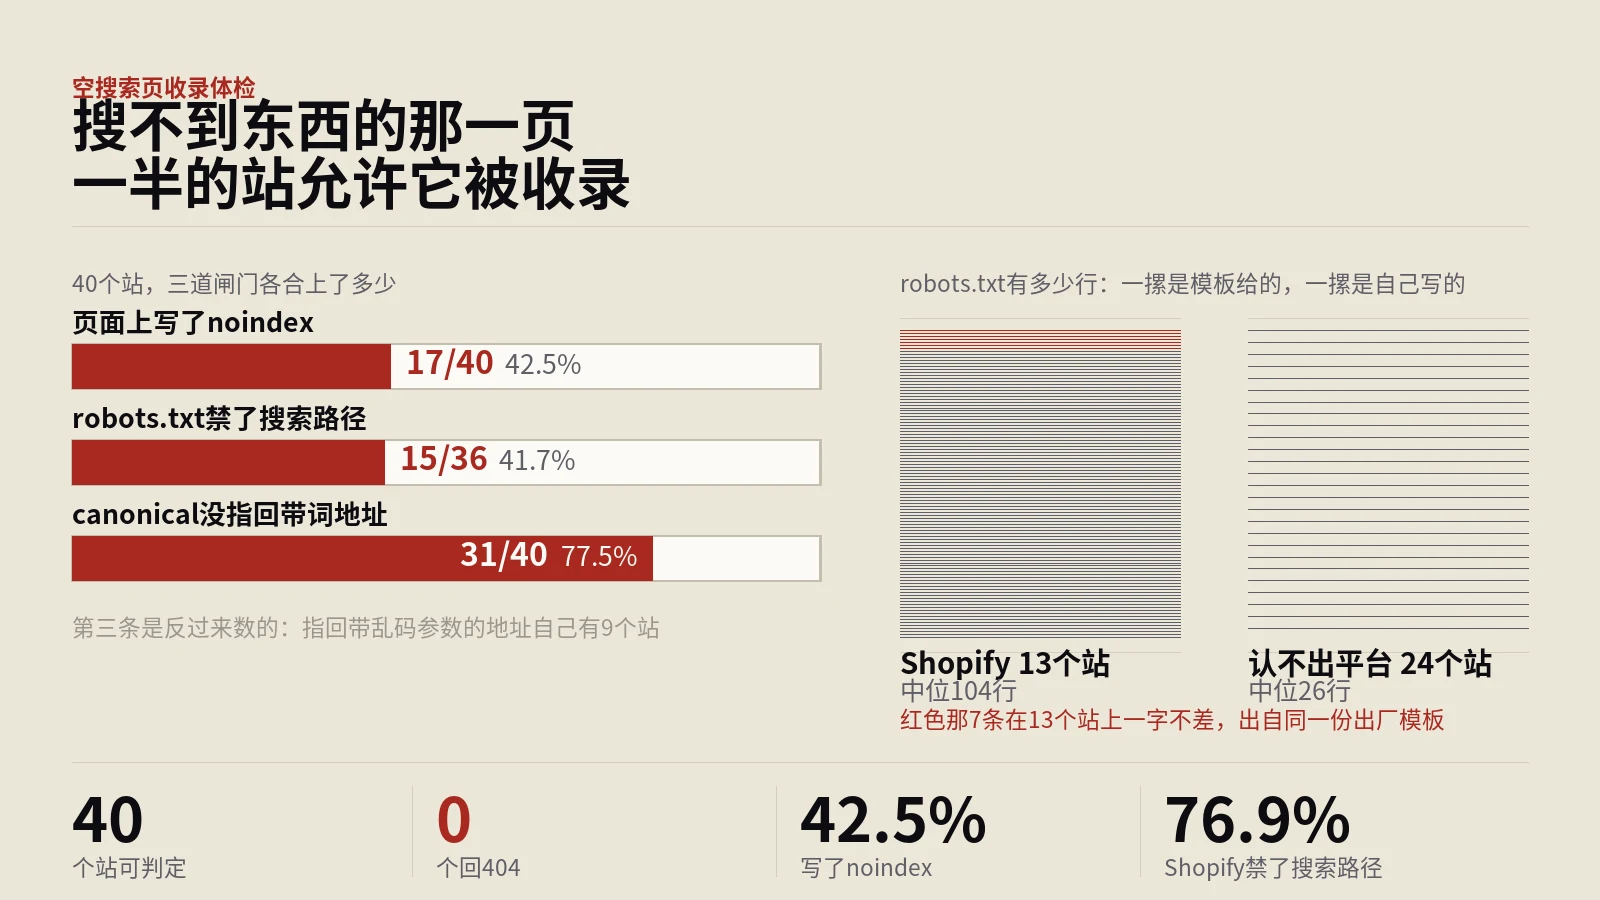
| meta robots里写了noindex | 9 | 25.7% |
| 响应头X-Robots-Tag里写了noindex | 15 | 42.9% |
| 两处任一有noindex | 21 | 60.0% |
| 写了规范网址 | 31 | 88.6% |
| 有任意JSON-LD | 20 | 57.1% |
| 声明自己是SearchResultsPage | 0 | 0.0% |
最后一行是这轮最干脆的一个数字。schema.org里有SearchResultsPage这个类型,2015年就有了。57.1%的搜索结果页发了结构化数据,发的是Organization、WebSite、SearchAction这些“我们是谁”的东西。没有一页说过“这一页是一批搜索结果”。
这跟上一轮量到的类目页只有三分之一说清自己是什么是同一条线上的事,而且更极端一档:类目页至少还有33.3%说了,搜索结果页是0。
原因不难理解。产品页写Product有富媒体回报,类目页写ItemList偶尔有,搜索结果页写SearchResultsPage一分钱回报都没有——它本来就不该进搜索结果。没有回报的声明,没人写。
但这里有个逻辑上的拧巴:正因为这类页面不该被索引,它才更需要说清自己是什么。一页没有身份声明、又返回200的内容,机器只能按普通网页对待。
搜不到东西,页面为什么还说自己是200?
把那串乱码喂进去,34个站的空结果页抓到了。
结果是一条直线:
- 返回200的:34个,100.0%
- 返回404的:0个
- 页面上明确写着“没找到”的:18个,52.9%
- 这18个里,状态码仍是200的:18个,100.0%
页面正文说“0 results found”,HTTP层说“200 OK,内容在这儿”。这两句话在同一次响应里,方向相反。
打个比方,这就像客服接起电话跟顾客说“您要的这款我们没有”,挂了之后在工单系统里把这通电话标成了处理成功。顾客那边信息是准的,系统这边记录是错的,而看报表的人只看得到系统。
这就是软404的标准形态——内容层承认没有,协议层坚持有。搜索引擎对这类页面有一套自己的识别逻辑,识别出来之后会当404处理,但那是在抓完、渲染完、判断完之后。这中间的抓取成本已经花掉了。要判断自己站上有多少这种页面,得从收录异常那一头倒着查。
还有一半更微妙。34个空结果页里,18个(52.9%)在“搜不到”的同时,页面上还铺着三个以上的商品卡片——热门推荐、你可能喜欢、大家都在买。从留客的角度这是对的,甩个空白页给用户等于把人赶走。可从机器的角度,这一页有商品、有价格、有链接、返回200,它看起来跟一个正常的类目页没有区别。
换句话说:为了留住人做的那件事,恰好抹掉了机器判断这一页是空的唯一线索。
有结果和没结果,站点区分过吗?
34个站两页都探到,逐项对比:
| 对比项 | 一致的站数 | 占比 |
|---|---|---|
| noindex处理完全相同 | 34 | 100.0% |
| 状态码相同 | 34 | 100.0% |
| 标题一字不差 | 19 | 55.9% |
| 规范网址指向同一个地址 | 15 | 44.1% |
头两行是100%。34个站,没有一个在技术声明上区分过“搜到了”和“搜不到”。
这不是疏忽,是结构决定的。这些声明写在模板层:一份搜索结果页模板,输出的时候不管命中几条,那几行meta都长一个样。要区分,得让模板知道结果数,再据此改状态码或者改robots指令——这是应用层的事,不是模板层的事,绝大多数平台默认不给这个口子。
标题那一行倒是分开了,55.9%的站两页标题不同。分开的方式很有意思,下面单说。
那14个把乱码原样写进标题的站,是怎么回事?
32个空结果页有标题,其中14个(43.8%)把qzxkvw7391这串乱码原样写进了title:
Search: 0 results found for "qzxkvw7391"
Search: 0 results found for "qzxkvw7391" – Decathlon
Search results: 0 results for "qzxkvw7391" – OLIPOP
Suchergebnisse für "qzxkvw7391"
13个是同一句英文模板,标点和短横线的样式都一致,一眼能看出是同一个平台的默认写法。第14个是德语站,句式换了,逻辑一模一样。
这句话本身写得没毛病,用户看着很清楚。问题在于它意味着什么:标题是用户输入的函数。任何人往地址栏里塞任何字符串,都能得到一个标题独一无二的页面,返回200,带完整导航和页脚,还带一批推荐商品。
这就是那个老问题的现代版本。搜索引擎很早就描述过“无限空间”这件事:一个能按参数无限生成页面的入口,会把抓取资源耗在没有价值的组合上。抓取预算的优化清单里排在前面的几条,讲的都是怎么关掉这类入口。
而这类页面被外部链接指到的情况并不罕见:论坛里有人贴了一条搜索链接,比价站抓走了一批带参数的地址,广告落地页带着追踪参数被人复制转发。这些链接一旦被爬到,就是一个个带独立标题的200页面。
robots.txt和noindex这两道锁,为什么锁的是同一扇门?
这是本轮数据里最值得说的一组。
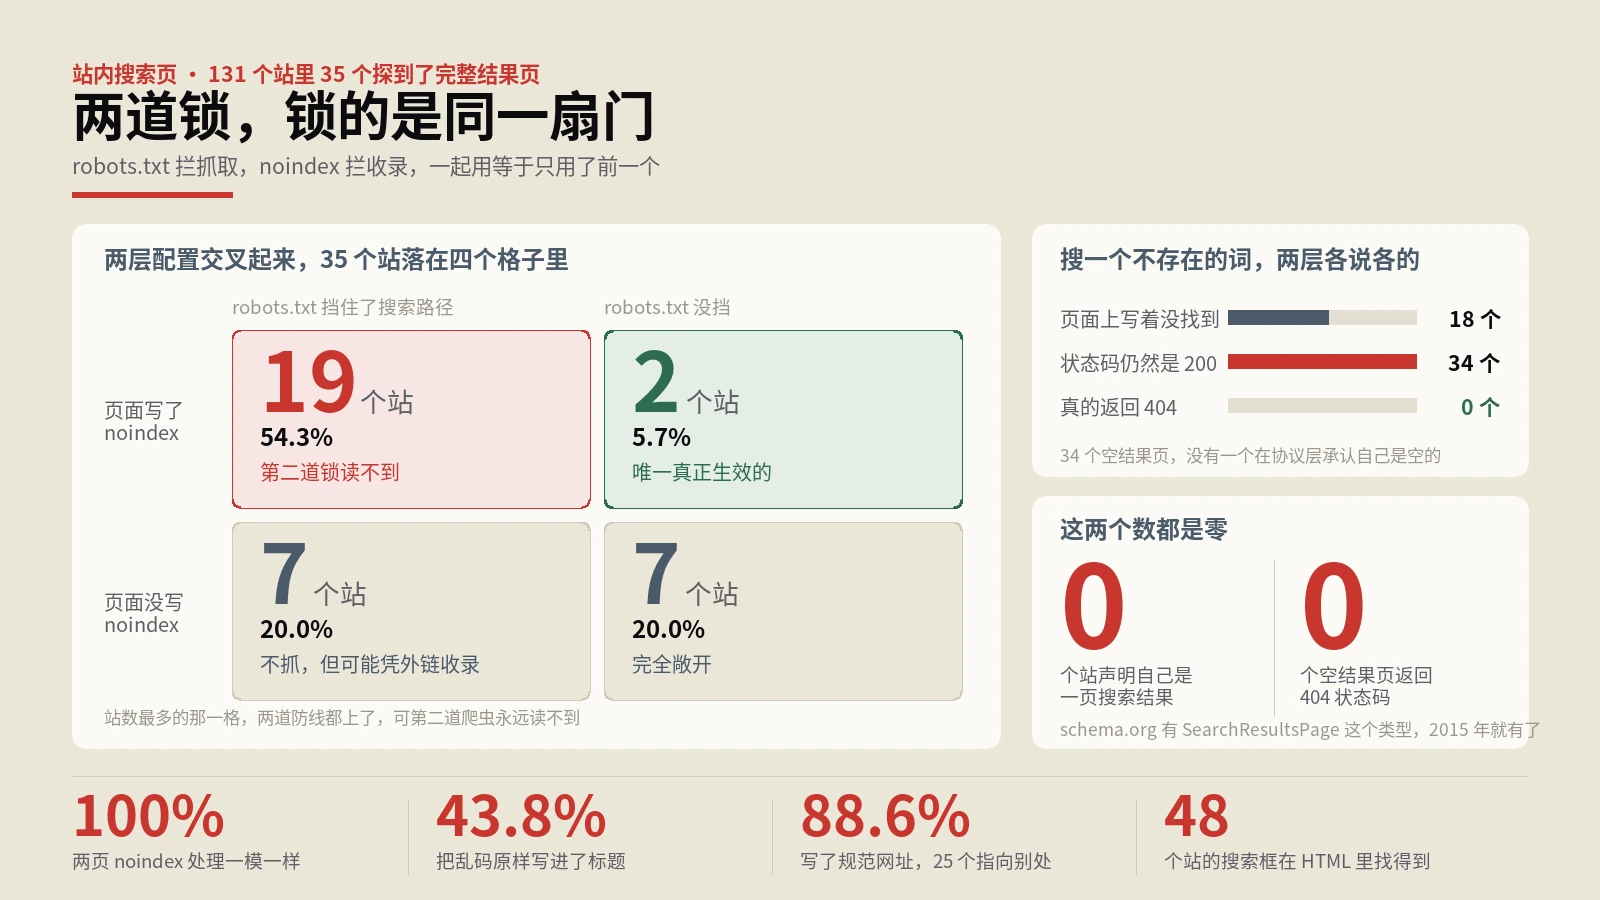
把robots.txt里有没有挡住搜索路径,和页面上有没有noindex,交叉起来看,35个站落在四个格子里:
| 组合 | 站数 | 占比 | 实际效果 |
|---|---|---|---|
| robots挡了 + 页面也写了noindex | 19 | 54.3% | 第二道锁读不到 |
| robots挡了 + 页面没写noindex | 7 | 20.0% | 不抓,但可能凭外链收录 |
| robots没挡 + 页面写了noindex | 2 | 5.7% | 唯一真正生效的组合 |
| 两样都没有 | 7 | 20.0% | 完全敞开 |
第一行占了一半以上,而且这一半恰恰是做得最认真的那批人——两道防线都上了。
可这两道防线不能叠加。Google关于阻止索引的文档里写得很清楚:noindex要生效,前提是这一页能被抓到。robots.txt把这一页挡在门外,爬虫就永远读不到页面里那行noindex。
结果是:你以为上了两把锁,实际上第二把锁被第一把锁在了门里。
更麻烦的是,这两种做法防的不是同一件事。robots.txt管的是爬虫能不能来读这一页,noindex管的是这一页能不能进结果。一个已被收录的页面加noindex之后要多久才从结果里消失,本身就是个需要抓取才能推进的过程;robots.txt挡住之后,这个过程直接停摆——旧的索引条目留在那儿,新的noindex指令永远送不到。
只有2个站落在了正确的那个格子里:不挡抓取,让爬虫进来读到noindex,然后把这一页从索引里剔掉。站内搜索URL到底该不该写Disallow这个问题,多数人凭直觉选了Disallow,而直觉在这件事上刚好选反。
顺便说一句样本外的数字:130个能拿到robots.txt的站里,40.8%挡了搜索类路径,55.4%写了Disallow: /*?这种一刀切的参数规则。后者的杀伤面比多数人以为的大得多——它会把所有带问号的地址一起挡掉,包括分页、包括筛选、包括带追踪参数的正常落地页。
规范网址是唯一在认真干活的那一层吗?
四层声明里,规范网址的覆盖率最高:88.6%的搜索结果页写了。但它写的内容有点出人意料。
| 规范网址指向 | 站数 |
|---|---|
| 指向自己(带搜索词) | 5 |
| 指向首页 | 1 |
| 指向别处 | 25 |
| 其中把查询参数整个去掉的 | 12 |
| 没写 | 4 |
12个站的规范网址指向不带任何搜索词的/search。这意味着搜shirt、搜shoes、搜那串乱码,三页的规范网址是同一个地址。按规范网址的合并逻辑,这三页会被当成同一页的不同版本,最终只有一份进索引。
从治理角度这是聪明的:一行配置就把无限空间收成了一个点。从数据角度它有代价——Search Console里所有搜索词的表现会被合并到一个地址上,你再也看不出用户搜了什么。
还有一个值得记下来的:joolz.com的规范网址是…/search?cgid=undefined。undefined这个词被拼进了规范网址里。某个变量没取到值,模板照拼不误,于是全站所有搜索结果页的规范网址都指向同一个语法上合法、语义上没有意义的地址。这种错误不报警、不掉排名、也不会有任何工具提醒你——它跟同一页写两条meta各说各话属于同一族:语法过关,语义失效。
代理时代要来了,这一类页面为什么突然重要了?
回到开头那件事。
过去搜索结果页在SEO里的位置很清楚:一类不该被索引的垃圾页,关掉就行。这个判断在“机器只是来抓内容”的年代是对的。
但WebMCP这类东西改变的是机器和网站的关系。模型不再只是读你的页面,它要在你的站里执行动作——搜一个词,看一批结果,选一个,进详情,加购。上一轮量过AI代理能不能在电商站里完成四个基本动作,83个站里只有1个全通。搜索是那四个动作里最基础的一个。
这时候搜索结果页的身份就有了新意义。它不需要进索引,但它需要能被理解:这一页是不是一批结果,有几条,每条对应什么商品,搜不到的时候机器怎么知道自己搜空了。
目前的答案是:机器无从知道。返回200,页面上有商品卡片,标题里有搜索词,一切看起来都像搜到了。唯一能说明搜空了的信号,是页面上那行给人看的英文句子。
这里面有个很实际的分野。索引和理解,从此是两件事:你可以既不想让这一页进搜索结果,又希望机器能读懂它。过去这两件事捆在一起,用一个noindex就解决了;现在得分开处理。
这一类页面到底该怎么配?
先说一个例外,不然下面的结论会用错地方。有一小类站,站内搜索页本身就是有价值的着陆页——商品品类极多、用户搜的词本身就是成型的长尾需求,把高频搜索词的结果页转成正经类目页,是很成熟的做法。属于这一类的站,下面几条要反着读:那些词的结果页不该加noindex,该当类目页认真做内容和标题。
但这条例外的适用面比多数人以为的窄。它成立的前提是你拿得出一份名单,说清楚哪几十个词值得留、剩下的一律不留。拿不出名单就一律留着,那不叫策略,那叫没管。
下面按这轮量到的问题,从最该动的排起。
先把两道锁拆开,只留一道
如果你现在既在robots.txt里挡了搜索路径,又在页面上写了noindex,选一个。推荐的是后者:从robots.txt里去掉搜索路径的Disallow,保留页面上的noindex。
代价是爬虫会来抓这些页面,消耗一点抓取额度。收益是noindex真正生效,已经进了索引的旧条目会被清掉。等索引清干净了,再考虑要不要加回Disallow——但那时候多半也没必要了。
如果你的站抓取额度确实紧张,且搜索页从来没被收录过,那保留Disallow、去掉noindex也行。别两个一起上,那是自欺欺人。
让空结果页说实话
搜不到东西的时候,最规矩的做法是返回404。但这会伤用户体验,多数团队不会接受。
折中方案有两个。一是保持200,但在页面上给机器一个明确信号——把结果数写进结构化数据,条数为0的时候机器就知道了。二是把空结果页和有结果页拆成两套模板,空的那套加noindex,有结果的那套按索引策略处理。第二种改动更小,效果也更直接。
不管选哪种,别在空结果页上铺满推荐商品还返回200。要推荐可以推荐,但得让机器知道这些卡片跟这次搜索无关。
把搜索词从标题里拿掉,或者收窄
标题里带用户输入,等于把标题的控制权交给了任何一个能编辑地址栏的人。稳妥的做法是给搜索词加长度和字符集限制:超过一定长度、含有非预期字符、或者结果数为0的时候,标题回落成一个固定值。
这一条改起来最快,五分钟的模板改动,直接掐掉整条无限生成的链路。
规范网址想清楚再指
指向不带词的/search是最省事的做法,35个站里12个这么干。但这等于放弃了搜索词的数据。
如果你的站内搜索词是重要的需求来源,更好的做法是让规范网址指向自己,同时靠noindex控制索引。这样Search Console里能看到每个词的抓取情况,索引这一层由noindex管。规范网址和noindex是两件事,不要用一个去代替另一个:前者按合并重复网址的规则决定收哪一版,后者决定收不收。
顺手补一句身份声明
在搜索结果页的JSON-LD里加一段SearchResultsPage,成本是几行代码。它现在没有任何富媒体回报,短期内也不会有。但它把“这一页是什么”这件事说清楚了,而这件事在代理时代的价值会比在索引时代高。
顺带把结果数也写进去。这一条比什么都直接:"numberOfItems": 0比页面上那句英文可靠得多。
先查一遍自己站
最小成本的自查是三步:搜一个真词,搜一串乱码,然后各看一遍状态码、meta robots、X-Robots-Tag、规范网址。再打开robots.txt看有没有挡住这条路径。四样凑齐,问题在哪一眼就出来了。
要看历史情况,得从服务器日志里查爬虫到底抓了多少搜索地址。这个数字往往比想象的大——尤其是robots.txt里写了Disallow、以为已经挡住了的那些站。
这套查法还能用在哪儿?
站内搜索只是这类页面里最典型的一个。同样的四层对账,能套到几个地方。
筛选后的类目页是最像的一个。用户点了颜色和尺码,网址多了两个参数,页面结构没变。它跟搜索结果页共享同一套问题:能被无限组合、内容重复、状态码永远200。区别是筛选页往往有真实的搜索需求,分面导航的治理要在放和挡之间做取舍,不能一刀切。
购物车、结账页、账户页是另一类。它们同样不该进索引,但处境跟搜索页不太一样——这几类页面牵涉隐私和交易,通常有专人盯着。电商站该屏蔽哪几类页面那份清单里它们排在最前,搜索页往往排在最后。这一轮没有专门测这几类页面,所以只说到这儿。
比价和排序参数是第三类。?sort=price_asc这种地址产生的页面,内容跟原页面一模一样,只是顺序不同。这类最适合用规范网址收,不适合用noindex。
还有一类容易被忘掉:站点自己的404页面。它有没有真的返回404?这件事跟空结果页是同一个毛病的两种表现,自定义错误页配错状态码是相当常见的一个坑。
站内搜索页的尴尬在于,它是站里唯一一类由用户写内容、由模板发身份、然后没有人审的页面。三十年来它一直这么跑着,因为它从来不出错——返回200,页面完整,用户满意,报表上什么异常都没有。只有换成机器的视角看一遍,才发现它对机器一句实话都没说过。
常见问题解答
站内搜索页到底该不该让搜索引擎抓
让抓,别让索引。这是这轮数据支持的结论,也是Google文档的逻辑推出来的结论:noindex要生效必须先被抓到。如果你的抓取额度极度紧张,且这些页面从来没进过索引,用robots.txt挡也可以,但那时候就别再写noindex了,写了也没用。
空结果页返回404,会不会伤用户体验
会,所以多数站不这么做,这轮35个站里一个都没有。更实际的方案是保持200但拆模板:空结果那套模板加noindex,同时把结果数写进结构化数据。用户看到的还是一个友好的页面,机器拿到的是明确的信号。
规范网址指向不带词的搜索页,算不算错
不算错,是一种取舍。好处是把无限空间收成一个点,坏处是丢掉了搜索词维度的数据。如果站内搜索词对你的选品和内容规划有价值,就别这么做;如果只是想尽快止血,这是最快的一招。
为什么要写SearchResultsPage,它又没有富媒体展示
短期确实没有回报。写它的理由是把页面身份说清楚,让机器不必靠猜。这轮35个站一个都没写,说明这件事目前完全是自选动作。判断标准很简单:如果你在意AI代理和生成式搜索怎么理解你的站,就值得写;如果只在意传统搜索排名,可以先放着。
标题里带搜索词,会被当成关键词堆砌吗
不会。它的问题不是堆砌,是可以被外部无限操纵。真实风险有两个:一是任何人都能造出一个带自定义标题的页面挂在你的域名下,二是这些页面被外链指到之后会消耗抓取资源。给搜索词加长度和字符限制就能解决。
我的搜索框是JS渲染的,会影响SEO吗
搜索框本身不影响,它不是内容。真正的影响是抓取方发现不了这个入口,从而发现不了搜索结果页——从减少无效抓取的角度看,这反而是件好事。但如果你希望AI代理能用你的站内搜索,那就得让这个入口在HTML里可见,或者用WebMCP这类机制显式声明出来。
这轮为什么只有35个站的数据
131个站里,能在服务端HTML找到搜索入口的48个,实际探到结果页的45个,人工核对后剔掉10个没真正到达搜索页的,剩35个。剔除的主要原因是表单提交地址为空,参数被挂到了首页上。这一步不做,数据里会混进一批首页,所有比例都会跑偏。
权威参考资料
本文标题:《站内搜索页搜不到也返回200,两道锁锁的是同一扇门》
本文链接:https://zhangwenbao.com/site-search-results-page-identity-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0