Google抓取频率文档补上Retry-After:服务器扛不住时,怎么用503和429让Googlebot先慢下来
本文目录
- 这次文档改了什么
- Google说的紧急降速怎么运作
- Retry-After怎么写
- 哪些坑不能踩
- robots.txt不能返回503
- 时间只能是几小时到一两天
- 别把降速和下线混在一起
- 不同情况该用哪个状态码
- 先查清楚是谁在猛抓
- 具体怎么配置
- 降速前、中、后各查什么
- 服务器返回不了错误怎么办
- 常见问题解答
- Google这次更新了抓取频率文档的什么内容?
- 怎么紧急让Googlebot少抓一点?
- Retry-After响应头有哪几种写法?
- Googlebot一定会按Retry-After的时间回来吗?
- robots.txt能返回503吗?
- 返回503会不会让页面掉出索引?
- 500、503和429对抓取的影响有区别吗?
- 只想降低某一类页面的抓取能做到吗?
- Googlebot抓取量突然暴涨通常是什么原因?
- 服务器改不了状态码怎么降低抓取频率?
- 网站计划维护时应该返回什么状态码?
- 怎么确认Google已经降低了抓取?
- 图片放在CDN子域名上会被一起降速吗?
- AI爬虫也能用503和Retry-After降速吗?
- Search Console还能手动设置抓取速度吗?
- 权威参考资料
摘要:Google在10月6日更新了“降低Google抓取频率”文档,重新整理了紧急降速一节,并补上Retry-After响应头的说明和示例:服务器返回503或429时,可以附带Retry-After,用秒数或一个UTC时间告诉Google的爬虫什么时候再来。Google说明这不是新功能,“暂停或停用网站”文档里早就写过,这次是为了让人在紧急降速时更容易找到。降速机制本身没变:大量URL返回500、503或429,会让整个主机名的抓取变慢,错误减少后自动恢复。紧急降速只适合几小时到一两天,robots.txt不能返回503,时间长了已收录的网址会被逐步移出索引。
大促零点流量一冲,服务器CPU打满,日志里一看,Googlebot还在不紧不慢地翻你几十万个筛选页。这种时候最想做的,就是让它先停一停。
Google一直有办法让你这么做,只是说明散在好几篇文档里。Search Engine Roundtable报道,Google在10月6日更新了降低Google抓取频率这篇文档,把Retry-After响应头的用法直接写了进去。这篇以文档原文和更新日志为主体,结合Google关于暂停网站和HTTP状态码的文档,把紧急降速的做法、容易踩的坑和具体配置讲清楚。
这次文档改了什么
Google抓取文档的更新日志在10月6日记了一条:重新组织了紧急降低抓取频率的那一节,并在“降低Google抓取频率”文档里加入Retry-After响应头的说明和示例。
为什么改,Google也写了:对Retry-After的支持并不新,“暂停或停用网站”文档里早就有;把它直接放进降低抓取频率的指南,能让人在紧急降低爬虫流量时更容易找到、更容易看懂。
Barry Schwartz对比了改版前后的页面,发现大部分改动是把内容在页面上挪了位置,最大的新增就是Retry-After这一段。他的总结很准确:Google没有引入新的限速方法,底层机制没变;Google本来就把500、503和429当成降低抓取的信号,新文档只是把Retry-After明确成在返回503或429时可以额外提供的信号。
| 内容 | 改版前 | 改版后 |
|---|---|---|
| 紧急降速的方法 | 返回500、503或429 | 不变 |
| 降速的范围和恢复 | 已有说明 | 重新整理,写明影响整个主机名、错误减少后自动恢复 |
| Retry-After | 只在“暂停或停用网站”文档里提到 | 写进降速文档,给出秒数和UTC时间两种示例 |
| 特殊降速请求 | 可以提交 | 不变,仍然不能申请提高抓取频率 |
Google说的紧急降速怎么运作
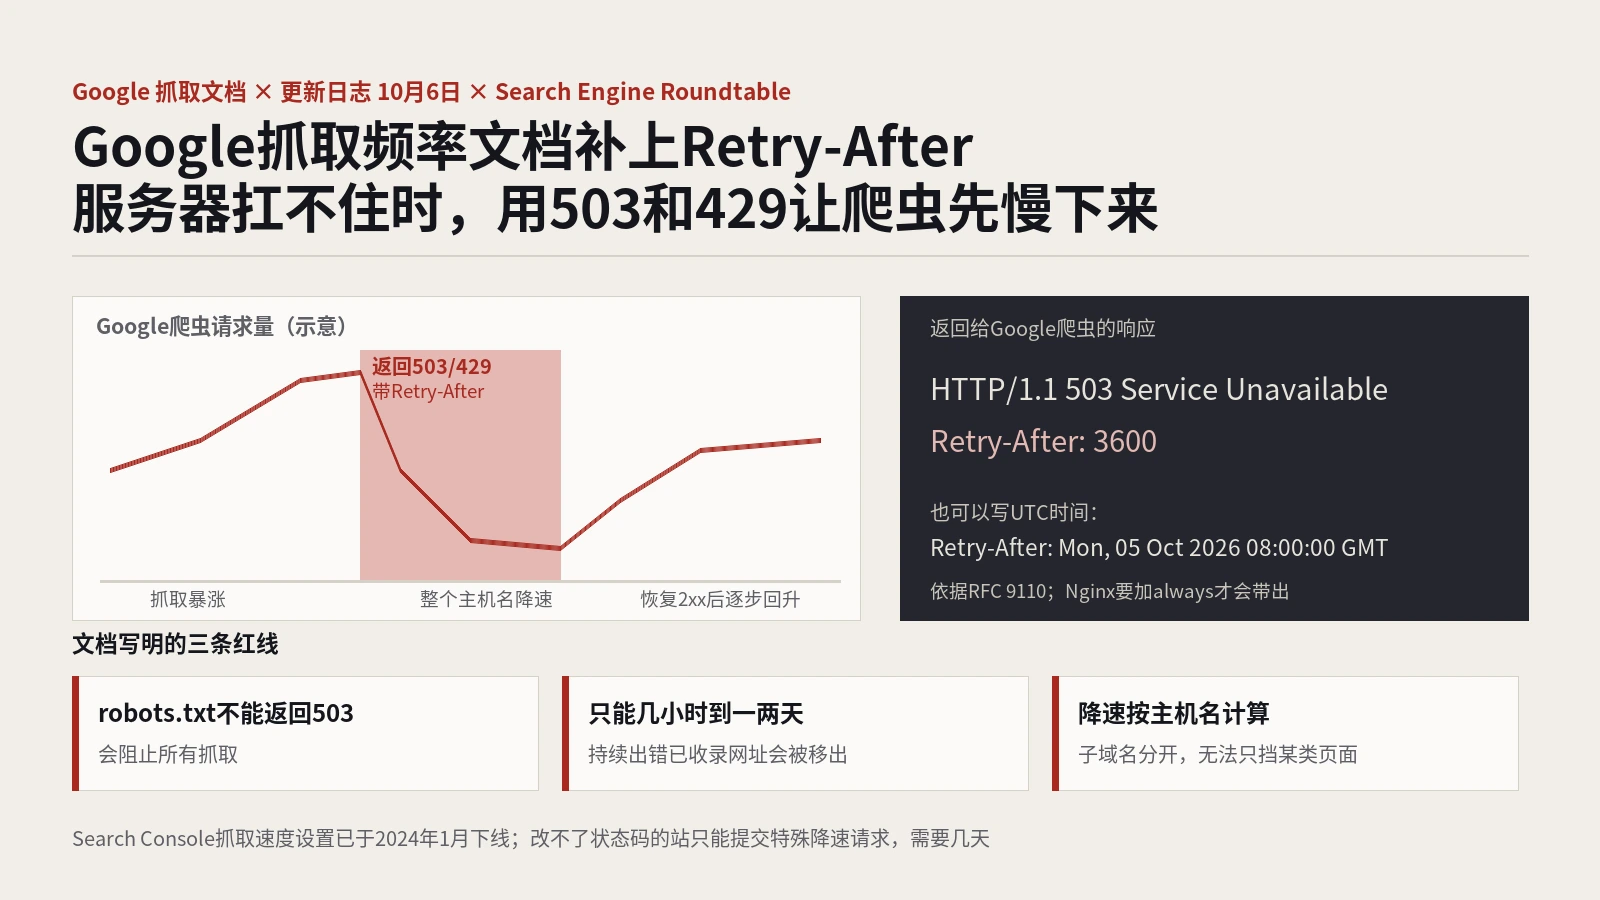
文档的说法是:想在短时间内紧急降低抓取频率,比如几个小时或者一两天,就对抓取请求返回500、503或429状态码,而不是200。
Google的抓取系统遇到大量返回这几种状态码的URL时,会发生两件事:
- 降低整个主机名的抓取频率,比如subdomain.example.com,返回错误的URL和正常返回内容的URL都会一起变慢;
- 错误数量减少后,自动把抓取频率提回来。
第一条有个细节值得留意:降速按主机名算。主站和博客分别在www和blog两个子域名上,一个子域名返回503,另一个不受影响。反过来,同一个主机名下你只想给某一类页面降速,比如只挡筛选页,也做不到精确控制,Google是按整体错误量来调。
按主机名计算这一点,放到常见的站点结构里看更直观:
| 主机名 | 放的内容 | 只有www返回503时 |
|---|---|---|
| www.example.com | 主站页面 | 抓取变慢 |
| blog.example.com | 博客 | 不受影响 |
| cdn.example.com | 图片、脚本等静态资源 | 不受影响 |
这也给了一个思路:静态资源单独放在CDN子域名上,主站紧急降速时,图片的抓取不会被一起拖慢;反过来,如果是图片子域名被抓爆了,在那个主机名上单独返回503就行,不用动主站。
Google关于HTTP状态码如何影响爬虫的文档补充了几条细节:
| 状态码 | Google爬虫怎么理解 | 对索引的影响 |
|---|---|---|
| 429 | 服务器过载的信号,按服务器错误处理 | 和5xx一样 |
| 500 | 降低抓取频率,降幅和返回错误的URL数量成正比 | 已收录的URL暂时保留,持续出错最终会被移出 |
| 503 | 服务暂时不可用,触发降速 | 同上 |
| 恢复返回2xx后 | 逐步提高抓取频率 | 恢复正常处理 |
“最终会被移出”这一点要记牢。紧急降速是止血,不能当长期方案。
503和429在HTTP规范里的本意不太一样:503是服务暂时不可用,429是这个客户端请求太多、被限流了。不过在Google这里,两者效果相同,都按服务器错误处理、都触发降速,也都能配Retry-After。实际选哪个看你的场景,整站扛不住用503更自然,只想对爬虫限流用429也说得通。
Retry-After怎么写
新加的段落说,返回503或429时,可以同时带上Retry-After响应头,按RFC 9110(HTTP语义规范)的定义,告诉Google的爬虫什么时候可以重试。值有两种写法。
第一种是延迟秒数,比如两分钟后再来:
HTTP/1.1 503 Service Unavailable
Retry-After: 120
第二种是一个绝对的UTC日期时间:
HTTP/1.1 503 Service Unavailable
Retry-After: Mon, 05 Oct 2026 08:00:00 GMT
日期格式要严格按HTTP日期的写法:星期缩写、日、月份缩写、年、时间,最后是GMT。星期和日期对不上、用了本地时区,都可能让这个头失效。拿不准就用秒数,最不容易写错。
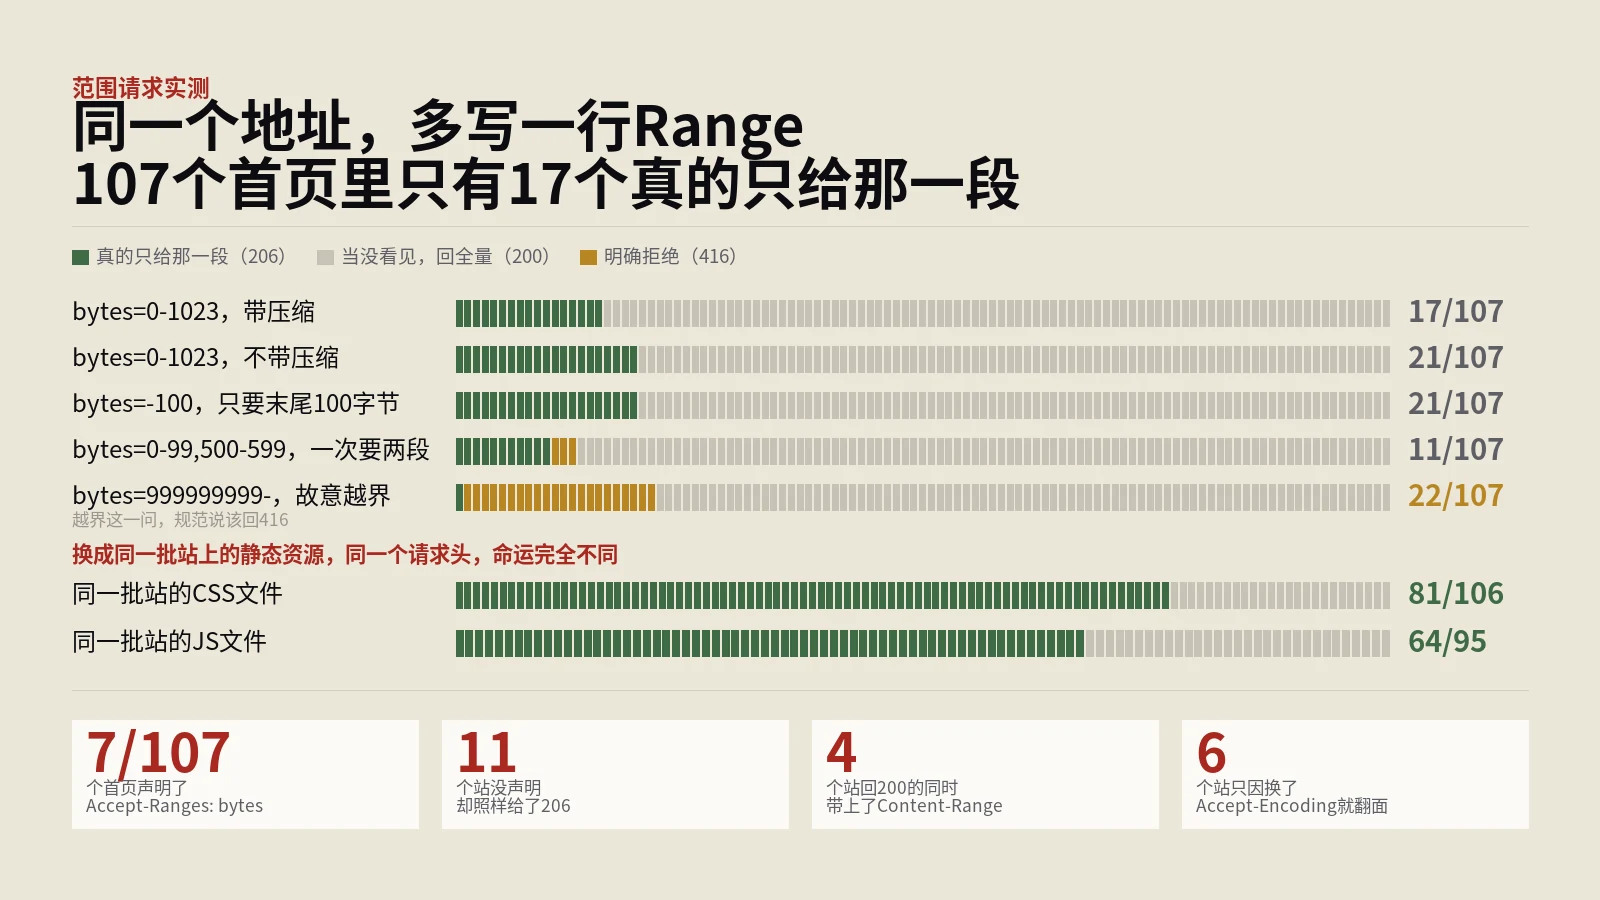
要注意的是,Google的措辞是“可以”带上,用来“表明”什么时候可以重试。文档没有承诺爬虫一定严格按这个时间回来,它更像是一个更明确的提示。所以设一个合理的时间就行,没必要设成几天以后,那样只会让降速变成长期停摆。
“暂停或停用网站”文档对503错误页还有几条最佳实践,正好可以一起用上:
- 带上Retry-After,写一个尽力估计的时间或时长;
- 错误页用静态HTML,别让它再去查数据库;
- 尽量少引用外部资源,样式内联,图片用base64编码嵌进去;
- 在页面上告诉真实用户接下来怎么办,比如多久后再来、紧急情况联系哪个邮箱。
哪些坑不能踩
紧急降速看起来就是改个状态码,真出问题往往是在细节上。Google文档里写明的几条红线,整理在这里:
robots.txt不能返回503
这是最致命的一条。“暂停或停用网站”文档明确说,不要让robots.txt返回503,这会阻止所有抓取。很多人在负载均衡或防火墙上一刀切地对所有请求返回503,robots.txt也被带上了。正确的做法是robots.txt照常返回200。robots.txt本身的机制,可以看robots协议的完整说明。
时间只能是几小时到一两天
降速文档说的是短时间,比如几个小时或一两天。暂停网站的文档说,停用整个网站是极端措施,最多只能持续几天,否则即使做法正确,也会对网站在搜索中的表现产生明显影响。需要停用更久的,文档建议换个做法:用200状态码提供一个可以被收录的首页占位,告诉用户发生了什么。
别把降速和下线混在一起
503是“暂时来不了”,404和410是“没有了”。大促期间某些商品下架,返回404没问题;但如果是服务器扛不住,就该用503或429,别图省事返回404,那会让Google以为页面真的删了。
不同情况该用哪个状态码
把降速文档和暂停网站文档的说法合在一起,几种常见情况可以这样对号入座:
| 情况 | 建议的做法 | 持续多久 |
|---|---|---|
| 爬虫把服务器抓爆了,用户访问也受影响 | 对爬虫或全部请求返回503或429,带Retry-After | 几小时到一两天 |
| 计划内的短时维护、迁移切换 | 返回503和一个说明页面,带Retry-After | 一两天以内 |
| 业务要暂停较长时间 | 首页返回200,做一个可被收录的占位说明页 | 按业务需要 |
| 某些页面真的不要了 | 返回404或410 | 长期 |
| 改不了状态码的托管环境 | 向Google提交特殊降速请求 | 需要几天才生效 |
第三行是很多人想不到的。暂停网站文档的思路是:停得越久,越不能让Google一直看到错误;提供一个正常的、能被收录的页面,告诉用户和搜索引擎“我们还在,只是暂停”,比连续几周的503安全得多。
先查清楚是谁在猛抓
降速文档专门有一节讲抓取量突增的原因。按Google收到的报告,最常见的是网站URL配置效率低,通常和这几类功能有关:分面导航或其他排序筛选功能、带大量日期URL的日历、动态搜索广告的目标网址(这时来的是AdsBot)。Google强烈建议先找主机商、看最近的服务器访问日志,确认流量来源再动手。
这一步很重要,因为日志里自称Googlebot的不一定是Googlebot,伪造UA的爬虫很常见。站内整理过用日志核验真假爬虫的方法。确认是真Googlebot在猛抓筛选页,长期的解法是治理URL,见分面导航的URL组合爆炸怎么治理,返回503只是让你先喘口气。
具体怎么配置
以Nginx为例,下面这段只在紧急时对Google的爬虫返回503并带Retry-After,robots.txt照常放行,真实用户不受影响:
# 紧急降速:识别Google爬虫的User-Agent
map $http_user_agent $google_crawler {
    default      0;
    ~*googlebot  1;
}

server {
    # robots.txt 永远正常返回
    location = /robots.txt {
        try_files $uri =404;
    }

    location / {
        if ($google_crawler) {
            add_header Retry-After 3600 always;
            return 503;
        }
        # ……原有配置……
    }
}
几个要点:
- add_header后面的always不能省。Nginx默认只在2xx和3xx响应里加自定义头,503不加always就带不出Retry-After;
- 改完先用curl模拟Googlebot的User-Agent请求一下首页和robots.txt,确认首页是503并带着Retry-After、robots.txt是200,“暂停网站”文档也建议用curl在本地确认503;
- 负载降下来就立刻撤掉这段配置,别忘在线上;
- 服务器真的整体扛不住时,对所有请求返回503比只针对爬虫更合理,同样记得放行robots.txt。
验证命令可以这样写,第一条模拟Googlebot请求首页,第二条请求robots.txt:
curl -I -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://www.example.com/
curl -I https://www.example.com/robots.txt
第一条的返回里应该看到503和Retry-After: 3600两行,第二条应该是200。两条都对了再放心离开电脑。
用Apache的站,可以在配置里做类似的事。下面是一个思路示例,具体写法以你服务器的版本和模块为准,上线前务必在测试环境验证:
# 紧急降速:Googlebot请求返回503,robots.txt除外
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} googlebot [NC]
RewriteCond %{REQUEST_URI} !^/robots\.txt$
RewriteRule ^ - [R=503,L]

# 只在503响应上附带Retry-After
Header always set Retry-After "3600" "expr=%{REQUEST_STATUS} == 503"
同样,Header后面的always是关键,否则错误响应上不会带出这个头。改完一样要用curl验证。
用了CDN的站,也可以在CDN边缘做同样的事,不让请求打到源站。CDN对SEO的影响和边缘规则怎么配,可以参考CDN缓存配置与SEO。防火墙的爬虫拦截规则也要检查一下,别在降速时误伤,见防火墙误拦搜索爬虫的排查。
降速前、中、后各查什么
| 阶段 | 要做的事 |
|---|---|
| 动手前 | 看服务器日志确认是哪个爬虫、抓的是哪类URL;核验是不是真的Googlebot;记下当时的抓取量作为对照 |
| 生效时 | 用curl确认目标请求返回503并带Retry-After,robots.txt返回200;真实用户访问正常 |
| 进行中 | 盯服务器负载和日志里爬虫请求量的变化;设一个提醒,到点必须撤掉 |
| 撤掉后 | 在Search Console的抓取统计信息报告里看请求量和主机状态,确认抓取逐步恢复;同时处理导致猛抓的根源,比如筛选URL |
抓取统计信息报告怎么读、各类问题URL的排查顺序,站内有一篇Google抓取报告的读法。
服务器返回不了错误怎么办
有些托管环境改不了状态码,比如部分建站平台。文档给了一个兜底办法:提交特殊请求,报告抓取频率异常偏高的问题,并在请求里写明适合你网站的抓取频率。两点限制:只能申请降低,不能申请提高;评估和执行可能要好几天,所以它解决不了眼前的紧急情况。
顺带一提,Search Console以前有个抓取速度限制设置,可以手动调低Googlebot的频率,2024年1月Google把它下线了,理由是Google的系统已经能根据服务器响应自动调节。所以现在想主动影响抓取速度,能用的就是这份文档里的方法:返回错误状态码、带上Retry-After,或者提交特殊请求。
抓取速度被调低还有一种情况比较隐蔽:服务器没报错,只是响应慢,Google同样会降速。站内之前写过抓取速率被调低时日志里一条错误都没有的案例。平时的抓取预算优化,可以看Google抓取预算优化指南;大促前的准备,可以参考独立站大促SEO排期,把紧急降速的预案提前写进去。
常见问题解答
Google这次更新了抓取频率文档的什么内容?
Google在2026年10月6日重新组织了“降低Google抓取频率”文档的紧急降速一节,并加入Retry-After响应头的说明和示例。Google说明对Retry-After的支持不是新功能,之前已写在“暂停或停用网站”文档里,这次改动是方便查找。
怎么紧急让Googlebot少抓一点?
在几个小时到一两天的短时间内,对抓取请求返回500、503或429状态码代替200。Google遇到大量这类状态码时会降低整个主机名的抓取频率,错误减少后自动恢复。返回503或429时可以同时带上Retry-After响应头。
Retry-After响应头有哪几种写法?
按RFC 9110的定义有两种:一种是延迟秒数,比如Retry-After: 120表示两分钟后重试;另一种是绝对的UTC日期时间,格式如Mon, 05 Oct 2026 08:00:00 GMT。拿不准日期格式时用秒数最不容易出错。
Googlebot一定会按Retry-After的时间回来吗?
文档的说法是可以带上这个头来表明爬虫什么时候可以重试,没有承诺严格遵守。它是比单纯返回503更明确的一个信号,设一个合理的时间即可,不建议设得过长。
robots.txt能返回503吗?
不能。Google的“暂停或停用网站”文档明确说,不要让robots.txt返回503,这会阻止所有抓取。紧急降速时要单独放行robots.txt,让它照常返回200。
返回503会不会让页面掉出索引?
短时间不会。按Google的HTTP状态码文档,5xx和429会让爬虫暂时放慢,已收录的URL会保留在索引里,但持续出错最终会被移出。所以紧急降速只适合几小时到一两天,停用整站最多几天。
500、503和429对抓取的影响有区别吗?
三者都会触发降速。Google把429当作服务器过载的信号,按服务器错误处理;500导致的降速幅度和返回错误的URL数量成正比。只有503和429可以配合Retry-After使用,紧急降速时更推荐这两个。
只想降低某一类页面的抓取能做到吗?
做不到精确控制。Google按主机名整体降速,返回错误的URL和正常返回内容的URL都会变慢。不同子域名分开计算,长期想减少某类页面的抓取,要从URL结构和分面导航治理入手。
Googlebot抓取量突然暴涨通常是什么原因?
按Google文档,最常见的是URL配置效率低,通常由分面导航和排序筛选、带大量日期URL的日历、动态搜索广告目标网址(来的是AdsBot)引起。建议先看服务器日志确认来源,并核验是不是真的Google爬虫。
服务器改不了状态码怎么降低抓取频率?
可以向Google提交特殊请求,报告抓取频率异常偏高,并写明适合网站的抓取频率。只能申请降低不能申请提高,评估和执行可能需要几天时间,解决不了当下的紧急情况。
网站计划维护时应该返回什么状态码?
一两天以内的短时维护,返回503并配一个说明页面,带上Retry-After,robots.txt照常返回200。按Google暂停网站文档,需要停用更久时,应改为用200状态码提供一个可被收录的首页占位页,避免长时间返回错误。
怎么确认Google已经降低了抓取?
可以看服务器日志里Google爬虫的请求量变化,也可以在Search Console的抓取统计信息报告里查看总请求数和主机状态。撤掉503后同样用这两个地方确认抓取在逐步恢复。
图片放在CDN子域名上会被一起降速吗?
不会。Google按主机名降速,只有返回错误的那个主机名会变慢。主站www返回503时,放在cdn等其他子域名上的图片和静态资源不受影响;反过来也可以只对被抓爆的子域名单独返回503。
AI爬虫也能用503和Retry-After降速吗?
503、429和Retry-After都是标准的HTTP机制,但Google的文档只说明了Google爬虫的处理方式。其他搜索引擎和AI爬虫是否遵守、怎么遵守,要看各家的说明,不能默认效果一样。
Search Console还能手动设置抓取速度吗?
不能了。Search Console的抓取速度限制设置已在2024年1月下线,Google表示其系统会根据服务器的响应情况自动调整抓取速度。现在主动降速只能靠返回错误状态码、Retry-After或提交特殊请求。
权威参考资料
本文标题:《Google抓取频率文档补上Retry-After:服务器扛不住时,怎么用503和429让Googlebot先慢下来》
本文链接:https://zhangwenbao.com/google-crawl-rate-retry-after-503-429.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0