Google讲了PDF怎么排名,我下载了129份外贸品牌PDF,9份一个字都读不出
本文目录
- Google这期播客关于PDF说了什么?
- Splitt说不知道的PDF抓取上限,文档里写着64MB
- 129份外贸品牌PDF,多少能读出文字?
- 标题、链接、语言,这些基本信息填了吗?
- 响应头里的noindex和canonical,有几家在用?
- 外贸站的PDF资料,按什么顺序整改?
- 先把读不出文字的找出来
- 超过64MB的分册或压缩
- 补标题,放链接
- 给重要的PDF配一个HTML页
- 别让系统自动生成PDF副本
- 更新时换文件名,查一遍响应头
- 常见问题解答
- Google会收录和排名PDF吗?
- PDF文件太大,Google会抓多少?
- 扫描版PDF能被Google搜到吗?
- PDF里的链接有用吗?
- PDF内容更新了,怎么让Google尽快收录新版?
- 下载中心要搜索或填表才能拿到PDF,Google能找到吗?
- 同一份PDF放在多个网站上,会被当成重复内容吗?
- 权威参考资料
摘要:Google的Martin Splitt和John Mueller在10月13日的播客里讲了PDF怎么被收录和排名:先转成HTML再进索引,链接照常有效,能进AI概览和AI模式,能用HTML就尽量用HTML。我从27个外贸和工业品牌官网下载了129份PDF逐份检查:9份一个字都读不出来,都来自中国品牌,大多是产品资料;一半没有填标题;有2份超过Googlebot文档写明的64MB抓取上限;没有一份用响应头声明规范网址。
做外贸的网站,PDF几乎是标配。产品规格书、安装手册、认证证书、画册,一个下载中心挂几十上百份,很常见。
这些文件在Google眼里是什么待遇,以前大多靠猜。10月13日,Google搜索关系团队的Martin Splitt和John Mueller专门录了一期Search Off the Record播客,主题就是PDF在搜索里的处理,讲得比较细。
站内去年写过一篇PDF SEO的优化清单,那篇是通用做法。这篇换个角度:先把播客里说的话和Google现有文档对一对,再拿真实的外贸品牌PDF去量,看看大家做得怎么样。
Google这期播客关于PDF说了什么?
两位主持人的说法整理如下。右边一列是我对照Google文档或实测后的结论。
| 播客里的说法 | 我的核对 |
|---|---|
| Google用一个转换器把PDF转成HTML,后面的索引流程只处理HTML版本 | 和Google多年来的说法一致,下面的统计里,读不出文字的PDF就是转不出内容的那类 |
| PDF里的链接会被当成普通链接处理 | 129份里只有35份含可点击链接,多数PDF根本没用上这一点 |
| PDF里的图片有没有被单独处理,Splitt说不确定,倾向于没有 | 图片没有自己的网址,进不了图片搜索的常规流程,这一点按“不会”准备更稳 |
| PDF的抓取上限比网页大,具体多少Splitt说不知道 | Googlebot文档写的是PDF抓前64MB,下一节细说 |
| 能复制出文字的PDF才能被用于搜索,扫描件和整页图片不行 | 样本里9份完全读不出文字 |
| PDF能出现在普通搜索、AI概览和AI模式里,排名方式和其他文档基本一样 | 官方说法,无从外部验证 |
| PDF重新抓取得慢,更新时换个文件名比覆盖旧文件更快被收录 | 样本里37%的文件名本来就带版本号或日期 |
| 能做成HTML的内容,做成HTML更省事 | 两人都表达了这个倾向,同时说菜单、表格这类有明确用途的PDF照样可以发 |
Search Engine Journal的整理引了不少原话。比如Splitt说,转换器发生在渲染之后、进索引之前,Google对富文本、Word、Excel都有转换器,“还有Lotus Notes文档,不知道为什么”。Search Engine Roundtable则列出了播客的章节,并汇总了过去十几年Google关于PDF的零散表态,比如PDF里的链接传递PageRank、PDF不适合手机浏览等。
Mueller的态度挺务实。他拿餐馆菜单举例:在“菜单做成PDF”和“网站上根本没有菜单”之间选,他当然选有菜单;可要是在“PDF菜单”和“普通网页菜单”之间选,他更喜欢网页,因为好操作。Splitt也说,需要严格的打印版式、需要可填写的表单,这些都是用PDF的正当理由。
播客一开头聊的是一个有点好笑的问题:能不能把llms.txt存成PDF。答案是别这么做,这个文件存在的意义就是给机器一份轻量的纯文本,换成PDF等于把目的给弄没了。
对做AI搜索优化的人来说,这期播客的结论很简单。Splitt说PDF能出现在AI模式里,理由和普通搜索一样:都是用转换后的HTML。反过来说,转不出文字的PDF,AI那边同样拿不到内容,也就谈不上被引用。PDF本来就在Google可索引文件类型的清单里,能不能被用上,看的是里面有没有文字。
Splitt说不知道的PDF抓取上限,文档里写着64MB
播客里Mueller问到PDF的文件大小上限,Splitt的回答很坦白:抓取PDF的上限应该比网页大,和视频、图片一样,但具体是多少他不知道,以后也可能随着大家发布的PDF变大而调整。
其实Google的Googlebot说明文档里有明确数字:为Google搜索抓取时,Googlebot抓取支持的文件类型的前2MB,PDF文件的前64MB。Google的抓取基础设施文档另外写了一个默认值,所有抓取器默认只抓前15MB,具体项目可以另设上限,比如给PDF设得比HTML大。这几条是今年2月写进文档的,Mueller当时在社交媒体上解释过,这些限制没有变化,只是写得更细了。
Splitt还提到一个他也拿不准的点:PDF转成HTML之后,那个HTML版本可能还受网页的大小限制。文档没提这一点,我也没法验证,先当作一个可能性记着。
那么外贸品牌的PDF有多大?我统计的129份文件里:
| 体积 | 份数 | 占比 |
|---|---|---|
| 超过2MB | 62 | 48.1% |
| 超过15MB | 9 | 7.0% |
| 超过64MB | 2 | 1.6% |
中位数是1.58MB,一半的文件在2MB以下。超过64MB的两份,一份是大华一本56页的门禁报警产品画册,76MB;另一份是中联重科下载中心里的一个文件,服务器报的大小是2.35亿字节,约224MB。
超出64MB会怎样?Mueller在2月解释2MB限制时说过,超出部分不会被用于索引,限额以内的部分照用。可PDF有个特殊情况:文件的交叉引用表通常放在末尾,截掉后半截的PDF,很多软件根本打不开。我把中联重科那份文件下载到120MB时截断,用PyMuPDF打开,一页都读不出来。Google的转换器面对被截断的PDF会怎么处理,没有公开说明。稳妥的做法是别让任何一份要被搜到的PDF超过64MB。
站内3月写过Googlebot 2MB限制的分析,讲的是网页HTML。PDF的64MB看起来宽松得多,对大多数规格书确实够用,真正会碰线的是产品画册和整本手册。想先知道自己网站的文件有多大,可以用站内介绍过的抓取体积检查器,批量看响应大小。站内8月还量过46个电商站的页面体积,网页碰线的情况比PDF常见得多。
体积还有一个手机端的问题,播客里也专门讲了:PDF要整份下载完才能显示,版式固定,放大后不会重排。固德威那份2页的安装说明有28.7MB,采购商在展会现场用手机流量点开,等上半分钟是常事。规格书这种常被手机打开的文件,控制在几MB以内更友好。
129份外贸品牌PDF,多少能读出文字?
先交代样本。我挑了40个中国出海品牌和30个国际工业品牌的官网,从首页出发,优先沿着“下载、支持、资料、手册”这类链接,每站最多看35个页面,收集PDF地址,再每站随机抽最多6份下载。最后有27个品牌找到了PDF,下载成功129份,其中中国品牌17个87份,国际品牌10个42份,能正常解析的128份。
这个样本偏小,又是从官网入口能点到的文件,不能代表整个行业,只能说明常见问题长什么样。
找文件的过程本身也说明了一些事。70个品牌里,22个站对一个不执行脚本的普通爬虫几乎什么都不给,要么直接拒绝,要么首页只有一个空壳。另外21个站,我顺着链接走了二三十个页面,一份PDF都没碰到,资料大概藏在要搜索、要选型号、要填表单才出来的下载中心里。
需要说明的是,Googlebot会执行脚本,我的爬虫不会,所以“我没找到”不等于“Google找不到”。但只能通过搜索框或表单才能拿到的文件,任何顺着链接走的爬虫都很难发现,Google一般也不会去提交表单。想让规格书被搜到,最起码要有一个普通的链接指向它,或者把它写进网站地图。
判断“读不出文字”的方法和Splitt说的复制粘贴测试是一个道理:逐页提取文本,一页少于30个字符就算空页。结果如下:
| 分组 | 解析成功 | 完全读不出文字 | 占比 |
|---|---|---|---|
| 中国品牌 | 86 | 9 | 10.5% |
| 国际品牌 | 42 | 0 | 0% |
| 合计 | 128 | 9 | 7.0% |
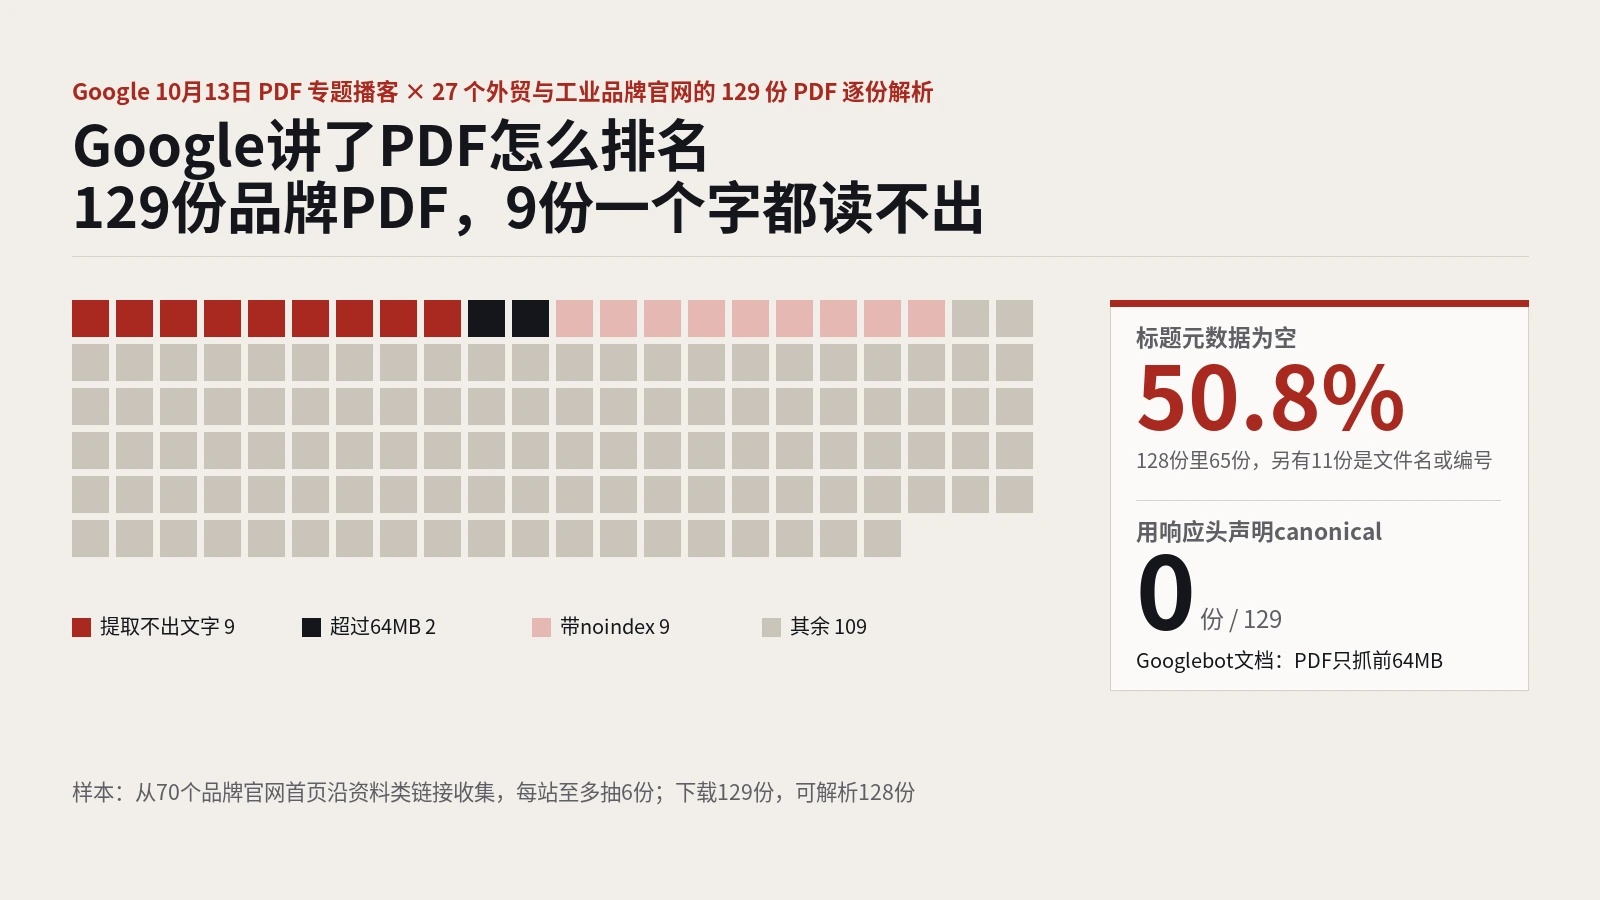
这9份来自6个品牌,大多是产品资料:
- 阳光电源一本53页的户用逆变器快速安装手册,27.7MB,197张图片,一个字都提取不出来。文件名带“_compress”,看起来是压缩时把整页转成了图片。同一品牌另外3份带“_compress”的文件文字正常,所以压缩工具本身未必有问题,要看具体用了什么设置。
- 古瑞瓦特澳洲站的3份规格书,每份2页,全是图片。
- 隆基2份组件资料,包括一份标着“Mobile Preview”的8页宣传页。
- 中联重科下载中心的一份38页资料,161张图片,0个字。
- 固德威一份2页的安装说明,28.7MB,60张图片。
- TCL澳洲公司发给客户的一份1页通知,整页是一张图片,内容再重要也搜不到。
这类文件在Google看来就是一叠图片。规格书里的型号、功率、尺寸,恰恰是采购商最可能拿去搜的东西,全锁在像素里了。说句不太客气的话,花钱做了一本漂亮的画册,在搜索引擎那里跟一张白纸差不多。
Google会不会对这类PDF做文字识别?播客里的说法是,扫描件和整页图片不经过文字识别就读不到内容,没说Google会替你做。按读不到准备是最保险的。补救的办法,站内写过扫描件批量OCR的流程,把文字层加回去就行;更好的办法是从设计源文件重新导出,别走“打印成图片再合并”这条路。
标题、链接、语言,这些基本信息填了吗?
能读出文字只是第一步。播客在讲重复文件和规范网址时,建议把PDF的元数据填好,在文件页眉放一个回到网站的醒目链接。我在样本里查了这几项:
| 项目 | 中国品牌(86份) | 国际品牌(42份) | 合计(128份) |
|---|---|---|---|
| 标题元数据为空 | 47 | 18 | 65,占50.8% |
| 含可点击链接 | 17 | 18 | 35,占27.3% |
| 含指向外站的链接 | 9 | 9 | 18,占14.1% |
| 带结构标签 | 21 | 15 | 36,占28.1% |
| 声明了文档语言 | 37 | 22 | 59,占46.1% |
| 加密或需要密码 | 0 | 0 | 0 |
标题这一栏,空着的超过一半。填了的63份里,还有11份写的是“Microsoft Word - ……”、排版软件的文件名或者内部编号。比如一份保修条款的标题是“Microsoft Word - PS-M-0135 N Standard Duomax Warranty_EN 20200423”,一份宁德时代的ESG报告标题直接是“……2025环境、社会与公司治理(esg)报告设计稿.pdf”,连“设计稿”三个字都带出来了。真正像样的标题只有52份,占40.6%。
Google在搜索结果里给PDF配标题时会不会用这个字段,播客没说死。可就算不用,空标题和“Microsoft Word - ”这种东西,也会出现在浏览器标签页、下载管理器和一些AI工具的引用里,没理由不填。
链接这一项差距更明显。国际品牌42份里有18份带可点击链接,中国品牌86份里只有17份。PDF里的链接既能把读者带回官网,也被Google当作普通链接处理。一份被转发到采购群里的规格书,如果连官网地址都点不了,等于断了回来的路。
结构标签和文档语言主要关乎无障碍阅读,播客的技术坑一章也提到了屏幕阅读器的问题。站内写过PDF无障碍与标签结构的做法,这里不展开。
响应头里的noindex和canonical,有几家在用?
PDF没有HTML的head,不能写meta标签。想控制收录和规范网址,只能靠服务器的响应头:X-Robots-Tag管收录,Link头里的rel=canonical管规范网址。播客的规范网址一章提到,同一份PDF放在不同网址上,就是一模一样的二进制文件,Google很难判断哪份是正本,可以用响应头里的canonical和元数据来帮忙。
129份文件的响应头统计:
- 带X-Robots-Tag的9份,全是noindex。其中6份来自Teltonika德语站点的/_files/ugd/路径,响应头带着Wix的标识,6份全部是“noindex, nofollow”。另有丹佛斯2份捷克语资料和WAGO 1份。
- 用Link响应头声明canonical的,0份。
- 带Last-Modified的115份,带ETag的96份,内容类型全部正确返回application/pdf。
Teltonika这6份值得多看一眼。从路径和响应头看,这些文件是通过Wix的文件服务发出去的,noindex很可能是平台默认加的,网站自己未必知道。如果这些是希望被搜到的产品资料,现在的状态就是一份都不会进索引。用Wix放PDF的外贸站,可以抽一份自己的文件看看响应头。
canonical的0份并不意外。多数站点的PDF只有一个地址,用不上。真正需要它的情况是:同一份规格书同时放在主站、子站、经销商站和第三方文档平台上。这种情况下,主站的那份最好在响应头里声明自己是正本。站内有一篇HTTP响应头与SEO讲过配置方法。
Last-Modified还能看出文件放了多久。115份带这个头的文件里,最后修改时间的中位数在一年左右,超过5年的有6份,全部来自国际品牌。PDF元数据里的创建年份也类似,能读到年份的126份里,2020年及以前创建的有22份。老资料本身没问题,麻烦在于参数、认证、型号可能早就变了,而Google重新抓取PDF又慢,搜出来的可能是一份过期的规格书。
文件名方面,129份里有48份带版本号或日期,比如“Ver25-202503”“V05”,占37.2%。这正好贴合播客里的建议:PDF重新抓取慢,更新时换一个新文件名,比覆盖旧文件更快被收录。反面例子是中联重科的“download.aspx?id=150”这类地址,文件名里没有任何内容信息,换版本时也很难换网址。
外贸站的PDF资料,按什么顺序整改?
前面的数字放在一起看,问题最大的不在格式选择,在于很多PDF根本没准备好被搜到。先把各项检查和样本的达标情况列在一起:
| 检查项 | 怎么查 | 样本里达标的比例 |
|---|---|---|
| 能复制出文字 | 全选复制到记事本,或用pdftotext逐页统计字符 | 119/128,93.0% |
| 体积在64MB以内 | 看响应头的Content-Length | 127/129,98.4% |
| 没有被noindex | 看响应头的X-Robots-Tag | 120/129,93.0% |
| 标题元数据像样 | 文档属性里的标题 | 52/128,40.6% |
| 声明了文档语言 | 文档属性或导出设置 | 59/128,46.1% |
| 带结构标签 | 导出时勾选“创建带标签的PDF” | 36/128,28.1% |
| 有能点回官网的链接 | 打开文件点一下 | 35/128,27.3% |
| 文件名带版本号或日期 | 看下载地址 | 48/129,37.2% |
前三项是“能不能被收录”的问题,达标率都在九成以上,可没达标的那几份往往正是最重要的产品资料。后面几项是“收录了好不好用”的问题,普遍做得不好。按影响从大到小,可以这样排。
先把读不出文字的找出来
最快的办法就是Splitt说的:打开PDF,全选,复制,粘贴到记事本。粘出来是空的或一堆乱码,这份文件在搜索引擎那里就是空的。批量检查可以用pdftotext这类命令行工具,统计每页提取出的字符数。产品规格书和手册优先,这些是采购商最会搜的。
超过64MB的分册或压缩
整本画册超过64MB的,分成几册发布,或者用压缩工具降低图片分辨率。压缩时盯住一件事:别选“转为图片”之类的选项,阳光电源那份手册就是前车之鉴。站内有PDF压缩与拆分的流程可以照做。大文件的存放和分发,可以参考外贸B2B大PDF用Cloudflare R2存放的做法。
补标题,放链接
导出PDF前,在文档属性里填上像样的标题,用产品名加型号加文件类型,比如“某型号储能逆变器规格书”,别留空,也别让“Microsoft Word - ”混进去。页眉或页脚放一个能点的官网链接,最好直接链到对应的产品页。
给重要的PDF配一个HTML页
这条是播客里两人反复说的:能做成HTML的就做成HTML。不需要把每份PDF都改写一遍,产品规格书的核心参数做成产品页上的表格,PDF作为下载附件挂在页面上,搜索引擎和读者两头都照顾到了。白皮书这类长文档,可以参考站内白皮书做成内容资产的思路,摘要和关键数据放在HTML落地页上。
别让系统自动生成PDF副本
有些网站系统会给每个页面自动生成一个“打印版PDF”。播客里专门提到这种情况:PDF副本和网页内容一样,会和网页抢排名,而PDF重新抓取又慢,网页改了,搜出来的可能还是旧的PDF。这类自动生成的副本,要么关掉,要么在响应头里加noindex。
更新时换文件名,查一遍响应头
规格书改版时,用带版本号或日期的新文件名发布,旧地址301跳转到新文件,站内链接同步改掉。最后抽几份文件看一下响应头,确认没有被平台默认加上noindex。多个地址放着同一份文件的,在主站那份的响应头里加上canonical。
常见问题解答
Google会收录和排名PDF吗?
会。Google在10月13日的播客里说,PDF先被转换成HTML再进入索引,收录和排名方式与其他文档基本一样,也能出现在AI概览和AI模式里。前提是PDF里有能提取的文字。
PDF文件太大,Google会抓多少?
按Googlebot的说明文档,为Google搜索抓取时,PDF只抓前64MB,其他支持的文件类型抓前2MB。超出部分不会被用于索引。播客里Splitt说他不清楚具体数字,以文档为准更可靠。
扫描版PDF能被Google搜到吗?
很难。整页都是图片的PDF没有文字层,播客里说这类内容不经过文字识别就读不到,Google没有说会替你做。最简单的检查办法是全选复制,粘贴不出文字的就要重新导出或补文字层。
PDF里的链接有用吗?
有用。Google把PDF转成HTML后,里面的链接会像普通网页链接一样被处理。实测的128份外贸品牌PDF里,只有35份带可点击链接,这一项很多站都还没用上。
PDF内容更新了,怎么让Google尽快收录新版?
播客里的建议是换一个新文件名发布,而不是直接覆盖旧文件,因为Google重新抓取PDF的频率比网页低。旧地址做301跳转到新文件,站内链接同步更新。
下载中心要搜索或填表才能拿到PDF,Google能找到吗?
很难保证。Google主要靠链接和网站地图发现网址,一般不会去填表单或在站内搜索框里输入型号。希望被搜到的资料,至少要有一个普通链接指向它,或者写进网站地图。需要留资才能下载的资料,本来也不适合指望它带来搜索流量。
同一份PDF放在多个网站上,会被当成重复内容吗?
多个地址上的同一份PDF是完全一样的文件,Google需要判断哪份是正本。可以在主站那份的HTTP响应头里加rel=canonical,并在PDF元数据和页眉里写清官网信息。
权威参考资料
本文标题:《Google讲了PDF怎么排名,我下载了129份外贸品牌PDF,9份一个字都读不出》
本文链接:https://zhangwenbao.com/google-pdf-ranking-indexing-b2b-brand-pdf-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0