相关问题97%的答案已经由AI写了,你那465个问答还通向哪
本文目录
- 相关问题那一格里,现在是谁在答?
- 你为问答准备的那一层,现在还剩几个出口?
- FAQ富媒体:文档整页撤了
- 问答标记:留下来的是另一个
- 精选摘要与生成式答案:还开着,但不归你调度
- 官方还专门列了一份不必做的清单
- 这批站到底准备了多少个问答?
- 这些问句挂在第几层标题上?
- 带问号的和不带问号的,是两种东西
- 问句底下那一句,真的是答案吗?
- 为什么答案句反而比正文写得好?
- 三类板块的答案形态不一样
- 出口关了,那这一层还值不值得继续做?
- 三个还成立的理由
- 三条要改的做法
- 先改哪一批最划算
- 这一趟量下来,尺子在哪儿会歪?
- 框架标题不剔掉,数全是假的
- 疑问词开头但不带问号的那一批
- 答案段只往后找三个块
- 这一格还在变,该怎么持续盯住?
- 这件事和段落工程、内容分块是同一回事吗?
- 常见问题解答
- 相关问题的答案97%由AI生成,是不是意味着底下的链接也没了?
- FAQ结构化数据现在到底要不要删掉?
- Q&A标记能不能拿来替代FAQ?
- 答案首句写多长合适?
- 问句标题挂在四级是不是一定要改?
- 只有几条问答的站,值不值得专门做一个问答页?
- 这份实测能不能直接套到中文站?
- 权威参考资料
摘要:把115个英文正文页的小标题全部抽出来,剔掉导航和页脚那939条框架标题之后,剩1273条真正的内容标题,其中465条是问句,占36.5%。这465个问答里,95.7%在紧随其后的三个块内能找到答案段;答案首句能离开上下文单独读懂的占91.0%,比同一批页面正文的平均水平高出15.3个百分点。可这465个问答只来自34个站,而且其中193条集中在同一个站;答案首句里出现自己品牌名的占15.5%,听着不低,可这些句子只来自8个站,另外24个站一条都没有。与此同时,谷歌在2026年5月宣布FAQ富媒体结果不再展示,那份文档已经整页撤下,官方现行的结构化数据类型清单里既没有FAQ也没有HowTo;而相关问题里的答案,14个月前只有12%由AI生成,今年9月第一周是97%。
相关问题那一格在搜索结果里待了十几年。它的样子没变过:一行问题,点开展开一段答案,底下挂一个来源链接。做内容的人为它准备了整整一层东西——页面上的问答区块、结构化数据里的问答标记、以及大量围绕疑问句写的小标题。
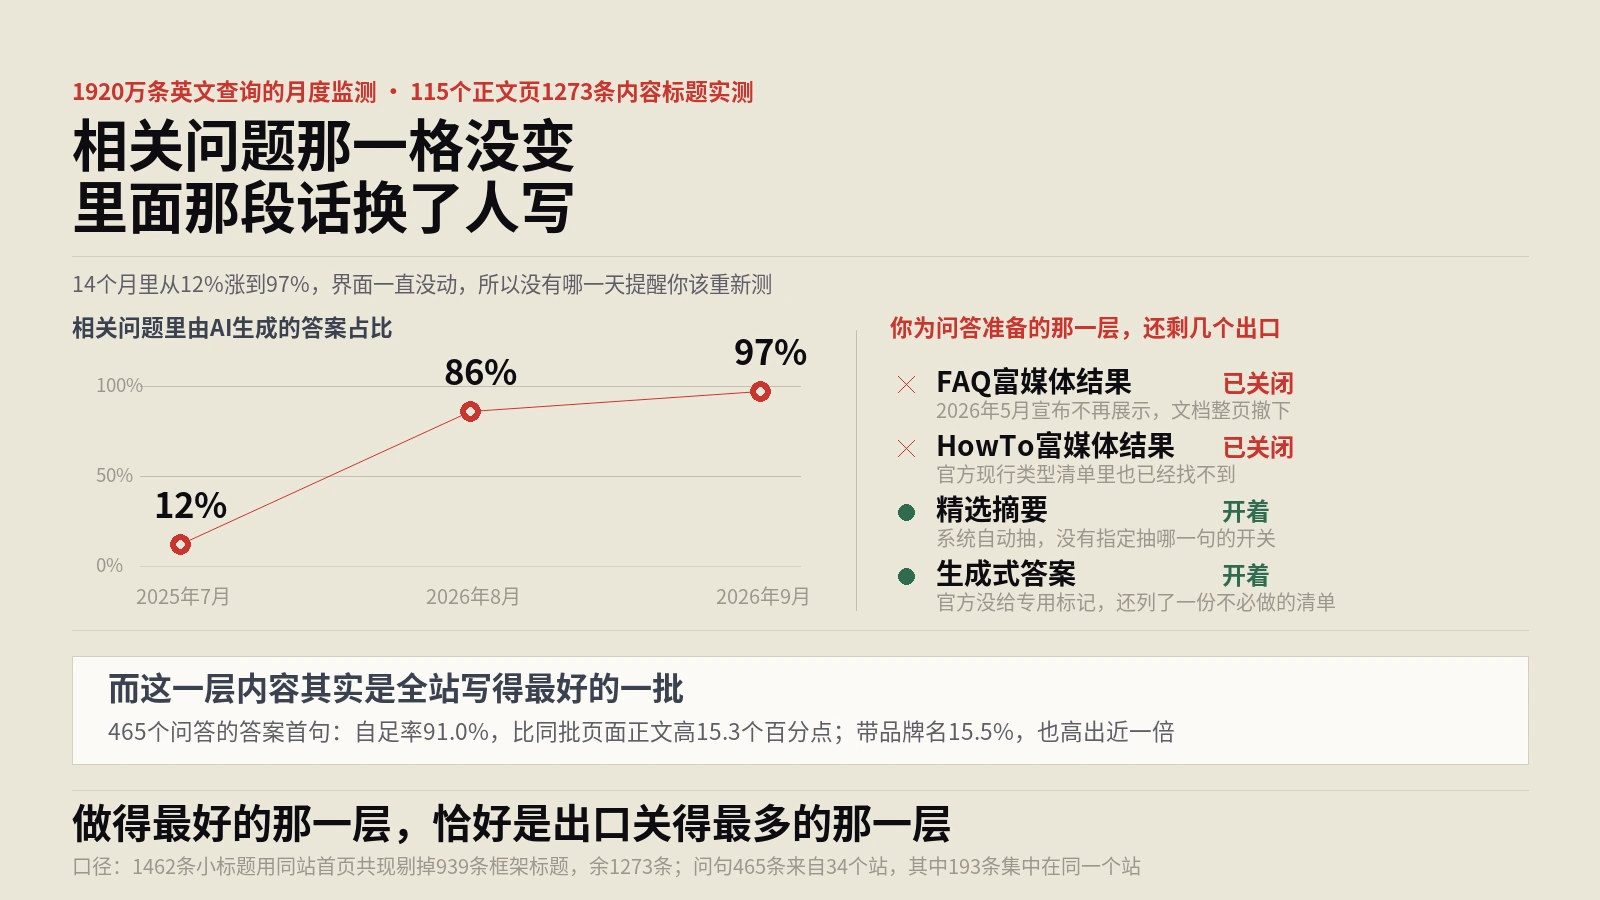
今年9月有两份互相独立的监测数据摆在一起:一家做相关问题挖掘的工具商说,从8月起这一格的答案已经100%由AI生成;另一家拿1920万条英文数据复核,说是97%,8月还是86%,而14个月前只有12%。位置没动,样式没动,底下那个链接也还在,只是里面那段文字换了写的人。
那么问题变成了:这一层东西现在通向哪儿。这件事一半能查官方口径,另一半能自己量,下面两趟都做了。
相关问题那一格里,现在是谁在答?
先把两份数据的口径说清楚,它们不是一回事。一份来自专做相关问题抓取的工具,口径是每月新抓到的问答里判定为AI生成的占比;另一份的样本是1920万条2026年内的英文查询,同样按月统计。两边都指向同一个走势:12%、86%、97%。
三个数之间隔着14个月,这不是一次开关,是一条爬升曲线。也就是说,任何一份关于相关问题的经验,都只在某个混合比例下成立,而这个比例一直在动。2025年初测出来的抢答成功率,到今天已经不是同一件事的成功率了。
这里要区分两个容易混淆的东西。相关问题是一个结果页组件,AI概览是另一个;这两者和AI模式的关系之前梳理过。现在发生的是前者的填充物换成了后者的产物,容器还是原来那个容器。
这类替换在别处也有过。精选摘要被吃掉一半是同一条线上的事,后台报表里那个平均排名算不清楚也是。共同点是界面没变,所以没有任何一天会提醒你该重新测一次。
你为问答准备的那一层,现在还剩几个出口?
把出口一个个数一遍,比争论该不该做有用。
FAQ富媒体:文档整页撤了
2026年5月,谷歌在更新日志里写明FAQ富媒体结果不再出现在搜索结果里,随后把那份功能文档整页删除。今天访问原来那个网址,会被直接带到更新日志的那条记录上。这不是收窄展示范围,是把说明书收回去了。
更直接的证据在类型清单里。官方现行的结构化数据功能清单逐条列了二十多个类型,里面已经没有FAQ这一项,HowTo也一并消失。上一轮我抓过谷歌搜索文档站的160个页面建语料,在那批文本里检索FAQPage这个类型名,命中页数是0。
问答标记:留下来的是另一个
清单里还留着的是Q&A,以及一个教育场景专用的教育问答。这两个和FAQ不是一回事:问答页那份文档要求页面本身是一个用户提问、其他人回答的形态,论坛和问答社区那种,而不是品牌自己写好问也自己写好答的那种。
很多站的FAQ标记严格说不符合Q&A的定义。富结果被砍之后要不要继续写这件事讨论过一轮,改法也梳理过,但当时的前提是文档还在。现在前提变了。
精选摘要与生成式答案:还开着,但不归你调度
剩下的两个出口都还在。精选摘要那份文档写得很明白,内容由系统自动从页面里抽,站长没有指定抽哪一句的开关。生成式那一侧,官方今年新出的面向生成式功能的优化指南也没有给出任何专用标记,反倒专门辟了一节去驳斥关于答案引擎优化的常见误解。
四个出口数下来,两个关了,两个开着但都不接受你的指令。这就是这一层东西现在的处境。
官方还专门列了一份不必做的清单
那份生成式优化指南里有一节叫破除迷思,逐条列出面向谷歌搜索可以忽略的做法,一共五条,值得一条条抄下来对照:
| 官方说可以忽略的 | 官方给的理由 |
|---|---|
| llms.txt以及各种专用标记文件 | 谷歌搜索本身不读这些文件,做了既不加分也不扣分 |
| 把内容切成很小的块 | 系统能理解一页里的多个主题并挑出相关那一段,没有理想页长 |
| 专门为AI重写内容 | 系统能理解同义表达,不必穷举每一种问法 |
| 去外面刷不真实的提及 | 核心排序看内容质量,另有系统在拦垃圾 |
| 过度纠结结构化数据 | 生成式搜索不要求结构化数据,也没有专用的词汇表 |
第五条正好把富媒体那件事收了尾:既然专用标记不是必需品,而FAQ那一类的展示位又已经撤了,继续往FAQ标记上投入就没有理由了。第二条和第三条更值得琢磨——官方明确说不必为AI切块、不必为AI换一种写法。
这和本篇量到的东西不冲突,反而对得上。问答区块的价值不在于它是一种AI专用格式,而在于它逼着你把用户真问的问题和一句干净的答案写出来;这件事对人和对机器都成立,所以它不在那份可忽略清单上。被检索和被引用的两套打法里分得更细,可以对着看。
这批站到底准备了多少个问答?
出口的事查完了,回头看看供给侧。语料是131个品牌站里筛出来的正文页,抓回178个,过掉非英文页之后剩115个,来自57个站。
从这115个页面里抽出所有二级到四级小标题,一共1462条。这里必须先做一次清理:导航栏、购物车、页脚栏目那些标题也在标签里,不清掉的话统计全歪。判据用的是同站首页共现——凡是在这个站首页上出现过的标题文本,一律判为框架标题剔除,一共剔掉939条,剩1273条内容标题。
1273条里,以问号结尾或者以疑问词开头的有465条,占36.5%。这个比例不算低。但下一个数字才是关键:
| 口径 | 数值 |
|---|---|
| 有问句标题的站 | 34个 / 58个 = 58.6% |
| 最多的一个站贡献 | 193条 = 41.5% |
| 前三个站合计 | 275条 = 59.1% |
| 其余31个站平摊 | 每站约6条 |
问答不是一件全行业都在做的事,是少数几个站做得很重。那个贡献193条的站是一家婴童用品品牌,它把整个帮助中心做成了逐条问答,产品维度铺得很细。剩下三十多个站,大多只是在文章里零星用了几个疑问句当小标题。
这些问句挂在第几层标题上?
层级分布出乎意料:四级标题236条,三级139条,二级只有90条。
也就是说近八成的问句藏在三级以下。这个位置本身没有错,帮助中心按产品线分大类、按型号分小类、最后才到具体问题,层级深是自然的。但它意味着这些问答在页面结构上离主题很远,切块的时候容易被上一级的标题盖住。按块检索那一套讲过块要带上足够的上下文,四级标题下的那一段恰恰是最容易丢上下文的。
按板块看也很集中:帮助中心261条,博客149条,指南49条,品牌故事4条。帮助中心是问答的主战场,博客里的疑问句小标题更多是文案手法而不是真在答问题。
把答案质量按层级拆开,出来一个很整齐的反差:
| 问句所在层级 | 条数 | 第一句直接给是否 | 第一句自足 | 第一句带品牌名 | 首句词数中位 |
|---|---|---|---|---|---|
| 二级标题 | 87 | 0.0% | 88.5% | 10.3% | 12 |
| 三级标题 | 123 | 17.9% | 91.1% | 1.6% | 15 |
| 四级标题 | 235 | 15.3% | 91.9% | 24.7% | 15 |
二级标题下面的87个问答,没有一条的第一句是直接给答案的。一条都没有。翻原文看得很清楚:二级标题位置的问句多半是文章的章节名,比如“为什么长距离跑舒适度最要紧”,底下那一段是展开叙述,不是回答。层级越深,越接近真正的一问一答。
顺带说一句,这些问句自己的质量还不错:97.6%的问句本身能独立读懂,65.2%的问句里有可落实的具体东西,比如型号名、产品线名或者数值。剩下那34.8%是“我们的退货政策是什么”“要多久才能收到订单”这种任何站都能挂上去的问法。
带问号的和不带问号的,是两种东西
465条问句里,真正以问号结尾的383条,剩下82条只是以疑问词开头,比如“如何清洁你的外套”。两组的问句自足率几乎一样,97.7%对97.6%,可落点率差得很远:
| 问句形态 | 条数 | 问句本身自足 | 问句里有具名落点 |
|---|---|---|---|
| 以问号结尾 | 383 | 97.7% | 59.8% |
| 只以疑问词开头 | 82 | 97.6% | 90.2% |
差30.4个百分点。原因是不带问号的那一批多是操作型标题,天然要把对象写出来——清洁什么、安装什么、搭配什么。而带问号的那一批里,大量是“我们的退货政策是什么”这种谁都能挂上去的通用问法。
这条数据有点反直觉:看起来更像问答的那一批,恰恰更不具体。把问号加上去不等于把问题问清楚了。
问句底下那一句,真的是答案吗?
判据这么定:从问句标题往后数三个块,找到第一个长度超过30个字符的段落,取它的第一句当作答案首句。找得到的445条,占95.7%。剩下20条要么底下直接又是一个标题,要么是列表或表格。
| 答案首句的形态 | 条数 | 占445条 |
|---|---|---|
| 直接给是或否 | 58 | 13.0% |
| 先加条件再回答 | 35 | 7.9% |
| 能离开上下文单独读懂 | 405 | 91.0% |
| 句子里出现自己的品牌名 | 69 | 15.5% |
| 短于8个词 | 68 | 15.3% |
答案首句的词数中位是15,均值15.7,最长的一条61个词。最短的那一批很有意思:有6条答案首句就是一个词——是、不是、当然可以。对着那个问题看,这几条答得干净利落;单独摘出来,它什么都不是。
先加条件的那7.9%是另一种情况。问的是孩子几岁能用某个产品,答的第一句是“如厕训练这件事很个人化,因此很难给出一个统一的建议”。这句话没错,但摘走之后读者拿不到任何东西。
为什么答案句反而比正文写得好?
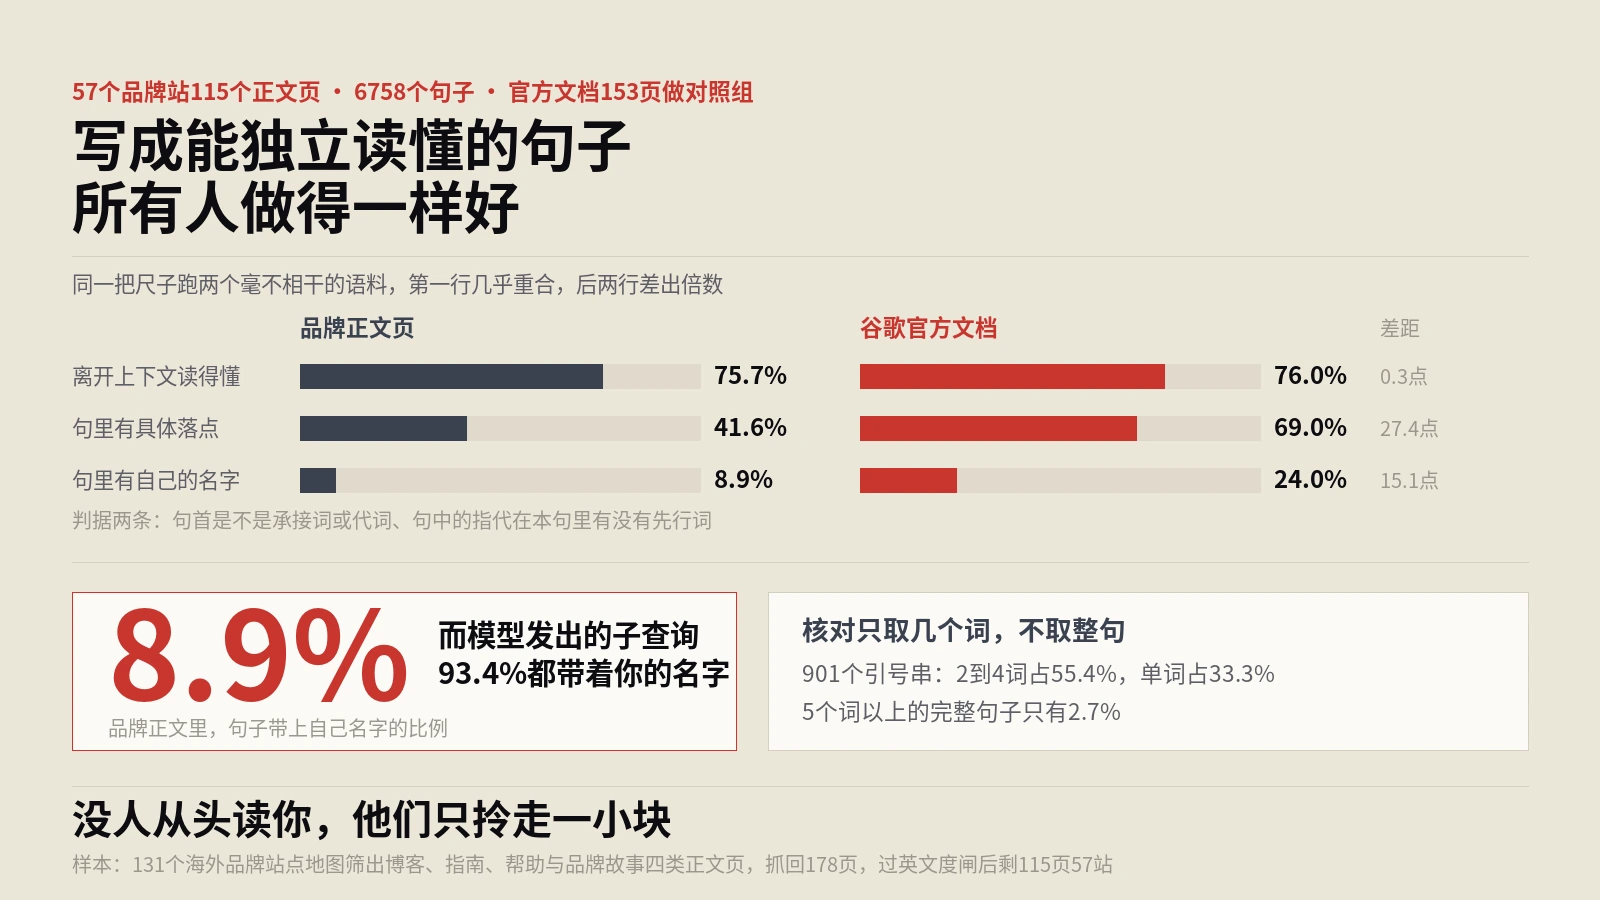
这是这批数据里最反直觉的一组。同一批页面的正文,句子自足率是75.7%;而问句底下的答案首句,自足率91.0%,高出15.3个百分点。
原因不玄。问答这个形态天然要求每条答案单独成立,写的人心里预设的读者就是只看这一条的那个人。这件事不是为搜索做的,是被业务逼出来的——客服要能直接把这一条发给用户。
换句话说,行业教了好几年的那条建议,在问答这一层已经被业务自己实现了,而且实现得相当好。这反过来说明另一件事:如果在问答区块里自足率都做到91%了,效果还是不理想,那问题一定不在这条建议上。
落款那一行也比正文好。答案首句带品牌名的15.5%,同一批页面的正文只有8.9%,几乎翻了一倍。原因同样是业务逼的:产品线一多,答案里不写全名就说不清在讲哪一件。
但这个平均数要拆开看才有意义。445条答案里的69条落款,只来自8个站;另外24个站,一条带品牌名的答案都没有。贡献192条的那家婴童品牌自己就占了22.9%的落款率,剩下33个站合起来9.9%。
换句话说,问答这一层的落款不是行业习惯,是少数几个站被自家产品线逼出来的副产品。把它当成普遍水平去对标,会高估自己。这类平均数陷阱在同一个指标传出三个数那件事上也出现过,分母和分档不说清楚,数字就没法用。
三类板块的答案形态不一样
| 板块 | 条数 | 直接给是否 | 先加条件 | 第一句自足 | 带品牌名 | 短于8个词 |
|---|---|---|---|---|---|---|
| 帮助中心 | 258 | 14.3% | 5.4% | 91.9% | 23.3% | 11.6% |
| 博客 | 136 | 8.8% | 11.0% | 87.5% | 5.1% | 17.6% |
| 指南 | 45 | 20.0% | 13.3% | 97.8% | 2.2% | 26.7% |
指南那一列很有意思:自足率97.8%,全场最高;可落款只有2.2%,全场最低,而且四分之一的答案首句短于8个词。写得最像标准答案的那一批,也是最认不出作者的那一批。
博客正好相反,先加条件的比例最高、自足率最低。博客里的疑问句小标题本来就承担着过渡的功能,底下那一句常常是一句铺垫而不是答案。这不算错,但它意味着博客里的问答区块在被摘引这件事上贡献有限,别把它算进产能。
出口关了,那这一层还值不值得继续做?
值得,但理由要换。原来的理由是拿富媒体展示位,那个理由现在不成立了。
三个还成立的理由
第一个是站内。帮助中心那261条问答是客服成本的直接对冲,跟搜索引擎给不给展示位没关系。
第二个是检索侧。生成式那一头的检索行为里,逐条问答天然就是一个个独立的小块,命中率比大段落高。这一点在加上问答引用涨、撤掉又掉回来的那次对照实验里有过因果证据,那不是相关性观察。
第三个是问题本身。问答区块逼着你把用户真问的问题写出来,这件事比答案更有价值,问答段落的写法里讲过怎么挖这些问题。
三条要改的做法
第一,别再为富媒体写标记。把精力挪到页面上那段可见的问答本身,那一份现在是唯一真正被读的。
第二,别急着把问句往上提层级。直觉上四级标题太深该往上挪,可数据正好相反:越深的那一层答得越像答案,二级标题那87条一条都没直接作答。真正该做的是让深层标题自带上下文——把产品线名或型号写进标题里,这样它被单独切走也知道在说什么。
这一条和层级调整是两回事,很容易做混。层级动的是目录结构,代价大、收益不确定;标题里补一个名词,代价接近零,而且直接解决切块之后指代不明的问题。
第三,在答案首句里补落款。这是四条数据里差距最大的一项,而且改起来最便宜——把“是的,可以”改成“可以,该型号支持这个用法”,一句话的事。发布前的内容体检里加这一项,成本几乎为零。
先改哪一批最划算
按这批数据排个序。帮助中心那261条是投入产出比最高的一批:它的自足率已经91.9%,落款23.3%,只差把通用问法换成带对象的问法。博客那136条排第二,主要问题是第一句常常是铺垫,把结论提到第一句就行。指南那45条最需要动的是落款,自足率97.8%已经到顶,可2.2%的落款率意味着它写得再好也认不出是谁。
有一类可以先放着:品牌故事页里的4条问句,量太小,不值得为它单独立规矩。
这一趟量下来,尺子在哪儿会歪?
三处,都记下来。
框架标题不剔掉,数全是假的
第一版没做清理,1462条标题里混着购物车、订阅框、页脚栏目。这些标题里也有问句,比如“我们能帮你什么”,它挂在页脚客服入口上,跟内容没关系。用同站首页共现做判据剔掉939条之后,问句比例和层级分布才稳定下来。
疑问词开头但不带问号的那一批
465条问句里,带问号的383条,只是以疑问词开头的82条。后面这一批包括“如何清洁你的外套”这种祈使式标题,严格说不是问句。把它们算进来会让问句比例偏高约6个百分点。我选择算进来,因为从切块和匹配的角度,它们和问句起的作用一样;但这条口径必须写出来,不然别人复现不了。
答案段只往后找三个块
找不到答案的20条里,有一部分其实答案在更后面,中间隔着图片说明或者列表。往后找的窗口开到五个块,找得到的比例会升到接近100%,但混进不相关段落的风险也上来了。三个块是个折中,不是最优解。
还有一条边界得说清:本篇量的是页面上可见的那一层问答,没有量结构化数据里的问答标记。两者经常不一致,但那是另一个题目。
样本量也要交代。465条问句来自34个站,但其中一个站占了193条,去掉它之后剩33个站272条,每站平均8条。所以凡是带跨站比较的结论,我都把那个大站单列出来对照过一遍;凡是没有单列的,读的时候请默认它受那个站影响。
最后一条是时间。相关问题里AI生成占比这条曲线是别人的月度监测,我没有复现能力,只能引用。它的样本是英文查询,别的语言什么情况没有公开数据。生成式功能在不同语种上的铺开节奏差得很远,所以这条曲线不能直接套到中文或者小语种上。
这一格还在变,该怎么持续盯住?
12%到97%这条曲线还没走完,所以任何一次性的结论都会过期。要盯的话,有三件事成本不高。
第一件是定期抽样。挑二三十个和自己业务相关的问法,每月固定跑一遍,记下相关问题里出现了哪几条、答案是不是生成的、底下挂的来源是谁。这份记录的价值不在单次数值,在于它能看出趋势拐点,跟把自己的内容和生成式答案逐条比差距那套做法是配套的。
第二件是采样次数。生成式那一侧的行为是概率性的,同一个问题跑一次和跑四次,看到的东西不是一回事。只跑一次然后下结论,是这两年最常见的测量错误。
第三件是把问答的产能和效果分开记。产能是你这个月新增了多少条问答,效果是这些问答被引用了几次。竞品对标那套维度里两者是分开的两栏,合成一栏看就分不清是没做够还是做了没用。保哥的习惯是产能按周记、效果按月记,两条线画在一张图上,什么时候脱节一眼能看出来。
这件事和段落工程、内容分块是同一回事吗?
方向一致,尺度不同,不要混着用。
段落级排名讲的是引擎能从整页里单独抽一段去排序,单位是段。内容分块讲的是向量检索按块存取,单位也是段。本篇的单位是一个问答对:一条标题加紧随其后的那一句,量级在二十到四十个词之间。
三者的关系是套娃:块里装着段,段里装着问答对,问答对里装着那一句答案。把内容当结构化数据来生产那套方法里,问答对是最小的可交付单元,因为它自带一个问题当标签。
还有一层区分值得点出来。被检索和被引用是两套打法,问答对在被检索那一侧优势明显,在被引用那一侧却因为落款缺失而吃亏。保哥做过几轮对比,同一批问答内容,补上产品全名之后被点名的次数明显变多,而流量变化不大——这两个指标本来就不该放在一起看。
常见问题解答
相关问题的答案97%由AI生成,是不是意味着底下的链接也没了?
链接还在。变的是那段文字的来源,不再是从某个页面上原样抽一段,而是模型综合生成之后再挂来源。这两种形态对内容的要求不一样:前者要求你那一段本身可摘,后者要求你那一段能被核对和归属。所以做法要跟着换,但不是不做。
FAQ结构化数据现在到底要不要删掉?
不必删,但也不必继续投入。留着它不会有惩罚,官方只是不再展示对应的富媒体,类型本身没有被判违规。官方的生成式优化指南里还专门说过,生成式搜索不要求结构化数据,也没有专用词汇表。真正要做的是把页面上可见的那段问答写好,因为那一份是所有通道都在读的。
Q&A标记能不能拿来替代FAQ?
多数情况不能。官方对问答页的定义是用户提问、其他人回答的社区形态,品牌自己写问自己写答不符合。硬套的风险是被判为结构化数据滥用,得不偿失。真正适用的是论坛、社区问答板块这类页面。
答案首句写多长合适?
实测这批站的中位是15个词,均值15.7。中文的话大致对应25到40个字。关键不是长度而是形态:第一句要能单独成立,需要条件的把条件放到第二句去。实测里7.9%的答案首句把条件写在了最前面,那是最不划算的一种写法。
问句标题挂在四级是不是一定要改?
数据不支持往上提。四级标题下的答案质量反而最好,自足率91.9%、直接作答15.3%、带品牌名24.7%;二级标题下的87条一条都没直接作答。可行的做法是让深层标题自带上下文,把产品线名或型号写进标题里,这样即使被单独切走也知道在说什么。
只有几条问答的站,值不值得专门做一个问答页?
先看问题是不是真的有人问。实测里31个站每站只有约6条问句,这个量级更适合散在对应的内容页里,而不是单开一个集中页。集中页的价值在于规模,规模不够的时候,分散反而更容易被匹配到。
这份实测能不能直接套到中文站?
问句识别那一部分要重写,中文的疑问词和问号用法都不一样,而且大量中文标题用陈述句形式提问。层级分布、板块分布、答案形态这几项的分析框架可以直接沿用。相关问题这个组件在中文搜索结果里的形态和占比也不同,那部分数据不能直接搬。
权威参考资料
本文标题:《相关问题97%的答案已经由AI写了,你那465个问答还通向哪》
本文链接:https://zhangwenbao.com/paa-ai-generated-question-block-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0