数据出处离数字有多远?1486条实测,同一句里给了链接的只有9.6%
本文目录
- 一个数字摆在你面前,你要走几步才能确认它是真的?
- 什么样的句子算一条数字断言
- 三档口径分别在量什么
- 这批页面怎么挑出来的
- 抽正文这一步先翻了一次车
- 为什么同一句里就给出链接的只有9.6%?
- 三档口径的总账
- 不同形态的数字,待遇差得不小
- 一半的数字连据谁说都没写
- 把口径放宽到整节,最差的一类为什么翻成了最好的?
- Sources那一行是什么写法
- 统计汇总页从3.9%跳到55.5%
- 九个站里只有三个站在用
- 数字离最近一条出处,中位数是两块,那均值为什么是十一块?
- 距离怎么算
- 三成隔了九块以上
- 两种体裁的距离不一样
- 说了机构名却不给链接,这三十九句该怎么算?
- 页面这一级看,多少篇文章一条外部出处都没有?
- 四成
- 通篇零外链的两成六
- 站内链接占了五成五
- 站与站之间差九倍,说明的是习惯还是体裁?
- 出处天然离数字远,这不是谁偷懒
- 出处是写给一整节的,数字是被一句一句取走的
- 三种排版惯例,代价各不相同
- 顺带说一句,这跟权威度是两个指标
- 这套判据怎么在自己站上跑一遍?
- 第一步:圈出数字断言
- 第二步:量距离
- 第三步:只补最贵的那几条
- 该补的只有三类,其余的补了也是噪声
- 常见问题解答
- 文末统一放一个参考资料区,算不算给了出处?
- 句子里挂太多链接会不会影响可读性?
- 把机构名写进句子但不给链接,是不是省事又安全?
- 统计汇总页那种Sources行的写法值得学吗?
- 这套办法对中文站适用吗?
- 为什么不直接看文章有没有引用权威域名?
- 数字很多的文章,是不是天然更难达标?
- 这次为什么要报三档口径,直接报一个数不行吗?
- 权威参考资料
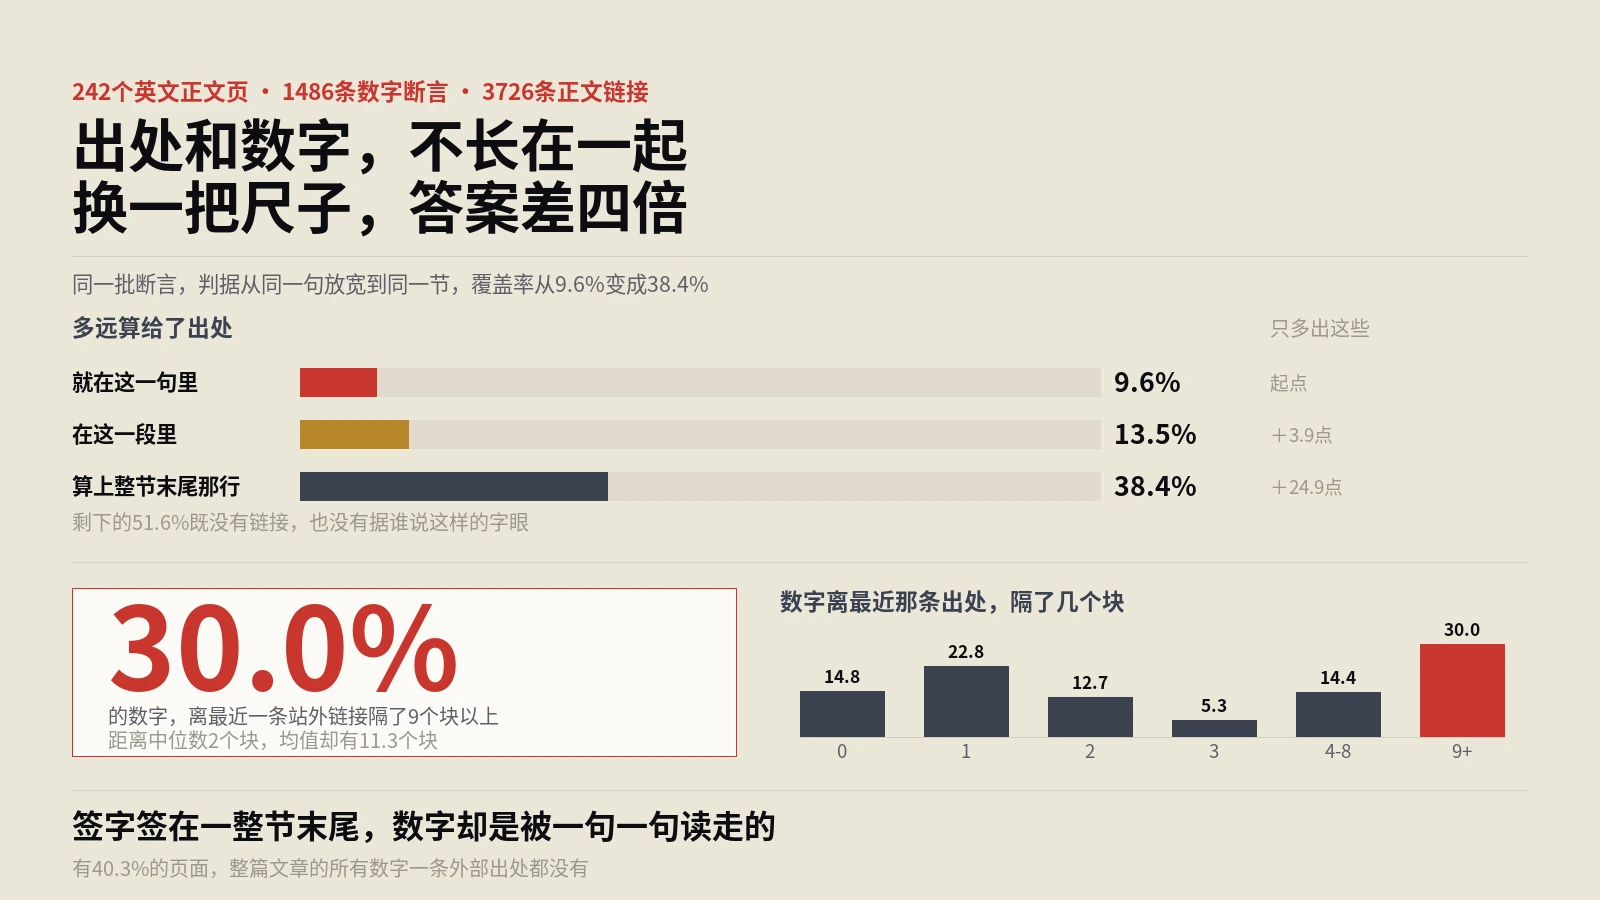
摘要:从9个英文搜索营销内容站取242篇正文,逐句挑出带百分比、倍数、金额或大数的断言共1486条,再看每条数字附近有没有一条可点开的站外出处。同一句里就给出链接的只有9.6%,放宽到同一段是13.5%,把整节末尾那行Sources也算进来才到38.4%。剩下51.6%既没有链接,也没有据谁说这样的字眼。数字离最近一条外部出处的距离中位数是2个块,但有30.0%隔了9个块以上。
做内容的人大概都同意一件事:写了数字就该给出处。真正麻烦的地方在下一层——出处给在哪儿。给在句子里,给在段末,给在这一节最后一行,还是统一堆到文末的参考文献区,读者的体验完全不同,而这四种写法在任何一份检查清单上都算“给了出处”。
保哥这次把这件事量了一遍。做法很笨:把一批英文内容站的正文拆成块,逐句找出带数字的断言,然后问一个非常具体的问题——从这句话出发,最近的一条站外链接在几个块以外。
一个数字摆在你面前,你要走几步才能确认它是真的?
先说清楚这次量的是什么,不然后面的百分比全是空的。
什么样的句子算一条数字断言
不是所有带数字的句子都需要出处。“第3步”“2026年”“5分钟读完”这类不需要。真正需要的是那种把一个外部事实说成定量结论的句子,判据用了五条封闭规则:句中出现百分比(含percent写法)、倍数(3x或3 times more这类)、比例(1 in 5、3 out of 4)、带千分位或量级词的大数(1,042、133.6 million)、带货币符号的金额。命中任意一条就进样本。
纯年份、纯序号、纯时长不计。星级评分模块那种Rated 5 out of 5被单独剔掉,它是界面组件不是断言,第一轮没剔的时候光这一条就混进来三十多次,还差点把“比例型断言的出处率是0”写成结论。
三档口径分别在量什么
“有没有出处”这句话本身太糊,所以拆成三档,从窄到宽:
- 窄口径:出处链接就在这一句里,读者读到数字的同一瞬间能看见它。
- 中口径:链接在同一个块内,也就是同一段、同一个列表项或同一个表格单元格。
- 宽口径:在中口径基础上,再算上章节末尾那种单独一行的
Sources: A、B、C——只要它带站外链接,就认为它覆盖了本节往上最多8个块。
三档一起报,是因为只报一个数一定会误导。这一点后面会看到非常刺眼的证据。做这类审计有个通用经验:绝对数会随判据大幅摆动,比值反而稳,所以能报比值就别报绝对数。
这批页面怎么挑出来的
从9个英文搜索营销内容站的站点地图与订阅源取近期文章,一共332个网址,全部抓回完整HTML。准入闸三道:页面自己声明是文章类型,也就是JSON-LD里写着Article、BlogPosting或NewsArticle,或者og:type是article;正文散文不少于1000字符;英文度达标。
三道闸各刷掉多少:不是文章类型的46个,正文太短的18个,英文度不足的26个,剩下242个通过。
第三道闸最值得说。被它刷掉的26个里,有19个是同一个站的葡语、德语、西语、法语、意语、荷语版本,它们在英文封闭词表下一条判据都不触发,不剔的话会被算成满分样本,直接进“做得最好”那一档。这个坑上一批也踩过一次,判据一样,翻车方式一样。另外7个页面自称是英文,但正文里散文比例太低,全是列表与短句,也一并剔掉了。
过闸的242页覆盖9个站,正文块合计取出3726条链接。每页的数字断言中位数是1条,均值6.1条,最多的一页有82条;完全不含数字断言的页面有96个,占39.7%。
抽正文这一步先翻了一次车
值得单独说一句,因为这个坑很隐蔽。取正文用的是文本密度法:自下而上把每个节点子树里的段落字数累加起来,找出包住绝大部分正文、层级又最深的那个节点。写第一版时用节点对象当字典的键,结果解析库每次访问父节点都返回一个新的包装对象,两次拿到的同一个节点既不是同一个对象、内置的取址函数也给出不同的值,累加根本没聚合上。
后果是两个站集体异常:一个站的正文只剩228个字符(真实值两万多),另一个站直接取出0个块。发现方式很朴素——按站看正文长度的中位数,两个站的数字明显不在一个量级上。修法是换成自顶向下遍历一次,顺带把每页的解析时间从29秒压到0.07秒。这类错误不会抛异常,只会静静地把某几个站从样本里抹掉,如果不按站分组看一眼,得出的全站比例就是错的。
为什么同一句里就给出链接的只有9.6%?
三档口径的总账
| 口径 | 判据 | 命中 | 占1486条 |
|---|---|---|---|
| 窄 | 链接在这一句里 | 143 | 9.6% |
| 中 | 链接在这一个块里 | 201 | 13.5% |
| 宽 | 再加上本节的Sources行 | 571 | 38.4% |
| — | 既没路也没写据谁说 | 767 | 51.6% |
窄到中只涨了3.9个百分点。这说明一件事:作者要么在写数字的当下就顺手挂链接,要么整段都不会挂。“数字在句首、链接在段尾”这种折中写法,在这批样本里几乎不存在。
不同形态的数字,待遇差得不小
| 数字形态 | 条数 | 窄 | 宽 | 裸数字 |
|---|---|---|---|---|
| 百分比 | 799 | 11.5% | 33.5% | 55.2% |
| 大数与量级词 | 704 | 7.2% | 46.3% | 45.6% |
| 金额 | 218 | 10.1% | 41.3% | 53.2% |
百分比的句内挂链率最高,也才11.5%。有意思的是大数那一档窄口径最低(7.2%)而宽口径最高(46.3%),因为用户规模、月活、样本量这类大数最常出现在统计汇总页,而那类页面的出处全部集中在节末。
一半的数字连据谁说都没写
把链接这件事先放一边,只看文字有没有交代来路。带according to、a study、survey by、data from这类归因措辞的断言只有8.9%。两个条件都不满足的,也就是既没有可点的路、也没有一个可搜的机构名的,占51.6%。
这个数比想象中难看,但它同时也说明这不是个别作者的问题。一半以上的样本落在同一种写法上,那就是行业惯例。逐条核对一份十条最佳实践清单那次做的是个案,把十个数字挨个追回出处;这次做的是全样本,先不追准不准,只看有没有路可追。两件事是上下两级,不能互相替代。
把口径放宽到整节,最差的一类为什么翻成了最好的?
这是整轮测量里最值得说的一处,因为它差点让保哥写出一个完全相反的结论。
Sources那一行是什么写法
统计汇总类页面有一种固定排版:连着写四五段数字,然后单起一行写Sources: Meta、Statista、ITU、World Bank,每个机构名都是一条链接。这一行不属于任何一段,它是给上面整块内容签的字。
判据这样写:一个块的纯文本不超过220个字符、以Source或Sources这类词加冒号开头、并且含站外链接,就算一条章节级出处,它向上覆盖到上一个同类块之后,最多8个块。全样本共命中215个这样的块,抽样翻了25条,没有一条误报。
统计汇总页从3.9%跳到55.5%
| 体裁 | 断言数 | 窄 | 中 | 宽 | 裸数字 |
|---|---|---|---|---|---|
| 长文与指南 | 744 | 14.9% | 22.3% | 22.3% | 60.9% |
| 短资讯 | 19 | 15.8% | 15.8% | 15.8% | 47.4% |
| 统计汇总页 | 723 | 3.9% | 4.3% | 55.5% | 42.2% |
第一版判据只查同一个块,跑出来的结论是“统计汇总页是全场最不给出处的一类,窄口径3.9%垫底”。加上章节级判据之后,这一类的覆盖率变成55.5%,从垫底直接变成榜首,而长文那一档纹丝不动,因为长文根本不用Sources行这种写法。
同一批数据,只因为判据从同一句放宽到同一节,两类页面的排名整个对调。这不是数据的问题,是尺子量错了位置。要不是抽样翻原文时看见那一行Sources,这篇文章的主结论会是反的。做这类审计最怕的就是这一步,跟孤岛页面检测里抽样口径决定结论真假是同一类风险。
九个站里只有三个站在用
章节级Sources段一共出现215次,但只分布在26个页面上,占全部页面的10.7%,而且只来自3个站。剩下6个站从头到尾没有用过这种写法:它们要么把链接写进句子,要么什么都不写。
这个分布本身值得注意。一种明显更省版面、也确实提高了覆盖率的写法,在同一个行业里只有三分之一的站在用,说明它不是被评估之后选择的,而是各家编辑部各自形成的习惯。
数字离最近一条出处,中位数是两块,那均值为什么是十一块?
距离怎么算
对每一条断言,找出本页所有含站外链接的块,取距离最近的那个,单位是块。1350条断言所在的页面至少有一条站外链接,剩下136条所在的页面一条都没有,占全部断言的9.2%,无法计算距离。
| 相隔块数 | 条数 | 占1350条 |
|---|---|---|
| 0(同一块) | 200 | 14.8% |
| 1 | 308 | 22.8% |
| 2 | 172 | 12.7% |
| 3 | 71 | 5.3% |
| 4至8 | 194 | 14.4% |
| 9及以上 | 405 | 30.0% |
三成隔了九块以上
中位数是2个块,看着不远。但均值是11.3个块,两者差出五倍多,原因就在最后一行:30.0%的数字,离最近的一条站外链接隔了9个块以上。这条长尾把均值整个拉了起来。
隔9个块是什么概念?读者要往上或往下滚过将近十段文字,才能碰到本页第一条通向外面的链接,而且那条链接多半跟这个数字毫无关系——它可能是一条产品页链接,也可能是作者提到某个工具时顺手挂的。在这种距离上,说这个数字有出处是自欺欺人。
两种体裁的距离不一样
长文与指南的距离中位数是2块,同块命中率27.1%;统计汇总页中位数3块,同块命中率只有4.3%。统计页的数字天生离链接远,因为它的链接集中在Sources行上。这恰好又印证了上一节:距离远不等于没有出处,但它确实等于读者当场核不了。
说了机构名却不给链接,这三十九句该怎么算?
有一类句子很微妙:它写了归因措辞,也点了机构名,但整段乃至整节都没有一条能点的链接。这类句子有39条,占全部断言的2.6%。
比例不高,但它们往往是文章里分量最重的那几句。样本里能看到这样的写法:某项分析说AI概览带来的点击损失约为58%,某团队用33.1万个页面做了一次验证,某研究机构说75%的受访者认为内容营销对建立品牌信任至关重要。三句话都点了名,三句话都没给路。把一份被反复转述的主张逐字核回原文那次的经历说明,这一步走岔的概率并不低。
读者要核这三句,得先把机构名复制出来,再去搜索引擎里找那份材料,然后自己判断找到的是不是同一份。同一家机构一年可能发好几份报告,同一份行业基准还可能被重发两次,搜到的未必是被引的那一份。
点名不给链接,等于把查证这件事从作者身上挪到了读者身上,而读者有多少人,这份成本就得付多少遍。相比之下,那767条裸数字反而诚实一些,它们至少没让人误以为出处就在附近。
页面这一级看,多少篇文章一条外部出处都没有?
四成
把断言按页面归堆,只看至少有3条断言的非统计类页面,一共72页。宽口径覆盖率的中位数是12.5%,均值23.9%。其中29页的覆盖率是0,占40.3%,整篇文章里所有的数字,一条外部出处都没有。
这一档最容易被漏掉,因为这些文章看上去毫无问题:有小标题、有表格、有加粗、有结论。缺的只是读者验证它的那条路,而没有任何工具会为此报错。死链检测工具查的是已有链接通不通,它不会问“这里为什么没有链接”。
通篇零外链的两成六
再放大到全部242页,正文里一条站外链接都不存在的有63页,占26.0%。这63页不全是数据密集型文章,其中一部分本来就没什么数字可引,但也有相当一部分是通篇讲数据的长文。
站内链接占了五成五
3726条正文链接里,指向本站其他页面的2049条占55.0%,指向站外的1597条占42.9%,指向同行内容站的80条占2.1%。也就是说,正文里超过一半的链接是内链。内链有内链的用处,它做的是站内导航与主题聚合,不承担举证责任。把这一半刨掉之后,真正能当出处用的链接密度比看上去低得多。这跟内链数量与权重稀释那件事无关,纯粹是分工不同:内链回答“还想看什么”,外链回答“凭什么这么说”。出站链接到底要不要做这个老问题,在这个语境下有了新答案——它不是权威传递问题,是举证责任问题。
站与站之间差九倍,说明的是习惯还是体裁?
把9个站按窄口径排一遍,最高37.1%,最低4.0%,差9.3倍。但这个差距不能直接读成“谁更严谨”。
| 站(按断言数排) | 断言数 | 窄 | 宽 | 裸数字 |
|---|---|---|---|---|
| 甲 | 749 | 4.0% | 53.8% | 43.0% |
| 乙 | 183 | 19.1% | 39.9% | 47.5% |
| 丙 | 148 | 11.5% | 16.9% | 65.5% |
| 丁 | 145 | 4.1% | 5.5% | 65.5% |
| 戊 | 109 | 32.1% | 33.9% | 55.0% |
| 己 | 105 | 4.8% | 7.6% | 81.0% |
| 庚 | 35 | 37.1% | 42.9% | 40.0% |
甲站窄口径只有4.0%,宽口径却有53.8%,因为它的统计汇总页全部用Sources行。丁站和己站两个口径都很低,己站的裸数字高达81.0%,它写的是观点型长文,数字大多来自内部估算,本来也无处可引。同一张表里,低分至少有三种完全不同的成因,把它读成排行榜就读错了。
这也是行业榜单那类材料最容易出问题的地方:一个指标横着排出名次,名次本身会替读者做出因果解释,而数据里根本没有这个因果。
出处天然离数字远,这不是谁偷懒
出处是写给一整节的,数字是被一句一句取走的
排版惯例是按写作单位组织的。作者写完一节,觉得这一节的材料来自某几个地方,就在节末签一行字。这在纸质时代完全合理,因为读者是从头读到尾的,读到签名那一行时,上面那几段还在脑子里。
今天的读取方式变了。搜索结果摘一句,答案引擎摘一段,同事在群里转发时截一张图,读者自己也是搜到哪儿看哪儿。取走的单位变小了,而签字的单位没变。这两个粒度一旦对不上,出处就等于不存在。这跟按块检索而不是按页检索是同一个道理的两面。往前推一步,可验证的出处正在变成一种信任货币,而货币的最小面额,现在还停在“一整节”这一级。
三种排版惯例,代价各不相同
- 句内挂链:查证成本最低,但会让长句变碎,编辑普遍不喜欢。
- 节末Sources行:版面干净,可一旦这一节被拆开引用,签名就掉了。
- 文末参考文献区:最像论文,也最没用——读者拿到的是一份清单,还得自己把清单和正文里的数字配对,而这份配对关系文章里并没有写。
顺带说一句,这跟权威度是两个指标
域名权威度回答的是“这个出处靠不靠谱”,距离回答的是“读者够不够得着”。一篇全是高权重外链但都堆在文末的文章,前一个指标满分,后一个指标为零。做E-E-A-T信号强化的时候通常只盯前者,后者从来没进过检查表。被引源榜单回答的也是前一个问题。
还有一层区别更容易被忽略:距离这件事对人和对机器的影响不是一回事。人可以往上翻,机器不会。一段被单独取走的文字,它带不带走那条链接,取决于取的时候切在哪一刀,而这一刀在哪儿不由作者决定。语义化标记做得再好,也只能让切口落在更合理的位置,改不了签名写在别处这个事实。
这套判据怎么在自己站上跑一遍?
第一步:圈出数字断言
不需要写复杂程序。把一篇文章的正文复制出来,用五条正则各扫一遍:百分号、倍数、比例、带千分位的数、货币符号。命中的句子逐条列成清单,一篇长文通常在10到40条之间。这一步和按页面模板抽样做审计的思路一样,先把要检查的对象固定下来,再谈检查什么。
第二步:量距离
对每一条,往上往下数,最近的一条站外链接隔几段。这个数字比“有没有参考资料”有用得多,因为它直接对应读者的动作成本。经验上超过3段就基本等于没有,这次的分布也支持这个阈值:3段以内累计55.6%,往后就断崖式掉进长尾。
第三步:只补最贵的那几条
不要全补。一篇文章里真正撑起论点的数字通常只有三五条,其余的是背景。把距离最远的那几条挑出来,看它们是不是恰好也是最关键的。如果是,先补它们。让AI替你跑审计可以做前两步,第三步的取舍它做不了,因为哪一条是核心论点只有作者知道。
该补的只有三类,其余的补了也是噪声
先说不该补的:自家产品的价格、自己后台跑出来的数、行业里人尽皆知的常识量级。这些补链接只会增加噪声。真正值得补的是下面三类。
| 优先级 | 哪一类数字 | 补法 |
|---|---|---|
| 第一档 | 标题或首段里出现的数字 | 句内挂链,同时在句子里写出机构名 |
| 第二档 | 被用来支撑核心结论的数字 | 至少落在同一段内 |
| 第三档 | 表格与图表里的数字 | 紧贴表格下方单起一行,不要放到文末 |
还有五条边界要提前说清楚。第一,这次测的是英文内容站,中文站的排版惯例不同,比例不能直接搬。第二,判据只认站外链接,指向自家研究页的链接被算成了内链,对少数以自研数据为主的站不太公平。第三,只看了HTML正文,图片里的出处标注扫不出来。第四,样本偏向近三个月的文章,更老的存量内容不在其中。第五,这里只回答“有没有路”,不回答“路的那一头对不对”,后者要一条条点开去核,属于另一件事——同一个指标传出七个数字那次就是这么做的。
去年帮一个做工业配件的外贸站看内容时遇到过一次真实的代价。他们的行业科普长文里引了一组市场规模数字,写在正文第二段,出处链接挂在文章最后的延伸阅读区。海外客户在询盘里质疑那个数字,销售翻遍正文找不到来源,回头问内容同事,同事也记不清当初引的是哪一份报告。三段文字的距离,在内部沟通里变成了两天。后来的做法很土:所有出现在前三段的数字,一律把机构名写进句子,链接跟在机构名后面。改完之后销售不再来问了。
顺带一提,判断该不该给出处这件事,规范层面其实早有分工。MDN对cite元素的说明把“标注作品名”和“标注引述来源”分成了两件事,前者用cite标签,后者要靠blockquote的cite属性或者一条实打实的链接;schema.org的citation属性则给了机器可读的那一层。而谷歌的内容自评清单只写到“清晰的出处”为止,没有规定它离数字该有多近——这一段空白,正是这轮测量想填的地方。
常见问题解答
文末统一放一个参考资料区,算不算给了出处?
算,但只在页面这一级算。对读者来说,他仍然要自己把正文里的第七个数字和参考区的第三条链接配对,而这份配对关系文章里并没有写。如果只能选一种,把链接放进句子的收益远大于放进文末清单。
句子里挂太多链接会不会影响可读性?
会,所以不需要每个数字都挂。这次的数据显示句内挂链率只有9.6%,离“太多”还差得很远。实操上抓两头:标题与首段里的数字必挂,正文里支撑核心结论的数字挂在同段内,其余的可以不挂。
把机构名写进句子但不给链接,是不是省事又安全?
省事,但不安全。样本里有39条这样的句子,读者要核对得先复制机构名再去搜,而同一家机构一年可能发好几份报告,搜到的未必是被引的那一份。写了名字反而会让人误以为容易查。
统计汇总页那种Sources行的写法值得学吗?
值得,但要改一处。它的问题不在于形式,而在于覆盖范围没有明确边界,读者看不出这一行到底管上面几段。改法是把它紧贴在它真正覆盖的那一块下方,并且不要跨小标题。
这套办法对中文站适用吗?
判据要改。中文的数字表达形态不一样,“三成”“翻了一番”“上千万”这类说法正则扫不出来,得单独加词表。距离这个概念是通用的,覆盖率的绝对值不通用。
为什么不直接看文章有没有引用权威域名?
因为那测的是另一件事。域名权威度回答出处靠不靠谱,距离回答读者够不够得着。一篇全是高权重外链但都堆在文末的文章,前一个指标满分,后一个指标为零。
数字很多的文章,是不是天然更难达标?
是。样本里断言最多的一页有82条,全靠句内挂链既不现实也不好读。这类页面正确的做法是分区块签名,每一小节写完就把这一节用到的几个来源列出来,而不是把上百条链接塞进正文。
这次为什么要报三档口径,直接报一个数不行吗?
不行。同一批数据在窄口径下是9.6%,宽口径下是38.4%,差四倍;更要命的是统计汇总页那一类,窄口径垫底、宽口径榜首。只报一个数,读者无法判断你量的是“作者写得勤不勤”还是“页面上到底有没有”。
权威参考资料
本文标题:《数据出处离数字有多远?1486条实测,同一句里给了链接的只有9.6%》
本文链接:https://zhangwenbao.com/numeric-claim-source-distance-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0