AI引用只取四个词:6758句实测,句子里带得上品牌名的只有8.9%
本文目录
- 模型核对你的时候,一次拎走的是几个词?
- 这把尺子是怎么定的,你自己能不能跑一遍?
- 两条否定判据:句子还读不读得懂
- 两条正面判据:搬走之后还认不认得出
- 语料是怎么来的
- 为什么自足率这个指标区分不出高下?
- 句子里没有落点,会丢掉什么?
- 句子里带不带自己的名字,差别到底有多大?
- 哪一类页面做得最差?
- 57个站排下来,差距落在哪一头?
- 三次尺子失效,是怎么被发现的?
- 第一次:一条判据在量另一件事
- 第二次:非英文页面在英文词表下一律及格
- 第三次:品牌名里的那两个点
- 这跟内容分块、段落级排名是同一件事吗?
- 还有一层是语言
- 官方口径怎么说
- 一句话要改成什么样,才经得起被单拎出来?
- 先定哪些句子值得改
- 三条改法
- 怎么自查
- 三件不必做的事
- 常见问题解答
- 自足率75.7%和76.0%差这么点,是不是判据太粗了?
- 为什么拿谷歌官方文档当对照组,而不是别的品牌站?
- 中文内容能不能套这套判据?
- 把品牌名写进正文,会不会被判成关键词堆砌?
- 句子写得可搬运,是不是就一定会被引用?
- 那些既自足又有落点却没品牌名的句子,要不要一句句补?
- 这份实测的边界在哪儿?
- 权威参考资料
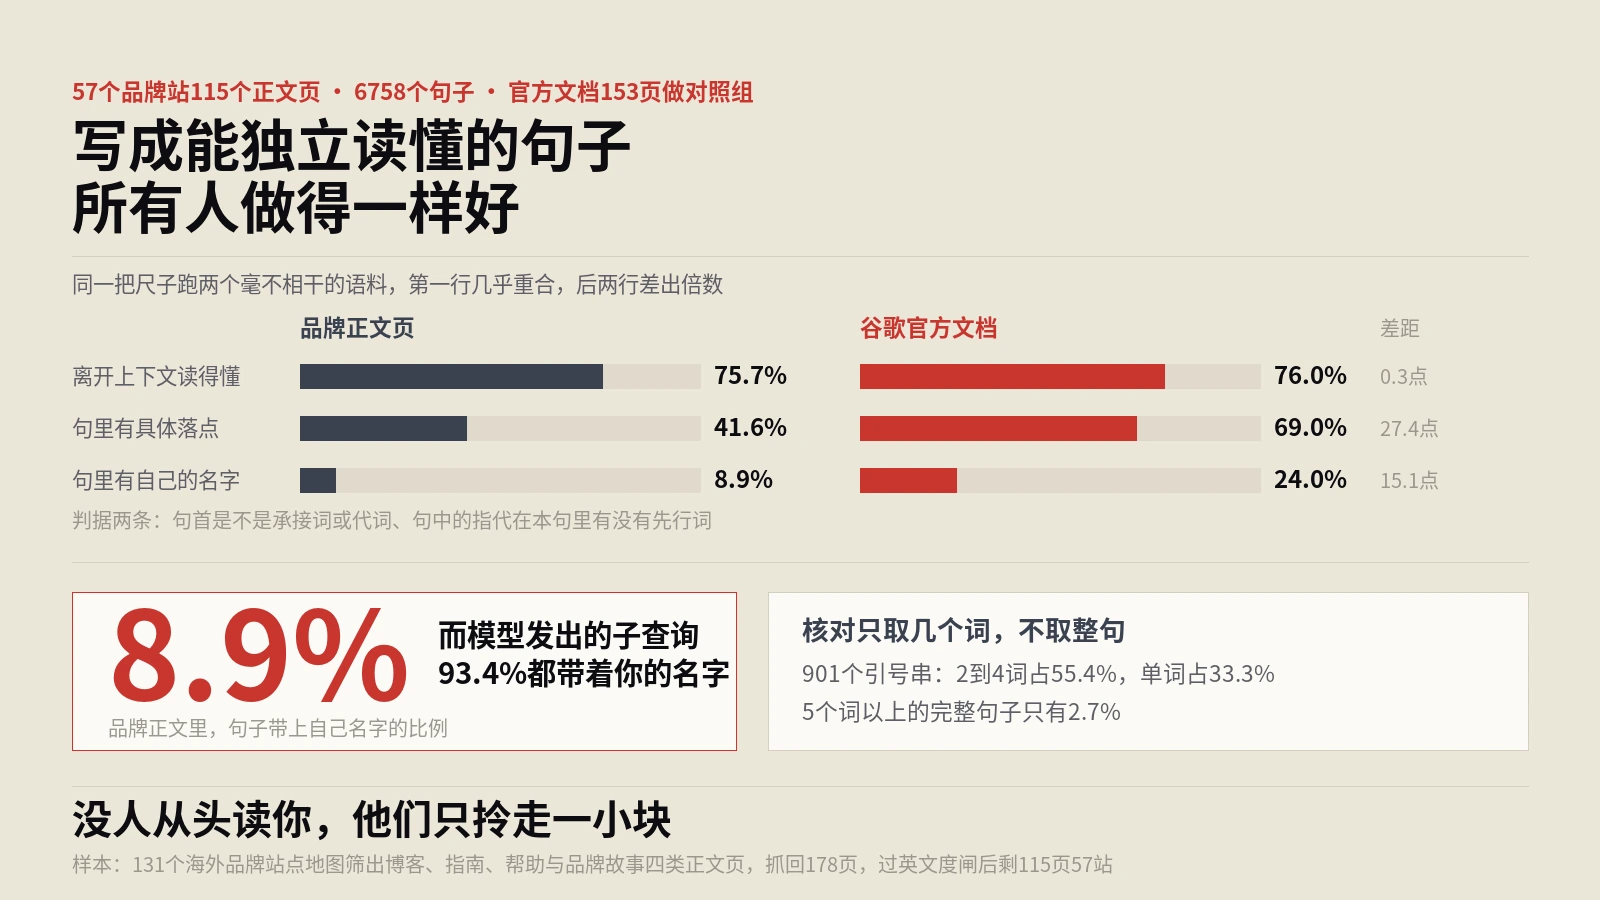
摘要:从131个海外品牌的站点地图里挑出博客、指南、帮助和品牌故事这四类正文页,抓回178个页面,过掉非英文页和跨页样板句之后,剩6758个句子,来自57个站。同一批判据也跑了一遍谷歌搜索官方文档的153个页面、8592个句子当对照组。结果是:能离开上下文单独读懂的句子,品牌页75.7%,官方文档76.0%,两边几乎一样;句子里有具体落点的,品牌页41.6%,官方文档69.0%;句子里出现自己名字的,品牌页8.9%,官方文档24.0%。三项里只有第一项大家做得一样好,而那一项恰恰是被讲得最多的一项。
八月底有一份实验记录被公开:有人拿189条带品牌名的提示词,在三个不同行业的项目上反复跑,记下模型自己发出去的每一条检索。1797条子查询,没有一条是人打进去的。这份记录里我盯住的不是扇出数量,是里面那901个加了引号的串——模型拿它们去核对某句话到底是不是原文这么写的。而那901个串里,2到4个词的占55.4%,只有一个词的占33.3%,5个词以上的只有2.7%。
换句话说,核对这一步取走的东西比一句话小得多。那么问题就变成了:从你的正文里随便切下这么一小块,它离开原处之后还剩什么。这件事能自己量,下面这一趟实测就是照着这个问题设计的。
模型核对你的时候,一次拎走的是几个词?
先把这件事的尺度定下来。那份扇出记录里,一条品牌提示词平均会长出10.3条子查询,单条子查询平均7个词;3个词以内的只占7.8%,10个词以上的占15.8%。这不是大家想象中的口语长尾,更像有人在后台把主提示词拆成了一组检索式。
更值得注意的是子查询里带什么。93.4%的子查询里出现了品牌名本身;30.2%用了限定域名的语法,其中55.1%指向品牌自己的主域名。也就是说模型把你的站当成一个可以直接查的事实来源,而且每次查的时候都会把你的名字一起打进去。查询扇出的机制这几年被讲了不少,但多数讲的是扇出多少条,很少有人去看扇出的那些条里到底写了什么。
这些子查询去了哪儿也值得看一眼。69.8%走的是没有任何限定的普通检索,16.6%直接限定在品牌自己的主域名上,7.9%去了同集团的其他域名,5.6%去了第三方,指向竞品的只有2条,占0.1%。另一个角度看更清楚:64.4%的品牌提示词至少会触发一次对自有域名的定向检索。这份扇出记录把它说得很直白——模型是把你的域名当成第一手事实来源在查的。
还有一条方法学上的提醒值得抄下来。同一条提示词只跑一次,平均拿到的子查询不到3条;跑到4次,不重复的子查询涨到10.3条。单次运行只让你看见模型可能问的四分之一,而且你不知道自己看见的是哪四分之一。凡是做AI可见度监测的,这条决定了采样次数不能少,跟做引用因果测试那套要求是同一个道理。
然后是引号。23.8%的子查询带引号,拆开看那901个引号串:
| 引号串的类型 | 条数 | 占比 |
|---|---|---|
| 2到4个词,多是品牌、职位、栏目名 | 499 | 55.4% |
| 单个词 | 300 | 33.3% |
| 编号或代码,税号、案卷号、文件名 | 78 | 8.7% |
| 5个词以上的长句子 | 24 | 2.7% |
88.7%的核对动作发生在4个词以内。这条数据把一个流行说法顶到了墙上:把每句话写成能整句引用的样子。真实情况是没人整句引用你,对方只拎走几个词,然后去问这几个词是不是真的出自你这儿。
这把尺子是怎么定的,你自己能不能跑一遍?
要量一个句子离开上下文之后还剩什么,得先把判据写死,不然就成了看着办。我用的是两条否定判据加两条正面判据,全部是封闭词表加形态规则,没有模型参与,同一份语料跑几遍结果一模一样。
两条否定判据:句子还读不读得懂
第一条叫句首承接。句子的第一个词是代词或者承接连词,比如以It、They、These、However、Instead、For example这类词开头。这类句子单独拎出来,读者第一个反应是往上找,而上面那段没跟着过来。
第二条叫悬空指代。句子中间出现了it、they、this、those这类词,而在它们前面,这一句里没有任何可以当先行词的成分——没有非句首的大写专名,没有限定词带出来的名词,也没有数字。判据写得偏严,宁可漏判也不错判。
两条命中任意一条,就算这句话离开原处站不住。两条都不命中,算自足。
两条正面判据:搬走之后还认不认得出
第三条叫具名落点:这句话里有没有非句首的大写专名、数字,或者带单位的量值。一句读得通但通篇没有一个具体东西的话,搬走之后是一句正确的废话。
第四条叫品牌落款:这句话里有没有出现这个站自己的品牌名。用域名主体做匹配,忽略大小写和连字符。
语料是怎么来的
样本源是131个海外品牌的站点地图,从里面按路径特征筛出博客、指南、帮助中心、品牌故事这四类正文页,每站最多取4条,一共186条网址。抓的时候用了5个并发加每请求1到2.4秒的随机间隔——之前打131个站那一轮吃过高并发的亏,被限速挡回来的站会被脚本当成没有这个页面记下来。这一趟178条拿到200,没有一条撞上限速。
对照组用的是谷歌搜索官方文档站的全量页面,剥完标签之后153个页面能进分析。选它当对照有个现成的好处:那是一批英语母语者写的、以被人反复摘引为目的的技术说明,如果自足率这个指标真能区分内容质量,它应该明显更高。
为什么自足率这个指标区分不出高下?
结果先放在这里。两个语料的内容类型、写作目的、作者背景完全不搭界,可前三行几乎重合:
| 指标 | 品牌正文页 | 谷歌官方文档 | 差距 |
|---|---|---|---|
| 句子总数 | 6758 | 8592 | — |
| 句首承接 | 15.2% | 14.5% | 0.7个百分点 |
| 悬空指代 | 19.1% | 16.8% | 2.3个百分点 |
| 自足率 | 75.7% | 76.0% | 0.3个百分点 |
| 句内有具名落点 | 41.6% | 69.0% | 27.4个百分点 |
| 句内有品牌名 | 8.9% | 24.0% | 15.1个百分点 |
自足率差0.3个百分点。这不是说两边写得一样好,而是说这个指标本身不挑人。英语散文里四分之三的句子天然能独立读懂,剩下四分之一天然要靠上文,这是这门语言的段落结构决定的,跟你努不努力关系不大。
一个指标如果在任何语料上都给出同一个数,它就没有诊断价值。这也是我做完第一轮之后必须停下来的原因:如果两边真的差出十几个点,才轮得到讨论谁做得好。它们没差。
再往下两行就完全是另一回事了。具名落点差27.4个百分点,品牌落款差15.1个百分点,都是倍数级的。真正把内容分出层次的是这两项,而这两项平时几乎没人当指标看。
句子里没有落点,会丢掉什么?
先看两个例子,都判为自足,都读得通:
一句来自某家户外品牌的博客:山地车可以加装车架包、驮包,甚至发电花鼓灯组,用来跑真正的野外路线。另一句来自某家家具站:我们能把省下来的这部分直接让给你。
前一句带了三个具体的部件名,切出来仍然是一条可查证的说法。后一句读得通,可它既没说省的是什么,也没说让给谁,从任何一份内容里切出来都成立——也就等于它不属于任何一份内容。
品牌页有2704个句子落在这一类里——判为自足、却一个具名落点都没有,占全部句子的40.0%。这些句子不是病句,很多还是全文写得最顺的部分。问题在于,核对动作要的是可以被落实的东西:一个型号、一个年份、一个数值、一个专名。没有这些,它连被核对的资格都没有。
官方文档那一边到69.0%,原因不神秘:技术文档几乎每句话都要提到某个具体的属性名、状态码或者类型名。这不是文风好,是题材逼的。但它说明这件事有天花板,而品牌内容离那个天花板还有27个百分点的距离,其中很大一部分是可以补的。
顺带说一句,句长和节奏这类可读性指标跟落点密度是两回事。一段读着顺的文字完全可以一个落点都没有,反过来也成立。
句子里带不带自己的名字,差别到底有多大?
这是整批数据里最刺眼的一组。模型发出去的子查询里93.4%带着品牌名,而品牌自己正文里的句子,带自己名字的只有8.9%。一边是每次都问你是谁,一边是十一句里才答一次。
更细的分布:57个站里,句子数达到40条的有42个站;这42个站当中,自足句里一次品牌名都没出现的有14个,占三分之一。另外,以We、Our、Us开头的句子占全部句子的5.5%——这类句子的主语在原处指得很清楚,切下来之后就是个谁也不认识的我们。
对照组那边24.0%。官方文档反复写谷歌怎样怎样,读起来甚至有点啰嗦,可它的每一句都自带落款。这件事和品牌词与非品牌词那条分界线是同一个机制的两头:模型认的是实体,而实体要靠名字在文本里反复出现才立得住。
做得对的句子长什么样?实测语料里有548句既自足又带品牌名。举三条:某灯具品牌写“遇到这种情况,用一盏Govee吊灯是更省事也更好看的做法”;某箱包品牌写“Bellroy承诺支持把全球升温控制在1.5摄氏度以内的目标”;某地毯品牌写“每一笔Ruggable订单都包含运输破损与丢件保障”。三句都没有堆词,名字是当主语或定语自然长出来的。
名字不写清楚的代价,在同一份扇出记录里有两处很实在的痕迹。其一,某个项目里模型一直在用一个早已301跳走的老域名做定向检索,它对域名这件事不做任何质疑,先前记住什么就照用什么。其二,社交账号占了5.5%的子查询,而在一个项目里模型先后试了3个Instagram、2个LinkedIn、2个Facebook和1个YouTube,来回猜哪个才是这家的官方号。
会出现试错,说明它手上没有确定答案。这和模型说错品牌事实之后怎么纠正是同一条链路的前后段:前端没把名字和账号说死,后端就得靠猜,猜错了再去纠正,成本差着好几个量级。
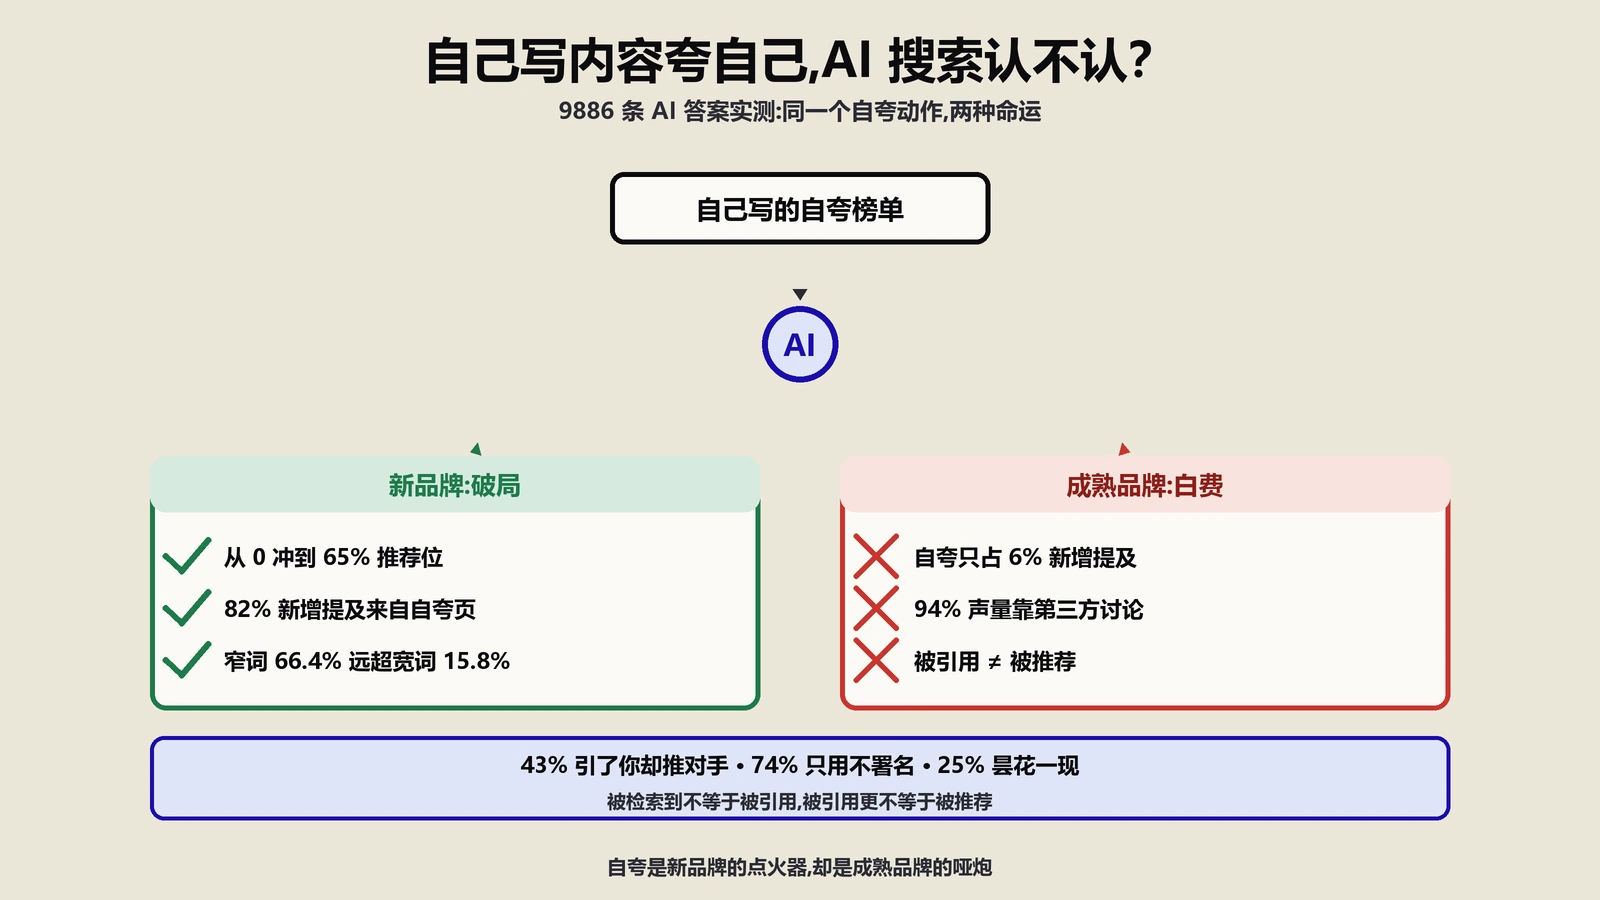
要注意的是别走到另一头。自夸型内容在AI搜索里反而吃亏这件事有过实测,9886条答案的结论是硬吹会被扣分。名字要出现,出现的方式得是陈述事实,不是喊口号。
哪一类页面做得最差?
把6758个句子按页面类型拆开,分档很明显:
| 页面类型 | 句数 | 自足率 | 有具名落点 | 自足且带品牌名 |
|---|---|---|---|---|
| 帮助中心 | 1381 | 83.7% | 43.2% | 10.9% |
| 指南类 | 467 | 77.7% | 31.5% | 4.3% |
| 品牌故事与关于页 | 522 | 76.8% | 44.6% | 9.8% |
| 博客 | 4328 | 72.6% | 41.8% | 7.5% |
帮助中心自足率最高,比博客高11.1个百分点。原因不难猜:帮助中心是一问一答的形态,每条答案本来就写给单独看的人。这和段落级排名那套结构工程的方向是一致的,只是帮助中心是被业务需求逼出来的,不是被SEO逼出来的。
顺带说一句,谷歌自己在精选摘要那一页写得很清楚:摘要里的内容是系统自动从页面上抽的,站长没有直接的开关去指定抽哪一句。也就是说抽到哪一句不由你定,你能定的只是每一句被抽走之后长什么样。这件事在摘要位被AI概览吃掉一半之后反而更要紧了。
帮助中心的品牌落款10.9%,是四类里最高的,原因也是业务逼的:型号一多,答案里不写全名就说不清在讲哪一件。指南类反过来,落款只有4.3%,是四类里最低。
指南类的具名落点只有31.5%,也是最低。指南这种体裁天生爱写通用做法,写着写着就变成了谁都能发的那种文章。这类内容拿去做顶部漏斗本来没错,错在它常常连一个自己的具体东西都没提。
57个站排下来,差距落在哪一头?
站级分布比总数更能说明问题。42个站里,自足率最低的56.6%,中位74.7%,最高100%,极差43.4个百分点。具名落点率的跨站分布更散,最低9.2%,最高73.3%。
自足率最低的那几个站有个共同点:博客写得非常口语,大量以So、But、Plus、That's why开头的短句,读起来轻快,切下来全是半截话。某户外零售站的瑜伽入门文开头就是“所以你决定练瑜伽了,太棒了”,下一句“现在就是最好的时候”——这两句都判不自足,但它们确实是好文案。
这就要说清一件事:自足率低不等于写得差。它衡量的是可搬运性,不是可读性,两者有时候还打架。真正该警惕的是第三列——自足、有落点、还带着名字,三样都占的句子在品牌页只有7.3%,官方文档是18.5%。
换个说法:品牌页每14句里有1句是完整可搬运的,官方文档每5句里就有1句。差的不是写作水平,是有没有把落款这件事当成写作的一部分。
三次尺子失效,是怎么被发现的?
这一轮量了五遍才定稿,中间三次差点把结论写反,都值得记下来。前两次改的是判据本身,第三次改的是匹配函数。
第一次:一条判据在量另一件事
最早那版把“句子里没有大写专名也没有数字”直接算进不自足。跑出来63.3%的句子不合格,看着很有冲击力。抽样一看就露馅了:像“羊毛能自然调温,还能把汗从皮肤上带走”这种句子,既没有专名也没有数字,可它完完整整能独立成立。
问题在于这条判据量的是有没有落点,不是读不读得懂。把它从自足率里拆出来单列之后,自足率回到77.6%,而拆出来那一项反倒成了整批数据里差距最大的一列。一个指标如果把两件不同的事加在一起,得到的数看着更吓人,但它谁也不代表。
第二次:非英文页面在英文词表下一律及格
拆完之后站级排名里出现了几个100%,其中一个站92个句子一条都不判不自足。翻原文才看见,那个站抓到的是西班牙语页面。我的判据全是英文封闭词表,遇到Los relojes dorados这种句子,一条都不触发,于是整站满分。
补了一道英文度闸——取13个高频英文虚词,词频占比低于16%的页面剔除——126个页面里剔掉11个,涉及9个站,剩115个页面。总体自足率从77.6%降到75.7%,看着变化不大,但站级排行榜的头部换了一半人。这类问题在按标点切句子那件事上出现过同型,语言没判对,后面每一步都白做。
第三次:品牌名里的那两个点
品牌落款那一列第一版算出来7.7%,其中有个站占了语料近八百句,却一次都没命中。翻出来一看,那个站的名字里有个带分音符的字母,而我的匹配函数把所有非英文字母直接删掉,于是名字被削成了另一个词,怎么也对不上。
补一道音标折叠——先做兼容分解、去掉组合符号,再把几个北欧字母单独映射一遍——整体品牌落款率从7.7%升到8.9%。看着只差1.2个百分点,可那个站的落款率是从0跳到两成多。凡是在跨国站上做文本匹配,这一步不做,得到的就是一份系统性偏向英语品牌名的数据。
另外对照组也踩了一脚:官方文档每页页脚都有许可证和商标那几句话,一字不差重复了几十遍。不剔掉的话,品牌名率会被这些句子凭空抬高。按“同一句出现在20个以上页面”判为样板句,剔掉1015句,33种。
这跟内容分块、段落级排名是同一件事吗?
不是同一件事,但确实在同一条线上,得说清楚边界,免得把三套做法混着用。
内容分块讲的是检索单位:向量库按块存、按块召回,所以块的边界和大小要管。段落级排名讲的是搜索引擎能从整页里单独抽一段出来排序。这两件事的单位都是段,量级在几十到几百个词。
分块预览工具那篇写过自包含评分在哪些地方误伤,包括“开头就是指代”那一项收得太宽。那篇讲的是工具的判据怎么调;这一篇是把同样两条判据拿出去,在57个真实品牌站和一个对照语料上各跑一遍,看它到底能不能分出高下。答案是分不出——这个结论只有做了跨语料对照才拿得到,单看一份内容永远看不出来。
本篇的单位比段小一档:一句话,甚至一句话里被引号框住的那两三个词。这个尺度上有用的只有三样东西——读不读得懂、有没有可落实的东西、有没有落款。三样都和段落结构无关,全在句子内部。
顺带划清另一条线。被检索和被引用是两套打法,本篇量的全部落在被引用那一侧的下游:先得被检索到,才轮得到被核对。前一段路走不通的时候,比如前端渲染让爬虫拿不到正文,句子写得再好也没用。
还有一层是语言
那份扇出记录里有个容易被跳过的数:8.9%的子查询用了英文词汇,而在有国际业务的项目上这个比例升到27.3%,纯本地项目只有1.0%,另有9.9%的运行出现了混用语言。做多语言站的要留意,用户用本地语言提问,模型未必用本地语言去查你。
这一点和落款是一件事的两面:同一个品牌在不同语言版本里如果叫法不一致,落款就等于没写。小语种那边这个问题更突出,工具给不出数据的时候,一致性只能靠自己定规矩。
官方口径怎么说
有必要把边界说清楚,免得读成又一条排名秘诀。谷歌在搜索工作原理那一页写的是相关性由数百个因素共同决定,举的三个例子还全在用户那一侧——位置、语言、设备。在创作有帮助内容那一页,官方唯一一次明确说某样东西不是排名因素,说的是经验、专业度、权威性与可信度这一组。
句子可搬运不是排名因素,官方文档里也找不到这个说法。它影响的是另一件事:当某个系统决定摘你一段的时候,摘走的那一段还剩多少信息。这两件事分属两条链路,不该混着讲。
一句话要改成什么样,才经得起被单拎出来?
照着三条判据倒推,能给出一套很短的改法。不必全篇都改,全篇都改反而会写成机器腔。
先定哪些句子值得改
每篇里挑出3到5句真正承载结论的:数据、承诺、定义、独有做法。这些句子被摘引的概率最高,也最该带落款。其余的句子保持原样,该用承接词就用,行文要顺。
三条改法
第一,把承接词换成主语。“所以它能省下30%的电”改成“这套方案能省下30%的电”,或者直接把产品名放进主语。改一个词的事,自足判据当场翻过来。
第二,给结论句配一个可落实的东西。型号、年份、数值、标准名、材料名都算。没有具体物的时候,把范围写出来也算:适用于什么场景、不适用于什么场景。
第三,在关键句里写出品牌名。不是每句都写,是在承载结论那几句里写。判断标准很简单:把这句话单独发给一个没读过全文的人,他知不知道这是谁说的。
怎么自查
最土的办法最管用:把正文复制出来,按句号断开,随机挑20句,一句一句读,每句只问三个问题——读得懂吗、有具体东西吗、知道是谁说的吗。三个问题都答是的句子占几成,就是你这篇的上限。品牌页的平均水平是7.3%,超过15%就已经不错了。
保哥自己试过把这套自查接到发稿前的检查表里,成本是每篇多花五分钟,代价最小的一项改动是第三条:结论句里补一次品牌名,几乎不影响可读性。至于要不要做成自动化,竞品对标那套多维度工具已经把类似的检查项做进去了,自己写脚本也就几十行。
三件不必做的事
不必追求全篇自足率90%以上,那会把文章写成说明书;不必给每句话都塞品牌名,身份这件事靠的是全站一致,不是单页密度;也不必因为这套判据去改已经跑得好的老文,先把新稿的习惯换过来更划算。
常见问题解答
自足率75.7%和76.0%差这么点,是不是判据太粗了?
判据确实偏保守,宁可漏判不错判。但这恰恰是结论成立的前提:如果判据很敏感,两个语料却仍然给出同一个数,那只能说明这个维度上大家真的一样。反过来看同一把尺子量出来的另外两列,具名落点差27.4个百分点、品牌落款差15.1个百分点,说明尺子是能分辨东西的,只是自足这一项本身没有区分度。
为什么拿谷歌官方文档当对照组,而不是别的品牌站?
因为需要一个在写作目的上尽可能远的语料。官方文档是以被反复摘引为目的写的英语技术说明,如果自足率能反映内容质量,它该明显更高。它没有更高,这个反证比找一批同类站更有力。缺点是题材差异大,所以具名落点那一列的差距不能全算到写作习惯头上,技术题材本身就更容易出现专名。
中文内容能不能套这套判据?
思路能套,词表要重写。中文的句首承接词是另一套,而且中文大量省略主语,悬空指代的判法要跟着改。具名落点这一条基本可以直接用,品牌落款那一条完全通用。要注意中文断句的问题,逗号连着写下去的长句在切分上比英文难处理得多。
把品牌名写进正文,会不会被判成关键词堆砌?
看写法。实测里做得好的那321句,品牌名都是当主语或定语自然出现的,一句里出现一次。堆砌的判定看的是密度和是否服务于内容,一篇里在三五处结论句带上名字离那条线还远。真正的风险在另一头,就是把陈述写成自夸,那件事有实测数据表明会反噬。
句子写得可搬运,是不是就一定会被引用?
不是。被引用至少要过三关:爬得到、检索得中、核对得上。本篇量的只有最后一关,而且只量了句子这一层。爬取和渲染那一关出问题的话,前面做得再好也传不出去;主题和实体对不上的话,根本进不了候选。三关要分开看,别把最后一关的改进当成全部。
那些既自足又有落点却没品牌名的句子,要不要一句句补?
不要。全篇补会让文字发僵。可行的做法是按位置补:开头的结论句、每个小标题下的第一句、数据句、以及结尾的总结句,这几个位置被摘引的概率明显高于正文中段。其余位置不动。
这份实测的边界在哪儿?
三条。第一,样本是英文内容,57个站115个页面,每站最多4页,站内一致性没有验过;第二,正文抽取只取了段落标签里的文字,列表和表格里的句子没进统计;第三,全部判据是规则式的,遇到倒装、省略、口语化表达会有误判,抽样看误判率在可接受范围内,但它不是零。
权威参考资料
本文标题:《AI引用只取四个词:6758句实测,句子里带得上品牌名的只有8.9%》
本文链接:https://zhangwenbao.com/sentence-portability-brand-anchor-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0
← 上一篇
谷歌SEO官方文档实测160页:522句必须里,只有1句提到排名下一篇 →
没有了