Meta爬虫robots.txt实测:新条款生效前,4410个大站怎么挡Meta
本文目录
- Meta新版商业条款到底多了什么?
- Meta现在有五个爬虫,各自管什么?
- 4410个大站的robots.txt是怎么对待Meta的?
- 训练爬虫挡得最多,广告爬虫几乎没人认识
- 链接预览爬虫被挡的206个站,几乎都是误伤
- “挡训练、留AI搜索”的站,有几个是想清楚了的?
- 点名挡Meta-ExternalFetcher,可能没用
- Meta自己的robots.txt是怎么写的?
- 过去一个月,有多少站改了Meta的规则?
- 外贸独立站的robots.txt该怎么写?
- 怎么查你的网站现在对Meta是什么态度?
- 要不要干脆把训练也放开?
- 常见问题解答
- Meta新商业条款什么时候生效?管到哪些人?
- Meta的AI训练爬虫在robots.txt里叫什么?
- 挡了Meta-ExternalAgent,会影响Facebook上的链接预览吗?
- robots.txt能挡住所有Meta爬虫吗?
- robots.txt改了多久对Meta生效?
- Meta-ExternalAds要不要挡?
- Meta-WebIndexer要不要放行?
- 权威参考资料
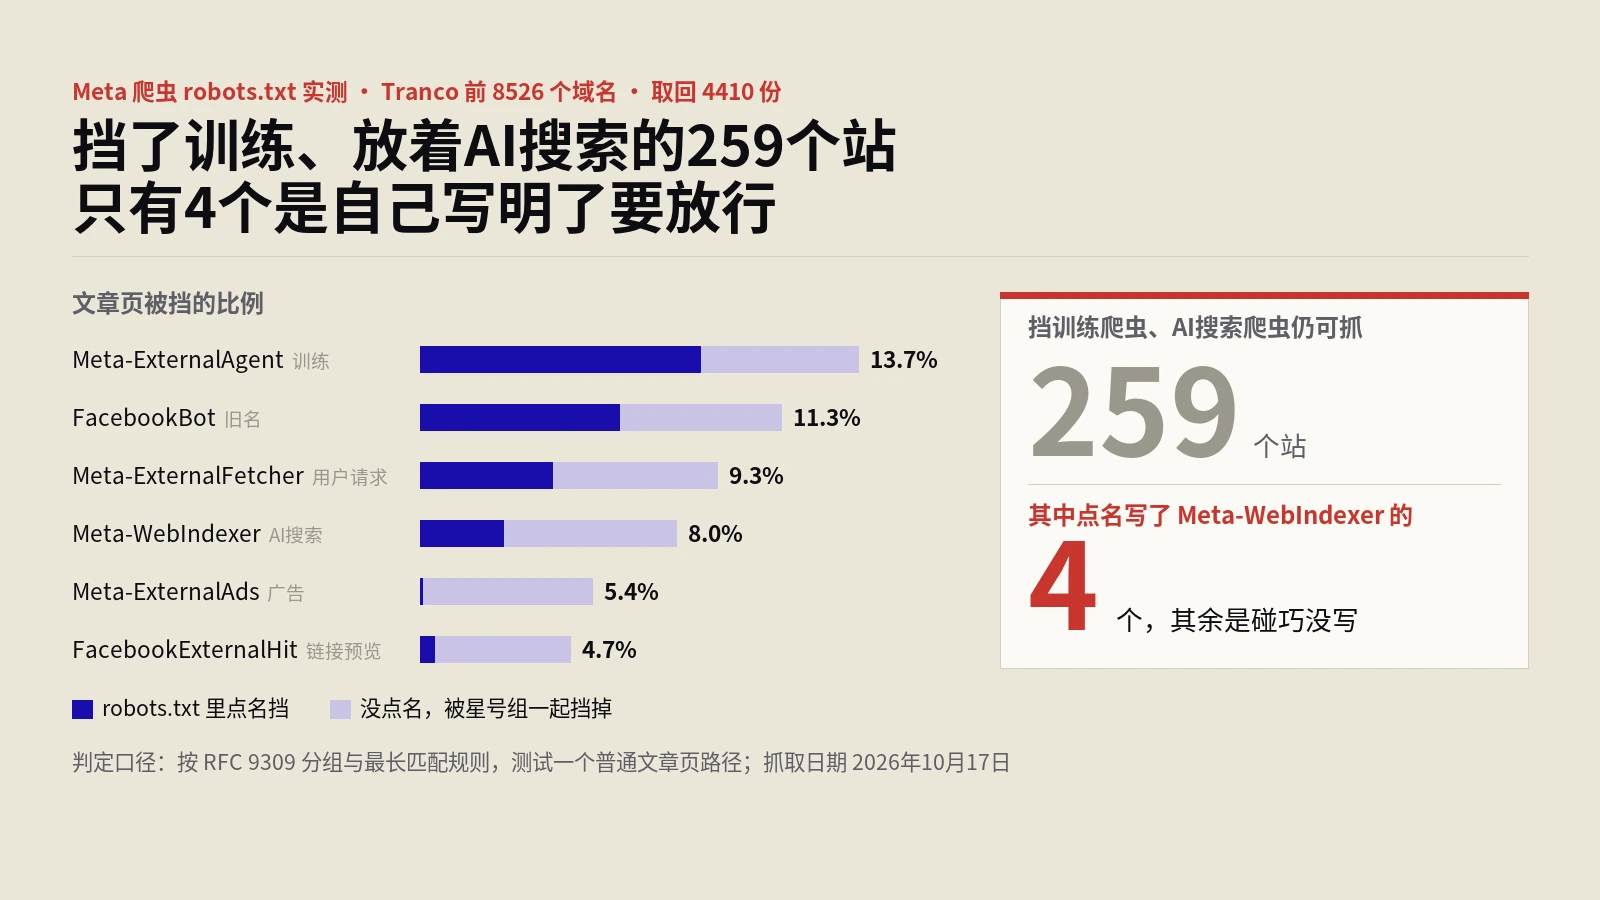
摘要:Meta新版商业条款10月30日生效,开过Facebook公共主页、投过广告的商家,都等于同意Meta抓取自己的网站并拿去训练。条款全文没提robots.txt。我们取回了Tranco排名前8526个域名里4410份可读的robots.txt:挡住Meta训练爬虫Meta-ExternalAgent的有604个,占13.7%,其中259个同时放行Meta AI搜索爬虫,但真正点名放行Meta-WebIndexer的只有4个。和广告业务对口的Meta-ExternalAds,只有15个站写过它的名字。
做外贸的朋友大多有个Facebook公共主页,有的还在投广告。10月中旬,这件事和你的网站突然扯上了关系。
Meta更新了商业条款,10月30日生效。新版里多了一段话:只要你出于业务目的用Meta的产品,Meta就可以派爬虫去抓和你的商品、服务相关联的网站,抓来的内容可以用于“提供、开发、改进、研究和训练”Meta的产品。Nieman Lab在10月15日最早报道了这件事,几位法律人士认为这段话可能被用来主张抓取新闻网站。Meta发言人回应说,这次更新是想准确拿到第三方网站上的商品信息,和抓新闻网站无关。他还说,站长仍然可以用robots.txt管理访问。
条款归条款,网站这头能直接动手的只有robots.txt。所以我们去看了看:大站的robots.txt里,Meta的几个爬虫现在是怎么被对待的。
Meta新版商业条款到底多了什么?
我们在已登录的Facebook账号里,把现行版和10月30日生效的商业条款预览版都读了一遍。
现行版的生效日期是2024年3月6日,全文没有抓取条款。它开头就写明了适用范围:出于业务目的投放广告、销售商品、开发应用、管理公共主页、管理小组、使用成效衡量服务,都算“业务或商业目的”。
预览版新增的那段,中文版原话是这样的:
您授权我们(或任何代表我们行事的实体)使用自动化软件(如网页抓取工具、智能助手、机器人、蜘蛛程序、网络爬虫和用户代理)以及创建测试凭证,以访问、索引、缓存、分析、收集、检索或爬取与您的商品或服务相关联的网域、网页或网址……
后面还有半句:Meta可以用这些内容来提供、开发、改进、研究和训练Meta旗下的产品。我们在预览版全文里搜了“robots”,一处都没有。
这里有三个点,商家读的时候容易漏:
- 门槛很低。不用买广告,开一个公共主页、建一个小组就算业务用途。
- 范围很宽。除了你自己提交的网址,还包括“与您的商品或服务相关联”的网域,以及用户在Meta产品里分享出来的网址。
- 多了“测试凭证”。法律学者在Nieman Lab的报道里提到,这在技术上可以用来注册账号,进入需要登录的页面。Meta没有回答它会不会用来绕过付费墙。
同意方式也很省事:10月30日之后继续出于业务目的使用Meta产品,就算同意。不同意的唯一办法,是停止业务使用。
广告主早就给过类似授权。据Search Engine Journal对新条款的梳理,2025年8月22日版的自助广告条款里,下单投广告就等于授权Meta抓取广告主的网域,用途里就有“研究和训练”。新版的变化,是把这层授权从“投广告的人”扩到了“所有业务用户”。
Meta现在有五个爬虫,各自管什么?
Meta官方的网络爬虫文档最后更新于2026年5月21日,列了五个爬虫。Search Engine Journal的报道只提到其中四个,这里按官方文档原文整理一下:
| 爬虫名称(robots.txt里写的名字) | 官方说的用途 | 会不会绕过robots.txt |
|---|---|---|
| FacebookExternalHit | 链接被分享到Facebook、Instagram、Messenger时,抓标题、描述、缩略图做预览 | 做安全或诚信检查时可能绕过 |
| Meta-ExternalAgent | 训练基础AI模型,或者直接把内容编入索引来改进产品 | 文档没说会绕过 |
| Meta-WebIndexer | 改进Meta AI的搜索结果,放行它有助于在Meta AI回复里引用、链接你的内容 | 文档没说会绕过 |
| Meta-ExternalAds | 改进广告和其他业务相关的产品和服务 | 文档没说会绕过 |
| Meta-ExternalFetcher | 用户请求时抓单个链接,包括让AI代用户浏览网站、完成任务 | 会,文档明说可以绕过 |
文档里还有两条规则。robots.txt改动之后,最多要24小时才生效,因为Meta的爬虫会把它缓存最长24小时。另外,Meta说它用robots.txt这类行业标准来识别站长的意愿,不用NoAI标签这类非标准写法。
注意第四行。Meta-ExternalAds是专门和广告、业务产品对口的爬虫,而这次条款改的恰好就是商业用途。Search Engine Journal的报道里也没提到它。
4410个大站的robots.txt是怎么对待Meta的?
先说清楚样本和判定方法,后面的数字才有意义。
样本取自Tranco网站排名的前8526个域名。2026年10月17日,我们逐个请求它们的robots.txt,拿回了4410份能正常解析的文件。打不开、返回网页而不是规则文件的,都没算。
判定方法按robots.txt标准RFC 9309和Google的实现来:先找名字完全对上的user-agent组,找不到再用星号组;同一路径有多条规则时,最长的那条生效,一样长就是允许优先。测试路径用的是一个普通文章页地址,相当于问“这个爬虫能不能抓你的文章”。
| 爬虫 | robots.txt里点了名 | 文章页被挡(含星号组挡) | 点了名并且挡住 |
|---|---|---|---|
| Meta-ExternalAgent(训练) | 476(10.8%) | 604(13.7%) | 386 |
| FacebookBot(旧名) | 328(7.4%) | 500(11.3%) | 275 |
| Meta-ExternalFetcher(用户请求) | 213(4.8%) | 410(9.3%) | 182 |
| Meta-WebIndexer(AI搜索) | 131(3.0%) | 353(8.0%) | 115 |
| FacebookExternalHit(链接预览) | 292(6.6%) | 206(4.7%) | 20 |
| Meta-ExternalAds(广告) | 15(0.3%) | 240(5.4%) | 3 |
读这张表要注意一点:Tranco排名按访问量算,里面混着gstatic.com、googleadservices.com这类基础设施域名,还有各种接口和下载服务器,它们本来就不放内容。所以13.7%这个比例只能说明“大站里挡Meta训练的有多少”,不能直接读成“八成多的内容网站不在乎”。如果只看有新闻、文章的内容站,比例会是多少,这次没有分类统计,不好下结论。
FacebookBot不在Meta现行文档的五个爬虫里,是个旧名字,还有328个站在写它。这种情况在robots.txt里很常见,规则写上去就没人再管了。
训练爬虫挡得最多,广告爬虫几乎没人认识
挡Meta-ExternalAgent的604个站里,386个是点名挡的,剩下218个是因为星号组本来就把所有爬虫都挡在外面。点名挡的名单里有不少熟面孔:Twitter和X、领英、亚马逊、MSN、Medium、eBay、Canva、《自然》、《华盛顿邮报》、CNBC。
Meta-ExternalAds就冷清多了。4410个站里只有15个写过这个名字,包括Twitter、X、WhatsApp、CapCut、Pinterest、Disney+。它被挡的240个站里,237个是被星号组顺手挡掉的,没人专门针对它。
看来大部分站长对Meta爬虫的认知,停在“Meta-ExternalAgent是AI训练爬虫”这一步。条款里那句“用于提供、开发、改进广告和业务产品”,对应的爬虫几乎没人设过规则。
链接预览爬虫被挡的206个站,几乎都是误伤
FacebookExternalHit被挡的206个站里,只有20个是点名挡的。其余186个,都是星号组一刀切的结果。
挡它的后果很直接:链接分享到Facebook、Instagram、Messenger时,可能拉不到标题和缩略图,只剩一个光秃秃的网址。点名挡它的20个站,有wikiHow、美国国会网站congress.gov、日本读卖新闻、Flipboard,这几家应该是有意为之。跟着星号组一起被挡的那些,就不好说了。
对做外贸的站来说,社媒分享出去的商品链接没有图,点击率会难看很多。如果你的robots.txt用了星号组全挡、再单独放行Googlebot这种写法,最好检查一下FacebookExternalHit有没有被顺手挡掉。
“挡训练、留AI搜索”的站,有几个是想清楚了的?
Meta在文档里给了一个现成的选项:挡Meta-ExternalAgent,不让拿去训练;放行Meta-WebIndexer,让Meta AI能引用你、给你链接。Search Engine Journal也建议站长按这个思路检查。
表面看,这样设置的站不少。挡了训练但AI搜索仍可抓的,有259个,占全部样本的5.9%,MSN、Medium、eBay、Canva、《华盛顿邮报》、CNBC、Statista都在里面。
可是在这259个站里,robots.txt里写了Meta-WebIndexer这个名字的只有4个:EBSCO、ManualsLib、Astro.com、Game8。其余255个能放行AI搜索,只是因为它们点名挡了训练爬虫,又压根没写Meta-WebIndexer,它自然就落到了星号组里,而星号组恰好是放行的。
换个大白话讲,这255个站的“挡训练、留搜索”是碰巧碰上的,没人专门设计过。哪天它们把星号组改严一点,Meta AI搜索也会跟着被挡,站长自己可能都不知道。
反过来也有。点名写了Meta-ExternalAgent、却给它放行的有90个,包括Ubuntu、英国政府网站gov.uk、Trustpilot、Indeed、搜狐、Airbnb、Squarespace。这些站是想好了要让Meta抓的。
点名挡Meta-ExternalFetcher,可能没用
点名挡Meta-ExternalFetcher的有182个,Twitter、领英、亚马逊、《连线》都在里面。可是Meta的文档写得很直白:这个爬虫是替用户抓单个链接的,可以绕过robots.txt。
这类“用户触发的抓取器”不止Meta有,Google也有一整类不看robots.txt的抓取器,站内Google用户触发抓取器那篇专门讲过。真想拦住它们,得在服务器或防火墙上按访问来源处理,robots.txt管不到。
Meta自己的robots.txt是怎么写的?
顺手看了一眼facebook.com自己的robots.txt,1310行。文件开头是一段声明:未经Facebook明确的书面许可,禁止用自动化手段在Facebook上收集数据,获准的爬虫也只能用于许可里写明的用途。
规则部分点名了37个user-agent,其中就有Google-Extended,也就是Google用来控制AI训练的那个名字,写的是全站禁止。文件最后两行是“User-agent: *”和“Disallow: /”,没点名的爬虫一律挡在门外。
别人抓它,要先拿书面许可;它抓别人,靠的是条款里一段默认同意。两套规矩放在一起看,挺有意思的。
过去一个月,有多少站改了Meta的规则?
9月17日我们抓过同一批站点的robots.txt。两次都拿到文件的Tranco站点有4001个,可以直接比。
| 爬虫 | 9月点名 | 10月点名 | 新点名 | 取消点名 | 新挡住 | 新放行 |
|---|---|---|---|---|---|---|
| Meta-ExternalAgent | 416 | 447 | 36 | 5 | 31 | 11 |
| Meta-ExternalFetcher | 196 | 202 | 12 | 6 | 17 | 12 |
| FacebookExternalHit | 202 | 205 | 5 | 2 | 5 | 6 |
| Meta-WebIndexer | 123 | 126 | 3 | 0 | 7 | 8 |
| Meta-ExternalAds | 14 | 14 | 0 | 0 | 6 | 7 |
一个月里新挡Meta-ExternalAgent的有31个站,包括美联社ap.org、大英博物馆、美国心脏协会期刊站、Screen Rant、XDA Developers、Android Authority。
这些改动要看清时间。9月17日到10月17日之间,条款新闻是10月15日才出来的。我们只能确认它们在这一个月里改了,没法确认是不是因为这次条款。从整体看,挡训练爬虫的比例从13.4%变成13.9%,变化很小,站长们还没有集体反应。
9月的Cloudflare事件是一个对照。当时Cloudflare托管的robots.txt下线,一千多个站的AI训练禁令同时消失,站内Cloudflare托管robots.txt下线实测记录过。那次是平台替你改了规则,这次是条款替你签了授权。两件事有个共同点:站长不主动去看,就不会知道。
外贸独立站的robots.txt该怎么写?
网站这头能自己动手的,目前只有robots.txt。它能不能对抗条款授权,法律上还没有定论,Nieman Lab采访的一位版权律师说,法院最后会不会执行这一条没有保证,但出版商最好按“会执行”来做准备。Meta公开表态说robots.txt仍然有效,那就先把它写清楚。
按Meta文档的用途划分,大多数外贸站可以从下面这个思路出发,再按自己的需要改:
User-agent: meta-externalagent
Disallow: /

User-agent: meta-webindexer
Allow: /

User-agent: meta-externalads
Allow: /

User-agent: facebookexternalhit
Allow: /
这几行的意思是:不让Meta拿内容去训练模型;让Meta AI搜索能引用你;广告和链接预览照常。写的时候有几个坑要避开。
想挡训练就点名写Meta-ExternalAgent。只靠星号组挡,会把链接预览、AI搜索一起挡掉,前面那186个误伤的站就是这么来的。
放行的爬虫也建议点名写一遍,哪怕星号组本来就放行。爬虫只会听一个组的话:有组写了它的名字,它就只看那一组,星号组里写了什么都不管。这个规则站内robots.txt分组不继承的实测讲过。点了名,以后改星号组就不会误伤它。
别指望robots.txt挡住Meta-ExternalFetcher,它是可以绕过的。如果在意这部分流量,得去服务器日志里看它的实际访问,站内用日志分析AI爬虫那篇有具体做法。
FacebookBot这种旧名字留着没坏处,但别只写它。Meta现行文档里已经没有这个爬虫了。
改完之后等24小时再验证,Meta的爬虫缓存robots.txt最长就是这么久。
怎么查你的网站现在对Meta是什么态度?
不用装任何工具,三步就能查完。
第一步,打开你自己的robots.txt,找有没有写着meta-externalagent、meta-webindexer、facebookexternalhit这几个名字的组。没写的话,它们全都按星号组那几行来,星号组写的是什么,Meta的爬虫就照什么执行。
第二步,看服务器访问日志,搜“meta-externalagent”“meta-webindexer”这几个字样。有记录,说明Meta的爬虫确实来过,可以看它抓了哪些目录、抓得多频繁。日志里看不到,规则写得再细也只是摆设。
第三步,把一个商品页网址贴进Facebook的分享调试器(Sharing Debugger),看能不能拉到标题和图片。拉不到的话,先查是不是robots.txt挡住了FacebookExternalHit,再查页面有没有写Open Graph标签。Meta文档还提了一个容易忽略的要求:Open Graph标签要放在页面前1MB以内,否则抓取会中断。
要不要干脆把训练也放开?
这个没有标准答案。挡住训练,内容不会被拿去训练模型,但Meta AI在回答相关问题时,对你的品牌可能了解得更少。放开训练,等于把内容白送出去,换一个说不清的曝光机会。
对外贸站,商品页、规格页本来就希望被更多地方看到,放开的代价不大。原创的行业文章、调研报告、买家指南,这些花了真成本的内容,挡住训练更稳妥。robots.txt支持按目录写规则,可以只挡/blog/、放开/products/,没必要一刀切。
还有一点要想清楚:条款里的授权,可能比robots.txt管得更宽。如果你的品牌在Meta上有业务账号,又特别在意内容被拿去训练,最终能做的选择只有两个:接受条款,或者停止业务使用。这是商业决定,不是技术问题,robots.txt解决不了。
常见问题解答
Meta新商业条款什么时候生效?管到哪些人?
2026年10月30日生效。只要出于业务目的使用Meta产品就适用,包括投广告、卖商品、开发应用、管理公共主页、管理小组、使用成效衡量服务。生效后继续业务使用就视为同意。
Meta的AI训练爬虫在robots.txt里叫什么?
叫Meta-ExternalAgent,写成小写meta-externalagent也一样。Meta文档说它用于训练基础AI模型,或者直接编入索引来改进产品。挡它的写法是单独建一个User-agent: meta-externalagent的组,写Disallow: /。
挡了Meta-ExternalAgent,会影响Facebook上的链接预览吗?
只点名挡它不会。链接预览由FacebookExternalHit负责,是另一个爬虫。但如果你用星号组把所有爬虫都挡了,FacebookExternalHit也会被挡,分享出去的链接就可能没有标题和缩略图。
robots.txt能挡住所有Meta爬虫吗?
挡不住。Meta文档写明,Meta-ExternalFetcher替用户抓链接时可以绕过robots.txt,FacebookExternalHit做安全或诚信检查时也可能绕过。另外,新条款里的授权和robots.txt是什么关系,条款没写,法律上也还没有定论。
robots.txt改了多久对Meta生效?
最多24小时。Meta文档说它的爬虫会缓存robots.txt最长24小时。
Meta-ExternalAds要不要挡?
看你在不在Meta上投广告、卖货。Meta文档说它抓网页是用来改进广告和业务相关的产品,挡掉它,Meta读取你商品页信息的渠道就少了一个。本次样本里只有15个站点名写过它,其中12个是放行,被挡的基本是星号组全挡造成的。投广告的商家一般建议点名放行,不投的可以按自己对数据的态度决定。
Meta-WebIndexer要不要放行?
想在Meta AI的回答里被引用、带链接,就放行。Meta文档说放行它有助于引用和链接你的内容。建议在robots.txt里点名写一个Allow: /,别只靠星号组的默认放行。
权威参考资料
本文标题:《Meta爬虫robots.txt实测:新条款生效前,4410个大站怎么挡Meta》
本文链接:https://zhangwenbao.com/meta-crawler-robots-txt-commercial-terms-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0