Meta商业条款删掉“训练”后抓取权照旧:外贸站和独立站要盯的是robots.txt与广告爬虫
本文目录
- 从10月15日到10月19日,这件事是怎么一步步变的?
- 新旧两段条款,删了哪几个词?
- 抓取权原封不动,留下的几处才值得盯
- 英国英文版还没改过来
- 现行条款里原本就有的授权
- Meta怎么解释,法律学者为什么不买账?
- robots.txt在这件事里到底能管多少?
- 和新用途对口的是哪个爬虫?
- 做外贸和独立站的,10月30日前该做什么?
- 先确认自己在不在范围里
- 把你那个语言版本的条款存一份
- 按爬虫分别决定放不放
- 真不想被抓的内容,别只靠robots.txt
- 盯着10月30日前后的日志
- 还有哪些说不准的地方?
- 常见问题解答
- Meta这次修订删掉了什么?
- 不投广告、只开了Facebook公共主页,也受这份条款约束吗?
- robots.txt挡住Meta的爬虫,条款还能让它抓吗?
- 和修订后的用途最对口的是哪个爬虫?
- 测试凭证是什么意思,会影响我的会员内容吗?
- 中文版条款也改了吗?
- 现在要不要停用Meta的商业账号?
- 权威参考资料
摘要:Meta在10月16日改写了商业条款预览版里的抓取条款,删掉“训练”一词,用途改成“广告和商业产品”,外加产品诚信与安全。授权抓取的那半句原样保留:关联网站、测试凭证、定期拉取更新都还在,全文依旧没有一个字提robots.txt。三位法律学者认为“开发”足以涵盖“训练”,“商业产品”也没有定义。10月30日新条款生效,开着Facebook公共主页的商家继续使用就等于接受。
10月15日大家还在骂Meta想白拿网站内容训练AI,第二天下午,Meta就把“训练”两个字从条款里拿掉了。
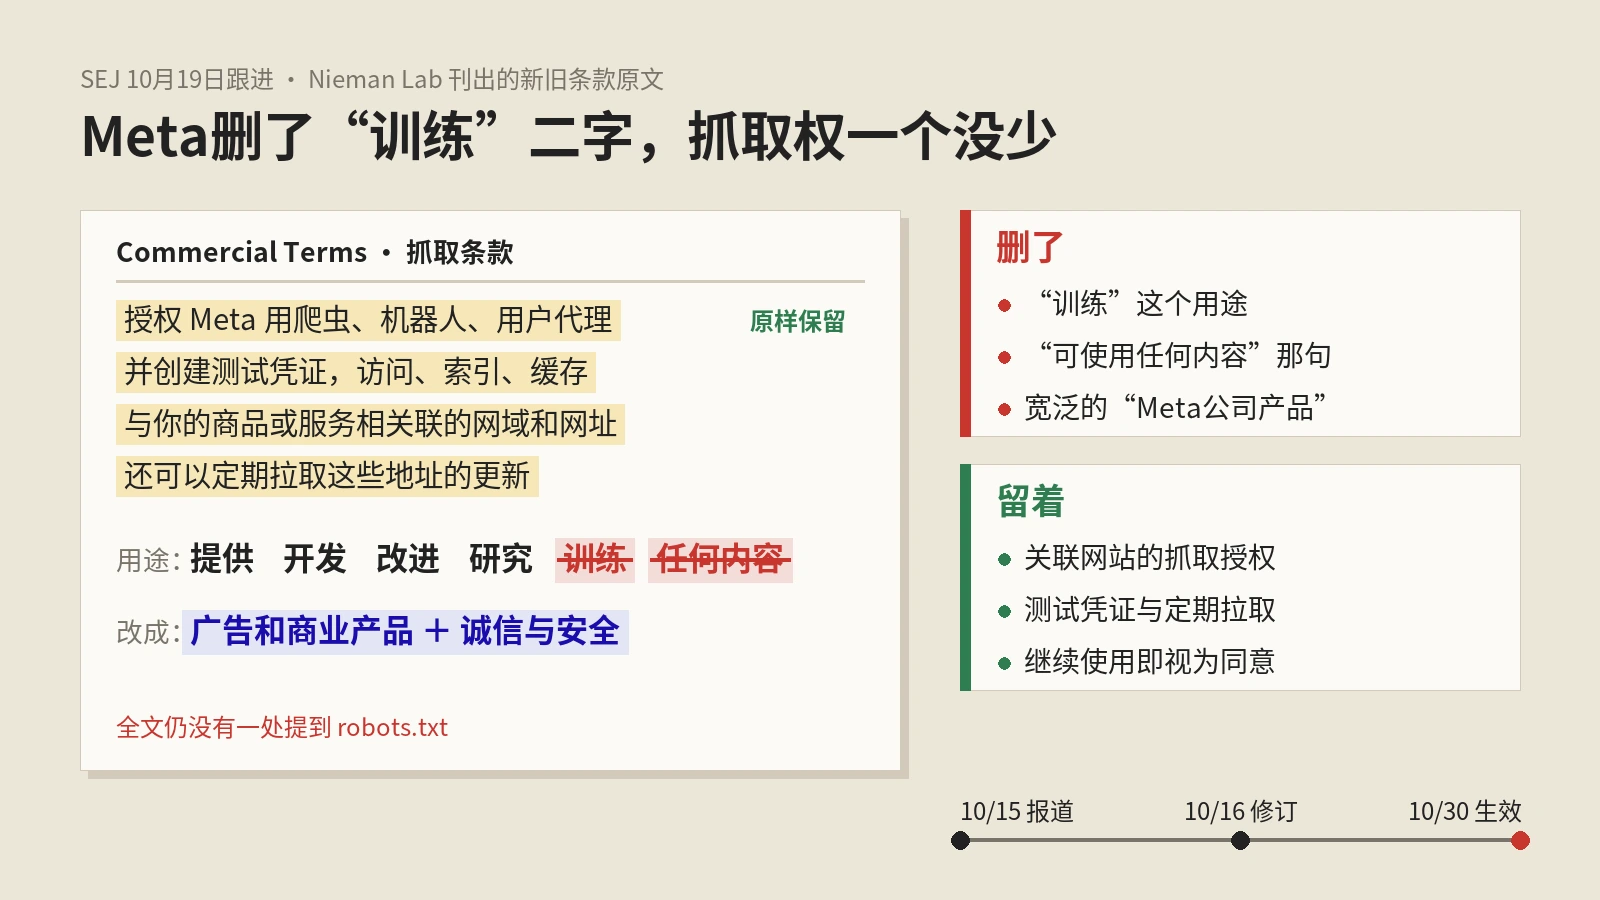
看上去像是认怂。可要是把新旧两段原文并排摆在一起读,会发现动刀的只是后半句的用途清单,前半句“允许我们派爬虫去抓你的网站”一个字都没改。
Search Engine Journal的Matt G. Southern在北京时间10月20日凌晨发了一篇跟进稿,标题就叫Meta Drops Training From Its Crawl Clause And Keeps The Crawl,意思是训练删了,抓取留着。这篇就以他的稿子为主线,对照Nieman Lab先后两次刊出的条款原文,把改了什么、没改什么、对做外贸和独立站的人意味着什么讲清楚。
条款刚出来时有哪些爬虫、大站的robots.txt怎么对待它们,站内Meta爬虫robots.txt那篇已经整理过,这里不再重复,只讲这次的修订。
从10月15日到10月19日,这件事是怎么一步步变的?
前后不到五天,条款预览改了一版,Meta出来解释了好几次,几家媒体行业组织也表了态。按时间排一下,后面读条款才不会乱。
| 时间(美国当地) | 发生了什么 | 出处 |
|---|---|---|
| 10月初 | Meta在商业帮助中心和Meta Business Suite里通知用户条款将更新,说是把散在各处的条款合并到一处 | Nieman Lab首篇报道 |
| 10月15日 | Nieman Lab报道新条款允许抓取商家关联网站,抓来的内容可用于“训练”,三位法律学者认为可能被用来主张抓取新闻网站 | Nieman Lab |
| 10月16日 | Meta传播副总裁Andy Stone在X上回应,说更新是想准确拿到第三方网站上的在售商品信息,和抓新闻网站无关 | SEJ首篇报道 |
| 10月16日 | 欧洲出版商理事会宣布要请欧盟委员会审查这些条款;英国新闻媒体协会发声明,称这是“无耻的圈地” | Nieman Lab第二篇 |
| 10月16日下午 | Meta改写预览版,删掉“train”,用途缩小到广告和商业产品 | Nieman Lab第二篇 |
| 10月17日 | Meta发言人Daniel Roberts对The Verge说抓取条款只适用于广告和商业产品;Nieman Lab刊出修订后的条款和学者意见 | The Verge、Nieman Lab |
| 10月19日 | SEJ发跟进稿,指出英国英文版自助广告条款预览当天仍保留旧说法 | SEJ |
| 10月30日 | 新版商业条款生效 | 条款预览页 |
美国的News/Media Alliance也表了态,总裁Danielle Coffey说这次更新“离谱,而且可能违法”,还说Meta拿受众做筹码逼商家同意抓取,是滥用市场支配地位。这几家组织的声明都出在修订之前,修订之后有没有改口,目前没看到新的表态。
新旧两段条款,删了哪几个词?
Nieman Lab在第二篇报道Legal experts warn Meta’s new terms still grant broad scraping permissions里把两版原文都贴了出来,旧版取自10月5日的网页存档。两段话的前半句一模一样,大意是:你授权Meta(或任何代表Meta行事的实体)使用网页抓取工具、机器人、蜘蛛、爬虫和用户代理,并创建测试凭证,去访问、索引、缓存、分析、收集、检索或爬取与你的商品或服务相关联的网域、网页或网址,以及你或用户在使用Meta产品时提供出来的网址,还可以定期拉取这些地址的更新。
差别全在后半句,也就是抓来以后拿去干什么。
| 对比项 | 旧版(10月15日报道时) | 新版(10月16日修订后) |
|---|---|---|
| 句式 | 另起一句:“Meta可以使用这些网域、网页或网址上的任何内容” | 并进同一句:抓取和拉取更新都服务于下面这些用途 |
| 用途动词 | 提供、开发、改进、研究、训练、维护诚信 | 提供、开发、改进、研究、维护,“训练”没了 |
| 用于什么 | Meta公司产品,以及本商业条款和其他补充条款下提供的服务和功能 | 广告和商业产品,括号里举例:帮你制作投放广告和商业内容、向用户介绍你的商品服务、把你和可能感兴趣的用户连起来 |
| 诚信用途 | 维护Meta公司产品的诚信 | 维护Meta公司产品的诚信和安全 |
| robots.txt | 没有提 | 仍然没有提 |
还有一个细节容易被忽略。旧版写的是“任何内容”,新版这个词随着另起的那句话一起消失了,用途改成挂在抓取动作后面。从字面看,新版把“抓什么”和“为什么抓”绑在了一起,旧版则是先抓,再说抓来的东西随便用。
“Meta公司产品”这个范围有多大?Meta在别处的条款里把“AI at Meta”也列为Meta公司产品之一,所以旧版等于把训练AI写进了允许范围。新版改成“广告和商业产品”,Meta目前举的例子是广告、Meta Business Tools和Meta Business Suite。
抓取权原封不动,留下的几处才值得盯
SEJ的标题说得很直白,删的是训练,抓取留着。具体留下了这些东西:
- 抓取对象没变。还是“与你的商品或服务相关联”的网域,加上你或用户在Meta产品里分享出来的网址。什么算“相关联”,条款没有解释。
- 测试凭证还在。Cornell法学院的James Grimmelmann在Nieman Lab的首篇报道里说过,这在技术上允许Meta以假用户身份注册,越过网站的注册墙。Meta没有回答它会不会用来绕过付费墙。
- 定期拉取更新还在。抓一次不算完,Meta可以隔段时间回来看你的页面变了没有。
- robots.txt依旧一个字没写。Meta对Nieman Lab承认,第一版没写清楚会尊重robots.txt的设置,可修订后的条款文本里同样没有补上这句话。
- 接受方式没变。10月30日后继续出于业务目的使用Meta产品就算同意,不同意的话只能停止业务使用,生效前也没有单独退出的选项。
适用范围也没有缩小。SEJ和Nieman Lab都指出,商业条款覆盖所有业务用途,不只是买广告。按Meta现行商业条款开头的定义,投广告、卖商品、开发应用、管理公共主页、管理小组、用成效衡量服务都算业务用途。换成国内外贸圈的话说,你开了个Facebook公共主页挂公司名,就在这个范围里。
英国英文版还没改过来
SEJ在跟进稿里专门查了自助广告条款的预览版。截至美国时间10月19日,英国英文版的自助广告条款预览里还留着旧说法,Meta可以用抓来的“任何内容”去“提供、开发、改进、研究、训练和维护”其产品的诚信;美国英文版已经没有这句。
可见条款的不同语言版本是各改各的。站内前一篇写作时读过的简体中文版商业条款预览,当时也是带“训练”的旧说法。中文版现在有没有跟着改,发布前我们没能登录核实,开着Meta商业账号的读者可以自己进Meta Business Suite看一眼你那个语言版本的原文。
现行条款里原本就有的授权
这次修订之前,Meta手里本来就有一部分抓取授权,两家媒体的说法略有不同,放在一起看更完整:
- Nieman Lab说,现行条款里只在一个很具体的场景下允许抓取:广告主使用Meta的生成式AI广告功能时,抓来的内容只能用来“优化你的广告”。所以新条款把用途扩到全部“广告和商业产品”,在它看来仍是大幅扩权。
- SEJ首篇报道翻到的是另一份:2025年8月22日版的自助广告条款写明,下单投广告就授权Meta抓取广告主的网域,列出的用途里本来就有“研究和训练”。
两份说法并不冲突,一个讲的是生成式AI广告条款,一个讲的是自助广告条款。对广告主来说,训练授权早就以另一种形式给出去了;对只开公共主页、不投广告的商家来说,这次才是第一次被纳入抓取授权。
Meta怎么解释,法律学者为什么不买账?
Meta这边的口径前后基本一致,发言人Daniel Roberts对The Verge的声明可以归成三句话:抓取条款只适用于广告和商业产品;这次更新不改变Meta使用网络爬虫的方式;内容方照样可以用robots.txt表达偏好,更新不会给Meta压过这些偏好的新权利。发言人还加了一句,“这和抓取新闻网站无关”。
Nieman Lab请的三位学者,修订后看完都没松口。
| 学者 | 身份 | 对修订版的看法 |
|---|---|---|
| Matt Topic | Loevy & Loevy律所的媒体与知识产权律师 | 出版商仍应担心;“商业产品”似乎没有定义,Meta大概率在做AI商业产品,“开发”这个词宽到足以包含“训练” |
| James Grimmelmann | Cornell法学院数字与信息法教授 | 修订没解决他的担忧;“开发广告和商业产品”的用途宽得能开进一辆卡车,“与你的商品或服务相关联”那句一点没收,足以让Meta抓整个网站 |
| Benjamin Sobel | 威斯康星大学法学教授 | robots.txt只是表达偏好,遵守全凭自愿,不给网站带来可执行的法律权利 |
Sobel打了个比方:robots.txt像房主在门口挂个牌子写“别看我家”,挂了牌子并不等于你有权阻止别人看。他在首篇报道里还提到反垄断法里的“搭售”概念,想用要求接受商业条款的Meta产品,就得一并接受条款里的抓取授权。
站在中立的位置看,两边各有说得通的地方。Meta说这次只是把散落在几份条款里的抓取语言合并到一处,Nieman Lab的报道也证实了这一点。学者担心的是条款字面能被解释到多宽,而合同纠纷里,最后起作用的往往就是字面。Topic在首篇报道里的原话是,法院会不会执行这条不好说,但出版商应该按会被执行来做准备。
robots.txt在这件事里到底能管多少?
Meta把robots.txt当成站长控制抓取的办法,这一点在声明里说了好几次。可它的分量要分开看。
技术上,它管得住守规矩的爬虫。robots.txt的正式标准RFC 9309写得很明白,这些规则是请爬虫遵守的约定,“不是一种访问授权”。它约束的是愿意守约的爬虫,拦不住不守约的。站内robots.txt写了允许、GPTBot却进不去的那篇也说明过,规则文件和服务器实际放不放行,本来就是两回事。
法律上,它和条款的关系没人说得清。SEJ跟进稿里最关键的一句是:修订后的条款没有说明,robots.txt里的设置能不能限制商家接受条款时授出去的权利。一边是你在网站上挂了“请勿抓取”,一边是你在Meta后台点了“继续使用”,两者打架时听谁的,现在只有Meta的口头声明,没有条款文本。
和新用途对口的是哪个爬虫?
Meta的爬虫文档把训练、AI搜索、广告分给了不同的爬虫,SEJ在跟进稿里也提到,想挡一个放一个可以靠robots.txt分别写。按站内前一篇整理的官方文档,和这次修订最对口的有三个:
| robots.txt里的名字 | 官方说的用途 | 和修订后条款的关系 |
|---|---|---|
| Meta-ExternalAgent | 训练基础AI模型,或直接编入索引改进产品 | 条款删了“训练”,但这个爬虫本身还在,挡不挡由你的robots.txt决定 |
| Meta-ExternalAds | 改进广告和其他业务相关的产品和服务 | 和新版用途“广告和商业产品”几乎一字不差,是这次最该看的那个 |
| Meta-WebIndexer | 改进Meta AI的搜索结果,帮助在回答里引用和链接你的内容 | 不在“广告和商业产品”的字面里,但挡掉会少一个被Meta AI引用的机会 |
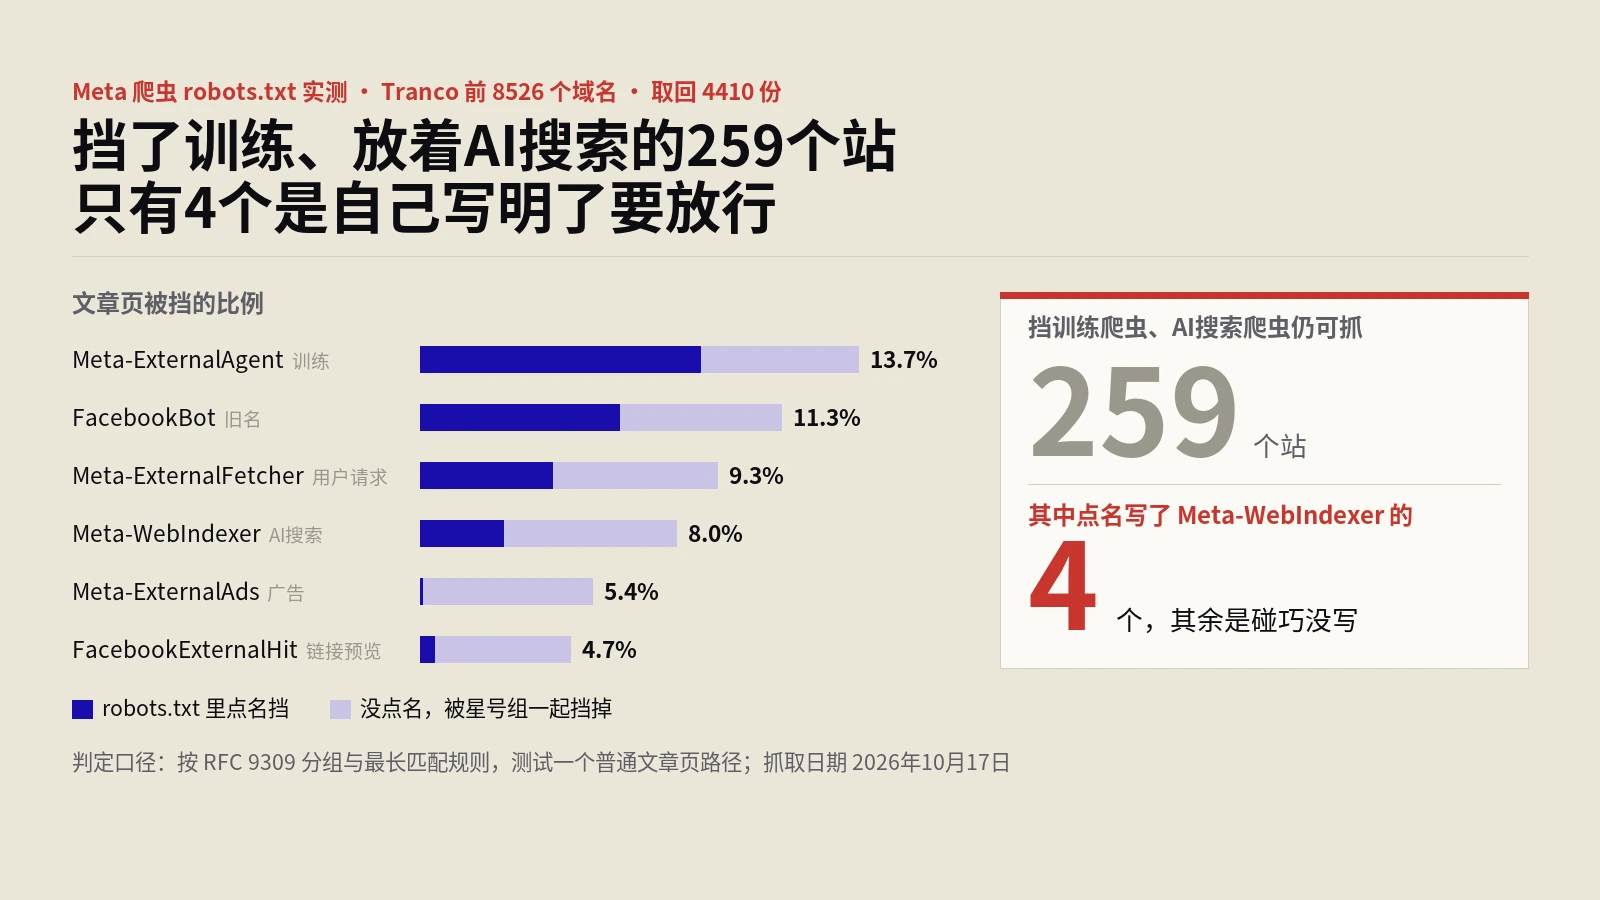
前一篇统计过的大站robots.txt里,点名写到Meta-ExternalAds的只有15个站,占0.3%。条款改完以后,这个冷门名字反而成了和新用途最贴的那一个。另外Meta文档说它的爬虫会把robots.txt缓存最长24小时,改完规则别指望立刻生效。
还有一类爬虫要单独说。Meta-ExternalFetcher是用户请求时抓单个链接用的,FacebookExternalHit负责生成分享预览,文档写明前者可以绕过robots.txt,后者在做安全或诚信检查时也可能绕过。新条款保留了“维护诚信和安全”这条用途,这两类抓取本来就不太受robots.txt约束。
如果你想核对自己的规则文件会不会被分组规则坑到,可以对照站内两篇:robots.txt分组不继承讲点名组和星号组的关系,两条规则撞车谁赢讲最长匹配。给Meta-ExternalAds单开一组时,最容易犯的错就是以为它会继承星号组里的禁止规则。
做外贸和独立站的,10月30日前该做什么?
这次的主角是新闻出版商,可条款不分行业。外贸B2B站、独立站卖家几乎都有Facebook公共主页,很多还挂着商品目录和像素,比媒体更深地绑在Meta的商业产品上。下面这几步,按先易后难排。
先确认自己在不在范围里
判断标准很简单:你有没有出于业务目的使用Meta产品。公司公共主页、Instagram商业账号、WhatsApp商业频道、投过广告、接过商品目录,任何一项都算。在范围里的话,10月30日之后继续用就等于接受,不存在“我没点同意”这回事。
把你那个语言版本的条款存一份
条款预览五天里改过一次,英国英文版和美国英文版又不同步。登录Meta Business Suite,找到你的账号对应的商业条款和自助广告条款预览,截图或另存网页,记下日期。以后真有争议,你需要知道自己当时接受的是哪一版。
按爬虫分别决定放不放
别图省事写一行全挡。比较常见的取舍是:
- FacebookExternalHit一般要放行,不然你在Facebook和WhatsApp里分享产品页时出不来标题和缩略图。
- Meta-ExternalAgent挡不挡看你的立场。不想给AI训练白送内容,就写进禁止组。
- Meta-ExternalAds如果你在投Meta广告、用Advantage+目录广告,挡了可能影响商品信息的抓取和广告效果,先别急着挡,看完日志再说。
- Meta-WebIndexer关系到Meta AI会不会引用你的页面,想在AI回答里露脸的就放行。
这几条只是起点,最终还得看你的服务器日志里这些爬虫实际来了多少、抓了哪些路径。站内别照抄爬虫黑名单那篇讲过,名单上写的和真来访问的,往往对不上。
真不想被抓的内容,别只靠robots.txt
条款里有测试凭证这一条,又没写明会尊重robots.txt。会员价目表、经销商报价、内部资料下载区这类内容,应该靠服务器端登录校验来保护,不要只放在一个“请勿抓取”的告示后面。经销商门户如果允许随便注册就能看价格,这次正好是收紧的时机。
盯着10月30日前后的日志
Meta说这次更新不改变它使用爬虫的方式。这句话可以验证:把10月30日前后两周的访问日志按Meta的几个用户代理名分开统计,看抓取量、抓取路径有没有明显变化。有变化就留存日志,这比任何声明都实在。站内AI爬虫抓取与引荐比那篇讲过怎么从日志里算一个爬虫抓了多少、带回多少流量,方法可以直接套。
还有哪些说不准的地方?
这件事离定论还远,下面几处目前没有答案,写在这里免得大家把哪一方的说法当成结论。
- “开发”包不包括“训练”。Topic认为包括,Meta没有正面回答。新版条款没有给“开发”或“商业产品”下定义。
- 条款还会不会再改。SEJ提醒,Meta在预览版发出后已经改过一次,10月30日之前最好再核对一遍原文。
- robots.txt和条款冲突时以谁为准。Meta口头说尊重robots.txt,条款文本里没有。真闹到法院,这会是争点之一。
- 各语言版本什么时候统一。英国英文版自助广告条款截至10月19日还没改,其他语言没人系统核对过。
- 监管会不会介入。欧洲出版商理事会说要找欧盟委员会,英国新闻媒体协会要求部长和监管机构出面,后续进展还看不到。
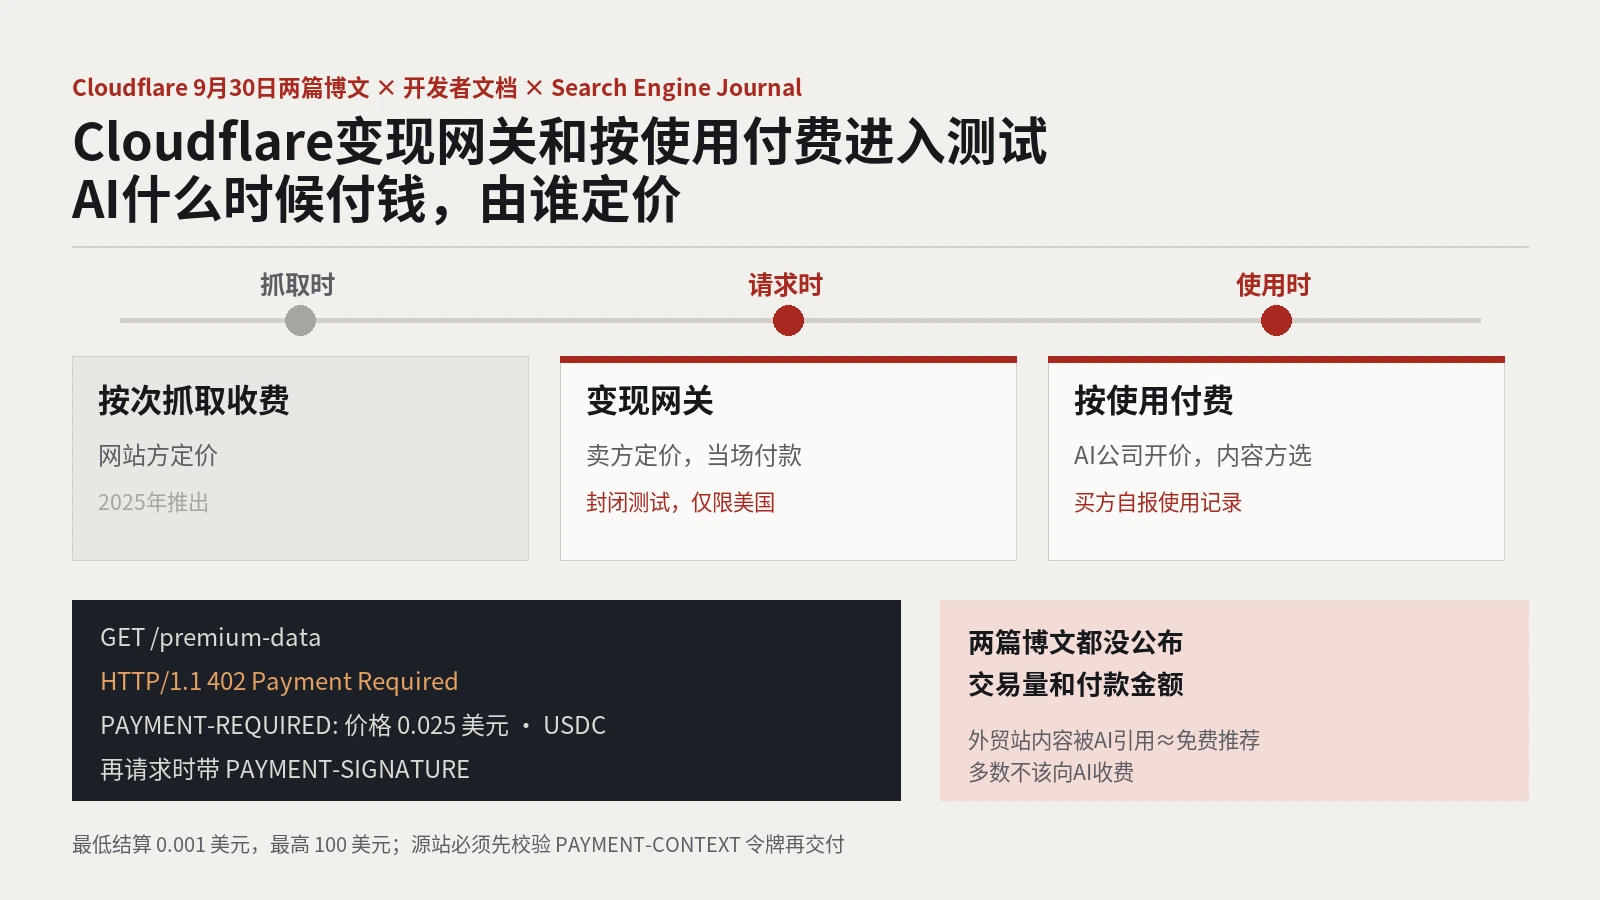
放远一点看,大平台在内容授权上松口,Meta不是头一家。Google今年8月起允许网站单独退出AI概览和AI模式,此前出现在传统搜索结果就等于同意出现在AI功能里,Sobel在首篇报道里也拿这件事做了类比。站内Google-Extended挡不住AI概览那篇讲过Google那边的授权怎么拆,Cloudflare变现网关那篇讲的是另一条路,让AI按请求付钱。三家放在一起看,平台都在把“抓取”和“怎么用”往开了分,只是Meta这次把抓取权绑在了商家账号上,而且在条款里写得比口头声明宽。
对普通站长来说,能做的事情不多:存好条款原文,分清每个爬虫,把值钱的内容锁在登录后面,然后看日志说话。至于“训练”两个字删掉以后是不是真的不训练了,等10月30日之后的日志会比任何一份声明都诚实。
常见问题解答
Meta这次修订删掉了什么?
删掉了“训练”这个用途和“Meta可以使用任何内容”那句,把用途从Meta公司产品缩小到广告和商业产品,并在诚信之外加了安全。授权抓取的那半句没有改动。
不投广告、只开了Facebook公共主页,也受这份条款约束吗?
受约束。商业条款覆盖所有业务用途,管理公共主页、小组、商业账号都算,10月30日之后继续出于业务目的使用就视为接受。
robots.txt挡住Meta的爬虫,条款还能让它抓吗?
Meta口头表示会尊重robots.txt,但条款文本里没有这句话。robots.txt按RFC 9309只是请爬虫遵守的约定,不是访问授权,两者冲突时谁优先目前没有明确答案。
和修订后的用途最对口的是哪个爬虫?
是Meta-ExternalAds。Meta文档说它用于改进广告和其他业务相关的产品和服务,和新版条款里的广告和商业产品几乎一致。训练用的是Meta-ExternalAgent,AI搜索用的是Meta-WebIndexer。
测试凭证是什么意思,会影响我的会员内容吗?
条款允许Meta创建测试凭证去访问关联网站,学者认为技术上可以用来注册账号越过注册墙。Meta没有回答是否会用来绕过付费墙,所以会员价格、经销商资料这类内容应靠服务器端登录校验保护。
中文版条款也改了吗?
不确定。SEJ发现截至10月19日英国英文版自助广告条款预览仍是旧说法,美国英文版已改。简体中文版需要自己登录Meta Business Suite核对,并截图留存。
现在要不要停用Meta的商业账号?
对大多数外贸和独立站卖家来说,停用的代价远大于条款风险。更现实的做法是按爬虫分别配置robots.txt、保护高价值内容、留存条款版本,并对比10月30日前后的访问日志。
权威参考资料
本文标题:《Meta商业条款删掉“训练”后抓取权照旧:外贸站和独立站要盯的是robots.txt与广告爬虫》
本文链接:https://zhangwenbao.com/meta-commercial-terms-crawl-clause-training-removed.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0