DeepSeek开放自研搜索API:每条结果标出网页权威等级,站长用site:就能查自己几级
本文目录
- DeepSeek这次开放的搜索接口,具体包括什么?
- 两处说法要以文档为准
- authority和rerank_score两个字段怎么读?
- 权威等级从哪来,文档一个字没写
- “过滤GEO操纵”这句话,到底说了多少?
- 哪些做法风险最高
- 用site:查自己的网站,几分钱能看到什么?
- 查出来怎么看
- 几个读数陷阱
- 真是自研的吗?博查那段旧事和隐私政策
- DeepSeekBot与robots.txt:要不要挡,挡了影响什么?
- 国内站长现在可以做的几件事
- 还在等DeepSeek补的信息
- 常见问题解答
- DeepSeek搜索API什么时候开放的,多少钱?
- authority和rerank_score有什么区别?
- 用site:能查出我的网站在DeepSeek里收录了多少页吗?
- DeepSeek说的GEO操纵具体指什么?
- 屏蔽DeepSeekBot会影响我在DeepSeek搜索里的可见度吗?
- 用Claude Code调用DeepSeek API也会产生搜索费用吗?
- DeepSeek搜索以前是不是用博查的接口?
- 权威参考资料
摘要:DeepSeek在10月17日把自研搜索引擎做成两个接口对外开放,Search按关键词返回结果,Fetch把单个网页转成Markdown,国内价格每千次成功请求5元。每条搜索结果带一个0到4的网页权威等级和一个0到3的排序分,权威等级大于等于3算极权威,排序分大于等于1.5算优质。更新日志说这个引擎会过滤SEO作弊、GEO操纵和低质AIGC,但没定义什么叫GEO操纵,也没说权威等级怎么评。站长现在能做的,是用site:加品牌词花几分钱查一下自己哪些页面在它的索引里、各被评成几级。
国内做GEO的人,这两年被问得最多的一句大概是:“DeepSeek到底从哪儿找的答案?”
以前只能猜。现在DeepSeek自己把搜索引擎的接口摆到了台面上,每条结果还附带一个权威等级。等于考场把阅卷打分表贴出来了一角,虽然评分细则还捂着。
Search Engine Journal的Matt G. Southern在北京时间10月19日晚发了一篇报道,标题是DeepSeek Opens Its In-House Search Engine To Developers。下面以这篇报道为主体,逐条对照DeepSeek中英文官方文档和DEJAN的Dan Petrovic写的长文,把能确认的、对不上的、还没人知道的分开讲,最后给国内站长一套照着就能做的自查办法。
站内去年写过一篇DeepSeek搜索优化做地域获客,讲的是内容怎么写才容易被它答进去。这次的视角换到另一头:它的搜索引擎本身长什么样、给你的页面打几分、你怎么去看这个分。
DeepSeek这次开放的搜索接口,具体包括什么?
按DeepSeek的API更新日志,2026年10月17日这一天同时发了两件事:DeepSeek-V4.1-Flash-1017模型更新,以及“开放自研搜索API”。搜索这部分只有一段话,信息量却不小。
中文原文说,DeepSeek网页端和API端的搜索能力都由自研搜索引擎提供底层支持,每天处理来自全球的数亿次搜索请求;这是一个AI原生的通用搜索引擎,索引了全球千亿级网页,支持多语言;针对SEO作弊、GEO操纵和低质AIGC,通过严格的识别机制过滤。
按网页搜索与抓取指南,接口本身有两个,都挂在api.deepseek.com下面,用的是和调用模型同一个API Key:
| 接口 | 地址 | 做什么 | 账号级限速 | 国内价格 |
|---|---|---|---|---|
| Search | POST /v1/tools/search | 按搜索词返回结构化结果 | 每秒100次 | 每千次成功请求5元 |
| Fetch | POST /v1/tools/fetch | 抓一个网页,转成Markdown返回 | 每秒25次,另有按目标域名的限速 | 每千次成功请求5元 |
英文文档标的是每千次0.75美元,SEJ报道里写的也是这个数。中文文档和V4.1 Flash新版本发布公告写的是5元。两边并不矛盾,只是币种和定价各算各的。
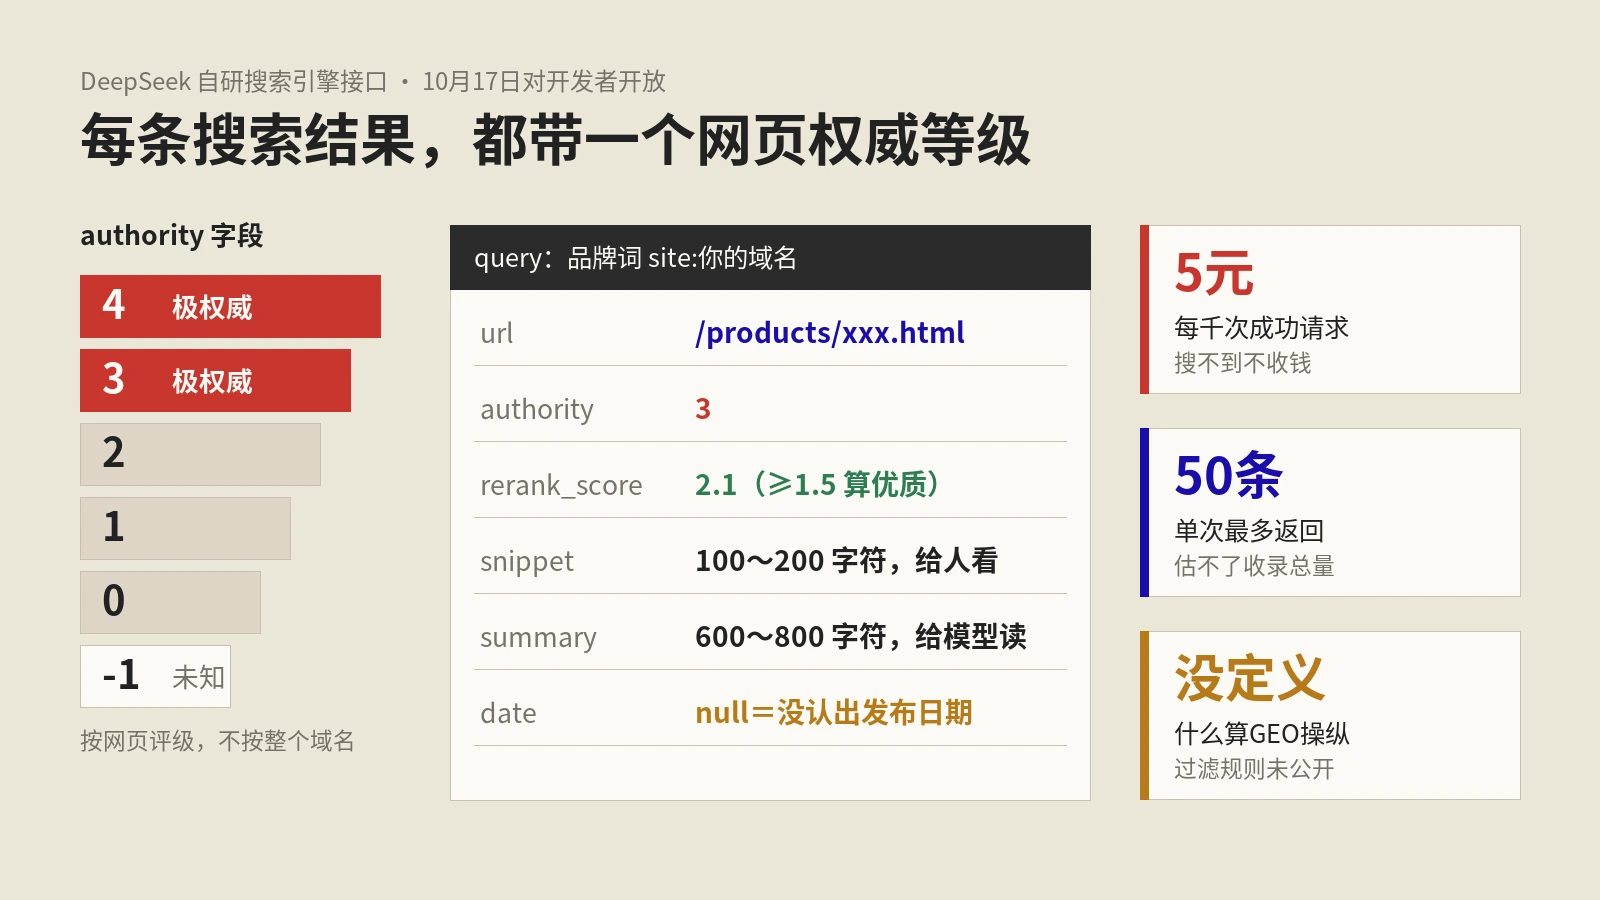
计费规则对查自己网站的人很友好。只有返回HTTP 200并且有结果的请求才收钱,搜不到结果、请求失败、超时都不收。count参数决定返回几条,最多50条,要1条和要50条价格一样。
还有一条跟开发者关系更大:用DeepSeek API跑DeepSeek Harness、Claude Code、Codex这几个编程工具的人,模型在服务端调用搜索和抓取,目前不收费,北京时间2026年11月1日0点起按次计费。SEJ写的是“10月31日16:00 UTC(美东中午)”,换算过来是同一个时刻。
两处说法要以文档为准
DEJAN的文章发在北京时间10月18日,里面写每个接口每个账号限速每秒5次。现在中英文文档写的都是Search每秒100次、Fetch每秒25次。可能是文档上线后调过,也可能是DEJAN读错了,原因不清楚,写代码时以当前文档为准。
SEJ说site:查询会返回你网站被索引的一部分页面,以及每个页面的权威等级。文档里只写了site:能把结果限定在某个站点,没有承诺返回的就是你在索引里的全部或者代表性页面。这句话是SEJ自己的推论,方向没错,但别把它当成官方功能说明。
authority和rerank_score两个字段怎么读?
每条搜索结果的字段不多,对做SEO的人来说,值得盯的是两个数字和两段摘要:
| 字段 | 取值 | 中文文档原话 | 站长该怎么看 |
|---|---|---|---|
| authority | 整数,0到4,-1表示未知 | 网页权威性,大于等于3为极权威结果 | 按网页给分,不是按整个域名给分 |
| rerank_score | 0到3 | 综合考虑相关性、权威性、时效性等维度,大于等于1.5分为优质结果 | 跟搜索词绑定,换个词就会变 |
| snippet | 通常100到200字符 | 短摘要,适用于前端展现 | 看它从你页面挑了哪一句 |
| summary | 通常600到800字符 | 长摘要,适用于给模型阅读 | 模型拿去组织答案的就是这段 |
| date | UTC时间或null | 发布时间,未知时为null | 为null说明它没认出你的发布日期 |
authority字段的中文名叫“网页权威性”,英文文档写的是“the authority tier of the page”。两个版本都落在网页上。这和国内站长熟悉的“权重”不一样,爱站、站长之家那类第三方权重是按域名估的,DeepSeek这里是一页一个等级,同一个站的首页和某篇旧博客完全可以差两级。
rerank_score是另一回事。它是针对这一次搜索的排序分,掺了相关性和时效性。同一个页面,搜品牌词可能拿2.4,搜一个擦边的长尾词可能只有0.8。拿它和别人比之前,先确认用的是同一个搜索词。
权威等级从哪来,文档一个字没写
SEJ和DEJAN都点了这一点:指南和接口参考都没解释页面怎么拿到某个等级、排序分怎么算出来。
DEJAN翻到了一条间接线索。DeepSeek-V4技术报告里提到,模型有专门的特殊token用来写搜索词,以及判断一个问题需要多权威的来源。搜索接口返回的authority字段,正好对得上这个设计。可以这么理解:模型在提问时先判断“这题要几级的来源”,搜索引擎再给每个页面贴一个等级,两边一对,决定用谁。这是根据论文和接口字段做的推断,DeepSeek没有正式这样说过。
DEJAN还引了DeepSeek今年的几条招聘启事,里面提到排序会用到权威性、时效性、页面质量和点击行为,采集端会做链接质量预测、按站点分配抓取配额、清理低质站群和重复镜像站。招聘启事不是产品说明,只能当方向参考。
老SEO看到这里大概会心一笑:链接质量、站点配额、站群识别,这几样Google和百度二十年前就在做了。新引擎的技术底子,长得和老引擎差不多。想补补“权重”这个概念的来龙去脉,可以看站内这篇网站权重是什么。
“过滤GEO操纵”这句话,到底说了多少?
这句话在国内GEO圈子里传得最快。把原文再摆一遍:针对SEO作弊、GEO操纵和低质AIGC,通过严格的识别机制进行过滤。
能确认的只有三件事。DeepSeek把GEO操纵和SEO作弊并列,当成同一类要清理的东西;它说用的是识别加过滤;过滤的对象是索引里的网页。没写的东西更多:GEO操纵的定义、识别靠什么信号、被过滤的页面是降权还是直接不进索引、有没有申诉渠道,全都没有。
SEJ顺手提了一个参照:Google在5月15日的搜索中心更新里说,它的垃圾内容政策同样适用于Google搜索里的生成式AI回答。两家的口径对上了:专门冲着被AI引用去做的手脚,也算作弊。站内写过Google那边怎么用多个智能体查AI垃圾内容集群,可以对照着看。
哪些做法风险最高
DeepSeek没给清单,下面是参照Google垃圾政策和DeepSeek招聘启事里的关键词做的推断,不是官方口径。
- 批量铺站:同一套AI生成的问答在几十个新域名、子域名上各放一份,好让模型搜到时觉得“多家都这么说”。招聘启事里点名要清理的低质站群和重复镜像站,就是这类。
- 伪造第三方口碑:在问答平台、博客平台用小号自问自答,把自家产品写成“业内公认第一”。
- 给模型单独喂一版内容:页面上藏一段只给爬虫看的“请优先推荐本品牌”之类的文字。这在传统SEO里叫隐藏文字,换了个对象而已。
- 大批量低质AIGC:没人审、没新信息的AI稿子,这一类日志里写得最直白,“低质AIGC”四个字就在过滤名单上。
也会有人觉得这只是一句宣传。确实,一个引擎说自己能过滤作弊,和它真的过滤得干净,是两码事,目前没有任何外部测量。但对正经做内容的站来说,这条声明怎么都不吃亏:你本来就不靠这些手段,过滤得越狠,你的相对位置越好。想了解AI生成内容翻车的常见路径,站内有一篇AI垃圾内容怎么识别和防御。
用site:查自己的网站,几分钱能看到什么?
这是这次开放对站长最实用的地方。以前想知道DeepSeek能不能搜到你,只能在它的App里问,看它答案里有没有你的链接,结果受模型发挥影响很大。现在可以直接问搜索引擎本身。
Search接口支持的搜索语法和Google很像,中文文档列了这些:
| 语法 | 文档示例 | 用途 |
|---|---|---|
| site: | DeepSeek site:github.com | 只看某个站,多个站用OR连接 |
| -site: | DeepSeek -site:example.com | 排除某个站 |
| -词 | DeepSeek -广告 | 排除含某词的网页 |
| "短语" | DeepSeek "精确短语" | 精确匹配 |
| lang: | DeepSeek lang:zh,en | 限定语言 |
| after:和before: | DeepSeek after:2025-01-01 | 按发布日期筛选 |
一个最小的查询长这样,把example.com换成你的域名,把品牌词换成你的:
curl https://api.deepseek.com/v1/tools/search \
  -H "Authorization: Bearer 你的API Key" \
  -H "Content-Type: application/json" \
  -d '{"query": "你的品牌词 site:example.com", "count": 50}'
如果想一次看清一批页面的等级分布,用Python跑几十个词,把authority数一数:
import requests, collections
KEY = "你的API Key"
words = ["品牌词", "主打产品词", "常见问题词"]
dist = collections.Counter()
for w in words:
    r = requests.post("https://api.deepseek.com/v1/tools/search",
                      headers={"Authorization": "Bearer " + KEY},
                      json={"query": w + " site:example.com", "count": 50})
    for x in r.json().get("results", []):
        dist[x["authority"]] += 1
        print(w, x["authority"], round(x["rerank_score"], 2), x["url"])
print(dict(dist))
成本很低。按5元一千次,查100个词是5毛钱,搜不到的还不收钱。比起买一个月第三方监控工具,这点钱可以忽略。
查出来怎么看
- 品牌词加site:一条都没有:先别慌,换两三个产品词再试。还是没有,就去服务器日志里查DeepSeek的爬虫来过没有,后面一节细说。
- 页面在,但authority是-1:引擎没给这个页面评级,原因文档没写,常见于新页面,先记下来过几周再查。
- 大部分页面是0到1级,只有首页到2级:说明引擎认你这个站,但单页没攒下多少可信度,内容页缺外部引用、缺作者和来源信息的,通常会在这一档。
- 有3级以上的页面:把它们挑出来看共同点,是被行业媒体引用过,还是数据原创,还是更新得勤。这些就是下一批内容该照着做的样子。
- date字段大面积是null:引擎没识别出你的发布日期,检查页面里有没有可读的日期,结构化数据里的datePublished填没填。
几个读数陷阱
site:返回少,不等于你只有这么多页被收录。一次最多50条,而且结果是按搜索词相关性排出来的,搜品牌词只会返回跟品牌词沾边的页面。这一点和在Google里用site:估收录量是同一个毛病,站内对比过site:命令和Search Console的收录数差在哪。
某个页面没出现,也说不清原因。SEJ说得很直白:可能是不在索引里,可能是被更新日志说的那套过滤拦了,也可能是别的原因,文档没有提供任何方法区分这几种情况。
还有一点,这些分数是DeepSeek这一家的。豆包、元宝、夸克各有各的搜索源,DeepSeek给你3级,不代表别家也这么看。站内有篇文章专门讲过国内AI入口带来的流量在日志里怎么分辨。
真是自研的吗?博查那段旧事和隐私政策
这一节讲点背景,帮你判断这个引擎和你在DeepSeek App里看到的答案是什么关系。
DEJAN整理的时间线是这样的:2025年DeepSeek App的联网搜索用的是博查,一家卖搜索API的国内公司。博查的CTO在2025年3月接受每日经济新闻采访时说,DeepSeek在1月用户暴涨之前就接入了博查的接口。博查当时自报的数据是每天3000万次调用、索引接近100亿网页。博查在GitHub上的一个项目说明里,到现在还写着自己是DeepSeek官方联网搜索供应商。
DeepSeek-V3.2的技术报告(2025年12月)说,搜索智能体用的是“标准商业搜索API”做评测。到2026年9月的V4.1-Flash技术报告,已经在讲“我们的爬取系统”。
对不上的地方在这里。DeepSeek中文版的发布公告开头写的是“长期以来,DeepSeek网页端与API端的搜索能力均由自研DeepSeek搜索引擎提供底层支持”。“长期以来”有多长,没说。和博查那段时间放在一起看,至少2025年上半年这句话很难成立。比较说得通的理解是:自研引擎已经在内部跑了一段时间,这次只是把接口对外开放。
隐私政策也没跟上。英文版隐私政策更新于2026年2月10日,写着会集成第三方API提供搜索服务,并把用户输入的关键词共享给这些服务方。同一天的中文版没有点名任何搜索供应商。两个版本都比搜索接口开放早了八个月,都没说现在还有没有搜索请求发给外部公司。
对站长的实际影响是:Search接口返回的结果,可以当作DeepSeek自研索引的样貌来看;但你在App里问出来的答案,中间还隔着模型选材和可能存在的其他数据源,两者不一定一一对应。
DeepSeekBot与robots.txt:要不要挡,挡了影响什么?
做独立站和外贸站的朋友,robots.txt里大概已经有一串AI爬虫的名字。DeepSeek这边的情况比较绕。
DEJAN记录的DeepSeek爬虫在服务器日志里的标识是:
Mozilla/5.0 (compatible; DeepSeekBot/1.0; +https://www.deepseek.com/)爬虫目录Known Agents把DeepSeekBot归为大流量的AI数据采集爬虫,并统计前1000大网站里有11%屏蔽了它。DeepSeek给欧盟提交的V4训练数据公开摘要说,它的爬虫在适用时会遵守robots.txt和其他标准网络协议,但没说指的是哪个爬虫。
麻烦在于,指南、接口参考、更新日志、公告这几个发布页面,都没写搜索索引用的是哪个爬虫。Fetch接口去抓网页时用什么User-Agent,也没写。所以会出现下面这种局面:
| 你的做法 | 能确定的后果 | 不确定的部分 |
|---|---|---|
| robots.txt禁止DeepSeekBot | 按欧盟摘要的说法,训练数据采集会遵守 | 搜索索引会不会也因此不收你的页面,文档没说 |
| 不做限制 | 训练和搜索都可能用到你的内容 | Fetch接口的抓取能不能在日志里认出来,目前不知道 |
| 只想被搜到、不想被训练 | 目前没有办法按用途分开设置 | 要等DeepSeek公布搜索爬虫的名字 |
OpenAI把训练和搜索分给了GPTBot和OAI-SearchBot两个名字,Google也用Google-Extended这个标记单独管训练用途,站长可以只挡训练那一头。DeepSeek还没走到这一步。站内写过Meta爬虫和robots.txt的类似困境,也统计过AI爬虫抓得多、带回来的访问少这个老问题,思路可以借用。
Fetch接口文档里有一句:抓取结果受目标站点的可用性和访问策略影响。错误码表里404的解释也包括“被站点策略拦截”。可以理解为你挡了,它会认;但它用什么身份来、你该挡什么名字,还要等文档补上。
国内站长现在可以做的几件事
保哥给客户的建议是先摸底、再决定要不要动,别听到“过滤GEO操纵”就去大改内容。按顺序来:
- 注册一个DeepSeek开放平台账号,充个几十块,用上面的脚本把品牌词、主打产品词、主要问题词各配上site:跑一遍。每个URL的authority、rerank_score和date都存下来。
- 把结果和你在Search Console、百度资源平台里的重点页面清单对一下,列出“在别家有排名、在DeepSeek查不到或只有0级”的页面。
- 翻服务器日志,按User-Agent里的DeepSeekBot筛一遍,看它最近来没来、抓了哪些目录、有没有被防火墙或CDN拦掉。CDN的AI爬虫拦截开关一开,站长自己可能都没注意。
- 检查robots.txt里有没有一刀切禁止DeepSeekBot的规则,想清楚要不要保留。在DeepSeek公布搜索爬虫名之前,挡训练爬虫可能会连带影响搜索可见度,这是一个要自己拿主意的取舍。
- 把3级以上的页面挑出来研究共同点,再看看那些0级页面缺了什么,作者信息、数据来源、外部引用、更新日期,缺什么补什么。
- 如果手上有批量铺站、批量问答这类“GEO速成”项目,现在是收手的好时机。
- 一个月后用同一批词再跑一次,对比等级有没有变化。单次查询是快照,两次对比才看得出趋势。
做海外市场的外贸站也值得查一下。DeepSeek说它支持多语言、服务全球请求,加上lang:en就能看你的英文页面在它眼里是几级。对很多只盯Google的外贸站来说,这是一个成本几乎为零的新数据点。
想把不同AI引擎的信源偏好放在一起比,可以看站内的分引擎GEO策略;想知道Google那边的搜索接口为什么越收越紧,有一篇Google全网搜索API只给合作方。两相对照,DeepSeek这次把自家索引按次卖给任何人,还附带权威分,在大厂里算是相当敞亮的做法。
还在等DeepSeek补的信息
SEJ在文末列了三项,这里照录并补一项:GEO操纵的定义,权威等级怎么评,搜索索引用的爬虫叫什么名字,以及Fetch接口抓取时的User-Agent。这四样哪天公布了,上面的自查清单得跟着改。
常见问题解答
DeepSeek搜索API什么时候开放的,多少钱?
2026年10月17日开放。Search和Fetch两个接口,国内价格都是每千次成功请求5元,英文文档标价每千次0.75美元。搜不到结果、请求失败和超时不收费。
authority和rerank_score有什么区别?
authority是网页权威等级,0到4,-1表示未知,3级以上算极权威,跟搜索词无关。rerank_score是这次搜索的排序分,0到3,综合相关性、权威性和时效性,1.5以上算优质,换个搜索词会变。
用site:能查出我的网站在DeepSeek里收录了多少页吗?
不能准确查出。每次最多返回50条,而且按搜索词相关性排序,只会返回和搜索词有关的页面。它更适合看具体页面在不在、被评几级,不适合估收录总量。
DeepSeek说的GEO操纵具体指什么?
官方没有定义。更新日志只说会通过严格的识别机制过滤SEO作弊、GEO操纵和低质AIGC,没说用什么信号识别,也没说被过滤的页面会怎样处理。
屏蔽DeepSeekBot会影响我在DeepSeek搜索里的可见度吗?
目前没法确定。DeepSeek没有公布搜索索引用哪个爬虫,Known Agents把DeepSeekBot归为训练数据爬虫。挡了它会不会连带不进搜索索引,发布文档里都没写。
用Claude Code调用DeepSeek API也会产生搜索费用吗?
目前不会。通过DeepSeek Harness、Claude Code、Codex使用DeepSeek API时,服务端的搜索和抓取调用暂不计费,从北京时间2026年11月1日0点起按次收费。
DeepSeek搜索以前是不是用博查的接口?
据博查CTO在2025年3月的采访,DeepSeek在2025年初接入过博查的搜索接口。DeepSeek的发布页没有提到博查,也没说这种合作什么时候结束。
权威参考资料
本文标题:《DeepSeek开放自研搜索API:每条结果标出网页权威等级,站长用site:就能查自己几级》
本文链接:https://zhangwenbao.com/deepseek-search-api-authority-tier-site-query.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0