引用来源实测392条:三分之一来自卖工具的,学术出处只有8条
本文目录
- 一条出处链接指到最后,落在谁的服务器上?
- 两个分母,别混着看
- 八个桶怎么分
- 卖工具的占三分之一,学术只有八条,这个比例正常吗?
- 学术那一档,三分之一指的不是论文
- 那个占四分之一的未归类桶,里面到底是什么?
- 为什么被引最多的那个域名是搜索引擎自己?
- 各家依赖的头部来源完全不同
- 一百零六条链接指向领英,其中三十九条是个人主页?
- 社交帖细分
- 社交帖为什么会变成主要来源
- 帖子与主页是两种不同的证据
- 数据订阅商那一档,链接过去往往看不到那个数
- 同行之间几乎不互相引用
- 四百八十一个域名里,六成三只出现过一次
- 正文外链里混着广告位,这件事有多常见?
- 先看标注
- 带推广参数的65条,一半没标
- 还有自家公司的域名
- 同一页里挂了二十三次的那条链接,是出处吗?
- 各家引谁,差别有多大?
- 这套分类自己怎么做?
- 先把出处位置和其他链接分开
- 再按发布方的利益关系分档
- 顺便量一下来源多样性
- 最后查一遍标注
- 知道了构成,能改哪些决定?
- 常见问题解答
- 做完这套分类,最该改的是哪一件事?
- 厂商发布的数据是不是就不能用?
- 学术出处只占2.0%,是不是说明行业不严谨?
- 指向官方文档的链接算强证据吗?
- 怎么快速看出一条外链是不是广告位?
- 正文里的自家集团链接,要不要加nofollow?
- 社交帖当出处,有没有补救办法?
- 为什么要把出处位置和普通外链分成两个分母?
- 这份构成能代表中文内容生态吗?
- 权威参考资料
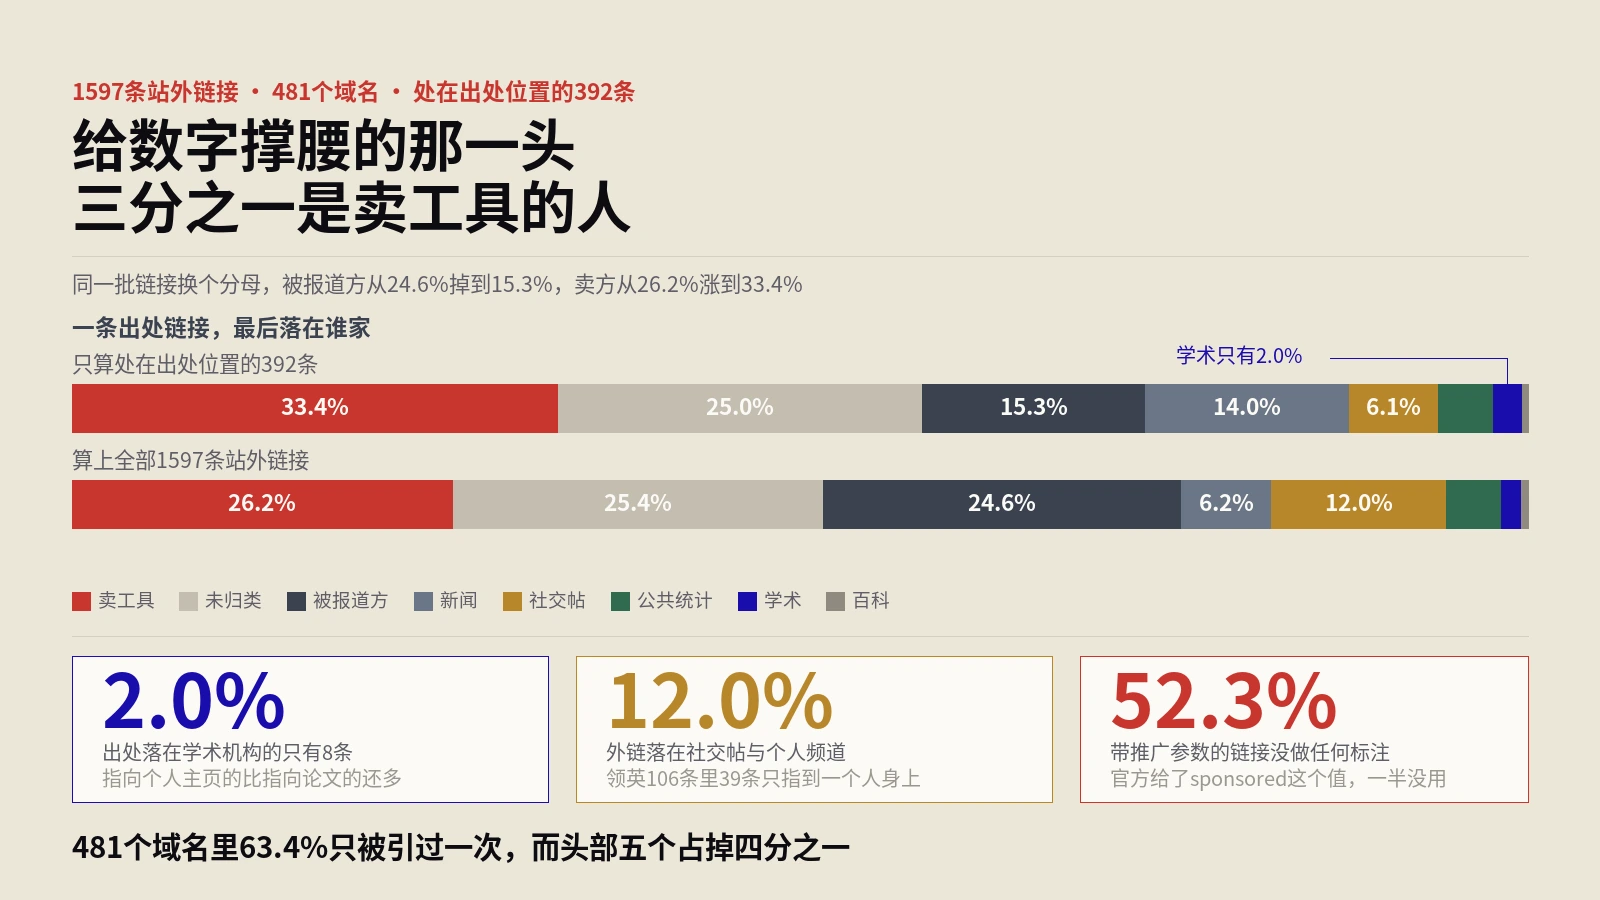
摘要:把9个英文搜索营销内容站的242篇正文里1597条站外链接逐条归类,再单独挑出真正处在出处位置的392条去重链接看它们通向谁。卖工具与卖服务的机构占33.4%,被报道对象自己占15.3%,新闻媒体14.0%,社交帖6.1%,政府与公共统计3.8%,学术只有8条占2.0%。全部外链里481个域名有63.4%只被引过一次,而带推广参数的65条链接中有52.3%没做任何标注。
一条数字给了出处链接,这件事只做对了一半。剩下那一半是:这条链接最后落在谁的服务器上。是发布这份数据的机构,是转述它的媒体,是卖相关工具的厂商,还是某个人在社交平台上随手写的一段话。
这四种落点在页面上长得一模一样,都是一段蓝字。但它们能提供的证据强度差着好几个量级。这一轮把落点全部拆开数了一遍。
一条出处链接指到最后,落在谁的服务器上?
两个分母,别混着看
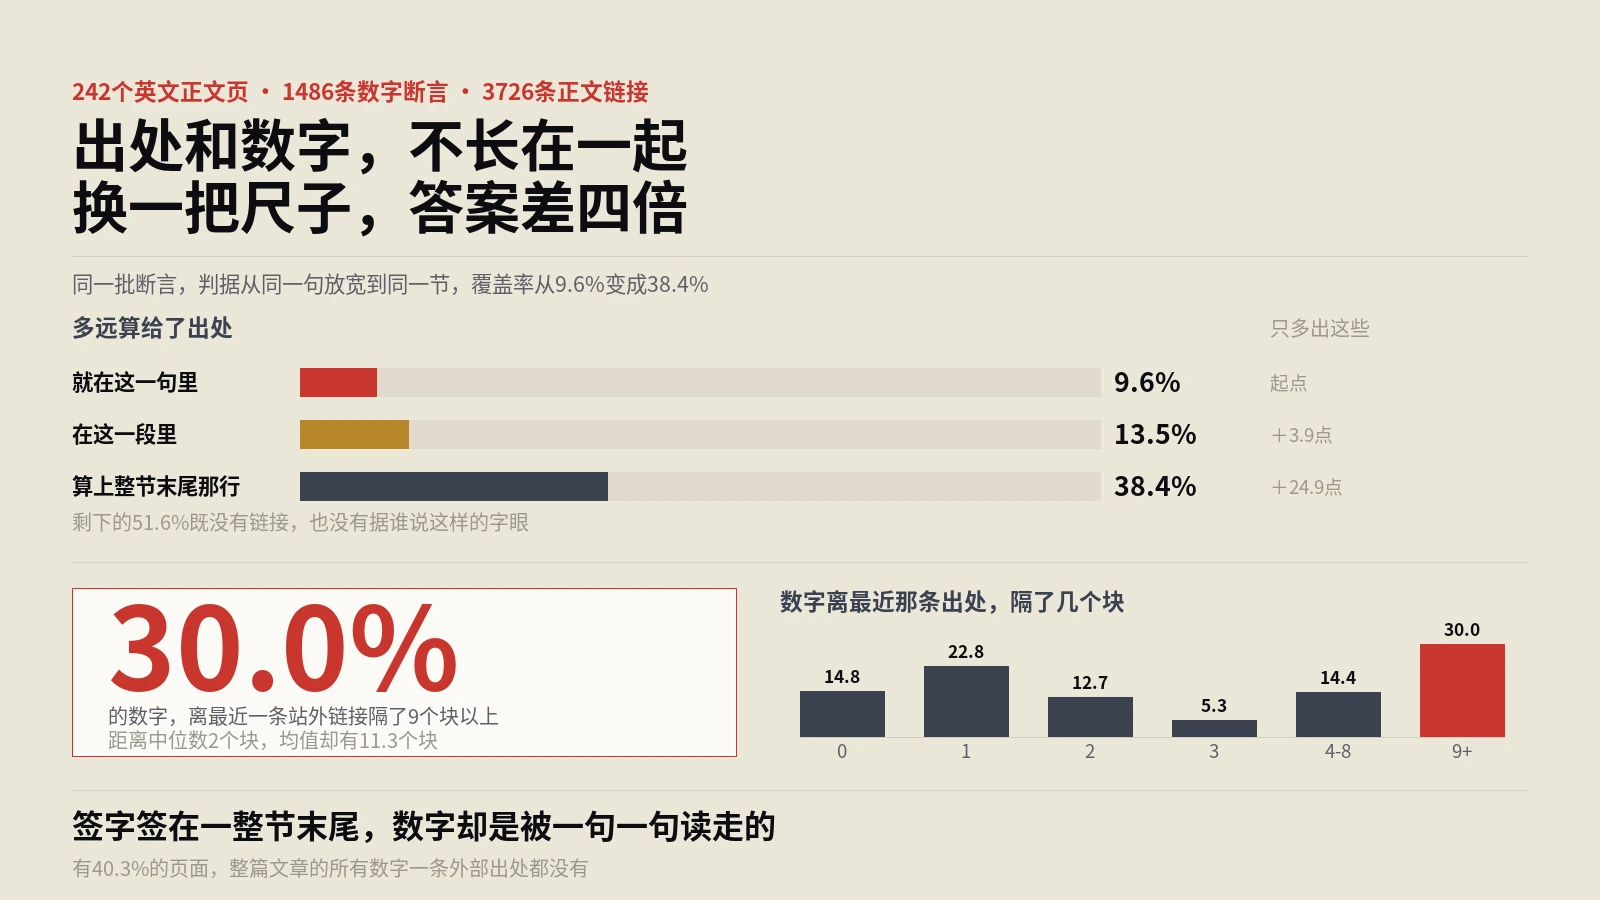
样本是242篇英文内容页,正文里一共3726条链接,其中站外的1597条。这1597条是第一个分母,它包含了作者顺手提到某个工具、某个案例、某个品牌时挂上去的链接,并不都在举证。
第二个分母窄得多:只取那些真正处在出处位置的链接,也就是和一条数字断言落在同一个块里的,或者出现在章节末尾那行Sources里的,去重之后392条。后面凡是讲“出处”的比例,用的都是这个分母。
八个桶怎么分
归类规则先说清楚,因为这一步的判断空间最大。被报道对象自己指的是平台与厂商发布的官方公告与文档;卖工具与卖服务的包括数据订阅、软件厂商,以及自研数据的代理与咨询公司;社交帖与个人频道按网址形态判定,比如领英的posts与feed路径、推特的状态页、Substack的单篇;学术看域名是不是教育机构、预印本库或期刊;政府与公共统计包括国际组织、统计局与标准组织;剩下认不出来的进未归类桶。
未归类那一档占了不小的比例,里面绝大多数是被举例的具体网站与小型机构,一次性出现。这一档不做过度解读,只如实报出来。
卖工具的占三分之一,学术只有八条,这个比例正常吗?
| 出处落在哪一类 | 条数 | 占392条 |
|---|---|---|
| 卖工具与卖服务的 | 131 | 33.4% |
| 未归类(多为被举例的具体站点) | 98 | 25.0% |
| 被报道对象自己 | 60 | 15.3% |
| 新闻媒体 | 55 | 14.0% |
| 社交帖与个人频道 | 24 | 6.1% |
| 政府与公共统计 | 15 | 3.8% |
| 学术 | 8 | 2.0% |
| 百科 | 1 | 0.3% |
卖工具与卖服务的这一档是学术的16.4倍。这不是说厂商数据不能用,很多行业指标只有厂商测得出来——只有他们手上有那个规模的抓取日志、点击流或者客户面板。问题在于,这类数据的口径、样本与时间窗全部由发布方自己定,而发布方同时是这个结论的受益者。
换成全部1597条站外链接来看,比例会变:卖工具与卖服务的26.2%、未归类25.4%、被报道对象自己24.6%、社交帖12.0%、新闻媒体6.2%、政府与公共统计3.8%、学术1.4%。被报道对象自己那一档从24.6%掉到15.3%,说明官方链接更多出现在叙述里,而不是出现在举证位置上。
这一层跟AI搜索的被引源榜单看的不是同一件事。那份榜单回答的是“机器最爱引谁”,这里回答的是“人在写文章时把举证责任交给了谁”。两个名单的重合度并不高。
学术那一档,三分之一指的不是论文
全部外链里进学术桶的22条值得拆开看:预印本库10条,某商学院7条,一所技校2条,另有政治学系、公共政策学院、新闻研究所各1条。而这22条里有6条指向的是某位教授的个人主页,另有2条指向一所学校的首页,都不是任何一篇论文。个人主页能证明这个人的头衔,证明不了他说过那句话。
指向预印本的那几条也有它自己的麻烦:链接落在摘要页上,而被引的百分比往往写在正文里,读者点过去看到的是一段两百词的摘要,得再下一次PDF才能核对。教育域名的权威性在链接建设那边是块金字招牌,在举证这边要打个折。
那个占四分之一的未归类桶,里面到底是什么?
八个桶里最大的一块争议在“未归类”,它在出处位置占25.0%,在全部外链里占25.4%,涉及343个域名。数量这么大,不说清楚整张表都不可信。
逐条翻过之后,它主要是四类。第一类是被当成例子的具体品牌站,比如讲某个策略时顺手链上一家做咖啡、做母婴用品、做户外露营的独立站,这类占了大头,几乎全部只出现一次。第二类是小型咨询公司与个人从业者的博客,作者引的是同行的观点或者一次小规模测试。第三类是各种一次性的工具页与在线服务,作者拿它举例说明某个功能。第四类才是真正的漏网机构,数量很少。
换句话说,这一桶里绝大多数根本不是出处,是插图。把它从分母里剔掉之后,其余七桶的相对关系不变,但卖工具那一档会从33.4%涨到四成以上。这就是为什么八个桶要连未归类一起报——藏起来会让结论更好看,也更不可信。
为什么被引最多的那个域名是搜索引擎自己?
按域名排,第一名是谷歌主域174次,出现在全部9个站上;第五名是谷歌的官方博客32次,出现在5个站上。两者相加超过第二名一倍。
这有它的合理性:搜索行业报道的对象就是搜索引擎,产品变更、官方声明、帮助文档,一手来源本来就在那里。但它也带来一个后果——整个行业最主要的事实来源,是同一个既做裁判又做运动员的机构。当官方文档改了措辞、下架了某个功能页,或者干脆把一份说明整页删掉,行业里所有引用它的文章会同时失去依据,而没有任何一篇会因此收到通知。
第二名是领英106次,出现在7个站上。这一条值得单独说。
各家依赖的头部来源完全不同
| 站 | 外链数 | 用到几个域名 | 最依赖的那一个 |
|---|---|---|---|
| 甲 | 468 | 139 | 一家数据订阅商占12% |
| 乙 | 287 | 64 | 搜索引擎官方占16% |
| 丙 | 223 | 126 | 搜索引擎官方占10% |
| 戊 | 206 | 109 | 自家母公司占16% |
| 庚 | 150 | 72 | 搜索引擎官方占18% |
| 己 | 126 | 37 | 领英占42% |
己站126条外链只用了37个域名,其中42%落在领英;甲站468条用了139个域名,头部只占12%。同样是做行业内容,一家的信息来源是一百多个机构,另一家是几十个人的社交动态。这两种做法产出的文章在版面上看不出差别。
一百零六条链接指向领英,其中三十九条是个人主页?
社交帖细分
| 平台 | 条数 | 出现在几个站 |
|---|---|---|
| 领英 | 103 | 6 |
| X | 25 | 6 |
| YouTube | 20 | 8 |
| Substack | 15 | 3 |
| Bluesky | 12 | 3 |
| 9 | 4 |
全部社交类落点191条,占1597条站外链接的12.0%。上表里的领英是103条,比按域名统计的106条少3条,因为有2条指向站点根地址、1条指向企业营销方案页,不算社交帖。
按平台内的路径形态再拆一层,领英那106条里,指向个人主页的39条,指向动态流的34条,指向单条帖子的29条,另有1条长文与2条根地址。也就是说,近四成的领英引用只是指到了一个人身上,没有指到他说的那句话上。
社交帖为什么会变成主要来源
原因不复杂:这个行业里很多第一手观察确实只发在社交平台上。一个人跑了个小实验、截了一张后台的图、注意到搜索结果页多了一个模块,他不会为此写一篇博客,就发一条动态。行业媒体要报道这件事,能引的只有那条动态。
问题不在引,在于引完之后什么都没留下。一手观点比汇总更值钱的前提是它能被归属、被复核;一条只有链接没有摘录的引用,等于把这两件事都押在平台的存档策略上。
帖子与主页是两种不同的证据
指向一条帖子,至少还有具体内容可看,尽管帖子随时可以被作者删改,而且没有版本记录。指向个人主页则连内容都没有——它证明的只是“这个人存在”,不构成对任何一个数字的支持。
更麻烦的是可达性。领英、Bluesky、Reddit这几个平台对非登录访问的限制一年比一年紧,从很多网络环境点过去根本打不开。同一条社区内容在不同AI引擎里被派不同角色那件事说的是机器怎么看待社交来源,这里说的是人:把一个数字的举证责任放在一条社交动态上,等于把它交给了一个随时可以撤回、且很多读者根本进不去的地方。
数据订阅商那一档,链接过去往往看不到那个数
卖工具与卖服务这一档里,有一个子类值得单拎出来:付费数据订阅商。有一个站的外链里,单是两家数据订阅商就占了21%,其中一家54次、另一家44次。
这类链接有一个共同特征:落地页上通常只有图表标题、一段说明和一个购买按钮,被引的那个具体数值藏在图表里或者登录之后。读者点过去,看到的是这个数确实由这家机构发布过,但看不到这个数是多少,更看不到它是怎么测的。
这不是链接的问题,是这类数据本身的商业模式决定的。要做的是在正文里把关键信息补齐:数值、口径、观测时间。行业基准的观测日期那件事讲的正是这一层,发布日期和测量日期是两个东西,而付费墙会把后者一起挡在外面。
同行之间几乎不互相引用
还有一个数值得记一笔:这9个站彼此之间的引用只有80条,占全部正文链接的2.1%。同一个行业、报道同一批事件、经常在同一天写同一条新闻,互引率却低到这个程度。
合理的解释有两个,多半同时成立。一是竞争关系,把读者送到对手站上没有好处;二是这类报道的一手来源本来就公开,谁都能直接引官方,不必经手同行。后果是同一件事被九个版本各自转述,而这九个版本之间没有任何显式的关联,读者也就无从判断哪一个版本更接近原始表述。
四百八十一个域名里,六成三只出现过一次
| 集中度 | 占1597条站外链接 |
|---|---|
| 前5个域名 | 25.9% |
| 前10个域名 | 34.1% |
| 前20个域名 | 43.6% |
| 前50个域名 | 58.4% |
头部很集中,尾部极长。481个域名里有305个只被引过一次,占63.4%,它们合计承载19.1%的链接。这条长尾里主要是三类:被当成例子的具体品牌站、小型咨询机构的博客、以及一次性的工具页。
长尾本身不是问题,问题是它和头部混在同一个筐里。用工具扒一遍链接结构时,报表会告诉你这篇文章有多少条外链、指向多少个域名,但不会告诉你其中一条指向国际电信联盟、另一条指向某家三人公司的博客。域名数量这个指标,把两种完全不同的证据算成了同一个单位。
正文外链里混着广告位,这件事有多常见?
先看标注
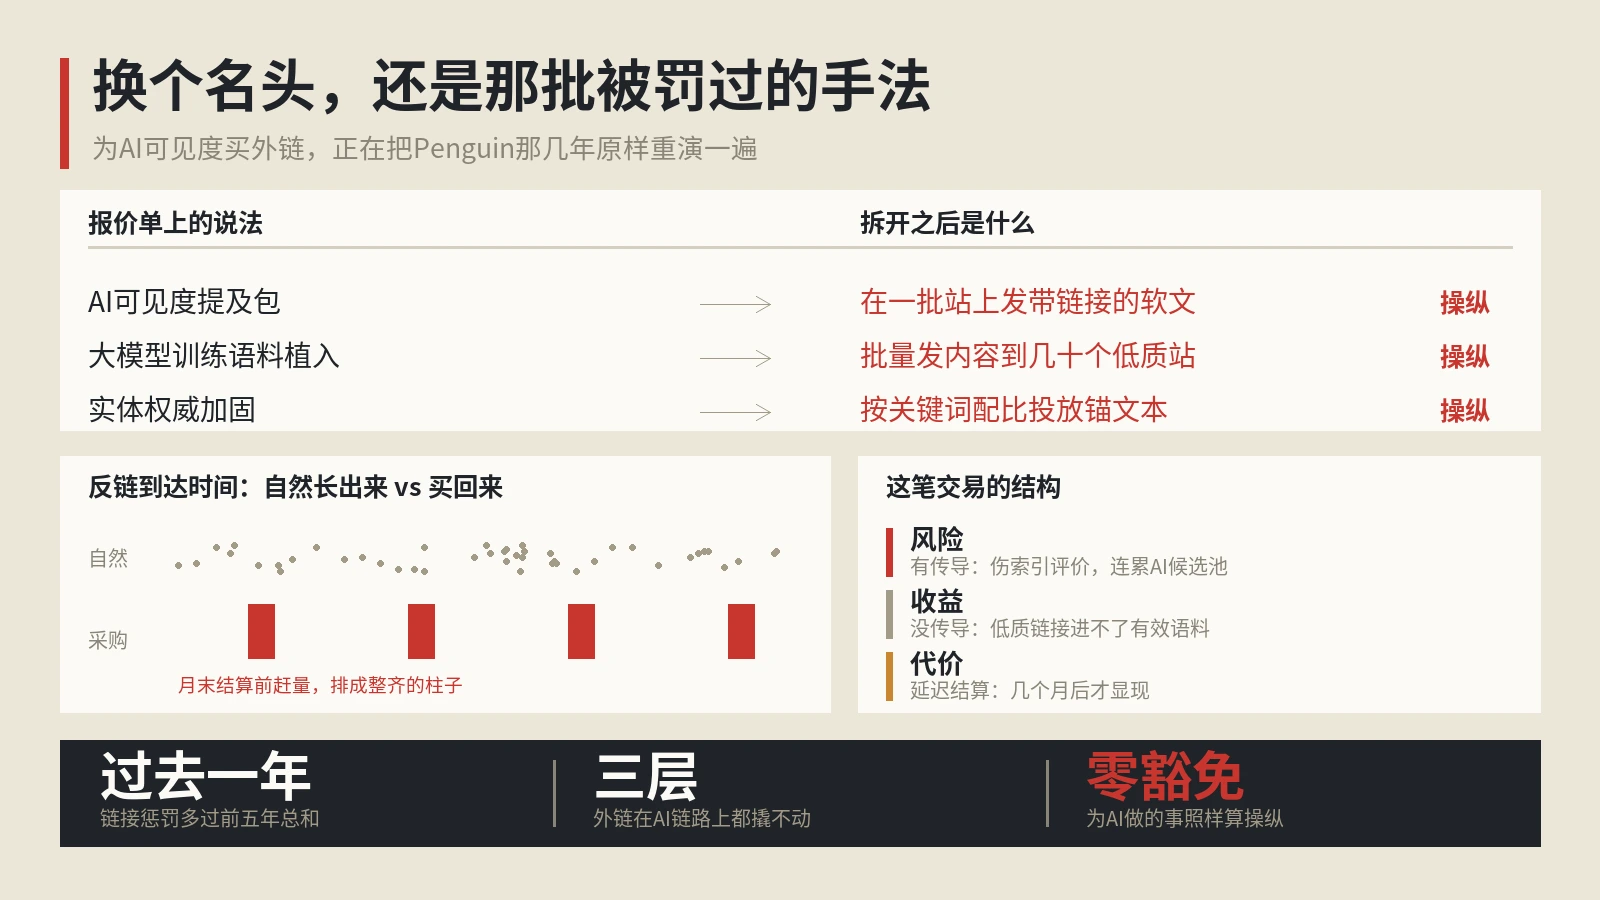
把1677条能与原始标签对上的站外链接的rel属性全部读出来,分布是这样的:只写noopener的42.6%,什么都不写的27.6%,写noreferrer noopener的15.4%,含nofollow的合计9.8%,含sponsored的2.6%,含ugc的0条。
三种限定值一个都没有的占87.6%。这个数本身不算问题,普通引用本来就不需要限定。真正要看的是带推广痕迹的那一批。
带推广参数的65条,一半没标
按网址里的推广特征筛选,比如联盟跟踪码、utm_medium写着affiliate或sponsored-article或cpc、以及形如/c/数字/数字/数字的联盟跳转路径,一共命中65条,来自6个域名。其中标了sponsored的31条占47.7%,标了nofollow的0条,什么都没标的34条占52.3%。
谷歌关于限定出站链接的文档写得很直白:广告或付费位置用sponsored,用户生成内容用ugc,其余不想产生关联的用nofollow。这份文档同时说明sponsored优于早年推荐的nofollow。垃圾内容政策里把未标注的付费链接列为链接垃圾的一种。也就是说,那52.3%不是风格问题。
还有自家公司的域名
有一个站的正文里出现了32条指向同一家营销服务公司的链接,而那家公司正是这个博客所属的机构。技术上它是站外链接,会被任何一个链接分析工具算成外链,实质上它是内链。付费外链那笔账算的是买链接的风险,这里说的是另一头:在自己的正文里,你分不清哪些外链是在举证,哪些是在导流。
同一页里挂了二十三次的那条链接,是出处吗?
把每一条链接按“页面加网址”配对去重,1597条压缩成1380对,也就是有14%的链接是同一页里的重复出现。重复4次以上的组合有21组,覆盖127条链接。
榜首是一条联盟跟踪地址,在同一篇文章里出现了23次,锚文本各不相同——有时是产品名,有时是“把提示词变成成交”,有时是“各自独立的系统”。第二名是一家公司的财报索引页,10次。第三名是一条领英帖子,7次。
23次同一个联盟链接,配23个不同的锚文本,这是广告位的写法,不是出处的写法。它同时会污染两个指标:外链总数,以及锚文本分布。做审计时如果不先按页面加网址去重,这一篇文章会显得引用极其丰富。
各家引谁,差别有多大?
按站拆开看构成,会发现同一个行业里的编辑规范几乎没有交集。
| 站 | 外链数 | 卖工具 | 对象自己 | 社交帖 | 新闻 | 学术 |
|---|---|---|---|---|---|---|
| 甲 | 468 | 35.9% | 18.6% | 6.4% | 15.0% | 0.2% |
| 乙 | 287 | 28.9% | 31.7% | 14.6% | 5.2% | 5.6% |
| 丙 | 223 | 24.2% | 24.2% | 6.3% | 4.5% | 0.4% |
| 戊 | 206 | 31.1% | 16.5% | 0.0% | 0.0% | 1.0% |
| 庚 | 150 | 12.7% | 42.0% | 5.3% | 0.7% | 0.0% |
| 己 | 126 | 15.9% | 10.3% | 52.4% | 0.0% | 0.8% |
己站有52.4%的站外链接指向社交帖与个人频道,是全场唯一超过一半的;庚站42.0%指向被报道对象自己,靠官方文档撑起举证;戊站的社交与新闻两项都是零,它的外链几乎全部落在工具厂商与自家案例上。
rel标注上的分化更极端:己站99.2%的站外链接带nofollow,而甲、丙、戊、丁四个站是0.0%,全部裸链。同一个行业,一半的站把每条外链都加限定,另一半一条都不加,两种做法都持续了很多年,也都没出过事。这个事实本身就说明,rel标注对排名的影响远小于行业传说,真正的意义在披露而不在权重,跟权重信号这些年的演变是一条线上的事。
这套分类自己怎么做?
先把出处位置和其他链接分开
这一步跳不过去。同一篇文章里,有的链接在举证,有的在举例,有的在导流,有的是广告。它们在HTML里长得完全一样,只有位置能区分:和数字断言同处一个块的,才承担举证功能。出站链接的权威传递那套老框架不区分这几种,因为它关心的是链接图,不是内容质量。
不要一上来就统计外链总数。先圈出数字断言,再看哪些链接和这些断言落在同一个块里,只有这部分需要按证据强度分类。剩下的链接归到导流与举例,不参与评估。
再按发布方的利益关系分档
不必套用这里的八个桶,最简的分法是三档:数据的产生方与结论的受益方是不是同一个、是不是有独立的方法学披露、能不能被第三方复核。三个问题全是“是”的放第一档,全是“否”的放第三档。这比按域名权威度打分实用,因为域名权威度量的是链接图,不是利益关系。
顺便量一下来源多样性
用两个数就够:外链总数除以独立域名数,得到平均每个域名被引几次;再看头部那个域名占了多少。前者超过3、后者超过30%,说明这篇内容的证据基本压在少数几家身上。这个指标比外链总数敏感得多,也比反链有没有进索引那类检查更贴近内容质量本身。
最后查一遍标注
把带推广参数的链接筛出来,逐条确认有没有sponsored。这一步用正则就能做,找irclickid、utm_medium=affiliate、以及联盟平台的跳转路径特征。为了可见度买链接这件事正在重演十几年前的剧本,而未标注的付费链接是其中最容易被抓到的一类。
知道了构成,能改哪些决定?
第一,选题阶段就能判断这篇文章的证据底子够不够。如果一个话题只有厂商数据,那就在文章里明说“目前只有厂商在测”,而不是把它写成行业共识。最佳实践清单那类内容翻车,多半就是把单一来源写成了公论。
第二,引社交帖时补一句上下文。写清楚是谁、什么时候、在什么场合说的,这样即使帖子被删,读者也还能追。一手观点越来越值钱的前提是它可归属,而不只是有链接。
第三,把自家域名的链接单独标出来,别混进外链统计。这一条对代理公司和有母公司的媒体尤其重要。
第四,凡是被引用超过三次的同一个域名,把它记下来。一篇文章反复引同一家,读者未必看得出;一个季度的内容全部反复引同一家,那就是这个团队的知识来源结构,值得开会说一说。同一个指标传出七个数字那次的教训正在这里:当所有人都从一个源头取数时,源头的口径变一次,全行业跟着变,而没有人会察觉。
第五,凡是带商业关系的链接,标注它。这件事的收益不在SEO,在于当读者发现你没标的时候,他会开始怀疑你没标的其他东西。结构化数据那一层也留了位置,schema.org的sponsor属性就是干这个用的,只是几乎没人填。
保哥去年帮一个做户外装备的独立站梳理内容资产时碰到过一个具体的例子。他们一篇讲市场规模的科普文引了三处数据,全部来自同一家做行业报告的厂商,而那家厂商同时在卖一份两千美元的报告。文章里没有任何一处说明这一点。后来的处理不是删掉数据,而是加了一句话:这三个数出自同一份商业报告,公开版本只给了摘要。加完这句话之后,这篇文章反而被两家海外行业站引用了。说清楚证据的边界,比假装没有边界更容易被信任。
最后提一句边界。这份构成来自9个站242篇近三个月的文章,样本偏新、偏英文、偏搜索营销这一个垂直领域。桶的划分有人工判断的成分,尤其是卖工具与被报道对象自己这两档之间——一家既做平台又卖工具的公司,两边都能放。这次的处理是按链接落地页的性质定,落在产品页归卖方,落在官方公告或文档归被报道对象。换一种处理,两档的比例会互相挪走几个百分点,但卖方与学术之间那个十几倍的差距不会变。
常见问题解答
做完这套分类,最该改的是哪一件事?
如果只改一件,改引社交帖的写法:把关键内容原样摘进正文,链接只当定位用。这条改动成本最低,收益最直接,而且它同时解决可达性与可归属两个问题。其余的改动都需要动编辑流程,这一条不用。
厂商发布的数据是不是就不能用?
能用,而且很多时候只有它能用。要做的是三件事:写清楚数据的产生方是谁、有没有公开方法学、样本口径是什么。读者判断可信度需要这三样,而不是需要你回避厂商数据。
学术出处只占2.0%,是不是说明行业不严谨?
不完全是。搜索营销这个领域大部分现象没有学术界在跟踪,学术论文的时效性也跟不上产品迭代。这个数字更适合读成一句提醒:当你看到一个被反复引用的行业结论时,它极可能从来没有被独立复核过。
指向官方文档的链接算强证据吗?
算,但要注意它会变。官方文档会改措辞、会下架功能页、会把整节删掉,而引用它的文章不会同步。引用时最好把关键句原样摘出来放进正文,这样即使目标页变了,读者还知道当时写的是什么。
怎么快速看出一条外链是不是广告位?
看三处:网址里有没有联盟跟踪码或utm_medium写着affiliate、sponsored、cpc;同一页里是不是重复出现多次;锚文本是不是和落地页的主题不完全对得上。三条中两条命中基本可以确定。
正文里的自家集团链接,要不要加nofollow?
不需要。nofollow解决的是不想产生关联的场景,自家链接反过来是希望被关联的。要做的是在统计口径上把它单列,别让它虚增外链数。
社交帖当出处,有没有补救办法?
有两个。一是在正文里把关键内容原样引述出来,链接只作为定位;二是同时给一份存档地址。前者更实用,因为存档服务本身也会失效。
为什么要把出处位置和普通外链分成两个分母?
因为两个分母得出的结论方向不同。全部外链里被报道对象自己占24.6%,只看出处位置就掉到15.3%;卖工具那一档反过来从26.2%涨到33.4%。混着算的话,你会以为官方文档是主要证据来源,实际上它更多出现在叙述里。
这份构成能代表中文内容生态吗?
不能直接搬。中文场景里社交帖的比例大概率更高,而政府与公共统计那一档反而更容易拿到。分类框架可以用,比例要自己测。
权威参考资料
本文标题:《引用来源实测392条:三分之一来自卖工具的,学术出处只有8条》
本文链接:https://zhangwenbao.com/citation-endpoint-composition-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0