llms.txt内容实测4.5万份:一半套着模板,53份整份链到测试站
本文目录
- 这次量的是什么,和之前那些研究有什么不同?
- 这4.5万份文件,是谁写的?
- 模板替站长写了些什么?
- Wix写的是一份接口说明书
- All in One SEO和Rank Math写的是一份站点地图
- Shopify写的是一份购物协议入口
- GoDaddy写的是一份卖域名的广告
- 给AI的站点介绍,和站点本身对得上吗?
- 还列着WordPress默认文章
- 还留着没替换的占位文字
- 整份清单指向测试站,是怎么发生的?
- 清单里的链接,点得开吗?
- 写在llms.txt里的规矩,爬虫认不认?
- 反过来,robots.txt挡着AI,却挂着给AI看的清单?
- 服务器返回的,真是一份llms.txt吗?
- 自己站上的llms.txt,按什么顺序查?
- 这次的尺子,哪几处会歪?
- “没有链接”是8.6%还是22.56%
- “开发域名”差点把Wix全算进去
- 一个分片能代表全量吗
- 602个站不是随机样本
- 常见问题解答
- 我的站是插件自动生成的llms.txt,要不要关掉?
- 在llms.txt里写禁止AI训练有用吗?
- robots.txt挡了AI爬虫,还需要llms.txt吗?
- Shopify店铺的llms.txt能改吗?
- 为什么llms.txt里会出现测试站的链接?
- Common Crawl的原始数据普通人能用吗?
- 权威参考资料
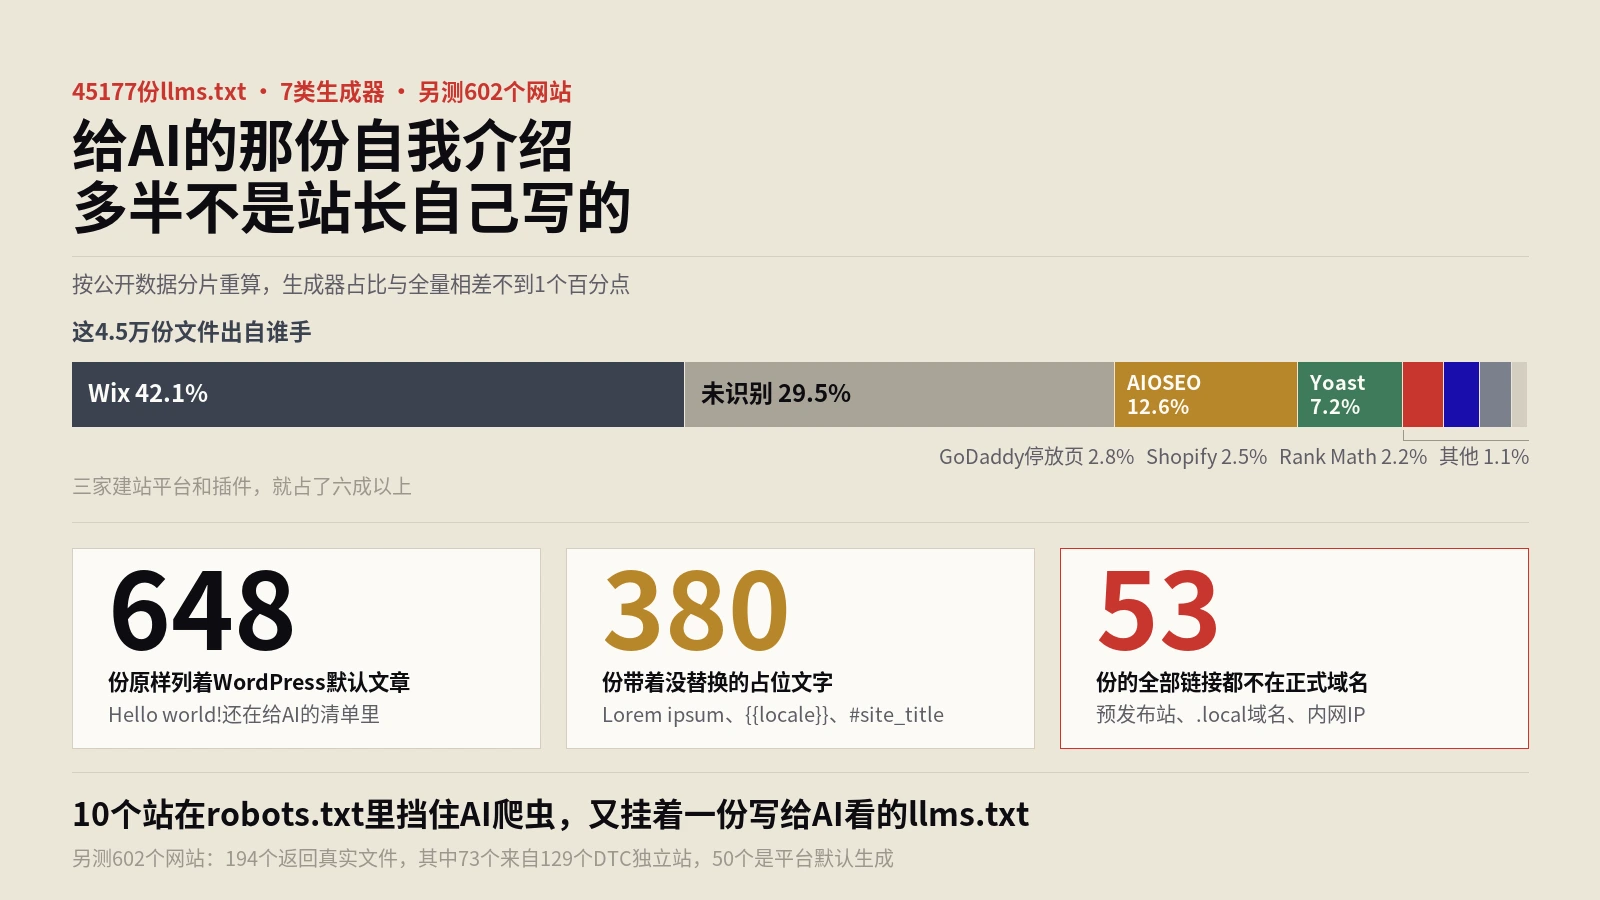
摘要:把Common Crawl公开的一个llms.txt分片重算了一遍,4.5万份文件里42.1%出自Wix,12.6%出自All in One SEO,按模板骨架归并,至少20份文件共用同一骨架的模板家族,合起来覆盖了一半文件。模板替站长写下的东西,很多和站本身对不上:648份原样列着WordPress默认的“Hello world!”,380份带着没替换的占位文字,53份的全部链接指向预发布站、本地开发域名或内网地址。另测602个网站,10个站一边在robots.txt里把GPTBot、ClaudeBot、CCBot挡在门外,一边挂着专门写给AI看的llms.txt。
llms.txt这件事,站内已经写过好几轮:10个站跑了90天看有没有被读取,生成器每个字段怎么填,校验器亮绿灯时漏掉了什么。这几篇问的都是“要不要做”和“怎么做对”。
这篇换个问法:已经挂在网上的几十万份llms.txt,里面到底写了什么,是谁写的。答案有点出乎意料,大多数文件的作者不是站长。
这次量的是什么,和之前那些研究有什么不同?
此前关于llms.txt的公开研究,量的基本是两件事:有多少网站发布了这个文件,以及有没有爬虫来请求它。一家工具商统计过13.7万个域名,28%发布了llms.txt,其中97%从来没被请求过。
Common Crawl在2026年7月的抓取批次里做了一次实验:把“/llms.txt”和“/llms-full.txt”加进一大批随机主机的抓取种子,记录返回了什么。最终记录了656万个地址的结果,近七成返回404,返回200且是纯文本或Markdown的文件有59.8万份,剔除空文件后58.4万份。它随后发布的内容分析第一次看的是文件里面写了什么。
这份数据的原始文件放在Common Crawl的数据仓库里,另在Hugging Face上按8个分片提供了表格格式。这次下载了其中一个分片,47426行,去掉llms-full.txt与空文件后是45177份llms.txt,自己重写了一套判据重算,重点补上Common Crawl没有展开的几件事:模板替站长写进去的内容和站点本身对不对得上,链接指向哪里,文件里写的规矩和robots.txt打不打架。
另外单独抓了602个网站的llms.txt和robots.txt做对照,其中129个是欧美DTC独立站,464个是SEO与营销类文章里经常被引用的站点。
这4.5万份文件,是谁写的?
先按文件开头的署名和结构特征认生成器。有的插件会在第一行写上“Generated by All in One SEO”,Wix的文件都带着同一个MCP接口地址,GoDaddy的停放域名文件开头就是“这个域名正在出售”。
| 生成器 | 本分片文件数 | 占比 | Common Crawl全量占比 | 链接数中位数 | 有摘要段的比例 |
|---|---|---|---|---|---|
| Wix | 19022 | 42.1% | 41.3% | 3 | 94.8% |
| 未识别 | 13312 | 29.5% | 33.8% | 14 | 73.7% |
| All in One SEO | 5698 | 12.6% | 12.5% | 135 | 0.0% |
| Yoast | 3234 | 7.2% | 6.9% | 21 | 84.0% |
| GoDaddy停放页 | 1280 | 2.8% | 2.5% | 0 | 99.9% |
| Shopify | 1139 | 2.5% | 未单列 | 5 | 9.8% |
| Rank Math | 973 | 2.2% | 2.1% | 84 | 0.0% |
分片的生成器占比和全量几乎一致,说明这个分片可以代表整体。三家建站或插件就占了六成以上的llms.txt。
“未识别”那三成也不全是手写的。把每份文件去掉标题、摘要、链接行,再抹掉网址、数字和非英文字符,剩下的骨架拿去比对,骨架相同就算同一个模板。结果是:最大的一个骨架家族占30.8%(Wix),前12个家族合计46.3%,所有至少20份文件共用的骨架加起来覆盖50.8%的文件。Common Crawl用署名加骨架两种方法合并估算,得出的模板化比例是68.27%。两个数口径不同,但指向同一个结论:大多数llms.txt是软件替站长写的。
这件事和robots.txt那87行出厂规则没人改过很像,但更进一步:robots.txt的出厂件至少是站长知道存在的文件,而llms.txt常常只是插件或建站平台里一个功能开关顺手生成的,站长未必意识到自己的站上多了这么一份对AI的自我介绍。
模板替站长写了些什么?
不同生成器对“llms.txt是什么”的理解差得很远,看文件就知道。
Wix写的是一份接口说明书
Wix的文件结构很规整:一个标题,一段摘要,一个首页链接,然后是一大段“AI代理访问”说明,告诉AI这个站支持MCP协议,列出站点搜索、获取商家信息、生成访客令牌、调用站点接口等工具,建议AI直接连接接口,不必抓取页面。本分片里46.5%的文件提到了MCP,几乎全是这个原因。
这份文件的主要目的不是给AI一份精选页面清单,而是把AI从抓网页引导到调接口。18967份文件里都链着同一个Wix开发者文档地址。
All in One SEO和Rank Math写的是一份站点地图
这两个插件生成的文件,有摘要段的比例都是0,链接数中位数分别是135条和84条,第一个分区通常就是“Sitemaps”。它们把llms.txt理解成了网站地图的Markdown版本:把文章、页面、分类全列出来。提案原本想要的是“一小份精选清单”,这里变成了“全部清单”。
Shopify写的是一份购物协议入口
1139份Shopify文件里,1001份都链向同样两个地址:Shopify自家的购物应用和一个通用商务协议的站点,而90.2%的文件没有一条列表式的页面链接。这和Shopify默认上线agents.md是同一个思路,平台在替所有店铺统一接入AI购物代理的那套协议。
GoDaddy写的是一份卖域名的广告
停放域名的文件结构合规率接近100%:标题、摘要一应俱全,内容是“本域名在售,可一口价、可议价、可租赁”。Common Crawl的原话很精辟:一份只有推销话术的文件,照样能通过我们能写出的每一项结构检查。
四种写法放在一起,就能理解为什么选哪个SEO插件现在还多了一个副作用:你选的不只是标题和结构化数据怎么输出,还有你的站对AI怎么介绍自己。
给AI的站点介绍,和站点本身对得上吗?
模板写得规整,不代表写对了。这一节只数那些一眼就能判定“这不是这个站该有的内容”的情况。
还列着WordPress默认文章
WordPress装好之后自带一篇叫“Hello world!”的示例文章和一个“Sample Page”示例页面。本分片有648份llms.txt原样列着“Hello world!”,511份列着“Sample Page”。按生成器看,All in One SEO的文件里有6.7%列着这篇示例文章。
这类文件的典型样子是:标题是域名,分区是“Posts”,底下唯一的一条就是“Hello world!”,描述是“欢迎使用WordPress,这是你的第一篇文章,编辑或删除它,然后开始写作吧”。这里面有两种站:一种干脆停在了建站第一天,除了示例什么都没发;另一种正式内容早就上线了,那篇示例却一直没删,于是和真文章一起被列进了给AI的清单。
还留着没替换的占位文字
380份文件带着明显的占位内容。最多的是排版用的假文“Lorem ipsum”,一共出现1217次;再就是花括号变量没被替换,比如“{{locale}}”“{{city}}”“{{country}}”,以及“[Your privacy]”这种方括号提示。
在单独抓的602个网站里还看到一份很典型的:一家PPC代理机构的llms.txt由Rank Math生成,第一行标题直接是“# #site_title”,插件应该替换成站名的那个变量原样写了进去,底下的文章列表却是最新的,写着8月才发的广告出价改动。说明文件在持续更新,只是标题这一行从来没人看过。
整份清单指向测试站,是怎么发生的?
这是这次重算里最意外的发现。
本分片有53份llms.txt的全部链接都不在正式域名上,指向的是预发布环境、本地开发域名或者内网地址;另有25份部分链接是这样。按生成器分,Yoast 24份、All in One SEO 22份、未识别7份。挑几个有代表性的形态:
| 链接指向的主机形态 | 含义 | 本分片里的例子(主机名已脱敏) |
|---|---|---|
| ……stg.wpenginepowered.com | 托管商分配的预发布站 | 一个加盟招商站,34条链接全部指向它 |
| dev-…….pantheonsite.io | 托管商的开发环境 | 一个国际公益倡议组织的站,703条链接全部指向它 |
| …….local | 本地开发工具生成的域名 | 一个慈善组织的法语站,48条 |
| wordpress-……cloudwaysapps.com | 云主机的临时域名 | 一个家居站,228条 |
| 172.24.x.x:31817 | 内网地址加端口 | 一个媒体站,229条 |
| localhost:3000 | 开发者自己的电脑 | 一个小型品牌站,4条 |
成因不难猜。站点在预发布环境里搭建时装了插件,插件按当时的站点地址生成了llms.txt,要么写成了静态文件,要么缓存了下来;迁到正式域名之后,数据库里的地址被批量替换了,这份文件却没有跟着重生成。
后果有两层。第一,AI按这份清单去取页面,要么打不开,要么打开的是没人维护的测试站。第二,预发布子域名本来就经常忘了设noindex,现在又被正式站亲手写进了一份“推荐AI阅读”的清单,等于把测试环境的地址主动公布出去。预发布站被收录之后清理有多麻烦,做过迁移的人都有体会。
两类加起来占本分片的0.17%,比例不高。但它有一个特点:生成它的插件和校验它的工具都不会报错,只有顺着链接点过去才知道。
清单里的链接,点得开吗?
从本分片有链接的文件里随机抽了约1.2%,每份最多取3条,共1539条链接,在2026年9月13日逐条请求。第一轮4个线程并发,所有非200的再换成单线程、完整浏览器请求头重测一遍,重测翻回来11条。
| 最终结果 | 条数 | 占1539条 |
|---|---|---|
| 正常返回200 | 1216 | 79.0% |
| 401要求登录或令牌 | 235 | 15.3% |
| 404不存在 | 42 | 2.7% |
| 403拒绝访问 | 21 | 1.4% |
| 连不上 | 17 | 1.1% |
| 429请求过多及其他 | 8 | 0.5% |
那235条401全部来自Wix的文件,指向的是它写进每份文件的那个MCP接口。接口本来就要令牌才能调用,算不上坏链;但对一个只会按清单去取网页的AI来说,清单里第一条“推荐资源”就是一扇锁着的门。
把Wix这部分拿掉,剩下828条链接里200占89.7%,404占4.7%。按生成器拆开,差别很明显:
- 未识别的文件(大多是手写或小众工具生成的)385条里404有30条,死链率7.8%;
- All in One SEO 246条里404有5条,2.0%;
- Yoast 113条里404有2条,1.8%;
- Shopify 24条全部200。
这和前面几节正好形成对照。插件是从数据库实时生成清单的,文章删了清单就跟着少一条,所以死链少,它的毛病是写错内容;手写的清单写完就不动了,页面改了地址、下线了,它都不知道,毛病是跟不上变化。另有6条跳到了别的域名,5条原本指向具体页面、最后落在了首页。
要注意,这批文件是7月抓到的,链接是9月请求的,中间隔了两个月左右,一部分404可能是这两个月里才坏掉的。但对读这份清单的AI来说没有区别,它拿到的就是现在这份。
写在llms.txt里的规矩,爬虫认不认?
Common Crawl的全量统计是,6.59%的llms.txt写着提案里根本没有的政策性内容:频率限制、版权声明、要求引用署名,写法五花八门,有散文段落,有类似配置文件的权限块,有照抄robots.txt语法的,也有混着写的。
本分片用自己的判据数了一遍:
| 写进llms.txt的内容 | 文件数 | 占比 |
|---|---|---|
| 提到许可或授权 | 1869 | 4.14% |
| 频率限制或抓取间隔 | 1211 | 2.68% |
| 版权声明 | 1111 | 2.46% |
| 要求引用或署名 | 112 | 0.25% |
| 点名具体爬虫 | 76 | 0.17% |
| 直接写了User-agent这类robots.txt语法 | 41 | 0.09% |
| 禁止用于训练 | 29 | 0.06% |
这些话写在llms.txt里没有任何约束力。llms.txt的提案只规定了文件结构,没有定义任何访问控制;Common Crawl在报告里说得很直白:这个文件不授予任何权限,也不阻止任何访问,没有哪个爬虫有义务读它。CCBot的说明页写明它遵守的是robots.txt。
Common Crawl还专门核对了全量里32份声称禁止CCBot的llms.txt,去抓了这32个站的robots.txt:能核对的31个站里,没有一个在robots.txt里真正挡住CCBot。其中一个站的llms.txt里有一节标题叫“AI爬虫访问(截至2026年6月的robots.txt状态)”,把CCBot列在“已屏蔽”下面,而它真实的robots.txt里根本没提CCBot,用通配规则放行了所有爬虫。报告的评价是:这份文件不是政策,是对政策的描述,而描述已经和它描述的东西脱节了。
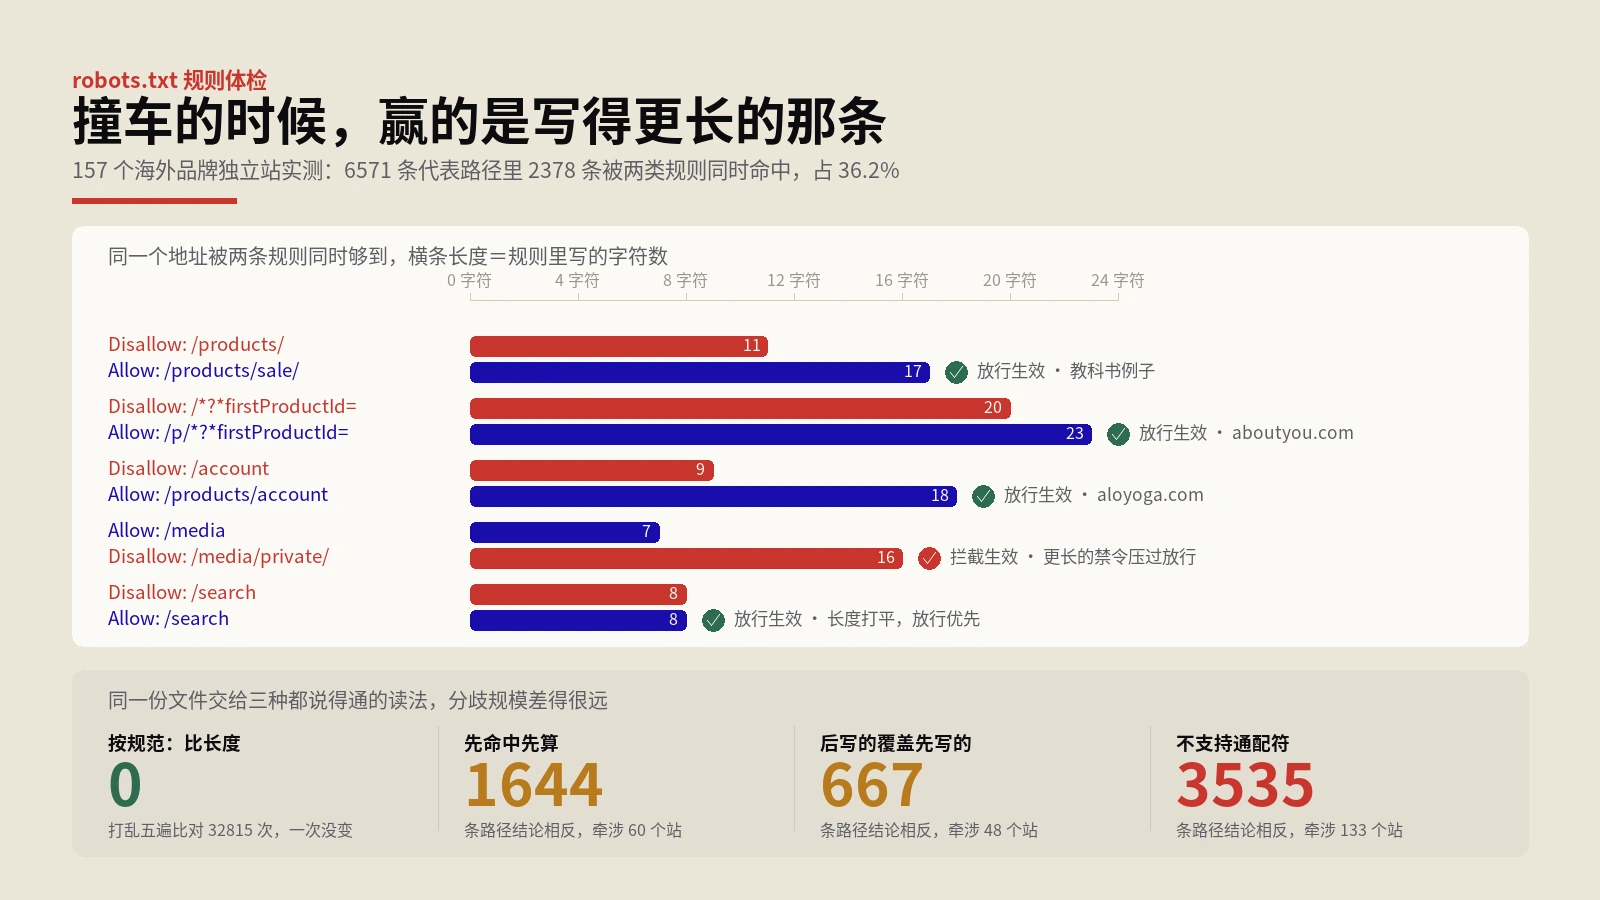
想挡哪个爬虫,规则只能写在robots.txt里。robots.txt的规则怎么匹配、两条规则撞车时谁赢,按的是机器人排除协议的规范文本,不是llms.txt里的一句话。
反过来,robots.txt挡着AI,却挂着给AI看的清单?
Common Crawl查的是“llms.txt说挡、robots.txt没挡”。在单独抓的602个网站里,看到的是另一个方向的矛盾。
602个站里有194个返回了真正的llms.txt。其中10个站的robots.txt在根目录挡着AI爬虫:8个站同时挡了GPTBot、ClaudeBot、Google-Extended和CCBot,另外2个站只挡了CCBot。这10个站里有本地营销软件公司、广告行业协会、科技媒体和一家眼镜品牌。
也就是说,这些站一边在robots.txt里对这几个AI爬虫说“整站都不许进”,一边在根目录放了一份文件,标题写着站名,摘要写着公司是做什么的,底下列着“供大模型阅读的Markdown版本”。有一家的llms.txt开头还特意写着“以下链接是本站页面的首选大模型可读版本”。
两份文件多半出自不同的人。robots.txt里那几段AI爬虫屏蔽规则排列整齐、成组出现,其中两个站连顺序都一样,还夹着同一个云服务商渲染爬虫的名字,更像是托管平台或CDN一键功能写进去的;llms.txt则像是后来市场或SEO团队为了做GEO加上去的。托管主机悄悄替你拦了AI爬虫那篇说的就是前一半,这10个站把两半拼在了一起。
还有一种小一点的矛盾:llms.txt推荐的页面,robots.txt不让抓。194份文件里有5份出现这种情况,最多的一个站列了797条链接,其中358条落在分类等目录下,而它的robots.txt对所有爬虫写着禁止抓取这些目录。清单是插件按全站内容生成的,robots.txt是人按SEO需要写的,两边从来没对过账。
服务器返回的,真是一份llms.txt吗?
拿到状态码200,不等于拿到了文件。
Common Crawl的全量里,返回200的响应中40.36%的内容类型是HTML,最常见的成因是单页应用的兜底路由:服务器对任何不认识的路径都返回应用外壳;另有10.61%被识别为robots.txt,也就是站点在llms.txt的地址上直接返回了robots.txt的内容。
602个站的实测里,返回200的230个地址中,35个拿到的是网页外壳,占15.2%,这批站里有几个大型电商平台和社交平台,也有两个AI聊天产品自己的官网,空壳页面让爬虫读不到正文是同一类问题;一个都没有出现“把robots.txt当llms.txt返回”的情况。
跳转也值得看。有的站把llms.txt跳到了结账子域名下,有的跳到了公司主页,有的跳到了静态资源存储桶里一个带时间戳的文件地址,还有一个短链接服务把“llms.txt”当成了视频编号,跳去一个播放页。这些都返回200,可跳到主页和播放页的那几个,拿到的根本不是清单;只看状态码的检查工具会把它们全部记成“有llms.txt”。
DTC独立站这一组的情况单独说一句:129个站里73个有真正的llms.txt,比例远高于Common Crawl随机样本的11.72%,这73个里有50个是Shopify默认生成的。换句话说,一个Shopify店铺即便从来没考虑过llms.txt,它也已经在对AI说话了,说的是平台统一写好的那几句。
自己站上的llms.txt,按什么顺序查?
把上面几类问题收成一张检查单,按从便宜到贵的顺序排。
- 先确认有没有、是不是它。在命令行执行
curl -sI https://example.com/llms.txt(换成你的域名),看状态码和内容类型;再看正文前几行,是Markdown标题还是HTML标签。返回的是网页外壳,说明你以为有、其实没有。 - 看第一行署名。有“Generated by”字样的,记下是哪个插件哪个版本;没有署名的,打开建站后台找有没有自动生成llms.txt的开关。知道作者是谁,才知道以后改哪里。
- 全文搜四样东西:Hello world、Sample Page、Lorem ipsum、花括号或井号开头的变量名。任何一样命中,说明文件是按模板生成后没人看过。
- 把所有链接的主机名去重列出来。除了正式域名和你确实想推荐的第三方,出现wpengine、pantheonsite、cloudways、.local、localhost、IP地址的,立刻重生成。
- 拿robots.txt对一遍。先看根目录有没有挡GPTBot、ClaudeBot、Google-Extended、CCBot这几个;挡了,就想清楚这份llms.txt到底写给谁看。再把清单里的链接逐条套一遍robots.txt规则,列出被禁止抓取的。
- 如果llms.txt里写了“禁止某爬虫”“请勿用于训练”这类话,确认robots.txt里有对应规则;没有的话,要么补上规则,要么删掉这句话,别让描述和实际不一致。
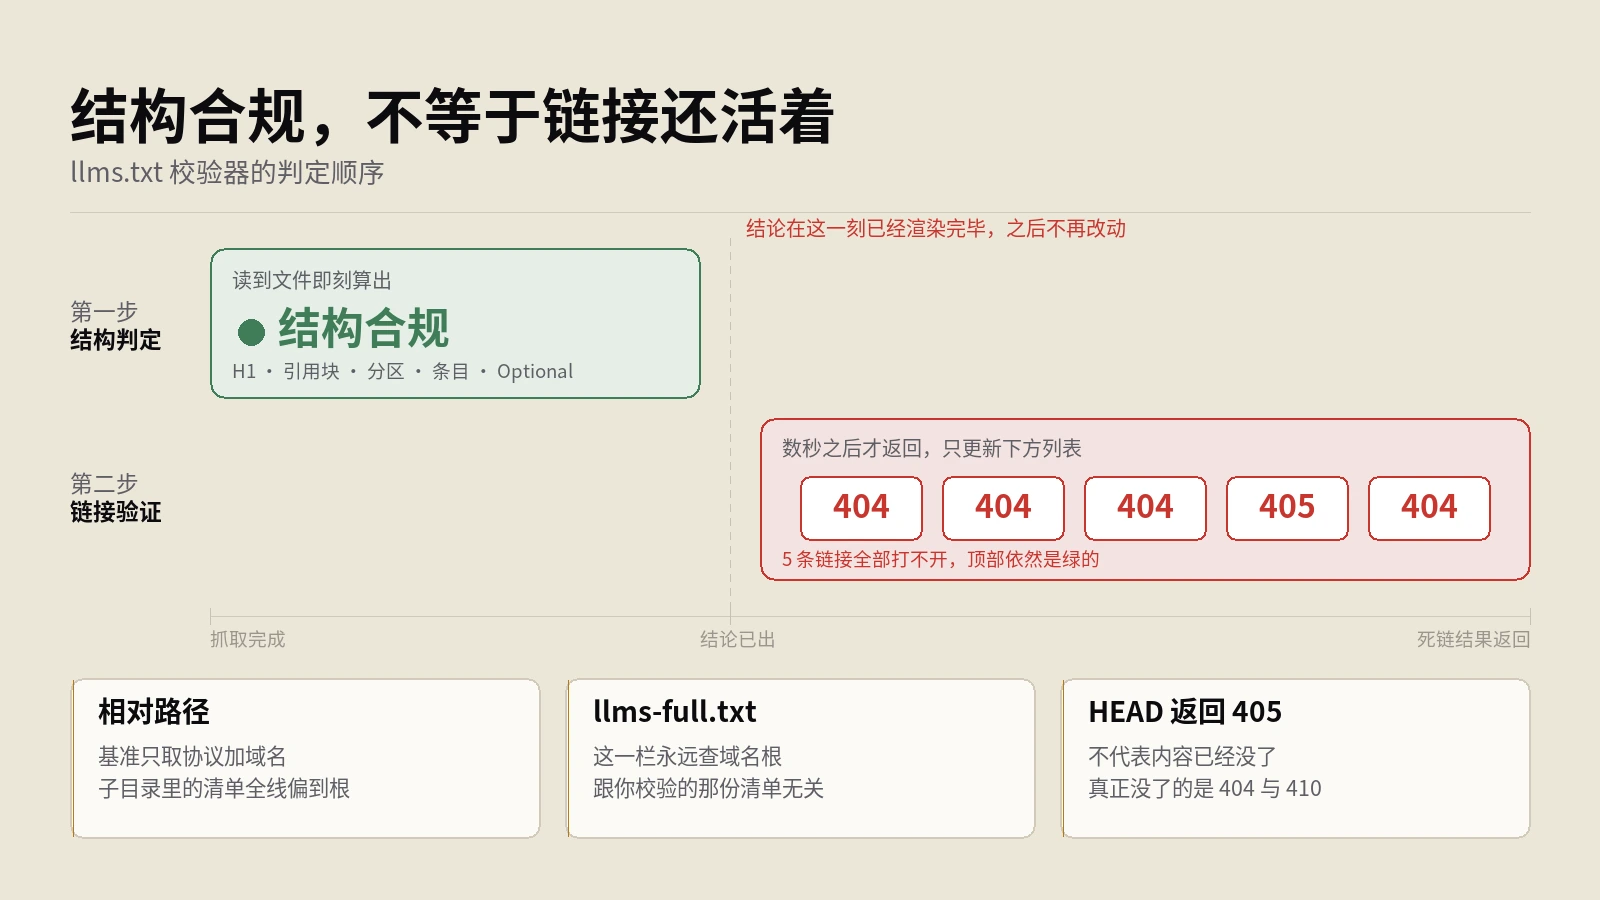
- 链接逐条点一遍,记下404和跳转,前面提到的校验器能替你做一部分,但它不查主机名是不是测试站。
- 写进迁移与改版的检查表。换域名、换主题、从预发布环境上线,这三个时刻都要重生成一次llms.txt。
做完这一遍,再回头决定要不要保留这份文件。按谷歌目前的口径,搜索不需要它,而一份写错的llms.txt,至少不比没有更好。
这次的尺子,哪几处会歪?
重算过程中踩到的几处口径问题,直接影响结论的读法,一并交代。
“没有链接”是8.6%还是22.56%
Common Crawl报告里22.56%的文件没有链接,这次重算只有8.6%。差别在判据:只要文件里出现任何Markdown链接就不算“没有链接”,得到8.6%;只数提案要求的“列表项里的链接”,得到11.58%。剩下的差距来自报告自己的判据细节,文中没有展开。Shopify的文件是个好例子,它有链接,但90.2%没有列表式链接,按哪个口径算,结论完全相反。
“开发域名”差点把Wix全算进去
第一版判据把以dev开头的主机都当成开发环境,结果42.18%的文件被判为链接到了开发站,因为几乎所有Wix文件都链着Wix的开发者文档站。剔除这类文档站之后,数字降到0.17%。一个前缀规则差点把最大的生成器整个误判。
一个分片能代表全量吗
生成器占比与全量的差距都在1个百分点左右(未识别类差4个点,是因为自己的识别规则比报告多认出了Shopify、Hostinger、GitBook几家),可以认为分片不偏。但Common Crawl的样本本身只是“它能顺利抓到的主机”,不等于整个网络,这一点报告自己也写明了。
602个站不是随机样本
这批站是DTC品牌和营销文章里高频被引用的站点,比普通网站更可能有专人维护SEO,所以里面出现的矛盾,放到普通网站上大概率不会更少。10个站这个数只说明这种矛盾真实存在,不能外推成比例。
常见问题解答
我的站是插件自动生成的llms.txt,要不要关掉?
先按文中的检查单查一遍。没有示例文章、占位文字、测试站链接,也不和robots.txt打架,留着问题不大;只要命中其中一项,要么重生成,要么关掉。关掉之后确认那个地址返回404,而不是网页外壳。
在llms.txt里写禁止AI训练有用吗?
没有约束力。llms.txt的提案不包含任何访问控制,主流爬虫遵守的是robots.txt。想限制哪个爬虫,规则要写进robots.txt;llms.txt里如果提到了,内容要和robots.txt保持一致。
robots.txt挡了AI爬虫,还需要llms.txt吗?
两者是矛盾的。挡住了爬虫,它就读不到这份清单,也读不到清单指向的页面。先决定你对AI爬虫的整体立场,再决定要不要这份文件,别让两个团队各写各的。
Shopify店铺的llms.txt能改吗?
平台默认生成的内容主要是购物协议相关的入口。能不能覆盖、覆盖到什么程度,取决于主题和应用的支持情况,改之前先看清楚当前文件的每一行是谁写进去的,避免把平台接入AI购物代理所需的部分删掉。
为什么llms.txt里会出现测试站的链接?
最常见的原因是站点在预发布环境搭建时,插件按当时的地址生成了文件,迁移到正式域名后没有重新生成。检查办法是把文件里所有链接的主机名去重列出来,出现托管商临时域名、本地域名或IP地址的,都需要重生成。
Common Crawl的原始数据普通人能用吗?
能。数据按分片提供表格格式文件,单个分片几百兆到一点几个G,本机用DuckDB就能直接查询,不需要写复杂的解析程序。每条记录带着原始网址,可以回到线上核对文件现在的样子。
权威参考资料
本文标题:《llms.txt内容实测4.5万份:一半套着模板,53份整份链到测试站》
本文链接:https://zhangwenbao.com/llms-txt-content-authorship-audit.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0
← 上一篇
正文里的缩写实测176种:在同一页上解释过的只有三分之一下一篇 →
没有了