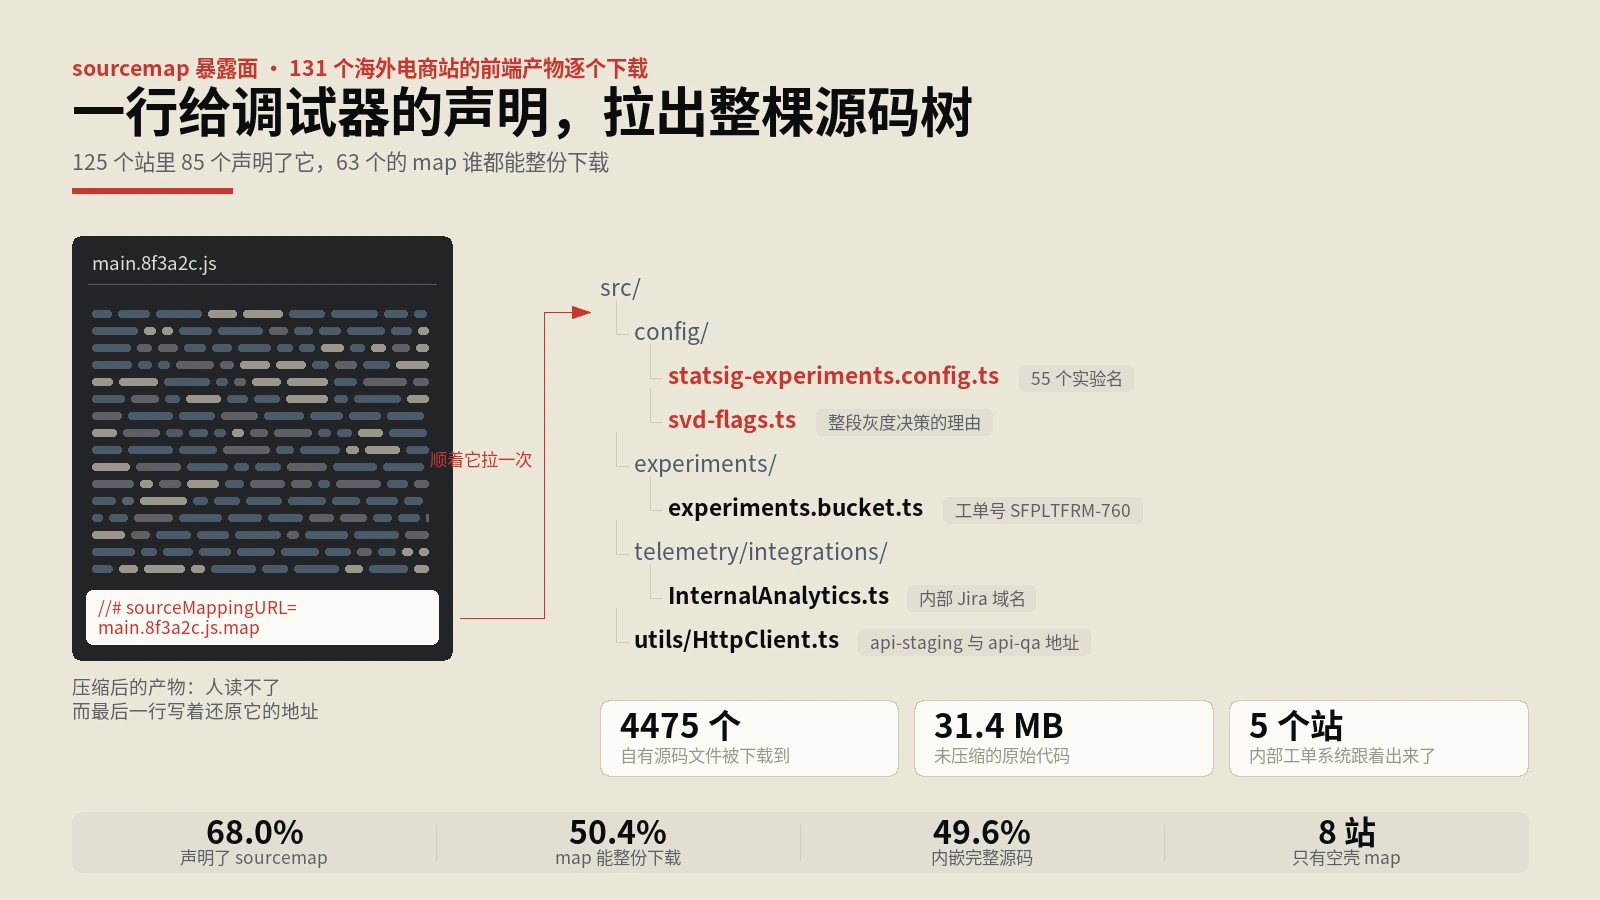
sourcemap文件谁都能下,里面是55个还没上线的实验名
对131个海外电商站首页引用的JS与CSS逐个下载,在文件尾部搜sourceMappingURL声明,顺着声明拉map并解析;用正文首字节而不是状态码判真伪,剔掉单页应用的兜底首页和只有29字节的空壳map,最后把拿到的自有源码全文扫一遍工单链接、非生产域名与实验配置。五道尺子全部修过一遍。
标签
保哥笔记 技术SEO 标签下共 50 篇文章合集,含《技术SEO一堆问题先修哪个?500站实测排出来的优先》《Core Web Vitals在AI搜索时代还值不值》《电商SEO最重要的5点:从AI爬虫到accessib》等,与 Core Web Vitals、AI爬虫、结构化数据 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
对131个海外电商站首页引用的JS与CSS逐个下载,在文件尾部搜sourceMappingURL声明,顺着声明拉map并解析;用正文首字节而不是状态码判真伪,剔掉单页应用的兜底首页和只有29字节的空壳map,最后把拿到的自有源码全文扫一遍工单链接、非生产域名与实验配置。五道尺子全部修过一遍。
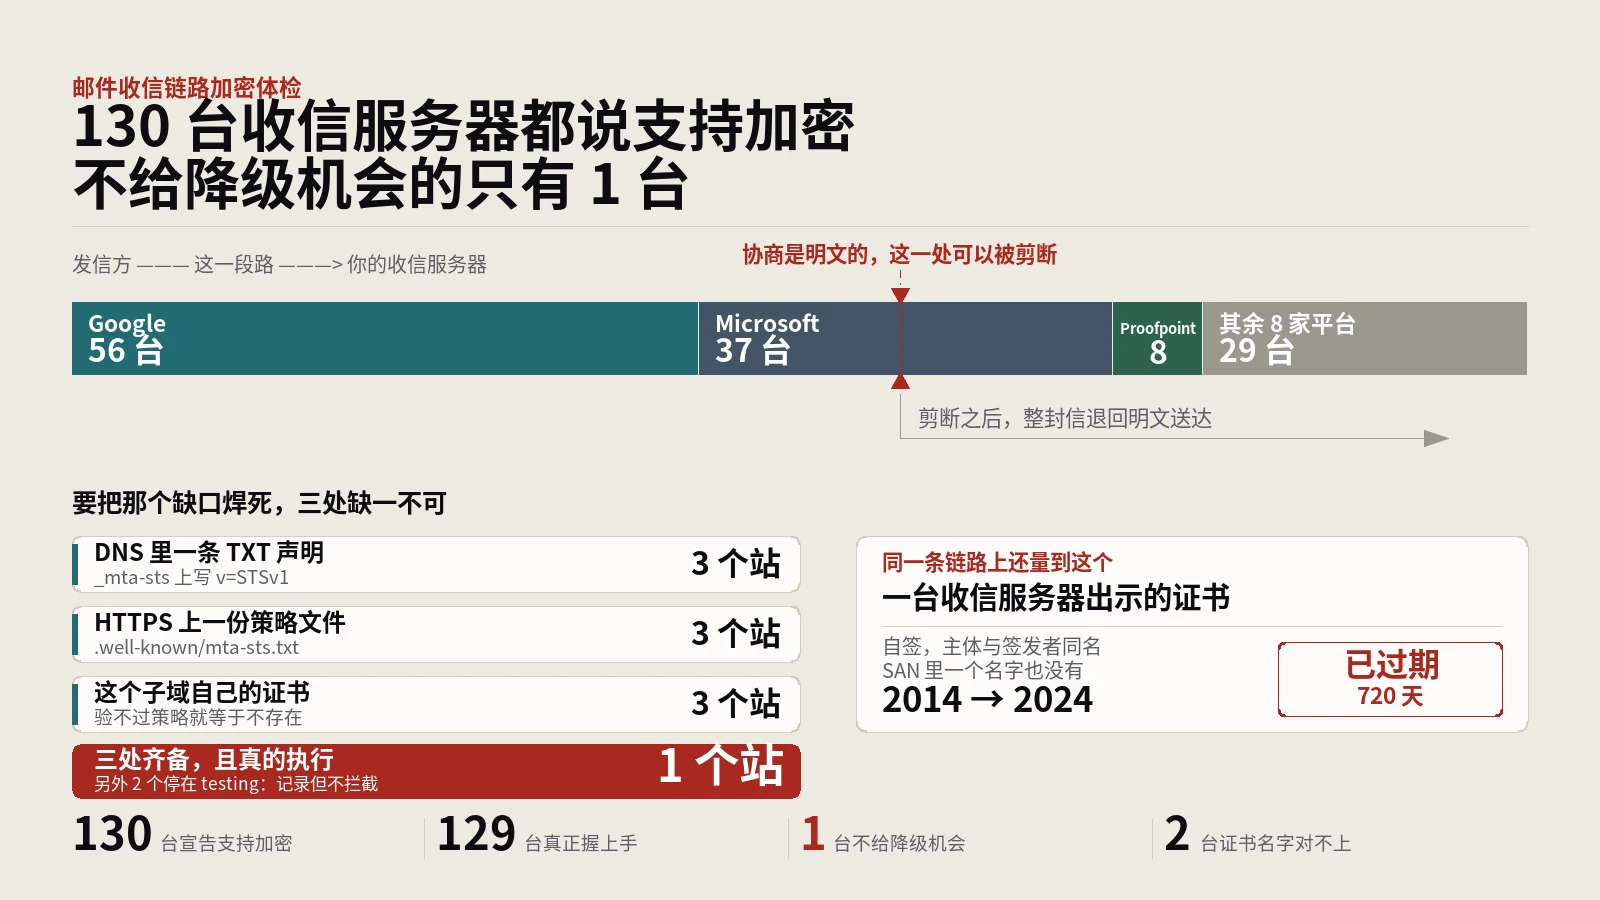
逐台连上130个大牌域名的收信服务器25端口,EHLO看能力清单、STARTTLS握手取证书,再逐张比对主机名在不在SAN里;同时用DNS over HTTPS查MTA-STS声明与TLS-RPT回执地址,抓HTTPS上的策略文件做三处对账。四把尺子中途改过,其中两把改变了结论方向。
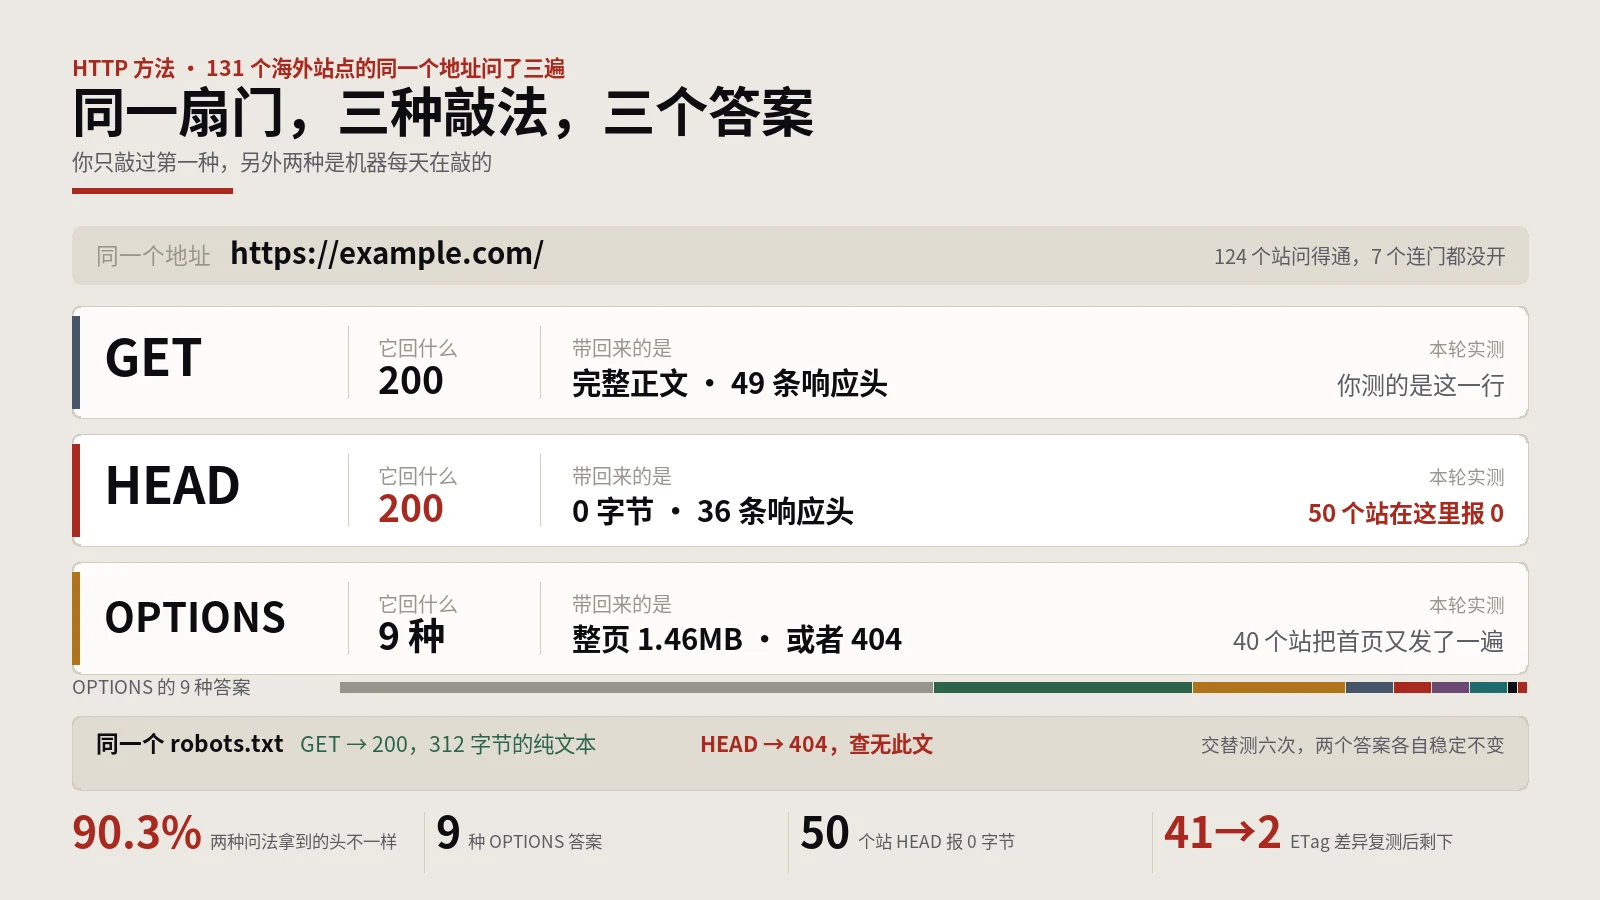
对同一个首页地址依次发GET、HEAD、OPTIONS,记录状态码、全部响应头、正文字节与耗时,再往下测一层内页、一个静态资源和robots.txt;被拦的站打乱顺序多轮重试,把分母从84做回124。五把尺子中途改过,其中ETag那把把41个站的结论砍成了2个。
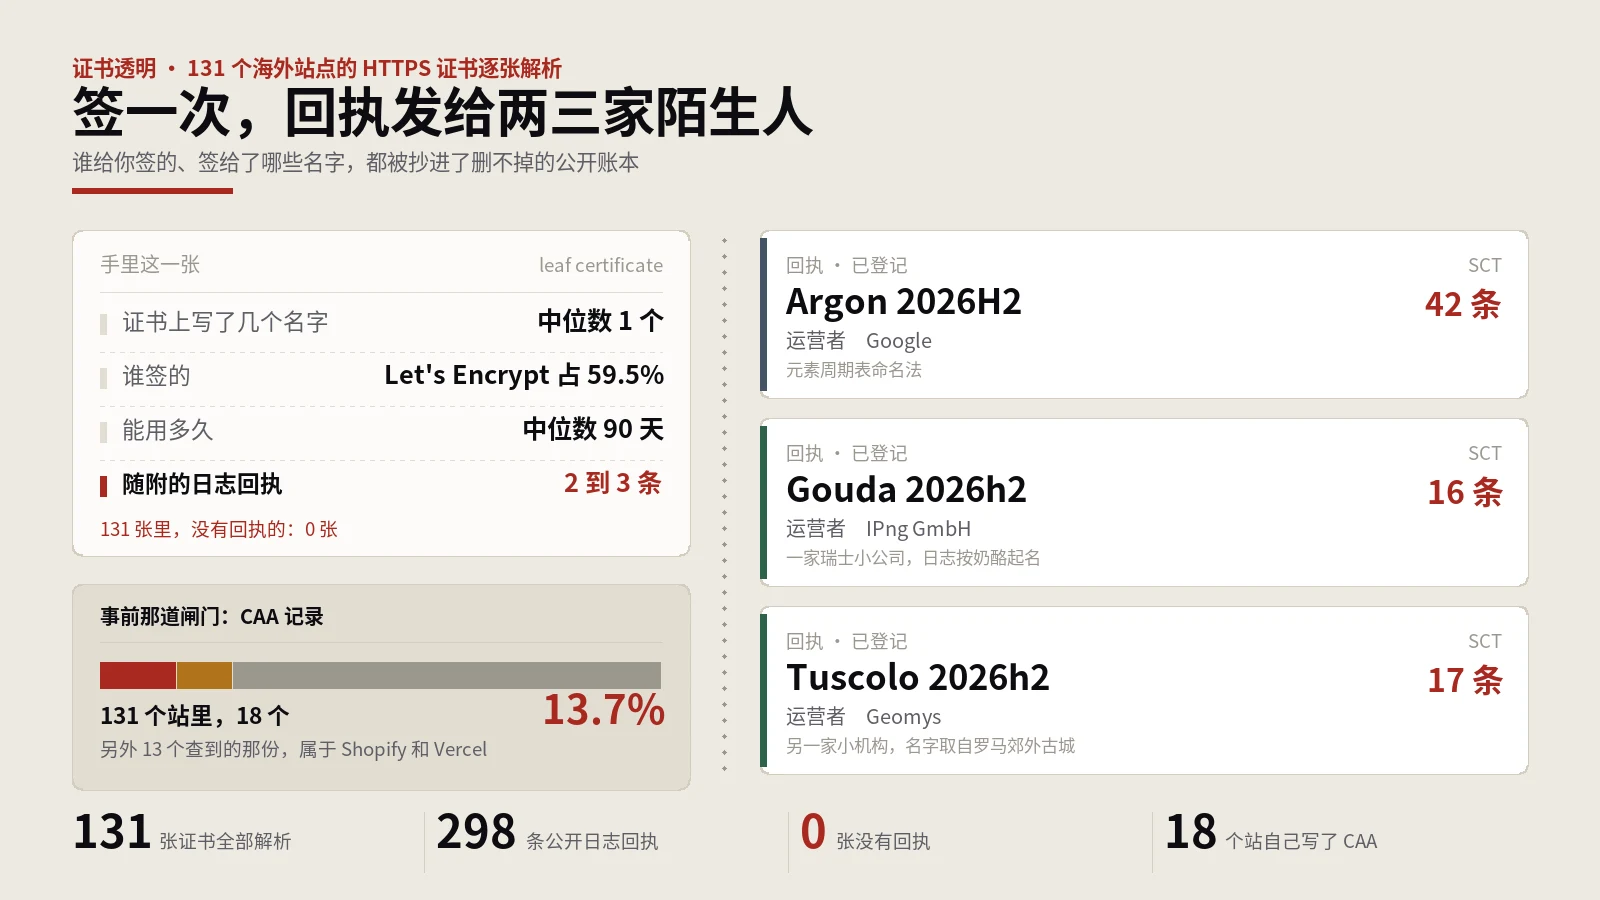
用TLS握手逐站取下叶证书,解析SCT回执、SAN名单、策略标识与AIA扩展;再用DNS over HTTPS从待签发的名字逐级向上查CAA,遇到CNAME跟着跳过去,最后把事前授权与事后账本对账。四把尺子中途改过,其中三把改变了结论方向。
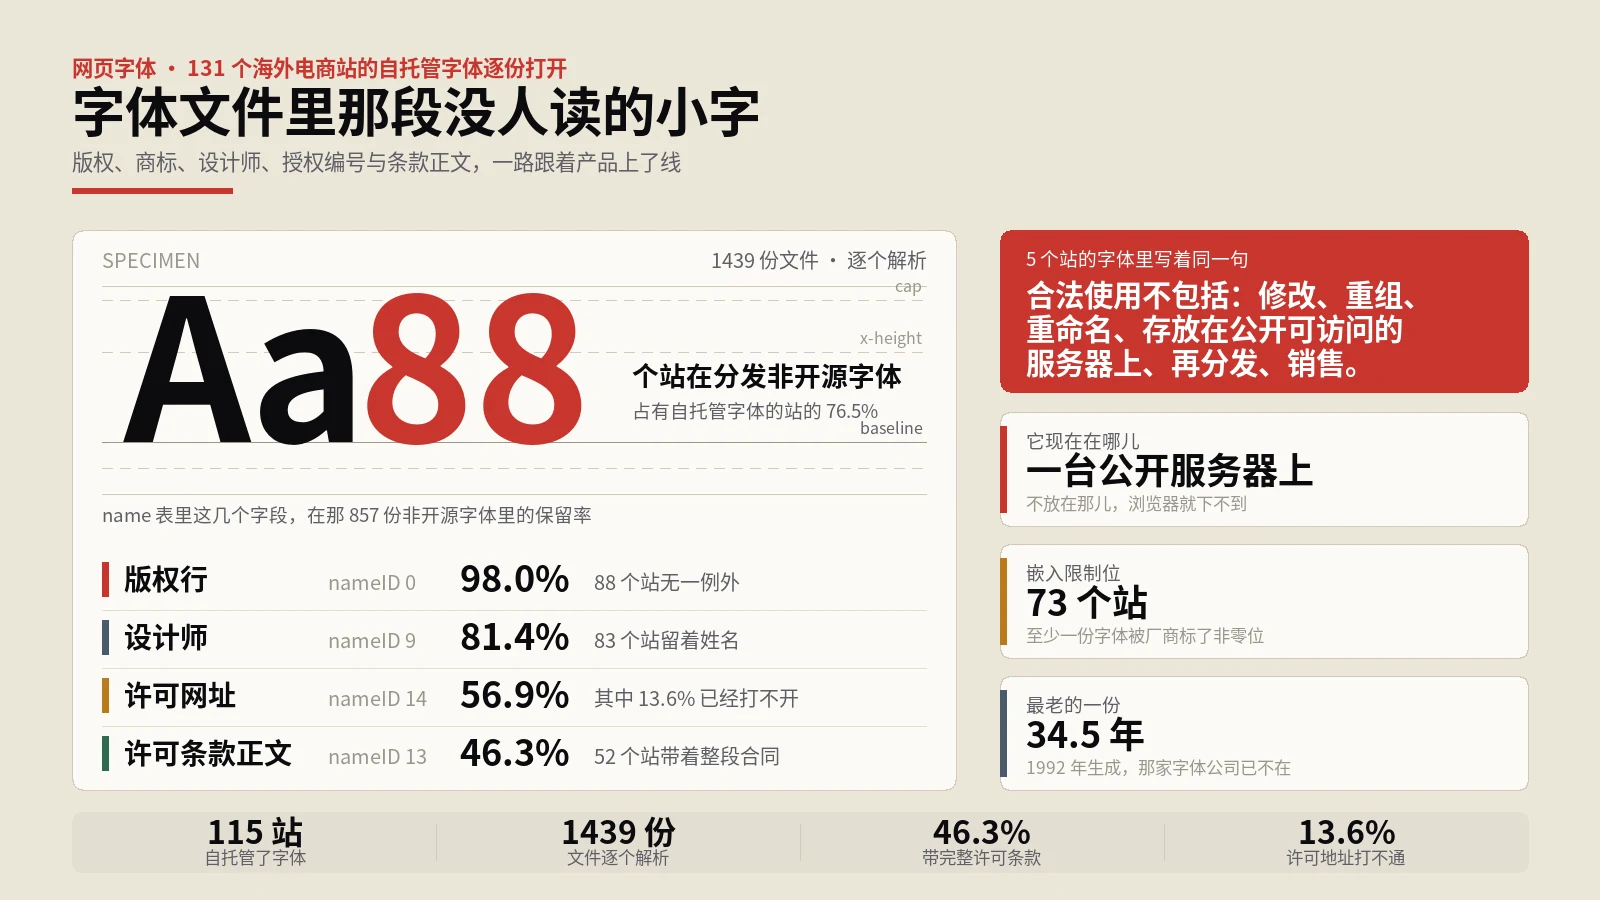
顺着131个海外电商站首页CSS里的@font-face把自托管字体逐个下载,用fontTools读name表与OS/2的fsType位,一律按站统计;再把字体里写着的176个许可与厂商地址跟随跳转逐个访问。三把尺子中途修过:图标字体判据误杀真排版字体,head日期是1904纪元的秒数,死链不跟跳转会把结论写反。
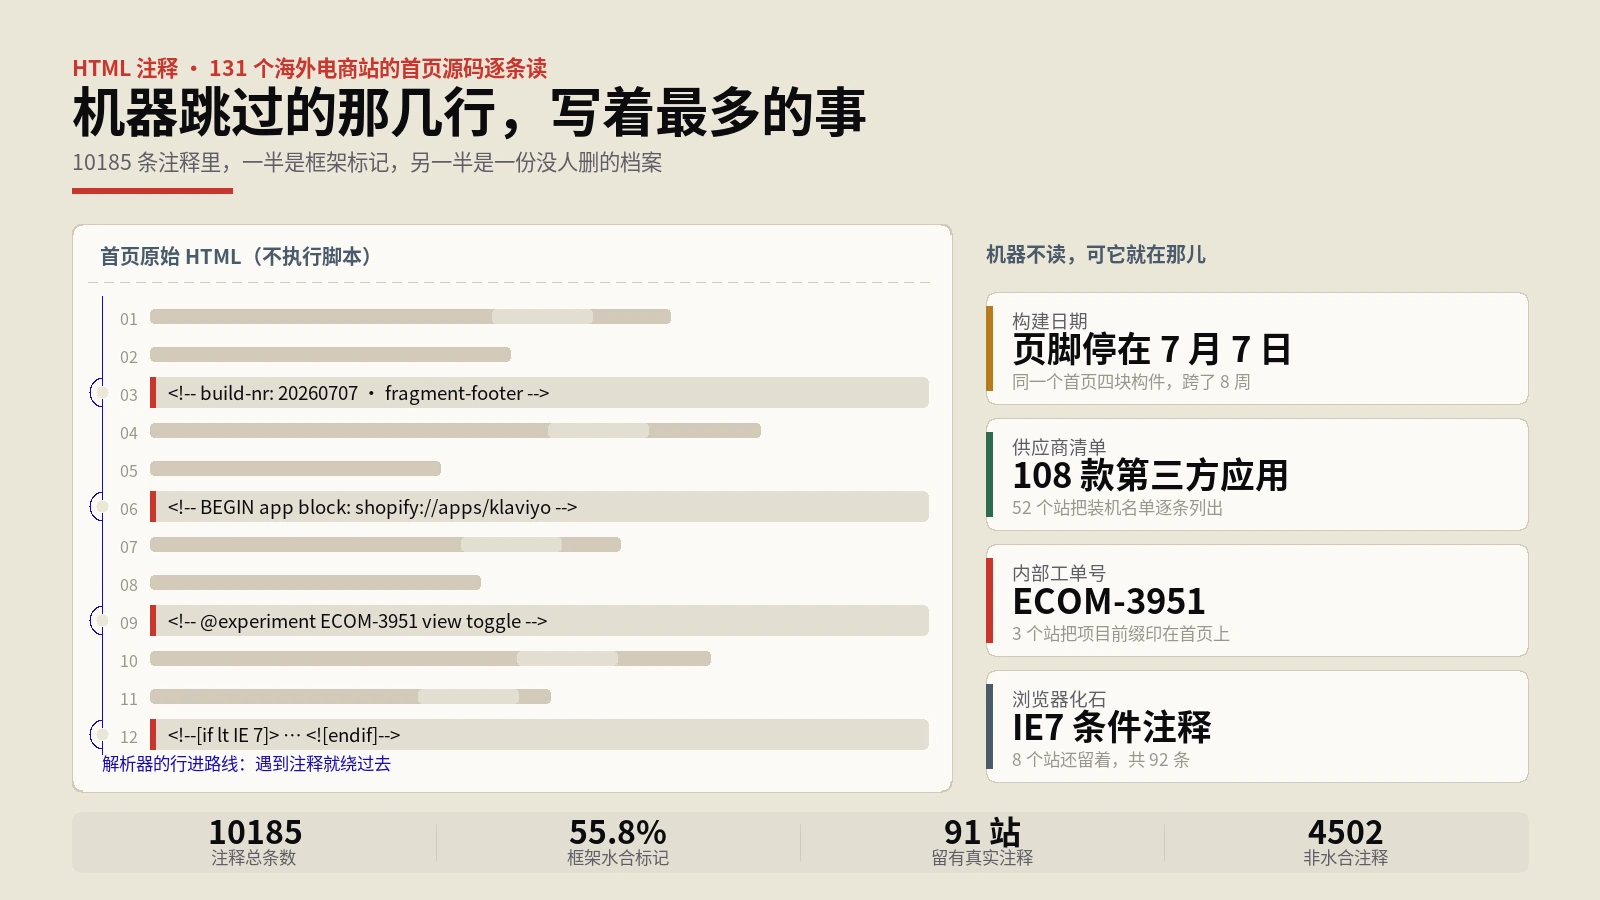
取131个海外电商站首页的原始HTML而不是渲染后的文档树,逐条抽出注释,先剔掉React与Vue流式渲染的水合标记,再按内容打十一类标签、一律按站统计;日期戳、工单号、应用块清单逐条回原文人工核对。中间修了两次判据,一次把排名整个颠倒,一次差点把巧合写成发现。
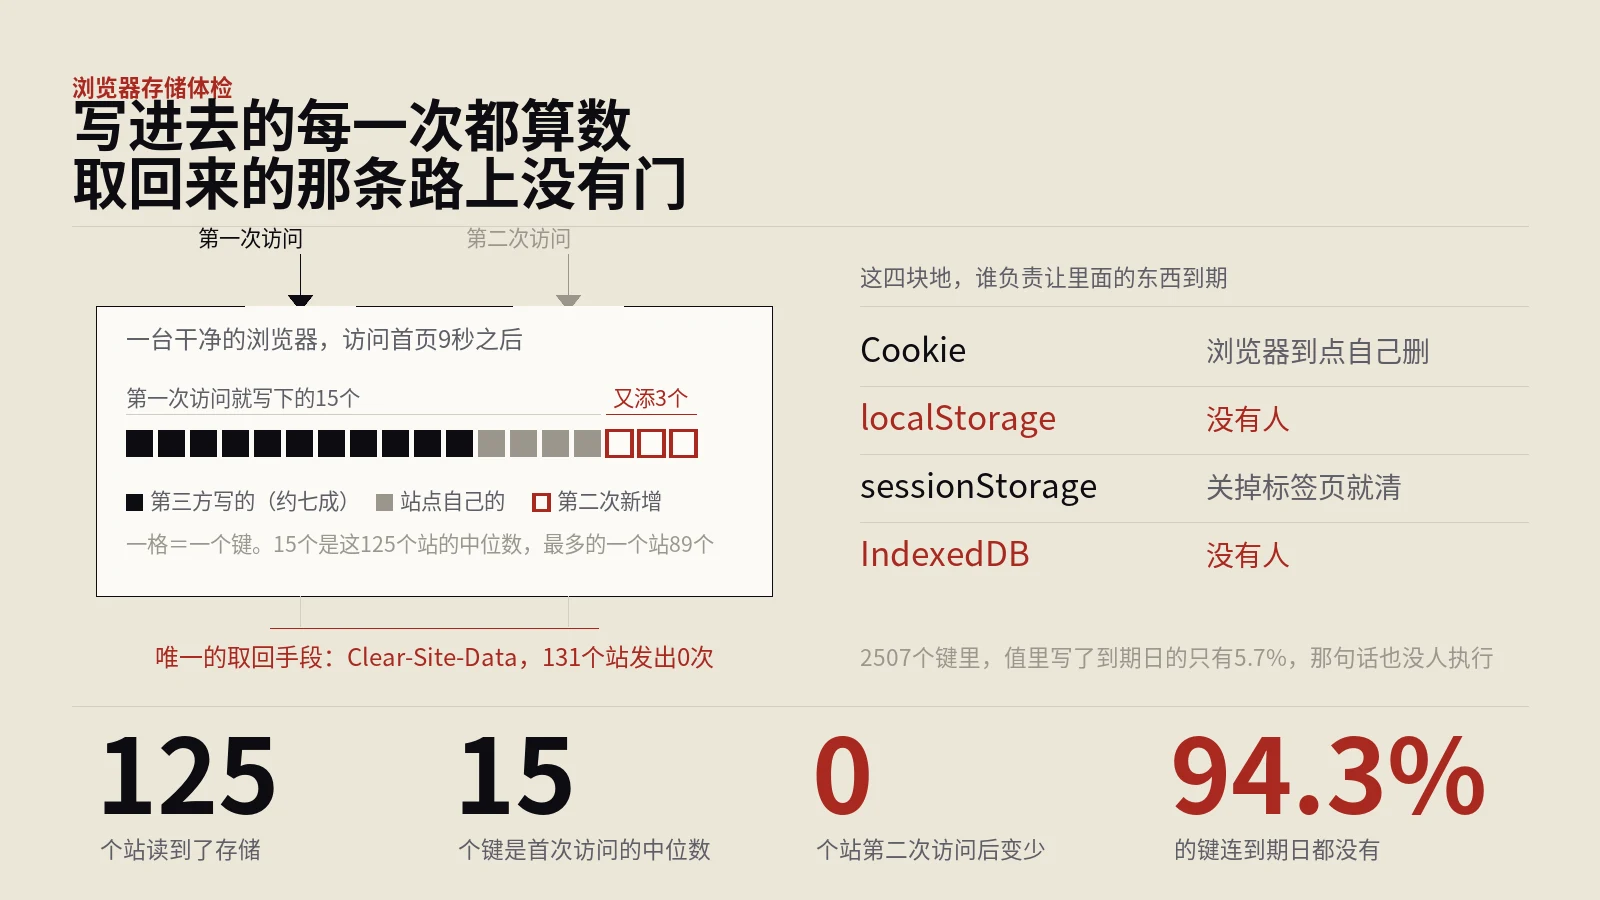
做法是每个站开一个全新的浏览器配置,访问首页等9秒,把三处存储连键带值读出来,再带着它回访一次做对照。尺子坏过两回:浏览器自带的用量接口根本不数这块地,报回来的中位是0字节;而第一版那条看起来严丝合缝的因果,把cookie和存储拆开重跑之后就散了。
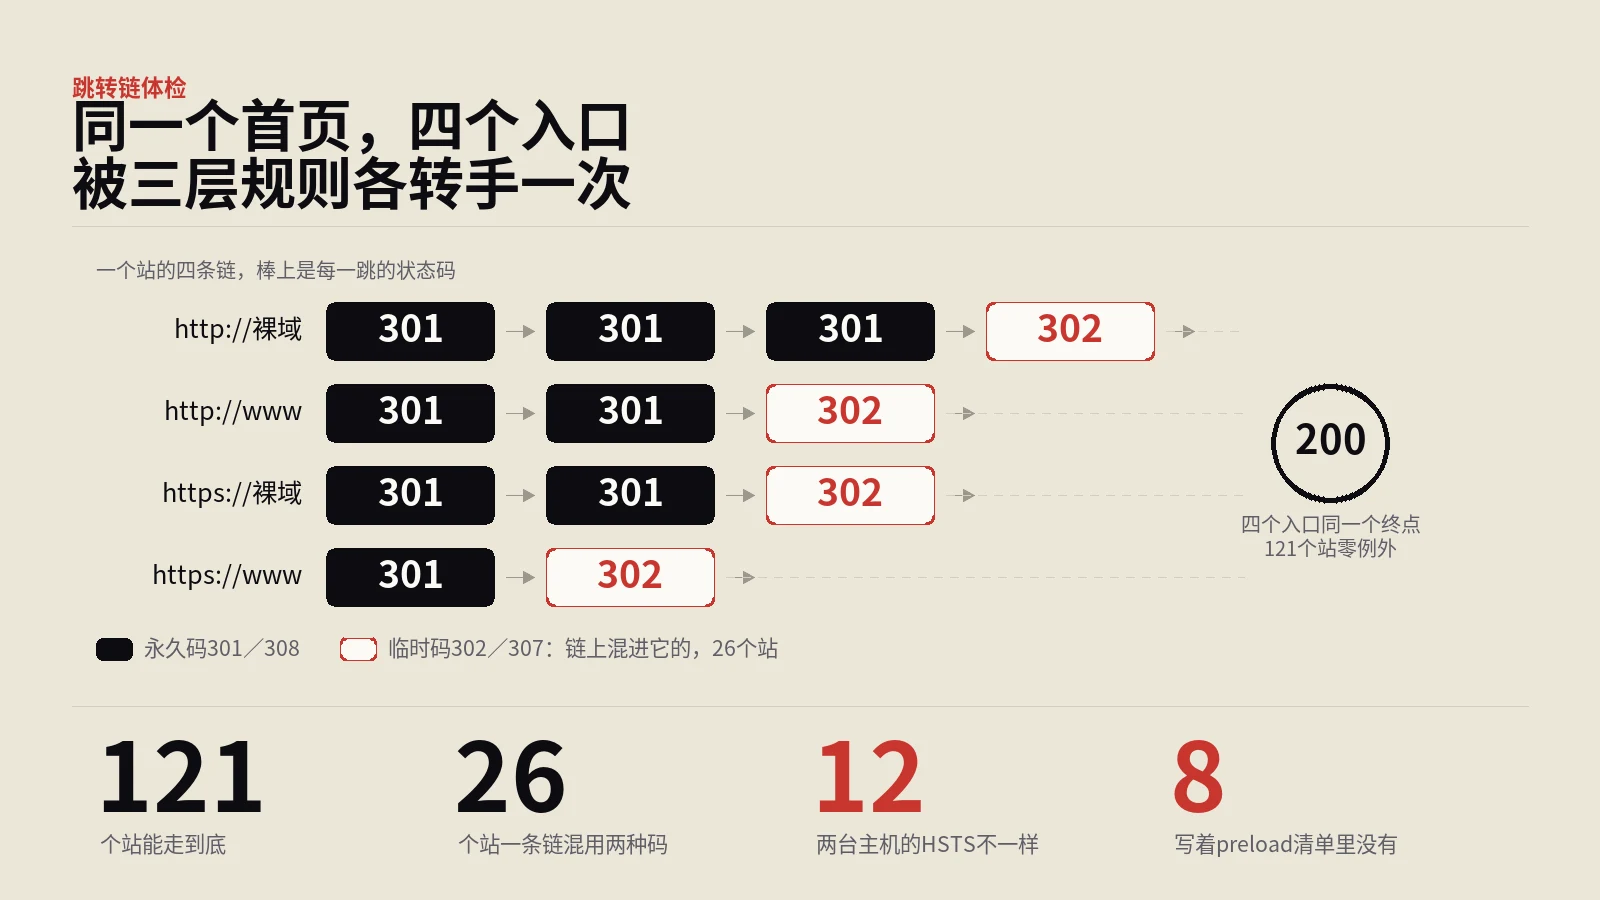
量法是每个站从四种入口各走一次不跟随重定向的链,逐跳记状态码和能认出厂商的响应头,再取两台主机各自的HSTS,最后拿域名去问浏览器预置清单的状态接口。中途尺子坏了四次:并发太高把限流读成没数据,用响应头认建站平台全样本命中零,还把抓取失败当成了没有指纹。
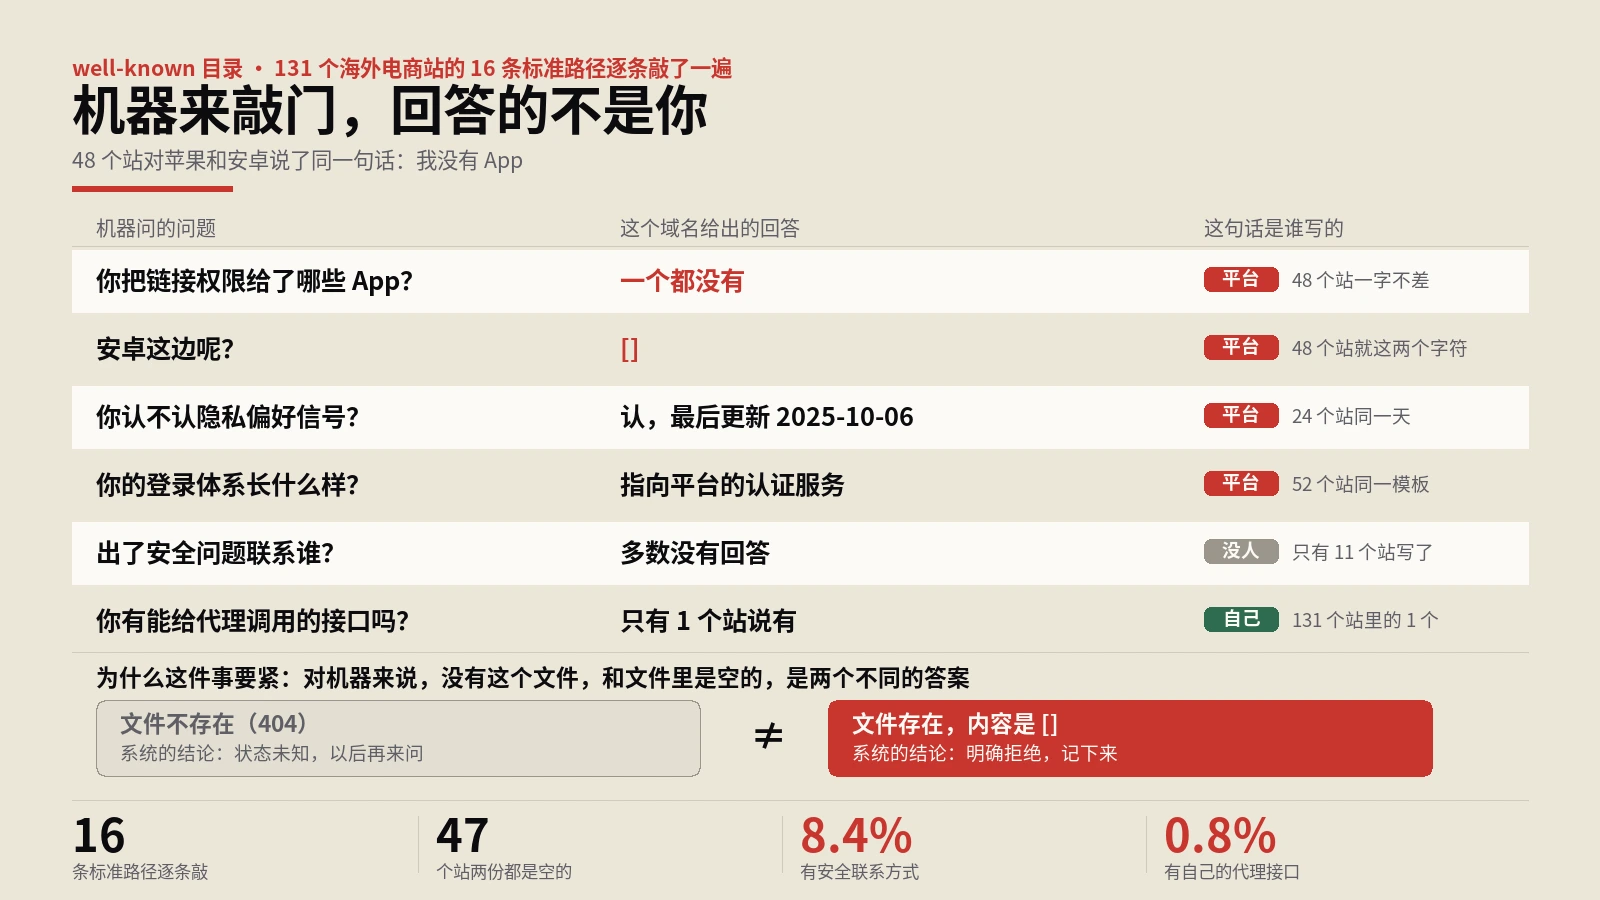
把131个海外电商站的16条well-known路径挨个请求,跟随重定向后按三层判据剔掉假200:状态码、内容类型、正文里有没有自称404或拒绝访问的结构;再抹掉域名与店铺标识做内容聚类,区分哪些是平台批量铺的、哪些是品牌自己写的。判据前后改了6处,方向全部是让数字变小。
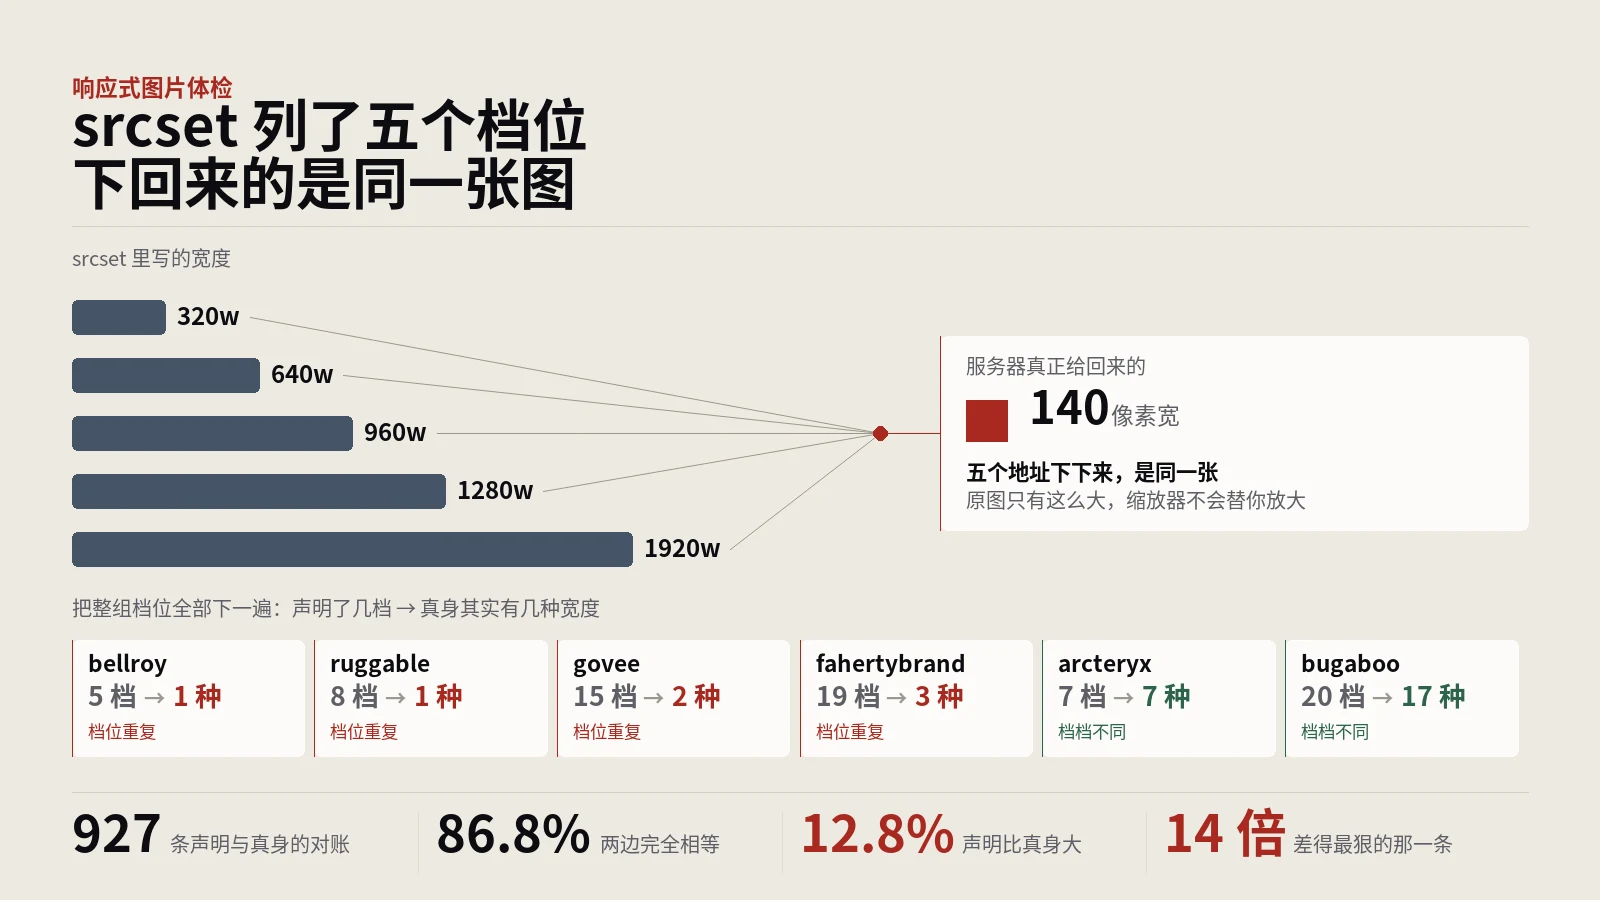
对每张图只取前64KB,从PNG的IHDR、JPEG的SOF段、WebP的VP8X、AVIF的ispe盒子里直接读出真实宽高,再拿它跟srcset的w描述符、width与height属性、地址里的尺寸参数、文件扩展名这四处声明逐条对账;最后把整组srcset的每一档全部下一遍,验它们是不是同一张图。
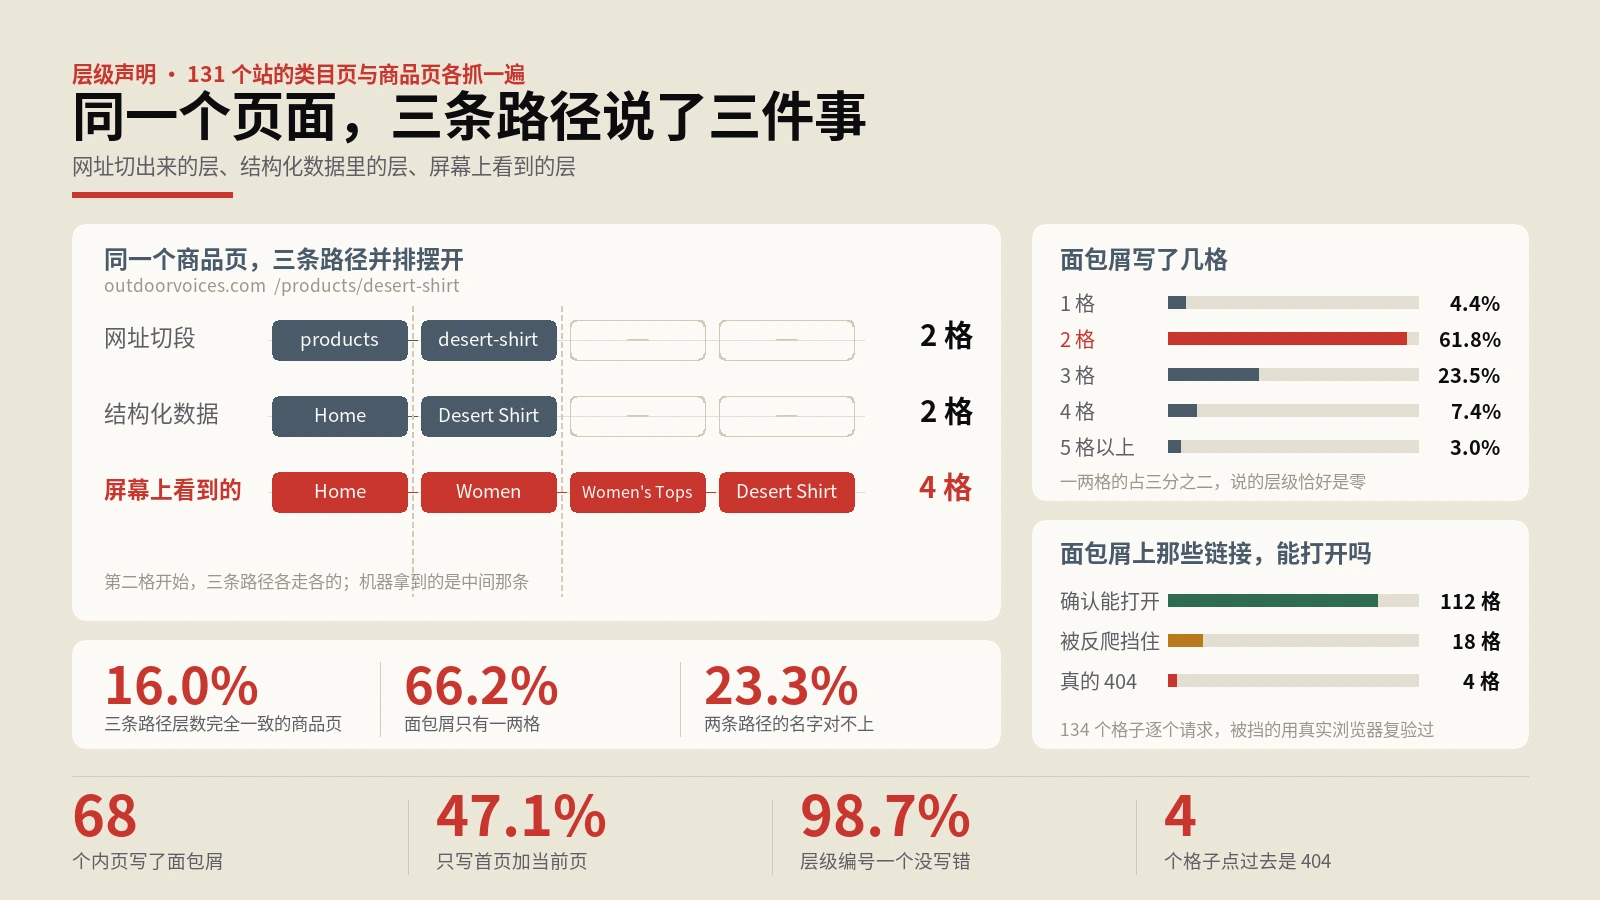
131个海外品牌站抓了类目页与商品页,把三样东西并排对齐——网址切出来的目录段、结构化数据里的BreadcrumbList、渲染后页面上那排可点的面包屑,逐页比对层数、名称与链接可达性;网址段数扣除语言与地区前缀,DOM选择器误判的样本人工剔除。
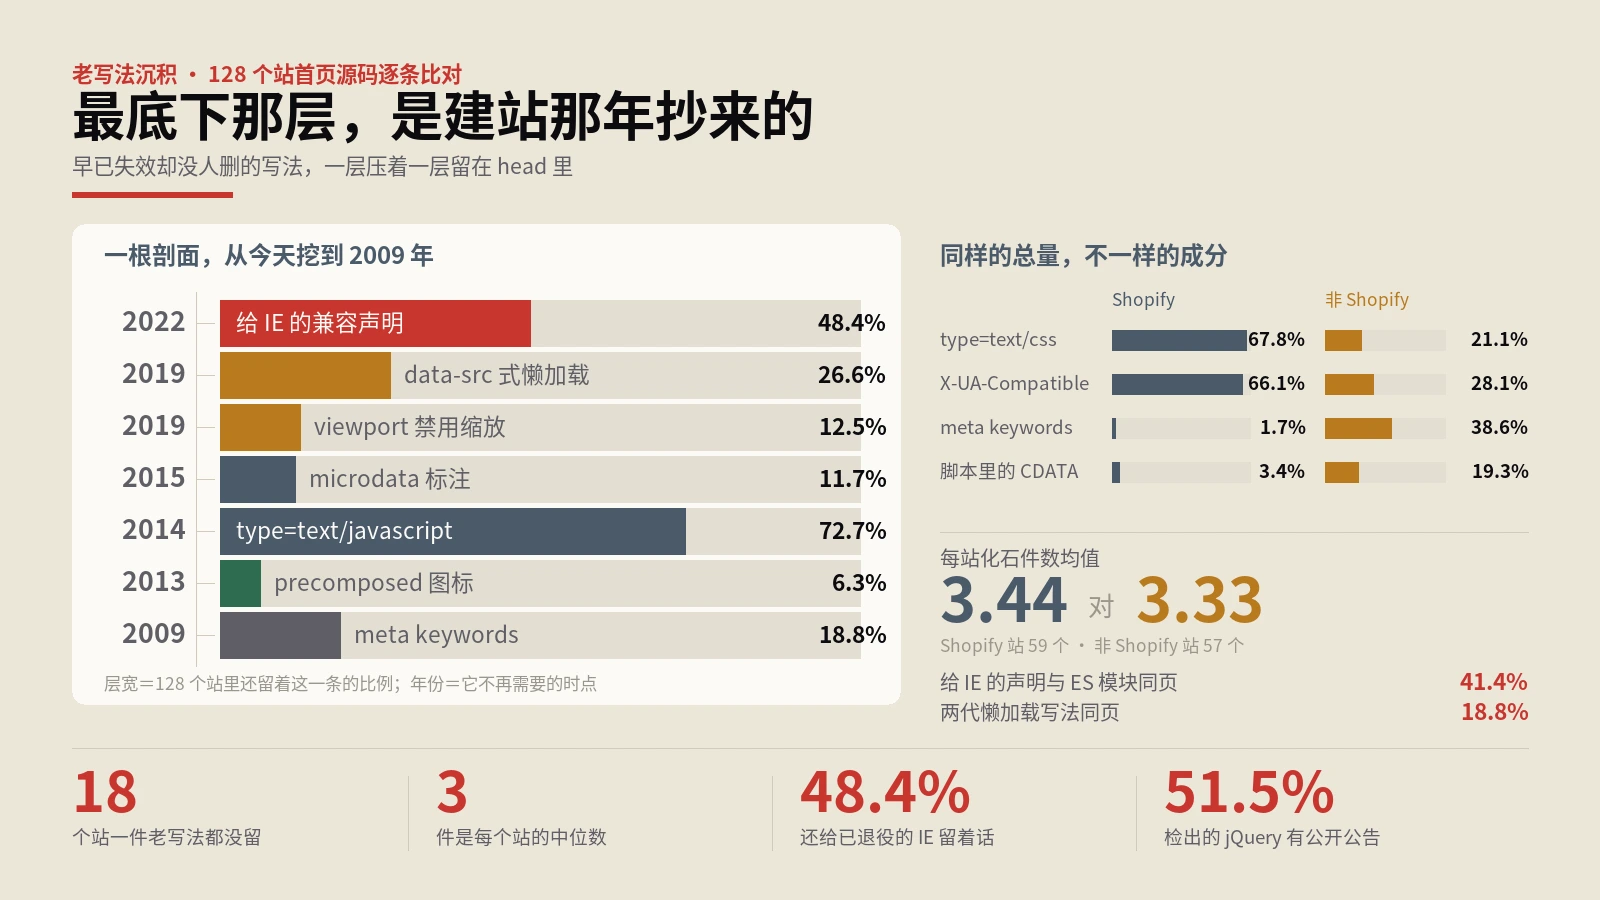
先列一张有明确退场时点的老写法清单,再抓128个海外品牌站首页的服务端HTML逐条比对,最后按建站平台把样本分成两组,看在化石总量几乎相等的前提下,两组页面留下来的种类分布差在哪里。
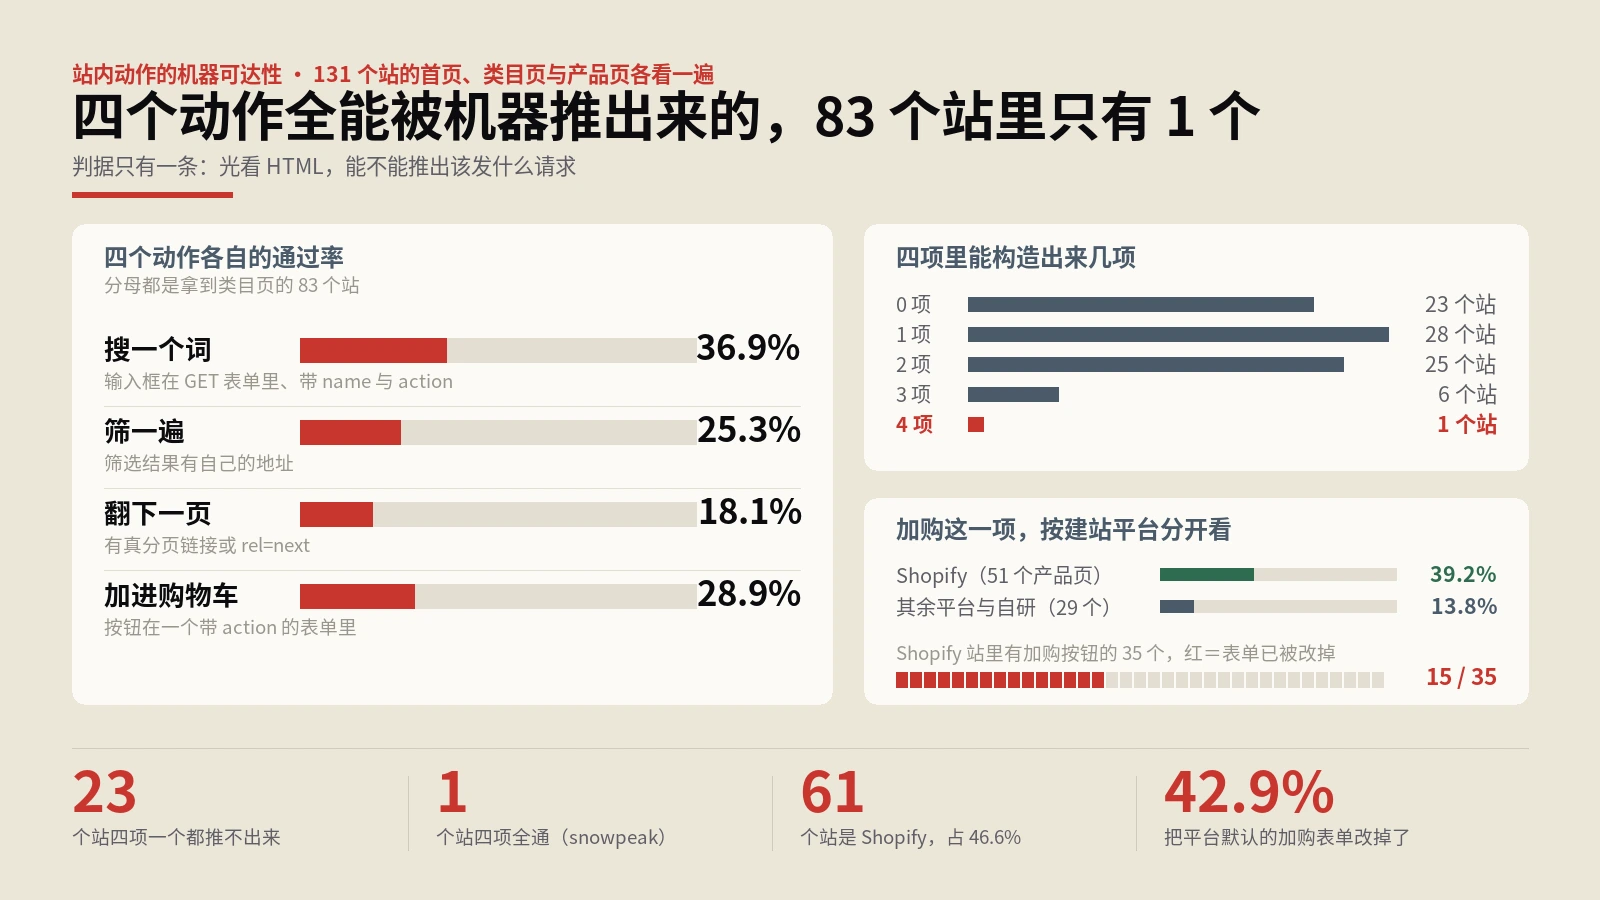
做法是用真实浏览器把131个英文电商品牌站的首页、一个类目页和一个产品页各打开一遍,在渲染后的DOM上取四组静态特征:搜索输入框在不在GET表单里且带name与action、类目页有没有带筛选参数的链接、有没有真分页链接或rel=next、加购按钮在不在带action的表单里。建站平台的判定另外补了一轮首页HTML特征探测才敢用——最初拿加购表单地址是不是/cart/add来认Shopify,把61个站认成了19个,低估3.2倍,那一版…
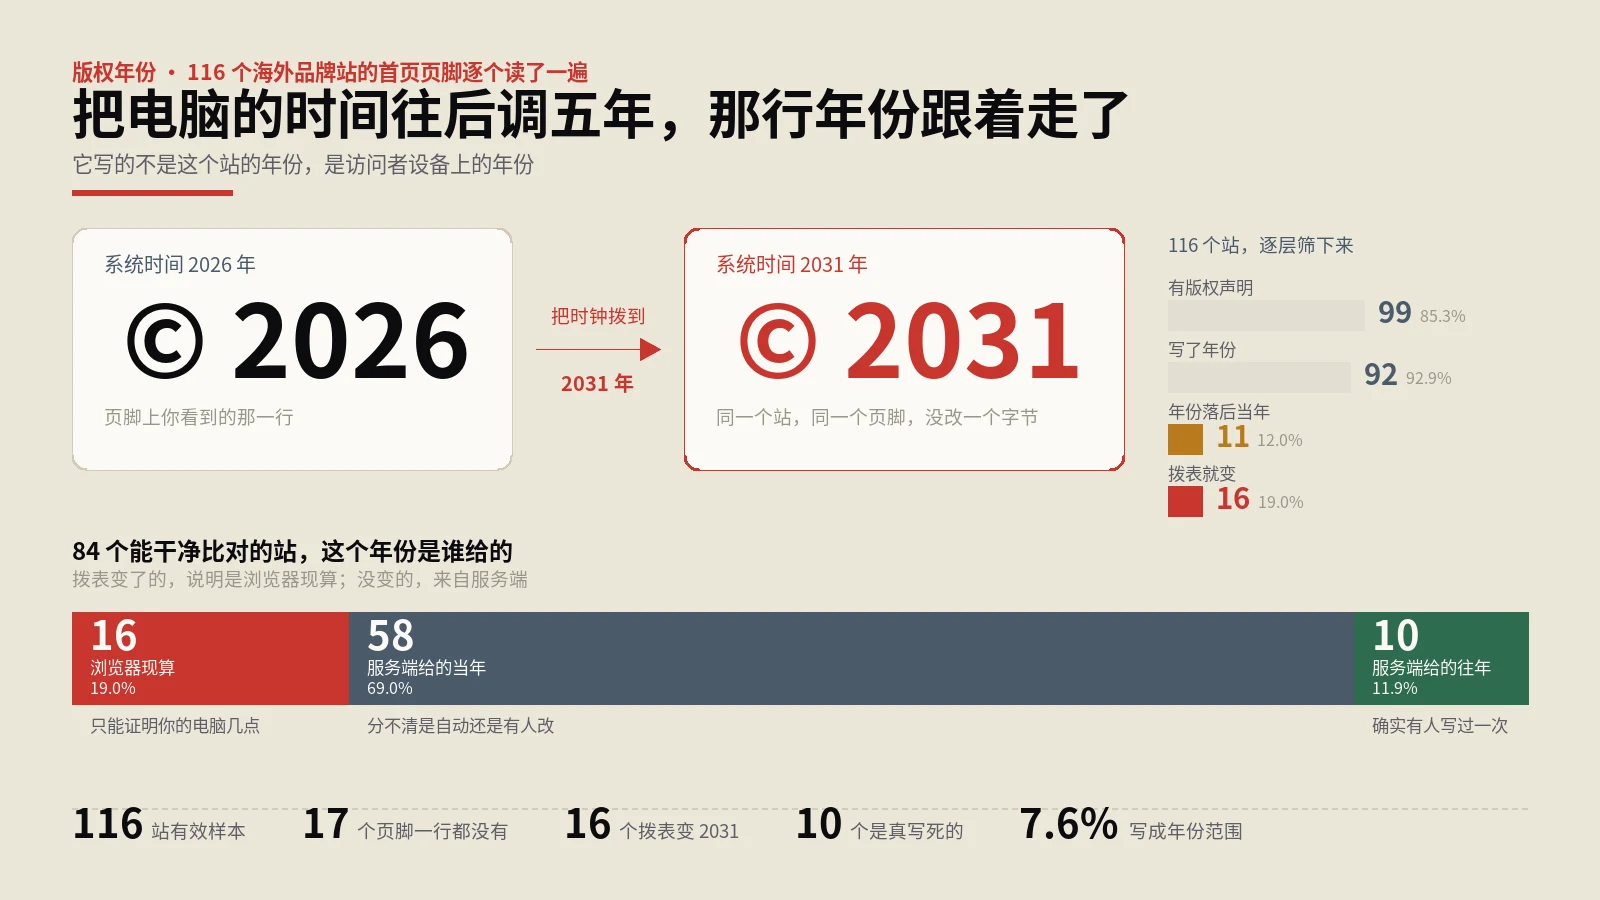
116个海外品牌站的首页页脚逐个抓取,识别版权声明与年份写法;每站访问两遍,第二遍在页面加载前把浏览器全局Date固定为2031年,比对同一段版权文本的年份是否变化,两遍抹去数字后相似度不足的样本剔除。
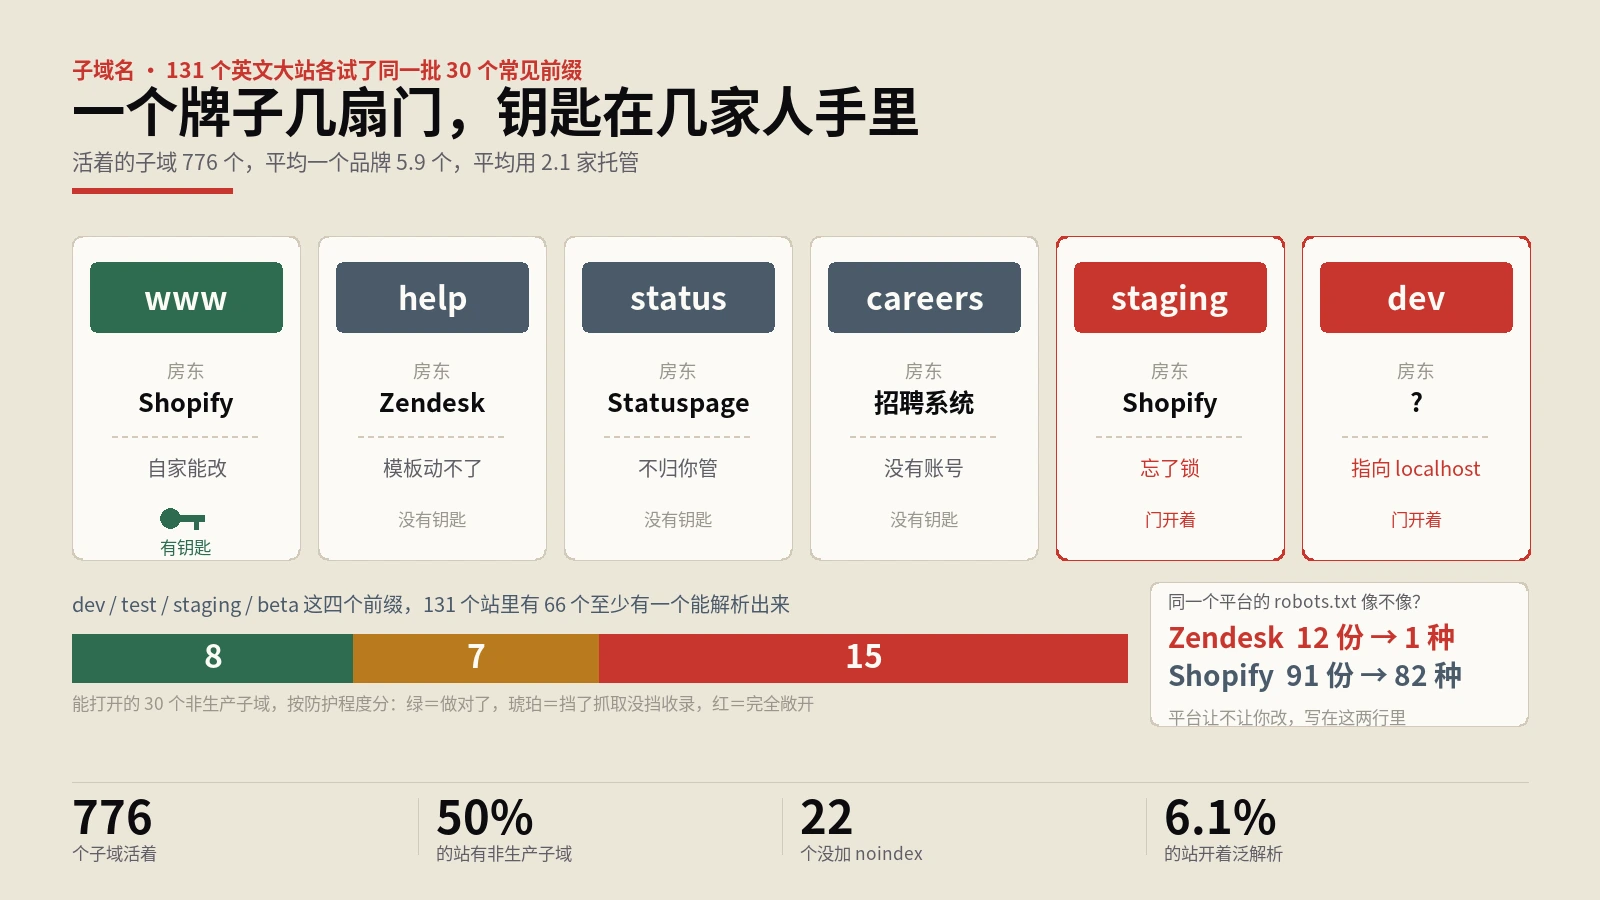
给131个英文大站各试同一批30个常见子域前缀,先用随机子域探泛解析再剔除兜底回声,对活着的子域追CNAME判托管方,并逐个记录HTTP状态码、页面标题、noindex与robots.txt封禁情况。
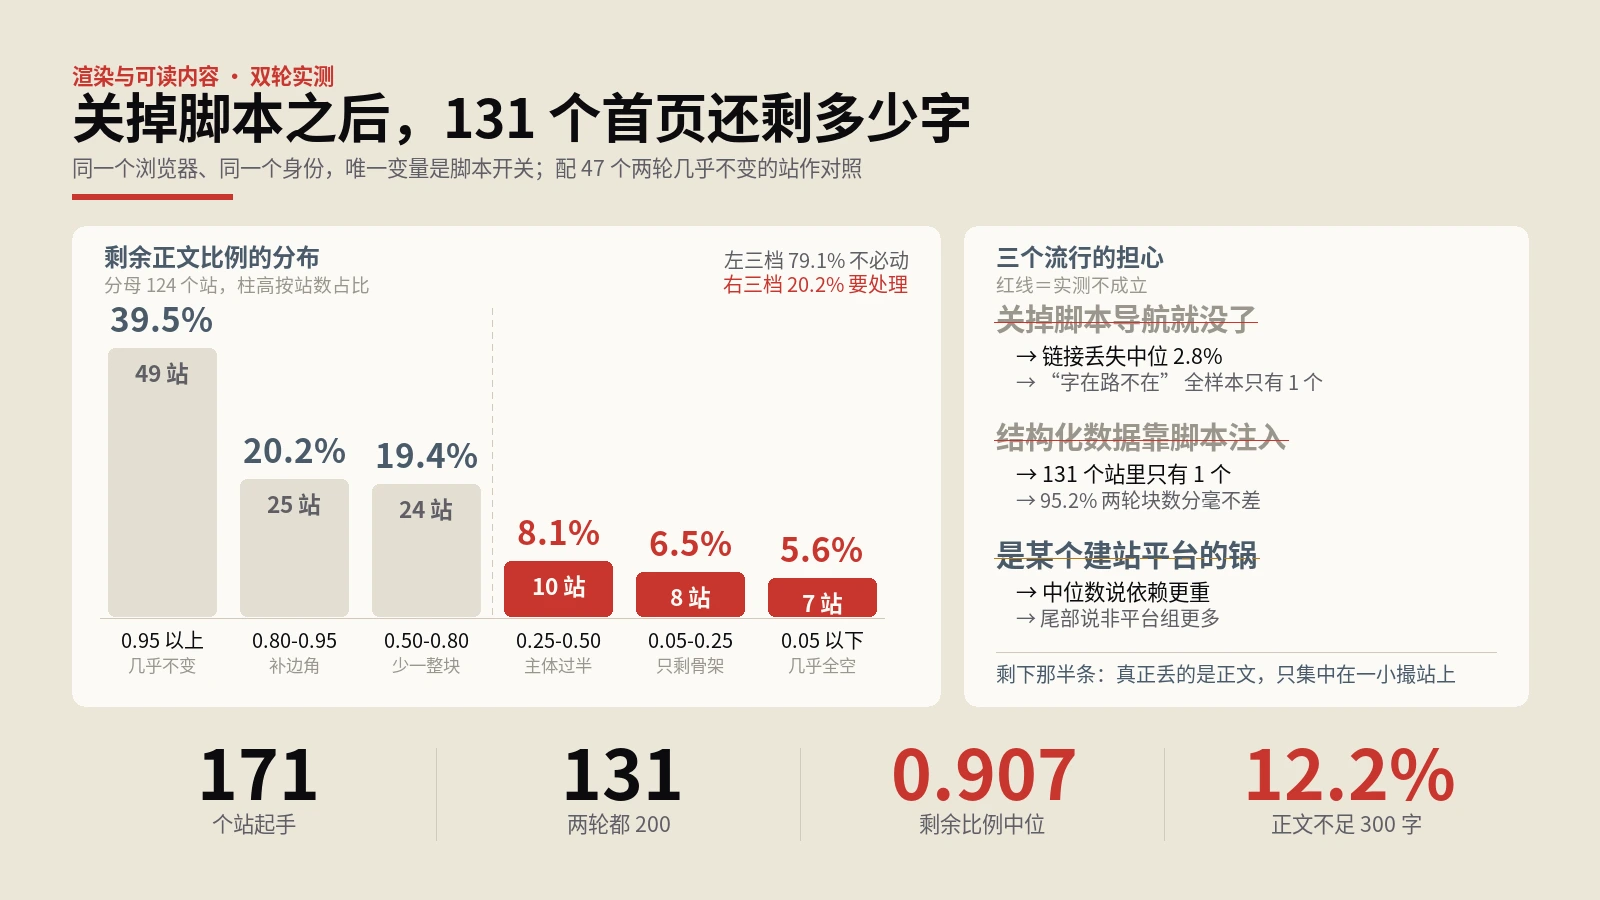
用同一个浏览器对171个海外独立站首页各跑两轮,唯一变量是脚本开关,两轮都拿到200的有131个。三个文本口径在同一次访问里取,配47个两轮几乎不变的站作对照,再用1秒、3.5秒、10秒三档等待时间做敏感性检验,逐层拆开正文、链接、结构化数据、主标题、商品入口五类结构件的丢失情况,并把测量过程中翻车的两次尺子问题一并记下来。
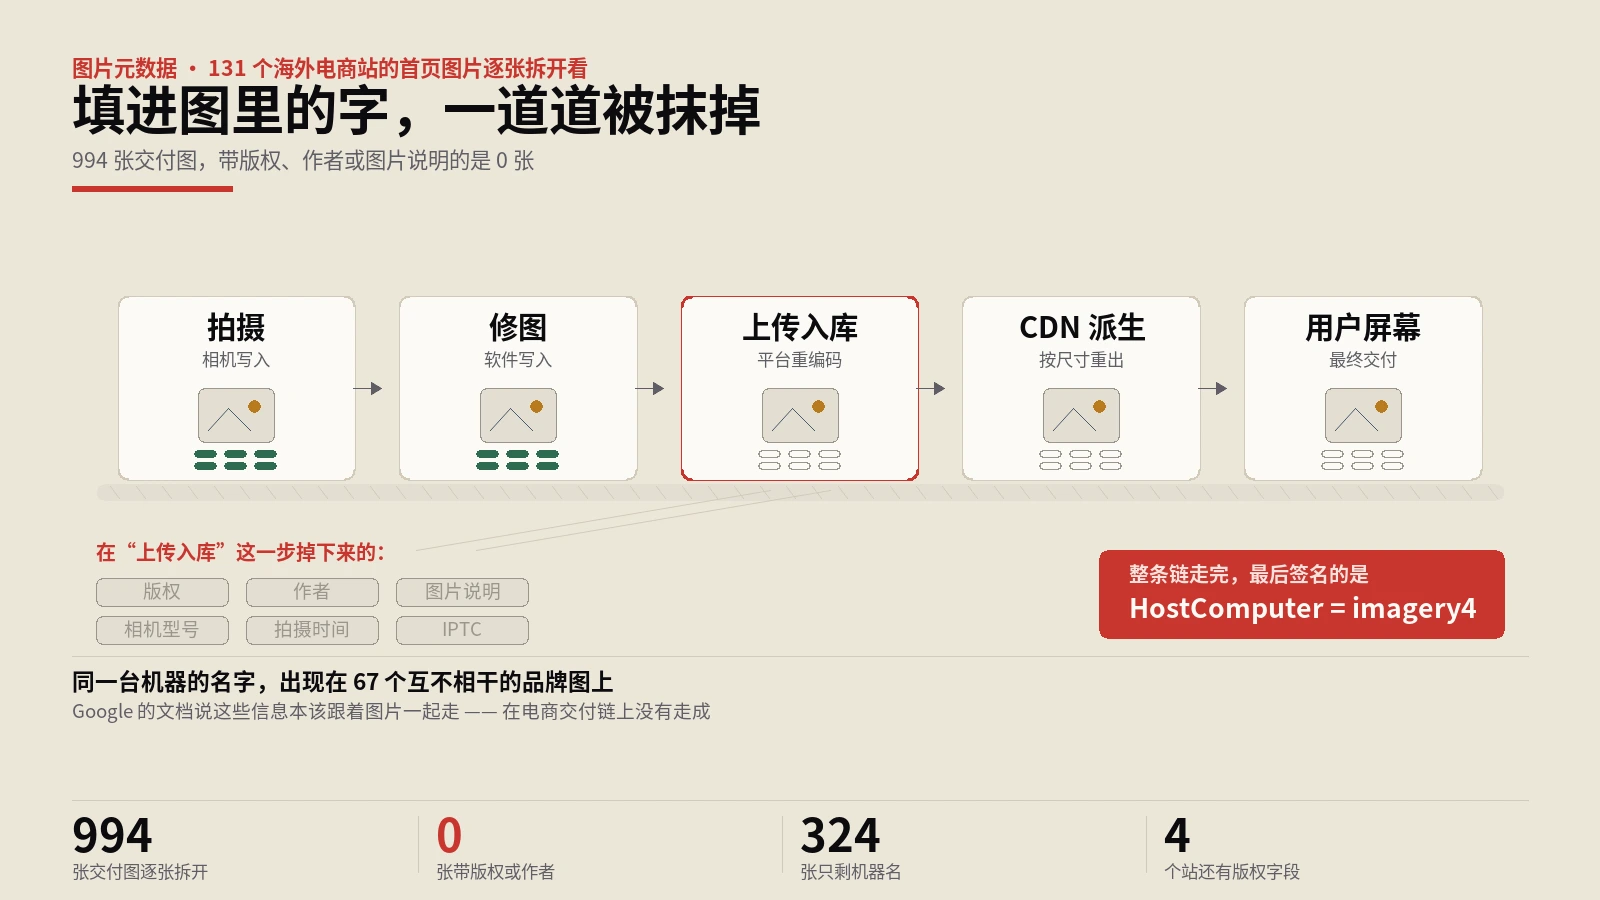
从131个海外电商站的首页取浏览器真实加载的图片,按Range只下文件头部,逐段解析JPEG的APP标记、PNG文本块与WebP的RIFF块;再把同一张图去掉CDN处理参数取一份裸地址,用177组对照区分元数据究竟是入库时清的还是交付时剥的。判据前后改了14处,方向与影响全部列出。
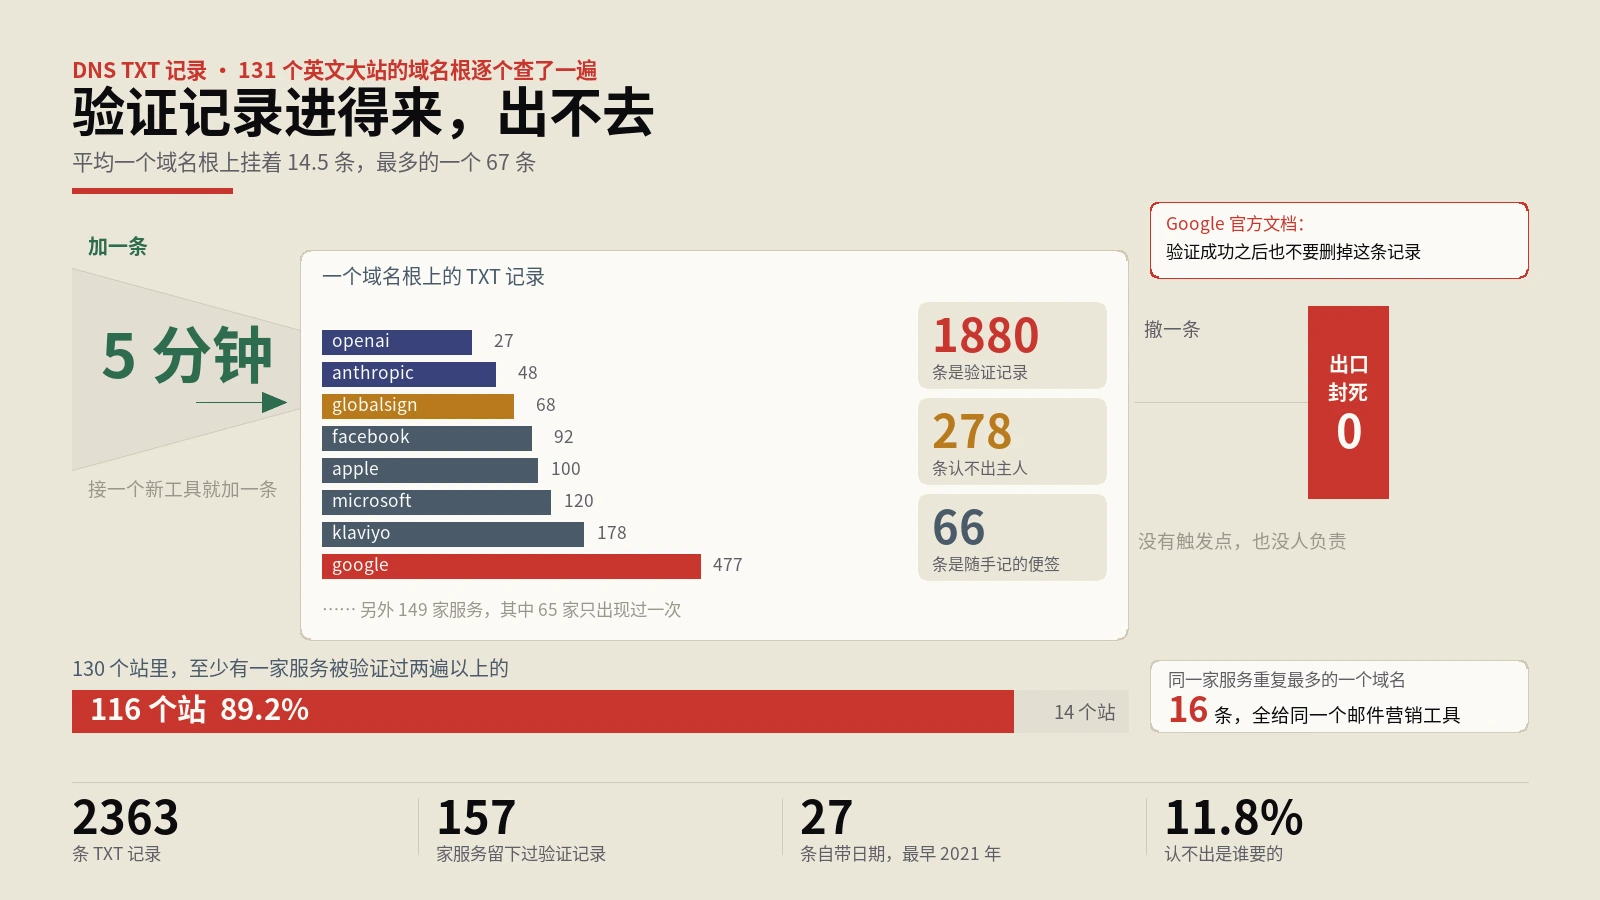
131个英文大站的域名根逐个做DNS查询,取根域与_dmarc的TXT记录,按写法把每条判成第三方验证记录、认不出主人的裸串、邮件配置或内部随手记,再按厂商归并统计重复与年龄。判据经六处人工核对修正。
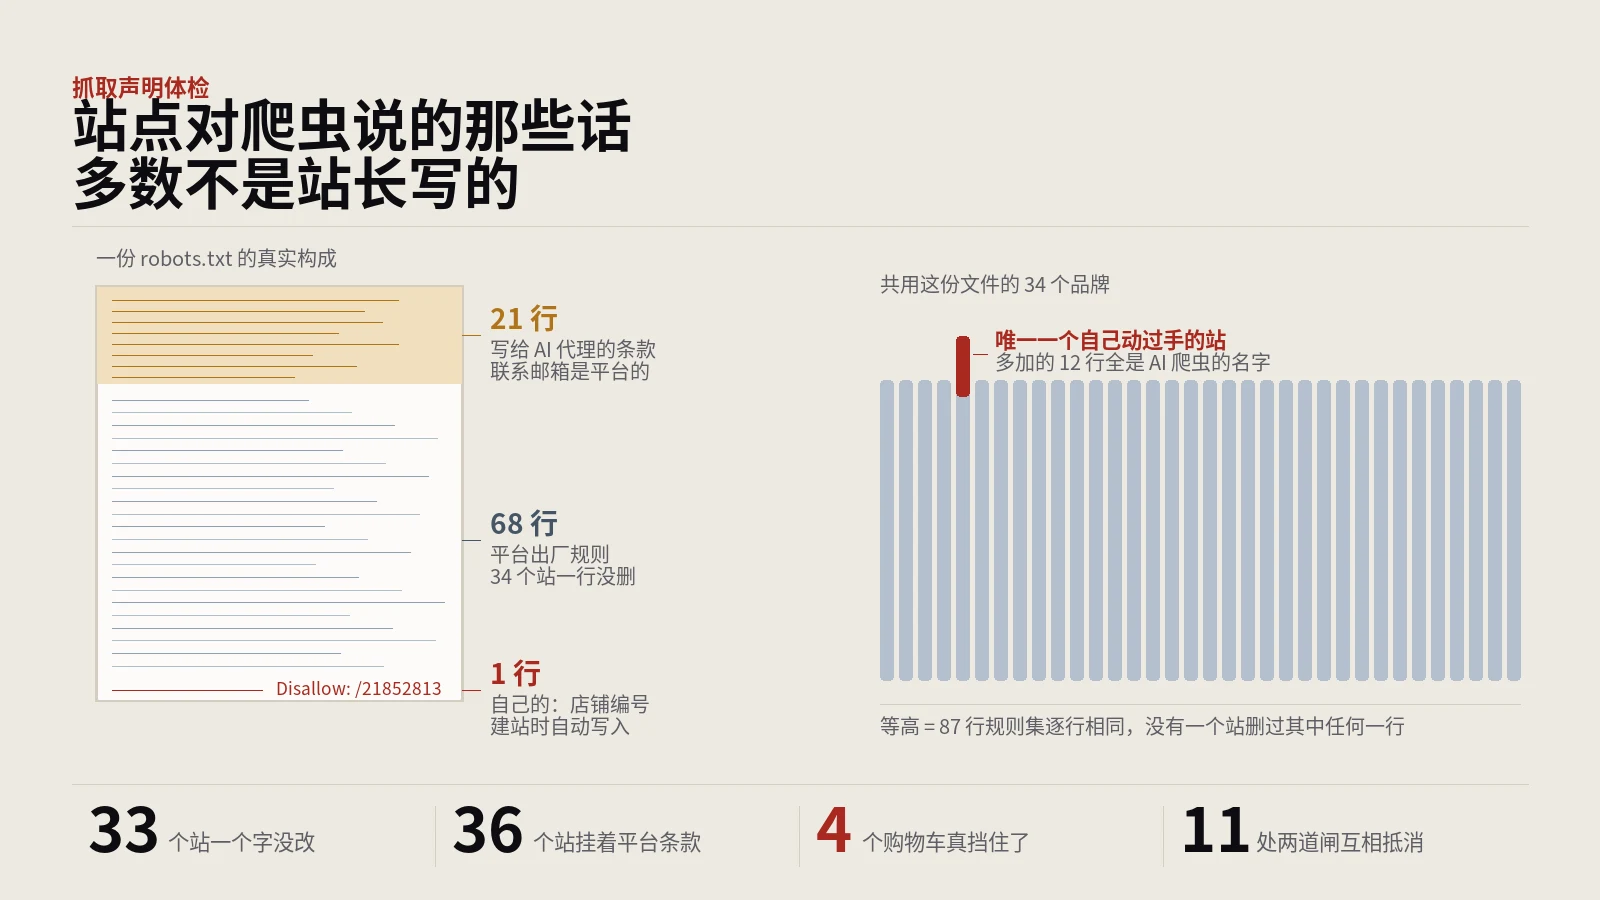
先按RFC 9309自己实现一遍规则匹配,用规范里的18道经典用例把匹配器验过,再拿它逐条判定450个页面能不能被抓;然后读每个页面HTML里的meta robots与响应头里的X-Robots-Tag,把两份声明落进四个格子。全程按页面最终落地的主机去找对应的robots.txt,跨域跳到平台认证域的单独归类。
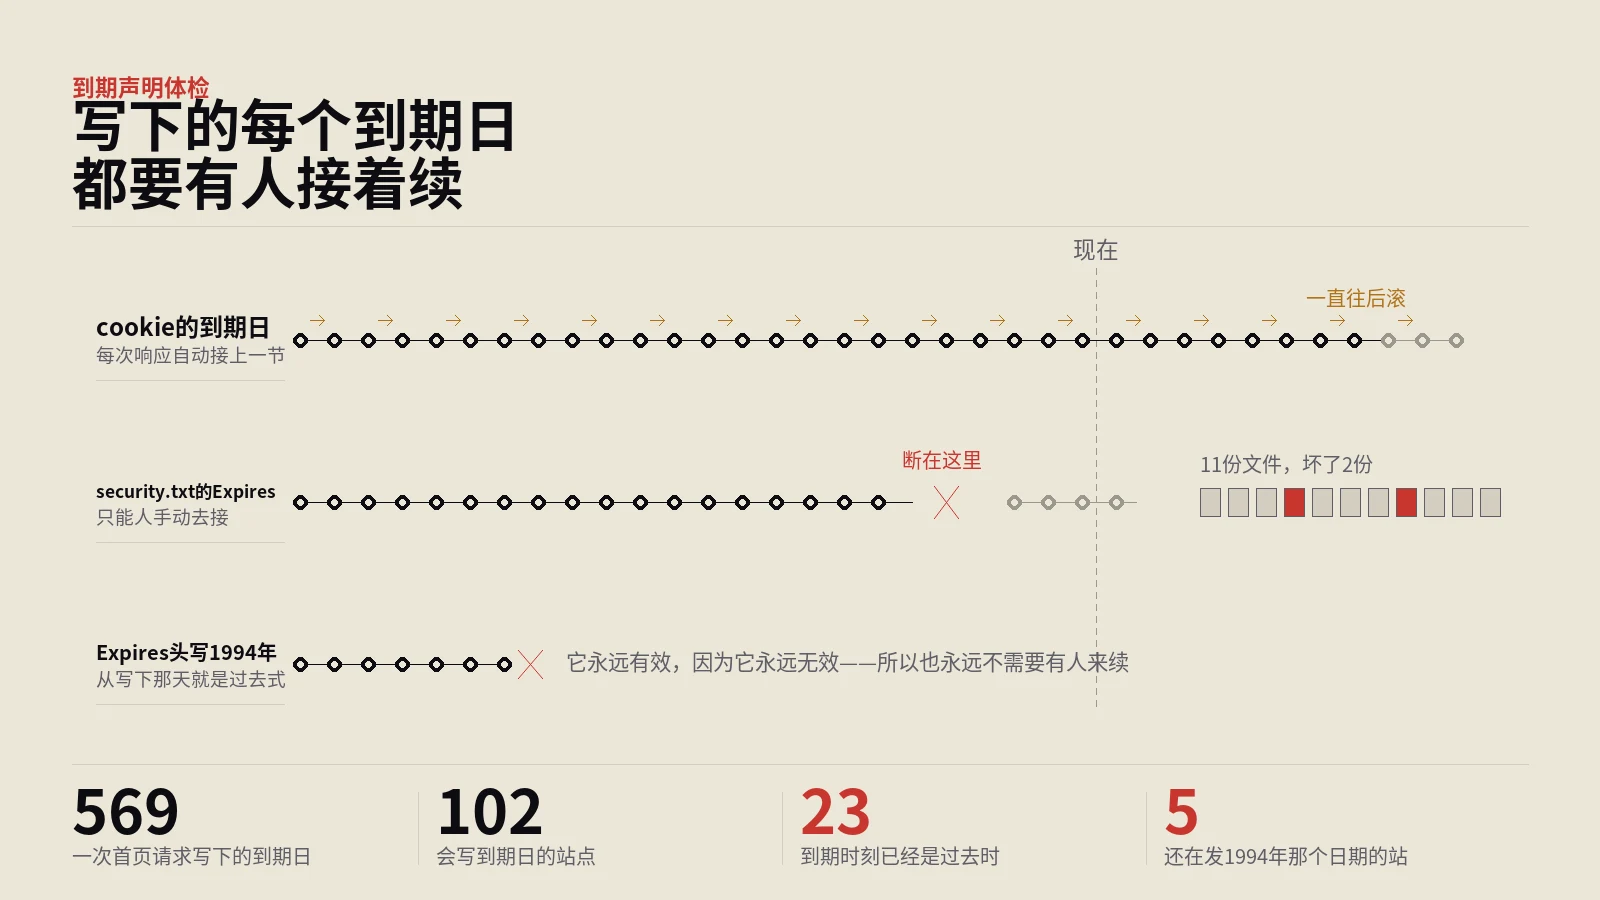
做法是把响应头里所有指向未来的字段拆开逐条换算:Set-Cookie的两个到期字段、Expires响应头,以及.well-known下那份规范要求必须写到期日的文本。换算的零点得取每次响应自己的Date头,第一版拿了个固定时刻,凭空多出十天,55条被误判成自相矛盾。