AI接地查询长什么样?Moz公开的Gemini搜索词数据,看机器替自己搜什么
本文目录
摘要:Moz的Pete Meyers从Gemini接口里取回5333条接地查询,覆盖1000个子话题。这批机器替自己写的搜索词平均6.56个英文单词,六到七个词的占了52.7%,三分之一带着年份,还有把一串术语硬塞进一行的写法,搜索量估计接近零。它告诉SEO的是:AI在补训练数据的时效缺口,会按“类型、挑战、趋势、对比”这些侧面去搜,你的页面有没有把这些侧面写清楚、把日期写明白,比追某一条具体查询更要紧。数据是靠改系统指令逼出来的,跟AI模式里的真实扇出不能画等号。
做了这么多年关键词研究,大家心里都有一张表:词、搜索量、难度、意图。可AI回答问题时自己跑出去搜的那些词,从来不在这张表里。这些词是模型替自己敲的,人从没往搜索框里输过。
Moz在2026年9月1日发了一篇Demystifying Grounding Queries with Real Data,作者是Moz的常驻营销科学家Pete Meyers,圈里都叫他Dr. Pete,本行是认知心理学。他用Gemini的接口收了5333条这样的查询,把整份数据也公开了。下面按原文的思路讲这批数据说明了什么,保哥把他公开的表格重新数了一遍,顺手补上Google官方文档里的字段、计费和使用要求,最后说说外贸站和独立站拿它能干点什么。
接地查询是什么,和查询扇出是什么关系?
大模型的知识停在训练截止那天。Google搜索的索引每天都在更新,模型脑子里的东西可能已经旧了一年多。要补上这段差距,模型在回答之前会自己去搜一圈,把搜回来的网页当依据再组织答案。它这时候发出去的搜索词,就叫接地查询(grounding query)。“接地”这个词借的是电工的说法,意思是让答案有个能核实的着落,别飘着。
什么时候搜、搜几条,是模型自己决定的。按Gemini API的接地文档,流程大致是这样:应用把用户的提示连同搜索工具一起发给模型,模型先判断搜一下能不能让答案更好;觉得有必要,就自己生成一条或几条搜索词去执行,再把结果消化掉,写成带引用标注的回答。觉得没必要,它就一条也不搜。后面会看到,这个“自己决定”给Moz收数据添了不少麻烦。
Dr. Pete给的定义很干脆:接地查询是机器发起、给机器用的搜索,用来弥补大模型天生的短板。这句话里最要紧的是“给机器用”。人搜东西会挑短词、会犯懒,机器不会,它想搜什么就写什么,长度和语法都不讲究。
它和查询扇出(query fan-out)是包含关系。Google在2025年5月发布AI模式时就写过,AI模式会把你的问题分成多个子话题,同时替你发出一大批查询。Search Central的AI功能与你的网站文档也写明,AI概览和AI模式都可能用扇出技术,在多个子话题和数据源之间发出相关搜索。扇出是整个过程,接地查询是这个过程里最后落到搜索引擎上的那一条条词。扇出的整体机制站内在查询扇出的多路子查询机制里讲过,这里只看落地的那一条条词长什么样。
原文举了一个“游戏主机”的例子。有人搜“gaming consoles”,背后可能想买(商业意图),可能在比某个品牌某款机型,而且大概率想要最新的信息。扇出会把这几种需求都照顾到,各自生成接地查询。所以Dr. Pete说,接地查询能让人看到扇出的过程,但它终归是机器对搜索意图的一种理解,人的判断还得自己补上。
Moz收来的5333条查询长什么样?
样本是这么来的:Moz准备了1000个子话题,横跨不少行业,每个子话题让Gemini跑一遍,平均拿回五条左右的接地查询,一共5333条。表格里只有四列:子话题、查询原文、单词数、字符数。表格下载下来重新统计,原文给的几个数字都对得上。
长度落在过去叫长尾的那一段
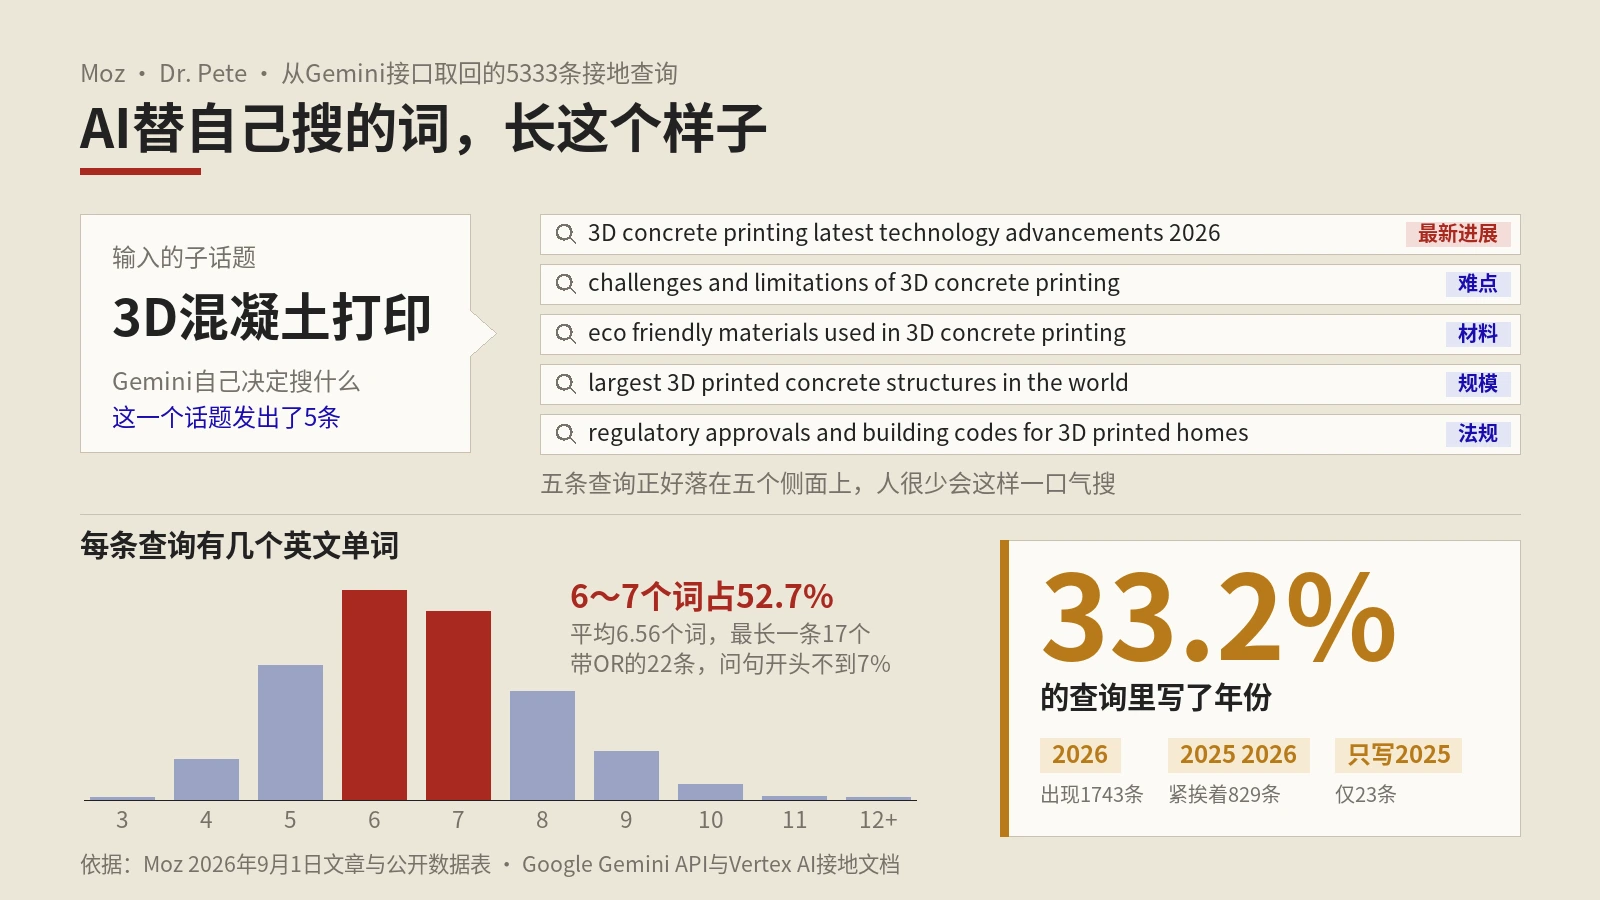
最短3个词,最长17个词,平均6.56个词,平均字符数46.7。六个词和七个词这两档加起来2813条,占52.7%,原文说的“过半是六到七个词”就是这个。完整分布如下:
| 单词数 | 条数 | 占比 |
|---|---|---|
| 3~4个词 | 305 | 5.7% |
| 5个词 | 950 | 17.8% |
| 6个词 | 1480 | 27.8% |
| 7个词 | 1333 | 25.0% |
| 8个词 | 767 | 14.4% |
| 9~10个词 | 456 | 8.6% |
| 11个词及以上 | 42 | 0.8% |
原文挑了三条落在六到七个词区间的例子:standard types of auto insurance coverage(车险的标准保障类型),must have baking tools equipment beginner(新手必备烘焙工具),extended stay hotel amenities vs traditional hotels(长住酒店和普通酒店的设施对比)。这类词放在今天的关键词研究里,也得往深处挖才挖得出来,属于传统意义上的长尾。Dr. Pete自己也说,在提示词和大模型的年代,“长尾”这个说法还管不管用,可以再争。关于长尾查询变长这件事,站内无限长尾那篇有更早的数据可以对照着看。
有些查询人根本不会这么搜
再看长的。全表最长的一条是17个词:
"best indie games of 2025" OR "biggest indie game hits of 2025" OR "popular indie games 2026"它直接用上了搜索运算符OR和引号。另外两条长例子是laptop gpu vs desktop gpu performance difference 2025 2026 rtx 40 50 series,还有semiconductor fabrication front end back end steps lithography deposition etching doping,一串相关术语挤在一行里。Dr. Pete说他敢打赌这几条的月搜索量是个位数,这个数字还可能是0。
不过从整张表看,这种带运算符的写法在全表里很少见:带OR的22条,带引号的33条,用site:限定站点的一条都没有。机器写的查询大多数还是普通的一串词,只是比人写得长、塞得满。以问句开头的(how、what、is之类)只有370条,不到7%。人对着AI说话喜欢用问句,AI转身去搜的时候,绝大多数改成了关键词串。
所以原文的结论是,接地查询也许参考过搜索数据,但整个过程是机器主导的。SEO们习惯把它想成我们熟悉的关键词研究,数据可不管我们习惯不习惯。说白了,这是Google自己替自己搜,去把它可能漏掉的内容找出来。
三分之一带着年份
5333条里有1769条出现了年份,占33.2%。把年份单独数一下,结果挺有意思:
| 年份写法 | 条数 | 说明 |
|---|---|---|
| 出现2026 | 1743 | 收集数据那年,覆盖了几乎全部带年份的查询 |
| 2025和2026同时出现 | 840 | 其中829条是“2025 2026”紧挨着写 |
| 只写2025不写2026 | 23 | 非常少 |
| 出现2027及以后 | 12 | 多是市场预测、利率预测、政策截止日 |
原文的解释是,Gemini认得自己的训练截止时间。Moz引用Google的说法,Gemini 3.5的训练截止在2026年3月,但有些数据可能早到2025年1月,和之前几代Gemini差不多。接地的一个目的就是越过训练数据的限制,拿到最新的结果。
保哥的读法更具体一点:只写2025的几乎没有,说明模型清楚现在是2026年;可带年份的查询里接近五成顺手捎上了2025。合理的猜测是,它怕今年的资料还没出来,干脆把去年也一起搜上,哪个有就用哪个。这只是根据写法的推断,Google没有解释过模型为什么这么写。
机器在查哪些侧面,内容就该补哪些侧面
把查询里反复出现的词数一遍,能看出机器搜东西时在找哪些侧面。下表是按单词在全表里检索的结果,一条查询可能同时命中几个词:
| 词 | 命中条数 | 它在找的东西 |
|---|---|---|
| trends | 755 | 近期趋势 |
| best/top | 330/194 | 推荐和排名 |
| market | 319 | 市场规模、行业格局 |
| how | 277 | 做法和原理 |
| vs | 238 | 两样东西的对比 |
| types | 191 | 分类 |
| challenges | 182 | 难点和限制 |
| benefits | 126 | 好处 |
| latest | 108 | 最新进展 |
| regulations | 89 | 法规 |
这张表很像一份写作提纲:某个话题有哪几类、各自优缺点、跟谁比、难在哪、最近有什么变化、受哪些法规管。拿一个子话题看更直观。表里第一个子话题是3D混凝土打印,Gemini发出的五条查询分别是:最新技术进展2026,挑战和限制,环保材料,世界上最大的3D打印混凝土建筑,3D打印房屋的监管审批和建筑规范。五条正好是五个侧面。
放到外贸站上,假设你卖工业烘干设备。一个只写产品参数的页面,能被“烘干设备类型”这种查询找到,可要是机器搜的是industrial dryer energy regulations 2025 2026,或者heat pump dryer vs gas dryer operating cost,它就接不住。这些侧面不一定要在一页里全塞进去,分在几篇文章里、互相链好也行,关键是站上得有人认真回答过。
年份那三分之一对内容的提示更直接。机器在找新东西,它判断新旧主要靠页面上能读到的时间信号。几件很实在的事:
- 有时效的内容,把发布日期和最近更新日期都写在正文能看到的地方,结构化数据里的datePublished和dateModified跟着对上。
- 年度内容(行业报告、价格表、法规汇总)每年单独出一版,标题里写清楚年份,旧版留着并链到新版,别在原地改个数字就当新的。
- 别光图蹭年份就把所有标题都改成“2026最新”。内容没变光改年份,读者一眼就能看穿,那些确实需要时效的页面也会跟着失去可信度。
页面上的年份还有个容易翻车的地方。页脚版权年份如果由前端脚本按访客电脑时间生成,可能显示一个根本没到的年份,站内有篇页脚版权年份的排查专门讲过。更新频率和AI引用的关系,可以看内容新鲜度的几条法则。
有人会问:既然这些查询搜索量接近零,SEO还管它干嘛?问题在于,它们被执行的次数取决于有多少人在问AI,关键词工具里的人工搜索量反映不了这个。一条查询在关键词工具里是0,可只要很多人问AI同一类问题,它就会被反复执行。工具里看不到,不代表没人在用。这也是为什么关键词研究需要往需求研究那边挪一步,站内关键词研究转向需求研究那篇讲过具体步骤。
这批数据是怎么取到的,又花了多少钱?
Moz用的是Gemini在Vertex平台上的接口。开启“用Google搜索接地”之后,返回结果里会有一个groundingMetadata对象,搜索词就放在这里。按Vertex AI的接地文档,这个对象里主要有四样东西:
| 字段 | 装的是什么 |
|---|---|
| webSearchQueries | 模型实际执行的搜索词,Moz收集的就是它 |
| groundingChunks | 搜回来用作依据的网页,含标题和域名 |
| groundingSupports | 答案里哪一段文字对应哪个来源 |
| searchEntryPoint | 一段现成的HTML和CSS,用来显示搜索建议 |
这里有个很多人没留意的规定。文档写明,只要接地结果里带了搜索建议,你的应用在生产环境里就必须把它展示出来,展示的就是webSearchQueries里的那些搜索词。这样一来,用Gemini接地做产品的第三方应用,按规定要把这些查询亮给用户看。接地查询本来就不是什么秘密,只是过去很少有人专门去收集。
原文自己认了两处“作弊”
Dr. Pete很坦白,说这事理论上令人兴奋,做起来挺乱,遇到两个大问题。
第一个问题是Gemini对接地很抠。哪怕用Gemini 3.5 Flash、把思考等级开到MEDIUM或更高,一次也很少拿到超过一两条接地查询,很多时候一条都没有。用过AI模式的人都知道,AI模式几乎总会跑好几条。Moz是靠调整系统指令,把Gemini推到每次生成四到六条。他承认这些查询是真的(Google确实执行了这些搜索),但“我们算是作了点弊”,AI模式和真实的扇出可能表现得很不一样。
这一点在数据里看得出来。1000个子话题里,有706个正好拿到5条查询,只有4条的108个,6条和7条的各65个,最多的一个16条。分布这么整齐,明显是指令在起作用。所以每个话题“五条左右”这个数是Moz定下的,Gemini自己并没有这个习惯。至于查询的长度、年份写法有没有被指令带偏,原文没公布系统指令,外人也没法判断。
第二个问题是贵。原文说,除了token费用,截至2026年8月接地查询的价格是每1000条14美元,而且按查询算,不按提示算。Gemini的文档举过一个例子:一个提示里模型先搜了UEFA Euro 2024 winner,又搜了Spain vs England Euro 2024 final score,这就算两次计费;空的搜索词不计。Moz平均每个提示跑五条,所以每100个提示光接地就要7美元左右,比token费用高出几个数量级,企业规模一跑就是一大笔。用第三方工具、填自己API密钥的,要盯紧账单。
按查询计费,比按提示计费贵还是便宜?
这个价格可以对照Gemini API定价页核一下。Gemini 3及以后的模型按查询计费,每月有5000条免费额度(所有Gemini 3及更新的模型共用),超出后每1000条14美元;Gemini 2.5及更早的模型按提示计费,每1000个接地提示35美元。两种算法放在一起比:
| 每个提示跑几条查询 | Gemini 3按查询计(每个提示) | Gemini 2.5按提示计(每个提示) |
|---|---|---|
| 1条 | 0.014美元 | 0.035美元 |
| 2.5条 | 0.035美元 | 0.035美元 |
| 5条(Moz的情况) | 0.07美元 | 0.035美元 |
分界线在每个提示2.5条查询。Gemini默认很抠,一般只跑一两条,这时候新算法反而便宜;像Moz这样逼它多跑,成本就翻倍。原文说的“贵”,有一部分是他们自己的做法造成的。
反过来算个小数:Moz这次5333条查询,扣掉每月5000条免费额度,超出333条,接地费用不到5美元(还没算token)。想用自己行业的几百个话题复现一次,钱不是门槛。花钱的大头在持续监控。每天跑两千个提示、每个两条查询,一个月是12万条,扣掉免费额度,光接地就要一千六百美元出头。
外贸站和独立站可以这样用这份表
Moz把5333条查询连同1000个子话题都放在一张公开表格里,原文最后也鼓励大家去看跟自己行业相关的部分。建议这么用:
- 在表里按子话题筛出跟你行业沾边的条目,看机器在你这个领域会搜哪些侧面。比如做储能的看能源类子话题,做美妆的看消费品类。
- 把这些侧面和你站上现有页面对一遍。哪些侧面有页面认真回答了,哪些只在产品页里一句话带过,哪些完全空白,列出来。
- 空白的侧面按业务价值排优先级。法规、对比、成本这几类,往往离询盘最近。
- 用自己的API小规模跑一批,几十个核心话题就够,免费额度基本覆盖。顺便看groundingChunks里引用了哪些网站,你的竞争对手有没有在里面。
- 改完内容隔几周再跑一次同样的话题,看引用来源有没有变化。注意每次结果本来就会波动,单次变化别急着下结论,站内AI引用测试怎么证明因果讲过怎么设对照。
不想自己调接口,也有别的路。站内写过AI后台搜索查询的几种抓取方法,包括角色模拟和接口截取;微软那边,Microsoft Clarity反推AI引用能看到Copilot等场景下的检索查询,Clarity最近给这些查询加了品牌词和非品牌词的标签,标签怎么画出来的、哪里会误判,可以看品牌词与非品牌词拆分那篇。
有一件事别做:拿到几百条接地查询,就一条一条去写页面,每条查询配一篇文章。这些查询每次生成都可能不一样,今天是这五条,明天换个说法又是另外五条。追着具体的词写,写不完也追不上。该做的是把它们归到侧面里,用侧面去补内容。
哪些结论别急着往自己身上套?
这份数据很有用,但它的样本范围决定了它能说明什么,几处得先讲清楚。
子话题只是一个个话题名,真实用户可不会这么提问。“3D混凝土打印”这种输入,天然把查询带向资料调研型。全表里带near me的查询一条没有,带price的只有5条。所以别从这份数据推出“机器不搜本地、不搜价格”,它只是没被问到这类问题。做本地生意和电商比价的,得用自己的真实提问去测。
只有Gemini,只有英文。ChatGPT、Perplexity、Copilot背后接的搜索引擎和改写方式都不同。站内微软Web IQ那篇讲过Bing给AI代理的接地接口,规则跟Google这套并不一样。中文、小语种的接地查询长什么样,这份数据回答不了。
接口不等于AI模式。原文自己说了,Gemini接口默认很少接地,AI模式几乎总在接地,Moz靠指令把两者的差距拉近了,但没法证明拉近之后的表现和AI模式一致。AI概览和AI模式本身的触发逻辑也不一样,这篇对照可以先看一下。
训练截止日期是Google公布的数。Gemini 3.5截止在2026年3月、部分数据早到2025年1月,这是Moz转述Google的说法。模型实际“知道”到哪一天,外部没办法精确验证。“模型因为知道自己知识旧,所以加年份”是合理推断,但也可能是系统层面的设计,比如接口把当前日期告诉了模型。
这些限制不影响数据的主要价值。它让大家用几千条真实样本看清楚,机器替自己写的搜索词是什么形状:比人长,比人满,在意时间,按侧面铺开。对写内容的人来说,这几条已经够用了。
常见问题解答
接地查询和用户输入的提示词有什么区别?
提示词是用户对AI说的话,通常是问句,可能很长还带上下文。接地查询是AI要回答这句话时,自己发给搜索引擎的搜索词。Moz的数据里,以问句开头的接地查询不到7%,大多数是六七个英文单词的关键词串,有时还带年份和OR运算符。
接地查询的搜索量接近零,还值得优化吗?
值得关注它代表的侧面,不值得逐条追。关键词工具统计的是人工搜索次数,接地查询是在AI回答别人问题时被执行的,次数不进这些工具。同一个话题每次生成的查询都会变,比较稳妥的做法是把它们归纳成类型、对比、挑战、趋势、法规这些侧面,用侧面去补内容。
怎么拿到Gemini的接地查询?
在Gemini的API里开启用Google搜索接地,返回结果的groundingMetadata对象中,webSearchQueries字段就是模型实际执行的搜索词。注意Gemini默认很少接地,常常一条都不给,Moz是通过调整系统指令才让它每次生成四到六条。
用API收集接地查询要花多少钱?
按Gemini API定价页,Gemini 3及以后的模型按查询计费,每月共享5000条免费额度,之后每1000条14美元,另算token费用。Moz平均每个提示五条查询,约合每100个提示7美元。小规模复现基本在免费额度内,长期大规模监控才会成为一笔明显的开支。
为什么三分之一的接地查询带年份?
模型的训练数据有截止日期,接地的目的之一就是拿到更新的信息,所以它常在查询里写上当前年份。Moz数据里带年份的占33.2%,其中有840条同时写了2025和2026。对内容方来说,把发布和更新日期写在页面上能看到的地方,年度内容每年单独出版,比较能接住这类查询。
这份数据能代表ChatGPT或AI模式吗?
不能直接代表。样本只来自Gemini接口、只有英文,子话题偏资料调研型,而且查询数量是用指令推出来的。原文作者自己也说AI模式和真实扇出可能表现很不一样。要了解其他平台,得用各自的工具或抓取方法单独看。
权威参考资料
本文标题:《AI接地查询长什么样?Moz公开的Gemini搜索词数据,看机器替自己搜什么》
本文链接:https://zhangwenbao.com/grounding-queries-ai-search-data.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0