SEO流量预测模型:用可被反驳的假设设定增长目标

本文目录
- 为什么凭感觉定SEO增长目标迟早会出问题?
- 拍脑袋目标的两种结局:报太高和报太低
- 预测最常见的两种滥用:曲棍球杆和保命数
- 预测不准也比没有强:它的用途不是预言
- 先区分:预测、季节性、见效周期、预算各管什么
- SEO流量预测模型由哪四块输入组成?
- 可触达需求池:只算你够得着的那部分搜索量
- 排名达成概率:用概率分布代替单一目标名次
- 点击曲线:同一名次点击差异很大,为什么不能套通用曲线?
- 季节性叠加:预测结果为什么必须是带形状的月度曲线?
- 四块相乘:最小可用的流量预测骨架
- 强季节DTC和无季节B2B站的流量预测有何不同?
- 滑雪装备DTC:关键在需求池收缩和季节形状
- B2B检测设备站:关键在点击截留和竞争位移
- 滑雪站四块相乘的示意算例
- 如何给出带情景区间、可被反驳的SEO流量预测?
- 单点数字不可信,预测为什么要给情景区间?
- 预测区间多宽才算诚实?
- 敏感度分析:每个假设出错会让结果偏多少?
- 新站和老站的流量预测为什么不能用同一套方法?
- AI概览和零点击怎样改变“排名→流量”的换算?
- 竞争位移:为什么要把对手的动作算进预测?
- 流量预测做完后怎样持续校准并用于决策?
- 为什么要把预测落成看板上的月度曲线?
- 偏差复盘:为什么定位出错的假设比记录差额更重要?
- 追踪预测准确率,模型才会越用越准
- 只预测总量够吗?流量结构变化也要单独预测
- 流量预测多久重做一次,由哪些条件触发?
- 如何把流量预测翻译成管理层能用于决策的语言?
- 常见问题解答
- 权威参考资料
摘要:SEO流量预测不是算命,它把“大概能涨到多少、有多大把握”写成能被反驳、事后能复盘的模型。拿不出可信预测,要预算、定KPI、跟老板对赌增长就只能拍脑袋,吹高了背锅,报低了被砍。一个站得住的预测由四块相乘:你够得着的可触达需求池、把名次换成概率的排名达成率、随名次剧烈变化且不能套通用值的点击曲线,再叠上带形状的季节性;最后给出区间,不给单个数,并计入竞争对手的动作。预测真正有用的地方,是逼你把每条假设写下来,事后逐块算账、越用越准。它与季节性预判(认规律别慌)、见效周期(多久见效)、预算ROI(拿数字算钱)是四件不同的事。下文先划边界,再用强季节DTC站与无季节B2B站对照演示。
做SEO的人迟早会被问:“做这个,明年能带来多少流量?”多数人的回答有两种,一种是含糊的“得看情况”,另一种是脱口报出一个让自己后半年不得安宁的数字。两种都不行:前者让你在预算桌上没有筹码,后者让你在复盘会上没有退路。本文讲中间那条路:怎样给出一个有区间、有假设、能被人当面反驳、事后能逐块对账的流量预测。
先划边界,因为这个主题很容易和保哥另外几篇混在一起。本文讲的是“向前推一个能定目标的流量数字”。它和SEO见效周期那篇不同:那篇回答“多久才见效”,是时间问题;本文回答“能到多少、多有把握”,是量级和置信度问题,见效周期只决定预测曲线从哪个月开始爬、爬得多陡。它也不讨论“认出每年都来的季节规律、别把规律当事故”,季节性在本文里只是预测模型的一块输入。它同样不负责把流量数字换算成钱和回报,那是预算模型的事;预测是那套模型最上游的输入,输入错了,后面算得再漂亮也是错的。
本文用两个对照案例贯穿:一个做滑雪与冬季户外装备的跨境DTC品牌(季节性极强),一个B2B工业检测设备的官网内容站(几乎没有季节性、决策周期长)。同一套方法在这两种站上的形态完全不同,这也说明预测没法套公式。
为什么凭感觉定SEO增长目标迟早会出问题?
先讲清不做预测的代价,否则很容易觉得“反正预测也不准,何必费这个劲”。
拍脑袋目标的两种结局:报太高和报太低
没有模型支撑的目标只有两个走向,都不好。报太高:为了在预算会上拿到资源,报了一个漂亮数字,没人追问这个数字怎么来的,半年后兑现不了,SEO这条线在管理层那里就被贴上“讲故事不靠谱”的标签,下一轮预算第一个被砍。报太低:被上一次的教训吓怕了,这次报一个闭着眼都能完成的数字,目标轻松达成,但你主动压低了这条增长线的天花板,资源、人手和注意力都流向那些“看起来更有想象力”的渠道。
两种结局的根源相同:没有模型,你和老板之间只能比谁的直觉更大声。比直觉,SEO几乎总是输的一方,因为它的反馈周期太长,等结果出来,赌注早已下完。
预测最常见的两种滥用:曲棍球杆和保命数
在不健康的组织里,预测会被当成两种政治工具,认出来才不会被卷进去。第一种是“曲棍球杆”:前几个月走平甚至下滑,全部增长都画在最后一个季度陡然拉起,凑出一个漂亮的年度数字。这种曲线几乎总是假的,因为SEO的真实增长是缓慢复利型的,不存在“前面不动、最后突然爆发”的内生机制;曲棍球杆通常是“先答应下来、增长以后再说”的财务故事,算不上预测。第二种是“保命数”:报一个自己闭着眼都能完成的数,把目标当成自我保护,达成了就邀功,也没人追问天花板在哪。
这两种做法的共同点,是把预测从“尽力说真话的估计”换成了“对自己最有利的叙事”。预测一旦服务于报数人的处境,不再服务于决策,模型再精细也已经从根上坏了。识别方法很简单:要求对方说出每一档背后“需要哪几个条件同时成立”。曲棍球杆和保命数都经不起这一问,因为它们的形状是从想要的结论倒推画出来的,没有从假设推导。
预测不准也比没有强:它的用途不是预言
很多人抗拒做预测,理由是“SEO变量太多,预测不可能准”。这话只对了一半:预测确实很难精确,而这正说明了它的真正用途——做预测的过程会逼你把每一条隐含假设都摊开写下来,这比最后那个数字有用得多。当你被迫写下“我假设这批词三个月内能进前五、点击曲线按这个行业的实测取值、转化率沿用历史中位数”,会发生三件事:一,这些假设从此可以被别人当面挑战,挑战假设比挑战一个光秃秃的数字有意义得多;二,结果出来后,你能准确知道是哪一条假设错了、错了多少,不会只剩一句“没达成”;三,下一次预测时你带着上次的偏差证据回来,模型会真的变准。
一个做了、错了、但能逐块归因的预测,和一个因为“反正不准”而从来没人做、也从来没人复盘的预测,差距在于这条线有没有积累判断力,准确率反倒是次要的。设想两个团队,一个常年凭感觉报数,一个每次都做会出错的预测但每次都复盘,三年后前者还在原地比嗓门,后者的预测已经能进决策桌。
先区分:预测、季节性、见效周期、预算各管什么
这四件事经常被混为一谈,混在一起谁也讲不清。下表列出它们各自的分工:
| 它回答的问题 | 这是哪件事 | 在本文里的角色 |
|---|---|---|
| 这波下滑该不该慌、是不是每年都来 | 季节性预判 | 预测模型的一块输入(曲线形状) |
| 要多久才开始见效 | 见效周期 | 决定预测曲线的爬升起点和斜率 |
| 能涨到多少、有多大把握 | 流量预测(本文) | 主题本身 |
| 这些流量值多少钱、值不值得投 | 预算与ROI模型 | 消费预测输出的下游 |
这条链的方向是:见效周期和季节性是预测的输入,预测是预算ROI的输入。如果把链条接反,比如直接拿一个没有置信区间的流量数字去算ROI,误差会沿着链条一路放大;最后那个精确到小数点的回报率建立在一个拍脑袋的输入上,算得越精确越危险。
SEO流量预测模型由哪四块输入组成?
把预测拆成四块独立的输入,分别估算、分别接受质疑,最后相乘。拆开的好处是出错时能定位到具体哪一块。
可触达需求池:只算你够得着的那部分搜索量
第一块,也是最多人做错的一块。新手做预测,第一步往往是把目标关键词的搜索量全部加起来,得到一个很大的数,再乘一个点击率了事。这个数从一开始就是错的,因为它假设你能吃下全部需求。真实的可触达需求池要做三层收缩:先剔掉意图不匹配的词(搜这个词的人不是你的用户,排上去也没用);再剔掉结果页被实体结果、官方答案、强势品牌词占满,自然位形同虚设的词;最后按你站点当前的权威度,给不同竞争档位的词打一个“现实可及”的折扣。面对同一批词,一个新站和一个行业老站的可触达池能差一个数量级。
预测里最大的系统性高估,几乎都发生在这一步:把“市场总需求”当成了“你够得着的需求”。那个滑雪装备DTC的第一版预测高得离谱,原因就是把一大批被大型综合电商和老牌品牌词牢牢占住的大词也算进了池子;按“自然位实际可见度近乎为零”剔掉这些词之后,可触达池只剩原始估计的一小部分,预测才回到现实。
排名达成概率:用概率分布代替单一目标名次
第二块。错误做法是给每个目标词钉死一个未来名次(“这个词我们会到第3”),再据此算流量。这等于在赌,因为你并不知道哪个词会到第几。正确做法是改用概率分布:根据这个词的竞争度、你站点的相对权威、内容当前的差距,估计它在预测期末落在第1、落在2-3、落在4-10、落在10名外的概率,再用这个分布计算期望流量。这样做有两个好处:一,单个词押错不致命,因为你算的是整组词的期望,不是押一个点;二,用概率表达名次会逼你诚实,你很难一边嘴上说“八成能进前三”,一边心里清楚这个词竞争度高得离谱。
这块概率的起点,是当前名次和可见度的真实状况,保哥在排名监测与可见度份额那篇里写得很细。这里只强调一点:起点估错,整块概率全歪。你以为某批词现在排在第二页、“离前几名不远”,实际它们卡在第五页,那么“三个月进前五”的概率就完全不是你估的那个值。
点击曲线:同一名次点击差异很大,为什么不能套通用曲线?
第三块,最容易被网上随手抄来的“第一名点击率百分之三十”带偏。点击曲线指每个名次能分到的点击比例,它并非一条固定曲线,会随查询类型、结果页形态、设备、品牌强弱剧烈变化。如果一个查询的结果页第一屏全是实体结果、广告和AI概览,自然第一名的实际点击率可能只有通用值的一小半;如果是纯信息查询、结果页干净,前几名的点击率又会明显高于通用值。套用通用点击曲线,是流量预测里仅次于“需求池没收缩”的第二大系统性误差来源。
可靠的做法是用你自己站点搜索后台的真实数据,按查询类型分桶,校准出属于你这个站、这类词的点击曲线,再拿它计算。没有自有数据的新站,至少要按结果页形态分类取不同的曲线,不能一条曲线用到底。那个B2B检测设备站就在这里吃过亏:它的词大量伴随强品牌或强实体结果,自然位点击被压得很低,第一版预测套了通用曲线,整体高估了近一倍。
季节性叠加:预测结果为什么必须是带形状的月度曲线?
第四块。前三块相乘得到的是一个“去季节化”的需求基线,但流量从来不会均匀分布在十二个月里,它有形状。滑雪装备那个DTC,全年六成以上的自然流量集中在四个月里;那个B2B检测设备站的曲线几乎是平的,只在客户财年预算窗口前有两个不明显的小鼓包。对季节性强的业务,把同一个年度总数平摊成月度目标会造成严重后果:旺季前你会因为“没达标”而慌乱调整,旺季高点又会误以为是自己的功劳。
所以预测的最终产物必须是一条带季节形状的月度曲线:用去季节化的基线乘以从历史数据中提取的季节指数。怎样干净地提取季节指数、怎样避免把品类趋势误当成季节,是季节性流量预判那篇专门讲的内容。这里只需知道:它是预测的最后一道乘法,跳过它,你的月度目标从第一个月起就是错的。
四块相乘:最小可用的流量预测骨架
四块凑齐,预测骨架就成形了,它由一连串可以逐项审视的乘法组成:
| 步骤 | 这一步在做什么 | 最容易出的错 |
|---|---|---|
| 1收缩需求池 | 从市场总需求收缩到你够得着的部分 | 把总需求当可触达需求 |
| 2名次转概率 | 给每个词的未来名次估概率分布 | 钉死单一名次,变成赌博 |
| 3套自有点击曲线 | 用按查询分桶校准过的曲线算点击 | 套网上的通用点击率 |
| 4叠季节形状 | 基线乘季节指数得月度曲线 | 把年度总数平摊到每月 |
| 5出区间 | 对关键假设取乐观/中性/保守三档 | 只给一个单点数字 |
这个骨架不复杂,真正难的是每一步背后的判断诚不诚实。整个预测的可信度由四块里最弱、最靠猜的那一块决定,算得最精细的那一块决定不了它。这条“最弱环节定上限”的规律比任何公式都重要:你把点击曲线校准到小数点后两位,需求池却只是拍脑袋估的,那这个预测的精度也只有拍脑袋的量级。
强季节DTC和无季节B2B站的流量预测有何不同?
把骨架套到两个对照案例上,同一套方法会产出两条完全不同的曲线,各自的关键风险点也不一样。
滑雪装备DTC:关键在需求池收缩和季节形状
这个站的目标词里混着大量高搜索量的品类大词,但这些词的结果页几乎被综合电商和老牌品牌占满,自然位可见度极低。它的预测成败取决于第一步需求池收缩够不够彻底,“能不能排上去”倒在其次:把“排上去也没人点”的大词剔干净之后,真正可触达的是一批中长尾的具体型号、场景、选购对比词。
第二个关键点是季节形状。这个品类全年六成以上流量集中在雪季前后四个月,如果预测只给一个年度总数再平摊,前八个月每个月都会“严重未达标”,团队会在淡季里频繁乱调,把好不容易积累的页面权重折腾掉。它正确的预测产物,是一条前低后高、峰值集中在雪季前导期的月度曲线;淡季的“低”在模型预期之内,不该触发任何动作。这个站的敏感度分析会显示:结果对需求池收缩比例和季节指数极其敏感,对单个词排到第几反而不敏感。
B2B检测设备站:关键在点击截留和竞争位移
这个站的情况正好相反。它几乎没有季节性,季节那一块乘的基本是1,不构成关键风险。它的词量不大但意图非常精准,决策周期长达数月。真正的关键风险有两个。一是点击曲线:它的词大量伴随强实体结果和强品牌位,自然第一名的实际点击率被压得很低,套通用曲线会让预测高估近一倍。二是这个细分市场只有几家在抢同一批词,是个近乎零和的小池子,你的流量增长很大程度上要从某个具体对手手里夺过来,很难指望“市场增长”凭空带来。
所以它的预测必须显式建模竞争位移:如果某个对手刚加大投入、内容明显在升级,你对那批词的达成概率就要相应调低。它的月度曲线几乎是平的,缓慢爬升,没有任何尖峰,但每个数都更可靠,因为意图纯、转化路径短。同样是四块方法,在它身上几乎用不到季节那块,却要额外加重竞争位移那块,这就是“预测不能套公式”的具体含义。
滑雪站四块相乘的示意算例
四块讲起来容易,落成数字才能看清关键环节怎样放大误差。下面是一个纯示意的算例,数字是为讲清结构编的,并非某个站的真实战绩,重点看误差怎样在乘法链里被放大。假设滑雪站初步圈了一批词,原始搜索量加总为每月一百万次。第一步需求池收缩:剔掉意图不符、自然位被综合电商和品牌词占满、以及超出本站权威可及范围的部分,真正可触达的大约只剩十五万。单这一步就把基数砍掉了八成五,后面所有乘法都建立在这十五万上,这一步估偏十个百分点,终值也跟着偏十个百分点。
第二步名次转概率:这十五万分散在很多词上,按各词的达成概率分布计算期望覆盖,假设期望能拿到其中四成的“有效曝光”,得六万。第三步套自有点击曲线:这类有强电商竞争的词,自有数据校准出的实际点击率远低于通用值,假设综合点击率为百分之十二,得到约七千二的去季节化月均自然访问。第四步叠季节:基线乘以季节指数,雪季前导月份的指数可能超过三百,深淡季不到三十,于是产物不是“每月七千二”,而是一条峰谷相差十倍的曲线。
这个算例要说明的重点在数字之外:四步里只要需求池和点击曲线两步各估偏一点,终值就能差出两三倍,而这两步恰恰最常被随手估算。前文“最弱环节定上限”落到算术上,就是这个样子。
如何给出带情景区间、可被反驳的SEO流量预测?
有了骨架和案例,接下来要让预测站得住:经得起追问,也扛得住现实波动。
单点数字不可信,预测为什么要给情景区间?
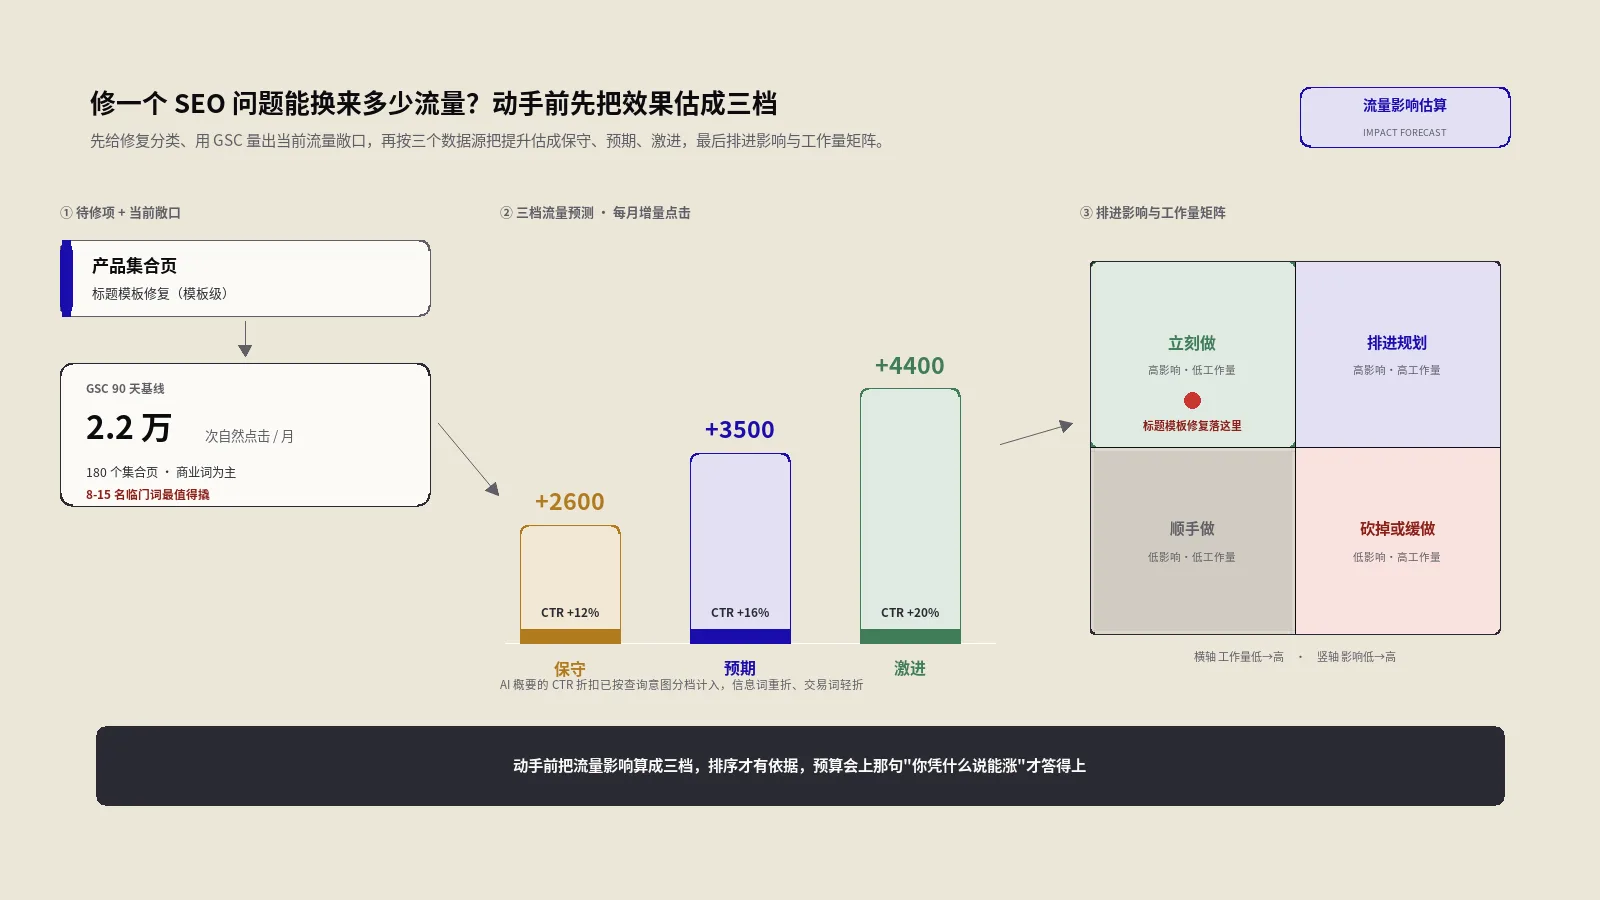
只有一个数字的流量预测都值得怀疑,因为它隐藏了不确定性,而不确定性正是这件事最该讨论的部分。正确的产物是三档情景:保守档(关键假设都往不利方向取合理下界,比如词排得比预期慢、点击被AI概览吃掉更多)、中性档(假设取最可能值)、乐观档(往有利方向取合理上界)。三档不是为了显得严谨,每一档背后都要写清“它成立需要哪几个条件同时为真”。
和管理层沟通时,最有用的是保守档,中性档那个数反而次要:保守档回答“最坏情况下这条线还值不值得投”,这个问题的答案决定要不要做。把三档一起拿出来,你的角色就从“报数字的人”变成了“管理风险的人”,这是预测在沟通层面最有分量的地方。
预测区间多宽才算诚实?
给了区间不等于诚实,区间的宽窄本身也在传递信息,需要把握好。窄到几乎是单点的区间是在假装确定,等于没给区间;宽到“从基本没涨到翻三倍”的区间覆盖了所有可能,听起来谨慎,其实同样没用,它等于在说“我不知道”,只是包装成了一张专业的表。区间的合理宽度,应当正好对应你对这件事真实的不确定程度:你对这个站、这类词掌握的真实数据越多,区间就该越窄;越是新站、越缺自有数据,区间就该如实放宽,并明确说明它会随数据逐月收窄。
判断带宽是否合理有个朴素办法:保守档和乐观档分别写出“它成立需要哪几个条件同时为真”。如果保守档的条件是“一切几乎都不顺”、乐观档是“一切几乎都顺”,而这两组条件你都认为有现实可能,这个宽度就是诚实的;如果为了让数字好看,你把乐观档的成立条件悄悄设成了“正常发挥”,区间再宽也是装出来的。带宽用来传达把握程度,不是给自己留退路的。
敏感度分析:每个假设出错会让结果偏多少?
有区间还不够,还要做敏感度分析:逐个假设问“如果只有这一条偏离,最终结果会变多少”。这项分析很有价值,它能指出整个预测押在哪一两条假设上。前面两个案例已经说明,滑雪站的关键在需求池收缩和季节指数,B2B站的关键在点击截留和竞争位移,同样是四块,敏感点完全不同。知道关键在哪,资源就该投向那里:把那一两条决定性假设用真实数据核实,其余假设允许粗估,这比把十条假设都粗估一遍更有效。对所有假设用同样粗的精度去估,等于把力气平均浪费了。
敏感度分析也是应对质疑的有效工具。对方问“你这个词凭什么能排上去”,你可以直接回答:“这条假设就算完全不成立,整体也只偏百分之几,真正决定成败的是另外那条,我们来谈那条。”这样就把讨论引到了真正重要的地方。
新站和老站的流量预测为什么不能用同一套方法?
这是一个分水岭,方法用错,预测必然作废。老站有自己的历史数据:自有点击曲线、各竞争档位词的真实达成率、季节指数,都能从过去十几个月的数据里提取出来,预测是“基于自身历史外推”。新站什么都没有,硬套老站的方法只会得到一个看着精确、实际全靠猜想的数。
新站的正确做法是“先借外部曲线起步,再用自有数据替换”:点击曲线先借同类站的公开实测,季节形状先借品类趋势数据,达成率先借“这个权威度的新站通常多久能进入某竞争档”的行业经验值,给出一个明确标注“高度不确定”的宽区间;然后从第一个月起按真实数据逐块替换借来的假设,通常三到六个月后,预测就从“借来的”收敛成“自己的”。新站预测最该承诺的是“这个区间会随数据进来每月收窄”这件事本身,具体数字反倒次要,这才是诚实且专业的做法。
AI概览和零点击怎样改变“排名→流量”的换算?
传统预测链条有一个默认前提:排到某个名次,就能按点击曲线拿到对应比例的点击。结果页的变化正在系统性地削弱这个前提。越来越多查询的第一屏被AI概览、实体结果和各类富媒体模块占据,答案被直接前置,用户看完就走,自然结果即使排第一,也只能分到压缩后的剩余点击。
这对预测的具体影响是:点击曲线这一块必须额外乘一个“点击截留系数”,而且这个系数按查询类型分桶时差异极大,信息型、问答型查询被截留得最多,交易型、导航型相对安全。不计入这一层的预测会系统性高估信息类内容的流量,而很多内容站的预测恰恰大量押在信息类词上,结果整体偏高而自己察觉不到。这个系数没有现成公式可算,但至少要做到三点:在预测里把它列为一条显式假设,按查询类型分别取值,并纳入敏感度分析,因为它正在成为很多站预测偏差里最大的一块。
竞争位移:为什么要把对手的动作算进预测?
还有一个几乎人人都会漏掉的因素:搜索结果页前几名的位置是有限的,你增长的那部分流量,很多时候来自某个具体对手的位置,“市场总量增长”贡献的没那么多。这带来两个结论。其一,在竞争充分的细分市场,预测必须明确问一句“我要从谁手里抢这批位置,他正在做什么”;如果对手刚融资、内容明显在系统性升级,你那批词的达成概率就得下调,不能按自己单方面的努力线性外推。其二,反过来也成立:你自己的大规模内容升级或站点改版,可能把流量从对手那里吸过来,对手的流量会下降,他们也会做出反应。
把市场当成一个只靠自己努力就能线性变好的真空环境,是乐观档总是过度乐观的主要原因之一;在零和的位置竞争里,对手不会原地不动。预测里至少要为“预测期内前几名竞争格局的变化”留一条显式假设,哪怕只是定性标注“假设主要对手维持现状”,也比默认它不存在强,因为这条假设一旦被打破,偏差会很大,而且来得突然。
流量预测做完后怎样持续校准并用于决策?
多数预测做完就放进某个文档夹,再没人打开,等于没做。要让它持续发挥作用,需要遵守下面几条规则。
为什么要把预测落成看板上的月度曲线?
只有年终一个数的预测,全年都用不上:要到十二月才知道对不对,那时已经来不及了。预测必须落成一条月度预期曲线(带季节形状的那条),挂在团队每天都能看到的看板上,每个月把实际值标上去,和预期区间对比。这样做主要不是为了考核,而是把一个长周期的赌注拆成每个月都能拿到的早期信号:连续两三个月稳定落在保守档下沿之外,说明某条假设系统性出错,这时离年终还远,来得及排查和调整。等到年底才发现差距很大,就连归因的机会都没有了。月度曲线把“事后算总账”变成了“过程中能干预”,这是它最大的用处。
偏差复盘:为什么定位出错的假设比记录差额更重要?
复盘时,绝大多数团队只记录一个结论:“预测X,实际Y,差了百分之多少。”这个数字本身几乎没有信息量。有信息量的做法是把偏差拆回四块:是需求池估高了,排名达成比预期慢,点击曲线被AI概览截留得比预估多,季节性判断错了,还是某个对手的动作没算进去?预测由几块相乘得出,偏差也能按乘法拆回去,定位到具体哪一块偏了多少。
一次能拆到具体假设的偏差复盘,比十次只记“差了多少”的复盘更能让模型变准,因为它指明了下次该替换哪一块的估算方法。这也是前文反复强调“预测要把假设写下来”的原因:没写下来的假设,事后无法归因,复盘就只剩下记录一个没用的差额。
追踪预测准确率,模型才会越用越准
把每次预测的偏差按上面的方式拆解,记进一个长期台账,你会得到一个很有价值的新指标:团队在这类站、这类词上的预测准确率,以及更重要的一点,你习惯在哪一块高估、哪一块低估。比如几轮下来你发现自己总是把需求池估高两成左右,从下一次起就可以系统性地修正这个已知偏差。预测能不能越来越准,取决于你有没有把自己的预测偏差当作长期追踪的对象,模型复杂与否影响不大。不追踪准确率,每次预测都是从零开始的猜测,做十年也不会比第一次强;追踪了,三五次之后准确率就开始累积提升。
只预测总量够吗?流量结构变化也要单独预测
几乎所有人只预测一个数:总自然流量。这会漏掉一类很危险的情况:总量看着达标,内部结构已经恶化。常见的有几种:品牌词流量在涨、非品牌词在掉,加总后总量持平,但真正该靠SEO拿下的增量需求其实在流失,品牌词的上涨本是市场和广告的功劳,却被算到了SEO头上;或者高商业意图词的流量在减少、低意图的泛信息流量在增加,总量甚至更好看,但这批流量的转化价值完全不同。
所以预测时至少要把流量拆成两到三类分别预测:品牌与非品牌、高意图与泛信息、旺季依赖型与常年型。复盘时也按这几类分别对账,不能只看一条总线。只盯总量的预测,会让你在结构已经恶化时毫无察觉,以为一切按计划进行,等转化和营收下滑才反应过来,已经晚了一两个季度。预测的粒度至少要大致匹配这些流量在商业价值上的差异,否则那个达标的总数会误导人。
流量预测多久重做一次,由哪些条件触发?
预测不应在年初做完就锁定到年底,它应该滚动更新:每个月用最新实际值校正一次假设、收窄一次区间,这是常规节奏。此外,有几类事件应当强制触发重做,不必等下个周期:结果页形态明显变化(比如目标词大面积出现AI概览)、核心算法更新后排名结构重排、体量很大的内容或技术改动上线、主要竞争对手出现明显动作。
把预测当成年初签完就不再改动的合同,是它失效的最常见方式:环境变了,预测没变,后面每个月的对比都建立在一个已经过时的预期上,看似在盯曲线,其实是拿旧地图找新路。重做不等于推翻,多数时候只是把一两块假设换成新证据、重新收窄区间,半天就能完成,但这半天决定了后面几个月的对比有没有意义。
如何把流量预测翻译成管理层能用于决策的语言?
最后一步,也是技术型从业者最容易出问题的地方:预测做得再扎实,表达方式不对,拿到管理层面前也等于没做。管理层不关心点击曲线怎么校准,他们关心三件事:保守情况下这条线值不值得投、要投多少、投多久,以及凭什么相信这次的数字。相应地,汇报时不该拿出一张满是关键词和名次的表,而应给出三样东西:三档区间(重点讲保守档)、支撑预测的几条关键假设(点出敏感度最高的一两条)、以及区间随数据进来多久会收窄。
这份预测最终会成为SEO预算与ROI模型的输入,所以它必须以对方能直接拿去算钱的形式给出,不能是一份还要对方自己翻译的技术产物。如果一个流量预测没法翻译成“最坏情况、需要多少投入、多久能验证”这三句话,算得再精,在决策桌上也用不上。
常见问题解答
问:SEO流量到底能不能预测,会不会就是算命?
能预测,但不可能精确。它有用的地方是逼你把假设写下来,让假设能被反驳,事后能逐块归因。给出的是区间和假设,不是一个单点数字,这就和算命不同。
问:流量预测和季节性预判是一回事吗?
不是。季节性预判是认出每年都来的规律,避免把规律当成事故;它在预测里只是其中一块输入(曲线形状)。预测回答的是能涨到多少、有多大把握。
问:做预测第一步最容易错在哪?
把市场总搜索量加总当成可触达需求。必须按意图、结果页占用、站点权威三层收缩,最大的系统性高估几乎都发生在这一步。
问:为什么不能给目标词钉死一个未来名次?
钉死名次是在赌,算不上预测。应改用概率分布,估计它落在各名次区间的概率再算期望,这样单个词押错也不致命,同时逼自己如实评估竞争度。
问:网上的“第一名点击率百分之多少”能直接用吗?
不能。点击曲线随查询类型、结果页形态、设备剧烈变化,套用通用值是第二大系统性误差来源。要用自有后台数据按查询类型分桶校准。
问:新站没有历史数据,怎么做预测?
先借外部曲线起步(同类站点击率、品类季节趋势、行业达成经验值),给出一个标注高度不确定的宽区间,再按真实数据逐月替换,三到六个月收敛成自有模型。
问:AI概览会让流量预测彻底失效吗?
不会失效,但必须在点击曲线上加一个按查询类型分桶的点击截留系数,信息型、问答型查询被截留得最多。不计入这一层,会系统性高估信息类内容的流量。
问:预测做完最该交给老板的是什么?
保守档、关键假设和收窄节奏,中性档那个数反而次要:最坏情况下值不值得投、预测靠哪几条假设支撑、区间多久会随数据收窄。这三句话才进得了决策桌。
权威参考资料
本文标题:《SEO流量预测模型:用可被反驳的假设设定增长目标》
本文链接:https://zhangwenbao.com/seo-traffic-forecasting-model-credible-targets.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0