GEO策略自进化:AgenticGEO的MAP-Elites档案与落地路径
本文目录
- 为什么人工设计的GEO策略会逐渐失效?
- GEO是什么,现有GEO方法卡在哪里?
- 什么是GEO?一句话定义
- 现有GEO方法的短板在哪里
- AgenticGEO如何让GEO策略自动进化出来?
- 从“人工设计”到“自动发现”的方法转变
- 系统架构总览
- MAP-Elites策略档案在AgenticGEO中如何运作?
- 什么是MAP-Elites?为什么它比“只选最好的”更合适
- 策略变异机制:5个维度各自进化
- Value-Novelty门控:同时看分数和新颖度
- AgenticGEO的协同进化评审模型如何降低评估成本?
- 为什么需要评审模型?
- 评审模型的训练方法
- 协同进化循环
- AgenticGEO消融实验中哪个组件贡献最大?
- 去掉进化档案后性能下降最大
- 评审模型有效替代了真实引擎反馈
- 跨域迁移能力
- 进化出的GEO策略比人工设计的策略精细在哪里?
- AgenticGEO对日常GEO优化有哪5条启示?
- 个人和技术团队怎样落地GEO策略进化?
- 个人和小团队的落地方案
- 技术团队的进阶实现
- AgenticGEO研究有哪些边界与局限性?
- 现实环境比实验更复杂
- 黑帽风险不容忽视
- 计算成本仍然不低
- GEO自动化优化接下来会往哪里走?
- 从“人工优化”走向“自动优化”
- 内容质量仍是底线
- AI搜索生态的治理挑战
- GEO自进化框架用到国产AI引擎上,需要替换哪些部分?
- 种子策略库:国产引擎上的初始有效性排序不同
- 反馈回路:拿不到引用API时,评审模型(Critic)要用国产数据重训
- MAP-Elites策略档案为什么不能只追求策略数量?
- 常见问题解答
- AgenticGEO和传统GEO方法的最大区别是什么?
- MAP-Elites策略档案具体是怎么工作的?
- 普通站长和SEO人员能从AgenticGEO中学到什么?
- AgenticGEO的进化策略会不会被AI引擎识别为操纵?
- AgenticGEO的消融实验中,哪个组件对性能影响最大?
- AgenticGEO需要多少真实引擎反馈才能有效运行?
- GEO自动化会不会导致所有内容都变得雷同?
- 权威参考资料
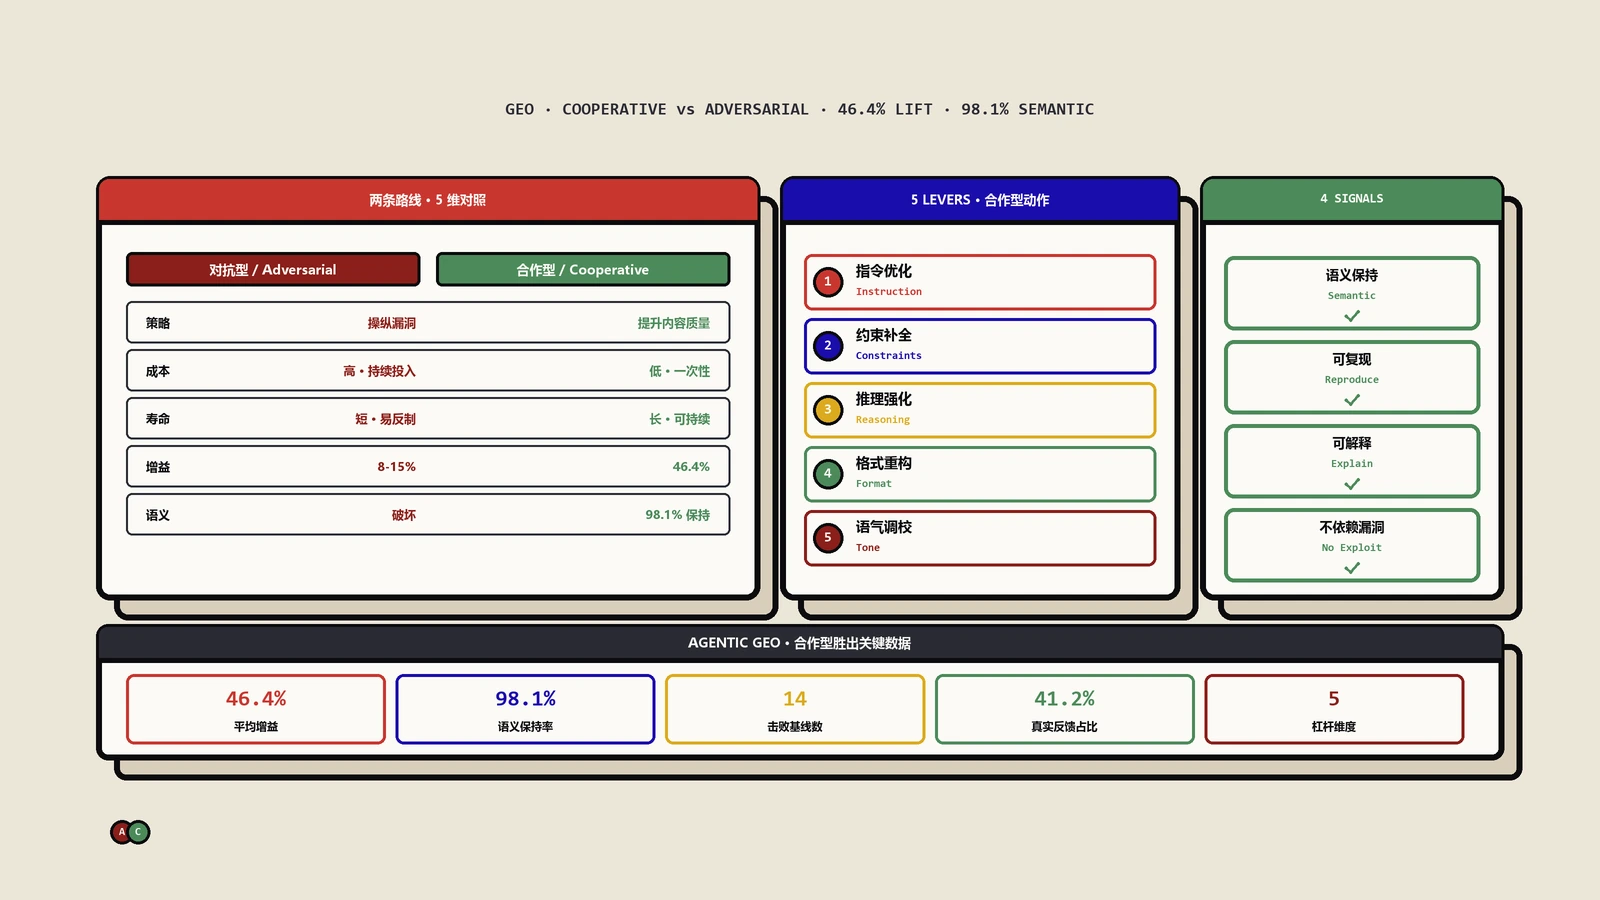
摘要:GEO没法靠花钱直接买到效果。在9种主流改写策略下,接近一半的内容样本用任何现有策略都优化不动;AgenticGEO改由进化算法生成、筛选和淘汰策略,在3个数据集上比14种基线平均高出46.4%,只用41.2%的真实引擎反馈就保留了98.1%的性能。文章逐项拆开它的策略档案、评审模型和消融结果,说明静态策略为什么跟不上引擎变化,并给出5条启示和个人、小团队的落地路径。
为什么人工设计的GEO策略会逐渐失效?
做过GEO优化的人大多遇到过这种情况:某个策略上周还管用,这周效果就打了折扣。你总结出的“加权威引用”“插入统计数据”“改写为问答格式”这些套路,用过几轮之后,AI搜索引擎似乎就不再买账了。
这并非错觉。一项针对GEO-Bench数据集的策略敏感性分析显示,在9种主流改写策略中,接近一半的内容样本无法通过任何现有策略得到有效优化。不同内容对策略的偏好差异也很大:对A内容有效的策略,套到B内容上可能完全无效,甚至起反作用。
由此可见,靠人工总结规则、手动挑选策略的GEO优化方式,上限已经很明显。
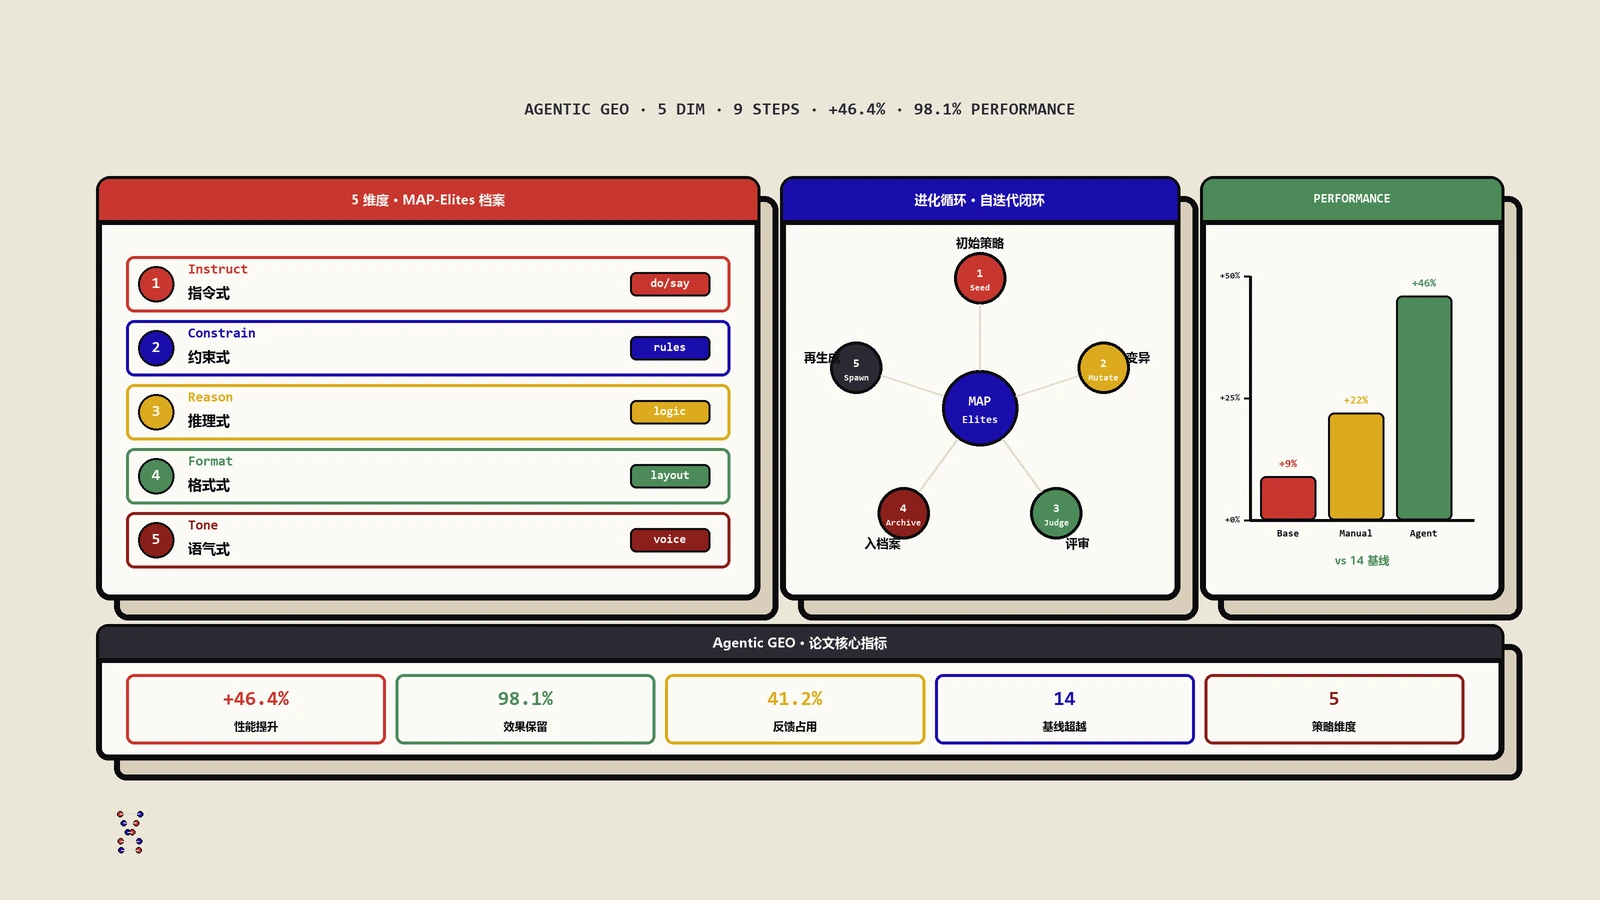
2026年3月,arXiv上的一篇论文换了个思路:让AI自己去发明更好的GEO优化策略。这个系统不依赖人工设计规则,用进化算法自动生成、筛选和积累策略,最终在3个数据集上超过了14种基线方法,平均提升46.4%。
下面把这篇论文的核心机制逐一拆开,再说明它对实际GEO工作有哪些启示。
GEO是什么,现有GEO方法卡在哪里?
什么是GEO?一句话定义
GEO(Generative Engine Optimization,生成式引擎优化)是面向AI搜索引擎(如Google AI Overviews、Perplexity、ChatGPT Search等)优化内容的方法,目标是让你的内容被AI引擎引用为回答来源,而不只是在传统搜索结果中取得排名。
传统SEO追求“排名位置”,GEO看的是两个核心指标:可见性(你的信息有多少被写进AI的回答)和归因性(AI是否明确引用了你的来源)。
现有GEO方法的短板在哪里
目前GEO领域的方法大致分两类,各有明显短板:
第一类:静态启发式方法。 代表是2024年普林斯顿大学发表的GEO原始论文。这类方法定义一组固定的改写策略模板(比如“添加权威引用”“插入统计数据”“优化可引用性”等),再让LLM按模板改写内容。问题在于这些策略一刀切:不管内容是医疗还是电商、是技术文档还是评测文章,都套同一组模板,内容之间的差异被完全忽略了。
第二类:基于学习的方法。 代表是AutoGEO。这类方法尝试从AI引擎的反馈中蒸馏出偏好规则,再用规则指导改写。它比静态方法灵活,但有两个硬伤:一是容易过拟合到引擎当前的行为,引擎一更新就失效;二是需要大量与引擎交互得到的反馈数据,实际成本很高。
这两类方法的共同问题是:用固定的规则去应对不断变化的系统。好比拿一把固定形状的钥匙,去开一把每天都换锁芯的锁,偶尔能打开,多数时候打不开。
AgenticGEO如何让GEO策略自动进化出来?
从“人工设计”到“自动发现”的方法转变
AgenticGEO的核心思想可以概括为一句话:GEO策略不再由人设计,交给AI系统通过进化自动发现。
这对GEO领域是一次方法上的转变。过去的流程是:SEO/GEO专家根据经验总结规则 → 写成改写模板 → 批量应用。AgenticGEO的流程是:从少量种子策略出发 → 用进化算法反复变异和筛选 → 自动积累一个规模大、类型多的策略档案 → 针对每条具体内容,从档案中选出最匹配的策略组合。
打个比方:传统方法像医生凭经验开固定药方;AgenticGEO更像药物筛选,在大量候选分子中做实验,找出对特定靶点最有效的那个。前者依赖个人经验,后者依赖系统性搜索。
系统架构总览
AgenticGEO分三个阶段:
离线评审对齐阶段。 先训练一个轻量级的评审模型(Critic),让它学会预测某个策略作用于某条内容后,AI引擎会给出多少分。它相当于一个代理考官:改写后的内容不必每次都提交给真实AI引擎评判(成本太高),先由代理考官预筛一轮。
在线协同进化阶段。 这是系统的核心。策略档案(MAP-Elites Archive)和评审模型在这一阶段同步进化:档案持续产出新策略,评审模型持续校准自己的判断,两者相互推动。
推理阶段。 拿到一条待优化内容后,系统从进化好的策略档案中选出最合适的策略,做多轮迭代改写,直到效果不再提升。
MAP-Elites策略档案在AgenticGEO中如何运作?
什么是MAP-Elites?为什么它比“只选最好的”更合适
MAP-Elites是一种质量-多样性(Quality-Diversity)进化算法,由法国机器人学研究者Mouret和Clune在2015年提出。它的做法是:不只保留“最好的”解,而是保留“每种类型中最好的”解。
这样做的原因在于:假设得分最高的策略是“学术权威型”,对论文类内容效果极好,对产品评测类内容却很差。如果只保留这一个冠军策略,遇到产品评测就没有可用的方案。MAP-Elites会同时保留“学术权威型冠军”“通俗易懂型冠军”“数据驱动型冠军”等多个类型的冠军,面对不同类型的内容都有合适的策略可选。
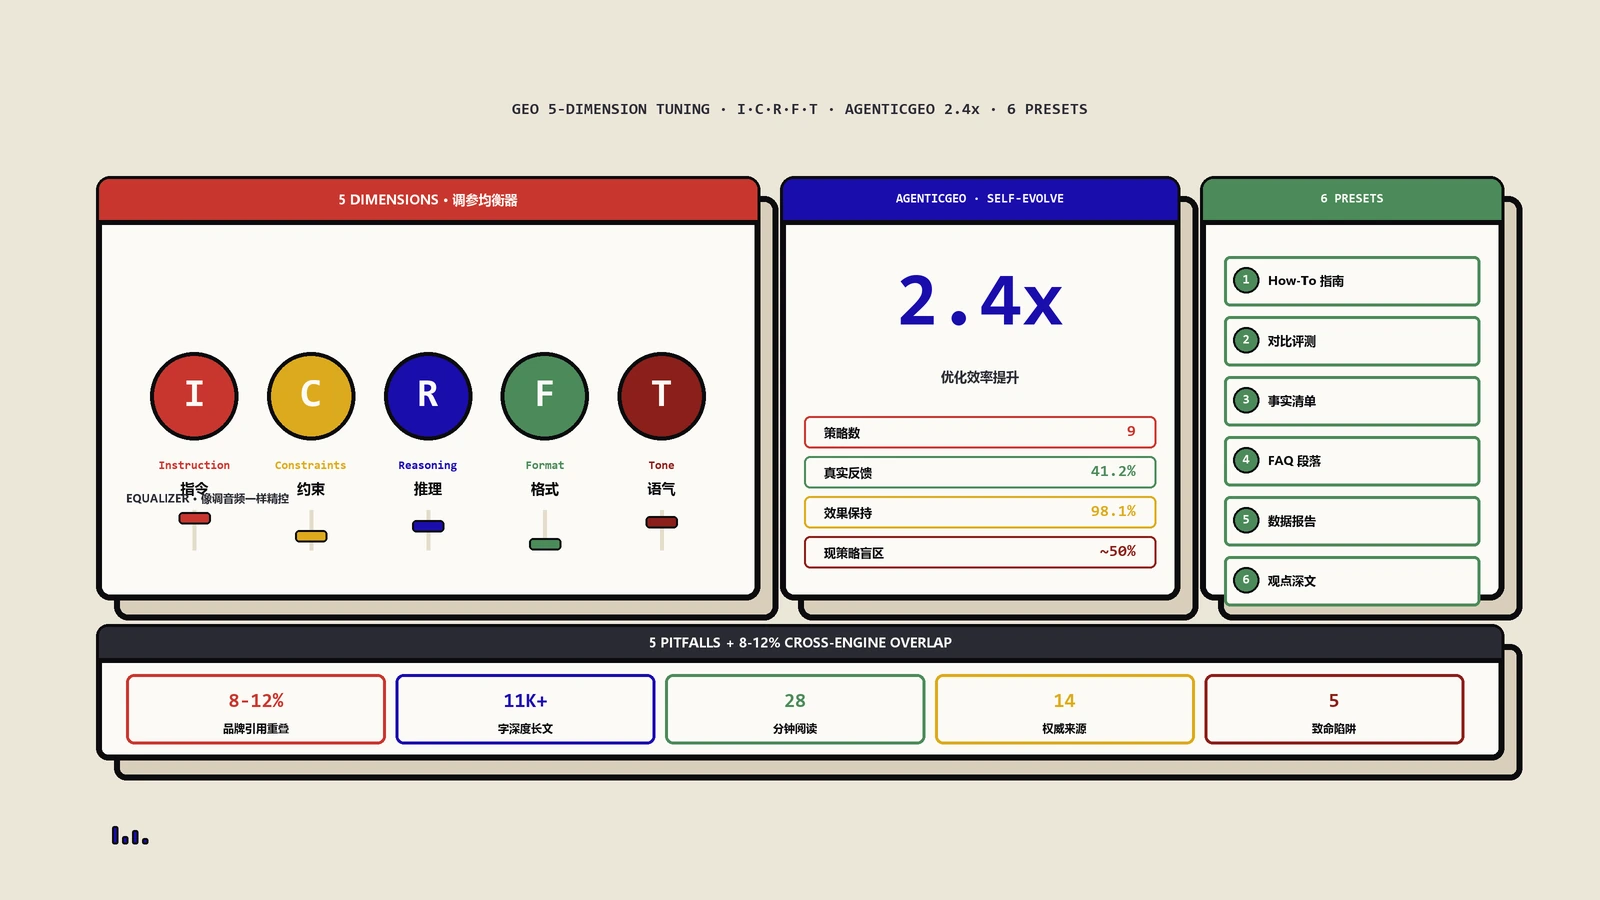
在AgenticGEO中,每个策略由5个维度组合而成:
| 维度 | 含义 | 举例 |
|---|---|---|
| 指令(Instruction) | 定义改写的目标和范围 | 目标受众、需要强调的核心事实、扮演的专家角色 |
| 约束(Constraints) | 设定改写的硬边界 | 字数限制、必须引用来源、禁止臆造事实 |
| 推理(Reasoning) | 添加逻辑推理步骤 | 冲突解决、自我纠错、逻辑验证 |
| 格式(Format) | 控制输出结构 | 列表式、代码块、分段式、表格式 |
| 语气(Tone) | 调整写作风格 | 权威断言型、技术专业型、通俗易懂型 |
MAP-Elites把这5个维度组合成一个多维网格,每个网格单元对应一种策略类型。比如“权威语气 + 列表格式 + 严格引用约束”就是一个单元,系统在这个单元里只保留效果最好的那条策略。
策略变异机制:5个维度各自进化
进化算法靠“变异”推进:从现有的优秀策略出发做小幅修改,看能否得到更好的结果。AgenticGEO的变异有两种方式:
神经变异。 由专门训练的进化器(Evolver)模型执行。它接收一个父策略,选出5个维度中的一个或几个进行改写。例如把“使用权威学术引用”改成“使用行业领军人物的第一手观点引用”。
符号扰动。 一种更简单的机械式变异:随机交换两个维度的内容、删掉某个维度的部分约束,或者把两个父策略的不同维度拼在一起。
两种方式互补:神经变异更有针对性,但计算成本高;符号扰动随机性更强,能保证多样性。
Value-Novelty门控:同时看分数和新颖度
新生成的策略要进入MAP-Elites档案,需要过两道关:
价值关卡(Value Gate)。 这个策略在对应网格单元里的得分是否超过当前冠军?超过就直接替换。
新颖性关卡(Novelty Gate)。 即使分数没超过现有冠军,只要它与档案中所有现有策略的差异足够大(用n-gram距离衡量),也可以进入其他空位。类似球队选人,既要全能型球员,也要有独特技能的专项球员。
为控制档案容量,系统还给每个策略计算一个综合的PND分数(Pareto-Novelty-Diversity Score),档案满员时淘汰效果一般、差异也不大的策略。
AgenticGEO的协同进化评审模型如何降低评估成本?
为什么需要评审模型?
GEO优化的一个核心难点是:改写后的内容会不会被AI引擎引用,事先无从得知。唯一的办法是把改写后的内容提交给AI引擎,等它生成回答,再看你的内容有没有出现在回答里。
这个过程成本很高:每次提交都要消耗AI引擎的计算资源,延迟也大。如果每生成一个候选策略都跑一次完整的AI引擎评估,进化过程根本跑不起来。
AgenticGEO的做法是训练一个轻量级评审模型充当代理,快速预测某个策略作用于某条内容后的效果分数。这样进化过程中90%以上的评估可以交给评审模型,只有少量关键评估才需要真实引擎反馈。
评审模型的训练方法
评审模型的架构是一个轻量级解码器语言模型加一个价值头(Value Head)。训练目标结合了两种损失函数:
回归损失。 让评审模型预测的分数尽量接近真实引擎的反馈分数,用Huber损失函数降低噪声影响。
排序损失。 这一项更重要,目标是让评审模型把顺序排对:对同一条内容,好策略的预测分数应高于差策略。这里用的是加权的pairwise ranking loss,排名靠前的策略对权重更大。
训练分两个阶段:先冻结语言模型骨架、只训练价值头(防止表示崩溃),再解冻全部参数联合微调。
协同进化循环
在线阶段,系统每轮迭代执行下面四步:
第一步:生成候选。 从MAP-Elites档案中采样父策略,通过神经变异和符号扰动生成一批候选新策略。
第二步:评审筛选。 用评审模型给所有候选策略打分,只把得分最高的一小部分(外加少量随机抽取的)送去真实引擎评估。
第三步:真实评估与档案更新。 拿到真实引擎的准确反馈后,更新MAP-Elites档案,淘汰不达标的旧策略。
第四步:双向更新。 用新拿到的真实反馈数据更新评审模型(让它判断更准),同时用评审反馈更新进化器(让它变异得更有效)。
这个循环形成正反馈:评审模型越准,进化方向越对,产出的好策略越多;好策略越多,真实反馈数据越丰富,评审模型又能校准得更准。“协同进化”指的就是两个组件这样相互推动、逐轮提升。
AgenticGEO消融实验中哪个组件贡献最大?
去掉进化档案后性能下降最大
论文里说服力最强的是消融分析。研究者逐个去掉AgenticGEO的核心组件,观察性能变化。结果显示:
去掉进化策略档案(只保留初始种子策略、不再进化)后,性能下降幅度最大。 这说明AgenticGEO的效果主要来自策略的自动进化和积累,评审模型或多轮改写机制的作用排在其后。
对实践者来说,这个结果意味着:用更强的模型去执行同样几条策略,效果提升有限。关键在于策略本身的多样性和质量。
评审模型有效替代了真实引擎反馈
另一项关键实验显示:把真实引擎反馈减少到原来的41.2%,AgenticGEO仍能保留98.1%的性能。评审模型作为引擎的代理效果很好,大幅降低了优化成本。
跨域迁移能力
AgenticGEO在一个领域训练出的策略档案,迁移到完全不同的领域后依然有效。这表明进化出的策略学到的并非特定领域的知识,而是更通用的“让AI引擎更容易引用内容”的底层模式。
进化出的GEO策略比人工设计的策略精细在哪里?
论文附录给出了一个具体案例,对比进化产生的策略和人工设计的策略。
人工设计的策略通常很粗,比如“添加权威引用”。进化产生的策略往往包含很细的组合指令,例如:
“以领域专家的身份改写内容,在每个核心论点后添加具体的量化数据或来源引用。输出使用清晰的层级标题结构,每个段落控制在3-4句话以内。保持断言式的语气,避免模棱两可的表述。在改写前先列出原文的3个核心论点,然后逐一增强。”
这条策略比人工总结的经验规则细得多,它同时控制了格式、语气、推理步骤、内容约束和指令目标这5个维度,各项要求之间相互配合。
人类专家能总结出“加引用有效”“用列表格式有效”这类单维度规律,却很难穷举所有维度的最优组合。进化算法擅长的正是在这种高维组合空间里搜索。
AgenticGEO对日常GEO优化有哪5条启示?
启示一:按内容类型准备不同的策略池。别再找“一条万能的GEO策略”。更可行的做法是给不同类型的内容建立不同的优化策略池,再通过测试找出最匹配的策略。
实操建议: 把内容按类型分好(产品页、博客文章、FAQ页面、评测内容等),每种类型至少准备3-5条有差异的改写策略,然后用A/B测试筛选。如果想先了解内容当前的GEO优化水平,可以用保哥开发的GEO内容分析优化工具做一次全面诊断,看看哪些维度还有提升空间。
启示二:保持策略多样性。这是MAP-Elites架构带来的最大启示:GEO优化中,保持策略多样性比把单一策略优化到极致更有价值。AI引擎的行为一直在变,今天效果最好的策略,明天可能就被引擎更新抵消了。
实操建议: 优化内容时别把所有鸡蛋放在一个篮子里。比如不要所有页面都用“添加权威引用+数据支撑”这一种套路,让不同页面试不同的策略组合:有的侧重结构化表达,有的侧重情感共鸣,有的侧重技术深度。
启示三:用评审清单代替评审模型。AgenticGEO中的评审模型相当于一个预测器,预测什么样的内容更容易被AI引擎引用。你不必真的训练一个模型,但可以建一份类似的评审清单来检查自己的内容。
实操建议: 建一份GEO内容评审清单,至少包含这些维度:信息密度够不够高?有没有明确的定义性语句(方便AI直接引用)?有没有量化数据支撑?内容结构是否清晰、便于解析?语气是否权威、明确?每次发布前按清单过一遍。
启示四:优化多个维度的组合效果。进化策略能超过人工策略,关键在于它优化的是5个维度的组合效果。人类专家往往只盯单点,比如“加了引用效果好”“用了列表格式效果好”,忽略了这些维度之间的相互作用。
实操建议: 下次优化内容时,别只做一件事(比如只加几条统计数据)。试着同时调整格式结构、语气风格、论证方式和引用策略,看组合之后效果有没有明显跃升。
启示五:把GEO当成持续迭代的工作。AgenticGEO的进化持续运行,策略档案不断更新。GEO因此不能当成一次性工作,需要持续迭代。AI引擎一直在进化,你的优化策略也得跟上。
保哥在这篇关于AI对SEO影响的深度分析里说过:GEO和SEO从来不是二选一,得“双线程并行”。SEO的基础工作不能放下,GEO的迭代优化也不能停。
实操建议: 建立月度GEO优化复盘机制。每月检查核心页面在AI搜索引擎中的引用情况,分析哪些策略仍然有效、哪些已经失效,及时调整策略组合。
个人和技术团队怎样落地GEO策略进化?
个人和小团队的落地方案
如果没有能力复现完整的AgenticGEO系统(说实话大部分团队都做不到),可以用下面的简化方案拿到一部分收益:
第一步:构建种子策略库。 从论文提到的9种经典GEO策略出发(添加引用、插入统计数据、引用来源、加入技术术语、简化语言、使用权威语气、优化流畅性、提供独特视角、增加可引用性声明),再结合你的行业特点补充3-5条行业专属策略。
第二步:对每条重要内容做多策略测试。 用不同策略分别改写同一条内容,再实际提交给AI搜索引擎(如Perplexity、ChatGPT Search等)评估效果,记录每种策略在不同类型内容上的表现。
第三步:建立策略-内容匹配矩阵。 测试数据积累多了,你会逐步得到一张“什么类型的内容用什么策略最有效”的经验矩阵,它就是你自己的简化版MAP-Elites档案。
第四步:持续迭代。 每隔2-4周,在现有有效策略的基础上做小幅变异(改一下语气、换一种引用方式、调整内容结构),看能不能找到更好的变体。这相当于简化版的“进化”。
技术团队的进阶实现
如果团队有开发能力,可以考虑更系统的实现方式:
构建评审模型。 用一个轻量级LLM(如Llama 3.2 3B)微调评审模型,训练数据取自过去GEO优化的历史记录:输入是策略+内容,输出是实际的AI引擎引用效果评分。
自动化策略变异。 用Prompt Engineering实现策略的自动变异:给大模型一条现有策略,让它在保留核心思路的前提下做创造性修改。
批量评估与筛选。 搭建自动化的内容提交和效果评估流水线,定期把优化后的内容提交给多个AI搜索引擎,自动抓取并分析引用情况。
实施过程中如果要给页面添加结构化数据标记来提升AI引擎的解析效率,记得同步更新Schema.org标记,让AI系统更准确地理解内容语义。
AgenticGEO研究有哪些边界与局限性?
现实环境比实验更复杂
AgenticGEO的实验在受控环境下进行,用的是两个有代表性的生成式引擎。现实中的AI搜索引擎(Google AI Overviews、Perplexity、ChatGPT Search等)检索和生成逻辑各不相同,策略迁移过去效果会打折扣。
黑帽风险不容忽视
任何强力的GEO优化技术都可能被滥用。315晚会曝光的GEO“投毒”事件就是警示:自动化GEO优化系统一旦被用来推广虚假产品或操纵AI回答,会严重破坏整个信息生态。
AgenticGEO论文也明确写到,方法的目标是“增强内容的内在质量”,而非“操纵引擎行为”。这个区分很关键:好的GEO优化应当让内容真的变好(结构更清楚、数据支撑更足、更有权威性),不能靠注入欺骗性信号去骗过AI引擎。
计算成本仍然不低
评审模型大幅降低了与真实引擎交互的成本,但整个在线进化过程仍需要大量计算资源。资源有限的团队短期内很难完整复现AgenticGEO,但它的核心思路(策略多样性、组合优化、持续迭代)完全可以用低成本的方式实践。
GEO自动化优化接下来会往哪里走?
从“人工优化”走向“自动优化”
AgenticGEO代表的方向不会回头。AI搜索引擎越来越复杂,人工总结优化规则的速度会越来越跟不上引擎变化。未来的GEO工作模式很可能是:人负责定大方向和质量标准,AI系统负责在策略空间里自动搜索和优化。
内容质量仍是底线
有一点不会变:无论GEO技术怎么发展,内容本身的质量始终是基础。AgenticGEO的消融实验表明,进化出的策略之所以有效,主要是因为它们确实让内容变好了(结构更清楚、更权威、信息量更大),并没有靠技术手段欺骗引擎。
所以GEO的竞争力最终还是落在内容上:独特的数据、原创的见解、真实的经验和清晰的表达。技术只能放大这些东西,替代不了它们。
AI搜索生态的治理挑战
AgenticGEO这类自动化GEO工具出现后,AI搜索引擎面对的内容操纵压力会迅速增大。引擎也不会坐着挨打,会持续升级内容质量评估和反操纵机制,最后演变成传统SEO里那种“优化者vs搜索引擎”的拉锯,谁也别想一招吃遍。
GEO自进化框架用到国产AI引擎上,需要替换哪些部分?
AgenticGEO论文的实验用的是两个海外代表性引擎,种子策略也是普林斯顿那套经典的9种。如果你的目标是文心一言、豆包、腾讯元宝这些国产引擎,直接照搬论文的种子库和反馈管线,进化大概率会往错误的方向跑。有两个部分必须替换。
种子策略库:国产引擎上的初始有效性排序不同
海外9种种子策略里,“添加权威学术引用”“引用Nature/arXiv级来源”这类在英文引擎里是高分项,搬到依赖百度索引的文心上,权重会明显下降。百度的索引反馈更偏向百度百科、百家号、行业协会白皮书这些自家生态里的来源。种子库的起点一旦偏了,后面进化几十轮也很难自己纠正回来。建议给种子库补上本土策略:
- 把“海外学术引用”这条种子,替换或补充为“国产权威源引用”(百度百科定义+行业协会白皮书+官媒数据)。
- 补一条“百度百科式权威首句定义”策略,专门对应百度系引擎对“可直接摘引定义句”的偏好。
- 豆包背靠抖音生态,补一条“场景化口语+分点清单”策略,对应短视频生态用户的表达习惯。
反馈回路:拿不到引用API时,评审模型(Critic)要用国产数据重训
论文里评审模型(Critic)能省下近60%的真实引擎调用,前提是有Perplexity那种相对开放、能批量拿到引用反馈的接口。国产引擎大多既不开放引用API,也不标注来源,反馈数据只能靠人工抽样跑出来。这带来一个容易被忽略的问题:用海外引擎反馈训出来的Critic,不能直接拿来预测国产引擎的引用效果。两边的引用逻辑差别太大,海外数据训练的Critic放到国产引擎上会出现系统性偏差,进化越久偏得越远。
| 框架组件 | 论文(海外引擎) | 国产引擎落地替代 |
|---|---|---|
| 种子策略库 | 普林斯顿9种通用策略 | 9种打底+3-5条国产权威源/百科定义/场景化清单 |
| 真实反馈来源 | Perplexity等开放引用API | 双周人工抽样跑文心/豆包/元宝,手工整理引用记录表 |
| Critic训练数据 | 海外引擎反馈批量回流 | 必须用国产引擎人工反馈重训,海外数据只能做冷启动 |
| 权威源画像 | Wikipedia/学术机构 | 百度百科/百家号/行业协会/知乎高赞 |
框架结构可以照搬,但种子决定进化的起点,反馈决定进化的方向。这两部分不做本土化,自进化系统只会耗费大量算力,把你带到一个国产引擎并不认可的局部最优。
MAP-Elites策略档案为什么不能只追求策略数量?
MAP-Elites的“质量-多样性”理念很容易被误读。保哥见过一个技术型小团队,把它简化成一句“策略越多越好”,结果这次复刻失败了,过程很有代表性。
他们复现AgenticGEO时为了省事,把价值门控、新颖性门控、PND淘汰评分这几个“看起来很学术”的机制全部省掉,只保留“不停变异、不停往档案里加”。三个月后,策略池从最初的9条种子膨胀到400多条。账面上多样性很高,回头抽查才发现其中绝大多数是低质量的重复变体:同一个“添加权威引用”,换几个措辞就作为新策略反复入库,真正有差异、有效果的策略被这些变体淹没了。
下游的问题更严重:策略检索环节面对400多条高度相似的候选,匹配准确率不升反降,给一篇内容选出的“最匹配策略”经常只是某个变体的随机版本。最终的优化效果还不如老老实实只用9条种子策略。客户的引用率没有变化,算力账单却翻了好几倍。
后来的纠偏只抓一条:MAP-Elites的关键在于“每个网格只留最优+持续淘汰”,数量多并不是目标。这里的多样性是有约束的多样性,不能靠堆量实现。具体分三步:
- 把淘汰机制补回来。价值门控(同一网格只留冠军)、新颖性门控(用n-gram距离去重)、档案满员时的PND淘汰,一个都不能省,它们构成了进化的“选择压力”。
- 给档案设容量上限。400多条砍回30多条,每种策略类型只留有差异的头部策略,宁可少而精。
- 变异后加去重检查。新生成的策略入库前先做相似度检查,与现有策略n-gram重合度过高的直接丢弃,不占名额。
他们精简之后,30多条高质量策略把引用率重新拉了上来。这次的教训是进化要靠淘汰:只变异不淘汰,策略池只会越来越臃肿,检索时谁也选不准,这就是这次复刻失控的原因。
常见问题解答
AgenticGEO和传统GEO方法的最大区别是什么?
传统GEO方法使用人工设计的固定改写策略模板,所有内容用同一套规则优化。AgenticGEO的主要区别是策略不由人设计,由进化算法自动生成并持续迭代。系统维护一个MAP-Elites策略档案,能根据不同内容的特点自动选择最匹配的策略组合,策略池也会在使用中不断进化和扩展。
MAP-Elites策略档案具体是怎么工作的?
MAP-Elites是一种质量-多样性进化算法。它把策略空间划分成多维网格,每个维度对应策略的一个属性(指令、约束、推理、格式、语气),每个网格单元只保留同类型中效果最好的策略。新策略由现有策略变异产生,要经过价值(效果分数)和新颖性(与现有策略的差异度)两道筛选才能进入档案。这样档案里的策略既多样又有效。
普通站长和SEO人员能从AgenticGEO中学到什么?
主要有三点:第一,别再依赖单一的GEO优化策略,为不同类型的内容准备不同的优化方案;第二,关注策略的组合效果,同时优化内容的格式、语气、引用、结构等多个维度;第三,建立持续迭代机制,定期测试和更新你的GEO策略,因为AI引擎一直在变化。
AgenticGEO的进化策略会不会被AI引擎识别为操纵?
AgenticGEO的设计思路是“提升内容的内在质量”,而非“操纵引擎行为”。进化产生的策略实际作用是让内容结构更清楚、更有权威性、信息量更大,这些改进对人类读者同样有价值。不过任何GEO技术都可能被滥用。判断标准在于:你的优化有没有真的让内容变好?如果有,就不用担心被识别为操纵。
AgenticGEO的消融实验中,哪个组件对性能影响最大?
论文的消融实验明确显示,去掉进化策略档案后性能下降最大,说明策略的自动进化和积累是AgenticGEO效果的主要来源。评审模型和多轮改写机制也有贡献,但重要性排在进化档案之后。对实践的意义是:提升GEO效果,关键在于策略的多样性和质量,单靠换更强的模型不够。
AgenticGEO需要多少真实引擎反馈才能有效运行?
论文实验表明,AgenticGEO只使用41.2%的真实引擎反馈时,仍能保留98.1%的优化性能。原因是协同进化的评审模型能有效充当代理,准确预测大部分策略的效果,只有少量关键决策需要真实引擎验证。这大幅降低了实际部署成本。
GEO自动化会不会导致所有内容都变得雷同?
这个风险值得关注,但MAP-Elites架构在设计上就在防范它:新颖性门控和多样性评分保证档案中的策略彼此有足够差异。另外,策略是按内容条件分配的,不同内容会分到不同策略,不会所有内容都套用同一个“赢家策略”。内容雷同的根源在于对技术的粗暴使用,技术本身不是原因。
权威参考资料
本文标题:《GEO策略自进化:AgenticGEO的MAP-Elites档案与落地路径》
本文链接:https://zhangwenbao.com/geo-self-evolving-strategy-agenticgeo.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0