结构化数据里价格64个站全写了,规格只有7个
做法是用真实浏览器打开131个英文电商品牌站,从首页两跳之内进到产品页,取渲染之后的document.body.innerText当作机器实际拿到的那条文本流,用一份六十多个词的英文规格字段词表定位字段名所在的行,再逐条看它下一行是什么;同时在DOM那一侧记录字段名用的标签、有没有落在table与dl里、JSON-LD有没有写offers和additionalProperty。关键的一步是尺子自检:脚本自动判据给出的93.6%被187条…
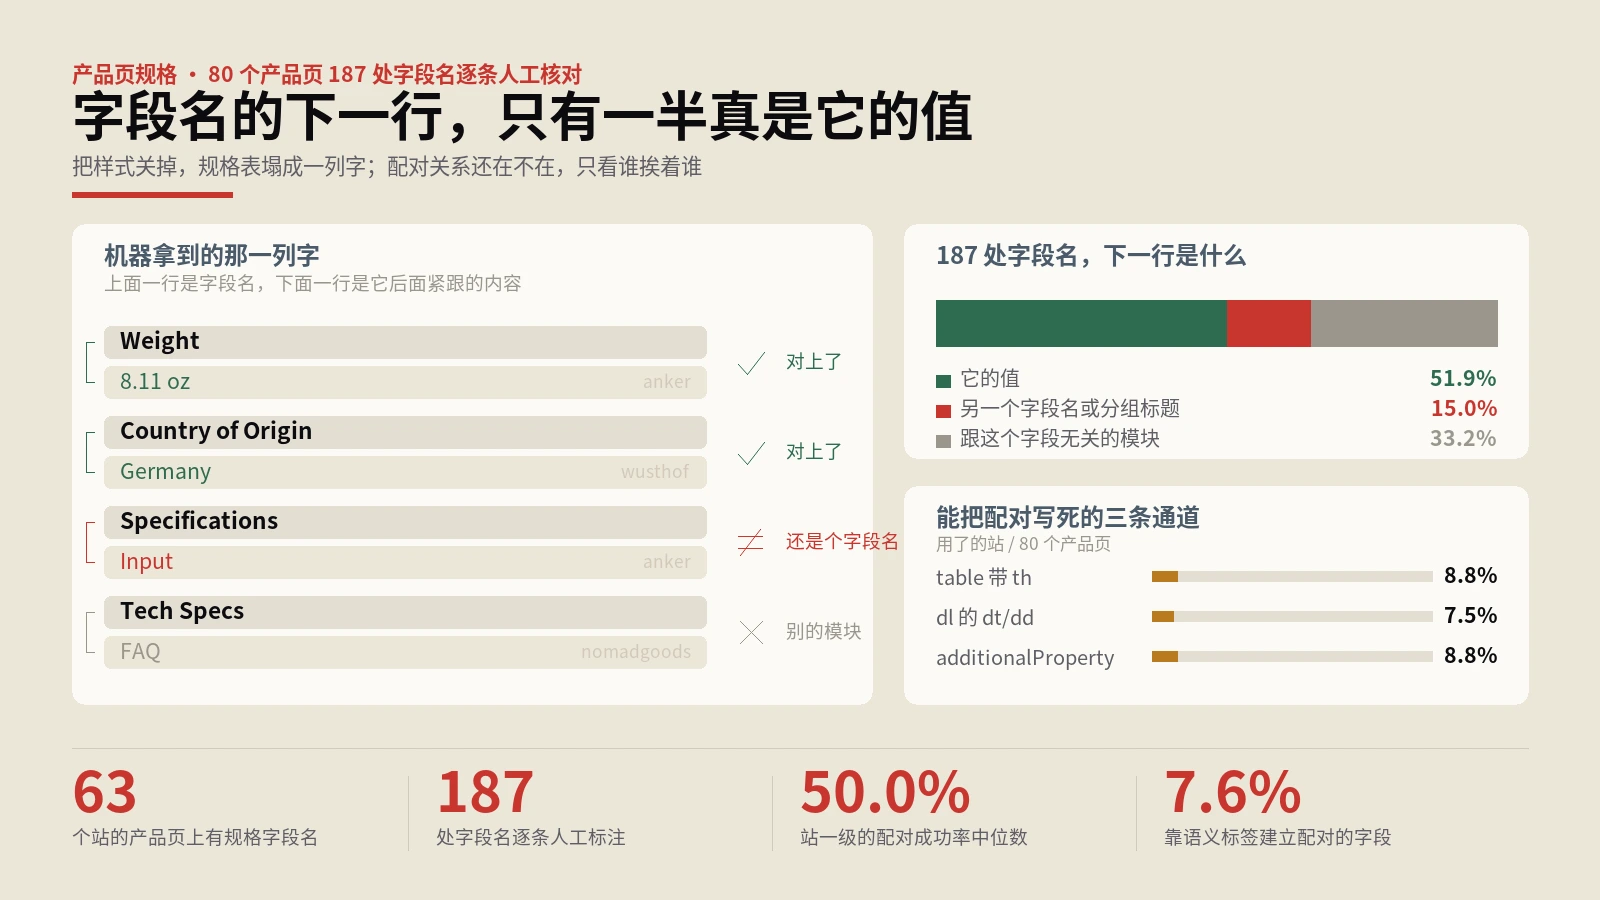
做法是用真实浏览器打开131个英文电商品牌站,从首页两跳之内进到产品页,取渲染之后的document.body.innerText当作机器实际拿到的那条文本流,用一份六十多个词的英文规格字段词表定位字段名所在的行,再逐条看它下一行是什么;同时在DOM那一侧记录字段名用的标签、有没有落在table与dl里、JSON-LD有没有写offers和additionalProperty。关键的一步是尺子自检:脚本自动判据给出的93.6%被187条…
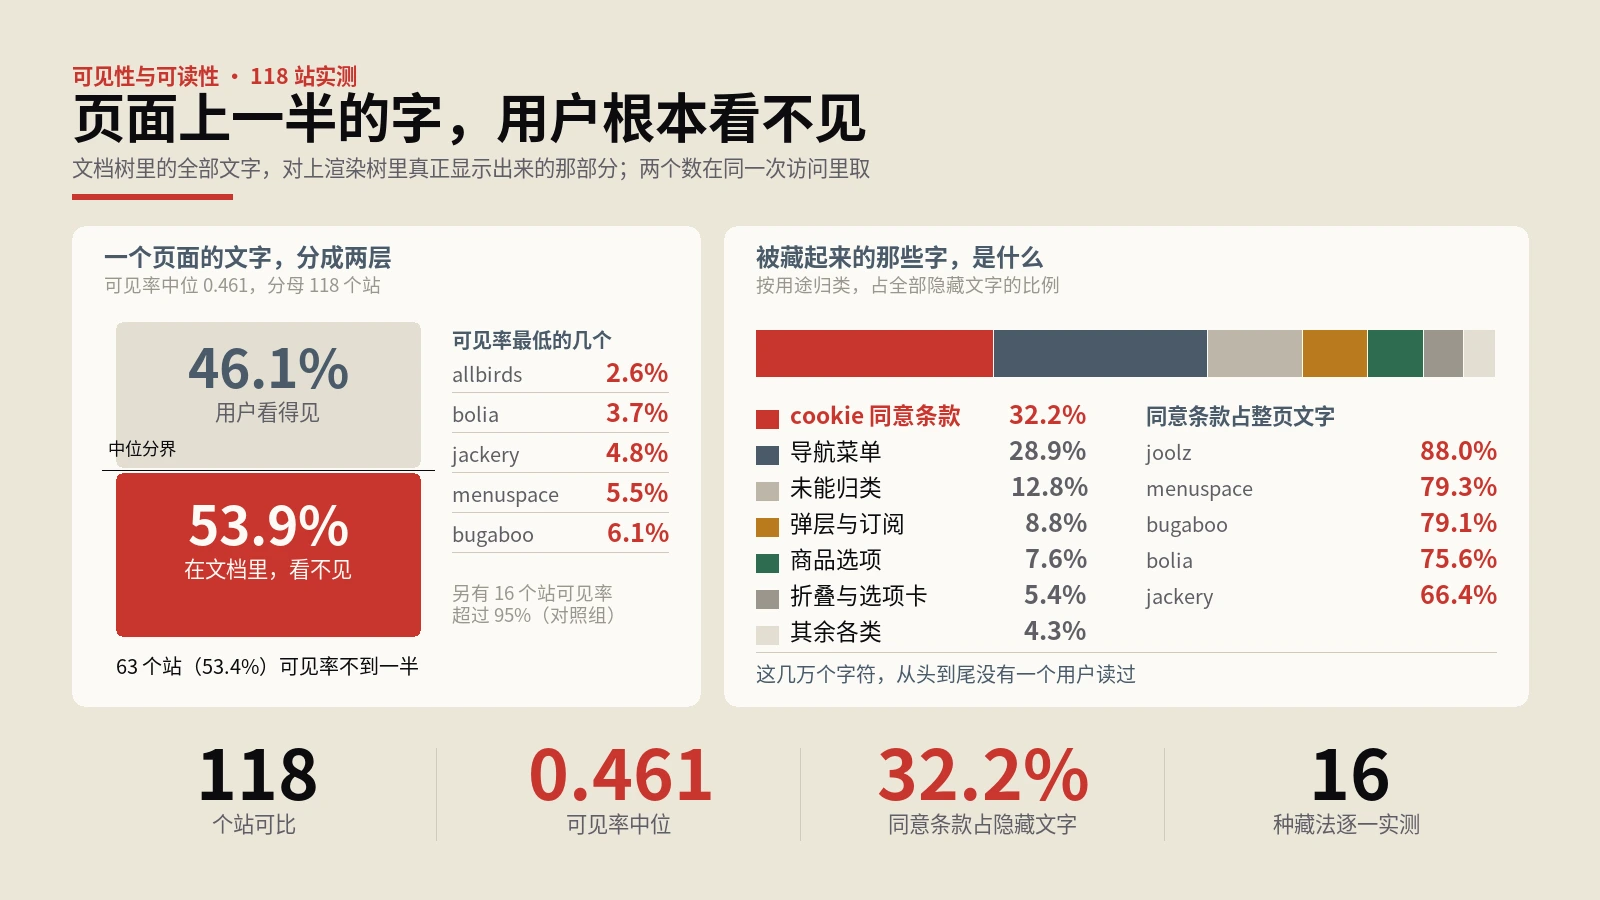
在浏览器里同时取文档树文字与渲染树文字两个数,量出118个海外独立站首页的可见率分布,再把所有隐藏容器按用途归类,看清那些看不见的字到底是菜单、弹层还是同意条款。另在本机搭台造出16种藏法各一个页面,让8个读取器逐一去读,得到一张谁读得到谁读不到的裁决表,并记下无障碍量法自己打架的两处。
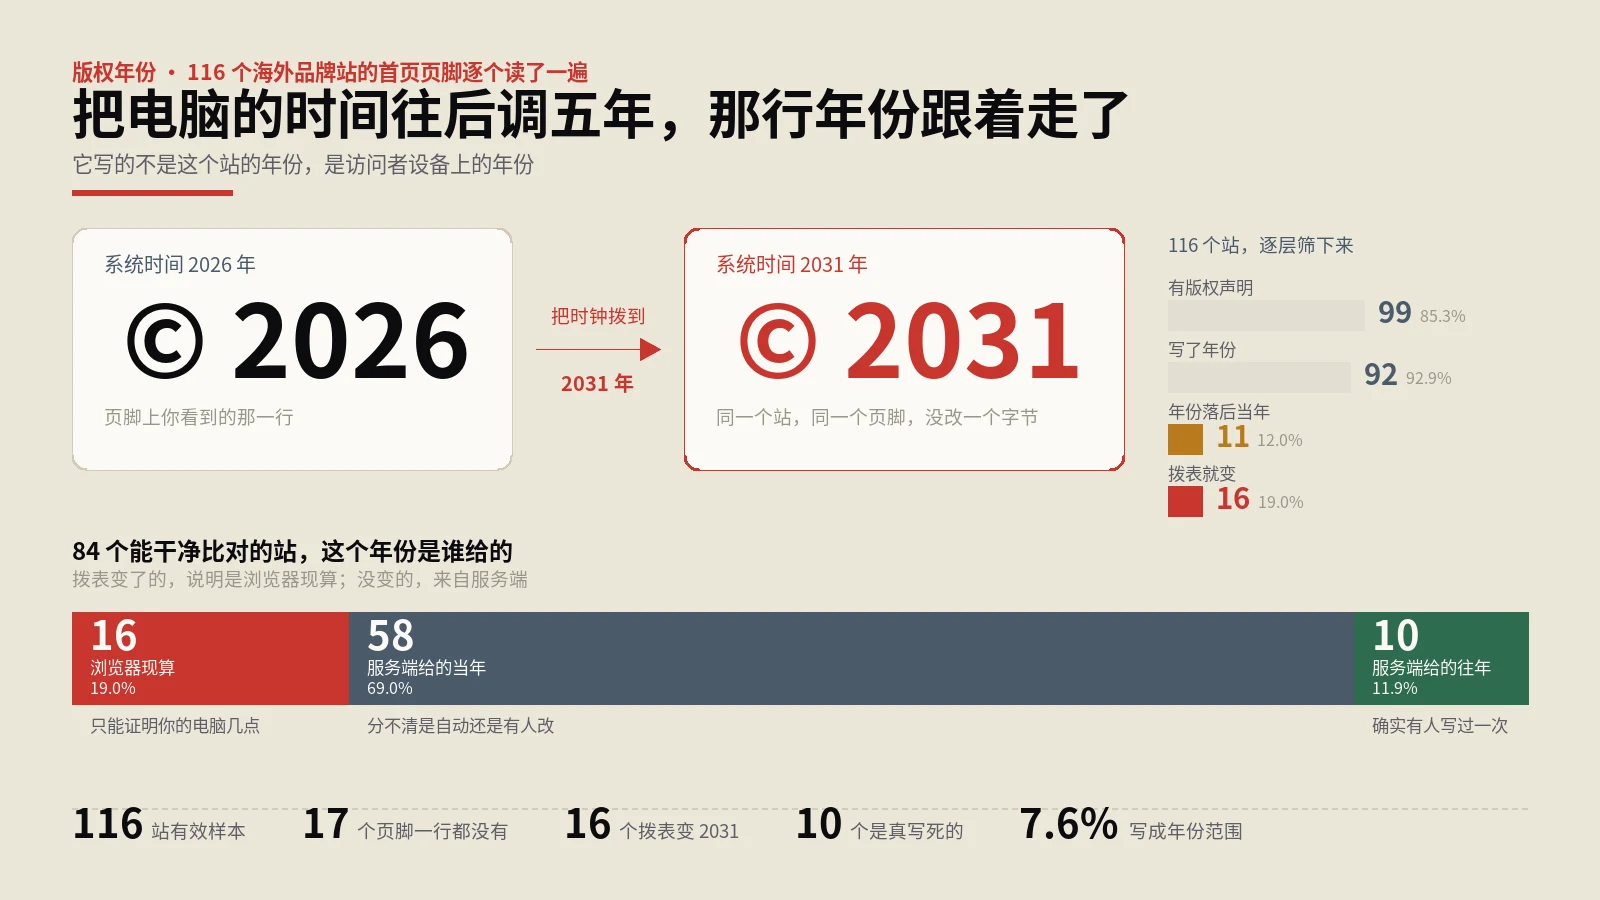
116个海外品牌站的首页页脚逐个抓取,识别版权声明与年份写法;每站访问两遍,第二遍在页面加载前把浏览器全局Date固定为2031年,比对同一段版权文本的年份是否变化,两遍抹去数字后相似度不足的样本剔除。
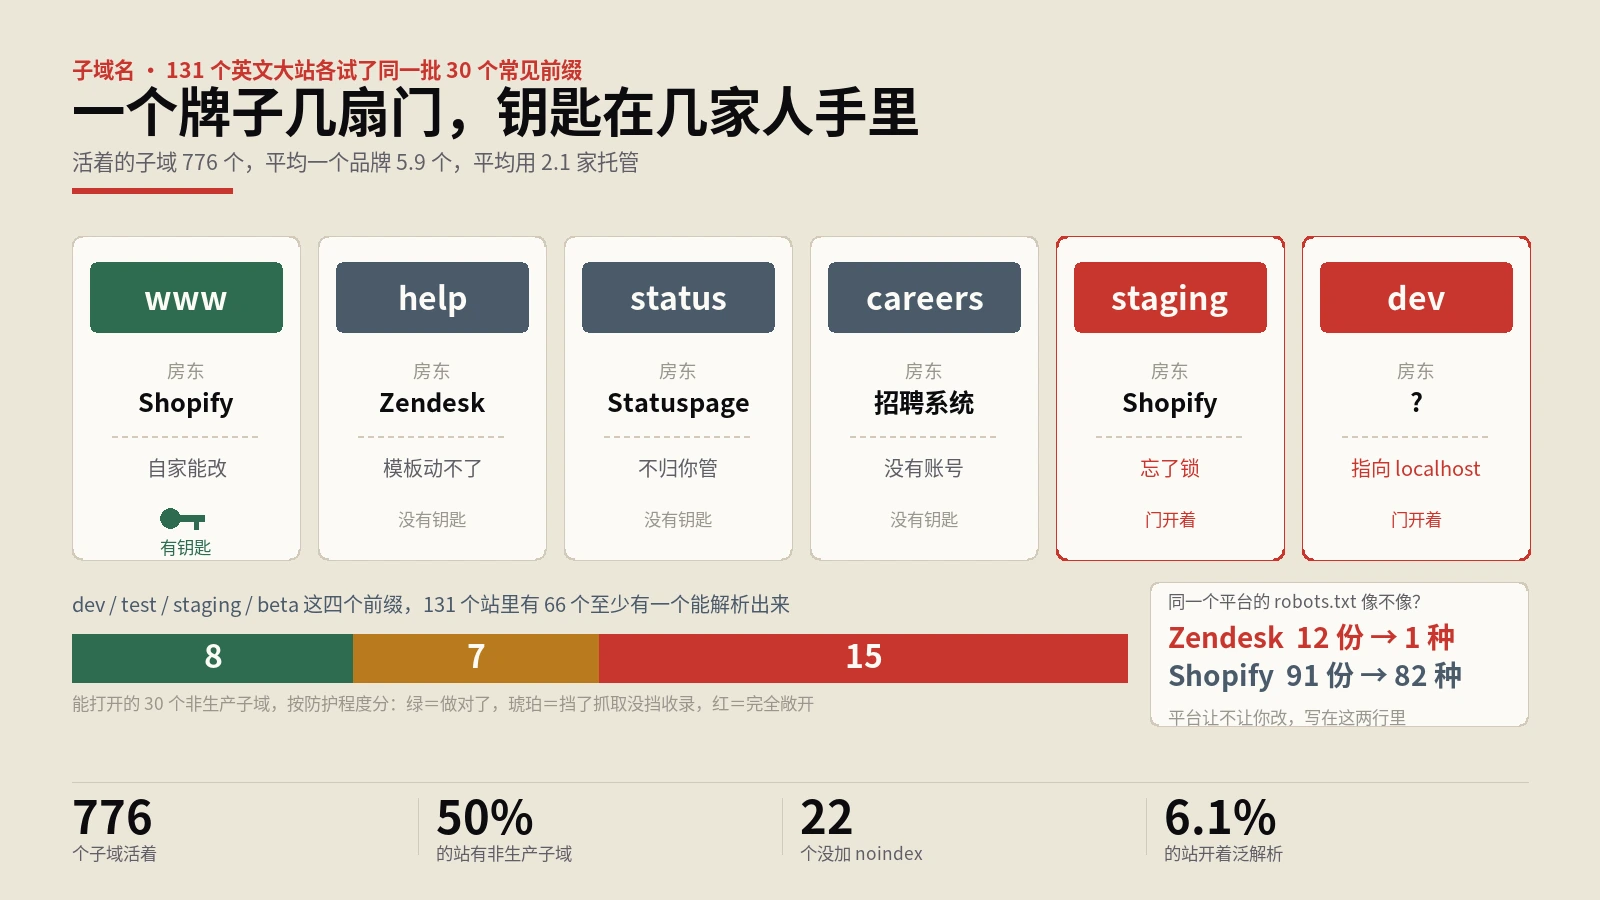
给131个英文大站各试同一批30个常见子域前缀,先用随机子域探泛解析再剔除兜底回声,对活着的子域追CNAME判托管方,并逐个记录HTTP状态码、页面标题、noindex与robots.txt封禁情况。
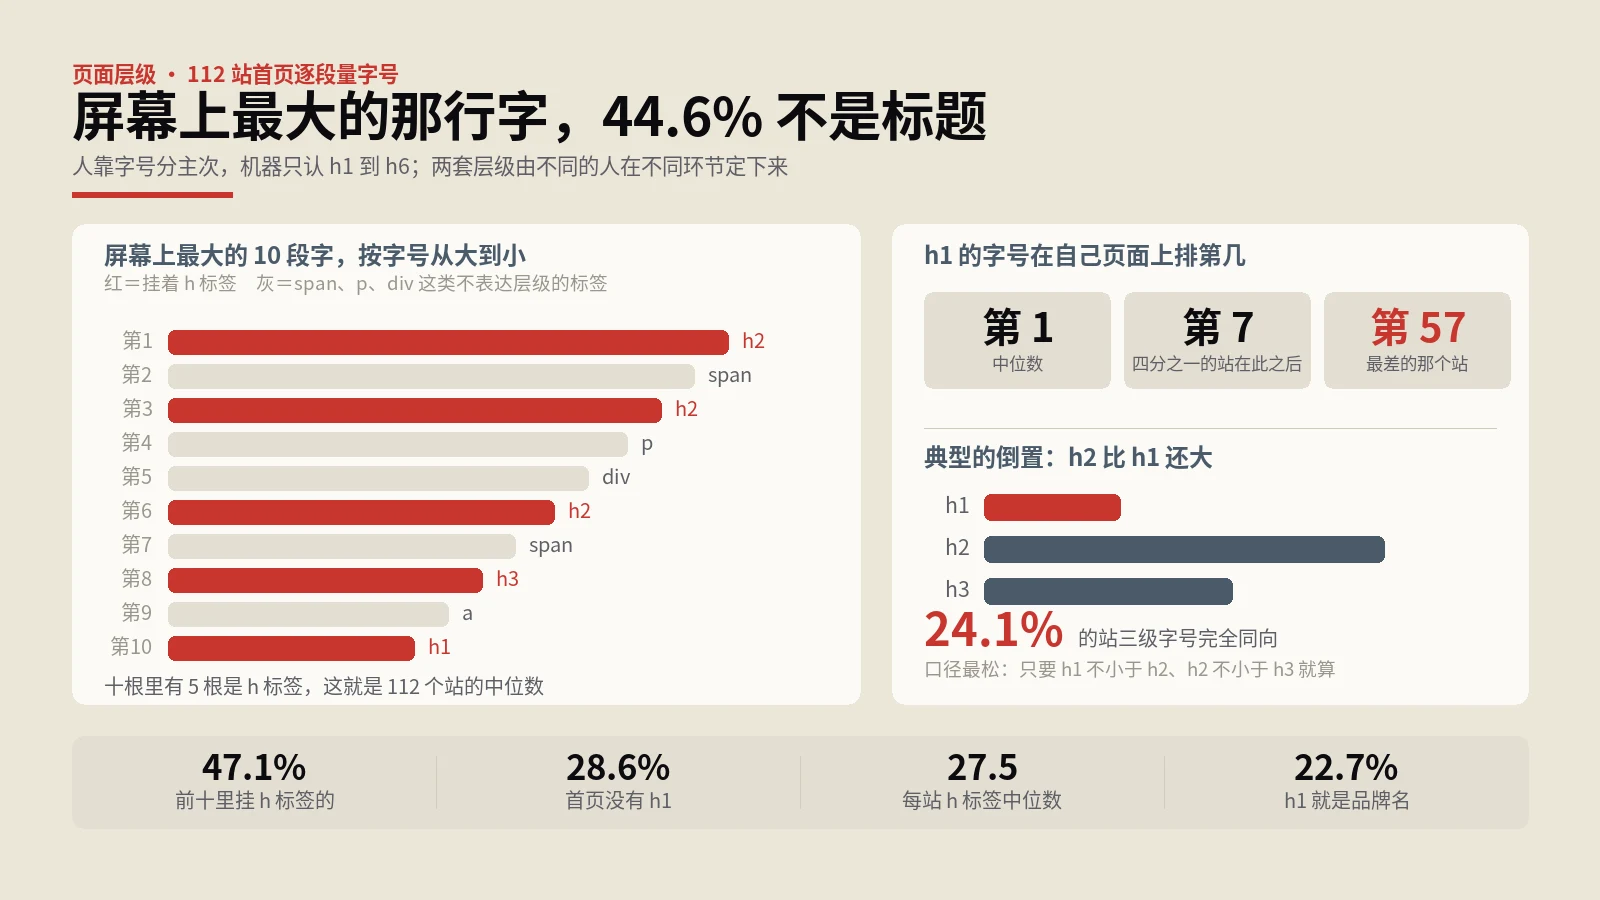
做法是用真实浏览器在1440宽视口打开112个电商独立站首页,遍历主内容区每个元素、只取它自己直接持有的那段文字,记下渲染后的实际字号、字重、标签名与位置,再按字号排序看排在最前的几段挂的是什么标签;同时把全部h1到h6单独取出比对字号、可见性与是否为空,并把被同意层整个盖住的13个站单独剔出。
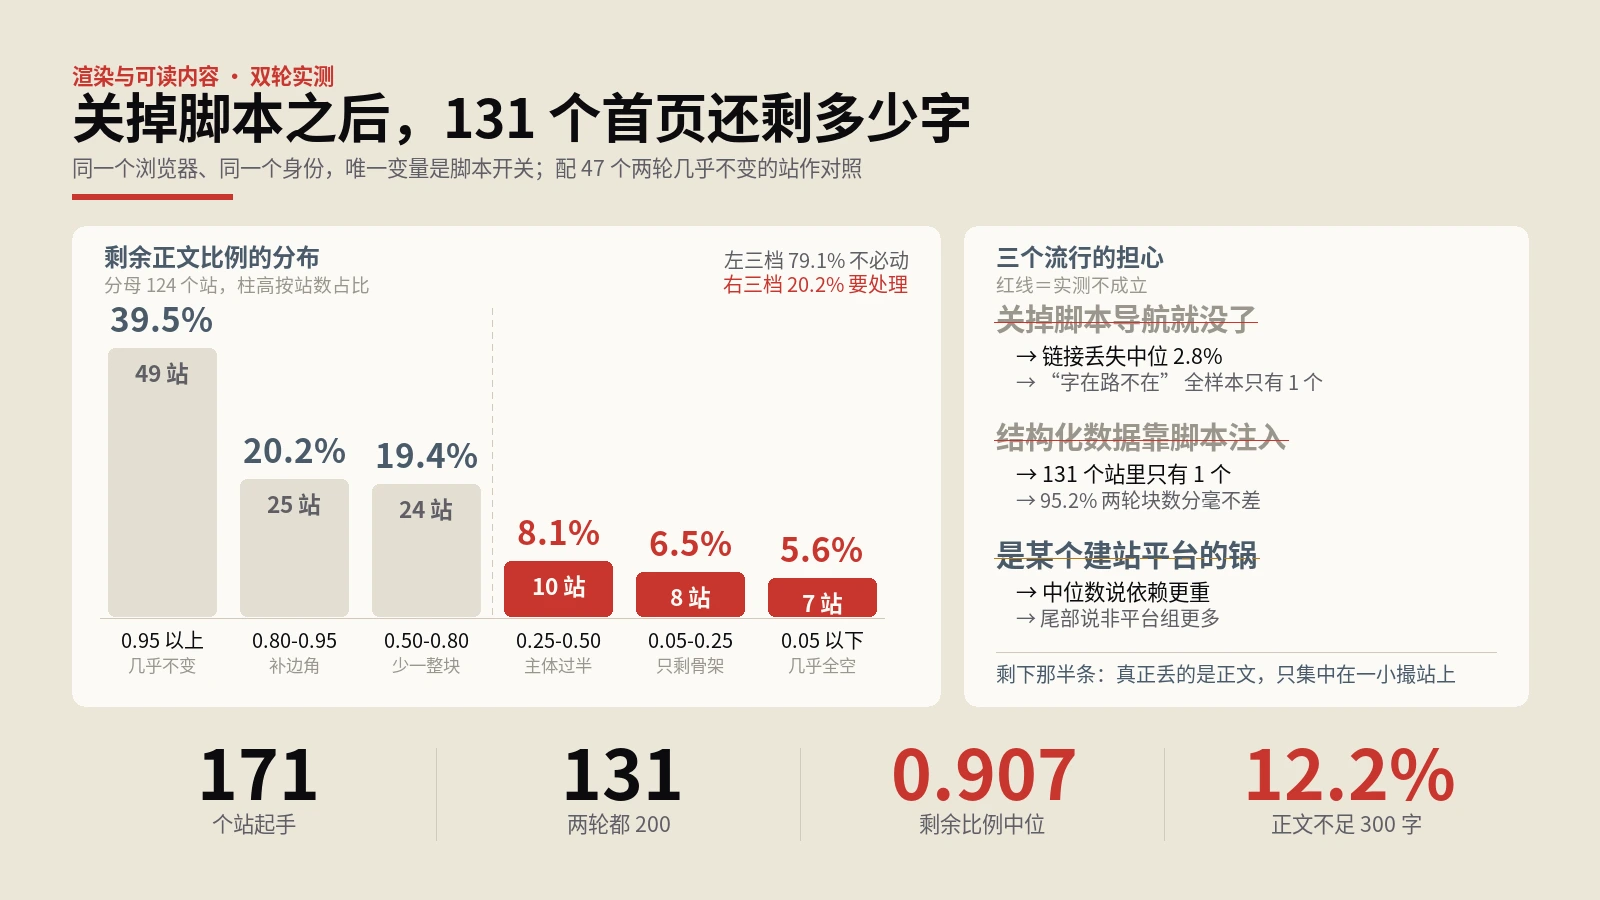
用同一个浏览器对171个海外独立站首页各跑两轮,唯一变量是脚本开关,两轮都拿到200的有131个。三个文本口径在同一次访问里取,配47个两轮几乎不变的站作对照,再用1秒、3.5秒、10秒三档等待时间做敏感性检验,逐层拆开正文、链接、结构化数据、主标题、商品入口五类结构件的丢失情况,并把测量过程中翻车的两次尺子问题一并记下来。
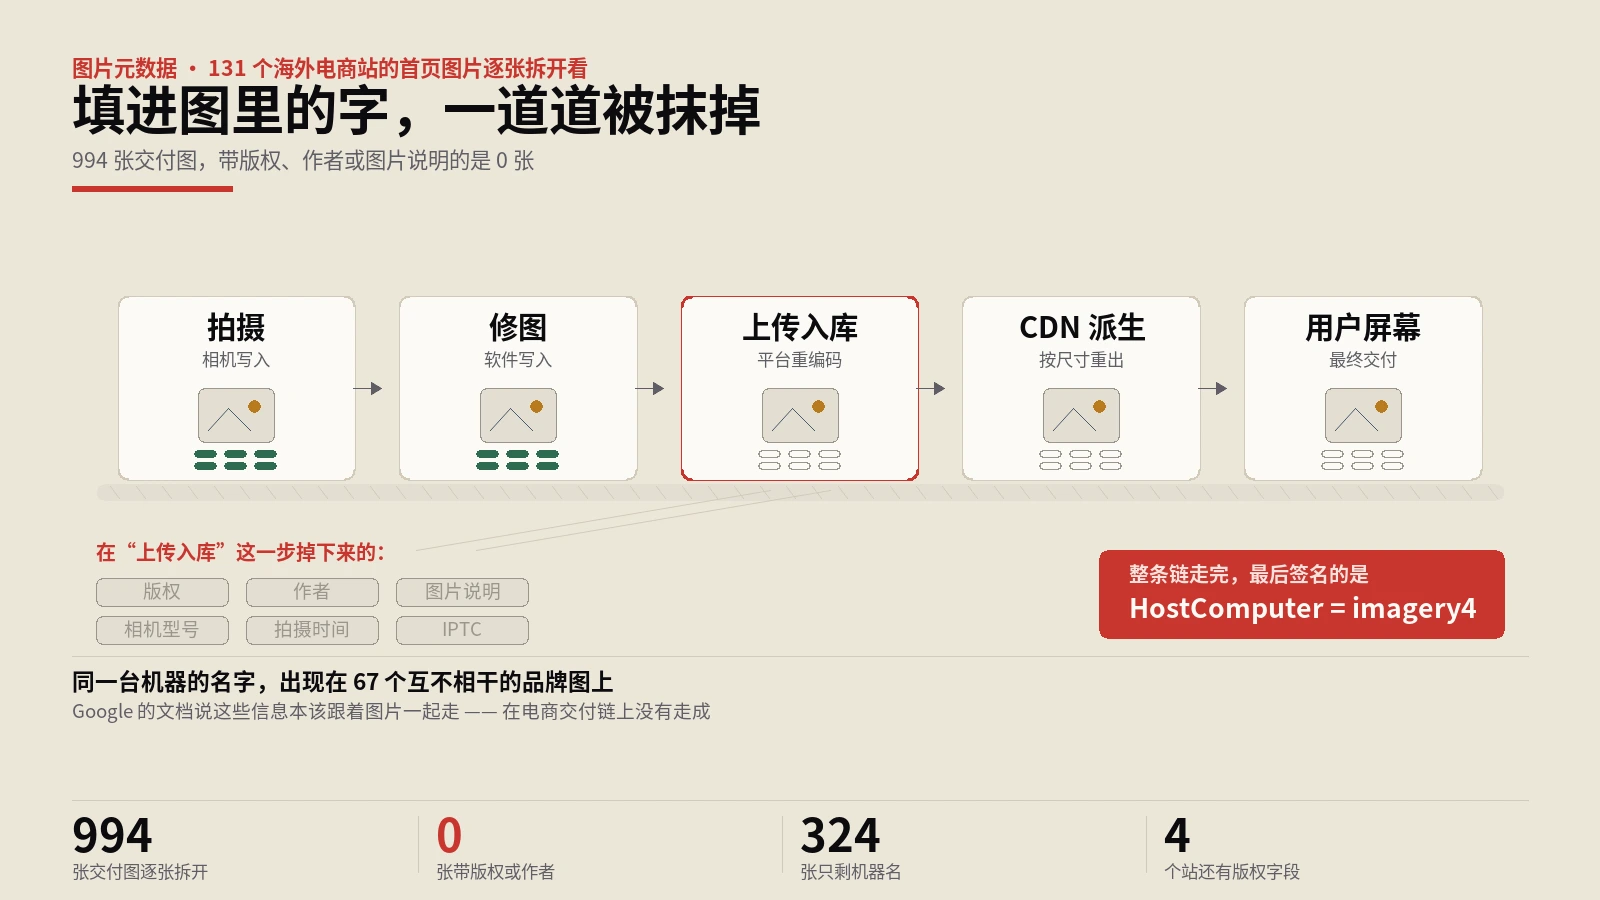
从131个海外电商站的首页取浏览器真实加载的图片,按Range只下文件头部,逐段解析JPEG的APP标记、PNG文本块与WebP的RIFF块;再把同一张图去掉CDN处理参数取一份裸地址,用177组对照区分元数据究竟是入库时清的还是交付时剥的。判据前后改了14处,方向与影响全部列出。
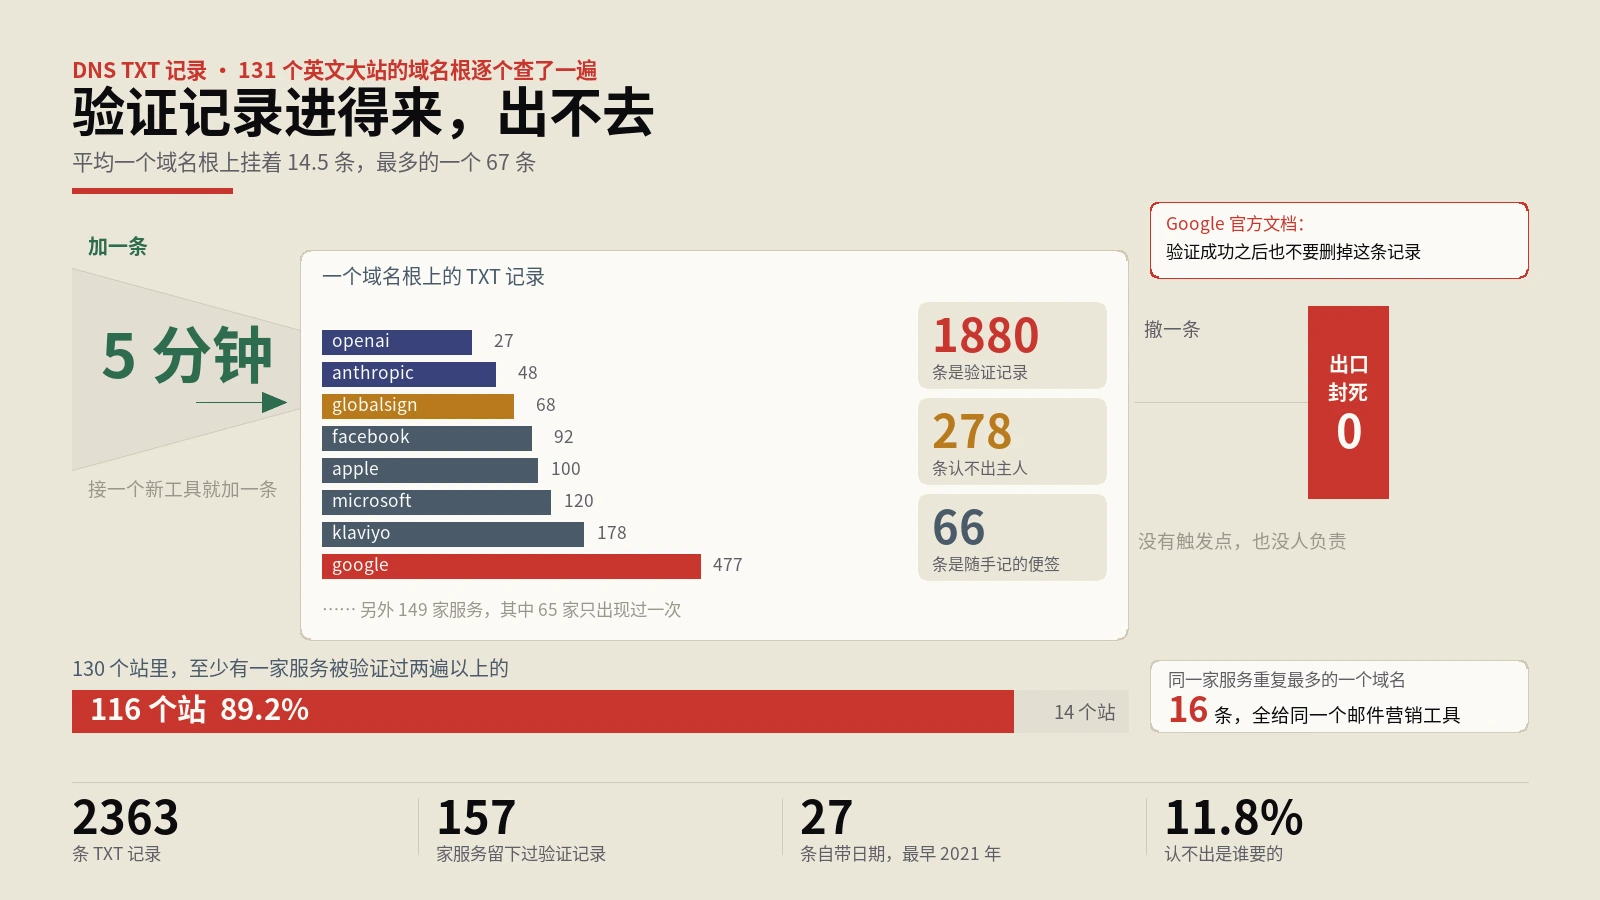
131个英文大站的域名根逐个做DNS查询,取根域与_dmarc的TXT记录,按写法把每条判成第三方验证记录、认不出主人的裸串、邮件配置或内部随手记,再按厂商归并统计重复与年龄。判据经六处人工核对修正。
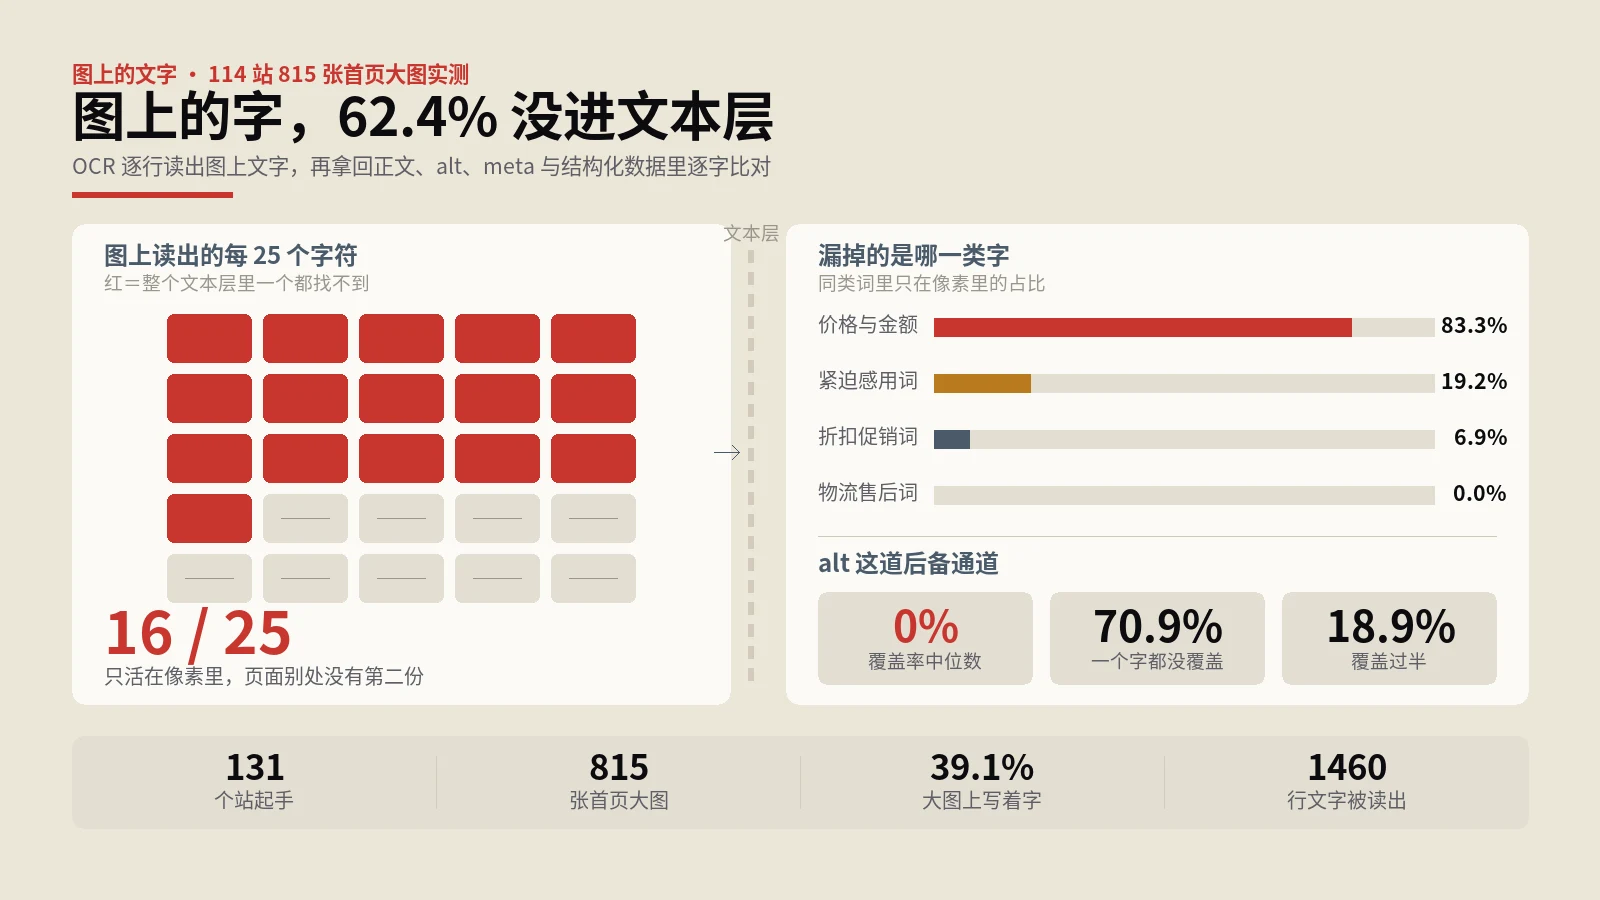
做法是把127个电商独立站首页用真实浏览器打开、滚三屏逼出懒加载,再按原始地址下载渲染面积最大的8张图(不截屏,避免把叠在上面的HTML文字拍进去),用RapidOCR逐行读出文字,最后拿回由正文、DOM全部文字、alt与aria属性、meta和JSON-LD拼成的文本池里逐行比对;OCR这把尺子先用12张已知文案的合成图和24张人工标注的真图考过两轮,并做了置信度敏感性检查。
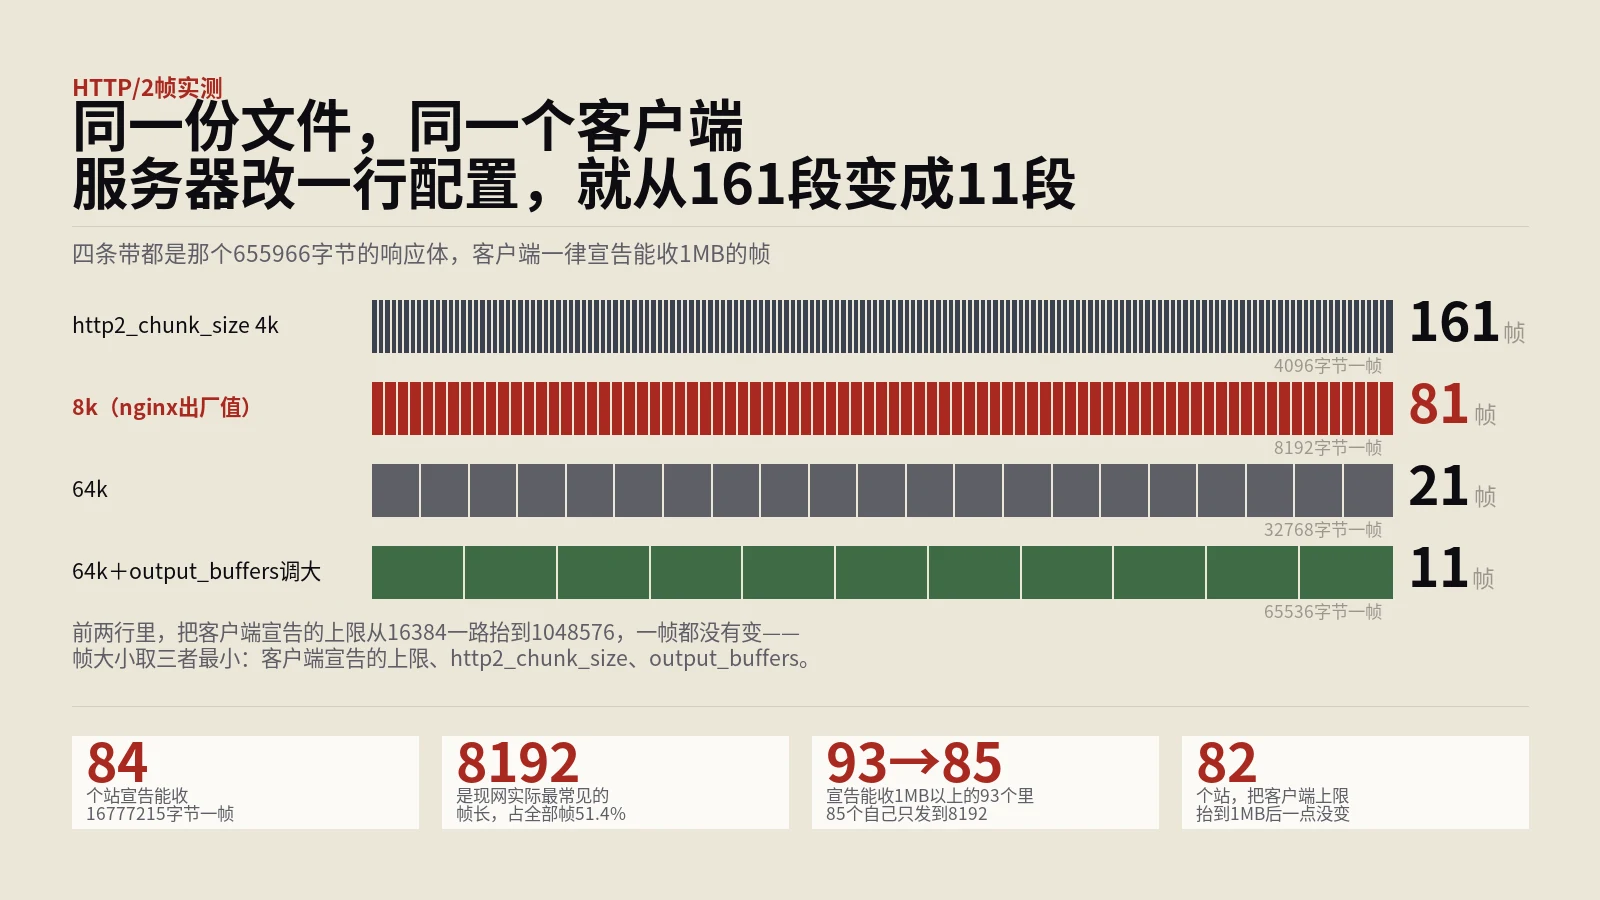
量法是自己写客户端:不用现成的HTTP库,直接拿h2协议库完成ALPN协商、发SETTINGS、逐帧记录DATA帧的长度与到达时刻。131个站每站两组设置背靠背各打一次,整套跑两轮,第二轮把两组的先后顺序反过来,用来把设置的作用和请求顺序的作用分开。再在自己的nginx上另起一个独立实例,把三个上限拆成三个独立开关逐一验证。
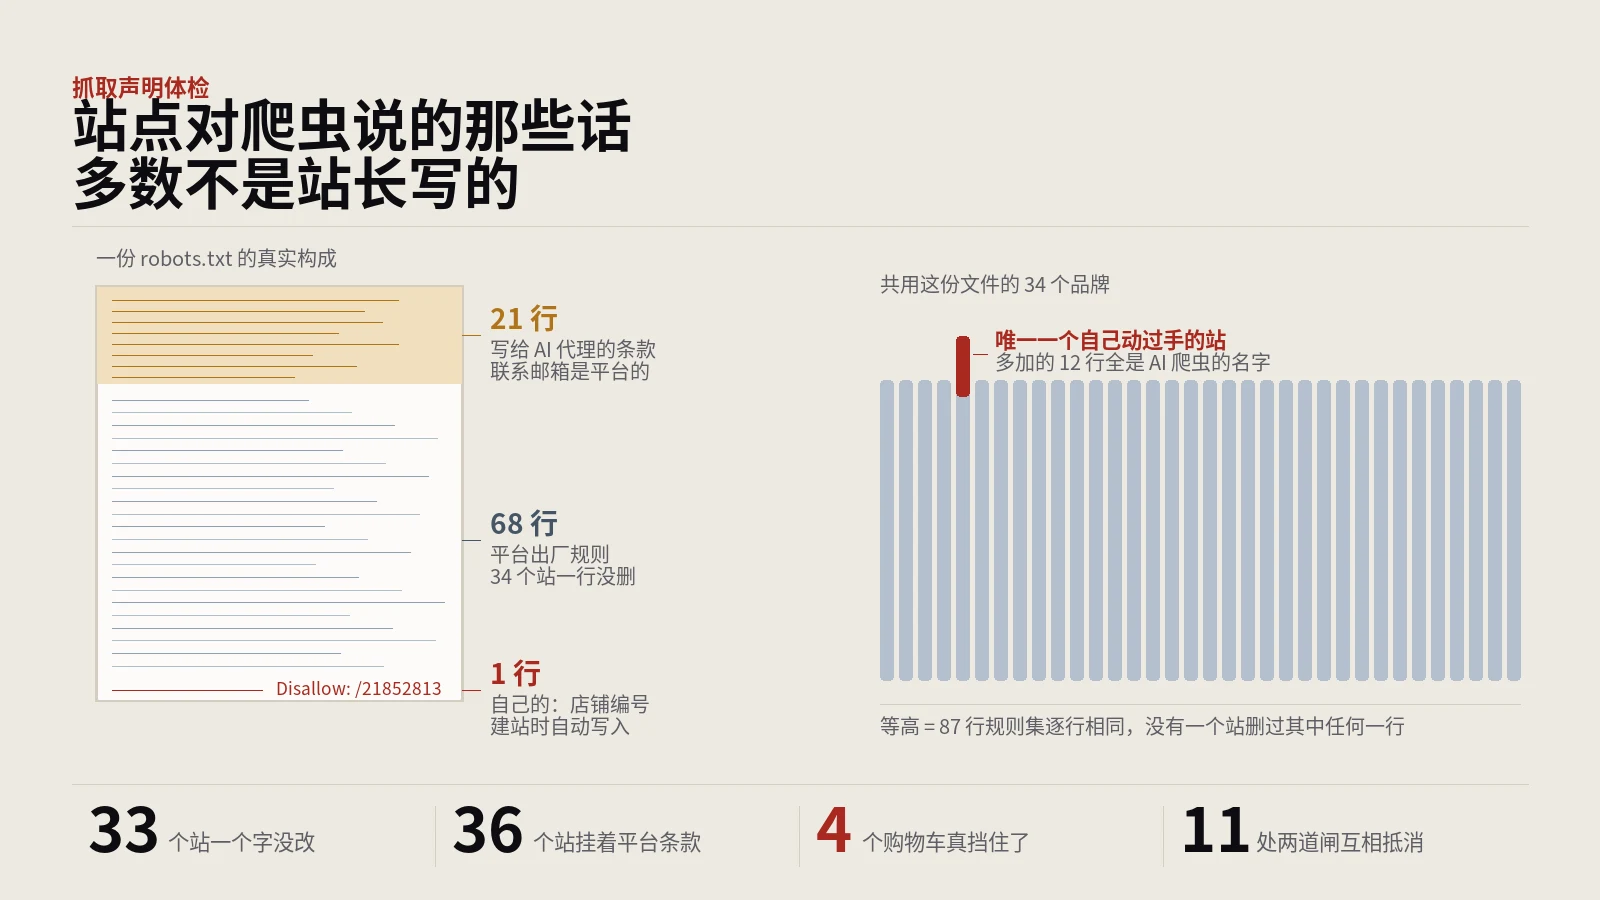
先按RFC 9309自己实现一遍规则匹配,用规范里的18道经典用例把匹配器验过,再拿它逐条判定450个页面能不能被抓;然后读每个页面HTML里的meta robots与响应头里的X-Robots-Tag,把两份声明落进四个格子。全程按页面最终落地的主机去找对应的robots.txt,跨域跳到平台认证域的单独归类。
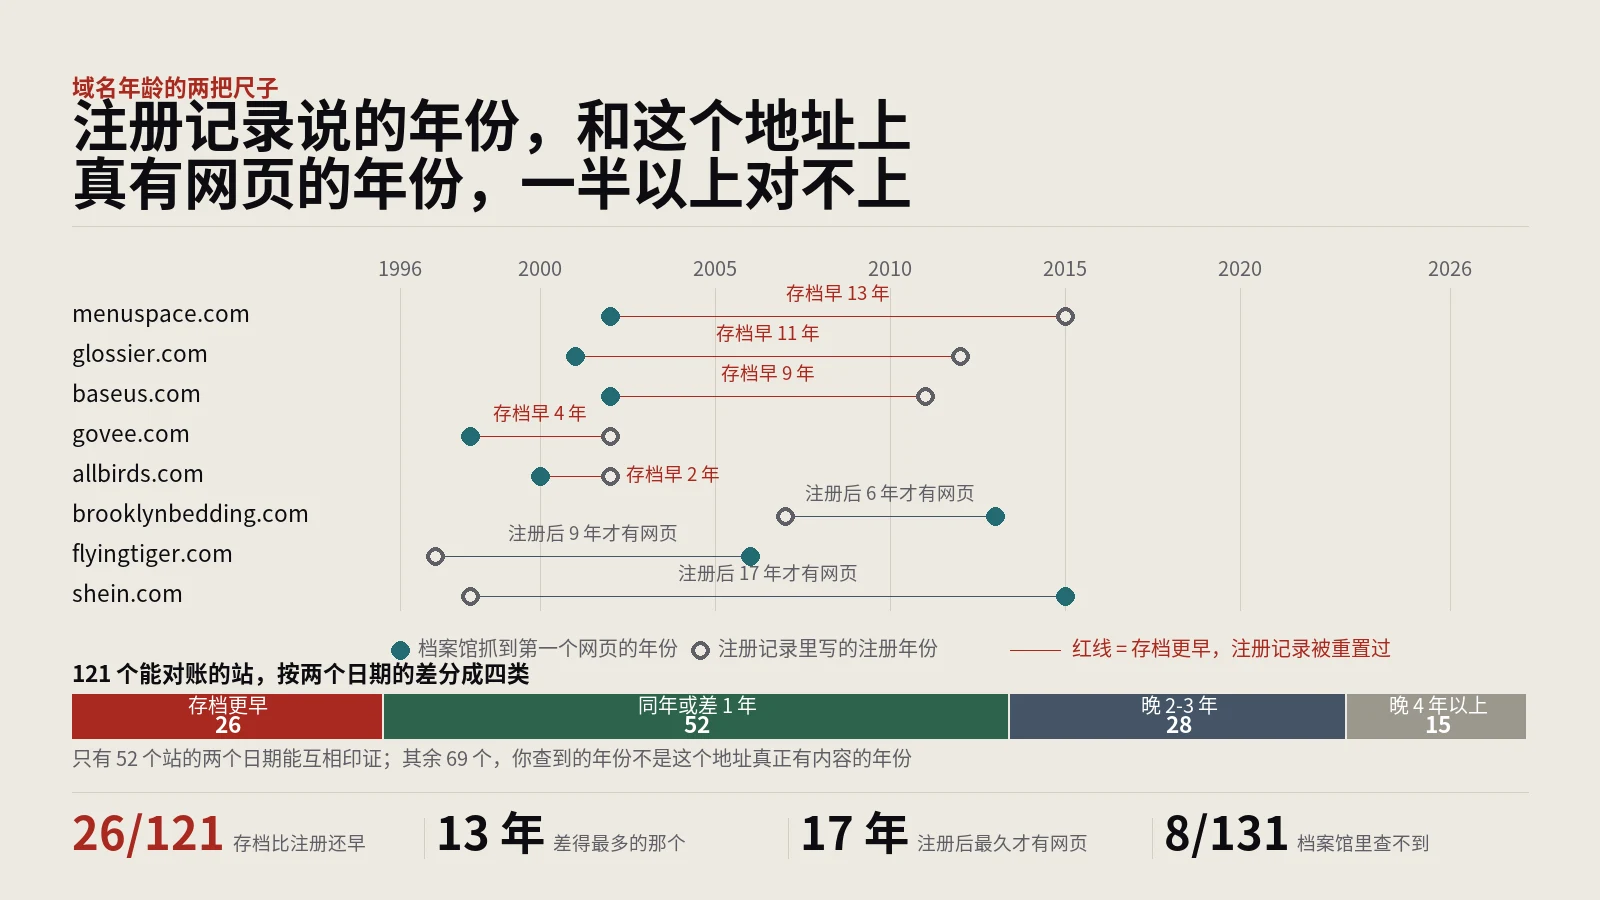
两把独立的尺子量同一批131个域名:一把从各注册局的RDAP记录里取注册日期,一把从互联网档案馆的抓取索引里取最早那份能打开的快照,再把最早那一版原样调回来看当年是谁在用。文末给了三条可以直接跑的命令。
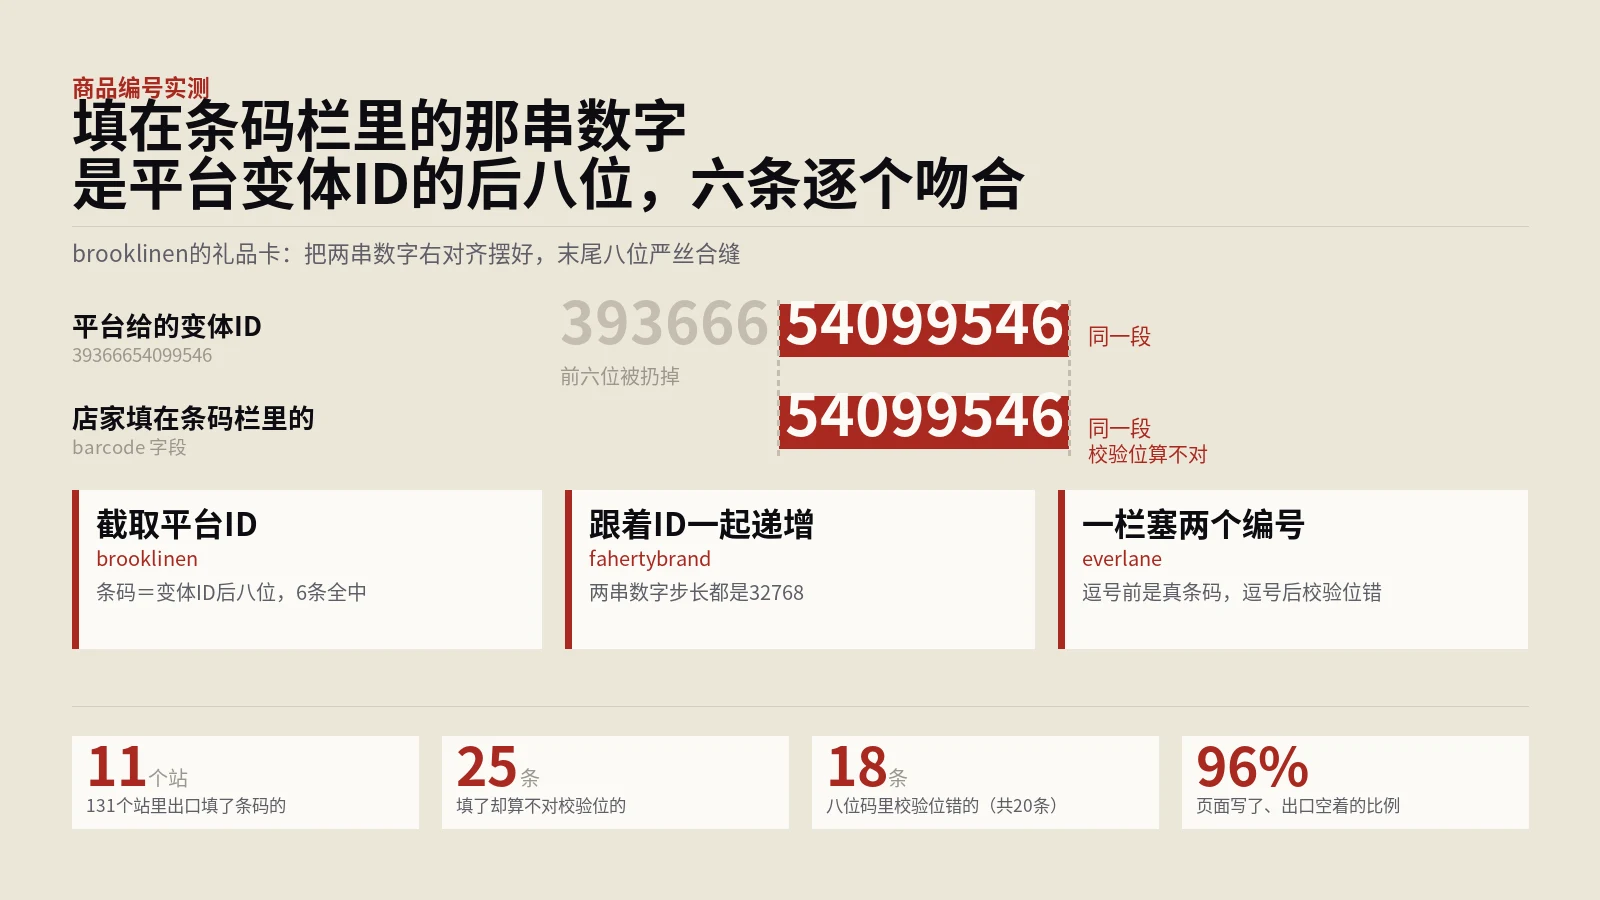
量法是把校验位这把离线尺子架到全站字段上:GTIN不论8位12位13位14位,末位都由前面各位推算,不联网也能判真伪。131个站单线程采集、间隔2秒,把页面结构化数据的每个节点和两个数据出口的每条变体记录都摘出编号,逐条算校验位,再按SKU把两侧配对,看同一件商品的条码是不是同一个。算不对的那些回原始记录里挖,看它原本是什么。
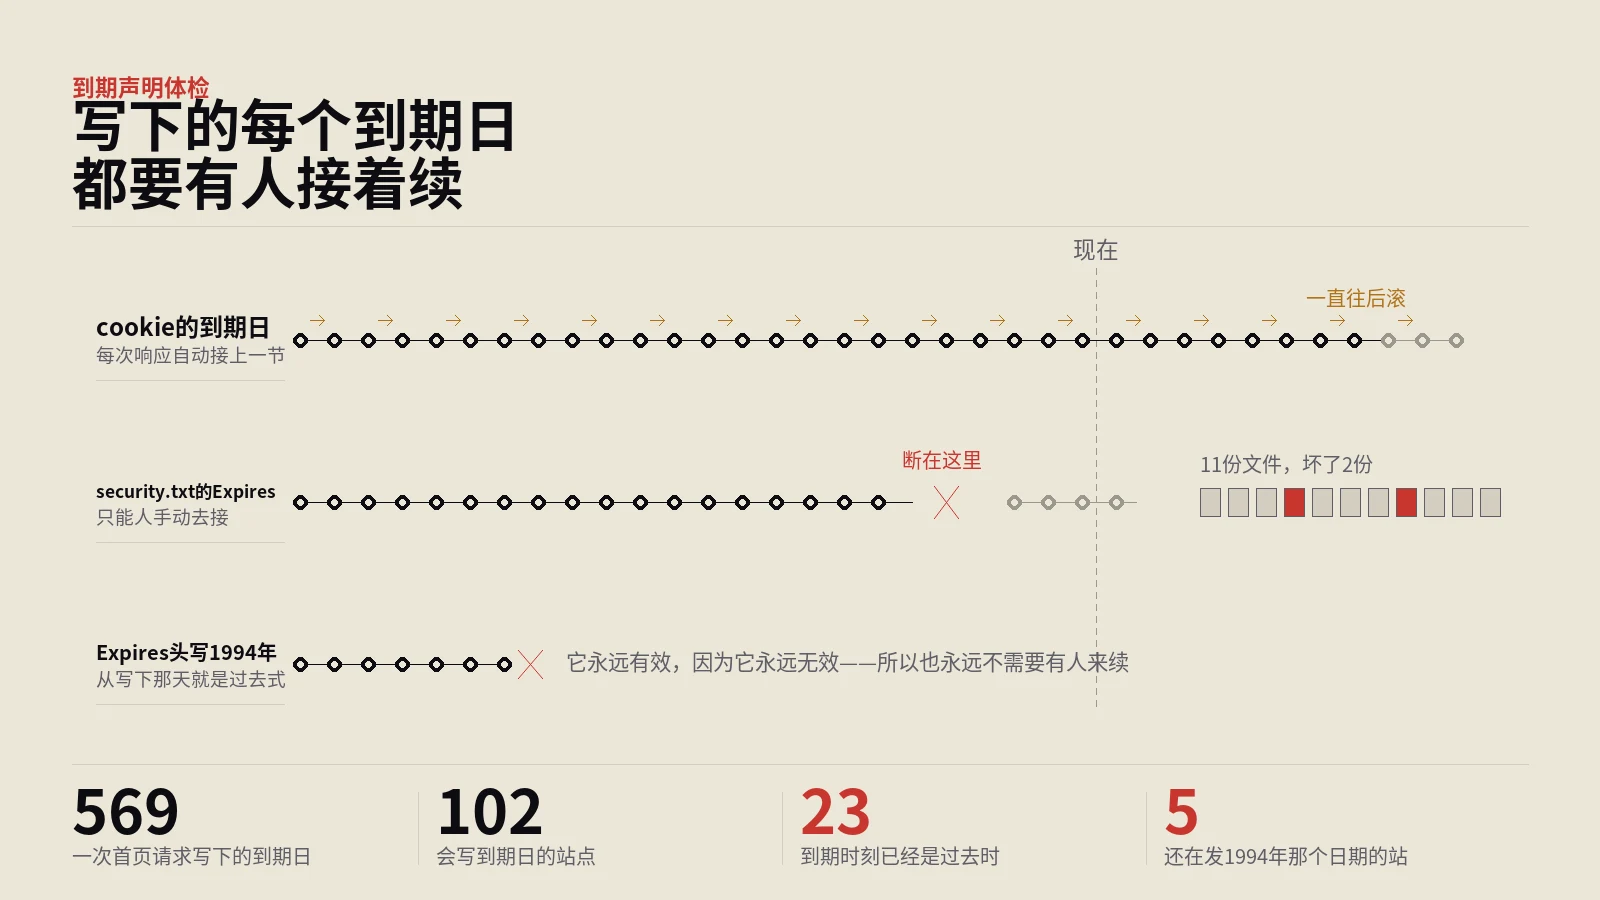
做法是把响应头里所有指向未来的字段拆开逐条换算:Set-Cookie的两个到期字段、Expires响应头,以及.well-known下那份规范要求必须写到期日的文本。换算的零点得取每次响应自己的Date头,第一版拿了个固定时刻,凭空多出十天,55条被误判成自相矛盾。
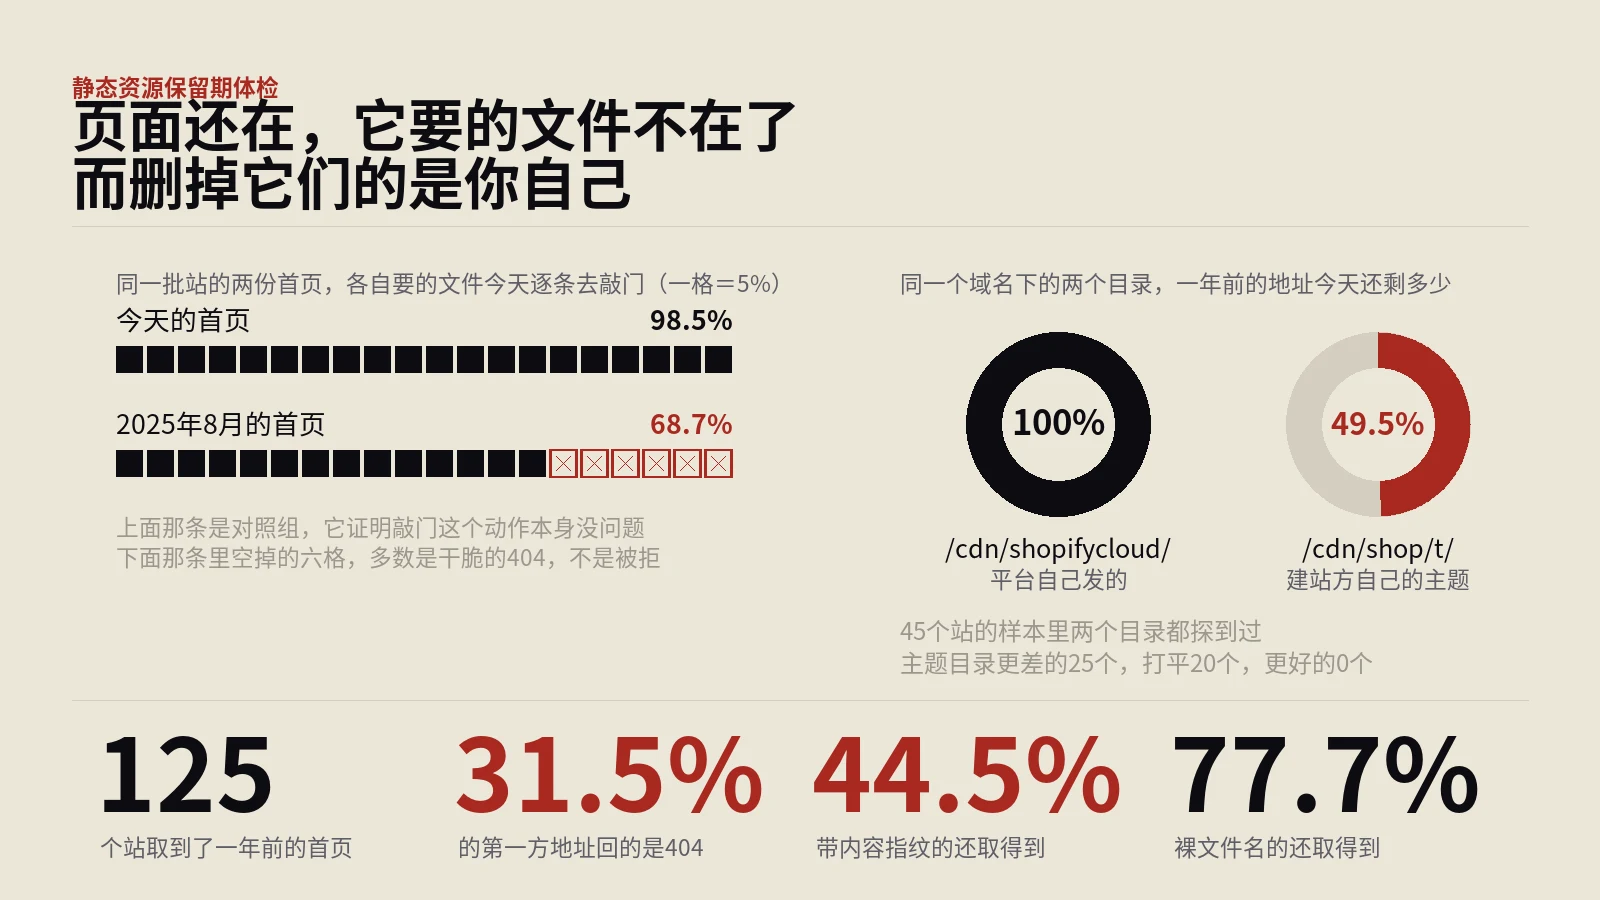
做法是从存档站取回2025年8月那份未经改写的原始HTML,把上面的资源地址按归属分好逐条拿到今天请求,同一套代码同时跑一遍今天的首页当零点。尺子坏过一次:存档站在目标日期没有快照时会跳到最近的任意一份,两个站落到了2017年,必须挑出来剔掉。
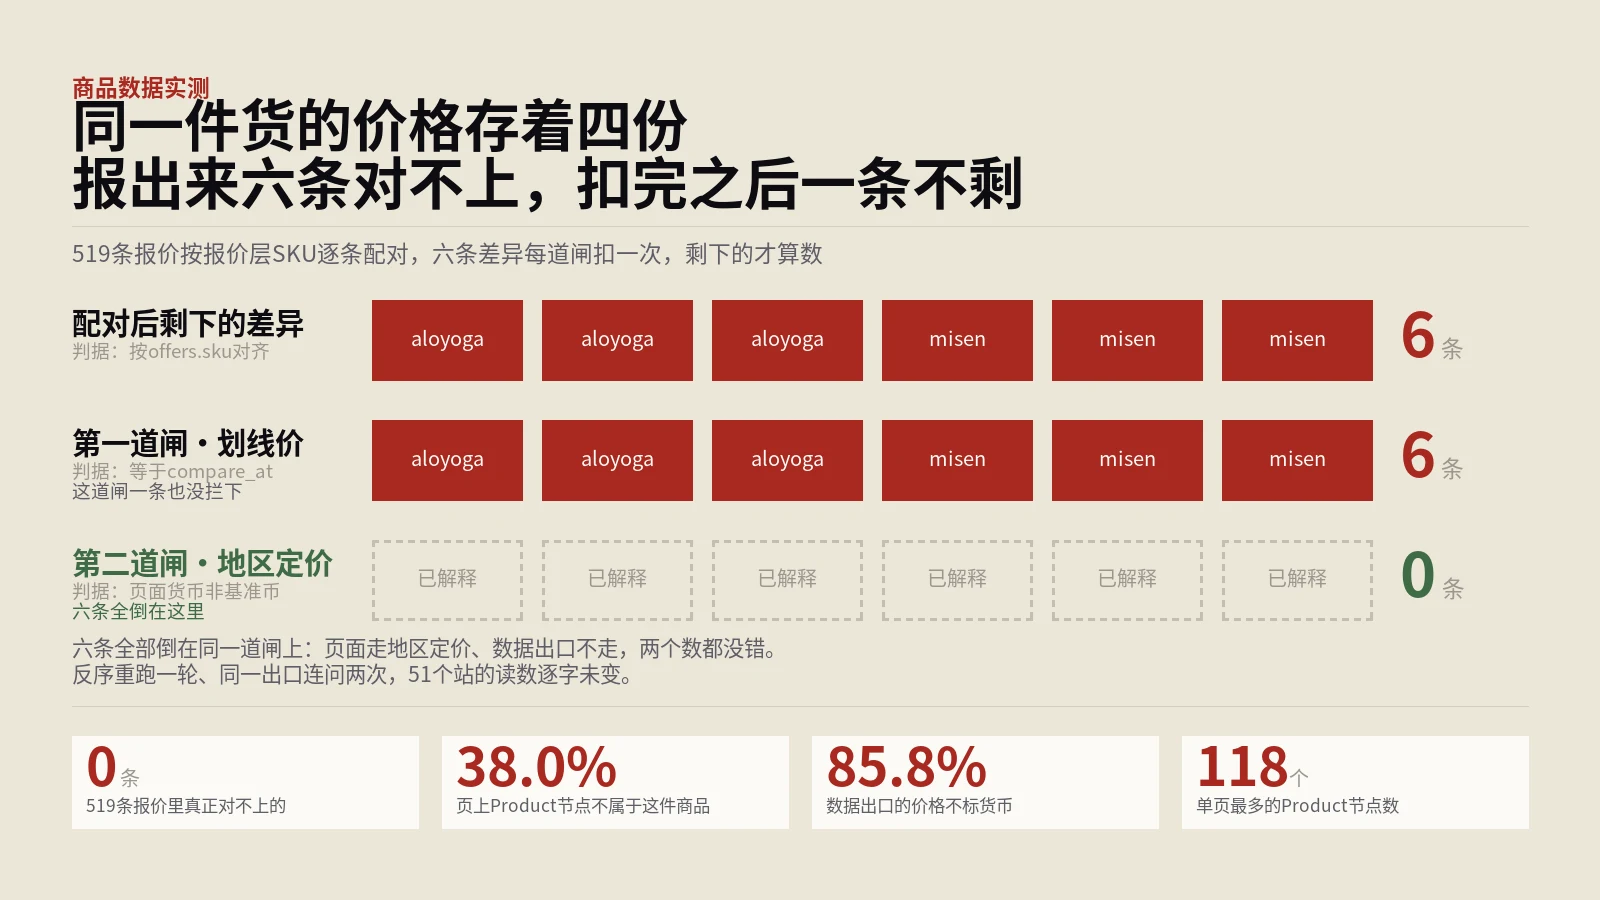
量法是把同一件商品的价格从四条独立路径各取一份:页面渲染、og标签、页面里的结构化数据、以及平台自带的两个数据出口。131个站单线程采集、间隔2秒,第二轮把请求顺序整个反过来重跑,并让同一个出口连问两次做自基线。配对不按节点出现的顺序,按报价层的SKU逐条对齐,再依次扣除划线价、地区定价、商品层与报价层编号错位这三类假阳性,剩下的才算数。
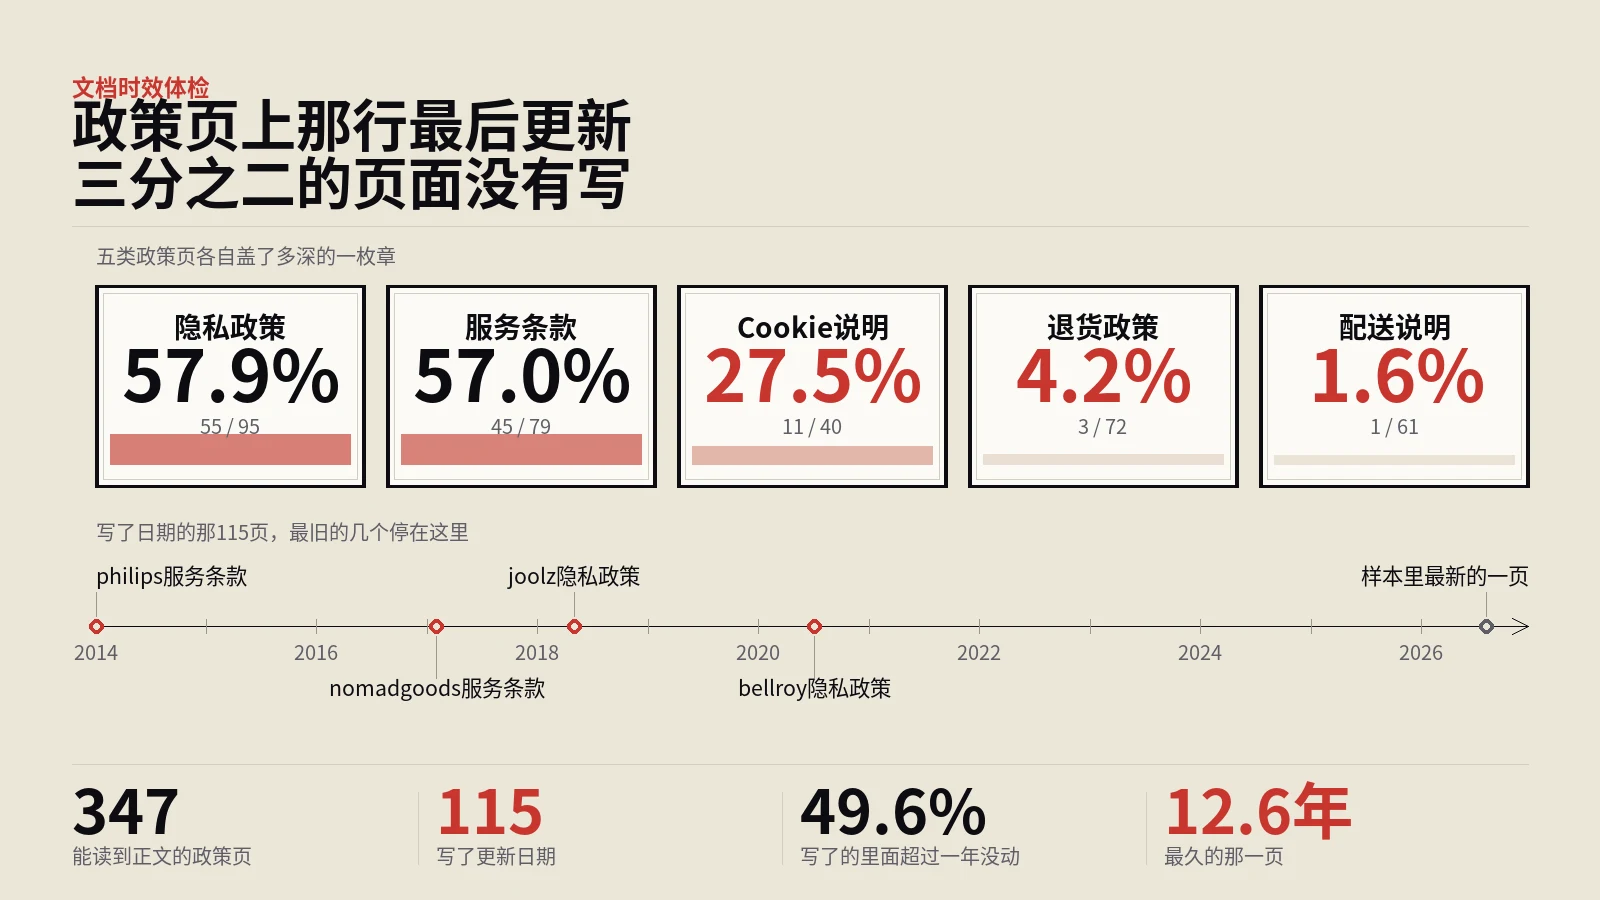
取样先顺页脚锚文本找五类政策页,找不到再按常见路径逐个试,取回正文后剔掉JS空壳与被限流挡回的页面,剩下100个站、347页。识别器前后修了六次:漏掉Last Reviewed与EFFECTIVE两种写法,把促销条款与FAQ当成了服务条款,还差点被平台限流骗成没有数据。
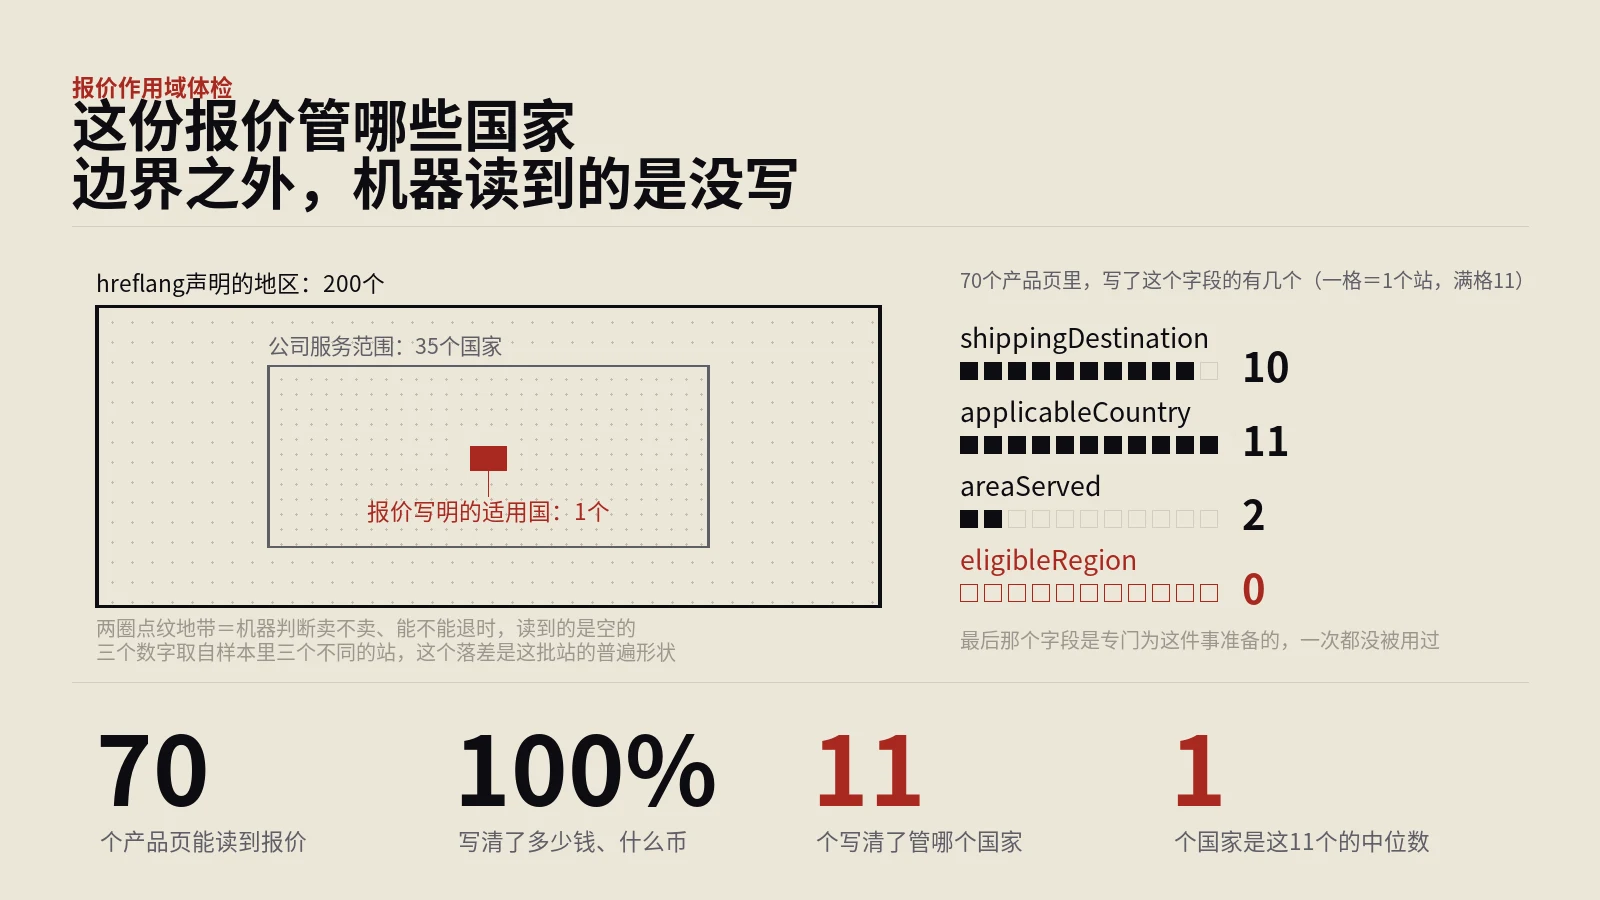
做法是从每个站的robots.txt找到sitemap入口,挑出商品那一份取一条网址抓回来,把结构化数据整段拍平后逐字段核地域信息,再拿hreflang里的多条地区网址交叉验证。尺子在这里坏过一次:第一版把欧元区多国共用一种货币的样本判成了地址不生效,9个站的结论修完只剩3个,而错的那一版恰好指向更有故事的那一边。
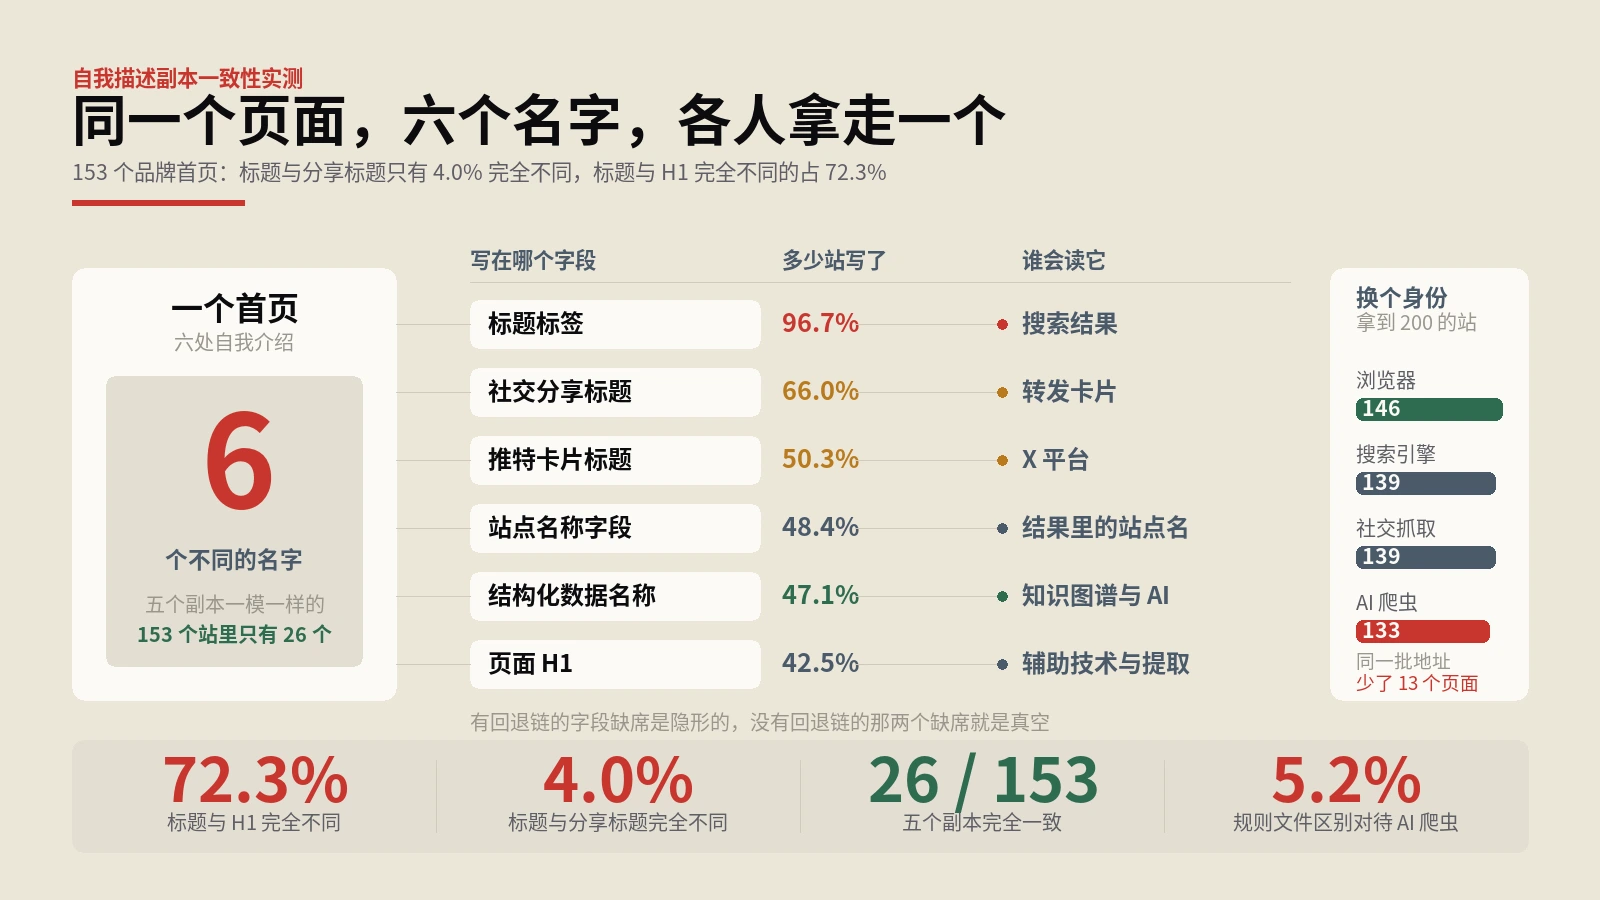
把171个海外品牌站的首页抽出六个自我介绍字段——标题标签、社交分享标题、推特卡片标题、页面H1、结构化数据里的名称、站点名称字段,逐对比对完全相同、包含还是完全不同;再用浏览器、搜索引擎爬虫、社交抓取器、AI爬虫四种身份各抓一轮,看不同的读者拿到的是不是同一份页面。文中给出字段覆盖率、五组两两一致率、消费方的取用顺序与回退链、四种身份的状态码差异、同一份规则文件对不同爬虫的判定落差,以及一条从模板层收敛六个副本的路线和几段可直接跑的核…
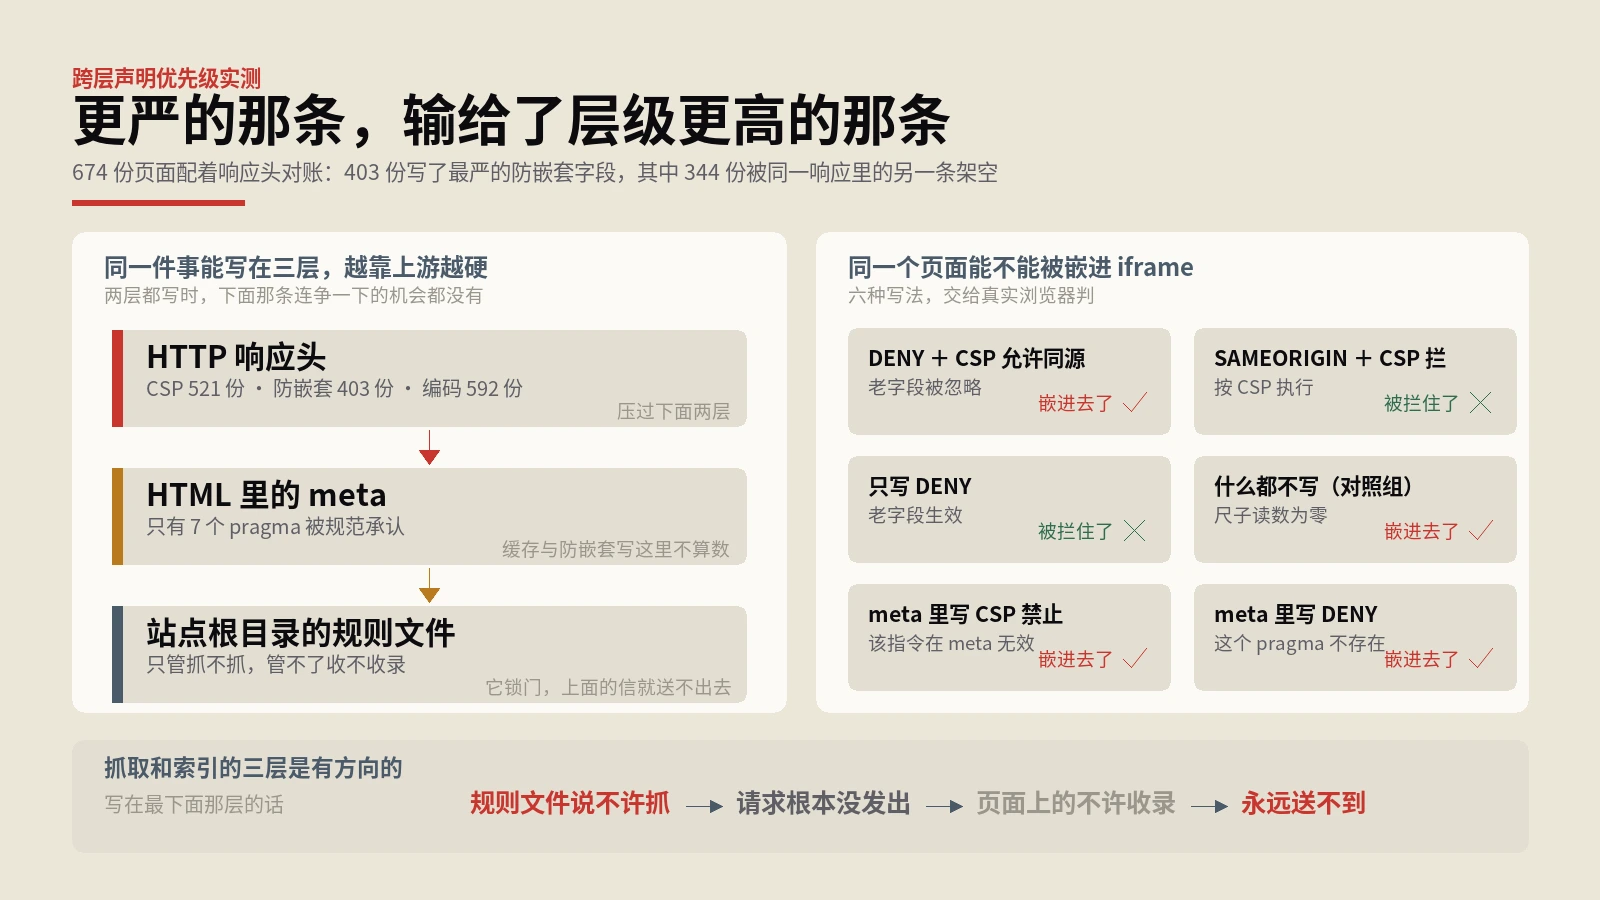
把同一件事分别写进HTTP响应头和HTML,再交给真实浏览器裁决:字符编码两个方向各测一次,防嵌套做成六格对照,其中一格同时写了最严的老字段和较松的新指令。另一头拿674份配着响应头的真实页面逐项对账,统计响应头层各字段的实际覆盖率、meta里那些规范根本不承认的写法、以及站点规则文件里各类指令的接收方现状。文中给出三条线的层级顺序、三层规则的方向性、一张按层归位的对照表,以及四条能直接跑的核对命令与一段响应头变更监控脚本。