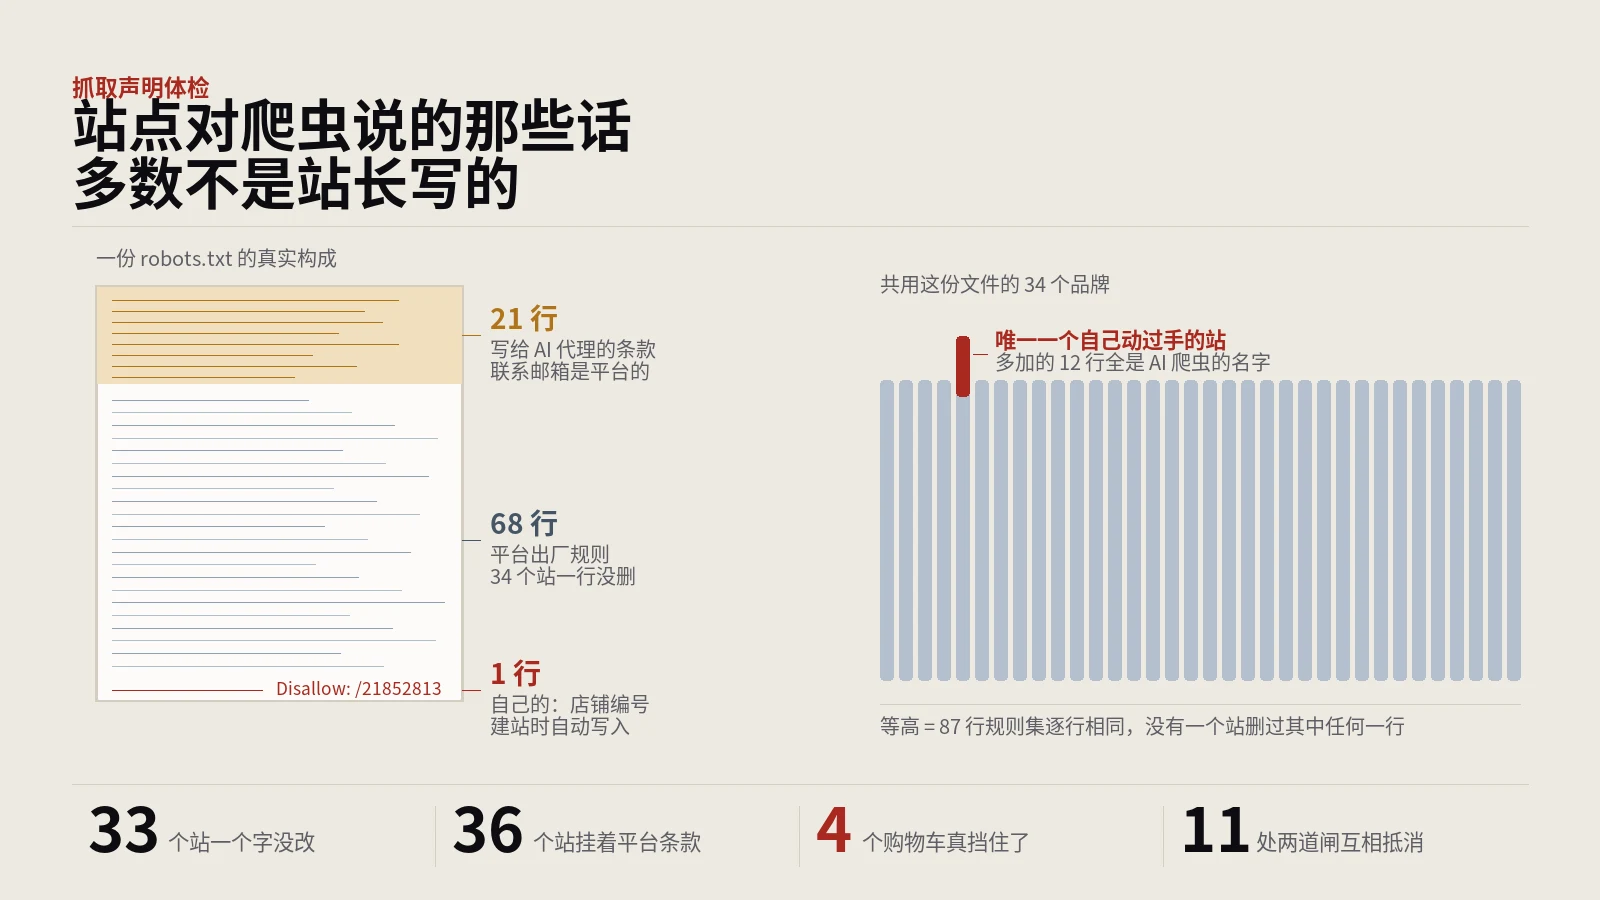
robots.txt那87行,33个站一个字都没改过
先按RFC 9309自己实现一遍规则匹配,用规范里的18道经典用例把匹配器验过,再拿它逐条判定450个页面能不能被抓;然后读每个页面HTML里的meta robots与响应头里的X-Robots-Tag,把两份声明落进四个格子。全程按页面最终落地的主机去找对应的robots.txt,跨域跳到平台认证域的单独归类。
标签
保哥笔记 爬虫抓取 标签下共 4 篇文章合集,含《robots.txt那87行,33个站一个字都没改过》《整站都开了HTTP/3,可做SEO唯一在乎的那个请求》《robots.txt生成器怎么用?预设别照抄,通配符》等,与 技术SEO、JS渲染、robots.txt 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
先按RFC 9309自己实现一遍规则匹配,用规范里的18道经典用例把匹配器验过,再拿它逐条判定450个页面能不能被抓;然后读每个页面HTML里的meta robots与响应头里的X-Robots-Tag,把两份声明落进四个格子。全程按页面最终落地的主机去找对应的robots.txt,跨域跳到平台认证域的单独归类。
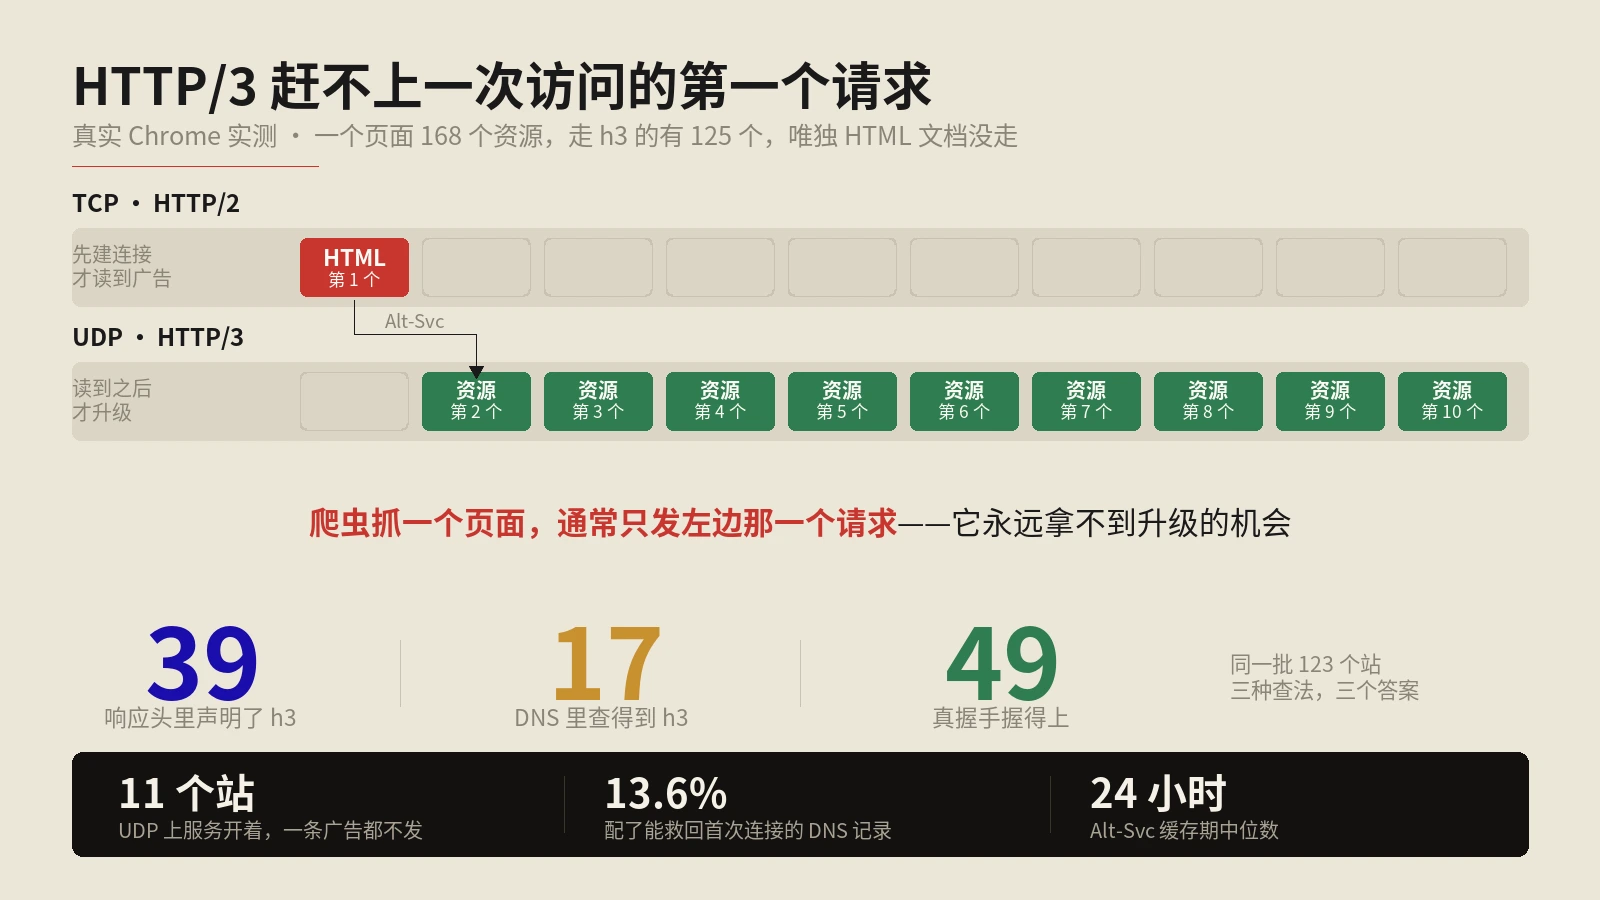
自建nginx五端口实验台把发现机制逐条复现:漏写listen ssl而只留quic那一档,语法检查通过、进程正常、端口在听,浏览器却永远找不到它;撤掉广告头之后服务照常应答,证明它只是块牌子而非开关;OpenSSL兼容层下ssl_early_data形同虚设且毫无提示。另含缓存有效期中位二十四小时、十个站还挂着旧草案版本号、云安全组只放行TCP时形成的排查盲区,以及那条能救回首次连接的DNS记录为何多数客户端拿不到。
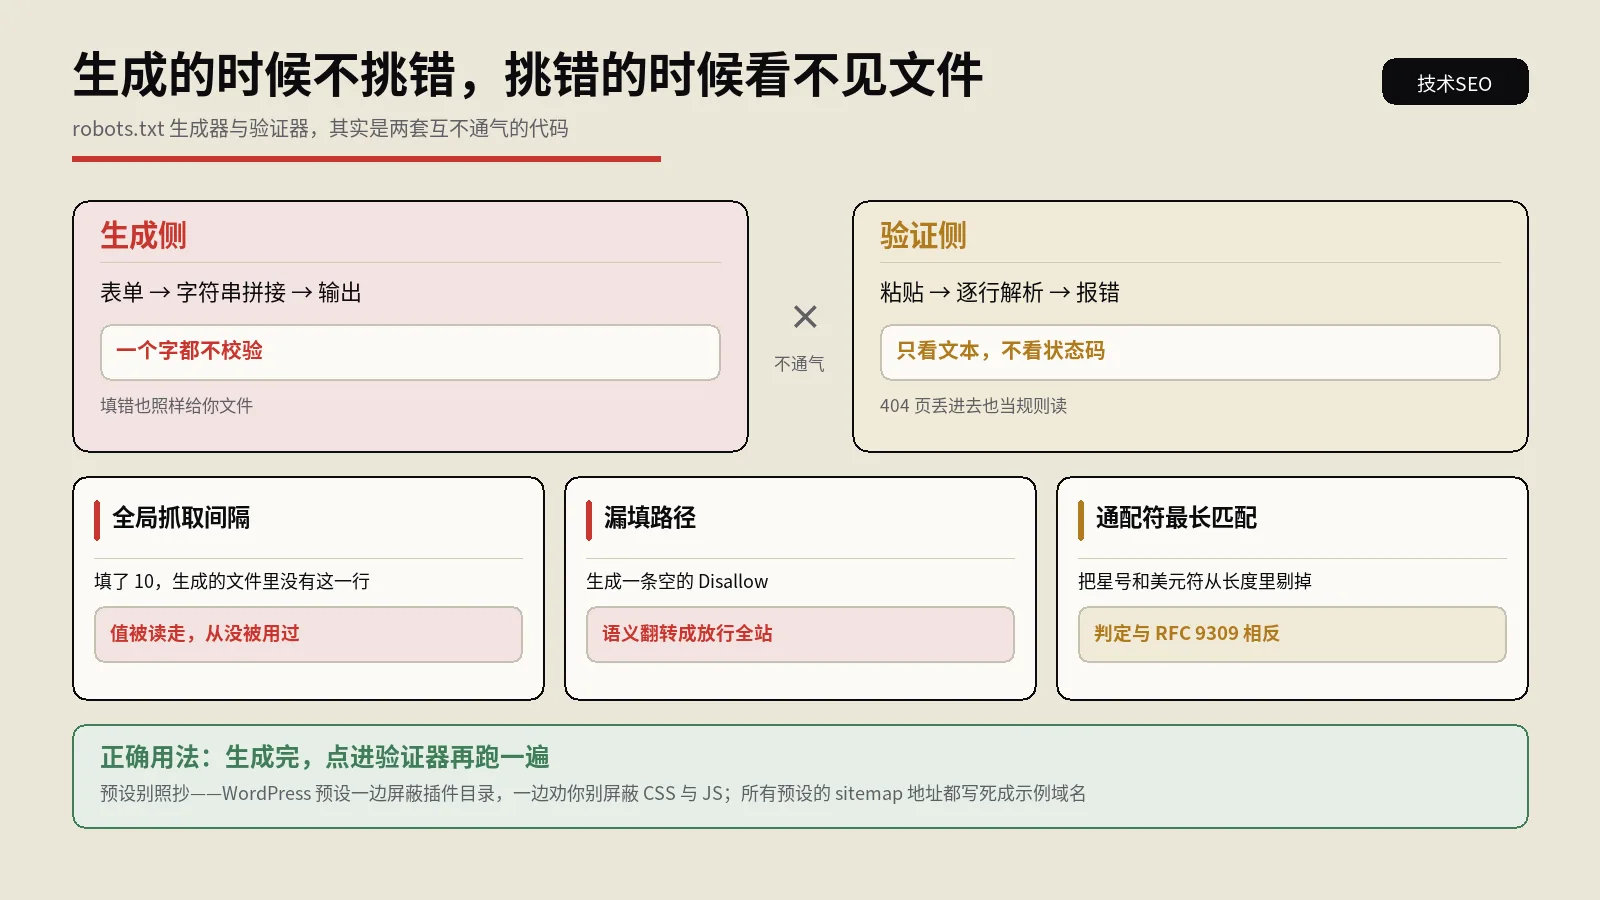
生成器只管拼字符串、一个字都不校验,验证器才挑错却看不见文件的HTTP状态。实测三处必知行为:全局抓取间隔填了不进文件、漏填路径会静默翻转成放行全站、通配符与放行规则同时命中时判定和RFC 9309相反。
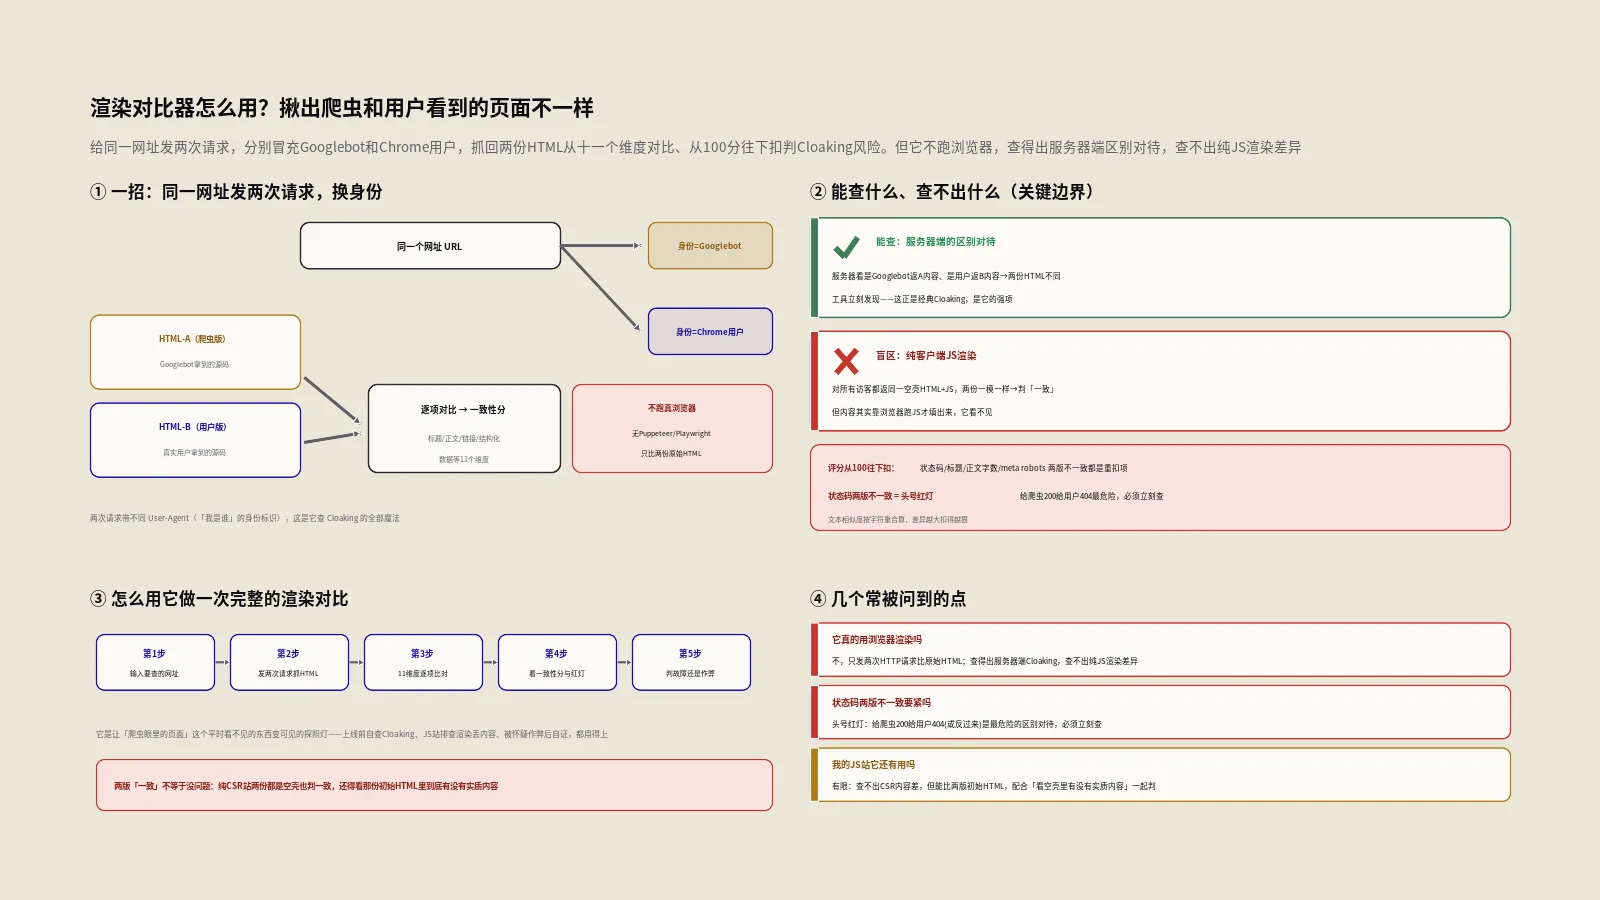
搜索引擎爬虫看到的页面,和真实用户看到的是同一份吗?本文拆解一个渲染对比器:它怎么发两次请求分别冒充Googlebot和用户、从十一个维度对比扣分判Cloaking风险,以及它不跑真浏览器、查得出服务端区别对待却查不出纯JS渲染差异这条关键边界。