AI搜索流量下降幅度:三类行业数字的口径边界与自证方法
本文目录
- 关于AI搜索影响的两个数字,为什么方向相反?
- 9.4%的查询量降幅,到底测的是什么?
- 5.2%对31.1%:这组对外点击率说明了什么?
- 传统搜索查询量减少后,那些需求流向了哪里?
- 查询量降幅从9.4%扩大到17%,这条时间线说明什么?
- 点击流研究的局限在哪,哪些结论不能外推?
- 点击流研究的样本量,为什么常被引述错?
- 零对外点击的家庭占比:ChatGPT用户和搜索用户差多少?
- 同一份研究为什么给出8.2%和17.0%两个查询量降幅?
- AI对外点击流向广告变现网站的比例低27.6个百分点,谁受影响最大?
- Google“每周数十亿次点击”为什么几乎没有信息量?
- Google为什么不公布AI点击的分母?
- 第三方可见度工具给出的AI替代率可信吗?
- AI搜索流量的三类数字,各自能回答什么?
- 不等行业数字,怎样自建AI搜索流量的测量口径?
- 哪些AI搜索影响读数可以直接测量?
- 哪两个AI可见度信号只能间接代理?
- AI提及情况只能定性测量时,怎样避免自欺?
- 页面替代梯度表:哪类页面最先被AI替代?
- 如何计算网站的AI替代暴露度分数?
- 户外露营装备独立站的六个月流量读数
- 出海多市场的AI搜索替代压力,会更重还是更轻?
- 替代率不确定时,哪些SEO动作在两种情形下都不会后悔?
- 用行业AI流量数字给老板做预测,会踩哪些坑?
- AI搜索替代流量这件事,最终该怎么判断?
- “每周数十亿次点击”的原帖是怎么说的?
- 每天与每周两个点击数字,为什么不能放在一起读?
- 同日另一平台的版本,为什么删掉了每日点击那句?
- 英文里的billions,实际能指多大的区间?
- “每天数十亿次点击”的说法最早出自哪里?
- 批评第三方方法论的Google博文,自己披露了多少方法论?
- “高质量点击”指标由谁定义、怎么测量?
- Google承认的流量重新分配,为什么比总量争论更值得记住?
- 流传的68%零点击率,研究样本经得起推敲吗?
- “AI概览让点击降42%”的说法是怎么被传错的?
- 这几份AI点击材料里,哪一份的研究设计最扎实?
- 这五个搜索流量数字放在一张表上,各自能回答什么?
- 常见问题解答
- AI搜索到底让网站流量掉了多少?
- 查询量下降9.4%,是不是意味着我的流量要掉9.4%?
- 为什么Google不公布AI搜索的点击占比?
- 在Search Console里能看到AI带来的流量吗?
- 可见度监控工具的数字能信吗?
- 哪类页面最先被AI替代?
- 在数字不确定的情况下,现在做什么不会后悔?
- 怎么向只看数字的老板解释这件事?
- 权威参考资料
摘要:同一周里,一份点击流研究说AI让传统搜索查询量掉了9.4%,Google则说AI功能每周给网站送出数十亿次点击。两个数字都不假,但都回答不了你最关心的问题:我的站到底被吃掉了多少。本文拆开三类数字各自测的是什么、边界在哪、为什么谁都给不出分母,再给出一套不依赖行业数字的自证口径:三层读数、页面替代梯度表,以及数字不确定时也不会后悔的几个动作。
关于AI搜索影响的两个数字,为什么方向相反?
2026年7月中旬,行业里前后脚出现了两组关于AI搜索影响的数字。
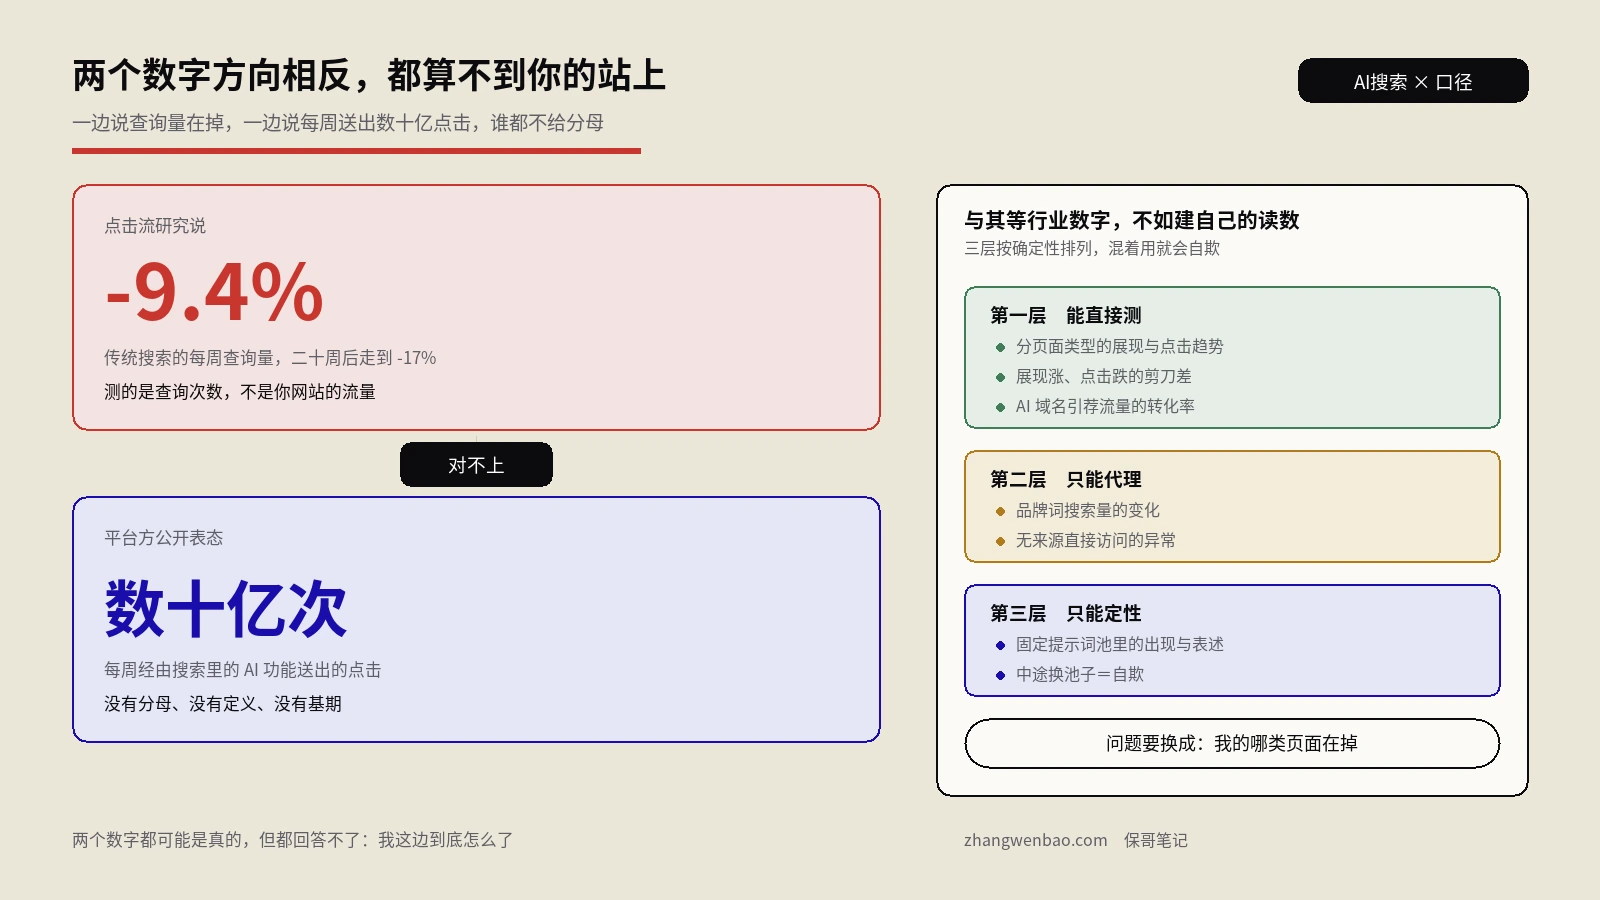
一组来自学术侧:一项基于美国桌面点击流数据的研究发现,ChatGPT搜索功能扩大开放范围之后,传统搜索的每周查询量平均下降9.4%,二十周之后降幅扩大到17%。
另一组来自Google:官方公开表示,现在仅搜索里的AI功能,每周就向网站送出数十亿次点击。
一个说流失,一个说输送。从业者看到这种局面,第一反应通常是选边站:看空的人转发前者,看多的人转发后者。两种反应都跳过了该先做的一步:先搞清楚这两个数字各自测的是什么,以及它们能不能推导到你自己的站上。
答案是都不能。这个答案本身就是最有用的一条信息。
9.4%的查询量降幅,到底测的是什么?
先把研究本身讲清楚,因为它在传播过程中被简化得面目全非。
这项研究来自博科尼大学的研究团队,论文《Answering Without Referring》的arXiv预印本用的是Comscore的网址级桌面点击流记录,覆盖四万五千多个美国家庭,时间窗从2024年10月到2025年7月。这个窗口是特意选的:ChatGPT搜索功能分批开放,先付费用户、再免费用户、最后匿名访客,分阶段推开的过程正好构成一个准自然实验,可以比较“已经能用”和“还不能用”的两群人。
要点是:9.4%测的是搜索查询量的减少,不是你网站流量的减少。
这是两回事。查询量减少意味着人少搜了几次,至于这些少掉的搜索原本会不会点进你的站、点进去会不会转化,研究没有回答,也回答不了。把“查询量降9.4%”读成“网站流量降9.4%”,是这一轮传播里最普遍的误读。
5.2%对31.1%:这组对外点击率说明了什么?
同一份研究里还有一组数字,比9.4%重要得多,传播却少得多:ChatGPT的对话会话中,产生对外引荐点击的比例只有5.2%;Google搜索查询产生对外点击的比例是31.1%。
这组对比给出的是机制层的答案。它说明的问题比“搜索少了”更具体:同一个信息需求,走AI这条路,流向外部网站的概率大约只有走传统搜索的六分之一。
这组数字更重要,是因为它可以用来推导。假设某个需求场景整体搬到了AI那边,你能拿到的点击会掉到原来的一个零头,远不止打个九折。打九折可以靠优化补回来,掉到零头说明渠道结构变了,得换打法。
这条数据也能解释为什么很多人的体感比统计数字惨得多:统计口径看的是全网平均,你的体感来自自己那几类页面。如果这些页面恰好落在被替代最严重的类目里,感受自然更接近32.8%那一档(研究里查资料和研究类查询的降幅),而不是平均值。
传统搜索查询量减少后,那些需求流向了哪里?
“替代”很容易被读成“需求消失了”。实际上,少掉的那部分查询有三条不同的去向,对应三种不同的应对。去向分不清,力气就会用错地方。
去向一,同一个需求换了个地方问。用户还是想知道那件事,只是从搜索框换到了对话框。这部分是严格意义上的替代,也是讨论最多的一条。应对它靠的是可见度:让AI在回答这类问题时提到你、引用你。
去向二,需求被前一次对话顺手消化掉了。这条更隐蔽。过去要搜三次才能问明白的事,现在在一次对话里追问两轮就解决了,后面那两次搜索根本没有发生。从统计上看是“查询量下降”,从用户角度看是需求被压缩,并没有转移。这部分需求你几乎无从触达,因为它没有形成一次独立的检索。
去向三,需求没有被满足,用户放弃了。AI给了个似是而非的答案,用户接受了,也就不再往下查。这是对你最不利的一种:你的内容明明更准确,用户却已经不觉得自己需要它。
这三条去向各占多少,没有任何公开数据能拆开。但它们的存在有个实用推论:那个降幅数字里,只有第一部分能靠做可见度追回来。如果把全部降幅都当成“能靠GEO打法追回的流量”,就会高估投入产出比,半年后面对没达标的数据只能重新评估。
查询量降幅从9.4%扩大到17%,这条时间线说明什么?
研究里还有一个容易被略过的细节:降幅随暴露时间加深,并非一次性发生。刚开放访问时是9.4%,二十周之后是17%。
这条曲线的形状比终点包含更多信息。它说明替代是一个习惯迁移的过程,而非一次性冲击:人不会因为出了个新工具就立刻改变行为,而是用着用着,某一类问题就不再默认去搜索框了。
由此可以得出三个推论。
第一,用早期数据做长期外推一定会低估。一个产品刚铺开三个月时测到的影响,并不是它的稳态影响。反过来,用二十周的数字去外推两年同样没有依据:曲线会不会走平、什么时候走平,没人知道。
第二,基线要滚动重设。如果你去年建了一条基线后一直沿用,这条基线正在持续失真。更合理的做法是每个季度重设一次同比口径,并在报告里注明基线更新时间。
第三,你自己的曲线也应该是渐变的。如果数据显示某一周突然断崖式下跌,多半是别的原因,比如改版、索引问题、算法更新或跟踪代码失效,而不是AI替代。替代是逐步渗透的,断崖另有原因。这个判据能帮你省掉很多无效排查。
点击流研究的局限在哪,哪些结论不能外推?
研究团队在论文里写明了局限。这部分在转发中几乎全部丢失,却决定了你能不能拿这个数字做决策。
只有美国桌面数据。没有移动端,也没有国际市场。做外贸和出海的人要特别注意这一条:东南亚用户用手机搜索,和美国家庭在桌面浏览器上搜索,行为结构差异很大。
没有收入数据。研究能看到点击去了哪,看不到这些点击值多少钱。少掉的那部分查询里,可能大部分本来就不带来收入。
时间窗截至2025年7月。此后一年,AI搜索的产品形态又变了好几轮,趋势方向大概率没变,但幅度不能直接沿用。
类目差异很大。研究本身就报告了交易类和娱乐类查询的变化明显更小。用一个跨类目平均值去预测某个具体类目,在方法上不成立。
因此,这份研究的正确用法是:把它当作机制方向和一组结构性比例,而不是可以填进财务模型的系数。
点击流研究的样本量,为什么常被引述错?
这份研究传开之后,中英文渠道里出现最多的一句概括是:它覆盖了四万五千多个美国家庭。
这句话不算错,但用错了位置。
论文里的原始口径是:Comscore的完整样本每月包含十六万八千余到二十三万八千余个活跃的美国桌面家庭;其中有一个由四万五千三百八十六个家庭组成的平衡子面板,要求每个月至少产生四次前台页面加载。
重点在后半句:这个四万五千多户的子面板,只用于传统搜索替代效应这一项分析。研究里关于对外点击比例、目的地构成的结论,用的是范围大得多的完整样本。
把四万五千当成整份研究的样本量,就是把一个专用子集的规模说成了全部工作的规模。
再往下还有一层。用于识别替代效应的处理组规模小得多:合计三千八百八十二个家庭,其中付费订阅组只有八十四户。
八十四这个数字值得记住。分组结论的可靠性取决于该组自身的人数,与总样本量无关。看到按人群拆开的结论时,先找那一组的分母,这比看总样本更有用。
零对外点击的家庭占比:ChatGPT用户和搜索用户差多少?
这份研究里最该被拿出来讨论、却几乎没人转述的数字是74.4%。
在十个月的窗口里,五万六千多个使用过ChatGPT的活跃家庭中,有74.4%从头到尾没有产生过一次干净的对外点击。同期,二十九万多个使用搜索引擎的家庭里,这个比例只有9.6%。
两个数差距很大。用搜索的人里,十个中有九个至少点出去过一次;用AI的人里,四个中有三个一次都没有。
这比前面的5.2%更能说明问题。5.2%是把所有会话摊平后的平均值,容易让人以为流量被均匀削薄了。74.4%说明的是另一回事:对大多数用户而言,这条通道从来没给你送过流量,谈不上变少。
剩下的点击高度集中在少数家庭身上。AI带来的站外访问从一开始就由少数重度用户贡献,呈长尾结构,并非人人都贡献一点的普惠结构。
这条推论对预期管理很有用。如果你的站在这一轮确实拿到了一些AI来源的访问,这些访问大概率来自一小部分人;用这批数据外推整个用户群的行为,结论会严重偏乐观。
同一份研究为什么给出8.2%和17.0%两个查询量降幅?
前面用到的降幅是二十周之后的17.0%。同一份研究里还有另一个数:8.2%。
两个数字都对,差别在于比较对象不同。
17.0%来自研究的主口径,比较的是新获得访问权的家庭和此前完全没用过这类工具的家庭。8.2%来自一个更干净但样本更小的比较:两批都已经在用这个工具的人,只是获得完整访问权的时间不同。
后者剔除了一部分选择性偏差,因为主动去用AI的人,本来就可能是搜索习惯正在变化的人。剔除之后,降幅缩小了一半还多。
由此可以得到一个通用判断:一份研究同时给出几个估计值时,口径越干净的通常越小,而进入摘要的通常是最大的那个。
这不一定是研究者有意为之。审稿、传播、注意力竞争,每一环都在把最醒目的数字往前推。对读者来说,习惯性地翻到方法论部分找那个更保守的估计,几乎总是值得的。
研究团队自己在这件事上相当克制。他们明确写道,这项工作的主张刻意窄于福利层面的主张:测的是可观察的流量分配变化,不涉及消费者福利、发布商收入,也不涉及长期的内容生产。
这句自我设限比论文里任何一个百分比都有价值。它提前排除了一整类外推:拿这份研究论证内容行业整体的兴衰,研究者自己都不认可。
AI对外点击流向广告变现网站的比例低27.6个百分点,谁受影响最大?
还有一组很少有人提的数字,讲的是实际发生的点击流向了哪里。
把AI产生的对外点击和搜索引擎产生的对外点击按目的地的变现方式分类比较,结果是:流向广告变现网站的比例低了27.6个百分点,流向媒体类站点的比例低了15.8个百分点。
相应地,流向专门性目的地的比例更高。
剩下的点击因此并非原来那股流量的等比例缩小版,它的成分变了。
沿着这一点往下推,不同类型的站受到的冲击结构完全不同。
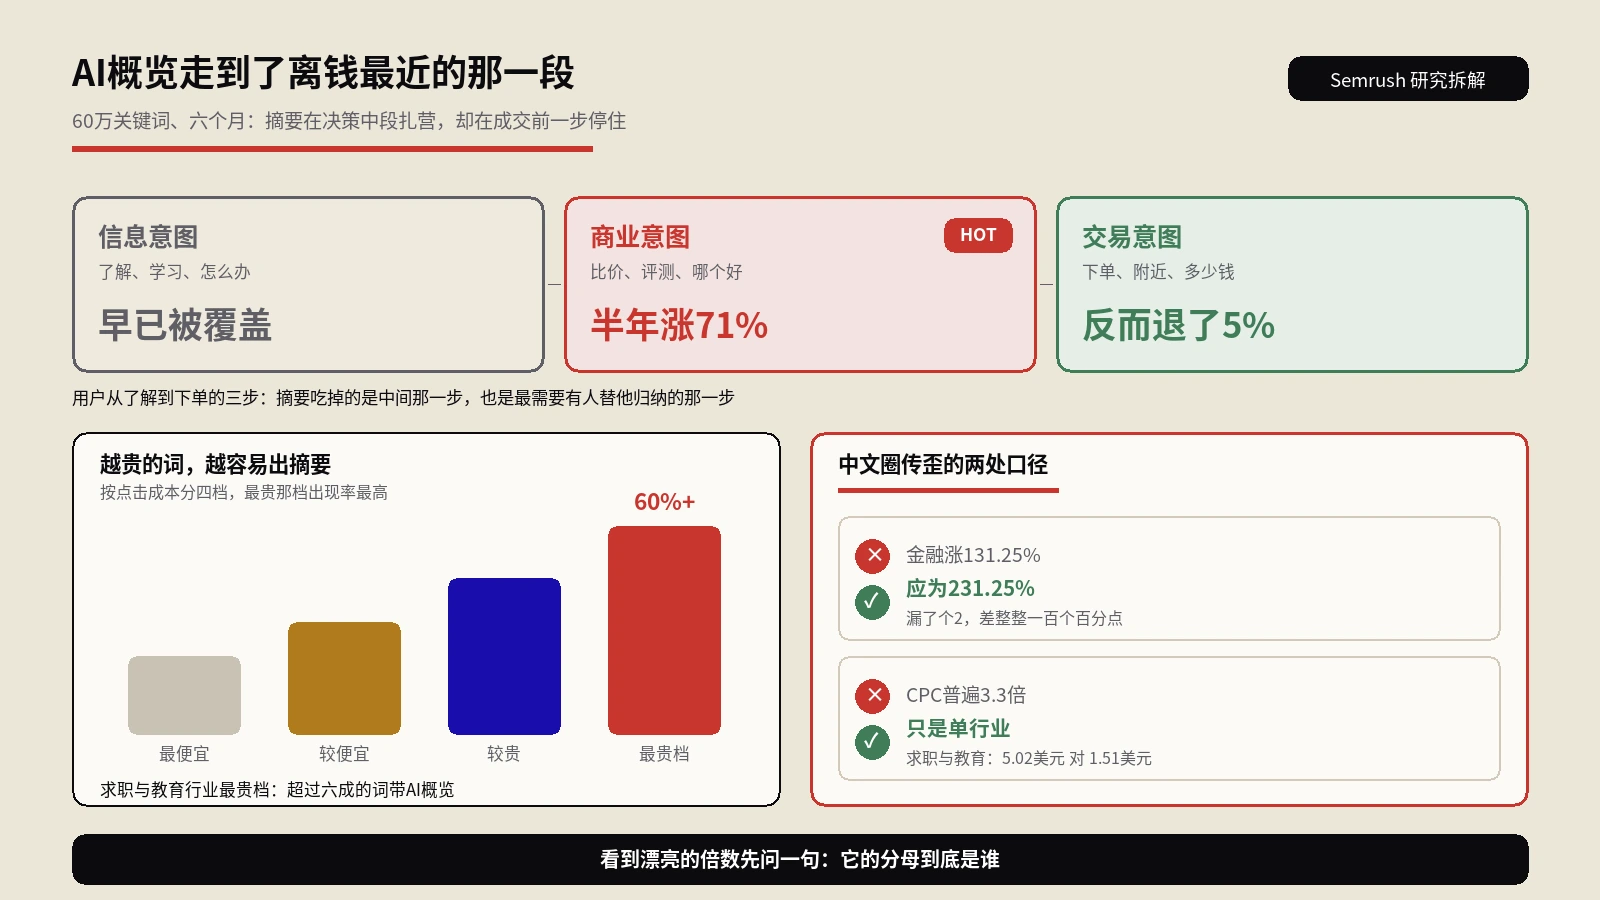
靠广告变现的内容站受到双重冲击:总量在降,剩下的流量还系统性地绕开它们。品类维度的数据也能对上:学术研究类目的地的搜索引荐下降32.8%,参考知识类下降26.5%,开发技术类15.1%,新闻资讯类13.4%。前两类正是典型的“查完就走”的信息需求。
靠交易变现的站受影响相对轻一些。原因不在于它们做对了什么,而在于购买这件事目前还无法在对话框里完成,用户最终得走到能付款的地方。
对独立站来说,这是这份研究里少有的好消息,但作用有限:它保护的是交易环节,不保护交易之前的内容页。你站上用来做认知和教育的文章,处境与内容站相同。
另外,同一块结果页上的广告位、被引来源和自然结果其实是三条互不相通的通道,彼此带不动。站内另有一篇拿五万个商业词的实测专门拆过,它和这里的替代效应是同一个问题的两个侧面。
Google“每周数十亿次点击”为什么几乎没有信息量?
再看另一边。Google公开表示,搜索里的AI功能每周单独送出数十亿次点击。这句话每个字都可能是真的,但作为信息,它的价值接近于零,原因有三个。
没有分母。数十亿听着很大,但相对于什么?Google搜索整体的日均点击本身就在数十亿量级。一个周度绝对数和一个日均绝对数放在一起没法比,除非知道总量,否则判断不了这是大头还是零头。
没有定义。什么算一次“点击”?AI概览里的来源链接被展开算不算?引用角标的悬浮预览算不算?不同定义之间可能差出好几倍。
没有基期。没有说明这个数字比去年同期涨了还是跌了。不带趋势的绝对数无法支撑任何判断。
还有最后一层:就算这三样都给了,它仍然是一个汇总数字,和你的站没有任何映射关系。你无法从“全网每周数十亿”反推出“我的站这周应该拿到多少”。
Google为什么不公布AI点击的分母?
这里不必往阴谋论上想,有两个更朴素的解释。
一是竞争考量。点击的绝对量和占比是Google最核心的商业数据之一,公开完整口径等于亮出广告业务的底牌。
二是产品口径本身在变。Google关于搜索中AI功能的官方说明显示,AI概览、AI模式等形态的数据按搜索类型合并进现有报告,没有单独拆出一套。产品形态每几个月变一次,口径随之变化,公布一个三个月后就站不住的数字,对谁都没有好处。
明白这一点,就不必再等:官方不会给出能让你算出自己那一份的数据,这种缺失是结构性的,并非暂时的信息滞后。指望一个权威数字来解答你的疑问,等不到。
第三方可见度工具给出的AI替代率可信吗?
市面上还有第三类数字:各家可见度工具给出的AI流量占比、引用份额、替代率。这类数字的问题不在造假,而在外推链条太长。
典型做法是:建一个提示词池,跑一批引擎,统计品牌出现和被引用的情况,再按某种权重外推到市场份额。链条上每一环都有假设:提示词池能否代表真实的需求分布?所跑引擎的市场份额怎么加权?出现一次和被点击一次怎么换算?
这些工具适合做纵向对比:同一套提示词池、同一批引擎、每周跑一次,看自己的曲线是升是降,这种用法可靠。用来做横向的绝对值判断就不合适:说“我们在AI里的份额是12%”,这个12%的置信区间大到没有意义。
AI搜索流量的三类数字,各自能回答什么?
| 数字来源 | 实际测的是 | 能回答 | 不能回答 |
|---|---|---|---|
| 学术点击流研究 | 特定人群的查询行为变化 | 替代是否真实发生、机制往哪个方向走 | 你所在类目、你所在市场的具体幅度 |
| 平台官方表态 | 全网汇总的绝对量 | 这条渠道整体上还在输送流量 | 占比、趋势、以及你那一份是多少 |
| 可见度工具 | 自设提示词池里的出现与引用 | 自己的曲线是升是降 | 绝对份额、跨品牌横向比较 |
| 你自己站的读数 | 真实发生在你这里的事 | 哪类页面在掉、掉多快、掉的是不是值钱的那部分 | 全行业发生了什么、同行是不是也这样 |
这张表要对照最后一行和前三行来看:前三类数字回答的都是“世界怎么了”,只有第四类回答“我怎么了”。做决策需要的是后者。
不等行业数字,怎样自建AI搜索流量的测量口径?
下面是可执行的部分。自证口径分三层,按确定性从高到低排列。三层不要混用,混用就会自欺。
哪些AI搜索影响读数可以直接测量?
第一层是能直接测的三个读数。
读数一,按页面类型拆分的展现与点击趋势。在Search Console的性能报告里,把页面按类型分组打标(定义解释型、操作教程型、对比评测型、交易转化型),再分组看展现量和点击量的走势。Search Console性能报告的官方口径说明里有一点必须记住:AI相关形态的数据是合并计入的,你看到的是合并后的结果。所以这里读不出纯粹的AI影响,能读出的是“哪类页面在失血”。
读数二,展现涨、点击跌的剪刀差。这是信息量最大的单一指标。展现量持平甚至上升,点击量却在下降,说明内容仍被检索到,只是用户不再需要点进来。剪刀差的斜率比任何行业百分比都更接近你的真实处境。GSC各项指标怎么读才不被带偏,保哥在GSC的数字为什么人人都读错里逐项拆过。
读数三,引荐来源里的AI域名。在分析工具里把来自各家AI产品域名的引荐流量单独拉出来。这部分量通常很小,重点也不在绝对值,而在它的转化率:多数站会发现这批流量的转化率明显高于自然搜索平均水平,因为用户已经被AI预先筛选过一轮。
哪两个AI可见度信号只能间接代理?
第二层是只能代理的两个信号。
代理信号一,品牌词搜索量。如果AI在推荐你,会有一部分人转头去搜你的品牌名。品牌词搜索量的变化可以作为可见度的间接证据,但它同时受广告、社媒、线下活动等多种因素影响,不能单独用来归因。
代理信号二,直接访问的异常。没有来源标记的直接访问上涨,可能是用户看到AI推荐后手动输入了网址,也可能只是统计口径造成的。这类信号应当读作“值得进一步查证”,不能当作“证据”。
这两个信号如何组合成一张分层归因表,保哥在零点击时代的归因怎么补里给过完整做法,这里不再重复。
AI提及情况只能定性测量时,怎样避免自欺?
第三层是剩下只能定性测量的部分,包括AI在多少次相关对话里提到了你、提到时说得对不对、有没有把你和竞品放在一起比较。
做法是建一个固定的提示词池,每周或每两周手动跑一遍,记录三件事:有没有出现、出现时的表述是否准确、引用的是不是你自己的页面。关键是提示词池固定不变。一旦中途更换,前后数据就失去可比性,而这恰恰是最常见的自欺方式:曲线不好看,就换一批提示词。
零点击环境下,品牌影响力还有哪些可衡量的维度,零点击搜索拿走了流量,品牌影响力还怎么衡量那篇给了一整套仪表盘,可以直接拿去用。
页面替代梯度表:哪类页面最先被AI替代?
这张表把研究里的类目差异,转换成可以对照自己站点打标的形式,用来判断应该先检查哪一批页面。
| 页面类型 | 被替代压力 | 原因 | 该往哪改 |
|---|---|---|---|
| 名词解释、概念定义 | 最高 | 答案短、无歧义,一句话就能给完 | 别指望它带流量,改成承接内链和实体佐证的枢纽 |
| 通用型操作步骤 | 高 | 步骤可被完整复述 | 加版本差异、报错处理、实际截图这些复述不了的东西 |
| 横向对比、选型 | 中 | AI能列表格,但列不出真实使用体验 | 补自己实测的数据和踩坑,把对比锚在一手经验上 |
| 带地域、带资质的服务页 | 中低 | 需要核实主体,AI倾向给出处 | 把实体信息和第三方佐证做扎实 |
| 交易与产品页 | 低 | 最终必须落到某个具体商家 | 保证结构化数据和库存价格准确,别在这层丢分 |
这张表还揭示了一个问题:压力最高的两类页面,往往正是过去几年做内容时被当作流量主力的类型。很多内容站的体感远比行业平均惨,原因在于它们的资产结构正好压在替代梯度的顶端,并非行业跌得更狠。
如何计算网站的AI替代暴露度分数?
梯度表是定性的,再推进一步就能变成可以排序的数字。这个算法很粗糙,但解决的问题很实际:老板问“我们受影响大不大”时,你需要一个能拿出来讨论的依据,而不是一句“要看情况”。
分三步。
第一步,给页面类型赋权。按上面的梯度表给每一类设定替代压力系数:名词解释类1.0,通用操作步骤类0.8,对比选型类0.5,带地域资质的服务页0.3,交易产品页0.1。这些数字是相对刻度,不是概率,不必纠结准不准。只要全站用同一把尺子,排序就有意义。
第二步,按自然搜索点击量计算权重。取过去90天的数据,算出每一类页面的点击量占全站自然搜索点击的百分比。注意用点击量,不用页面数量:一百个没人看的名词解释页,不该和一个主力页面同等计分。
第三步,加权求和。把各类的占比乘以对应系数再相加,得到一个0到1之间的分数。0.6以上说明你的流量结构严重依赖高替代压力的资产,这件事对你是战略级的;0.3以下说明短期影响有限,可以按常规节奏推进,先建口径,不急着大改。
这个分数的绝对值用处有限,更有价值的用法是每季度重算一次,看它的移动方向。分数下降,说明流量结构正在往抗替代的方向迁移,这本身就可以作为汇报里的成果指标;分数不变甚至上升,说明新做的内容仍然集中在最容易被替代的那一类。
需要注意一个失真因素:改版、季节性和新页面上线都会影响这个分数,所以每次算完要顺手记下当期发生了什么。GSC里那份生成式AI相关报告怎么读、屏蔽开关要不要动,保哥在GSC生成式AI性能报告与屏蔽开关怎么用里单独写过,那份报告能为这套算法补充一层实证。
户外露营装备独立站的六个月流量读数
去年帮一个户外露营装备独立站分析过这个问题。他们卖便携炉具和睡袋,主力市场是欧洲和澳洲。老板拿着一堆行业报告,第一个问题是:我们该按跌多少来做预算?
这个问题无法回答,所以当时先把他们自己的读数拉了出来。按上面的页面分类打标后,六个月的数据分化得很清楚:科普解释类页面展现基本没降,点击降了将近一半;产品页和分类页几乎没有变化;对比选型类页面点击小幅下滑,但同期引荐来源里AI域名的流量明显增长,转化率高于自然搜索平均水平。
行业里那个平均数字,落到这个站上变成了三种完全不同的走向。用任何一个单一百分比做全站预算,都会同时高估一部分、低估另一部分。
后续动作据此确定:科普页不再追求点击,改造成融入实体信息、产品内链和佐证材料的枢纽页;对比页补充了他们自己在阿尔卑斯做的低温实测数据,这是AI复述不了的内容;产品页没有改动,只把结构化数据和库存状态的准确性重新核对了一遍。
这套读数有明确边界:它解决的是“钱该往哪投”,不解决“总量会跌多少”。后一个问题在数据结构上就没有答案,谁给出精确答案,谁就是在编。
出海多市场的AI搜索替代压力,会更重还是更轻?
研究只覆盖美国桌面端,而做外贸和独立站的人面对的是许多其他市场,而且大半是移动流量。这个缺口不能靠猜,但可以根据几条已知的结构差异推断方向。
移动端的替代大概率更重,但点击基数本来就低。手机上的AI入口正在进入系统层和浏览器内置功能,路径比桌面更短,替代发生得更自然。不过移动端搜索的点击率本来就低于桌面,从“损失的绝对点击”看,未必比桌面严重。两个方向相反的效应叠加,净结果只能自己测,不能沿用别人的数字。
非英语市场目前的替代偏轻,但这个窗口正在关闭。小语种的AI答案质量普遍不如英语:训练语料少,本地实体识别弱,引用的来源经常与问题不相关。用户吃过几次亏后会回到搜索框。这为做小语种市场的团队留出了一段缓冲期,但语料在补充,缓冲期在缩短。合理的做法是利用这段时间抢占本地实体和本地佐证,而不是把它当作可以不动的理由。
B2B出海的替代压力,结构性地低于B2C信息类。采购决策要核实主体、查看资质、走多人审批流程,AI在这类场景里更倾向于给出处而非给结论。因此,工业品和设备类独立站短期内不必把AI替代当成首要威胁。更该关注的是:采购方用AI做初筛时,你在不在候选名单里。
落到操作上只有一条:按市场分别建立口径。全球合并成一条曲线,是这件事上最没用的图表,因为它把方向相反的几个市场平均成了一条没有信息量的横线。至少按主力市场拆成三条,每条单独看展现与点击的剪刀差。
还可以顺手加一个低成本判据:看某个市场里品牌词点击和非品牌词点击的比值走向。非品牌词点击下降、品牌词点击上升,通常说明替代正在发生,但品牌资产接住了这部分需求;两者同时下降,多半不是AI的问题,而是这个市场的整体运营出了别的问题。
替代率不确定时,哪些SEO动作在两种情形下都不会后悔?
做决策的人真正需要的不是准确预测,而是一组“无论替代率是9%还是30%都该做”的动作。这样的动作有四个。
一,把可被复述的内容改成不可复述的。替代率高,这样做能保住流量;替代率低,这样做本来也能提升内容质量。两种情形下都成立。
二,把实体信息做扎实。官网主体信息、第三方佐证、一致的品牌描述,在AI搜索里决定你会不会被推荐,在传统搜索里是E-E-A-T的基础。两边都受益。
三,先把测量口径建起来。建口径的成本很低,价值随时间增长。等到需要向老板解释时再建,基线就晚了半年。
四,把渠道结构分散一档。这条不要求全面转投别的平台,只要求别让某一个渠道占到七成以上。它在任何一种未来里都成立。
反过来,有两个动作明确应该放缓:为了追一个不确定的趋势而大规模重写老内容,以及在没有自己基线的情况下采购一整套昂贵的监控工具。这两件事都是用确定的成本,去赌不确定的收益。
用行业AI流量数字给老板做预测,会踩哪些坑?
下面是几个具体的坑,都在实际项目中出现过。
坑一,把查询量降幅当作流量降幅上报。触发条件是转述二手结论时没有核对原始口径。后果是预测系统性失真,而且失真方向不确定,可能高估也可能低估。处理方式:任何要写进汇报的数字,都先查看它的原始定义。
坑二,用全球平均值预测单一市场。美国桌面数据推不出东南亚移动端的情况,做出海的团队尤其容易在这里出错。处理方式:明确标注适用范围,宁可写“缺该市场数据”,也不要拿一个不适用的数字充数。
坑三,把没有分母的绝对数当作利好。看到“数十亿次点击”就放心,和看到降幅就恐慌,是同一个错误的两面。处理方式:遇到任何绝对数,先问分母和基期,两者都没有就不予采信。
坑四,中途更换提示词池。这是自证口径里最隐蔽的自欺。曲线不好看就换一批词,换完曲线变好看了,但这条曲线已经不代表任何东西。处理方式:把提示词池当作合同管理,需要修改时重新起算基线并留档说明。
坑五,混用三层读数。用第三层的定性观察回答第一层的定量问题,或者反过来。处理方式:汇报时明确标注每个数字来自哪一层、置信度如何。老板能接受数据有不确定性,难以接受的是把不确定的东西讲得很确定,结果下个季度被现实推翻。
AI搜索替代流量这件事,最终该怎么判断?
替代正在发生,这一点已无需争论,机制层的证据足够扎实:同一个信息需求走AI路径,流向外部网站的概率只有传统搜索的零头,这是结构性的变化。
但幅度无法得知,而且大概率会长期无法得知。平台没有动力公布能让你算出自己那一份的数据,学术研究受限于样本和时滞,工具受限于外推链条。如果你在等一个权威数字告诉你该紧张到什么程度,这个数字不会出现。
能做的是换一个问题:不问“行业跌了多少”,改问“我的哪一类页面在掉、掉的是不是值钱的那部分、我手上有没有一条能自己解释的曲线”。这个问题有答案,答案就在你自己的后台里,今天就可以开始拉数据。
“每周数十亿次点击”的原帖是怎么说的?
这个说法出自Google负责知识与信息的高级副总裁Nick Fox在2026年7月17日发布的一条领英帖子。行业媒体转发时大多只截取了一句,丢掉了上下文,而上下文恰恰是关键。
原帖里相关的一段是:
Actually, as we've shared before, we continue to send billions of clicks to the web every day through Search. And we've designed our AI features in Search to connect people to websites. In fact, we're now sending billions of clicks to websites every week through AI features in Search alone – and we're just getting started.
仔细读这段会发现,里面并排放了两个数字,而且两者含义不同。
每天与每周两个点击数字,为什么不能放在一起读?
拆开来看:
- 每天数十亿次:指整个Search,包含所有传统搜索结果的点击;
- 每周数十亿次:指AI功能单独贡献的点击。
这两个数字分母不同,时间单位也不同,却被放在紧挨着的两句话里。读的时候不留意,脑子里留下的就是一个笼统的印象:“Google送出了很多点击”。而这种印象,正是这种写法不费力气就能留下的效果。
更值得算的是量级关系。如果每天是数十亿、每周也是数十亿,按最简单的口径推算,AI功能贡献的部分大致相当于整体的七分之一上下。前提是两个“数十亿”取值接近,而这个前提无法验证。
这里要记住的是一个读法:一段话里出现两个同样模糊的大数时,先看它们的分母和单位是否一致。如果不一致,任何把两者连起来得出的结论,都是读者自己的推测,不是发布方的说法。
同日另一平台的版本,为什么删掉了每日点击那句?
有个细节值得一提。同一天晚些时候,这位高管在另一个社交平台也发了一版,内容大体一致,但删掉了“每天数十亿次”那一句,只保留了AI功能每周数十亿次那句。
这谈不上阴谋,更可能只是不同平台的篇幅习惯。但它带来一个实际后果:在不同平台看到这条消息的人,拿到的信息量不一样。只看到删节版的人会以为“每周数十亿”是Google给出的唯一口径,完全不知道旁边还有一个更大、口径不同的数字。
这件事涉及引用习惯:转述平台高管的表态时,最好回到他最先发布的版本,不要随手引用自己正好刷到的那一版。同一个人、同一天、同一件事,措辞可能不同。
英文里的billions,实际能指多大的区间?
还有一层模糊性藏在这个词本身。
英文里的billions,下界是20亿,没有上界:20亿可以叫billions,9000亿也可以叫billions。两个取值相差450倍。
因此,这个表述从一开始就不具备可证伪性。你没法说它错,因为它没有给出任何可以检验的具体值;你也没法用它做测算,因为代入下界和上界,结论可以相差两个数量级。
这么说并非挑字眼。无法被证伪的表述不承担任何信息义务,它的作用在于塑造印象,而非传递事实。认清这一点,再看到平台方给出的“数以亿计”“大幅提升”“显著改善”之类说法,就知道该放在哪一档来读。
“每天数十亿次点击”的说法最早出自哪里?
“每天数十亿次点击”并不是这次才有的说法,帖子里那句as we've shared before也表明这是旧话重提。它的正式出处是Google搜索负责人Liz Reid在2025年8月发布的一篇官方博文。
那篇文章的原话是:
We continue to send billions of clicks to websites every day and believe that Search's value exchange with the web remains strong.
同一篇里还有一个更关键的主张,针对的是趋势而非绝对值:
Overall, total organic click volume from Google Search to websites has been relatively stable year-over-year.
注意这句的口径:总量、同比、相对稳定。它没有说增长,说的是稳定。三个限定词各自都在缩小这句话的适用范围。
批评第三方方法论的Google博文,自己披露了多少方法论?
这是整件事里最值得单独拿出来看的一处。
那篇官方博文在给出自身数据的同时,明确批评了第三方研究:
This data is in contrast to third-party reports that inaccurately suggest dramatic declines in aggregate traffic — often based on flawed methodologies, isolated examples, or traffic changes that occurred prior to the roll out of AI features in Search.
方法论有缺陷、样本孤立、时间窗口错位,这三条批评本身都有道理,前面分析第三方研究时也能看到类似问题。
反差在后面:这篇批评别人方法论有缺陷的文章,自己没有披露任何方法论。没有绝对数值、没有样本量、没有地域范围、没有统计窗口,也没有说明“相对稳定”的容差:下降5%算稳定吗,下降15%算吗?全文没有一个可以被外部审计的数据点。
这并不等于说Google在撒谎,它大概率没有撒谎的必要。问题在于证据等级:一方给出了可检查的方法论和可被指出的缺陷,另一方给出的是无法检查的结论。第三方研究的方法论能被批评,恰恰因为它们公开了方法论。
这个读法可以直接用在别处:一份材料同时批评别人的方法论、又给出自己的结论时,先看它有没有为自己的结论提供同等标准的方法论。如果没有,这就属于公关表态,算不上学术争论。
“高质量点击”指标由谁定义、怎么测量?
同一篇博文里还有一个更需要警惕的说法,它听起来最像数据,实际上最不像。
原文是这样定义的:
Additionally, average click quality has increased and we're actually sending slightly more quality clicks to websites than a year ago (by quality clicks, we mean those where users don't quickly click back — typically a signal that a user is interested in the website).
随之而来的是三个问题。
第一,这是个自造指标。“高质量点击”不是行业通用定义,而是Google在这句话里临时给出的定义。自己定义指标、自己测量、自己宣布指标上升,整个链条中没有任何一环允许外部介入。
第二,判据只有一条行为信号:用户没有很快点返回。多快算“很快”?三秒、十秒还是三十秒?阈值没有公布,而这个阈值直接决定了指标的取值。
第三,测量面板没有公布。在什么样本上测的、覆盖哪些地区和设备,都没有说明。
再加上“slightly”(略微)一词,这句话的实际信息量接近于零:一个自己定义、阈值未公开的指标,在未披露的样本上,略微上升了。这句话没有错,但也什么都没说。
Google承认的流量重新分配,为什么比总量争论更值得记住?
争论总量的时候,很容易漏掉官方在同一篇文章里主动承认的一件事。原话是:
While overall traffic to sites is relatively stable, the web is vast, and user trends are shifting traffic to different sites, resulting in decreased traffic to some sites and increased traffic to others.
意思是:总量大体稳定,但流量在站与站之间重新分配,有些站少了,有些站多了。
这句话的分量比表面上重得多。它等于官方亲口承认:“行业总量稳定”和“你的站流量下降”可以同时成立,两者并不矛盾。
于是,“AI到底有没有吃掉流量”的争论在决策层面失去了意义。无论总量稳定还是下滑,都推不出你自己站的走向,这正是本文一直在讲的问题。该问的是“我的哪些页面在被替代、替代到什么程度”,而非“行业掉了多少”。
这句话也解释了为什么平台方和站长的感受差距那么大。平台看的是整个池子,你看的是自己那一瓢。池子水位没变,不代表你那一瓢没被舀走。
流传的68%零点击率,研究样本经得起推敲吗?
争论的另一方,被引用最多的是零点击比例。这个数字的准确值是68.01%,并非常见转述里的整数68%,出自SparkToro的Rand Fishkin。
先分清三方角色,这里最容易张冠李戴:SparkToro是分析方和发布方,Similarweb只是提供点击流面板数据的一方,2024年的对比数据来自Datos,更早的历史数据来自已经停运的Jumpshot。把它称为“Similarweb的研究”并不准确。
研究口径是2026年1月至4月、仅限美国。这份研究值得肯定的是主动披露了缺陷,其中一条很关键:
This data is not inclusive of the Google mobile search application, but rather mobile searches within the browser.
即不含Google的移动搜索应用,只统计浏览器内的搜索。作者判断应用内的零点击特征只会更强,所以真实零点击率很可能高于68.01%。这是一处诚实的自我披露,值得记下。
但它也有硬伤:通篇没有披露样本量,只说明数据源是Similarweb的桌面与移动点击流面板,没有给出面板规模、用户数或搜索次数。另外,跨年对比换过数据提供方,作者原话是these aren't the same users or devices,所以那条历史趋势线只能看方向,不能当作精确数列引用。
“AI概览让点击降42%”的说法是怎么被传错的?
这条说法流传极广,而且被传成了因果结论:“AI概览让点击掉了42%”。回到原报告看,这个转述至少错了两层。
原文的表述是:
Compared to the pre-AIO average, organic search in Q4 2025 is down -42%.
第一层错在因果。原文说的是“与AI概览上线前的均值相比,2025年第四季度的自然搜索下降了42%”。这是前后对比,没有对AI概览做因果隔离,也无法证明这42%由AI概览造成。
第二层错在范围。这份数据的样本是一家数字媒体服务商旗下的新闻出版客户组合,属于单一垂类。新闻类内容对AI概览的敏感度明显高于电商、B2B和本地服务,把这个数字外推到全网毫无依据。
还有一个更严重的问题:它的基线是2023年第一季度到2024年第一季度的均值,对比期是2025年第四季度,跨度接近三年。这期间发生了几轮核心算法更新、社交平台去链接化、新闻消费习惯向短视频和推送迁移、内容分发产品的权重调整,这些影响全部被算到了AI概览头上。
需要说明的是,这份数据本身是真实的,取自他们自己的搜索后台。站不住的是那个因果命题,数字本身没有问题。所以正确的引用措辞是“某新闻出版组合在这段时间里自然搜索下降了42%”,而不是“AI概览让点击降了42%”。
这几份AI点击材料里,哪一份的研究设计最扎实?
把上面几份材料放在一起,会得到一个有些讽刺的结果:被引用最多的两份,设计上都不是最扎实的;设计最扎实的那份,传播得最少。
这份研究是皮尤研究中心2025年7月发布的调查。核心结论是:
- 遇到AI摘要的用户,在8%的访问里点击了传统搜索结果;
- 没遇到AI摘要的用户,点击比例是15%,接近前者的两倍。
它更扎实的原因是:这是几份材料里唯一设有对照组的。同一批人、同一个时间窗,按是否遇到AI摘要自然分成两组比较,而不是拿今年和三年前比。方法是在900名美国成年人的设备上安装追踪应用,采集2025年3月的全部访问记录;研究期内18%的搜索出现了AI摘要,58%的受访者至少遇到过一次。研究机构本身在结论上也没有商业利益。
它的局限同样要讲清楚:样本偏小、只覆盖一个月、只限美国,而且数据来自2025年3月,放到现在已经偏旧。
这五个搜索流量数字放在一张表上,各自能回答什么?
| 数字 | 发布方 | 有无对照组 | 能回答的问题 | 不能回答的问题 |
|---|---|---|---|---|
| 每周数十亿次AI点击 | 无 | 基本什么都回答不了 | 无分母、无方法论、量级开区间 | |
| 总量同比相对稳定 | 无 | 官方对行业总量的定性判断 | 不可外部审计,且官方自承流量在重新分配 | |
| 68.01%零点击 | SparkToro | 无 | 美国浏览器端搜索有多大比例不产生点击 | 样本量未披露,不含移动应用,跨年换过面板 |
| 自然搜索降42% | 某数字媒体服务商 | 无 | 一个新闻出版组合近三年的流量变化 | 不能归因给AI概览,不能外推到其他行业 |
| 8%对15% | 皮尤研究中心 | 有 | 同期人群中,AI摘要是否降低点击倾向 | 样本小、仅一个月、仅美国、数据偏旧 |
这张表最该记住的是最后一列。每个数字都有能回答的问题,也都有回答不了的问题,而传播中被丢掉的总是后者。
回到开头的问题:这几个数字里,有没有哪个能算到你自己站上?一个也没有。但它们合起来说明了一件事:连最有动机讲清楚的那一方都拿不出可审计的分母,就不要指望有人能替你算这笔账。自建口径没有捷径。
常见问题解答
AI搜索到底让网站流量掉了多少?
目前没有可靠的行业数字,而且大概率长期不会有。公开研究测的多是查询量变化,而非网站流量变化,覆盖范围也常限于特定市场和特定设备;平台方公布的是没有分母、没有基期的绝对量;第三方工具的数字建立在自设提示词池的外推之上。这三类数字都能说明替代正在发生,但都无法推导到你的站。可行的做法是建立自己的读数:按页面类型拆分展现与点击趋势,重点看展现上涨、点击下降的剪刀差。
查询量下降9.4%,是不是意味着我的流量要掉9.4%?
不是。这两个指标测的是不同的东西:查询量下降指人少搜了几次,至于那些少掉的搜索原本会不会点进你的站、点进来有没有价值,数据没有回答。更值得关注的是同一研究里的另一组数字:AI对话产生对外点击的比例约5.2%,传统搜索约31.1%。这意味着一个需求场景整体转移到AI后,流向外部网站的概率大约只有原来的六分之一,这是结构变化,不是打折。
为什么Google不公布AI搜索的点击占比?
有两个现实原因。一是点击的绝对量和占比属于核心商业数据,公开完整口径等于亮出广告业务的底牌。二是产品形态在持续变化,AI相关形态的数据目前按搜索类型合并进现有报告,没有单独拆分,公布一个几个月后就会失效的口径,对平台没有好处。所以这种数据缺失是结构性的,并非暂时的信息滞后,等官方给出能让你算出自己那一份的数据,等不到。
在Search Console里能看到AI带来的流量吗?
看不到单独的那一份。AI相关形态的数据合并计入现有报告,你读到的是合并后的结果。能读出的是另一件更有用的事:把页面按类型分组后,哪一类展现量还在、点击量却在下降。这个剪刀差说明内容仍被检索到,只是用户不再需要点进来。它比任何行业百分比都更贴近你的真实处境。
可见度监控工具的数字能信吗?
取决于用法。用来做纵向对比是可靠的:固定提示词池、固定引擎组合、固定频率,看自己的曲线走向。用来做绝对值判断就不可靠:说自己在AI里占多少份额,这个数字的置信区间大到没有决策价值。最需要警惕的是中途更换提示词池,换完曲线会变好看,但已经不代表任何东西。
哪类页面最先被AI替代?
替代压力从高到低大致是:名词解释和概念定义类最高,因为答案短、无歧义,一句话就能给完;通用型操作步骤次之,因为步骤能被完整复述;横向对比和选型居中,AI能列表格但列不出真实使用体验;带地域和资质的服务页较低;交易和产品页最低,因为最终必须落到某个具体商家。问题在于,压力最高的两类,往往正是过去几年被当作流量主力来做的类型。
在数字不确定的情况下,现在做什么不会后悔?
有四个动作在任何一种未来里都成立:把可被复述的内容改造成不可复述的(加版本差异、报错处理、一手实测);把实体信息和第三方佐证做扎实;先建立测量口径,成本低且价值随时间增长;把渠道结构分散一档,不让单一渠道占到七成以上。反过来,有两件事应该放缓:为追不确定的趋势大规模重写老内容,以及在没有自己基线之前采购昂贵的监控工具。
怎么向只看数字的老板解释这件事?
不要去争行业数字准不准,这场辩论赢不了。换一种讲法:先承认总量幅度无法得知并说明原因(平台不公布分母、研究样本有限),再把自己站的三条曲线摆出来,即分类型的点击趋势、展现与点击的剪刀差、AI引荐流量的转化率。最后把结论落到资源配置上:哪类页面不再追求点击,哪类页面追加投入。老板需要的是投向哪里的依据,而不是精确到小数点的预测。
权威参考资料
本文标题:《AI搜索流量下降幅度:三类行业数字的口径边界与自证方法》
本文链接:https://zhangwenbao.com/ai-search-traffic-decline-numbers-unverifiable.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0