LSI关键词是真的吗?解析被误传十几年的SEO伪概念
本文目录
- LSI关键词是真实存在的排名要素吗?
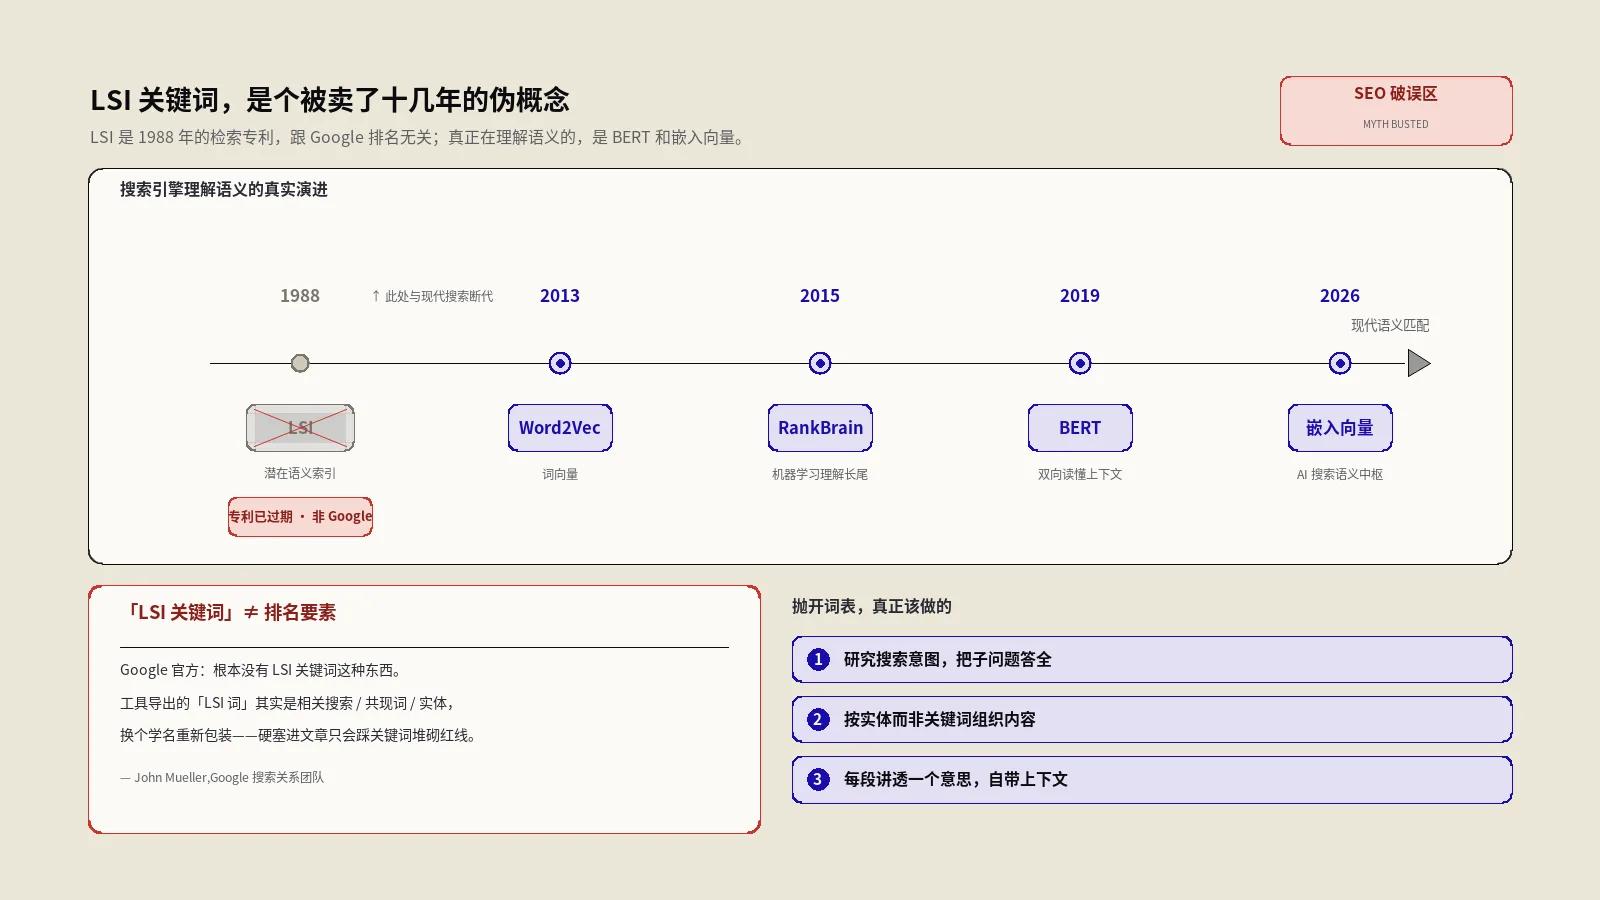
- LSI潜在语义索引的来历:1988年的一份信息检索专利
- “LSI关键词”这个说法为什么在技术上不成立?
- Google官方如何回应LSI关键词?
- Google网页搜索为什么用不了LSI技术?
- 从同义词系统到BERT,Google靠什么理解语义?
- BERT神经匹配和凑LSI关键词有什么区别?
- LSI与BERT、嵌入向量的关键差异对比
- AI搜索的嵌入向量匹配为什么让语义覆盖更重要?
- LSI关键词误区是怎样形成并延续的?
- LSI关键词工具导出的词实际是什么?
- 哪些SEO概念常被误当成LSI关键词?
- 按LSI词表硬塞词,为什么会被判为关键词堆砌?
- 不用LSI关键词,语义覆盖该怎么落地?
- 外贸独立站案例:放弃LSI词表后的语义覆盖改写
- 听到“LSI关键词”时应该警惕什么?
- 常见问题解答
- LSI关键词到底存不存在?
- 既然LSI是假的,语义相关词还重要吗?
- LSI关键词工具导出的词能用吗?
- Google现在用什么理解内容语义?
- 为什么LSI关键词这个误区难以破除?
- 不凑LSI词,怎样做好语义覆盖?
- 权威参考资料
摘要:“LSI关键词”是SEO圈流传了十几年的伪概念。LSI(潜在语义索引)确实存在,它是1988年贝尔实验室为小型静态文献库做的一项信息检索专利,和Google给网页排名没有关系,Google官方也直接说过“根本没有LSI关键词”。有用的是“语义相关”本身,但Google靠的是同义词系统、RankBrain、BERT这套神经匹配,不靠某个能用工具一键导出的“LSI词表”。本文依次说明LSI的真实出身、这个误区如何形成、Google实际用什么理解语义,以及AI搜索时代怎样做语义覆盖。结论很简单:不必再花钱买“LSI关键词工具”。
LSI关键词是真实存在的排名要素吗?
经常有外贸独立站的朋友拿着某款工具导出的一长串“LSI关键词”来问保哥:这些词要不要都放进文章、放几次、密度多少合适。每次我都先说明一点:这串词本身可能有点用,但把它们叫作“LSI关键词”,从头到尾是错的。
明确地说,搜索引擎优化里没有“LSI关键词”这种排名要素。这个判断不是个人观点,Google自己反复讲过。你花钱买的“LSI关键词生成器”,做的事情是把“相关搜索”“人们还在问”“共现词”换了个学术化的名字重新包装,卖给不了解底细的人。弄清这一点,才能把精力从凑词转到真正影响排名和AI引用的地方。
本文不会只给一句“LSI是假的”。下面会逐项拆开:LSI这门技术实际是什么、它为什么和Google排名无关、Google实际用什么理解语义、这个误区如何被工具厂商制造出来,以及最关键的一点——去掉LSI这个错误标签后,“让内容语义更完整”该怎么落地。
LSI潜在语义索引的来历:1988年的一份信息检索专利
LSI的全称是Latent Semantic Indexing,即潜在语义索引,源自更早的LSA(Latent Semantic Analysis,潜在语义分析)。这项技术真实存在,来头也不小,只是它的出身和搜索引擎没有关系。
按照1988年那份编号US4839853A的原始专利,LSI由Scott Deerwester、Susan Dumais等研究者发明,申请人是贝尔通讯研究院(Bellcore),1988年9月提交、1989年6月获批。它的做法是把一批文档里“词—文档”的对应关系排成一个大矩阵,再用奇异值分解(SVD)降维,让经常出现在相似上下文里的词产生关联。这样即使用户查询用的词和文档里的词不完全一致,系统也能依据“潜在的语义结构”找出相关文档。
LSI要解决的是上世纪80年代信息检索的一个老问题:用户搜“汽车”,系统找不到只写了“轿车”的文档。这项发明很巧妙,在规模小、相对静态的文献库里(比如某个图书馆的几万篇论文)确实有效。维基百科关于潜在语义分析的词条对这段历史记录得很清楚:这项技术80年代末最早在Bellcore落地,之后用于各种检索和文本分析场景,自始至终和Google无关。
“LSI关键词”这个说法为什么在技术上不成立?
很多人没想明白的一点是:LSI是一种索引和检索的方法,它处理的是整个文档集合的统计结构,并不产出“一批LSI关键词”这样的东西。
可以这样理解:LSI相当于一套给整座图书馆重新编目的算法,分析的是全馆几万本书之间的关系。你无法指着其中一本书要“这本书的LSI词”,这个请求在技术上不成立,就像问“这盘菜的GDP是多少”。“LSI”和“关键词”拼在一起,是营销话术硬造出来的组合,原始论文和专利里都没有这个说法。
因此,当一款工具说“这是为你的目标词找到的20个LSI关键词”时,它做的事和LSI算法毫无关系。它多半只是抓取了Google搜索结果页底部的“相关搜索”、“大家还在搜”(People Also Ask),或者统计了排名靠前页面里反复出现的共现词,再贴上一个学术标签出售。词可能是真实的,名字是假的。
Google官方如何回应LSI关键词?
Google自己的说法很明确。Google搜索关系团队的John Mueller早在2019年7月就公开表示:“根本没有LSI关键词这种东西——任何告诉你有的人都搞错了,抱歉。”此后他换着说法重复过很多次,几年来口径没有变化。
这并非某位工程师随口一说。Ahrefs关于LSI关键词的专文归纳了Google无法使用LSI的几条硬理由,还补充了一个细节:LSI的专利2008年就已过期,而Google在专利过期前好多年就已经能理解同义词和近义概念。可见Google理解语义的能力和LSI这条技术路线在时间线上对不上,Google走的是另一条路。
Ahrefs文中还引用了一句行业评价:在已有Word2Vec这类现代词向量技术的情况下还去用LSI,“就像开着卡丁车去跟法拉利赛车”。这句话概括了LSI在今天搜索引擎语境里的位置:一件值得尊重的古董,但不是Google引擎盖下面那台发动机。
Google网页搜索为什么用不了LSI技术?
即使不看官方表态,从技术上推演一遍也能发现,LSI放到现代网页搜索上根本跑不动。问题主要在三处。
第一,规模不匹配。LSI的SVD矩阵分解是为几万、几十万篇文档设计的。今天Google索引的网页数以千亿计,对这么大的“词—文档”矩阵做奇异值分解,算力成本是天文数字,工程上不可行。
第二,更新方式不匹配。索引发生较大变化时,LSI的矩阵就要整体重新分解一次。网页却在时刻新增、改动、消失,实际运行的搜索引擎不可能每天把整个语义模型推倒重算。LSI是为“相对静止的文献库”设计的,不适合持续变化的互联网。
第三,能力不匹配。LSI依赖词的共现统计,无法理解语序和语境。“从巴西去美国的旅客需要签证”和“从美国去巴西的旅客需要签证”,在LSI看来用词几乎一样,含义却完全相反。现代搜索最看重的恰好是识别这类差别的能力。Google需要能读懂句子结构的工具,LSI做不到。
从同义词系统到BERT,Google靠什么理解语义?
否定LSI不等于否定语义。理解语义是现代搜索的核心,只是Google采用的是另一条技术路线,而且这条路线一直在升级。
最早是同义词系统和查询改写,让“轿车”和“汽车”可以互相对应。2015年前后RankBrain上线,开始用机器学习理解从未见过的长尾查询,Word2Vec这类词向量技术也在这一阶段投入实际使用:它把每个词映射成一串数字(向量),语义相近的词在向量空间里的距离也近。
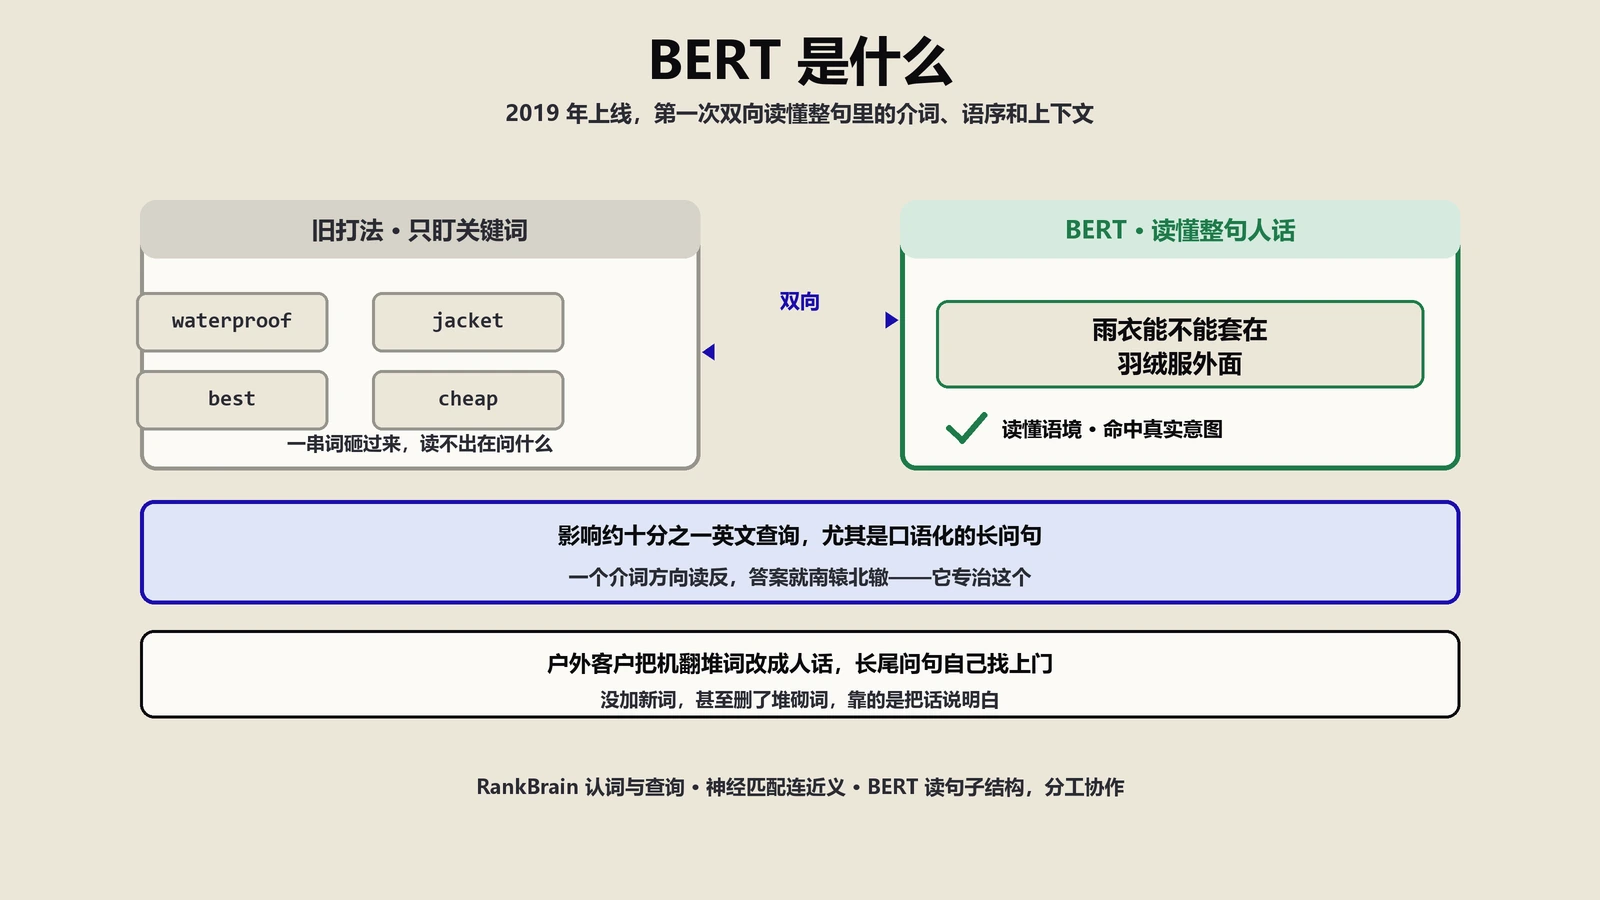
分水岭是2019年的BERT。按Google官方介绍BERT的那篇博客,BERT是搜索自RankBrain以来最大的一次升级,上线时就影响了约十分之一的英文查询。它的特点是“双向”:它同时看一个词前后的所有词,从完整上下文判断这个词在句中的具体含义,而不是逐词顺序读取。前面“巴西去美国还是美国去巴西”的例子,BERT这类模型能处理,LSI处理不了。
想了解更底层的原理,可以读 BERT的原始论文。论文说明,机器理解语义依靠的是Transformer深度神经网络架构和海量文本预训练,和80年代的矩阵分解是完全不同的技术。把两者混为一谈,就像把算盘和超级计算机当成同一类东西。
BERT神经匹配和凑LSI关键词有什么区别?
很多人在这里犯了一个推理错误:听说“Google现在理解语义、关心相关词”,就推出“所以要在文章里多放语义相关词”。前半句成立,后半句错得离谱。
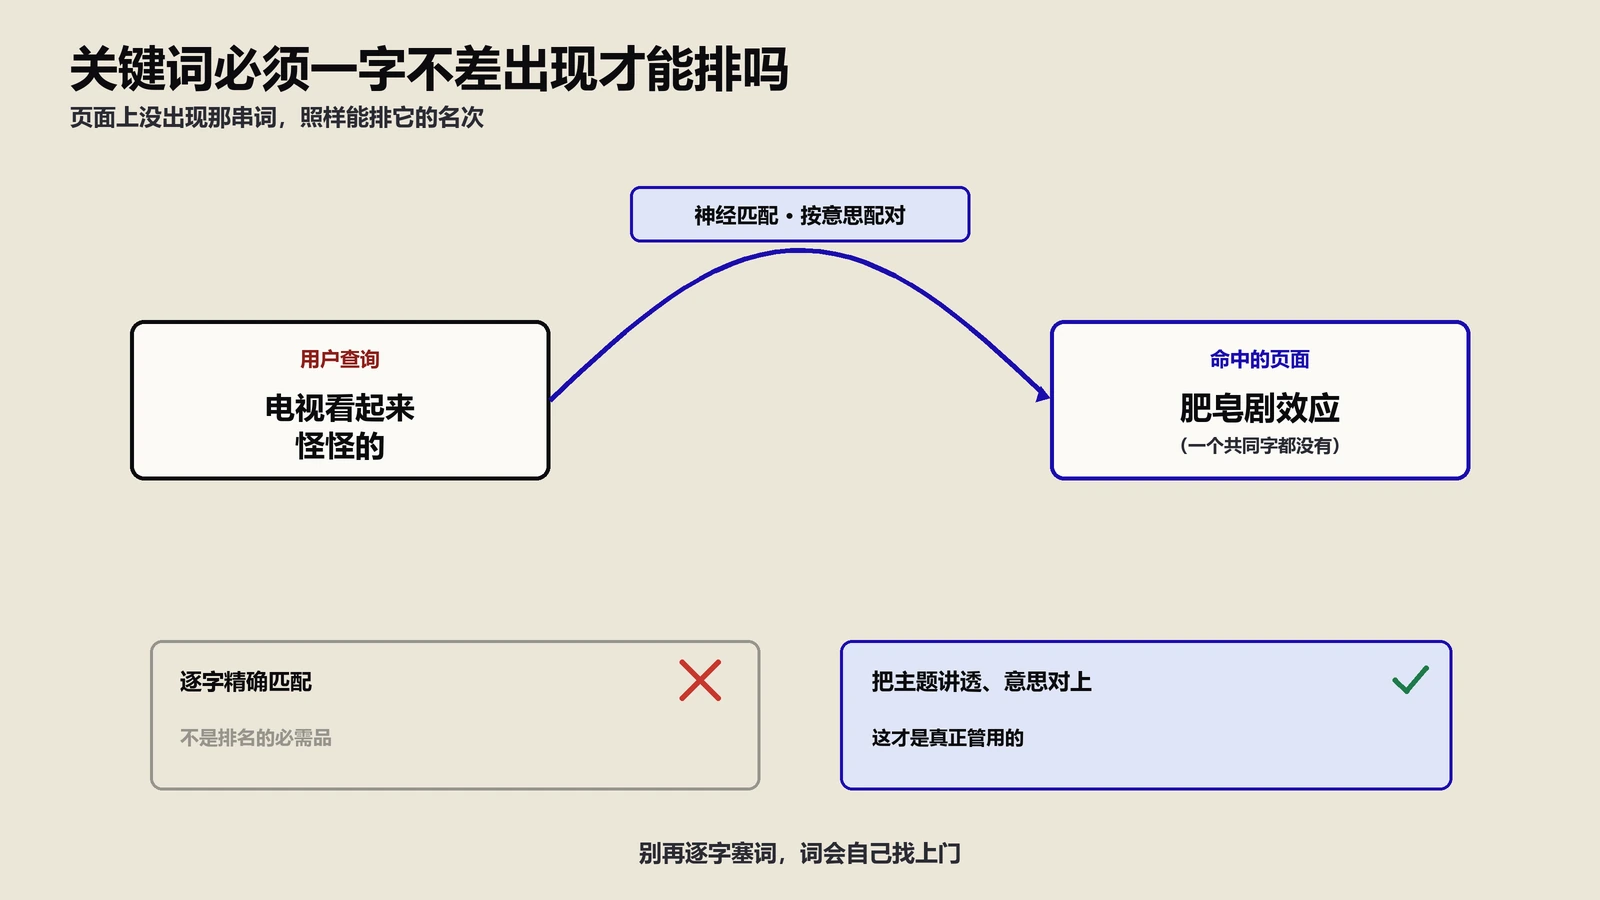
Google用BERT和神经匹配理解语义,目的是更准确地判断用户的查询意图,以及你这一整篇内容讲的是什么。它评估的是整体话题覆盖和上下文连贯性,不会去数你的文章里是否出现了某几个特定的“魔法词”。硬塞十个所谓的LSI词进去,模型不会因此认为这篇更相关,因为它读的是意思,不是词频清单。
反过来,认真把一个话题讲全、覆盖读者真正关心的子问题,相关词会自然出现在该出现的位置。顺序是先有完整的内容,再有相关的词;先凑齐相关词并不能换来完整的内容。一旦把因果关系颠倒,写作就会变成为机器写、而不是为人写。
LSI与BERT、嵌入向量的关键差异对比
仅凭文字说明不够直观,下表把两者的关键差异并列对照。看完这张表,基本就不会再把凑LSI词当回事了。
| 维度 | LSI(潜在语义索引) | BERT / 嵌入向量(Google与AI搜索现用) |
|---|---|---|
| 诞生年代 | 1988年,贝尔实验室的信息检索专利 | 2019年(BERT),AI搜索的嵌入向量更晚 |
| 底层数学 | 词—文档矩阵做奇异值分解(SVD)降维 | Transformer深度神经网络,海量文本预训练 |
| 适用规模 | 几万到几十万篇的静态文献库 | 数千亿网页,持续动态更新 |
| 能否读懂语序 | 不能,只看词的共现统计 | 能,双向看一个词前后的完整上下文 |
| 更新方式 | 索引大改就要整体重算矩阵 | 模型预训练好后增量服务,不需推倒重来 |
| 对内容人的含义 | 无所谓“LSI词表”,这个产物不存在 | 把话题讲完整、每段讲透,语义自然达标 |
重点看最后一行:LSI一栏没有任何“给内容创作者的待办事项”,因为它从来不是写作工具,而是一套图书馆级别的检索算法。现代技术一栏给出的要求也不是塞词,而是把意思讲清楚。两栏都推导不出“应该买一张LSI词表往文章里填”的结论。
AI搜索的嵌入向量匹配为什么让语义覆盖更重要?
到了2026年,语义覆盖的影响更大了,但这和LSI毫无关系。AI搜索和GEO(生成式引擎优化)背后是一套比BERT更彻底的语义机制:嵌入向量(embeddings)。
AI概览、ChatGPT、Perplexity在检索资料时,都会把内容切成一段段、转成高维向量,再用用户问题的向量做相似度匹配。保哥在内容分块优化那篇里专门分析过这套机制:一段内容会不会被AI引用,取决于它在语义向量空间里和问题的距离,而不取决于字面上堆了多少关键词。
此外,AI搜索还会把一个问题拆成多路子查询同时检索,即查询扇出,因此它评估的语义范围比传统搜索更宽。在这种环境下,凑LSI词不但没用,而且显得荒唐:你在为一个网页排名里并不存在的1988年算法做优化,而实际起裁判作用的是嵌入向量和大语言模型。与其纠结词表,不如确保每一段都把一个意思讲清楚、讲完整。
LSI关键词误区是怎样形成并延续的?
官方否认、技术上也站不住,“LSI关键词”为什么还能在SEO圈流传这么多年,至今还有人相信?主要有三方面原因。
第一是工具厂商。早年一批关键词工具直接推出了“LSI关键词生成器”功能,这个名字显得专业、有技术含量,比“相关词推荐”更能吸引用户。功能做进产品、写进定价页之后,这个错误标签就有了商业惯性,厂商不愿承认自己核心功能的名字是错的。
第二是内容农场相互抄袭。一篇讲“LSI关键词”的文章排上去后,大量文章跟着照写“如何使用LSI关键词提升排名”,错误在搜索结果里反复强化,形成自我循环。搜“LSI关键词”,满屏都是教你怎么用它的文章,读者自然会以为它真实存在。
第三是它“听起来很对”。语义相关确实重要,Google也确实在理解语义,这些都是事实,于是“用LSI关键词覆盖语义”这个推论显得顺理成章。这类误区难破,原因往往在于它并非全错,而是包着一层正确的外壳。SEO圈这类“听起来很对”的伪命题,关键词策略演变那篇里也讨论过:旧公式失效后,这类似是而非的说法反而更容易流行。
LSI关键词工具导出的词实际是什么?
这些工具导出的词并非毫无价值,只是它们的真实身份不是“LSI关键词”。搞清楚它们来自哪里,才知道该怎么用。常见的有以下几类:
- 相关搜索与“大家还在搜”:直接来自Google结果页底部和PAA框,反映真实用户围绕这个话题还在问什么,这部分价值最高。
- 排名页共现词:统计排名靠前的页面里高频出现、而你没有写到的词。它能提示话题盲区,但需要注意:别人写了不代表你必须写,照搬也不代表就能排上去。
- 同义词与变体:同一个意思的不同说法,写作时自然替换能让行文更顺,但这和“塞进去提升排名”是两回事。
- 实体与关联概念:和主题相关的人、品牌、产品、地点。这部分对应Google知识图谱的实体理解,价值不小,但要求真实相关,不能硬蹭。
这四类数据本身都有用,正确用法是帮你判断话题覆盖是否完整,而不是当作一张必须填满的词表。名字和用法不同,同一份数据的价值差别很大。
哪些SEO概念常被误当成LSI关键词?
“LSI关键词”容易让人相信,还因为它周围有一圈听起来相近、实际各不相同的概念。分清这几个概念,就不容易被话术误导。
TF-IDF。这是一个真实存在、历史也不短的统计方法,用来衡量一个词在某篇文档里相对于整个文档集合的区分度。有些工具会拿TF-IDF算出的词冒充“LSI关键词”。但TF-IDF只是词频权重统计,和LSI是两种不同的技术;而且Google早已不靠这种简单词频判断相关性,拿它指导写作同样是刻舟求剑。
关键词密度。“目标词占全文百分之多少最理想”曾是SEO圈的热门话题,至今仍有工具计算密度、提示“密度偏低请增加”。这项指标和LSI一样早该淘汰。Google这些年反复强调,不存在理想的关键词密度,自然写作即可,刻意追求某个百分比只会让文字变形。
共现词与搭配词。这个概念确实有用:讨论同一话题时,某些词天然会一起出现,比如讲“海运”自然会提到“提单”“集装箱”“船期”。统计排名靠前页面的高频共现词,可以帮你查漏补缺。但它的价值在于提示话题盲区,不应当成一张必须填的词表,更不该叫“LSI关键词”。
实体与知识图谱。这是四个概念里最接近现代正确做法的一个。Google用知识图谱理解人、地点、品牌、产品等实体之间的真实关系,围绕实体把内容讲全,确实有助于排名和被AI引用。但实体理解依靠的是神经网络和知识图谱,和LSI的矩阵分解毫无关系,借LSI的名义讲实体属于张冠李戴。
把这四个概念放在一起,可以看出一个规律:真正有用的(共现词、实体),正确用法都是判断话题覆盖是否完整;被包装成“LSI关键词”出售的,几乎都在把你引回按表填词的老路。识别这类话术,就看它最终要求你答好问题,还是凑够词数。
按LSI词表硬塞词,为什么会被判为关键词堆砌?
更大的风险在于,有人真的按工具给的词表把几十个词硬塞进文章,还称之为“提升语义相关性”。这种做法的实际后果是触碰关键词堆砌的红线。
Google搜索中心的垃圾内容政策对关键词堆砌的定义很明确:往页面里填塞关键词或数字以操纵排名即属违规,尤其是“成串、成组、不自然或脱离上下文”地堆砌词语,是Google明确点名的问题模式。把一张“LSI词表”逐条塞进段落,读起来生硬别扭,正是这条政策针对的对象。本想迎合算法,结果落进了处罚清单,怎么算都不划算。
有一个简单实用的判断方法:把这段话念给一个不懂SEO的同事听,如果对方皱眉说“这写的是什么,怎么反复绕圈子”,那就是在堆词,无论你把这些词叫作什么。
不用LSI关键词,语义覆盖该怎么落地?
让内容语义更完整,这个目标本身没错,只是落地方式和凑词表正好相反:应围绕意图和实体来组织内容,而不是围绕词。
先吃透搜索意图。动笔前先搜一下目标词,看排名靠前的是哪类页面:教程、对比、清单还是产品页。结果页底部的“相关搜索”和PAA框,就是用户围绕这个话题实际在问的子问题清单。把这些子问题尽量在文章里答到位,语义覆盖自然完整,比任何工具导出的词表都可靠。
按实体而不是按关键词组织内容。一篇讲“跨境物流”的文章,自然会涉及报关、清关、海运、空运、尾程派送、关税等实体和概念。正确做法不是查LSI词再塞进去,而是顺着这个话题应有的知识结构,把相关实体讲清楚。Google的知识图谱识别的是实体之间的真实关系,这条路和让内容被AI引用是相通的,主题权威与实体证据那篇里有更详细的说明。
一段讲透一个意思。前面提到,AI搜索按段落切块做向量匹配。因此,与其在全文分散铺关键词,不如保证每一段都集中回答一个具体子问题,并带有足够的上下文。一段话能够独立成立、把一件事说清楚,被传统搜索命中和被AI引用的概率都会更高。
先写给人看,再让机器顺带读懂。这是最根本的一条。把读者真正关心的问题答全、答透,并提供新的信息,所谓的“语义相关词”会自然出现,不需要拿着清单逐项对照。这个顺序不能颠倒。
外贸独立站案例:放弃LSI词表后的语义覆盖改写
保哥手上有个做户外储能产品的独立站客户,早年在“LSI词表”上吃过亏。当时负责内容的写手买了某款工具,给每篇产品文章配了二三十个“LSI关键词”,要求逐个用上。结果文章里“便携储能”“户外电源”“移动电站”“应急电源”几个近义词来回堆叠,一段里能出现五六次,读起来反复重复,跳出率一直降不下来,排名也没有上升。
后来我们彻底换了思路。不再参照词表,而是拆解用户围绕“户外储能”实际会问的子问题:容量怎么选、能不能带上飞机、能给哪些设备供电、低温下衰减多少、循环寿命多少次、怎么和太阳能板搭配。每个子问题单独成段、讲到位,配上真实的参数和使用场景。改完之后,这些近义词出现得反而更自然,因为讲不同子问题时本来就会用到不同说法,无需刻意凑。三个多月后,这批页面的长尾覆盖明显变宽,停留时间增加了一截,还开始零星出现在AI概览的引用里。
过程中有个细节。那位写手起初很抵触,认为不按词表写心里没底,担心漏掉哪个“关键的LSI词”导致排名上不去。我让他做了个小实验:挑两篇旧文,一篇按老办法把词表填满,一篇只把用户的子问题答清楚,三个月后对比后台数据。结果很清楚:按问题答全的那篇,长尾关键词覆盖反而更宽,因为认真讲不同子问题时,自然会用到各种说法和相关实体,并非刻意凑出来的;填词表的那篇,词是齐了,读起来生硬,停留时间明显短一截。
这个实验比任何解释都有说服力,他此后再没提过“LSI词”。这个案例的关键不在数字,而在做法的转变:从“把词填满”变成“把问题答全”。前者是在为一个不存在的算法白费力气,后者是在服务真实用户、适配真实的搜索机制。转变之后,写作反而更轻松,不必对着词表反复数密度,只需回到最基本的问题:读者搜这个词想知道什么,我是否答清楚了。
听到“LSI关键词”时应该警惕什么?
下次再有人——无论是工具的营销页、外包写手,还是某位所谓的SEO“大神”——跟你谈“LSI关键词”,你应该立刻提高警惕。这不代表对方一定在骗人,而是提示你:这个人对搜索引擎语义机制的认识,很可能还停留在多年前的二手信息上。
值得投入的从来不是某张能一键导出的“魔法词表”,而是这几件基础工作:研究透搜索意图,围绕实体把话题讲完整,让每一段都能独立成立、信息密度足够,先服务好真实读者。这些工作听起来不如“LSI关键词”四个字唬人,但它们能让你在Google和AI搜索里都站得住。下次打开那张词表之前,先把目标词的相关搜索和PAA子问题列出来逐条答。
常见问题解答
LSI关键词到底存不存在?
作为“排名要素”或“可以导出的词表”,它不存在。LSI(潜在语义索引)这项技术本身是真实的,是1988年贝尔实验室的一项信息检索专利,但“LSI关键词”是后来工具厂商造出的营销说法,Google的John Mueller明确说过“根本没有LSI关键词这种东西”。
既然LSI是假的,语义相关词还重要吗?
重要,但背后的机制不是LSI。Google靠同义词系统、RankBrain、BERT这套神经匹配理解语义,AI搜索进一步用嵌入向量做相似度匹配。语义相关一直都重要,但它是把话题讲完整后的自然结果,不是对照词表往文章里塞词得来的。
LSI关键词工具导出的词能用吗?
能用,但要弄清它们的真实身份。这些词多半是相关搜索、“大家还在搜”、排名页共现词、同义词和关联实体。把它们当作检查话题覆盖是否全面的清单是合理的;如果当作必须逐个填进文章的硬指标,就会写出生硬的内容,触碰关键词堆砌的红线。
Google现在用什么理解内容语义?
主要是2019年上线的BERT,以及更早的RankBrain、查询改写和同义词系统。BERT能同时看一个词前后的上下文,判断它在整句话里的实际含义,这是LSI的词共现统计做不到的。到了AI搜索时代,嵌入向量和大语言模型成为新的语义处理核心。
为什么LSI关键词这个误区难以破除?
原因有三:一是工具厂商把它做成产品功能、写进定价页,形成了商业惯性;二是内容农场相互抄袭,让错误在搜索结果里反复强化;三是它包着一层正确的外壳,“语义相关确实重要”是真的,于是“用LSI词覆盖语义”这个错误推论显得顺理成章。半对半错的说法往往最难纠正。
不凑LSI词,怎样做好语义覆盖?
围绕意图和实体组织内容,而不是围绕词。先研究搜索意图,把“相关搜索”和PAA里用户实际在问的子问题答到位;按话题应有的实体和概念组织内容;保证每一段集中回答一个子问题并带有足够上下文;先写给人看,相关词会自然出现。这套做法对传统搜索和AI引用都适用。
权威参考资料
本文标题:《LSI关键词是真的吗?解析被误传十几年的SEO伪概念》
本文链接:https://zhangwenbao.com/lsi-keywords-myth-semantic-seo-truth.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0