BERT是什么?Google搜索语言理解模型的原理、分工与写作要求
本文目录
- BERT是什么样的语言理解模型?
- 户外装备英文页把话写通顺后,长尾流量为什么来了?
- BERT何时上线搜索,为什么说它影响约十分之一的查询?
- BERT的双向编码比单向语言模型强在哪里?
- BERT、RankBrain与神经匹配在Google搜索中如何分工?
- BERT与蜂鸟算法、MUM是什么关系?
- BERT能否被针对性优化或操纵?
- 怎样写内容才对BERT的语义理解友好?
- 外贸站与多语言站如何应对BERT的语言理解?
- 常见问题解答
- BERT是一个排名算法吗?
- BERT上线后,我需要重新做关键词研究吗?
- BERT只对英文有效吗?
- BERT和ChatGPT是一回事吗?
- BERT还在用吗,会不会被MUM淘汰?
- 我怎么知道自己的页面对BERT友好不友好?
- 权威参考资料
摘要:BERT是Google在2019年10月正式用于搜索的自然语言理解模型,它让机器第一次能双向读取一句话,结合介词、语序和上下文判断意思,官方称它影响了大约十分之一的英文搜索。BERT不给页面打分排名,它负责先弄清用户到底在问什么,所以针对它能做的,就是把话写通顺、写得像真人在说。文中还拆了它和RankBrain、神经匹配、蜂鸟、MUM的分工,以及外贸站和多语言站该怎么写。
前阵子有个做户外装备的客户来找我,说他的英文产品详情页怎么都排不上去。我打开页面一看,问题很明显:整页英文是机器翻译后再硬塞关键词拼出来的,读起来像喝多了在说绕口令。他觉得委屈,说该有的词都堆齐了。问题恰恰出在这里:他以为Google在数页面里写了几个词,实际上Google早就在判断这句话读不读得通。负责这件事的,就是本文要讲的BERT。
BERT是什么样的语言理解模型?
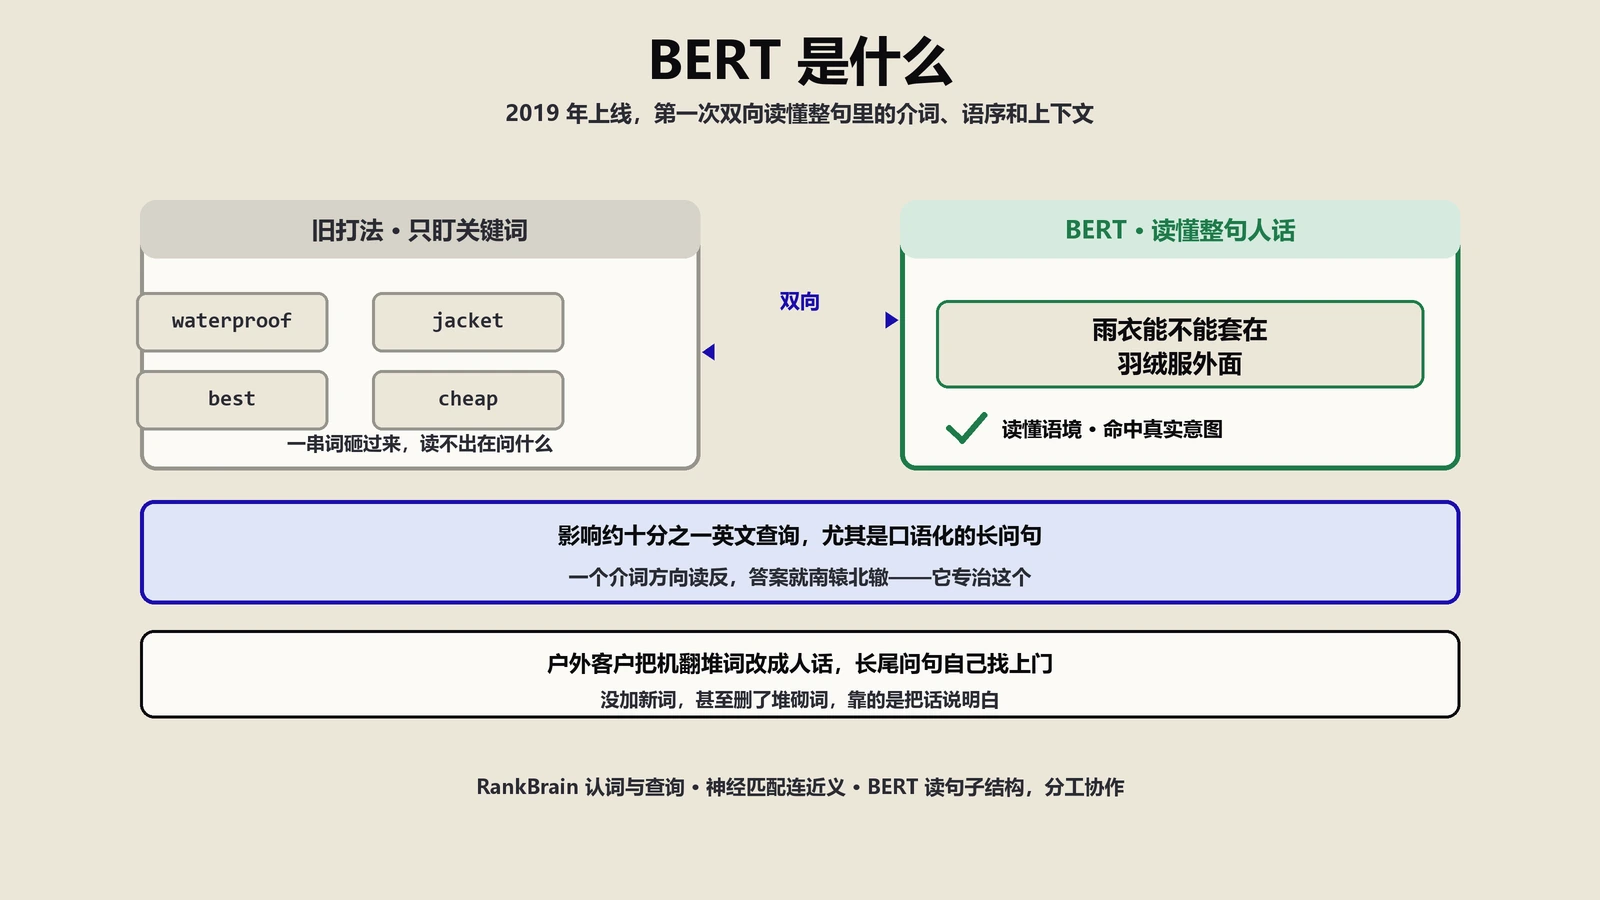
BERT是Google 2019年用到搜索里的语言理解模型,全称Bidirectional Encoder Representations from Transformers,中文可以译作基于Transformer的双向编码器。名字很长,核心能力只有一项:读一句话时,它不按从左到右的顺序逐词去猜,而是同时看一个词左右两侧的上下文,再判断这个词在当前句子里的含义。
举个例子,人听别人说话,只听前半句常常会理解偏。对方说“我把苹果放桌上了”,这个苹果是水果还是手机,要等整句甚至下一句说完、结合场景才能确定。BERT做的就是这类判断:它把查询里前后的词拿来互相印证,尤其是以前被搜索引擎当作噪音丢掉的小词,比如of、to、for、no这类介词和否定词。这些词经常决定一句话的意思。
Moz那篇讲 BERT在自然语言处理里到底扮演什么角色的科普文章里有个说法我认同:BERT让机器开始理解语言的细微差别,不再把一句话当成一袋无序的词。以前的搜索更接近关键词配对,现在多了一步:先读懂查询的语法结构,再去找匹配的答案。这一步看起来不大,落到结果上却能差出一大截。
户外装备英文页把话写通顺后,长尾流量为什么来了?
回到开头那个客户。他的旧页面里塞满了waterproof、jacket、best、cheap这类词,语法支离破碎。用户实际会搜的是“can you wear a rain jacket over a puffer”这种带完整语境的问句,关心的是外面套不套得下、怎么搭。旧页面里这些词都有,可是连不成通顺的句子,Google读不出页面在回答哪个具体问题。
我让他做的事很简单:清掉机翻痕迹,请母语者把每段改成正常人会说的英文,补齐该有的介词和连接词,把“防风外套能不能罩在羽绒服外面”这类真实场景逐句写清楚。没有加新词,还删掉了一批堆砌的关键词。三周后,那些长尾问句陆续开始带来流量。他问我是不是偷偷做了外链,我说没有,只是页面终于把话说明白了,BERT能读懂了。这就是我一直强调的写给人看,顺带就喂饱了机器。
改完之后,流量质量也变了。以前靠堆词勉强引来的访客,发现内容和需求对不上,很快就离开;现在进来的都是带着具体问题的人,停留时间长、咨询也更细,转化随之上升。意图匹配对上之后就会出现这样的连锁反应:BERT帮页面过滤掉了无效流量,把合适的用户送到了合适的页面。
BERT何时上线搜索,为什么说它影响约十分之一的查询?
2019年10月,Google搜索副总裁Pandu Nayak在那篇宣布BERT用于搜索的官方博客里说,这是过去五年里最大的一次飞跃,影响大约十分之一的英文查询。到2019年12月,BERT扩展到了七十多种语言。
为什么只影响十分之一,没有覆盖全部?因为短查询和导航类查询本身没有多少语境可读,搜一个品牌名,读不读语序结果都一样。BERT真正起作用的,是那些较长、口语化、带着一堆小词的复杂问句,而这正是用户越来越习惯的自然表达方式。
官方举过一个后来被反复引用的例子:查询“2019 brazil traveler to usa need a visa”。这里的关键是to:到底是巴西人去美国,还是美国人去巴西?以前搜索引擎会忽略这个to,给出方向相反的结果。BERT上线后,系统读懂了to指向的方向,返回的才是巴西公民赴美签证的信息。
另一个常被引用的例子是“do estheticians stand a lot at work”。过去stand会被理解成“忍受”,BERT上线后才明白这里问的是美容师上班是不是要一直站着。一个介词,或者一个多义动词,放在不同语境里意思可能完全不同,双向阅读的价值就体现在这里。
这些例子有个共同点:它们都是口语化的完整问句,不是几个孤立的关键词。这类自然语言搜索越来越普遍,BERT针对的正是这种场景。
BERT的双向编码比单向语言模型强在哪里?
这要从BERT之前的模型说起。过去很多语言模型是单向的,要么从左读到右,要么从右读到左,预测一个词时只能看到一侧的上下文。BERT的原始论文(Devlin等,2018)提出了遮盖语言模型的训练方法:随机遮住句子里的一部分词,让模型根据剩下的左右文猜出被遮住的词。这样训练,模型必须同时理解一个词的前后文,没法只看半边。
论文里还有一个叫“下一句预测”的任务,让模型学会判断两句话能不能前后衔接,这对理解整段逻辑很有帮助。
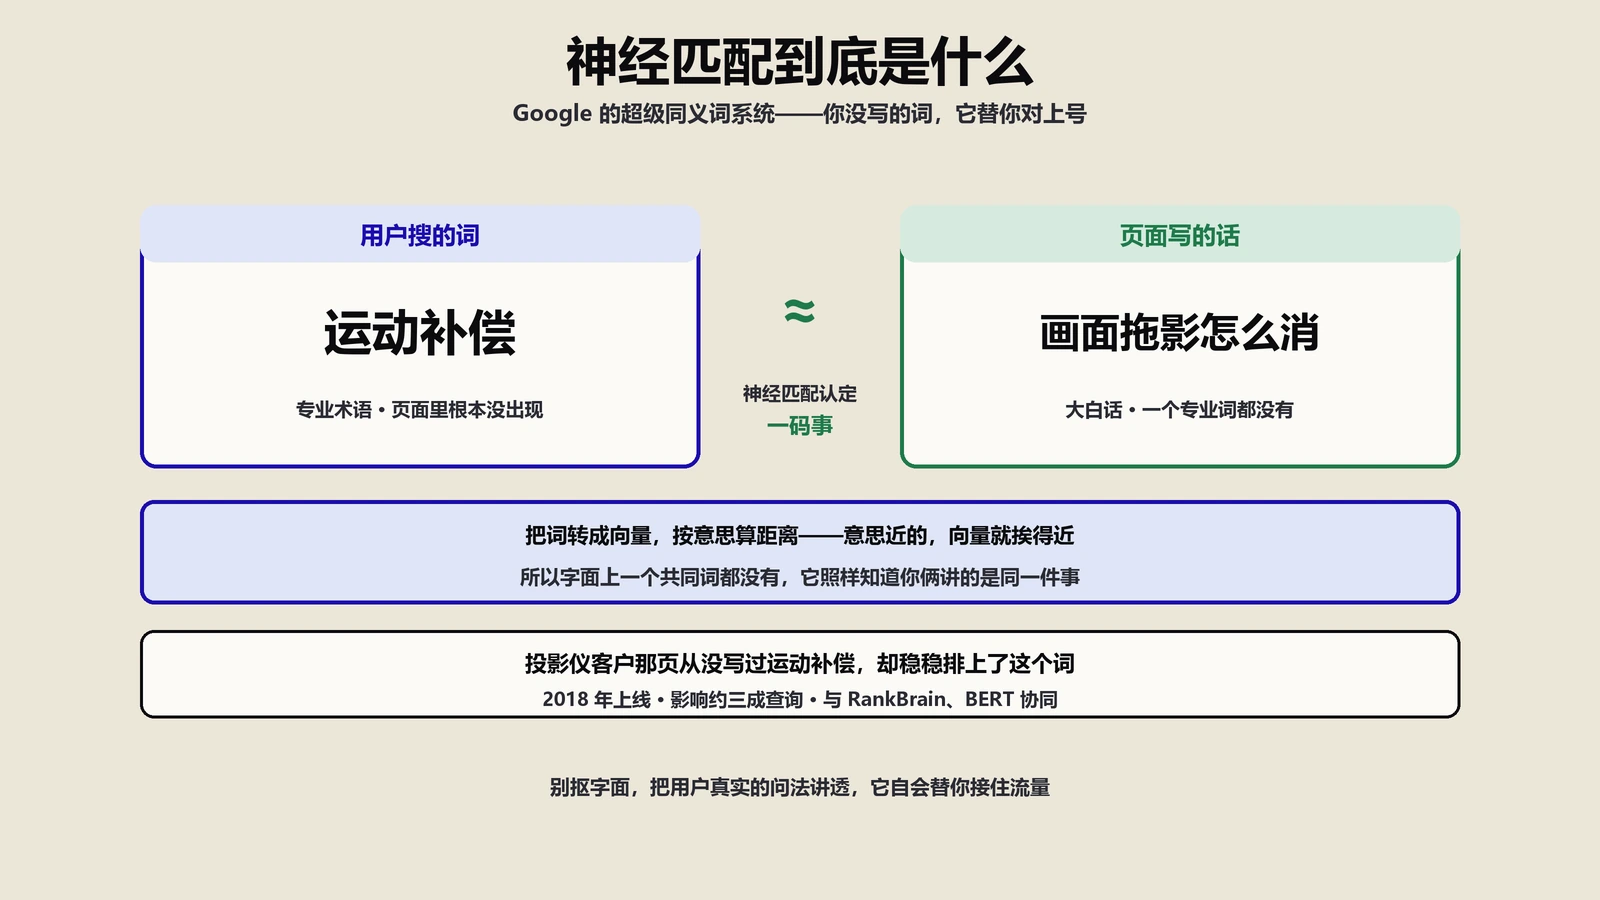
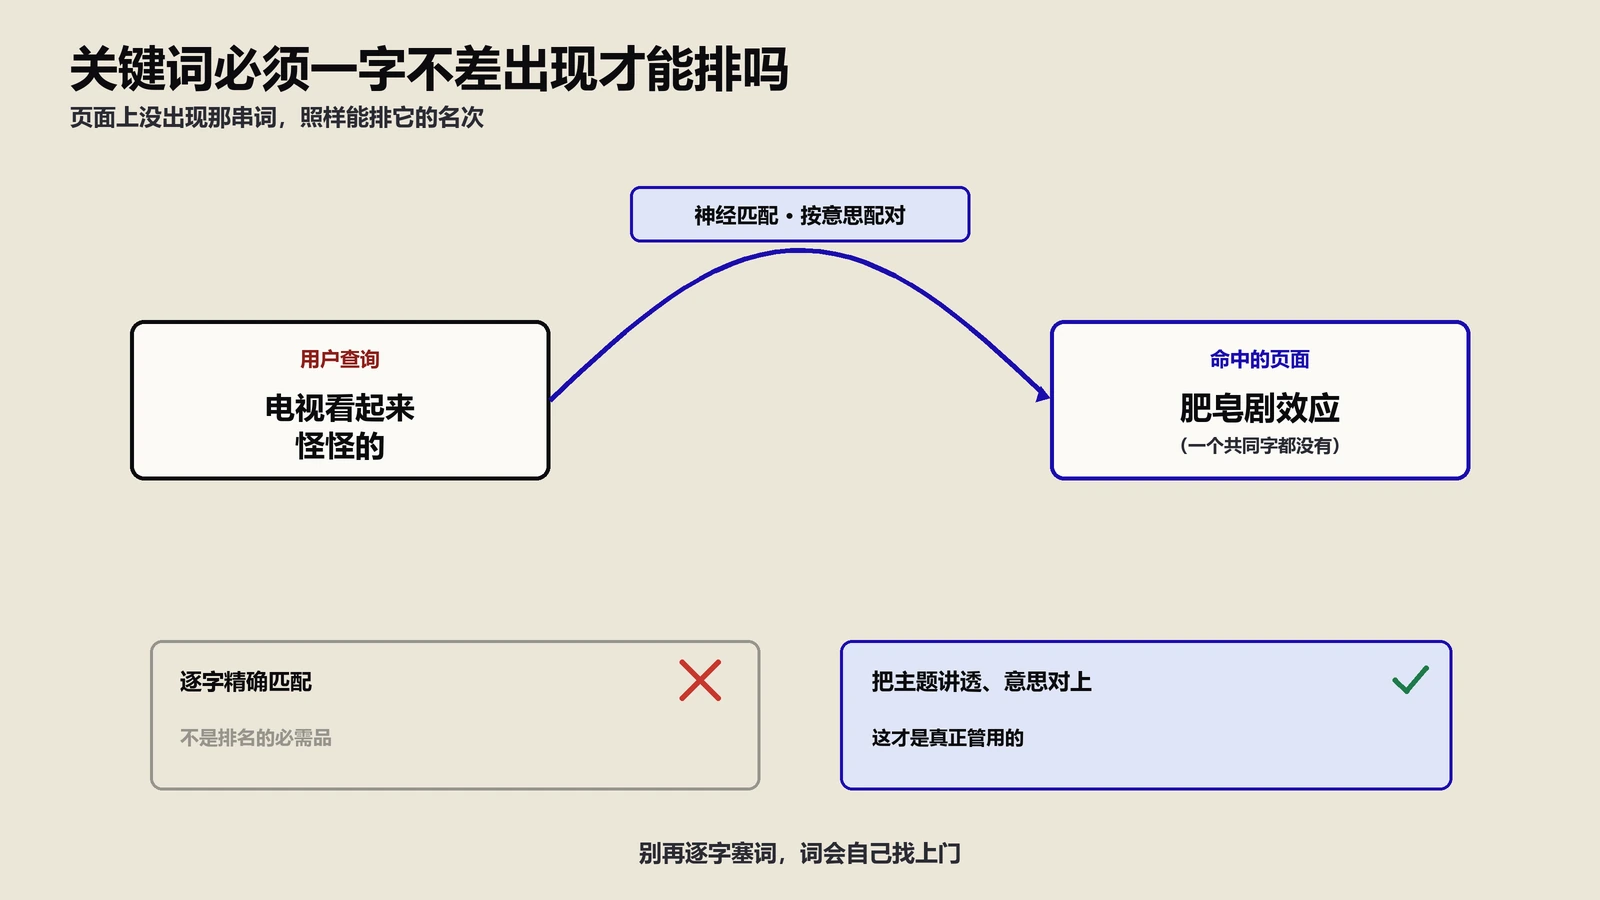
训练的结果是,同一个词出现在不同句子里,BERT能给出不同的理解。bank在“river bank”和“bank account”里意思不同,靠的就是旁边的词。搜索引擎读懂了这一层,你就不必把每个同义词、每种说法都硬塞进页面,系统能顺着语境把页面和用户的真实意图对上。这也解释了一个常见误区:关键词不必一字不差地出现在页面上,页面照样可能排上这个词,因为机器识别的是意思,不只看字面。
BERT、RankBrain与神经匹配在Google搜索中如何分工?
这三个系统最容易被混为一谈,下面分开说。RankBrain作为Google第一个机器学习排名系统,2015年上线,主要处理系统从没见过的新查询,把陌生词和已知概念关联起来,还会参考用户互动做调整。它负责“词和查询”之间的关联。
神经匹配这套被叫做超级同义词的系统,2018年用于搜索,擅长在词和概念之间做模糊的语义匹配:页面上没写某个词,但表达的是那个意思,它也能匹配上。它负责“词和概念”之间的模糊关联。
BERT负责的是语言本身的结构,也就是语序、介词、上下文这些语法层面的信息。Search Engine Journal那篇 BERT更新的完整拆解专门强调过一点,我常转述给客户:BERT的用途是读懂查询,不负责判断内容好坏,所以根本不存在“BERT优化”。
Google自己也澄清过,这三者之间没有替代关系,它们分工协作,在不同环节各自工作。RankBrain帮助理解陌生查询,神经匹配连接近义表达,BERT读懂句子结构,三者合起来,得到一个更贴近用户真实意图的理解。
BERT与蜂鸟算法、MUM是什么关系?
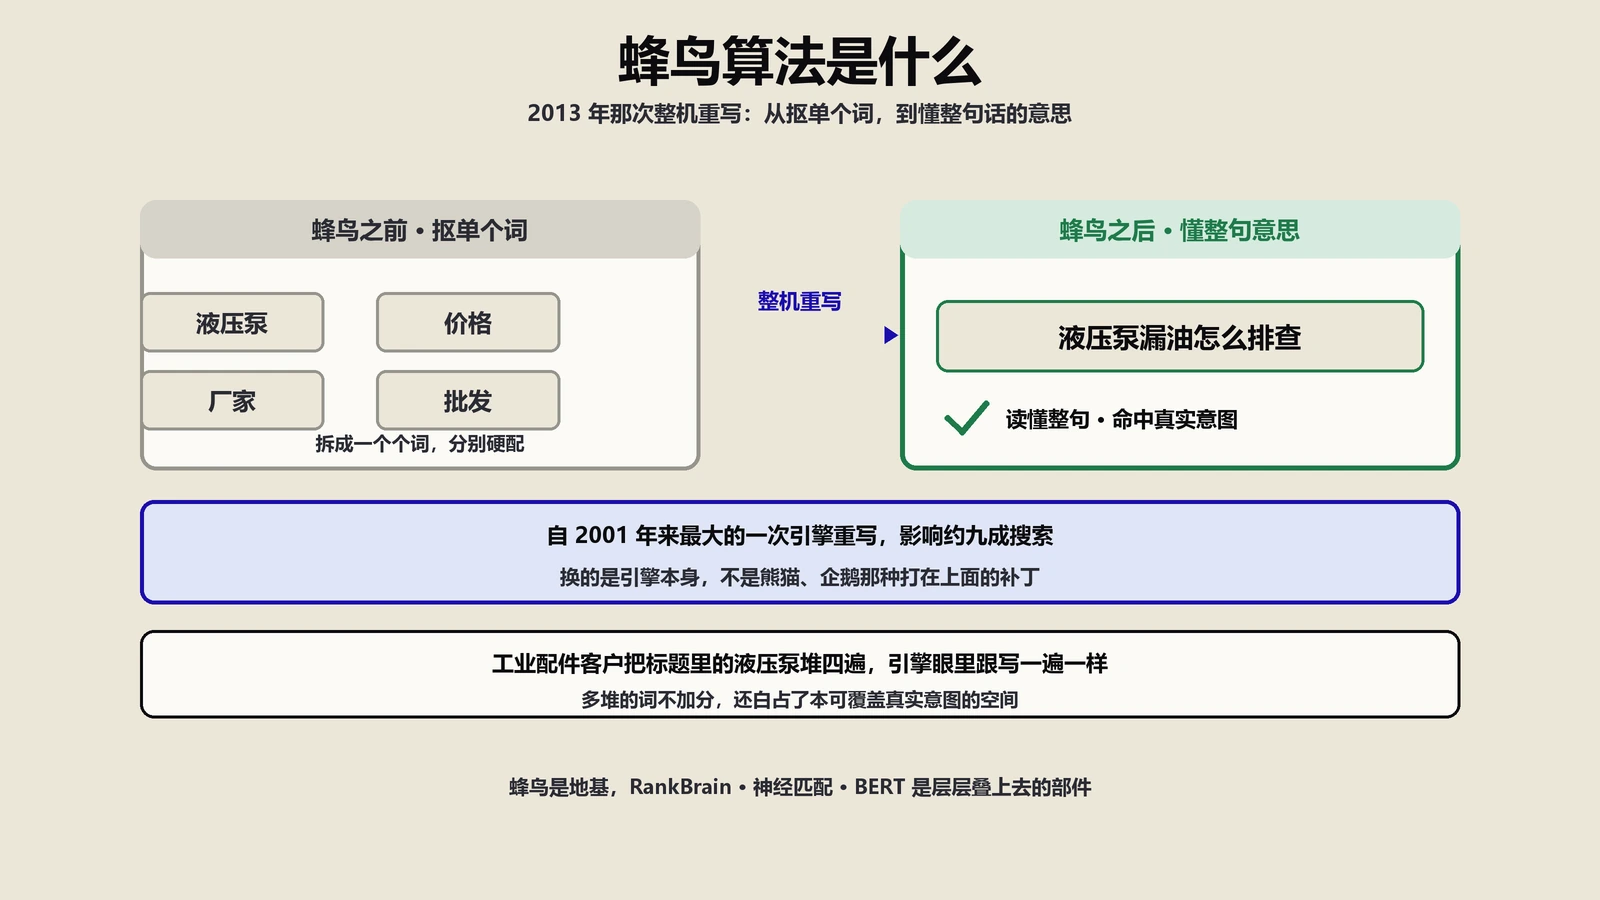
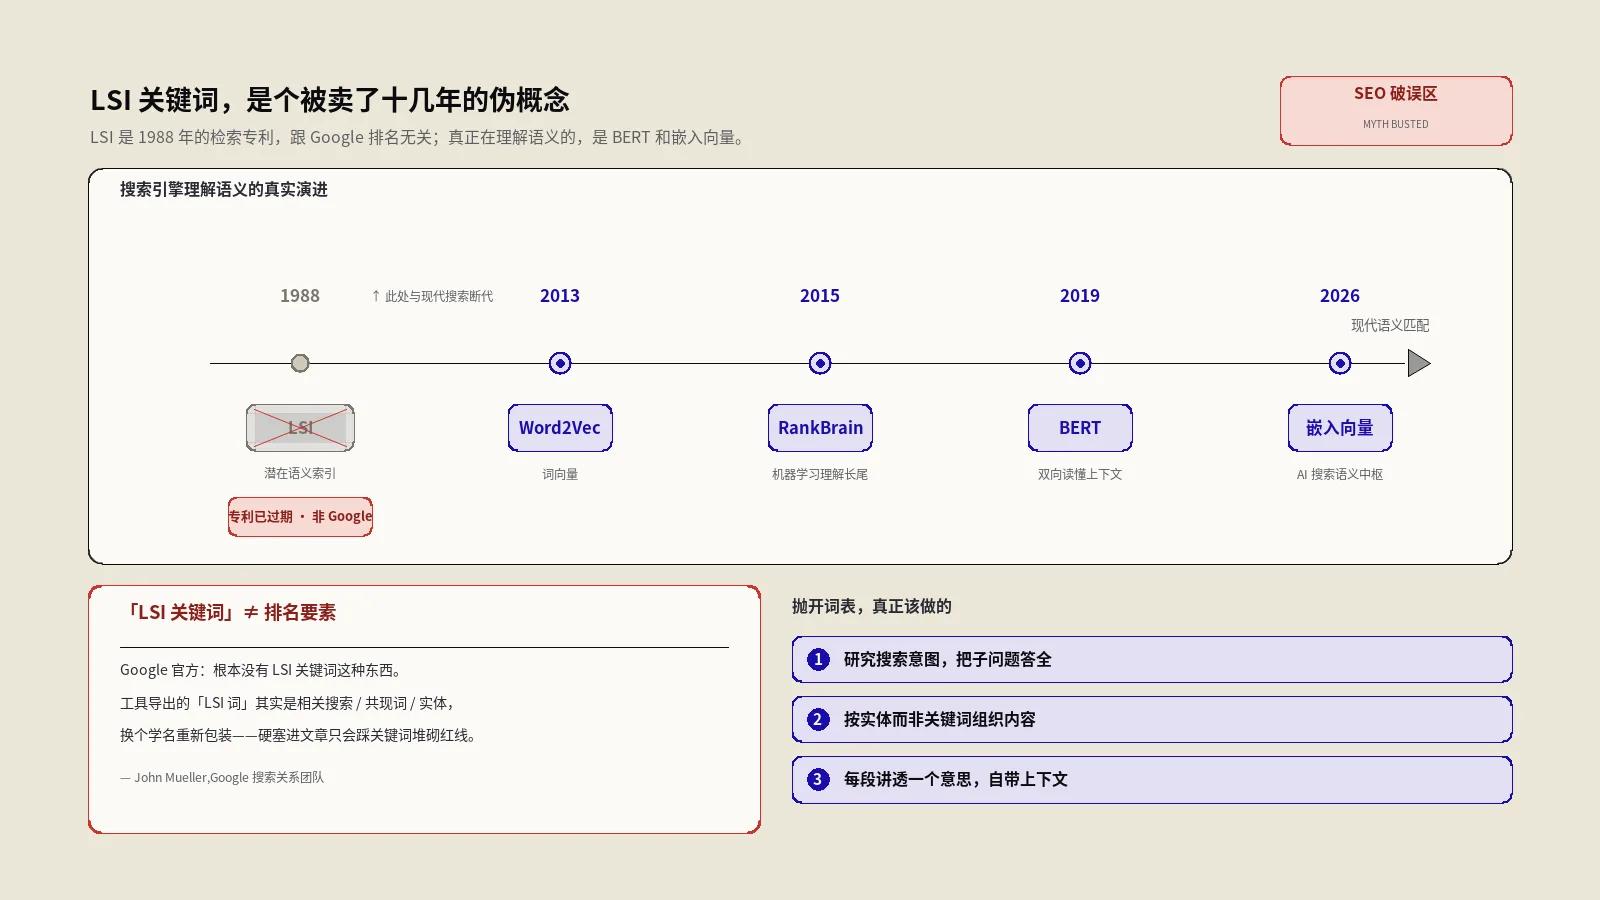
如果说前面三个系统处在同一层,蜂鸟和MUM就属于不同层级。蜂鸟是2013年那次搜索引擎的整机重写,它为“理解整句意图”搭起了基础框架。BERT没有取代蜂鸟,它是在蜂鸟框架里加装的一层更强的语言理解能力:框架由蜂鸟搭建,BERT是后来装进去的组件。
MUM是Google在2021年推出的下一代模型,支持多任务、跨语言、跨模态,官方称它比BERT强上千倍。可以这样区分:BERT只处理文字,只负责理解;MUM能同时处理文字和图片、跨越语言,还能做多步推理。想了解这四代系统从关键词匹配一路演变到意图理解的全景脉络,把它们串起来看会清楚很多。四者的关系可以这样概括:蜂鸟是框架,RankBrain、神经匹配、BERT是框架里的三种能力,MUM是这些能力的全面升级。
BERT能否被针对性优化或操纵?
很多人最关心这个问题。答案是:操纵不了,也没有可供优化的接口。BERT不像meta标签那样有一个入口可以去迎合,它是嵌在理解环节里的底层能力,你能控制的只有写出来的文字本身。BERT刚上线时,Search Engine Land在 对这次更新的解读里就指出:没法针对BERT做优化,能做的只有把内容写得让人和机器都读得懂。
因此那些老做法全部失效:堆同义词、把关键词硬塞进每一段、为了密度写出不通顺的句子,在BERT看来都会减分。它读取的是意思和结构,文字越别扭、越机械,它越难判断页面在讲什么。反过来,把话写顺,把用户的真实问题逐个正面回答清楚,它自然能把页面匹配到相应的查询上。
这条规律和AI时代的写作要求正好一致:无论是Google的BERT,还是后来的大模型,偏好的都是同一类内容,即清楚、自然、确实在回答问题的内容。
怎样写内容才对BERT的语义理解友好?
我给客户的建议一直是下面三条,做法朴素,但很管用:
- 把话写通顺。句子读起来不要拗口,不要为了塞词删掉该有的介词和连接词。“wear over jacket rain”和“can you wear this over a rain jacket”,机器读到的意图完全不同。
- 围绕真实问题组织内容。先想清楚用户会怎么问,把完整的问句和对应的答案写明白,不要只围着一个孤立的关键词打转。
- 不要回避自然语言的长句。过去大家担心长尾词太细、不值得做,现在情况正好相反:越是口语化的长问句,BERT越能发挥作用,这类词竞争小、意图准,是很好的机会。
下面是我常用的一组对照。差的写法:“Waterproof jacket men outdoor best price buy online”,一串名词堆在一起,机器读不出这是在回答谁的什么问题。好的写法:“男士户外防水外套怎么选?我们按防水等级、透气和预算分了三档,帮你在雨天登山时不至于被浇透。”后者用词更少,却把场景、意图和答案都交代清楚了,BERT一读就知道该把它匹配给哪些查询。
还有一点很多人不知道:BERT不只影响普通的十条蓝色链接,也用于精选摘要的抽取。Google当年宣布时就提到,BERT帮助它在更多国家和语言里挑出更贴切的精选摘要片段。所以,如果某段文字写得准确完整、正面回答一个具体问题,它被抽成摘要、被AI引用的概率也会提高,在今天的AI搜索环境里,这一点的价值只会更高。
用不着专门为BERT优化,别再围着那套过时的关键词游戏写就行。把读者当成真实的人,把他的问题当成真实的问题来回答,BERT这一关自然能过。理解系统在整条搜索流水线里处于哪个环节,可以对照Google搜索中心的搜索工作原理文档看一遍:抓取、索引、理解、排名各管各的事,不必混在一起焦虑。
外贸站与多语言站如何应对BERT的语言理解?
这是外贸从业者最该重视的部分。BERT从2019年底起就扩展到了七十多种语言,它读英文站的方式,和读德语站、西班牙语站的逻辑相同。这里面有两个坑和一个机会。
第一个坑是机器翻译。机翻文案经常语序别扭、介词误用,在BERT看来就是一堆读不通的句子,关键词填得再满也没有用。很多站点栽在这上面:钱花在了引流上,内容却是一眼就能看出来的机翻。第二个坑是按中文思维直译,英文母语者根本不会那样表达,语境一错,意图就对不上。你自己看到一段中式英文都会皱眉,Google也很难把它读顺。
机会在于:大多数同行还在堆词、还在用机翻应付,你只要请母语者把内容写得自然,把目标市场用户的真实问法逐句回答清楚,就已经领先一大截。这件事没有什么黑科技,听起来也不新鲜,却是BERT时代最实在的竞争壁垒。保哥做了二十多年,越来越相信一点:搜索引擎的每一次进化,都在奖励那些踏实做好内容的人。BERT用技术手段把这个道理又重申了一遍。
常见问题解答
BERT是一个排名算法吗?
严格来说不是。BERT是语言理解模型,任务是帮Google弄懂查询和内容的意思,本身不直接给页面打分排序。它作用于“理解”这个环节,理解准确了,匹配和排名才更可靠。如果把它当成排名器,就会陷入“为它优化”的误区。
BERT上线后,我需要重新做关键词研究吗?
关键词研究照常做,但重点要调整。不必再纠结某个词一字不差地塞进去多少次,要去研究用户真实的问法、完整的问句和背后的意图,围绕这些组织内容。工具给出的仍然是词,但做内容时要想的是一个个具体的用户问题。
BERT只对英文有效吗?
不是。BERT在2019年10月先用于英文,同年12月扩展到了七十多种语言。无论做哪种语言的站,只要该语言在覆盖范围内,逻辑都相同:把话写自然。多语言站尤其要警惕机器翻译,这是BERT时代最容易踩的坑。
BERT和ChatGPT是一回事吗?
不是一回事,但有渊源。两者都基于Transformer架构,区别在于BERT是专做理解的编码器模型,用来读懂输入;ChatGPT这类是生成式模型,用来产出文本。前者偏重读,后者偏重写,架构同源,用途不同。
BERT还在用吗,会不会被MUM淘汰?
还在用。MUM是能力更强的下一代,但这不代表BERT已经退役。这些系统通常层层叠加、协同工作,很少简单地一个替换另一个,搜索引擎的底层能力一般是逐步累加,不会推倒重来。今天在自然语言表达上下的功夫,服务的不只是BERT,也包括叠加在它之上的各层理解能力,这份投入长期有效。
我怎么知道自己的页面对BERT友好不友好?
没有专门的检测工具,但有个简单办法:把文案念给一个不懂SEO的普通人听,如果对方听着别扭、不知道你在讲什么,BERT大概率也难以理解。读起来像正常人说的话,就是最好的自查标准。
权威参考资料
本文标题:《BERT是什么?Google搜索语言理解模型的原理、分工与写作要求》
本文链接:https://zhangwenbao.com/google-bert-algorithm-nlp-explained.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0