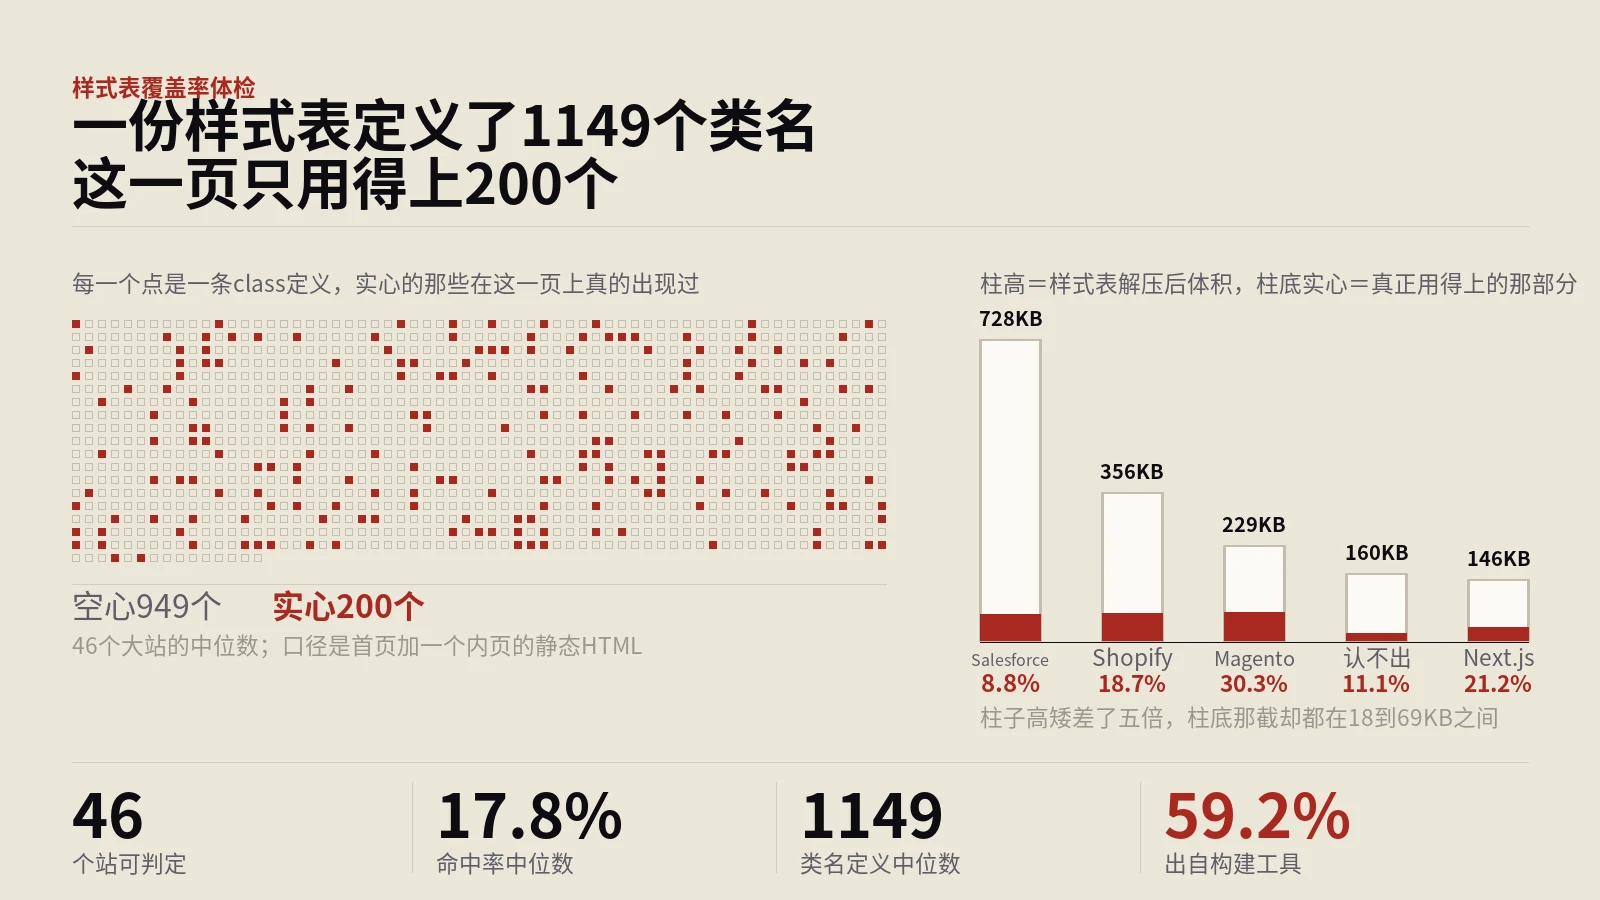
CSS覆盖率实测:1149个类名里这一页只用上200个
做法是抓首页声明的每一份样式表,把里面定义的类名跟首页加一个内页的类名求交集。尺子改过三次:正则会把url里的文件后缀当类名,而修它的那一刀更狠,反复挖花括号会把整个媒体查询里的选择器一起挖掉。
标签
保哥笔记 技术SEO 标签下共 50 篇文章合集,含《技术SEO一堆问题先修哪个?500站实测排出来的优先》《Core Web Vitals在AI搜索时代还值不值》《电商SEO最重要的5点:从AI爬虫到accessib》等,与 Core Web Vitals、AI爬虫、结构化数据 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
做法是抓首页声明的每一份样式表,把里面定义的类名跟首页加一个内页的类名求交集。尺子改过三次:正则会把url里的文件后缀当类名,而修它的那一刀更狠,反复挖花括号会把整个媒体查询里的选择器一起挖掉。
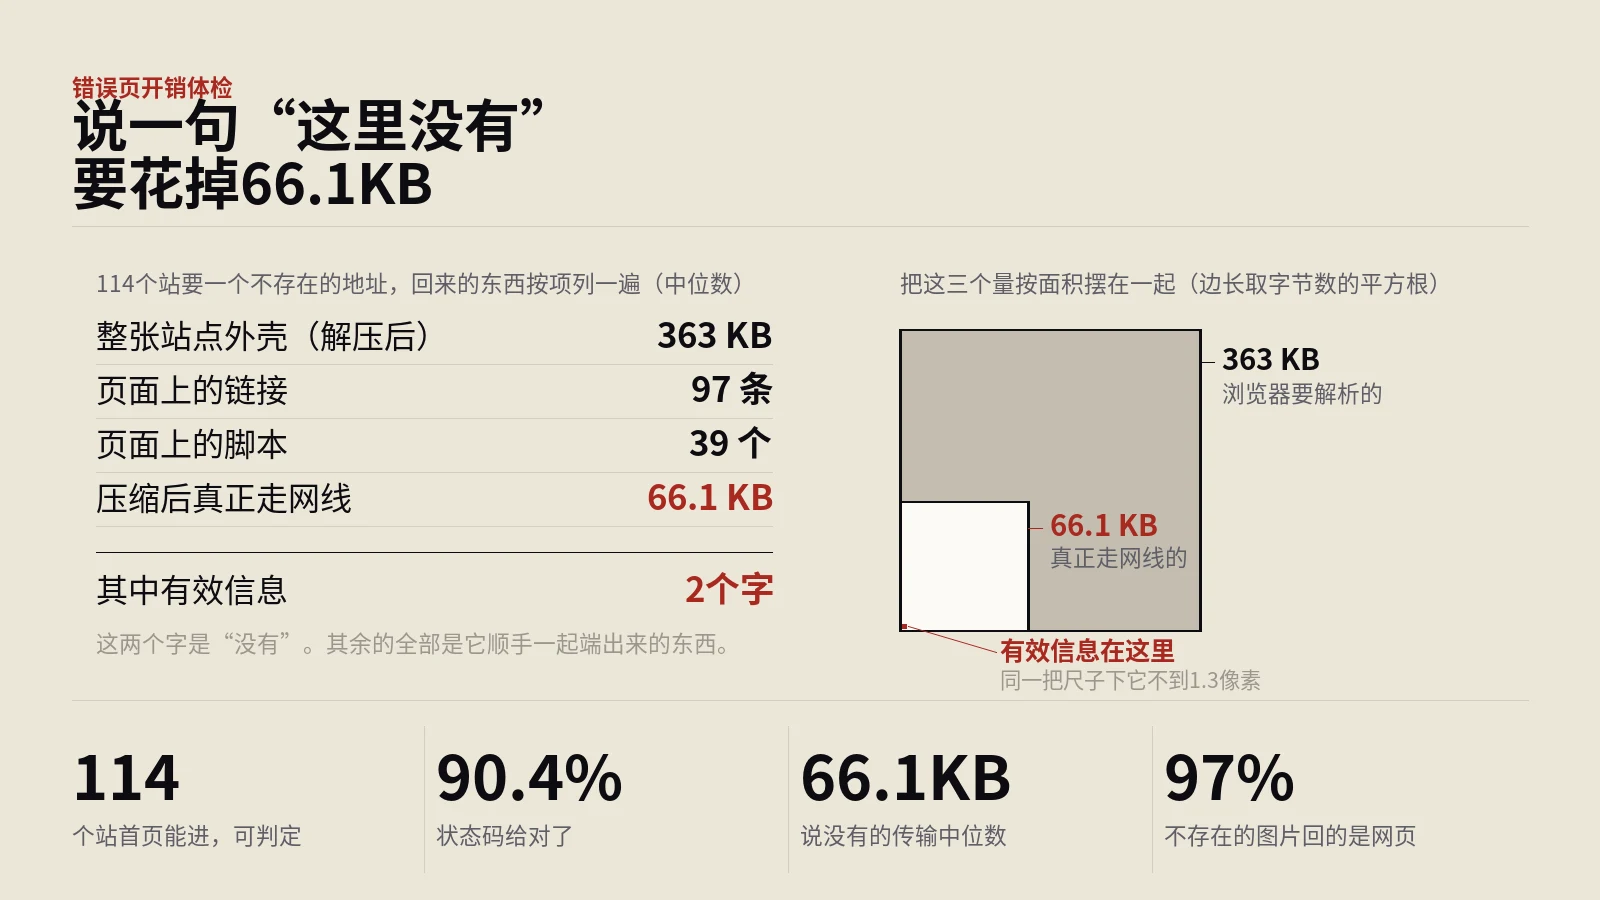
做法是给每个站要十一个编出来的地址,再要两个真实存在的当零点,同一个不存在的地址要两遍看字节稳不稳。尺子失效过一次:第一轮采得太密,三十六个站改口回429,放慢重跑之后又有七个站反过来被拒。
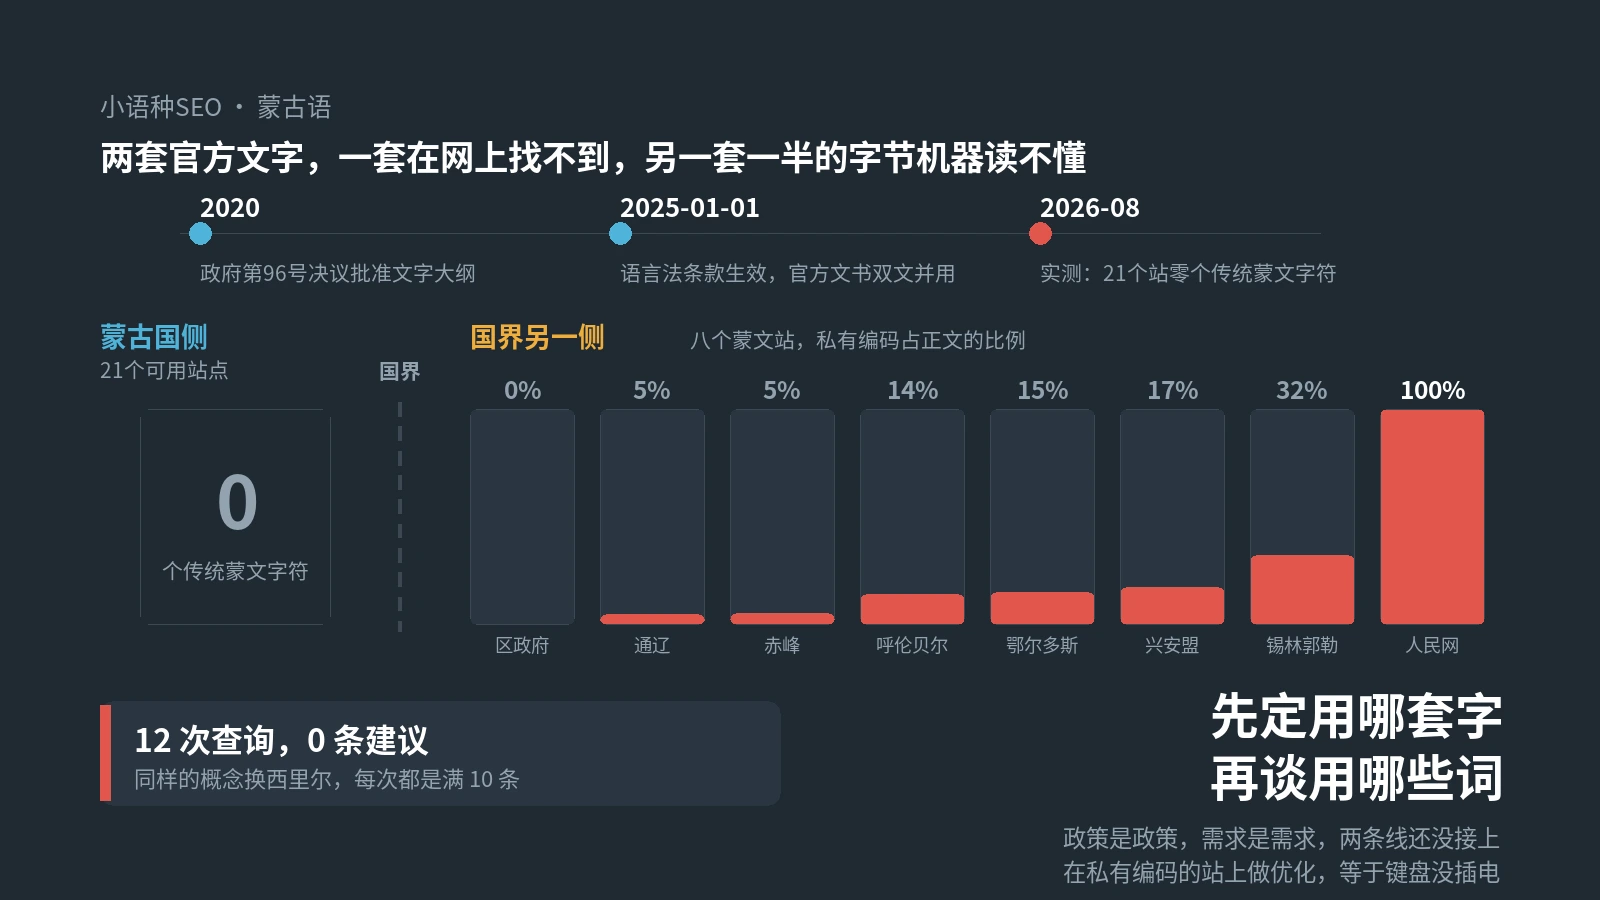
客户拿着一条当地语言法规过来要求照做,可实测下来那套字在网上一个字符都找不到。这里给出网页侧与搜索侧的两组零结果、国界另一侧八个站的编码欠账清单,以及一套不懂这门语言也能跑完的排查动作。
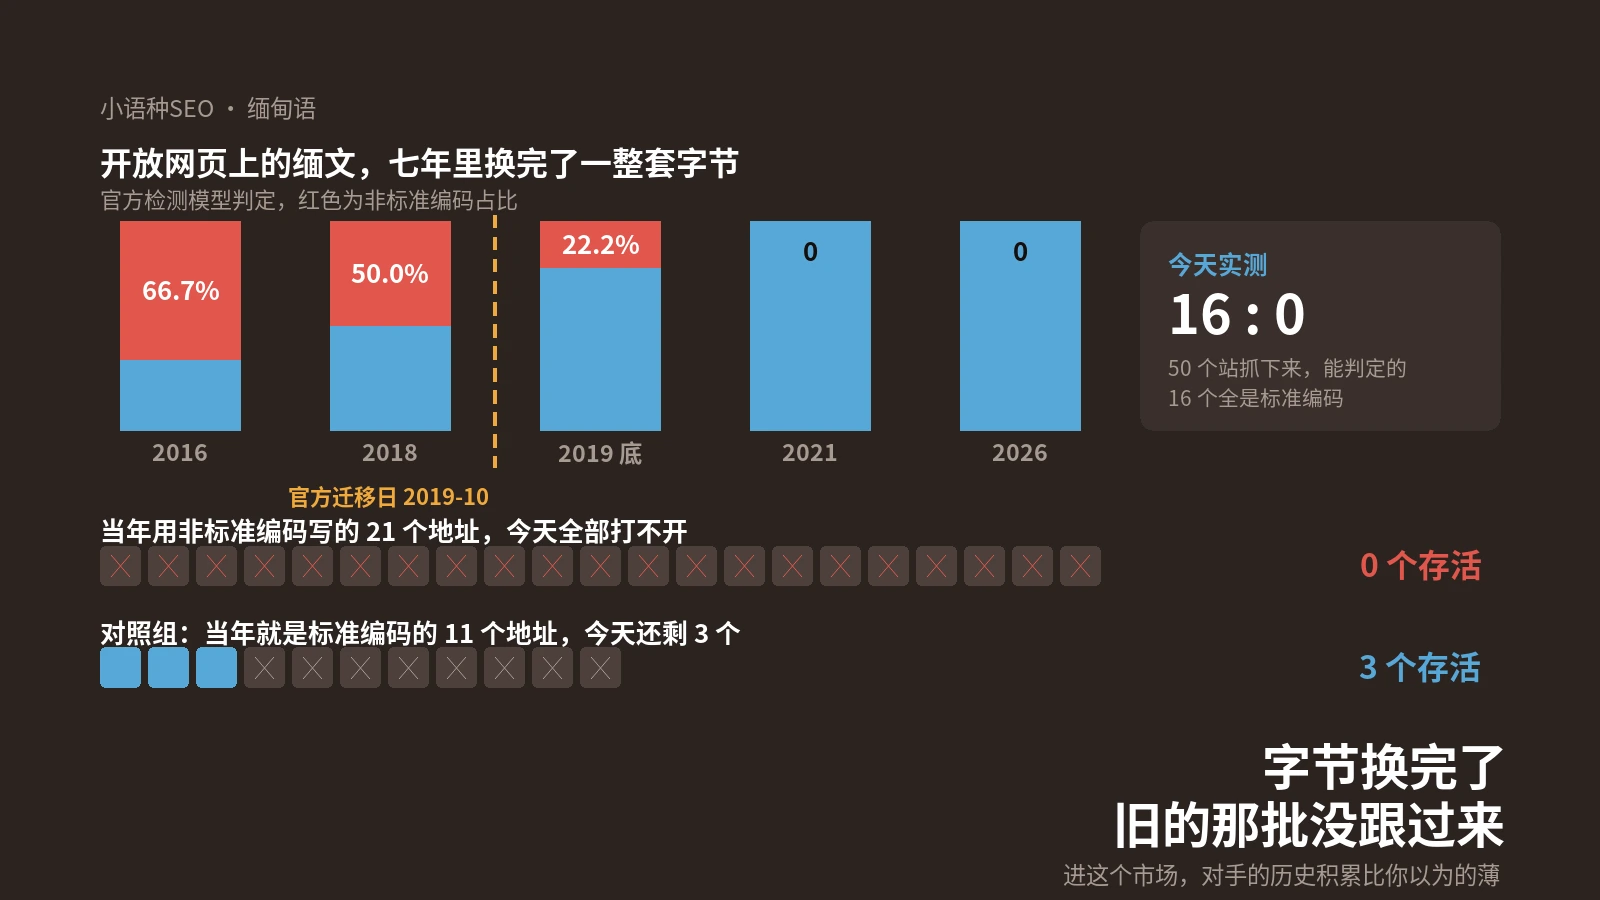
离网太阳能站的缅甸语页面,团队和本地同事截出来的图不一样。这里给出50个缅甸站的编码实测、一条从三分之二掉到零的迁移曲线、21个旧地址今天全部打不开的存量账,以及两天能跑完的排查流程。
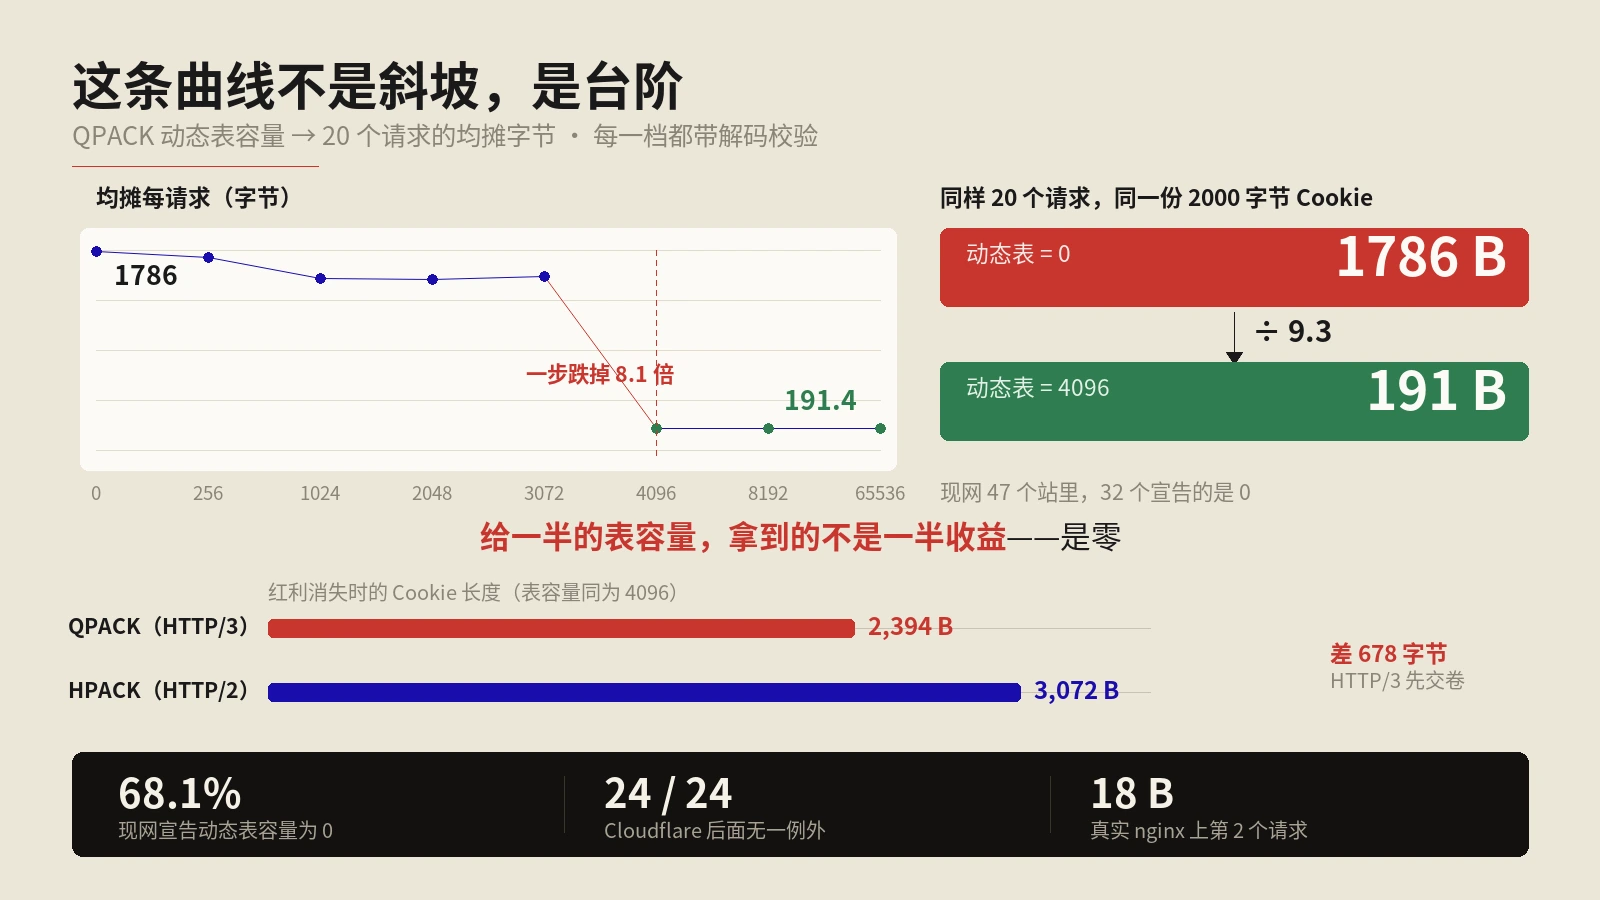
规范把这项默认值定成零,而它自称等价的HTTP/2参数默认是4096:同一套机制迁过来,默认状态从开着变成了关着。逐档扫描还量出一个反常现象——容量从1024加到3072,均摊不降反升二十字节,付了管理开销却没省到最长那个字段。把请求头拆开这一招在长度过线之前越拆越亏、过线之后拆四条能省2.3倍。另含服务端可接收头部上限的取值分布,以及十三个站根本没宣告这一项。
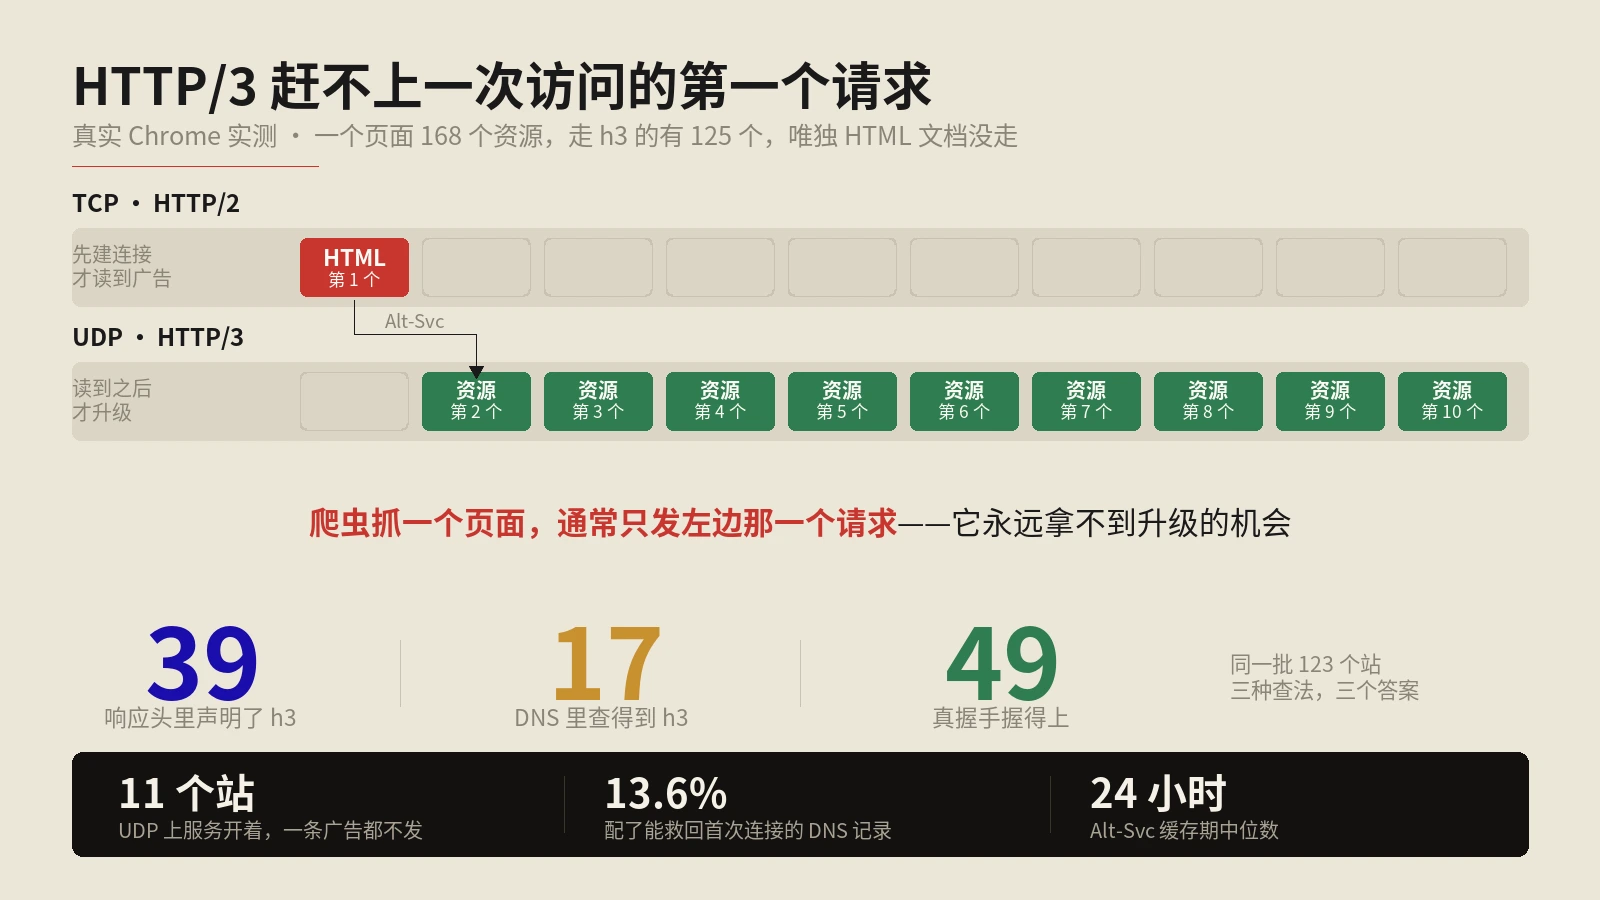
自建nginx五端口实验台把发现机制逐条复现:漏写listen ssl而只留quic那一档,语法检查通过、进程正常、端口在听,浏览器却永远找不到它;撤掉广告头之后服务照常应答,证明它只是块牌子而非开关;OpenSSL兼容层下ssl_early_data形同虚设且毫无提示。另含缓存有效期中位二十四小时、十个站还挂着旧草案版本号、云安全组只放行TCP时形成的排查盲区,以及那条能救回首次连接的DNS记录为何多数客户端拿不到。
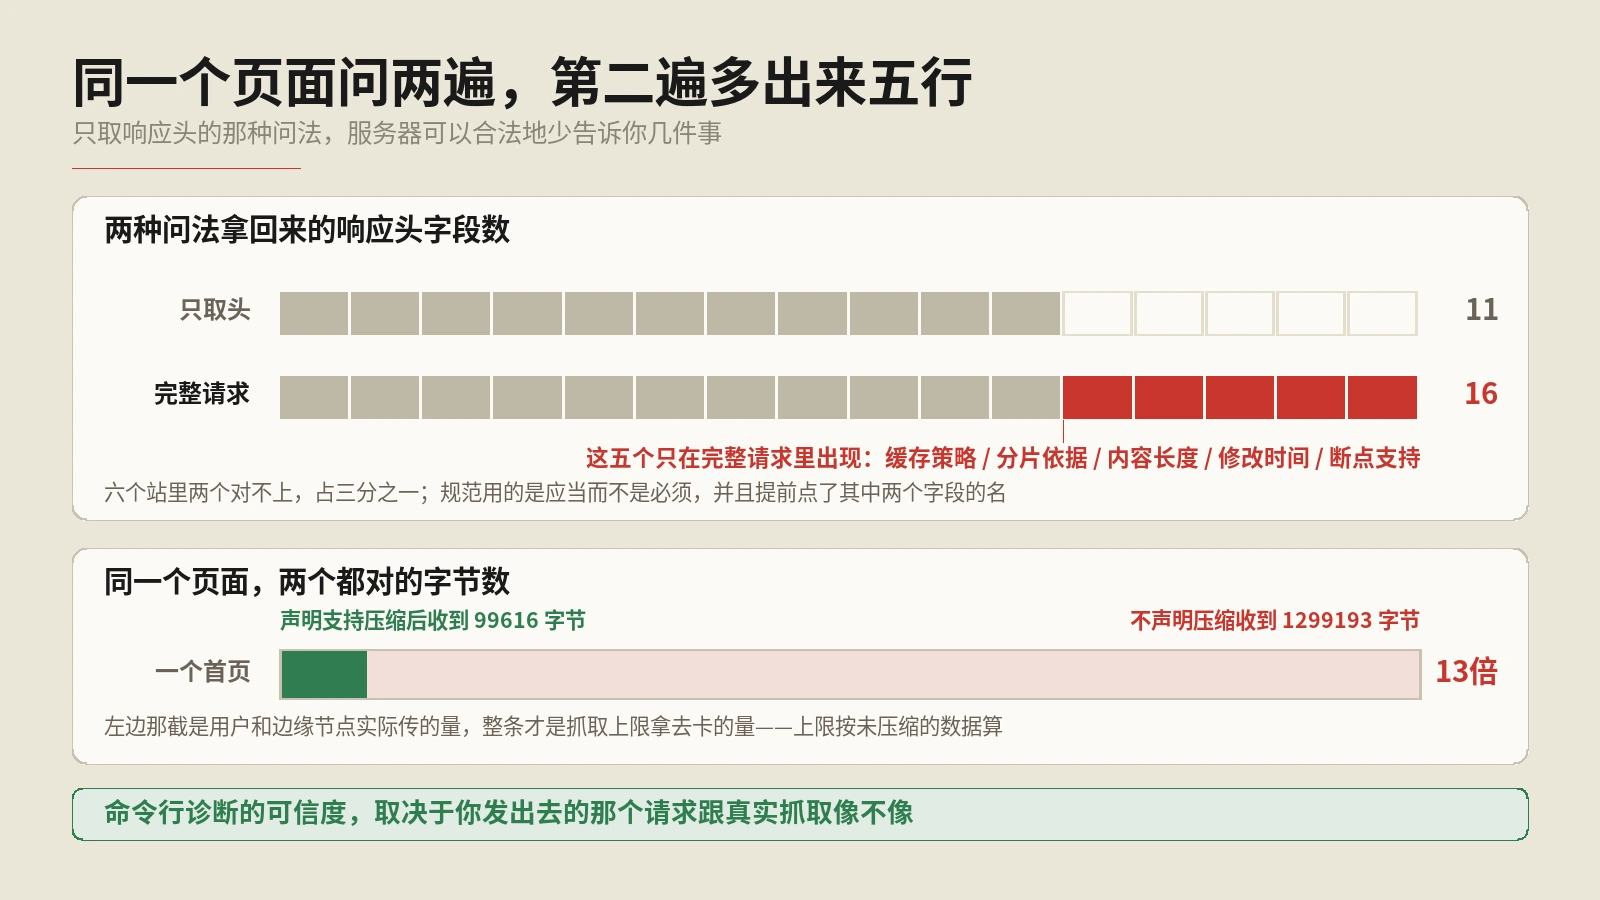
对六个真实站点各发一次HEAD和一次GET做集合差:三分之一的站两边对不上,缺的字段里有cache-control、last-modified、content-length和vary,而RFC 9110第9.3.2节明写服务器MAY省略这些只在生成正文时才确定的值,还点名了Content-Length与Vary。同轮实测另外三组数据:裸curl收到的字节是压缩后的6到13倍,而Googlebot那2MB上限按未压缩数据计算;同一个URL…
户外露营站的波兰语页展现涨了点击不动,三轮排查都在自己这一侧。这里给出取材源清单怎么列、二十分钟抄写自查怎么做、四类差异各修哪一处,以及站点名那一格怎么定。

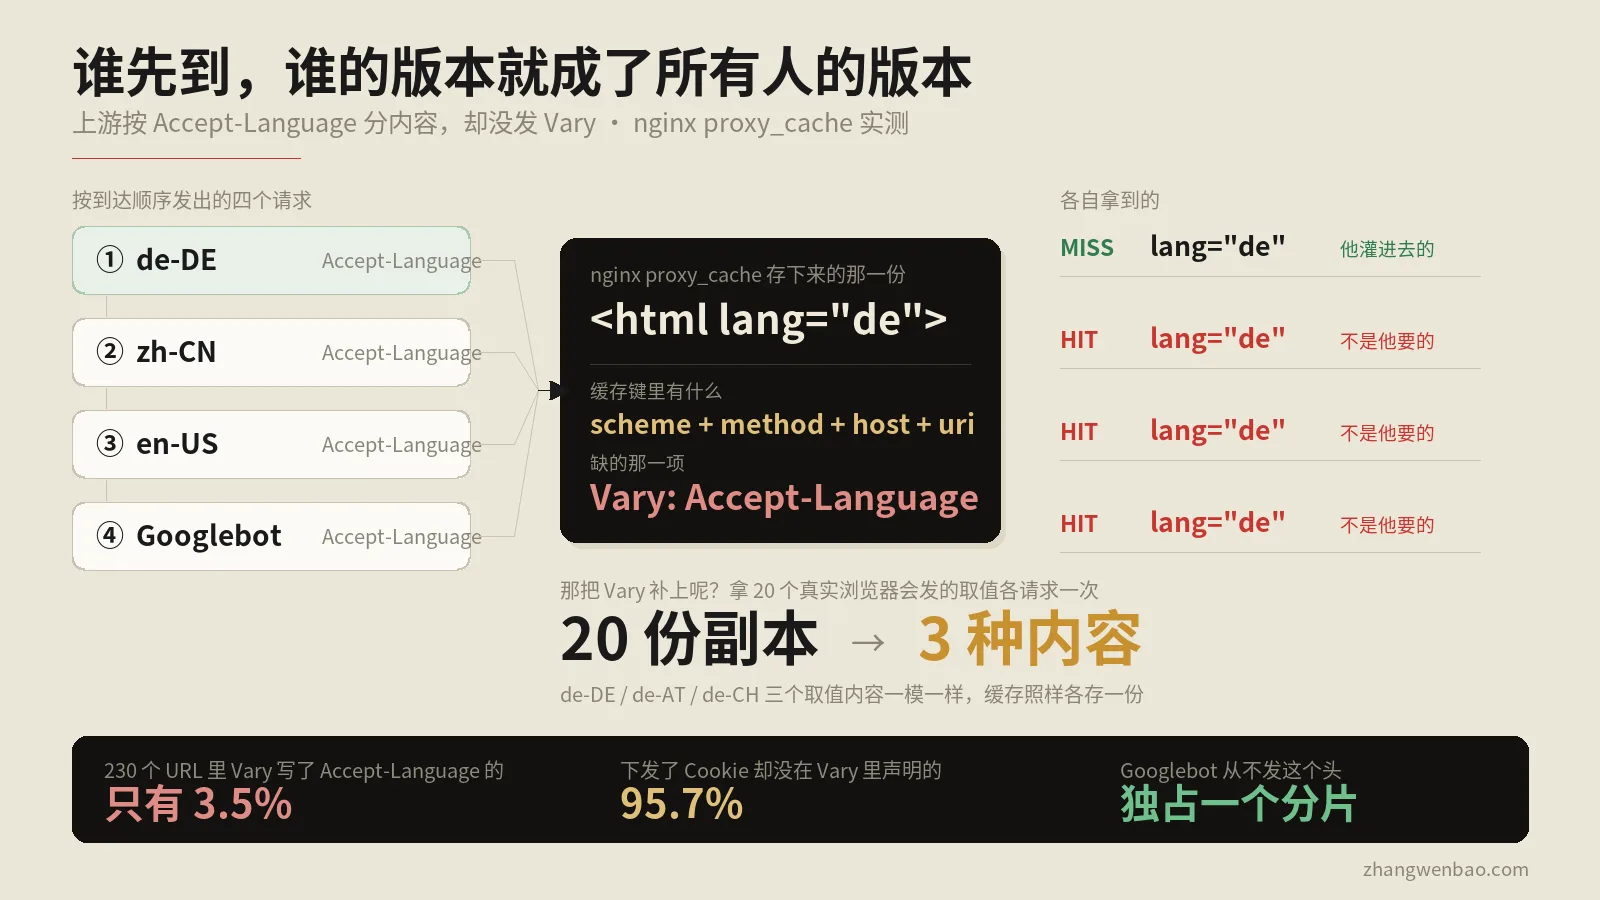
nginx实验台实测:上游按语言分内容却不发Vary,德语用户灌入缓存后,中文、英文、法语用户与Googlebot全部命中同一份德语页面;把Vary补上又会让20个Accept-Language取值生成20份副本、实际只对应3种内容。另含230个URL的Vary现网分布、首访下发Cookie占比50.4%,以及proxy_ignore_headers导致会话串号的最小复现。
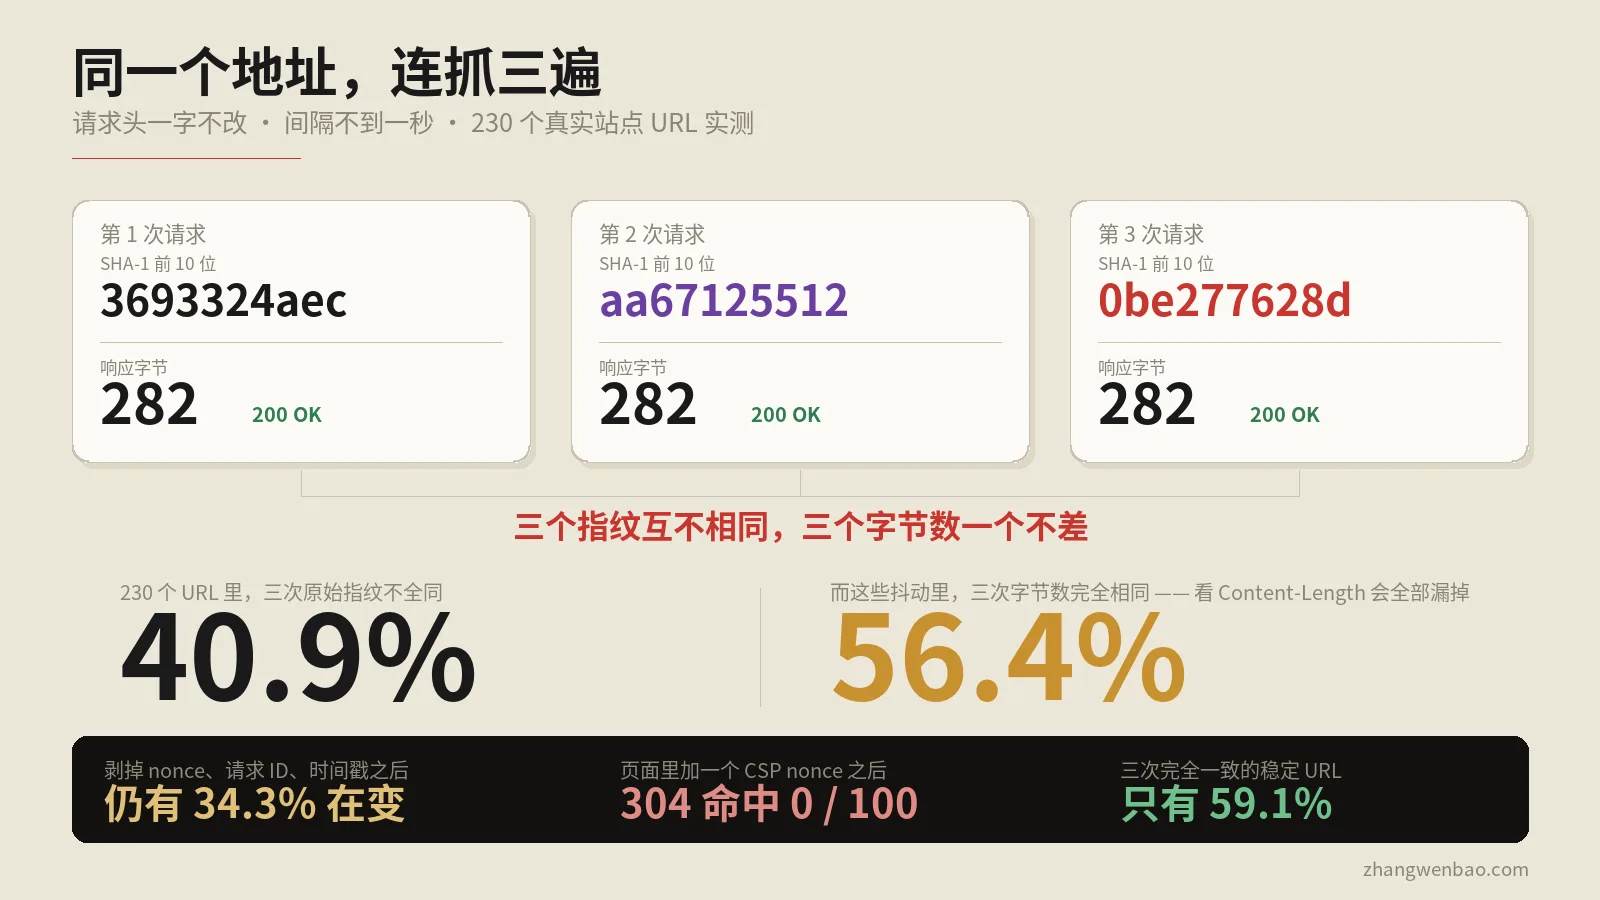
230个真实URL连抓三遍的实测:40.9%三次原始指纹不全同,其中56.4%三次字节数完全相同、靠Content-Length根本看不出来;剥掉nonce与请求ID等高熵串之后仍有34.3%在变;nginx实验台上一个CSP nonce把条件请求的304命中率从100/100打成0/100,另附抖动成因归类与五步基线测法。
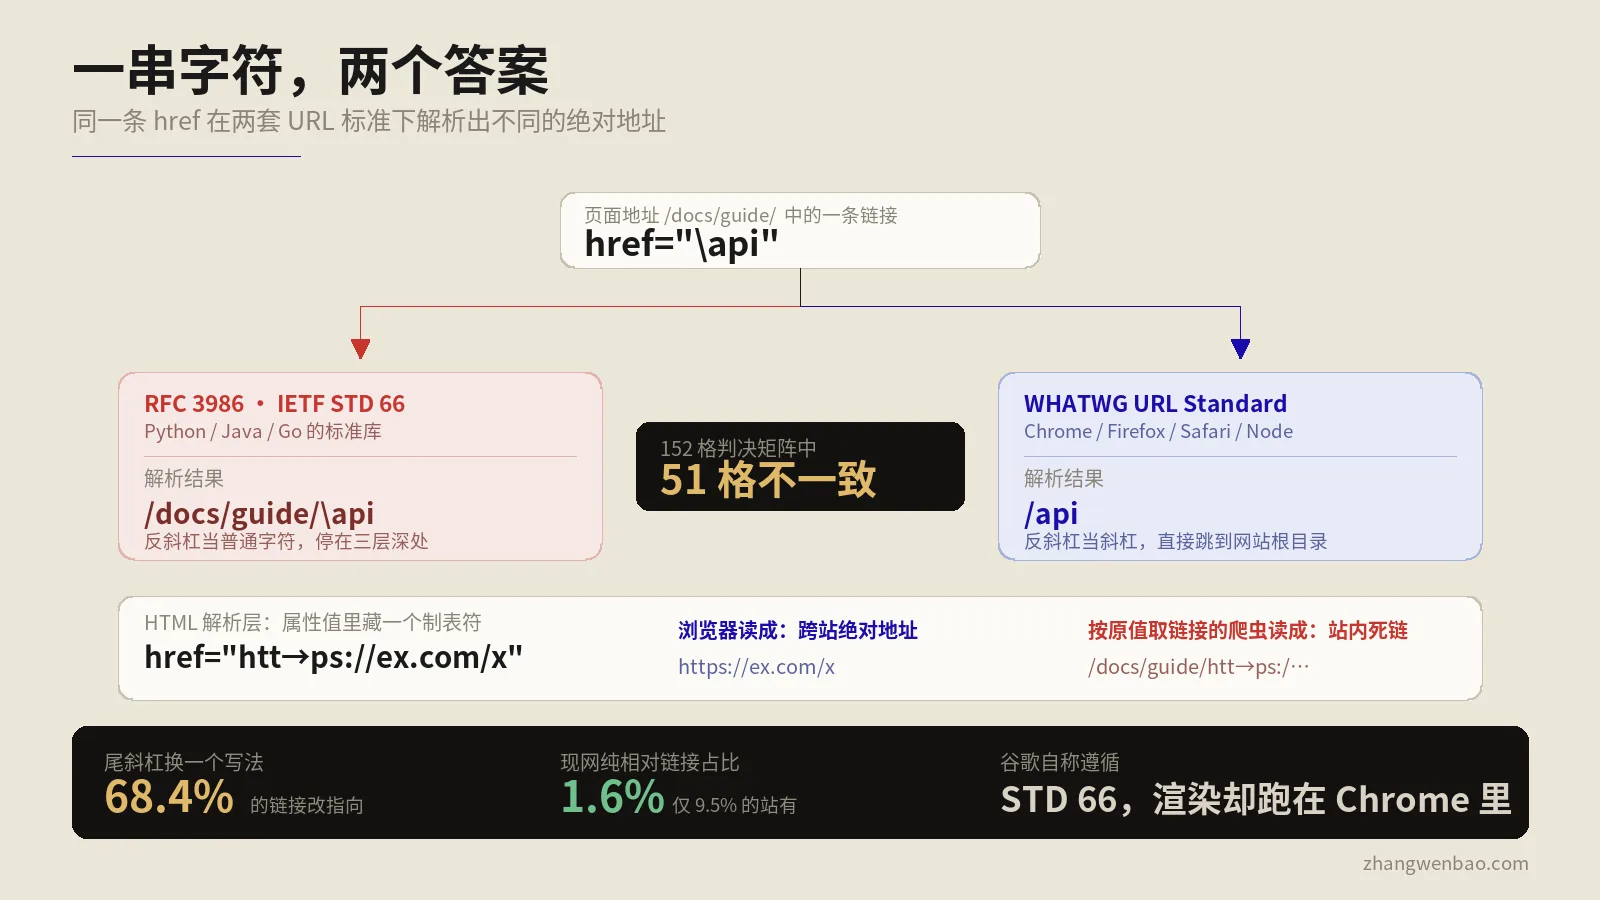
同一份HTML挂在带与不带尾斜杠两个地址下,19条链接有13条解析结果不同;152格双引擎判决矩阵中51格RFC 3986与WHATWG给出不同答案;含真实Chrome实测的HTML解析层空白剥离行为与116站链接形态普查。
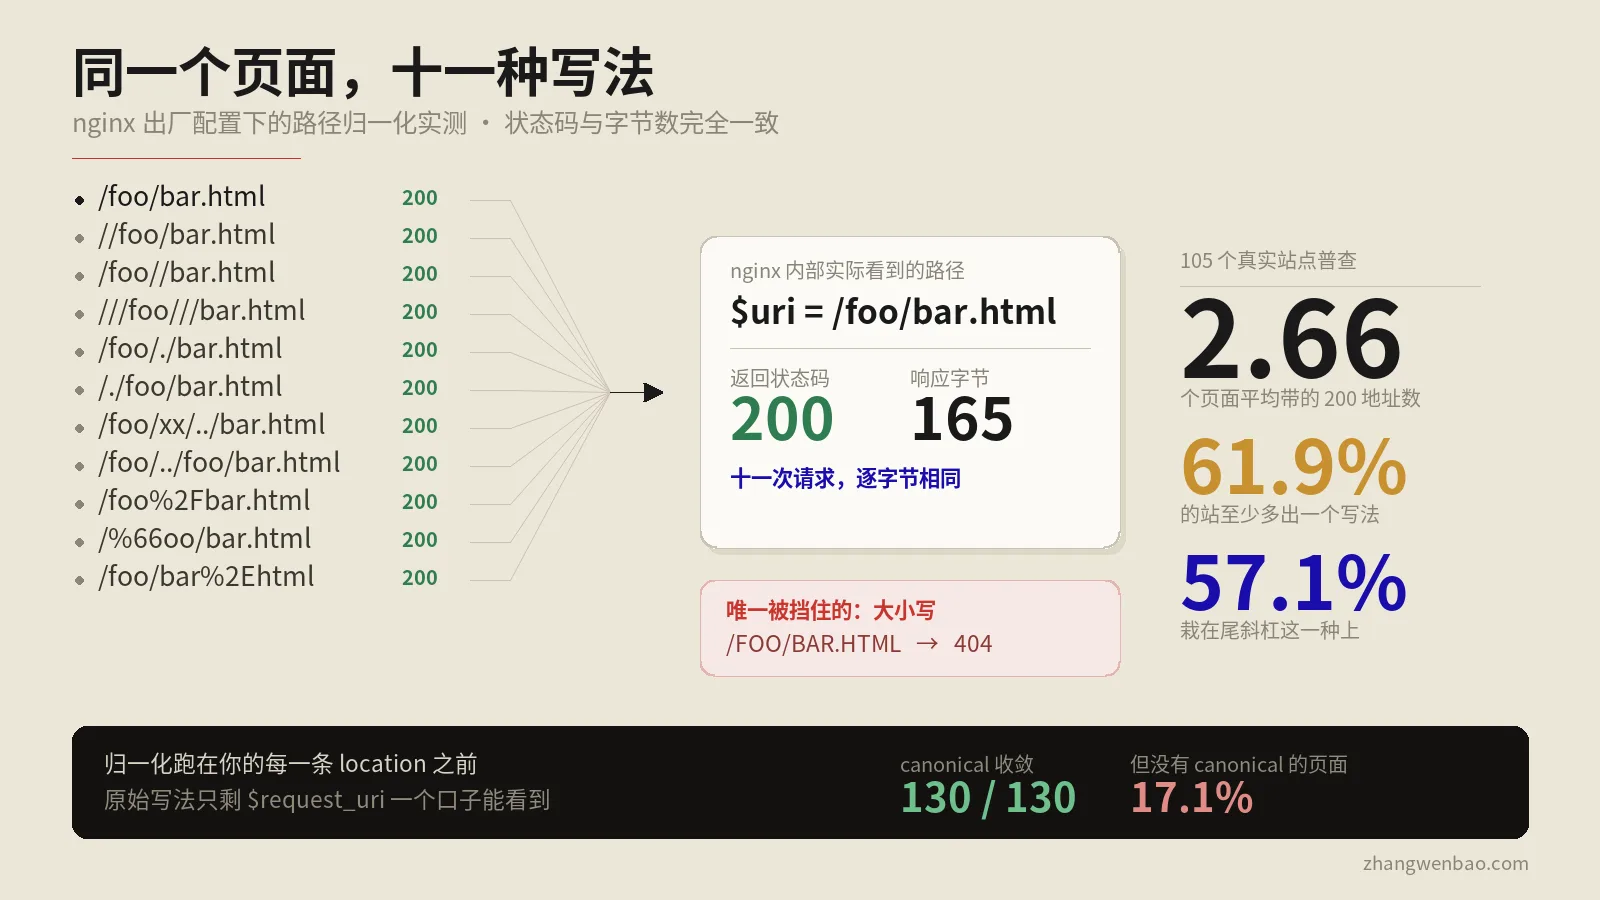
nginx实验台实测:多余斜杠、点段、百分号编码共11种路径写法全部返回200且字节完全相同;105站普查显示一个页面平均带2.66个等价地址,61.9% 的站至少多出一个;附大小写三档分布与收敛决策表。
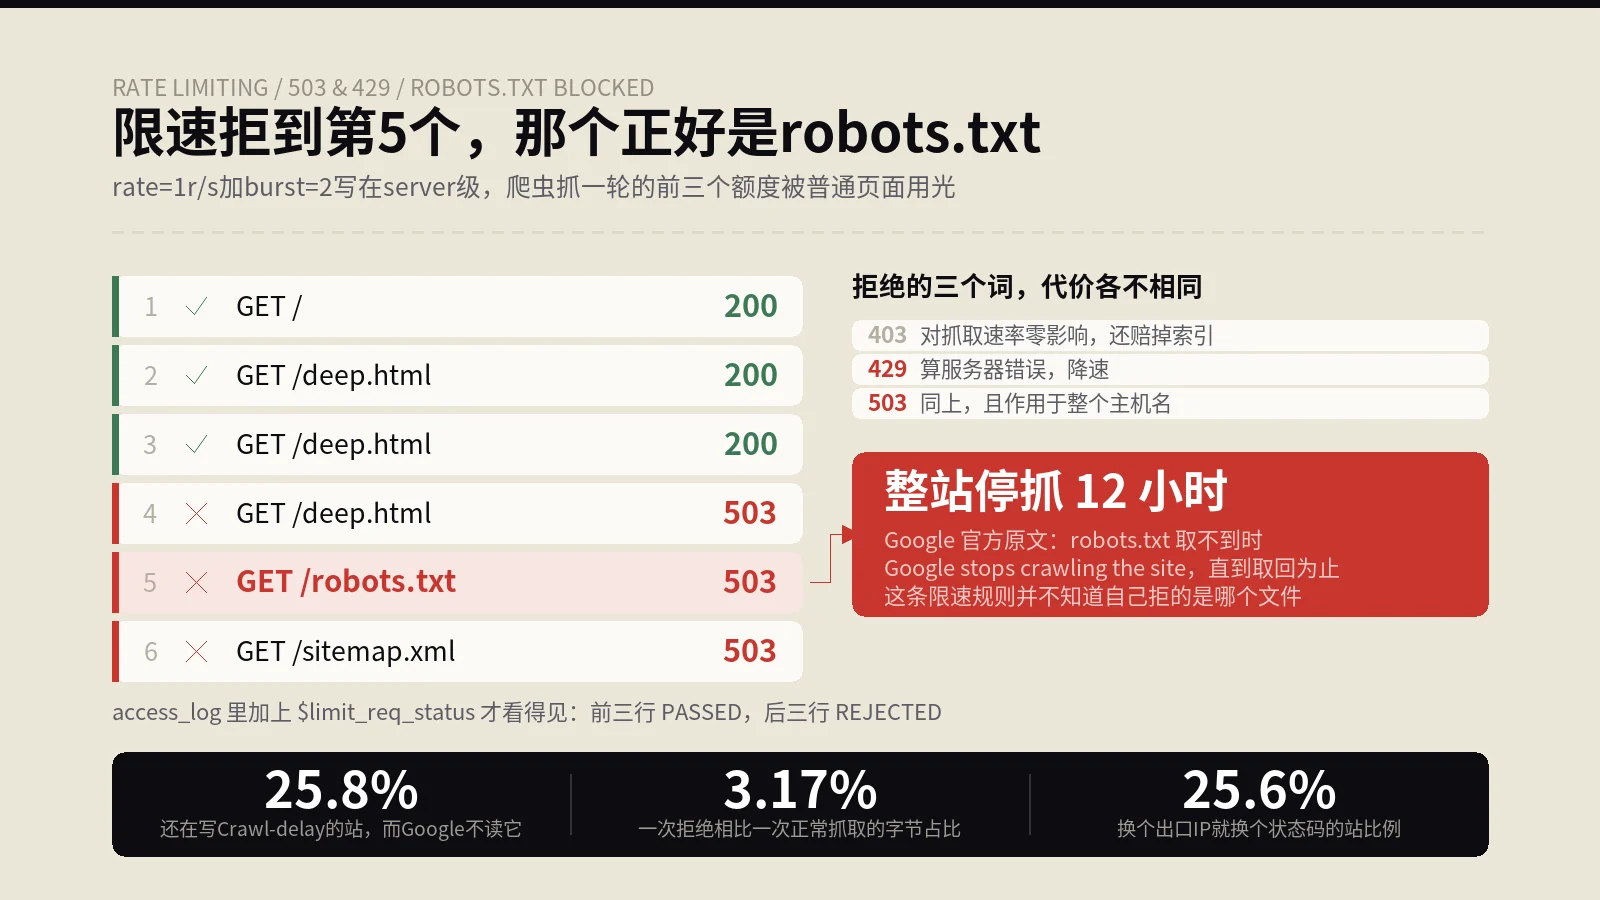
一条抄来的limit_req写在server级,爬虫抓到第4个页面就把配额吃光,接着robots.txt和sitemap.xml双双吃到503。而按官方规矩,robots.txt取不到会让Google前12小时停止抓取整站。想把它摘出来时才发现,limit_req off这条指令根本不存在。
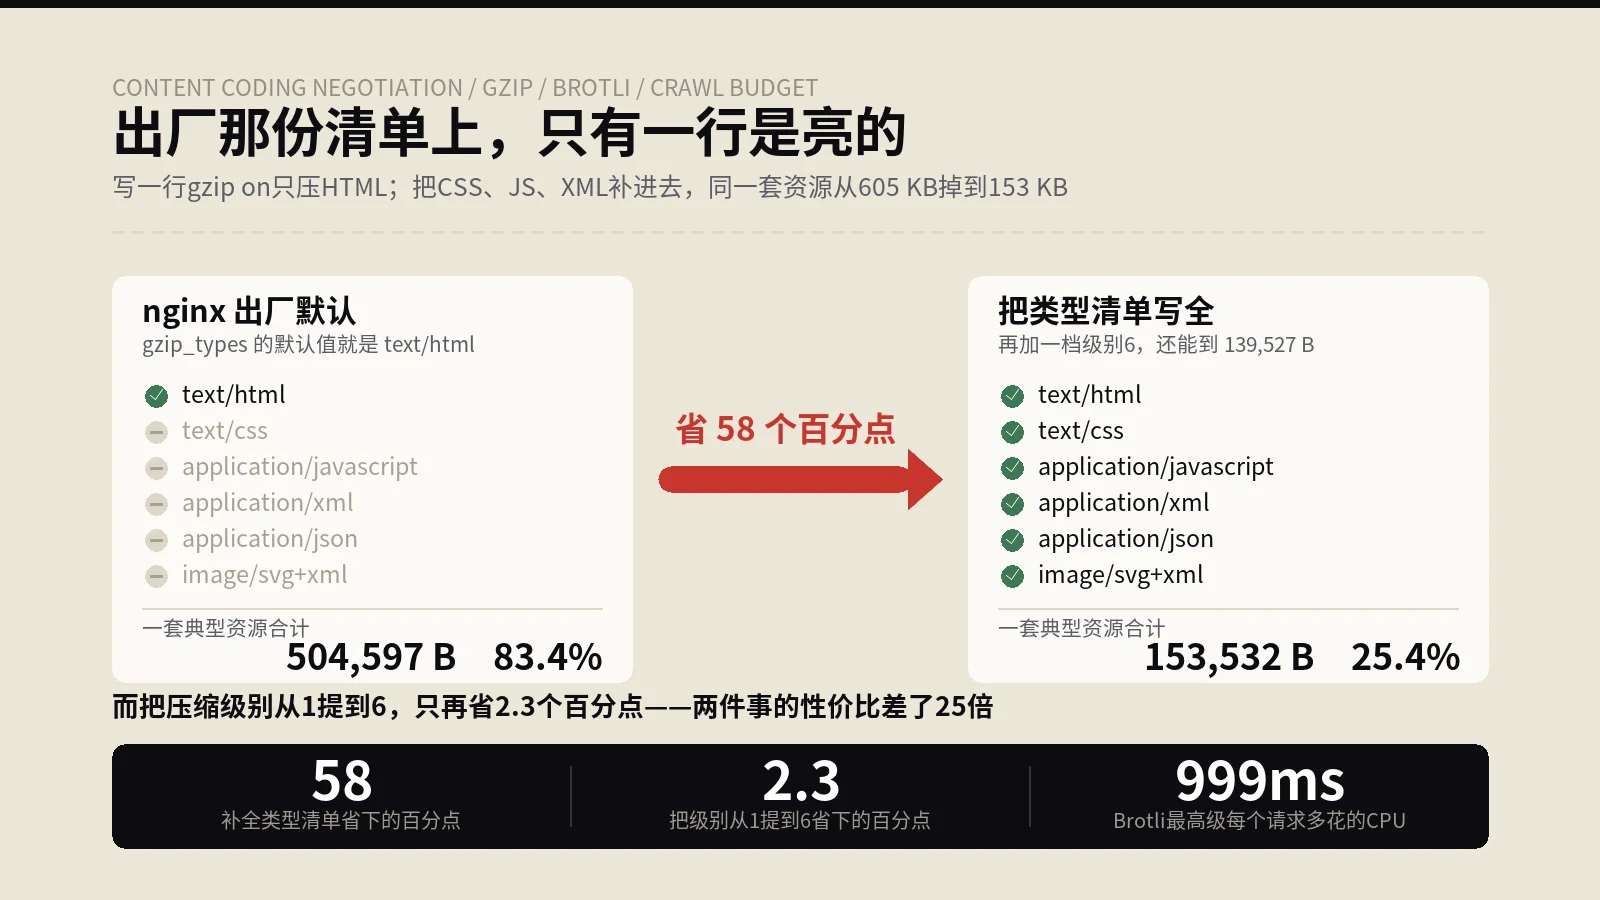
把CSS、JS、XML补进类型清单,一套典型资源从605 KB降到153 KB;再把压缩级别从1提到6,只多省2.3个百分点。两件事的性价比差了25倍,而绝大多数教程的篇幅都花在后面那件上。
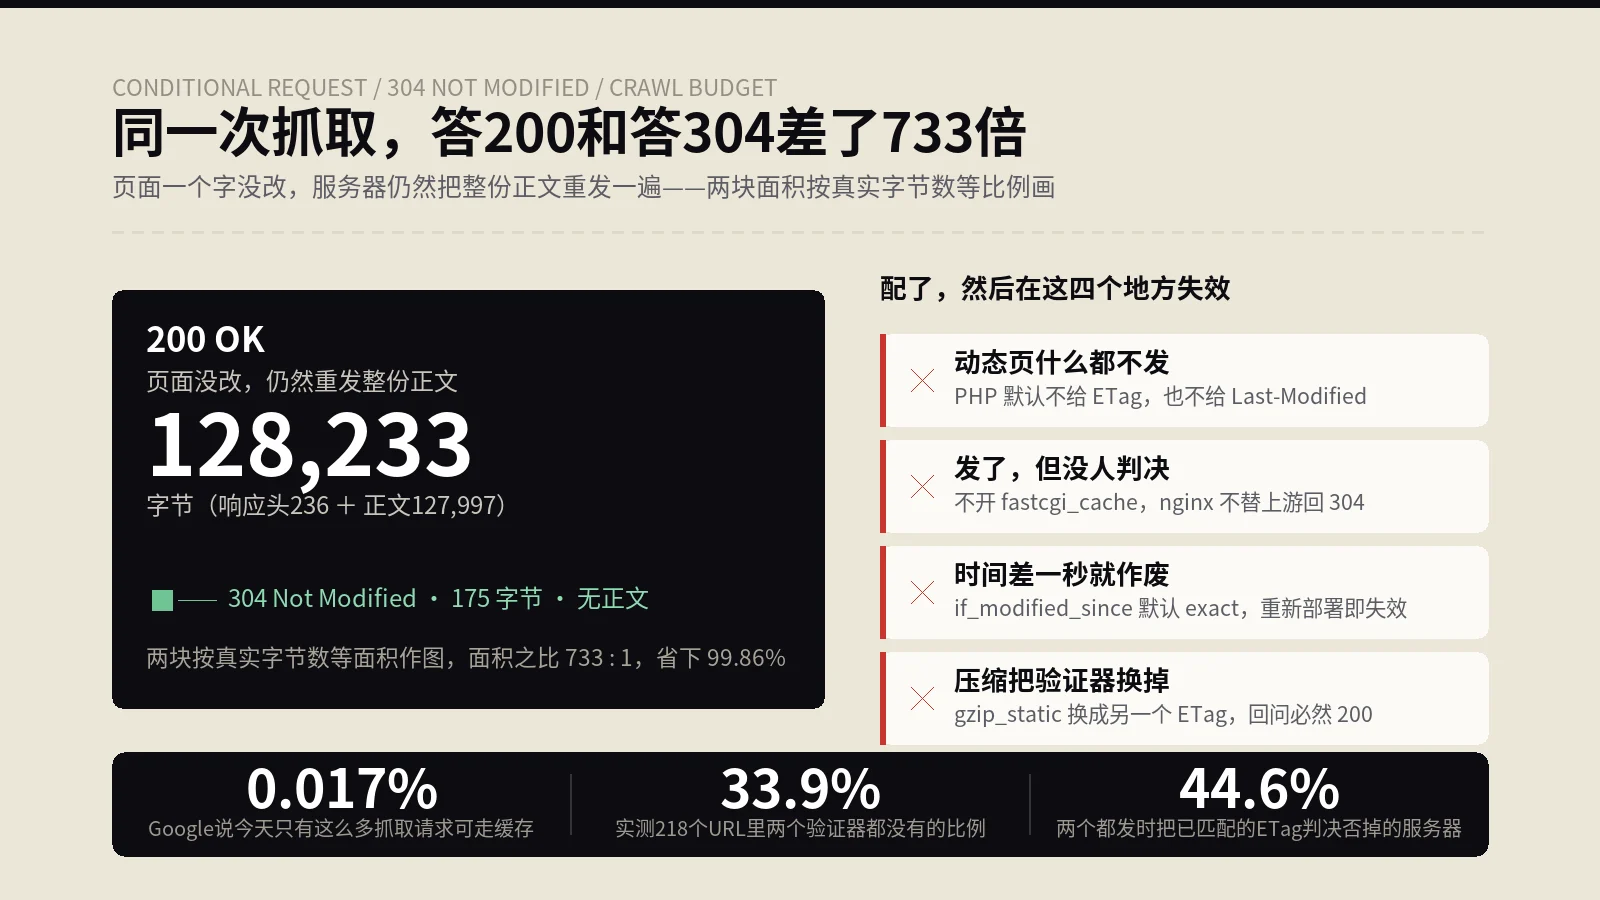
同一个页面,服务器答200要走12万字节,答304只要175字节。真正卡住的不是站长不肯配ETag,而是配完之后没有任何人告诉你它已经失效了——本文把16种服务器配置逐个打了一遍。
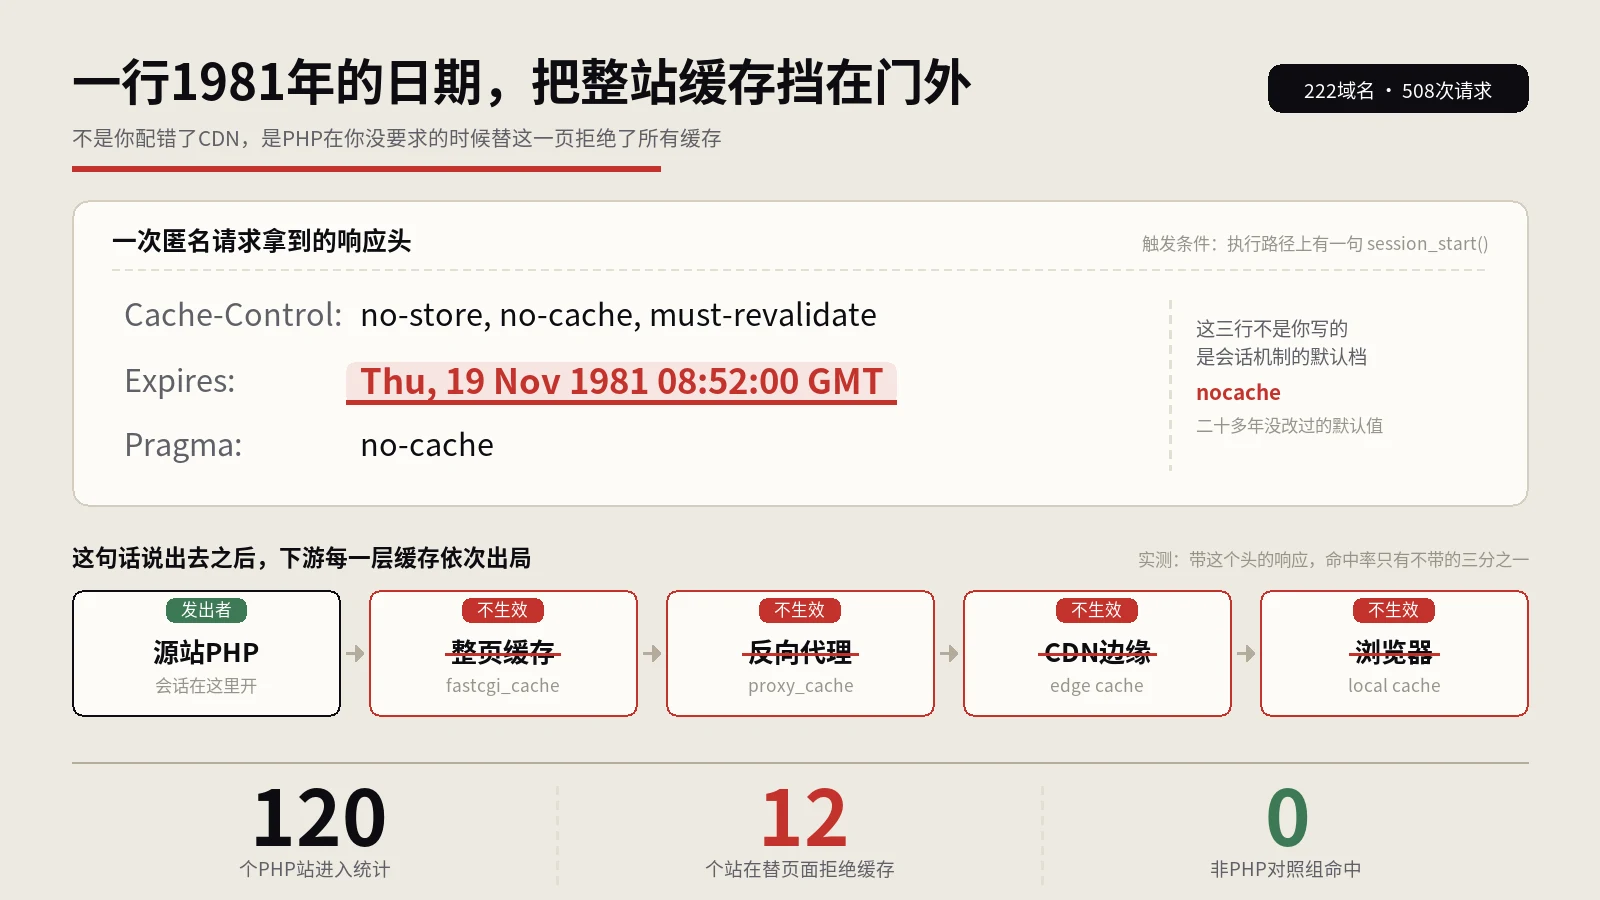
一句session_start就会让PHP自动发出no-store和一个1981年的Expires,整页缓存与CDN在这些页面上全部作废。本文用实测数据说明它为什么和页面该不该缓存无关,并给出十秒自查命令与三种修法。
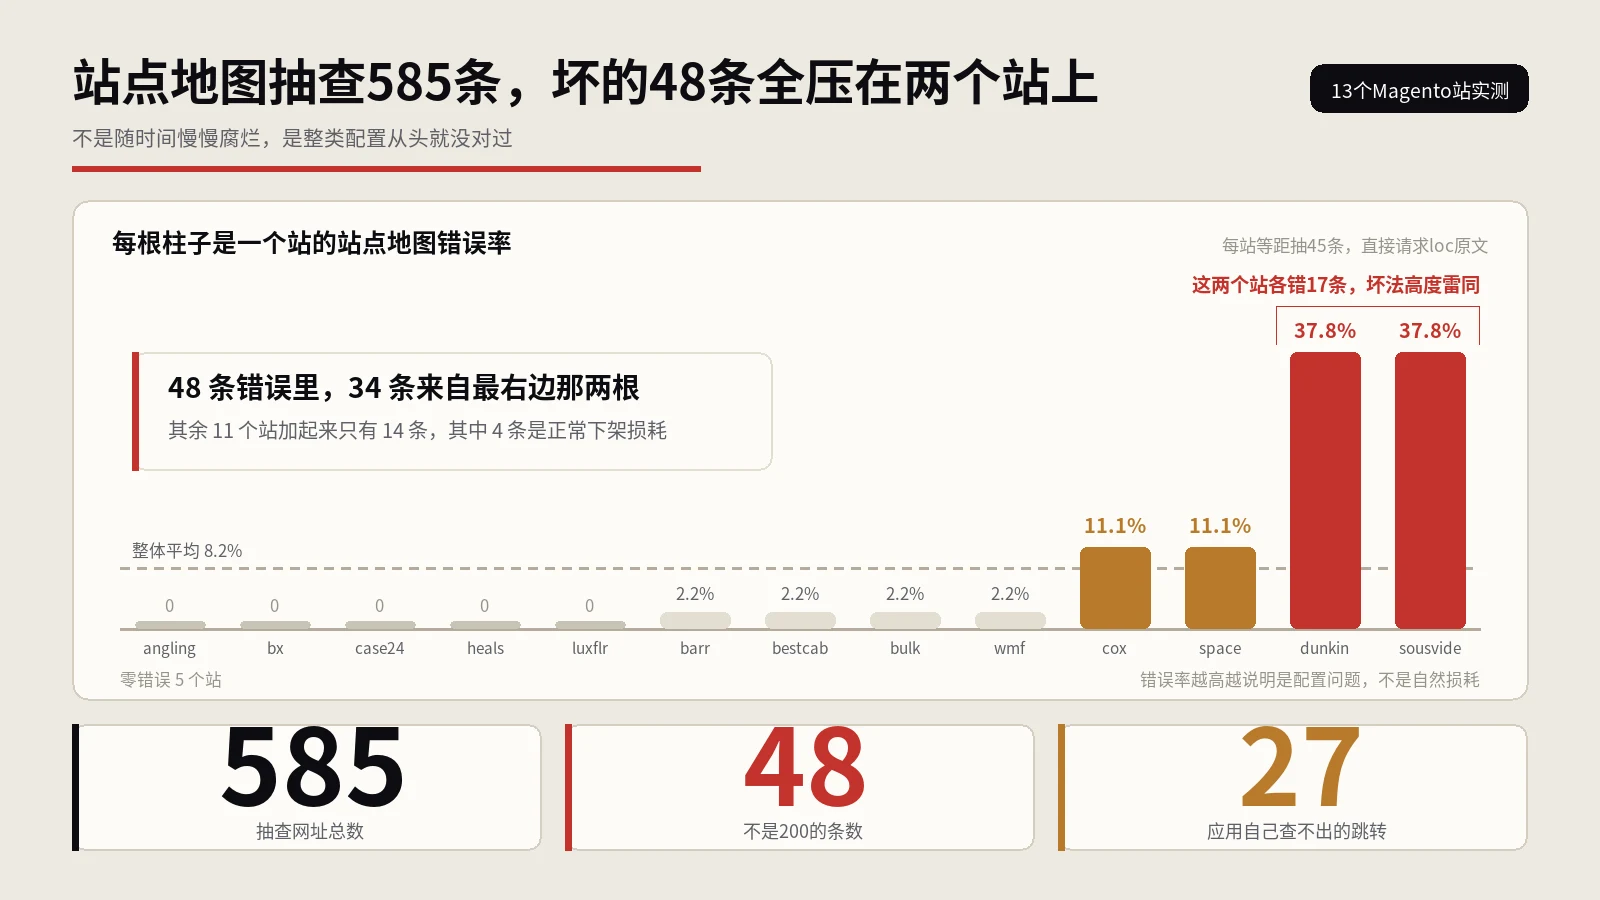
站点地图是唯一一份主动交给搜索引擎的清单,也是最少被打开检查的一份。这里给出一套不依赖付费工具的排查顺序:先确认文件本身拿得到,再统计主机名与尾斜杠形态,最后等距抽样逐条请求。
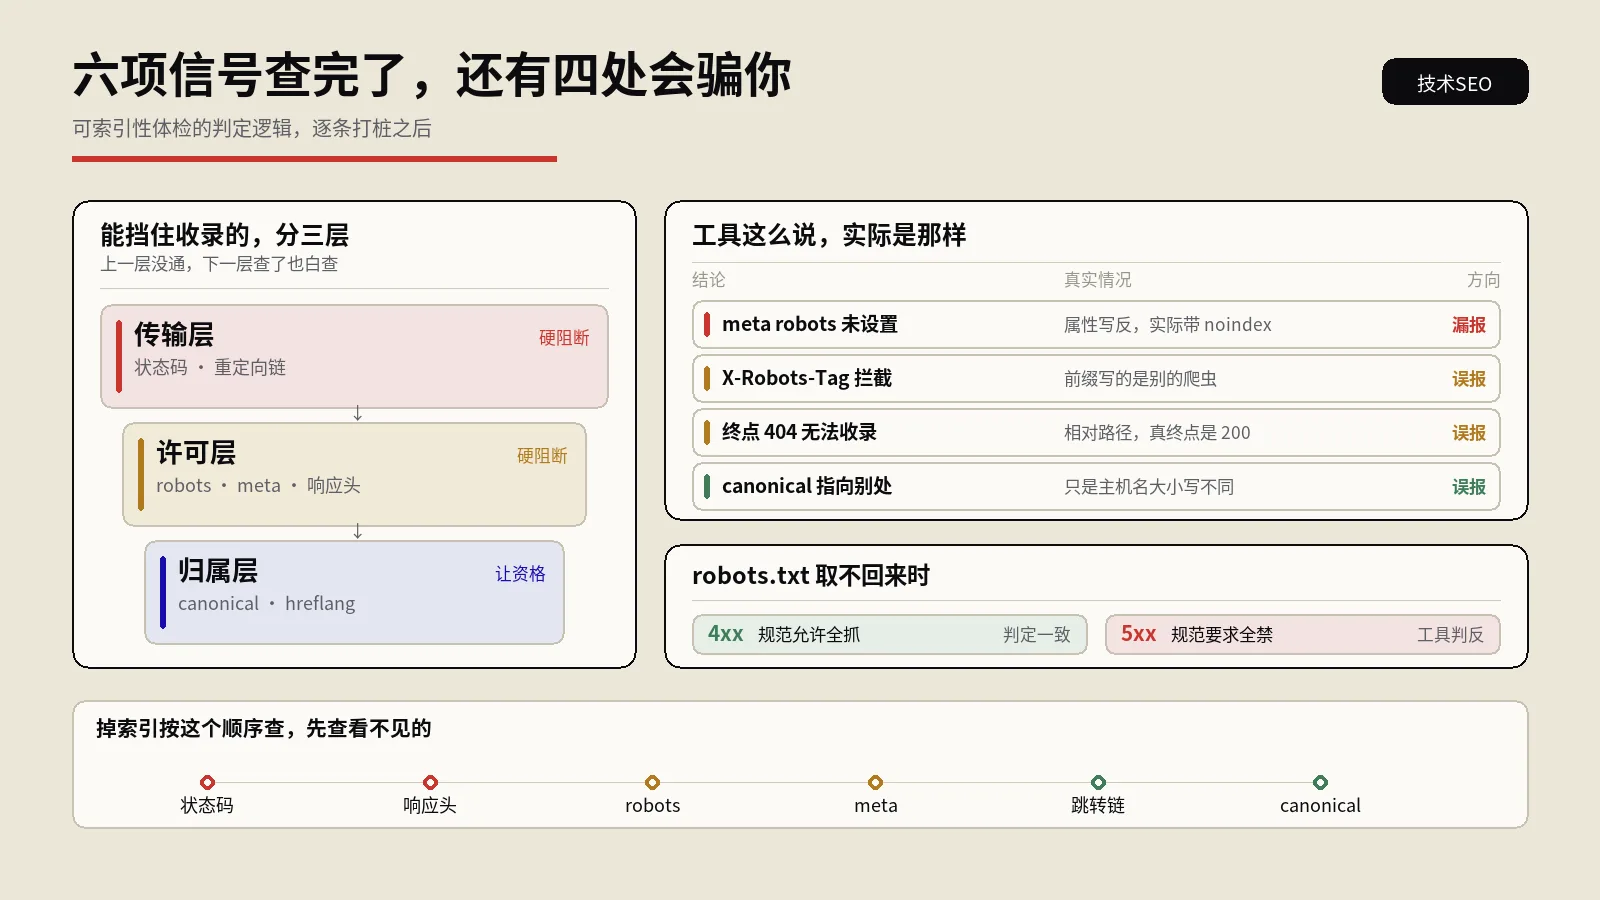
打桩实测可索引性一键体检的判定逻辑:robots规则组算得准,但meta属性写反会漏报noindex、带爬虫名前缀的响应头会误报、相对路径跳转结论会翻车。
机器识别页面元素靠的是角色和名称,不是外观。样式化容器冒充控件时,它在结构里等于不存在,任务因此中断、信息因此答错。本文给出十分钟自查流程、七类替换动作,以及按交易路径优先的落地顺序。

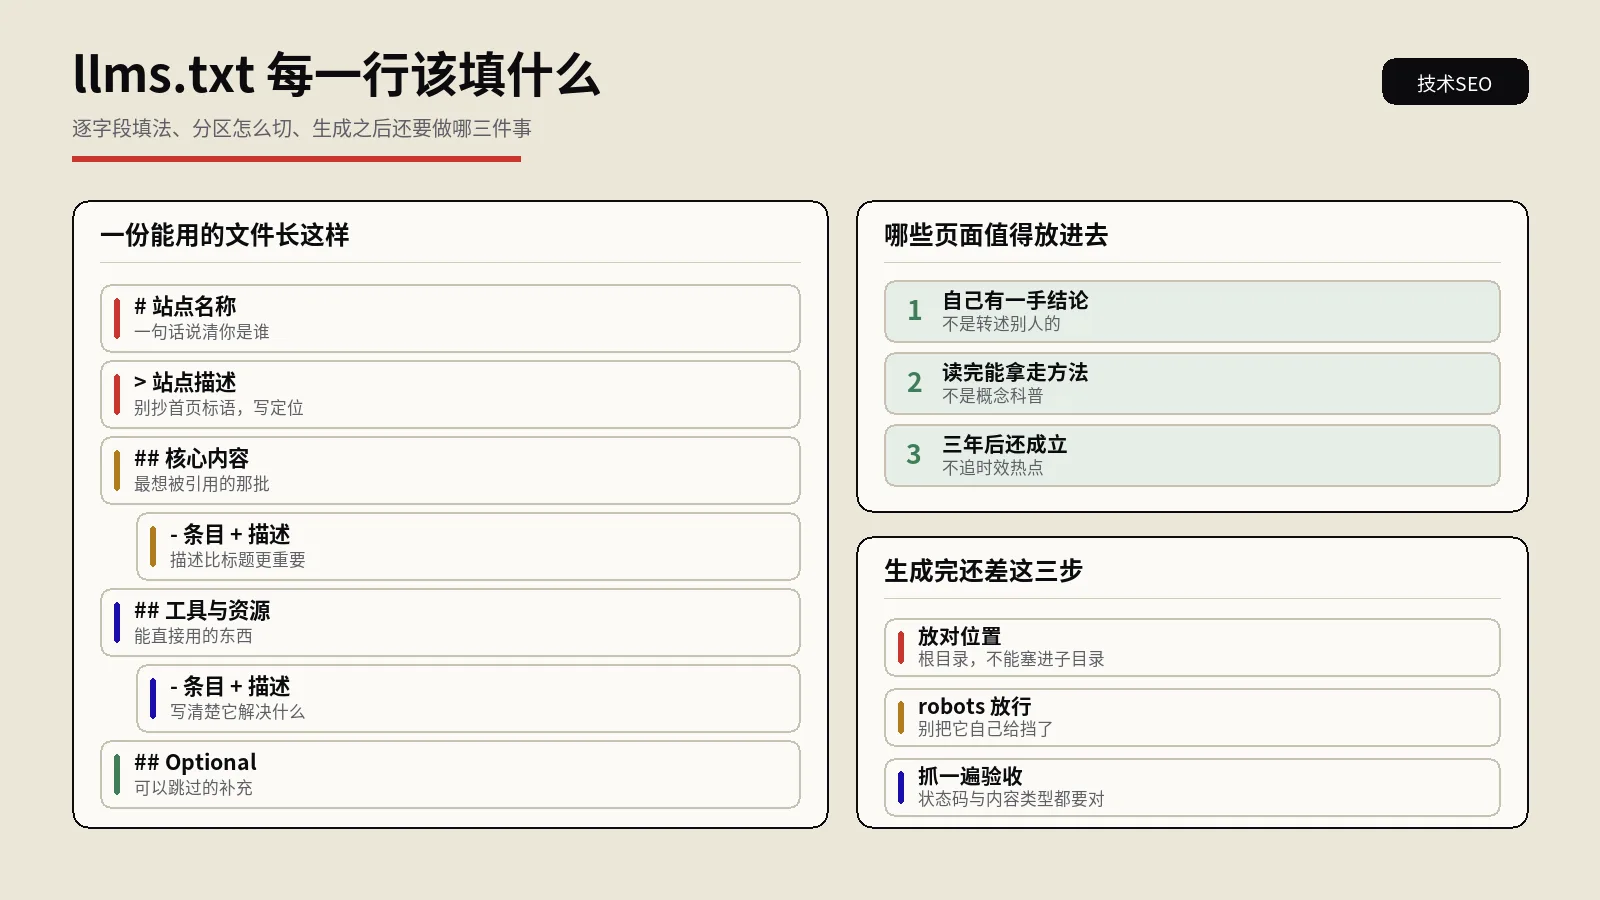
llms.txt生成器的完整用法:站点名称、描述、分区各填什么,条目描述怎么写才有信息量,选内容的三条标准,以及生成后的部署位置、robots放行与校验闭环。