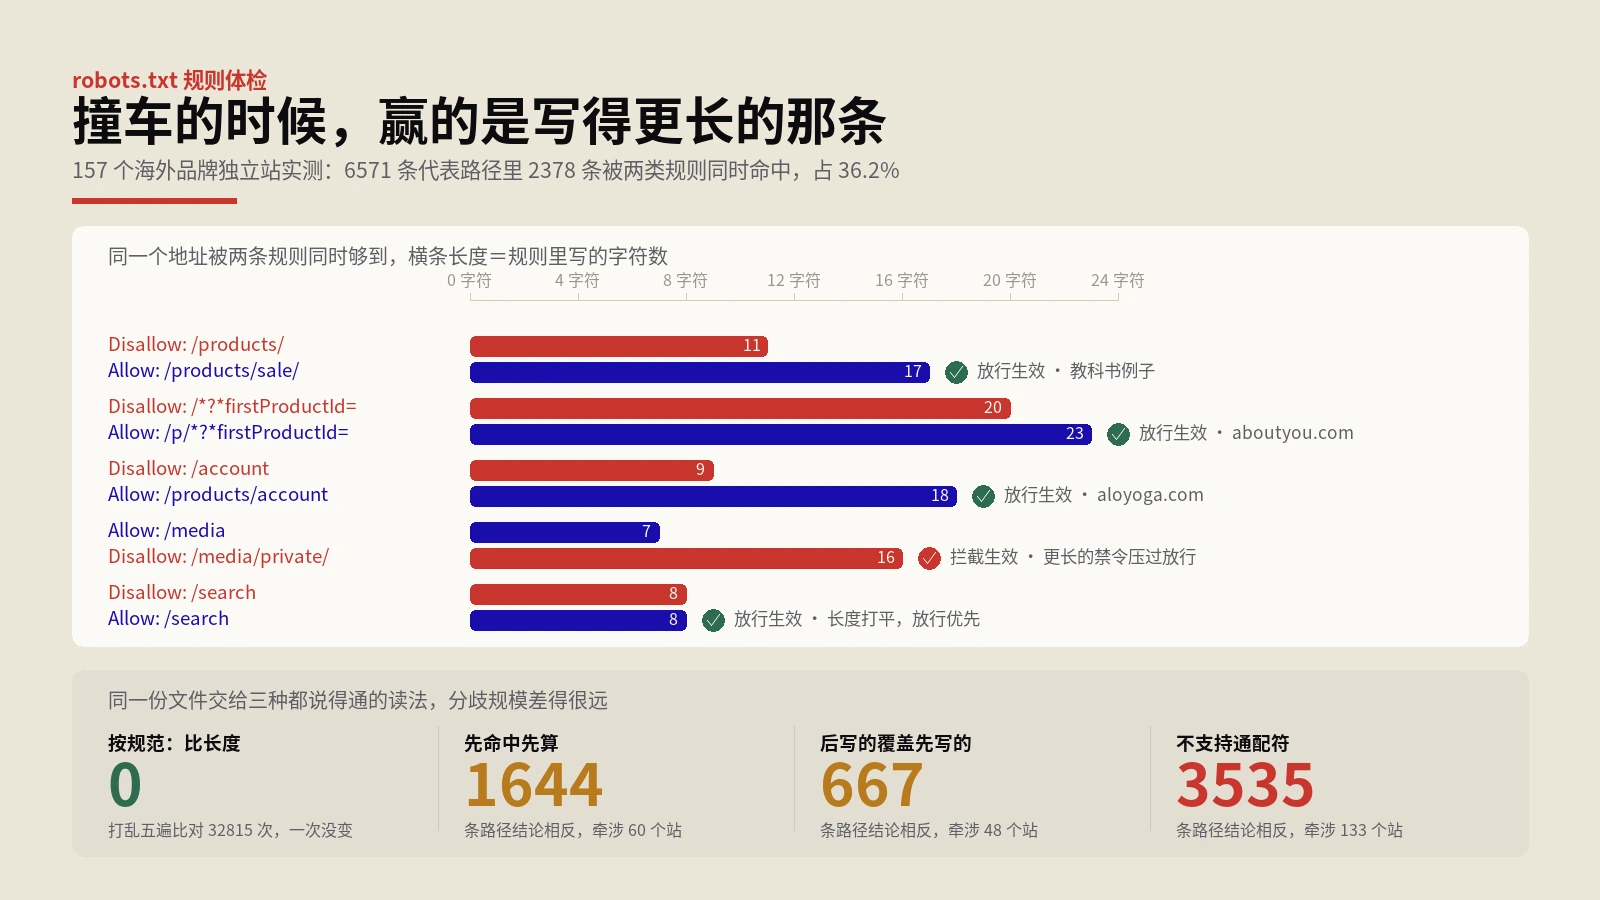
robots.txt两条规则撞车,赢的不是先写的那条
按RFC 9309从零实现一遍匹配器,再用三种办法把157份robots.txt的合并效果逐条判出来:给每条规则生成一个一定能匹配的代表路径,做删除实验看这条规则删掉之后判定变不变,以及把规则随机洗牌五遍验证顺序到底有没有影响。文中给出撞车率、胜负分布、空转成因分类、三种解析器读法的分歧规模,以及一套五步自查顺序和两次量错口径的完整过程。
标签
保哥笔记 技术SEO 标签下共 50 篇文章合集,含《技术SEO一堆问题先修哪个?500站实测排出来的优先》《Core Web Vitals在AI搜索时代还值不值》《电商SEO最重要的5点:从AI爬虫到accessib》等,与 Core Web Vitals、AI爬虫、结构化数据 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
按RFC 9309从零实现一遍匹配器,再用三种办法把157份robots.txt的合并效果逐条判出来:给每条规则生成一个一定能匹配的代表路径,做删除实验看这条规则删掉之后判定变不变,以及把规则随机洗牌五遍验证顺序到底有没有影响。文中给出撞车率、胜负分布、空转成因分类、三种解析器读法的分歧规模,以及一套五步自查顺序和两次量错口径的完整过程。
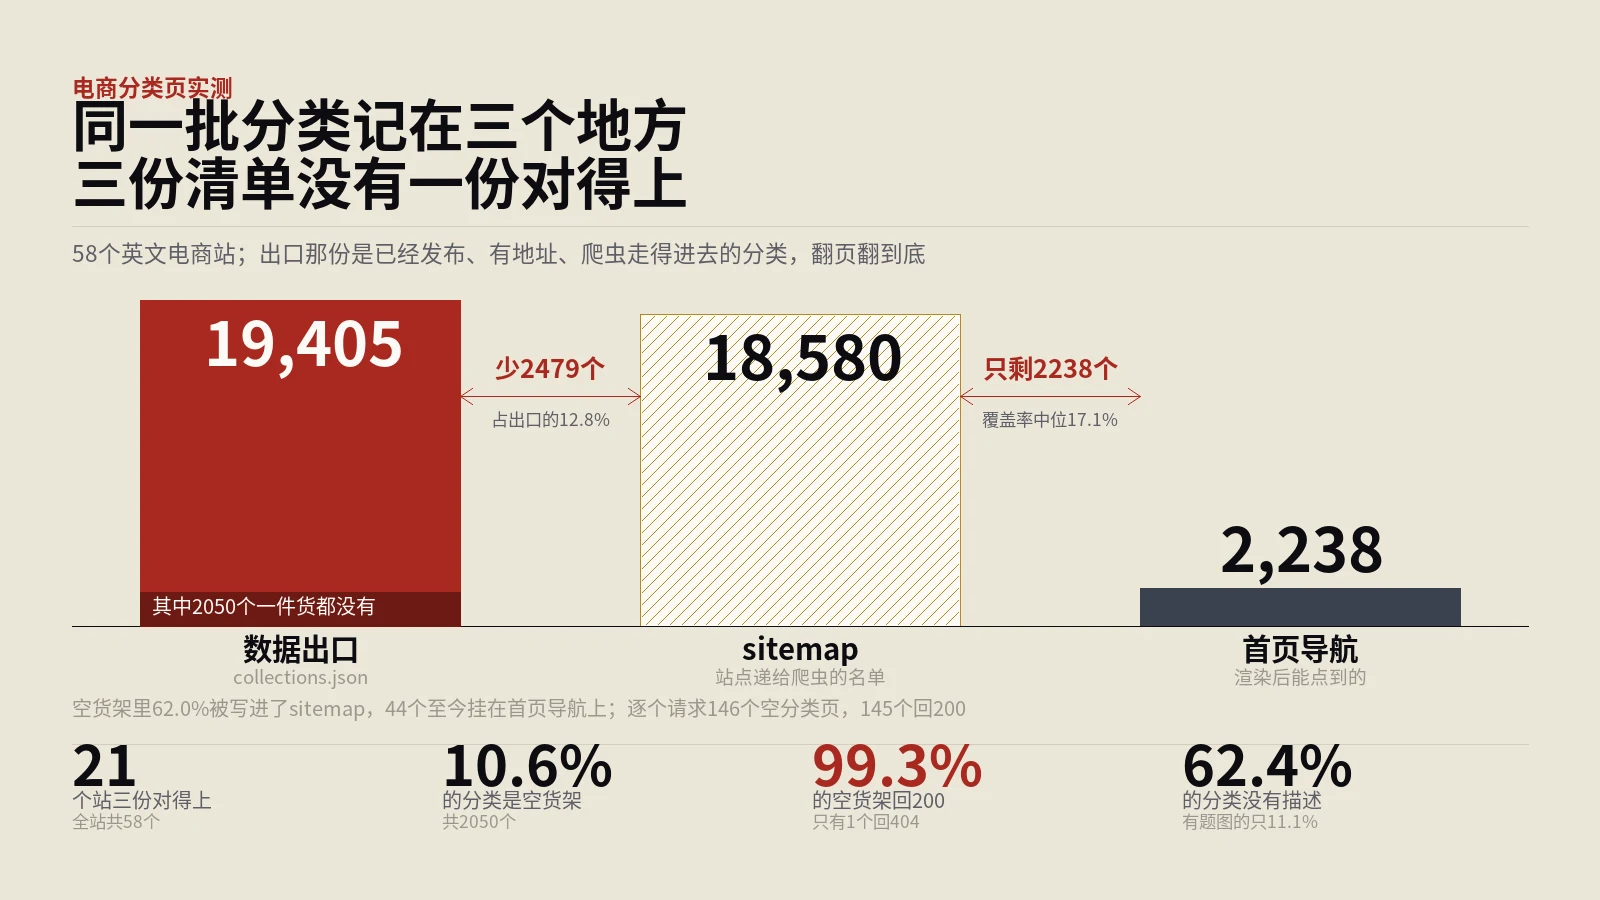
做法是把同一批分类从三条独立路径各取一份清单:不用登录就能读的分类出口、站点递给爬虫的sitemap、以及首页渲染后DOM里能点到的链接。sitemap那一份要按语言分卷拆开只取根语言,否则翻译过的handle会被算成另一批;导航那一份不能只抓静态HTML,得用无头浏览器渲染后取并集。空货架的判定不数页面上的商品链接,改用商品清单接口加浏览器里正文区可见的商品卡两条一起看。
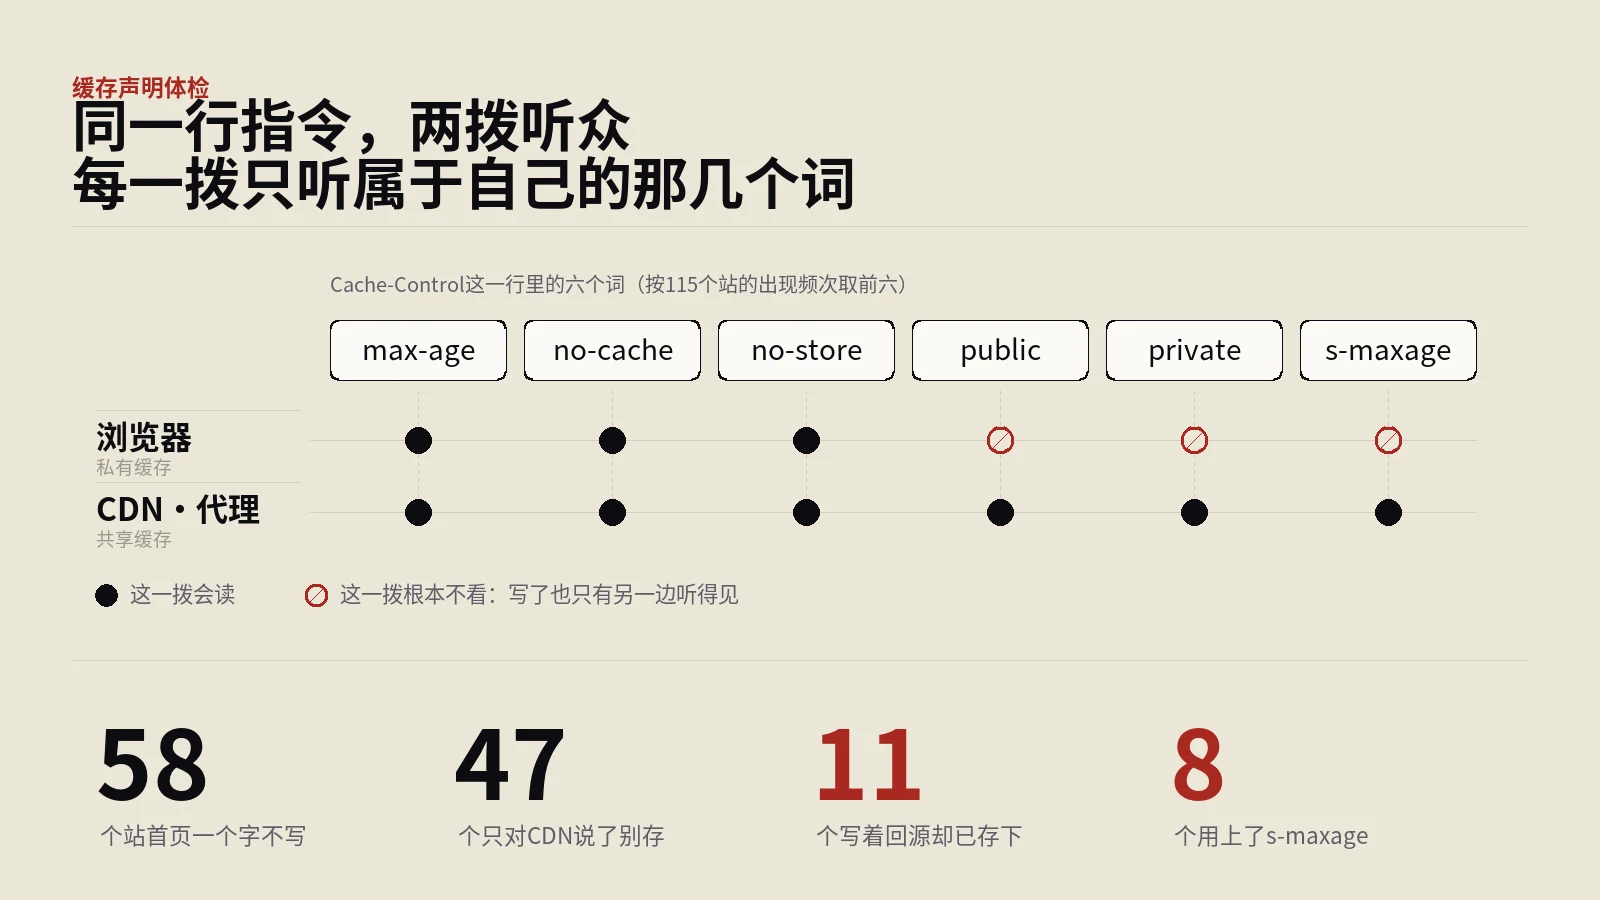
量法是每个站的首页连打三次、再各取一个CSS、一个JS、一张图片、一个网站图标和robots.txt,逐个记下全部缓存相关响应头,用Age字段反查谁真的把它存下来过。尺子中途出过两次问题:并发开太高让11个站返回429,差点被读成这些站没数据;以及把不带Age当成没被缓存,而115个站里91个不带Age,其中72个带着CDN自己的命中标记。
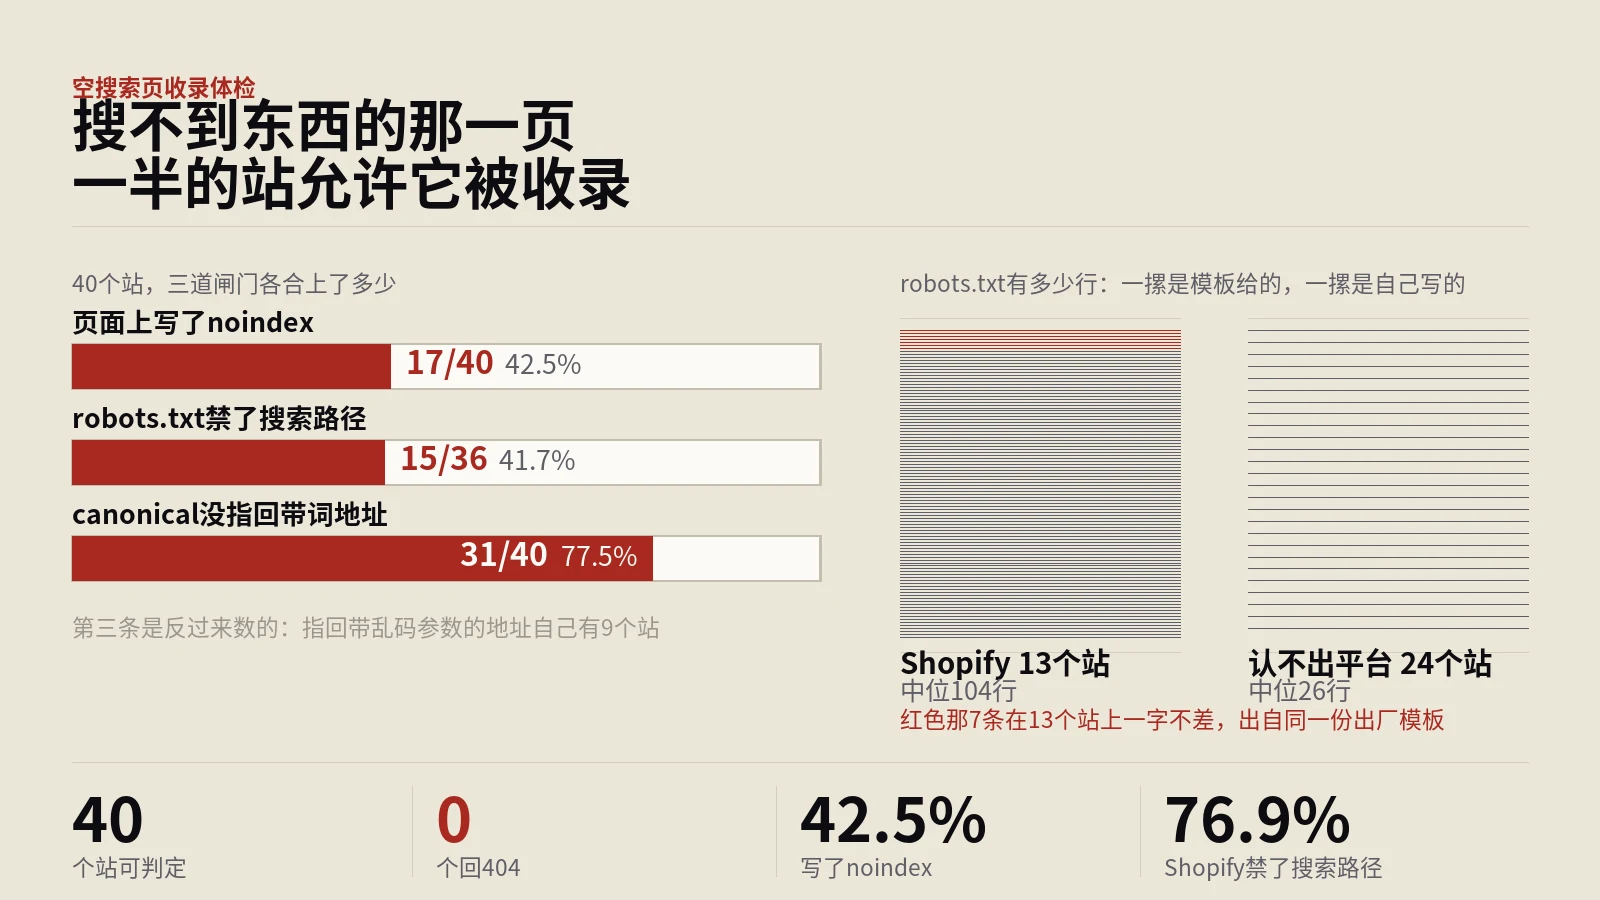
做法是拿两个乱码词加一个必然搜得到的词各请求一遍,回答不跟着变的站说明它压根没在搜,整体剔出分母,69个里剔掉了29个。归属靠覆盖率判断:同平台里覆盖率越高的指令,越可能来自出厂模板。
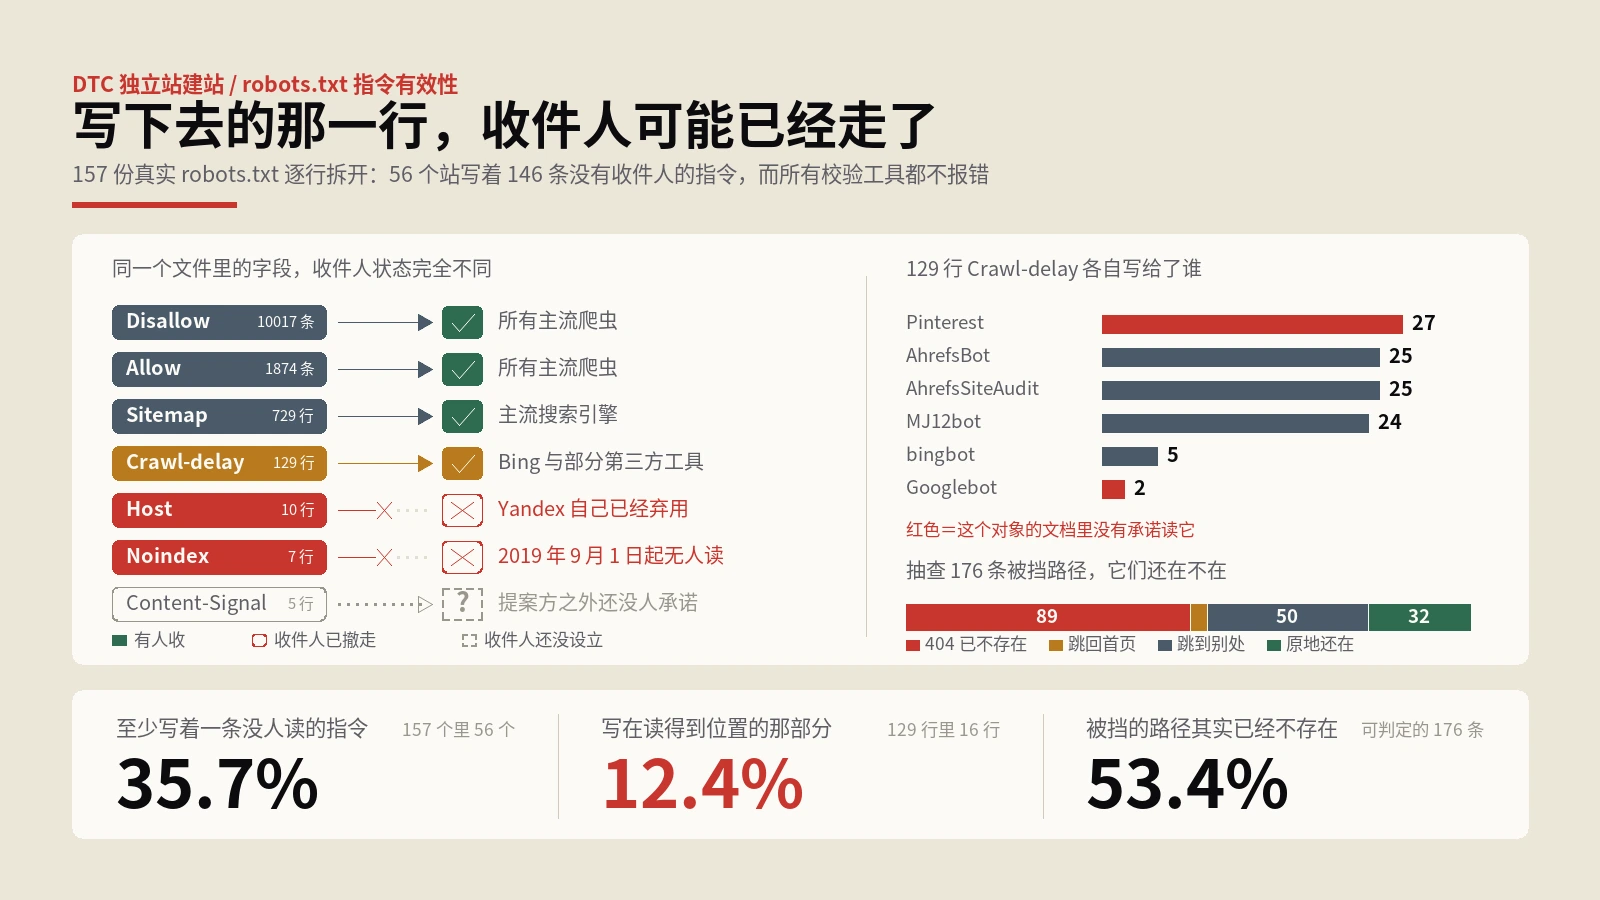
给robots.txt做一次收件人体检的量法:先把字段名去重列出来,多出常规四五种的逐个查谁在读;再比通配组与专属组的条数差;抽三条具体路径实际请求看还在不在;最后把依据和日期写成注释留下。含157份真实文件的逐字段实测、四步自查清单与两种服务端替代写法。
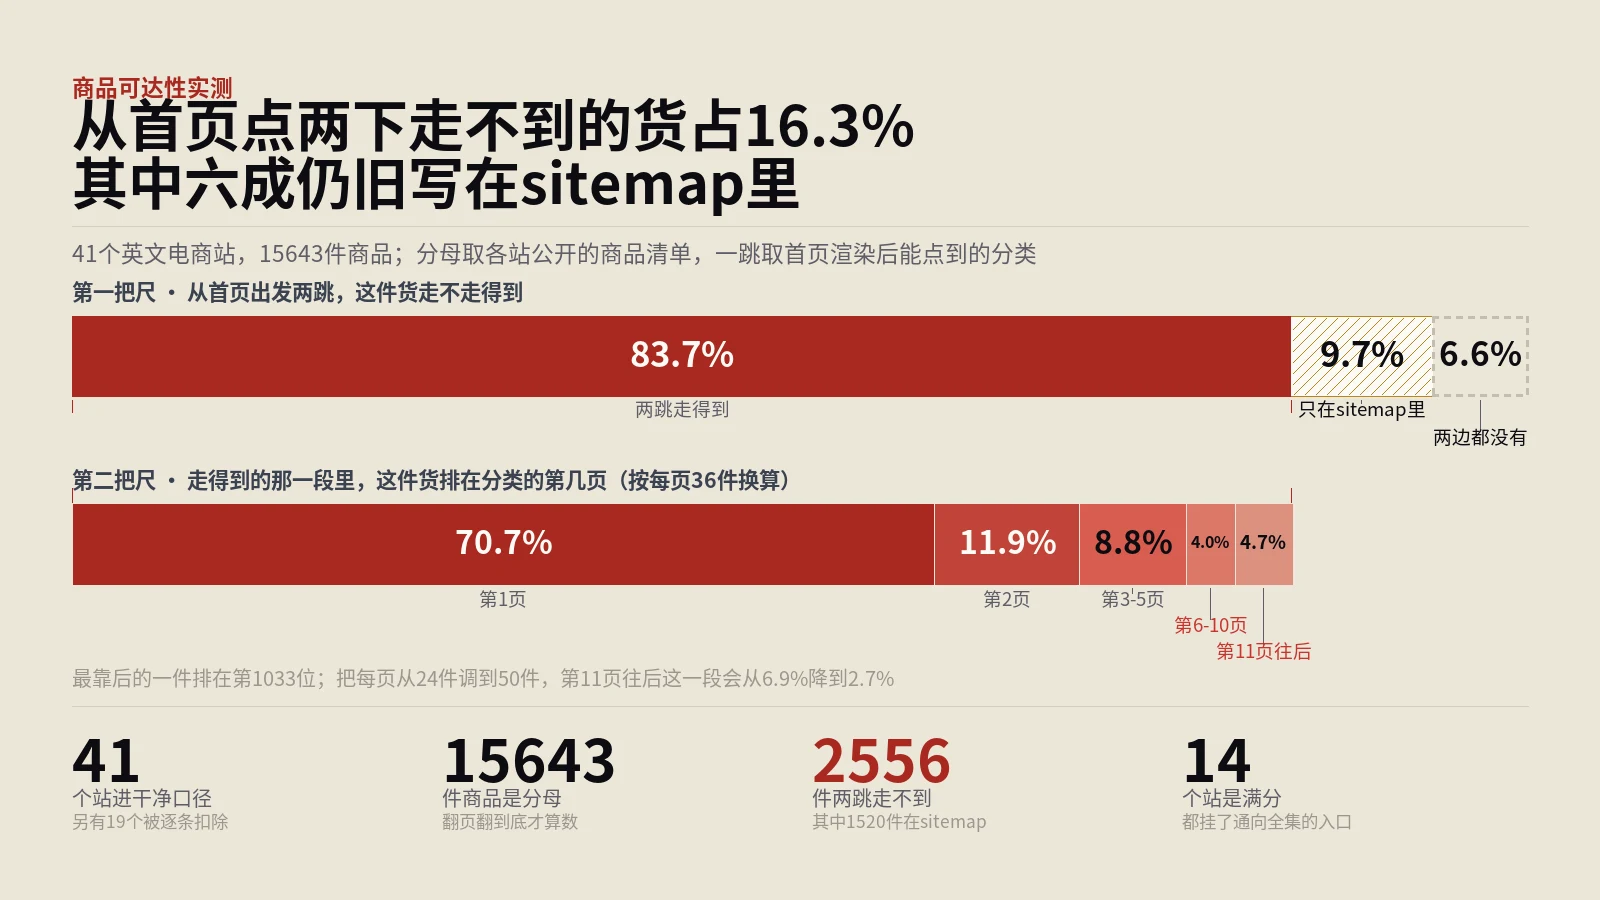
实验台分三层搭:分母取各站公开的商品清单接口并翻页到底,第一跳取首页渲染后DOM里的分类链接(只用静态HTML会漏,gymshark从0变92),第二跳取这些分类各自的商品清单。名次按商品在各分类里的最好位置计,再按每页24、36、50三档分别换算页码,不预设某个站用了哪一档。逐条扣掉地区路由、变体级伪商品、语言分卷重复、翻页截断、导航不走collections路径这五类干扰,60个候选站最后41个进干净口径。
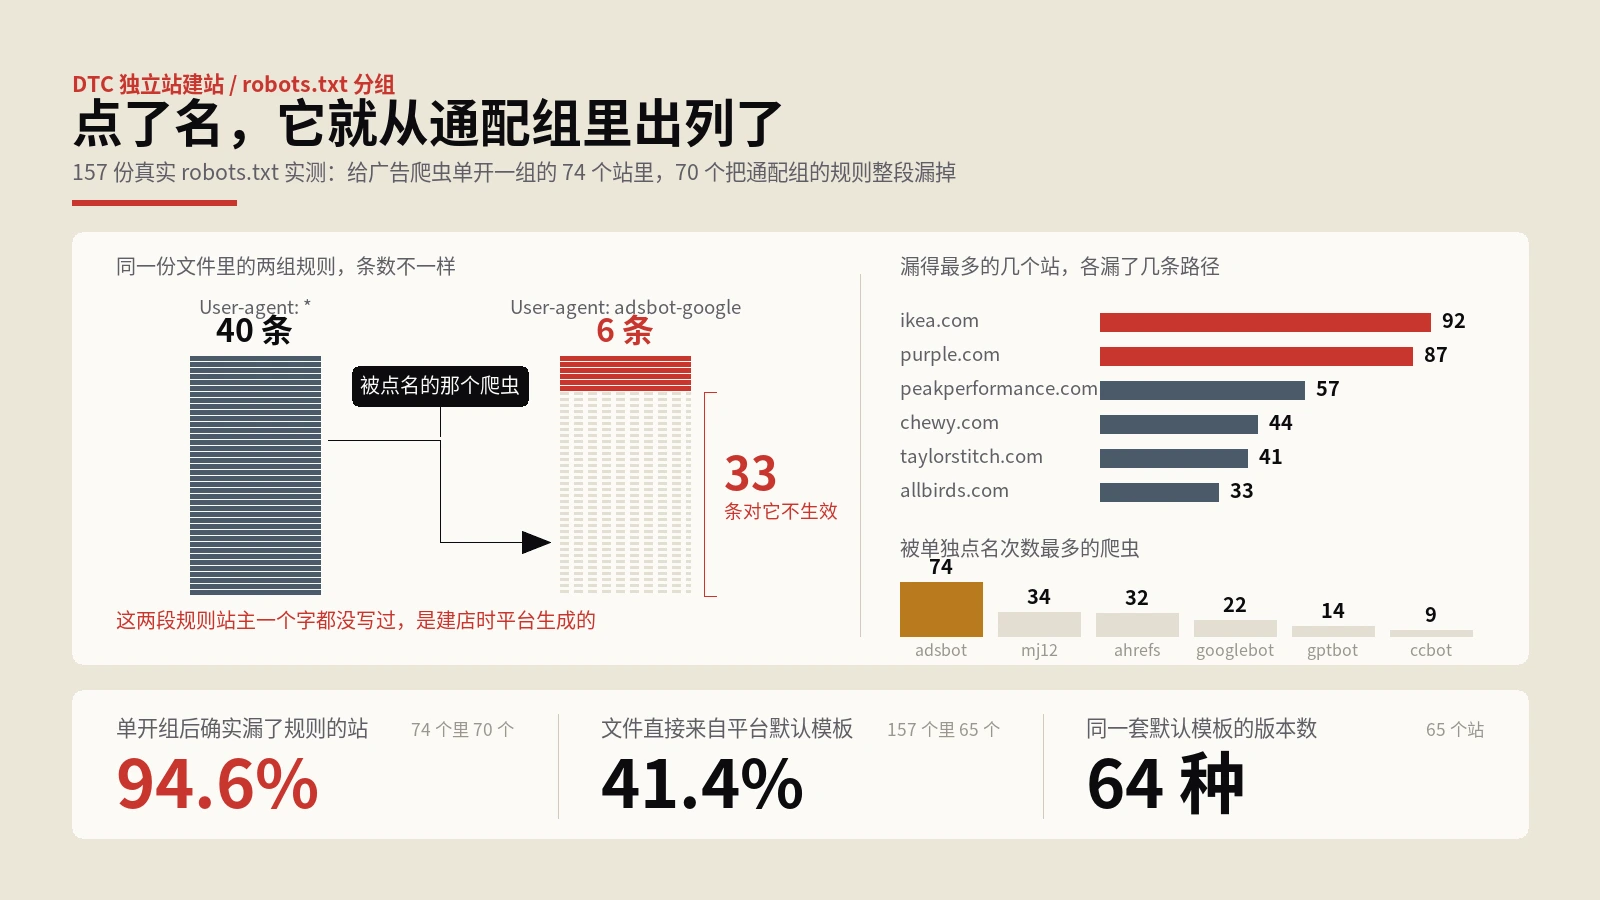
给robots.txt做一次分组体检的完整量法:先数通配组的Disallow条数,再数每个专属组的条数,两边做减法找出被漏掉的路径;接着把不会生效的Crawl-delay、Noindex、Host这类字段清掉;最后用测试工具按地址乘爬虫名做一个小矩阵逐个验证,把结果存下来当回归基线。文中给出157份真实robots.txt的实测数据、三种写法的效果对照表、五步自查清单,以及把平台默认模板接管过来之后要承担什么。
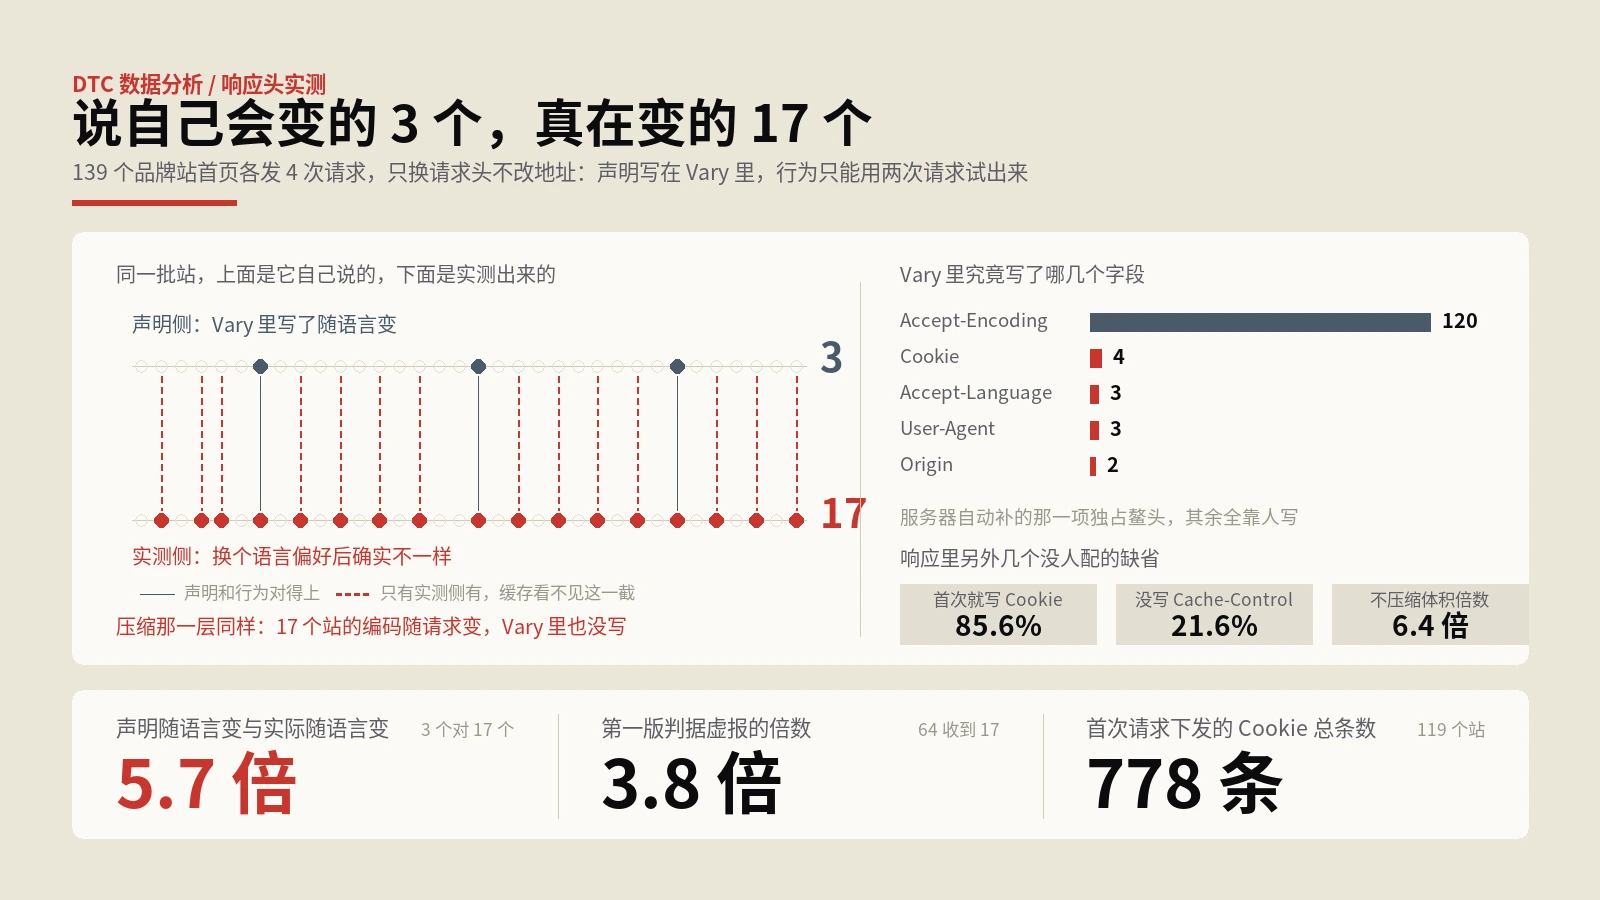
把响应的不成文缺省测出来的完整做法:对同一个地址发三次请求,分别换掉语言偏好、去掉压缩声明、保持原样,再比对最终地址、页面语言标记、标题与正文体积这四项稳定证据;拿到变化维度清单之后逐项去核对Vary头,多了删、少了补。文中给出139个站的实测分布、判据从宽到严导致数字缩水3.8倍的完整过程、五分钟版与半天版两套清单,以及修复该落在哪一层。
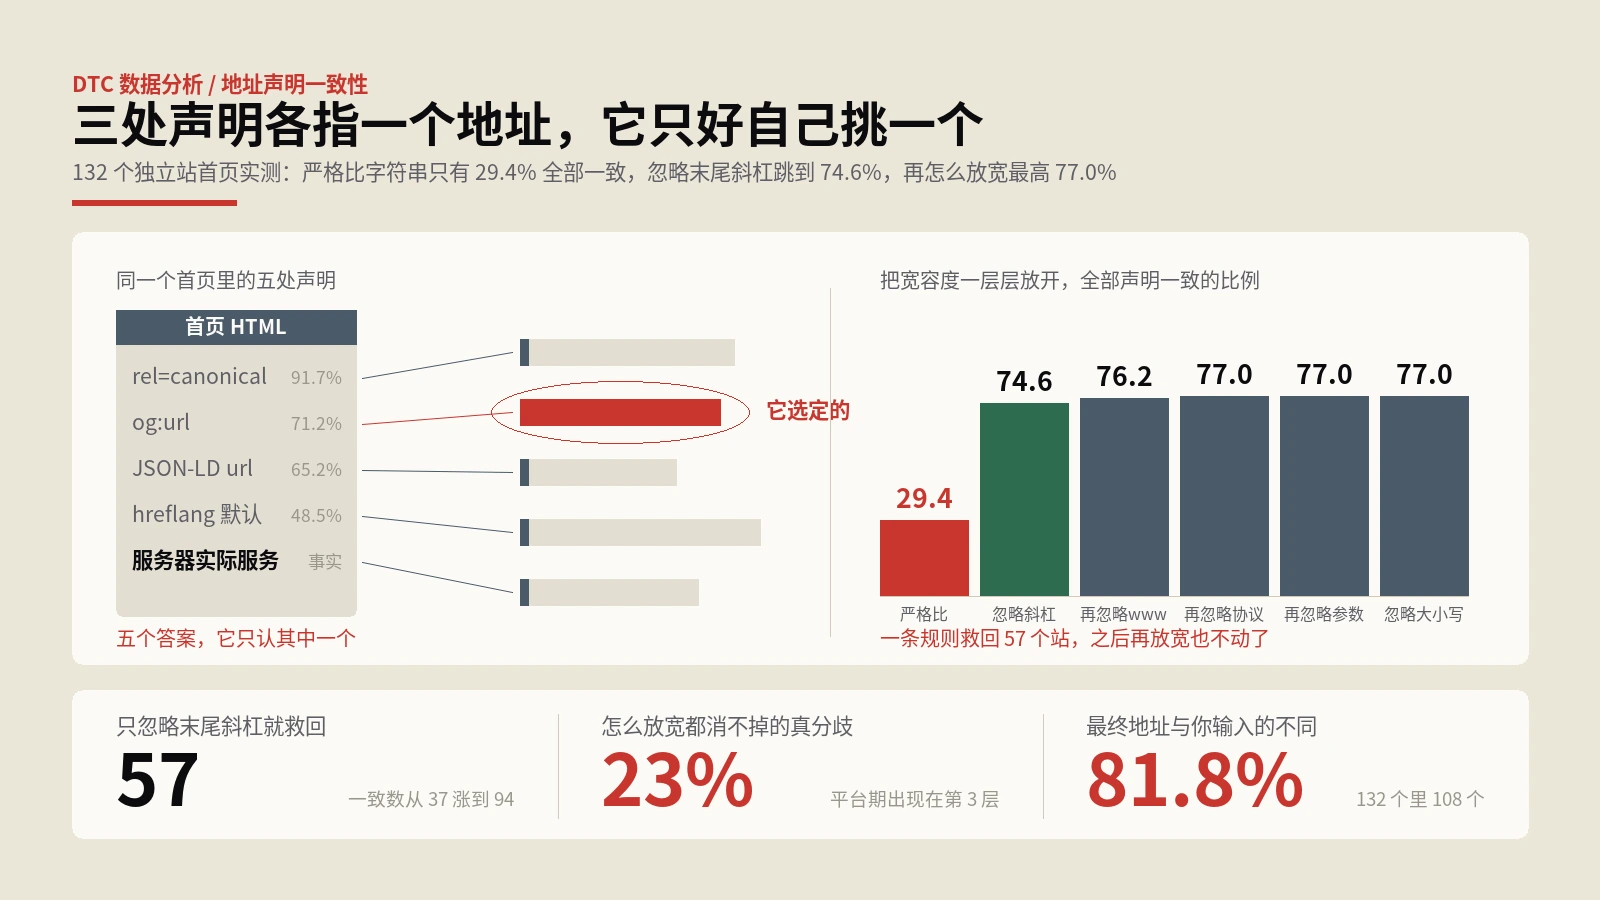
把一个页面对自己地址的所有声明抠出来做对齐,这件事有一套可复现的跑法。先取事实,用跟随跳转的请求拿到服务器实际服务的那个地址,别拿你输入的那个当基准;再从原始源码里取出规范网址、og:url、hreflang默认版本、结构化数据里的url这四处声明;然后做分层比对,第一层严格比字符串,第二层忽略末尾斜杠,第三层忽略www,记下它在哪一层变成一致,那一层就是问题的性质;最后比对站点地图,逐字符比。一个页面十分钟,全站按模板抽八到十个就够。
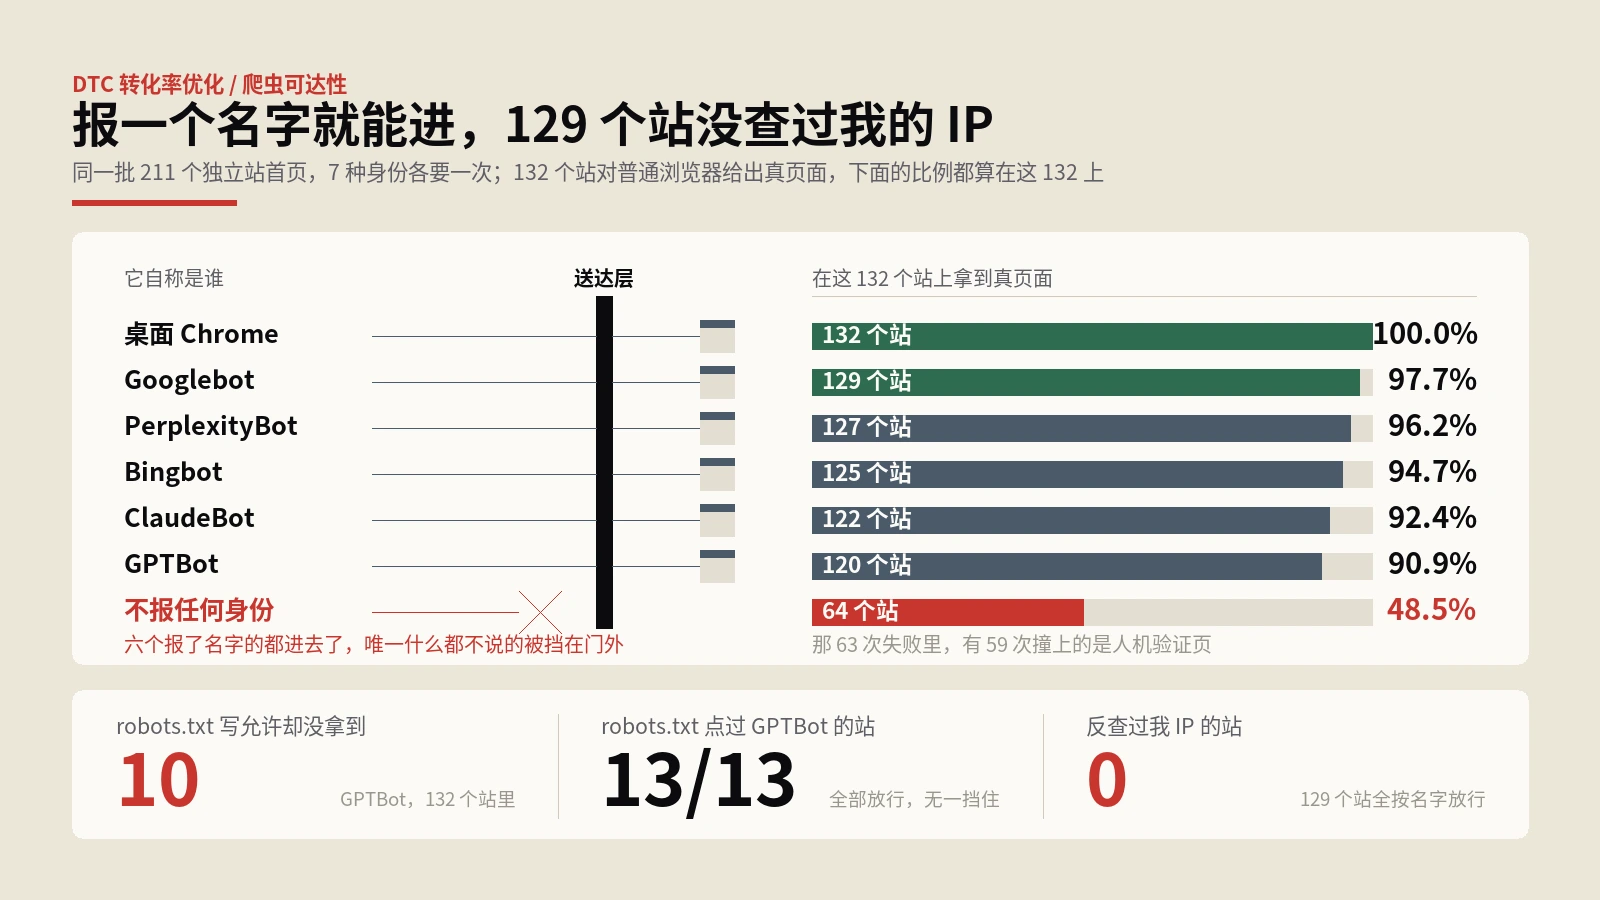
一个页面拿不到,先别急着改内容。正确的顺序是把同一个地址换几种身份各要一次,逐项比较状态码、正文字节数和最终落点,两次结果不一样就说明问题出在送达层而不是内容层。本文给出七种身份对照的完整跑法,包括基线怎么从数据内部长出来、什么算真的拿到了页面、拒绝页可以用哪四类信号自动识别、声明层与送达层的两层对齐审计怎么在半小时内做完,最后是一份每天跑一分钟、覆盖五个地址三种身份的监测清单。
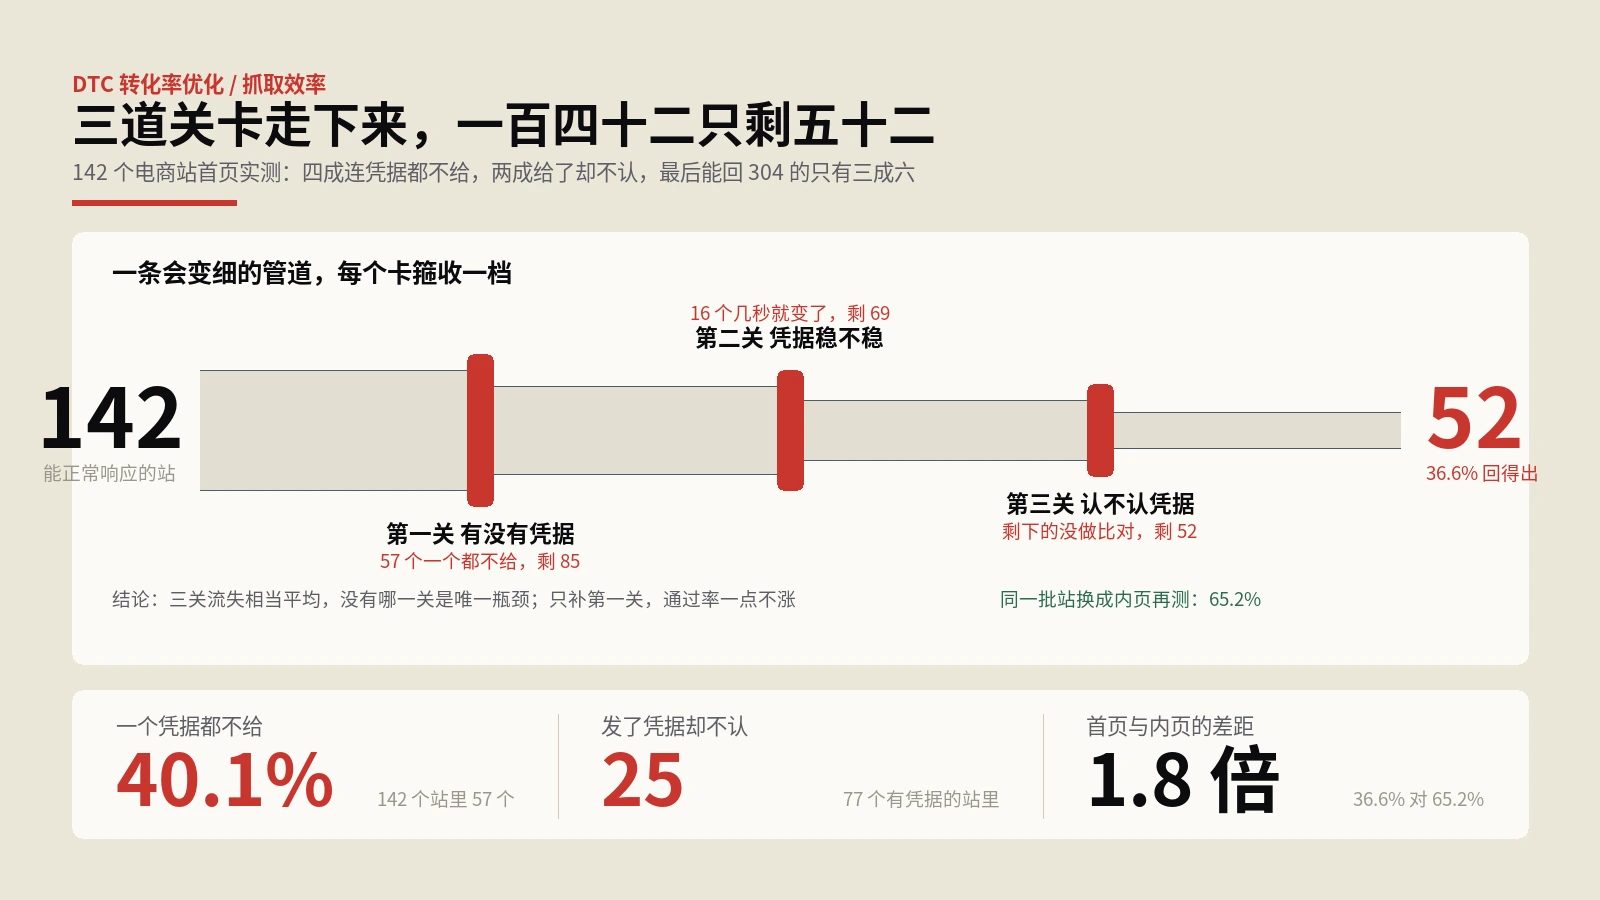
排查条件请求要按关卡来:先看响应头里有没有可以拿来协商的凭据,再连发两次看凭据稳不稳,然后带着凭据重发一次看回不回304,最后确认最后修改时间填的不是当前时刻。文中把这套顺序在211个国际化电商域名上走了一遍,逐关给出该看哪个头、判据定在哪、失败对应哪种成因,末尾附一张四种失败对应四种修法的对照表和一份三分钟自检。
排查顺序比工具重要:先抓一次首页把标签剥干净数字符,判断这一页有没有把内容交出来;正文正常再进第二层,在字节里找按钮的名字、图片的替代文本、表单标签和地标区域;只有字节里找不到、而页面上确实有的,才需要打开浏览器看渲染后的无障碍树。文中把这三层在211个国际化独立站上走了一遍,逐层交代口径怎么定、基线从哪来、哪些样本必须先剔掉,末尾给出一张行业参照表、一份分诊流程和三个能在一个下午跑完的动作。
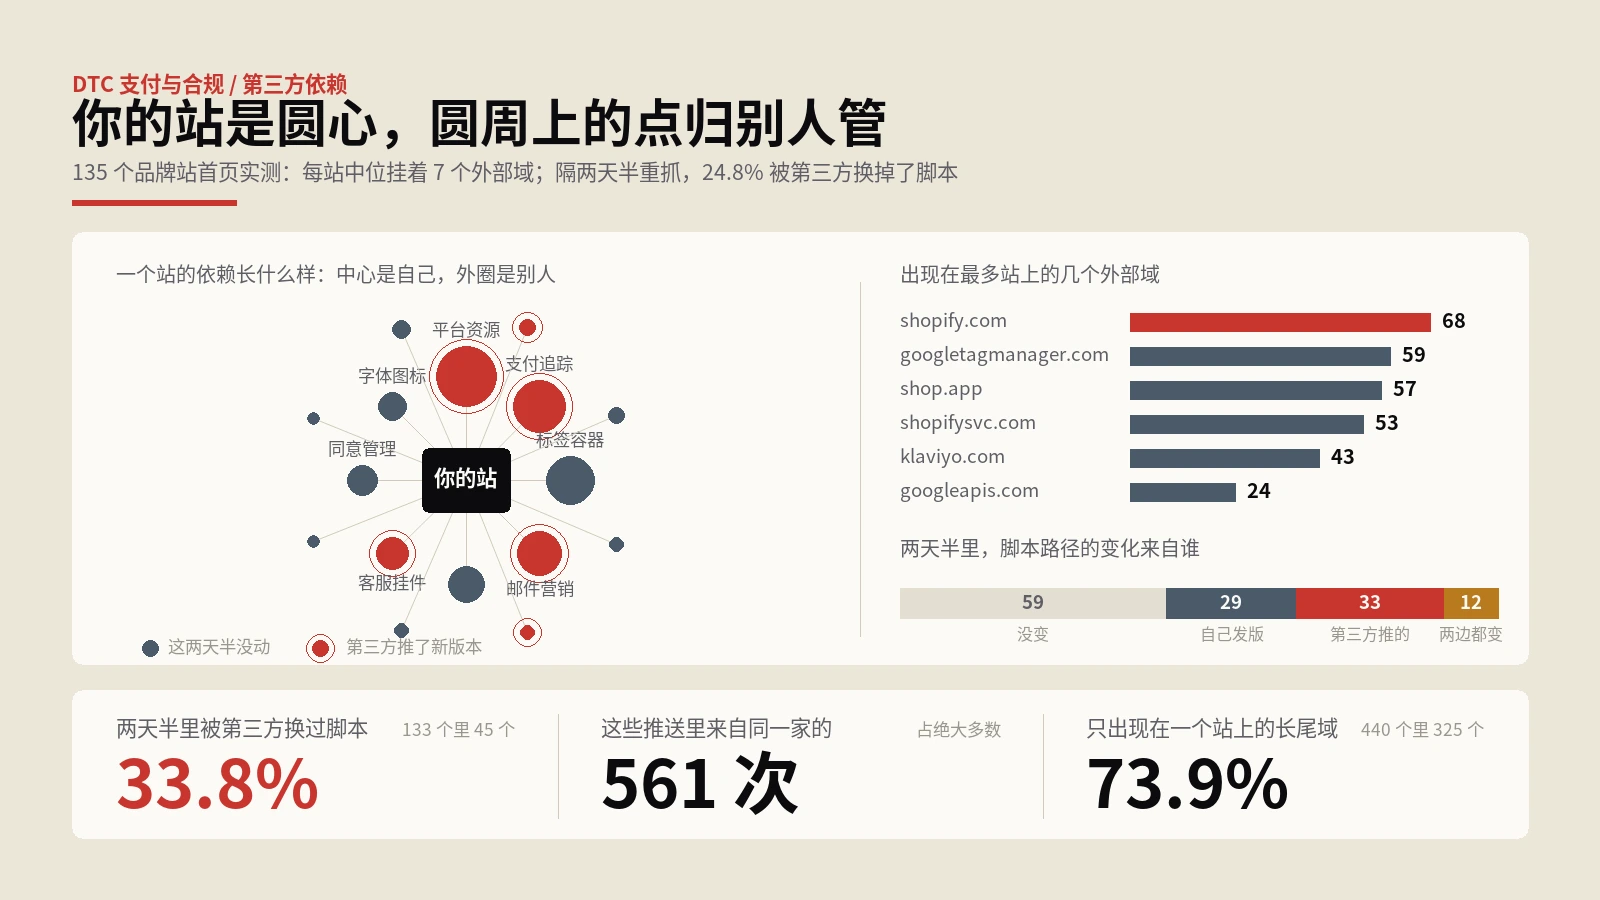
把一个站上不归自己管的部分清点出来的完整方法:先扫首页与结算流程的外部域,逐条标注归属、用途和去掉之后的后果分四档;再把清单转成内容安全策略的来源白名单;最后挂一个每日快照差分,盯住外部域清单、页面标题和结构化数据块这三个低噪声字段。文中给出135个品牌站的依赖图谱、两次快照相隔两天半的变化率拆分,以及一次删掉九个域的清理复盘。
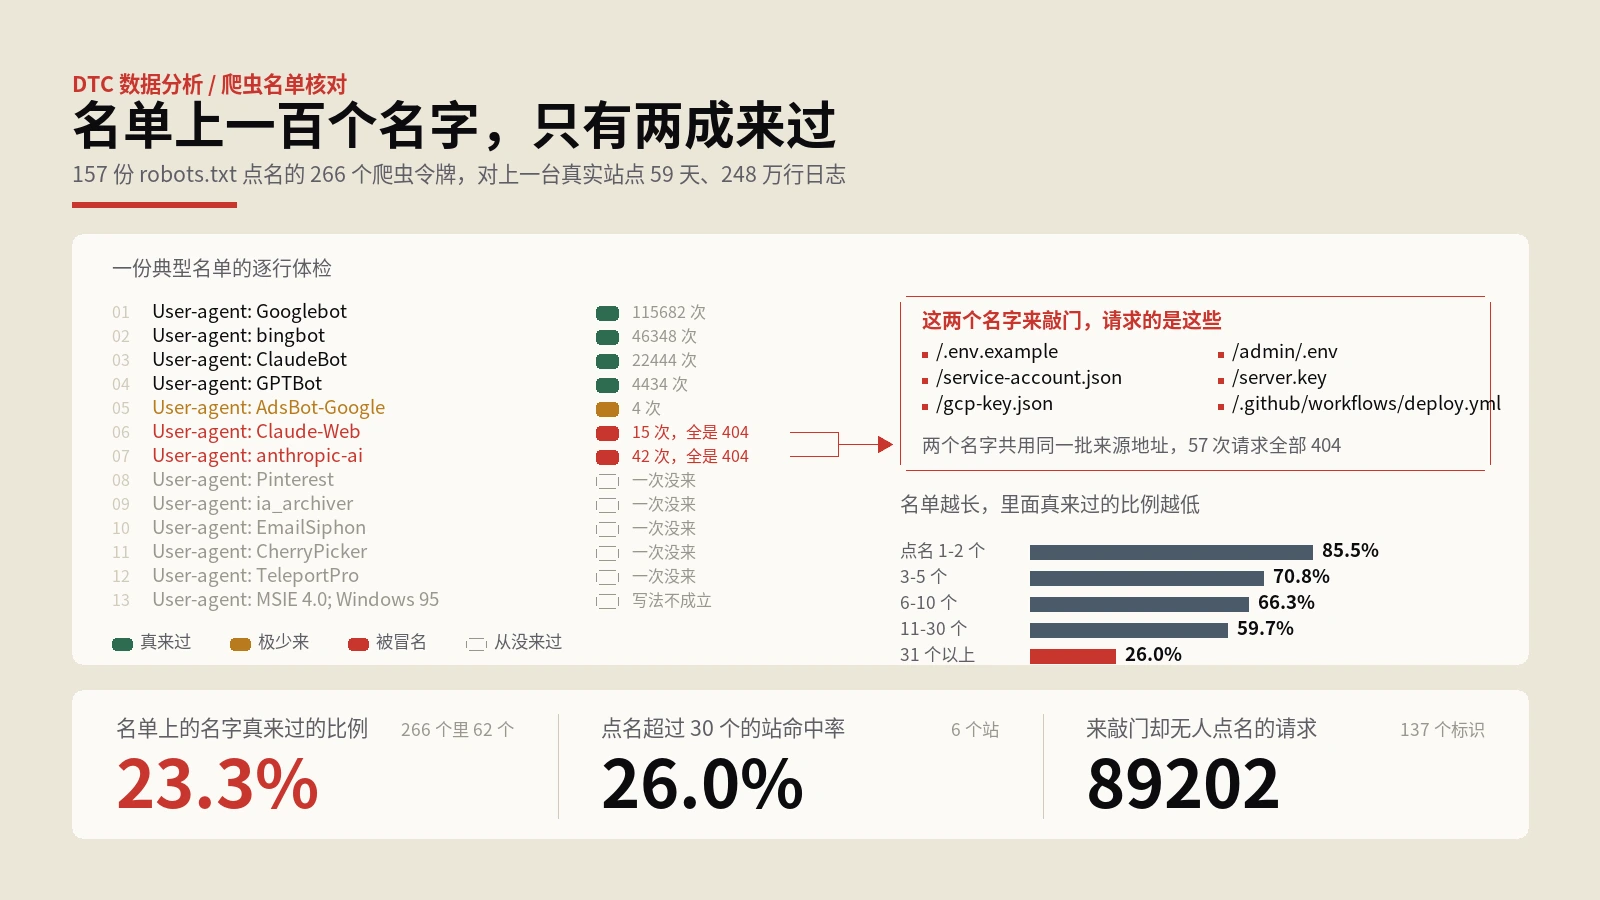
给robots.txt里的爬虫名单做一次核对的完整量法:先从访问日志提取真实来访的抓取标识,再逐个对文件里的名字算命中率,接着按用途把来过的分成五类给不同待遇,最后给每个分组补一行注明依据和日期的注释。含157份文件281个令牌与59天248万行日志的交集实测。
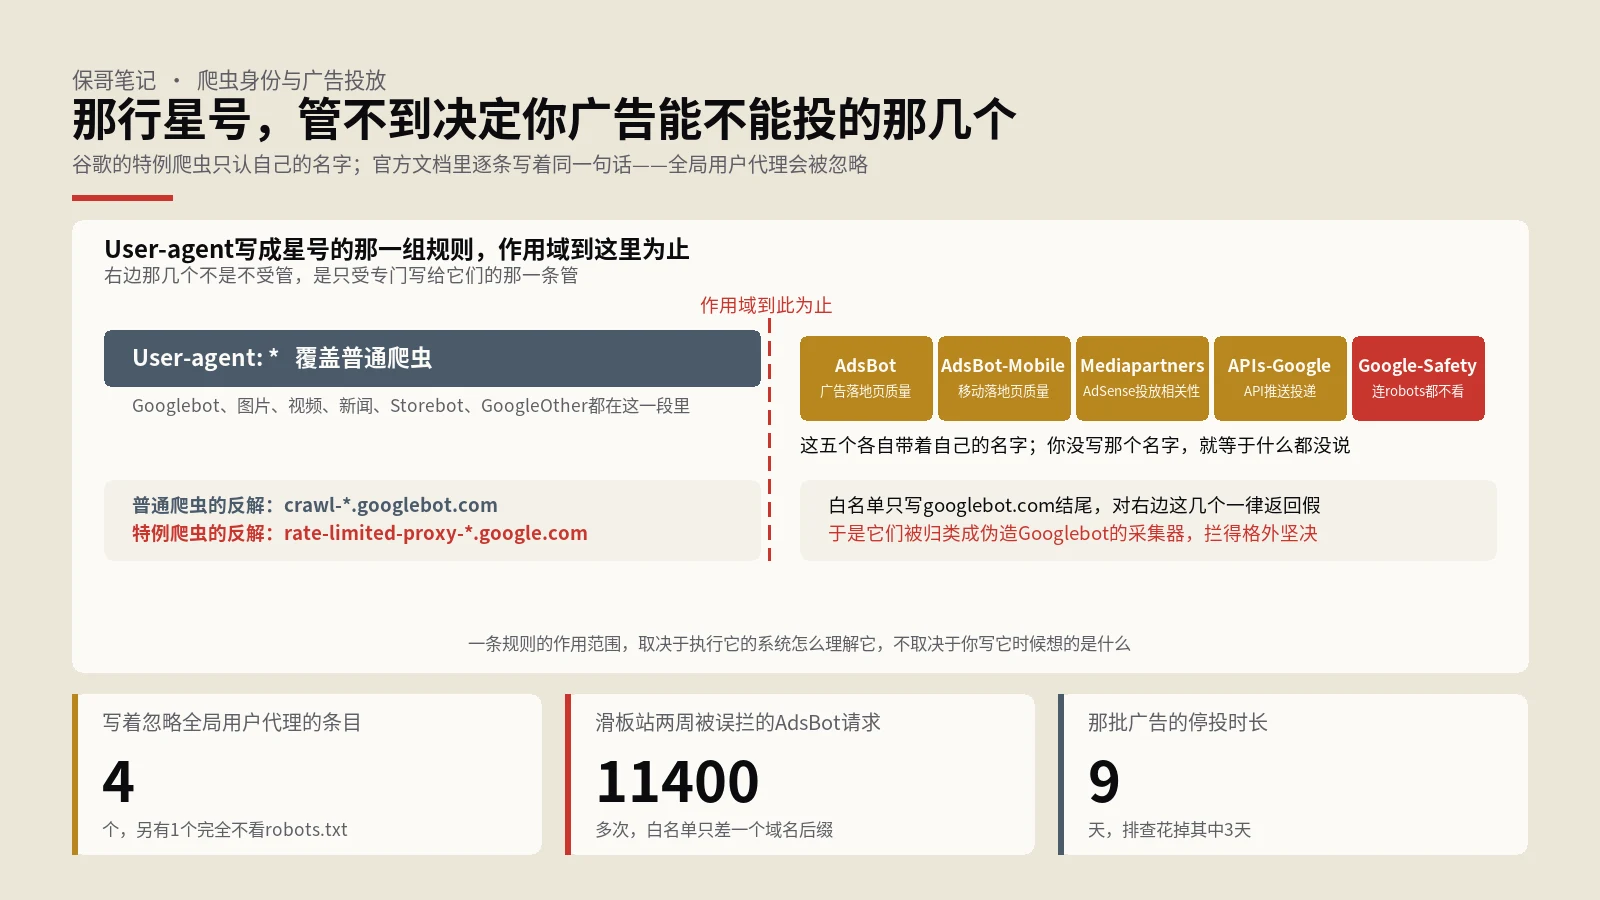
谷歌把自己的抓取客户端分成三份清单,其中特例爬虫那一份里,AdsBot-Google、AdsBot-Google-Mobile、Mediapartners-Google和APIs-Google四条下面写着同一句话:全局用户代理会被忽略;Google-Safety更彻底,完全不看robots.txt。这意味着你那行星号覆盖的范围小于你以为的范围,而覆盖之外那几个恰好后果最直接。本文把日志里的用户代理与robots.txt里的令牌这两套字典…
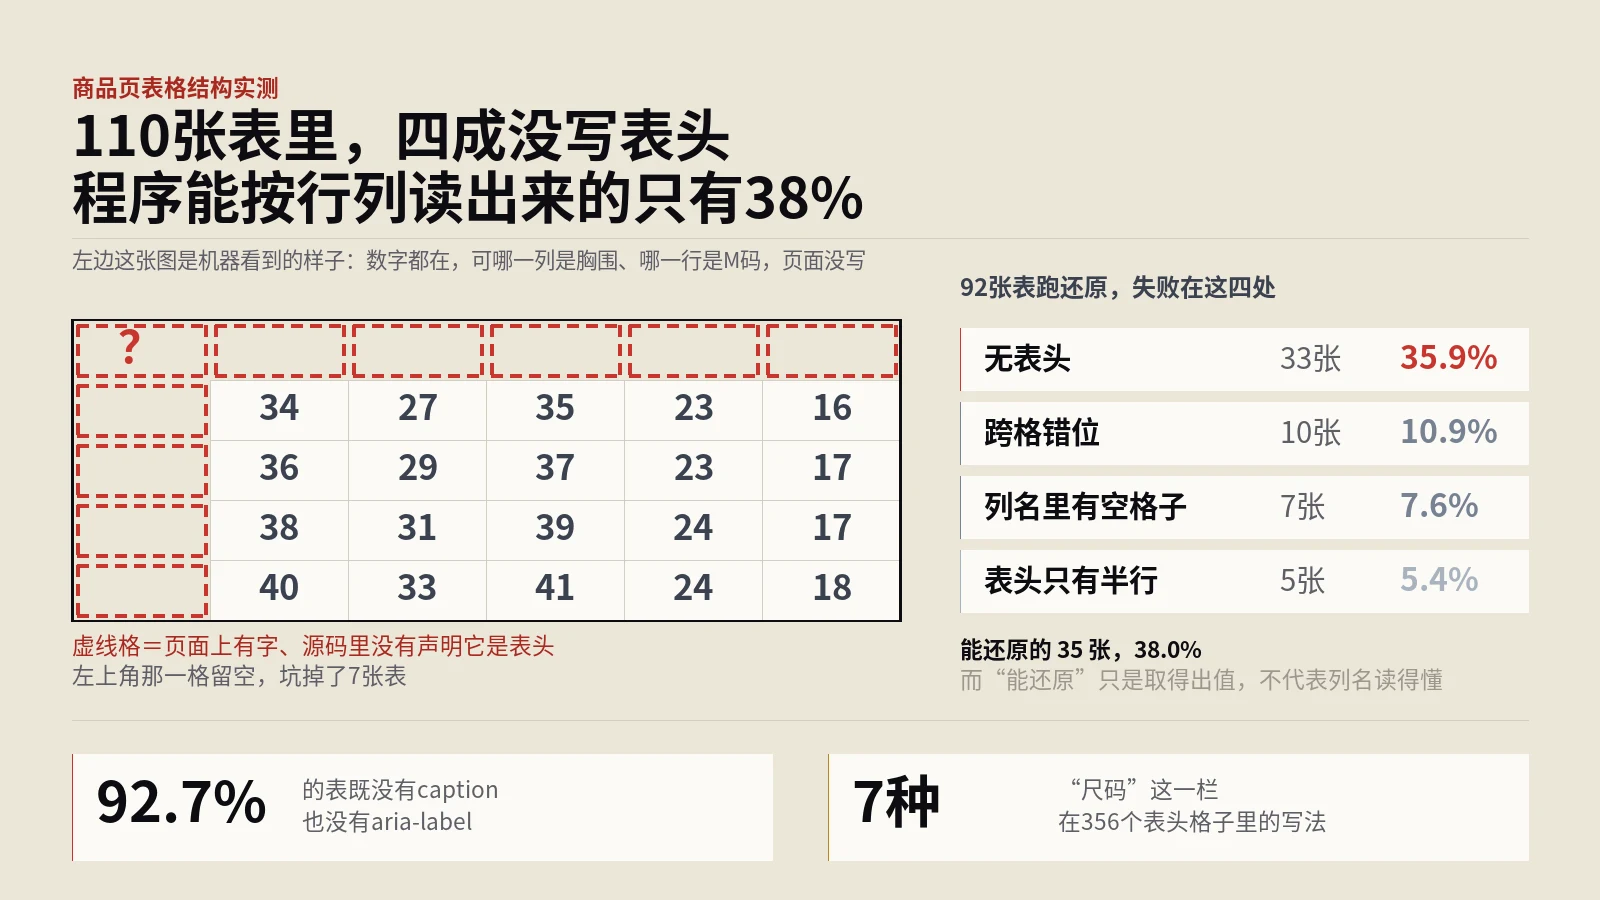
做法是把每张表最多20行12列的单元格连同标签类型一起原样取下来,再写一段还原程序按四条判据逐张试:首行是不是全部为表头单元格、有没有跨行跨列、各行格子数是否一致、列名是不是既非空也非纯数字,任何一条不满足就归进对应的失败类型。单位不从采集端的正则读,改成从表格矩阵离线重算,因为括号写法那种形式会被常规正则整批漏掉。格子总数不超过两个的空壳表单独摘出,不进还原成功率的分母。
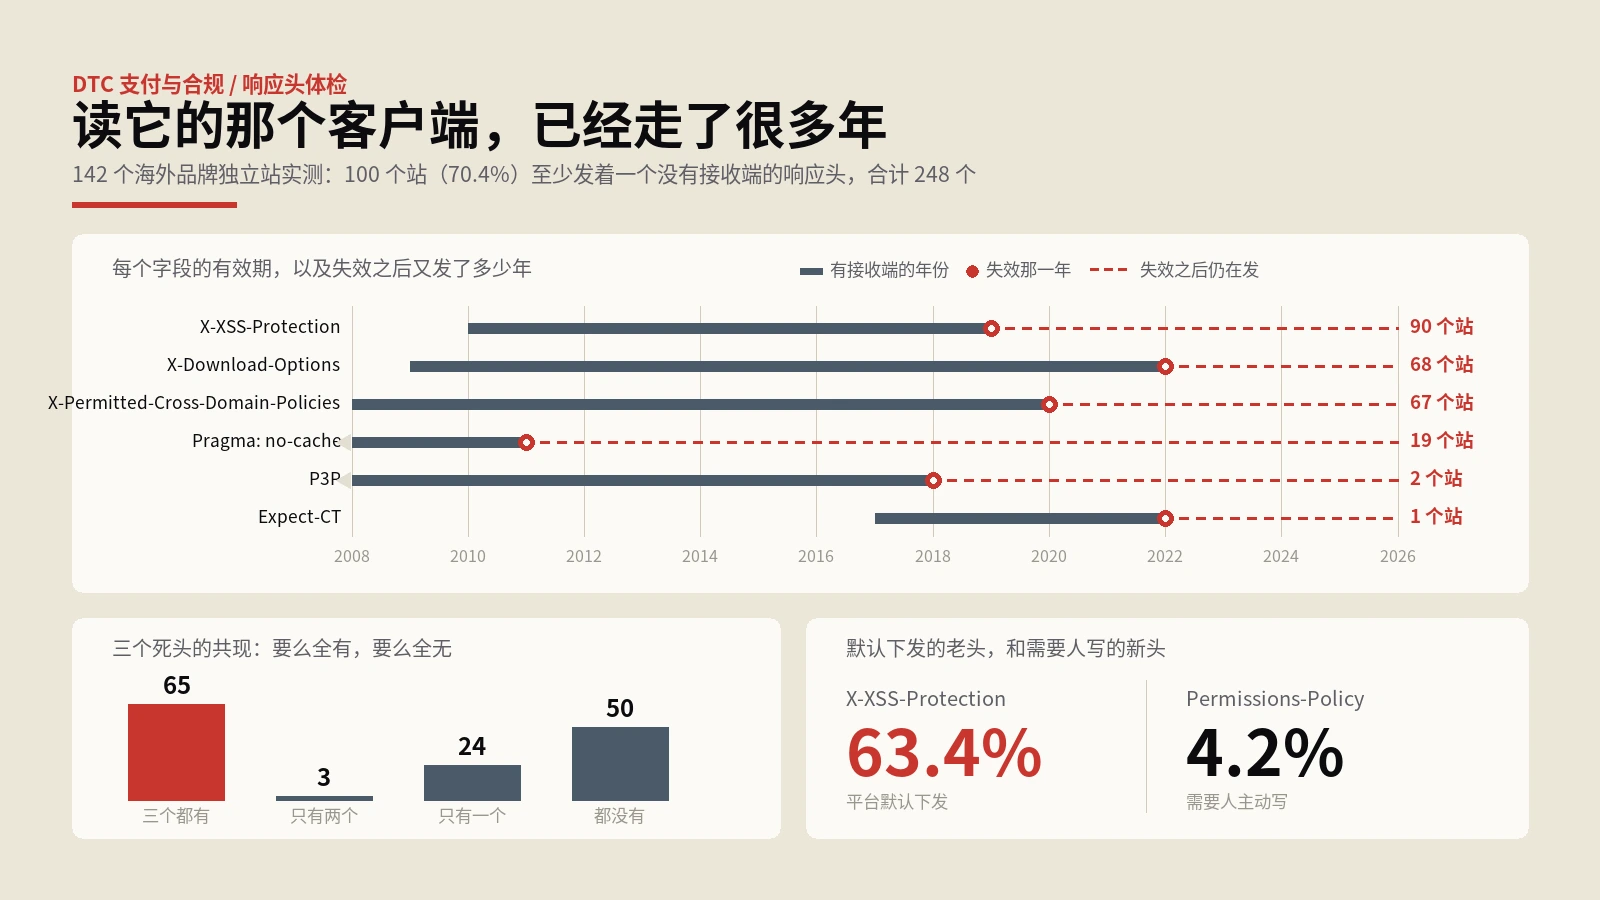
给响应头做一次接收端体检的完整量法:先取两次响应头做差集分清每个字段是自己加的还是平台加的,再逐个查它在规范里的状态与浏览器实现状态,接着先补新版写法再按确定性分三批删除,最后把结论同步给做安全审计的人。含142个站逐字段实测与一张判断结果对照表。
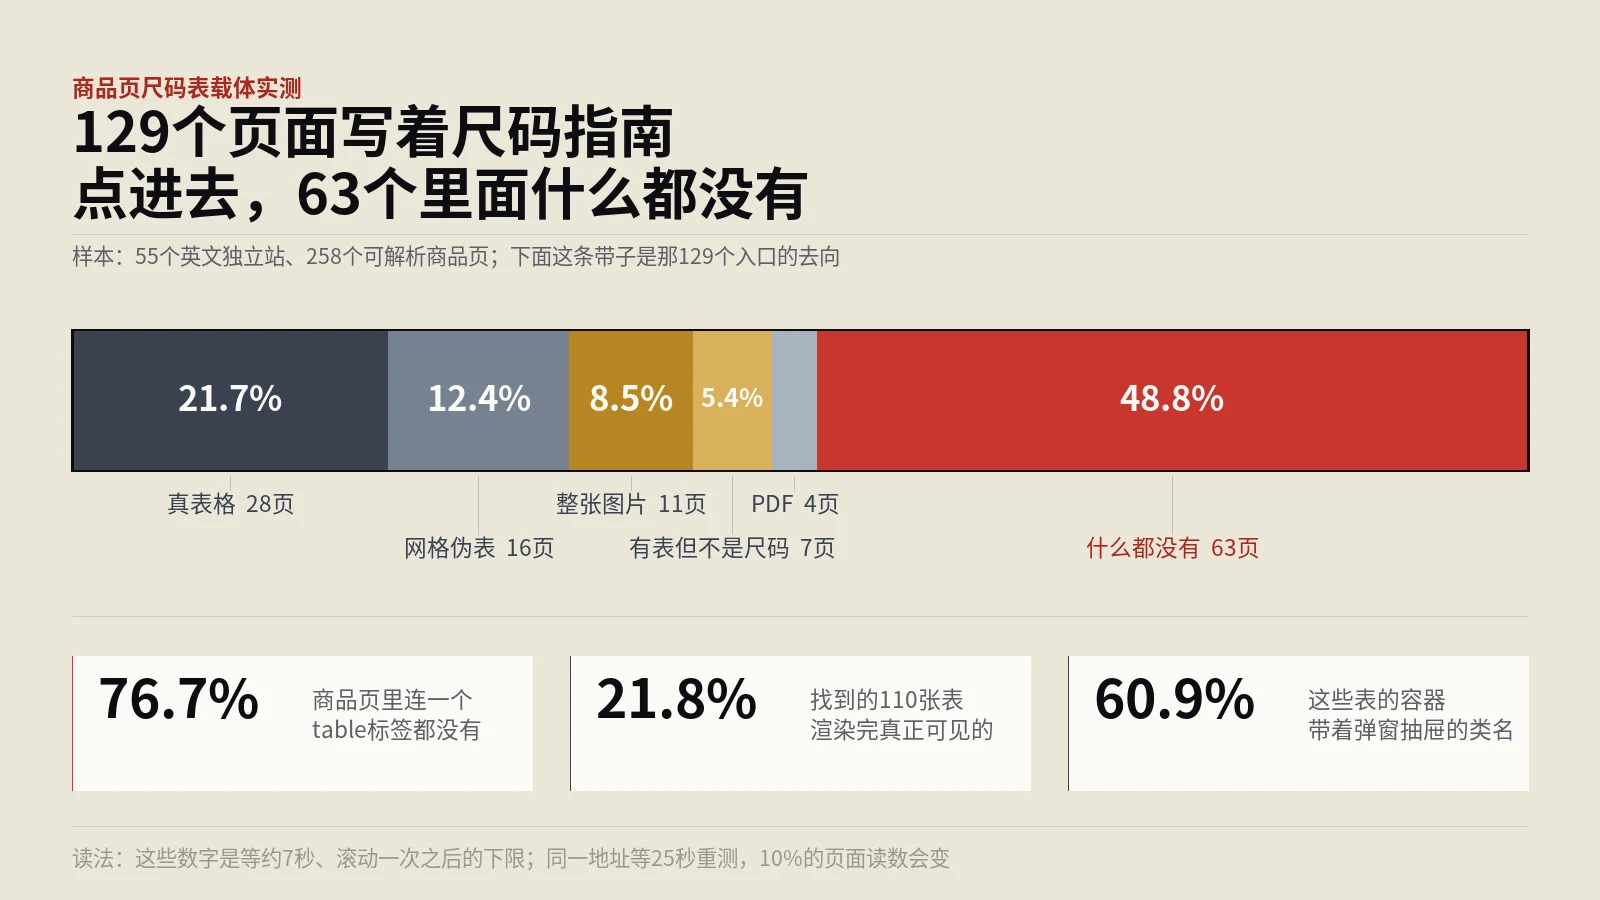
实验台用真实浏览器逐页打开55个英文独立站的商品页,等渲染完成并滚动一次之后,同时清点五类可能承载尺码信息的东西:真表格、计算样式为网格的伪表、老式CSS表格布局、整张图片形态的对照表,以及定义列表;再单独记录页面上有没有尺码指南这类入口,把入口与内容逐页对上。为了区分“页面没写”和“我没等到”,另挑三十个站做了两组对照:同一个地址等5秒与再等20秒各量一次,以及替用户点开尺码指南之后再量一次。限流与失效的页面逐条记录,没有拿去凑分母。
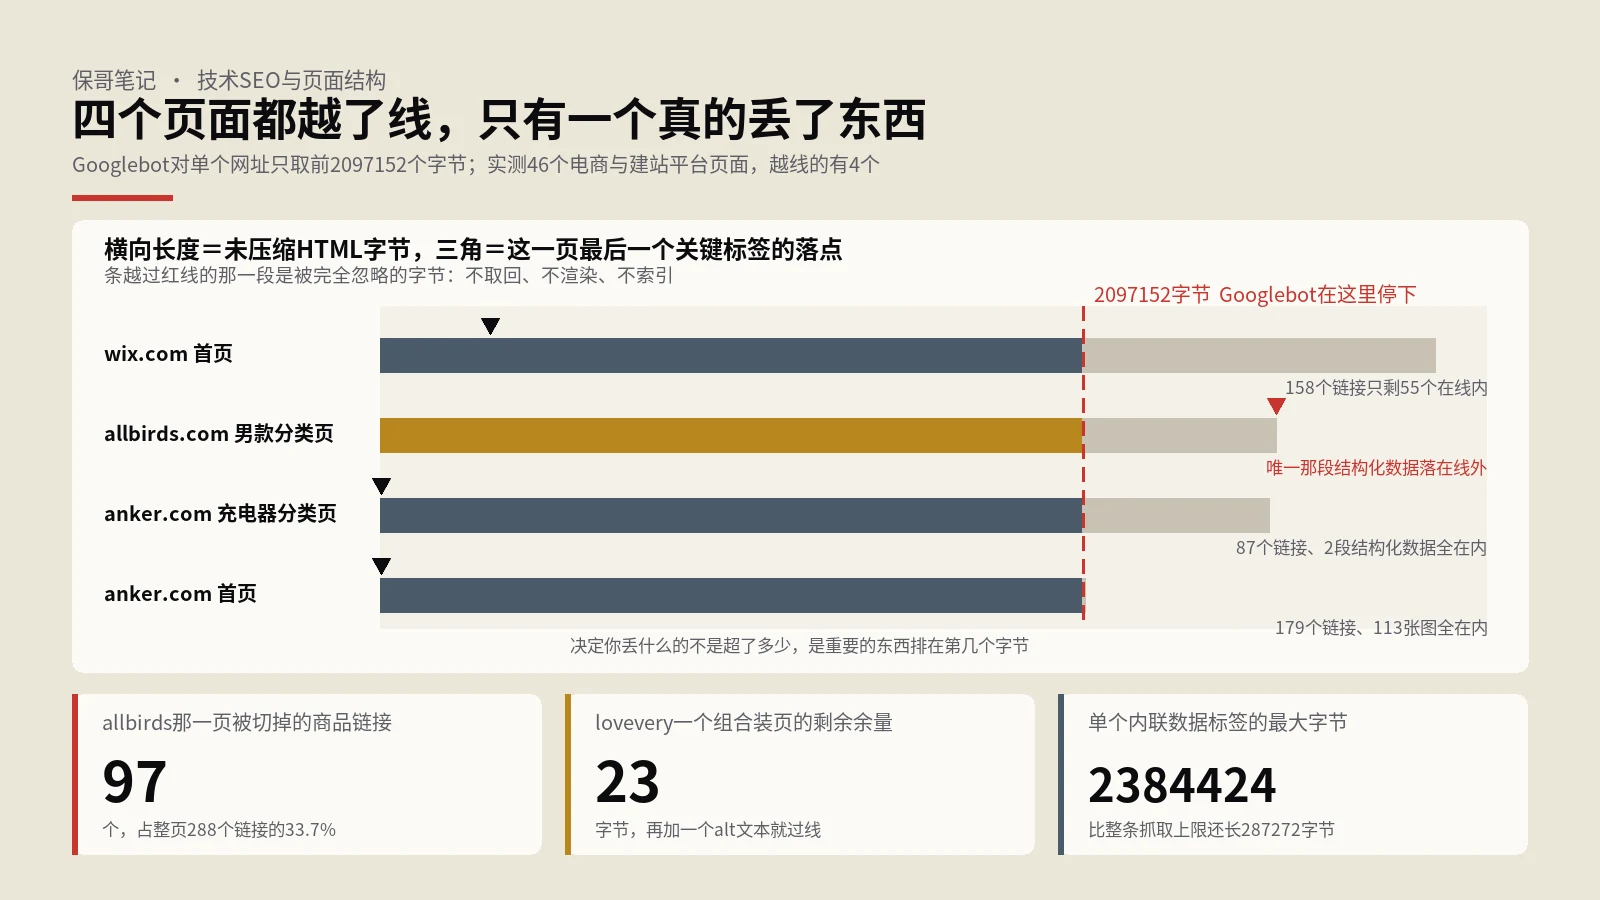
Googlebot对单个网址只取前2097152个字节,超出的部分不会报错,只是不存在。本文逐字节量了46个真实电商与建站平台的页面:未压缩HTML中位数972274字节、均值1131569字节,4个页面已越过上限,7个用掉八成以上预算,其中lovevery一个组合装页离上限只剩23个字节。更值得看的是受伤程度完全不按超标幅度排:anker两个页面超标最多却一个链接都没丢,allbirds男款分类页只超27.49%,288个链接被切掉9…
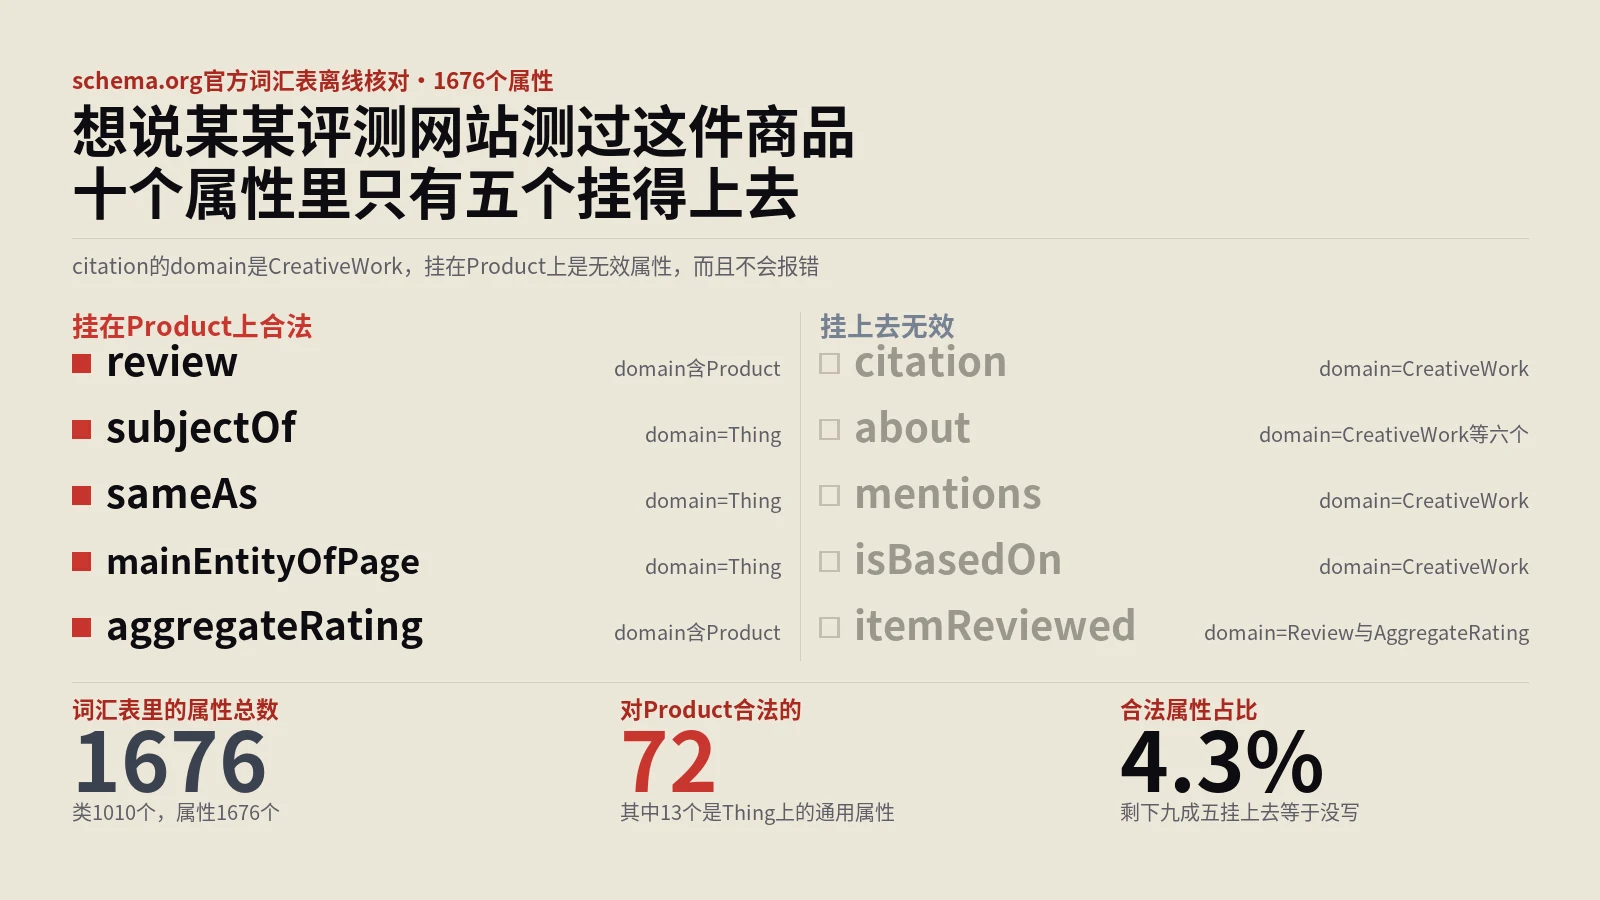
把评测网站的背书写成机器读得懂的关系,正确分工是Product节点上挂subjectOf、WebPage节点上挂citation,Review里再用itemReviewed反指回来把这条边闭合。这篇给出可以直接改的JSON-LD骨架,说明author为什么必须写成Organization、评分为什么绝对不能并进aggregateRating、验证该用schema.org官方验证器而不是富媒体结果测试,最后附一段查属性合法性的代码,自己就…