
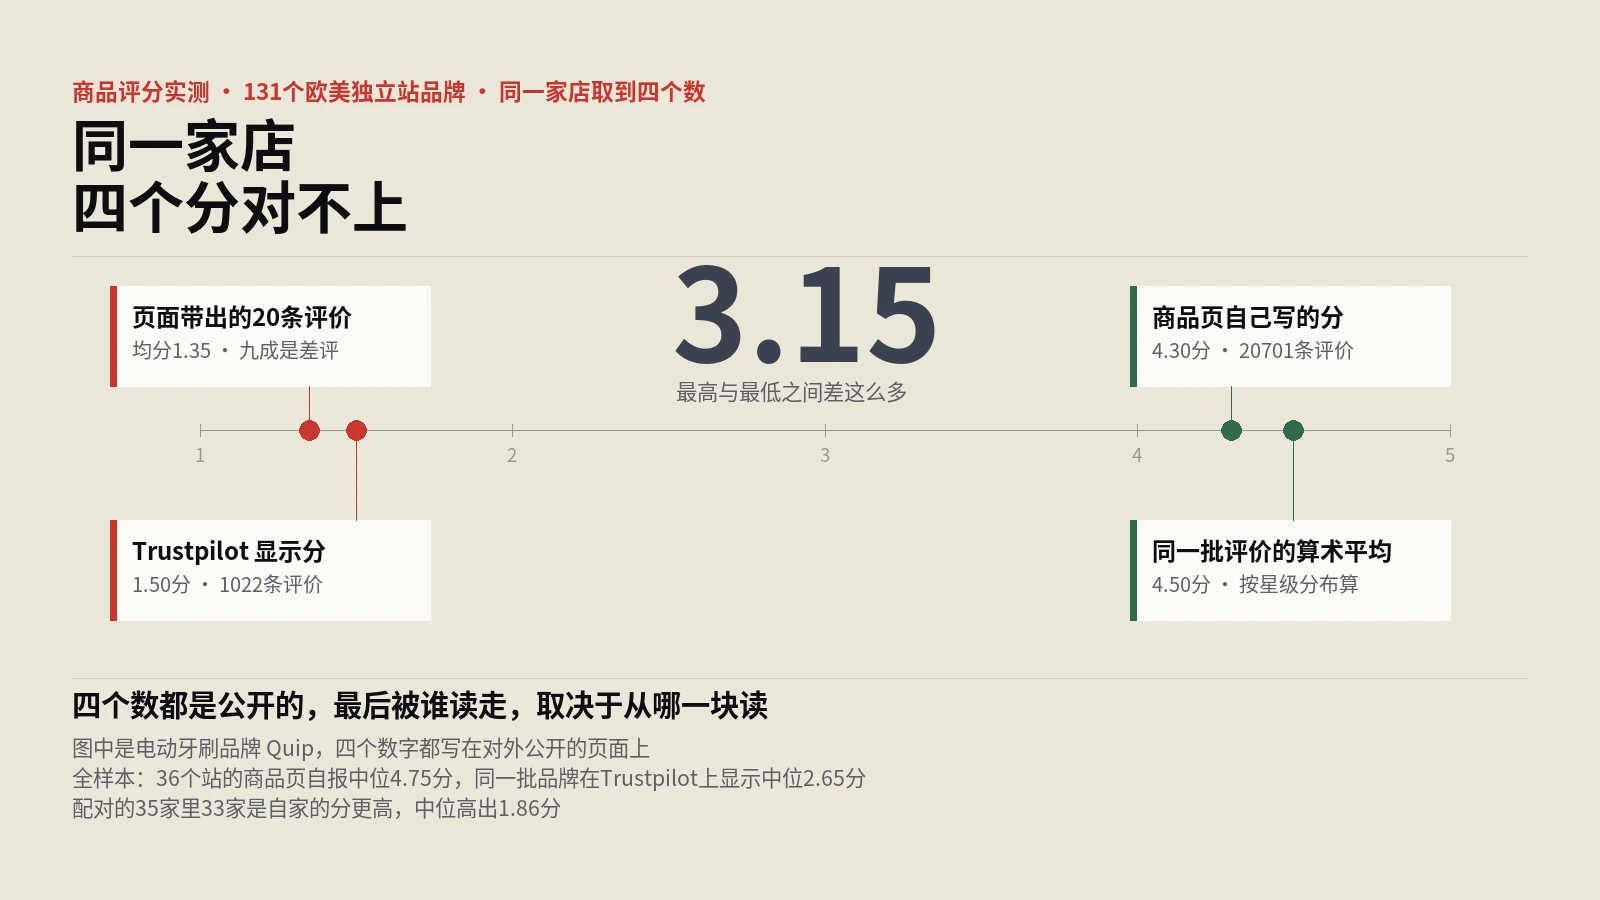
商品评分四个数对不上,AI拿走的是商家自己填的那一个
做法:对131个欧美独立站品牌,用不渲染JavaScript的抓取器取商品页原始HTML里的aggregateRating,同时抓Trustpilot品牌页的显示分、星级分布与页面自带的评价节点,按平台公布的口径把7条中性先验加回去复算;商品页与品牌页各测两轮做自基线,另挑26个商品页用真浏览器渲染对照。
电商站SKU多、页面杂,SEO一不小心就内部蚕食。这里聚焦电商SEO,从产品页TDK与结构化数据、分类页优化到Faceted Navigation和库存价格信号,帮你把每一个商品页都做成能带单的流量入口。
做法:对131个欧美独立站品牌,用不渲染JavaScript的抓取器取商品页原始HTML里的aggregateRating,同时抓Trustpilot品牌页的显示分、星级分布与页面自带的评价节点,按平台公布的口径把7条中性先验加回去复算;商品页与品牌页各测两轮做自基线,另挑26个商品页用真浏览器渲染对照。
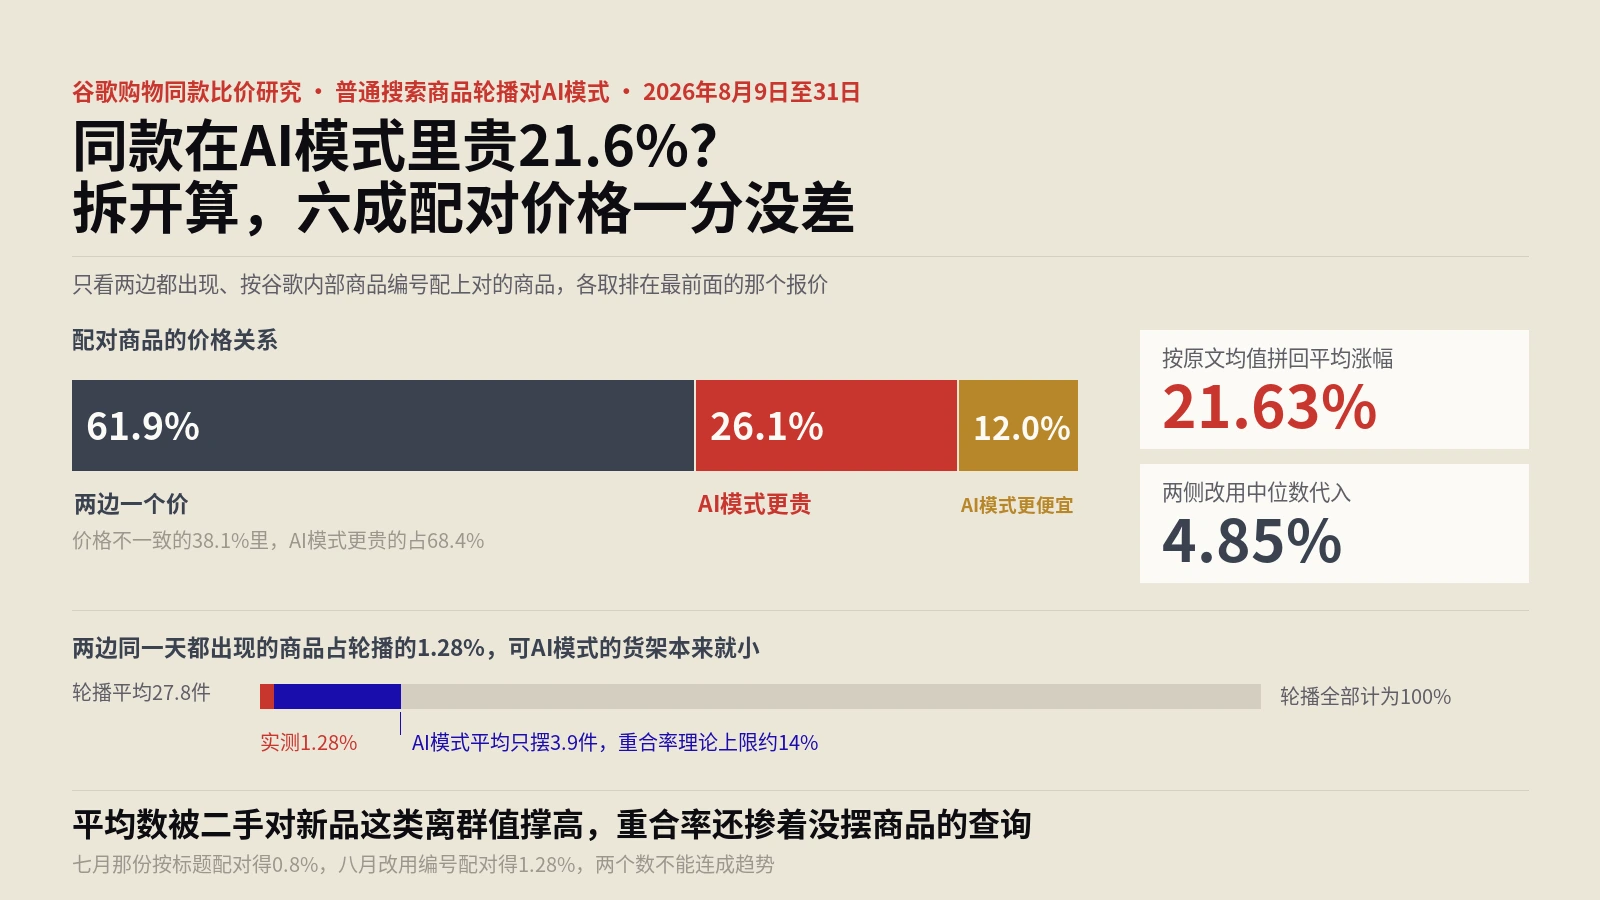
核对办法:用研究方公布的价格不一致比例、两侧贵出的均值与中位数,把21.6%的平均涨幅逐项拼回;再对照同一团队七月的前作、谷歌内部商品编号配对说明和商家后台AI效果报告,区分哪些差异来自样本、配对方法与分母口径。
把OpenAI那份商品数据上传规范整份拆了一遍:64个字段里只有9个必填,availability留空会让整行商品当场被拒,变体那三个字段配错会静默把一组变体拆成互不相干的独立商品。文章按回报排出四步落地顺序,从确认自己在不在名单上开始,到按品类补该补的可选字段。

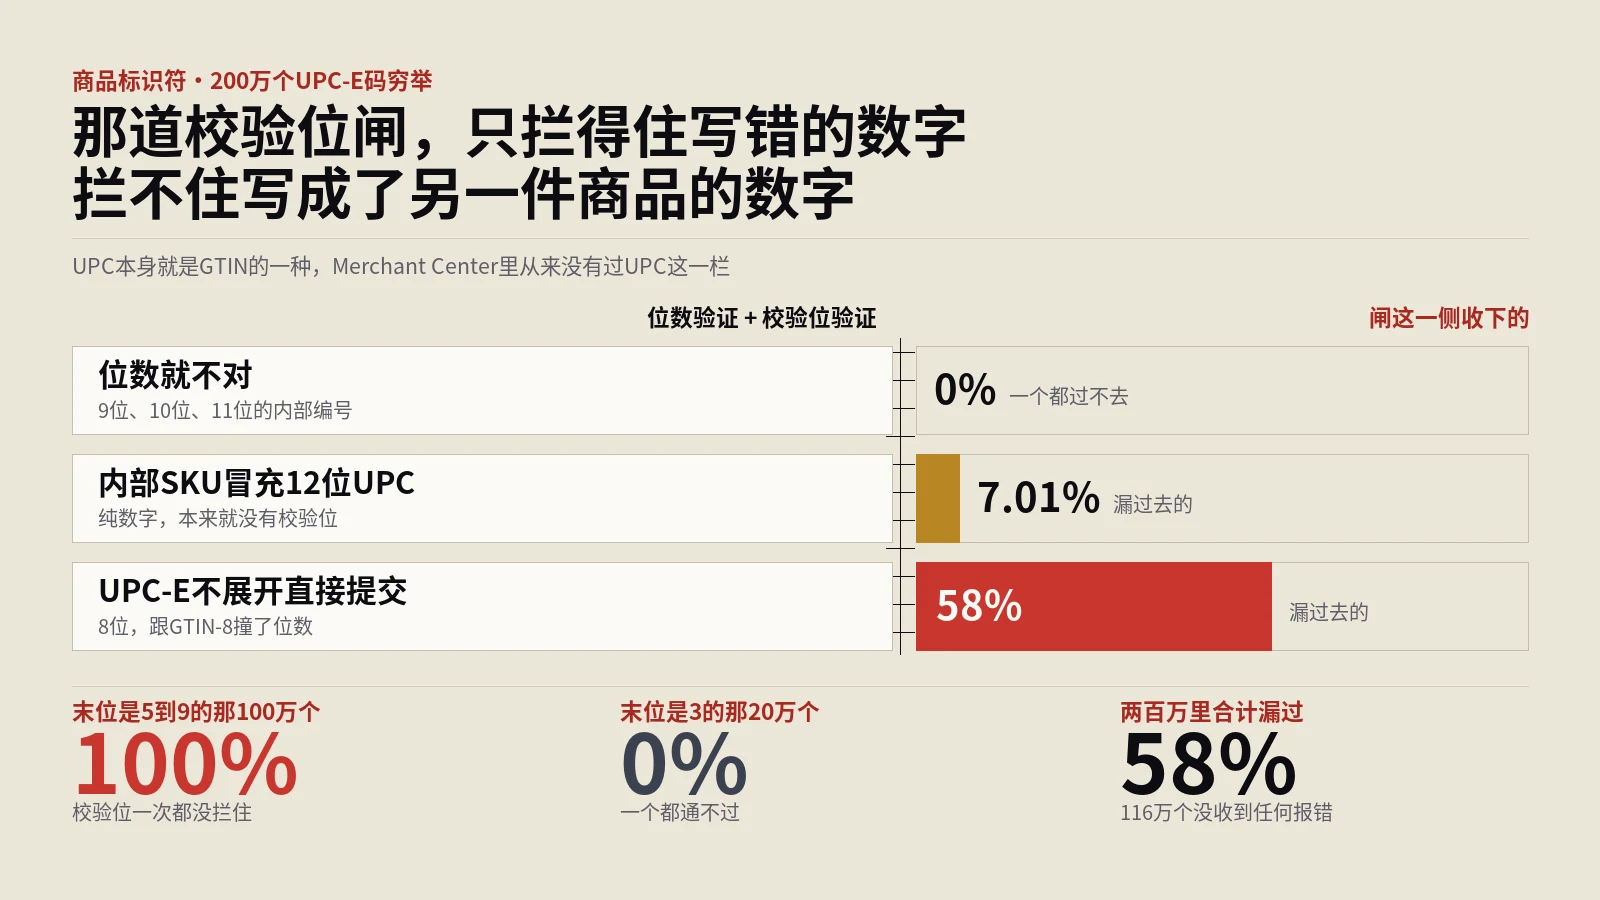
UPC、EAN、JAN、ISBN都是GTIN的格式,Merchant Center的属性表里从来没有过UPC这一栏,手上有码直接填进gtin就是标准做法。这篇把8位UPC-E展开成12位的算法、受限号段与优惠券号段、只有MPN时该填哪一栏、identifier_exists什么时候才允许填no、页面上gtin与mpn与sku与brand四个字段各自的分工,以及Shopify那个藏在变体库存区块里的条形码栏,逐条对着官方文档写清楚,最后附…
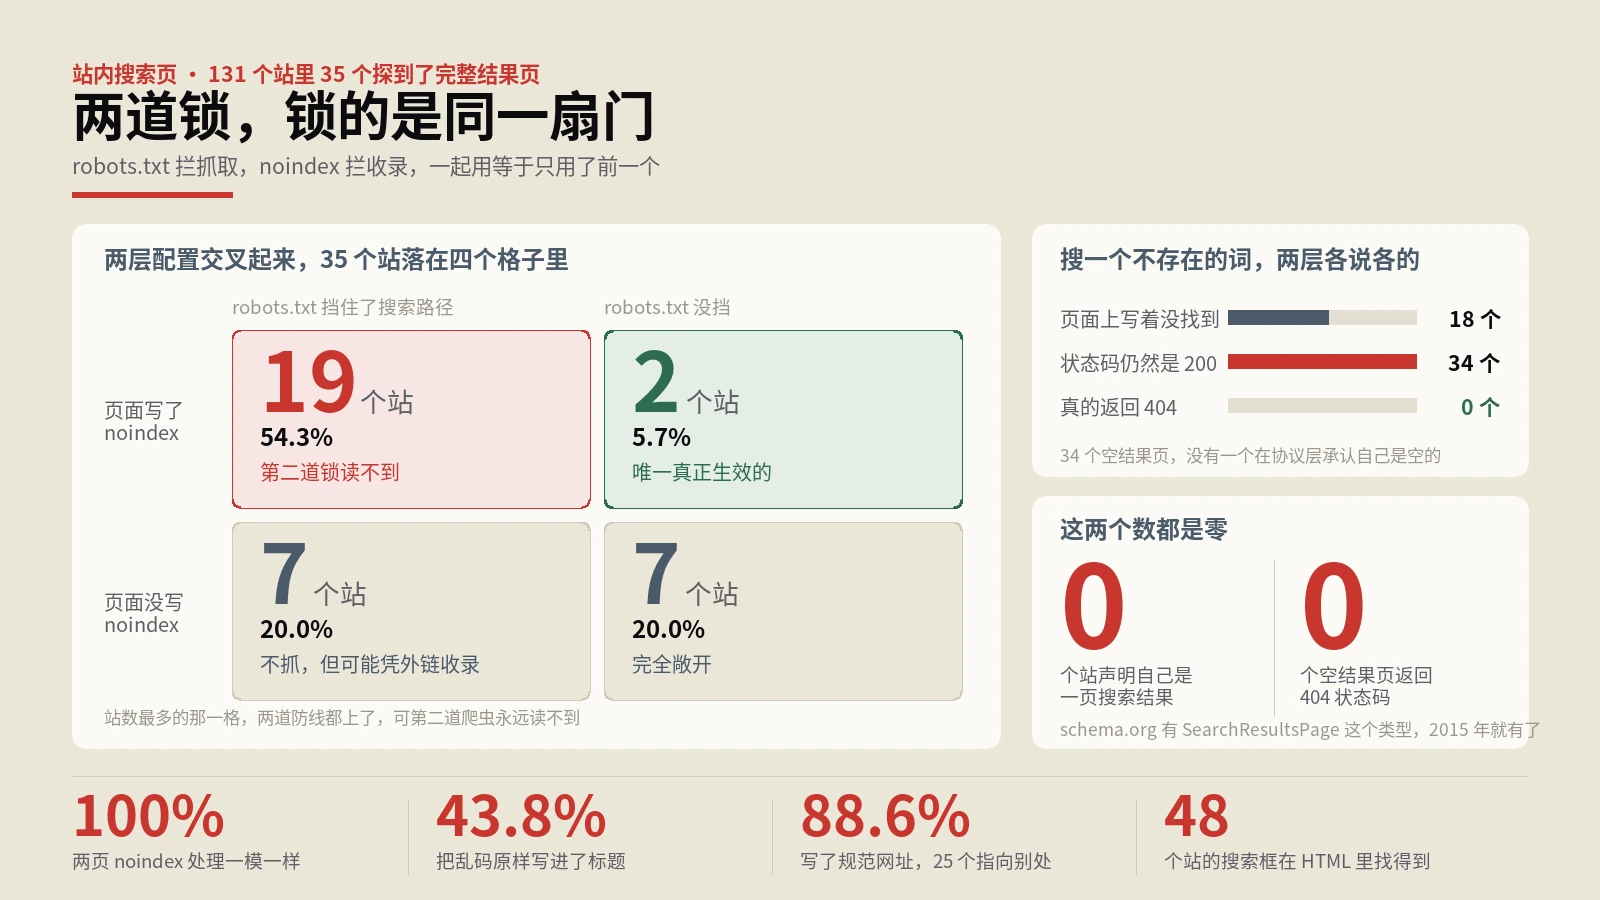
131个海外品牌站逐个找站内搜索入口,用一个常见词和一串随机字符各搜一次,把状态码、meta robots、X-Robots-Tag、规范网址、JSON-LD与robots.txt六项对齐比对;人工剔除参数落在首页的伪样本之后,落在35个站的严口径样本上。
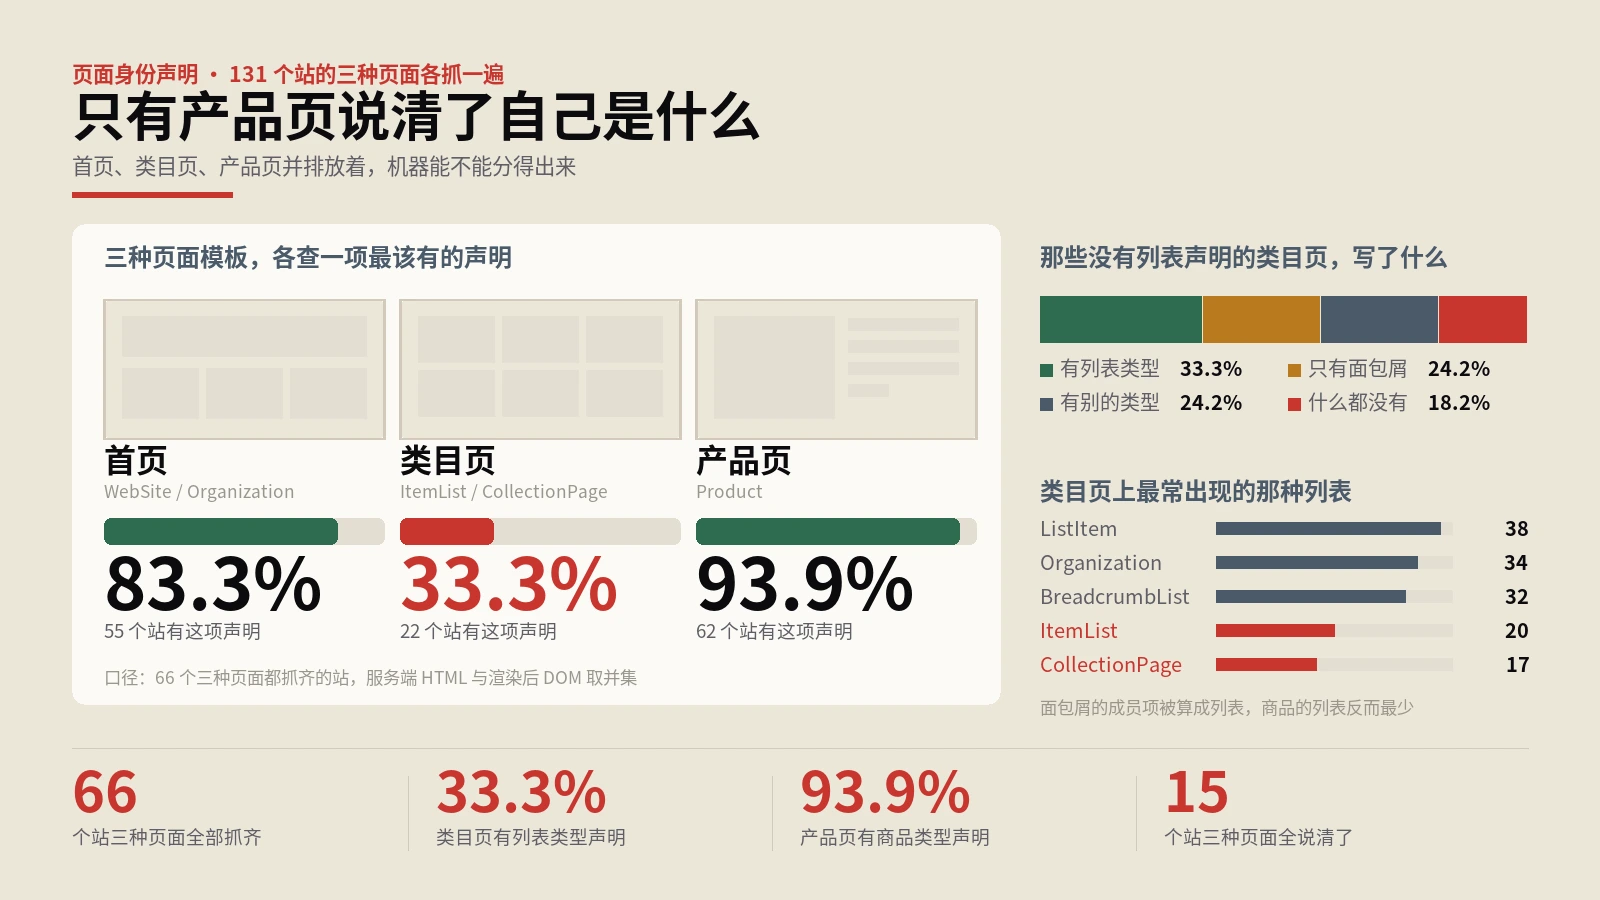
用真实浏览器把131个海外品牌站的首页、类目页、产品页各抓一遍,服务端HTML与渲染后DOM两份都解析后取并集,再人工逐条核对网址挑得对不对,最后落在66个站的可比样本上,逐项量三种页面各自的身份声明覆盖率。
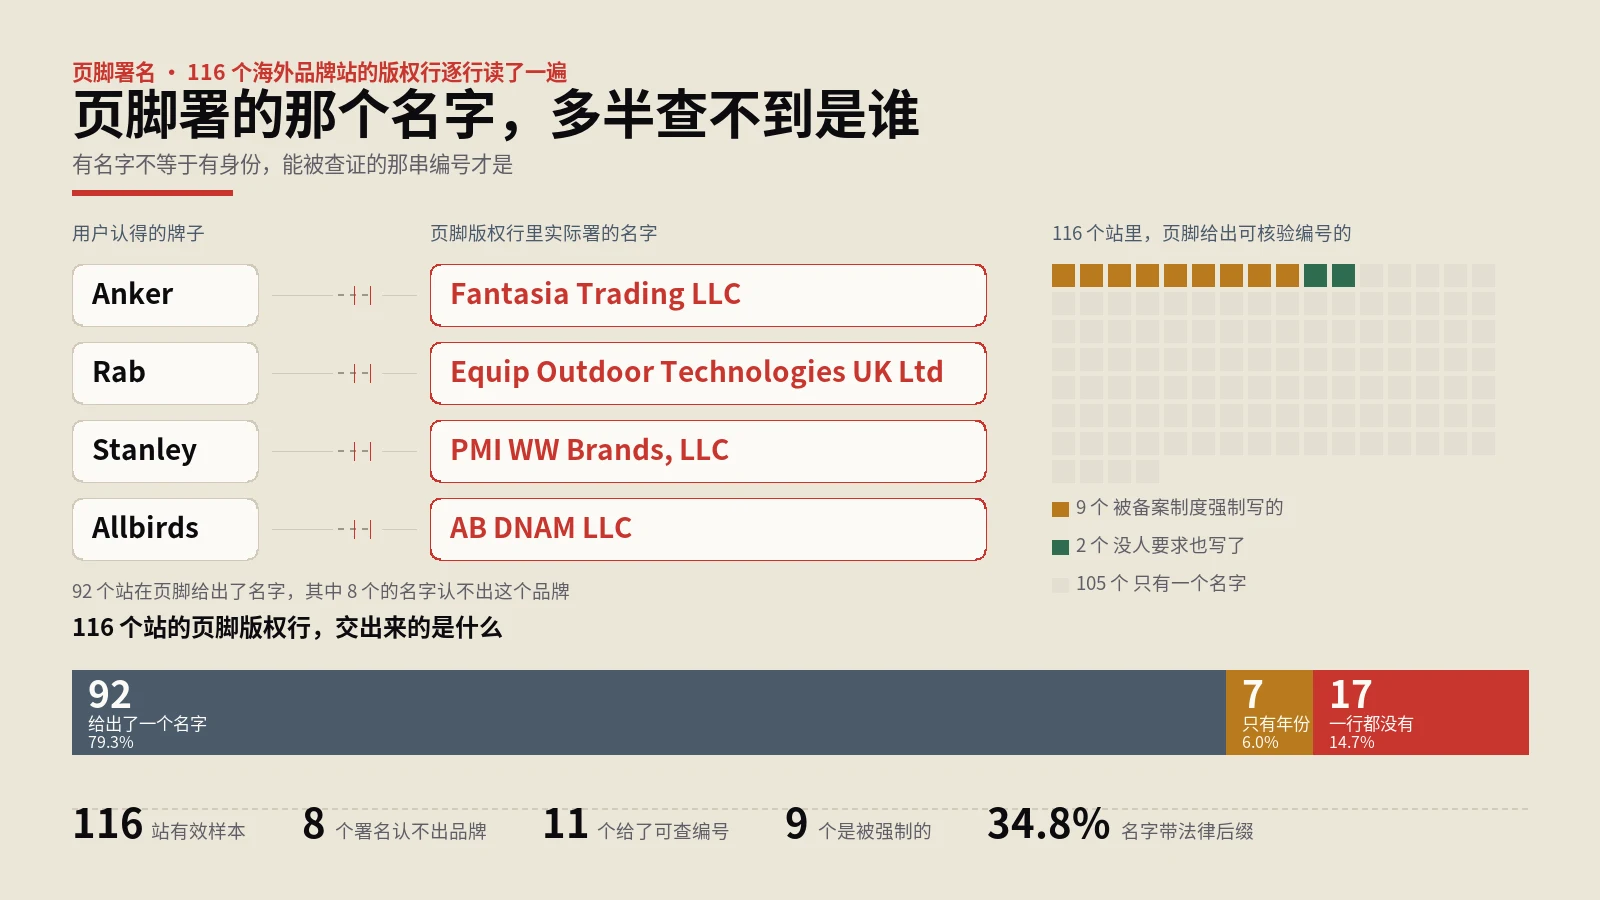
116个海外品牌站的首页页脚版权行逐行读取,切出署名后与域名主体做归一化比对,识别法律实体后缀与注册号写法;自动切分结果逐站人工核对,修正9处切分与归一化误差,署名与品牌不符的样本另做整页出现次数抽查。
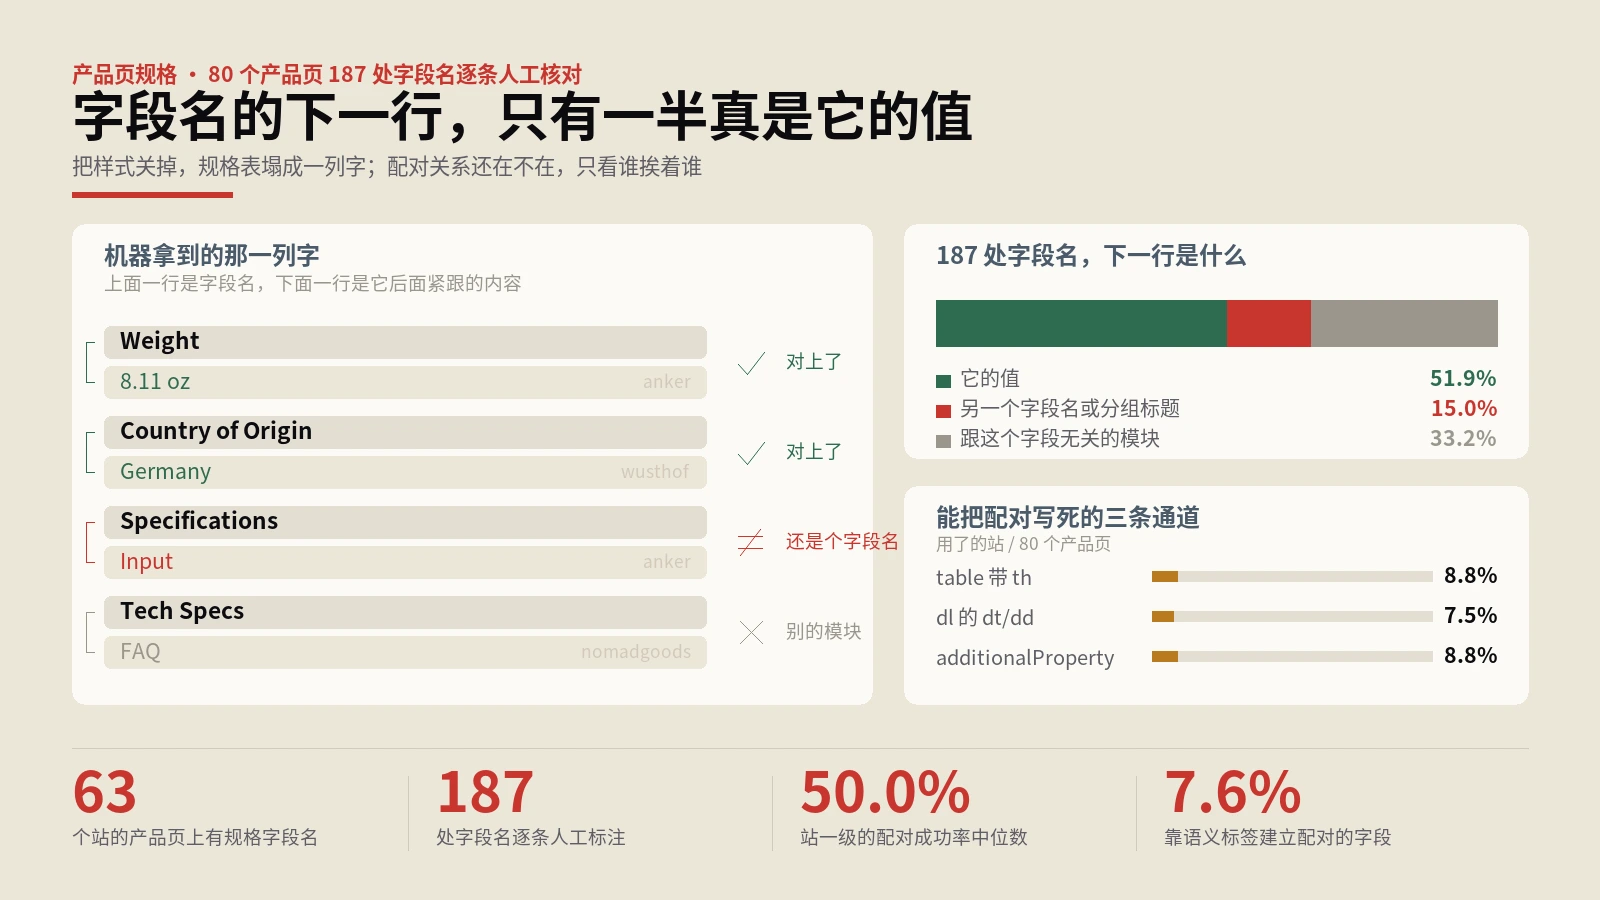
做法是用真实浏览器打开131个英文电商品牌站,从首页两跳之内进到产品页,取渲染之后的document.body.innerText当作机器实际拿到的那条文本流,用一份六十多个词的英文规格字段词表定位字段名所在的行,再逐条看它下一行是什么;同时在DOM那一侧记录字段名用的标签、有没有落在table与dl里、JSON-LD有没有写offers和additionalProperty。关键的一步是尺子自检:脚本自动判据给出的93.6%被187条…
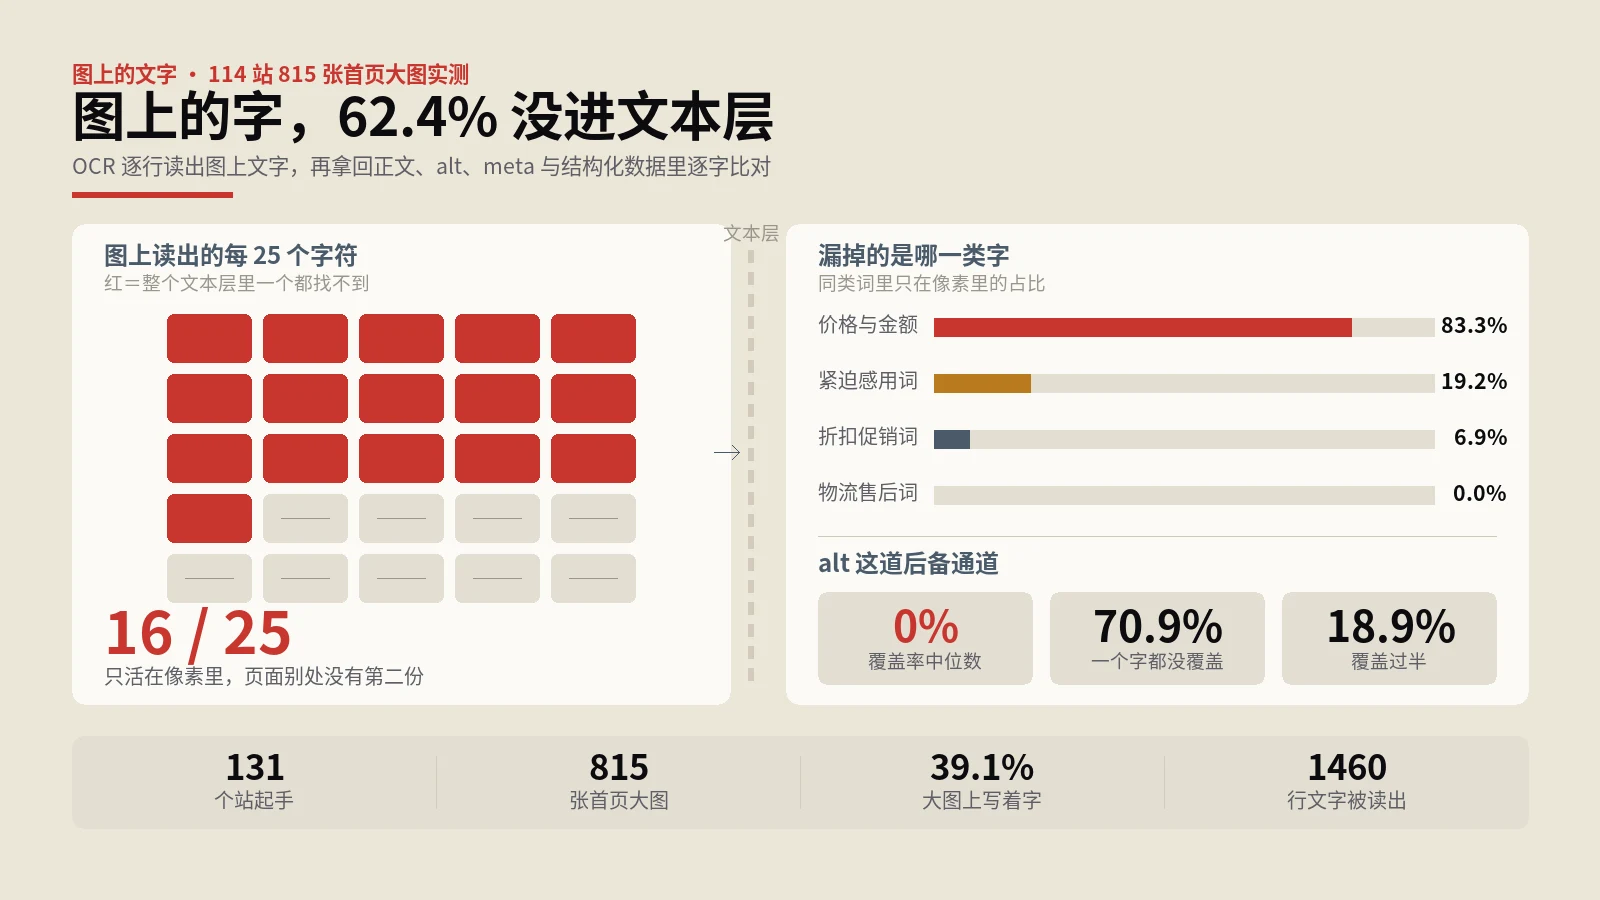
做法是把127个电商独立站首页用真实浏览器打开、滚三屏逼出懒加载,再按原始地址下载渲染面积最大的8张图(不截屏,避免把叠在上面的HTML文字拍进去),用RapidOCR逐行读出文字,最后拿回由正文、DOM全部文字、alt与aria属性、meta和JSON-LD拼成的文本池里逐行比对;OCR这把尺子先用12张已知文案的合成图和24张人工标注的真图考过两轮,并做了置信度敏感性检查。
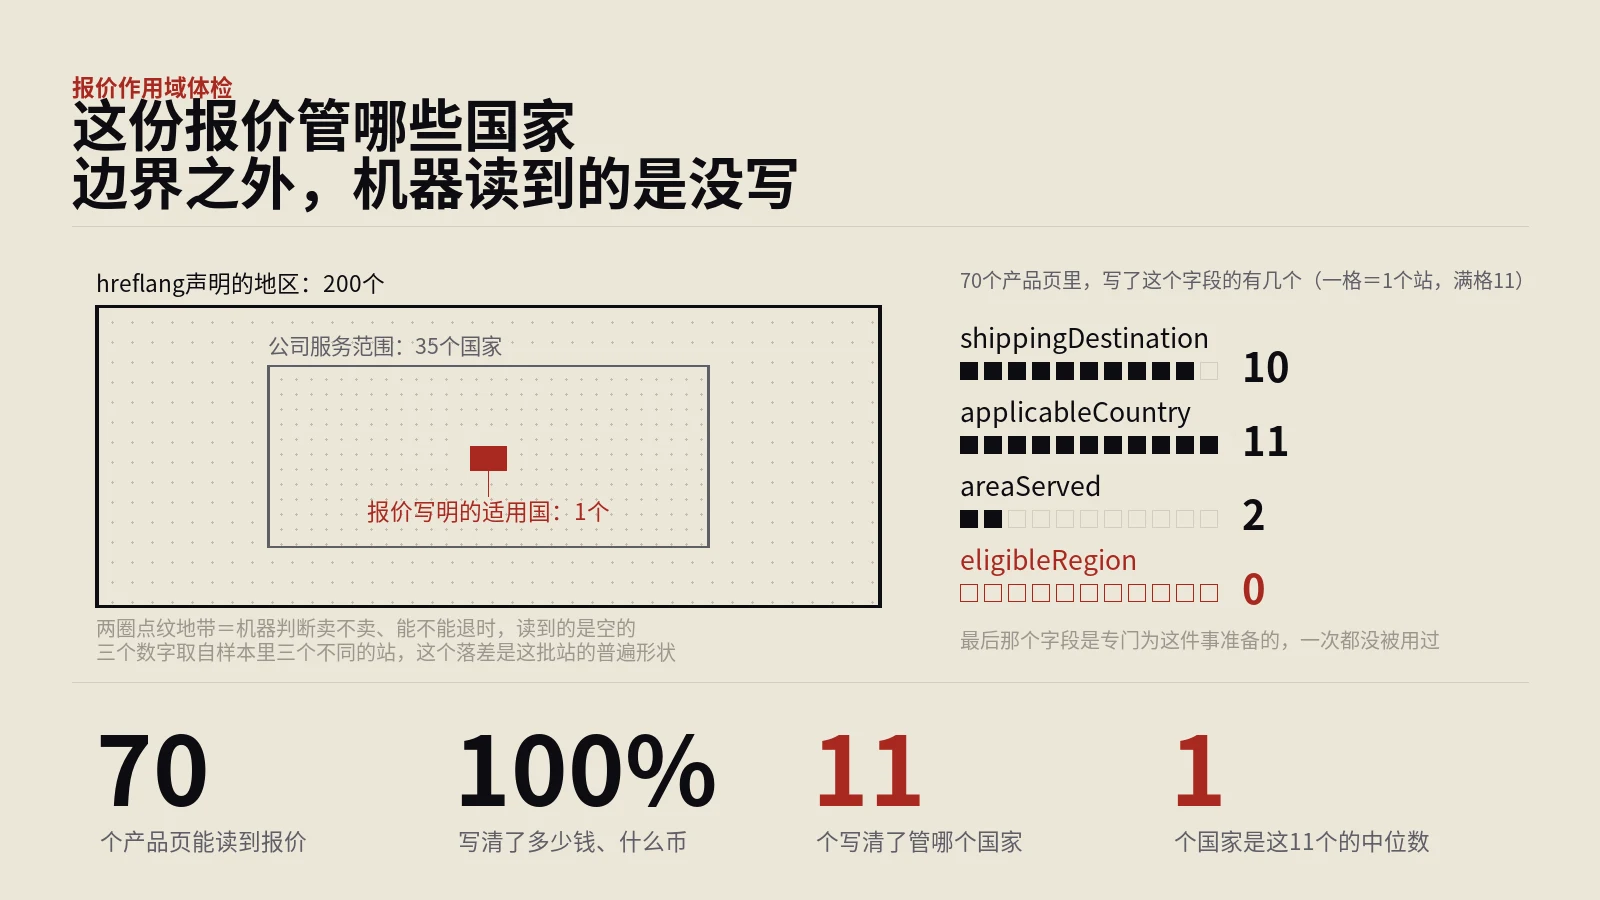
做法是从每个站的robots.txt找到sitemap入口,挑出商品那一份取一条网址抓回来,把结构化数据整段拍平后逐字段核地域信息,再拿hreflang里的多条地区网址交叉验证。尺子在这里坏过一次:第一版把欧元区多国共用一种货币的样本判成了地址不生效,9个站的结论修完只剩3个,而错的那一版恰好指向更有故事的那一边。
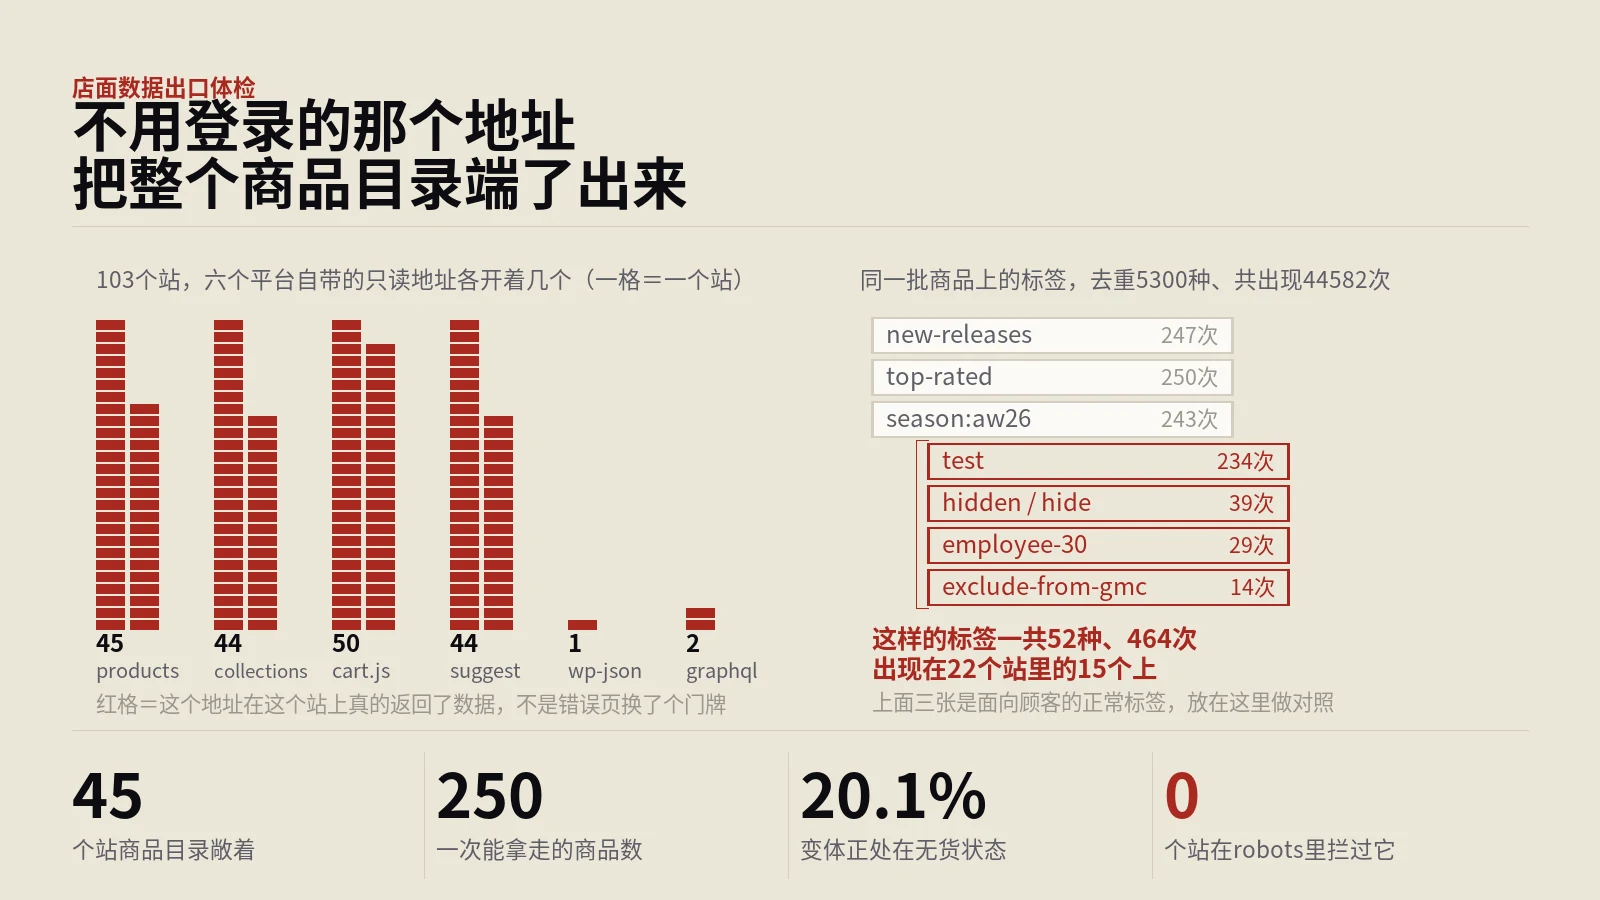
判定要过三道关:站要能进、这个站对不存在的地址得会说没有、响应得真解析成带商品数组的结构。光看状态码会把13例假阳性算进来,把45虚报成58。第二轮还栽了一次,有个时间字段对所有商品都给同一个答案。
文章把一份公开的电商体验行业榜单连续三年的版本逐项拆开对照,涵盖同一份名单里“前1%”这个标签被印了55次而候选池只允许4个位置、19个行业乘3个平台切出的格子如何决定标签数量、七个行业只有一家获奖、同一家机构对自己准则条数给出500+与700+与794与1254四个数且其中1254可由442加429加383还原、275000个分数除以794恰好接近公开的335个站而不是自称的400家、2023年版215000除以234得918.8已超…

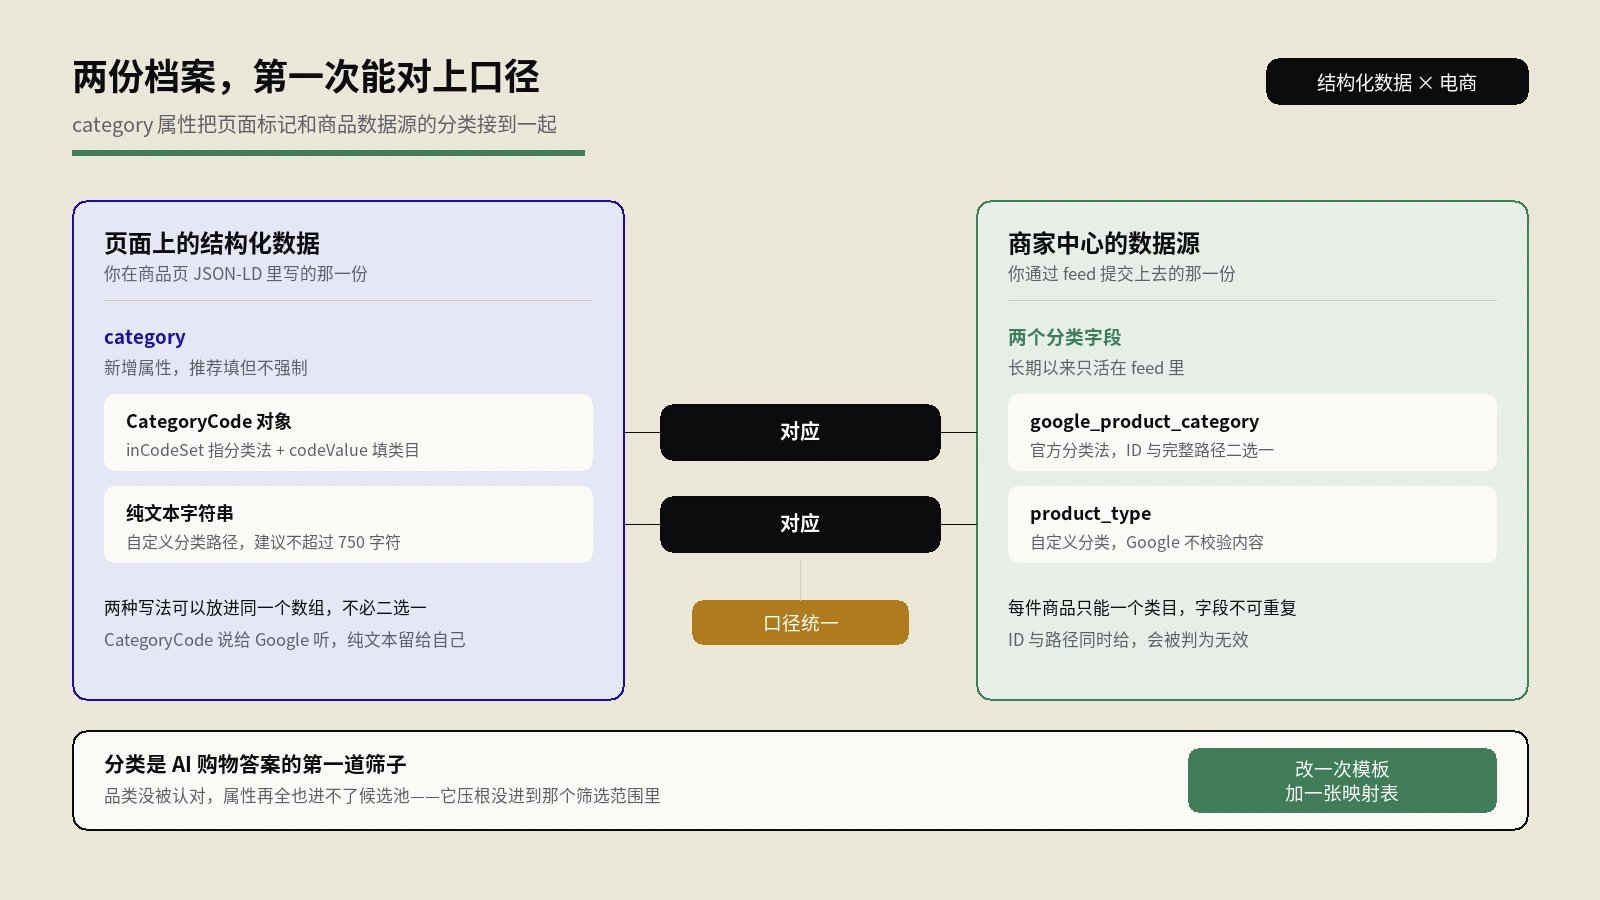
Google在2026年7月给商家信息结构化数据新增了category属性,可写成纯文本对应product_type,也可写成CategoryCode对象承载官方商品分类法。本文拆清两种写法怎么选、ID与完整路径为何不能同时提交、什么情况下才该覆盖自动归类,以及三大建站平台各自的落地路径。
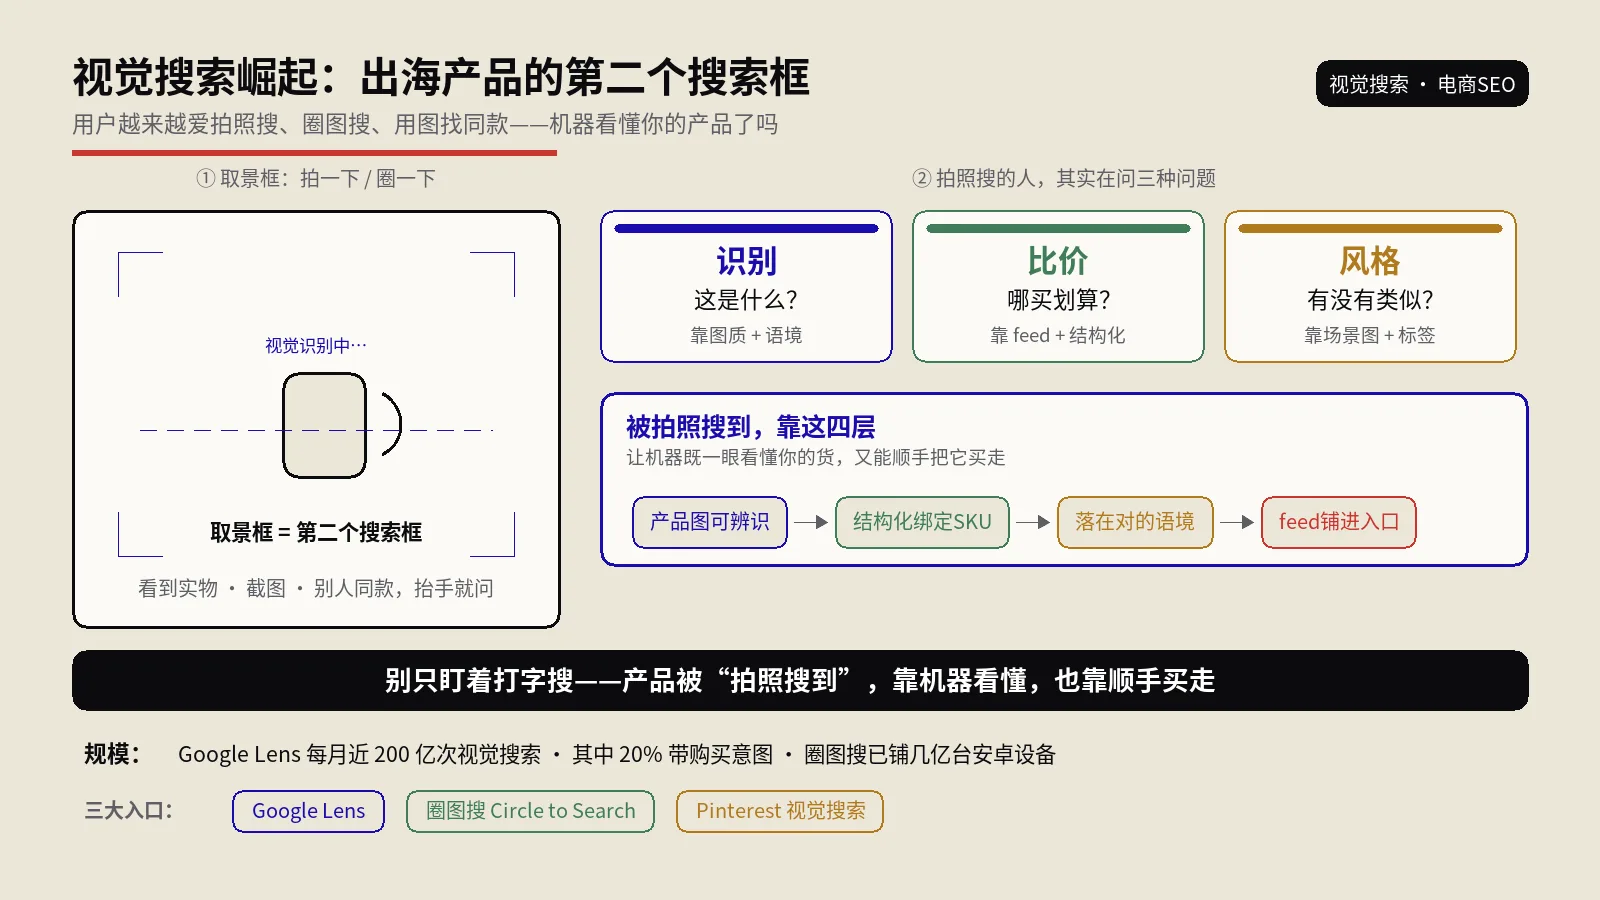
视觉搜索正成为出海产品的第二个搜索框。Google Lens每月近200亿次视觉搜索、20% 带购买意图,Circle to Search铺到几亿台设备。本文讲清它和图片SEO的区别,以及产品被拍照搜到的四层抓手和7步落地清单。
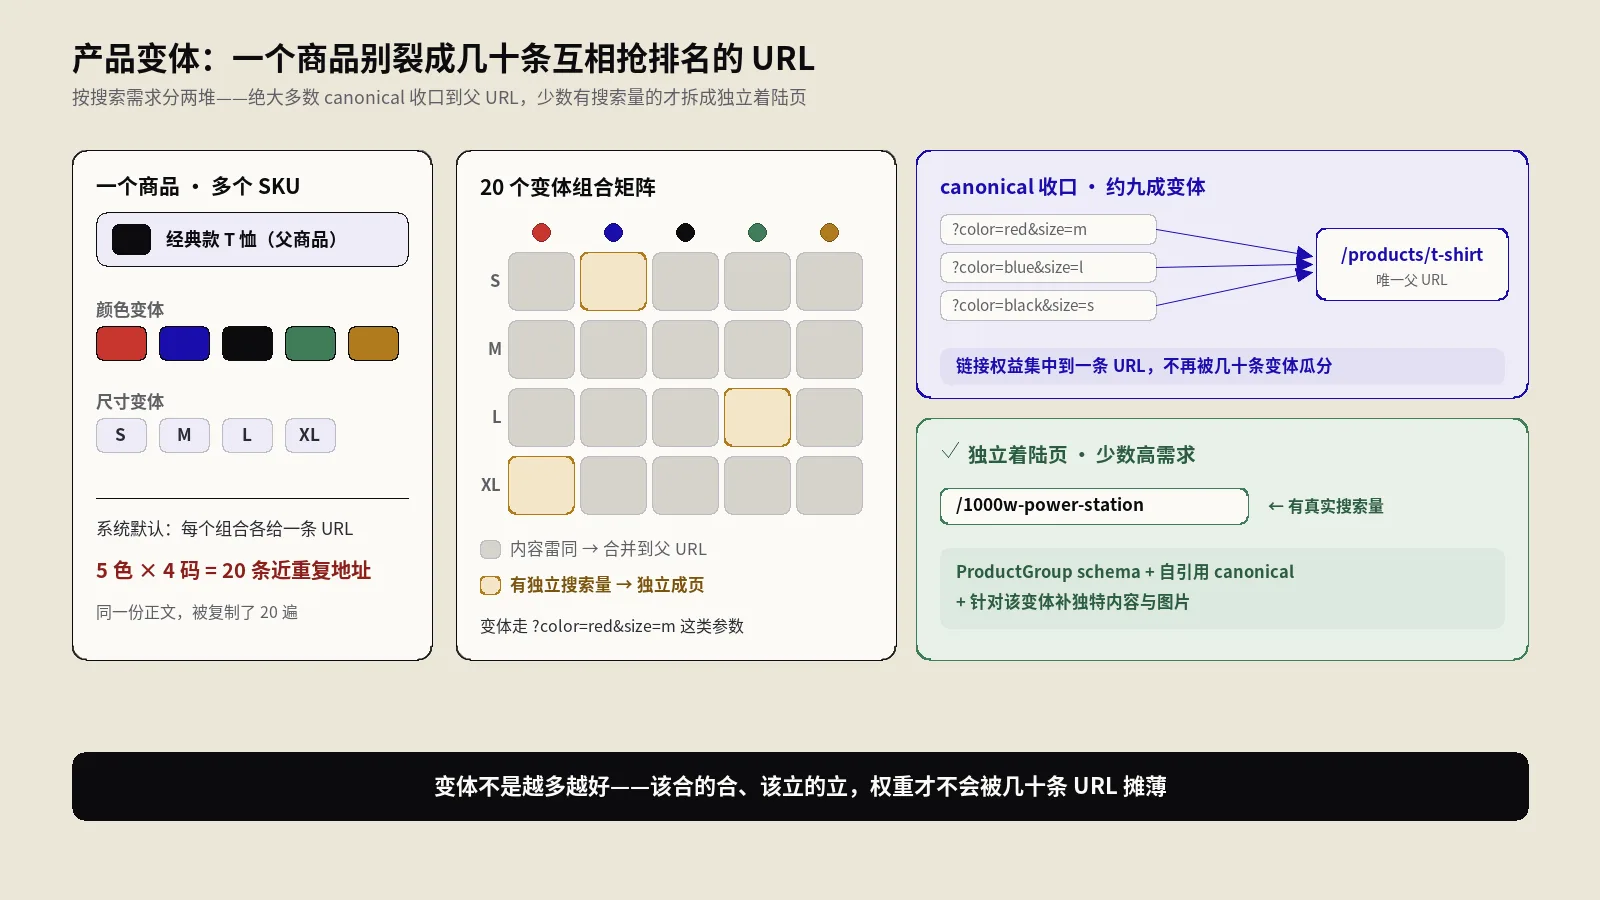
同一件商品的颜色、尺码、容量变体,常被电商系统拆成几十条近重复URL,互相稀释权重、吃抓取预算。本文讲清按搜索需求把变体分两堆:多数用canonical收口父URL,少数有搜索量的才独立成页,附ProductGroup结构化数据与三大平台落地。
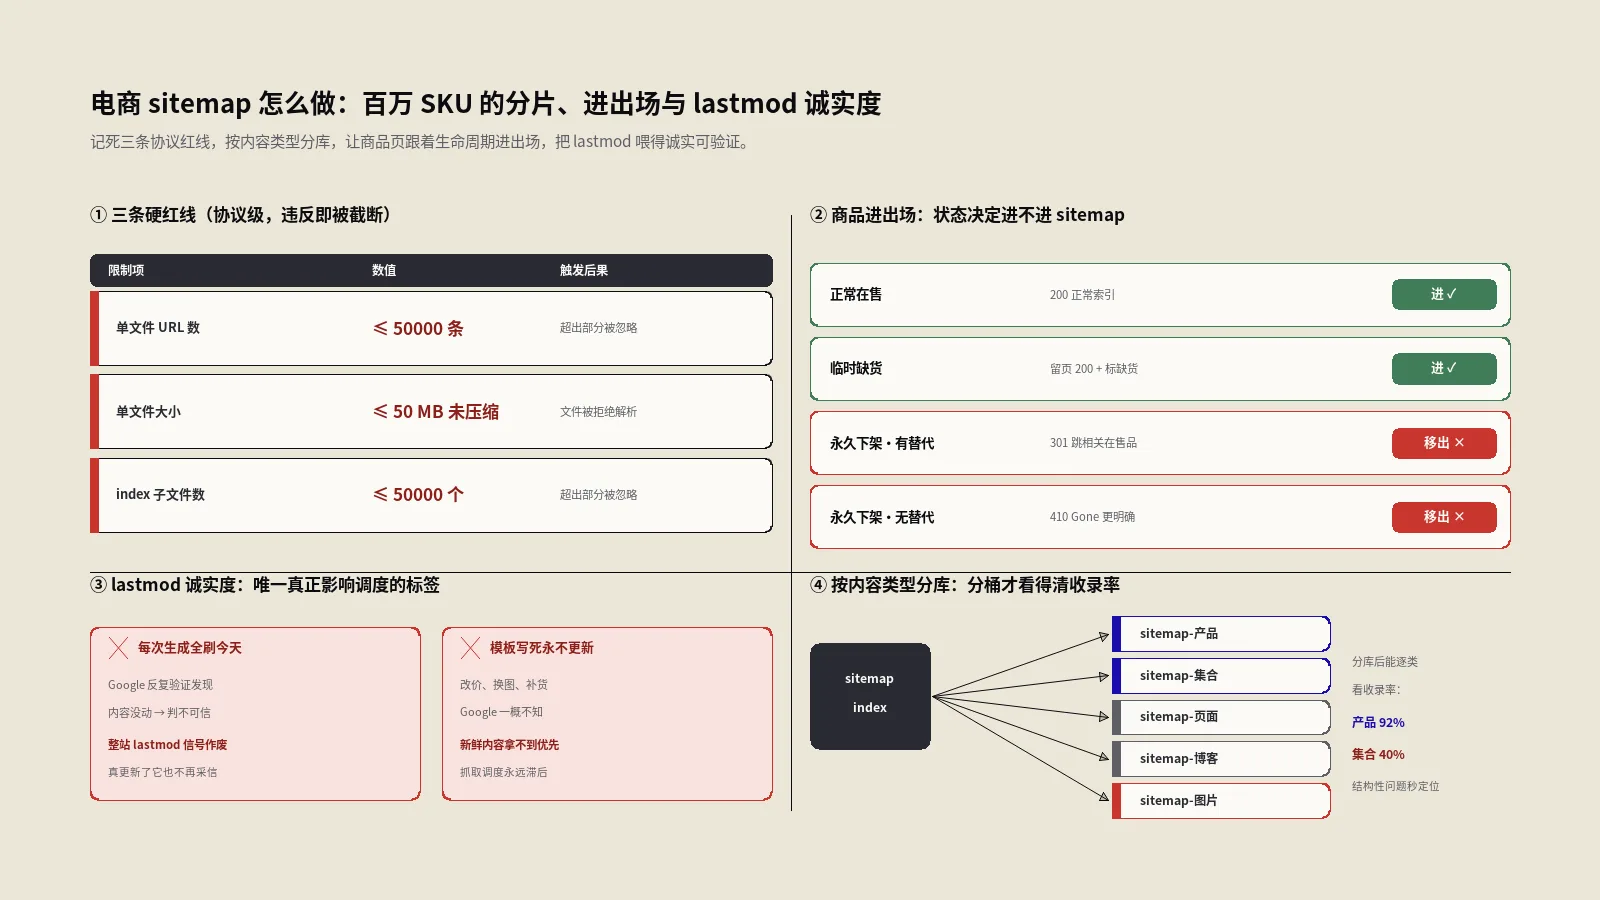
几十万SKU的电商站,sitemap是一座随时塌方重建的城市地图。本文按工程拆解:50000URL三条红线、按内容类型分库、产品页上下架进出场、变体进不进、lastmod诚实度、图片sitemap这条购物通道,最后给一份能直接照着跑的体检清单。
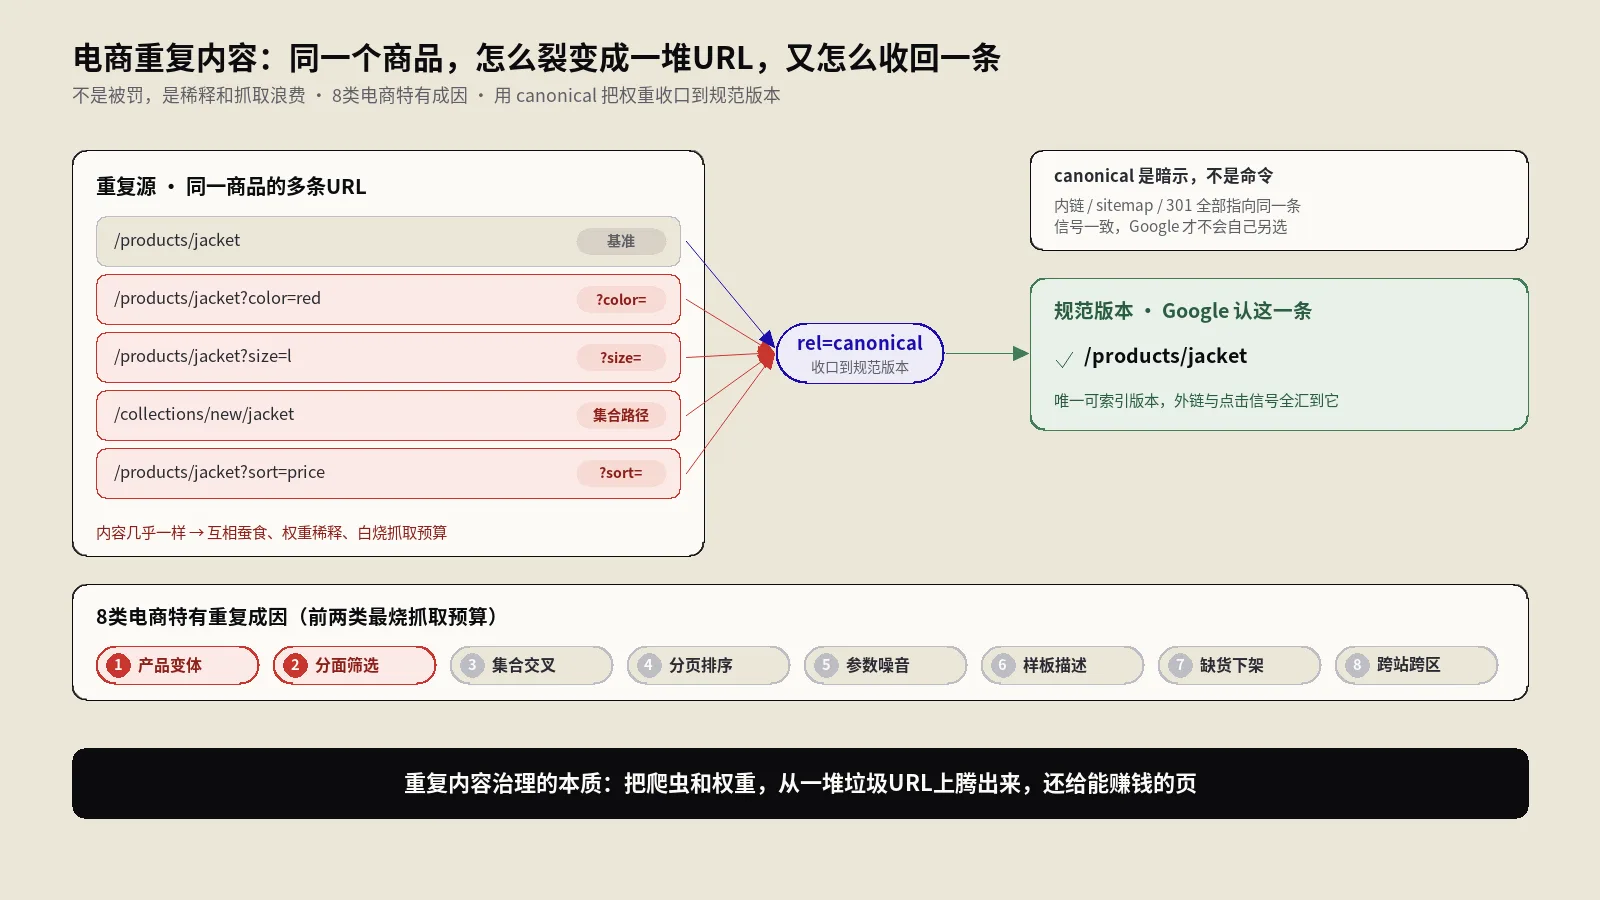
电商站几乎天生重复内容成灾,但根子不是被Google罚,而是权重稀释和抓取浪费。本文把产品变体、分面、集合页、分页、参数、样板描述、缺货、跨站这8类电商特有成因画成地图,每类给诊断与治理手法,再配四步诊断工具箱和合并拆分拦截决策树。
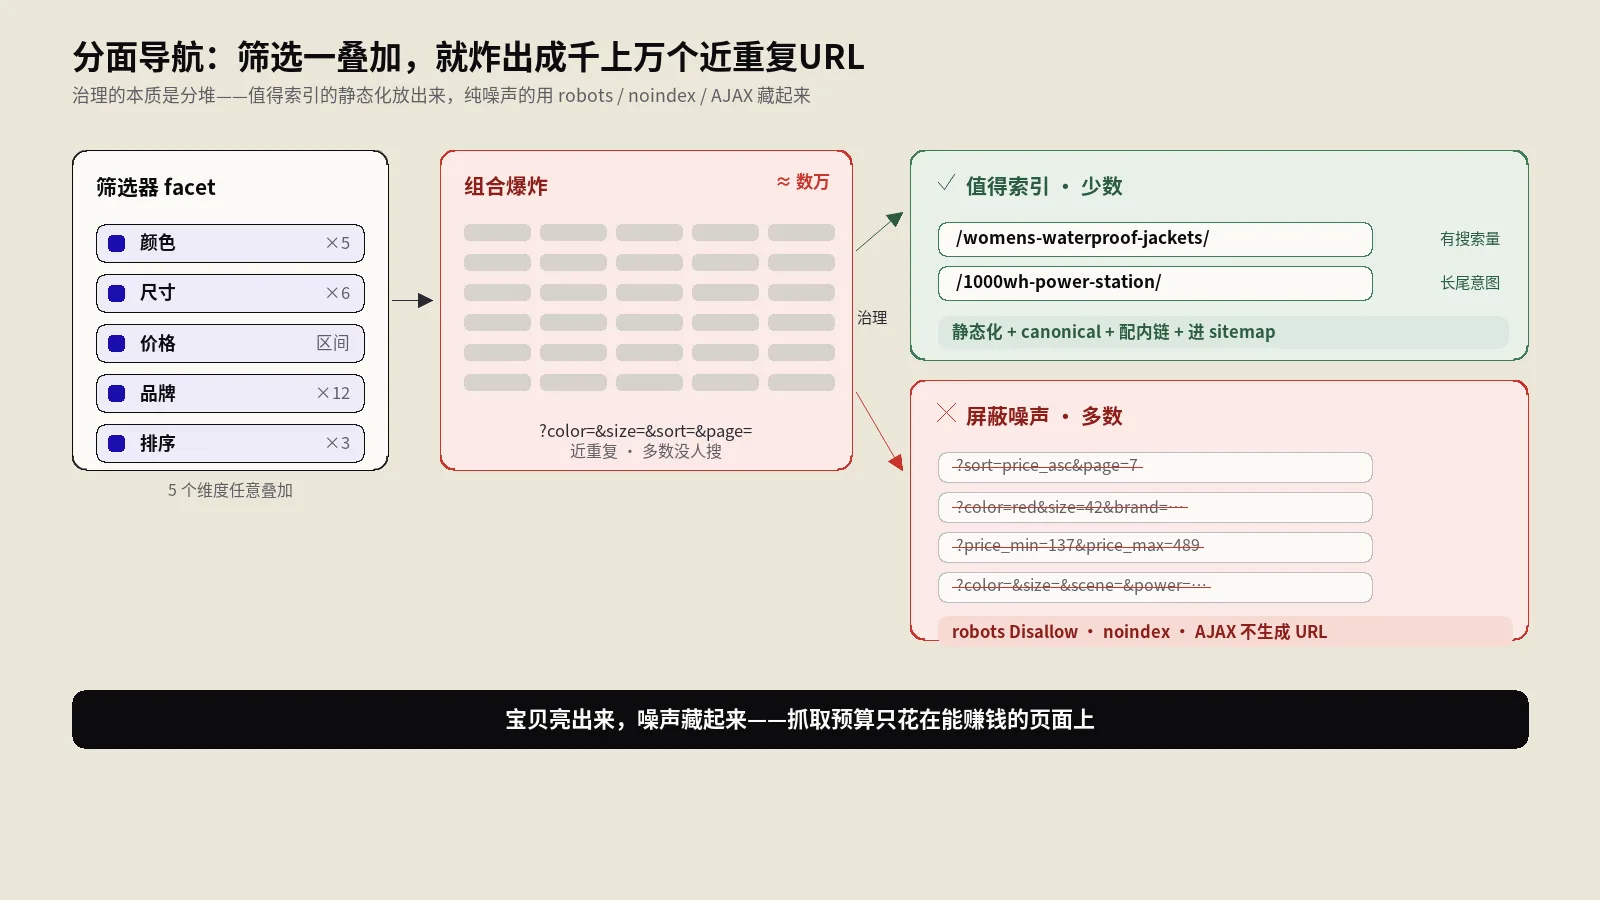
分面导航让用户叠加筛选找货,却在URL层面生出成千上万近重复地址,吃光抓取预算、撑爆索引、稀释内链权重。这篇讲清该先用搜索需求把筛选分成值得索引和纯噪声两堆,再分别用canonical、noindex、robots.txt和AJAX各管一段,附决策树与平台落地。
Shopify、BigCommerce、Wix、WooCommerce或直连支付,分别怎么开通AI购物代理结账?这篇逐个对号入座,并说清为什么真正费力的是产品数据,而不是ACP、UCP这些协议本身。

从2020年起Google购物标签页几乎整个改成免费,商品不花广告费也能在搜索、图片、Lens里露脸。本文把这条被荒废的自然通道讲透:七大曝光面、两条进场路、GTIN与合规门槛、归因怎么做对,一路到出海独立站落地。
