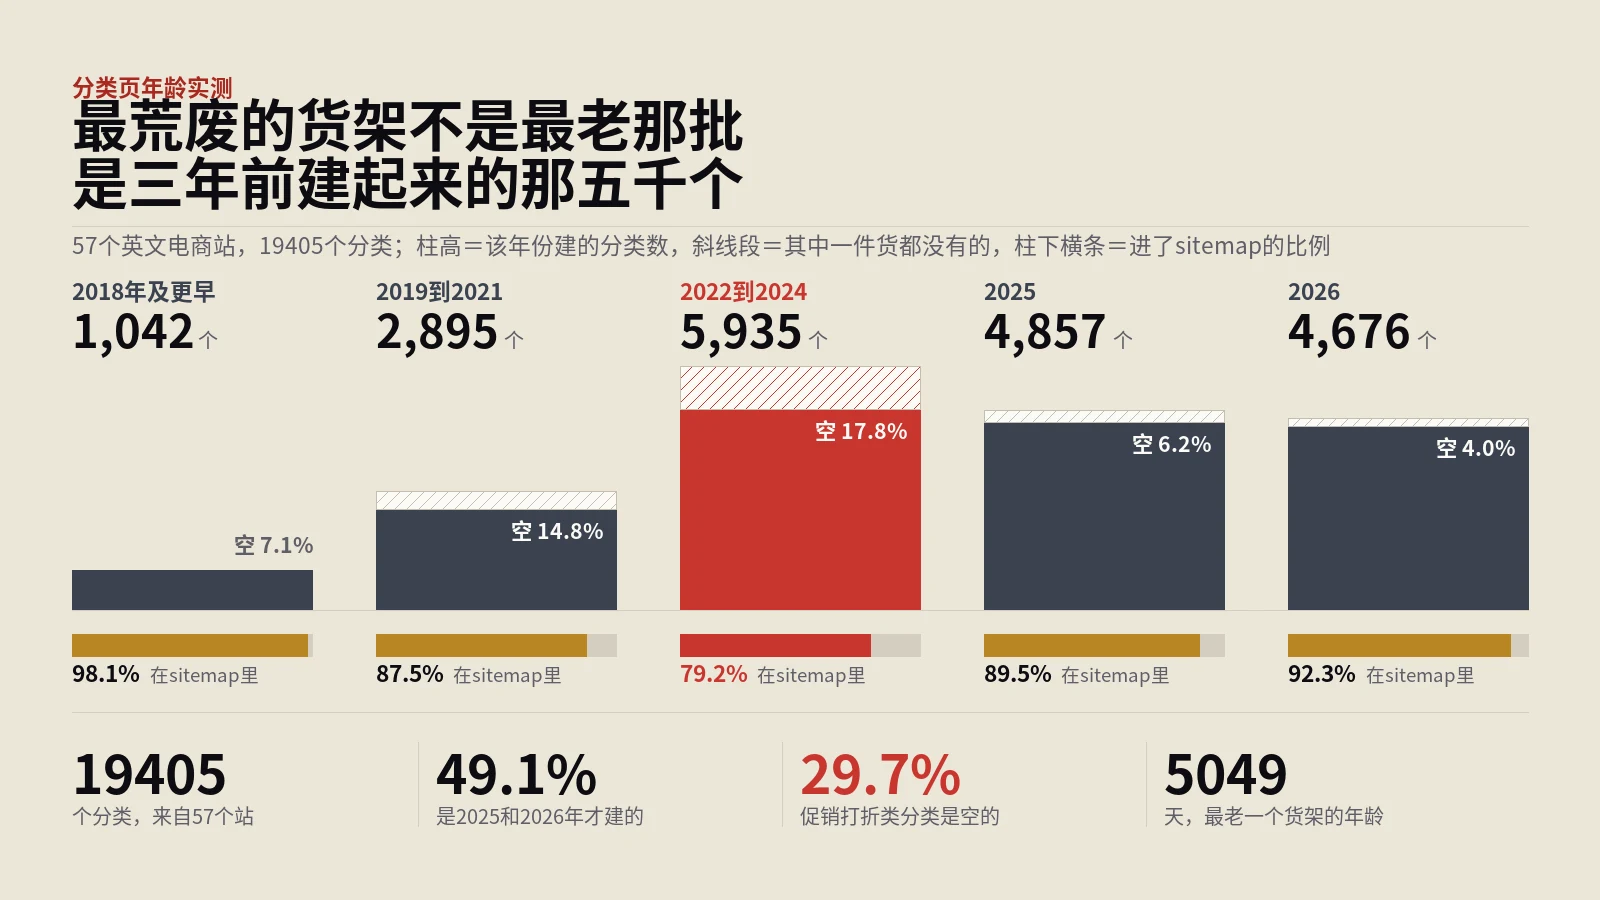
分类页越老越荒废?19405个实测,最乱的是三年前建的那批
把57个英文电商站的19405个分类按建立年份切成五个桶,逐桶交叉商品数、描述长度、题图、sitemap收录与首页导航覆盖这五项指标;再用一组正则按handle的命名把它们分成促销、节日、赠品、联名等类别,跟空置率交叉;接着把分类的年龄与它里面商品的货龄配对,看货架和货哪一头更旧;最后用真实浏览器逐个打开每站最老与最新的分类页,核对状态码、最终地址与robots标记,并把不可靠的读数逐条剔出去。
内容再好,爬虫抓不到、收录不进去也是白搭。这里深入技术SEO,从抓取预算、robots与sitemap、canonical与hreflang到JS渲染、日志分析和索引膨胀治理,帮开发和SEO协作把工程底子打牢。
把57个英文电商站的19405个分类按建立年份切成五个桶,逐桶交叉商品数、描述长度、题图、sitemap收录与首页导航覆盖这五项指标;再用一组正则按handle的命名把它们分成促销、节日、赠品、联名等类别,跟空置率交叉;接着把分类的年龄与它里面商品的货龄配对,看货架和货哪一头更旧;最后用真实浏览器逐个打开每站最老与最新的分类页,核对状态码、最终地址与robots标记,并把不可靠的读数逐条剔出去。
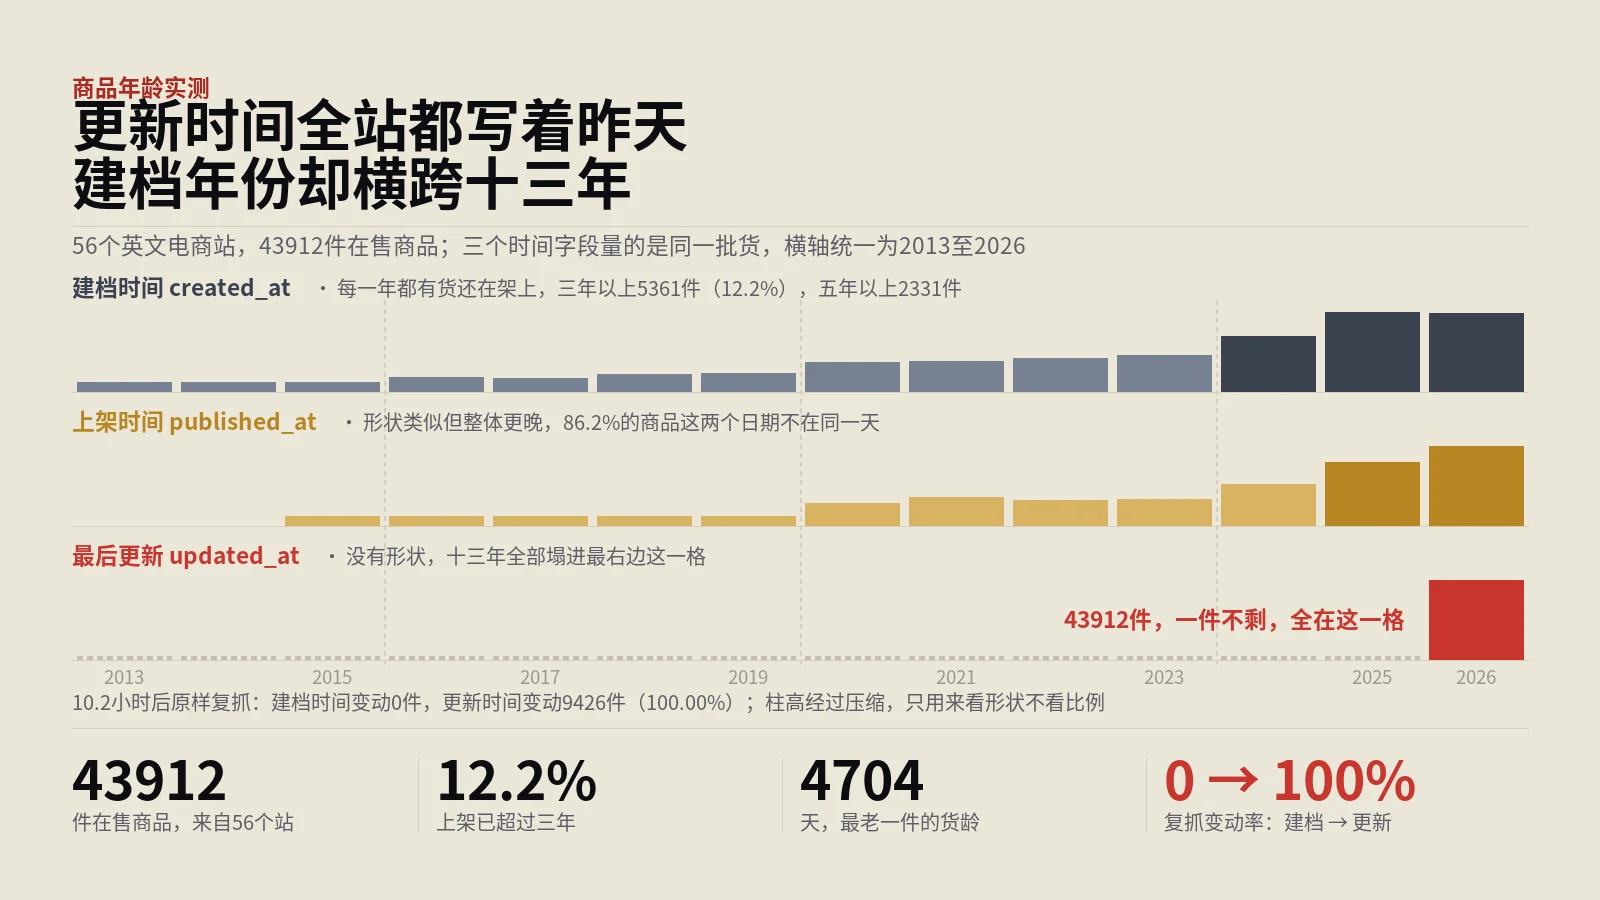
实验台从60个英文电商站的公开商品清单接口取回43912件在售商品与19405个分类的全部时间字段,再隔10.2小时把同一批站原样复抓一遍做纵向对照,用同一次测量里的另外两个字段当基线,判断哪一个字段真的记录了内容变动。随后按建档年份把商品分桶,逐站配对比较老货与新货在sitemap收录、首页两跳可达、前台是否仍在售三个维度上的差别,最后用真实浏览器逐个核对可疑读数,扣掉地区路由与渲染异常的站点。
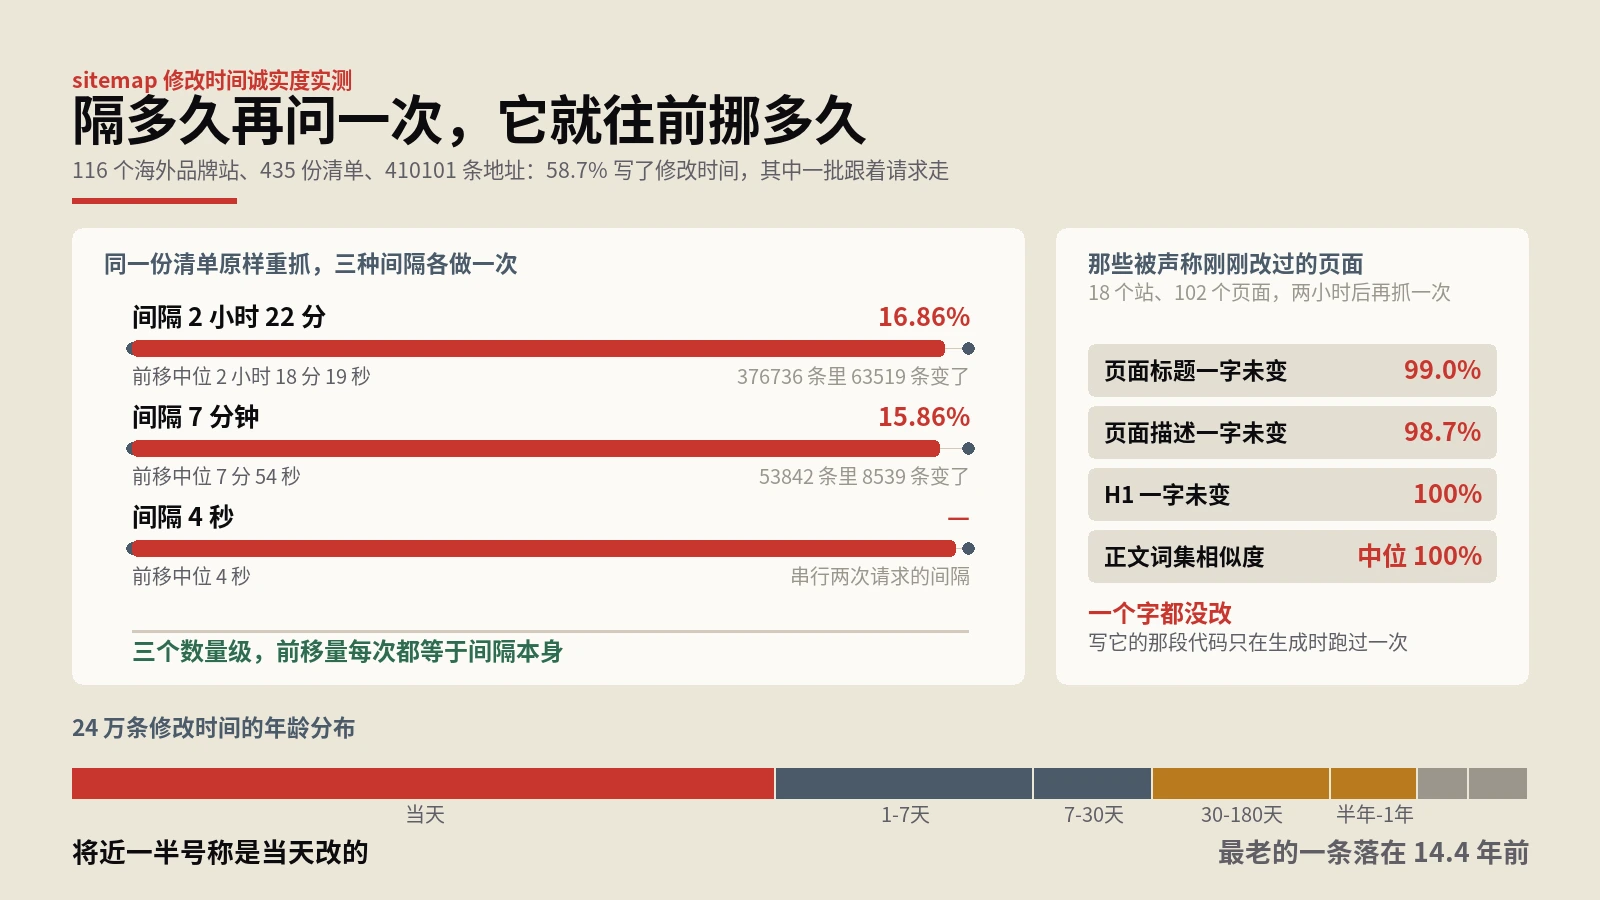
把143个站声明的sitemap两层全拉下来,435份文件、41万条地址,逐条解析修改时间字段,再按2小时22分、7分钟、4秒三种间隔各重抓一遍做前后比对;对声称刚刚改过的页面另做一次正文闭环,逐字比对标题、描述、H1与正文词集;最后用两种身份同时请求同一份文件,把测量顺序造成的假差异从身份差异里扣干净。文中给出覆盖率、精度、年龄七档分布、时间戳聚集度、索引层与子文件层的对账结果,一次把尺子量歪的完整复盘,以及一套可以在自己站上一分钟跑…
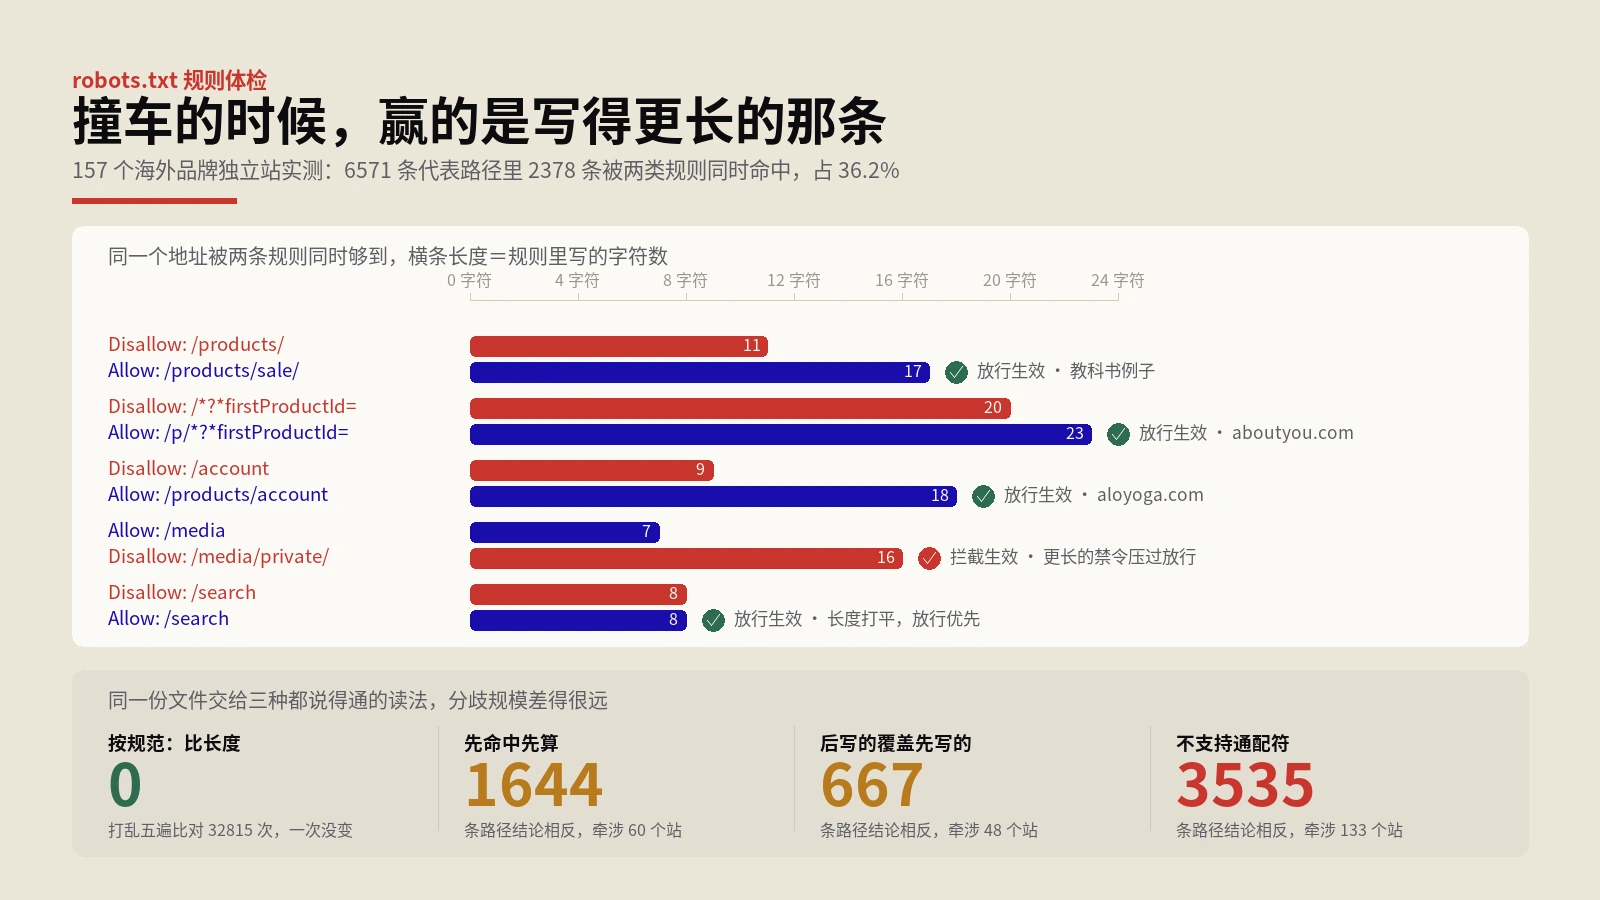
按RFC 9309从零实现一遍匹配器,再用三种办法把157份robots.txt的合并效果逐条判出来:给每条规则生成一个一定能匹配的代表路径,做删除实验看这条规则删掉之后判定变不变,以及把规则随机洗牌五遍验证顺序到底有没有影响。文中给出撞车率、胜负分布、空转成因分类、三种解析器读法的分歧规模,以及一套五步自查顺序和两次量错口径的完整过程。
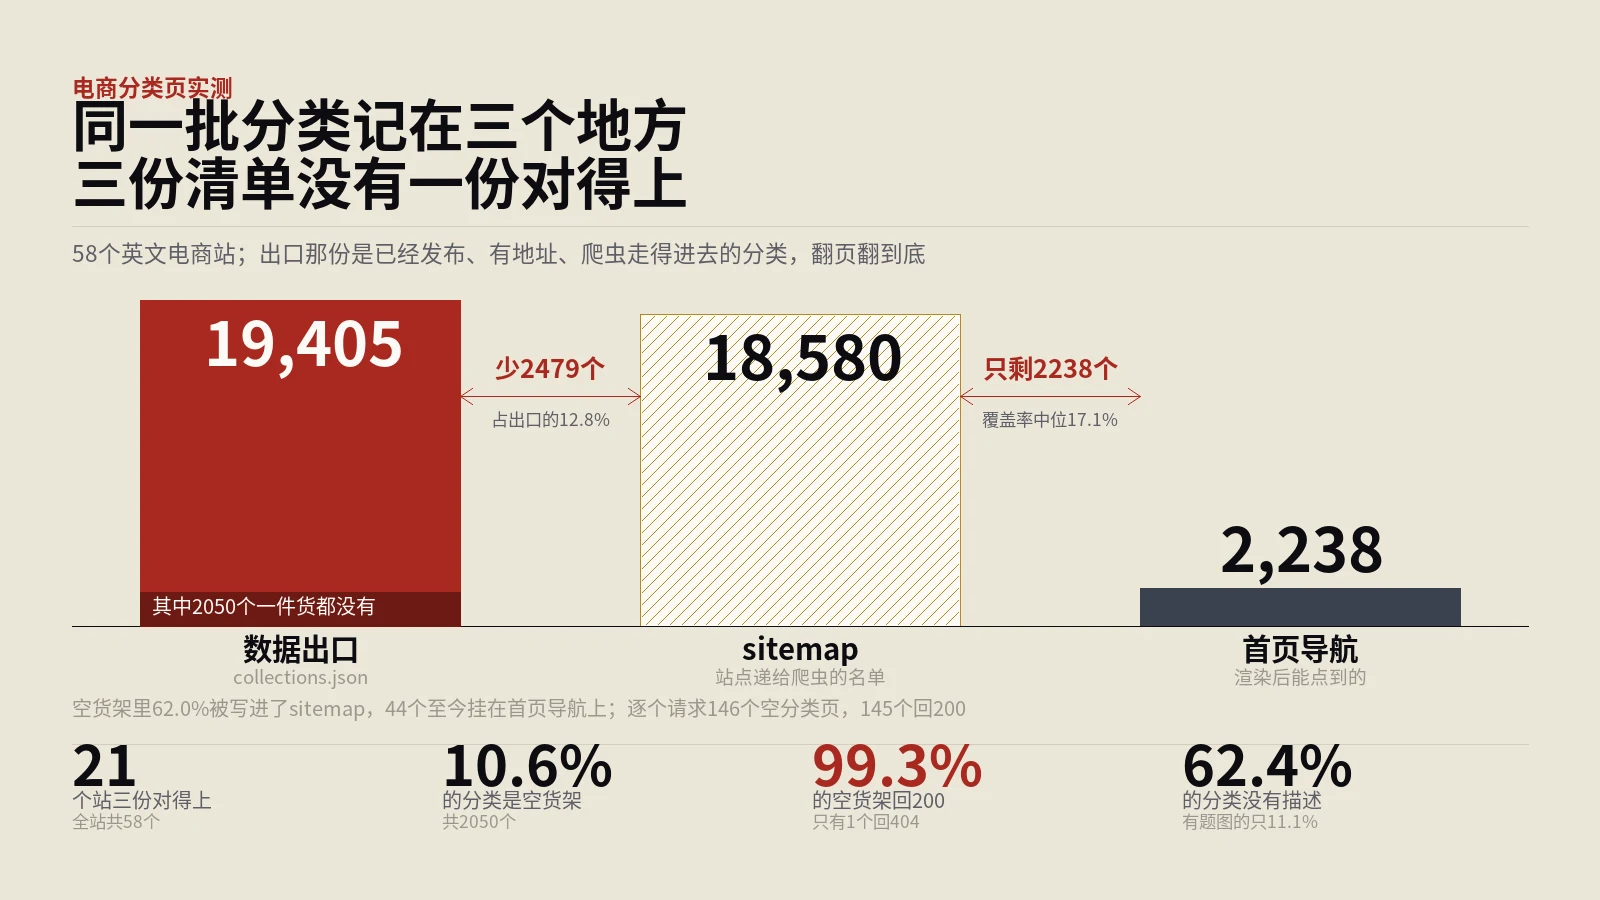
做法是把同一批分类从三条独立路径各取一份清单:不用登录就能读的分类出口、站点递给爬虫的sitemap、以及首页渲染后DOM里能点到的链接。sitemap那一份要按语言分卷拆开只取根语言,否则翻译过的handle会被算成另一批;导航那一份不能只抓静态HTML,得用无头浏览器渲染后取并集。空货架的判定不数页面上的商品链接,改用商品清单接口加浏览器里正文区可见的商品卡两条一起看。
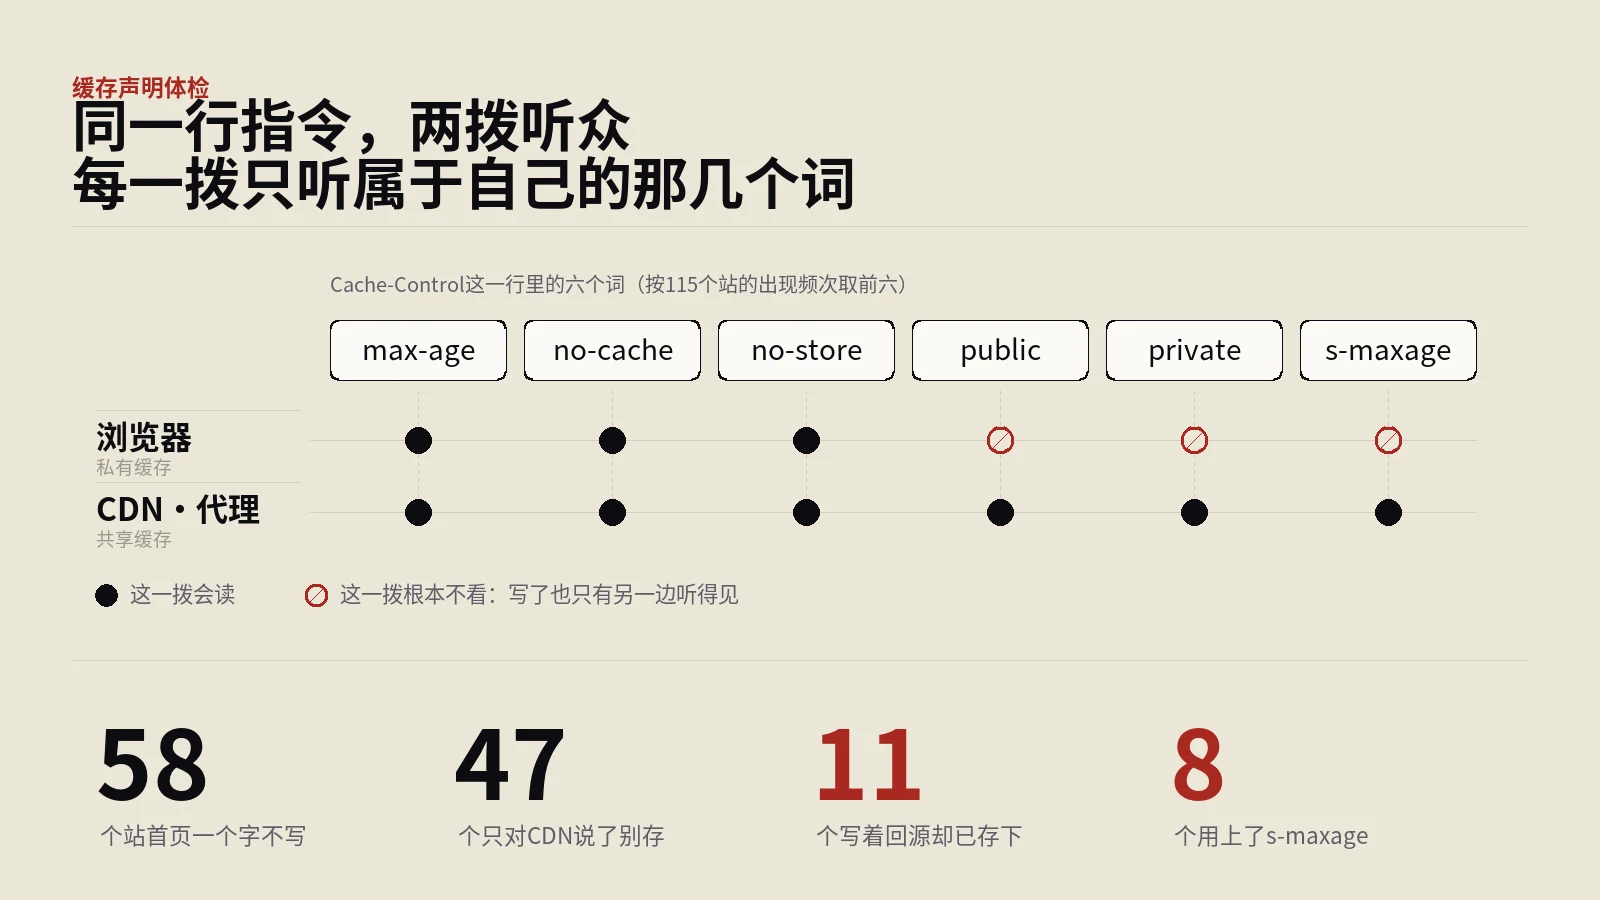
量法是每个站的首页连打三次、再各取一个CSS、一个JS、一张图片、一个网站图标和robots.txt,逐个记下全部缓存相关响应头,用Age字段反查谁真的把它存下来过。尺子中途出过两次问题:并发开太高让11个站返回429,差点被读成这些站没数据;以及把不带Age当成没被缓存,而115个站里91个不带Age,其中72个带着CDN自己的命中标记。
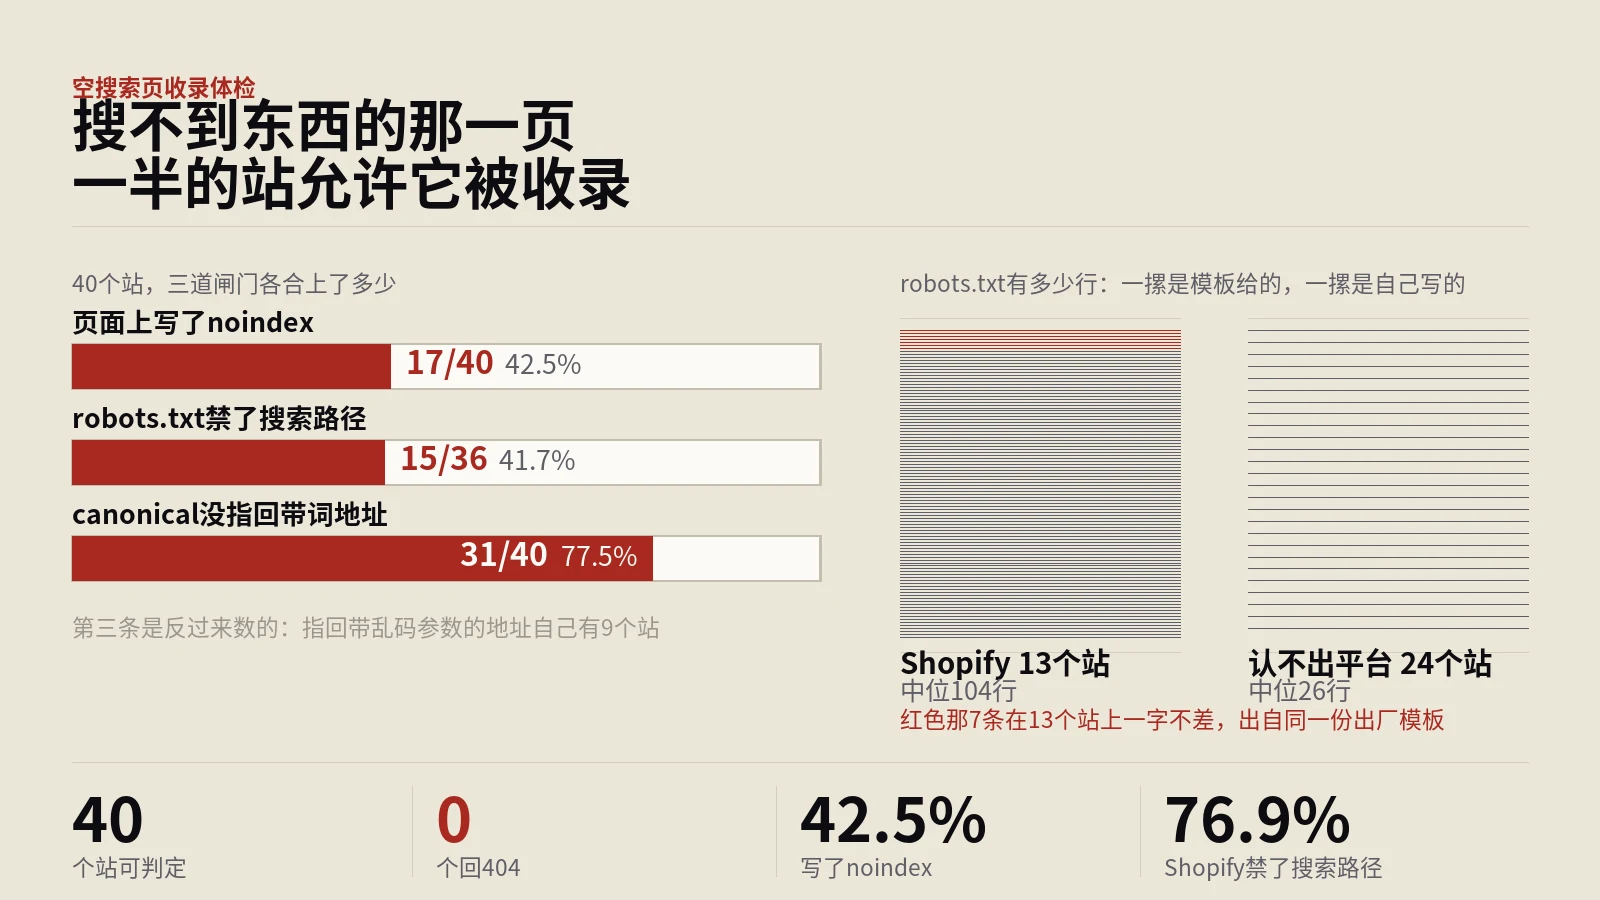
做法是拿两个乱码词加一个必然搜得到的词各请求一遍,回答不跟着变的站说明它压根没在搜,整体剔出分母,69个里剔掉了29个。归属靠覆盖率判断:同平台里覆盖率越高的指令,越可能来自出厂模板。
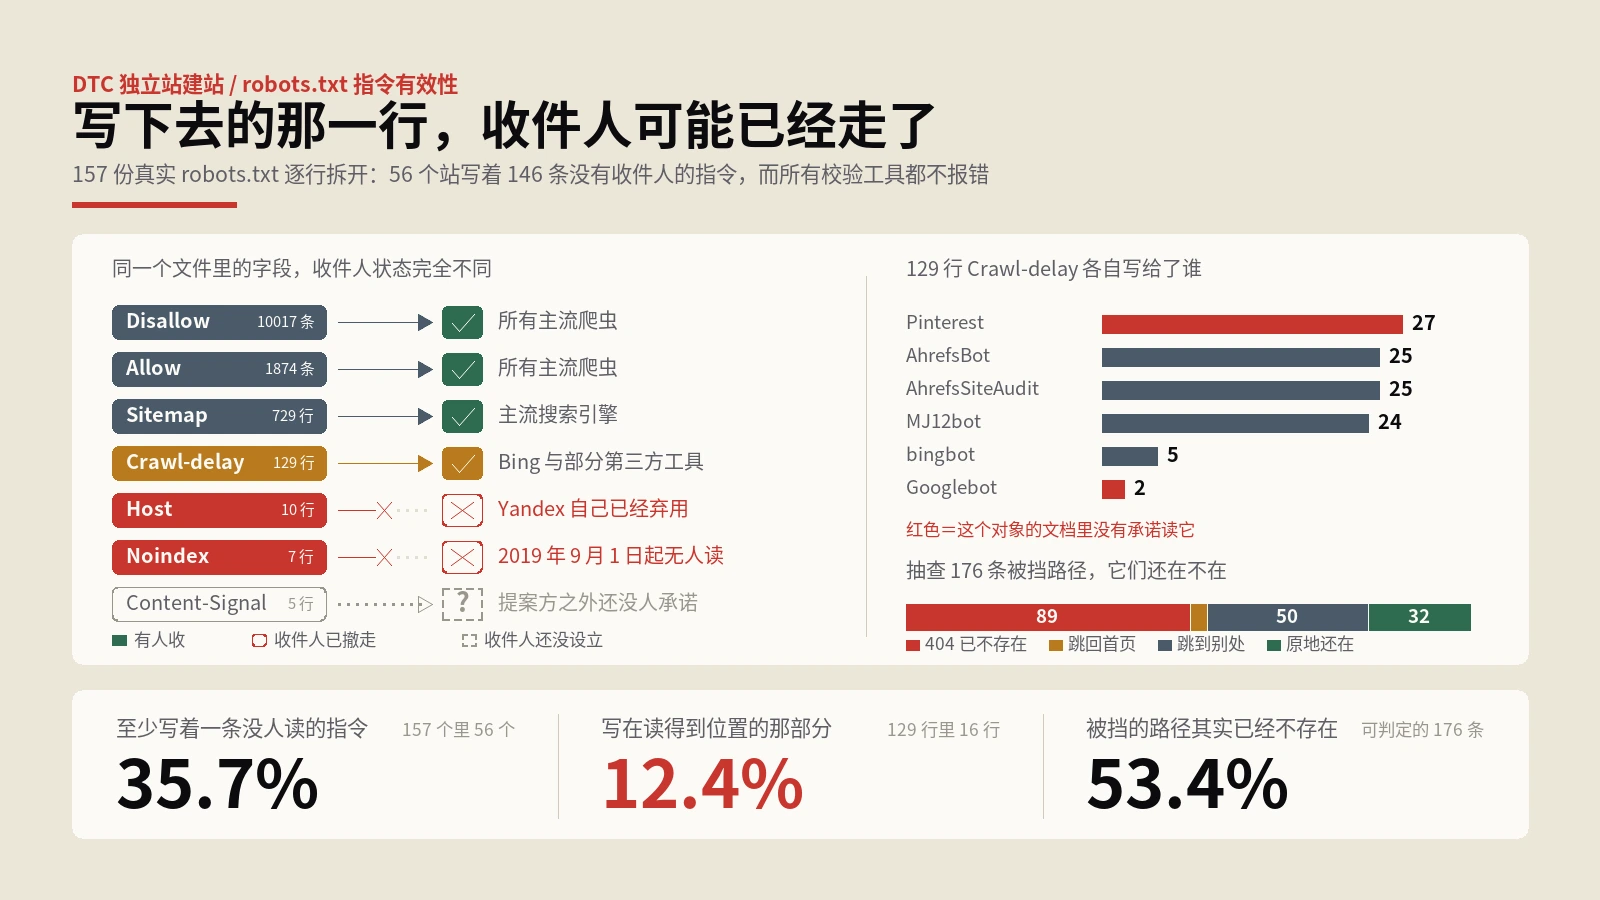
给robots.txt做一次收件人体检的量法:先把字段名去重列出来,多出常规四五种的逐个查谁在读;再比通配组与专属组的条数差;抽三条具体路径实际请求看还在不在;最后把依据和日期写成注释留下。含157份真实文件的逐字段实测、四步自查清单与两种服务端替代写法。
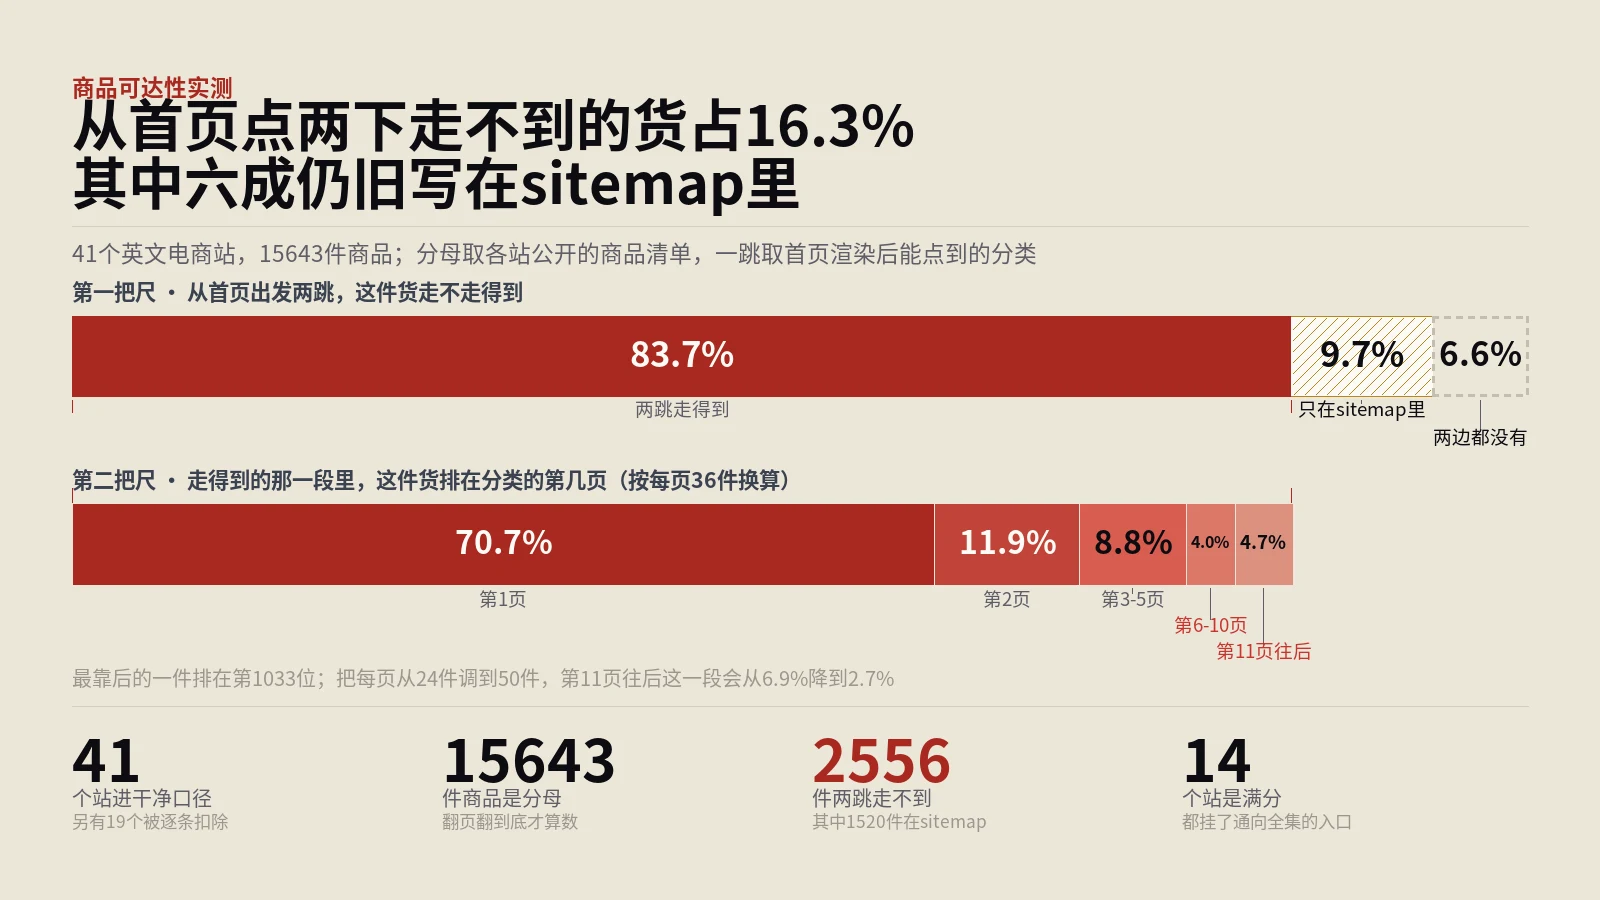
实验台分三层搭:分母取各站公开的商品清单接口并翻页到底,第一跳取首页渲染后DOM里的分类链接(只用静态HTML会漏,gymshark从0变92),第二跳取这些分类各自的商品清单。名次按商品在各分类里的最好位置计,再按每页24、36、50三档分别换算页码,不预设某个站用了哪一档。逐条扣掉地区路由、变体级伪商品、语言分卷重复、翻页截断、导航不走collections路径这五类干扰,60个候选站最后41个进干净口径。
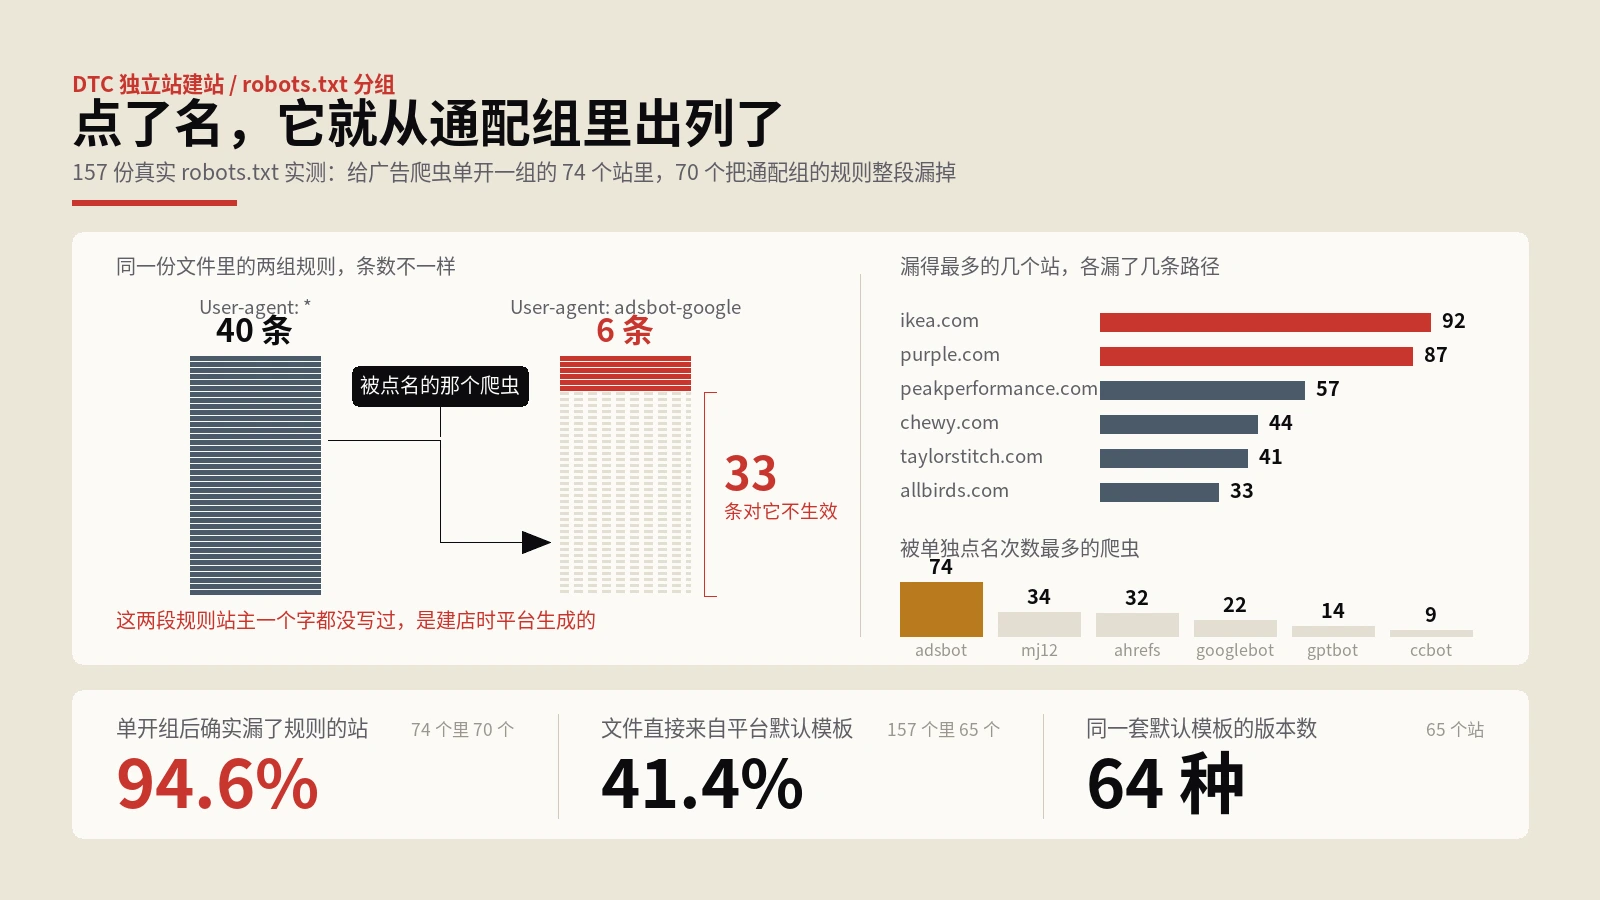
给robots.txt做一次分组体检的完整量法:先数通配组的Disallow条数,再数每个专属组的条数,两边做减法找出被漏掉的路径;接着把不会生效的Crawl-delay、Noindex、Host这类字段清掉;最后用测试工具按地址乘爬虫名做一个小矩阵逐个验证,把结果存下来当回归基线。文中给出157份真实robots.txt的实测数据、三种写法的效果对照表、五步自查清单,以及把平台默认模板接管过来之后要承担什么。
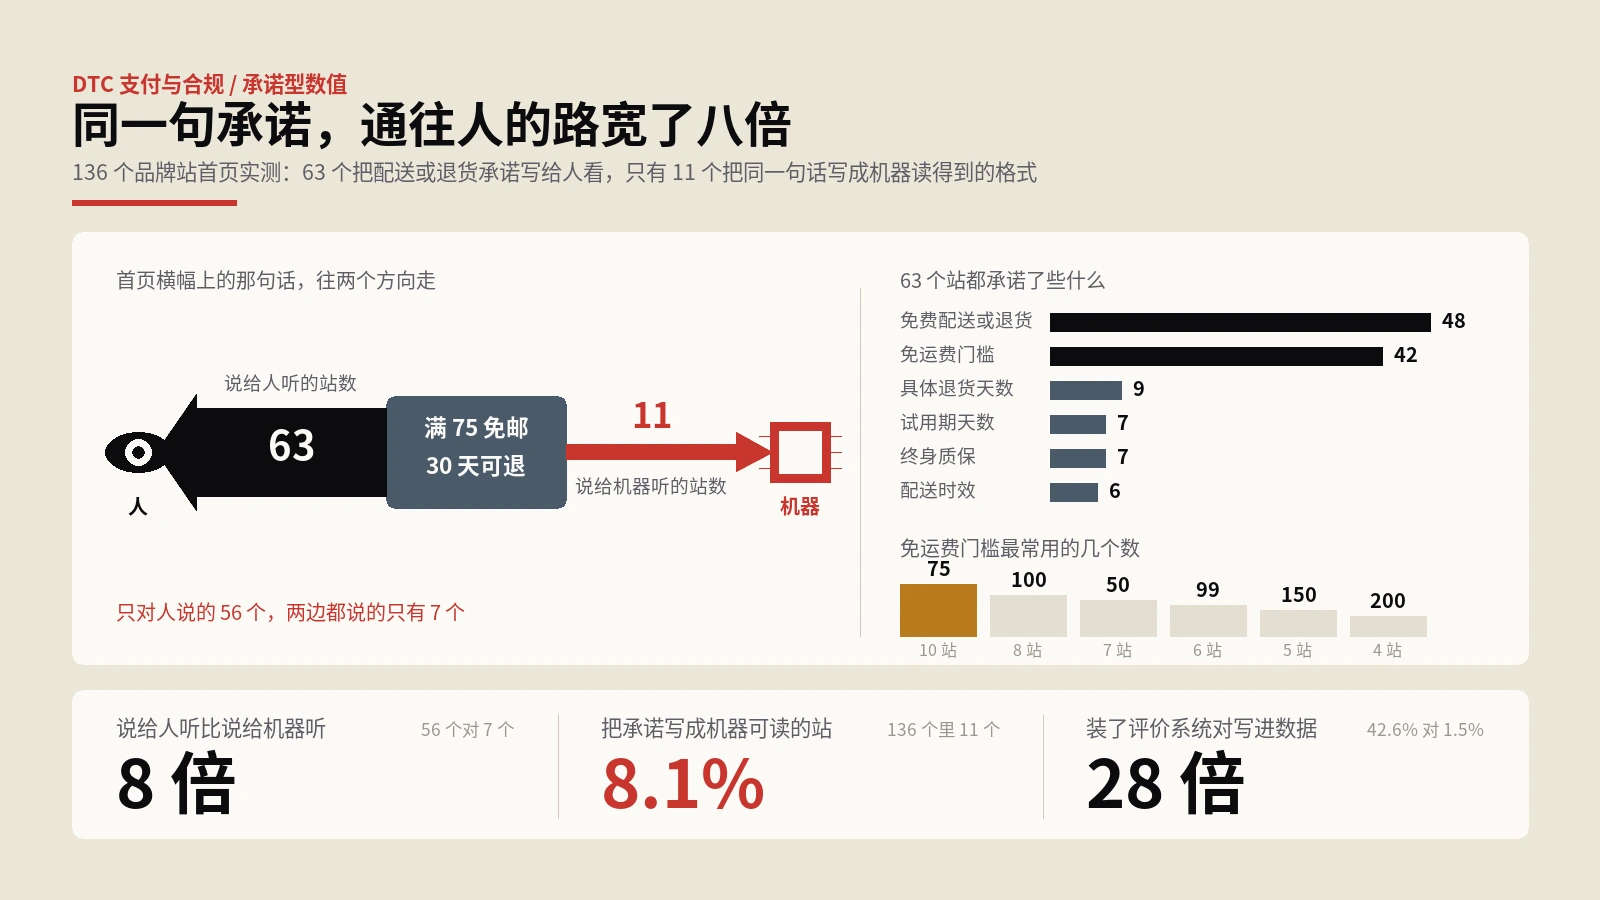
要判断一个站的承诺有多少是说给机器听的,有一套可以照着跑的量法。第一步把页面上人能读到的文字提出来,去掉脚本和样式只留正文,用一组模式匹配承诺类表述:免运费、免退货、多少天退货、多少天试用、多少天送达、多少年质保、终身质保、满意保证,各语言的常见说法都要覆盖。第二步在同一个页面的机器可读部分里找对应字段:配送详情、退货政策、退货天数、免运费门槛、处理时长、运输时长。两步结果交叉,就能算出只对人说、两边都说、只对机器说和两边都没说各有多少…
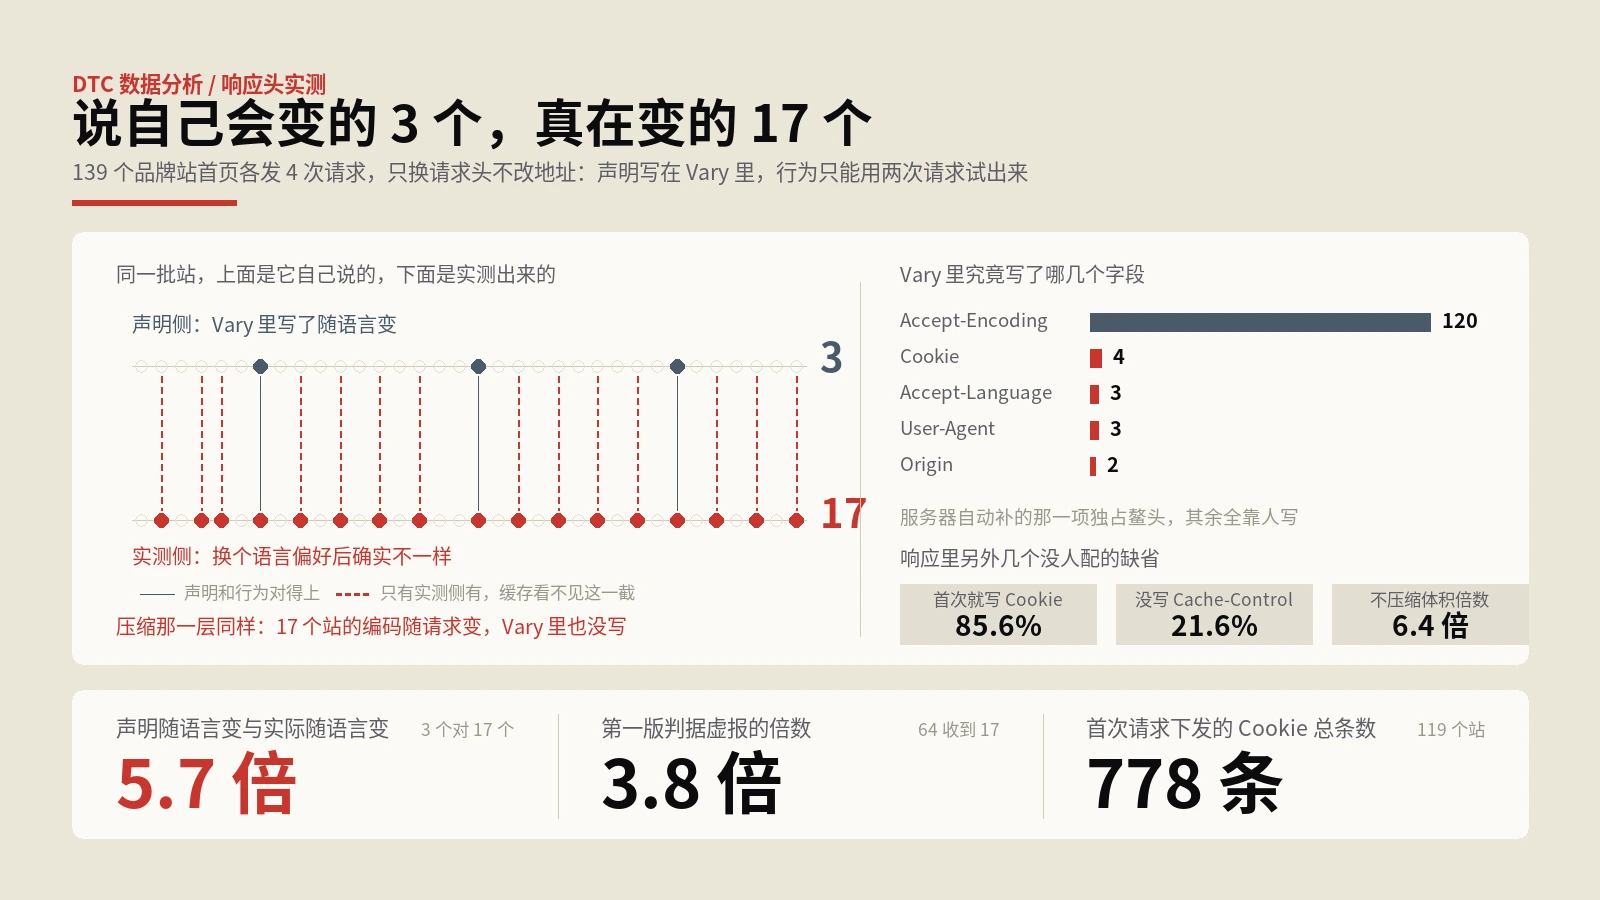
把响应的不成文缺省测出来的完整做法:对同一个地址发三次请求,分别换掉语言偏好、去掉压缩声明、保持原样,再比对最终地址、页面语言标记、标题与正文体积这四项稳定证据;拿到变化维度清单之后逐项去核对Vary头,多了删、少了补。文中给出139个站的实测分布、判据从宽到严导致数字缩水3.8倍的完整过程、五分钟版与半天版两套清单,以及修复该落在哪一层。
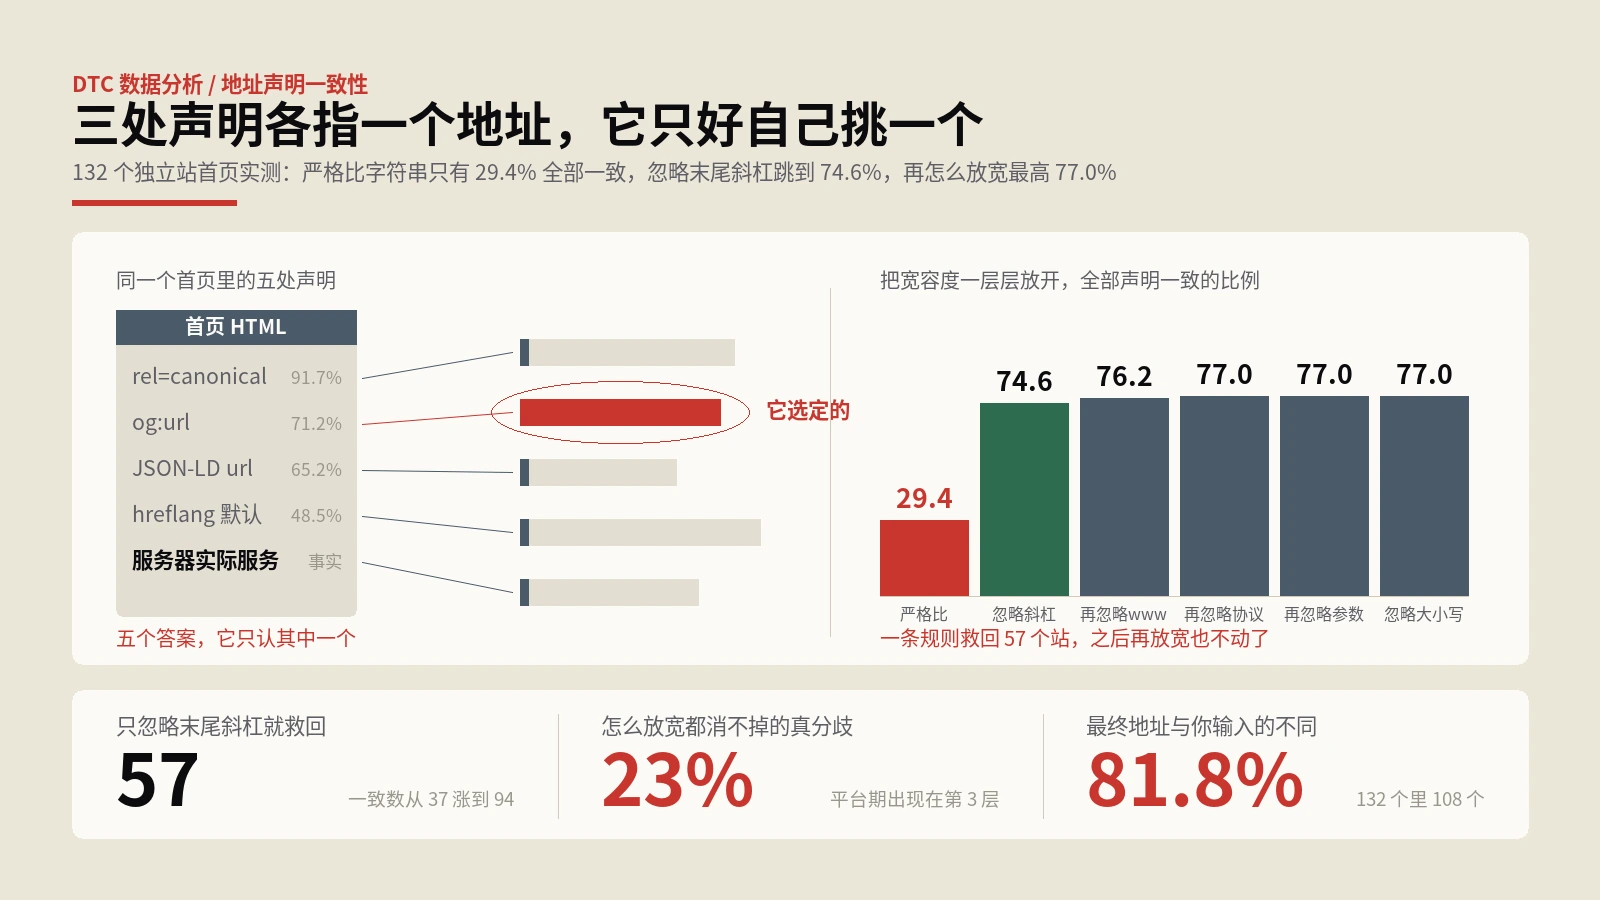
把一个页面对自己地址的所有声明抠出来做对齐,这件事有一套可复现的跑法。先取事实,用跟随跳转的请求拿到服务器实际服务的那个地址,别拿你输入的那个当基准;再从原始源码里取出规范网址、og:url、hreflang默认版本、结构化数据里的url这四处声明;然后做分层比对,第一层严格比字符串,第二层忽略末尾斜杠,第三层忽略www,记下它在哪一层变成一致,那一层就是问题的性质;最后比对站点地图,逐字符比。一个页面十分钟,全站按模板抽八到十个就够。
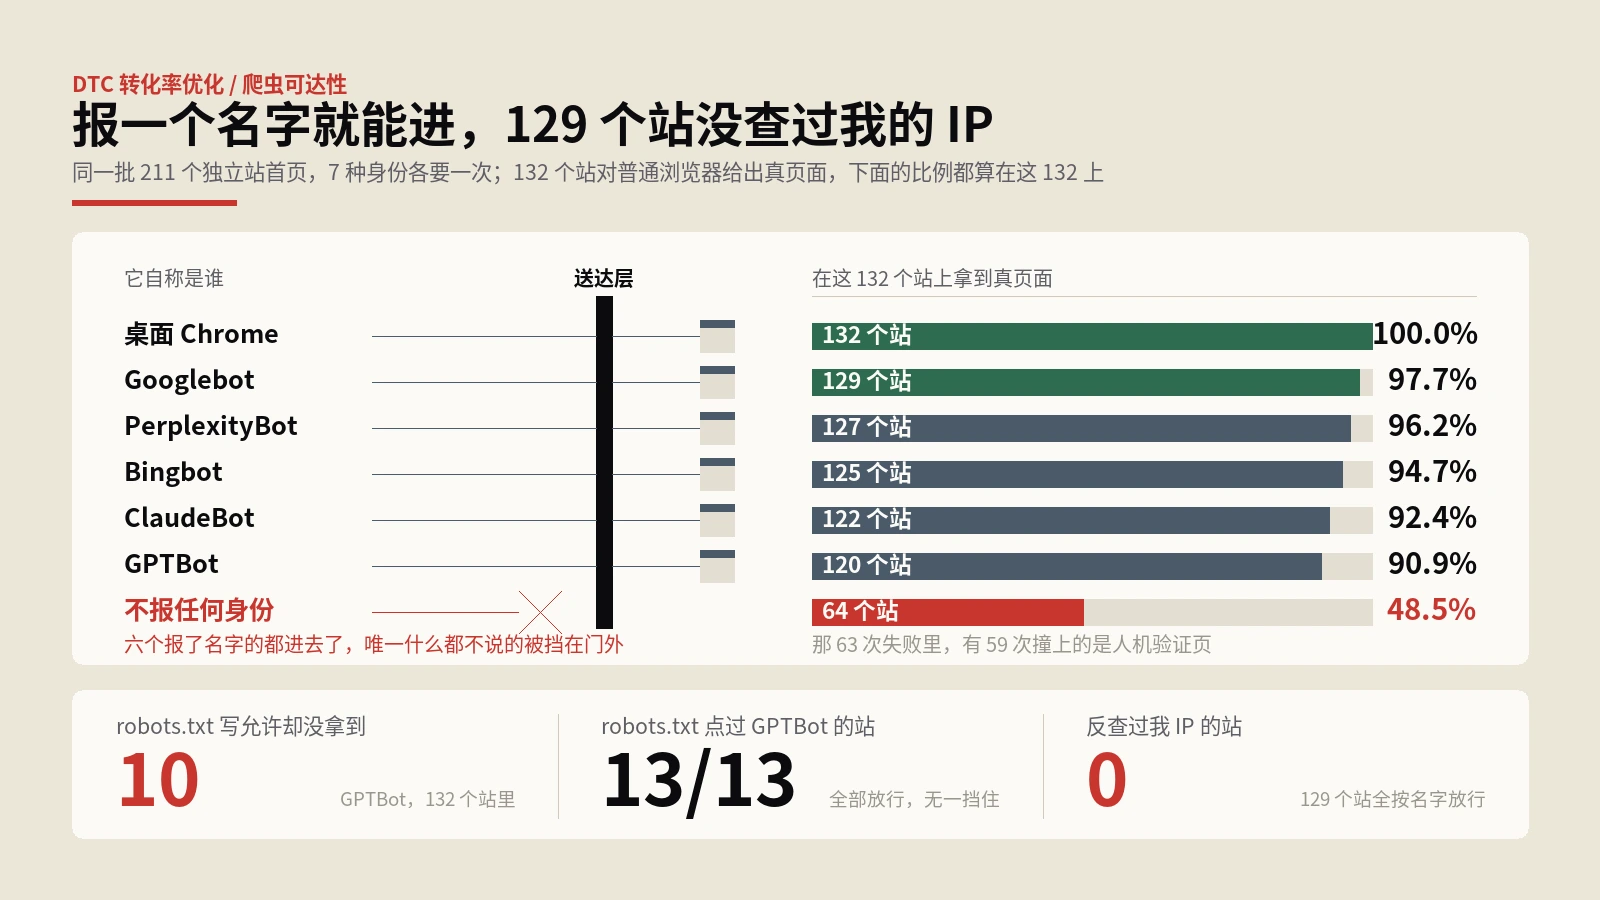
一个页面拿不到,先别急着改内容。正确的顺序是把同一个地址换几种身份各要一次,逐项比较状态码、正文字节数和最终落点,两次结果不一样就说明问题出在送达层而不是内容层。本文给出七种身份对照的完整跑法,包括基线怎么从数据内部长出来、什么算真的拿到了页面、拒绝页可以用哪四类信号自动识别、声明层与送达层的两层对齐审计怎么在半小时内做完,最后是一份每天跑一分钟、覆盖五个地址三种身份的监测清单。
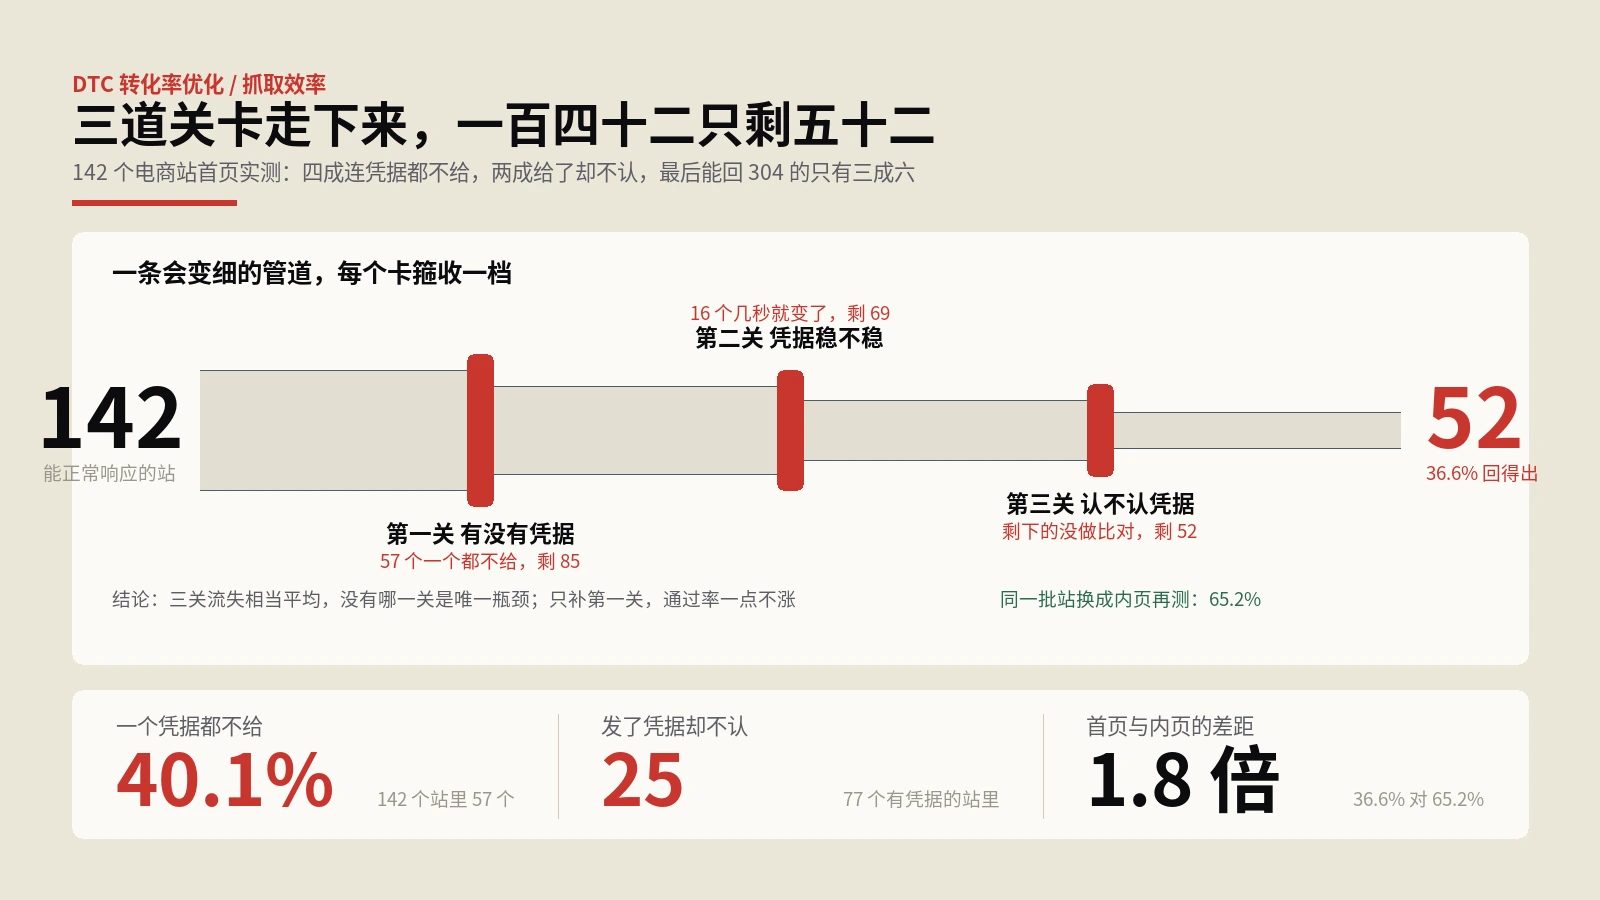
排查条件请求要按关卡来:先看响应头里有没有可以拿来协商的凭据,再连发两次看凭据稳不稳,然后带着凭据重发一次看回不回304,最后确认最后修改时间填的不是当前时刻。文中把这套顺序在211个国际化电商域名上走了一遍,逐关给出该看哪个头、判据定在哪、失败对应哪种成因,末尾附一张四种失败对应四种修法的对照表和一份三分钟自检。
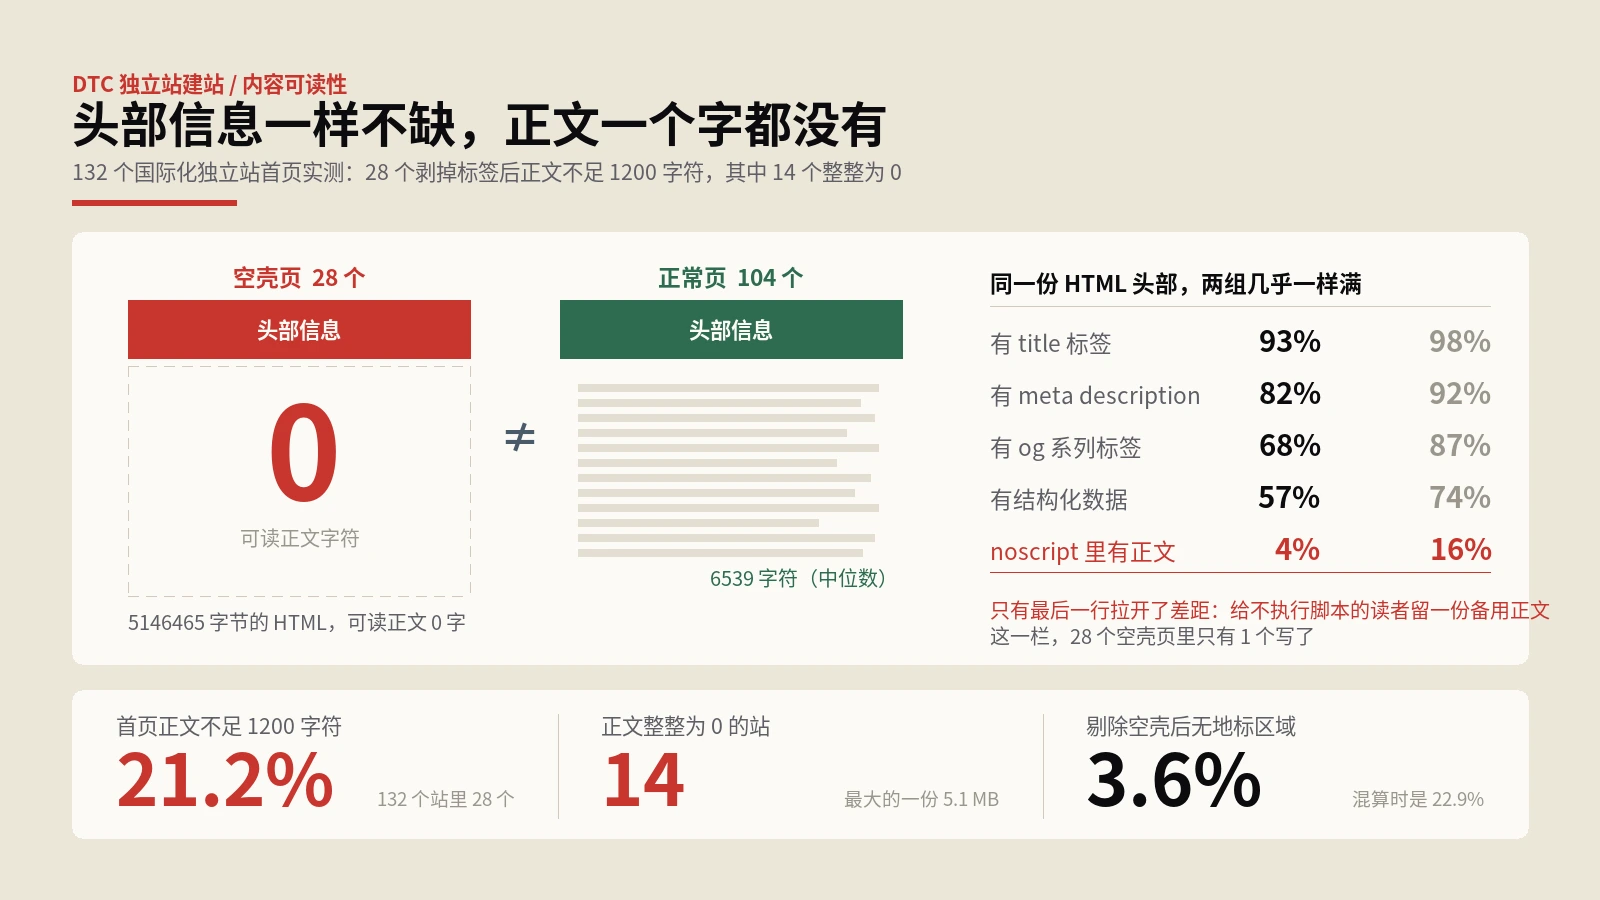
排查顺序比工具重要:先抓一次首页把标签剥干净数字符,判断这一页有没有把内容交出来;正文正常再进第二层,在字节里找按钮的名字、图片的替代文本、表单标签和地标区域;只有字节里找不到、而页面上确实有的,才需要打开浏览器看渲染后的无障碍树。文中把这三层在211个国际化独立站上走了一遍,逐层交代口径怎么定、基线从哪来、哪些样本必须先剔掉,末尾给出一张行业参照表、一份分诊流程和三个能在一个下午跑完的动作。
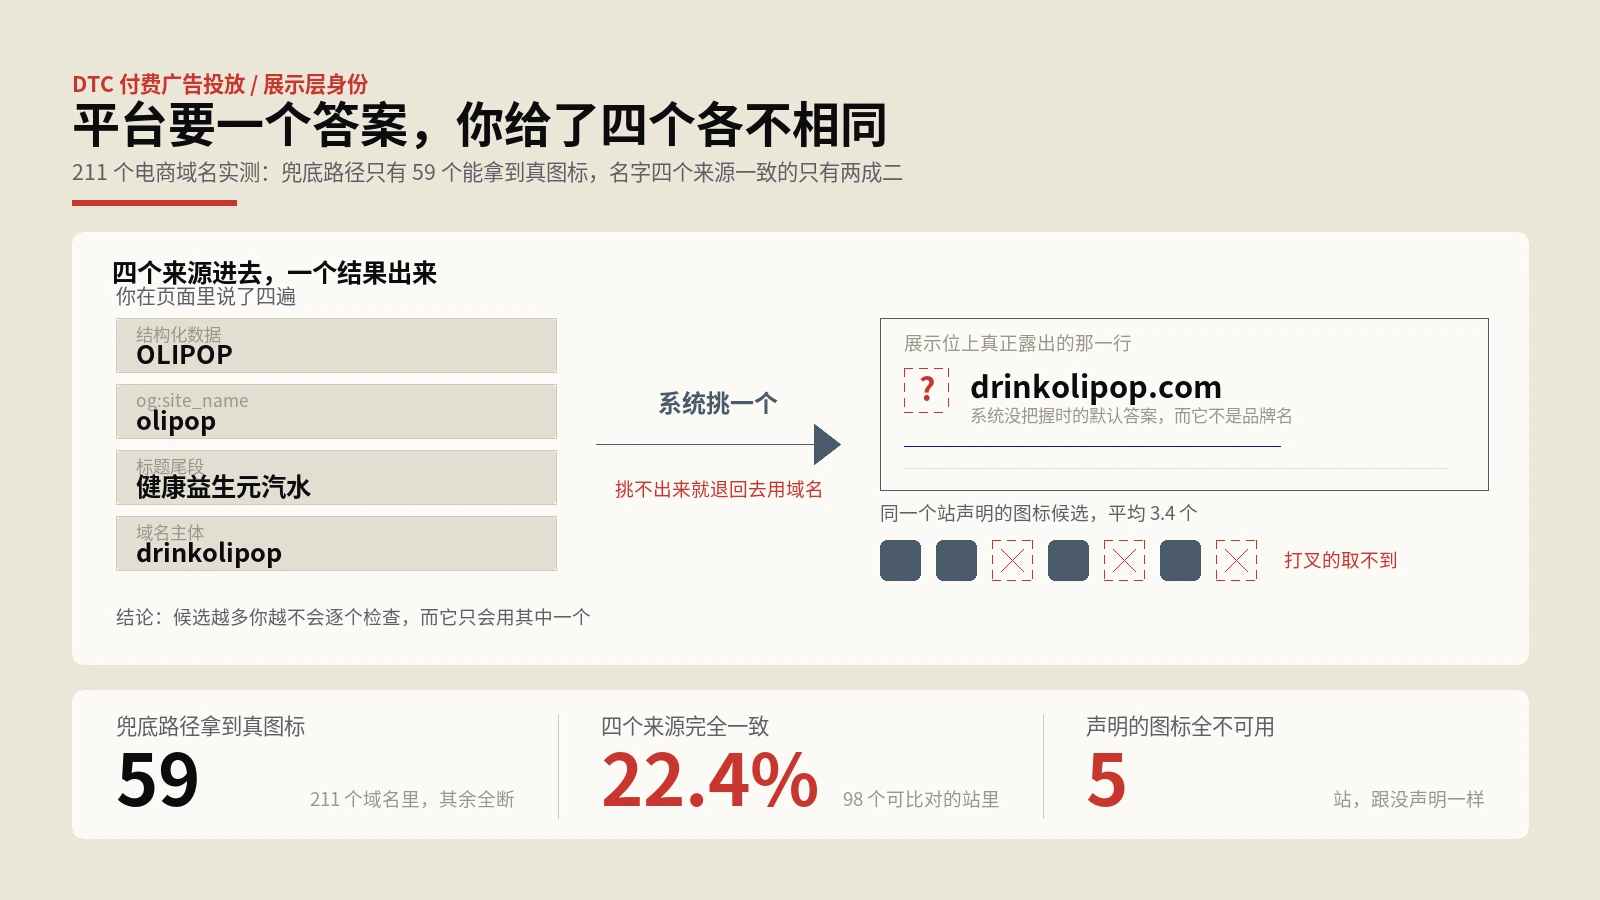
排查展示层身份要按顺序来:先数首页声明了几个图标,再逐个请求确认返回的是能读出宽高的图片,然后核对形状与尺寸,最后修兜底路径;名字那一半则是先补WebSite结构化数据,再把og:site_name和标题尾段调成同一个词。文中把这套顺序在211个国际化电商域名上走了一遍,逐步给出每一步该看什么、判据定在哪、什么情况可以放过,末尾附一张九项核对表和一份发布流程挂钩清单。
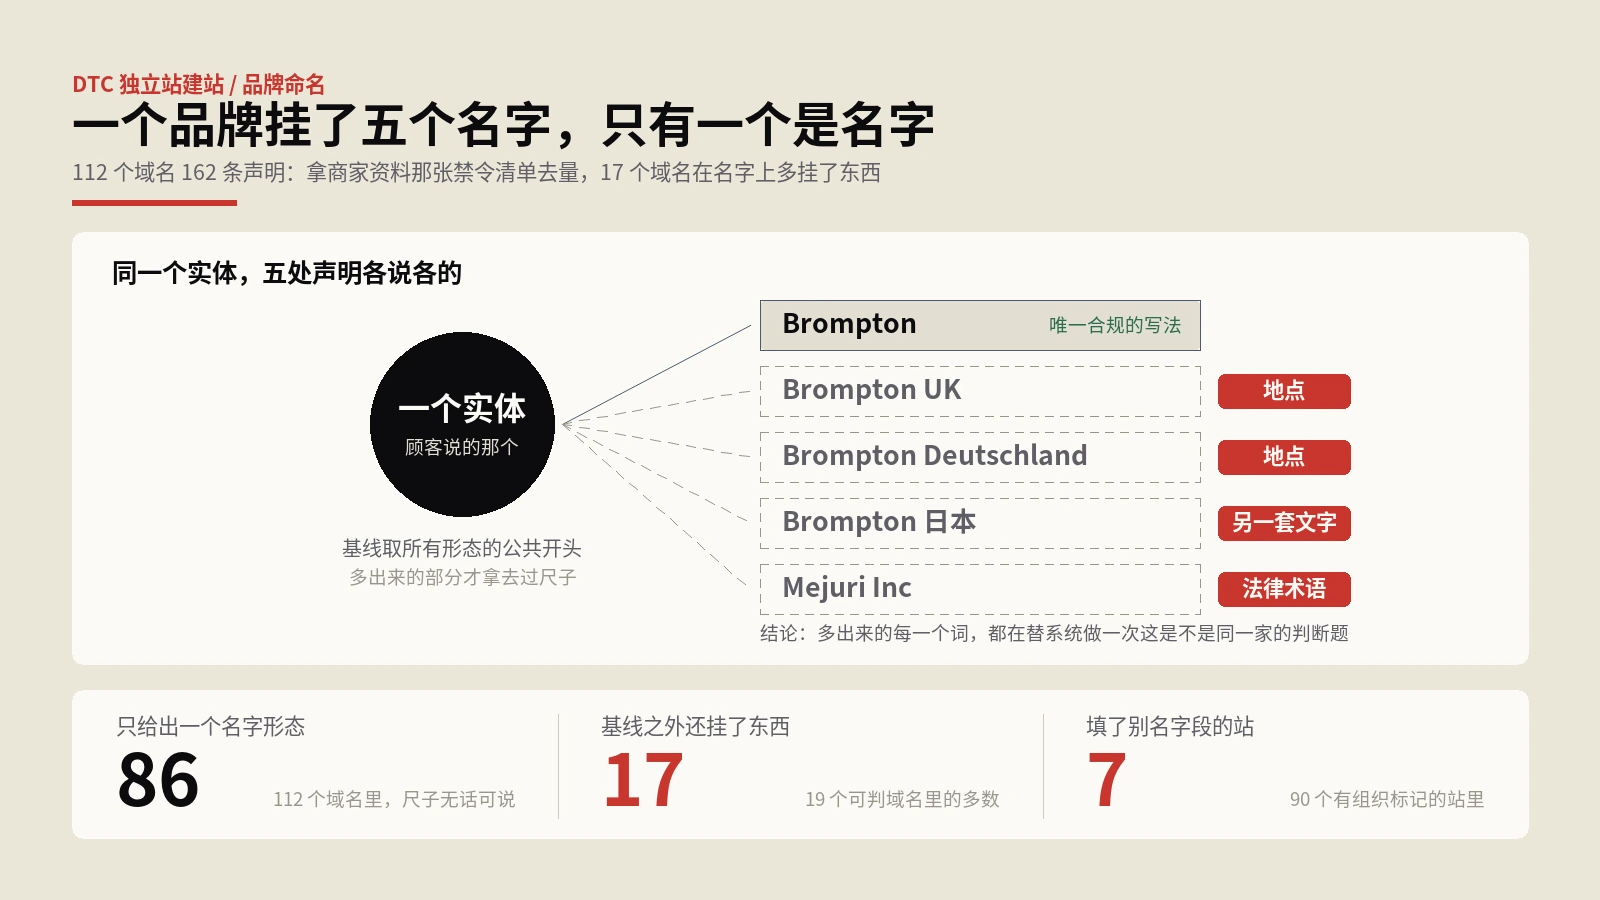
盘点品牌名要按顺序来:先把站上所有会说出名字的位置列全,再定一个顾客口头在用的基线名,最后逐个语言版本做减法。多出来的词按去处分流,国家地区直接删掉,法律后缀移进legalName,另一种文字移进alternateName,母公司名交给关系属性。文中把这套顺序在112个域名上走了一遍,逐步说明每一步该看哪个字段、判据定在哪、什么情况该弃权,末尾附一张六列盘点表、一张别名分流表和一份三分钟自检。
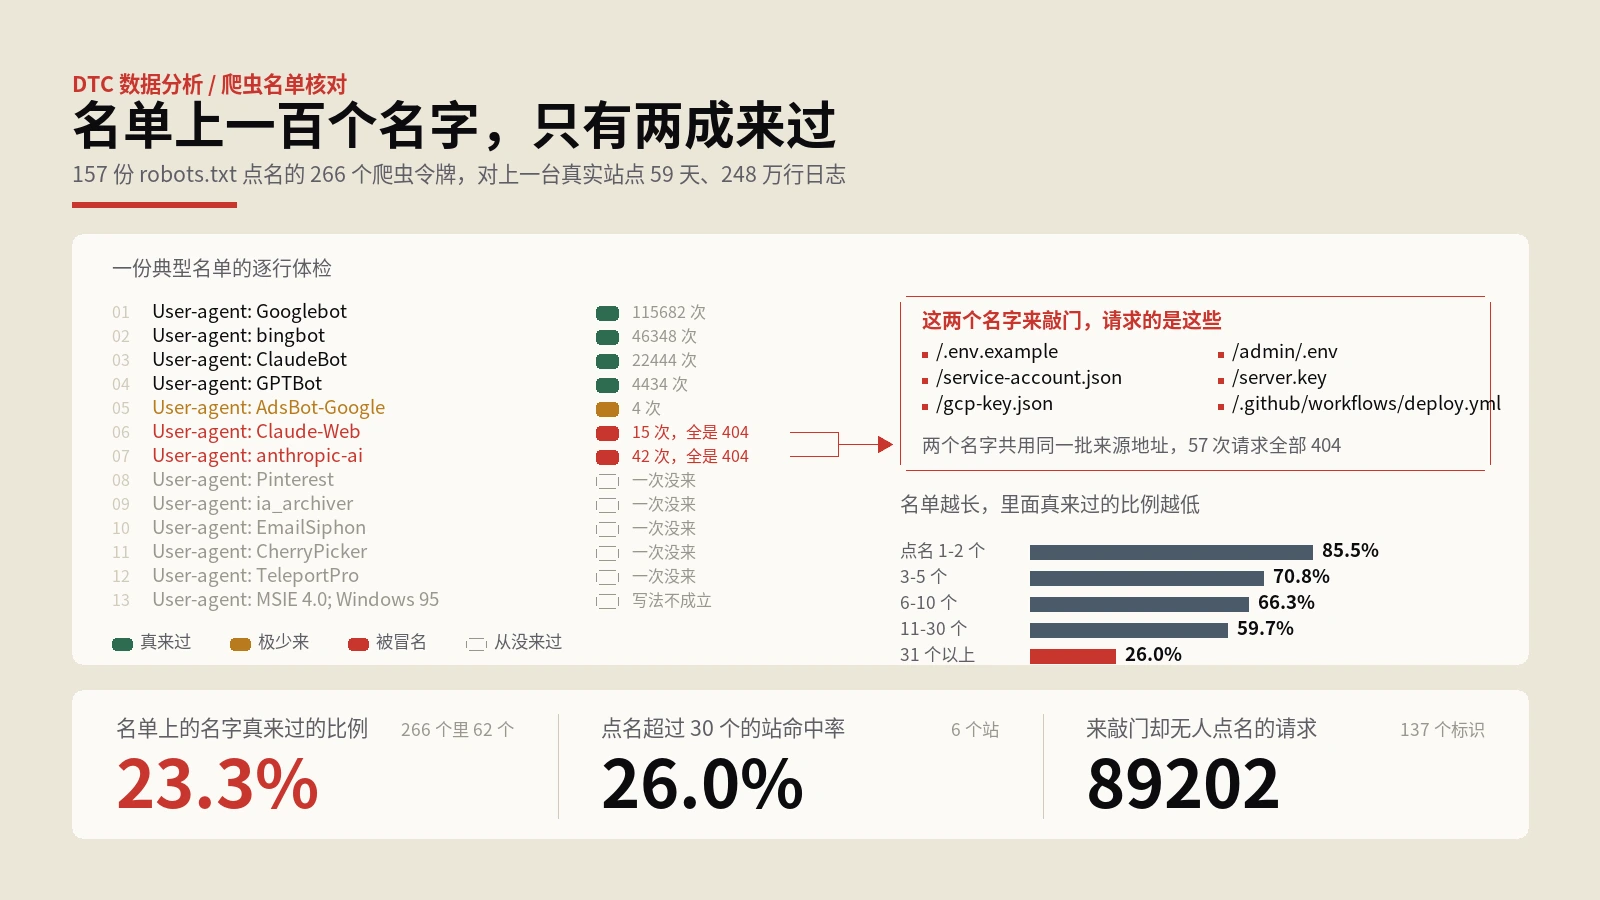
给robots.txt里的爬虫名单做一次核对的完整量法:先从访问日志提取真实来访的抓取标识,再逐个对文件里的名字算命中率,接着按用途把来过的分成五类给不同待遇,最后给每个分组补一行注明依据和日期的注释。含157份文件281个令牌与59天248万行日志的交集实测。
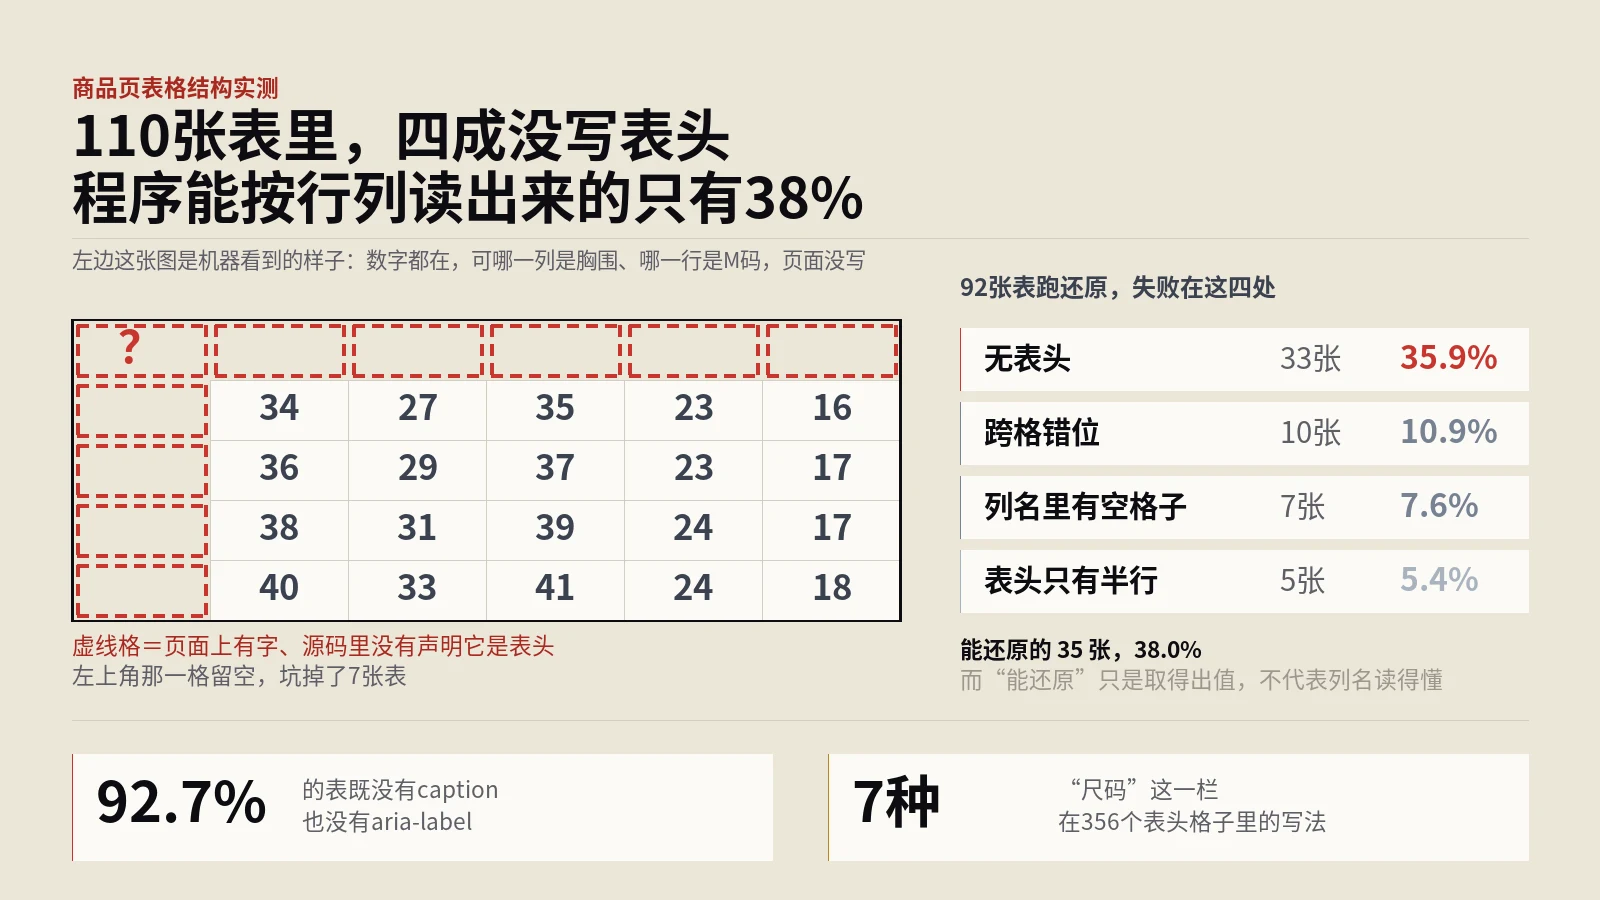
做法是把每张表最多20行12列的单元格连同标签类型一起原样取下来,再写一段还原程序按四条判据逐张试:首行是不是全部为表头单元格、有没有跨行跨列、各行格子数是否一致、列名是不是既非空也非纯数字,任何一条不满足就归进对应的失败类型。单位不从采集端的正则读,改成从表格矩阵离线重算,因为括号写法那种形式会被常规正则整批漏掉。格子总数不超过两个的空壳表单独摘出,不进还原成功率的分母。