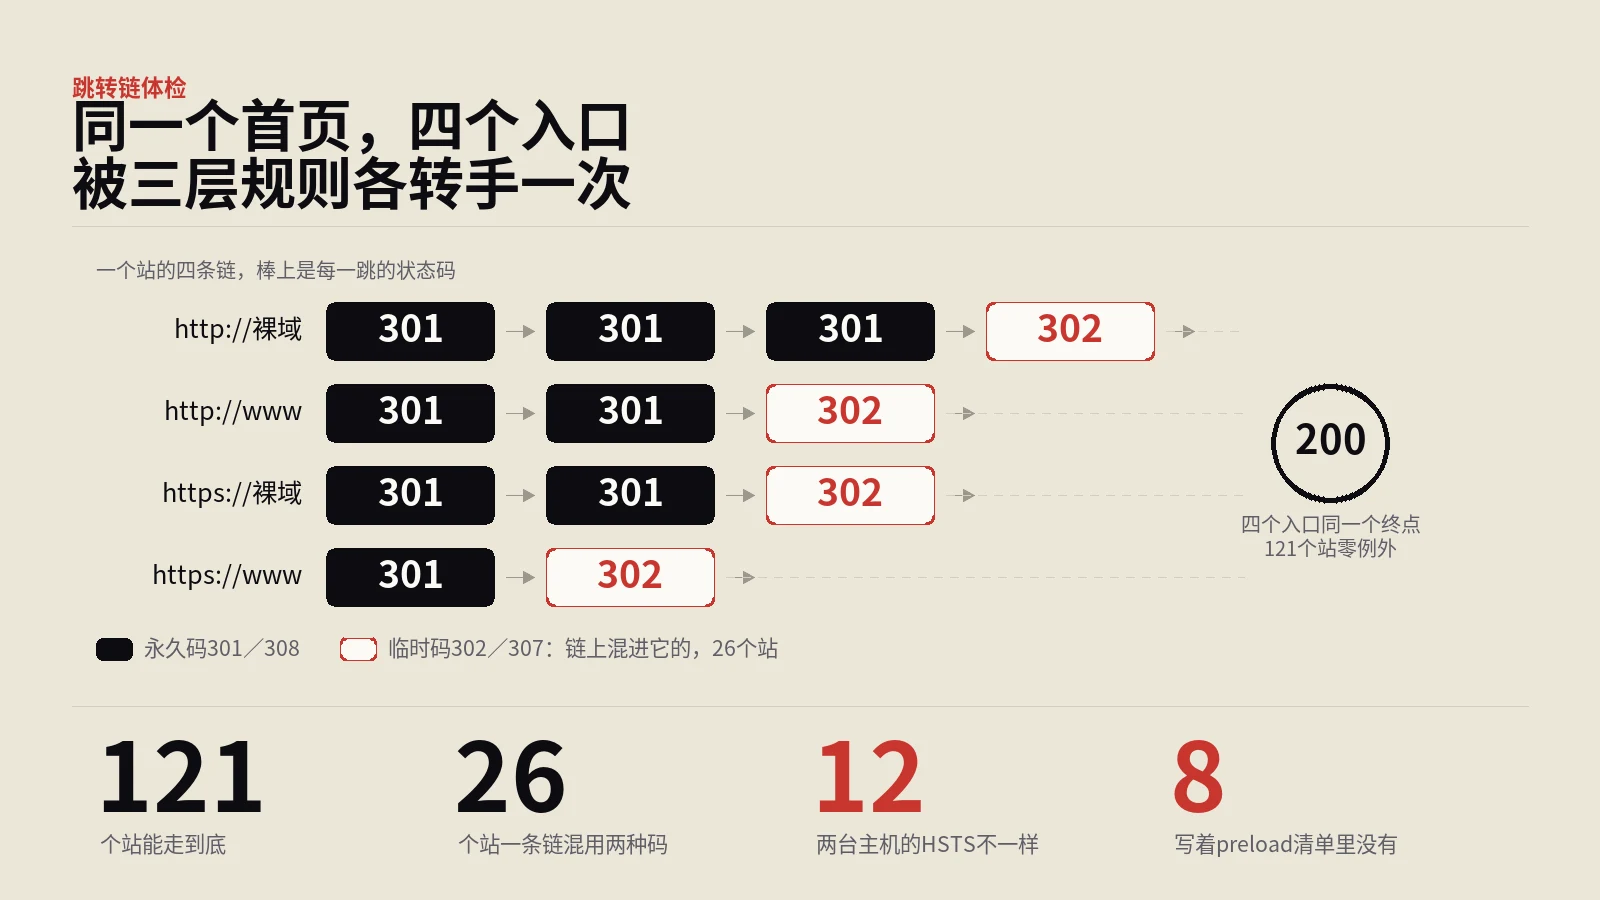
301重定向那条链,三个地方各写了一份规则
量法是每个站从四种入口各走一次不跟随重定向的链,逐跳记状态码和能认出厂商的响应头,再取两台主机各自的HSTS,最后拿域名去问浏览器预置清单的状态接口。中途尺子坏了四次:并发太高把限流读成没数据,用响应头认建站平台全样本命中零,还把抓取失败当成了没有指纹。
内容再好,爬虫抓不到、收录不进去也是白搭。这里深入技术SEO,从抓取预算、robots与sitemap、canonical与hreflang到JS渲染、日志分析和索引膨胀治理,帮开发和SEO协作把工程底子打牢。
量法是每个站从四种入口各走一次不跟随重定向的链,逐跳记状态码和能认出厂商的响应头,再取两台主机各自的HSTS,最后拿域名去问浏览器预置清单的状态接口。中途尺子坏了四次:并发太高把限流读成没数据,用响应头认建站平台全样本命中零,还把抓取失败当成了没有指纹。
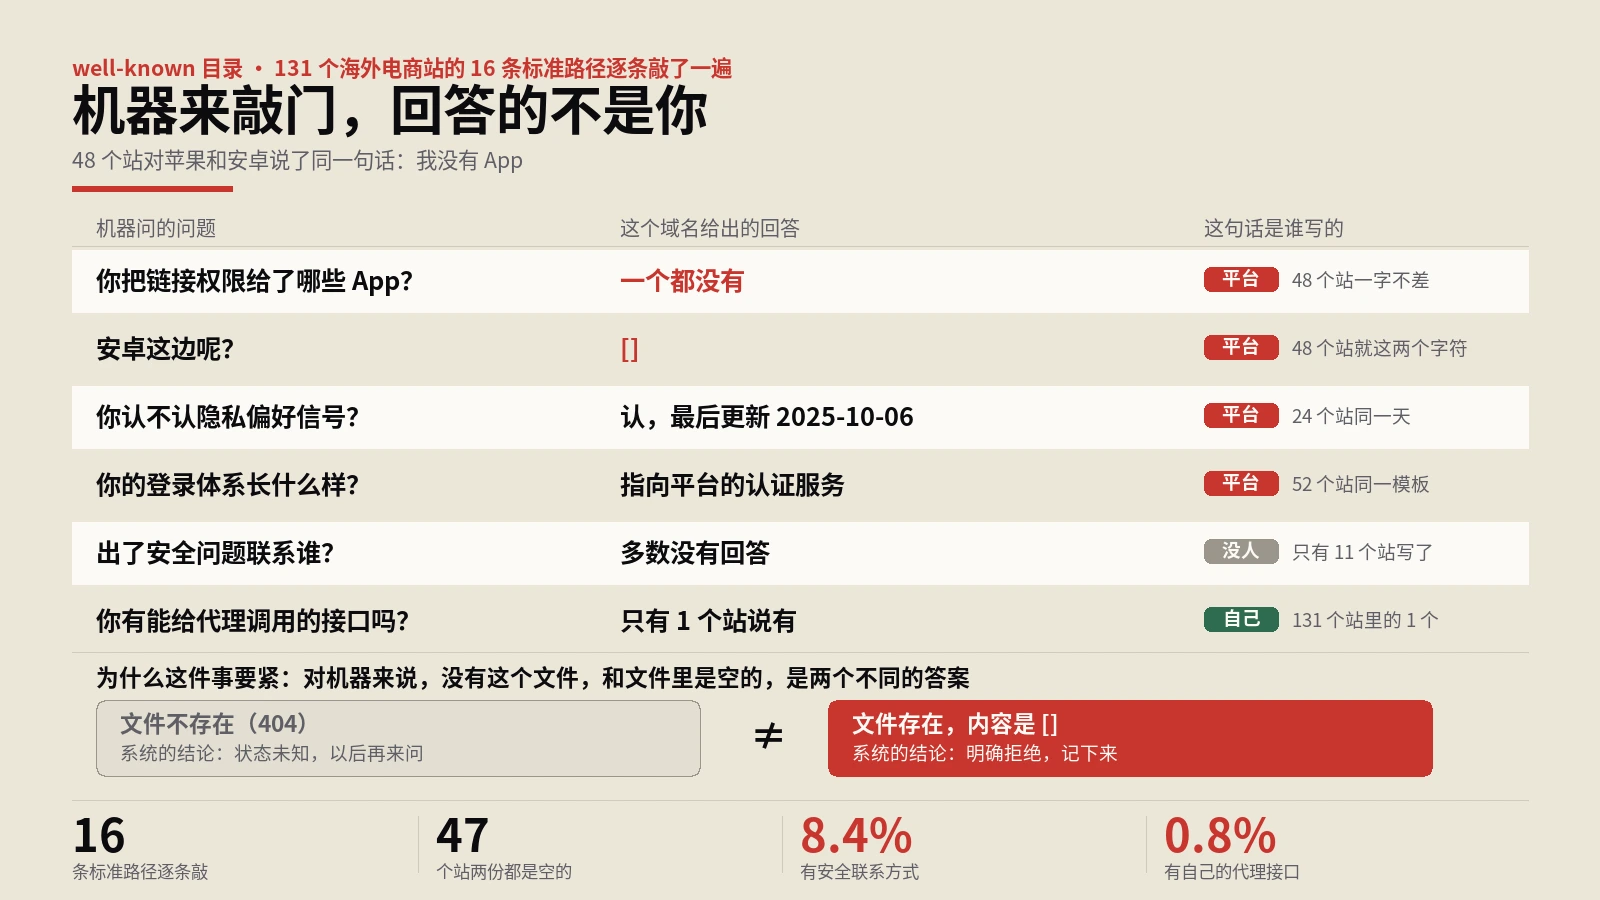
把131个海外电商站的16条well-known路径挨个请求,跟随重定向后按三层判据剔掉假200:状态码、内容类型、正文里有没有自称404或拒绝访问的结构;再抹掉域名与店铺标识做内容聚类,区分哪些是平台批量铺的、哪些是品牌自己写的。判据前后改了6处,方向全部是让数字变小。
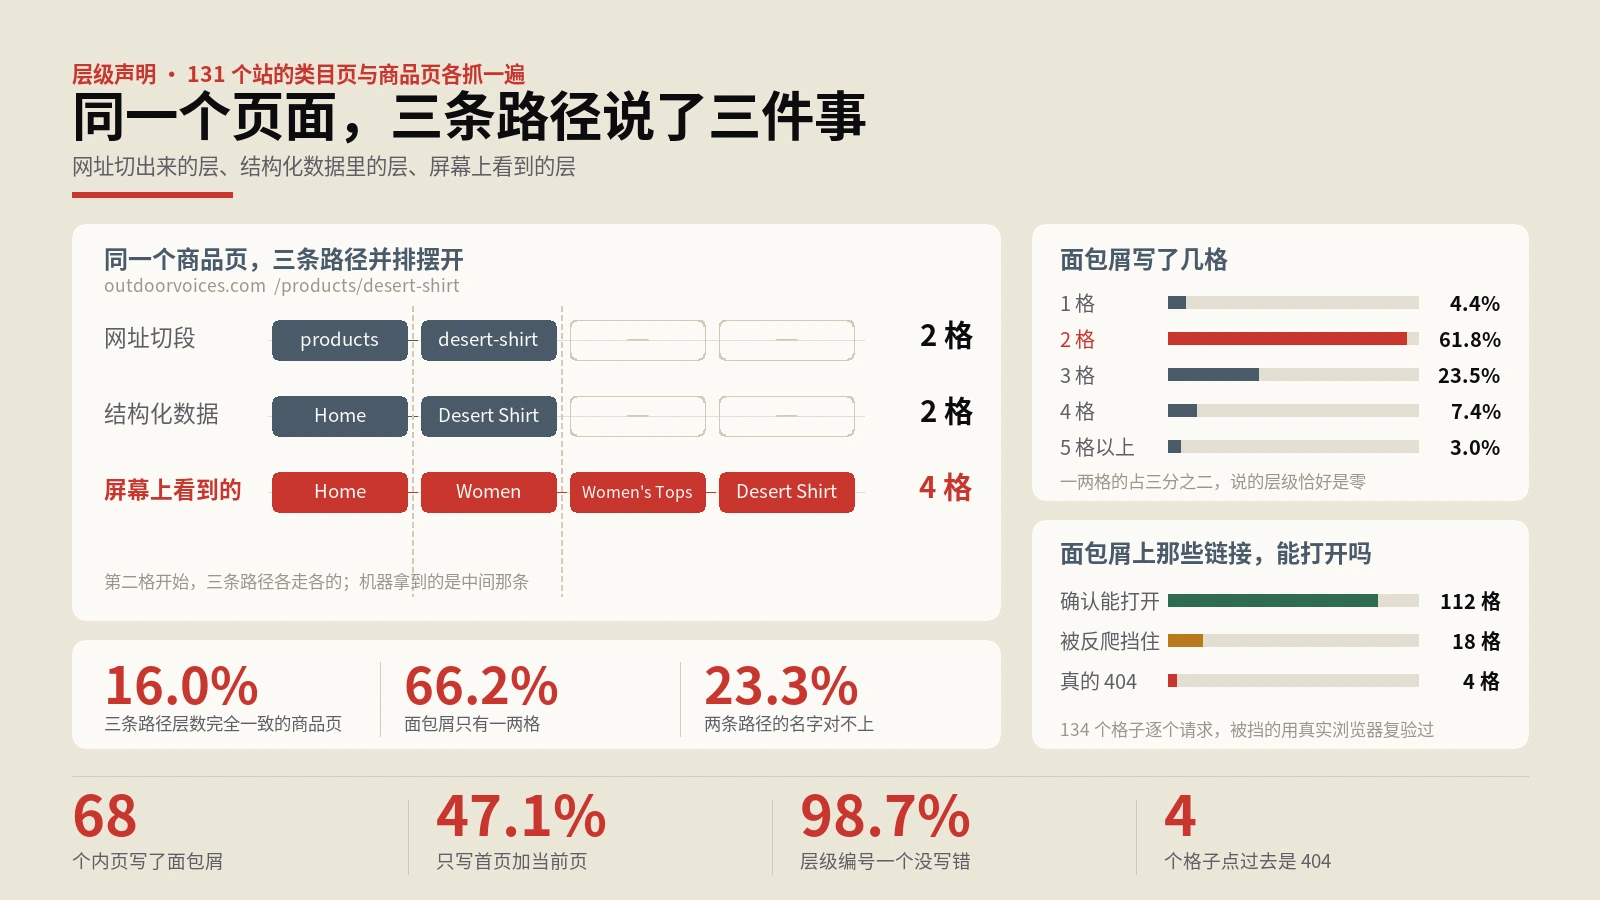
131个海外品牌站抓了类目页与商品页,把三样东西并排对齐——网址切出来的目录段、结构化数据里的BreadcrumbList、渲染后页面上那排可点的面包屑,逐页比对层数、名称与链接可达性;网址段数扣除语言与地区前缀,DOM选择器误判的样本人工剔除。
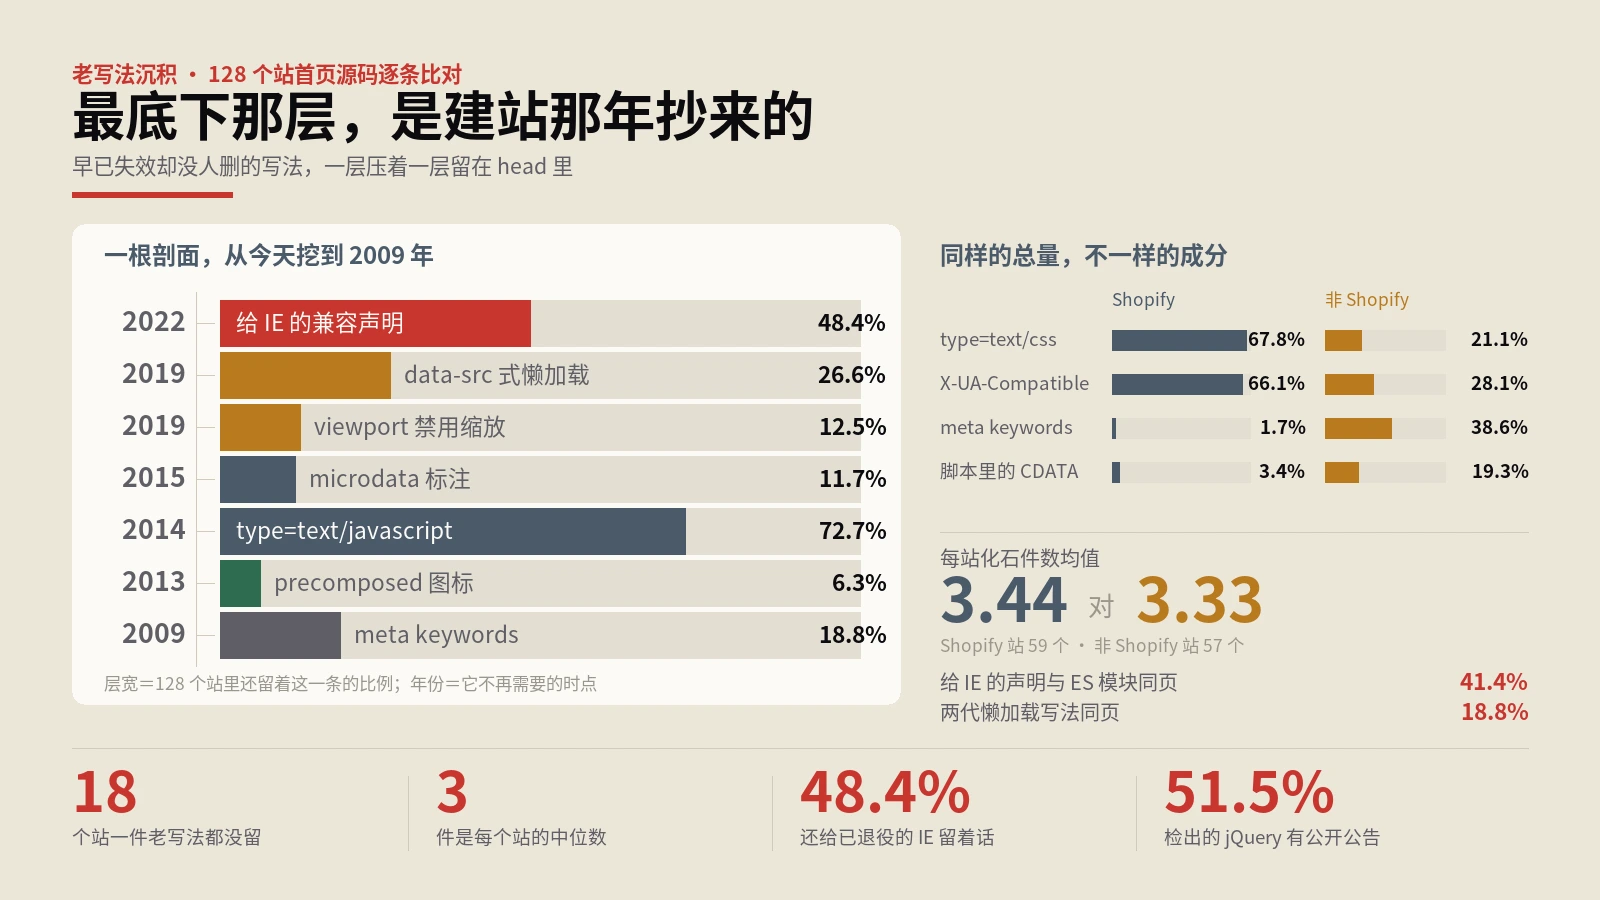
先列一张有明确退场时点的老写法清单,再抓128个海外品牌站首页的服务端HTML逐条比对,最后按建站平台把样本分成两组,看在化石总量几乎相等的前提下,两组页面留下来的种类分布差在哪里。
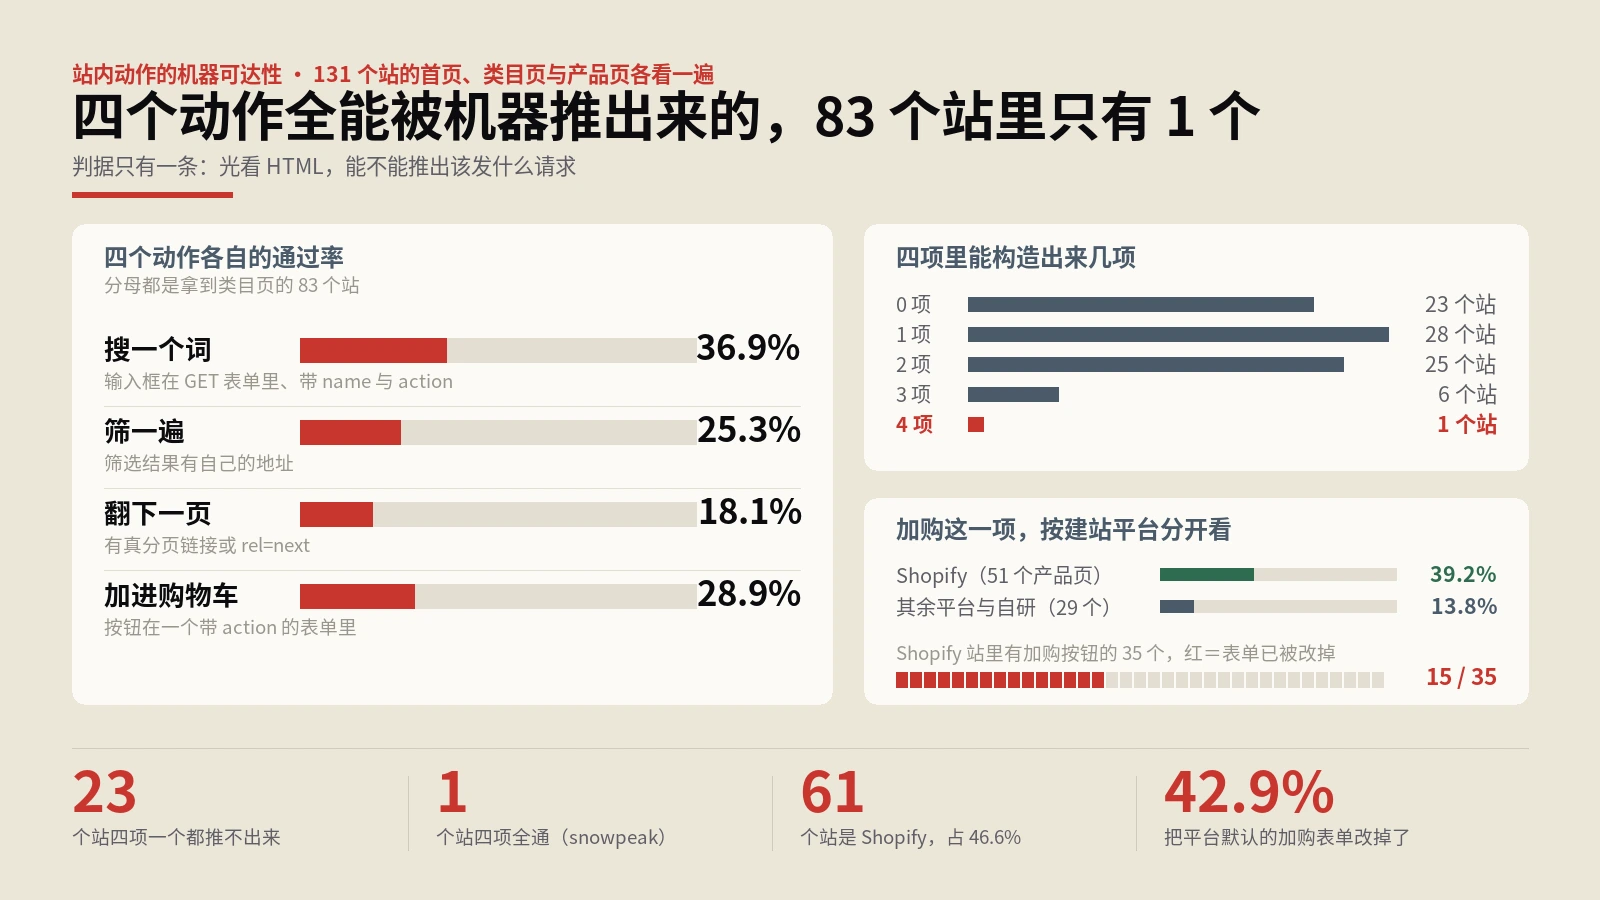
做法是用真实浏览器把131个英文电商品牌站的首页、一个类目页和一个产品页各打开一遍,在渲染后的DOM上取四组静态特征:搜索输入框在不在GET表单里且带name与action、类目页有没有带筛选参数的链接、有没有真分页链接或rel=next、加购按钮在不在带action的表单里。建站平台的判定另外补了一轮首页HTML特征探测才敢用——最初拿加购表单地址是不是/cart/add来认Shopify,把61个站认成了19个,低估3.2倍,那一版…
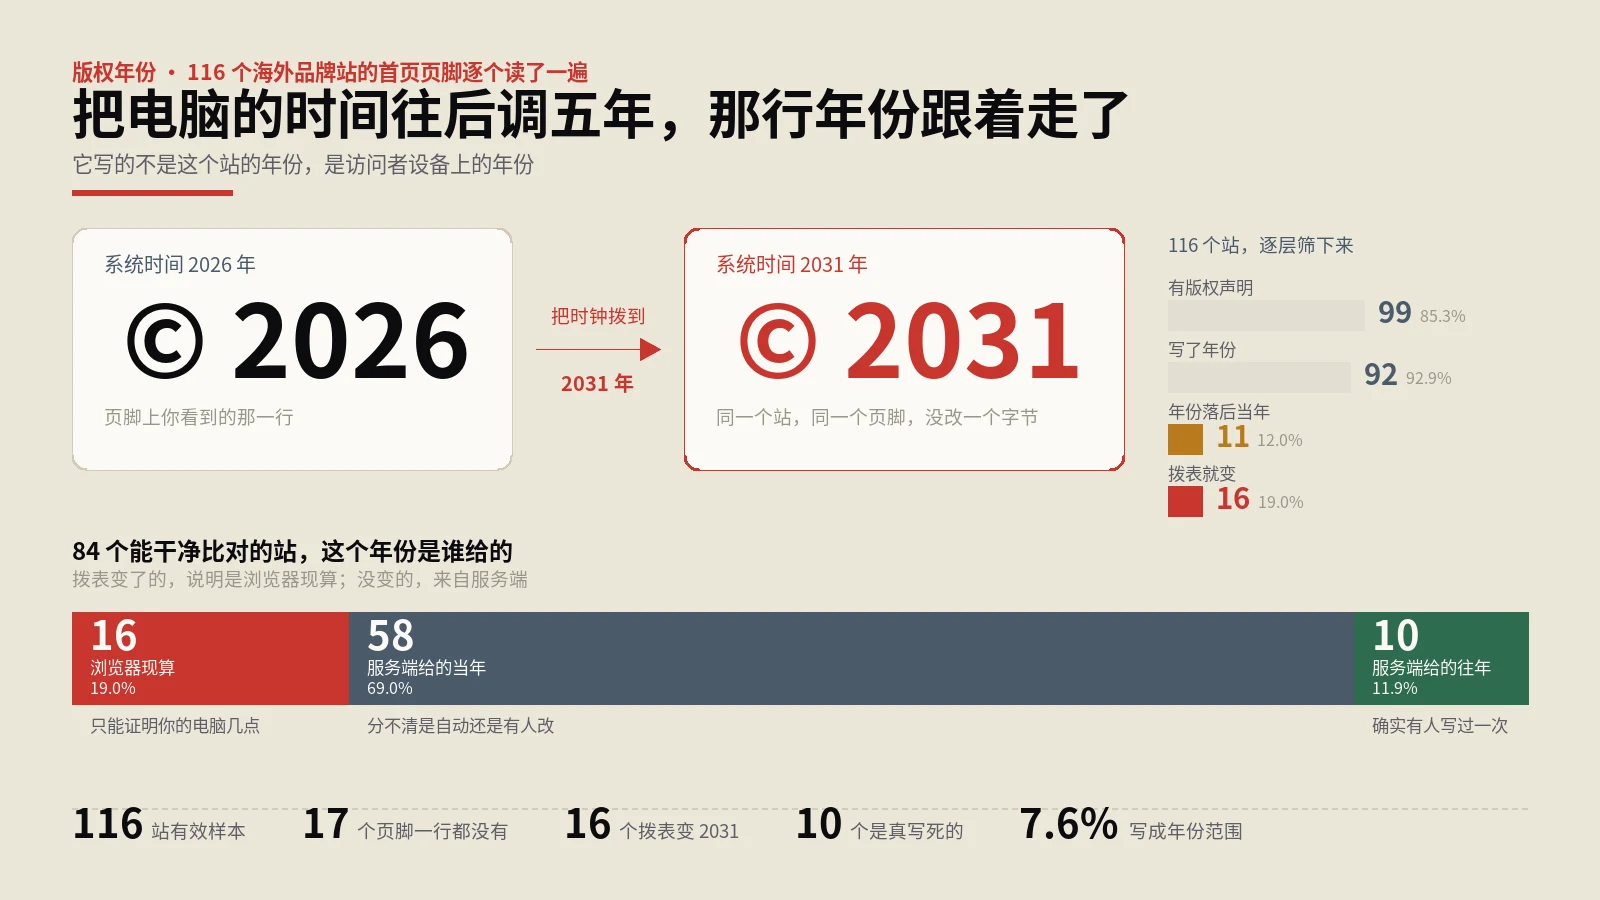
116个海外品牌站的首页页脚逐个抓取,识别版权声明与年份写法;每站访问两遍,第二遍在页面加载前把浏览器全局Date固定为2031年,比对同一段版权文本的年份是否变化,两遍抹去数字后相似度不足的样本剔除。
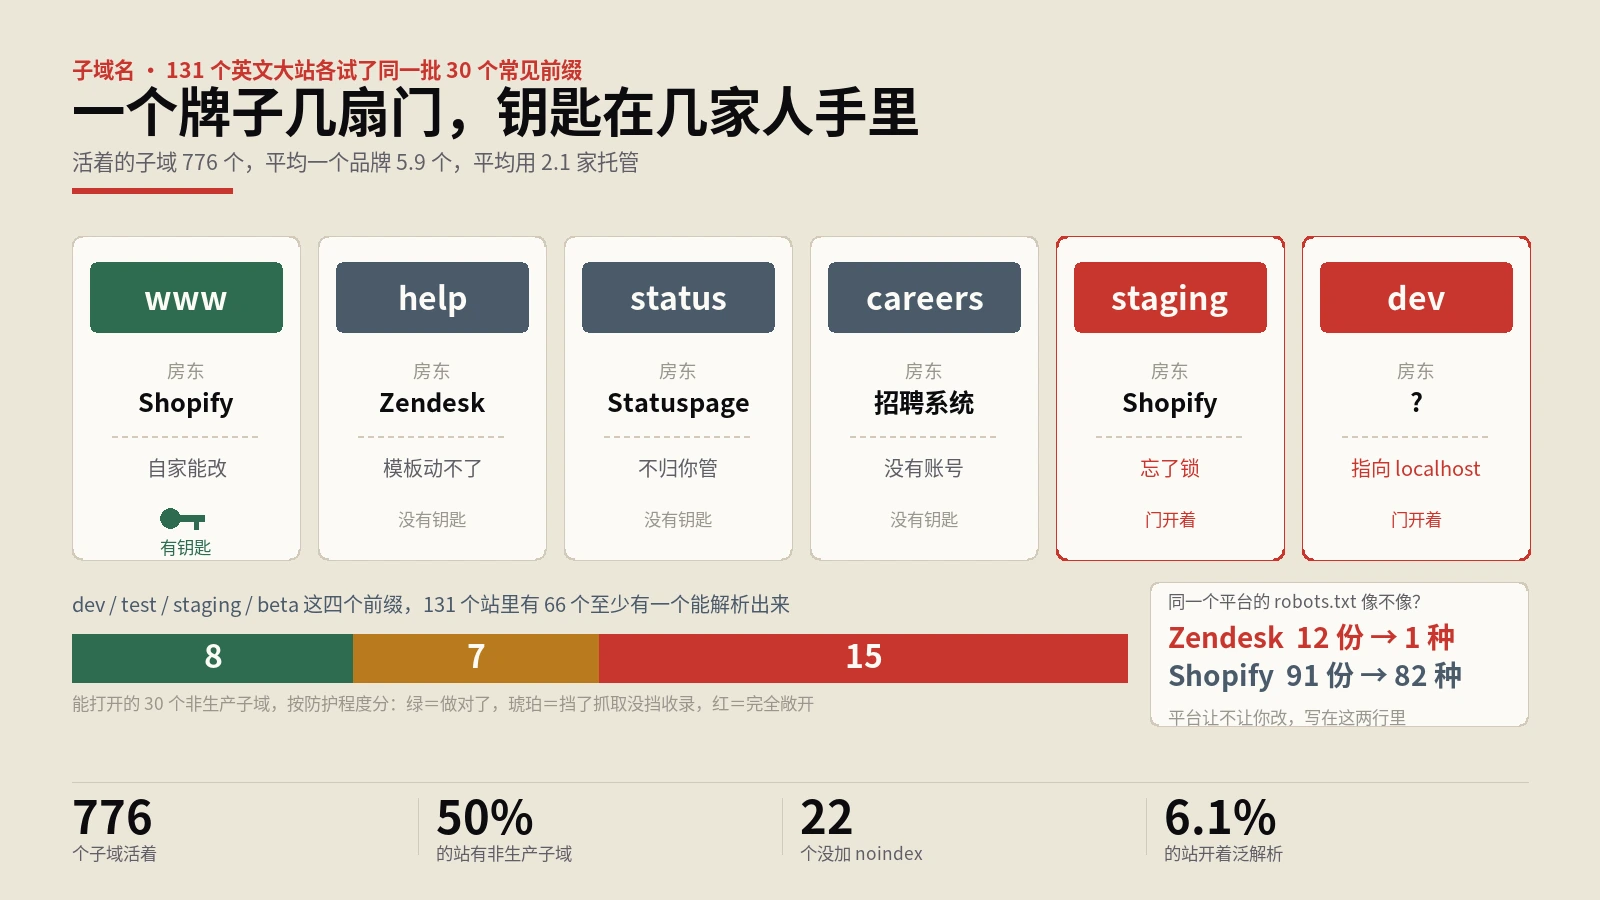
给131个英文大站各试同一批30个常见子域前缀,先用随机子域探泛解析再剔除兜底回声,对活着的子域追CNAME判托管方,并逐个记录HTTP状态码、页面标题、noindex与robots.txt封禁情况。
做法是用真实浏览器在1440宽视口打开112个电商独立站首页,遍历主内容区每个元素、只取它自己直接持有的那段文字,记下渲染后的实际字号、字重、标签名与位置,再按字号排序看排在最前的几段挂的是什么标签;同时把全部h1到h6单独取出比对字号、可见性与是否为空,并把被同意层整个盖住的13个站单独剔出。
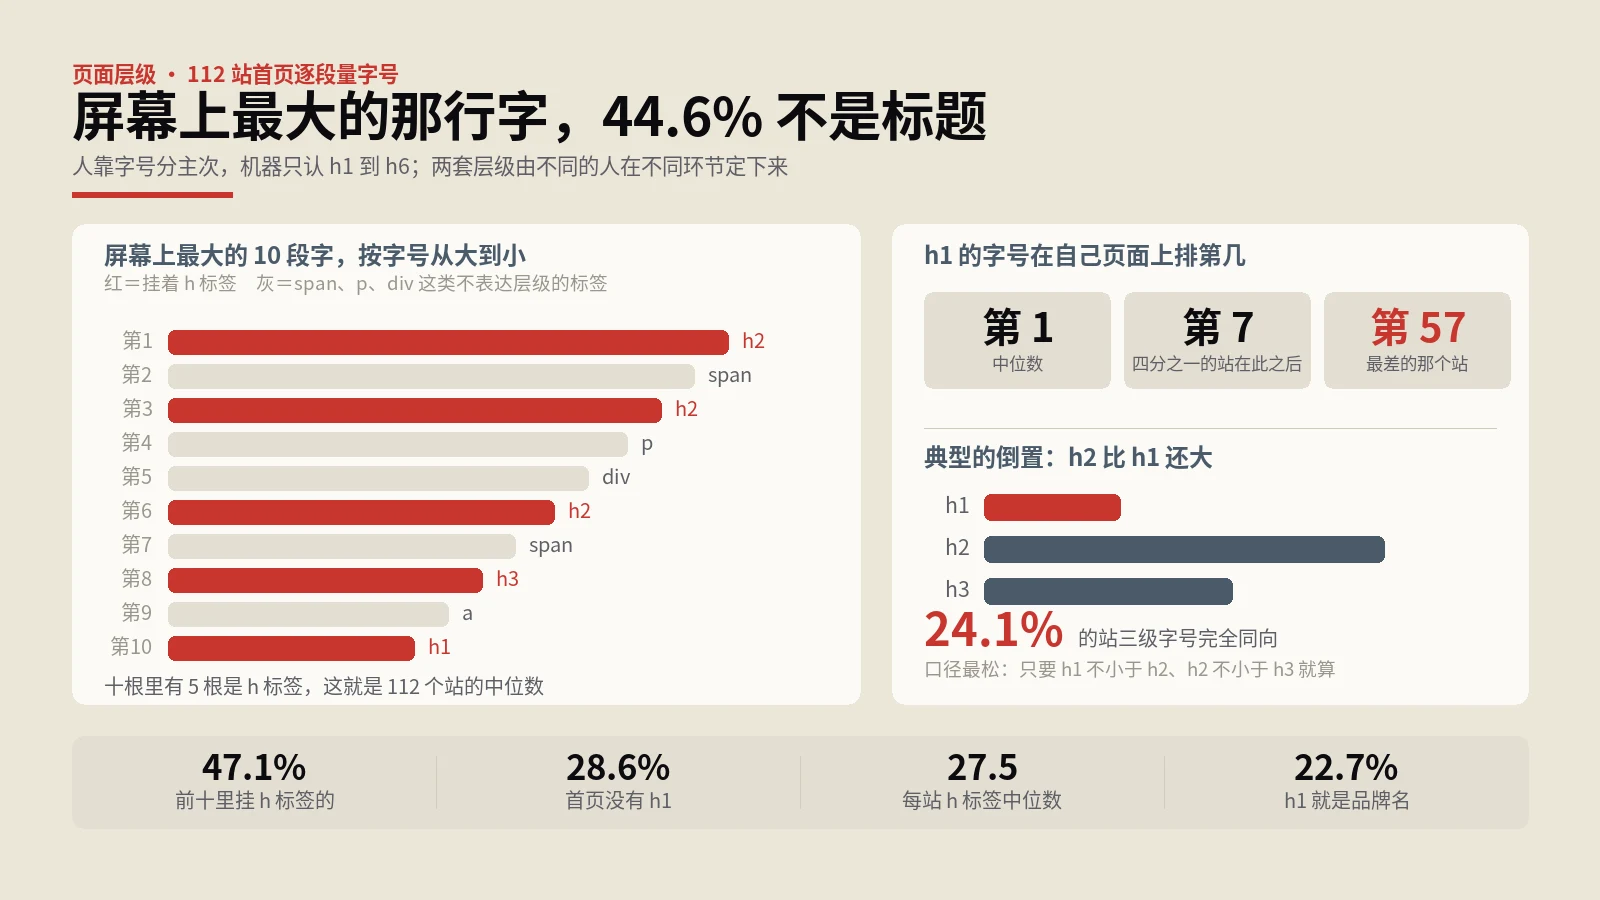
用同一个浏览器对171个海外独立站首页各跑两轮,唯一变量是脚本开关,两轮都拿到200的有131个。三个文本口径在同一次访问里取,配47个两轮几乎不变的站作对照,再用1秒、3.5秒、10秒三档等待时间做敏感性检验,逐层拆开正文、链接、结构化数据、主标题、商品入口五类结构件的丢失情况,并把测量过程中翻车的两次尺子问题一并记下来。
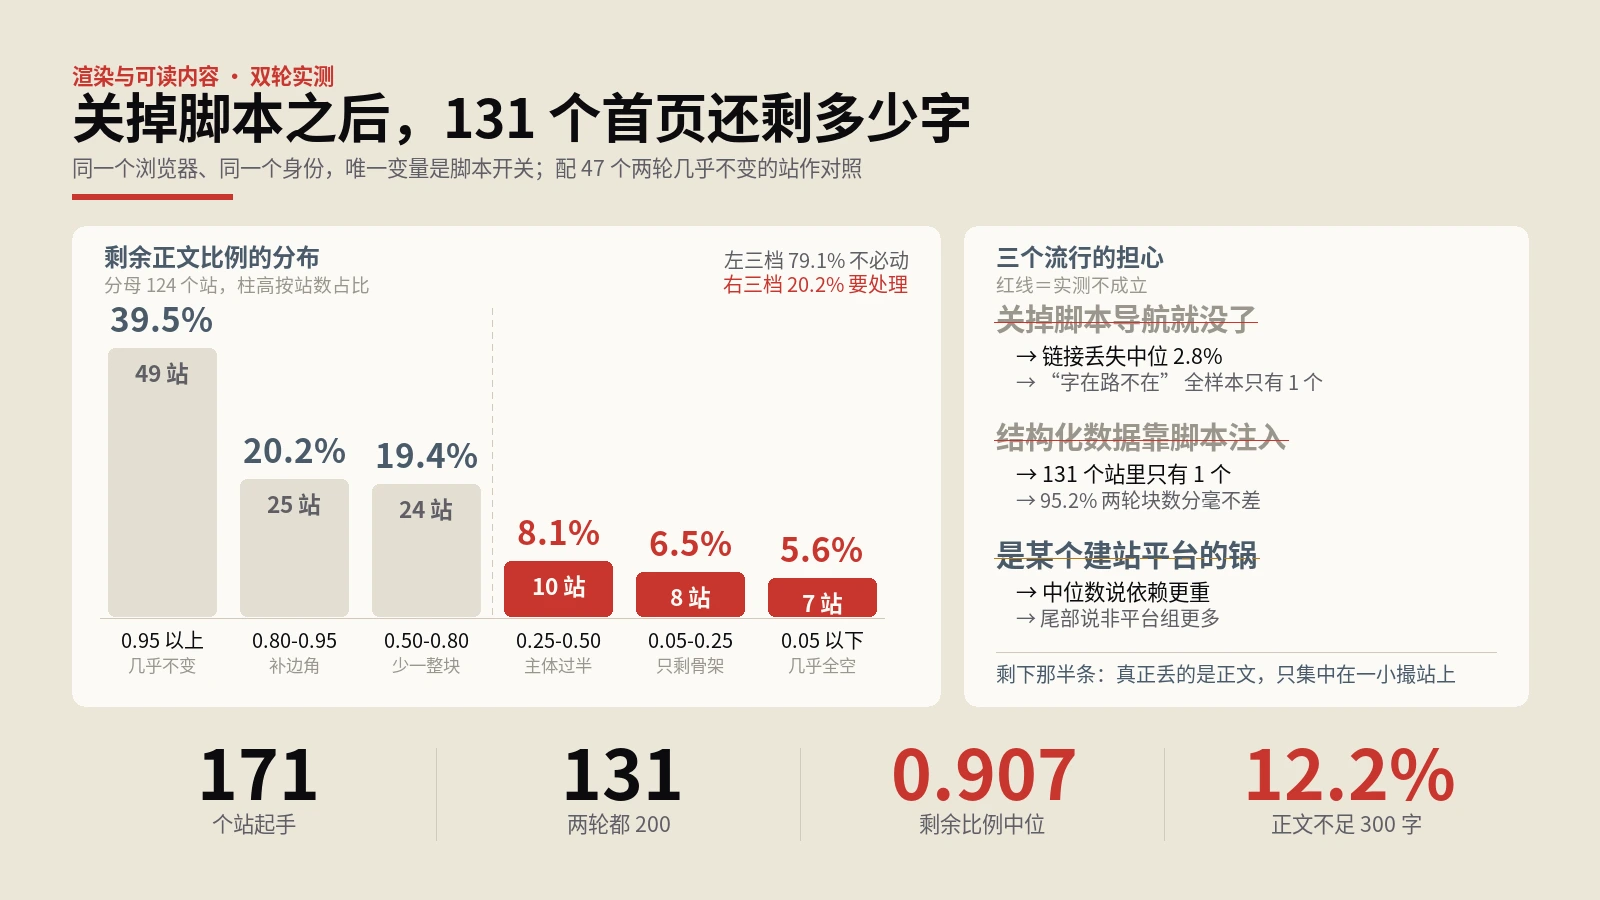
从131个海外电商站的首页取浏览器真实加载的图片,按Range只下文件头部,逐段解析JPEG的APP标记、PNG文本块与WebP的RIFF块;再把同一张图去掉CDN处理参数取一份裸地址,用177组对照区分元数据究竟是入库时清的还是交付时剥的。判据前后改了14处,方向与影响全部列出。
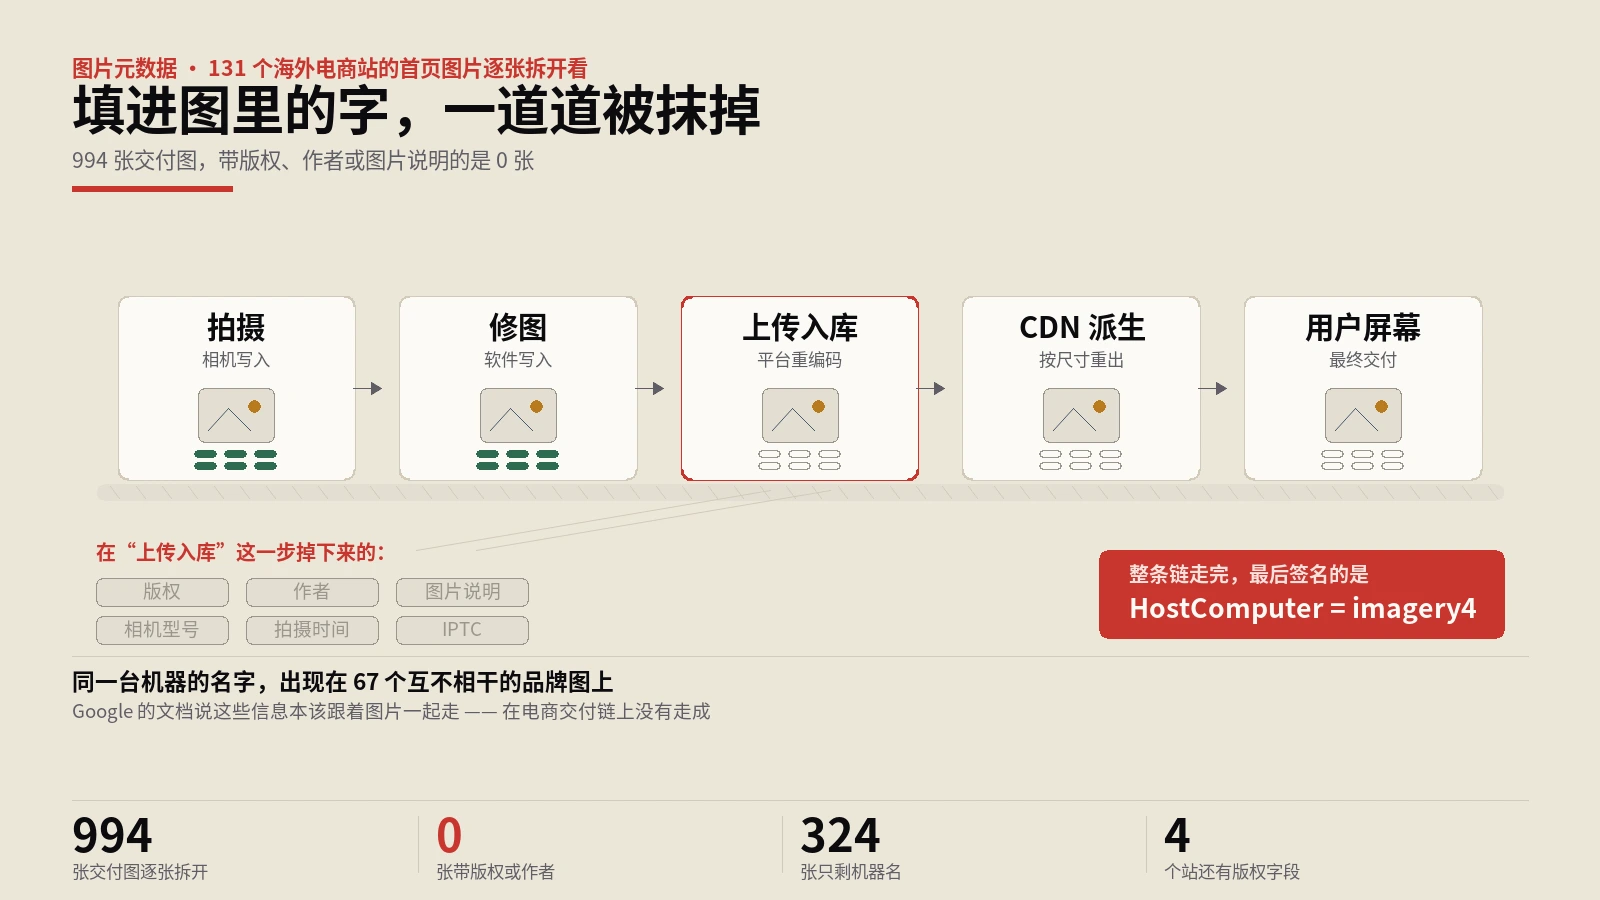
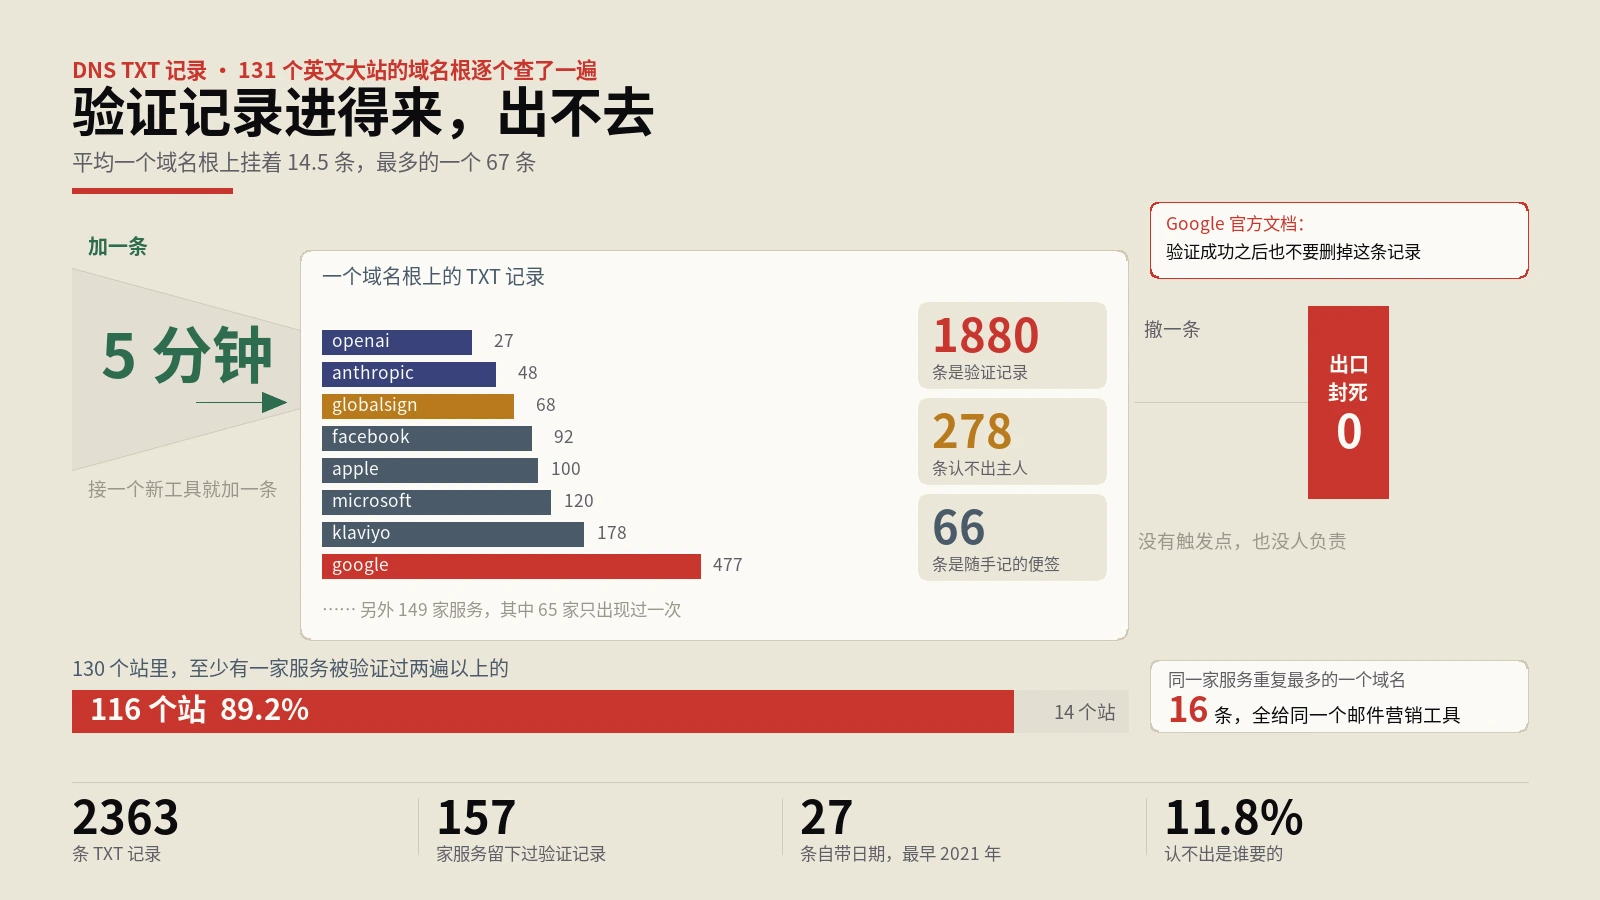
131个英文大站的域名根逐个做DNS查询,取根域与_dmarc的TXT记录,按写法把每条判成第三方验证记录、认不出主人的裸串、邮件配置或内部随手记,再按厂商归并统计重复与年龄。判据经六处人工核对修正。
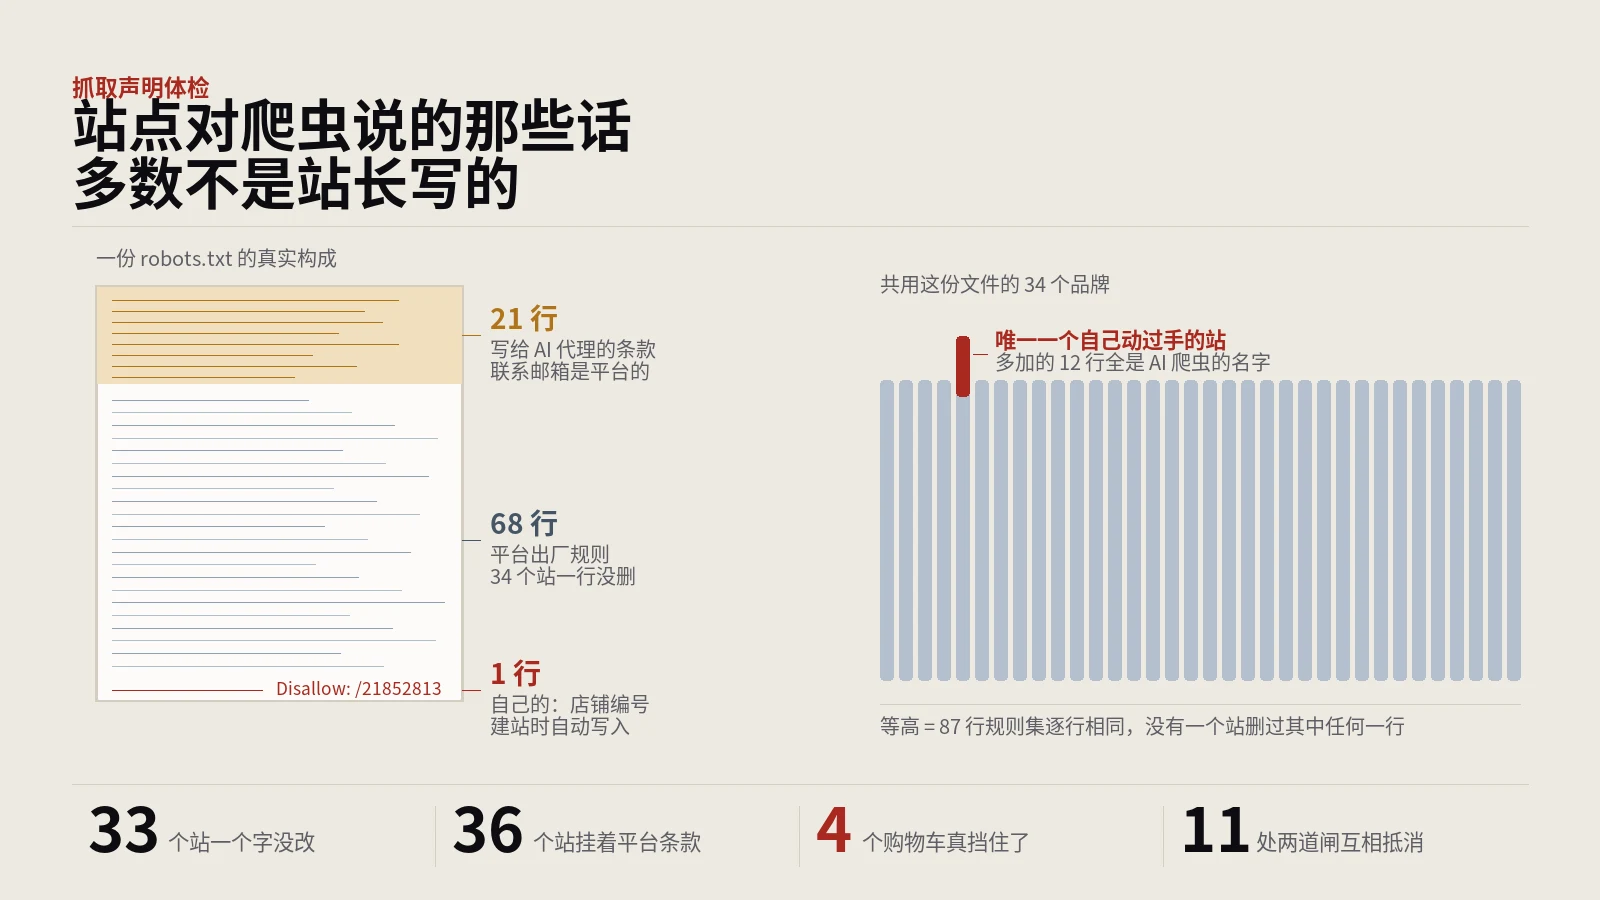
先按RFC 9309自己实现一遍规则匹配,用规范里的18道经典用例把匹配器验过,再拿它逐条判定450个页面能不能被抓;然后读每个页面HTML里的meta robots与响应头里的X-Robots-Tag,把两份声明落进四个格子。全程按页面最终落地的主机去找对应的robots.txt,跨域跳到平台认证域的单独归类。
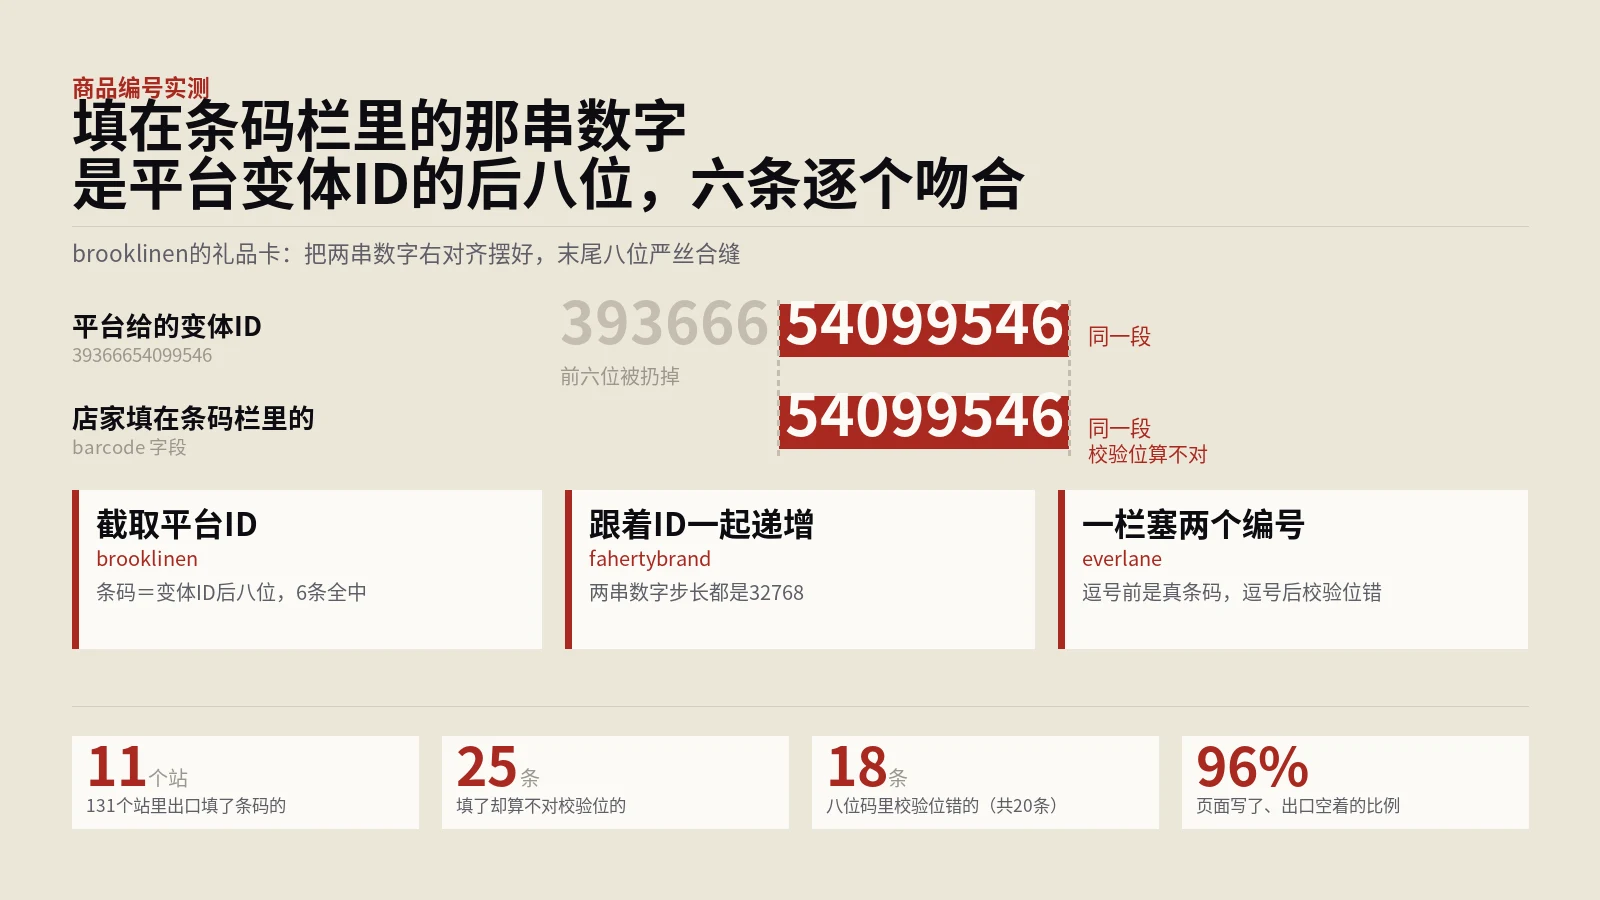
量法是把校验位这把离线尺子架到全站字段上:GTIN不论8位12位13位14位,末位都由前面各位推算,不联网也能判真伪。131个站单线程采集、间隔2秒,把页面结构化数据的每个节点和两个数据出口的每条变体记录都摘出编号,逐条算校验位,再按SKU把两侧配对,看同一件商品的条码是不是同一个。算不对的那些回原始记录里挖,看它原本是什么。
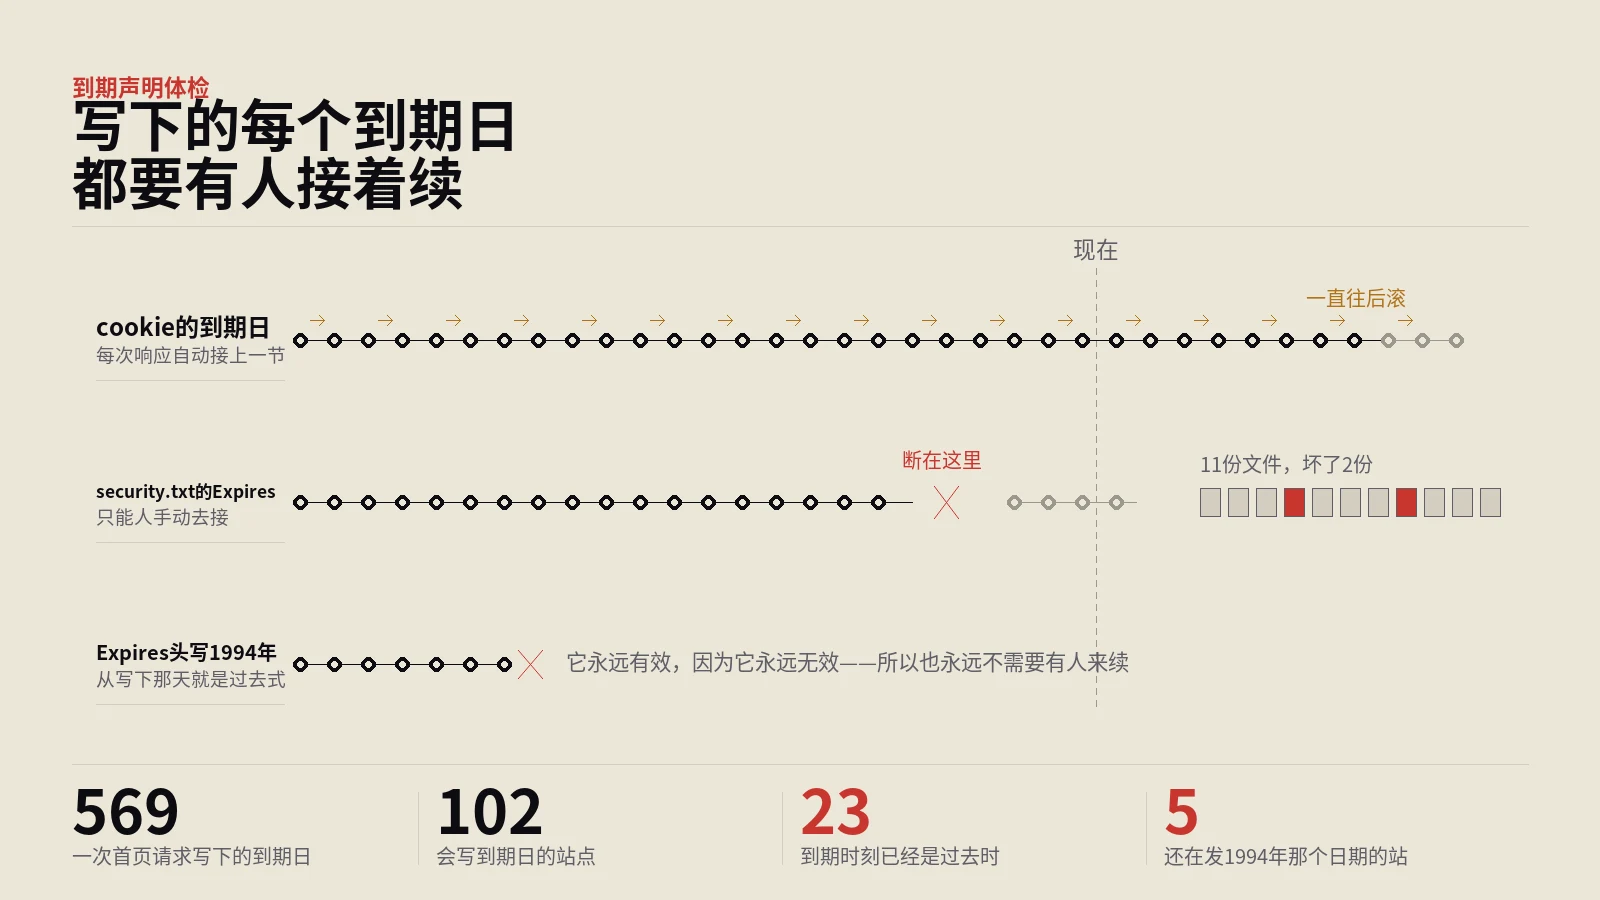
做法是把响应头里所有指向未来的字段拆开逐条换算:Set-Cookie的两个到期字段、Expires响应头,以及.well-known下那份规范要求必须写到期日的文本。换算的零点得取每次响应自己的Date头,第一版拿了个固定时刻,凭空多出十天,55条被误判成自相矛盾。
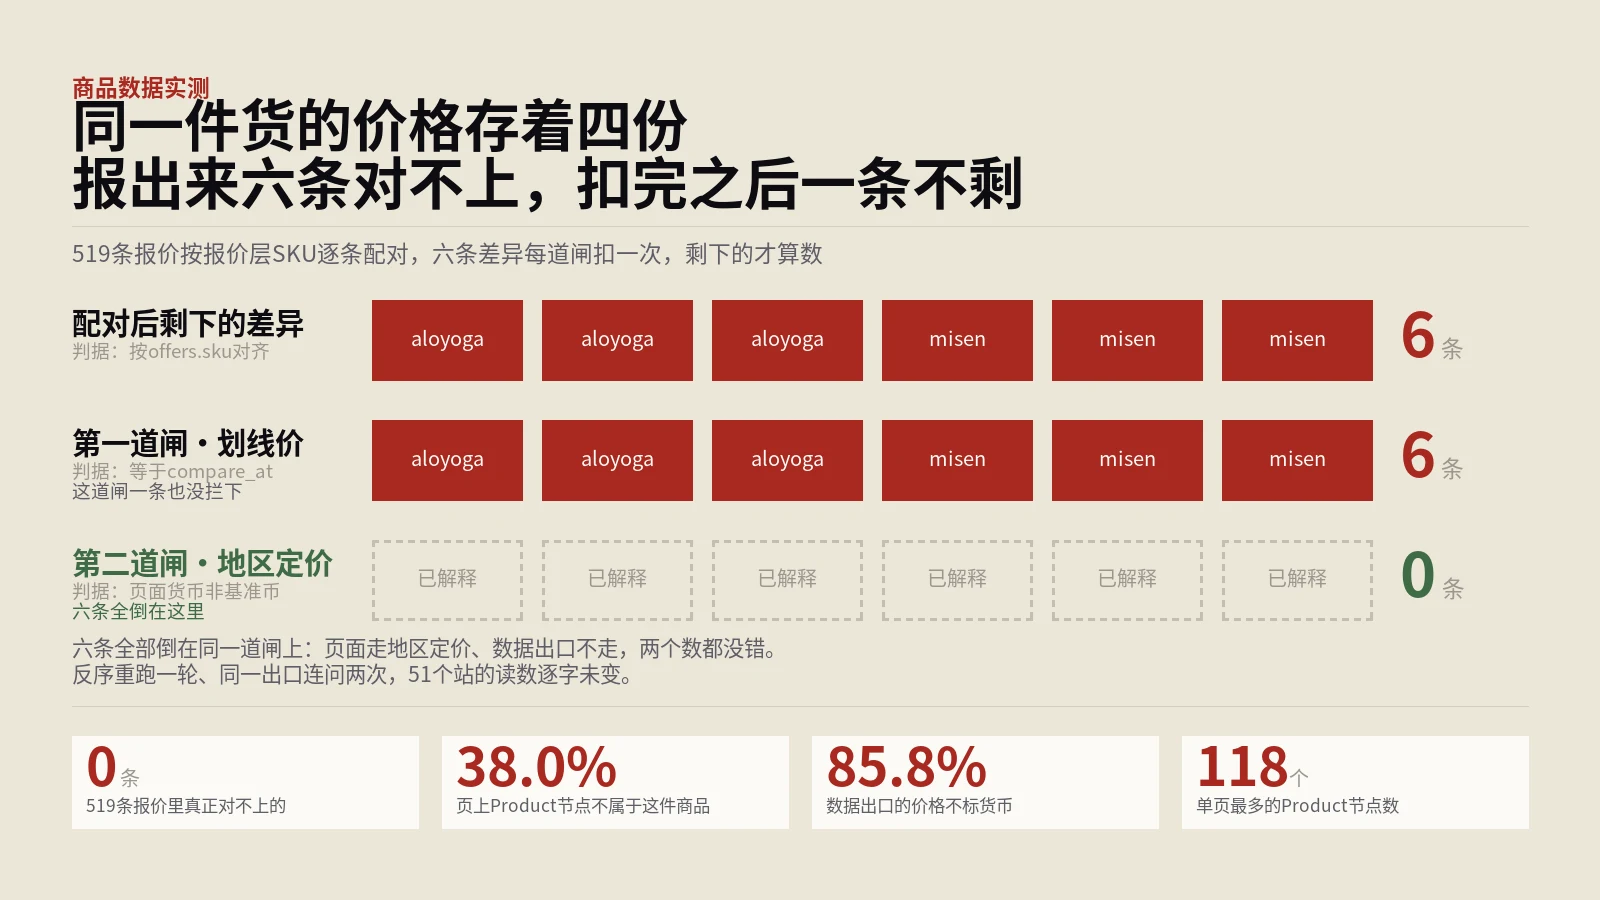
量法是把同一件商品的价格从四条独立路径各取一份:页面渲染、og标签、页面里的结构化数据、以及平台自带的两个数据出口。131个站单线程采集、间隔2秒,第二轮把请求顺序整个反过来重跑,并让同一个出口连问两次做自基线。配对不按节点出现的顺序,按报价层的SKU逐条对齐,再依次扣除划线价、地区定价、商品层与报价层编号错位这三类假阳性,剩下的才算数。
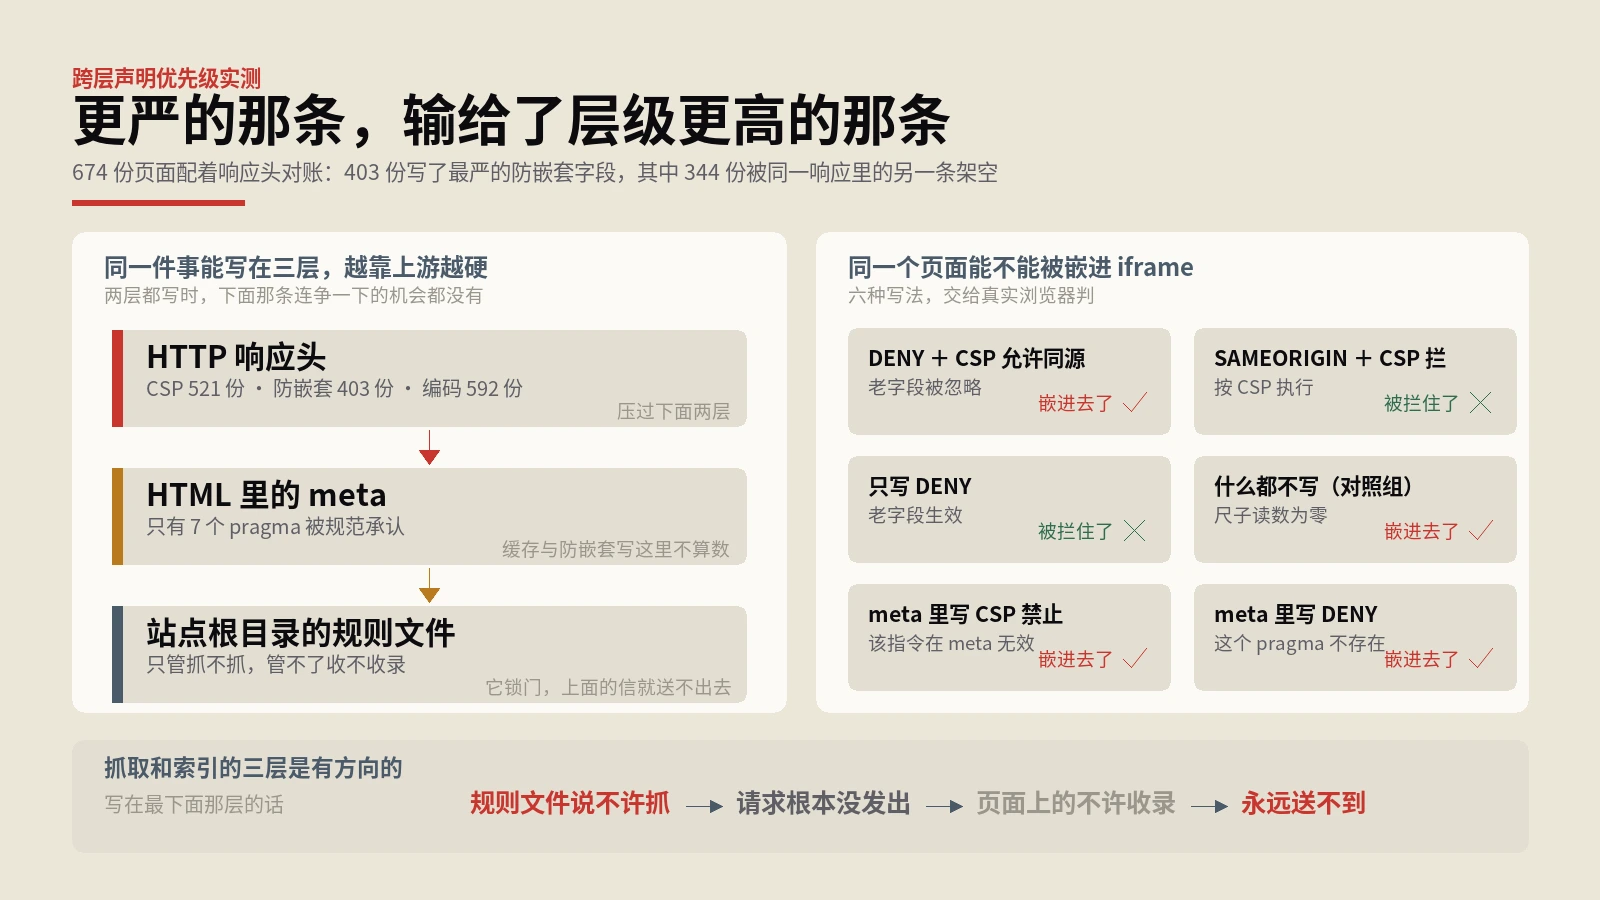
把同一件事分别写进HTTP响应头和HTML,再交给真实浏览器裁决:字符编码两个方向各测一次,防嵌套做成六格对照,其中一格同时写了最严的老字段和较松的新指令。另一头拿674份配着响应头的真实页面逐项对账,统计响应头层各字段的实际覆盖率、meta里那些规范根本不承认的写法、以及站点规则文件里各类指令的接收方现状。文中给出三条线的层级顺序、三层规则的方向性、一张按层归位的对照表,以及四条能直接跑的核对命令与一段响应头变更监控脚本。
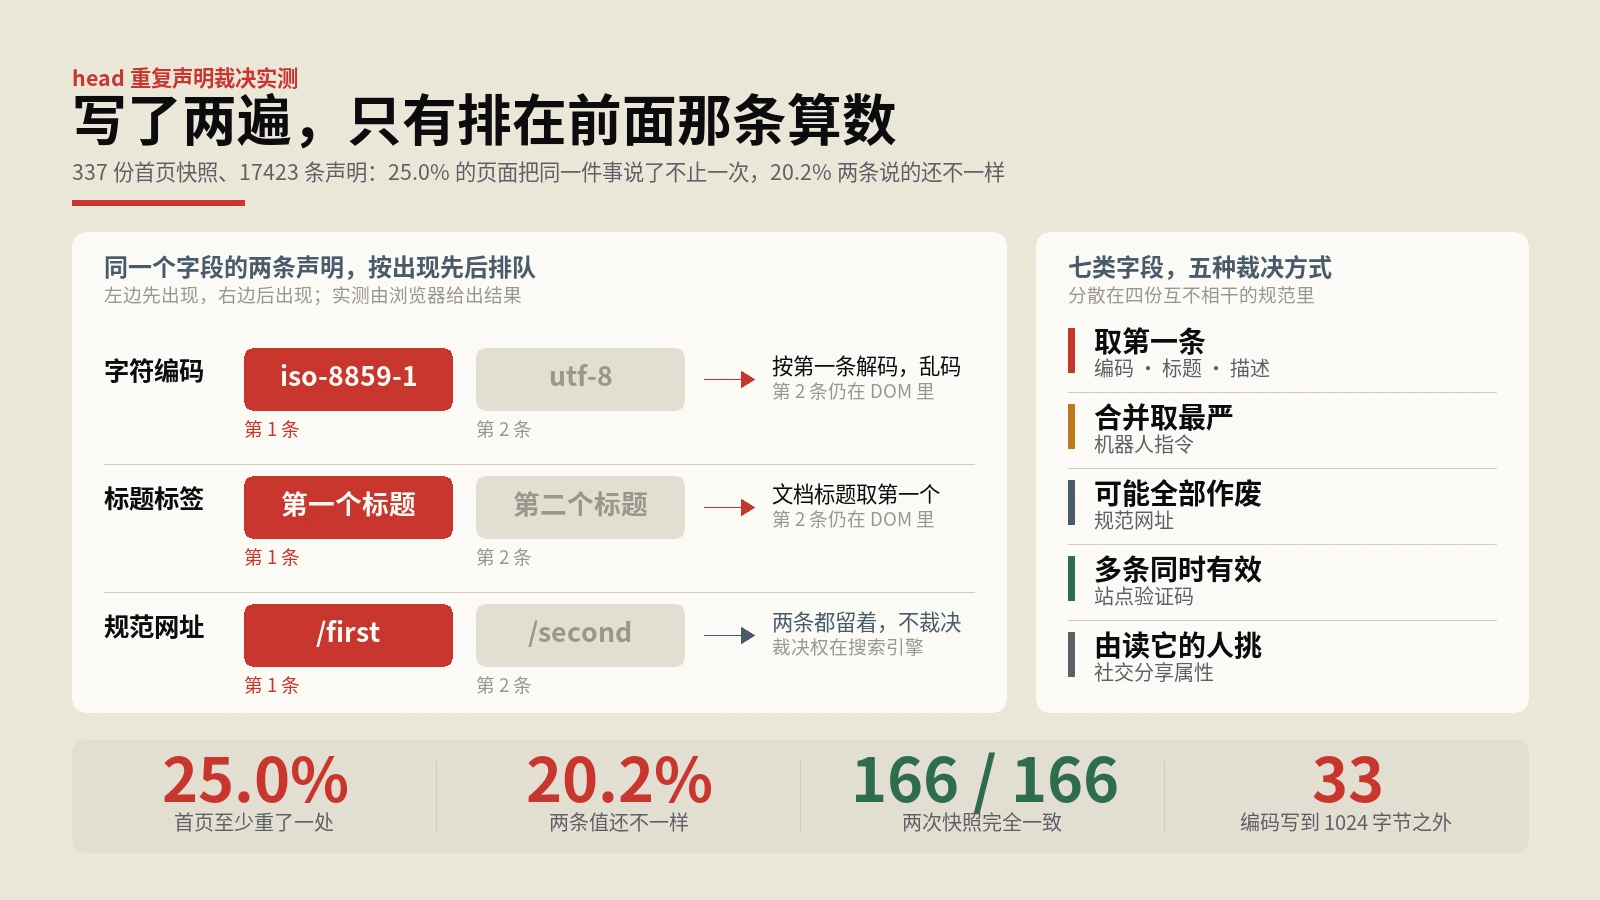
把188个海外品牌站的首页在两个时间点各抓一次,337份可解析文档、17423条head声明,逐类统计那些语义上本该唯一的字段被写了几遍、值一不一样;再用一个最小的本地服务制造六组典型冲突,交给真实的浏览器内核解析,看它最终采纳了哪一条。文中给出重复率与冲突率的两次快照对照、内页与首页的差距、七类字段各自的裁决方式、被一个div赶出head的三条声明、编码声明写到十几万字节之后为什么仍然没事,以及三档整改优先级和一段能直接接进流水线的检…
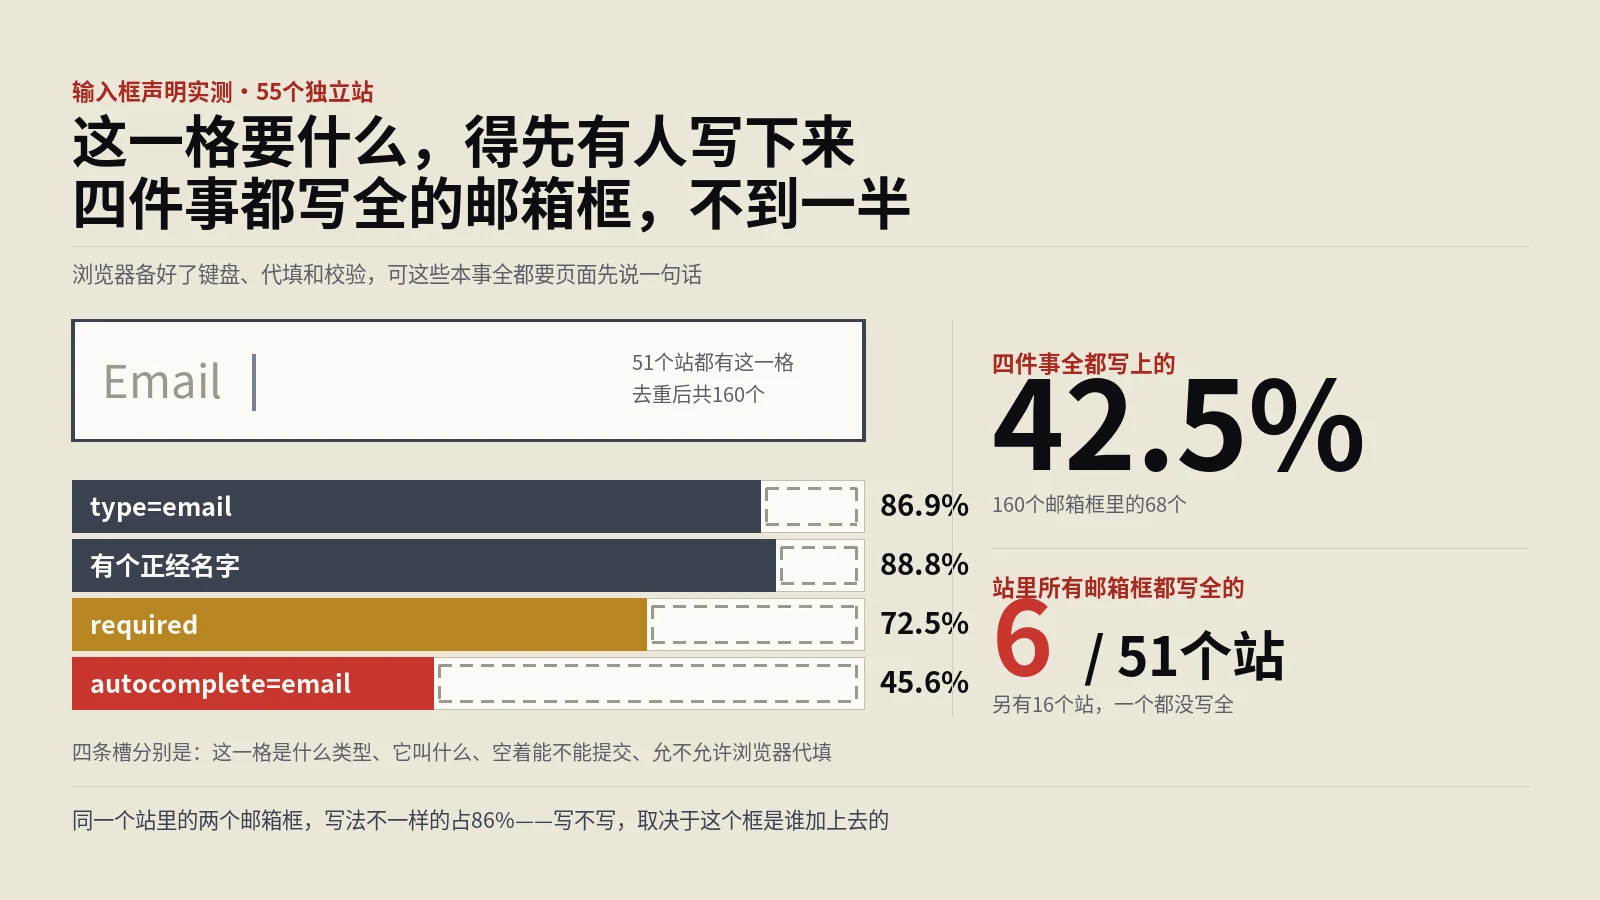
做法是用真实浏览器逐页打开55个英文独立站的首页、商品页,再从首页现场找出联系页与账号页,把每个页面上的input、select、textarea连同type、autocomplete、required、pattern、maxlength、inputmode与名字来源一并取下来。同一个站里声明完全相同的控件按签名合并,避免主题挂在每一页的抽屉表单被重复计数;从没可见过又没有任何说明文字的字段单独剔出,因为那多半是跟踪像素注入的参数框。另…
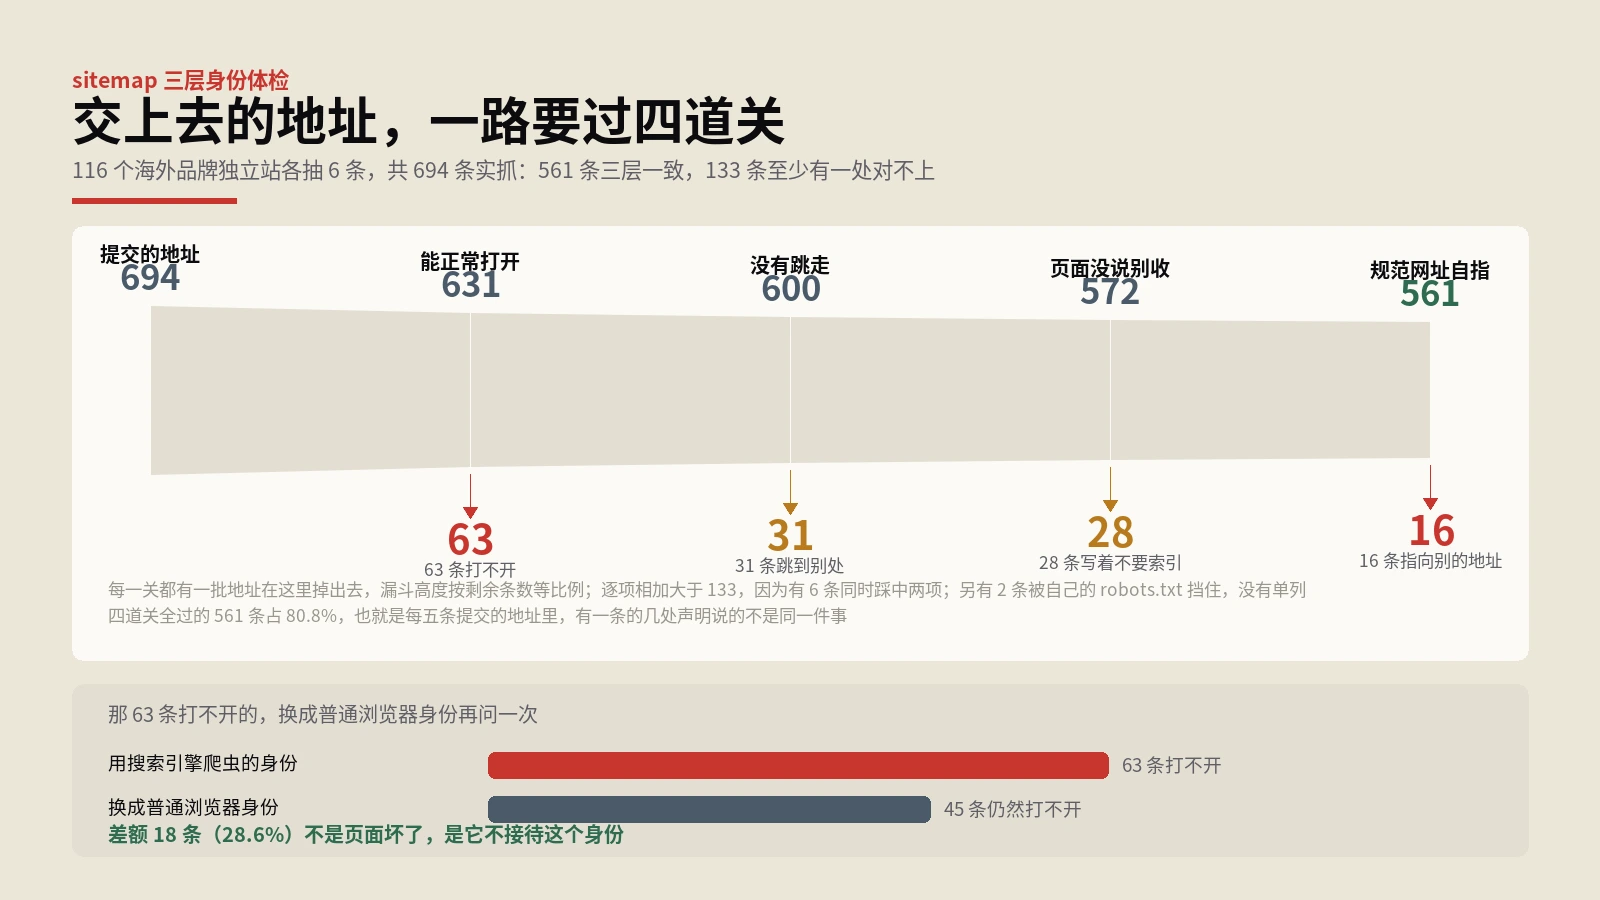
从116个海外品牌独立站的sitemap里各随机抽6条地址做实抓,把提交层、交付层、索引层三处的声明逐条比对。做法是先确认sitemap本身拿得到,再按固定随机种子抽样,一次请求同时取回状态码、跳转链、页面与响应头里的索引声明和canonical,最后对所有非200的地址换普通浏览器身份重抓一次做对照。文中给出一致率、各项失分分布、系统性与零星的分辨方法、六步自查顺序,以及五处差点搞错的判据。
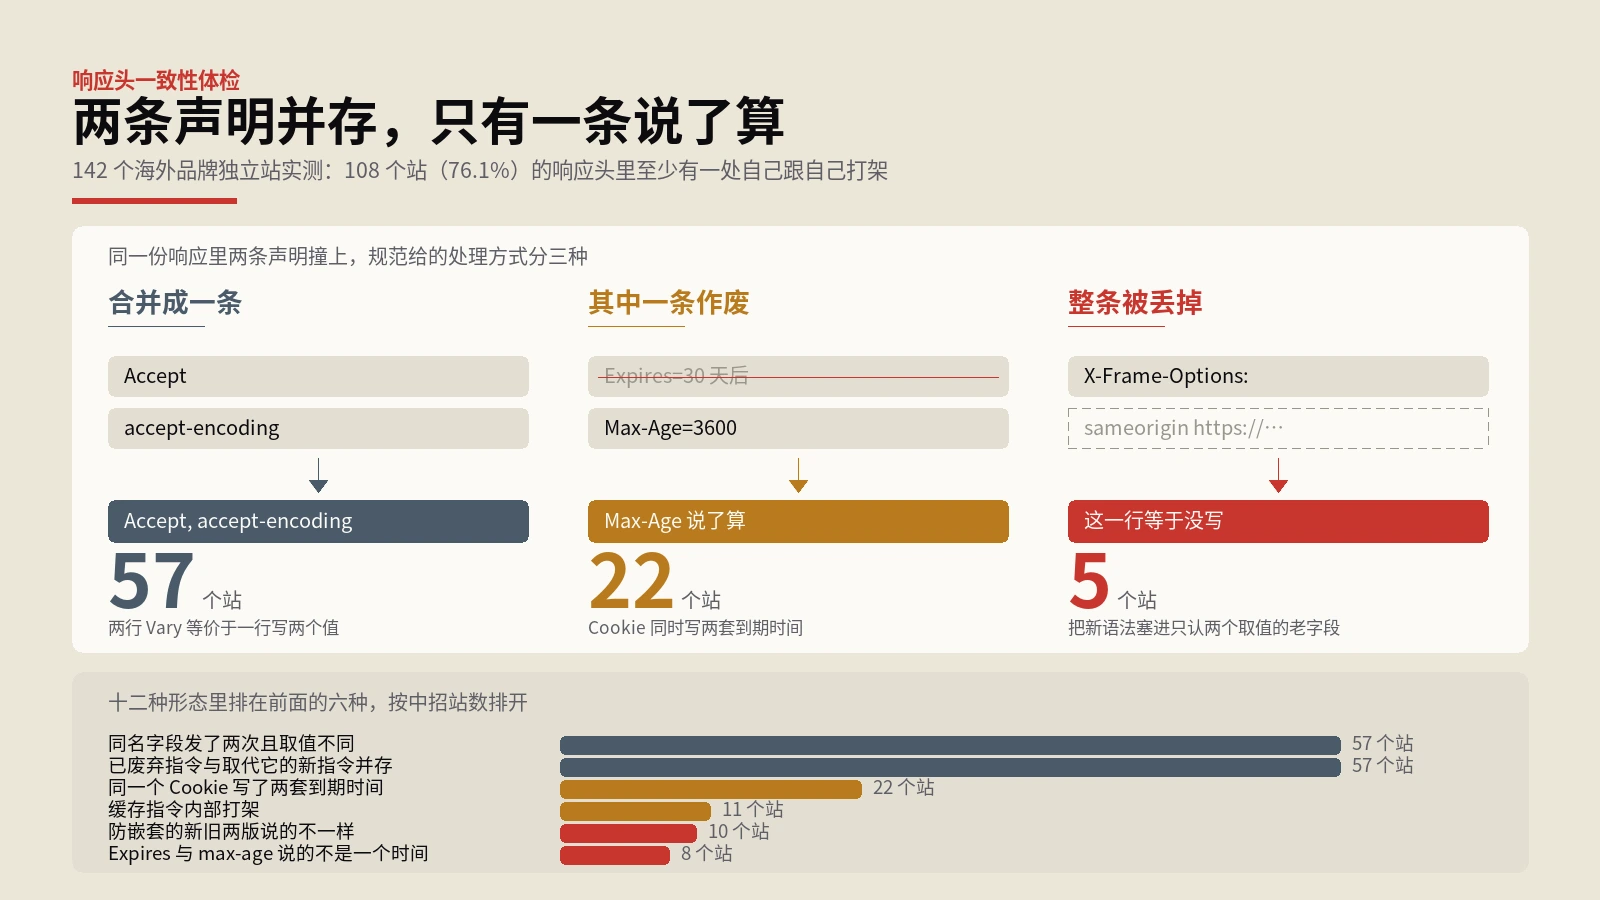
把142个海外品牌独立站首页的最终响应逐字段拆开,按十二种形态归类,再对着规范逐条判它们的下场。做法是先切出跳转链最后一段2xx响应,再按字段名分组找同名重复,然后查缓存、防嵌套、Cookie到期这三对经典冲突,最后把内容安全策略里的关键字逐个过一遍。文中给出各形态的站数分布、平台指纹与自写部分的拆分、六步自查顺序,以及把合并误判成矛盾之后数字从69降到57的修正过程。