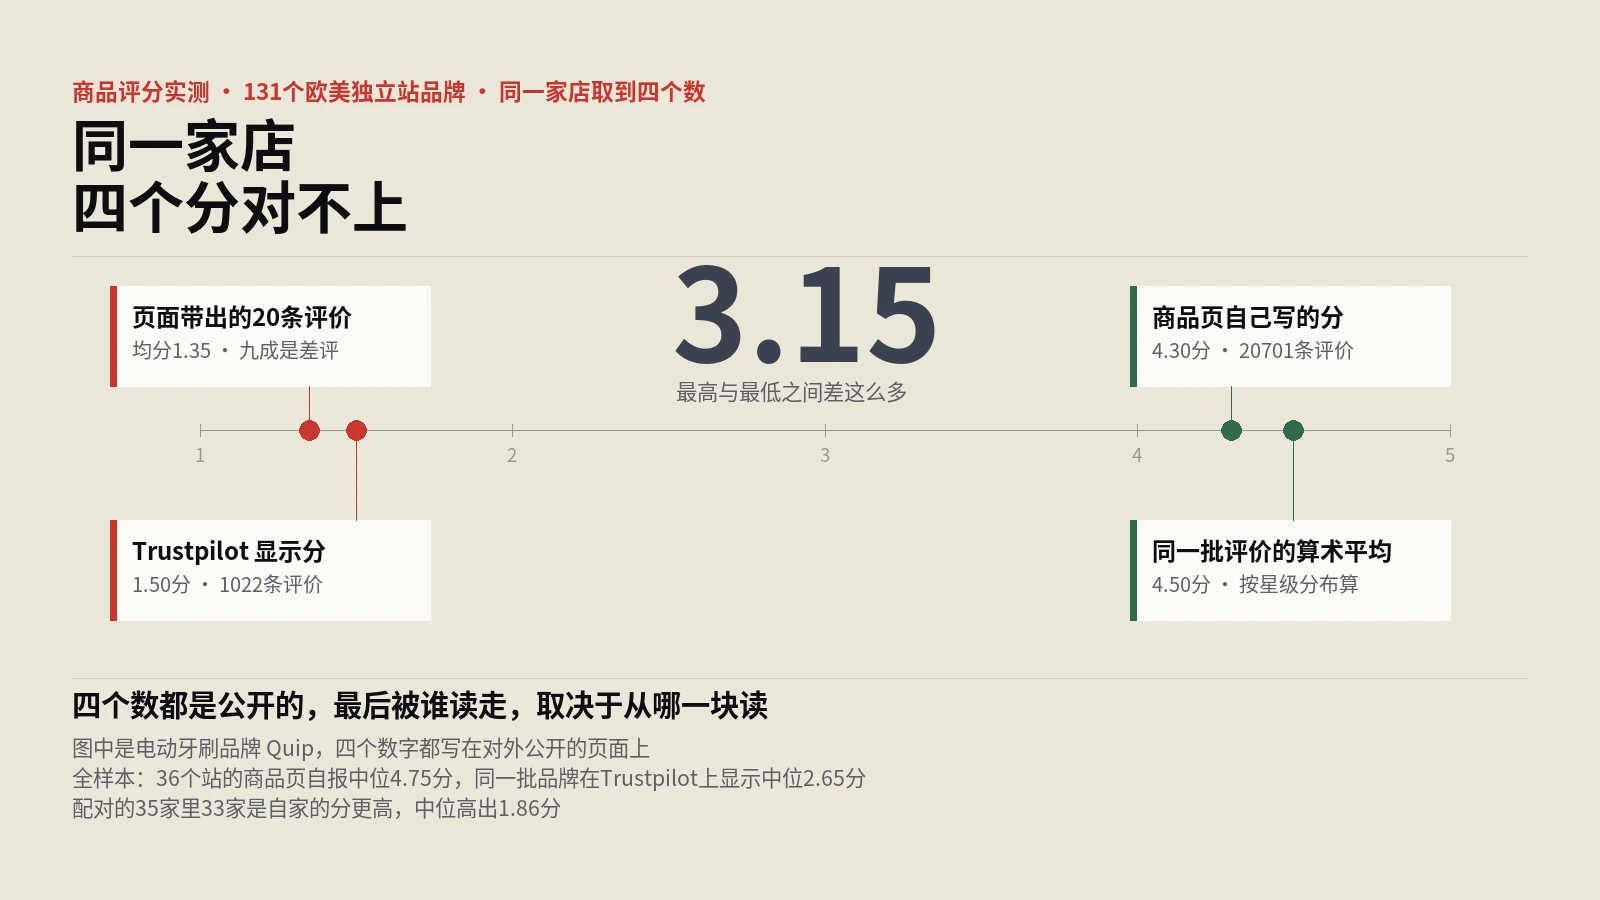
商品评分四个数对不上,AI拿走的是商家自己填的那一个
做法:对131个欧美独立站品牌,用不渲染JavaScript的抓取器取商品页原始HTML里的aggregateRating,同时抓Trustpilot品牌页的显示分、星级分布与页面自带的评价节点,按平台公布的口径把7条中性先验加回去复算;商品页与品牌页各测两轮做自基线,另挑26个商品页用真浏览器渲染对照。
标签
保哥笔记 电商SEO 标签下共 50 篇文章合集,含《站内搜索页搜不到也返回200,两道锁锁的是同一扇门》《结构化数据实测66个站:产品页都写了,类目页只有三分》《一个词值不值得单开一页,87个站的站点地图先替你答了》等,与 结构化数据、技术SEO、AI购物 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
做法:对131个欧美独立站品牌,用不渲染JavaScript的抓取器取商品页原始HTML里的aggregateRating,同时抓Trustpilot品牌页的显示分、星级分布与页面自带的评价节点,按平台公布的口径把7条中性先验加回去复算;商品页与品牌页各测两轮做自基线,另挑26个商品页用真浏览器渲染对照。
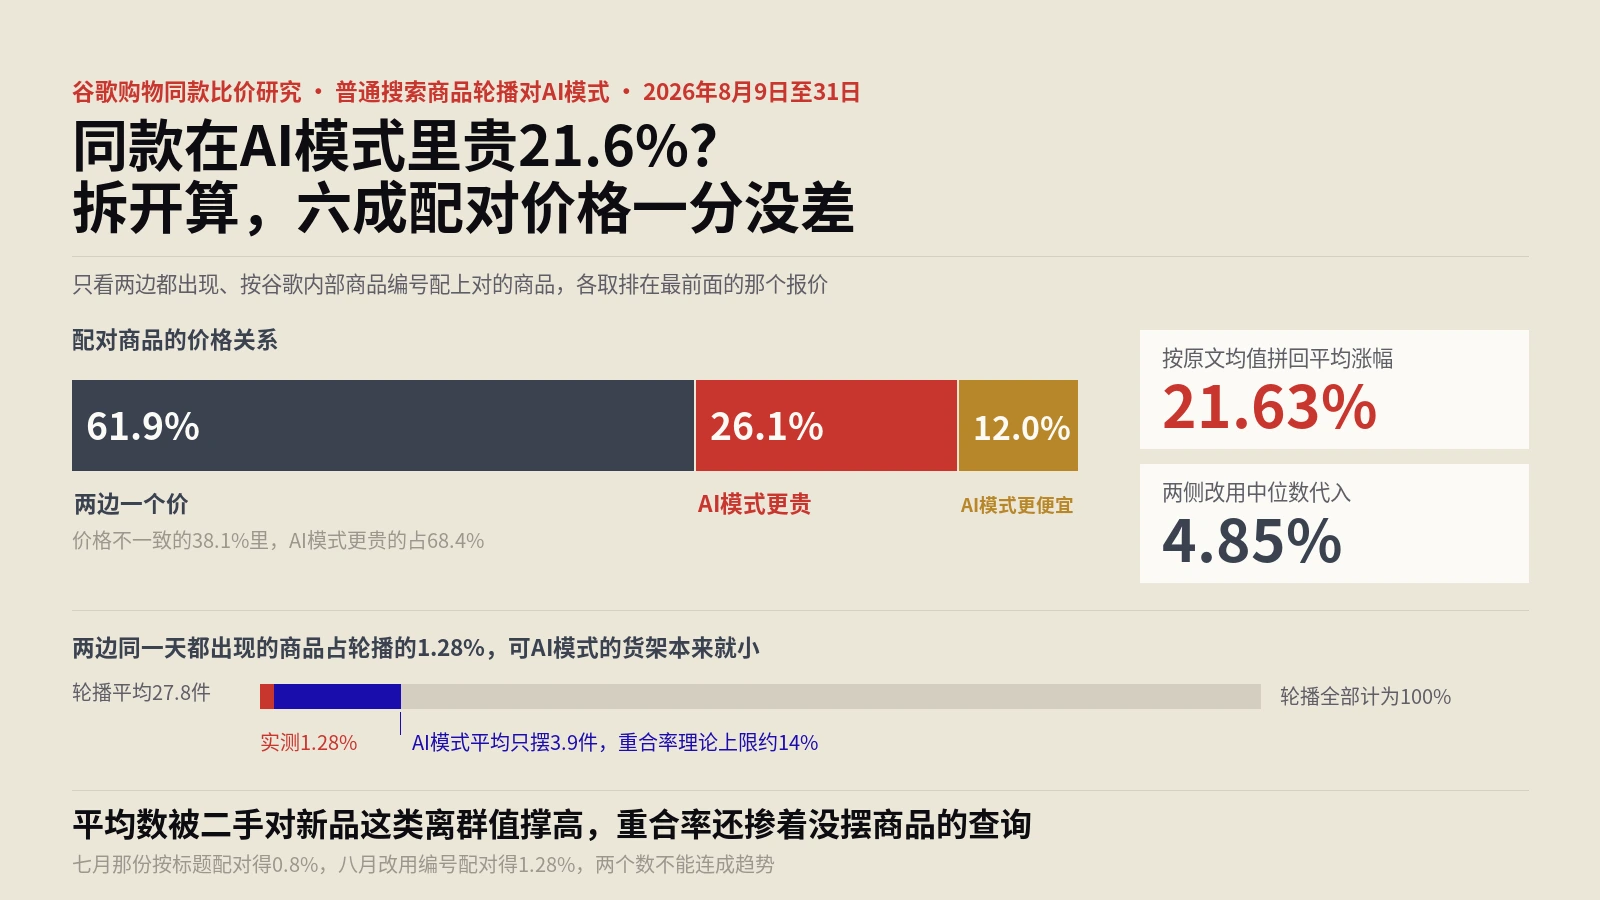
核对办法:用研究方公布的价格不一致比例、两侧贵出的均值与中位数,把21.6%的平均涨幅逐项拼回;再对照同一团队七月的前作、谷歌内部商品编号配对说明和商家后台AI效果报告,区分哪些差异来自样本、配对方法与分母口径。
把OpenAI那份商品数据上传规范整份拆了一遍:64个字段里只有9个必填,availability留空会让整行商品当场被拒,变体那三个字段配错会静默把一组变体拆成互不相干的独立商品。文章按回报排出四步落地顺序,从确认自己在不在名单上开始,到按品类补该补的可选字段。

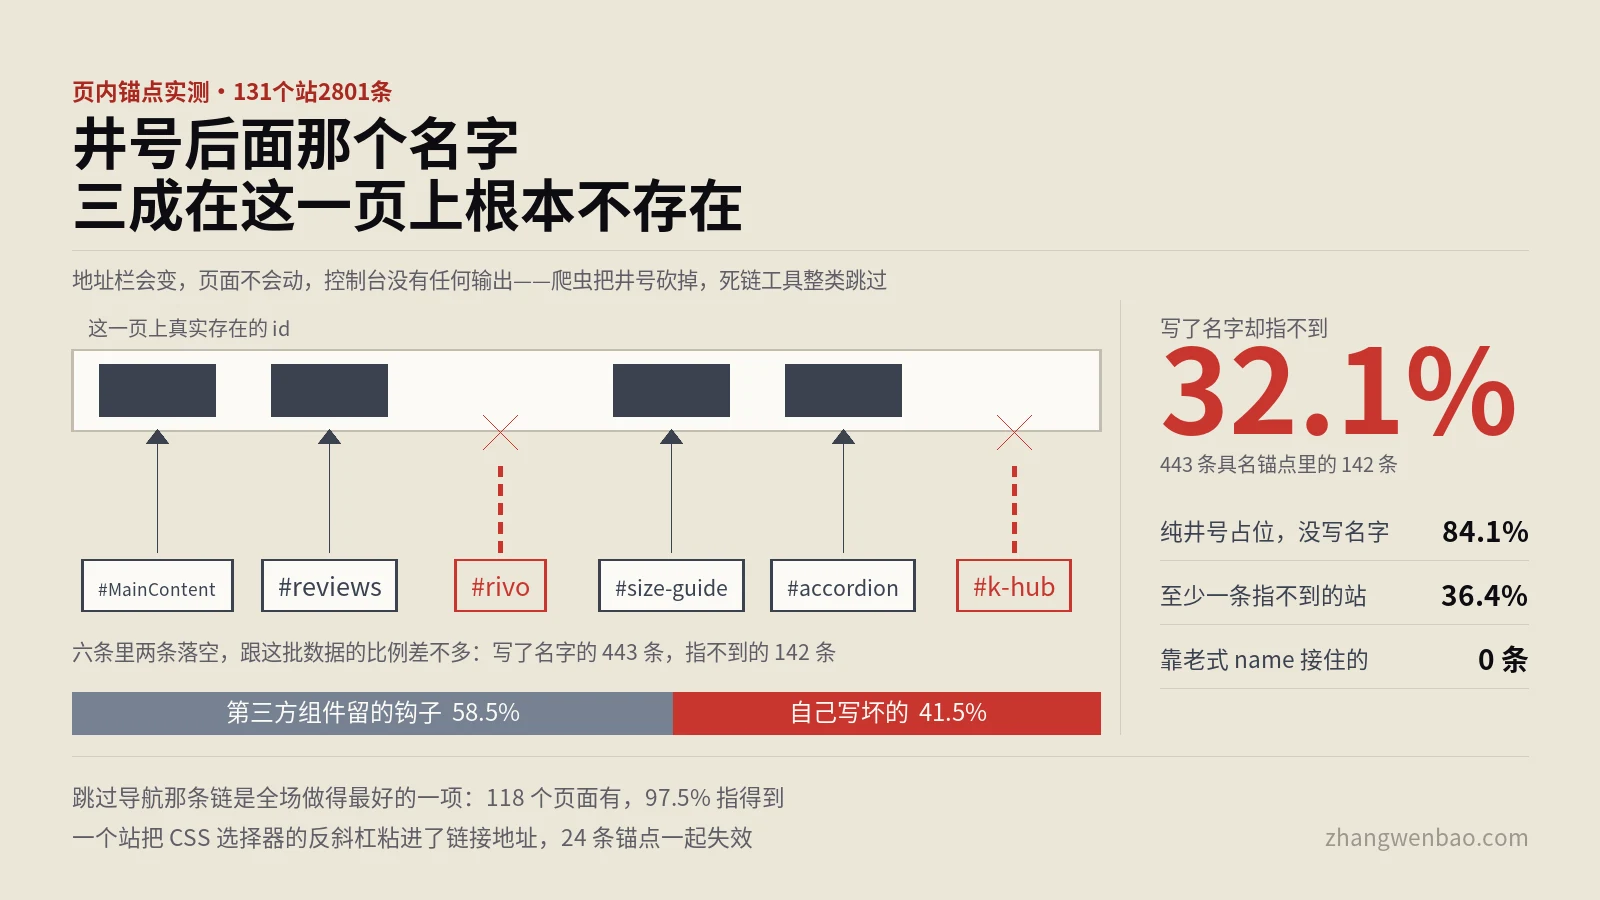
做法是把131个英文独立站首页与商品页上所有以井号开头的链接取下来,连同解析成绝对地址后只多一个井号的那一类,按HTML规范里滚动到片段的四步逐条判定目标在不在。同时把页面上所有按名字指认别人的属性一起量了一遍——label的for、输入框的form、以及aria那一族。这里踩过一个坑:第一遍把单值属性也按空格拆成了多个名字,算出label有一半指不到,改对分类之后真实数字是另一个量级,两个口径都写在文里。死锚点最后按第三方组件的钩子与…
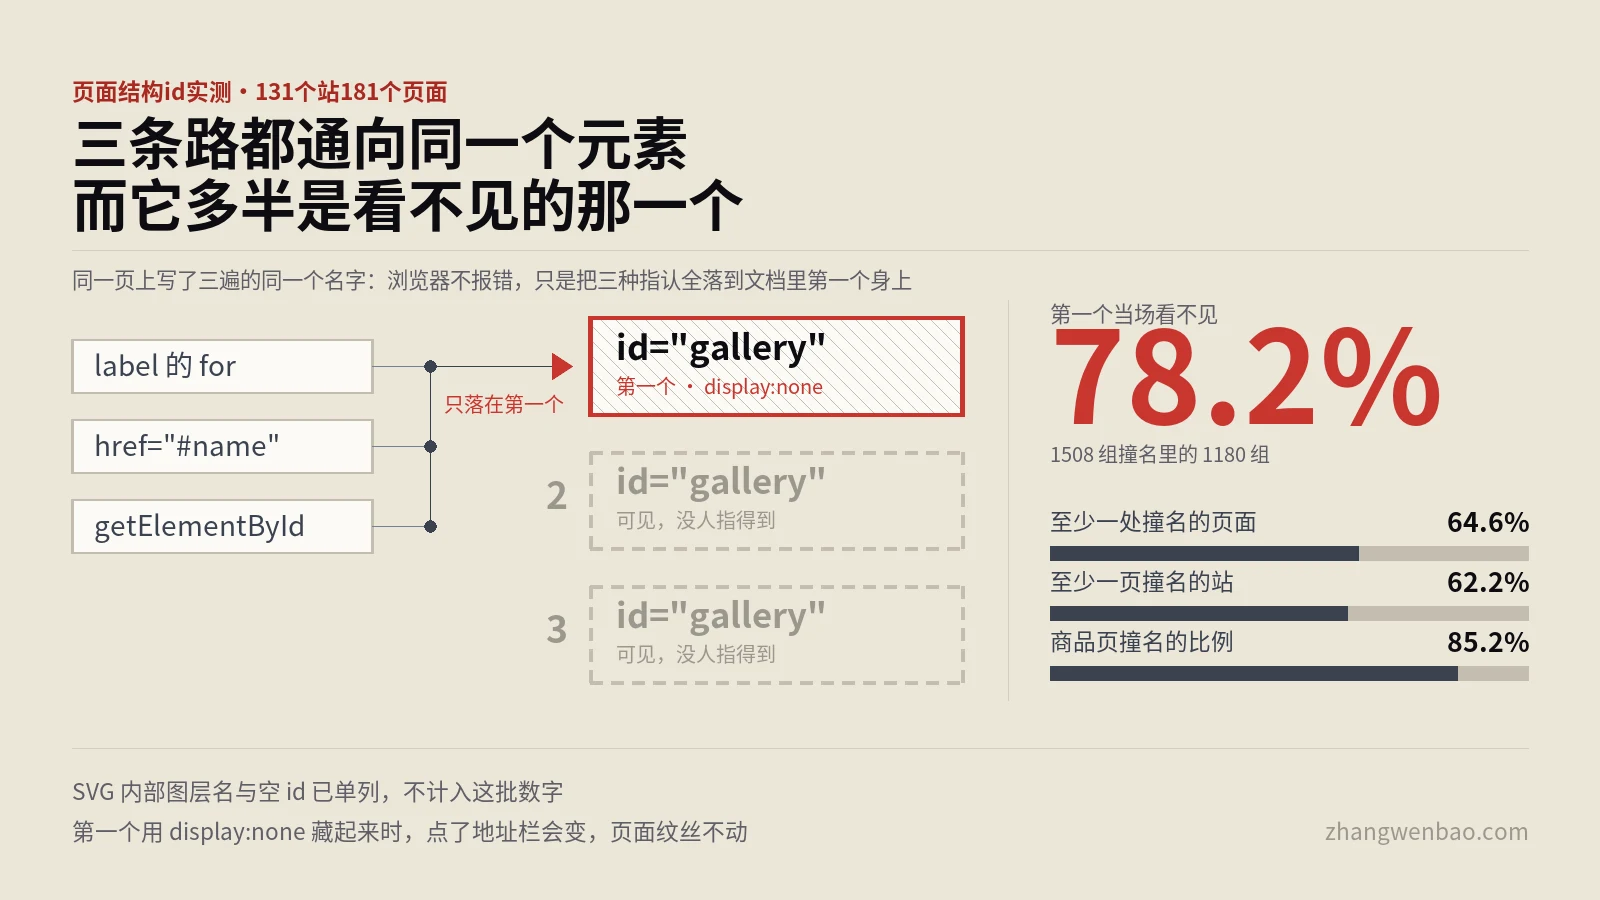
做法是用真实浏览器逐页打开131个英文独立站的首页与商品页,把每个页面上所有带id的元素连同标签名、当场可不可见、往上四层的祖先链一并取下来,按名字分组找出撞名的那些。统计前先把内联SVG导出时自动生成的图层名和写成空字符串的id剔到另外两栏,否则排行榜会被Figma的默认图层名占满。再拿服务端吐出的原始HTML与渲染完的DOM逐页对照,判断这些撞名是模板带来的还是脚本后加的;另挑30个站的首页做两组对照,桌面视口连读三遍再换手机视口读…
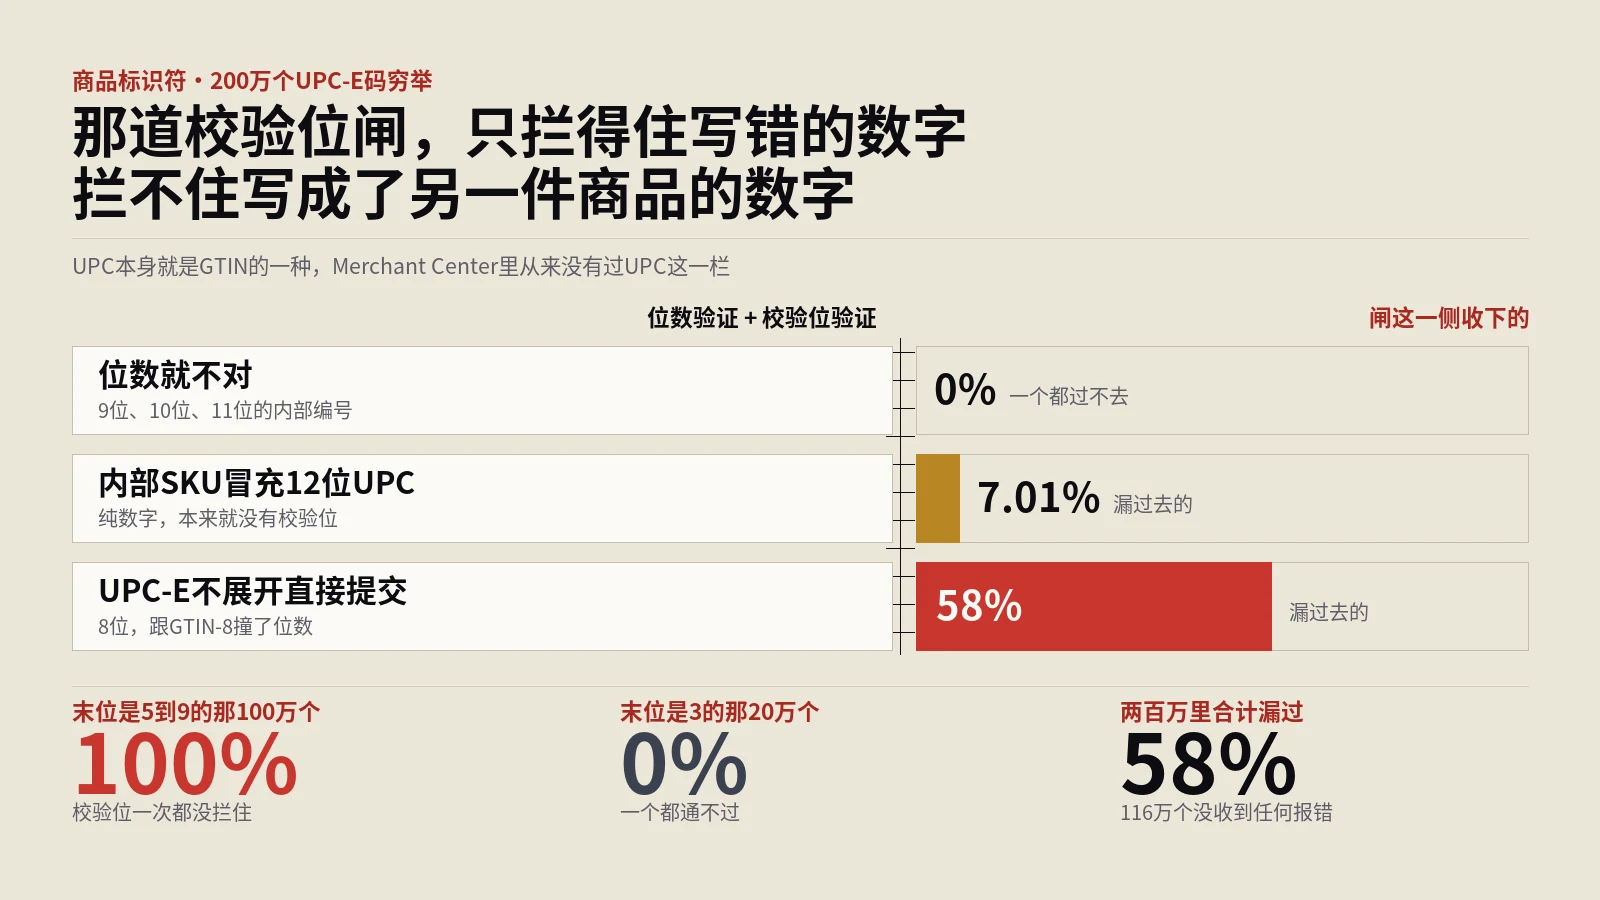
UPC、EAN、JAN、ISBN都是GTIN的格式,Merchant Center的属性表里从来没有过UPC这一栏,手上有码直接填进gtin就是标准做法。这篇把8位UPC-E展开成12位的算法、受限号段与优惠券号段、只有MPN时该填哪一栏、identifier_exists什么时候才允许填no、页面上gtin与mpn与sku与brand四个字段各自的分工,以及Shopify那个藏在变体库存区块里的条形码栏,逐条对着官方文档写清楚,最后附…
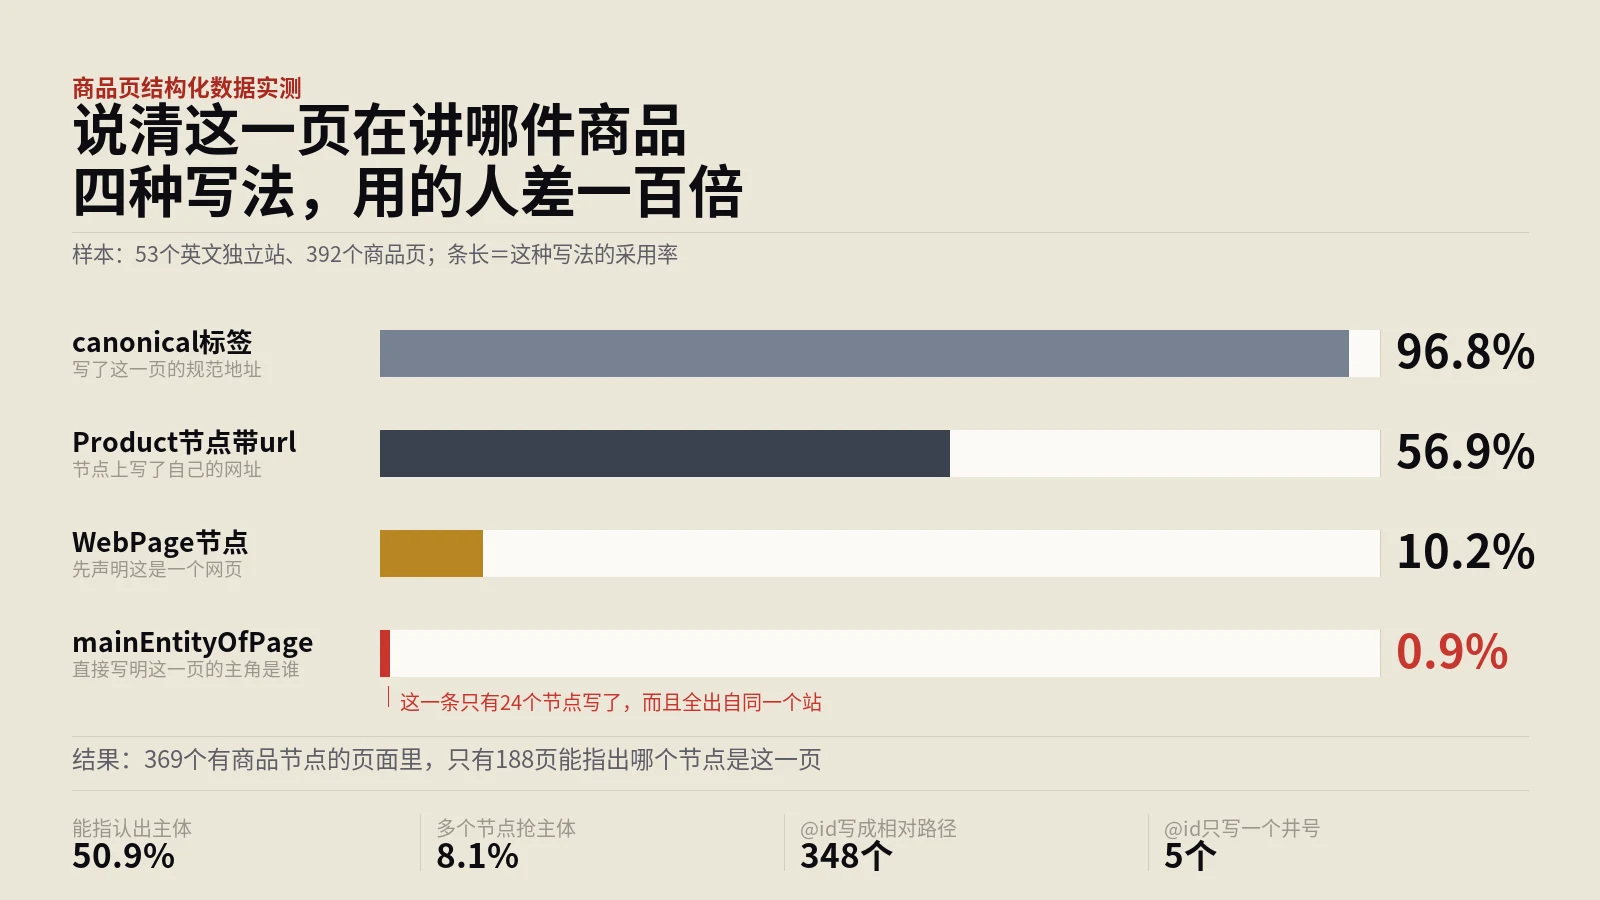
实验台把53个英文独立站392个商品页的JSON-LD节点全部取下,对每一个Product节点上的url与@id补全成绝对地址,再与页面自身地址逐字比对,据此判断这一页能不能指出它的主体。第一版比对忽略了查询参数,得到的通过率虚高三十多个百分点,翻查具体案例后改成完整地址严格比对。随后逐项统计@id、url、mainEntityOfPage的写入率与取值形态,把WebPage节点、结构化数据里的商品名与页面h1、以及同一页内的h1数量一…
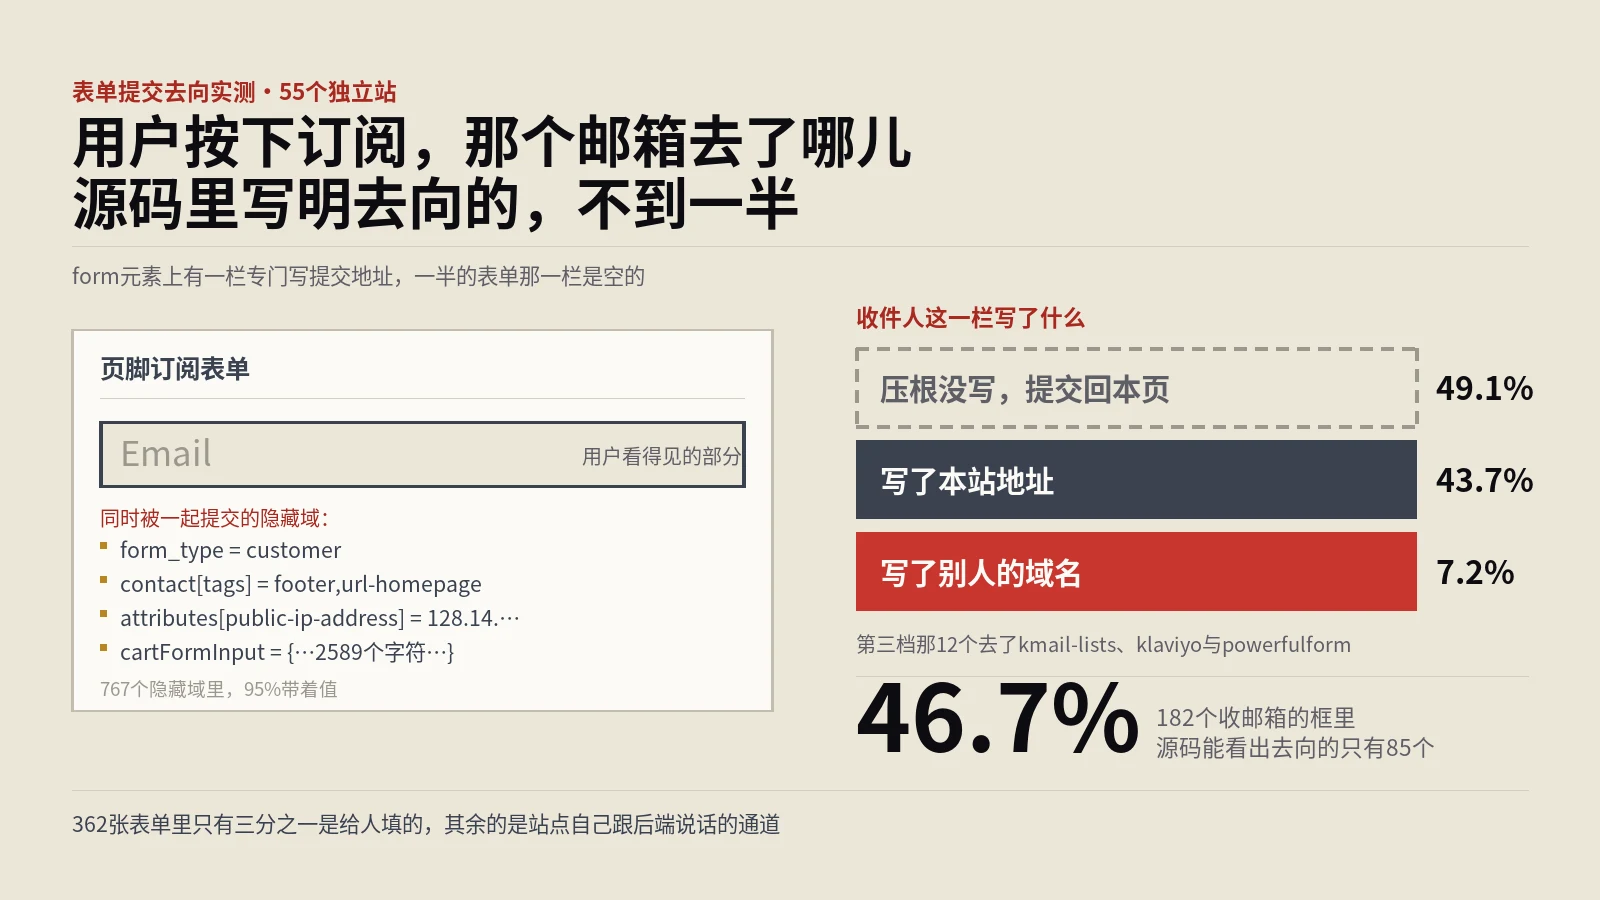
做法是把同一批页面上的form元素连同它的action、method、enctype、novalidate、提交按钮与全部隐藏域一并取下来,按站内签名合并重复渲染的表单,再把每个收邮箱的输入框与它所在的那张表逐一对上,看去向写在哪儿。跨域判据取注册域比较,不看子域;隐藏域按名字归成八类用途,并记下取值长度。另外对每个页面再取一次原始HTML,与渲染后的DOM逐页对照,用来区分“页面本来就这么写”和“脚本后来插进去的”。
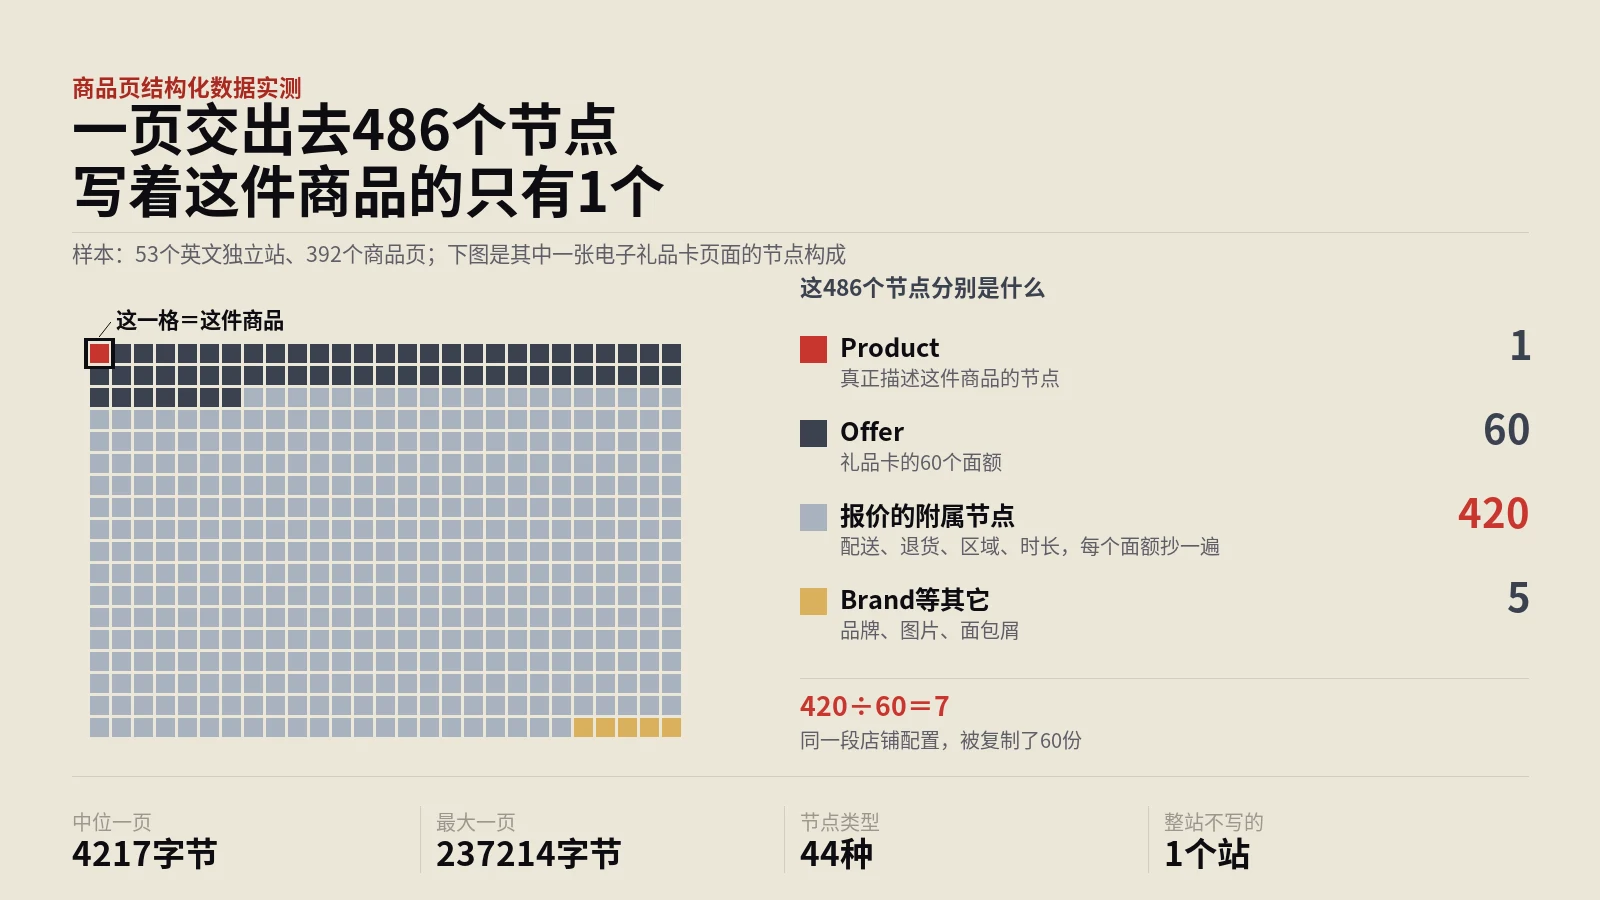
实验台用真实浏览器逐页打开53个英文独立站的392个商品页,等页面渲染完成后取出全部application/ld+json脚本,递归遍历每一个带@type的对象,按类型和它在JSON结构里的位置分别计数,同时记录字节量与脚本标签数。为了把模板复制与变体展开这两种不同的膨胀来源分开,每个站另外抽取了主推款与长尾款做同站对照;三个拿不到真实商品页的站——反爬拦截、跳转首页、地址全部失效——从统计中整体剔除。最后用加长等待时间的第二轮采集做自…
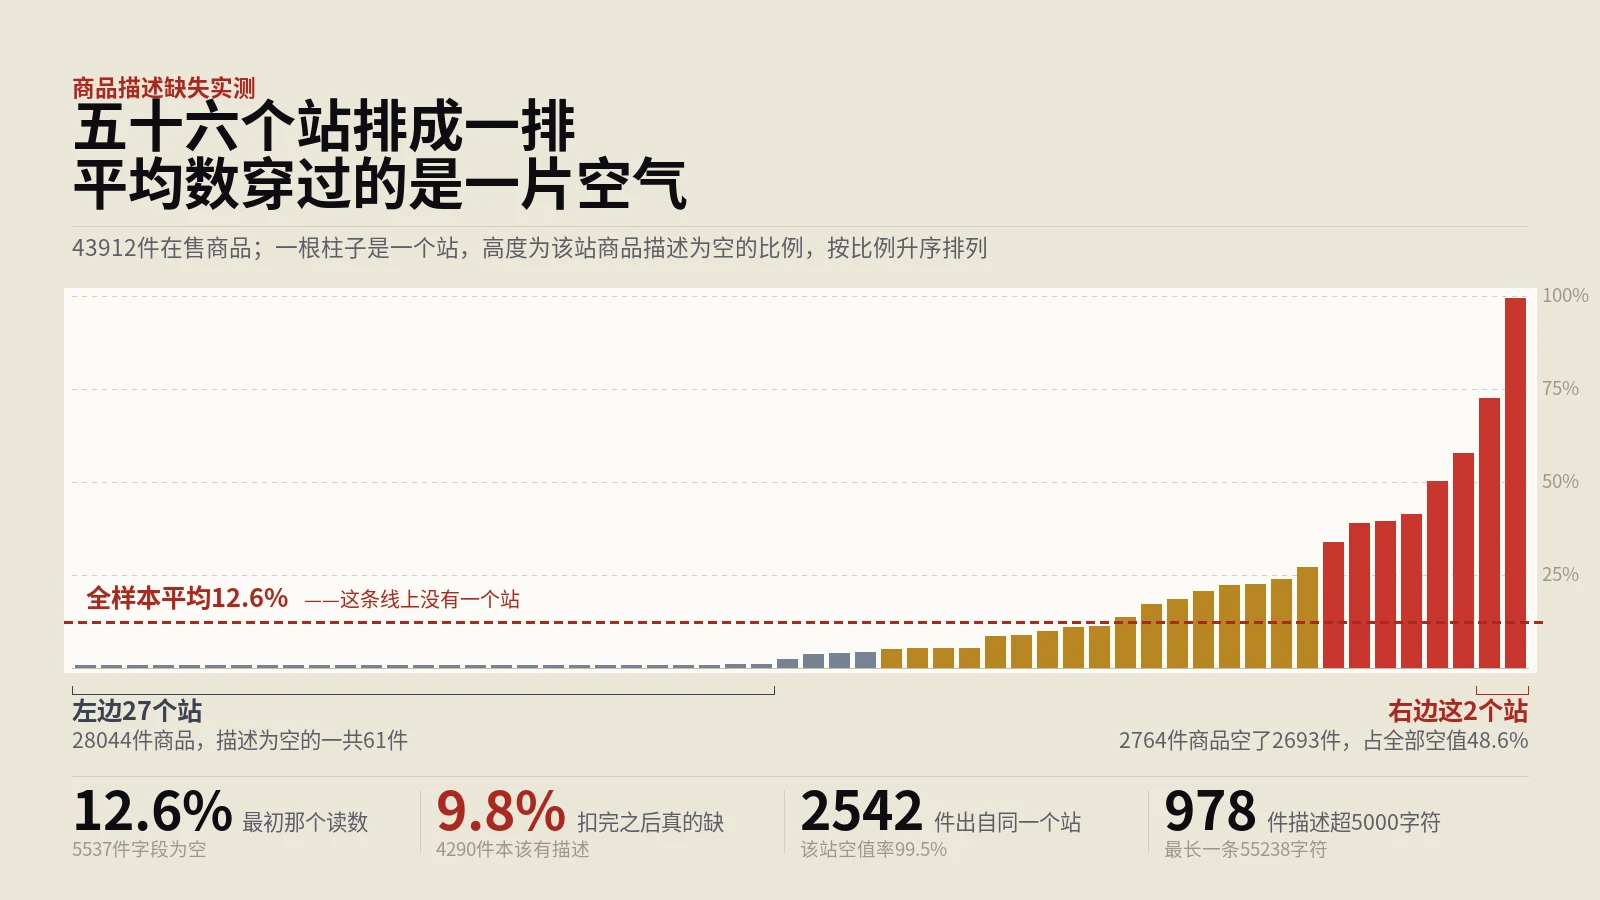
实验台从60个英文独立站的公开商品清单接口取回43912件在售商品的描述字段,先按站算空值率并观察整体分布形态,再用逐站剔除法看单个站对行业指标的影响幅度。随后给每一件空值商品跑一遍归因,按站级用法、非商品条目、占位测试、整条半成品四档依次往下扣。最后用真实浏览器打开商品页,把JSON-LD里的description与页面meta描述取出来跟接口值三方对照——正是这一步推翻了第一档的扣减依据,把2542件从待定改判回真缺,缺口最终从最初…
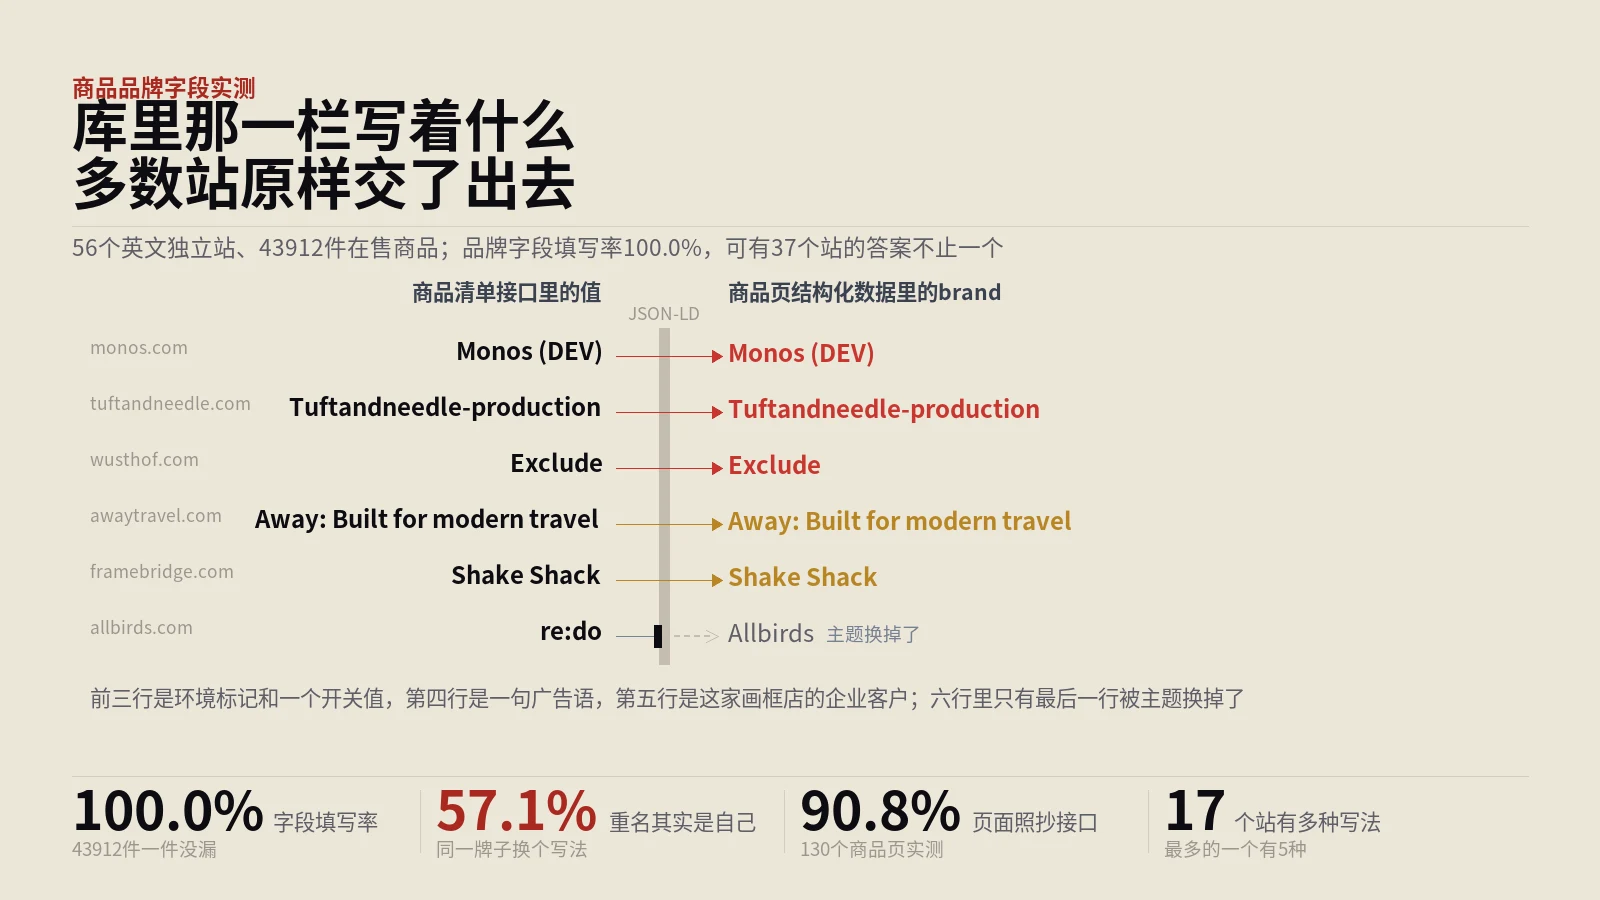
实验台从60个英文独立站的公开商品清单接口取回43912件在售商品的品牌字段,先按站算出主品牌,再把每一个非主品牌的取值做三级归一化——去掉重音符号、把与号换成and、砍掉地区码与公司后缀,据此把它们分成同一品牌的别写、字面空值、真正的另一个牌子三类,并逐条做字符级差异归因。随后用真实浏览器逐站打开商品页,等页面渲染完成后取出JSON-LD里Product节点的brand属性,与接口值一件件对照,判断这些取值有多少原样进入了搜索引擎读取…
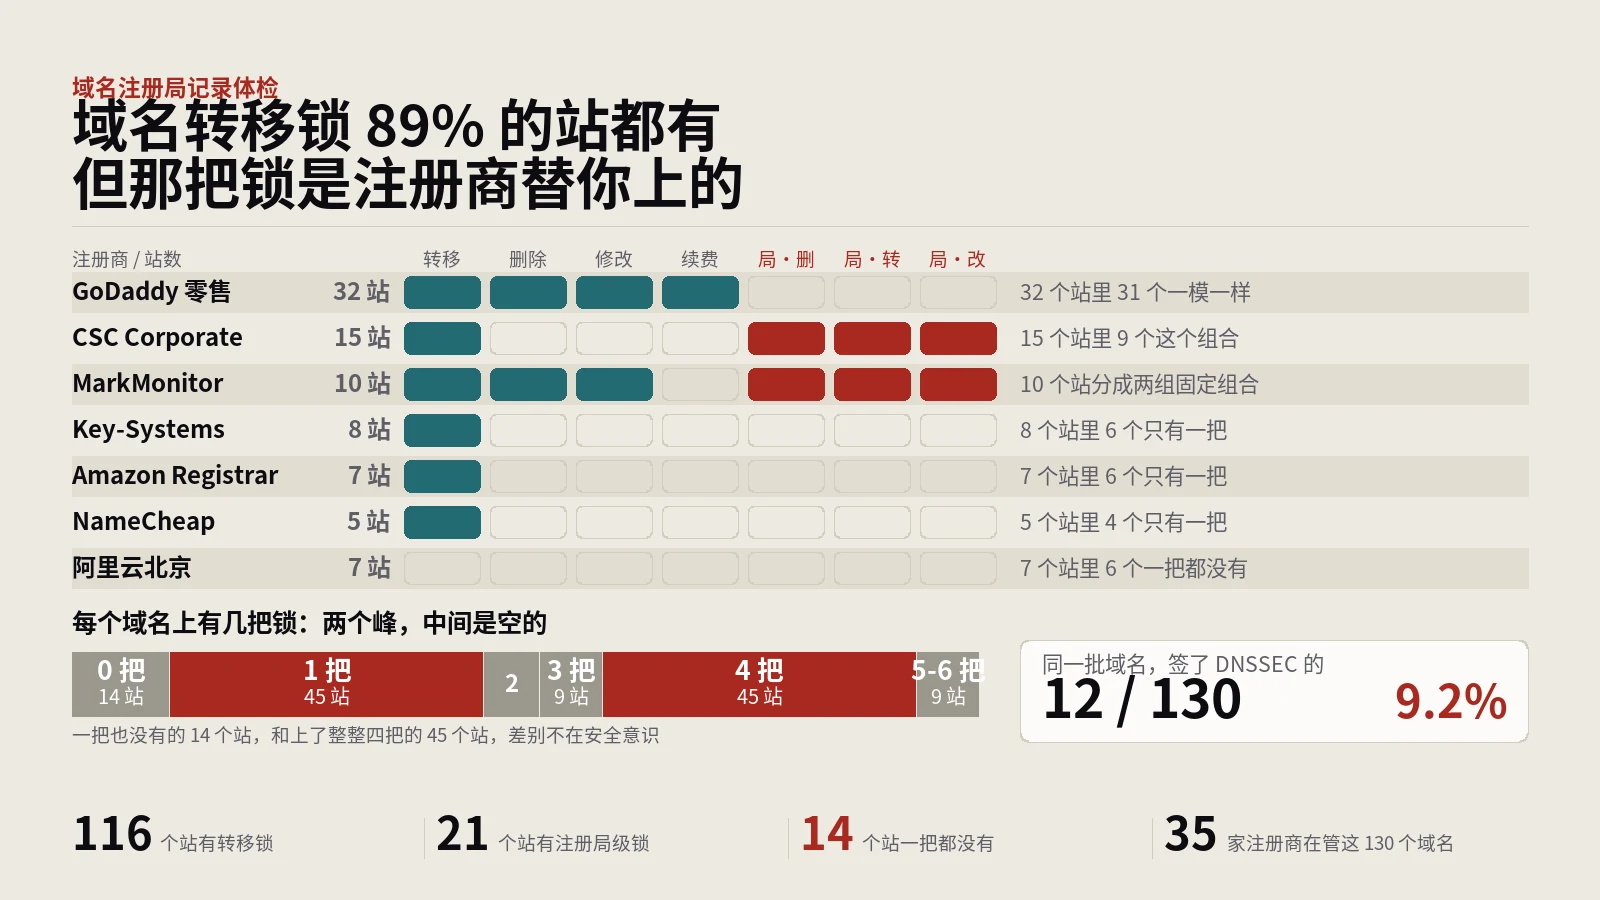
用RDAP协议逐个拉130个大牌域名的注册局记录,解析EPP状态位、到期事件、注册商归属与DNSSEC委派标记,再用DNS over HTTPS查DS记录两边对账;聚合服务限流掉的44个站,改从IANA引导表直连各注册局补齐。四把尺子中途改过,其中一把关系到整篇的分母。
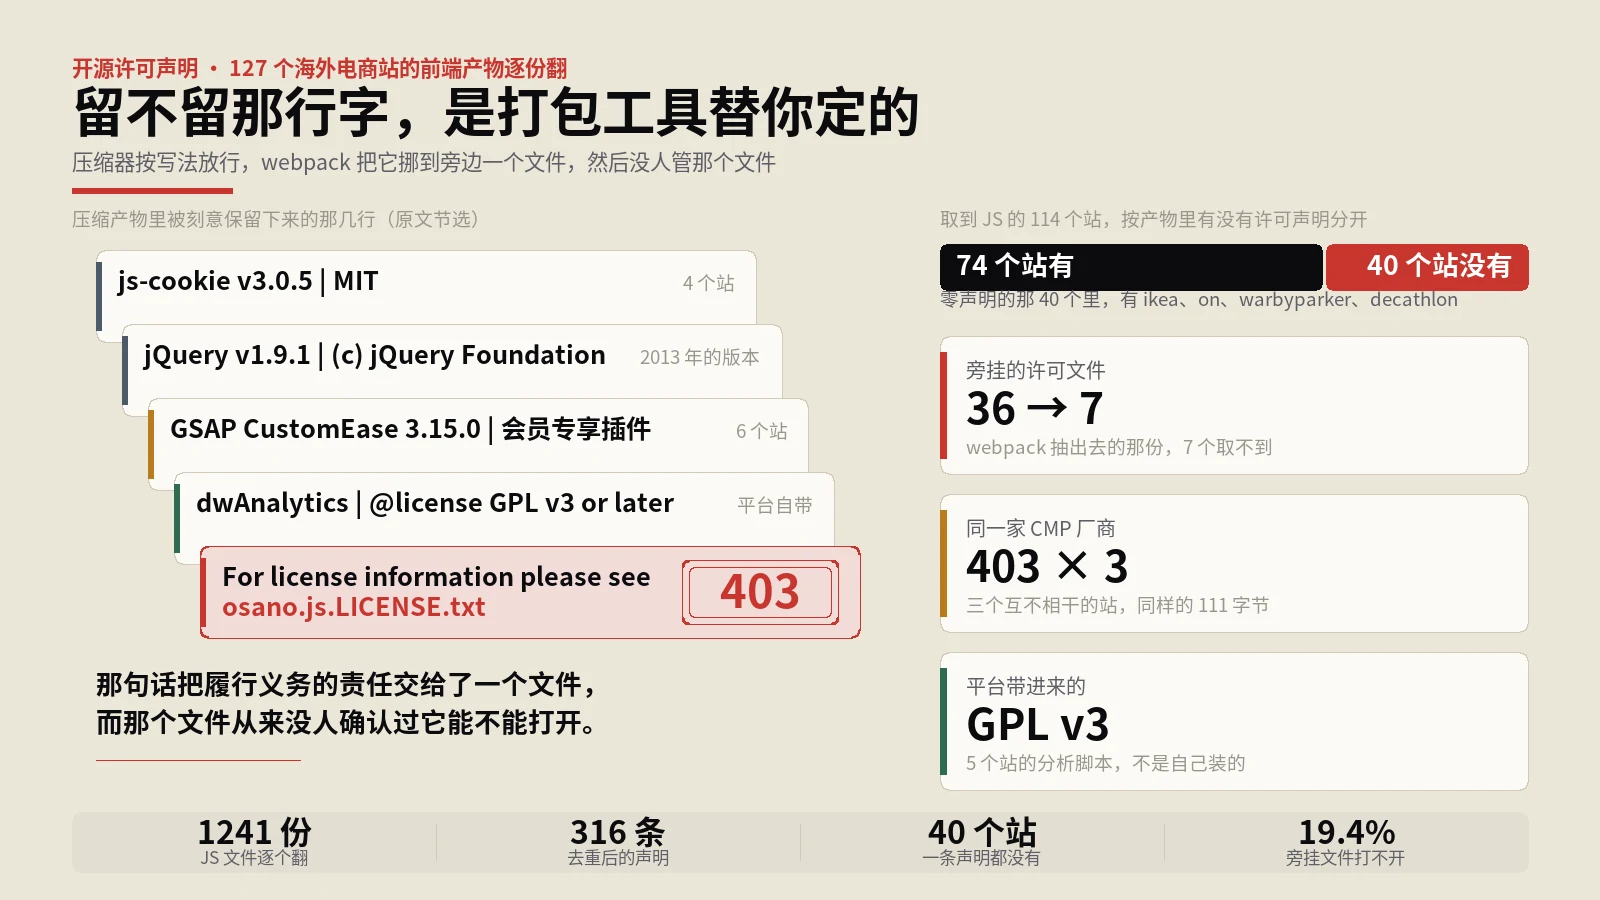
取127个海外电商站首页的全部外链脚本,把每份文件里的块注释扒出来,先按写法筛出构建工具刻意保留的那批,再判断哪些真是许可声明;随后把webpack抽到旁边的36个LICENSE文件逐个访问。第一版判据太窄,把短格式的声明整批判成了非许可,修完结论方向就变了。
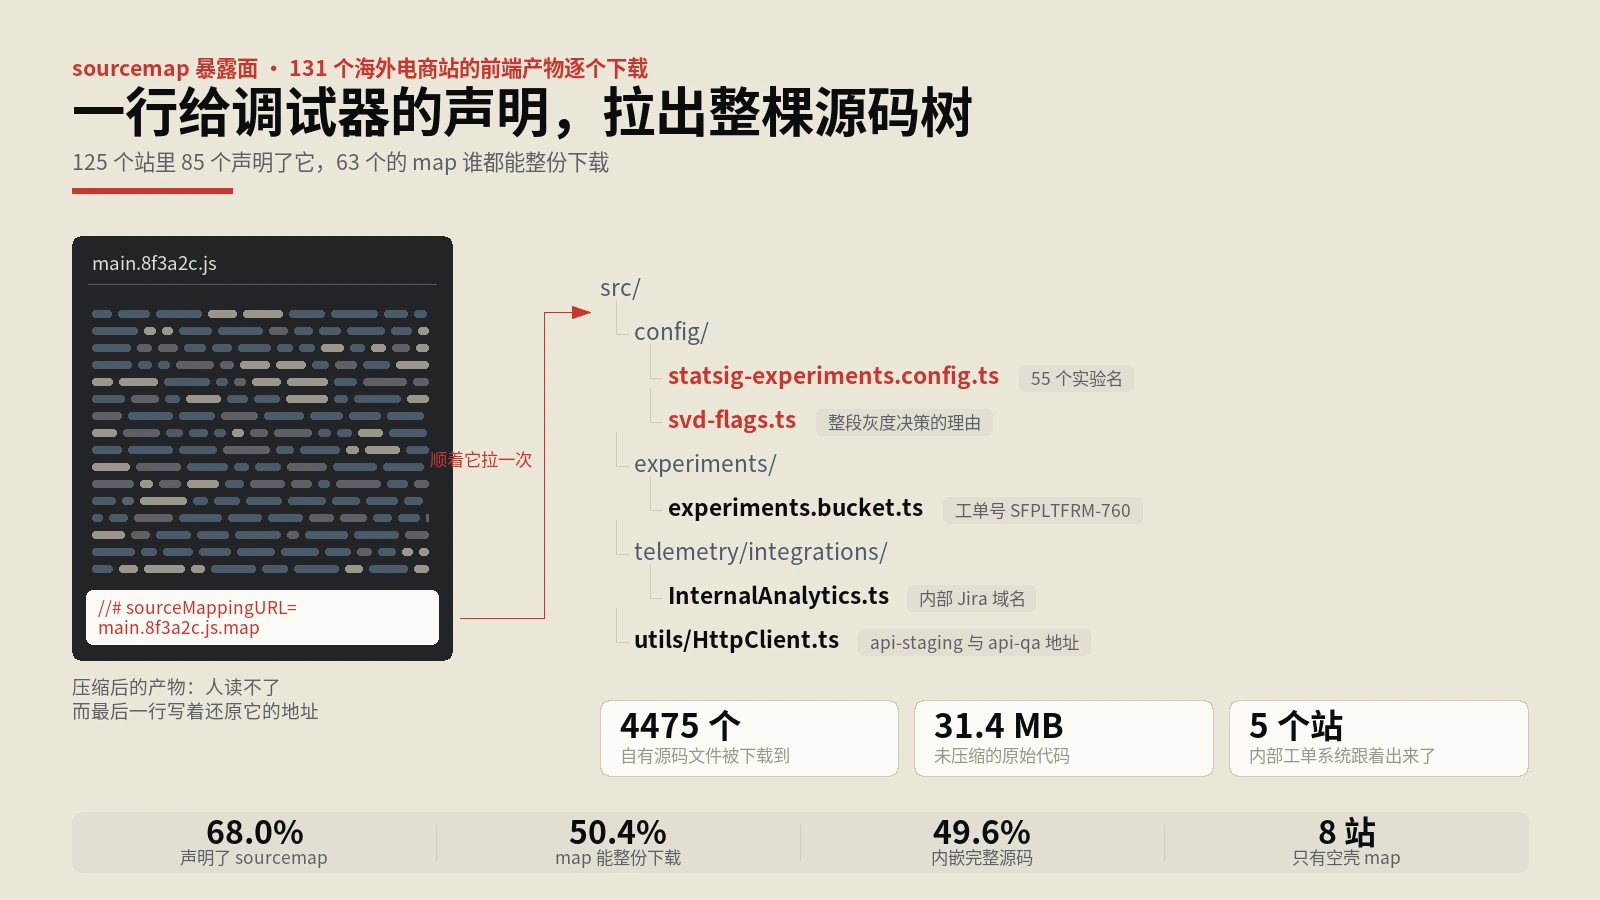
对131个海外电商站首页引用的JS与CSS逐个下载,在文件尾部搜sourceMappingURL声明,顺着声明拉map并解析;用正文首字节而不是状态码判真伪,剔掉单页应用的兜底首页和只有29字节的空壳map,最后把拿到的自有源码全文扫一遍工单链接、非生产域名与实验配置。五道尺子全部修过一遍。
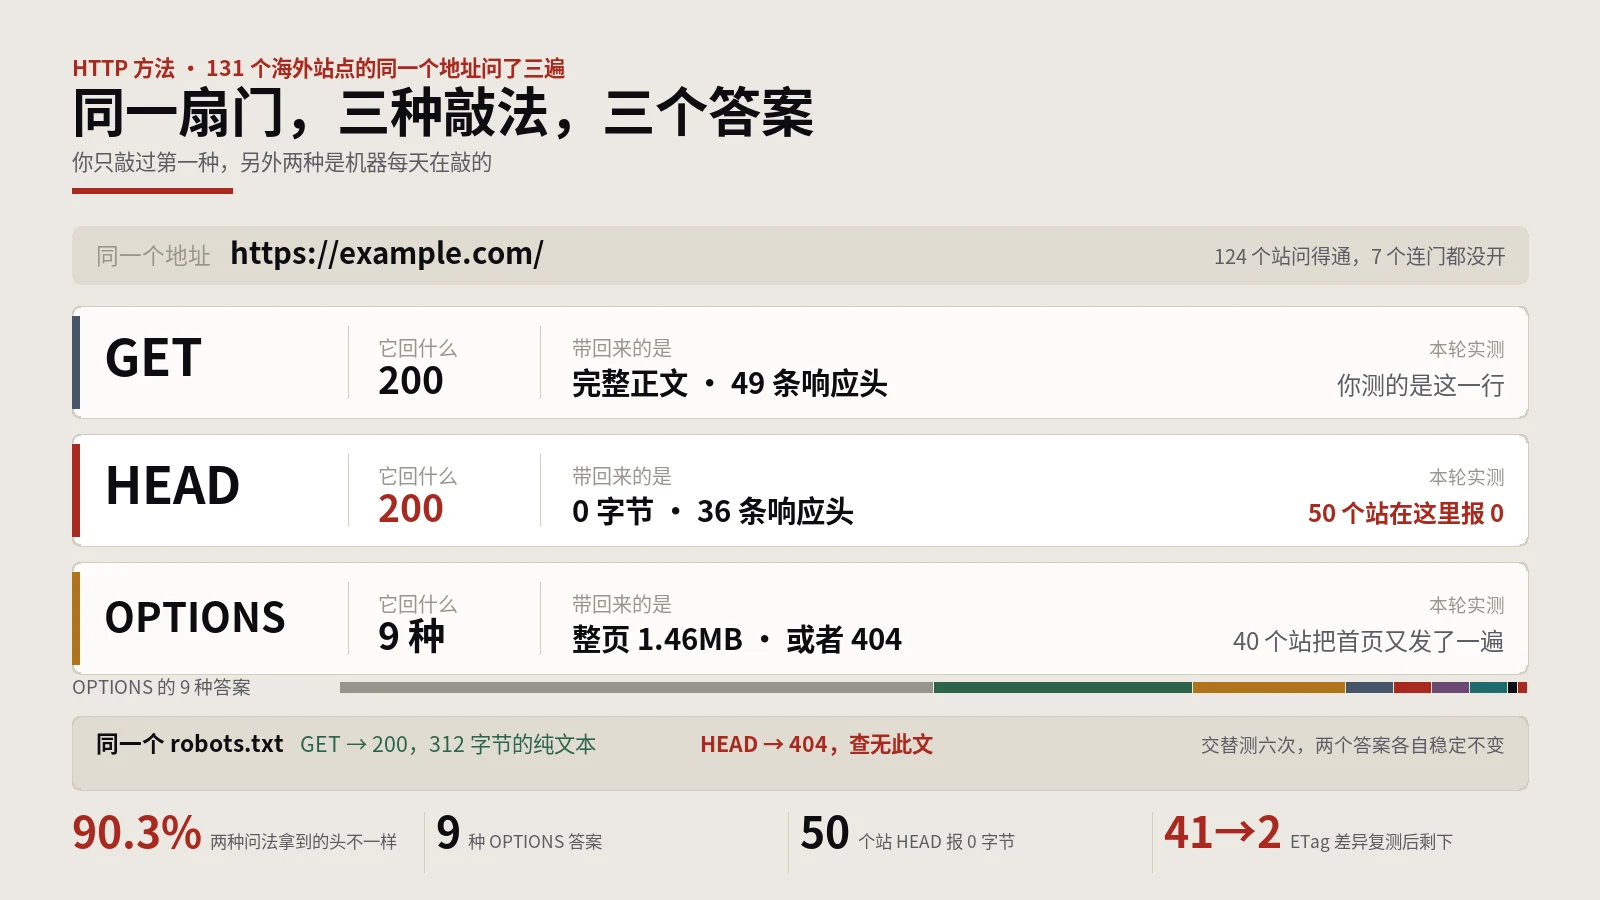
对同一个首页地址依次发GET、HEAD、OPTIONS,记录状态码、全部响应头、正文字节与耗时,再往下测一层内页、一个静态资源和robots.txt;被拦的站打乱顺序多轮重试,把分母从84做回124。五把尺子中途改过,其中ETag那把把41个站的结论砍成了2个。
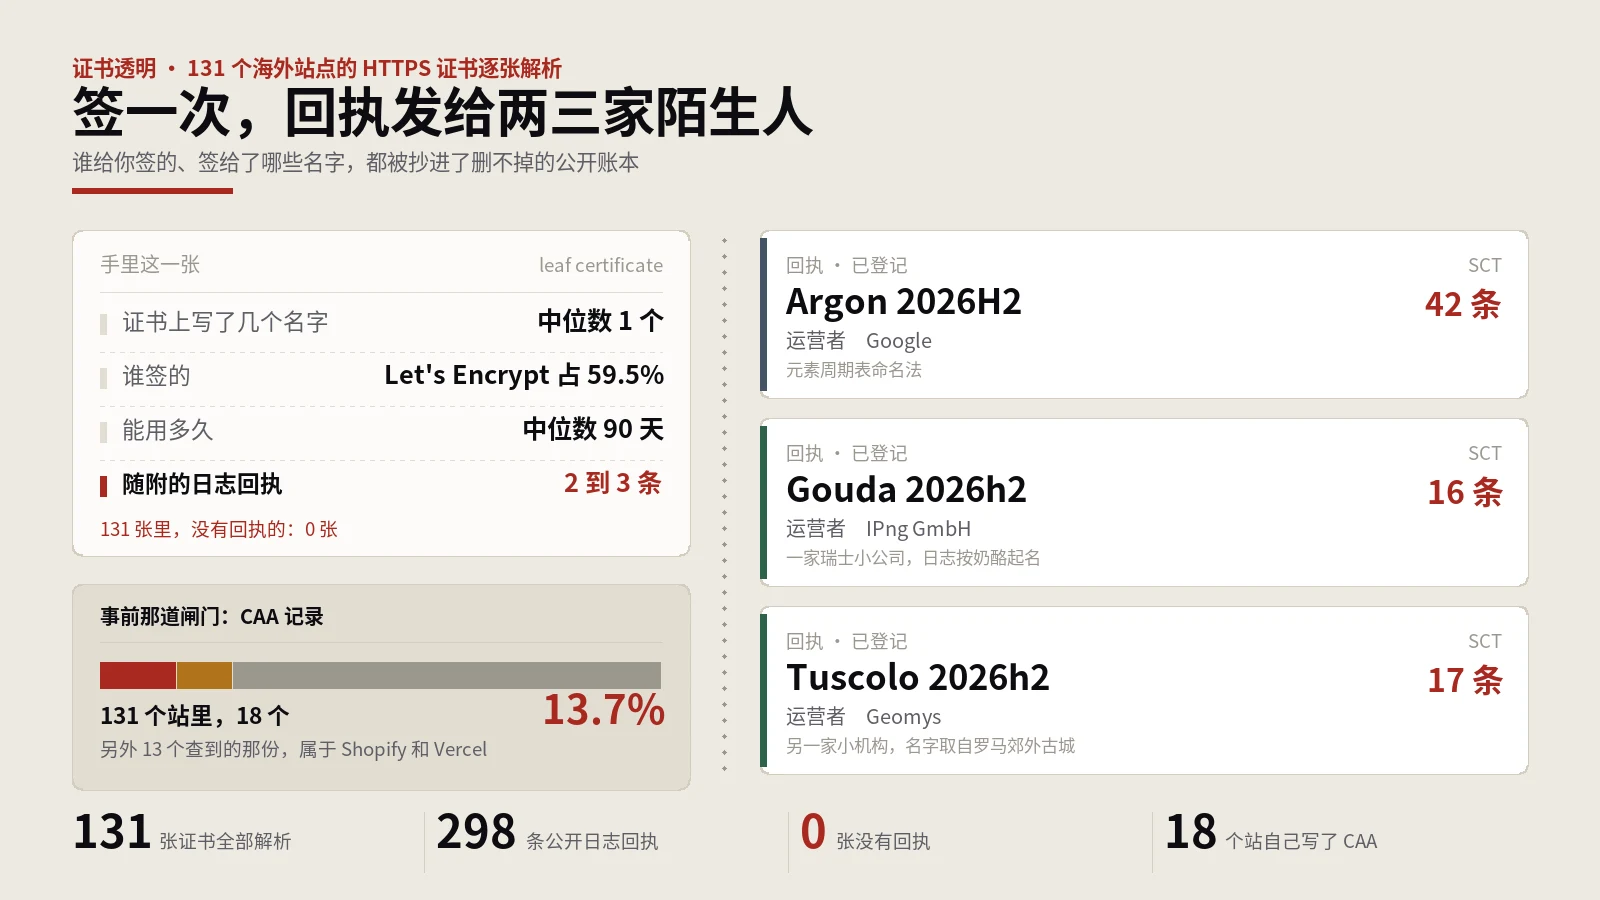
用TLS握手逐站取下叶证书,解析SCT回执、SAN名单、策略标识与AIA扩展;再用DNS over HTTPS从待签发的名字逐级向上查CAA,遇到CNAME跟着跳过去,最后把事前授权与事后账本对账。四把尺子中途改过,其中三把改变了结论方向。
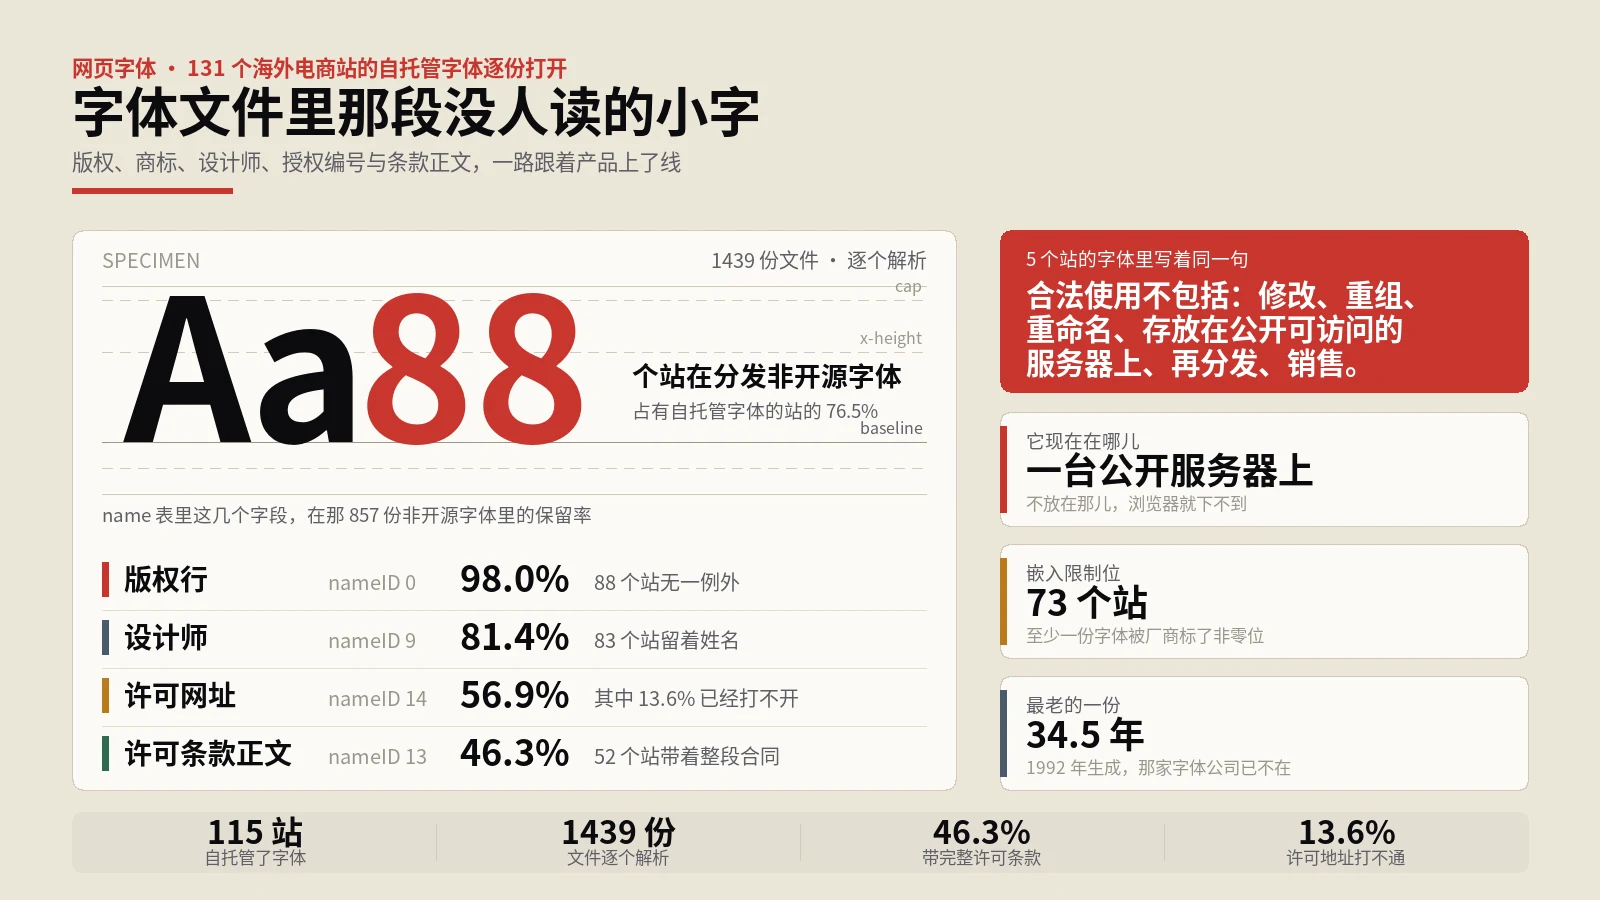
顺着131个海外电商站首页CSS里的@font-face把自托管字体逐个下载,用fontTools读name表与OS/2的fsType位,一律按站统计;再把字体里写着的176个许可与厂商地址跟随跳转逐个访问。三把尺子中途修过:图标字体判据误杀真排版字体,head日期是1904纪元的秒数,死链不跟跳转会把结论写反。
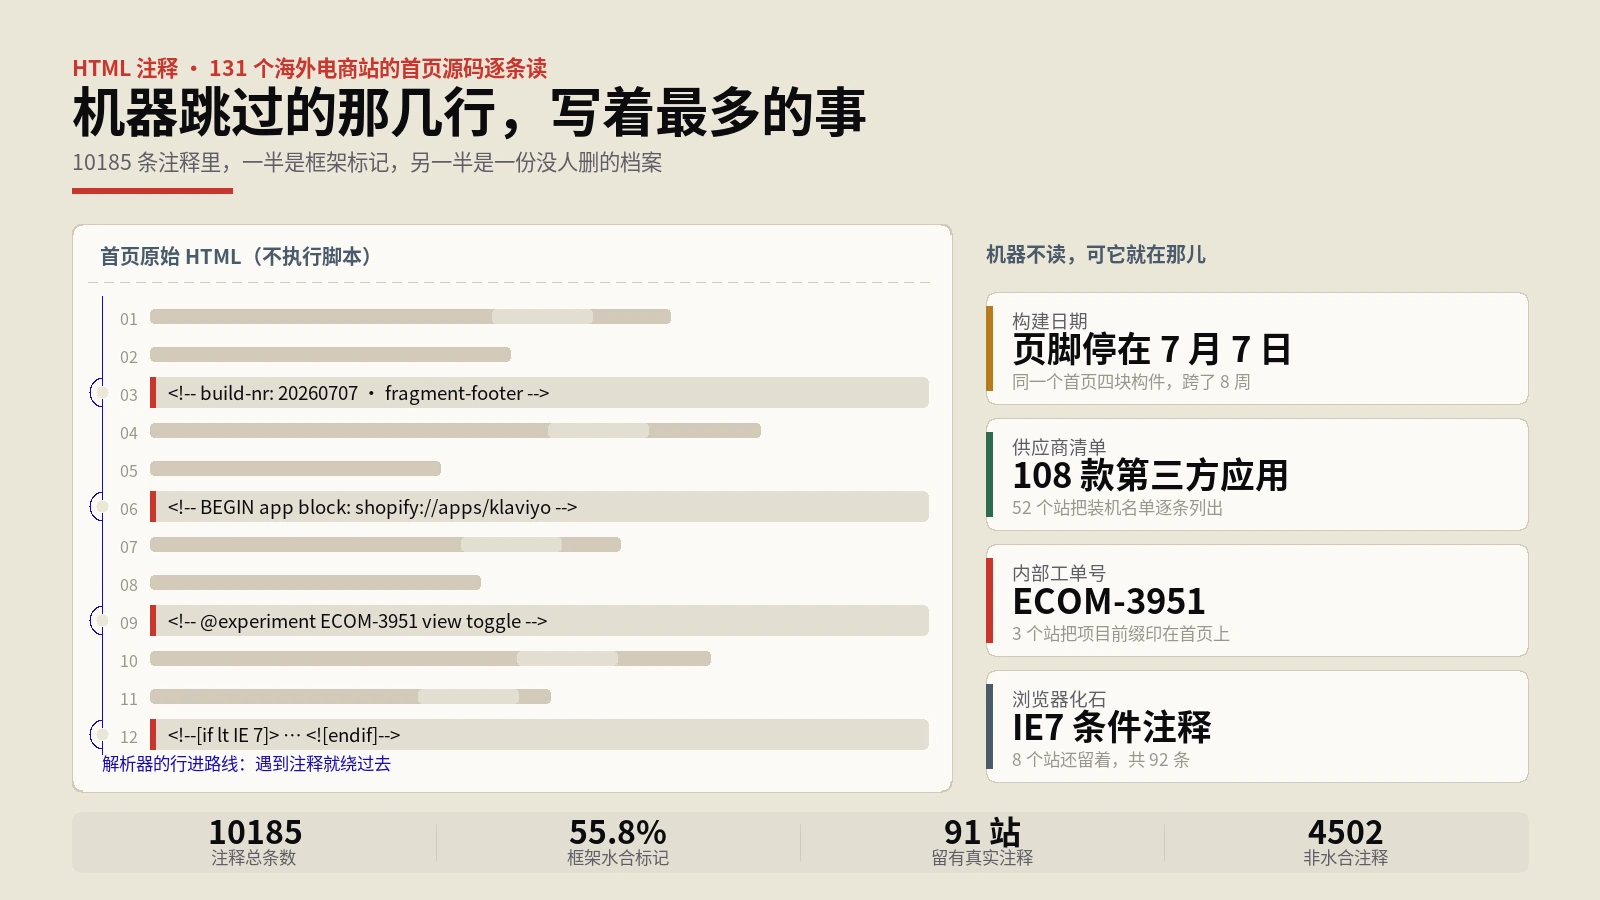
取131个海外电商站首页的原始HTML而不是渲染后的文档树,逐条抽出注释,先剔掉React与Vue流式渲染的水合标记,再按内容打十一类标签、一律按站统计;日期戳、工单号、应用块清单逐条回原文人工核对。中间修了两次判据,一次把排名整个颠倒,一次差点把巧合写成发现。
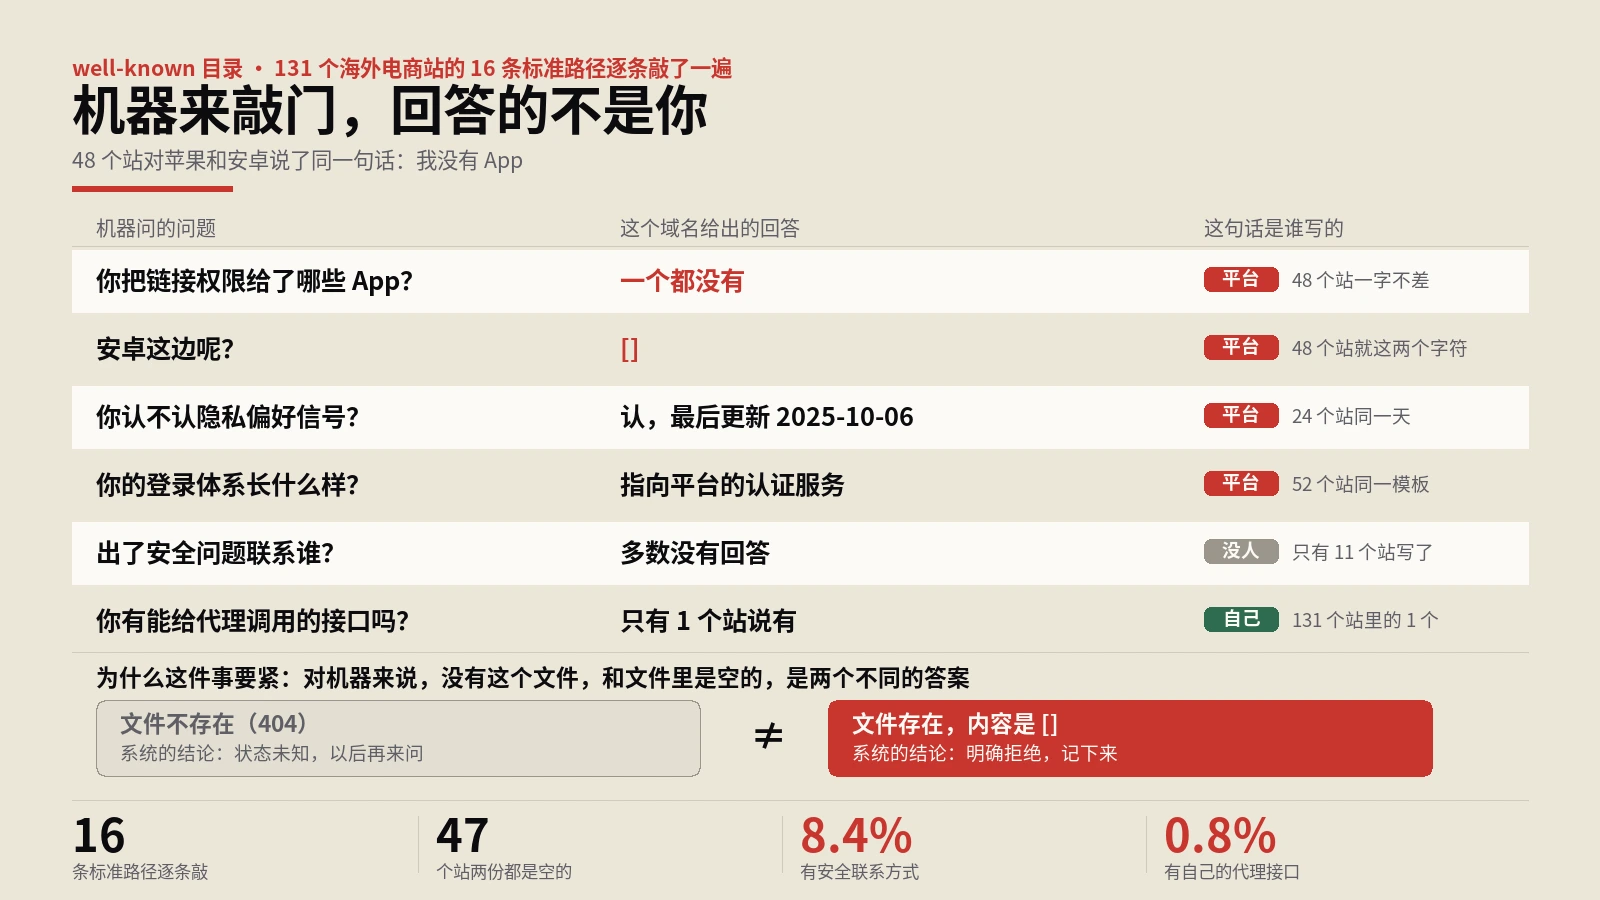
把131个海外电商站的16条well-known路径挨个请求,跟随重定向后按三层判据剔掉假200:状态码、内容类型、正文里有没有自称404或拒绝访问的结构;再抹掉域名与店铺标识做内容聚类,区分哪些是平台批量铺的、哪些是品牌自己写的。判据前后改了6处,方向全部是让数字变小。
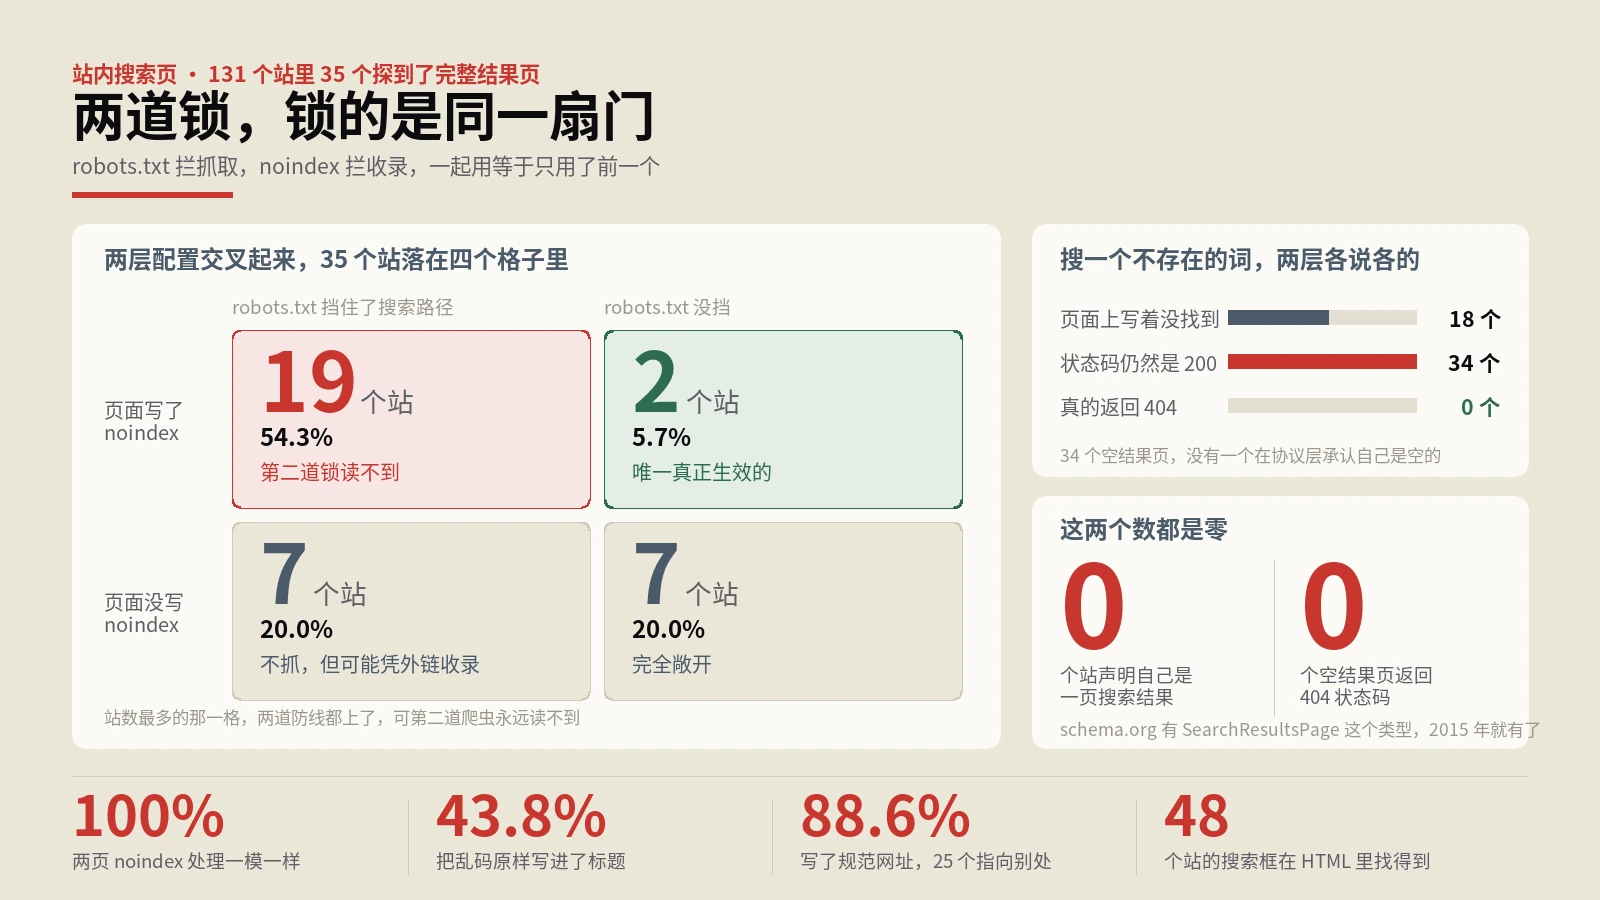
131个海外品牌站逐个找站内搜索入口,用一个常见词和一串随机字符各搜一次,把状态码、meta robots、X-Robots-Tag、规范网址、JSON-LD与robots.txt六项对齐比对;人工剔除参数落在首页的伪样本之后,落在35个站的严口径样本上。