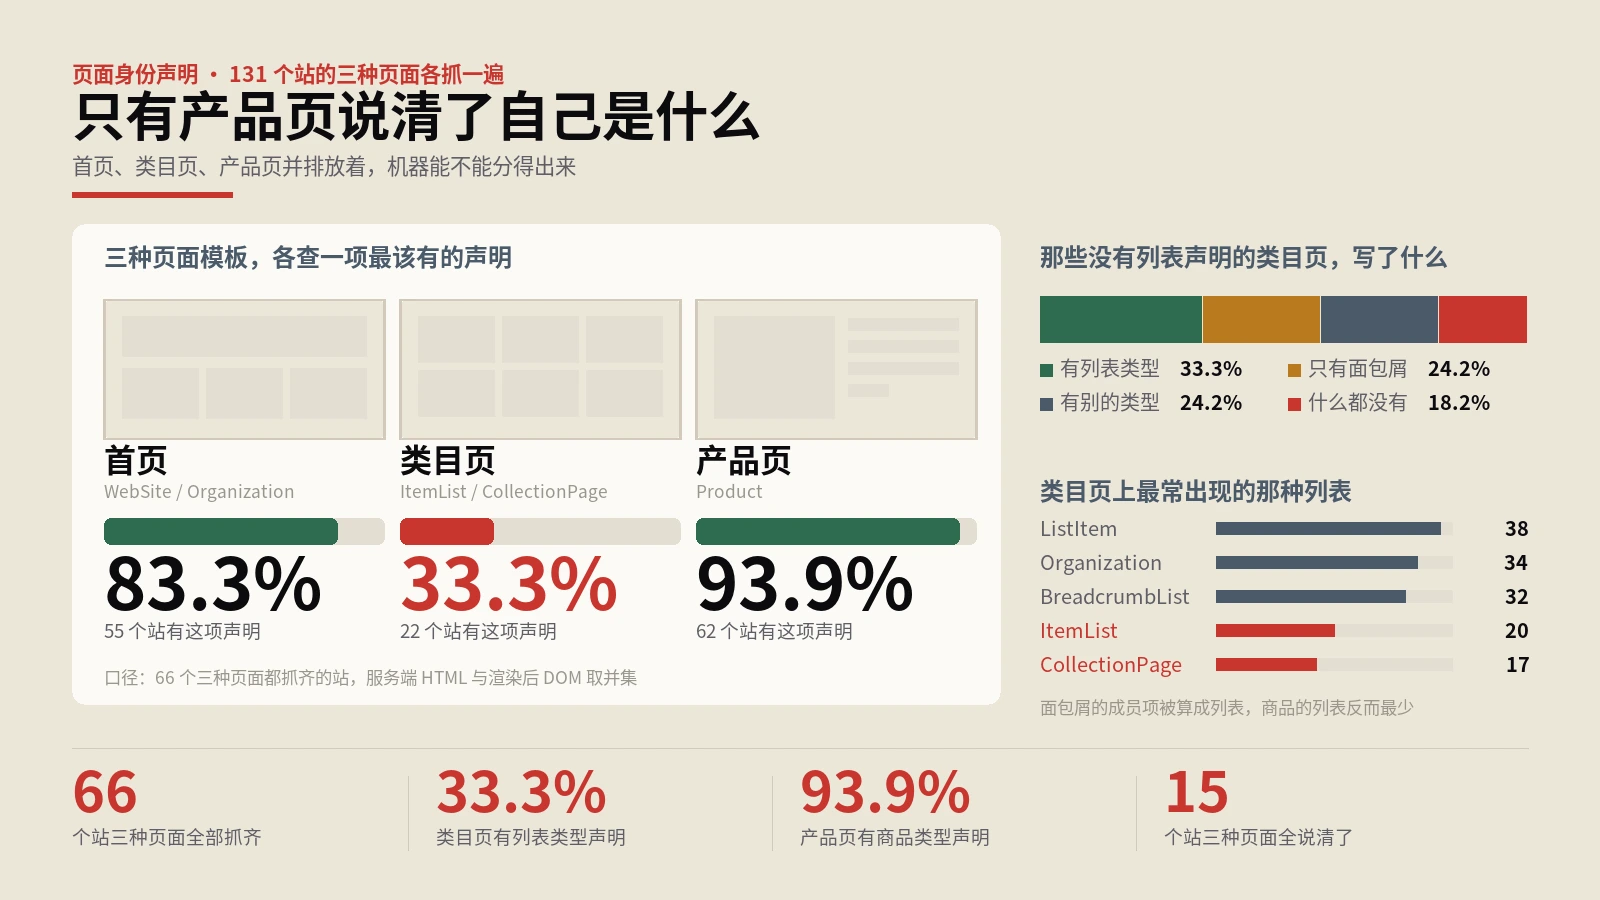
结构化数据实测66个站:产品页都写了,类目页只有三分之一
用真实浏览器把131个海外品牌站的首页、类目页、产品页各抓一遍,服务端HTML与渲染后DOM两份都解析后取并集,再人工逐条核对网址挑得对不对,最后落在66个站的可比样本上,逐项量三种页面各自的身份声明覆盖率。
标签
保哥笔记 电商SEO 标签下共 50 篇文章合集,含《站内搜索页搜不到也返回200,两道锁锁的是同一扇门》《结构化数据实测66个站:产品页都写了,类目页只有三分》《一个词值不值得单开一页,87个站的站点地图先替你答了》等,与 结构化数据、技术SEO、AI购物 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
用真实浏览器把131个海外品牌站的首页、类目页、产品页各抓一遍,服务端HTML与渲染后DOM两份都解析后取并集,再人工逐条核对网址挑得对不对,最后落在66个站的可比样本上,逐项量三种页面各自的身份声明覆盖率。
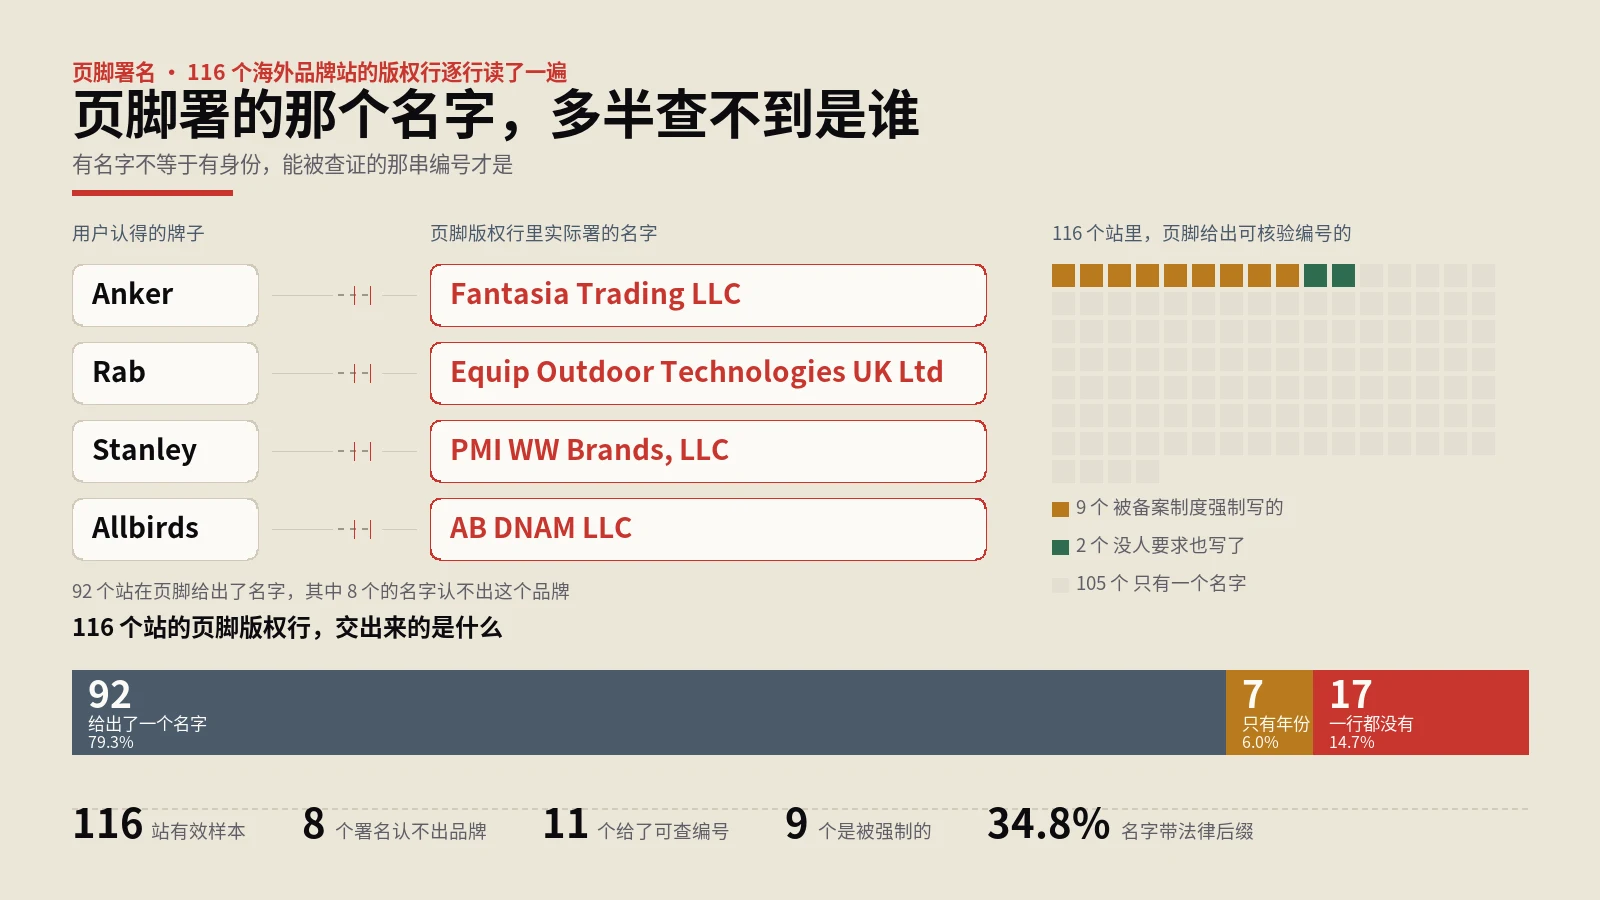
116个海外品牌站的首页页脚版权行逐行读取,切出署名后与域名主体做归一化比对,识别法律实体后缀与注册号写法;自动切分结果逐站人工核对,修正9处切分与归一化误差,署名与品牌不符的样本另做整页出现次数抽查。
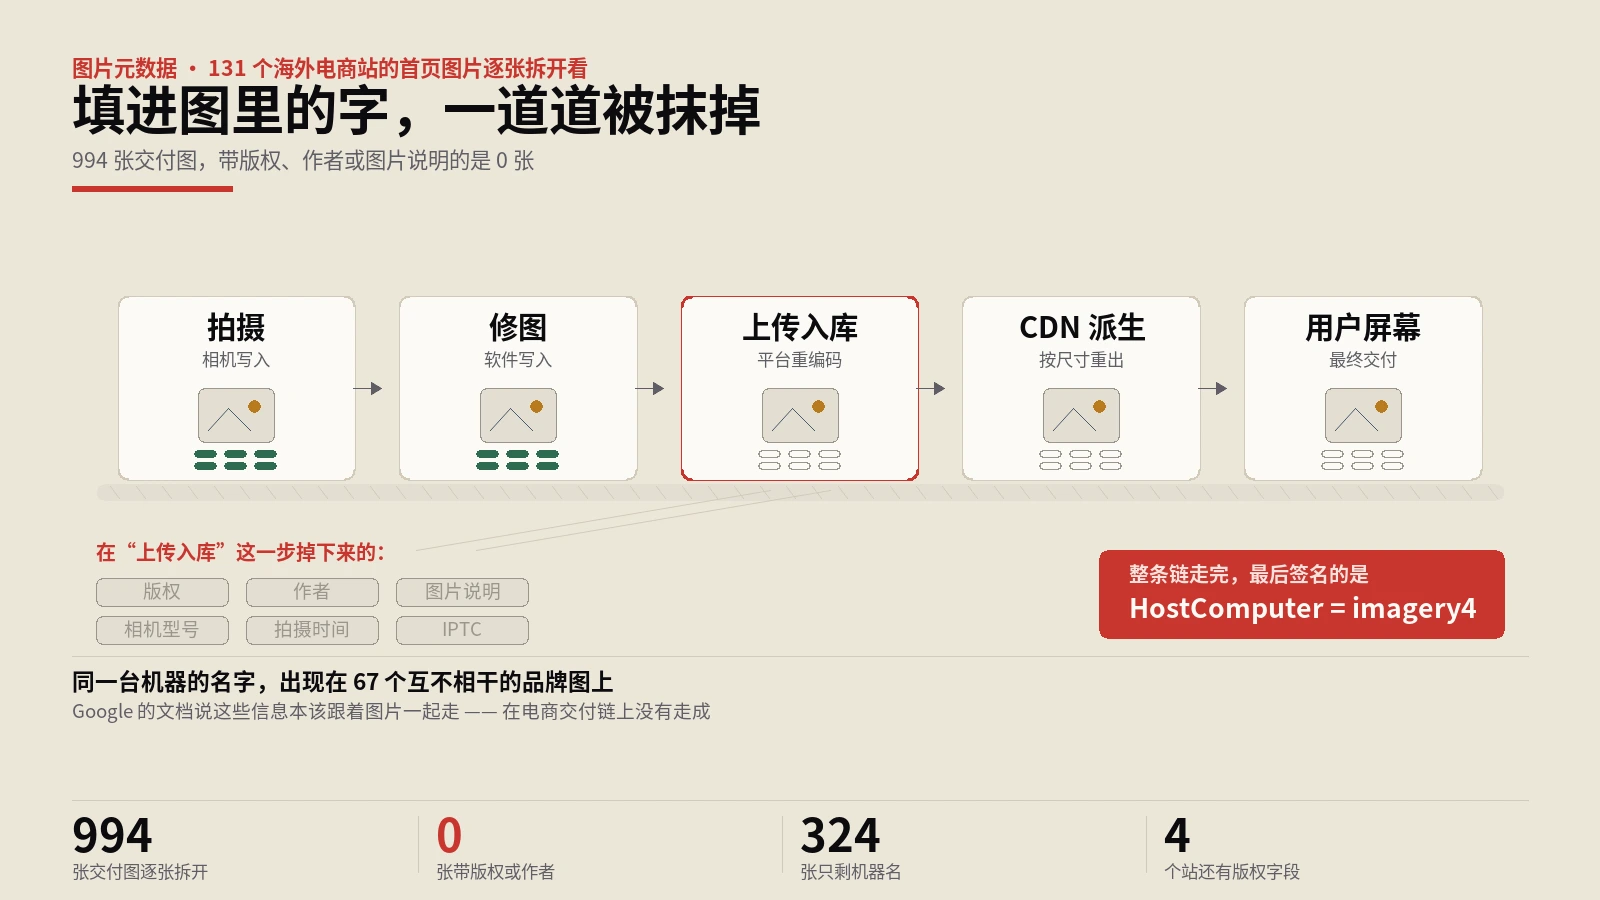
从131个海外电商站的首页取浏览器真实加载的图片,按Range只下文件头部,逐段解析JPEG的APP标记、PNG文本块与WebP的RIFF块;再把同一张图去掉CDN处理参数取一份裸地址,用177组对照区分元数据究竟是入库时清的还是交付时剥的。判据前后改了14处,方向与影响全部列出。
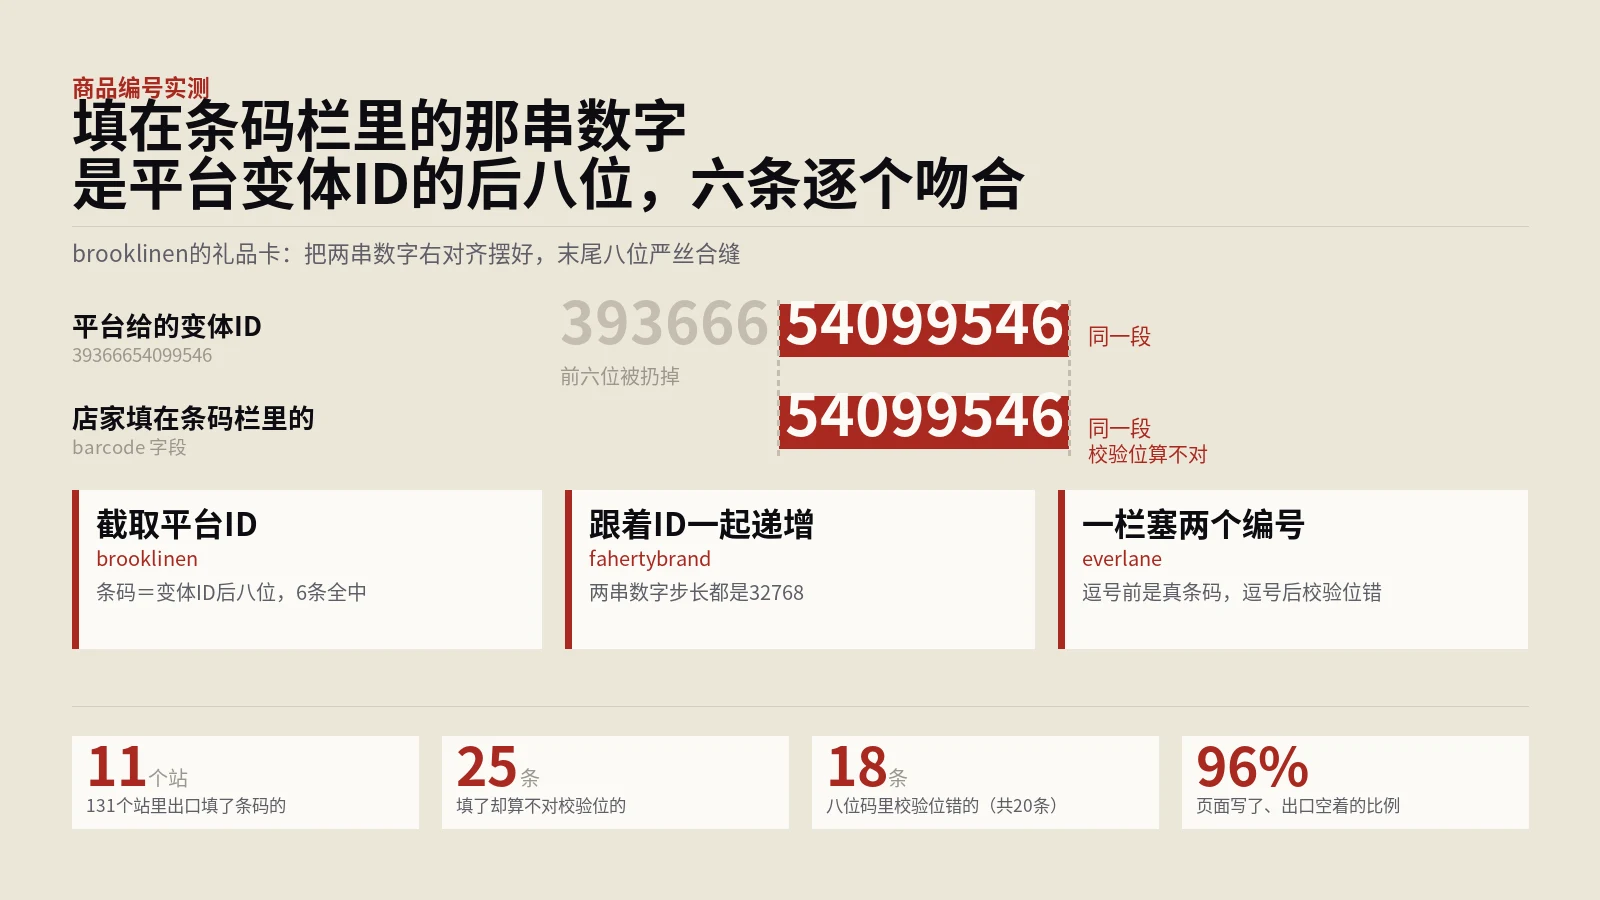
量法是把校验位这把离线尺子架到全站字段上:GTIN不论8位12位13位14位,末位都由前面各位推算,不联网也能判真伪。131个站单线程采集、间隔2秒,把页面结构化数据的每个节点和两个数据出口的每条变体记录都摘出编号,逐条算校验位,再按SKU把两侧配对,看同一件商品的条码是不是同一个。算不对的那些回原始记录里挖,看它原本是什么。
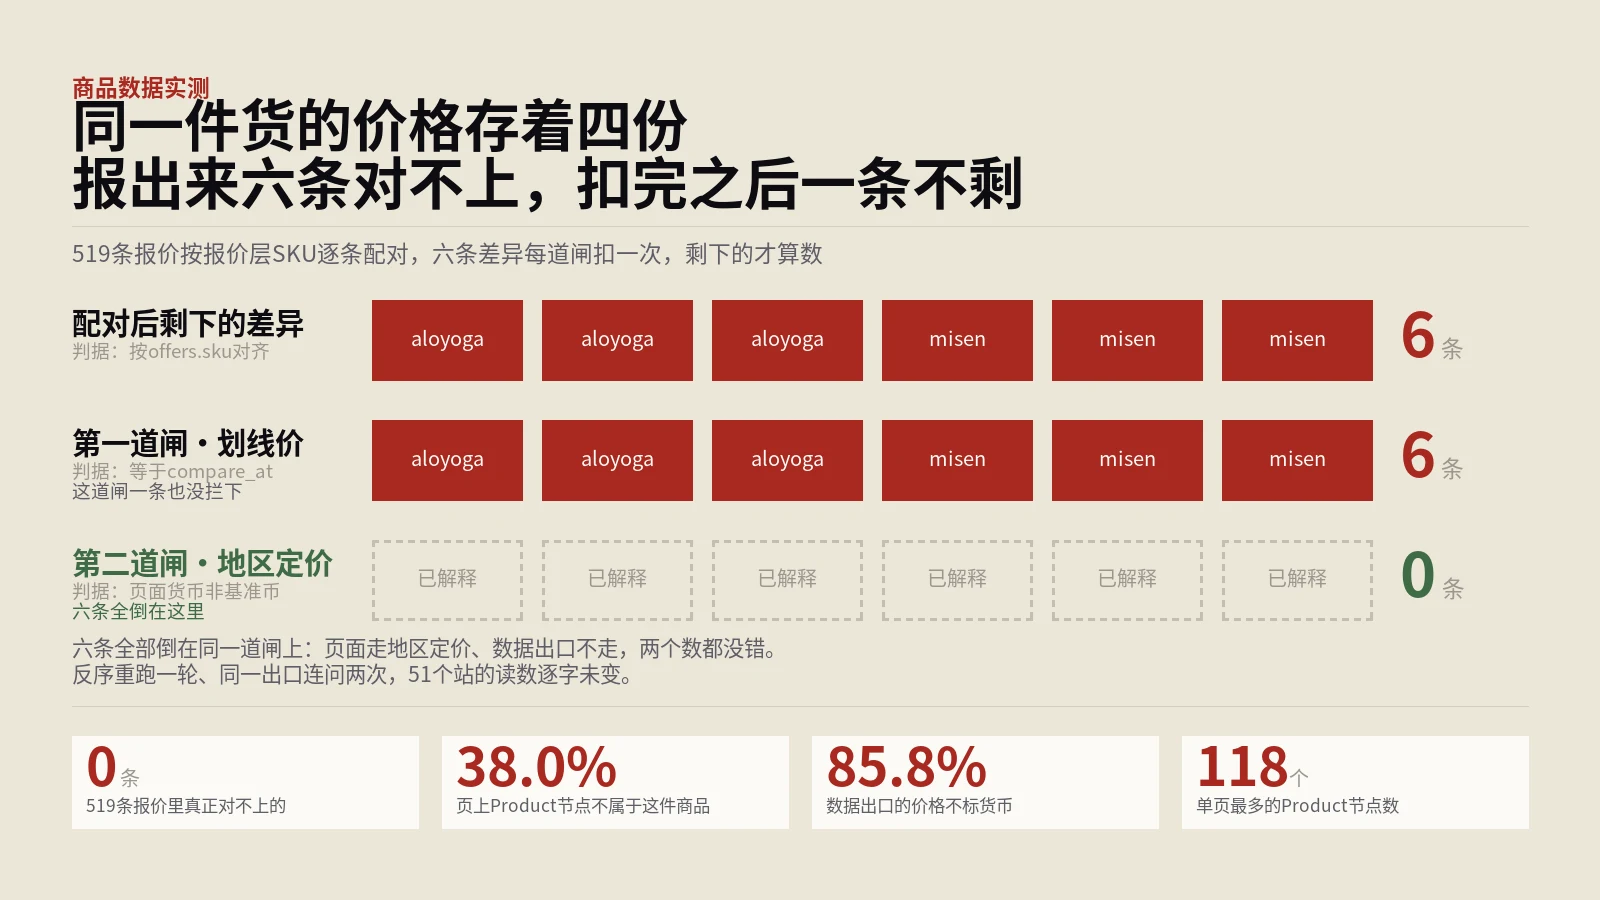
量法是把同一件商品的价格从四条独立路径各取一份:页面渲染、og标签、页面里的结构化数据、以及平台自带的两个数据出口。131个站单线程采集、间隔2秒,第二轮把请求顺序整个反过来重跑,并让同一个出口连问两次做自基线。配对不按节点出现的顺序,按报价层的SKU逐条对齐,再依次扣除划线价、地区定价、商品层与报价层编号错位这三类假阳性,剩下的才算数。
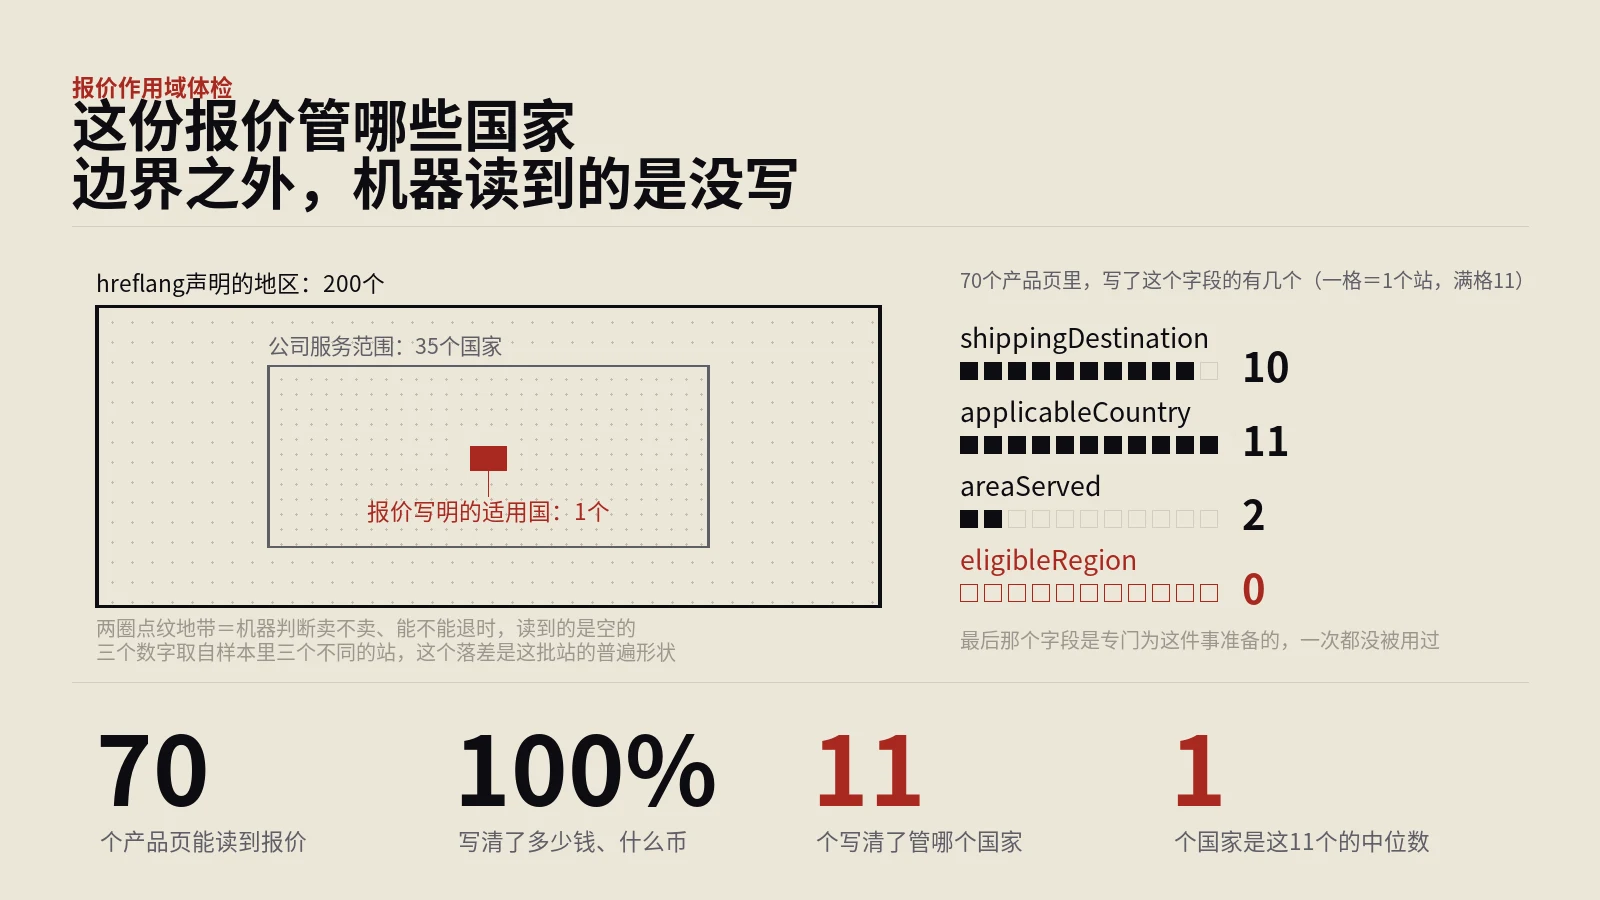
做法是从每个站的robots.txt找到sitemap入口,挑出商品那一份取一条网址抓回来,把结构化数据整段拍平后逐字段核地域信息,再拿hreflang里的多条地区网址交叉验证。尺子在这里坏过一次:第一版把欧元区多国共用一种货币的样本判成了地址不生效,9个站的结论修完只剩3个,而错的那一版恰好指向更有故事的那一边。
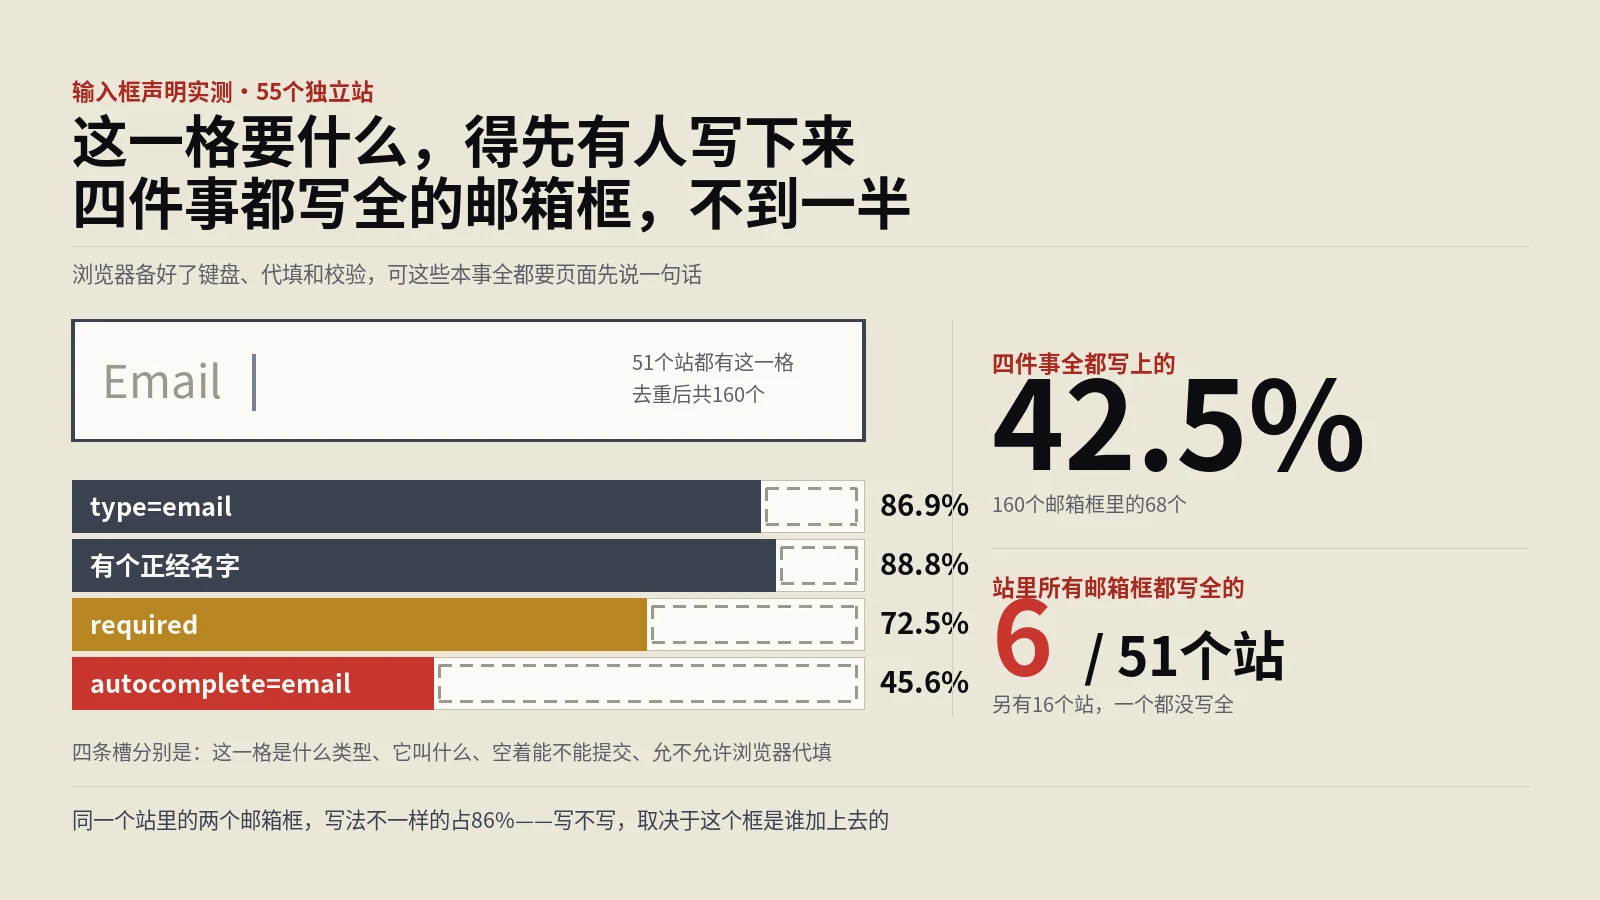
做法是用真实浏览器逐页打开55个英文独立站的首页、商品页,再从首页现场找出联系页与账号页,把每个页面上的input、select、textarea连同type、autocomplete、required、pattern、maxlength、inputmode与名字来源一并取下来。同一个站里声明完全相同的控件按签名合并,避免主题挂在每一页的抽屉表单被重复计数;从没可见过又没有任何说明文字的字段单独剔出,因为那多半是跟踪像素注入的参数框。另…
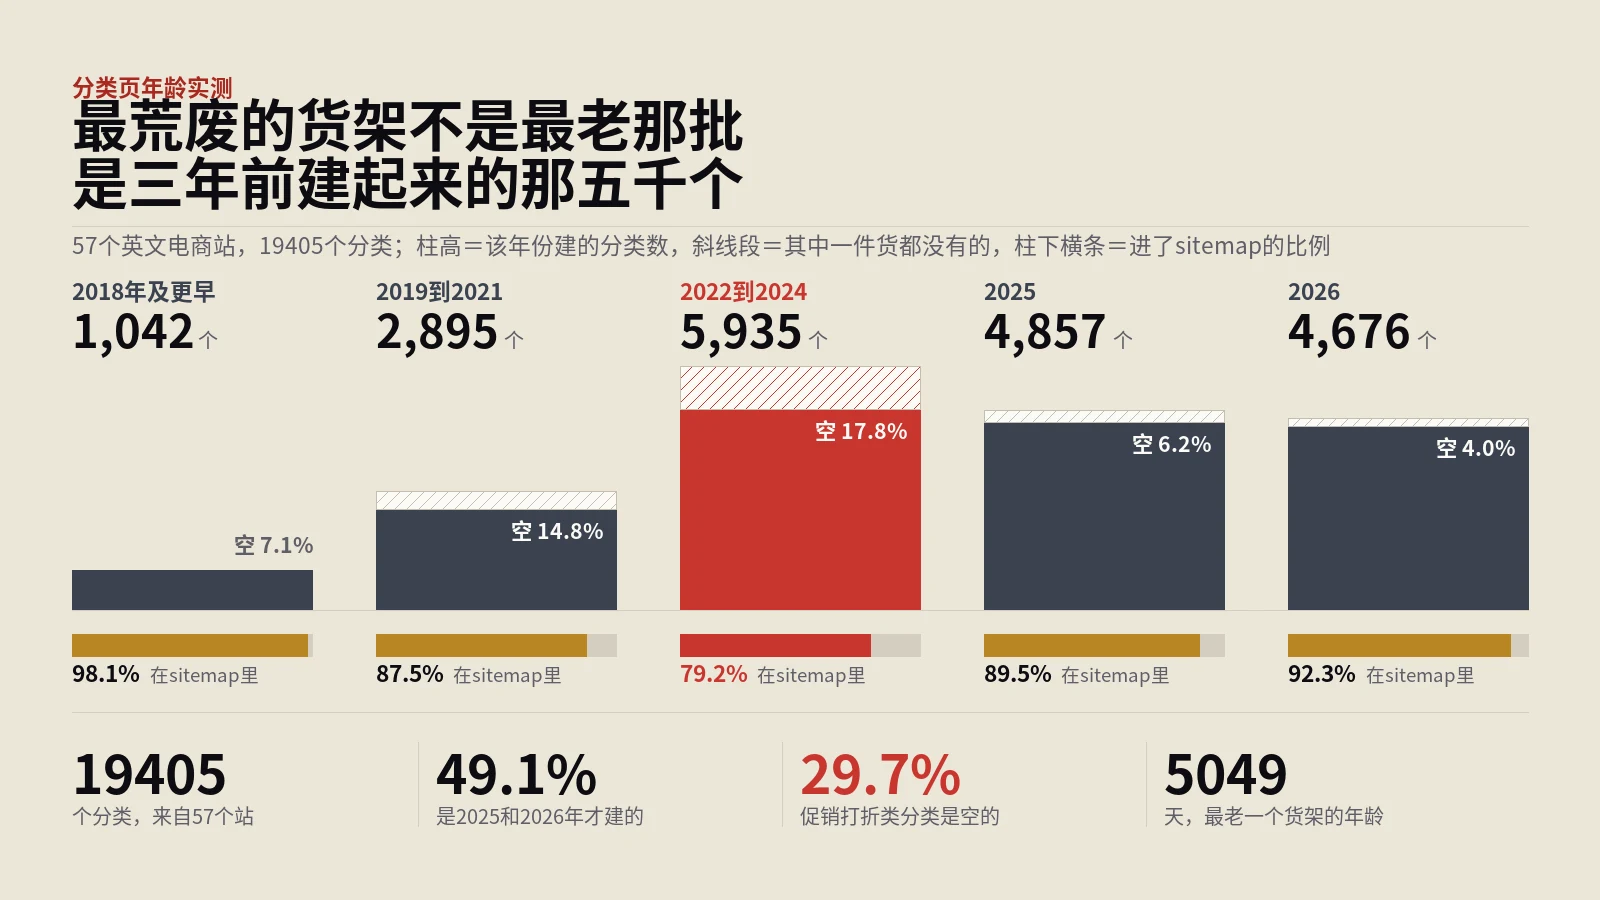
把57个英文电商站的19405个分类按建立年份切成五个桶,逐桶交叉商品数、描述长度、题图、sitemap收录与首页导航覆盖这五项指标;再用一组正则按handle的命名把它们分成促销、节日、赠品、联名等类别,跟空置率交叉;接着把分类的年龄与它里面商品的货龄配对,看货架和货哪一头更旧;最后用真实浏览器逐个打开每站最老与最新的分类页,核对状态码、最终地址与robots标记,并把不可靠的读数逐条剔出去。
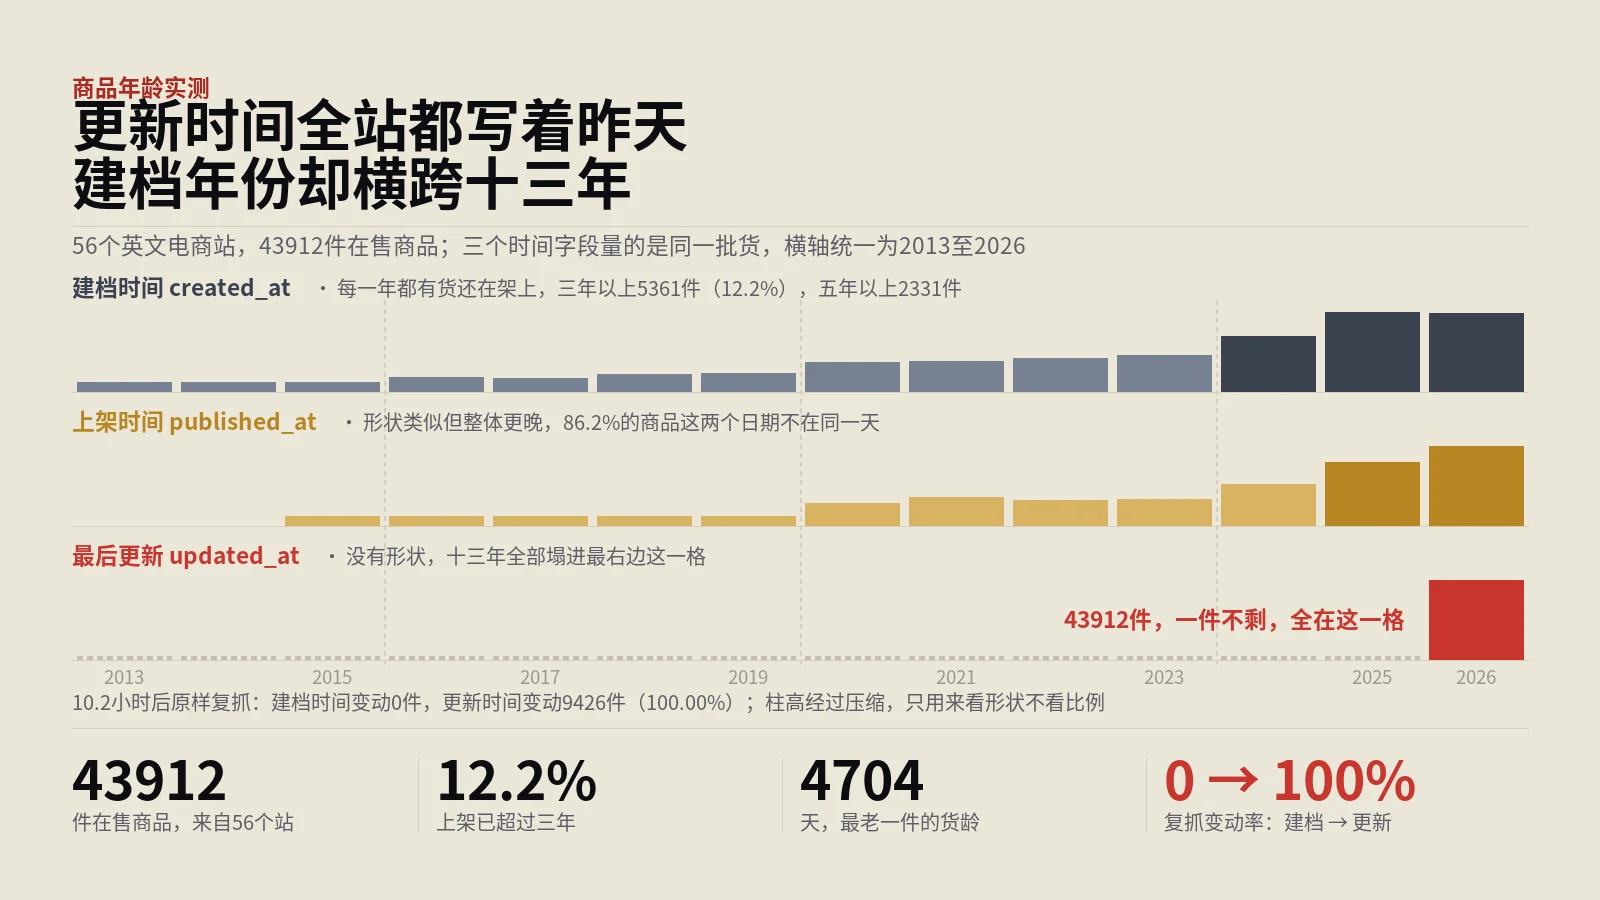
实验台从60个英文电商站的公开商品清单接口取回43912件在售商品与19405个分类的全部时间字段,再隔10.2小时把同一批站原样复抓一遍做纵向对照,用同一次测量里的另外两个字段当基线,判断哪一个字段真的记录了内容变动。随后按建档年份把商品分桶,逐站配对比较老货与新货在sitemap收录、首页两跳可达、前台是否仍在售三个维度上的差别,最后用真实浏览器逐个核对可疑读数,扣掉地区路由与渲染异常的站点。
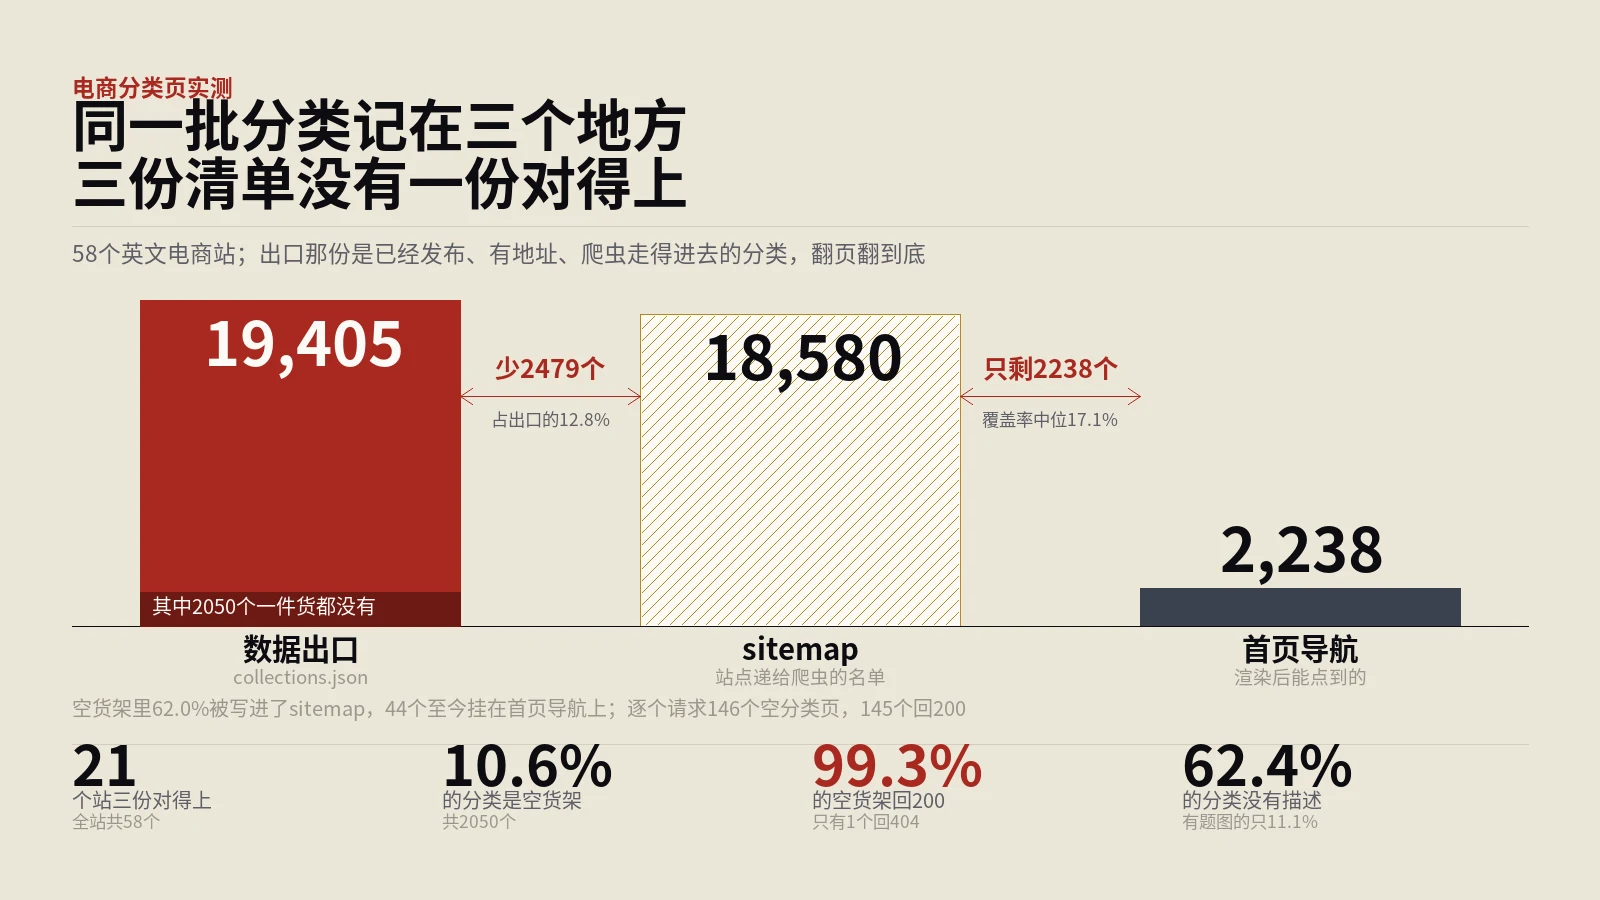
做法是把同一批分类从三条独立路径各取一份清单:不用登录就能读的分类出口、站点递给爬虫的sitemap、以及首页渲染后DOM里能点到的链接。sitemap那一份要按语言分卷拆开只取根语言,否则翻译过的handle会被算成另一批;导航那一份不能只抓静态HTML,得用无头浏览器渲染后取并集。空货架的判定不数页面上的商品链接,改用商品清单接口加浏览器里正文区可见的商品卡两条一起看。
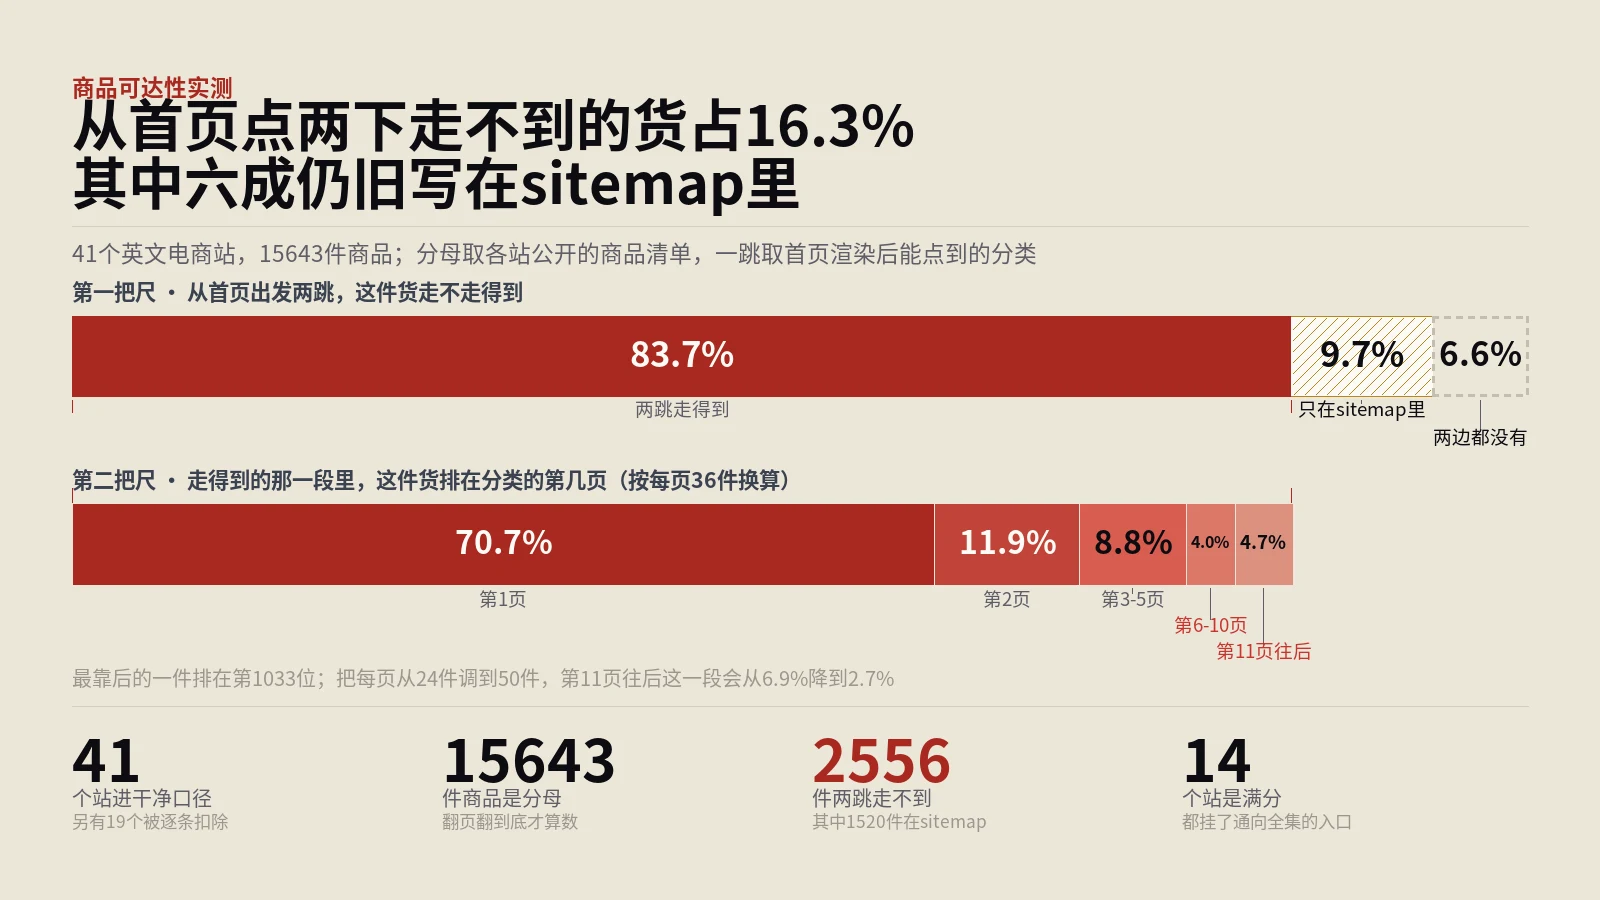
实验台分三层搭:分母取各站公开的商品清单接口并翻页到底,第一跳取首页渲染后DOM里的分类链接(只用静态HTML会漏,gymshark从0变92),第二跳取这些分类各自的商品清单。名次按商品在各分类里的最好位置计,再按每页24、36、50三档分别换算页码,不预设某个站用了哪一档。逐条扣掉地区路由、变体级伪商品、语言分卷重复、翻页截断、导航不走collections路径这五类干扰,60个候选站最后41个进干净口径。
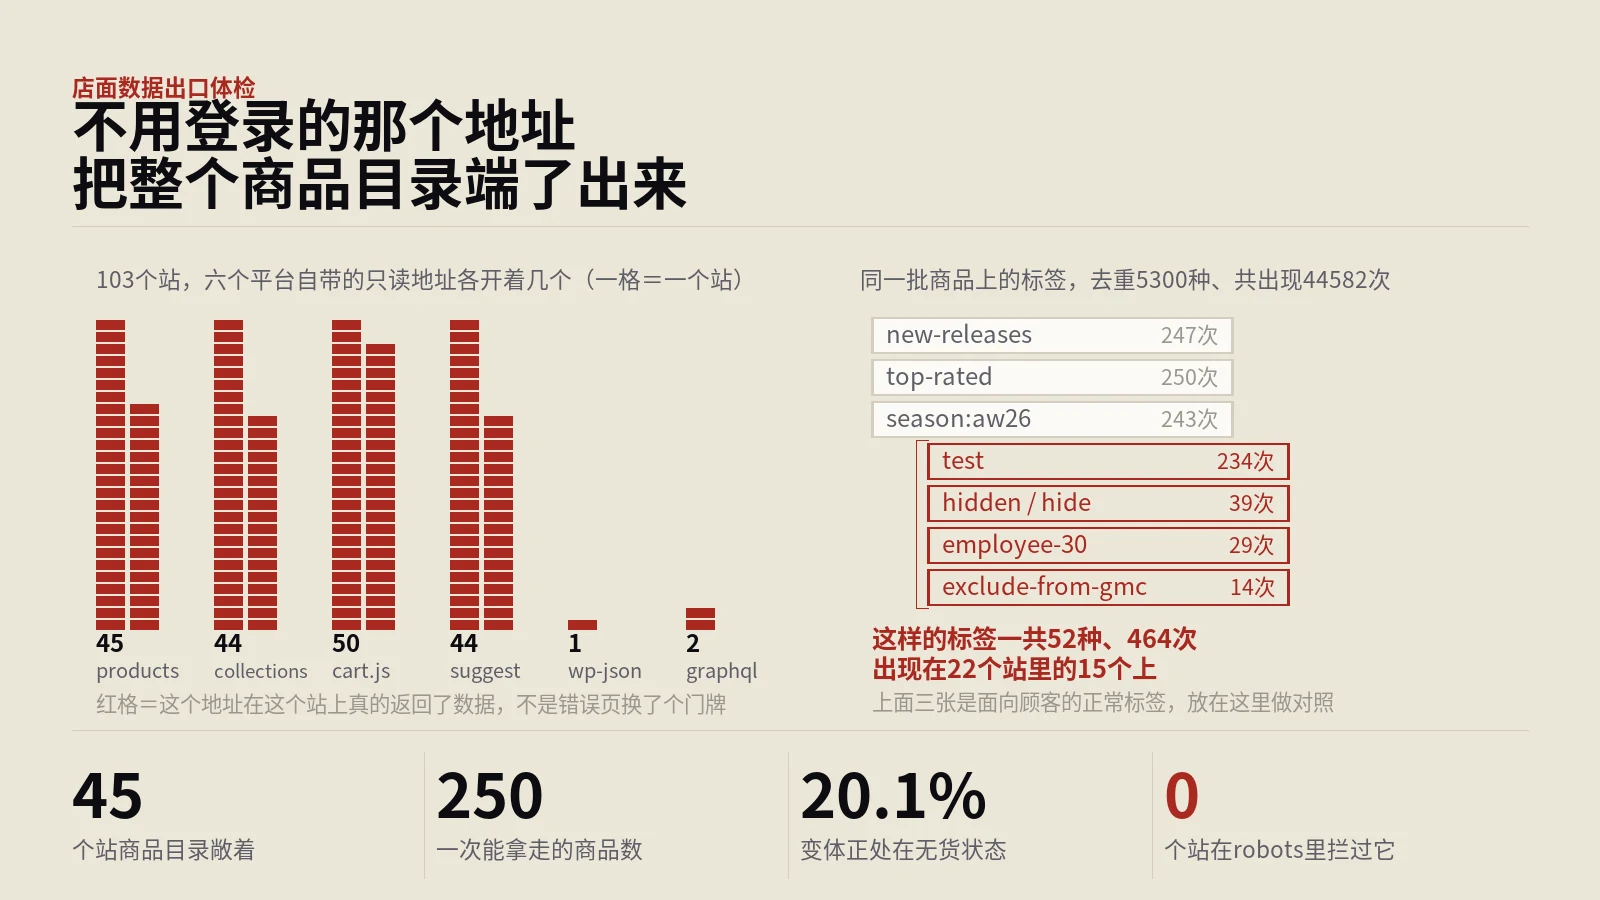
判定要过三道关:站要能进、这个站对不存在的地址得会说没有、响应得真解析成带商品数组的结构。光看状态码会把13例假阳性算进来,把45虚报成58。第二轮还栽了一次,有个时间字段对所有商品都给同一个答案。
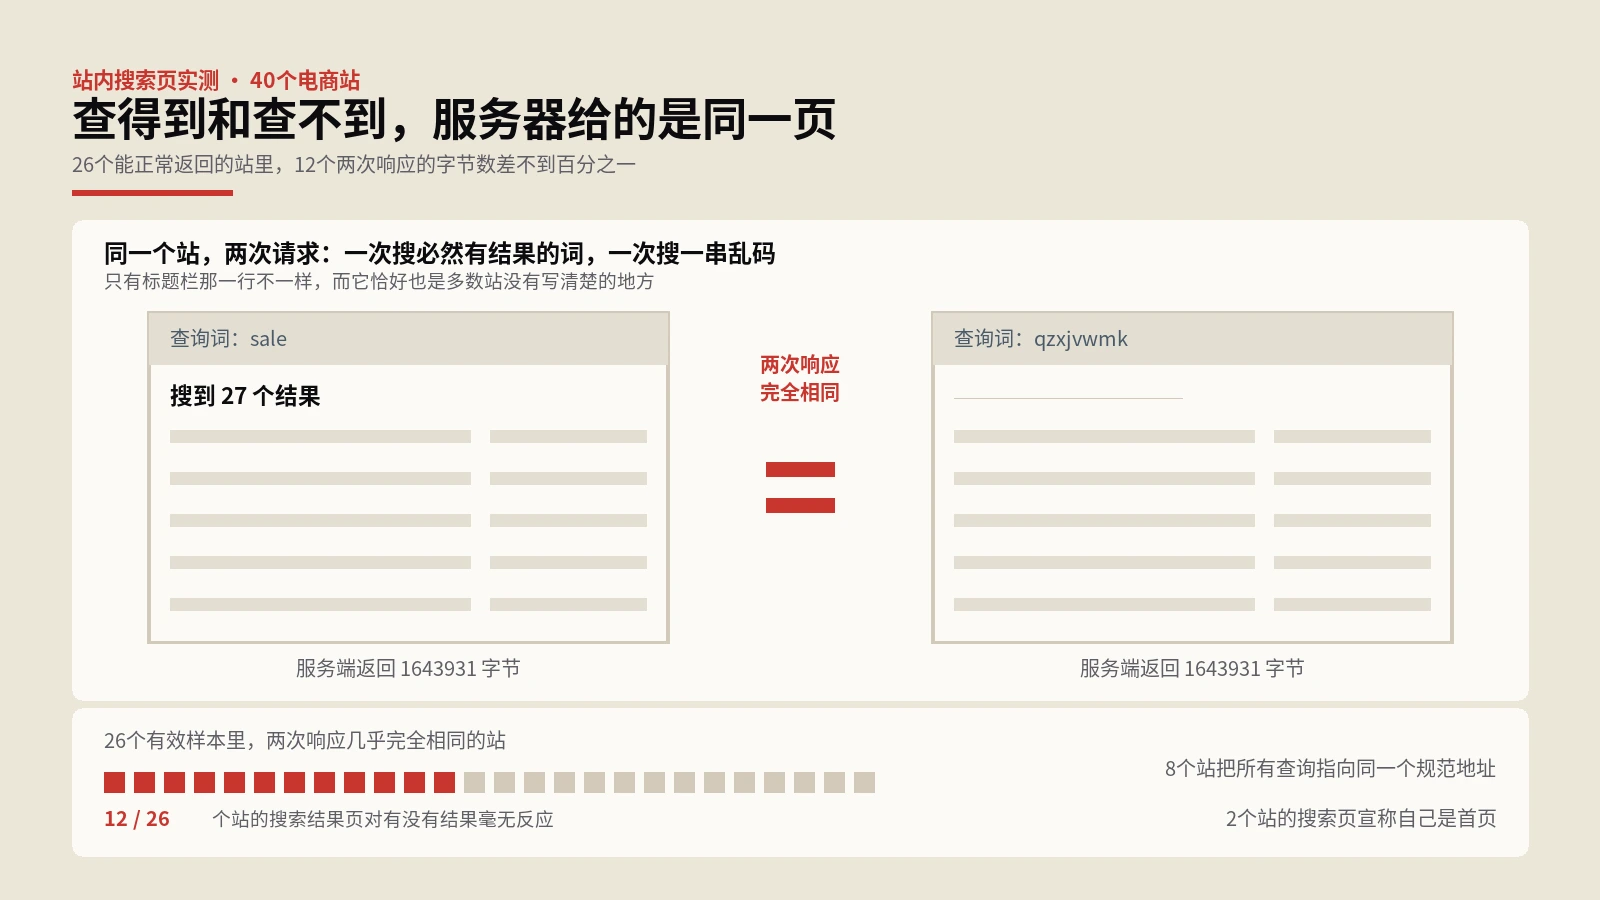
判断顺序建议改一改:先拿候选词的词集跟自己的站点地图比一遍,命中就说明这一页可能已经有了;没命中再去比搜索结果、建大纲、看结构位置。文中把这套顺序在87个电商站21.9万个网址上跑了一遍,给出重复的四种形态与各自的处理方式、合并时的五道检查,以及一份十步的照抄清单。

这一页在多数公司里没有主人:不属于内容团队,不属于设计团队,也不出现在任何一份优化清单上。可它正在接住一批意图最明确的访客。本文给出三十秒判断自己属于哪一类的方法,四个按性价比排序的改动,以及一个团队用四天半跑完这套改造的完整账。
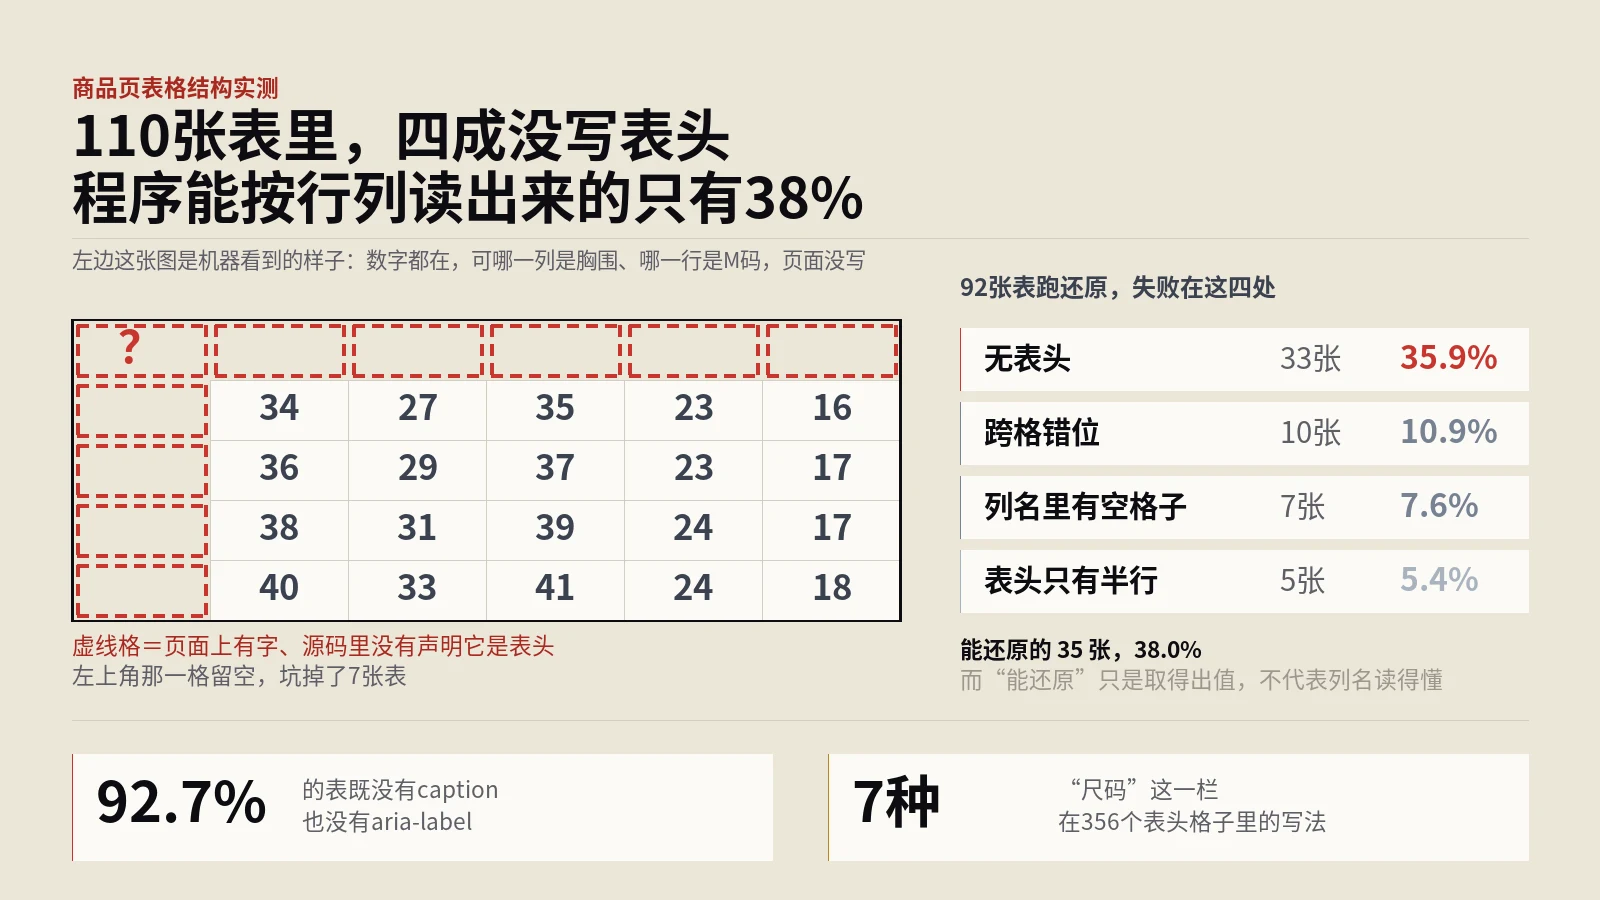
做法是把每张表最多20行12列的单元格连同标签类型一起原样取下来,再写一段还原程序按四条判据逐张试:首行是不是全部为表头单元格、有没有跨行跨列、各行格子数是否一致、列名是不是既非空也非纯数字,任何一条不满足就归进对应的失败类型。单位不从采集端的正则读,改成从表格矩阵离线重算,因为括号写法那种形式会被常规正则整批漏掉。格子总数不超过两个的空壳表单独摘出,不进还原成功率的分母。
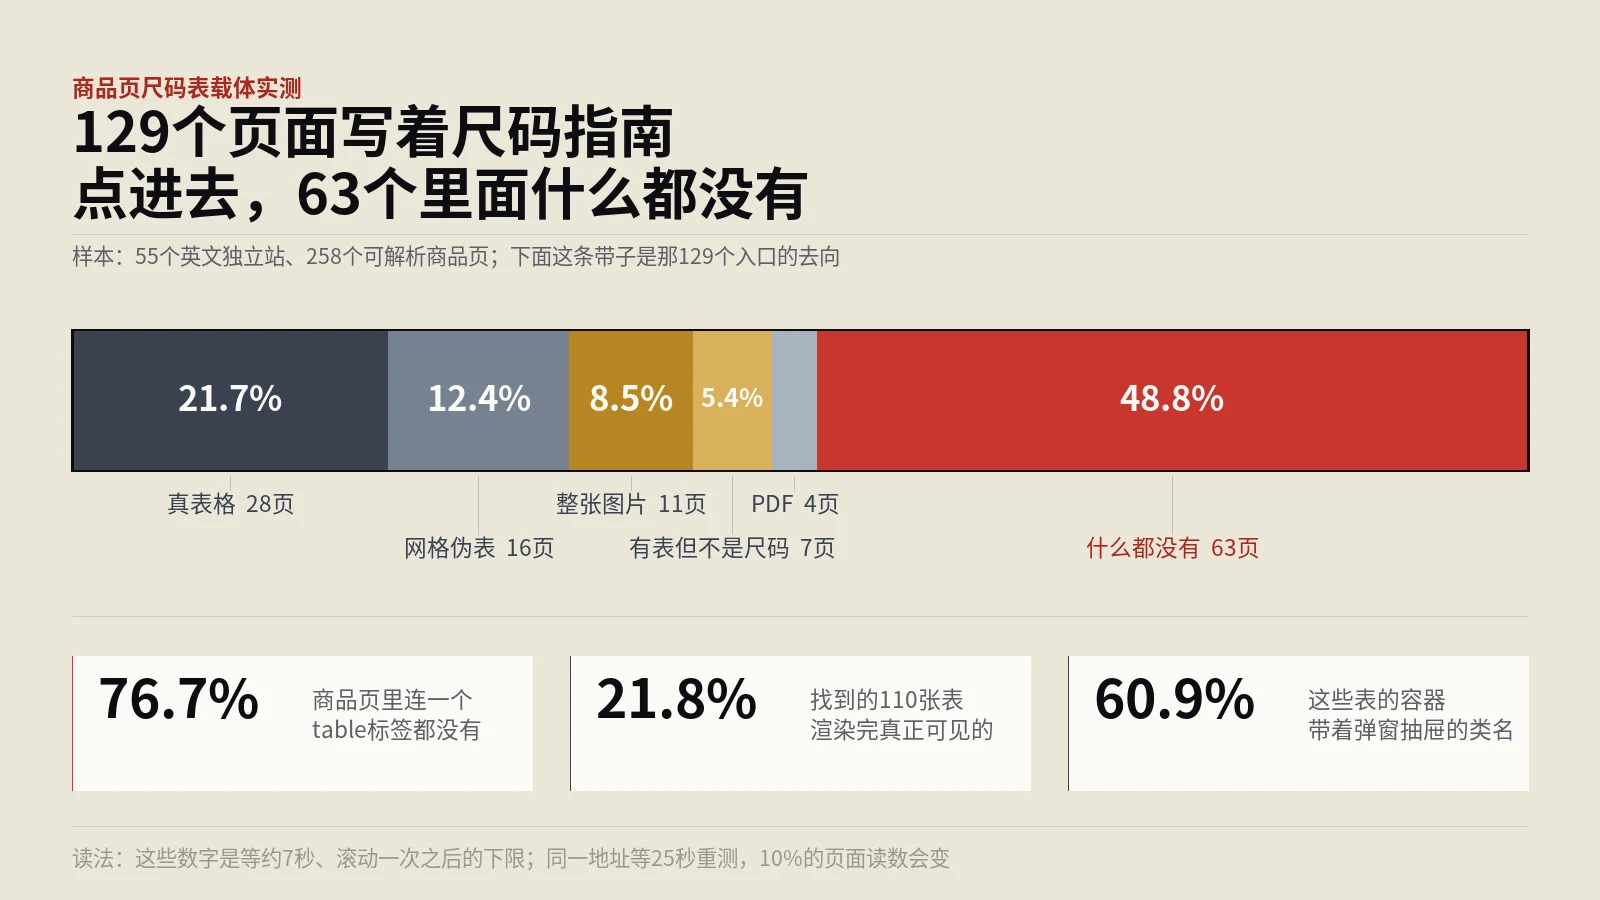
实验台用真实浏览器逐页打开55个英文独立站的商品页,等渲染完成并滚动一次之后,同时清点五类可能承载尺码信息的东西:真表格、计算样式为网格的伪表、老式CSS表格布局、整张图片形态的对照表,以及定义列表;再单独记录页面上有没有尺码指南这类入口,把入口与内容逐页对上。为了区分“页面没写”和“我没等到”,另挑三十个站做了两组对照:同一个地址等5秒与再等20秒各量一次,以及替用户点开尺码指南之后再量一次。限流与失效的页面逐条记录,没有拿去凑分母。
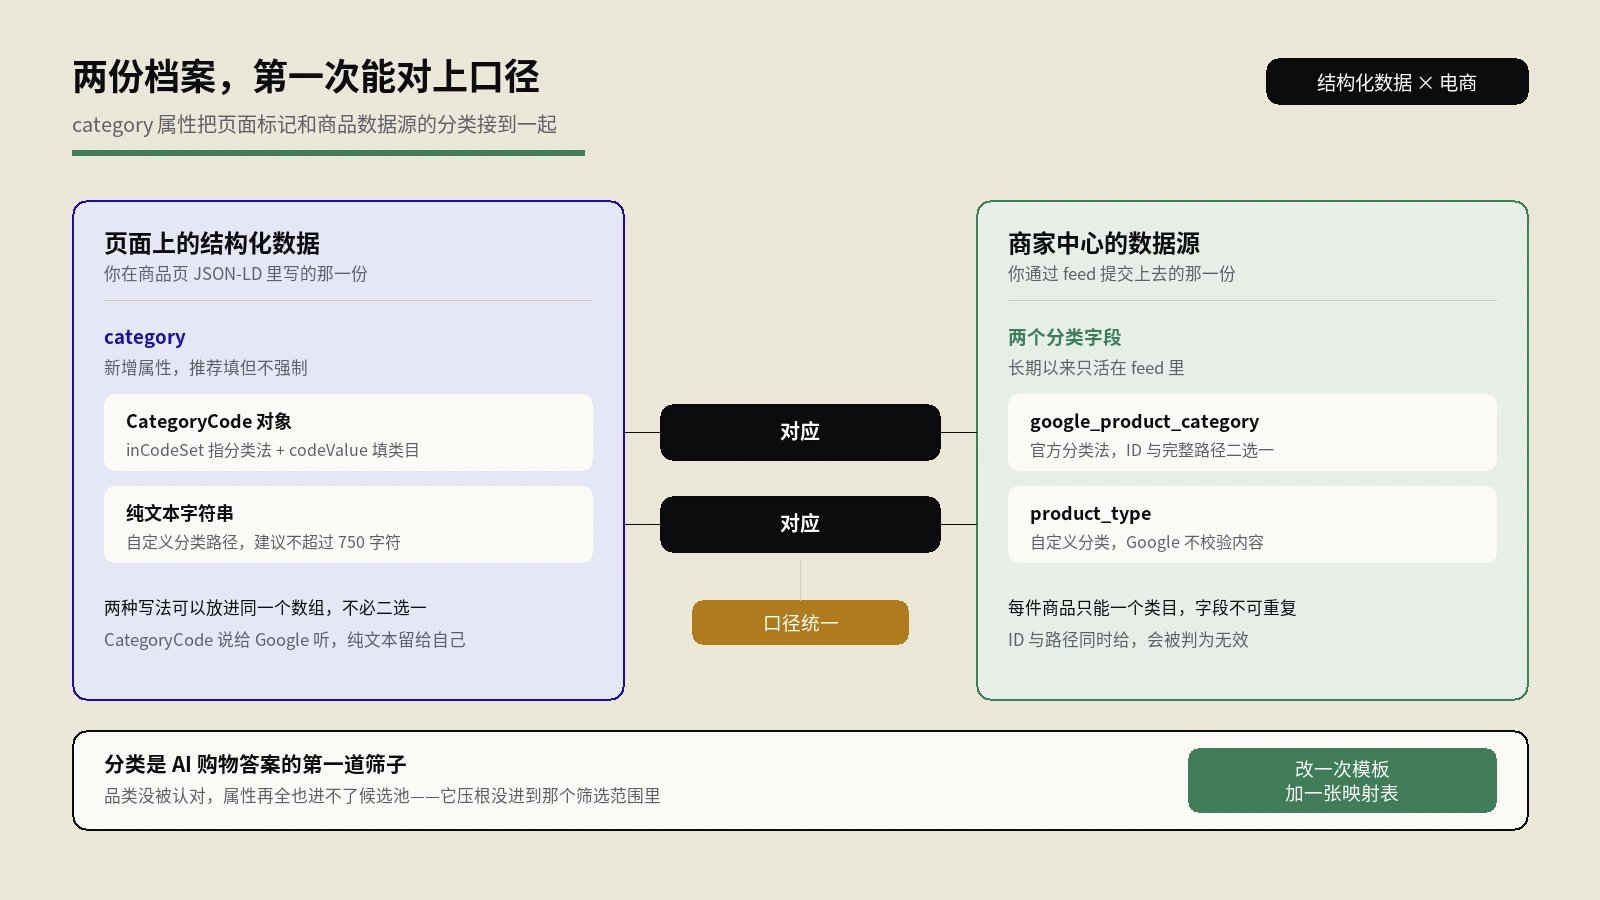
Google在2026年7月给商家信息结构化数据新增了category属性,可写成纯文本对应product_type,也可写成CategoryCode对象承载官方商品分类法。本文拆清两种写法怎么选、ID与完整路径为何不能同时提交、什么情况下才该覆盖自动归类,以及三大建站平台各自的落地路径。
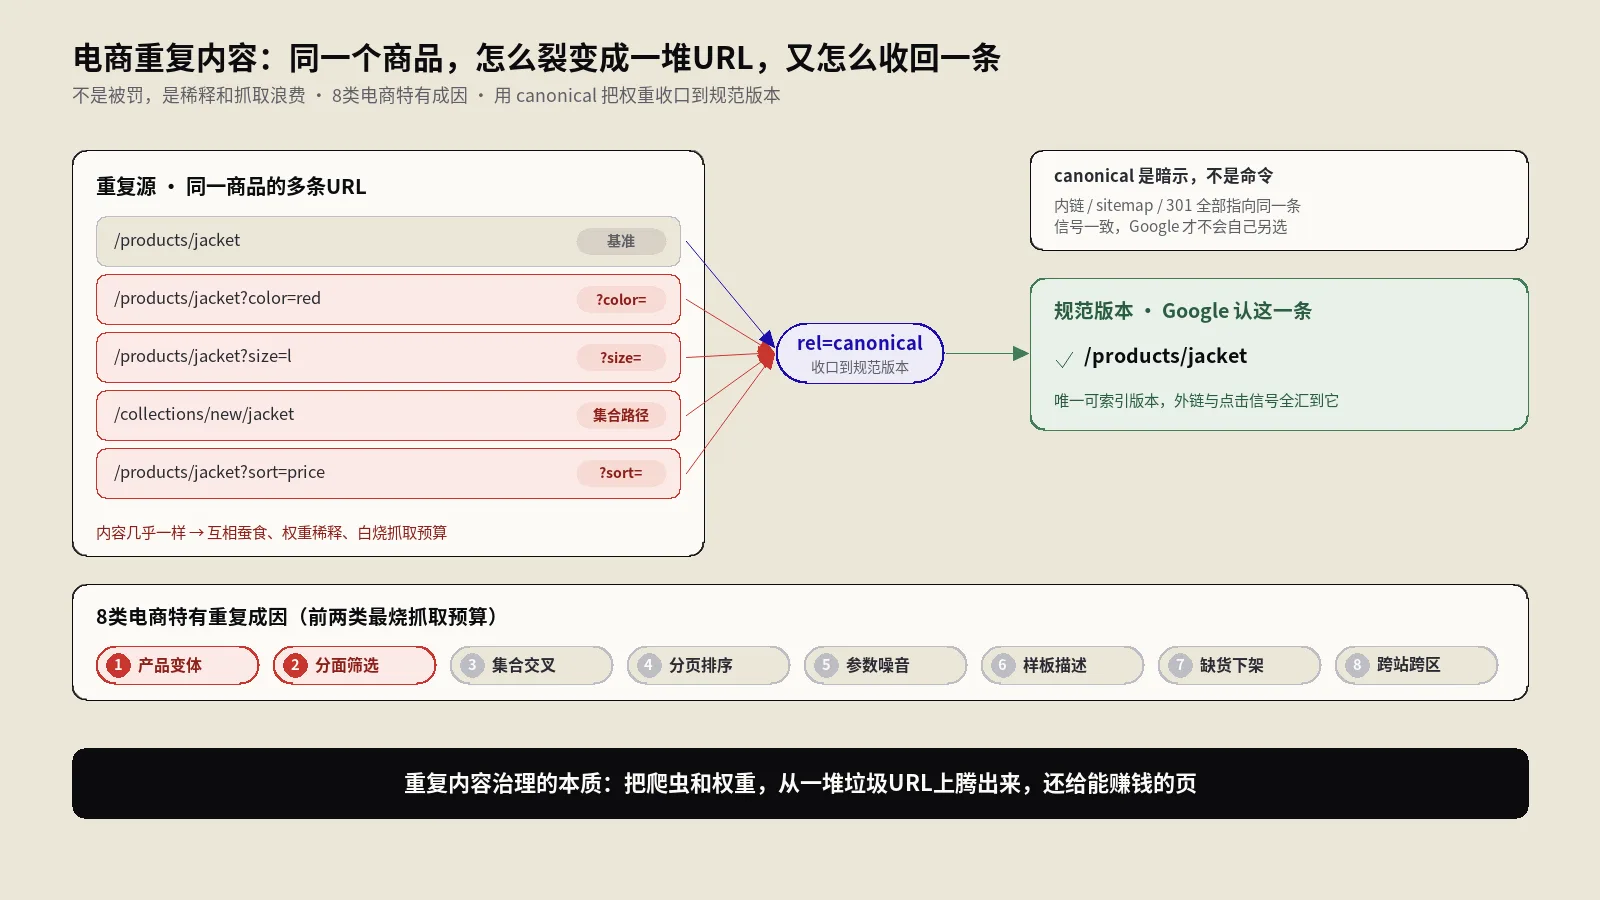
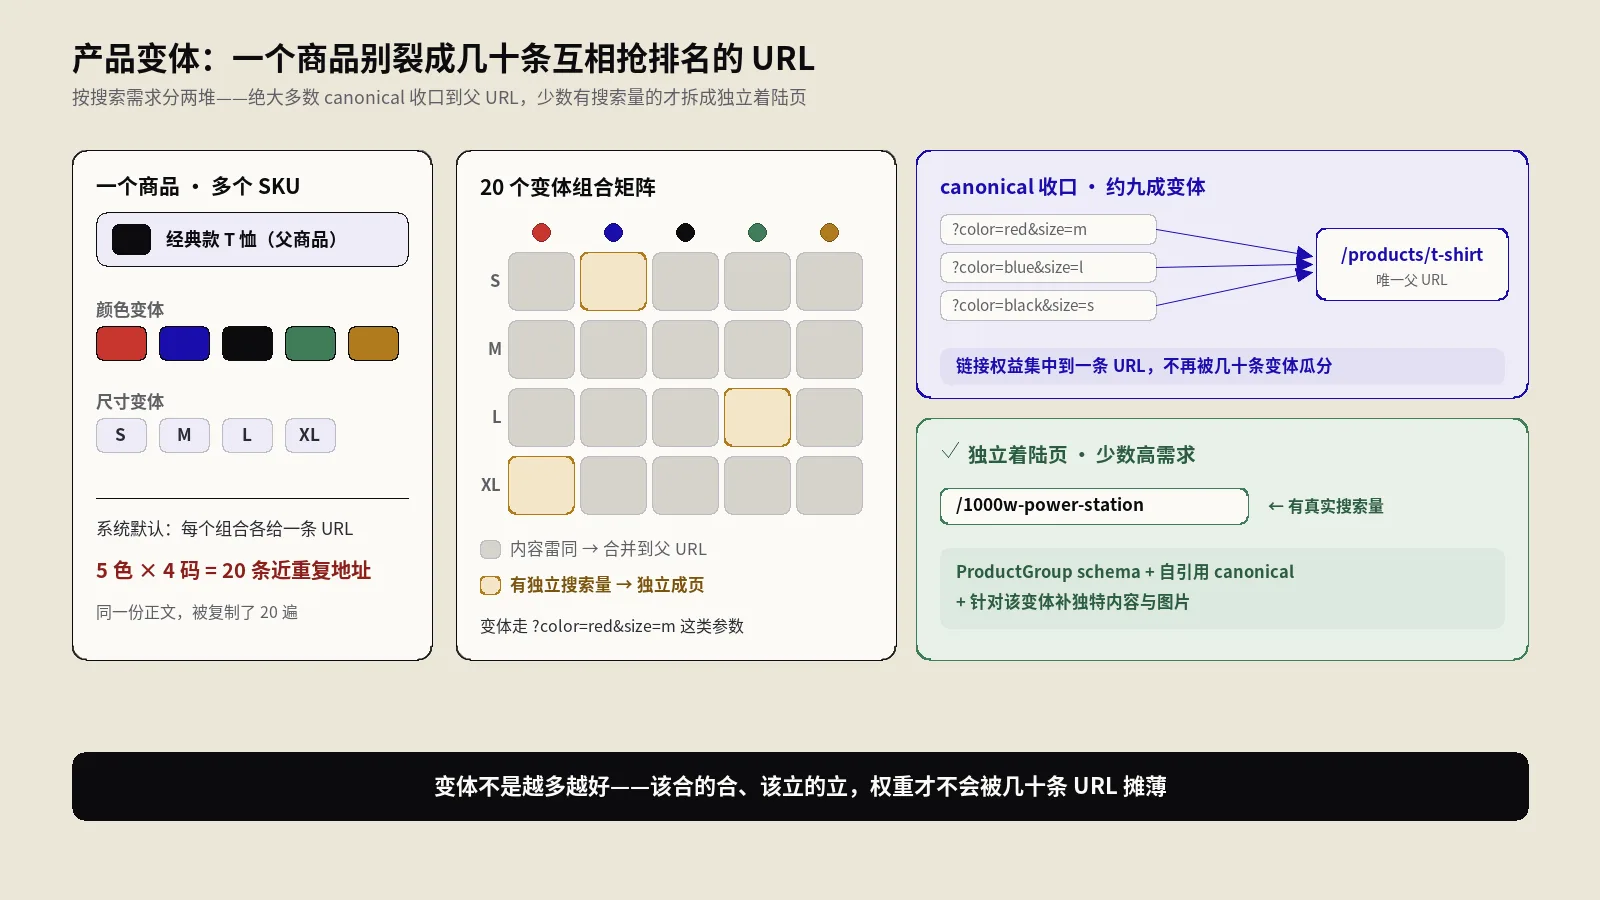
同一件商品的颜色、尺码、容量变体,常被电商系统拆成几十条近重复URL,互相稀释权重、吃抓取预算。本文讲清按搜索需求把变体分两堆:多数用canonical收口父URL,少数有搜索量的才独立成页,附ProductGroup结构化数据与三大平台落地。
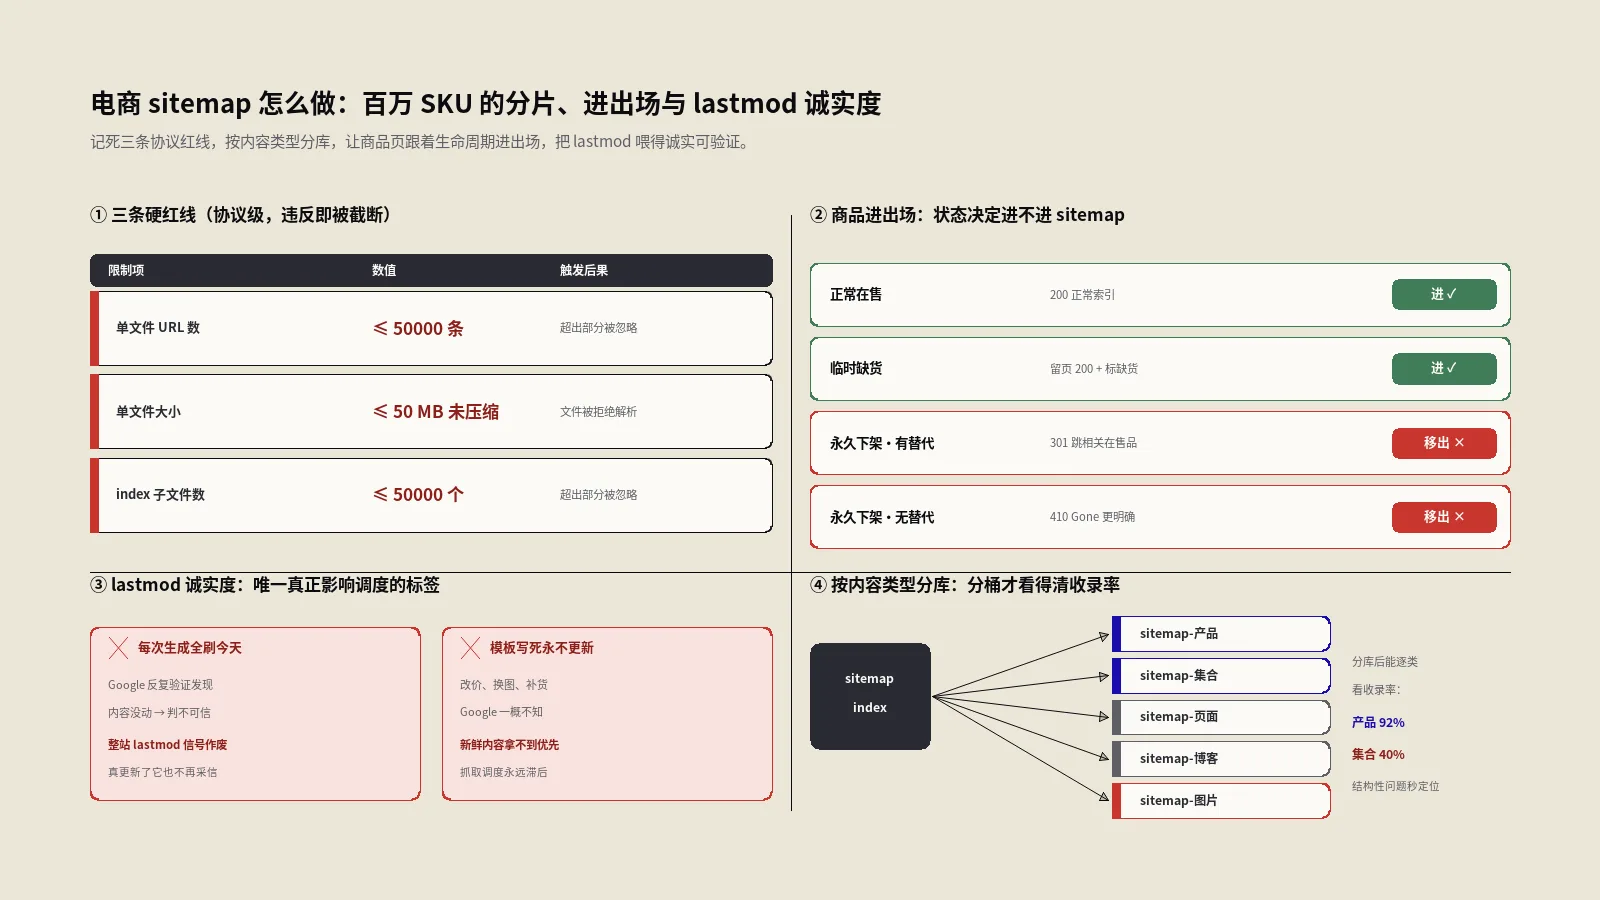
几十万SKU的电商站,sitemap是一座随时塌方重建的城市地图。本文按工程拆解:50000URL三条红线、按内容类型分库、产品页上下架进出场、变体进不进、lastmod诚实度、图片sitemap这条购物通道,最后给一份能直接照着跑的体检清单。
电商站几乎天生重复内容成灾,但根子不是被Google罚,而是权重稀释和抓取浪费。本文把产品变体、分面、集合页、分页、参数、样板描述、缺货、跨站这8类电商特有成因画成地图,每类给诊断与治理手法,再配四步诊断工具箱和合并拆分拦截决策树。