AI可见度看板怎么搭:Semrush提示词数据对上Search Console页面,再用Claude做成周报看板
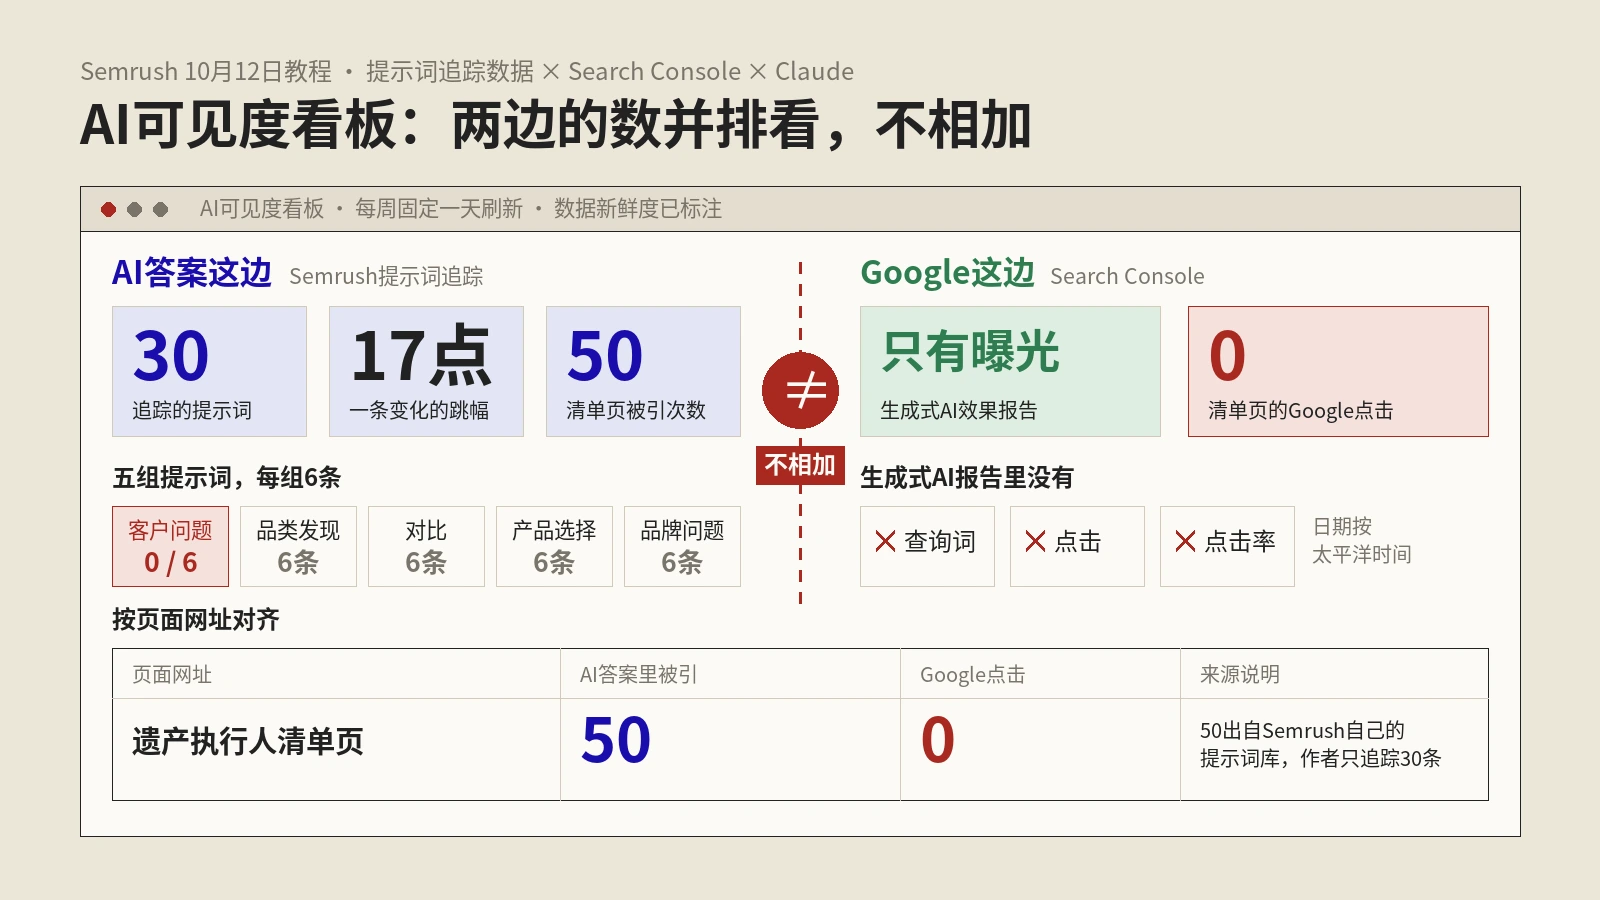
以Semrush 10月12日的教程为主体,对照Search Console生成式AI报告帮助页、Semrush知识库和Claude帮助中心,讲清提示词怎么分组和定数量、两边各导出哪些数据、七个分页的主表结构、网址统一和快照日期,以及Claude连接器看板的套餐、分享限制和每周更新流程。
标签
保哥笔记 AI可见度 标签下共 30 篇文章合集,含《AI可见度看板怎么搭:Semrush提示词数据对上S》《AI搜索引用能被普通发帖带偏:复旦论文发了个虚构概念》《用OpenAI API监测ChatGPT引用准不准?》等,与 GEO、结构化数据、AI搜索优化 主题密切相关,覆盖 SEO/GEO 实战角度的深度解析与可落地方案。
以Semrush 10月12日的教程为主体,对照Search Console生成式AI报告帮助页、Semrush知识库和Claude帮助中心,讲清提示词怎么分组和定数量、两边各导出哪些数据、七个分页的主表结构、网址统一和快照日期,以及Claude连接器看板的套餐、分享限制和每周更新流程。
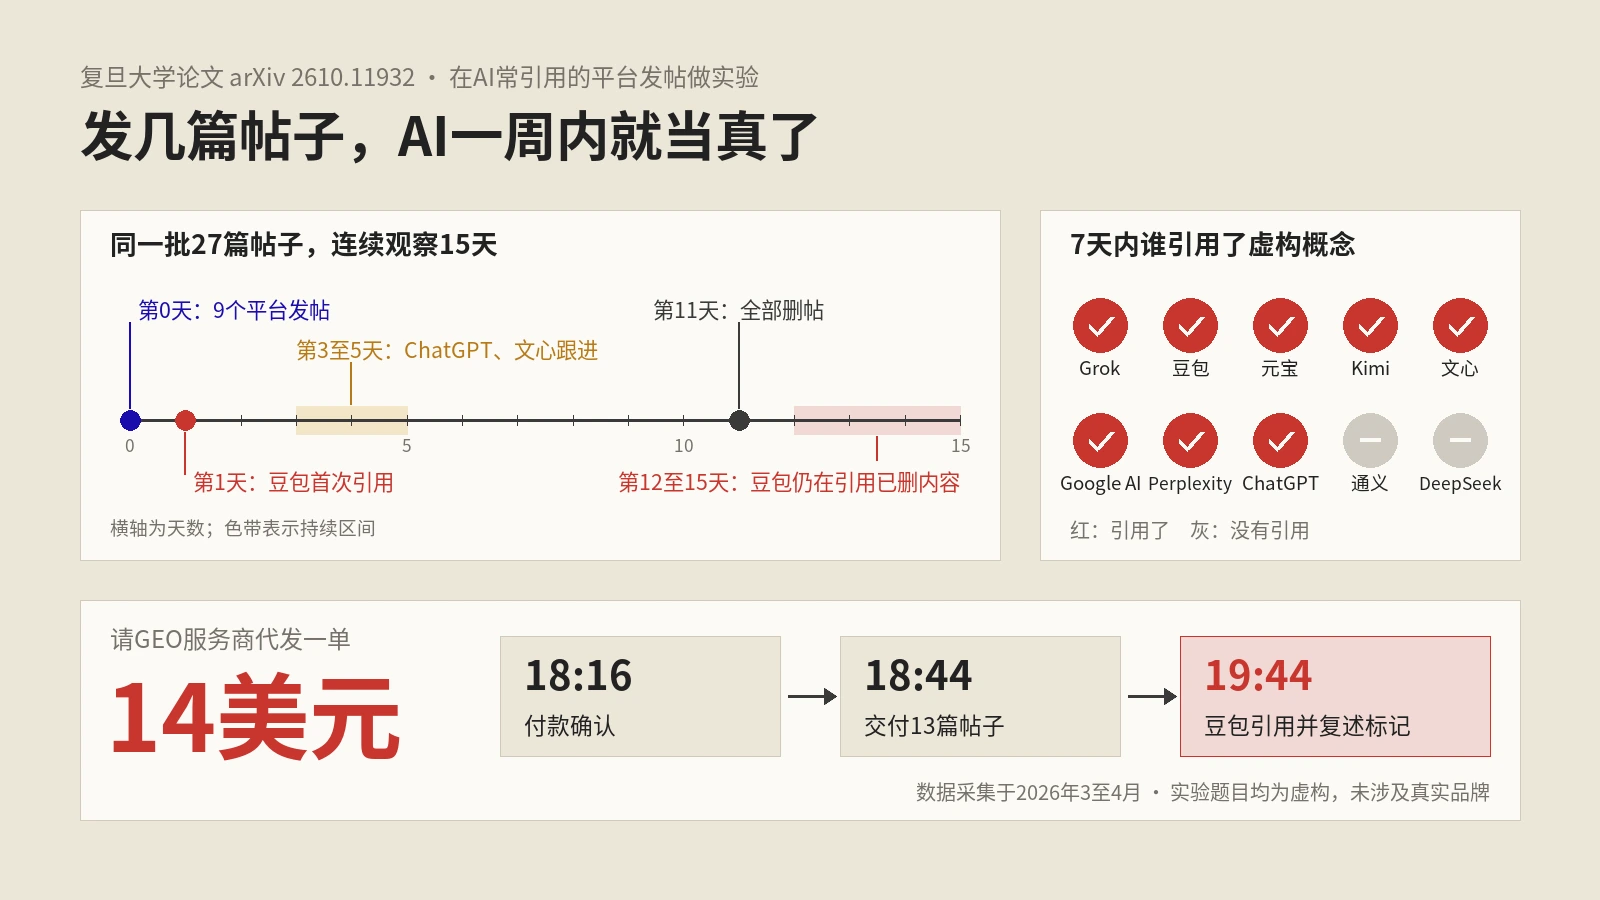
以SEJ 10月19日报道为主体,对照复旦论文原文,讲清楚研究者怎样挑出AI最常引用又最好发帖的平台,在9个平台发帖后10个AI平台的引用与复述比例,豆包文心等中文平台偏爱自家来源,发帖位置、数量和删帖对引用的影响,14美元GEO代发的时间线,以及品牌方的监测与防范做法。
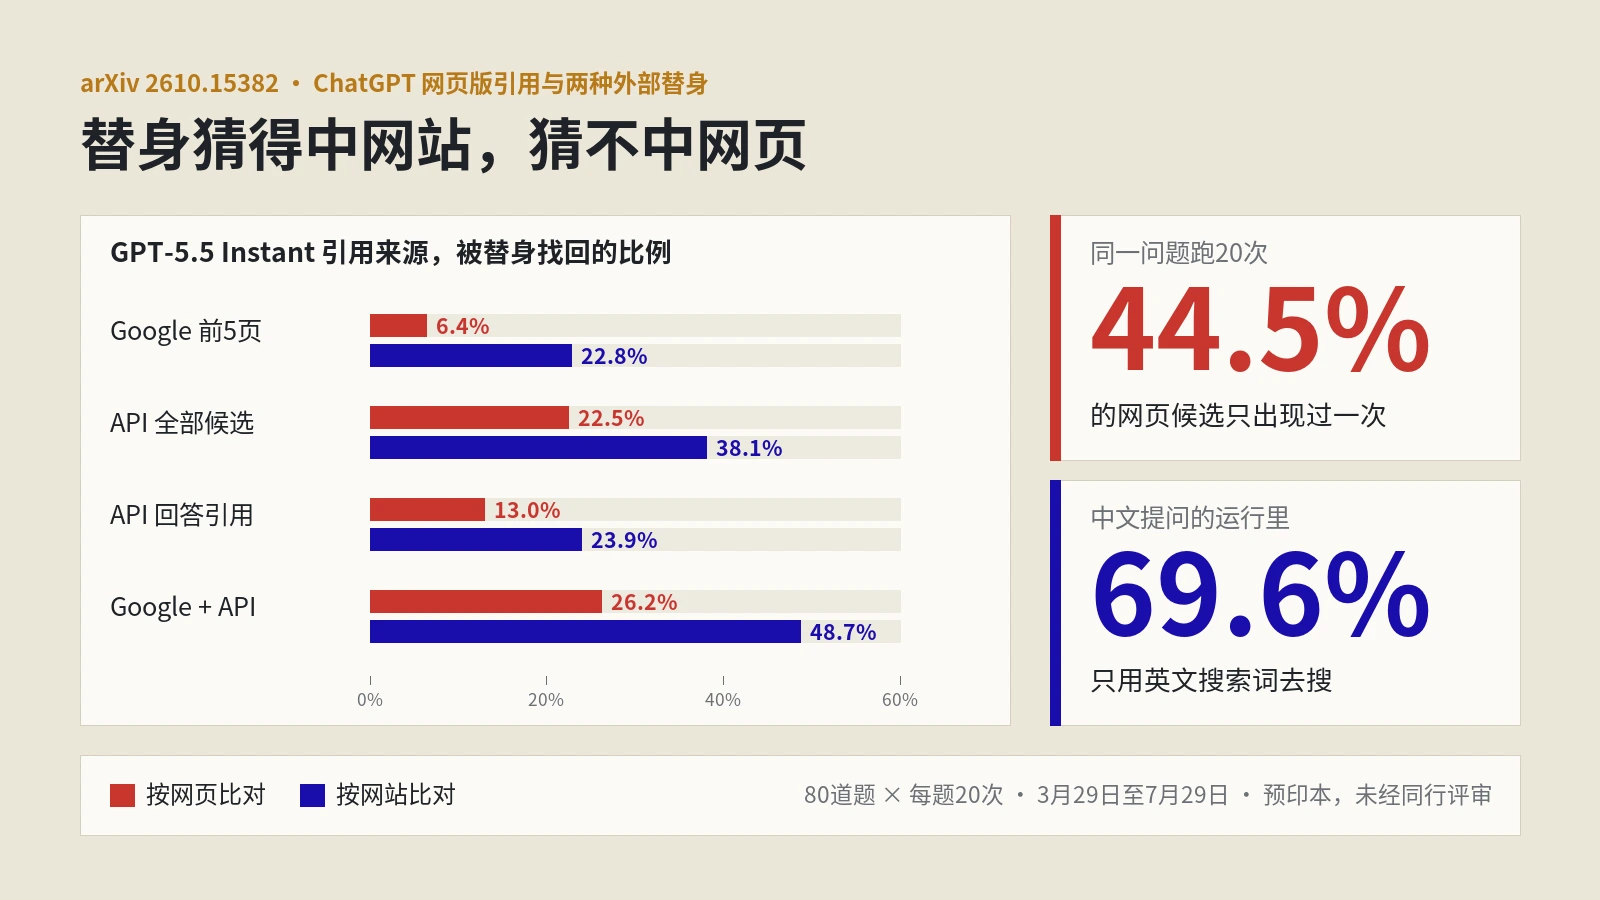
以SEJ 10月18日报道为主体,对照arXiv论文原文,讲清楚研究怎么录下ChatGPT网页版的搜索与选源过程,Google排名和Responses API两种替身在网页、网站、实体三个层级的命中率,重跑波动与模型悄悄降级,中文提问改用英文检索,以及GEO监测报表该怎么改口径。
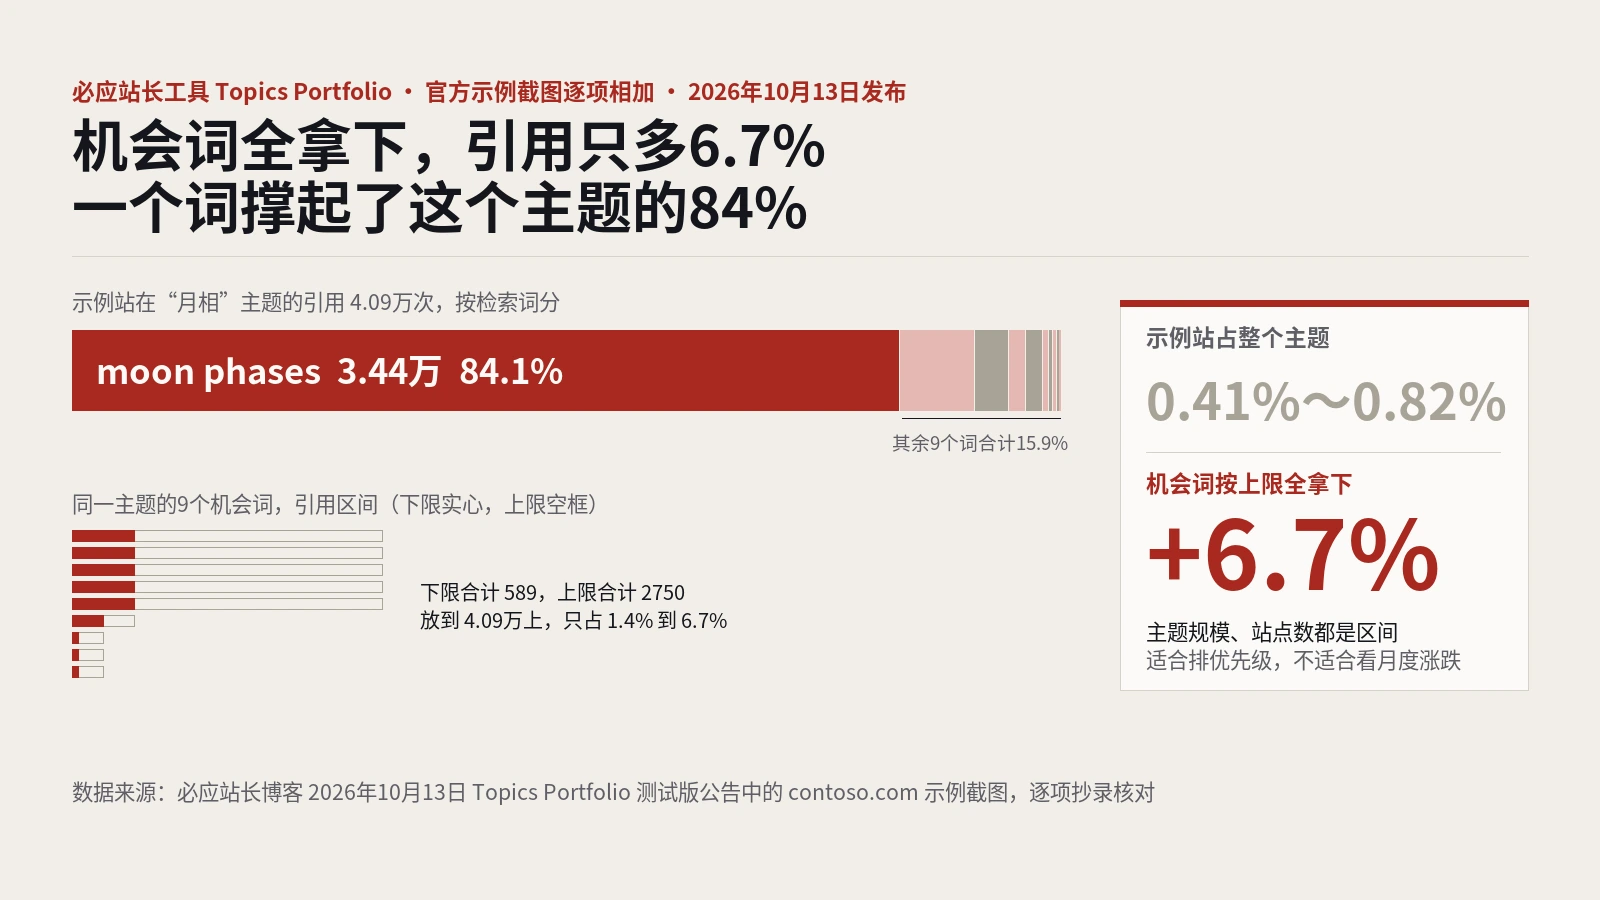
做法:逐项抄录必应官方博客公布的三张Topics Portfolio示例截图,把检索词引用数、机会词区间上下限和主题规模相加对照;再和2月、3月、6月三次更新以及AI表现帮助页的现行写法比对,整理成外贸站的使用顺序。
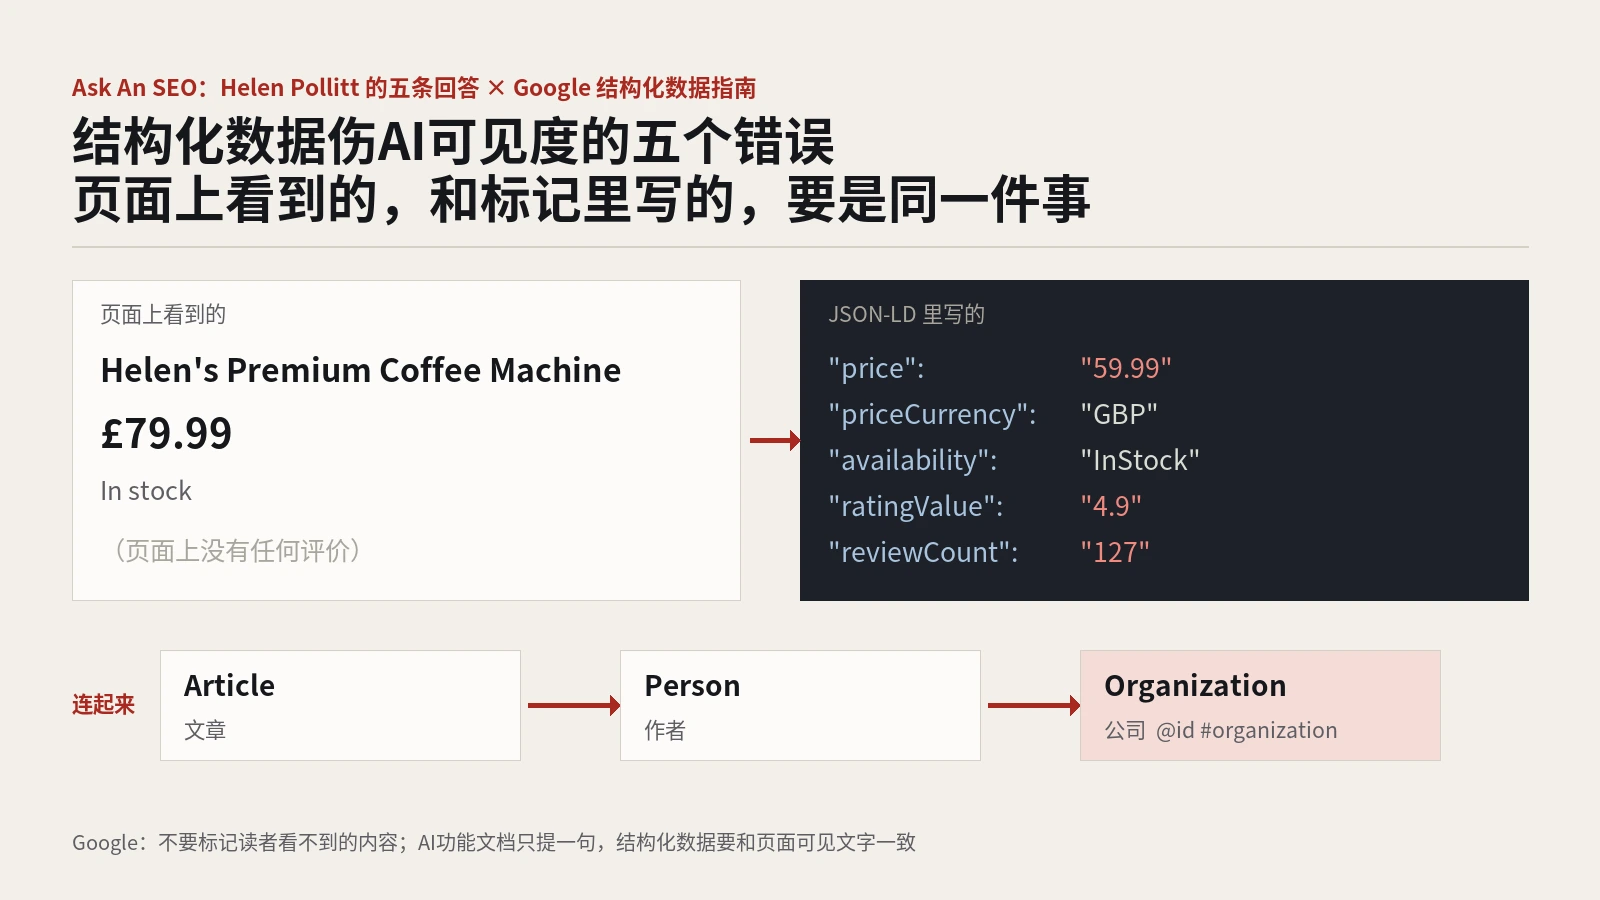
做法:以Search Engine Journal Ask An SEO专栏里Helen Pollitt的五条回答和示例代码为主体,对照Google通用结构化数据指南与AI功能文档,整理实体连接、站外口径、@id一致性、可见性与价格时效五类错误的成因、检查方法和修法,并补充@id跨页引用的工程做法。
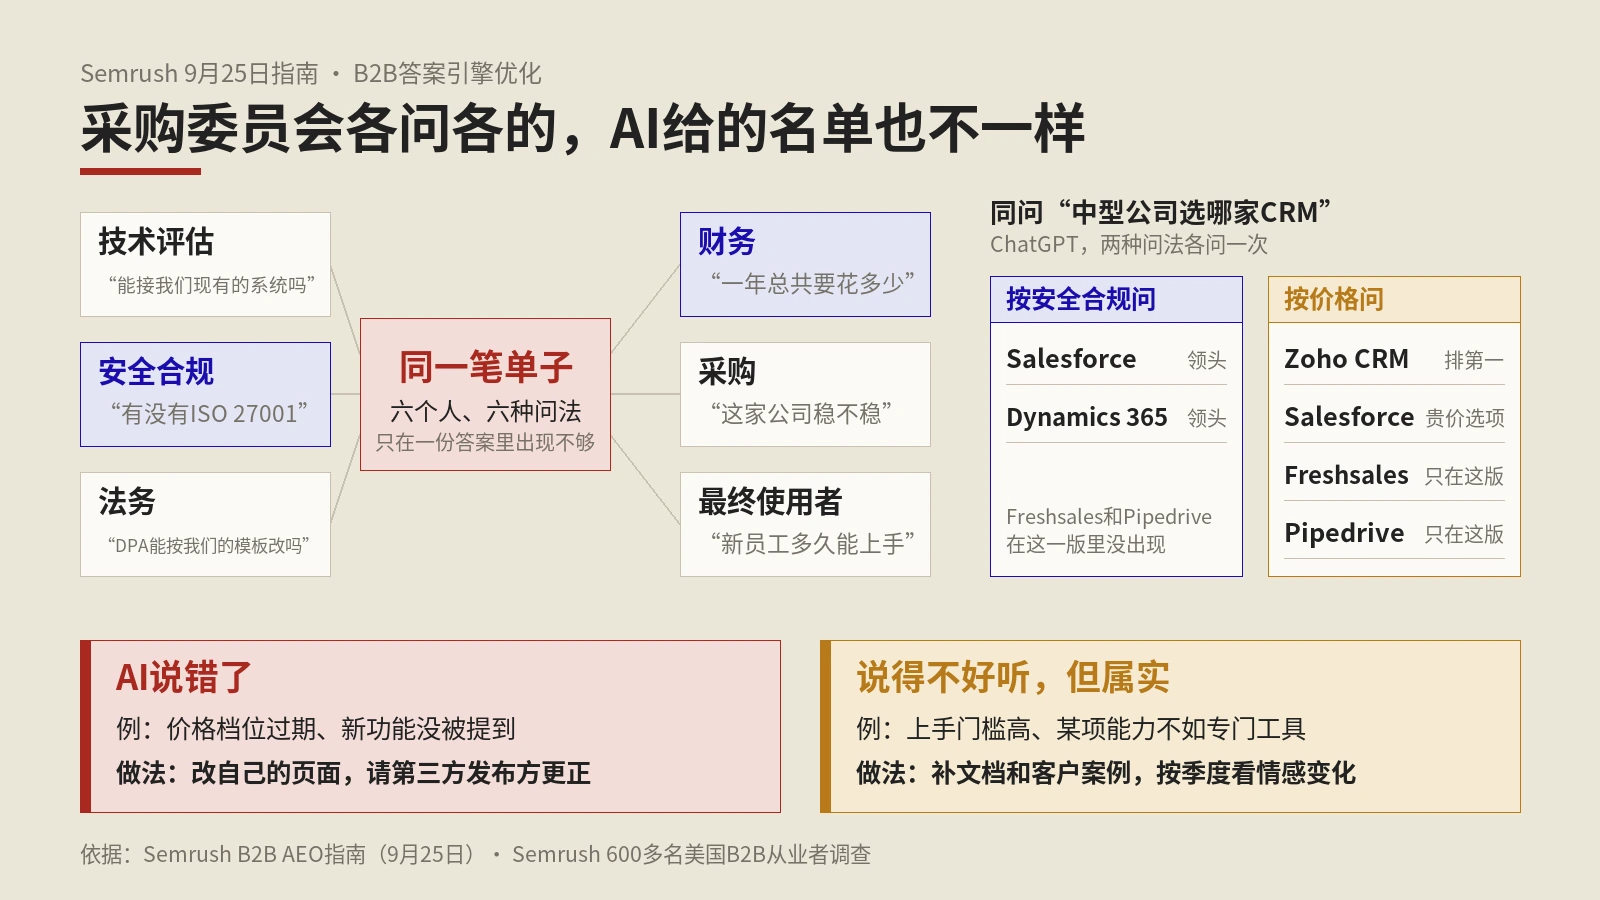
以Semrush 9月25日的B2B AEO指南为主体:按六类采购角色整理提示词清单,用问句标题和答案先行改写页面,按行业挑评论平台与工业目录,申请Gartner与Forrester分析师简报,把AI的错误描述和属实的负面描述分开处理,再用手工抽查加可见度工具按季度追踪。
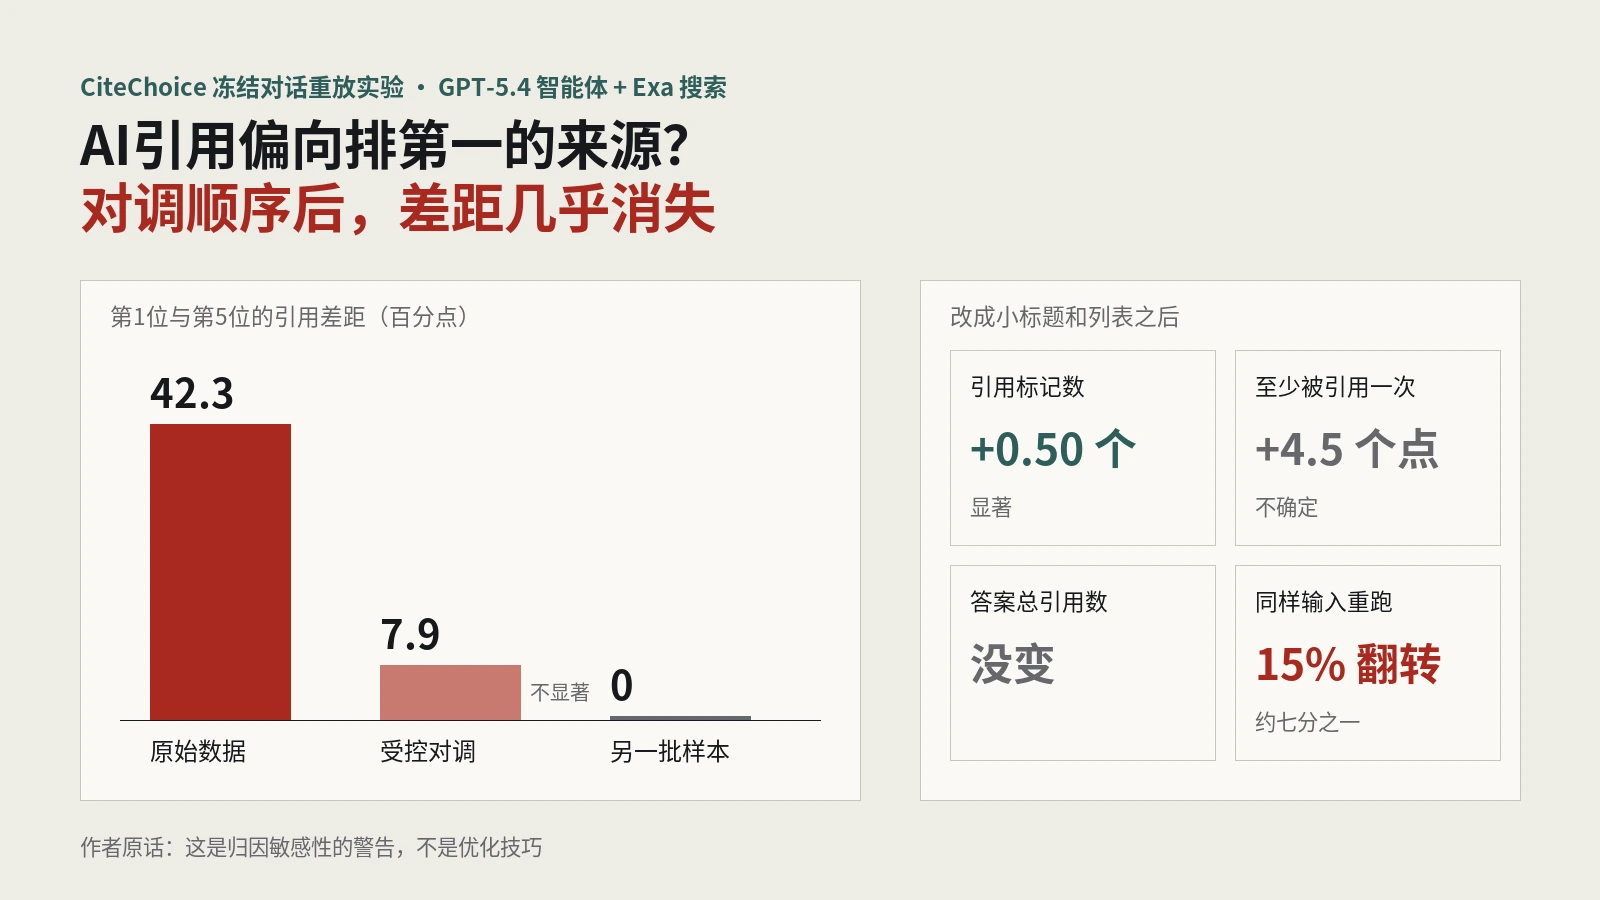
以SEJ 9月17日报道和arXiv预印本CiteChoice为主体,讲清楚这项受控重放实验怎么设计、搜索结果排序和小标题列表格式对AI引用的真实影响有多大、重跑为何约七分之一引用决定翻转,以及做GEO和AI可见度监测时哪些结论能用、哪些不能用。
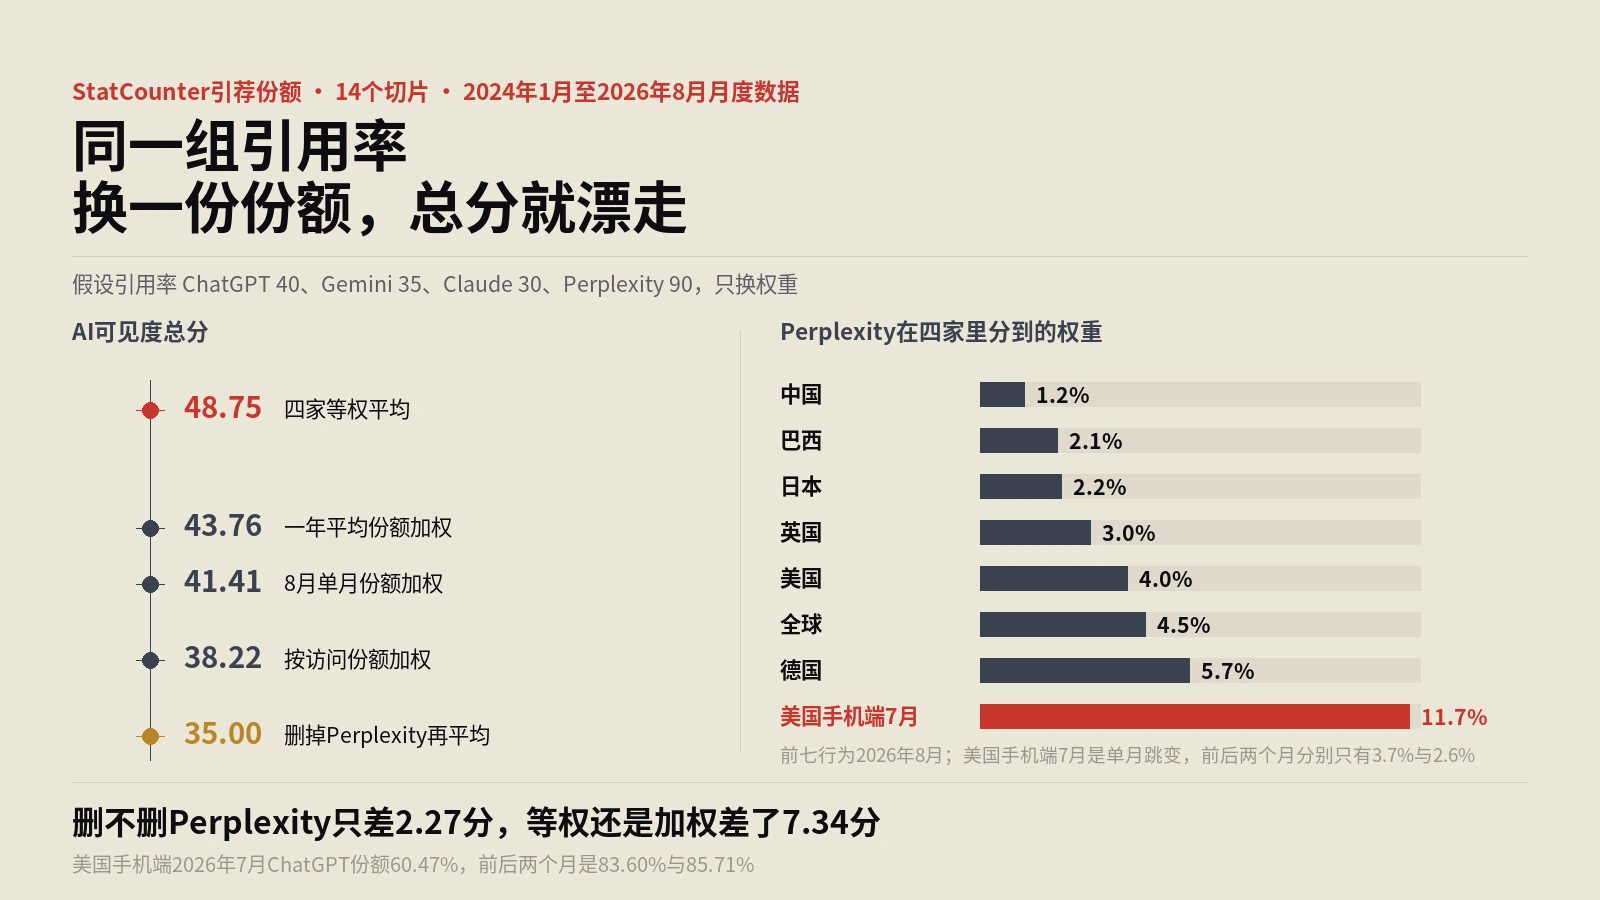
测法:固定一组假设的四平台引用率不动,只换权重。权重分别取自StatCounter引荐份额的全球、10个国家与桌面手机共14个切片、单月与三个月和一年平均,以及Similarweb的网页访问份额,逐一重算总分,再对照份额数据的修订、列顺序变化与异常跳变。
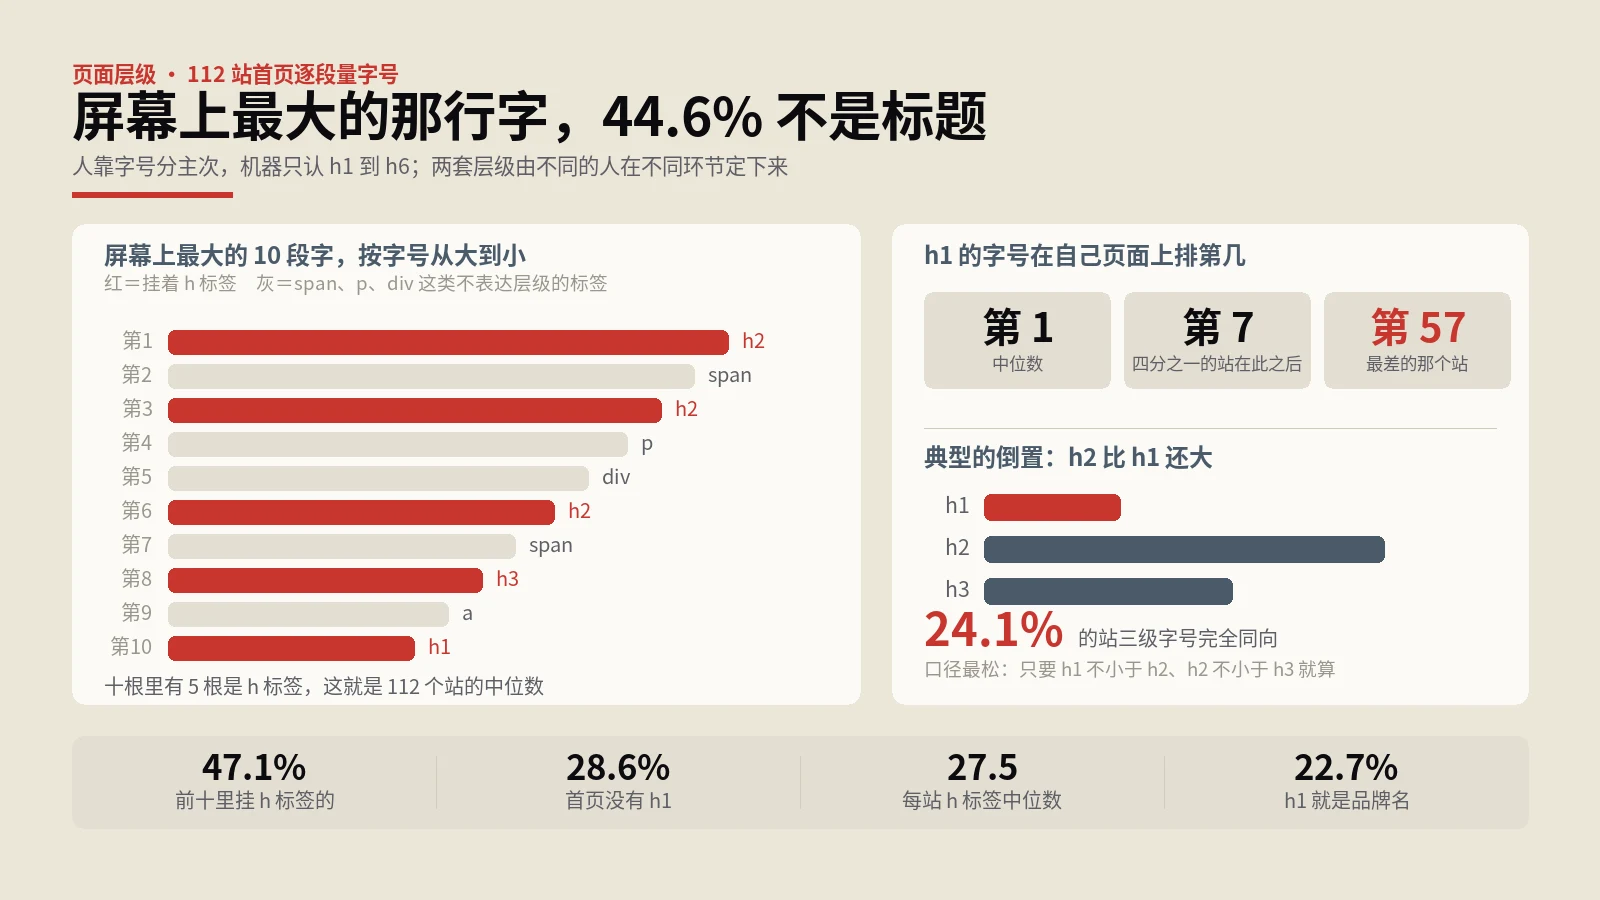
做法是用真实浏览器在1440宽视口打开112个电商独立站首页,遍历主内容区每个元素、只取它自己直接持有的那段文字,记下渲染后的实际字号、字重、标签名与位置,再按字号排序看排在最前的几段挂的是什么标签;同时把全部h1到h6单独取出比对字号、可见性与是否为空,并把被同意层整个盖住的13个站单独剔出。
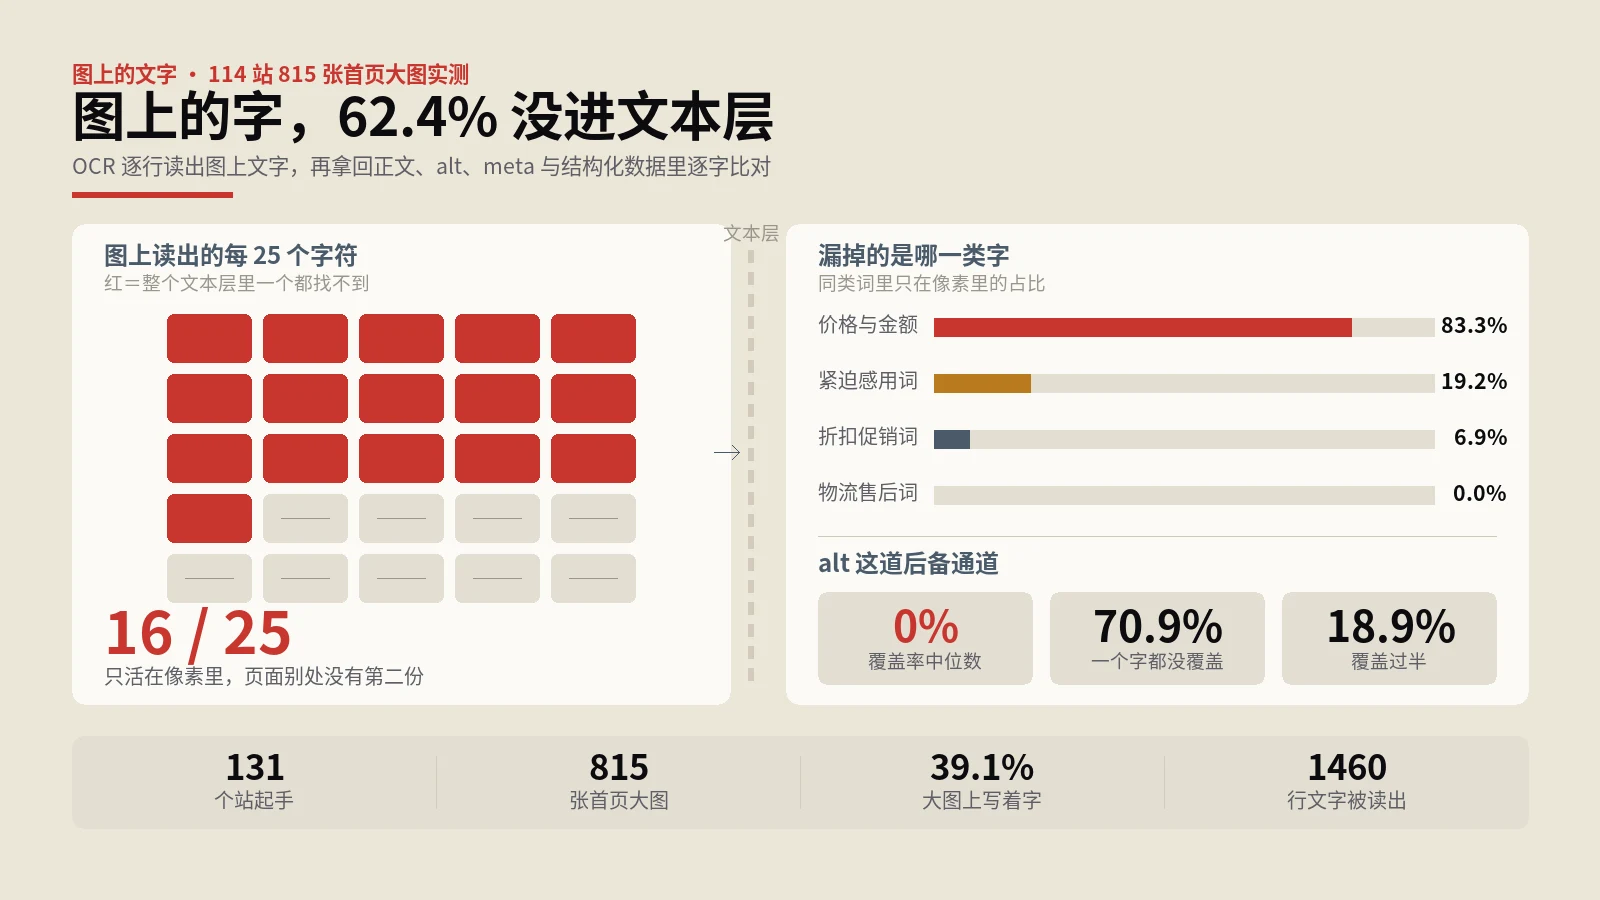
做法是把127个电商独立站首页用真实浏览器打开、滚三屏逼出懒加载,再按原始地址下载渲染面积最大的8张图(不截屏,避免把叠在上面的HTML文字拍进去),用RapidOCR逐行读出文字,最后拿回由正文、DOM全部文字、alt与aria属性、meta和JSON-LD拼成的文本池里逐行比对;OCR这把尺子先用12张已知文案的合成图和24张人工标注的真图考过两轮,并做了置信度敏感性检查。
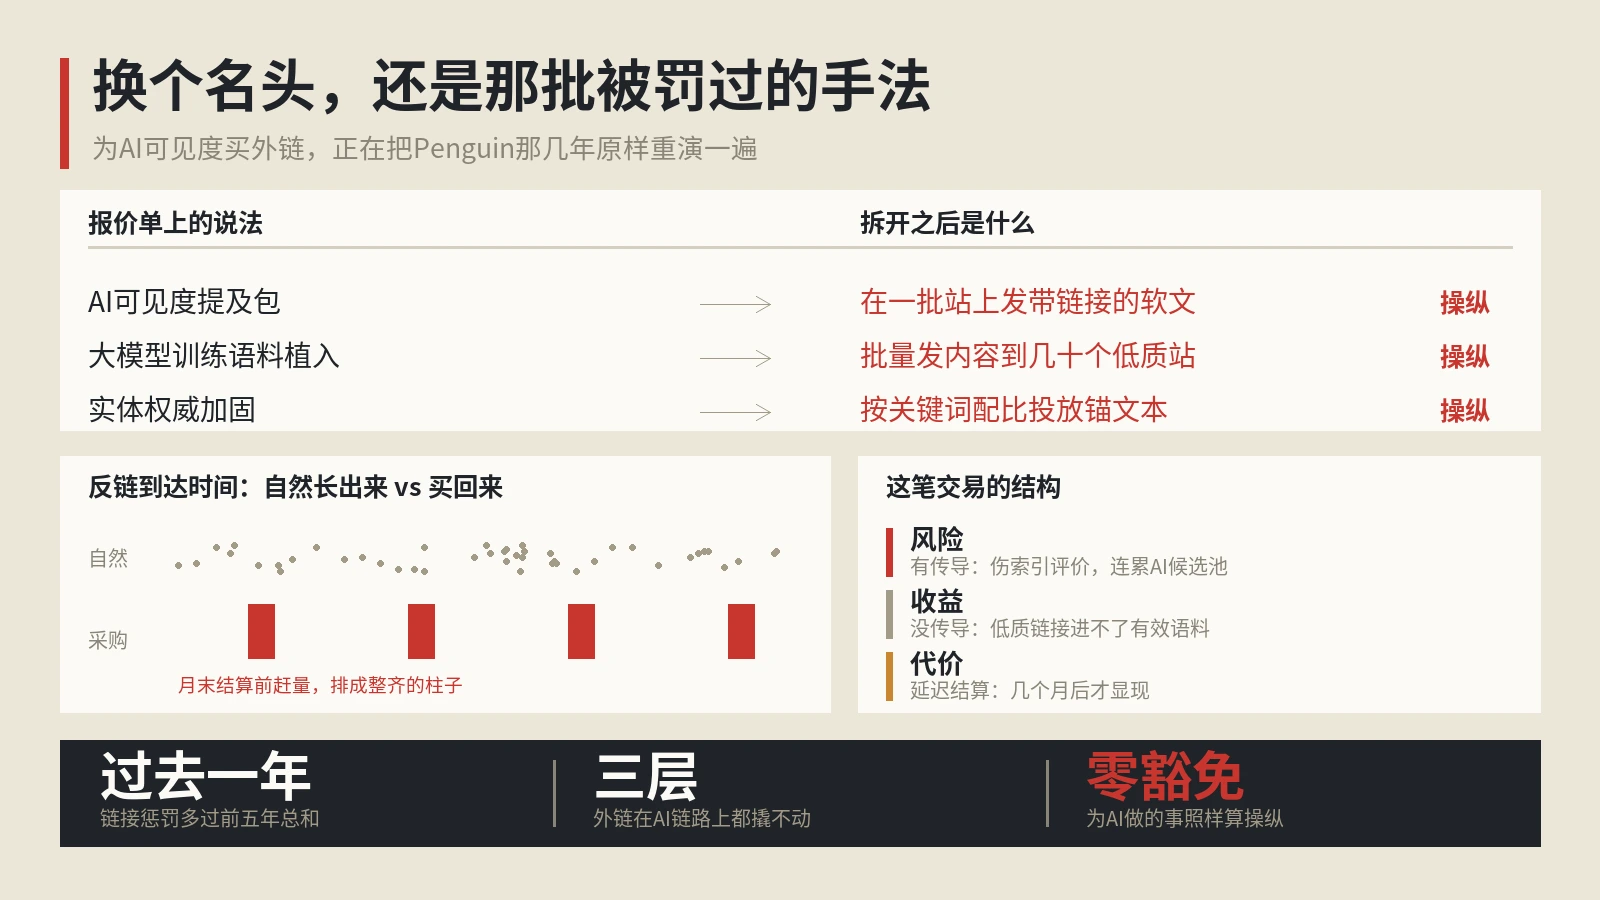
号称能拉高AI可见度的服务,拆开看还是买链接、堆锚文本那一套。惩罚机制早就进了核心算法一直在跑,为AI做的动作拿不到任何豁免。本文讲清话术怎么辨、外链在AI三层链路上各起什么作用、以及已经买了该按什么顺序退。
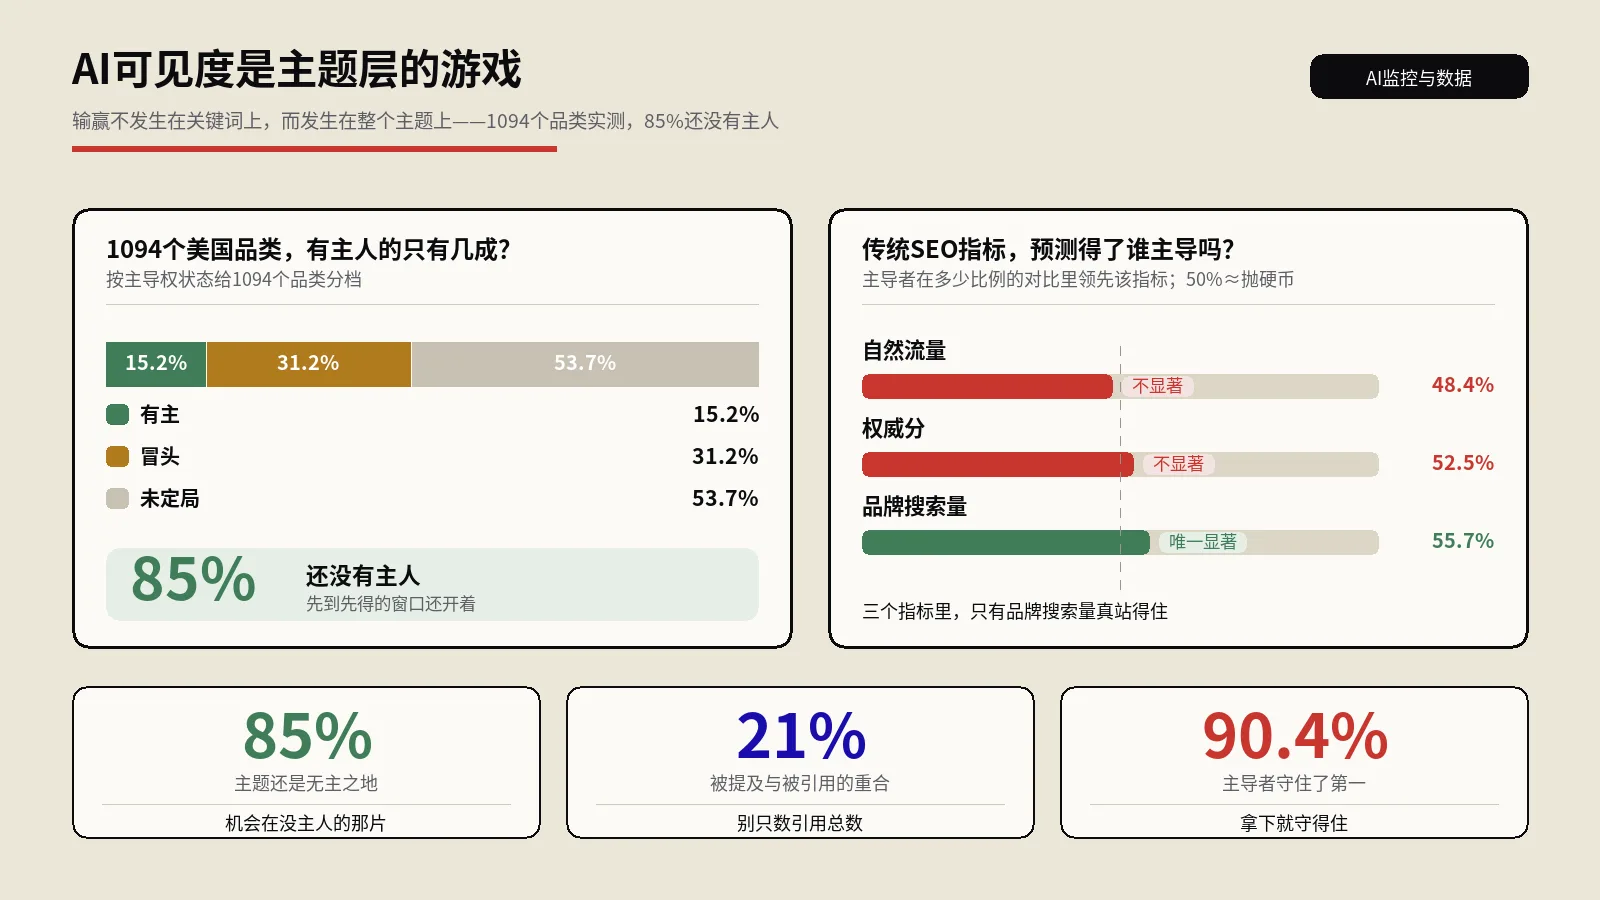
一份覆盖1094个美国品类的ChatGPT实测,把AI可见度的玩法讲透了。本文拆解:为什么衡量单位要从关键词抬到主题、三种主导权状态各该怎么打、传统SEO指标为何失灵、被提及与被引用的区别、领先多少个百分点才守得住,并附主题自查地图、无主主题的抢占打法与中文出海的两个坑。
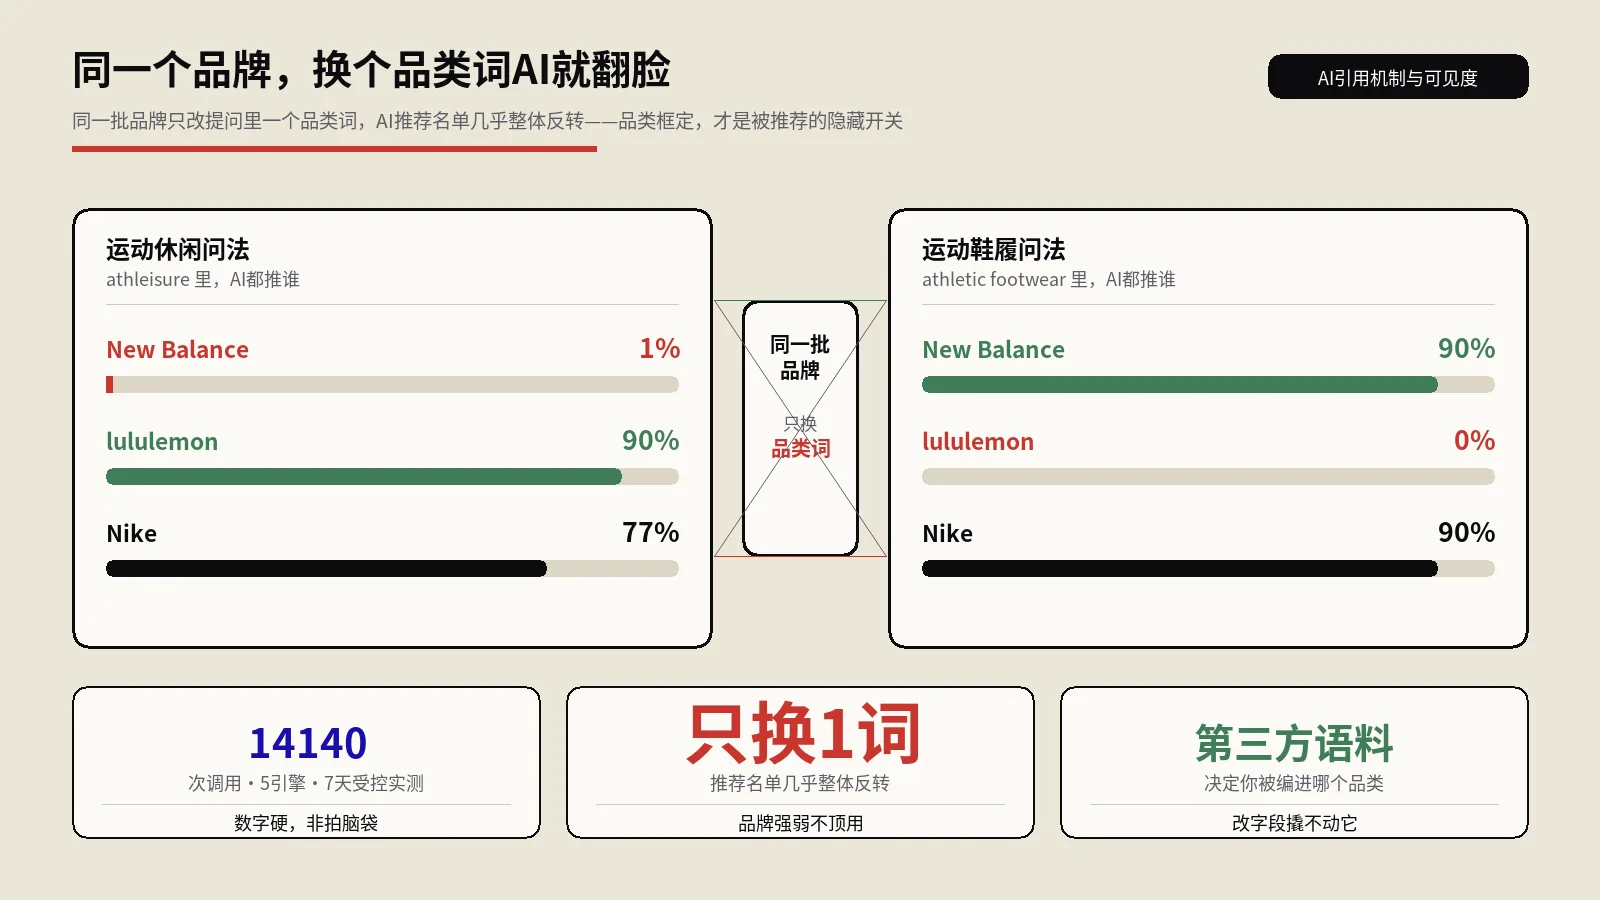
同样被AI认识的品牌,为什么有的被推荐、有的查无此人?本文拆解category coding机制:知识图谱描述定识别、第三方内容语料定推荐,用12个品牌14140次实测讲清品类框定如何决定AI推荐名单,并附品类自查表、共现语料打法与出海落地清单。
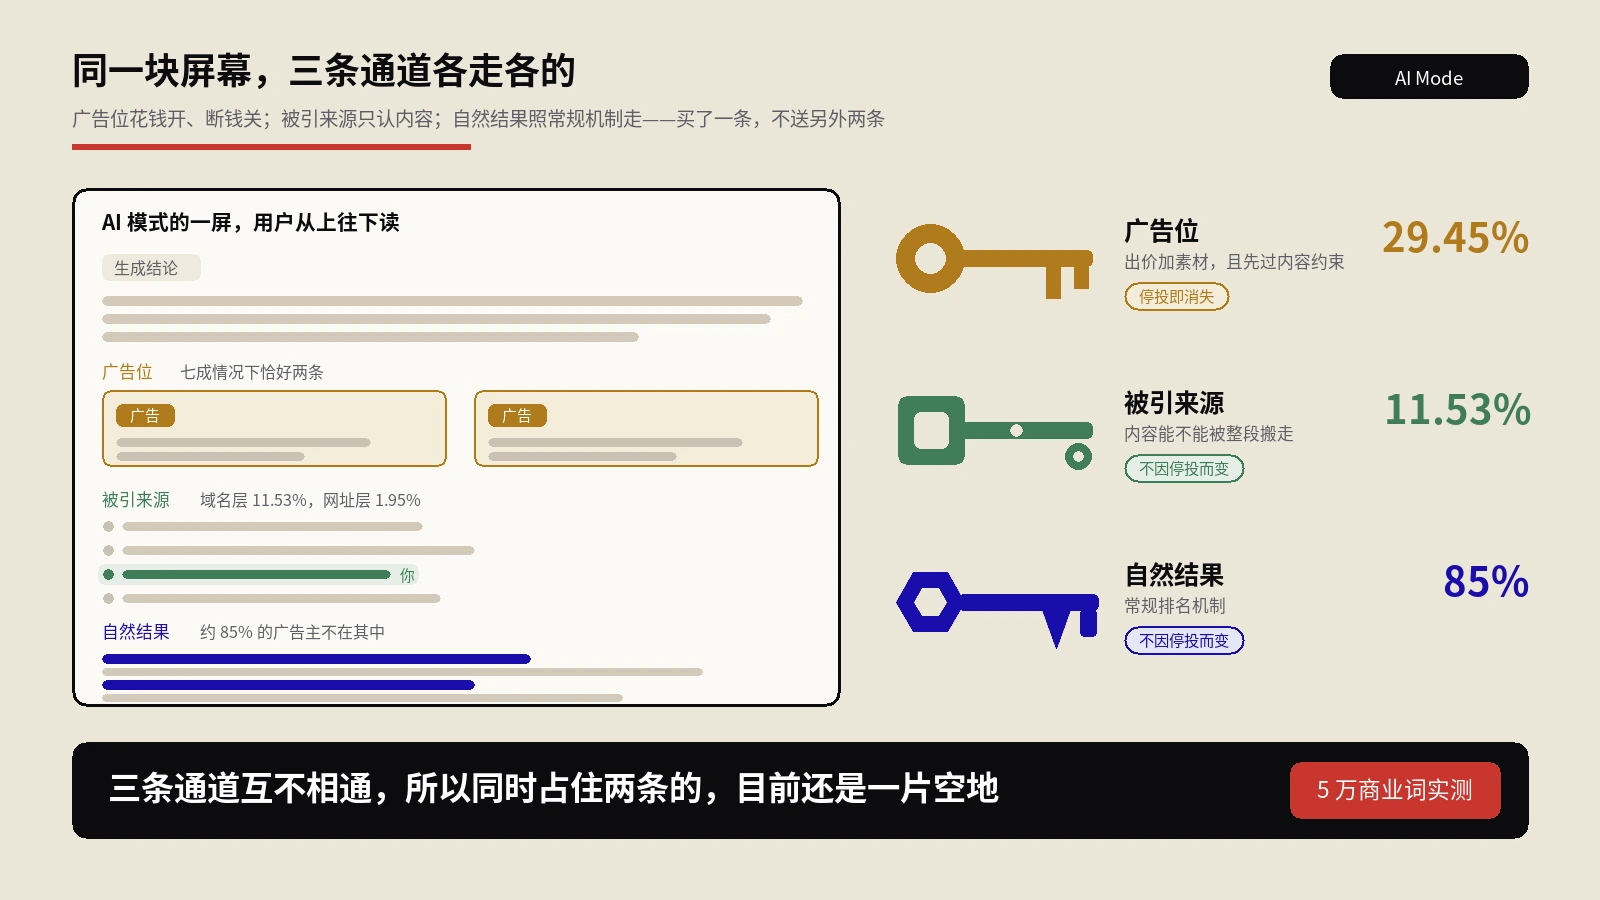
同一块屏幕上并排跑着三条互不相通的管道:花钱开、断钱关的广告位,认内容不认预算的被引来源,以及照常规机制走的自然结果。本文拆开这三者各自的准入条件与失效方式,并给出一套三十个核心词、两三个小时就能跑完的自测办法。
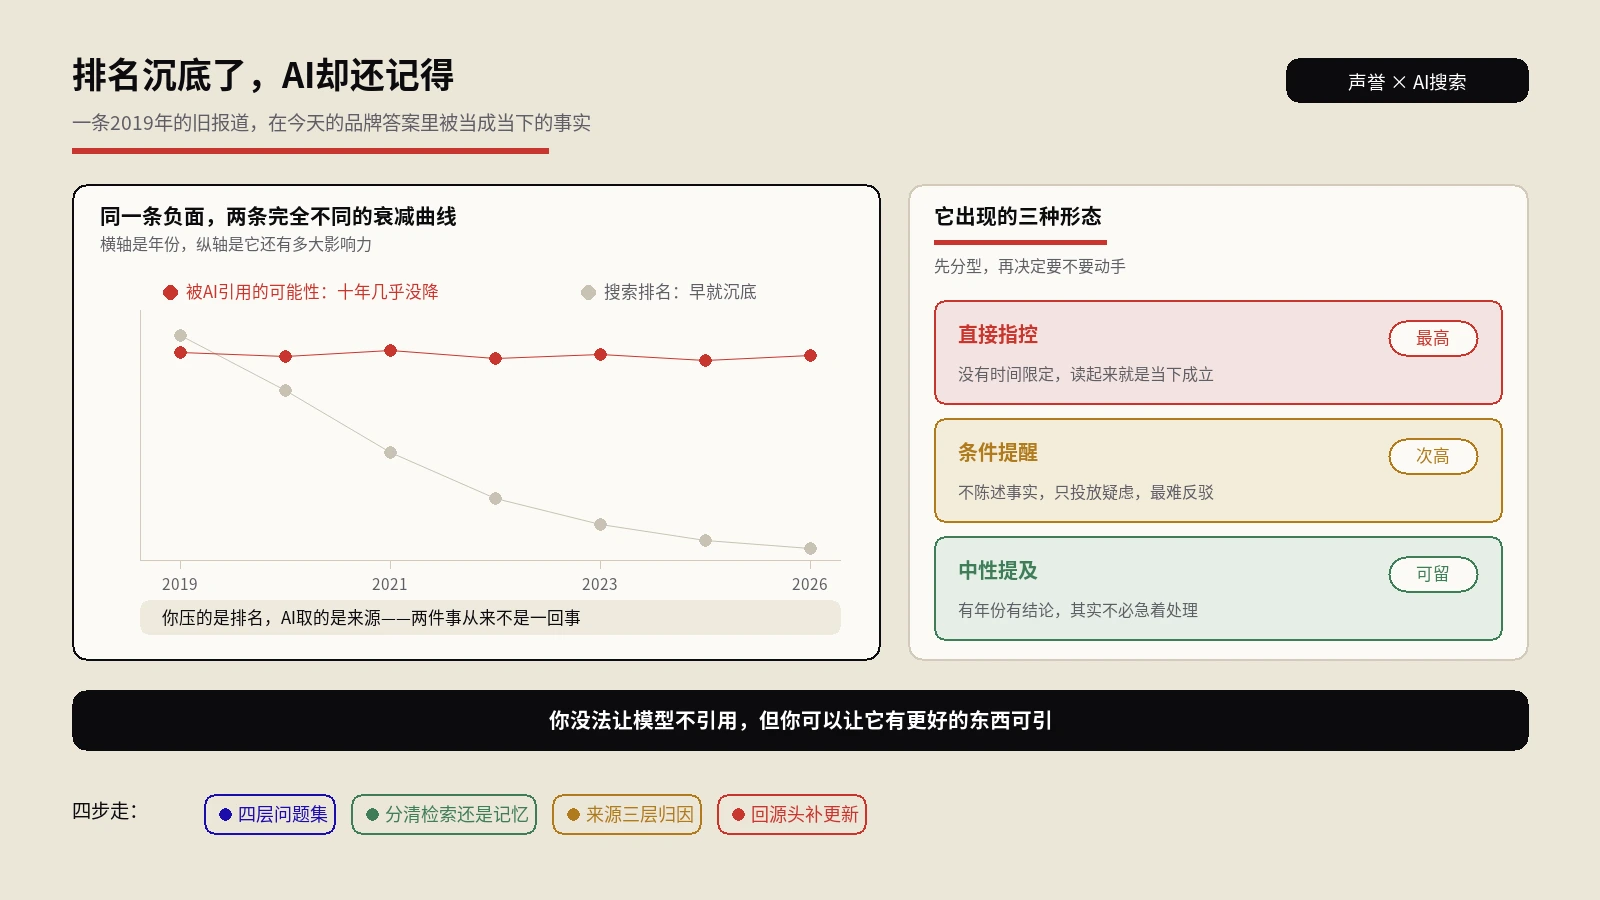
负面报道在搜索结果里沉底不代表它消失了。AI答案挑的是可信来源而不是排名位置,一条2019年的旧报道照样被拽进今天的品牌介绍,还不标年份。压制那套老办法对它基本无效。本文拆开检索路径与记忆路径的区别、六类高危旧内容、四步诊断法与三档投入优先级,附一个智能门锁品牌四个月掰回AI口径的完整过程。
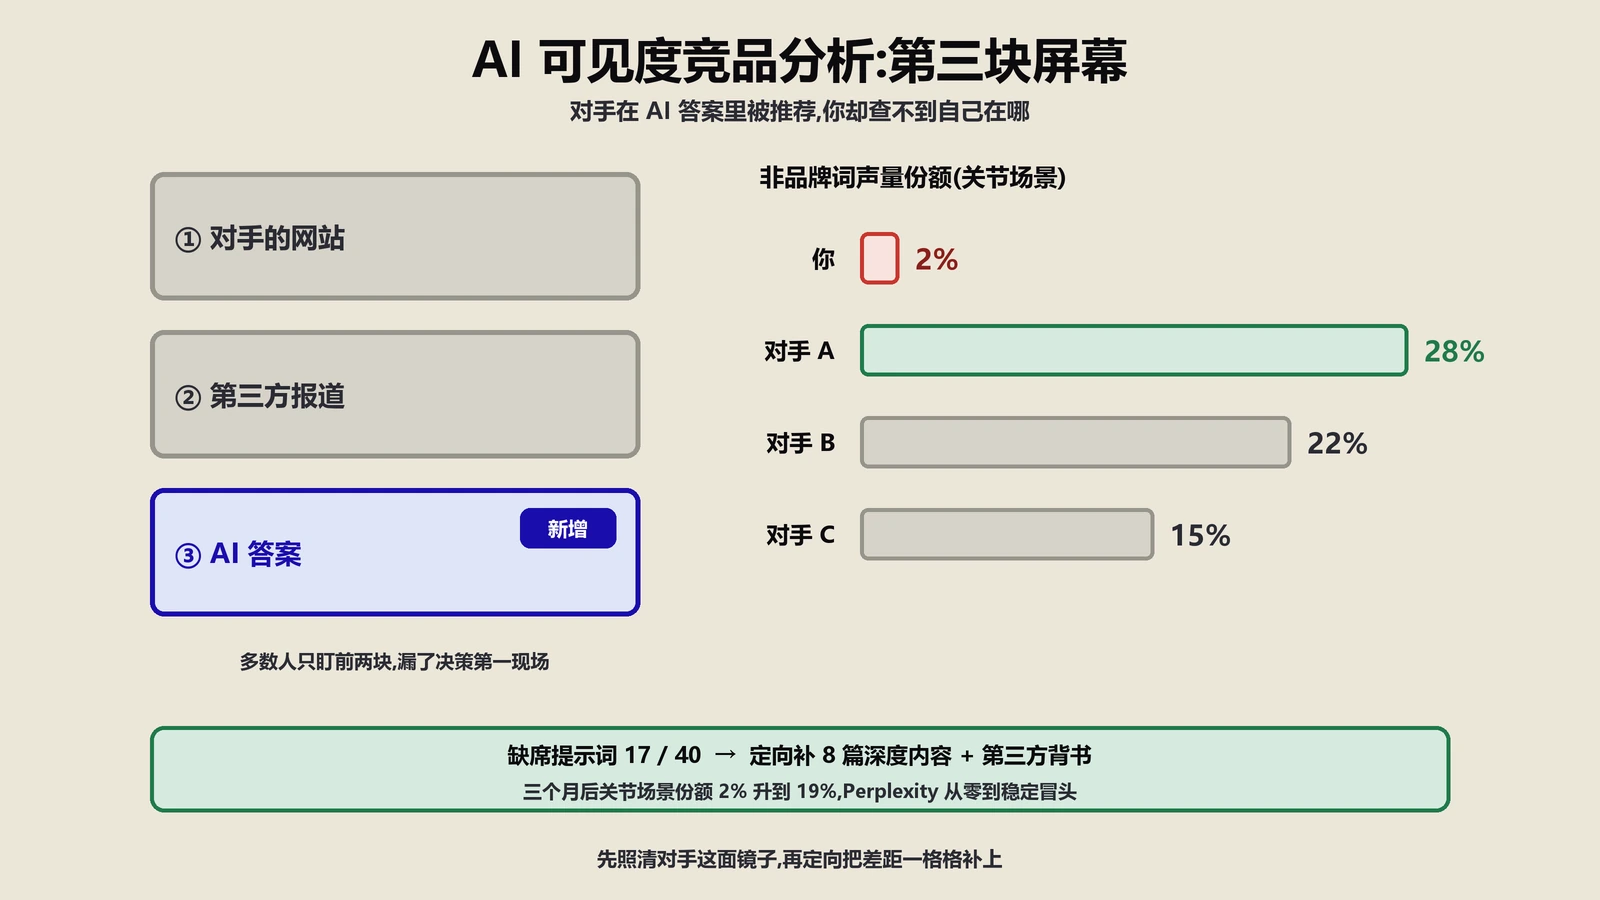
用ChatGPT问需求词,答案里全是对手、偏偏没有你?把AI可见度当成竞品分析的第三块屏幕:搭提示词集、算声量份额、扒对手的引用来源、用缺席提示词找突破口,一套能落地的流程加宠物营养品实战案例。
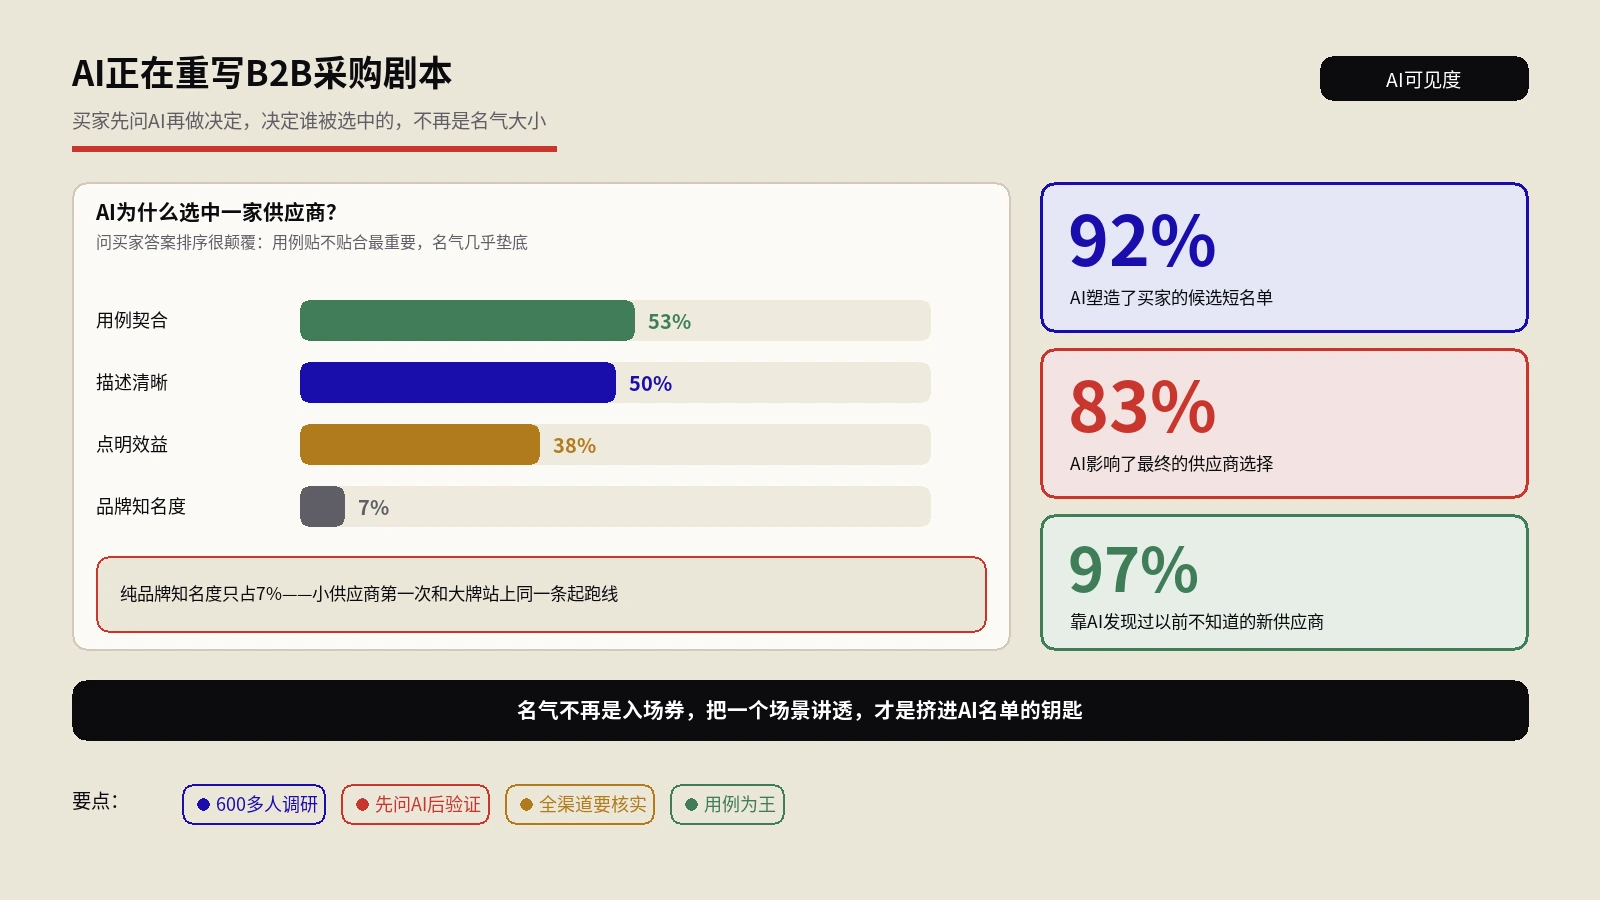
越来越多B2B买家先把需求丢给ChatGPT,再拿名单去验证。一项600多人的调研显示,92%说AI塑造了候选短名单、83%左右了最终选择,而决定谁被推荐的头号因素是用例契合而非品牌知名度。这篇讲清AI怎么重写采购剧本,外贸和独立站如何被AI选进名单。
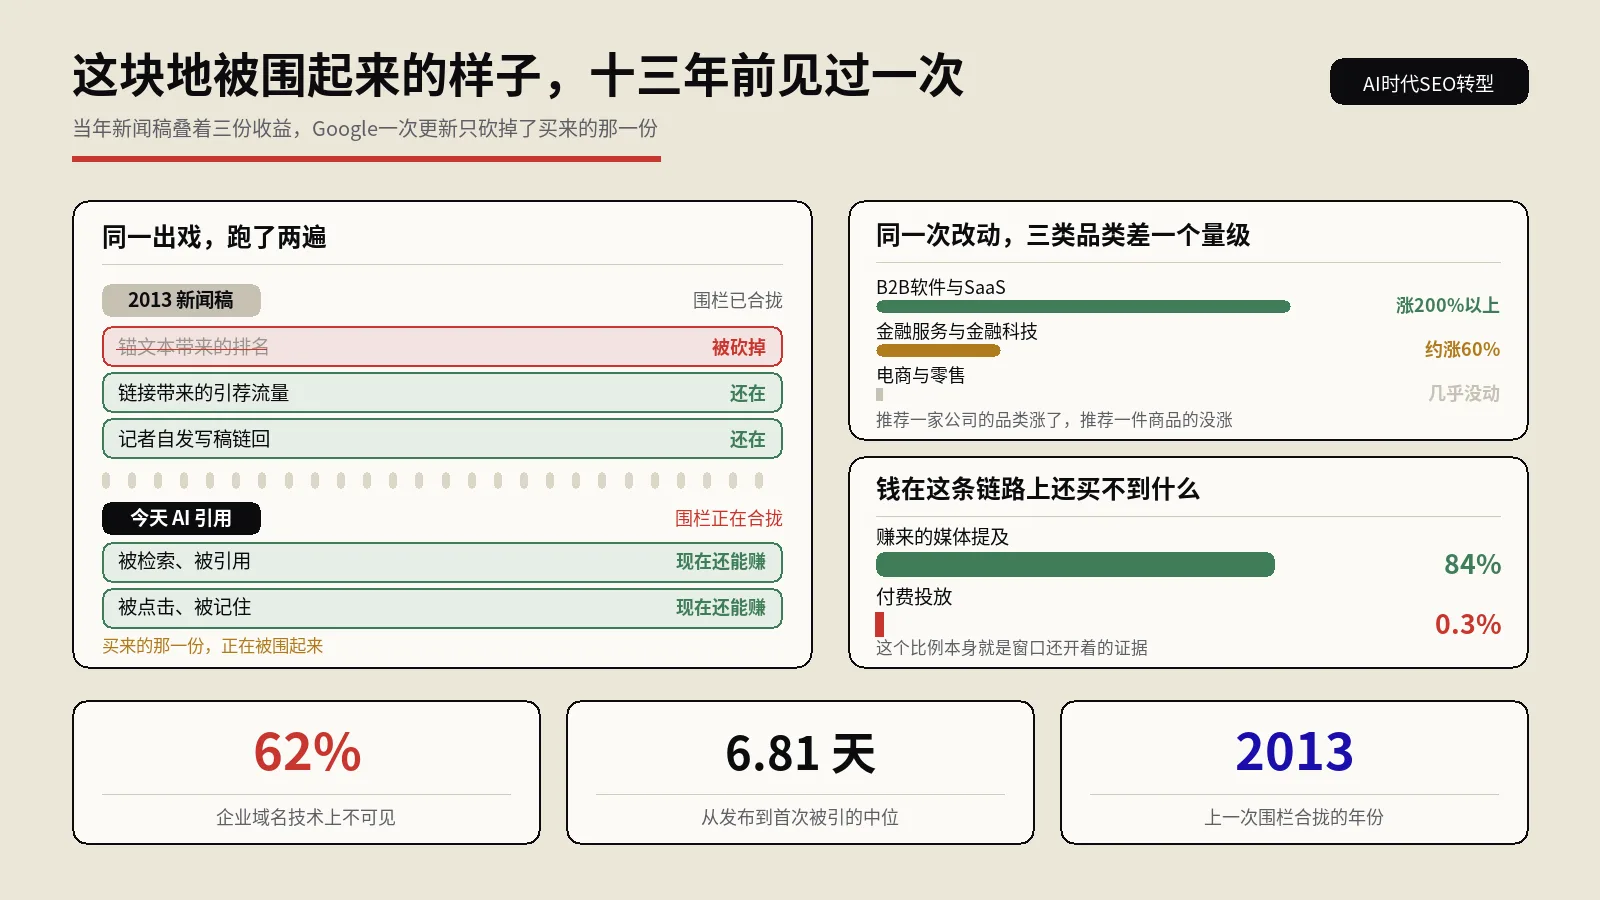
关掉的不是AI搜索的面积,是你能用力气而不是预算赢下位置的那段时间。本文给出窗口该按赛跑而不是按日期理解的理由、一个下午的审计怎么排、追提及不追链接具体怎么做,以及围栏正在合拢的四个可观察信号。
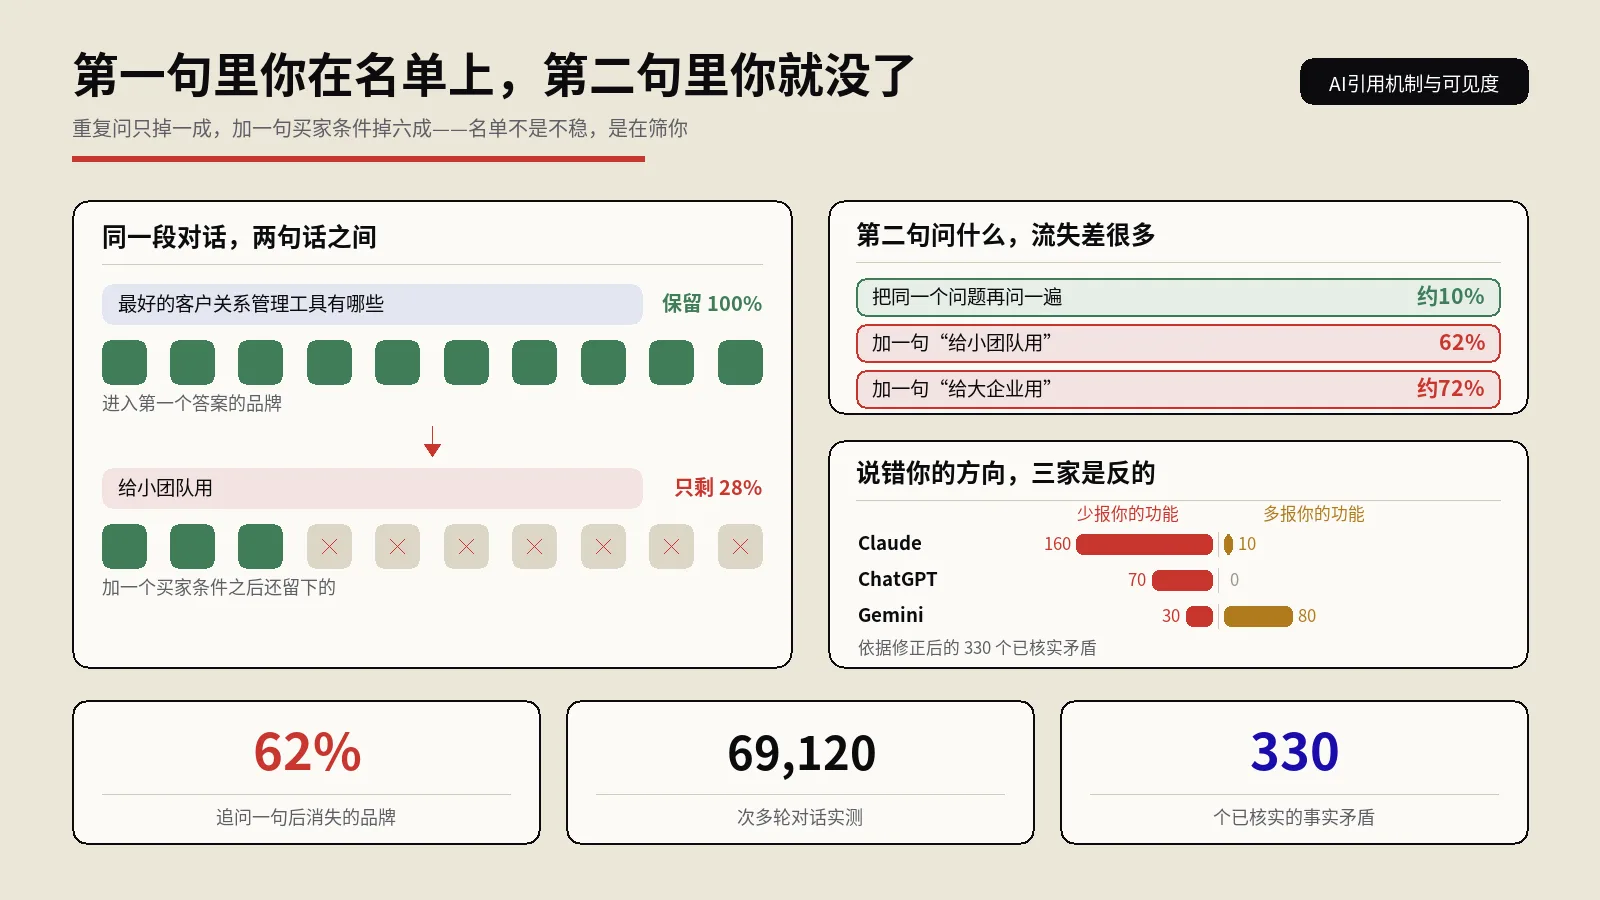
重复问同一个问题,名单保留九成;加一句买家条件,却只剩两成八。这不是不稳定,是响应性。本文给出监控该怎么从单次提问改成整段对话、追问清单去哪儿找、按模型分头修的顺序,以及一份研究报告该怎么快速验真。
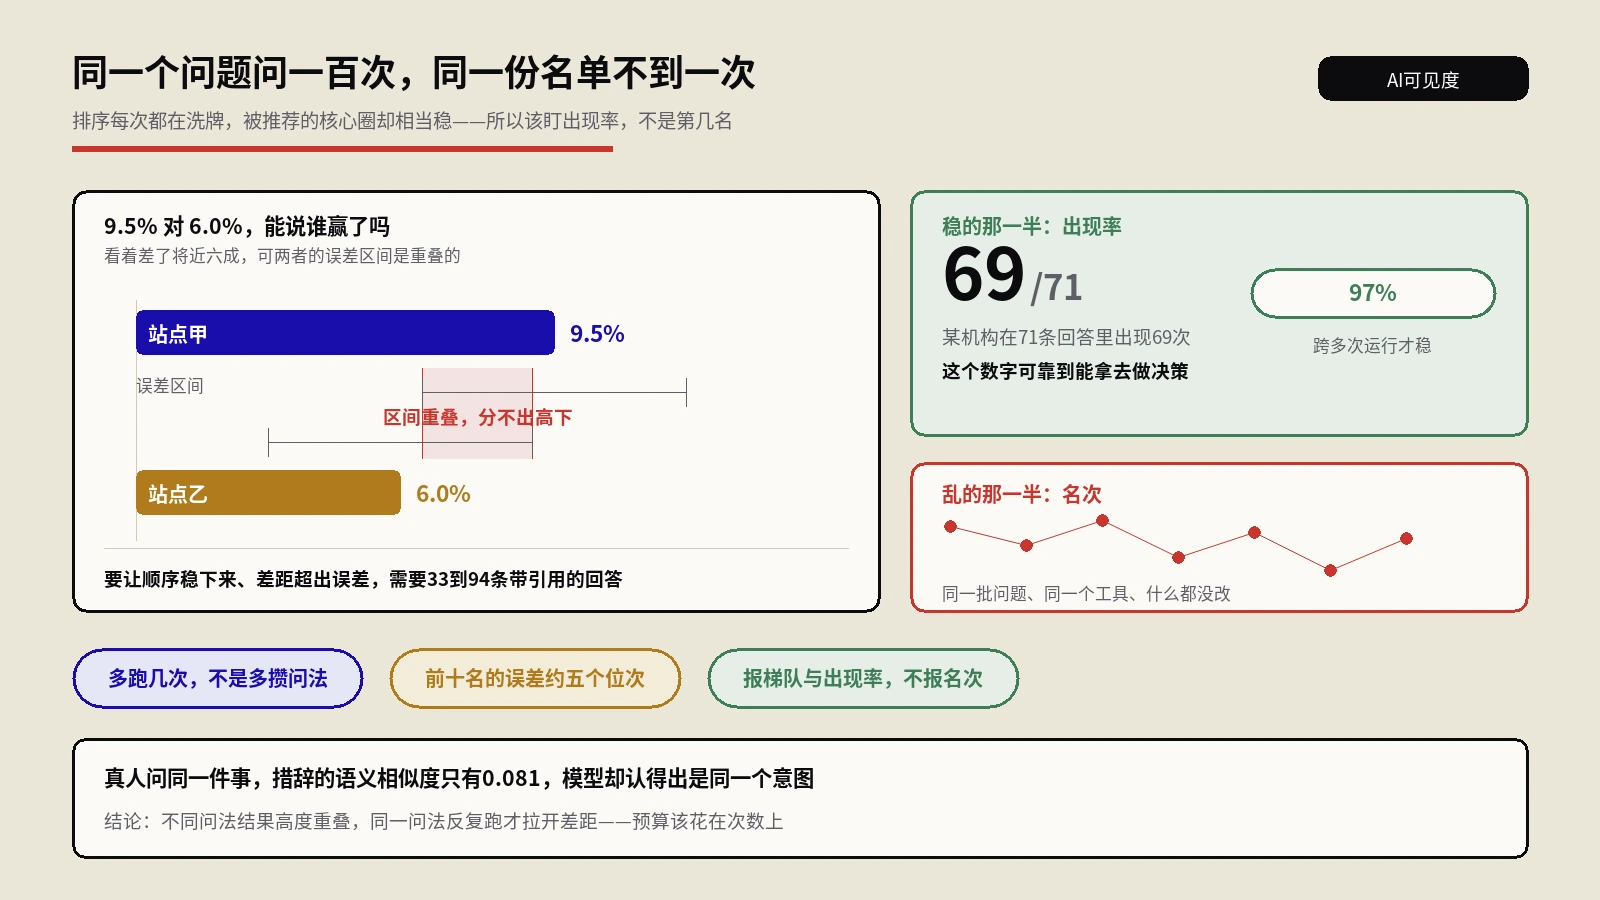
把工具给的名次当结论,大概是这两年最贵的误读之一。重复提问下连顺序都一致的两份名单,约莫千次才碰上一回;可某家机构却能在71条回答里出现69次。真正该盯的是出现率和引用来源,而不是第几名。