用OpenAI API监测ChatGPT引用准不准?新论文:网页只找回四分之一,按网站算能到五成
本文目录
- 这篇论文测了什么,和SEJ的转述有没有出入?
- 拿Google排名和API去猜ChatGPT的引用,能猜中多少?
- 为什么网站比网页好猜?
- 同一个问题问20遍,引用会差多少?
- 重跑时还有个坑:模型会悄悄换掉
- 中文提问,ChatGPT却拿英文去搜,中文站和外贸站怎么办?
- 被引用的网页有什么共同点?
- GPT-5.4 Thinking的搜法完全不同
- 做GEO监测,具体该怎么改?
- 这篇论文说明不了什么
- 常见问题解答
- 这篇论文是谁做的,可信吗?
- 论文里的引用和我在ChatGPT界面里看到的链接一样吗?
- 用OpenAI API做GEO监测还有意义吗?
- Google排名靠前,ChatGPT就会引用我吗?
- 中文提问时ChatGPT为什么用英文搜?
- 同一个提示词要跑多少次才够?
- 换成GPT-6之后这些数字还成立吗?
- 发布时间对ChatGPT引用有影响吗?
- 权威参考资料
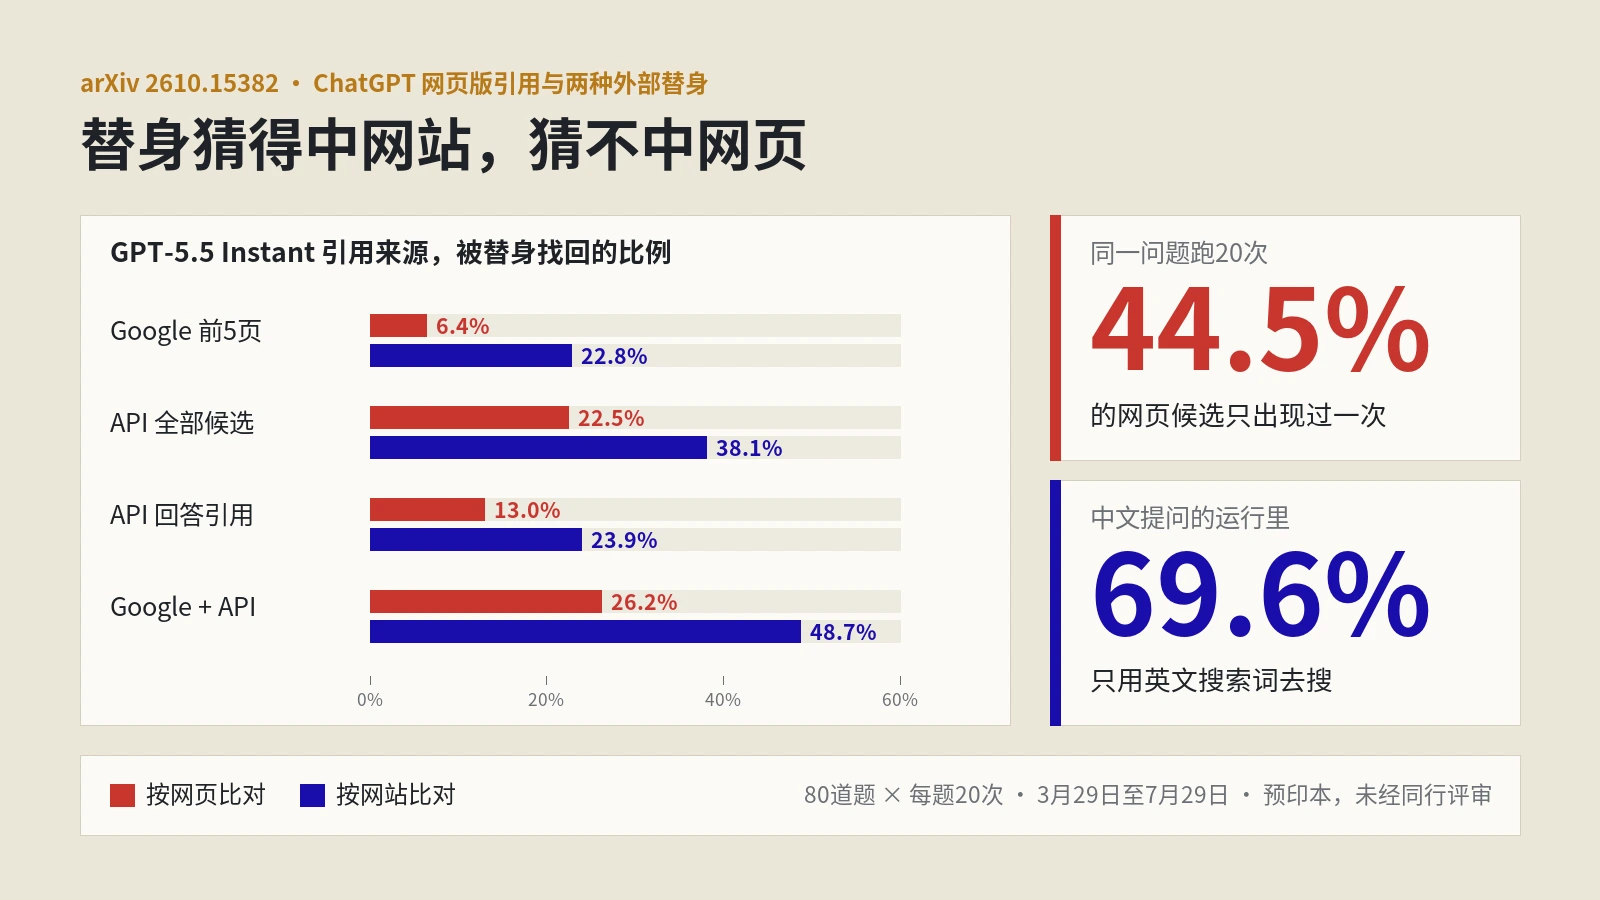
摘要:新加坡国立大学和西安交通大学的研究者10月11日在arXiv贴出预印本,录下自己账号里ChatGPT网页版的后台数据流,对比Google自然结果和OpenAI Responses API两种替身。两者合起来只覆盖GPT-5.5 Instant引用网页的26.2%,按网站算能到48.7%;同一问题跑20遍,44.5%的网页只出现过一次;中文提问的运行里,约七成只用英文去搜。论文未经同行评审,样本是80道题,数据截至7月,GPT-6还没测。
市面上很多AI可见度工具,背后跑的是OpenAI的API,或者干脆拿Google排名去推算ChatGPT会引谁。这样做省钱、能批量,可它到底准不准,一直没人拿真实数据对过。
Search Engine Journal的Matt G. Southern在10月18日的报道里介绍了一篇新论文,答案不太好听:替身猜对的网站不少,猜对的具体网页不多。下面以这篇报道为主体,对照论文原文把数字逐个核了一遍,补上SEJ没写的部分,再说说做中文和外贸GEO监测的人该怎么调整。
这篇论文测了什么,和SEJ的转述有没有出入?
论文题目是《Understanding ChatGPT Citations: Evidence from Production Web Search Across Model Generations》,编号arXiv:2610.15382,10月11日提交。五位作者分别来自西安交通大学和新加坡国立大学,第一作者同时挂着国家电网旗下SGIT AI Lab的单位。arXiv不做同行评审,这一点SEJ也提了,读数字的时候要记着。
研究者的做法挺朴素:用自己登录的ChatGPT网页版提问,把浏览器收到的服务器推送事件流(SSE)完整录下来。这份数据流里能看到ChatGPT实际发出的搜索词、拿回的候选网页,以及最后选作来源的网页。站内之前写过有人从网络请求里扒出ChatGPT挑源的内部字段,这篇论文走的是同一条路,只是做成了系统的样本。
样本和口径列在下面,SEJ的转述基本准确:
| 项目 | 论文原文 |
|---|---|
| 题目来源 | Search Arena公开数据集,约2.4万条用户和联网大模型的真实对话 |
| 题目数量 | 80道,事实查询、信息汇总、分析、推荐四类各20道,每类中英文各10道 |
| 主力设置 | GPT-5.3 Instant和GPT-5.5 Instant,每道题各跑20次,各1600次运行 |
| 补充设置 | GPT-5.2 Instant测了32道题547次,GPT-5.4 Thinking测了30道题491次,两者都在采集完成前下线 |
| 采集时间 | 2026年3月29日到7月29日 |
| 替身一 | 经SerpAPI抓Google自然结果前5页,平均每题43.2条 |
| 替身二 | Responses API开联网搜索,调gpt-5.3-chat-latest和gpt-5.5,不加系统提示词,每题20次 |
| 同步要求 | 同一道题的三路数据在3天内采完 |
有两处细节SEJ没展开,读数字前最好先知道。
第一处是“引用”的定义比用户看到的宽。ChatGPT会把几个网页归成一组来源,组里的辅助网页不一定单独显示链接。论文规定,只要这组来源被选中,组里的辅助网页也算被引用。所以论文里的引用率,比你在聊天界面里能数到的链接要多一些。
第二处是搜索词并不总能看到。GPT-5.3 Instant的1600次运行里,只有1339次能看到后台实际发出的搜索词,其余261次看不到。后面讲查询改写的比例,用的都是能看到的那部分。
拿Google排名和API去猜ChatGPT的引用,能猜中多少?
这是全文最该记住的一张表。召回率的意思是:ChatGPT网页版引用过的网页里,替身找到了多少。
| 替身 | GPT-5.3网页召回 | GPT-5.3网站召回 | GPT-5.5网页召回 | GPT-5.5网站召回 |
|---|---|---|---|---|
| Google自然结果前5页 | 9.4% | 26.1% | 6.4% | 22.8% |
| API返回的全部候选 | 22.9% | 38.3% | 22.5% | 38.1% |
| API回答里的引用 | 12.3% | 23.3% | 13.0% | 23.9% |
| Google加API候选 | 28.3% | 50.3% | 26.2% | 48.7% |
表里的“网站”按主机名算,并且保留子域名,blog.example.com和example.com算两个站。数字都是80道题各算一遍再取平均。
看这张表能得出三个结论。
Google排名几乎猜不中具体网页。前5页四十多条结果,只碰上ChatGPT引用网页的6%到9%。拿Google排名报表去推测“ChatGPT会引我哪篇”,基本等于看天气预报猜彩票号码。
API给的候选覆盖面最广,可它回答里引用的那几条更像ChatGPT。论文算了精确率,也就是API引用的网页里有多少同样被ChatGPT引用:GPT-5.3是16.4%,GPT-5.5升到23.3%;按网站算,从27.7%升到40.5%。这两处上升经过多重检验校正后仍然显著。SEJ报道里那句“GPT-5.5引用了API所引网页的23.3%”,说的就是这个精确率。
两个替身加在一起,按网页只能找回四分之一出头,按网站能找回将近五成。论文还多做了一个实体层级,就是从标题和摘要里抽出品牌、产品、机构这类名称来比,加起来的召回率是50.7%和45.1%,和网站层级差不多。
论文还拿这些外部信号训练了一个XGBoost分类器,预测候选里哪些会被引用。GPT-5.3在网页、网站、实体三个层级的AUC是0.782、0.763、0.743,GPT-5.5是0.779、0.763、0.742。AUC是0.5就等于抛硬币,0.78算有点用,但离精准差得远。
更要紧的是这个模型只能在替身找到的候选里排序。ChatGPT引用的网页里,七成多从来没进过Google和API的候选,模型排得再准,网页级召回的天花板也就26.2%到28.3%。
为什么网站比网页好猜?
论文给的解释是,ChatGPT每次拿回的具体网页变化很大,但网页背后的网站和实体相对稳定。同一个站可能这次被引产品页,下次被引博客文章,按网页比对不上,按网站比就吻合了。
放到实际监测里,这句话的分量不小。很多工具的报表按网址列“你被引用了哪几篇”,单看某一天的网址清单,噪声可能比信号还大。
同一个问题问20遍,引用会差多少?
差得挺多。论文把每道题20次运行里出现过的候选分成三档,只出现1次的叫一次性,出现14次及以上的叫稳定核心,中间的叫间歇出现。
| 指标 | GPT-5.3 Instant | GPT-5.5 Instant |
|---|---|---|
| 只出现1次的网页候选 | 40.8% | 44.5% |
| 稳定核心网页候选 | 9.4% | 7.7% |
| 每题20次累计不同网页数 | 96.4个 | 132.2个 |
| 两次运行之间网页重合度(Jaccard) | 0.303 | 0.292 |
| 两次运行之间网站重合度 | 0.408 | 0.402 |
| 两次运行之间实体重合度 | 0.421 | 0.404 |
GPT-5.5每题累计拿回的网页比5.3多三成多,稳定性却没提高。两次运行之间,网页候选的重合度只有三成左右。
这和站内之前写过的AI可见度排名每次查都不一样是同一个现象,这次换成了ChatGPT后台数据的直接证据。SEJ还提到另一篇CiteChoice预印本,同样的输入重跑一遍,有15%的“引不引”判断会翻转。
不过稳定性也不全是坏消息。论文用留一法检验发现,一个候选在其他19次里出现得越多,在第20次里被引用的可能越大。GPT-5.5在网页、网站、实体层级的AUC是0.651、0.709、0.711。反复出现本身是个信号,只是它只说明相关,不能推出“让页面多出现几次就会被引”。
重跑时还有个坑:模型会悄悄换掉
论文里有两个采集会话,分别在成功跑完14次和16次之后,被切到了降级模型,界面上并不明显。作者专门提醒,做重复测量时要逐条核对这次回答是哪个模型给的。
批量重跑的监测工具最容易中招,报表上写着GPT-5.5,后半截可能测的是别的模型。这跟体检抽血抽到中途换了个人差不多,数据看着齐全,结论全歪。
中文提问,ChatGPT却拿英文去搜,中文站和外贸站怎么办?
论文里最值得中文读者多看两眼的是这组数字。中文问题的运行里,GPT-5.2 Instant有96.8%同时发出中文和英文搜索词;到了GPT-5.3 Instant和GPT-5.5 Instant,67.0%和69.6%的运行只用英文搜。
改写的花样也随模型变。GPT-5.2 Instant每次运行都发多个搜索词,平均2.36个;GPT-5.3 Instant只有6.2%的运行发了不止一个,平均1.06个;GPT-5.5 Instant是31.3%,平均1.45个。三者多数时候都只搜一轮,多轮搜索的比例分别是17.4%、5.5%和3.8%。GPT-5.5发的词比5.3多,搜的轮数却没增加,等于一次撒网撒得更宽。
另外,GPT-5.3和GPT-5.5在能看到搜索词的运行里,没有一次是原封不动用用户原话去搜的,GPT-5.2还有5.5%。OpenAI的联网搜索帮助页写得很直白:ChatGPT和外部搜索服务合作时,通常会把你的问题改写成一个或多个更有针对性的搜索词,看了初步结果还可能再发更具体的查询。
这并非孤例。SEJ在2月报道过Peec AI的统计,非英文提问的扇出查询里有43%用的是英文。两份数据口径不同,Peec按查询条数算,论文按运行次数算,但方向一致。站内AI用你的语言回答、来源却是一水儿英文页面那篇讲的也是这件事。
先把这组数字的适用范围说清楚。中文题只有40道,来自Search Arena,题目偏什么领域论文没细分;测的是ChatGPT网页版,豆包、DeepSeek、Kimi这些国内产品不在样本里,不能直接套用。
在这个前提下,不同站点受的影响不一样:
- 做外贸和出海的英文站,本来就靠英文内容吃饭,这组数字算利好。海外买家哪怕用母语问ChatGPT,后台也很可能拿英文去搜,英文页面写得清楚,被检索到的机会就在。
- 只有中文内容的站点,在ChatGPT里的处境更难。用户用中文问,ChatGPT七成的时候根本不发中文搜索词,中文页面被搜到的机会小得多,更谈不上被引用。
- 做中英双语品牌的,要检查英文版有没有覆盖中文版的关键信息。论文抽实体时会把中文名称尽量映射成英文小写形式,品牌英文名不统一,实体层面的统计会被拆散。英文名、简称、官网写法最好在实体主页上统一好。
落到监测上,有一件马上能做的事,就是给中文提示词配一组英文对照。如果你的工具能记录ChatGPT实际发出的搜索词,就按搜索词而不是按你输入的提示词来分析覆盖。看不到搜索词的工具,至少把核心问题的英文说法也纳入跟踪,再看英文页面有没有出现在来源里。站内AI时代英文SEO的落地路线可以配合着看。
被引用的网页有什么共同点?
论文在ChatGPT网页版自己的候选池里比了被引和没被引的网页,几个结果和行业里流传的说法不太一样。
| 信号 | GPT-5.3 Instant | GPT-5.5 Instant | 怎么理解 |
|---|---|---|---|
| 检索摘要长度(AUC) | 0.612 | 0.625 | 弱但稳定,被引网页的摘要更长 |
| 摘要500字符以上的占比 | 被引16.5%,未引1.5% | 被引16.9%,未引1.9% | 长摘要集中在被引的那头 |
| 检索排位(AUC) | 0.561 | 0.623 | 排位靠前有帮助,但不起决定作用 |
| 排第15位以后仍被引的比例 | 24.0% | 19.0% | 排得靠后照样有机会 |
| 发布时间新旧(AUC) | 0.482 | 0.535 | 置信区间都包含0.5,看不出作用 |
摘要长这一条容易被误读。检索系统给的摘要越长,往往说明这段内容能单独拿出来当证据用,答案生成时更好引。作者也说了,长度不等于内容完整,它可能只是反映了网页类型、结构或排位。拿它当“文章越长越好”的依据就走偏了,更稳妥的读法是:关键段落要能脱离上下文独立成立,一段话把问题、数据和结论说全。站内ChatGPT引用什么内容那篇也得出过类似的结论。
发布时间那一条挺有意思。行业里常说AI偏爱新内容,可在这80道题里,新旧对引用几乎没有预测力。样本小、题型有限,不能据此说时效完全无关;新闻类问题和常青问题的差别,论文也没单独拆出来。但至少说明,靠改发布日期刷新鲜度,在这组数据里看不到效果。
还有一组数字反映出模型之间的差别。在分类器里,排位信号的权重从GPT-5.3的49.7%降到GPT-5.5的34.9%,曝光频率和引用转化率的合计从19.0%升到28.3%。换个模型,哪些信号重要就跟着变了。
来源类型和题型也有点差别。在两个模型都出现过的搜索、新闻、学术三类来源里,GPT-5.3被引比例最高的是新闻,有52.0%的候选至少被引过一次;GPT-5.5换成了学术,49.2%。四类题型里,事实查询的引用来源最稳定,两次运行之间重合度最高,其余三类排不出固定顺序。作者对这些属性的态度很克制,只当补充参考,不当通用规律。
API那边的规模也值得交代一下。gpt-5.3-chat-latest每次回答平均给出27.9个候选、5.8条网址引用,gpt-5.5是25.7个候选、5.4条引用。调用gpt-5.5时作者还把推理强度设成none,尽量贴近网页版Instant模式。配置这么接近,结果还是对不上,网页版和API之间差在哪,论文没有给出解释。
GPT-5.4 Thinking的搜法完全不同
思考模式是另一种节奏。GPT-5.4 Thinking每次运行平均发11.82个搜索词、搜3.20轮,71.3%的运行搜了不止一轮。信息汇总类问题多轮搜索的比例是87.6%,事实查询只有10.8%。
往后几轮越搜越窄:带site:限定的搜索词从第一轮的25.1%升到后续轮次的54.7%,带引号精确短语的从1.0%升到22.7%。思考模式会点名去某个站里找。站点在行业里有没有名气、能不能被模型想起来,这时候就显出分量了。这部分只有30道题,论文自己也把它当补充材料。
做GEO监测,具体该怎么改?
论文作者的建议和SEJ的总结一致:同时按网页和网站两个层级看、同一提示词多跑几次、考虑查询改写、换模型后重测。结合论文的数字,可以落成下面几条:
- 报表的主指标改成网站级和实体级。网页级引用清单保留,但当成线索看,不当成KPI。记得把子域名分开统计,否则blog子域和主站的数据会混在一起。
- 同一提示词至少重复跑多次再下结论。论文跑了20次,你未必需要这么多,但只跑一次的结果,四成多的网页下次就不见了。论文把20次里出现14次以上的候选算作稳定核心,自己定门槛时可以参照这个七成的比例。
- 每条回答都记录模型版本。批量跑的时候抽查后半段,防止中途被切到降级模型。
- 问清工具的数据来源。论文没测任何商业监测工具,SEJ特意提醒:工具给的网页级结果和ChatGPT对不上时,先问它的数据是走API还是走ChatGPT应用采的。按论文数字,API回答里引用的网页,只有16%到23%同样被ChatGPT网页版引用。
- 中文提示词配英文对照,有条件就分析实际搜索词。提示词库怎么搭,可以看站内的Prompt Tracking监测误区。
- 模型一换,基线作废重建。
最后一条有现成的例子。SEJ提到,5月GPT-5.5上线前后,Sistrix看到德语ChatGPT引用的日间变化跳到47%,平时只有1%到2%。论文所有数据都早于GPT-5.6和GPT-6,按OpenAI的模型帮助页,GPT-6正在向Plus、Pro、Business和Enterprise用户推送,免费版和Go版的默认模型换成GPT-5.6 Luna。站内ChatGPT换上GPT-6那篇写过界面层面的变化,引用层面的规律要等有人在新模型上重做一遍。
做竞品对比时也一样。站内AI可见度竞品分析全流程里讲的份额统计,按这篇论文的结论,网站级份额比网页级份额可信得多。多平台加权的问题见AI可见度分数怎么加权,模型变量的记录方式可以参考Gemini 4 Argon进入AI模式那篇。
这篇论文说明不了什么
论文是观察性研究,作者在第六节反复强调:它没有直接检验任何GEO策略,多发网页、让网页在检索里多出现,都不能推出被引概率会上升。80道题、两个主力模型、四个月的窗口,样本也有限。
另外,它测的是登录用户的ChatGPT网页版,地区、记忆功能、个性化设置都可能影响改写结果。OpenAI帮助页就写了,开了记忆功能时,ChatGPT改写搜索词会用到你保存过的信息,比如你说过自己吃素、住在旧金山,它可能直接去搜旧金山的素食餐厅。监测账号最好关掉记忆,并固定地区。
关于查询扇出本身的机制,站内查询扇出的机制与GEO覆盖对策和Ahrefs的ChatGPT查询扇出研究可以对照着看。Ahrefs那篇统计的是ChatGPT搜什么、搜不搜,这篇论文接着回答了搜到之后挑谁、替身能不能复现。两篇合起来,ChatGPT从改写、检索到挑源这一路就比较完整了。
回头看,这篇论文给监测行业泼的冷水挺实在:拿API或Google排名去模拟ChatGPT,网站层面还凑合,网页层面误差大到不能当真。还在按网址给客户出“本周新增引用”报表的,可以先把口径改一改。
常见问题解答
这篇论文是谁做的,可信吗?
作者来自新加坡国立大学和西安交通大学,10月11日以预印本形式发在arXiv,未经同行评审。方法和数据集都写清楚了,代码和数据放在匿名仓库,可以复核,但结论应当当作初步证据看。
论文里的引用和我在ChatGPT界面里看到的链接一样吗?
不完全一样。ChatGPT会把几个网页归成一组来源,论文把组里没有单独显示的辅助网页也算作被引用,所以口径比界面上能数到的链接宽一些。
用OpenAI API做GEO监测还有意义吗?
有,但要看层级。API候选在网站层级能覆盖ChatGPT网页版引用网站的38%左右,网页层级只有22%到23%。适合看网站和品牌的大致存在感,不适合逐个网址核对。
Google排名靠前,ChatGPT就会引用我吗?
不一定。论文里Google前5页结果只覆盖ChatGPT引用网页的6.4%到9.4%。在ChatGPT自己的候选里,排位靠前有一点帮助,排第15位以后的候选仍有约两成被引。
中文提问时ChatGPT为什么用英文搜?
论文只报告了现象:GPT-5.3和GPT-5.5的中文题运行里,约七成只发英文搜索词,没有分析原因。英文网页数量更多可能是一个因素,但论文没有验证。
同一个提示词要跑多少次才够?
论文每题跑了20次,把出现14次及以上的算作稳定核心。日常监测不一定要20次,但单次结果不可靠,四成多的网页只出现一次,至少多跑几轮再看出现频率。
换成GPT-6之后这些数字还成立吗?
不知道。论文数据采集于3月到7月,覆盖GPT-5.2到GPT-5.5,作者明确建议模型或服务环境变化后重新评估监测方法,GPT-6上的结果要等新的研究。
发布时间对ChatGPT引用有影响吗?
在这80道题里看不出影响,发布新旧的AUC是0.482和0.535,置信区间都包含0.5。样本有限,新闻类问题可能不同,不宜推广成时效完全无关。
权威参考资料
本文标题:《用OpenAI API监测ChatGPT引用准不准?新论文:网页只找回四分之一,按网站算能到五成》
本文链接:https://zhangwenbao.com/chatgpt-citations-openai-api-google-proxy-study.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0