小语种数字化程度有四张现成的分级表,73门语言查下来全挤在同一档
本文目录
- 你材料里那句“数字化程度低”,出处是哪张表?
- 这类说法通常只有一个来源
- 保哥这次拿了哪几把尺子
- 测量范围怎么划
- 先说结论
- 第一把尺子:濒危分级为什么在这批语言上是一条直线?
- 它的官方定义写着来源
- 全量分布长什么样
- 换到73门语言上
- 那7门是哪几门
- 第二把尺子:文献存量分级的最高档,定义到底是什么?
- 五个档位的字面意思
- 这一档在73门语言上的分布
- 为什么会这样
- 顺带一条容易被忽略的
- 那本语法书是哪一年写的?
- 这张表附带一条时间线
- 年份分布
- 爱沙尼亚语那一行
- 这不是数据库的错
- 第三把尺子:资源数这一列,刻度是从哪儿来的?
- 换一把看起来更对路的
- 但分辨的是另一件事
- 更反直觉的一条
- 这个反向有真实机制
- 还有第四套分级,它的档位更细,问题也一样吗?
- 13个档位听起来精细多了
- 但它量的还是同一件事
- 它跟前面那套是什么关系
- 那有没有哪套分级是为数字场景造的
- 三张表互相同意吗?
- 把它们两两算一遍
- 前四行说明什么
- 那个0.000要解释一下
- 最后一行才是重点
- 你在表里填的那个语言代码,查得到吗?
- 四个最常用的码查不到
- 更麻烦的是查得到但查错了
- 尼泊尔语这个例子最干净
- 这条跟本站写过的那两件事是一根线
- 同一门语言,在一张表里占几行?
- 先看一个翻倍的例子
- 还有几个
- 为什么这件事比看起来严重
- 可执行的做法
- 保哥这次量错了两回,错在哪?
- 第一次:年份序列是倒着排的
- 第二次:精确匹配撞上了宏语言
- 顺带一句尺子自检
- 那到底该拿什么当尺子?
- 先明确这些表能用在哪
- 该自己量的四个数
- 为什么自己量的数更好用
- 一个半天能跑完的最小版本
- 汇报的时候怎么讲
- 哪些相邻的问题不归这一层管?
- 语言能不能活下去,是另一个学科的事
- “数字语言死亡”那个命题也不归这里
- 引擎那半边不在这篇里
- 内容该怎么写也不归这一层
- 常见问题解答
- 这几套分级是不是过时了,新版本会不会好一点?
- 那能不能几套分级一起看,互相补足?
- 我的语言不在你这73门里,结论还成立吗?
- 资源数那一列能不能直接拿来排优先级?
- 不懂这些语言,我怎么自己验一遍?
- 用语言代码查表要注意什么?
- 这套做法多久该重跑一次?
- 权威参考资料
摘要:立项材料里那句“这门语言数字化程度低”,出处通常是一张现成的公开分级表。本文把三套被引用最多的分级拉到同一张表上,对73门做出海真会考虑的语言逐条比对。
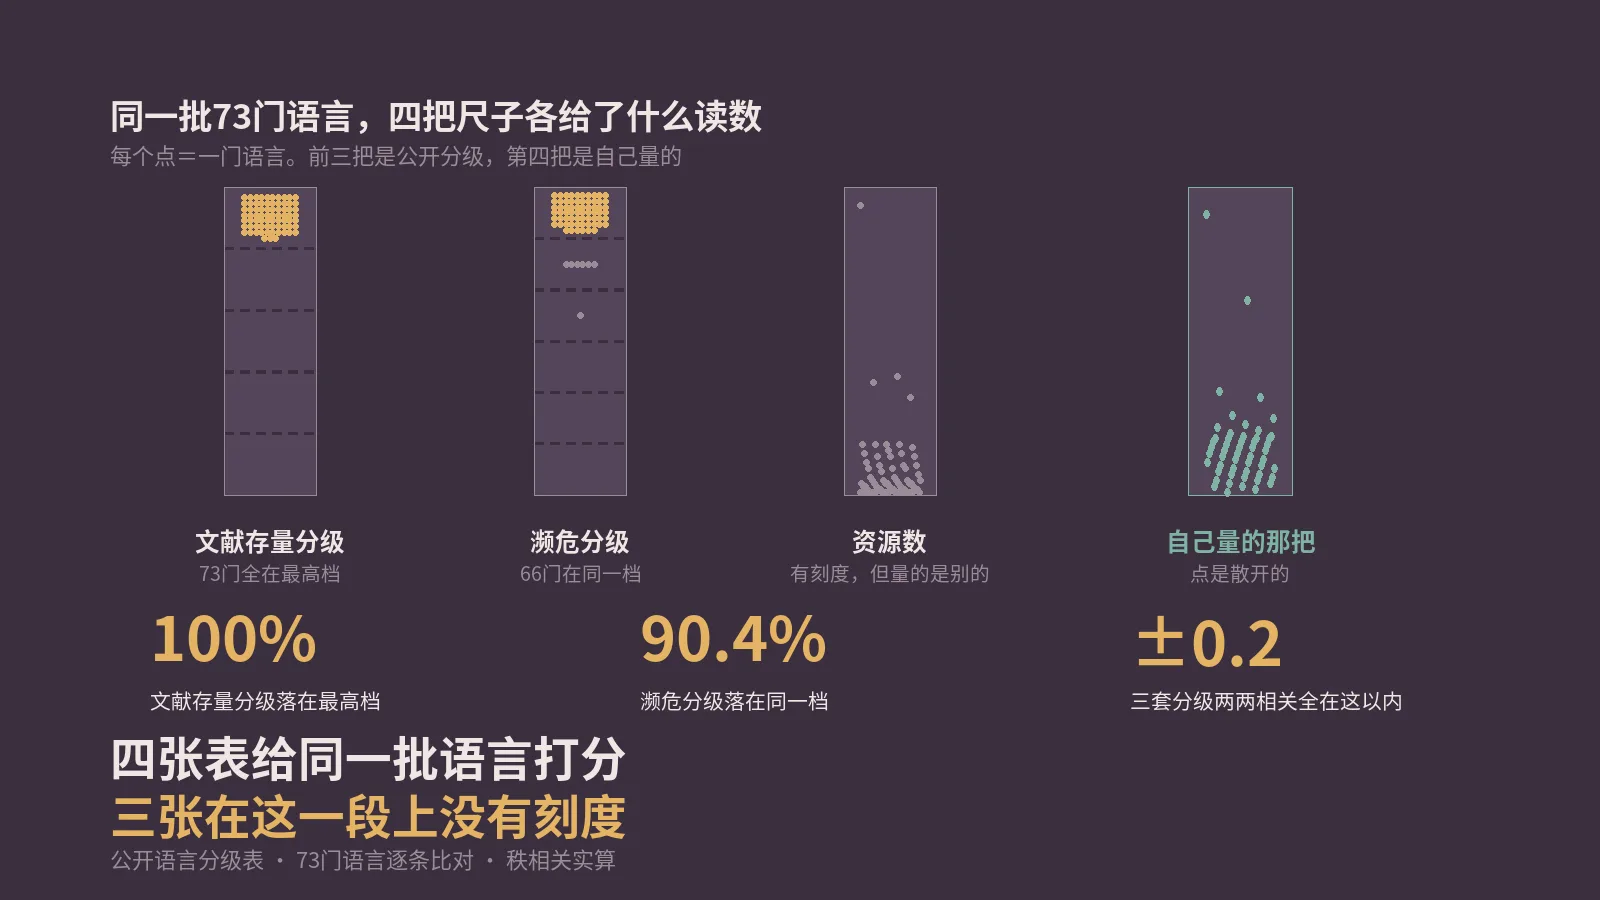
结果是:文献存量分级在这73门上100% 落在最高档,而全量同口径只有24.84%;濒危分级90.4% 落在同一档,全量只有35.34%。三套分级两两之间的秩相关全部落在正负0.2以内,等于互相独立;全场唯一一对真正相关的(ρ为−0.590)两边都不是分级,是实测。
文中还给出这些表最高档的官方定义、依据文献的年份分布、语言代码在表里查不到的四个常见例子,以及我自己在这次测量里错掉的两次。
去年冬天有个做户外家居的团队找过来,桌上摊着一份写了一半的立项材料。要开六个新市场,其中三门语言总部不同意做,理由写在材料第二页:这几门语言数字化程度低。
我问那句话是从哪儿来的。对方翻了翻,找出一个链接,是一张公开的语言分级表,每门语言后面跟着一个档位。三门语言的档位确实都不高。
然后我们一起打开那张表,把他们已经在做、做得还不错的四门语言也查了一遍。四门里有三门的档位跟那三门被否掉的一模一样。
这件事后来变成了一次完整的测量。保哥把被引用最多的几套语言分级拉到同一张表上,按做出海真会考虑的语言范围逐条比对。结论比那天会议室里的场面更难看一点。
你材料里那句“数字化程度低”,出处是哪张表?
这类说法通常只有一个来源
做多语言市场排期的时候,总要回答一个问题:这门语言值不值得投。人口、GDP、电商渗透率这些数都有现成的,唯独“这门语言在数字世界里活得怎么样”没有现成的。
于是大家都会去找那张表。语言学界确实做了好几套,公开、免费、可下载,每门语言后面跟一个档位,看着就像为这个问题准备的。
问题是这几套表不是为这个问题造的。它们各自有自己的目的,而那个目的跟你要做的判断隔着相当远的距离。远到什么程度,得把数摆出来才说得清。
这里有个容易被忽略的前提:一张表被广泛引用,说明它在自己的领域里做得好,不说明它能回答你的问题。引用次数多和适用于你,是两件独立的事。
保哥这次拿了哪几把尺子
三套公开的:一套濒危分级、一套文献存量分级、一套语言技术资源清单。前两套来自同一个语言学数据库,第三套来自一个欧洲的语言资源平台。
第四套是自己的:本站过去两年在这个栏目里做过的逐语言实测,包括同一段话在不同语言里要多少token、界面语言包翻到了几成、随机一页一年被真人打开几次、搜索建议在交易词上还剩多少。
这四项的共同点是都能自己跑完,不需要任何机构授权,也不需要懂那门语言。这一点后面会展开,因为它决定了这套办法能不能落到日常排期里。
前三套是别人给的分数,第四套是自己量的数。这次要看的就是这两类东西能不能对得上。
之所以要把自己量的那组也放进来,是因为光证明几张公开表互相矛盾还不够。矛盾可能只说明它们各测各的,不说明哪一套更接近你要的答案。要判断这一点,得有一组你确知口径的数当参照物。
测量范围怎么划
全世界在册的语言七千多门,但做出海的人真正会放进候选池的没那么多。我取了73门:本站写过专篇的三十几门,加上印度、东南亚、非洲、中东欧几个区域里体量够得上的,再加英语和官话当参照系。
这个范围很关键。后面所有的结论都只在这个范围里成立,换个范围结论会变——这一点本文会反复强调,因为这正是那几张表被用错的根本原因。
说得再直白一点:这几张表覆盖七千多门语言,而你的候选池大概三十门到一百门。你取的是它右边尾巴上很窄的一小段,而一把尺子在整体上有刻度,不代表在你截取的那一小段上还有刻度。
先说结论
三套分级在这73门语言上互相不同意,而且不同意的程度接近于随机。其中一套在这个范围内完全没有刻度,73门全落在同一格。
更实际的一条推论是:如果你正打算在材料里写“多套权威分级都指向同一结论”,这句话在这个语言范围内站不住。后面会用秩相关把这句话量出来。
第一把尺子:濒危分级为什么在这批语言上是一条直线?
它的官方定义写着来源
这套分级叫做聚合濒危状态,六个档位,从“未濒危”一路排到“已消亡”。Glottolog的GlottoScope说明页把它的来源写得很清楚:主要聚合自濒危语言目录、联合国教科文组织的濒危语言图集,以及Ethnologue。
三个来源,全部是为濒危语言造的。这句话本身就已经回答了后面所有的问题。
造这套尺子的人要回答的是“这门语言还有没有孩子在学”。这个问题严肃、重要,而且跟“这门语言的用户会不会在网上买东西”几乎正交。一门语言可以有几千万人天天用它刷手机,同时在代际传承上毫无风险,于是它在这把尺子上永远是同一个读数。
全量分布长什么样
按官方口径,7839门语言里:未濒危2770门占35.34%,受威胁1565门占19.96%,正在转用1799门占22.95%,濒临消亡421门占5.37%,接近灭绝300门占3.83%,已消亡984门占12.55%。
六个档位分布得相当均匀,看起来是一把刻度很细的尺子。我第一次看到这张表的时候也是这么想的。
顺便说一句,这组数字是可以对账的。我用公开数据仓库自己筛了一遍,按官网说明的口径(只算母语口语语言和手语)算出来的总数也是7839,六个档位的门数和百分比逐行一字不差。这说明我的分母跟官方同源,后面的比例都能被读者自己复核。
换到73门语言上
66门落在“未濒危”,占90.4%。剩下7门:6门受威胁,1门正在转用。
全量里“未濒危”只占35.34%,到了这73门里变成90.4%,是2.56倍。也就是说,这把尺子六个档位里的五个,在你关心的语言上基本用不到。
把这个数换个说法可能更直观:你从候选池里随手抽一门语言去查这张表,有九成的概率拿到同一个答案。一个九成概率给出同一答案的指标,放进决策表里占一列,实际上是在占位置而不是在提供信息。
那7门是哪几门
被标成受威胁的是拉脱维亚语、加泰罗尼亚语、斯洛伐克语、巴斯克语、威尔士语、乌克兰语;被标成正在转用的是克罗地亚语。
这个名单值得停下来看一眼。乌克兰语本站写过整篇,讲的是一个必须两套内容并行的真实市场;克罗地亚语也写过整篇。它们在这张表上的位置,跟做生意的人对它们的判断正好反着。
不是这张表判错了。乌克兰语的代际传承状况确实受过冲击,这是事实;克罗地亚语在部分使用者那里让位给别的语言,这也是事实。只是这两条事实跟“要不要为这个市场做内容”之间没有可推导的关系,而材料里那一栏偏偏就是这么用的。
第二把尺子:文献存量分级的最高档,定义到底是什么?
五个档位的字面意思
这套分级叫最详尽描述,缩写MED,衡量的是“这门语言最详尽的一份语法描述达到了什么程度”。官方定义列在同一页上,翻译过来是这样的:
| 档位 | 官方定义 | 全量门数 | 占比 |
|---|---|---|---|
| 长语法书 | 超过300页的语法书 | 1961 | 24.84% |
| 语法书 | 少于300页的语法书 | 1004 | 12.72% |
| 语法概要 | 语法概要 | 2024 | 25.64% |
| 音系或文本 | 新约圣经、文本、音系、某个特征的类型学研究,或词典 | 1403 | 17.77% |
| 词表或更少 | 词表或更少 | 1502 | 19.03% |
把最高档那一行再读一遍:超过300页的语法书。这就是全部的判据。
300这个数字不是随口定的,它是个操作性阈值,为的是让几万条文献能被自动归档。对做语言学文献计量的人来说这很合理。对拿着这张表决定要不要开市场的人来说,它的意思是:一本1890年出版的320页语法书,和一套2024年的完整语言技术栈,在这一列里是同一个值。
这一档在73门语言上的分布
73门,全部落在最高档。不是90%,不是95%,是73门里的73门。
全量同口径里这一档占24.84%,在这个范围里变成100%,是4.03倍。这把尺子在这段区间上不是刻度粗,是根本没有刻度。
这一条比濒危分级那条更彻底。濒危分级好歹还有7门语言给出了不同的读数,文献存量这一列是一个常数。一列常数放进任何模型、任何排序、任何加权打分,贡献都是零,但它在表格里看起来跟别的列一模一样。
为什么会这样
因为“有没有人写过一本300页以上的语法书”这件事,跟“这门语言今天在网上能不能做生意”几乎没有关系。前者是十九世纪到二十世纪语言学积累的结果,后者是过去二十年互联网积累的结果,两件事发生在不同的年代,由不同的人做。
凡是你会考虑拿来卖货的语言,多半在一百年前就已经有人给它写过厚语法书了。所以这一档对它们来说是默认通过,不是区分。
反过来说,这把尺子在它自己的适用范围里是非常有用的:全量七千多门语言里有1502门落在“词表或更少”,占19.03%。对做语言记录、做低资源语言技术的人来说,这一列每一格都在提供信息。它只是不在你站的那一段上提供信息。
顺带一条容易被忽略的
倒数第二档的定义里写着“新约圣经”。也就是说,在这套语言学的文献分级里,“有一本新约译本”是一个正式的档位。这条线索本身就说明了这些体系在关心什么——它们关心的是这门语言有没有被记录下来,不是它有没有人在用它下单。
这条线索后面还会以另一种形式冒出来。一门语言最早被系统记录下来的那批文本是什么,往往决定了它今天在各种语言技术资源里的底子是什么。这是另一篇的题目,这里先按下。
那本语法书是哪一年写的?
这张表附带一条时间线
同一份数据里还有一列,记着每门语言的最详尽描述随时间的变化,每一条都带着出版年份。把73门语言各自最新那一本的年份拉出来,能回答一个更要命的问题:这个判断是什么时候做出的。
年份分布
中位数1996年,四分位是1963年和2008年。最老的1875年,最新的2025年。
按年代分档看得更清楚:1950年以前7门,1950到1969年12门,1970到1989年8门,1990到2009年27门,2010年以后13门。最新的那一批是波斯语2025、意大利语2022、希伯来语2020、挪威语2018、加泰罗尼亚语2017、缅甸语2016、标准阿拉伯语2015、南非荷兰语2015。
其中20门语言的最新描述早于1970年,占27.4%。名单列一部分:爱沙尼亚语1875、高棉语1915、老挝语1917、孟加拉语1926、丹麦语1928、保加利亚语1949、冰岛语1949、捷克语1953、匈牙利语1955、泰语1957、拉脱维亚语1959、印地语1961、斯瓦希里语1963、泰米尔语1966、官话1968。
爱沙尼亚语那一行
这一行值得单拎出来。爱沙尼亚是欧洲数字化程度最高的国家之一,电子政务办了二十多年。而这套分级给爱沙尼亚语的判据,是一本1875年的书。
丹麦语是1928年。要是拿这一列去排“哪门语言的数字基础好”,丹麦语会排在一批你没听说过的语言后面。
再看几个:高棉语1915、老挝语1917、孟加拉语1926。孟加拉语的使用者两亿多,分布在两个国家,本站为它单独写过一篇讲国界两侧词汇分叉的文章。一本1926年的书当然不会知道这些。
这不是数据库的错
说句公道话:这套分级从来没说过自己在测数字化程度。它测的是文献存量,而且测得很准。它的全部数据都在一个公开仓库里,每一条都挂着具体的文献引用,谁都能复核。
出问题的是引用它的人。一张为语言学文献计量造的表,被搬进了商业立项材料,而中间没有人问过一句“这张表的最高档是什么意思”。
这个动作有个共同的形状:从一个可信的来源取一个可信的数字,然后把它放到一个它没有承诺过的语境里。数字本身没变,可信度看起来也没变,变的是它在回答什么问题——而这一层变化在表格里是看不见的。
第三把尺子:资源数这一列,刻度是从哪儿来的?
换一把看起来更对路的
前两把明显不是为这件事造的。那换一把直接数资源的呢——某门语言有多少份可用的语言技术资源,这总该跟能不能做有关系了。
欧洲有个叫European Language Grid的语言资源平台,把语料、模型、工具都编了目,可以按语言查。我拉了它的全量分面,911门语言,一万八千多份资源。这一列终于有分辨力了:英语6343份,西班牙语2577,德语2427,一路排下去到个位数。
这一列的好处是它数的是真东西:一份语料、一个模型、一个工具,各算一份,谁都能去平台上点开看。它跟前两把尺子的性质完全不同,前两把是专家给的判断,这一把是清点出来的数量。
但分辨的是另一件事
把73门语言按欧洲和非欧洲分成两组,欧洲组的资源数中位数714,非欧洲组84,差8.4倍。
非欧洲语言里最高的三门是官话486、阿拉伯语436、土耳其语324——三门加起来还不如芬兰语一门(1125)。芬兰语的使用者大约五百多万。
再往下是日语320、韩语258、印地语228、波斯语204、越南语179、印尼语176。这几门语言背后的互联网人口加起来十几亿,在这一列上的总和不到英语一门的四分之一。
再往下看几行也是同一个形状:斯洛文尼亚语939份排在荷兰语896前面,爱沙尼亚语839排在匈牙利语745、俄语714前面。这几对的排序,用任何一种“语言使用规模”的口径都解释不了。
这不是说这个平台做得不好,它是个欧洲项目,编目欧洲的资源天经地义。问题在于,你要是拿它当“语言数字化程度”的代理指标,量到的其实是“这门语言在不在欧盟的资助范围里”。
这类偏差有个特点:它不会把数字弄错,只会让数字回答另一个问题。你在表里看到的每一个数都是真的,加总、排序、算比例都没毛病,唯一的问题是这一列的表头应该改个名字。
更反直觉的一条
前面那7门被标成受威胁或正在转用的语言,在这个平台上的资源数中位数是540。而66门被标成未濒危的,中位数是175。
被标成“情况不妙”的那批,语言技术资源反而是“情况正常”那批的3.09倍。
这就是前面那个−0.153的来源。相关系数本身很小,容易被当成“没关系”,但它的负号是有内容的——如果只看系数大小而不看方向,会漏掉这条机制。
这个反向有真实机制
不是巧合。欧盟的少数语言保护经费,恰恰是按“这门语言受不受威胁”来分配的。一门语言被标成受威胁,它就更可能拿到做语言技术的项目钱,于是资源数上去了。
所以这两把尺子的负相关是制度造出来的,不是语言本身的性质。拉脱维亚语675份、爱尔兰语662份、加泰罗尼亚语660份——这三个数字记录的是资助政策,不是使用状况。
可执行的推论是:这一列只能在同一个资助体系内部横向比。拿爱尔兰语跟威尔士语比是有意义的,它们面对同一套经费规则;拿爱尔兰语跟泰语比就没有意义,两者根本不在同一个池子里抢钱。
还有第四套分级,它的档位更细,问题也一样吗?
13个档位听起来精细多了
前面三套之外还有一套被引用得很广,叫扩展分级代际中断量表,缩写EGIDS,Ethnologue的方法论页把13个档位的定义列成了一张表。
13档比6档细一倍还多,看上去应该更有分辨力。它的第0档叫“国际性”,定义是这门语言被广泛用于跨国贸易、知识交流和国际政策;往下依次是全国性、区域性、有文字传统、在教育中使用,一路排到已消亡。
但它量的还是同一件事
把这13档的定义连起来读一遍就会发现,整条量表是围绕“代际传承有没有中断”排的,这一点连名字里都写着。上半段几档区分的是这门语言在多大范围内被正式使用,下半段区分的是它还剩多少使用者。
这两件事对做市场的人来说是同一格:凡是你会考虑的语言,都在上半段。区分度更细没有用,因为细化发生在你用不到的那一段。
它跟前面那套是什么关系
本文用的六档聚合版,官方说明里写着它的上游之一就是Ethnologue。也就是说这两套不是互相独立的第二个意见,后者是前者的输入。
这条值得单独记一下:在材料里同时引用这两套,看起来是两个来源相互印证,实际上是同一条信息被数了两遍。判断两套分级独不独立,得去翻它们各自的来源说明,而不是看它们是不是不同的机构发布的。
那有没有哪套分级是为数字场景造的
有人试过。学界讨论过语言在数字世界里的存续问题,也有人提出过按“这门语言有没有被用于日常数字交流”来分档的方案。但这类方案的档位通常只有三到四格,而且判据本身就依赖网页和社交平台的可抓取性,在小语种上正是最不可靠的那部分数据。
换句话说,越是贴近你要的那个问题的分级,越依赖跟你同一批难以获取的数据。这不是巧合,是这件事本身就难。真要一个可靠的答案,还是得自己去量。
三张表互相同意吗?
把它们两两算一遍
用秩相关来算,因为几套分级的量纲完全不同,只能比排序。结果如下:
| 哪两把尺子 | 样本数 | 秩相关ρ |
|---|---|---|
| 濒危分级 × 资源数 | 73 | −0.153 |
| 文献存量依据年份 × 资源数 | 73 | +0.196 |
| 濒危分级 × 文献存量档位 | 73 | 0.000 |
| 濒危分级 × 文献存量依据年份 | 73 | −0.106 |
| 资源数 × 本站实测的token倍数 | 52 | −0.590 |
前四行说明什么
三套公开分级两两之间,相关系数全部落在正负0.2以内。这个量级跟随机排两列数字差不多。
需要说清楚的是,这不能证明它们“都是错的”。互不相关完全可以是因为它们各自测得很准,只是测的是三件不同的事——这也正是本文的判断。区别在于,三件不同的事不能当成同一件事的三次独立确认。
这条结论有个很实际的推论:如果你在材料里写“好几套权威分级都说这门语言不行”,这句话没有你以为的那种叠加效力。三套互不相关的判断放在一起,不等于三重证据,更接近于三次独立的抛硬币。
那个0.000要解释一下
濒危分级和文献存量档位之间是0.000,不是因为它们毫无关系,是因为文献存量在这73门上全是同一档——一列常数跟任何东西的相关系数都是零。这是前面那条“没有刻度”的数学表现。
我第一次看到这个整齐的零,第一反应是脚本写错了。查下来是真的:这一列73个值一模一样。
顺便记一条排查经验:相关系数算出一个整齐的0.000,八成不是巧合,而是某一列没有方差。先去数那一列有几个不同的取值,比检查相关系数的代码快得多。
最后一行才是重点
全场唯一一对真正相关的,是资源数和本站自己量的token倍数,ρ为−0.590。这两边都不是专家分级,都是数出来的:一边数资源条数,一边数同一批句子切成了多少token。
−0.590不算强相关,放在别的场景里甚至称不上可靠。但在这张表上,它比另外四行高出一个数量级,而这四行代表的是被引用最多的几套语言分级体系。
方向也对得上:资源越少的语言,同样一段话越贵。老挝语是全表token最贵的(8.23倍),资源数24份;德语1.31倍,资源数2427份。
中间那一段也顺:阿姆哈拉语5.82倍对63份,高棉语3.34倍对40份,缅甸语3.16倍对43份;另一头葡萄牙语1.23倍对1040份,印尼语1.25倍对176份。这条关系不完美(印尼语那一格就偏了),但它是全场唯一一条你能说出机制的关系:资源少的语言进不了分词器的词表,于是同样的意思被切成更多碎片。
你在表里填的那个语言代码,查得到吗?
四个最常用的码查不到
做这次比对的时候撞上一件挺离谱的事:ara(阿拉伯语)、fas(波斯语)、est(爱沙尼亚语)、zho(汉语)这四个码,在这套数据库的ISO码字段里一条都匹配不到。
要查到得换成arb、pes、ekk、cmn。而前四个才是你在hreflang、在语言标签、在商品数据里天天写的那一批。
原因不难理解:那四个是宏语言代码,指的是一族语言而不是一门;数据库按单门语言建条目,自然不会给宏语言码留位置。理解成因不难,难的是没有任何东西会提醒你这件事,你查不到就只会以为这门语言不在表里。
更麻烦的是查得到但查错了
还有45个ISO码,在这套数据库里挂在“语族”这一层而不是“语言”这一层,包括mon(蒙古语)、nep(尼泊尔语)、sqi(阿尔巴尼亚语)、ful、aym、cre、tmh、din、zap。另有280个挂在“方言”那一层,包括srp、hrv、nob。
挂错层不会报错,你照样能查到一个档位。只是那个档位说的不是这门语言。
而语族条目的档位是按这个语族里最不为人知的那个成员算出来的。所以这类误查有固定的方向:几乎总是把档位读低,很少读高。要是你正拿这张表找“不该投的语言”,这个偏差正好会帮你把一批语言错误地否掉。
挂在语族层的那45个码里,除了前面点到的几个,还有富拉语、艾马拉语、克里语、图阿雷格语、丁卡语、萨波特克语、科米语、马里语这一批。它们的共同点是都覆盖多个有明显差异的变体,于是编目的人选择建一个语族条目而不是一门语言。
尼泊尔语这个例子最干净
用nep查,命中的是一个语族条目,文献存量档位是“词表或更少”,最低档。
用npi查,命中的是尼泊尔语本身,文献存量档位是“长语法书”,最高档。
同一门语言,两个都合法的官方代码,一个查出最低档,一个查出最高档。你在材料里写哪个数,取决于你手上那份语言清单是谁给的。
更麻烦的是这两个码在别的地方是通用的。ne这个两位码在hreflang里、在浏览器语言列表里、在绝大多数商品数据后台里都指尼泊尔语,没有任何一处会告诉你它对应的三位码是nep而不是npi。
这条跟本站写过的那两件事是一根线
宏语言和个体语言的这道缝,本站在语言代码退役与合并那篇里讲过成因,在谁在替这门语言申请代码那篇里讲过是谁在维护这套东西。这次它以第三种形式出现:不是代码本身出问题,是查表的时候用错了那一行。
同一门语言,在一张表里占几行?
先看一个翻倍的例子
那个欧洲资源平台按语言名做分面。我第一次统计塞尔维亚语,拿到288份。
后来把相关的行都找出来:塞尔维亚语288、克罗地亚语636、波斯尼亚语86、塞克波语50,合计1060。这四行讲的是同一个语言连续体,本站在保加利亚语和塞尔维亚语那篇里拆过它的内部结构。
按一行数是288,按四行数是1060,差3.7倍。两个数都不能说是错的,取决于你认为“一门语言”是什么。
而“一门语言是什么”这个问题,在这个语言连续体上恰恰是最没有共识的。不同的表按不同的答案建行,于是同一批资源在一张表里聚成一行,在另一张表里散成四行。
还有几个
挪威语在这个平台上是三行(挪威语285、书面挪威语197、新挪威语108,合计590);斯瓦希里语两行(50和32);马来语两行(44和2);尼泊尔语两行(50和1)。
尼泊尔语那两行的比例值得留意:50比1。要是你碰巧匹配到了后面那一行,会得出“这门语言只有一份资源”的结论,跟真实情况差51倍。而两行的名字只差括号里的一个词。
为什么这件事比看起来严重
因为做横向比较的时候,你不会去查每一门语言在这张表里被切成了几行。你会直接拿分面上的数字排个序,然后告诉老板哪门语言资源多哪门少。
而切法在每张表里都不一样。同一个语言连续体,在文献存量那套里是一门(最高档),在这个资源平台上是四行。你用哪张表的行去数,数字就差几倍。
这件事跟前一节的语言代码是同一个问题的两面:一个是查的时候取错了行,一个是数的时候漏了行。根子都在于“语言”这个单位在不同体系里边界不同,而所有这些体系都用同一套代码互相引用,看起来像是能对得上。
可执行的做法
查任何一张语言表之前,先花十分钟把你要查的那门语言在这张表里的所有相关行找出来,而不是只查一个名字。判据很简单:搜语言名,看返回几条,逐条打开看它们是什么关系。
保哥这次量错了两回,错在哪?
第一次:年份序列是倒着排的
那一列文献时间线,格式是“文献编号[年份]”用分号连起来的一串。我想取最新的那一本,顺手取了末项。
跑出来德语的最新语法书是1800年,瑞典语是1650年,73门语言的中位数是1890年。这个结果当时看着极有冲击力,我差点直接写进结论。
拦住我的是德语那一行。德语在1800年之后显然有过无数本语法书,这个数不可能对。打开原始记录一看,那串年份是倒序排的,首项才是最新。德语实际是1997年,瑞典语1999年,中位数1996年。
固化成一句:任何一列年份序列在用之前,先拿一门你已经知道答案的语言试一次,确认它是正序还是倒序。这次要不是德语的数字离谱到一眼能看出来,这篇文章会以一个假结论开头。
值得记下来的是这个错误当时有多诱人。1890年这个中位数比真实的1996年更有冲击力,更适合当标题,而且它指向的结论方向跟真实结论完全一致——只是程度被夸大了一百年。方向对而程度错的结论最难自查,因为它符合你的预期。
第二次:精确匹配撞上了宏语言
统计资源数的时候,我用语言英文名做精确匹配。尼泊尔语跑出来0份。
0是个很危险的数,因为它读起来像个结论——“这门语言在欧洲资源平台上一份资源都没有”,写进文章里相当扎眼。
本站在别的批次里反复撞过这一类:任何量出来的零,先要排除三种可能——网络没通、字段是空的不是零、你的匹配条件根本没命中。确认是真零之后,它才是个结论。
实际是那个平台把尼泊尔语拆成了两行,一行叫“尼泊尔语(宏语言)”,一行叫“尼泊尔语(个体语言)”,两行都不等于我匹配的那个字符串。合起来51份。
这两次失效的根子是同一个:语言代码的宏语言和个体语言二分。一次让我查到了语族条目的档位,一次让我什么都没查到。这道缝在不同的表里以不同的形式咬人,但咬的是同一处。
这也是本文建议“查表先找全所有相关行”的直接来源。这个动作看起来啰嗦,但它同时挡住了上面两种错误,成本是每门语言多花几分钟。
顺带一句尺子自检
吃过这两次亏之后,我把统计口径按官方说明重筛了一遍,再跟官网公布的全量分布对账:濒危分级的总数我算出7839,官网也是7839,六个档位的门数和百分比逐行一字不差。文献存量那套我算出7894,官网7890,差4条,是数据仓库比网页版新了一点。
这一步花了二十分钟,买到的是后面所有百分比都能被读者自己复核。本站在按编辑人数算竞争强度那篇里吃过分子分母不同源的亏,这次是主动补的作业。
那到底该拿什么当尺子?
先明确这些表能用在哪
它们不是没用,是用错了地方。濒危分级在判断“这门语言二三十年后还有没有母语使用者”这件事上是可靠的;文献存量分级在判断“找不找得到这门语言的语法参考”上是可靠的——后者对招母语审校、给译者写简报是真有价值的。
问题只在于,这两件事都不是“要不要为这门语言建站”。
还有一个正当用途是当反向筛子。如果某门语言在文献存量上落到了“词表或更少”,那确实说明你会遇到实打实的麻烦:找不到语法参考、招不到有资质的审校、术语没有可依据的来源。这时候这张表是准的,而且是唯一现成的预警。
该自己量的四个数
本站这两年逐语言量过的东西里,有四个跟排期决策直接相关,而且都能自己跑:
第一个是同一段内容在这门语言里要多少token,直接决定AI改写和翻译的单价,本站量过70门语言的完整倍数表。第二个是你用的那套系统的界面语言包翻到了几成,决定用户看到的是不是半洋不土的页面。
第三个是站内搜索和拼写纠错依赖的那几个公共资源文件最后一次有人动是什么时候,决定站内体验要多花几天工时。第四个是搜索建议在交易词上还拉不拉得出来,本站在老挝语那篇和僧伽罗语那篇里各跑过一遍,两门语言的答案差43倍。
这四个数有个共同点:它们都直接对应一笔具体的开销或者一个具体的功能缺口。token倍数对应账单,语言包完成度对应用户看到的页面,词典文件对应工时,搜索建议对应你能不能建出词表。没有一个需要先转换成“数字化程度”这种中间概念再往下推。
为什么自己量的数更好用
不是因为它更准,是因为它的口径是你自己定的,你知道它在测什么。那几张公开分级最大的问题不是数字不对,是你不知道那个数字在回答什么问题。
这句话可以再推一步:一个指标能不能进决策表,判据不是它权不权威,是你能不能把它的定义用一句话讲清楚,并且这句话跟你要做的决定直接相关。讲不清楚就别放进去,哪怕它来自一个很有名的机构。
还有一个现实的理由:前面那个−0.590说明,两把自己量的尺子之间是能对上的。互相能对上的指标才有资格组成一张决策表。
一个半天能跑完的最小版本
挑五门候选语言,每门语言量三个数:token倍数(拿公开平行语料自己切一遍,半小时)、界面语言包完成度(翻译平台上直接看得到,十分钟)、八个交易词的搜索建议条数(手工查,一门语言二十分钟)。
三列数摆出来,比任何一张公开分级都更能告诉你这五门语言的实际差距。做完之后再回头看那几张表,你会发现它们给的是同一个答案,而这个答案对你的排期没有任何信息量。
如果还想再加一列,推荐加“这门语言的页面一年被真人打开几次”。本站量过这一列,同一批语言之间的差距能到两位数倍,而且它跟内容存量那一列的方向经常是反的。
汇报的时候怎么讲
不要说“那张表不准”,这句话既不对也说服不了人。要说的是:那张表测的是文献存量,我们要判断的是能不能做生意,这两件事的相关性我算过,接近于零。
然后把你自己量的三列数摆上去。本站在语言组合盘点那篇里说过,一张排期表真正会变的只有少数几列——这几列恰好全是要自己量的那种。
还有一个说法在会议室里管用:把那张公开表也留在材料里,但把表头改对。不要写“数字化程度”,写“文献存量档位”,后面加一句这一列在候选语言上全是同一个值。改完之后没人会再拿它当否决理由,因为它自己就说明了自己没有区分度。
哪些相邻的问题不归这一层管?
语言能不能活下去,是另一个学科的事
本文通篇在说这些分级不适合做商业判断,但它们在自己的领域里是严肃的工作。Ethnologue的方法论页用13个档位来描述语言的代际传承状况,聚合濒危分级的那份来源清单则把每一条判断挂到了具体的出处上。这些工作跟本文的结论不冲突,它们回答的本来就是别的问题。
“数字语言死亡”那个命题也不归这里
学界很早就讨论过一门语言会不会在数字世界里消失,有一篇叫《数字语言死亡》的论文给出过一套估算。那是一个几十年尺度的问题,而你的排期表管的是未来12个月。尺度对不上的指标,方向对了也用不上。
引擎那半边不在这篇里
搜索引擎在这门语言上的处理能力怎么样、结果页长什么样,跟本文说的资源清单是两套账。那一层归平台与多引擎那个栏目,本文不重复讲。
内容该怎么写也不归这一层
分级表只能帮你决定做不做,做了之后怎么写才像本地人写的、词表怎么建,是完全独立的工作量。本站在关键词工具返回零的时候怎么补数那篇里讲过在没有现成数据的语言上该怎么开工。
常见问题解答
这几套分级是不是过时了,新版本会不会好一点?
不会,因为问题不出在版本上。文献存量分级的最高档定义就是“超过300页的语法书”,这个定义再更新多少次,你关心的那批语言还是会全部落在最高档——它们在一百年前就已经满足这个条件了。饱和不是数据陈旧造成的,是判据本身跟你的问题无关。
唯一会变的是依据文献的年份那一列:有人给某门语言写了新的厚语法书,这一列就往后挪。但档位不会动,因为它已经在顶上了。
那能不能几套分级一起看,互相补足?
本文算过它们两两之间的秩相关,全部落在正负0.2以内。互不相关的几个指标放在一起,得到的不是更完整的图像,是三个互相矛盾的答案,而你会不自觉地挑那个支持你已有结论的。要合并使用的前提是先证明它们测的是同一个东西,这次的数据说明它们不是。
如果一定要合并,正确的做法是先讲清楚每一列在测什么,再让它们各自负责一个不同的判断:濒危分级负责“二三十年后还有没有人说”,文献存量负责“找不找得到语法参考”,资源数负责“在这个资助体系里排第几”。三个判断各自成立,但没有一个是“要不要开这个市场”。
我的语言不在你这73门里,结论还成立吗?
要看你的语言落在哪一段。如果它是一门有成规模现代书面使用的语言,本文的结论大概率成立,你可以自己查一遍:如果文献存量档位是最高档、濒危档位是未濒危,那这两把尺子对你就没有信息量。如果你的语言确实落在中低档,那这两把尺子反而是准的,只是它告诉你的事情比你想的严重得多。
判断落在哪一段有个粗筛:这门语言有没有全国性的日报和电视新闻,有没有中学阶段用它编的教材。两样都有,基本可以确定它在这两把尺子上都会顶格。
资源数那一列能不能直接拿来排优先级?
不建议单独用。欧洲组和非欧洲组的中位数差8.4倍,这个差距主要来自资助政策而不是语言本身。可以用的方式是在同一个区域内部比,比如在中东欧几门语言之间比,横跨区域比就会得到系统性偏差的结论。
还有一个用法是看趋势而不是看绝对值:同一门语言在这个平台上的资源数逐年涨得快,说明有项目在持续投它,这对判断未来两年的工具链会不会变好有参考价值。
不懂这些语言,我怎么自己验一遍?
三步,不需要任何语言知识。第一步,把你候选池里的语言逐个到那个语言学数据库里查文献存量档位,如果全是最高档,这把尺子对你作废。第二步,同样的语言去查濒危档位,如果大部分是未濒危,第二把也作废。第三步,把你自己能量的两三个数摆出来,看它们彼此之间对不对得上。三步加起来不到两小时。
第三步里“彼此对不对得上”是关键判据。两列自己量的数如果方向一致,说明它们至少在共同测量某个真实的东西;如果毫无关系,那就得回头看是不是其中一列的口径有问题。这个自查比拿它们去跟公开分级对照更有用。
用语言代码查表要注意什么?
注意两件事。一是你手上那个码在目标表里存不存在,阿拉伯语、波斯语、爱沙尼亚语、汉语这四个常用码在本文用的数据库里都要换写法。二是查到的那一条是不是语言本身,有45个码挂在语族层、280个挂在方言层,尼泊尔语用两个合法代码能查出最低档和最高档两个相反的答案。查完之后确认一下条目名跟你要的语言对不对得上,这一步花不了一分钟。
如果你的语言清单是从别的系统导出来的,还要多问一句这份清单用的是两位码还是三位码。两位码的覆盖面比三位码小得多,转换过程中一门语言被映射到哪个三位码,不同的转换表给的答案可能不一样。
这套做法多久该重跑一次?
公开分级那部分基本不用重跑,它们的更新节奏以年计,而且如前所述在你关心的区间上不会变。自己量的那几列建议一年重算一次,其中界面语言包完成度变化最快——本站实测过曾经翻满的版本有四成已经掉队,这一列半年看一次都不算勤。
token倍数那一列的重算触发条件不是时间,是换模型。分词器一换,整张表的倍数会重排,而这件事不会有人通知你。
权威参考资料
本文标题:《小语种数字化程度有四张现成的分级表,73门语言查下来全挤在同一档》
本文链接:https://zhangwenbao.com/minor-language-digital-rating-scale-saturation.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0