小语种平行语料清单列着上百个来源,按量算一多半出自同一家
本文目录
- 你查到的那几十个语料库,能算几个独立来源?
- 先说这件事是怎么撞上的
- 这次拉了多少数据
- 要回答的问题只有一个
- 归并的办法
- 70门语言的语料构成,拆开看是什么样?
- 先看最小的那一档
- 最大的那一档
- 全部70门的汇总
- 几个极端值
- 每门语言最大的那个语料库,是谁?
- 答案只有5个
- 把同一家的都算上
- 逐门看几个数
- 这张表最该看的是最后两行
- 覆盖面最广的语料库,和量最大的语料库,是同一批吗?
- 两张榜几乎不重合
- 这个错位是怎么造成的
- 为什么这件事容易骗人
- 宗教语料正好卡在中间
- 一份数据在清单上挂了两个名字,是怎么发现的?
- 先看到的是一个巧合
- 逐门语言核一遍
- 有一处不一样
- 为什么这件事值得单独写一节
- 为什么说两份语料互相验证在小语种上不成立?
- 先讲那两个最大的项目是怎么来的
- 所以它们共用的不只是文本
- 这就是“相关的错误”
- 在小语种上尤其严重
- 保哥开工前猜错了什么?
- 原本以为占大头的是宗教文本
- 实测结果是全线落空
- 错在量上,对在覆盖面上
- 为什么会差这么多
- 这件事会在哪几个环节结算?
- 估成本的时候
- 评估翻译质量的时候
- 判断一门语言能不能上机器工序的时候
- 做模型能力预期的时候
- 那该怎么用这些语料?
- 先明确它们不是不能用
- 三步归并法
- 这个数通常是几
- 顺带说一个便宜的自查
- 这次测量保哥错了一回,错在哪?
- 一个覆盖面最广但量为零的语料库
- 打开原始记录看了一眼
- 固化成一条
- 这一条跟本文的主命题是同一件事
- 哪些相邻的问题不归这一层管?
- 语料质量本身是另一套账
- 模型内部怎么用这些数据也不在这里
- 单语语料没有一起量
- 非英语的语言对更没量
- 常见问题解答
- 那我该不该继续用这些语料?
- 怎么快速看出两个语料库是不是同源?
- 大语种是不是就没这个问题?
- 我不做机器翻译,这件事跟我有关系吗?
- 为什么只查了与英语配对的语料?
- 这个结论会不会过两年就变了?
- 不懂这些语言,怎么自己跑一遍?
- 权威参考资料
摘要:在公开语料库平台上查一门小语种,下面会列出几十个语料库,看起来来源相当分散。本文把70门语言与英语的平行语料逐门拉下来,按句对数加总并按真实来源归并。
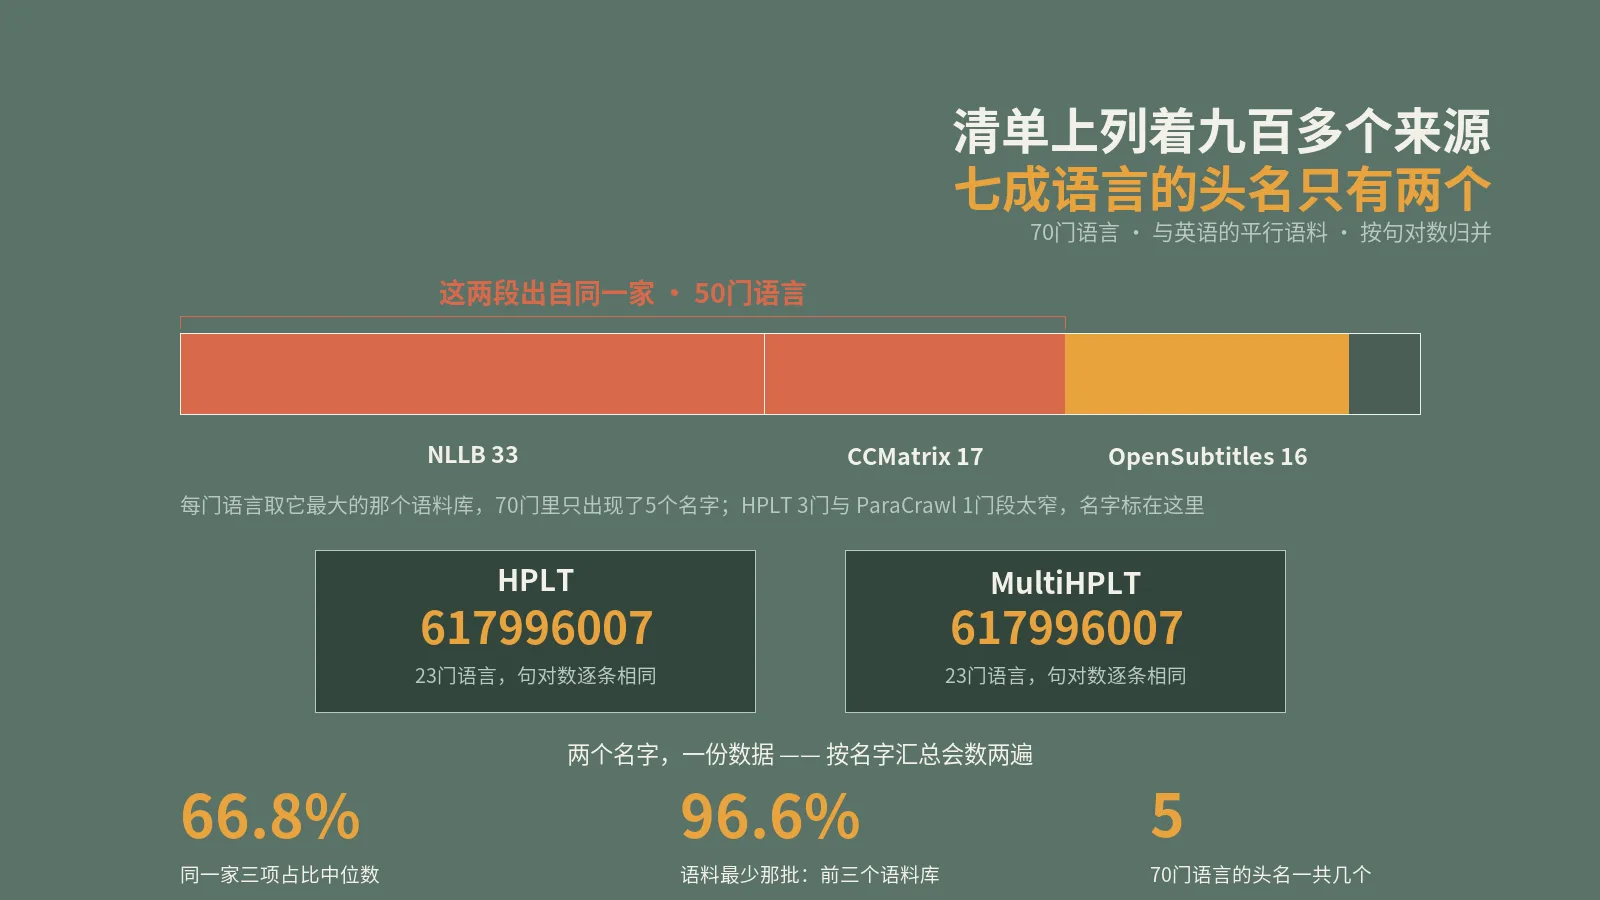
结果是:70门语言里有66门的最大语料库只来自3个项目,其中两个出自同一家公司;按句对数算,同一家的三个项目占比中位数66.8%;语料总量最小的那批语言,前三个语料库就占96.6%。还有一份数据在清单上挂着两个名字,23门语言的句对数逐条完全相同。
文中给出70门语言的构成分档、集中度随语料规模变化的曲线、那两个同名数据的比对过程,以及一条开工前猜错的预期。
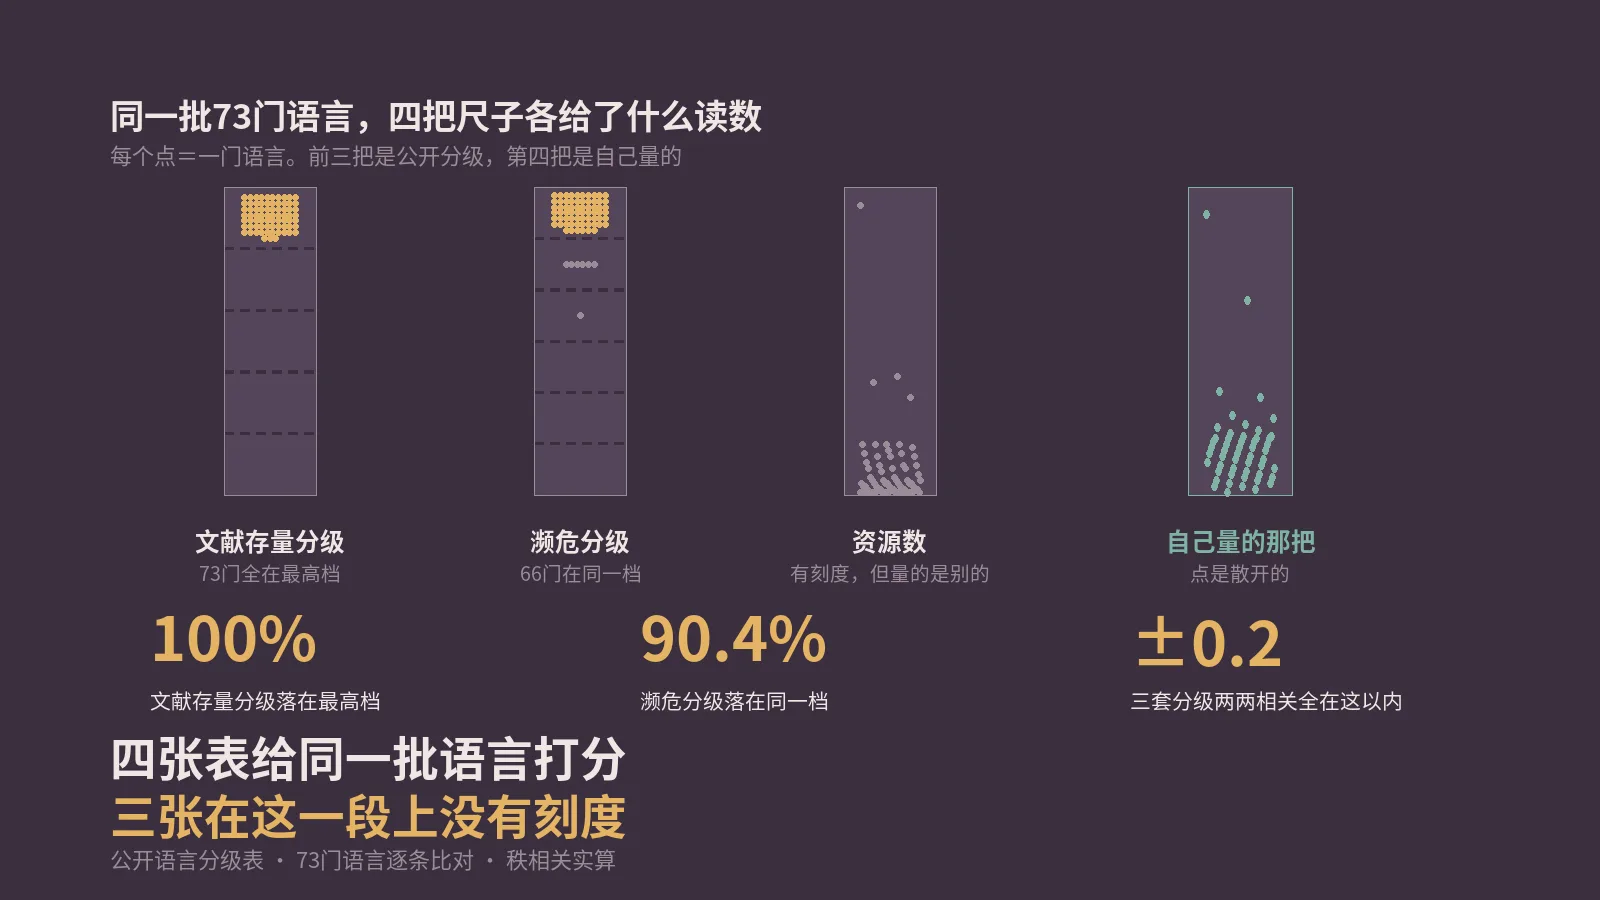
前一篇讲的是几张公开的语言分级表互相不同意,三套之间的相关性接近于零。这一篇是它的反面。
那篇的麻烦是,你以为拿到了几个独立的判断,其实拿到的是几个各说各话的判断。这篇的麻烦更隐蔽一点:你以为拿到了几份独立的数据,其实拿到的是同一份数据的几个切片。
两种情况下你都会做同一个动作——把几个来源摆在一起互相印证,然后因为它们一致或者不一致而更有信心。而这个动作在小语种上,两头都不成立。
上一篇的结论是“别把三个互不相关的判断当成三重证据”。这一篇要说的是反过来的那一半:别把同一份数据的几个切片当成几份数据。两条合起来才完整——在小语种上,交叉验证这个动作本身,得先验证被交叉的那几个源是不是独立的。
你查到的那几十个语料库,能算几个独立来源?
先说这件事是怎么撞上的
起因是要给一批市场估翻译和模型改写的成本。估这个要先知道每门语言能拿到多少平行语料——有现成语料的语言,机器工序的比重可以调高;没有的,人工那一档的预算得翻倍。
公开语料库平台上这个数查起来很方便,按语言一查,下面列着一长串语料库名字,每个后面跟着句对数。这个平台在自己的论文里把收录方式写得很清楚:它做的是把网上能免费拿到的对照文本转换、对齐、加标注,再统一发布。老挝语下面有二十来个,蒙古语三十来个,看着挺富裕。
直到把句对数加起来按大小排了一次序。排完之后那份富裕感就没了。
排出来的形状是这样的:前两三个语料库拿走绝大部分,后面十几二十个每个只有几万甚至几千句对,加起来凑不满一个零头。清单很长,但长度几乎全部来自那条尾巴。
这次拉了多少数据
70门语言,每门查一遍它与英语的平行语料清单,取最新版本。这70门是本站这个栏目写过或者提过的语言,加上几门大语种当参照系。
汇总下来一共出现过932个不同的语料库名字。这个数字本身就有迷惑性:九百多个来源,听起来是一个相当健康的生态。
覆盖面最广的几个是:有4个语料库出现在全部70门语言里,另有几个覆盖到67、68门。这些全覆盖的条目量都不大,它们更像是这个生态的底座,而不是主力。
另一头是长尾:九百多个名字里,绝大多数只出现在个位数的语言里,很多只覆盖一两门。这条长尾对总量的贡献可以忽略,但它撑起了“九百多个语料库”这个数字。
要回答的问题只有一个
不是“有多少个语料库”,是“有几个独立来源”。这两个数在英语上差不多,在小语种上差得离谱。
一个语料库是一个条目,一个来源是一批原始文本。十个条目可以从同一批网页里挖出来,那它们是一个来源不是十个。而平台上的列表按条目排,不按来源排。
这个区分不是学究气。它决定了一件很实际的事:当两份数据给出一致的结果时,你能不能把这当成一次确认。条目不同但来源相同的两份数据,给出一致结果是必然的,不提供任何额外信息。
归并的办法
按每个语料库的原始文本从哪来分类:从网页抓取里挖出来的归一类,电影字幕归一类,维基百科系归一类,官方与法律文书、软件界面字符串、宗教文本各归一类。
分类依据是每个语料库自己的说明页,不是名字。这一步不能偷懒,因为好几个名字完全不同的语料库,说明页上写的是同一件事。
也有反过来的情况:名字看着像一家的,实际来源完全不同。所以唯一可靠的办法是逐个打开说明页读两行,一门语言的主力语料库通常不超过五个,这一步比想象中快。
70门语言的语料构成,拆开看是什么样?
先看最小的那一档
把70门语言按句对总量排序切成四档。最小的那17门,语料总量的中位数是1639万句对。
这一档里,从网页抓取里挖出来的那一类占比中位数是96.8%。前三个语料库加起来占96.6%。
也就是说,清单上列着二三十个名字,实际上前三个就是全部,剩下的加起来不到百分之四。
这一档的语言包括老挝语、祖鲁语、伊博语、约鲁巴语、高棉语、豪萨语、缅甸语这些。它们的共同点是都有几百万到几千万使用者,在各自的国家里是主要语言,但在平行语料这一层上薄得只剩一层皮。
具体到数字:约鲁巴语的平行语料总量179万句对,祖鲁语483万,伊博语702万,高棉语862万,豪萨语977万。作为对照,西班牙语是13.7亿。同一个量纲下差了两到三个数量级。
最大的那一档
最大的19门语言,同样三个数字分别是69.8%和70.5%。集中度确实低了,但也只是从“三个语料库占九成六”降到“三个占七成”。
中间两档是88.4%、94.6%和71.0%、69.6%。整体趋势很干净:语料越少,集中度越高。
这条趋势的方向值得注意:它跟“语料越少越该小心”是同一个方向,所以很容易被当成一句废话略过去。但它多说了一件事——小语种面临的不是单纯的数据少,是数据少加上来源单一,这两件事的叠加效果比任何一件单独出现都严重。
叠加的具体后果是:数据少可以靠多花钱补,来源单一补不了——你多买十份来自同一次挖掘的数据,独立性一点没增加。这就是为什么这一列值得单独进排期表,它管的是一类花钱解决不了的风险。
全部70门的汇总
网页抓取那一类占比的中位数是82.3%,前三个语料库占比的中位数是88.2%。前三个就占八成以上的语言有40门,超过一半。
这条趋势本身不难理解。大语种有欧盟文书、有专利、有议会记录、有几十年的翻译积累,来源天然分散;小语种没有这些,能有的只有从网上挖出来的那些。
换个说法:大语种的语料是几十年里不同的人出于不同目的攒下来的,小语种的语料是最近几年少数几个项目一次性挖出来的。前者天然多样,后者天然同质,这个差别不是谁做得好做得差,是历史长度造成的。
几个极端值
蒙古语的网页系占99.6%里的99.3%,老挝语99.6%,阿姆哈拉语98.3%,祖鲁语98.3%,乌兹别克语95.1%。这几门语言的平行语料,几乎全部是从网页里自动挖出来的。
本站为老挝语单独写过一篇,讲它的交易词在搜索建议里几乎拉不出来。那篇量的是需求侧,这篇量的是供给侧,两边指向同一个结论:这门语言在数字世界里的底子,比它的使用人口暗示的要薄得多。
僧伽罗语是个有意思的对照。本站量过它的需求侧相当健康,搜索建议拉得出来,可它的平行语料总量只有3574万句对,前三个语料库占掉绝大部分。需求和供给这两侧不是一回事,得分开量。
每门语言最大的那个语料库,是谁?
答案只有5个
70门语言,每门取它最大的那个语料库,一共只出现了5个不同的名字。
NLLB占33门,CCMatrix占17门,OpenSubtitles占16门,HPLT占3门,ParaCrawl占1门。
前两个加起来50门,超过七成。而这两个项目出自同一家公司。
第三名OpenSubtitles是电影字幕,它跟前两个确实是独立来源——原始文本是人翻的台词,不是从网页挖的。它占16门语言的头名,而这16门几乎全是语料总量大的那批。
这一条其实是个好消息:字幕语料给了一批语言真正的第二来源。代价是它的文体极其单一,全是口语对白,用它训出来的东西在商品描述、政策条款这类文体上会明显水土不服。独立但偏科,比同源要好,但不等于够用。
把同一家的都算上
那家公司在这份清单上有三个项目:NLLB、CCMatrix、CCAligned。把三个的句对数加起来算占比,70门语言的中位数是66.8%。
三项合计占到一半以上的语言有49门。也就是说,你在七成的语言上,手里的平行语料有一多半出自同一家。
需要说明的是,这不是在说这家公司做错了什么。恰恰相反,这批数据是过去几年低资源语言技术最大的推动力,没有它,表上一多半语言连基本的机器翻译都不会有。问题只在于记账:一家出的三份数据,在你的表格里不该占三个独立来源的位置。
逐门看几个数
| 语言 | 句对总数 | 网页系占比 | 同一家三项占比 | 最大语料库及其占比 |
|---|---|---|---|---|
| 蒙古语 | 1729万 | 99.3% | 98.8% | NLLB 95.5% |
| 阿姆哈拉语 | 1684万 | 98.3% | 97.9% | NLLB 95.8% |
| 祖鲁语 | 483万 | 98.3% | 97.7% | NLLB 95.1% |
| 乌兹别克语 | 3259万 | 95.1% | 95.1% | NLLB 95.1% |
| 斯瓦希里语 | 3283万 | 98.9% | 95.4% | NLLB 71.6% |
| 威尔士语 | 2137万 | 93.4% | 92.4% | NLLB 88.4% |
| 德语 | 9.44亿 | 85.7% | 54.1% | ParaCrawl 29.5% |
| 捷克语 | 3.52亿 | 69.0% | 35.7% | OpenSubtitles 18.5% |
这张表最该看的是最后两行
德语和捷克语的最大语料库占比不到三成,同一家三项占比一半上下。这才是“来源分散”该有的样子。
而上面六门语言的最大语料库单独一个就占到七成到九成六。它们在平台上列出的语料库数量并不比德语少多少,只是那些条目里装的东西少得可以忽略。
这就是清单长度骗人的地方:条目数是按“有没有”算的,句对数是按“有多少”算的。一门语言可以在三十个语料库里都露一面,每面只有两千句。
可执行的替代做法:别看清单有多长,看累计占比曲线。把句对数从大到小排,看前几个加起来到九成五。这个数在小语种上通常是三,在大语种上是八到十五。这一个数字比整份清单都有信息量。
覆盖面最广的语料库,和量最大的语料库,是同一批吗?
两张榜几乎不重合
按覆盖语言数排,榜首是几个软件界面字符串和维基系的语料库,它们出现在全部70门语言的清单里。再往下是68门、67门、65门、63门这一档。
按句对数排,榜首完全是另一批:三十五亿、二十七亿、十八亿、十四亿,前四名拿走的量比后面九百多个加起来还多。
两张榜的交集只有两三个名字。也就是说,那些每门语言都有的语料库,恰恰是量最小的;而量最大的那几个,覆盖面反而不如它们。
这个错位是怎么造成的
每门语言都有的那批,多半是软件界面的翻译文件和维基系的条目标题。这类文本的特点是几乎所有语言都翻了一点,但每种语言翻的量都很有限——一个软件的界面就那么多句话。
而量最大的那批是自动挖掘的产物,它挖到多少取决于这门语言在网上有多少文本,所以量的分布极不均匀,覆盖面也就跟着参差。
为什么这件事容易骗人
因为“每门语言都有”读起来像是一种保障。你查一门冷门语言,看到几个熟悉的语料库名字都在,会觉得基础还在。
实际上那几个熟面孔加起来可能只有几万句对,而这门语言真正的数据量全部压在一两个自动挖掘的条目上。覆盖面这一列衡量的是有没有人翻过,句对数这一列衡量的是有多少可用,两者回答的不是同一个问题。
宗教语料正好卡在中间
宗教文本那一类在覆盖面上排得相当靠前,出现在47门语言的清单里;而它的句对总数只有两百多万,在按量排的榜上远远看不见。
这个位置很能说明问题:它是典型的“广而薄”。历史上被翻译成几千门语言,所以哪门语言都能查到;但篇幅固定,所以量永远上不去。本文开工前猜错的那一条,根子就在把这两张榜混为一谈。
一份数据在清单上挂了两个名字,是怎么发现的?
先看到的是一个巧合
把932个语料库按句对总量排序的时候,第5名和第6名的数字完全一样:617996007。覆盖的语言数也一样,都是23门。
两个名字是HPLT和MultiHPLT。数字一样到个位,这种事不会是巧合。
逐门语言核一遍
把23门语言逐条比对:两者都存在的23门,句对数完全相同的23门,不同的0门,只有其中一个的0门。版本号也一样,都是v3。
再看两个数据集的说明页,文字一字不差:都写着“来自HPLT项目收集的网页抓取平行语料”,都写着“本版本由原始发布调整而来以便在本平台重新分发”。
两页的结构、段落顺序、连致谢的措辞都一样。要是只打开其中一页,你不会觉得有任何异常;把两页并排放,差别只在标题那一个词。
这两个名字的字面差异也很有迷惑性:一个多了个前缀,看起来像是“多语言版”,会让人以为它是另一个覆盖面更广的数据集。而实际覆盖的语言数一模一样,都是23门。
有一处不一样
打包后的文件字节数有微小差异。保加利亚语两边完全相同,都是4007751;捷克语是5812445对5823024;丹麦语是6407106对6407107,差1个字节。
所以准确的说法不是“两个完全相同的文件”,而是:同一个项目的同一个版本,在这个平台上以两个名字各列了一份,句对数逐门语言完全相同,说明文字一字不差,只有打包结果差千分之几。
为什么这件事值得单独写一节
因为它是这篇里唯一一个不需要任何领域知识就能验证的例子。你不需要知道这些语料是怎么挖的、质量如何、能不能用,只需要看两列数字一不一样。
而如果你正在按语料库名字汇总“这门语言一共有多少平行语料”,这一份会被数两遍。23门语言,每门多算六亿多句对里的一份。
更值得警惕的是这件事发生得有多安静。平台没有标错,两个条目都真实存在、都能下载、都有各自的页面;错的是汇总这一步的默认假设——按名字去重,而不是按内容去重。
类似的形状在别处也会出现:同一批数据的不同版本号、同一个项目的分卷、同一份语料的清洗版与原始版。它们在清单上都是独立条目,在来源上都是同一个。按名字汇总的脚本一律看不出来。
为什么说两份语料互相验证在小语种上不成立?
先讲那两个最大的项目是怎么来的
NLLB和CCMatrix都不是有人一句一句翻出来的。它们是从大批网页文本里,用句向量模型把意思相近的句子自动配成对挖出来的。
CCMatrix那篇论文的标题就写着“从网页上挖掘数十亿高质量平行句”,它用的句向量模型是同一家开源的LASER。NLLB的数据集说明页写的也是同一条路子,用的是这个模型的后续版本。
所以它们共用的不只是文本
同一批网页当原料,同一个模型当筛子,只是筛子的版本号不同。这意味着两件事。
第一,一句话如果在网页上根本不存在,两份语料里都不会有它。第二,一对句子如果被这个模型判成对齐而实际上不对齐,两份语料里很可能都错,而且错得一样。
第一条比第二条更要紧。它意味着这两份语料共享同一个盲区:凡是这门语言里没被写到网上的话题、没被翻译过的品类、只在线下用的说法,两份里都是空的。而做电商本地化的人要找的词,恰恰有很大一部分落在这些地方。
这就是“相关的错误”
交叉验证之所以有用,前提是两个来源的错误彼此独立。一个偏左一个偏右,取交集就能把噪声压下去。
但如果两个来源的错误方向一致,取交集不会压掉噪声,只会让你对噪声更有信心。这比只用一个来源更糟,因为你会因为“两份都这么说”而不再去查。
这一条在日常工作里的样子是:你让两个不同的工具翻同一句话,结果一样,于是签字通过。而如果这两个工具底下垫的是同一批语料,结果一样是它们的出厂设置,不是对这句话的确认。
更稳的验收办法是找一个确定不同源的参照物:一个本地母语者、一份当地出版的印刷材料、一段线下采集的真实对话。哪怕样本很小,只要它跟那批语料没关系,它提供的信息量就比第二个自动工具大得多。
在小语种上尤其严重
大语种还有别的东西垫底:欧盟文书是人翻的,议会记录是人翻的,专利摘要是人翻的。这些语料的错误跟自动挖掘的错误确实独立。
而前面那张表上的六门语言,非自动挖掘的部分加起来不到百分之五。它们的“多个来源”在原料和方法两层上都收敛到了同一处。
这也解释了一个常被观察到但不太好解释的现象:几个不同厂商的机器翻译在小语种上,经常在同一个地方犯同一个错。以前会归因于“这门语言就是难”,现在有了一个更具体的解释——它们读的是同一批句子。
保哥开工前猜错了什么?
原本以为占大头的是宗教文本
这件事在低资源语言的语料圈里几乎是个常识:很多小语种最早也最完整的平行文本是宗教典籍的译本,因为那是历史上唯一被系统翻译成几千门语言的文本。
所以开工前的预期写得很明确:小语种的平行语料里,宗教文本应该占相当大的比例,越小的语言比例越高。
写下这条预期的时候还挺有把握,因为它有历史依据:几百年里唯一被系统翻译成几千门语言的文本就那一类,这在语言学文献里是反复被提到的事实。前一篇里那套文献分级,倒数第二档的定义里直接就写着新约圣经。
实测结果是全线落空
70门语言里,宗教文本占比最高的是乌尔都语2.1%,其次豪萨语1.3%,剩下全部在1%以下,多数是零点几。没有一门语言超过5%。
预期错得挺彻底。但错的方式值得记一下。
因为它不是简单的方向错了,而是把两个不同的指标搞混了。这类错误比方向错更难自查,因为你确实看到了支持你的证据,只是那证据回答的是另一个问题。
错在量上,对在覆盖面上
宗教语料的覆盖面确实极广:它出现在47门语言的清单里,在932个语料库里按覆盖语言数排第15。这一半的直觉是对的。
错的是量。它一共只有275万句对,而排第一的那个项目有35.3亿。覆盖广和量大是两件事,我把它们当成了一件。
为什么会差这么多
因为宗教典籍的篇幅是固定的,翻译一遍就那么多句子,不会因为时间推移而增长。而从网页里挖,网页每年都在变多。
这也意味着两者的趋势是分叉的:宗教语料的绝对量二十年基本不变,占比会持续被稀释;自动挖掘的量每次新版本都往上跳一截。今天占比不到百分之一的东西,十年前可能是主力。
这条修正反而比原来的预期更有用:它说明小语种的语料格局在过去十年里已经换过一轮,今天占大头的不是历史上那批人工译本,是这几年自动挖出来的东西。本站量过的那批公共词典资源停在十几年前,语料这一层却完全相反,新的把老的彻底盖过去了。
两层的节奏差这么多,对排期是有意义的:语料这一层的状况可能每两年就变一次,值得定期重查;而词典和工具链那一层十年不动,查一次可以管很久。
这件事会在哪几个环节结算?
估成本的时候
最直接的一处。你看到一门语言有三千万句对平行语料,判断它的机器工序可以多担一点,人工少一点。而这三千万里九成五出自同一次自动挖掘,质量分布是同一条曲线。
更稳的读法是把“句对总数”换成“非同源句对数”。按前面的中位数,这个数大概是总数的三分之一,在最小的那批语言上不到十分之一。
这个换算不需要精确。把总数打三折,最小那批语言打一折,用这个粗略的数去估人工比重,比用原始总数稳得多。估错的方向也更安全:宁可多排一点人工,也别在上线之后才发现机器那一档的质量兜不住。
评估翻译质量的时候
如果你拿两个不同名字的语料各抽一批做人工抽检,抽检结果一致,你会认为质量可信。而实际上你抽的是同一次挖掘的两个切片。
可执行的做法是抽检之前先看一眼这两批数据的说明页,确认它们的原始文本和对齐方法至少有一样不同。这一步花五分钟。
如果确认下来两批确实同源,也不是不能抽检,只是要把结论的措辞改掉:不能写“两份数据交叉验证通过”,只能写“这批数据内部一致”。后者是个弱得多的结论,但它是真的。
判断一门语言能不能上机器工序的时候
这一层跟本站写过的同一段话在不同语言里要多少token是配套的。token倍数决定单价,语料的独立来源数决定你能不能靠机器把质量兜住。
两个数一起看才有意义:单价高而且语料集中,那就是双重风险,这类语言要老老实实排人工。
按本文这70门的数据,同时踩中这两条的有老挝语、阿姆哈拉语、高棉语、缅甸语、僧伽罗语这几门。它们的token倍数都在2.5倍以上,而前三个语料库占比都在九成以上。
这几门语言的共同处境值得单独记一句:它们的单价最高、可用数据最少、来源最单一,三件事叠在一起。排期的时候如果按“市场潜力”把它们排在前面,实际执行会比预算表上难得多。
做模型能力预期的时候
模型在一门语言上的表现,上限是它见过的数据。如果一门语言的平行数据九成来自同一次挖掘,那么模型在这门语言上的盲区会跟那次挖掘的盲区重合。
本站在低资源语言的生成内容风险那篇里讲过哪些内容必须逐条核。这篇给那条建议补了一个成因:不是模型不努力,是它能拿到的材料本身就窄。
那该怎么用这些语料?
先明确它们不是不能用
自动挖掘出来的语料是过去几年低资源语言技术进步最大的推手,没有它们,很多语言连基本的机器翻译都不会有。这篇不是要劝人别用。
要改的只是记账方式:别把一个语料库当成一个独立来源,别把清单长度当成来源丰富度。
三步归并法
第一步,把你查到的语料库列表按句对数排序,只保留累计占比到95%的那几个,后面的可以全部忽略——在小语种上这通常是三到五个。
第二步,逐个打开它们的说明页,记下两件事:原始文本从哪来,对齐是人工还是自动。
第三步,把原始文本和对齐方法都相同的归成一组。剩下的组数,才是你真正的独立来源数。
判断“原始文本相同”有个省事的标准:都写着来自网页抓取的,就算一组,不必细究抓的是哪一批网页。因为对小语种来说,可抓的网页本来就那么多,不同项目抓到的重合度极高。
这个数通常是几
按这70门语言的数据,最小那一档的语言归并完之后通常剩1到2组,中间档2到3组,大语种4到6组。
1组是什么意思?意思是你手上没有任何东西可以用来验证它。这时候唯一的办法是自己造一个小的对照集:找几十句本地人写的真句子,人工核一遍,拿它当基线。
几十句听起来少,但它的作用不是统计显著,是给你一个不来自那批语料的参照点。本站在别的批次里反复验证过:一个小而独立的对照集,比一份大而同源的数据更能挡住系统性偏差。
造这个对照集的成本比想象中低:找本地同事写五十句真实的商品描述和客服回复,或者从当地的实体包装、说明书上抄五十句。关键不是数量,是它的产生过程跟那批语料完全没有交集。
顺带说一个便宜的自查
查任何语料清单的时候,顺手扫一眼有没有两行的句对数完全相同。这个检查不到十秒,而它能抓出本文第四节那种同一份数据两个名字的情况。
数字完全相同到个位的两行,几乎不可能是两份独立的数据。
这次测量保哥错了一回,错在哪?
一个覆盖面最广但量为零的语料库
统计跑完之后,汇总表上有一行很扎眼:一个软件界面字符串的语料库,出现在全部70门语言的清单里,覆盖面并列第一,而句对数合计是0。
这个组合读起来像个结论:一个每门语言都挂着、实际上什么都没有的空壳。写进文章里会相当有戏剧性。
打开原始记录看了一眼
那一格不是0,是空字符串。平台返回的字段里,句对数这一项在这个语料库上就没填,而我的脚本把转换失败的值落回了0。
落回0这个写法本身很常见,也很难说是错的——总得给一个默认值。问题在于0在这一列里是个有意义的读数,它跟“没填”长得一模一样,而汇总之后再也分不开。
实际上它是有数据的,德语那一条底下挂着378个文件,只是对齐句对的数量没被统计进去。
固化成一条
凡是出现“覆盖面最广但量为零”这种形状,先打开原始记录看那一格到底是0还是空。这两者在汇总表上长得一模一样,含义正好相反:一个是量过了没有,一个是没量过。
前一篇里也栽过类似的一次:一门语言的资源数算出0,实际是匹配条件没命中。两次的形状不同,教训是同一条——任何一个零在当成结论之前,都得先排除它是不是测量过程的产物。
这一条跟本文的主命题是同一件事
说到底,无论是把两个名字当成两份数据,还是把一个空字段当成一个零,错的都是同一步:拿汇总表上的形状直接当事实,而没有回到原始记录去看那个形状是怎么来的。
汇总表的作用是让你看见形状,不是让你相信形状。看见一个异常的形状之后,正确的下一步是回到原始记录,而不是给这个形状配一段解释。配解释太容易了,而且配出来的解释往往很有说服力。
哪些相邻的问题不归这一层管?
语料质量本身是另一套账
本文只数了来源和数量,一句都没评价质量。自动挖掘出来的句对里有多少是真对齐的、噪声比例多高,这是另一个专门的研究领域,结论也在持续变化。本文的结论不依赖质量好坏——就算质量很好,同源这件事依然成立。
模型内部怎么用这些数据也不在这里
一份语料进了训练流程之后会被怎么采样、加权、去重,跟它在公开平台上怎么列是两回事。那一层的决定权在做模型的人手里,从外面看不见。
单语语料没有一起量
本文查的全部是与英语配对的平行语料。单语语料是另一份清单,构成也不一样,结论不能直接套过去。要用同样的办法量单语那一侧,得换一套接口重做一遍。
非英语的语言对更没量
这次全部是某语言对英语。本站讲过中间经英语中转的那篇说明了为什么大部分链路都要经过英语这一站,所以英语对是最有代表性的一组。但两门小语种之间直接配对的语料是另一个故事,那一侧通常更薄。
常见问题解答
那我该不该继续用这些语料?
该用。它们在很多语言上是唯一现成的东西,不用就没有替代品。要改的只是两件事:别把语料库个数当来源数,以及在做任何“两份数据互相印证”的判断之前,先确认这两份的原始文本和对齐方法至少有一样不同。归并这一步一门语言花不了十分钟。
怎么快速看出两个语料库是不是同源?
三个信号,从快到慢。最快的是看句对数有没有完全相同的两行,十秒钟。其次是打开两边的说明页对照文字,同源的往往连措辞都一样。最慢但最准的是看它们各自引用的论文,如果指向同一个对齐模型,那原料不同也算半同源。
大语种是不是就没这个问题?
问题小很多但没消失。德语的同一家三项占比还有54.1%,捷克语35.7%。区别在于大语种有足够的人工翻译语料垫底,归并之后仍然剩四到六个真正独立的来源,做交叉验证是成立的。小语种归并完常常只剩一到两组,那时候交叉验证这个动作就没有对象了。
我不做机器翻译,这件事跟我有关系吗?
有,只要你用到任何涉及这门语言的自动处理。站内搜索的同义词扩展、商品标题的自动改写、AI生成的本地化文案,底下都可能踩在同一批语料上。更直接的一处是估预算:你按语料丰富度调低了人工比重,而那个丰富度是虚的。
为什么只查了与英语配对的语料?
因为绝大多数工具链的默认路径都经过英语,英语对是覆盖最全、最有代表性的一组。两门小语种之间的直接语料在多数语言上少一两个数量级,单独拉出来数据会太稀疏,得不出稳定的比例。想量那一侧要另外设计取样。
这个结论会不会过两年就变了?
集中度大概率会继续升高而不是降低。因为新增的语料主要来自更大规模的自动挖掘,而有能力做这件事的机构就那么几家。真正会改变格局的是有人开始为某门语言系统地做人工平行语料,但这件事在过去十年里只发生在很少几门语言上。
不懂这些语言,怎么自己跑一遍?
完全不需要懂。查语料清单、看句对数、读说明页,全部是英文界面加数字比对。一门语言从查到归并完大约十分钟,五门候选语言一个下午能做完,产出是一张“独立来源数”的表,可以直接贴进排期材料。
权威参考资料
本文标题:《小语种平行语料清单列着上百个来源,按量算一多半出自同一家》
本文链接:https://zhangwenbao.com/minor-language-parallel-corpus-source-concentration.html
版权声明:本文原创,转载与引用请注明作者与原文链接。许可协议: CC BY 4.0